ภาษาโปรแกรม Rust
โดย Steve Klabnik, Carol Nichols และ Chris Krycho พร้อมการมีส่วนร่วมจากชุมชน Rust
เนื้อหาในหนังสือเล่มนี้เขียนขึ้นโดยอิงตาม Rust 1.98.0 (เผยแพร่เมื่อ 2026-08-20) หรือใหม่กว่า และกำหนด edition = "2024" ในไฟล์ Cargo.toml ของทุกโปรเจกต์เพื่อให้สอดคล้องกับสำนวนของ Rust ฉบับ 2024 ดูคำแนะนำในการติดตั้งหรืออัปเดต Rust ได้ที่หัวข้อ “การติดตั้ง” ของบทที่ 1 และดูข้อมูลเกี่ยวกับฉบับของ Rust (editions) ได้ที่ภาคผนวก E
รูปแบบ HTML สามารถอ่านออนไลน์ได้ที่
https://doc.rust-lang.org/stable/book/
และสามารถอ่านแบบออฟไลน์ได้จากการติดตั้ง Rust ผ่าน rustup โดยรันคำสั่ง rustup doc --book เพื่อเปิดอ่าน
นอกจากนี้ยังมีฉบับแปลโดยชุมชนในภาษาอื่นๆ อีกหลายภาษา
หนังสือเล่มนี้มีจำหน่ายในรูปแบบหนังสือเล่มปกอ่อนและอีบุ๊กจาก No Starch Press
🚨 ต้องการประสบการณ์การเรียนรู้แบบอินเทอร์แอกทีฟมากขึ้นหรือไม่? ลองสัมผัส Rust Book อีกเวอร์ชันหนึ่งที่มาพร้อมแบบทดสอบ การไฮไลต์โค้ด การแสดงภาพจำลอง และฟีเจอร์อื่นๆ อีกมากมาย: https://rust-book.cs.brown.edu
คำนิยม
ภาษาโปรแกรม Rust ก้าวหน้ามาไกลมากในเวลาเพียงไม่กี่ปี จากจุดเริ่มต้นที่กำเนิดและฟูมฟักขึ้นโดยกลุ่มคนรักเทคโนโลยีกลุ่มเล็กๆ ที่เพิ่งก่อตัว จนเติบโตกลายเป็นหนึ่งในภาษาโปรแกรมที่ผู้คนรักและเป็นที่ต้องการมากที่สุดในโลก เมื่อมองย้อนกลับไป ย่อมเป็นธรรมดาที่ประสิทธิภาพและศักยภาพอันเปี่ยมคำมั่นสัญญาของ Rust จะสะกดทุกสายตาและหยั่งรากลึกในวงการเขียนโปรแกรมระดับระบบ (systems programming) ทว่า สิ่งที่ไม่ได้เกิดขึ้นเองตามธรรมชาติ คือคลื่นความสนใจและนวัตกรรมระดับโลกที่แผ่ขยายไปทั่วชุมชนโอเพนซอร์ส พร้อมจุดประกายให้เกิดการนำไปประยุกต์ใช้อย่างกว้างขวางในหลากหลายอุตสาหกรรม
ณ วันนี้ เป็นเรื่องง่ายที่จะชี้ให้เห็นถึงคุณสมบัติอันยอดเยี่ยมของ Rust เพื่ออธิบายถึงกระแสความนิยมและการเติบโตอย่างก้าวกระโดดนี้ ใครเล่าจะไม่อยากได้ทั้งความปลอดภัยของหน่วยความจำ และ ประสิทธิภาพความเร็วระดับสูง และ คอมไพเลอร์ที่พร้อมช่วยเหลือ และ เครื่องมือชั้นยอด ควบคู่ไปกับคุณสมบัติอันยอดเยี่ยมอื่นๆ อีกมากมาย ภาษา Rust ที่คุณเห็นในทุกวันนี้ ผสมผสานผลงานวิจัยยาวนานหลายปีด้านการเขียนโปรแกรมระดับระบบ เข้ากับภูมิปัญญาเชิงปฏิบัติของชุมชนที่เปี่ยมด้วยพลังและความมุ่งมั่น ภาษา Rust ได้รับการออกแบบอย่างมีเป้าหมายและรังสรรค์ขึ้นอย่างประณีต เพื่อมอบเครื่องมือที่ช่วยให้นักพัฒนาเขียนโค้ดที่ทั้งปลอดภัย รวดเร็ว และเชื่อถือได้ง่ายดายยิ่งขึ้น
ทว่าสิ่งที่ทำให้ Rust มีความพิเศษอย่างแท้จริง คือรากฐานที่มุ่งส่งเสริมและมอบพลังให้แก่คุณในฐานะผู้ใช้ เพื่อให้บรรลุเป้าหมายของตนเองได้อย่างราบรื่น นี่คือภาษาที่ปรารถนาให้คุณประสบความสำเร็จ และหลักการเสริมสร้างพลังนี้ไหลเวียนอยู่ในหัวใจของชุมชนผู้สร้าง ดูแล และผลักดันภาษานี้ตลอดมา นับตั้งแต่การพิมพ์ฉบับก่อนหน้าของตำราเล่มนี้ Rust ได้วิวัฒนาการจนกลายเป็นภาษาที่เป็นสากลและได้รับความไว้วางใจอย่างลึกซึ้ง ปัจจุบันโครงการ Rust ได้รับการสนับสนุนอย่างมั่นคงจาก Rust Foundation ซึ่งร่วมลงทุนในโครงการริเริ่มสำคัญๆ เพื่อให้มั่นใจว่า Rust จะปลอดภัย มีเสถียรภาพ และเติบโตอย่างยั่งยืนสืบไป
หนังสือ The Rust Programming Language ฉบับนี้เป็นการปรับปรุงครั้งใหญ่ที่ครอบคลุมทุกมิติ เพื่อสะท้อนพัฒนาการของภาษาตลอดหลายปีที่ผ่านมา พร้อมนำเสนอข้อมูลใหม่ๆ อันทรงคุณค่า ทว่าหนังสือเล่มนี้มิได้เป็นเพียงคู่มืออธิบายไวยากรณ์และไลบรารีเท่านั้น หากแต่เป็นบัตรเชิญให้คุณก้าวเข้าสู่ชุมชนที่ให้คุณค่ากับคุณภาพ ประสิทธิภาพ และการออกแบบที่คิดมาอย่างรอบคอบ ไม่ว่าคุณจะเป็นนักพัฒนาผู้ช่ำชองที่ต้องการสัมผัส Rust เป็นครั้งแรก หรือเป็นชาว Rustacean ผู้มีประสบการณ์ที่มองหาโอกาสขัดเกลาทักษะ หนังสือฉบับนี้มีสิ่งที่มีค่ายิ่งสำหรับทุกคนอย่างแน่นอน
การเดินทางของ Rust คือเส้นทางแห่งการร่วมมือ การเรียนรู้ และการพัฒนาอย่างต่อเนื่อง การเติบโตของภาษาและระบบนิเวศล้วนเป็นภาพสะท้อนโดยตรงของชุมชนอันหลากหลายและเปี่ยมชีวิตชีวาที่อยู่เบื้องหลัง การร่วมแรงร่วมใจของนักพัฒนาหลายพันคน ตั้งแต่นักออกแบบแกนกลางของภาษา ไปจนถึงผู้ร่วมสมทบผลงานเป็นครั้งคราว คือสิ่งที่หล่อหลอมให้ Rust กลายเป็นเครื่องมือที่มีเอกลักษณ์และทรงพลังยิ่ง การเปิดอ่านหนังสือเล่มนี้จึงมิใช่เพียงแค่การเรียนรู้ภาษาโปรแกรมใหม่เท่านั้น หากแต่เป็นการเข้าร่วมการเคลื่อนไหวเพื่อสร้างสรรค์ซอฟต์แวร์ที่ดียิ่งขึ้น ปลอดภัยยิ่งขึ้น และสนุกสนานเพลิดเพลินยิ่งขึ้นในการลงมือพัฒนา
ยินดีต้อนรับสู่ชุมชน Rust!
- Bec Rumbul, ผู้อำนวยการบริหาร Rust Foundation
บทนำ
หมายเหตุ: หนังสือฉบับนี้มีเนื้อหาเช่นเดียวกับ The Rust Programming Language ที่มีจำหน่ายในรูปแบบหนังสือเล่มและอีบุ๊กจาก No Starch Press
ยินดีต้อนรับสู่ The Rust Programming Language หนังสือแนะนำภาษา Rust ภาษาโปรแกรม Rust ช่วยให้คุณพัฒนาซอฟต์แวร์ได้อย่างรวดเร็วและเชื่อถือได้ยิ่งขึ้น โดยทั่วไปแล้ว ในการออกแบบภาษาโปรแกรม ความสะดวกในการใช้งานระดับสูงกับความสามารถในการควบคุมระดับล่างมักเป็นสิ่งที่ขัดแย้งกัน แต่ Rust ก้าวข้ามข้อจำกัดนั้น ด้วยการผสานสมดุลระหว่างขีดความสามารถทางเทคนิคอันทรงพลัง เข้ากับประสบการณ์การพัฒนาที่ยอดเยี่ยม Rust เปิดโอกาสให้คุณควบคุมรายละเอียดระดับล่างได้ตามต้องการ (เช่น การบริหารจัดการหน่วยความจำ) โดยไม่ต้องเผชิญกับความยุ่งยากซับซ้อนที่มักจะตามมา
Rust เหมาะกับใคร
Rust เหมาะอย่างยิ่งสำหรับผู้คนหลากหลายกลุ่มด้วยเหตุผลที่แตกต่างกัน มาดูกลุ่มที่สำคัญที่สุดบางกลุ่มกัน:
ทีมนักพัฒนา
Rust พิสูจน์แล้วว่าเป็นเครื่องมือที่ช่วยเพิ่มประสิทธิภาพการทำงานร่วมกันในทีมนักพัฒนาขนาดใหญ่ที่มีระดับความรู้ด้านการเขียนโปรแกรมระดับระบบ (systems programming) แตกต่างกัน โค้ดระดับล่างมักมีโอกาสเกิดบั๊กที่ตรวจพบได้ยาก ซึ่งในภาษาส่วนใหญ่ บั๊กเหล่านี้จะตรวจพบได้ก็ต่อเมื่อผ่านการทดสอบอย่างเข้มข้นและการตรวจทานโค้ดอย่างละเอียดโดยนักพัฒนาผู้เชี่ยวชาญเท่านั้น แต่ใน Rust คอมไพเลอร์จะทำหน้าที่เป็นปราการด่านสำคัญ คอยปฏิเสธการคอมไพล์โค้ดที่มีบั๊กแฝงเร้นเหล่านี้ รวมถึงบั๊กที่เกิดจากการทำงานพร้อมกัน (concurrency bugs) เมื่อมีคอมไพเลอร์คอยตรวจสอบ ทีมจึงสามารถทุ่มเทสมาธิไปกับตรรกะของโปรแกรมได้อย่างเต็มที่ แทนที่จะต้องเสียเวลาตามไล่ล่าหาบั๊ก
นอกจากนี้ Rust ยังนำเครื่องมือพัฒนาร่วมสมัยมาสู่โลกของการเขียนโปรแกรมระดับระบบ:
- Cargo ตัวจัดการดีเพนเดนซีและเครื่องมือบิลด์ที่ติดตั้งมาพร้อมกับ Rust ช่วยให้การเพิ่ม คอมไพล์ และจัดการดีเพนเดนซีเป็นไปอย่างง่ายดายและเป็นมาตรฐานเดียวกันทั่วทั้งระบบนิเวศของ Rust
- เครื่องมือจัดรูปแบบโค้ด
rustfmtช่วยดูแลให้สไตล์การเขียนโค้ดเป็นรูปแบบเดียวกันเสมอในทีมนักพัฒนา - Rust Language Server ช่วยขับเคลื่อนการทำงานร่วมกับโปรแกรมแก้ไขโค้ดและสภาพแวดล้อมการพัฒนาแบบบูรณาการ (IDE) ทั้งการเติมโค้ดอัตโนมัติและการแสดงข้อผิดพลาดแบบอินไลน์
ด้วยการผสานเครื่องมือเหล่านี้และเครื่องมืออื่นๆ ในระบบนิเวศของ Rust นักพัฒนาจึงสามารถทำงานได้อย่างมีประสิทธิภาพสูงสุดแม้จะเขียนโค้ดระดับระบบก็ตาม
นักเรียนและนักศึกษา
Rust เหมาะสำหรับนักเรียน นักศึกษา และผู้ที่สนใจศึกษาแนวคิดเชิงลึกเกี่ยวกับระบบ หลายคนใช้ Rust ในการศึกษาหัวข้ออย่างการพัฒนาระบบปฏิบัติการ ชุมชน Rust ยินดีต้อนรับและพร้อมให้คำแนะนำแก่นักเรียนนักศึกษาเสมอ ทีมงาน Rust มุ่งหวังที่จะทำให้แนวคิดเชิงระบบเข้าถึงผู้คนได้ง่ายขึ้นผ่านสื่อการเรียนรู้อย่างหนังสือเล่มนี้ โดยเฉพาะอย่างยิ่งสำหรับผู้ที่เพิ่งเริ่มต้นก้าวสู่วงการเขียนโปรแกรม
องค์กรและภาคธุรกิจ
บริษัทหลายร้อยแห่งทั้งขนาดเล็กและใหญ่ต่างนำ Rust ไปใช้งานจริงในโปรดักชันสำหรับงานหลากหลายประเภท ไม่ว่าจะเป็นเครื่องมือบรรทัดคำสั่ง บริการเว็บ เครื่องมือ DevOps ระบบฝังตัว (embedded devices) การวิเคราะห์และแปลงรหัสเสียงและวิดีโอ สกุลเงินดิจิทัล ชีวสารสนเทศศาสตร์ เครื่องมือค้นหา แอปพลิเคชันอินเทอร์เน็ตของสรรพสิ่ง (IoT) การเรียนรู้ของเครื่อง (machine learning) และแม้กระทั่งส่วนประกอบหลักของเว็บเบราว์เซอร์ Firefox
นักพัฒนาโอเพนซอร์ส
Rust เหมาะสำหรับผู้ที่ต้องการร่วมสร้างและพัฒนาภาษา Rust ชุมชน เครื่องมือนักพัฒนา ตลอดจนไลบรารีต่างๆ เรายินดีเป็นอย่างยิ่งหากคุณจะมาร่วมเป็นส่วนหนึ่งในการมีส่วนร่วมกับภาษา Rust
ผู้ที่ต้องการความเร็วและความเสถียร
Rust เหมาะสำหรับผู้ที่ต้องการทั้งความเร็วและความเสถียรจากภาษาโปรแกรม โดยคำว่าความเร็วในที่นี้ หมายถึงทั้งความเร็วในการประมวลผลโค้ดของ Rust และความเร็วที่ Rust ช่วยให้คุณพัฒนาโปรแกรมได้สำเร็จ การตรวจสอบของคอมไพเลอร์ Rust ช่วยรักษาเสถียรภาพของระบบไว้ได้อย่างมั่นคง แม้จะมีการเพิ่มฟีเจอร์ใหม่หรือทำการรีแฟกเตอร์โค้ด ซึ่งแตกต่างจากโค้ดระบบเก่าที่เปราะบางในภาษาที่ขาดระบบตรวจสอบเหล่านี้ จนทำให้นักพัฒนามักไม่กล้าแตะต้องแก้ไข ด้วยเป้าหมายสู่การจัดการนามธรรมแบบไร้ต้นทุนโสหุ้ย (zero-cost abstractions) ซึ่งเป็นการนำฟีเจอร์ระดับสูงมาใช้งานโดยคอมไพล์ออกมาเป็นโค้ดระดับล่างที่ทำงานได้รวดเร็วเทียบเท่าโค้ดที่เขียนปรับแต่งด้วยมือ Rust จึงมุ่งมั่นทำให้โค้ดที่ปลอดภัยเป็นโค้ดที่เร็วควบคู่กันไปด้วย
ภาษา Rust ยังพร้อมสนับสนุนผู้ใช้กลุ่มอื่นๆ อีกมากมาย โดยกลุ่มที่กล่าวถึงข้างต้นเป็นเพียงตัวแทนส่วนหนึ่งเท่านั้น ความมุ่งหวังสูงสุดของ Rust คือการก้าวข้ามข้อแลกเปลี่ยนที่โปรแกรมเมอร์ยอมรับกันมานานหลายทศวรรษ ด้วยการมอบทั้งความปลอดภัย และ ประสิทธิภาพการทำงาน ความเร็ว และ ความสะดวกสบายในการพัฒนา ลองสัมผัส Rust ดู แล้วคุณจะพบว่าแนวทางของภาษานี้ตอบโจทย์คุณหรือไม่
หนังสือเล่มนี้เหมาะกับใคร
หนังสือเล่มนี้เขียนขึ้นโดยสมมติว่าคุณเคยเขียนโค้ดภาษาใดภาษาหนึ่งมาก่อน แต่ไม่ได้จำกัดว่าต้องเป็นภาษาใด เราพยายามเรียบเรียงเนื้อหาให้ครอบคลุมและเข้าถึงง่ายสำหรับผู้ที่มีพื้นฐานการเขียนโปรแกรมที่หลากหลาย เราไม่ได้ใช้เวลาอธิบายว่าการเขียนโปรแกรม คืออะไร หรือมีหลักคิดพื้นฐานอย่างไร หากคุณเพิ่งเริ่มต้นเรียนรู้การเขียนโปรแกรมเป็นครั้งแรก การเริ่มต้นด้วยหนังสือที่ปูพื้นฐานการเขียนโปรแกรมโดยตรงจะช่วยให้คุณเข้าใจได้ดียิ่งขึ้น
วิธีใช้หนังสือเล่มนี้
โดยทั่วไป แนะนำให้อ่านหนังสือเล่มนี้เรียงลำดับตั้งแต่บทแรกไปจนจบ เนื่องจากบทหลังๆ จะต่อยอดจากแนวคิดในบทก่อนหน้า และบางหัวข้อในบทแรกๆ อาจยังไม่ได้ลงลึกในรายละเอียดทันที แต่จะย้อนกลับมาเจาะลึกอีกครั้งในบทต่อๆ ไป
คุณจะพบบทเรียน 2 รูปแบบในหนังสือเล่มนี้ ได้แก่ บทเชิงแนวคิด และบทเชิงโปรเจกต์ ในบทเชิงแนวคิด คุณจะได้เรียนรู้แง่มุมต่างๆ ของ Rust ส่วนในบทเชิงโปรเจกต์ เราจะลงมือสร้างโปรแกรมเล็กๆ ไปพร้อมกันเพื่อนำความรู้ที่ได้เรียนมาประยุกต์ใช้ โดยบทที่ 2, บทที่ 12 และบทที่ 21 เป็นบทเชิงโปรเจกต์ ส่วนบทที่เหลือจะเป็นบทเชิงแนวคิด
บทที่ 1 อธิบายขั้นตอนการติดตั้ง Rust วิธีเขียนโปรแกรม “Hello, world!” ตลอดจนวิธีใช้ Cargo ซึ่งเป็นตัวจัดการแพ็กเกจและเครื่องมือบิลด์ของ Rust บทที่ 2 เป็นการปูพื้นฐานการเขียนโปรแกรม Rust ผ่านการลงมือปฏิบัติจริง โดยสร้างโปรเจกต์เกมทายตัวเลข ซึ่งจะช่วยให้เห็นภาพรวมของแนวคิดต่างๆ ก่อนที่บทต่อๆ ไปจะลงรายละเอียดเพิ่มเติม หากคุณชื่นชอบการลงมือทำจริงทันที บทที่ 2 คือจุดเริ่มต้นที่เหมาะอย่างยิ่ง แต่หากคุณเป็นผู้ที่ชอบศึกษาทุกรายละเอียดให้แจ่มแจ้งก่อนไปต่อ คุณสามารถข้ามบทที่ 2 ไปเริ่มที่ บทที่ 3 ซึ่งครอบคลุมฟีเจอร์พื้นฐานของ Rust ที่คล้ายคลึงกับภาษาโปรแกรมทั่วไป แล้วจึงค่อยย้อนกลับมาทำโปรเจกต์ในบทที่ 2 เมื่อต้องการนำรายละเอียดที่ได้เรียนรู้มาฝึกฝน
ในบทที่ 4 คุณจะได้เรียนรู้ระบบสิทธิ์ความเป็นเจ้าของ (ownership) ซึ่งเป็นหัวใจสำคัญของ Rust บทที่ 5 อธิบาย struct และเมธอด บทที่ 6 ครอบคลุม enum, นิพจน์ match ตลอดจนโครงสร้างควบคุมทิศทางการทำงาน if let และ let...else เพื่อใช้ struct และ enum ในการสร้างชนิดข้อมูลที่กำหนดขึ้นเอง
ในบทที่ 7 คุณจะได้เรียนรู้ระบบมอดูลของ Rust และกฎความเป็นส่วนตัวเพื่อจัดระเบียบโค้ดและส่วนต่อประสานโปรแกรมประยุกต์ (API) สาธารณะ บทที่ 8 อธิบายโครงสร้างข้อมูลแบบคอลเลกชันทั่วไปที่ไลบรารีมาตรฐานจัดเตรียมไว้ให้ ได้แก่ เวกเตอร์ สตริง และแฮชแมป บทที่ 9 สำรวจปรัชญาและเทคนิคการจัดการข้อผิดพลาดใน Rust
บทที่ 10 เจาะลึกเจเนอริก เทรต และไลฟ์ไทม์ ซึ่งช่วยให้คุณเขียนโค้ดที่ยืดหยุ่นและรองรับชนิดข้อมูลได้หลากหลาย บทที่ 11 มุ่งเน้นเรื่องการทดสอบอย่างครบวงจร ซึ่งแม้ Rust จะรับประกันความปลอดภัยของหน่วยความจำ แต่การทดสอบก็ยังจำเป็นเพื่อยืนยันความถูกต้องของตรรกะในโปรแกรม ในบทที่ 12 เราจะร่วมกันสร้างเครื่องมือค้นหาข้อความในไฟล์ โดยจำลองฟังก์ชันการทำงานบางส่วนของเครื่องมือบรรทัดคำสั่ง grep ซึ่งจะได้นำแนวคิดจากบทก่อนๆ มาประยุกต์ใช้อย่างเต็มที่
บทที่ 13 สำรวจโคลเชอร์และอิเทอเรเตอร์ ซึ่งเป็นฟีเจอร์ทรงพลังของ Rust ที่ได้รับแรงบันดาลใจจากภาษาเชิงฟังก์ชัน ในบทที่ 14 เราจะเจาะลึก Cargo มากยิ่งขึ้น พร้อมแนะนำแนวปฏิบัติที่ดีที่สุดในการแบ่งปันไลบรารีของคุณให้ผู้อื่นใช้งาน บทที่ 15 อธิบายสมาร์ตพอยน์เตอร์ในไลบรารีมาตรฐานและเทรตที่ช่วยขับเคลื่อนความสามารถของสมาร์ตพอยน์เตอร์เหล่านั้น
ในบทที่ 16 เราจะพาคุณสำรวจรูปแบบต่างๆ ของการเขียนโปรแกรมแบบทำงานพร้อมกัน (concurrency) และวิธีที่ Rust ช่วยให้คุณพัฒนาโปรแกรมแบบมัลติเธรดได้อย่างมั่นใจไร้กังวล ในบทที่ 17 เราจะต่อยอดด้วยการสำรวจไวยากรณ์ async และ await ของ Rust พร้อมทั้งทาสก์ ฟิวเจอร์ สตรีม ตลอดจนโมเดลการทำงานพร้อมกันแบบประหยัดทรัพยากร (lightweight concurrency)
บทที่ 18 เปรียบเทียบสำนวนของ Rust กับหลักการเขียนโปรแกรมเชิงวัตถุที่คุณอาจคุ้นเคย บทที่ 19 เป็นคู่มืออ้างอิงเกี่ยวกับรูปแบบและการจับคู่รูปแบบ (patterns and pattern matching) ซึ่งเป็นวิธีอันทรงพลังในการถ่ายทอดแนวคิดทั่วทั้งโปรแกรม Rust บทที่ 20 รวบรวมหัวข้อขั้นสูงที่น่าสนใจมากมาย ไม่ว่าจะเป็น unsafe Rust, มาโคร รวมถึงเนื้อหาเชิงลึกเกี่ยวกับไลฟ์ไทม์ เทรต ชนิดข้อมูล ฟังก์ชัน และโคลเชอร์
ในบทที่ 21 เราจะลงมือทำโปรเจกต์ส่งท้าย โดยร่วมกันพัฒนาเว็บเซิร์ฟเวอร์แบบมัลติเธรดระดับล่างด้วยตนเอง!
สุดท้ายนี้ ส่วนภาคผนวกได้รวบรวมข้อมูลที่เป็นประโยชน์เกี่ยวกับภาษาไว้ในรูปแบบเอกสารอ้างอิง ได้แก่ ภาคผนวก A รวบรวมคำสงวนของ Rust, ภาคผนวก B รวบรวมตัวดำเนินการและสัญลักษณ์, ภาคผนวก C อธิบายเทรตที่ derive ได้ในไลบรารีมาตรฐาน, ภาคผนวก D แนะนำเครื่องมือพัฒนาที่มีประโยชน์ และภาคผนวก E อธิบายฉบับต่างๆ ของ Rust (editions) ส่วนในภาคผนวก F คุณจะพบข้อมูลฉบับแปลของหนังสือเล่มนี้ และในภาคผนวก G จะอธิบายกระบวนการพัฒนาภาษา Rust และทำความรู้จักกับ nightly Rust
ไม่มีวิธีใดที่ผิดในการอ่านหนังสือเล่มนี้: หากคุณต้องการข้ามไปอ่านบทที่สนใจก่อน ก็สามารถทำได้ทันที! คุณอาจเพียงแค่ต้องย้อนกลับมาเปิดดูบทก่อนหน้าเมื่อพบประเด็นที่สงสัย เลือกแนวทางที่เหมาะสมกับตัวคุณที่สุดได้เลย
สิ่งสำคัญอย่างยิ่งในการเรียนรู้ภาษา Rust คือการฝึกอ่านข้อความแจ้งข้อผิดพลาดที่คอมไพเลอร์แสดงออกมา เพราะข้อความเหล่านี้คือเข็มทิศนำทางคุณไปสู่โค้ดที่ถูกต้องและทำงานได้จริง ด้วยเหตุนี้ เราจึงได้เตรียมตัวอย่างโค้ดที่คอมไพล์ไม่ผ่านไว้มากมาย พร้อมข้อความข้อผิดพลาดที่คอมไพเลอร์จะแสดงในแต่ละสถานการณ์ โปรดทราบว่า หากคุณทดลองพิมพ์และรันตัวอย่างบางอัน ตัวอย่างนั้นอาจคอมไพล์ไม่ผ่านโดยตั้งใจ! อย่าลืมอ่านคำอธิบายประกอบรอบๆ ตัวอย่างเพื่อดูว่าโค้ดนั้นมีเจตนาให้เกิดข้อผิดพลาดหรือไม่ ซึ่งในเกือบทุกกรณี เราจะแนะนำโค้ดเวอร์ชันที่ถูกต้องตามมาเสมอ นอกจากนี้ เจ้าปู Ferris ยังจะช่วยส่งสัญญาณบอกใบ้เกี่ยวกับพฤติกรรมของโค้ดให้คุณสังเกตได้ง่ายขึ้น:
| Ferris | ความหมาย |
|---|---|
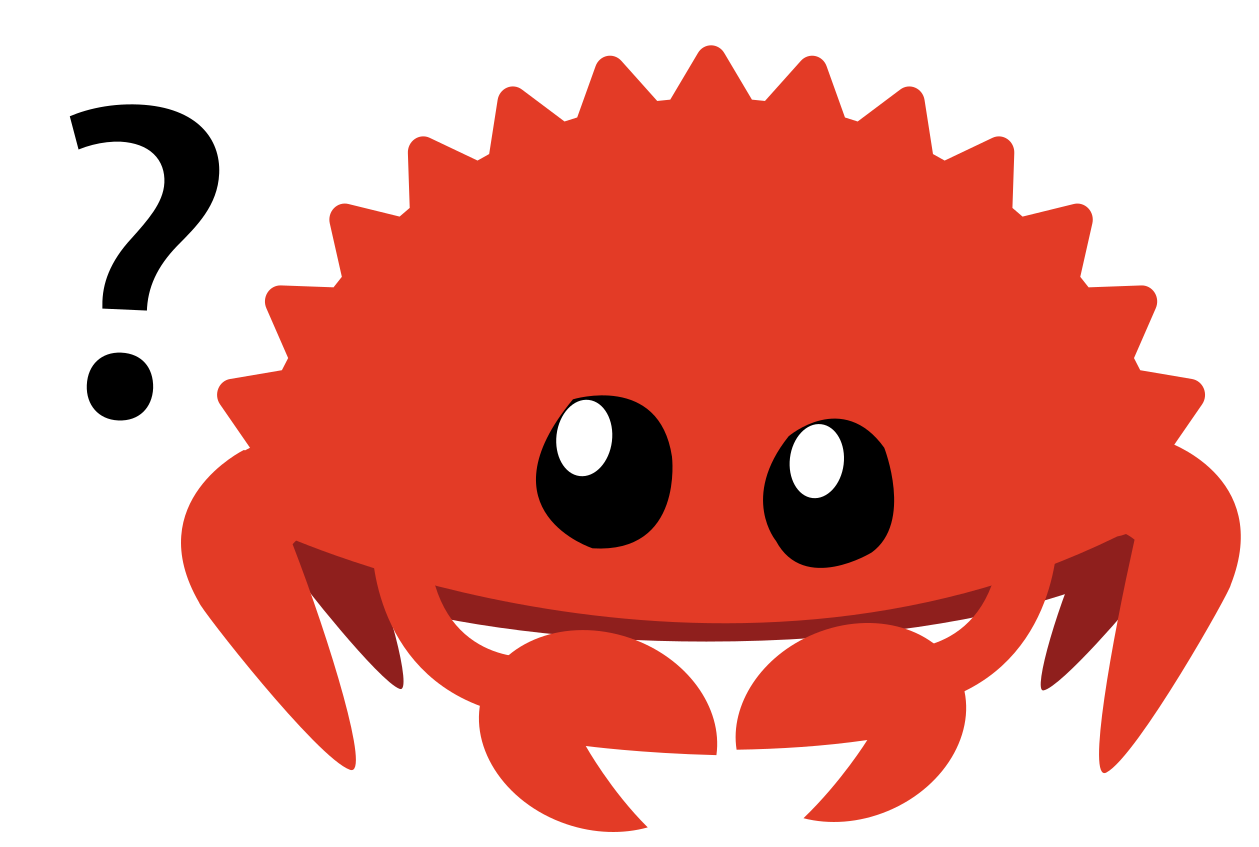 | โค้ดนี้คอมไพล์ไม่ผ่าน! |
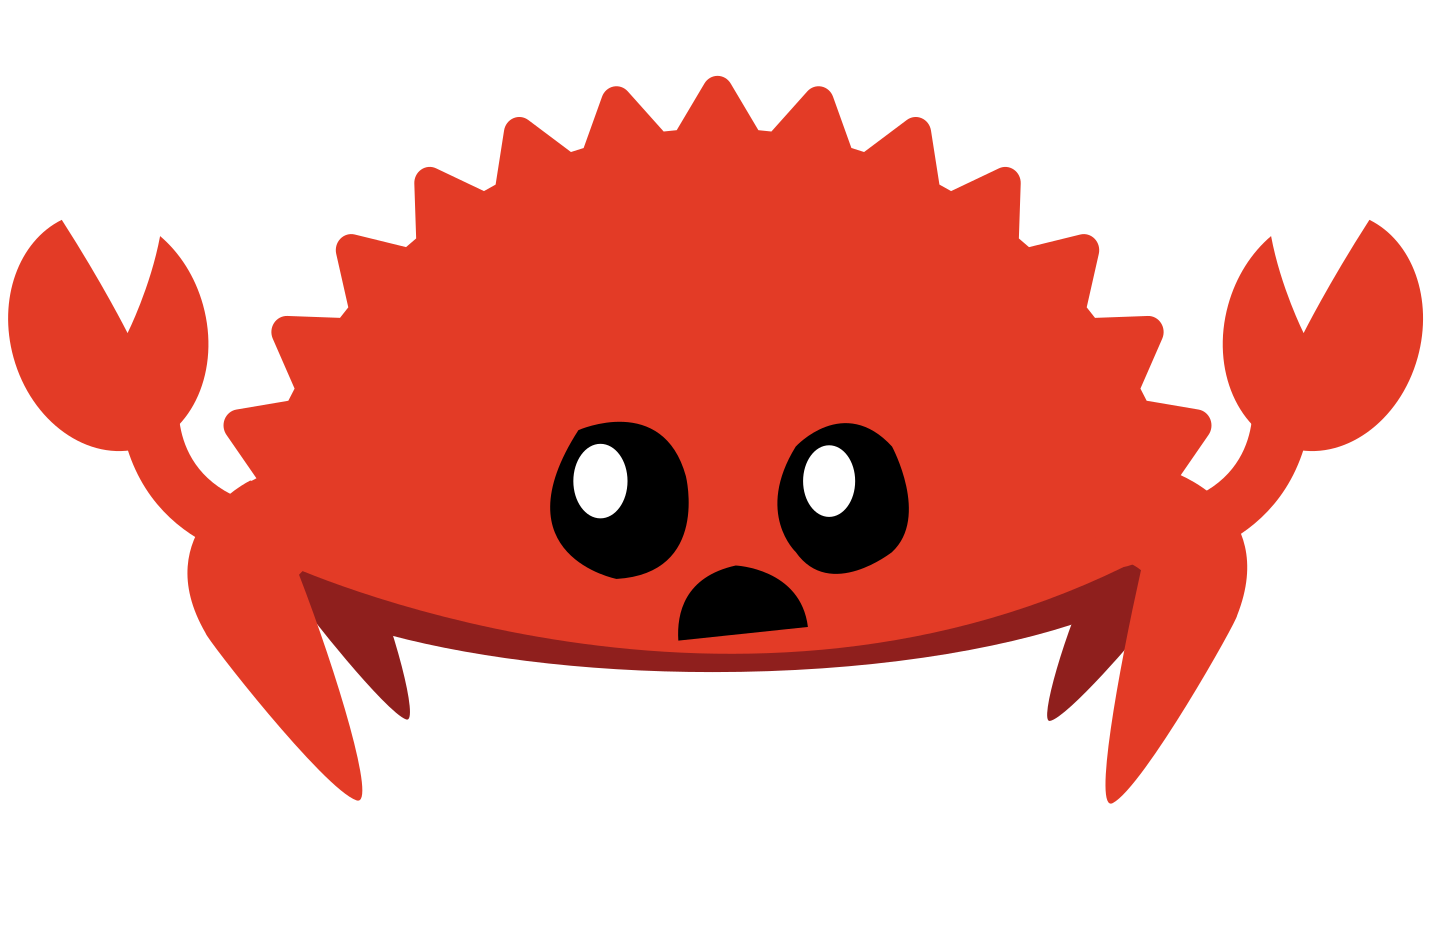 | โค้ดนี้เกิดการแพนิก (panic)! |
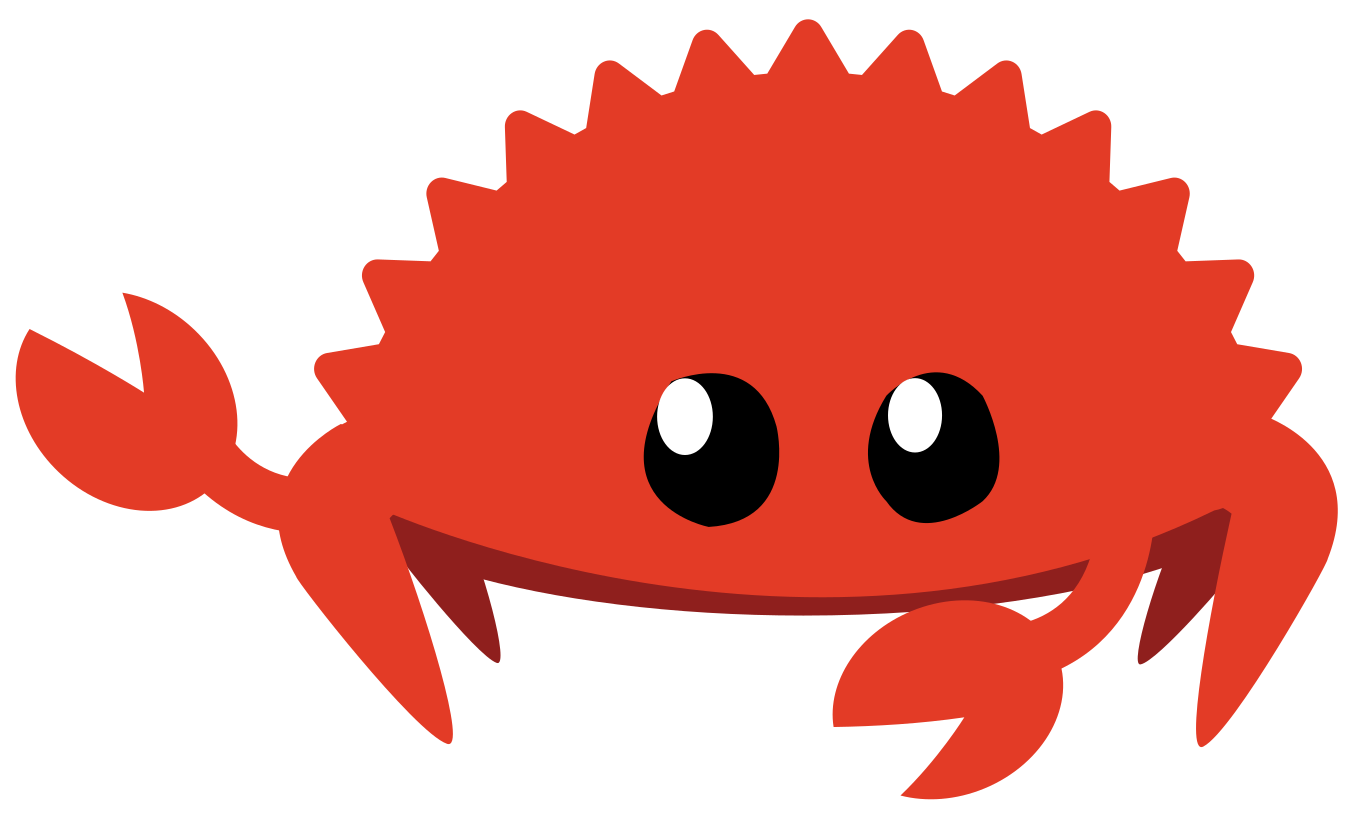 | โค้ดนี้ไม่ทำงานตามพฤติกรรมที่คาดหวัง |
ในสถานการณ์ส่วนใหญ่ เราจะพาคุณไปสู่โค้ดเวอร์ชันที่ถูกต้องของทุกตัวอย่างที่คอมไพล์ไม่ผ่าน
ซอร์สโค้ด
ไฟล์ต้นฉบับที่ใช้สร้างหนังสือเล่มนี้สามารถดูได้ที่ GitHub
เริ่มต้นใช้งาน
มาเริ่มต้นการเดินทางสู่โลกของ Rust กันเลย! ยังมีสิ่งใหม่ๆ ให้เรียนรู้อีกมากมาย แต่ทุกการเดินทางย่อมมีจุดเริ่มต้นเสมอ ในบทนี้ เราจะเรียนรู้เกี่ยวกับ:
- การติดตั้ง Rust บน Linux, macOS และ Windows
- การเขียนโปรแกรมแสดงข้อความ
Hello, world! - การใช้งาน
cargoตัวจัดการแพ็กเกจและระบบบิลด์ของ Rust
การติดตั้ง
การติดตั้ง
ขั้นตอนแรกคือการติดตั้ง Rust เราจะดาวน์โหลด Rust ผ่าน rustup ซึ่งเป็นเครื่องมือบรรทัดคำสั่งสำหรับจัดการเวอร์ชันของ Rust และเครื่องมือที่เกี่ยวข้อง คุณจะต้องเชื่อมต่ออินเทอร์เน็ตสำหรับการดาวน์โหลดนี้
หมายเหตุ: หากคุณไม่สะดวกใช้
rustupด้วยเหตุผลบางประการ สามารถดูช่องทางเลือกเพิ่มเติมได้ที่หน้าวิธีการติดตั้ง Rust แบบอื่นๆ
ขั้นตอนต่อไปนี้จะติดตั้งคอมไพเลอร์ Rust เวอร์ชันเสถียร (stable) ล่าสุด ซึ่งการรับประกันความเสถียรของ Rust ทำให้มั่นใจได้ว่าตัวอย่างโค้ดทั้งหมดในหนังสือที่คอมไพล์ผ่าน จะยังคงคอมไพล์ผ่านกับ Rust เวอร์ชันใหม่กว่าในอนาคตได้อย่างแน่นอน ทั้งนี้ ข้อความเอาต์พุตอาจแตกต่างไปบ้างเล็กน้อยระหว่างแต่ละเวอร์ชัน เนื่องจาก Rust มีการปรับปรุงข้อความแจ้งข้อผิดพลาดและคำเตือนให้ชัดเจนขึ้นอยู่เสมอ กล่าวคือ ไม่ว่าคุณจะติดตั้ง Rust เวอร์ชันเสถียรรุ่นใหม่ใดก็ตามตามขั้นตอนนี้ โค้ดตัวอย่างในหนังสือเล่มนี้จะยังคงทำงานได้ถูกต้องตามที่คาดหวัง
สัญกรณ์บรรทัดคำสั่ง
ในบทนี้และตลอดทั้งเล่ม เราจะแสดงคำสั่งที่ใช้ในเทอร์มินัล โดยบรรทัดที่คุณต้องพิมพ์ลงในเทอร์มินัลจะขึ้นต้นด้วย
$เสมอ ซึ่งคุณไม่จำเป็นต้องพิมพ์เครื่องหมาย$ตาม เพราะเป็นเพียงสัญลักษณ์พรอมต์บรรทัดคำสั่งที่บอกจุดเริ่มต้นของแต่ละคำสั่ง ส่วนบรรทัดที่ไม่ขึ้นต้นด้วย$จะแสดงผลลัพธ์ (output) จากคำสั่งก่อนหน้า นอกจากนี้ ในตัวอย่างคำสั่งเฉพาะของ PowerShell จะใช้เครื่องหมาย>แทน$
การติดตั้ง rustup บน Linux หรือ macOS
หากคุณใช้งาน Linux หรือ macOS ให้เปิดเทอร์มินัลแล้วป้อนคำสั่งต่อไปนี้:
$ curl --proto '=https' --tlsv1.2 https://sh.rustup.rs -sSf | sh
คำสั่งนี้จะดาวน์โหลดสคริปต์และเริ่มการติดตั้งเครื่องมือ rustup ซึ่งจะทำการติดตั้ง Rust เวอร์ชันเสถียรล่าสุดให้โดยอัตโนมัติ คุณอาจต้องป้อนรหัสผ่านของผู้ดูแลระบบในระหว่างนี้ และเมื่อติดตั้งสำเร็จ จะมีข้อความต่อไปนี้ปรากฏขึ้น:
Rust is installed now. Great!
คุณจำเป็นต้องมี ตัวเชื่อมโยง (linker) ซึ่งเป็นโปรแกรมที่ Rust ใช้รวมผลลัพธ์ที่คอมไพล์แล้วเข้าด้วยกันเป็นไฟล์เดียว โดยทั่วไปในเครื่องของคุณมักจะมีโปรแกรมนี้ติดตั้งอยู่แล้ว แต่หากพบข้อผิดพลาดเกี่ยวกับตัวเชื่อมโยง คุณควรติดตั้งคอมไพเลอร์ภาษา C เพิ่มเติม ซึ่งโดยปกติจะมาพร้อมกับตัวเชื่อมโยง นอกจากนี้ คอมไพเลอร์ภาษา C ยังมีประโยชน์อย่างยิ่ง เพราะแพ็กเกจ Rust ยอดนิยมบางตัวจำเป็นต้องพึ่งพาโค้ดภาษา C ในการทำงาน
บน macOS คุณสามารถติดตั้งคอมไพเลอร์ C ได้ง่ายๆ โดยรันคำสั่ง:
$ xcode-select --install
สำหรับผู้ใช้ Linux โดยทั่วไปแนะนำให้ติดตั้ง GCC หรือ Clang ตามคู่มือของดิสทริบิวชันที่ใช้งาน ตัวอย่างเช่น หากคุณใช้ Ubuntu สามารถติดตั้งแพ็กเกจ build-essential ได้ทันที
การติดตั้ง rustup บน Windows
บน Windows ให้เข้าไปที่ https://www.rust-lang.org/tools/install แล้วปฏิบัติตามคำแนะนำในการติดตั้ง Rust โดยในระหว่างขั้นตอนการติดตั้ง ระบบจะแนะนำให้คุณติดตั้ง Visual Studio ซึ่งจะช่วยจัดเตรียมตัวเชื่อมโยง (linker) และไลบรารีเนทีฟที่จำเป็นสำหรับการคอมไพล์โปรแกรม หากต้องการคำแนะนำเพิ่มเติมสำหรับขั้นตอนนี้ สามารถดูได้ที่ https://rust-lang.github.io/rustup/installation/windows-msvc.html
เนื้อหาในส่วนที่เหลือของหนังสือเล่มนี้จะใช้คำสั่งที่รองรับทั้งใน cmd.exe และ PowerShell หากมีจุดที่แตกต่างกันอย่างชัดเจน เราจะระบุไว้อย่างเจาะจงว่าควรใช้คำสั่งใด
การแก้ปัญหา
หากต้องการตรวจสอบว่าคุณติดตั้ง Rust ถูกต้องเรียบร้อยหรือไม่ ให้เปิดเทอร์มินัลแล้วป้อนคำสั่งนี้:
$ rustc --version
คุณควรจะเห็นหมายเลขเวอร์ชัน แฮชของคอมมิต และวันที่คอมมิตของเวอร์ชันเสถียรล่าสุดที่เผยแพร่ ในรูปแบบดังต่อไปนี้:
rustc x.y.z (abcabcabc yyyy-mm-dd)
หากเห็นข้อความในรูปแบบนี้ แสดงว่าคุณติดตั้ง Rust สำเร็จเรียบร้อยแล้ว! แต่หากไม่พบข้อความดังกล่าว ให้ตรวจสอบว่าพาธของ Rust ถูกเพิ่มลงในตัวแปรระบบ %PATH% แล้วหรือไม่ ดังนี้:
ใน Windows CMD ให้ใช้:
> echo %PATH%
ใน PowerShell ให้ใช้:
> echo $env:Path
ใน Linux และ macOS ให้ใช้:
$ echo $PATH
หากตรวจสอบทุกอย่างแล้วแต่ยังพบปัญหาในการใช้งาน Rust คุณสามารถขอความช่วยเหลือได้จากหลากหลายช่องทาง ดูวิธีติดต่อกับเพื่อนๆ ชาว Rustacean (ชื่อเล่นน่ารักๆ ที่เราใช้เรียกกลุ่มคนรัก Rust) ได้ที่หน้าชุมชน
การอัปเดตและการถอนการติดตั้ง
เมื่อติดตั้ง Rust ผ่าน rustup แล้ว การอัปเดตเป็นเวอร์ชันล่าสุดก็สามารถทำได้อย่างง่ายดาย เพียงเปิดเทอร์มินัลแล้วรันคำสั่งอัปเดตต่อไปนี้:
$ rustup update
หากต้องการถอนการติดตั้ง Rust และ rustup ให้รันคำสั่งต่อไปนี้ในเทอร์มินัล:
$ rustup self uninstall
การอ่านเอกสารในเครื่อง
การติดตั้ง Rust ยังได้รวมชุดเอกสารคู่มือไว้ในเครื่องของคุณด้วย เพื่อให้คุณสามารถเปิดอ่านแบบออฟไลน์ได้ทุกเมื่อ เพียงรันคำสั่ง rustup doc ระบบจะเปิดเอกสารคู่มือในเครื่องขึ้นมาบนเว็บเบราว์เซอร์ของคุณทันที
เมื่อใดก็ตามที่คุณพบชนิดข้อมูลหรือฟังก์ชันจากไลบรารีมาตรฐาน และต้องการทราบการทำงานหรือวิธีนำไปใช้งาน สามารถเปิดดูได้จากเอกสารส่วนต่อประสานโปรแกรมประยุกต์ (API) เพื่อหาคำตอบได้เสมอ!
การใช้โปรแกรมแก้ไขข้อความและ IDE
หนังสือเล่มนี้ไม่ได้จำกัดว่าคุณจะต้องใช้เครื่องมือหรือโปรแกรมแก้ไขโค้ดใด คุณสามารถใช้โปรแกรมแก้ไขข้อความตัวใดก็ได้ตามความถนัด! อย่างไรก็ดี โปรแกรมแก้ไขข้อความและสภาพแวดล้อมการพัฒนาแบบบูรณาการ (IDE) ยอดนิยมหลายตัวต่างรองรับภาษา Rust ในตัว สามารถตรวจสอบรายชื่อโปรแกรมแก้ไขข้อความและ IDE ที่แนะนำในปัจจุบันได้ที่หน้าเครื่องมือบนเว็บไซต์ของ Rust
การทำงานแบบออฟไลน์กับหนังสือเล่มนี้
ในหลายๆ ตัวอย่าง เราจะมีการนำแพ็กเกจนอกไลบรารีมาตรฐานมาใช้งาน ซึ่งจำเป็นต้องเชื่อมต่ออินเทอร์เน็ตหรือดาวน์โหลดแพ็กเกจที่ต้องพึ่งพา (dependencies) เตรียมไว้ล่วงหน้า หากต้องการดาวน์โหลดไว้ล่วงหน้า สามารถรันคำสั่งต่อไปนี้ (เราจะอธิบายรายละเอียดว่า cargo คืออะไรและแต่ละคำสั่งทำงานอย่างไรในภายหลัง):
$ cargo new get-dependencies
$ cd get-dependencies
$ cargo add rand@0.10.1 trpl@0.2.0
คำสั่งนี้จะดาวน์โหลดและแคชแพ็กเกจเหล่านี้ไว้ในเครื่อง เพื่อให้คุณไม่ต้องดาวน์โหลดซ้ำอีกในภายหลัง เมื่อรันคำสั่งเสร็จเรียบร้อยแล้ว คุณสามารถลบโฟลเดอร์ get-dependencies ทิ้งได้ทันที และหลังจากนี้ คุณสามารถเพิ่มแฟล็ก --offline ต่อท้ายคำสั่ง cargo ในตัวอย่างอื่นๆ ของหนังสือ เพื่อทำงานแบบออฟไลน์ได้โดยไม่ต้องเชื่อมต่ออินเทอร์เน็ต
Hello, World!
Hello, World!
หลังจากที่คุณติดตั้ง Rust เรียบร้อยแล้ว ก็ถึงเวลาเขียนโปรแกรมแรกของคุณ เป็นธรรมเนียมปฏิบัติสากลเมื่อเริ่มต้นเรียนรู้ภาษาใหม่ที่จะเขียนโปรแกรมเล็กๆ เพื่อพิมพ์ข้อความ Hello, world! ออกทางหน้าจอ ซึ่งเราจะทำเช่นเดียวกันนี้ในบทเรียนนี้!
หมายเหตุ: หนังสือเล่มนี้เขียนขึ้นโดยสมมติว่าคุณคุ้นเคยกับบรรทัดคำสั่ง (command line) มาบ้างแล้ว ทั้งนี้ Rust ไม่ได้จำกัดว่าคุณต้องใช้โปรแกรมแก้ไขโค้ด เครื่องมือ หรือจัดเก็บโค้ดไว้ที่ใด ดังนั้นหากคุณถนัดใช้ IDE มากกว่าบรรทัดคำสั่ง คุณสามารถเลือกใช้ IDE ที่คุณชื่นชอบได้ตามสะดวก ปัจจุบัน IDE หลายตัวต่างรองรับภาษา Rust เป็นอย่างดี สามารถดูรายละเอียดเพิ่มเติมได้จากคู่มือของ IDE นั้นๆ นอกจากนี้ ทีมงาน Rust ยังมุ่งมั่นพัฒนาการสนับสนุน IDE ชั้นยอดผ่าน
rust-analyzerอีกด้วย สามารถดูรายละเอียดเพิ่มเติมได้ที่ภาคผนวก D
การตั้งค่าไดเรกทอรีโปรเจกต์
เริ่มต้นด้วยการสร้างไดเรกทอรีสำหรับจัดเก็บโค้ด Rust ของคุณ โดยปกติแล้ว Rust ไม่ได้จำกัดว่าคุณต้องเก็บโค้ดไว้ที่ใด แต่สำหรับแบบฝึกหัดและโปรเจกต์ต่างๆ ในหนังสือเล่มนี้ เราแนะนำให้สร้างไดเรกทอรี projects ไว้ในไดเรกทอรีโฮม (home directory) ของคุณ เพื่อรวบรวมโปรเจกต์ทั้งหมดไว้ในที่เดียวกัน
เปิดเทอร์มินัลแล้วป้อนคำสั่งต่อไปนี้เพื่อสร้างไดเรกทอรี projects และสร้างไดเรกทอรีสำหรับโปรเจกต์ “Hello, world!” ไว้ข้างใน
สำหรับ Linux, macOS และ PowerShell บน Windows ให้ป้อนคำสั่งดังนี้:
$ mkdir ~/projects
$ cd ~/projects
$ mkdir hello_world
$ cd hello_world
สำหรับ Windows CMD ให้ป้อนคำสั่งดังนี้:
> mkdir "%USERPROFILE%\projects"
> cd /d "%USERPROFILE%\projects"
> mkdir hello_world
> cd hello_world
พื้นฐานของโปรแกรม Rust
ขั้นต่อไป ให้สร้างไฟล์ซอร์สโค้ดใหม่ชื่อว่า main.rs ไฟล์ของ Rust จะลงท้ายด้วยนามสกุล .rs เสมอ หากชื่อไฟล์ของคุณประกอบด้วยคำมากกว่าหนึ่งคำ ธรรมเนียมปฏิบัติคือให้ใช้เครื่องหมายขีดล่าง (underscore) คั่นระหว่างคำ เช่น ใช้ hello_world.rs แทนที่จะเป็น helloworld.rs
เปิดไฟล์ main.rs ที่เพิ่งสร้างขึ้นมา แล้วป้อนโค้ดตามลิสติ้ง 1-1
fn main() {
    println!("Hello, world!");
}
บันทึกไฟล์ให้เรียบร้อย แล้วสลับกลับมาที่หน้าต่างเทอร์มินัลในไดเรกทอรี ~/projects/hello_world บน Linux หรือ macOS ให้ป้อนคำสั่งต่อไปนี้เพื่อคอมไพล์และรันโปรแกรม:
$ rustc main.rs
$ ./main
Hello, world!
บน Windows ให้ป้อนคำสั่ง .\main แทน ./main:
> rustc main.rs
> .\main
Hello, world!
ไม่ว่าคุณจะใช้ระบบปฏิบัติการใด ข้อความสตริง Hello, world! ควรจะปรากฏขึ้นบนเทอร์มินัล หากคุณไม่เห็นผลลัพธ์นี้ ให้ย้อนกลับไปดูที่หัวข้อย่อย “การแก้ปัญหา” ในขั้นตอนการติดตั้ง เพื่อตรวจหาวิธีแก้ไขปัญหา
หากมีข้อความ Hello, world! แสดงขึ้นมา ขอแสดงความยินดีด้วย! คุณได้เขียนโปรแกรม Rust อย่างเป็นทางการสำเร็จแล้ว และนั่นทำให้คุณก้าวสู่การเป็นโปรแกรมเมอร์ Rust แล้ว—ยินดีต้อนรับ!
โครงสร้างของโปรแกรม Rust
มาพิจารณารายละเอียดของโปรแกรม “Hello, world!” นี้อย่างเจาะลึกกัน นี่คือจิ๊กซอว์ชิ้นแรก:
fn main() {

}
บรรทัดเหล่านี้ทำหน้าที่กำหนดฟังก์ชันชื่อ main ฟังก์ชัน main มีความพิเศษอย่างยิ่ง เพราะเป็นโค้ดจุดแรกสุดที่จะเริ่มทำงานในทุกโปรแกรมของ Rust ที่รันได้ ในที่นี้ บรรทัดแรกประกาศฟังก์ชันชื่อ main ซึ่งไม่มีพารามิเตอร์และไม่ส่งค่าใดๆ กลับมา หากฟังก์ชันมีพารามิเตอร์ พารามิเตอร์เหล่านั้นจะถูกระบุไว้ภายในวงเล็บ (())
บล็อกเนื้อหาของฟังก์ชันจะอยู่ภายในเครื่องหมายปีกกา {} โดย Rust กำหนดให้บล็อกเนื้อหาของฟังก์ชันทุกตัวต้องอยู่ในวงเล็บปีกกาเสมอ แนวปฏิบัติที่ดีคือให้วางปีกกาเปิดไว้ในบรรทัดเดียวกับคำประกาศฟังก์ชัน โดยเว้นวรรคหนึ่งช่อง
หมายเหตุ: หากคุณต้องการจัดรูปแบบโค้ดให้เป็นมาตรฐานเดียวกันตลอดทุกโปรเจกต์ของ Rust คุณสามารถใช้เครื่องมือจัดรูปแบบอัตโนมัติชื่อ
rustfmtเพื่อจัดโค้ดตามสไตล์มาตรฐานได้ (อ่านเพิ่มเติมเกี่ยวกับrustfmtได้ที่ภาคผนวก D) ทั้งนี้ ทีมงาน Rust ได้รวมเครื่องมือนี้มาพร้อมกับชุดติดตั้งมาตรฐานของ Rust เช่นเดียวกับrustcจึงติดตั้งอยู่ในเครื่องของคุณเรียบร้อยแล้ว!
ภายในบล็อกเนื้อหาของฟังก์ชัน main มีโค้ดดังนี้:
#![allow(unused)]
fn main() {
println!("Hello, world!");
}
บรรทัดนี้คือส่วนที่ทำหน้าที่หลักทั้งหมดในโปรแกรมเล็กๆ นี้ นั่นคือการพิมพ์ข้อความออกทางหน้าจอ โดยมีรายละเอียดสำคัญ 3 ประการที่ควรสังเกต:
ประการแรก println! คือการเรียกใช้มาโครของ Rust (Rust macro) หากเป็นการเรียกใช้ฟังก์ชันทั่วไป จะเขียนเพียง println (โดยไม่มีเครื่องหมาย !) มาโครของ Rust เป็นวิธีการเขียนโค้ดที่สร้างโค้ดอื่นขึ้นมาเพื่อช่วยขยายไวยากรณ์ของภาษา ซึ่งเราจะเจาะลึกรายละเอียดกันในบทที่ 20 สำหรับตอนนี้ คุณเพียงจำไว้ว่าการมีเครื่องหมาย ! หมายถึงคุณกำลังเรียกใช้มาโคร ไม่ใช่ฟังก์ชันทั่วไป และมาโครไม่ได้ปฏิบัติตามกฎเกณฑ์เดียวกันกับฟังก์ชันเสมอไป
ประการที่สอง คุณจะเห็นสตริง "Hello, world!" เราส่งสตริงนี้เป็นอาร์กิวเมนต์ให้กับ println! เพื่อพิมพ์ข้อความดังกล่าวออกทางหน้าจอ
ประการที่สาม เราจบบรรทัดด้วยเครื่องหมายอัฒภาคหรือเซมิโคลอน (;) ซึ่งเป็นตัวบอกว่านิพจน์ (expression) นี้สิ้นสุดลงแล้ว และพร้อมเริ่มต้นนิพจน์ถัดไป โดยโค้ดของ Rust เกือบทุกบรรทัดจะลงท้ายด้วยเครื่องหมายเซมิโคลอนเสมอ
การคอมไพล์และการรัน
คุณเพิ่งได้รันโปรแกรมที่สร้างขึ้นมาใหม่ ตอนนี้มาทำความเข้าใจแต่ละขั้นตอนในกระบวนการนี้กัน
ก่อนที่จะรันโปรแกรม Rust คุณจำเป็นต้องคอมไพล์โค้ดด้วยคอมไพเลอร์ Rust เสียก่อน โดยป้อนคำสั่ง rustc แล้วตามด้วยชื่อไฟล์ซอร์สโค้ด ดังนี้:
$ rustc main.rs
หากคุณคุ้นเคยกับภาษา C หรือ C++ มาก่อน คุณจะสังเกตได้ว่าคำสั่งนี้คล้ายกับการใช้งาน gcc หรือ clang เมื่อคอมไพล์สำเร็จ คอมไพเลอร์ Rust จะสร้างไฟล์ไบนารีที่รันได้ (binary executable) ออกมา
บน Linux, macOS และ PowerShell บน Windows คุณสามารถตรวจสอบดูไฟล์ที่รันได้โดยใช้คำสั่ง ls ในเทอร์มินัล:
$ ls
main  main.rs
บน Linux และ macOS คุณจะเห็น 2 ไฟล์ ส่วนใน PowerShell บน Windows คุณจะเห็น 3 ไฟล์ เช่นเดียวกับการใช้คำสั่ง CMD บน Windows ซึ่งป้อนคำสั่งดังนี้:
> dir /B %= the /B option says to only show the file names =%
main.exe
main.pdb
main.rs
ผลลัพธ์จะแสดงไฟล์ซอร์สโค้ดที่มีนามสกุล .rs, ไฟล์โปรแกรมที่รันได้ (main.exe บน Windows หรือ main บนแพลตฟอร์มอื่นๆ) และเมื่อใช้งานบน Windows จะมีไฟล์นามสกุล .pdb เพิ่มขึ้นมา ซึ่งเก็บข้อมูลสำหรับการดีบัก (debugging information) จากจุดนี้ คุณสามารถสั่งรันไฟล์ main หรือ main.exe ได้ดังนี้:
$ ./main # or .\main on Windows
หากไฟล์ main.rs ของคุณคือโปรแกรม “Hello, world!” คำสั่งนี้จะพิมพ์ข้อความ Hello, world! แสดงขึ้นมาบนเทอร์มินัลของคุณ
หากคุณคุ้นเคยกับภาษาไดนามิกอย่าง Ruby, Python หรือ JavaScript คุณอาจไม่ชินกับการที่ขั้นตอนการคอมไพล์และการรันโปรแกรมถูกแยกออกจากกันอย่างชัดเจน Rust เป็นภาษาแบบ คอมไพล์ล่วงหน้า (ahead-of-time compiled) หมายความว่าคุณสามารถคอมไพล์โปรแกรมแล้วส่งมอบไฟล์โปรแกรมที่รันได้ (executable) ให้ผู้อื่นนำไปใช้งานได้ทันที แม้ว่าเครื่องของพวกเขาจะไม่ได้ติดตั้ง Rust ไว้เลยก็ตาม แตกต่างจากการส่งไฟล์ .rb, .py หรือ .js ให้คนอื่น ซึ่งเครื่องปลายทางจำเป็นต้องมีตัวรัน (runtime/interpreter) ของ Ruby, Python หรือ JavaScript ติดตั้งอยู่ด้วย จึงจะรันโค้ดได้ แต่สำหรับภาษาเหล่านั้น คุณอาจใช้เพียงคำสั่งเดียวเพื่อรันโปรแกรม ทุกสิ่งในการออกแบบภาษาโปรแกรมล้วนมีข้อแลกเปลี่ยนเสมอ
การสั่งคอมไพล์ด้วย rustc โดยตรงอาจเพียงพอสำหรับโปรแกรมง่ายๆ ที่มีขนาดเล็ก แต่เมื่อโปรเจกต์ของคุณเติบโตและซับซ้อนขึ้น คุณจะต้องการเครื่องมือที่ช่วยจัดการตัวเลือกการคอมไพล์และการแบ่งปันโค้ดอย่างเป็นระบบ ในหัวข้อถัดไป เราจะพาคุณไปทำความรู้จักกับ Cargo ซึ่งเป็นเครื่องมือสำคัญที่จะช่วยให้คุณพัฒนาโปรแกรม Rust ระดับใช้งานจริงได้อย่างสะดวกสบาย
Hello, Cargo!
Hello, Cargo!
Cargo เป็นระบบบิลด์และตัวจัดการแพ็กเกจอย่างเป็นทางการของ Rust นักพัฒนา Rust ส่วนใหญ่ต่างเลือกใช้เครื่องมือนี้ในการจัดการโปรเจกต์ เพราะ Cargo ช่วยดูแลงานหลายอย่างให้โดยอัตโนมัติ ไม่ว่าจะเป็นการบิลด์โค้ด การดาวน์โหลดไลบรารีที่โค้ดของคุณต้องพึ่งพา ตลอดจนการบิลด์ไลบรารีเหล่านั้น (เราเรียกไลบรารีภายนอกที่โค้ดจำเป็นต้องใช้ว่า ดีเพนเดนซี หรือ dependencies)
โปรแกรม Rust ที่เรียบง่ายที่สุดอย่างที่เราได้เขียนไปแล้วนั้นไม่มีดีเพนเดนซีใดๆ หากเราสร้างโปรเจกต์ “Hello, world!” ด้วย Cargo มันจะทำงานเฉพาะในส่วนที่จัดการการบิลด์โค้ดเท่านั้น แต่เมื่อคุณพัฒนาโปรแกรมที่มีความซับซ้อนยิ่งขึ้นและจำเป็นต้องเพิ่มดีเพนเดนซี การเริ่มต้นโปรเจกต์ด้วย Cargo จะช่วยให้การจัดการดีเพนเดนซีเหล่านั้นเป็นเรื่องง่ายดายอย่างยิ่ง
เนื่องจากโปรเจกต์ Rust ส่วนใหญ่ใช้ Cargo ในส่วนที่เหลือของหนังสือเล่มนี้จึงสมมติว่าคุณเลือกใช้ Cargo เช่นเดียวกัน โดยปกติ Cargo จะติดตั้งมาพร้อมกับ Rust อยู่แล้ว หากคุณใช้ตัวติดตั้งมาตรฐานตามที่อธิบายไว้ในหัวข้อ “การติดตั้ง” หากคุณติดตั้ง Rust ด้วยวิธีอื่น สามารถตรวจสอบว่ามี Cargo ติดตั้งอยู่ในเครื่องหรือไม่โดยป้อนคำสั่งต่อไปนี้ในเทอร์มินัล:
$ cargo --version
หากพบข้อความแสดงหมายเลขเวอร์ชัน แสดงว่าติดตั้งเรียบร้อยแล้ว! แต่หากพบข้อความแจ้งข้อผิดพลาดอย่าง command not found ให้เปิดดูคู่มือของวิธีการติดตั้งที่คุณใช้เพื่อดูวิธีติดตั้ง Cargo แยกต่างหาก
การสร้างโปรเจกต์ด้วย Cargo
มาลองสร้างโปรเจกต์ใหม่ด้วย Cargo และดูความแตกต่างระหว่างโปรเจกต์นี้กับโปรเจกต์ “Hello, world!” เดิมของเรากัน เริ่มจากกลับไปที่ไดเรกทอรี projects ของคุณ (หรือโฟลเดอร์ที่คุณเลือกใช้เก็บโค้ด) จากนั้นรันคำสั่งต่อไปนี้ในเทอร์มินัล:
$ cargo new hello_cargo
$ cd hello_cargo
คำสั่งแรกจะสร้างไดเรกทอรีและโปรเจกต์ใหม่ชื่อว่า hello_cargo โดย Cargo จะสร้างไฟล์โครงสร้างต่างๆ ไว้ภายในไดเรกทอรีชื่อเดียวกันนี้
เมื่อเข้าไปในไดเรกทอรี hello_cargo แล้วสั่งแสดงรายการไฟล์ คุณจะพบว่า Cargo ได้สร้างไฟล์ 2 ไฟล์และ 1 ไดเรกทอรีให้โดยอัตโนมัติ ได้แก่ ไฟล์ Cargo.toml และไดเรกทอรี src ซึ่งมีไฟล์ main.rs บรรจุอยู่ข้างใน
นอกจากนี้ Cargo ยังสร้างและตั้งค่าที่เก็บ Git (Git repository) เริ่มต้น พร้อมกับไฟล์ .gitignore ให้ทันที โดยไฟล์และประวัติ Git จะไม่ถูกสร้างขึ้นหากคุณรันคำสั่ง cargo new ภายในที่เก็บ Git ที่มีอยู่เดิมแล้ว ทั้งนี้ คุณสามารถเปลี่ยนพฤติกรรมนี้ได้ด้วยตัวเลือก cargo new --vcs=git
หมายเหตุ: Git เป็นระบบควบคุมเวอร์ชัน (version control system) ยอดนิยม คุณสามารถสั่งให้
cargo newใช้ระบบควบคุมเวอร์ชันอื่นหรือไม่ใช้เลยก็ได้โดยระบุแฟล็ก--vcsสามารถรันcargo new --helpเพื่อดูตัวเลือกที่มีทั้งหมด
ลองเปิดไฟล์ Cargo.toml ด้วยโปรแกรมแก้ไขโค้ดที่คุณถนัด คุณจะเห็นเนื้อหาที่คล้ายคลึงกับโค้ดในลิสติ้ง 1-2
[package]
name = "hello_cargo"
version = "0.1.0"
edition = "2024"

[dependencies]
ไฟล์นี้ใช้รูปแบบข้อมูลแบบ TOML (Tom’s Obvious, Minimal Language) ซึ่งเป็นรูปแบบไฟล์การตั้งค่ามาตรฐานของ Cargo
บรรทัดแรก [package] เป็นหัวข้อกำกับส่วน (section header) ที่ระบุว่าคำสั่งถัดจากนี้ไปเป็นการตั้งค่าแพ็กเกจ เมื่อเราต้องการระบุข้อมูลอื่นๆ เพิ่มเติมในไฟล์นี้ เราจะเพิ่มส่วนใหม่อื่นๆ ตามมา
สามบรรทัดถัดมาเป็นการกำหนดค่าที่ Cargo จำเป็นต้องใช้ในการคอมไพล์โปรแกรมของคุณ ได้แก่ ชื่อโปรเจกต์ เวอร์ชัน และฉบับของภาษา Rust (edition) ที่ต้องการใช้งาน เราจะพูดถึงคีย์ edition อย่างละเอียดในภาคผนวก E
บรรทัดสุดท้าย [dependencies] คือจุดเริ่มต้นของส่วนที่ใช้ระบุดีเพนเดนซี (แพ็กเกจภายนอก) ที่โปรเจกต์จำเป็นต้องใช้ ในระบบนิเวศของ Rust เราเรียกแพ็กเกจโค้ดเหล่านี้ว่า เครต (crates) สำหรับโปรเจกต์นี้เรายังไม่จำเป็นต้องใช้เครตอื่น แต่ในโปรเจกต์แรกของบทที่ 2 เราจะได้เริ่มใช้งาน ดังนั้นเราจะกลับมาใช้ส่วน dependencies นี้ในบทถัดไป
ตอนนี้ลองเปิดไฟล์ src/main.rs ขึ้นมาดู:
ชื่อไฟล์: src/main.rs
fn main() {
    println!("Hello, world!");
}
Cargo ได้สร้างโปรแกรม “Hello, world!” ให้คุณเรียบร้อยแล้ว ซึ่งมีหน้าตาเหมือนกับโค้ดที่เราเขียนเองในลิสติ้ง 1-1 ทุกประการ! จุดที่แตกต่างระหว่างโปรเจกต์เดิมกับโปรเจกต์ที่สร้างด้วย Cargo มีเพียงการที่ Cargo นำโค้ดไปจัดเก็บไว้ในไดเรกทอรี src และมีไฟล์การตั้งค่า Cargo.toml อยู่ที่ไดเรกทอรีหลักด้านนอกสุด
Cargo กำหนดมาตรฐานไว้ว่าไฟล์ซอร์สโค้ดของคุณควรอยู่ภายในไดเรกทอรี src เสมอ ส่วนไดเรกทอรีโปรเจกต์ระดับบนสุดจะมีไว้สำหรับเก็บไฟล์ README ข้อมูลสัญญาอนุญาต (license) ไฟล์การตั้งค่าต่างๆ และสิ่งอื่นๆ ที่ไม่ใช่ซอร์สโค้ด การจัดระเบียบตามแนวทางของ Cargo ช่วยให้โปรเจกต์ของคุณเป็นระเบียบเรียบร้อย ทุกสิ่งมีที่อยู่ของตัวเองอย่างชัดเจน
หากคุณเริ่มโปรเจกต์โดยไม่ได้ใช้ Cargo มาก่อน เหมือนอย่างที่เราทำกับโปรเจกต์ “Hello, world!” ก่อนหน้านี้ คุณสามารถเปลี่ยนมาใช้ Cargo ได้ง่ายๆ เพียงย้ายโค้ดทั้งหมดเข้าไปไว้ในไดเรกทอรี src แล้วสร้างไฟล์ Cargo.toml ขึ้นมา ซึ่งวิธีที่สะดวกที่สุดคือการรันคำสั่ง cargo init ในไดเรกทอรีโปรเจกต์ แล้วระบบจะสร้างโครงสร้างที่จำเป็นให้โดยอัตโนมัติ
การบิลด์และรันโปรเจกต์ Cargo
คราวนี้มาดูความแตกต่างเมื่อเราสั่งบิลด์และรันโปรแกรม “Hello, world!” ผ่าน Cargo กัน! จากภายในไดเรกทอรี hello_cargo ให้สั่งบิลด์โปรเจกต์ด้วยคำสั่งต่อไปนี้:
$ cargo build
   Compiling hello_cargo v0.1.0 (file:///projects/hello_cargo)
    Finished dev [unoptimized + debuginfo] target(s) in 2.85 secs
คำสั่งนี้จะสร้างไฟล์โปรแกรมที่รันได้ขึ้นมาใน target/debug/hello_cargo (หรือ target\debug\hello_cargo.exe บน Windows) แทนที่จะสร้างไว้ในไดเรกทอรีปัจจุบัน เนื่องจากการบิลด์ตามค่าเริ่มต้นจะเป็นโหมดดีบัก Cargo จึงจัดเก็บไฟล์ไบนารีไว้ในไดเรกทอรีชื่อ debug คุณสามารถสั่งรันโปรแกรมดังกล่าวได้ด้วยคำสั่งนี้:
$ ./target/debug/hello_cargo # or .\target\debug\hello_cargo.exe on Windows
Hello, world!
หากทุกอย่างเรียบร้อย ข้อความ Hello, world! จะปรากฏขึ้นบนเทอร์มินัลของคุณ นอกจากนี้ การรันคำสั่ง cargo build เป็นครั้งแรกจะทำให้ Cargo สร้างไฟล์ใหม่ขึ้นมาที่ไดเรกทอรีระดับบนสุด นั่นคือ Cargo.lock ไฟล์นี้ทำหน้าที่บันทึกเวอร์ชันที่แน่นอนของดีเพนเดนซีต่างๆ ในโปรเจกต์ของคุณ เนื่องจากโปรเจกต์นี้ยังไม่มีดีเพนเดนซี ไฟล์นี้จึงแทบจะว่างเปล่า คุณไม่จำเป็นต้องเข้าไปแก้ไขไฟล์นี้ด้วยตนเองแต่อย่างใด เพราะ Cargo จะจัดการเนื้อหาภายในไฟล์นี้ให้คุณโดยอัตโนมัติ
เมื่อสักครู่เราสั่งบิลด์โปรเจกต์ด้วย cargo build แล้วสั่งรันด้วย ./target/debug/hello_cargo แต่นอกจากนั้น เรายังสามารถใช้คำสั่ง cargo run เพื่อสั่งคอมไพล์โค้ดและรันโปรแกรมที่ได้ให้จบในคำสั่งเดียวได้ทันที:
$ cargo run
    Finished dev [unoptimized + debuginfo] target(s) in 0.0 secs
     Running `target/debug/hello_cargo`
Hello, world!
การใช้คำสั่ง cargo run สะดวกสบายกว่าการต้องคอยจำรัน cargo build แล้วค่อยพิมพ์พาธยาวๆ เพื่อเปิดไฟล์ไบนารี นักพัฒนาส่วนใหญ่จึงนิยมใช้ cargo run เป็นหลัก
สังเกตว่าในครั้งนี้ เราไม่เห็นข้อความแจ้งว่า Cargo กำลังคอมไพล์ hello_cargo อีก นั่นเพราะ Cargo ตรวจพบว่าไฟล์ซอร์สโค้ดไม่ได้มีการเปลี่ยนแปลง จึงไม่ต้องบิลด์ใหม่ แต่ข้ามไปรันไฟล์ไบนารีได้ทันที แต่หากคุณมีการแก้ไขซอร์สโค้ด Cargo จะบิลด์โปรเจกต์ใหม่อีกครั้งก่อนรัน และคุณจะเห็นผลลัพธ์ดังนี้:
$ cargo run
   Compiling hello_cargo v0.1.0 (file:///projects/hello_cargo)
    Finished dev [unoptimized + debuginfo] target(s) in 0.33 secs
     Running `target/debug/hello_cargo`
Hello, world!
นอกจากนี้ Cargo ยังมีคำสั่ง cargo check ซึ่งทำหน้าที่ตรวจสอบโค้ดของคุณอย่างรวดเร็วเพื่อให้มั่นใจว่าโค้ดคอมไพล์ผ่าน โดยไม่เสียเวลาสร้างไฟล์โปรแกรมที่รันได้ออกมา:
$ cargo check
   Checking hello_cargo v0.1.0 (file:///projects/hello_cargo)
    Finished dev [unoptimized + debuginfo] target(s) in 0.32 secs
ทำไมถึงไม่อยากได้ไฟล์โปรแกรมที่รันได้ล่ะ? เหตุผลคือ บ่อยครั้ง cargo check ทำงานได้เร็วกว่า cargo build อย่างเห็นได้ชัด เพราะข้ามขั้นตอนการแปลงเป็นไฟล์ไบนารีไป หากคุณต้องการตรวจสอบความถูกต้องของโค้ดอยู่เรื่อยๆ ในขณะที่กำลังเขียน การใช้ cargo check จะช่วยให้คุณทราบได้อย่างรวดเร็วว่าโค้ดยังคงคอมไพล์ผ่านหรือไม่ ด้วยเหตุนี้ ชาว Rustacean จำนวนมากจึงนิยมรัน cargo check เป็นระยะระหว่างเขียนโปรแกรมเพื่อตรวจดูว่าโค้ดไม่มีข้อผิดพลาด จากนั้นจึงค่อยรัน cargo build เมื่อต้องการไฟล์ที่พร้อมนำไปรันจริง
มาสรุปสิ่งที่เราได้เรียนรู้เกี่ยวกับ Cargo จนถึงตอนนี้กัน:
- เราสามารถสร้างโปรเจกต์ใหม่ได้ด้วย
cargo new - เราสามารถบิลด์โปรเจกต์ได้ด้วย
cargo build - เราสามารถบิลด์และรันโปรเจกต์ได้ในขั้นตอนเดียวด้วย
cargo run - เราสามารถตรวจสอบข้อผิดพลาดในโค้ดโดยไม่ต้องสร้างไฟล์ไบนารีได้ด้วย
cargo check - แทนที่จะเก็บผลลัพธ์การบิลด์ไว้ปะปนกับโค้ด Cargo จะจัดเก็บไว้ในไดเรกทอรี target/debug อย่างเป็นสัดส่วน
ข้อดีที่สำคัญอีกประการหนึ่งของ Cargo คือคำสั่งต่างๆ จะทำงานเหมือนกันในทุกระบบปฏิบัติการ ดังนั้นนับจากจุดนี้เป็นต้นไป เราจะไม่ต้องแยกคำสั่งระหว่าง Linux, macOS และ Windows อีกต่อไป
การบิลด์สำหรับการรีลีส
เมื่อโปรเจกต์ของคุณพัฒนาจนพร้อมสำหรับการเผยแพร่ใช้งานจริงในที่สุด คุณสามารถใช้คำสั่ง cargo build --release เพื่อคอมไพล์โค้ดพร้อมเปิดใช้งานการปรับแต่งประสิทธิภาพ (optimizations) คำสั่งนี้จะสร้างไฟล์โปรแกรมที่รันได้ไว้ใน target/release แทนที่จะเป็น target/debug การเปิดใช้ตัวเลือกปรับแต่งประสิทธิภาพจะช่วยให้โค้ด Rust ของคุณทำงานได้รวดเร็วขึ้นอย่างมาก แต่ก็จะแลกมาด้วยระยะเวลาในการคอมไพล์ที่ยาวนานขึ้น ด้วยเหตุนี้ Cargo จึงแบ่งโหมดการทำงานออกเป็นสองโปรไฟล์: โปรไฟล์สำหรับการพัฒนา (development) เพื่อให้คอมไพล์ซ้ำได้บ่อยๆ อย่างรวดเร็ว และโปรไฟล์สำหรับการบิลด์เวอร์ชันสุดท้ายเพื่อส่งมอบให้ผู้ใช้งาน ซึ่งไม่ต้องบิลด์ซ้ำบ่อยและต้องการประสิทธิภาพการทำงานที่เร็วที่สุด หากคุณต้องการวัดประสิทธิภาพความเร็ว (benchmark) ในการรันโค้ด อย่าลืมบิลด์ด้วย cargo build --release แล้วทดสอบกับไฟล์ที่อยู่ใน target/release เสมอ
ใช้ประโยชน์จากธรรมเนียมปฏิบัติของ Cargo
สำหรับโปรเจกต์ขนาดเล็กที่มีโครงสร้างเรียบง่าย การใช้ Cargo อาจไม่ได้ดูแตกต่างจากการรัน rustc ตรงๆ มากนัก แต่ประโยชน์ที่แท้จริงของ Cargo จะเริ่มเด่นชัดขึ้นเมื่อโปรแกรมของคุณมีความซับซ้อนยิ่งขึ้น เมื่อใดที่โปรเจกต์ขยายตัวจนมีไฟล์ซอร์สโค้ดหลายไฟล์ หรือจำเป็นต้องเรียกใช้ไลบรารีภายนอก การให้ Cargo ช่วยบริหารจัดการขั้นตอนการบิลด์ทั้งหมดจะช่วยแบ่งเบาภาระของคุณไปได้มหาศาล
แม้ว่าโปรเจกต์ hello_cargo จะมีขนาดเล็กมาก แต่ก็ได้เริ่มใช้งานชุดเครื่องมือมาตรฐานจริงที่คุณจะได้ใช้ไปตลอดเส้นทางการพัฒนาด้วยภาษา Rust อันที่จริง ในการทำงานกับโปรเจกต์ Rust ใดๆ ที่มีอยู่แล้ว คุณสามารถดาวน์โหลดโค้ดด้วย Git สลับเข้าไปยังไดเรกทอรีโปรเจกต์นั้น แล้วสั่งบิลด์ได้ทันทีด้วยคำสั่งดังนี้:
$ git clone example.org/someproject
$ cd someproject
$ cargo build
สำหรับข้อมูลเพิ่มเติมเกี่ยวกับ Cargo สามารถศึกษาได้จากคู่มือการใช้งานของ Cargo
สรุป
คุณได้เริ่มต้นก้าวแรกบนเส้นทางของ Rust ได้อย่างยอดเยี่ยมแล้ว! ในบทนี้ คุณได้เรียนรู้วิธีการ:
- ติดตั้ง Rust เวอร์ชันเสถียรล่าสุดด้วย
rustup - อัปเดต Rust ให้เป็นเวอร์ชันใหม่อยู่เสมอ
- เปิดอ่านเอกสารคู่มือที่ติดตั้งไว้ในเครื่อง
- เขียนและสั่งรันโปรแกรม “Hello, world!” ด้วย
rustcโดยตรง - สร้างและสั่งรันโปรเจกต์ใหม่ตามแบบแผนมาตรฐานของ Cargo
นี่เป็นจังหวะเวลาที่ดีในการเริ่มต้นสร้างโปรแกรมที่มีความสมบูรณ์ยิ่งขึ้น เพื่อฝึกฝนทักษะการอ่านและเขียนโค้ด Rust ให้คุ้นเคย ในบทที่ 2 เราจะร่วมกันสร้างโปรเจกต์เกมทายตัวเลข แต่หากคุณต้องการเริ่มต้นด้วยการทำความเข้าใจแนวคิดพื้นฐานทั่วไปในการเขียนโปรแกรมของ Rust ก่อน สามารถข้ามไปอ่านบทที่ 3 แล้วค่อยย้อนกลับมาทำโปรเจกต์ในบทที่ 2 ได้เช่นกัน
เขียนโปรแกรมเกมทายตัวเลข
มาเริ่มต้นเรียนรู้ Rust ผ่านการลงมือพัฒนาโปรเจกต์จริงไปด้วยกัน! บทนี้จะแนะนำให้คุณรู้จักแนวคิดพื้นฐานที่สำคัญหลากหลายประการของ Rust โดยแสดงให้เห็นวิธีนำไปใช้งานจริงในโปรแกรม คุณจะได้เรียนรู้เกี่ยวกับคำสำคัญ let, match, เมธอด (method), ฟังก์ชันประจำชนิดข้อมูล (associated function), การเรียกใช้เครตภายนอก (external crates) และอื่นๆ อีกมากมาย! ซึ่งในบทต่อๆ ไป เราจะได้เจาะลึกแต่ละแนวคิดอย่างละเอียด ส่วนในบทนี้ เราจะเน้นการฝึกฝนและทำความคุ้นเคยกับพื้นฐานเป็นหลัก
เราจะร่วมกันสร้างโจทย์คลาสสิกสำหรับผู้เริ่มต้นเขียนโปรแกรม นั่นคือ “เกมทายตัวเลข” โดยมีกติกาการทำงานดังนี้: โปรแกรมจะสุ่มจำนวนเต็ม (integer) ระหว่าง 1 ถึง 100 ขึ้นมาหนึ่งตัว จากนั้นจะแจ้งให้ผู้เล่นป้อนตัวเลขที่ต้องการทาย เมื่อผู้เล่นป้อนตัวเลขแล้ว โปรแกรมจะบอกว่าตัวเลขที่ทายนั้นน้อยเกินไปหรือมากเกินไป หากทายถูกต้อง โปรแกรมจะแสดงข้อความแสดงความยินดีและสิ้นสุดการทำงาน
การตั้งค่าโปรเจกต์ใหม่
ในการเริ่มต้นโปรเจกต์ใหม่ ให้เปิดเทอร์มินัลไปยังไดเรกทอรี projects ที่คุณสร้างไว้ในบทที่ 1 แล้วสร้างโปรเจกต์ใหม่ด้วย Cargo ดังนี้:
$ cargo new guessing_game
$ cd guessing_game
คำสั่งแรก cargo new รับชื่อโปรเจกต์ (guessing_game) เป็นอาร์กิวเมนต์แรก ส่วนคำสั่งที่สองจะสลับเข้าไปยังไดเรกทอรีของโปรเจกต์ใหม่
มาดูไฟล์ Cargo.toml ที่ถูกสร้างขึ้นกัน:
ชื่อไฟล์: Cargo.toml
[package]
name = "guessing_game"
version = "0.1.0"
edition = "2024"

[dependencies]
ดังที่คุณได้เห็นในบทที่ 1 คำสั่ง cargo new จะสร้างโปรแกรม “Hello, world!” เริ่มต้นมาให้ ลองเปิดดูไฟล์ src/main.rs:
ชื่อไฟล์: src/main.rs
fn main() {
    println!("Hello, world!");
}
คราวนี้มาคอมไพล์โปรแกรม “Hello, world!” และสั่งรันในขั้นตอนเดียวด้วยคำสั่ง cargo run:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.08s
     Running `target/debug/guessing_game`
Hello, world!
คำสั่ง run มีประโยชน์อย่างยิ่งเมื่อคุณต้องการทดสอบและพัฒนาโปรแกรมแบบวนซ้ำอย่างรวดเร็ว ดังที่เราจะทำในโปรเจกต์เกมนี้ เพื่อทดสอบโค้ดในแต่ละรอบให้มั่นใจก่อนจะไปต่อยังขั้นตอนถัดไป
เปิดไฟล์ src/main.rs ขึ้นมาอีกครั้ง เราจะเขียนโค้ดทั้งหมดลงในไฟล์นี้
การประมวลผลคำทาย
ส่วนแรกของโปรแกรมเกมทายตัวเลขจะรับข้อมูลอินพุตจากผู้ใช้ นำมาประมวลผล และตรวจสอบว่าข้อมูลที่ป้อนเข้ามาถูกต้องตามรูปแบบที่ต้องการหรือไม่ เริ่มต้นด้วยการให้ผู้เล่นป้อนตัวเลขคำทาย โดยใส่โค้ดตามลิสติ้ง 2-1 ลงในไฟล์ src/main.rs
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
โค้ดชุดนี้มีรายละเอียดที่น่าสนใจอยู่หลายจุด เรามาทำความเข้าใจทีละบรรทัดกัน ในการรับอินพุตจากผู้ใช้และพิมพ์ผลลัพธ์ออกทางหน้าจอ เราจำเป็นต้องนำไลบรารีอินพุต/เอาต์พุต io เข้ามาสู่สโคป (scope) การทำงาน โดยไลบรารี io มาจากไลบรารีมาตรฐานที่เรียกว่า std:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
โดยค่าเริ่มต้น Rust ได้กำหนดชุดรายการพื้นฐานจากไลบรารีมาตรฐานที่นำเข้าสู่สโคปของทุกโปรแกรมไว้ให้อัตโนมัติ ชุดรายการนี้เรียกว่า พรีลูด (prelude) ซึ่งคุณสามารถดูรายการทั้งหมดที่มีในพรีลูดได้จากเอกสารของไลบรารีมาตรฐาน
หากคุณต้องการใช้ชนิดข้อมูลหรือฟังก์ชันที่ไม่ได้อยู่ในพรีลูด คุณจะต้องนำเข้าสู่สโคปอย่างชัดแจ้งด้วยคำสั่ง use ซึ่งการนำเข้าไลบรารี std::io จะช่วยให้คุณเข้าถึงฟังก์ชันที่มีประโยชน์มากมาย รวมถึงความสามารถในการรับอินพุตจากผู้ใช้ด้วย
ดังที่ได้เรียนรู้ในบทที่ 1 ฟังก์ชัน main คือจุดเริ่มต้นการทำงานของโปรแกรม:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
ไวยากรณ์ fn ใช้สำหรับประกาศฟังก์ชันใหม่ เครื่องหมายวงเล็บ () บ่งบอกว่าฟังก์ชันนี้ไม่ได้รับพารามิเตอร์ใดๆ และเครื่องหมายปีกกาเปิด { เป็นจุดเริ่มต้นของบล็อกเนื้อหาฟังก์ชัน
และตามที่ได้เรียนรู้มาเช่นกัน println! เป็นมาโครที่ทำหน้าที่พิมพ์ข้อความสตริงออกทางหน้าจอ:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
โค้ดส่วนนี้จะพิมพ์ข้อความต้อนรับเข้าสู่เกม และแจ้งให้ผู้เล่นป้อนตัวเลขคำทาย
การเก็บค่าด้วยตัวแปร
ถัดไป เราจะสร้าง_ตัวแปร_ขึ้นมาเพื่อใช้เก็บค่าอินพุตของผู้เล่น ดังนี้:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
ตอนนี้โปรแกรมเริ่มน่าสนใจขึ้นแล้ว! มีหลายสิ่งเกิดขึ้นในบรรทัดสั้นๆ นี้ เราใช้คำสั่ง let ในการประกาศสร้างตัวแปร ลองดูตัวอย่างนี้:
let apples = 5;บรรทัดนี้จะสร้างตัวแปรใหม่ชื่อว่า apples และผูกค่า 5 เข้ากับตัวแปร ใน Rust ตัวแปรทุกตัวจะเป็นแบบเปลี่ยนแปลงค่าไม่ได้ (immutable) โดยค่าเริ่มต้น หมายความว่าเมื่อกำหนดค่าเริ่มต้นให้แล้ว จะไม่สามารถเปลี่ยนค่านั้นได้อีก เราจะเจาะลึกแนวคิดนี้ในหัวข้อ “ตัวแปรและความสามารถในการเปลี่ยนแปลงค่า” ในบทที่ 3 หากต้องการให้ตัวแปรสามารถเปลี่ยนค่าได้ (mutable) เราจะใส่คำว่า mut ไว้ข้างหน้าชื่อตัวแปร:
let apples = 5; // immutable
let mut bananas = 5; // mutable
หมายเหตุ: ไวยากรณ์
//เป็นจุดเริ่มต้นของการเขียนคอมเมนต์ (comment) ซึ่งจะดำเนินไปจนจบบรรทัด โดยคอมไพเลอร์ Rust จะมองข้ามข้อความในคอมเมนต์ทั้งหมด เราจะพูดถึงคอมเมนต์อย่างละเอียดในบทที่ 3
กลับมาดูที่โปรแกรมเกมทายตัวเลข ตอนนี้คุณทราบแล้วว่า let mut guess คือการประกาศตัวแปรที่เปลี่ยนแปลงค่าได้ชื่อว่า guess เครื่องหมายเท่ากับ (=) บอก Rust ว่าเราต้องการผูกค่าบางอย่างเข้ากับตัวแปร ณ จุดนี้ โดยทางด้านขวาของเครื่องหมายเท่ากับคือค่าที่จะนำมาผูกกับ guess ซึ่งได้มาจากผลลัพธ์ของการเรียก String::new อันเป็นฟังก์ชันที่สร้างอินสแตนซ์ใหม่ของชนิดข้อมูล String โดย String เป็นชนิดข้อมูลสตริงที่ไลบรารีมาตรฐานจัดเตรียมไว้ ซึ่งสามารถปรับขยายขนาดได้และเข้ารหัสด้วย UTF-8
สัญลักษณ์ :: ใน String::new บ่งบอกว่า new เป็นฟังก์ชันประจำชนิดข้อมูล (associated function) ของชนิด String โดย_ฟังก์ชันประจำชนิดข้อมูล_คือฟังก์ชันที่อิมพลีเมนต์อยู่บนชนิดข้อมูลนั้นๆ ซึ่งในที่นี้คือ String ฟังก์ชัน new จะสร้างสตริงใหม่ที่ว่างเปล่าขึ้นมา คุณจะพบเห็นฟังก์ชันชื่อ new ได้บ่อยครั้งในชนิดข้อมูลต่างๆ ของ Rust เนื่องจากเป็นชื่อมาตรฐานที่นิยมใช้สำหรับฟังก์ชันที่สร้างค่าใหม่ของชนิดข้อมูลนั้นๆ
สรุปแล้ว บรรทัด let mut guess = String::new(); คือการประกาศตัวแปรที่แก้ไขค่าได้ ซึ่งปัจจุบันถือครองอินสแตนซ์ของสตริงว่างตัวใหม่อยู่ เห็นไหมว่าบรรทัดเดียวมีรายละเอียดซ่อนอยู่ไม่น้อยเลย!
การรับอินพุตจากผู้ใช้
จำได้ไหมว่าเราได้นำเข้าฟังก์ชันอินพุต/เอาต์พุตจากไลบรารีมาตรฐานด้วย use std::io; ไว้ที่บรรทัดแรกของโปรแกรม คราวนี้เราจะเรียกฟังก์ชัน stdin จากมอดูล io เพื่อช่วยจัดการการรับอินพุตจากผู้ใช้:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
หากเราไม่ได้นำเข้ามอดูล io ด้วย use std::io; ไว้ที่ตอนต้น เราก็ยังสามารถเรียกใช้ฟังก์ชันนี้ได้โดยเขียนพาธเต็มว่า std::io::stdin โดยฟังก์ชัน stdin จะส่งกลับอินสแตนซ์ของ std::io::Stdin ซึ่งเป็นชนิดข้อมูลที่เป็นตัวแทนของช่องทางอินพุตมาตรฐาน (standard input handle) ในเทอร์มินัลของคุณ
ถัดมา ส่วน .read_line(&mut guess) จะเรียกเมธอด read_line บนแฮนเดิลอินพุตมาตรฐานเพื่อรอรับข้อมูลจากผู้ใช้ และเราได้ส่ง &mut guess เข้าไปเป็นอาร์กิวเมนต์ให้กับ read_line เพื่อระบุว่าจะให้นำข้อความที่ผู้ใช้พิมพ์ไปจัดเก็บไว้ในสตริงใด หน้าที่ของ read_line คือรับสิ่งที่ผู้ใช้พิมพ์จากช่องทางอินพุตมาตรฐาน แล้วนำไปต่อท้าย (append) สตริงที่ส่งเข้าไป (โดยไม่เขียนทับข้อมูลเดิม) เราจึงต้องส่งสตริงนั้นเข้าไปเป็นอาร์กิวเมนต์ และอาร์กิวเมนต์สตริงนี้จำเป็นต้องเป็นแบบที่เปลี่ยนแปลงค่าได้ (mut) เพื่อให้เมธอดสามารถแก้ไขเพิ่มเนื้อหาลงไปในสตริงได้
สัญลักษณ์ & ด้านหน้าบ่งบอกว่าอาร์กิวเมนต์นี้เป็น_เรเฟอเรนซ์_ (reference) ซึ่งเป็นกลไกที่เปิดให้โค้ดหลายๆ จุดสามารถเข้าถึงข้อมูลชิ้นเดียวกันได้ โดยไม่ต้องคัดลอกข้อมูลนั้นซ้ำซ้อนในหน่วยความจำ เรเฟอเรนซ์เป็นฟีเจอร์ที่สำคัญและซับซ้อน แต่จุดเด่นอย่างยิ่งของ Rust คือการออกแบบให้การใช้งานเรเฟอเรนซ์มีความปลอดภัยและสะดวกสบาย คุณไม่จำเป็นต้องกังวลกับรายละเอียดเชิงลึกในตอนนี้เพื่อทำโปรแกรมนี้ให้เสร็จ สิ่งที่คุณต้องทราบเบื้องต้นคือ เรเฟอเรนซ์ก็เหมือนกับตัวแปร กล่าวคือเป็นแบบเปลี่ยนแปลงค่าไม่ได้โดยค่าเริ่มต้น ดังนั้นเราจึงต้องเขียน &mut guess แทนที่จะเป็น &guess เพื่อเปิดให้สามารถแก้ไขค่าในตัวแปรเป้าหมายได้ (บทที่ 4 จะอธิบายเรื่องเรเฟอเรนซ์อย่างละเอียด)
การจัดการความล้มเหลวที่อาจเกิดขึ้นด้วย Result
เรายังคงอยู่ในกลุ่มคำสั่งเดิม โดยตอนนี้มาดูส่วนที่สาม ซึ่งแม้จะเขียนแยกอีกบรรทัดหนึ่ง แต่ในเชิงตรรกะแล้วถือเป็นส่วนหนึ่งของประโยคคำสั่งเดียวกัน นั่นคือเมธอดต่อไปนี้:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
ความจริงแล้วเราสามารถเขียนคำสั่งทั้งหมดรวมในบรรทัดเดียวได้ดังนี้:
io::stdin().read_line(&mut guess).expect("Failed to read line");ทว่าการเขียนคำสั่งยาวๆ ติดกันในบรรทัดเดียวทำให้โค้ดอ่านยาก การแยกบรรทัดและจัดย่อหน้าเว้นวรรคเมื่อเรียกใช้เมธอดต่อเนื่องด้วยไวยากรณ์ .method_name() จึงเป็นแนวทางที่ช่วยให้อ่านโค้ดได้ง่ายและสบายตากว่ามาก ตอนนี้มาดูกันว่าบรรทัดนี้ทำหน้าที่อะไร
ดังที่ได้อธิบายไปแล้วว่า read_line จะนำข้อความที่ผู้ใช้พิมพ์ไปใส่ไว้ในสตริงที่เราส่งเข้าไป แต่ยิ่งไปกว่านั้น เมธอดนี้ยังส่งคืนค่าชนิด Result กลับมาด้วย โดย Result เป็นชนิดข้อมูลแบบอีนูเมอเรชัน (enumeration) หรือที่เรียกสั้นๆ ว่า enum ซึ่งเป็นชนิดข้อมูลที่สามารถมีสถานะได้หลากหลายรูปแบบตามที่กำหนดไว้ และเราเรียกแต่ละสถานะที่เป็นไปได้ว่า วาเรียนต์ (variant)
บทที่ 6 จะอธิบายเรื่อง enum อย่างละเอียด สำหรับตอนนี้ จุดประสงค์หลักของชนิด Result คือการใช้สื่อสารและจัดการกับข้อมูลเกี่ยวกับข้อผิดพลาด (error handling)
วาเรียนต์ของ Result ประกอบด้วย Ok และ Err โดยวาเรียนต์ Ok บ่งบอกว่าการทำงานสำเร็จเรียบร้อย และภายในจะบรรจุค่าผลลัพธ์ที่ได้จากการทำงานนั้น ส่วนวาเรียนต์ Err บ่งบอกว่าเกิดความล้มเหลว และภายในจะบรรจุข้อมูลที่อธิบายว่าเกิดข้อผิดพลาดขึ้นอย่างไรหรือเพราะเหตุใด
ค่าชนิด Result ก็เหมือนกับชนิดข้อมูลอื่นๆ ใน Rust ตรงที่มีเมธอดต่างๆ ที่นิยามไว้ให้ใช้งาน โดยอินสแตนซ์ของ Result จะมีเมธอด expect ให้คุณเรียกใช้ หากอินสแตนซ์ของ Result นั้นเป็นค่า Err เมธอด expect จะทำให้โปรแกรมหยุดทำงานกะทันหัน (crash/panic) พร้อมทั้งแสดงข้อความที่คุณระบุไว้ในอาร์กิวเมนต์ของ expect ออกมา หากเมธอด read_line ส่งค่า Err กลับมา มักเกิดจากข้อผิดพลาดในระดับระบบปฏิบัติการ แต่หากอินสแตนซ์ของ Result เป็นค่า Ok เมธอด expect จะดึงค่าผลลัพธ์ที่อยู่ภายใน Ok ออกมาให้คุณนำไปใช้งานต่อทันที ซึ่งในกรณีนี้ ค่าดังกล่าวคือจำนวนไบต์ของข้อความที่ผู้ใช้ป้อนเข้ามา
หากคุณไม่เรียกใช้ expect โปรแกรมจะยังคงคอมไพล์ผ่านได้ แต่คุณจะได้รับข้อความคำเตือน (warning) จากคอมไพเลอร์:
$ cargo build
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
warning: unused `Result` that must be used
  --> src/main.rs:10:5
   |
10 |     io::stdin().read_line(&mut guess);
   |     ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
   |
   = note: this `Result` may be an `Err` variant, which should be handled
   = note: `#[warn(unused_must_use)]` (part of `#[warn(unused)]`) on by default
help: use `let _ = ...` to ignore the resulting value
   |
10 |     let _ = io::stdin().read_line(&mut guess);
   |     +++++++

warning: `guessing_game` (bin "guessing_game") generated 1 warning
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.59s
Rust ส่งสัญญาณเตือนว่าคุณยังไม่ได้นำค่า Result ที่ได้จาก read_line ไปใช้งาน ซึ่งหมายความว่าโปรแกรมของคุณยังไม่ได้จัดการกับกรณีที่อาจเกิดข้อผิดพลาดขึ้น
วิธีแก้ไขคำเตือนที่ถูกต้องคือการเขียนโค้ดเพื่อจัดการข้อผิดพลาดอย่างเหมาะสม แต่สำหรับโปรแกรมตัวอย่างนี้ เราตั้งใจให้โปรแกรมหยุดทำงานทันทีหากเกิดปัญหาขึ้น การใช้ expect จึงตอบโจทย์ได้เป็นอย่างดี คุณจะได้เรียนรู้วิธีการกู้คืนและจัดการข้อผิดพลาดอย่างเต็มรูปแบบในบทที่ 9
การพิมพ์ค่าด้วยตัวยึดตำแหน่งของ println!
นอกจากเครื่องหมายปีกกาปิดแล้ว ยังมีโค้ดอีกหนึ่งบรรทัดที่เราต้องทำความเข้าใจ:
use std::io;

fn main() {
    println!("Guess the number!");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
บรรทัดนี้ทำหน้าที่พิมพ์ข้อความสตริงที่เก็บคำทายของผู้เล่นออกมา โดยเครื่องหมายปีกกา {} ทำหน้าที่เป็นตัวยึดตำแหน่ง (placeholder) ให้จินตนาการว่า {} เหมือนก้ามปูน้อยๆ ของเจ้าปู Ferris ที่ช่วยจับค่ามาวางไว้ตรงจุดนี้ เมื่อต้องการพิมพ์ค่าของตัวแปร คุณสามารถใส่ชื่อตัวแปรไว้ในปีกกาได้โดยตรง และเมื่อต้องการพิมพ์ผลลัพธ์จากการประเมินค่านิพจน์ (expression) ให้ใส่วงเล็บปีกกาเปล่า {} ไว้ในสตริงรูปแบบ (format string) แล้วตามด้วยรายการนิพจน์ที่คั่นด้วยเครื่องหมายจุลภาคต่อท้ายสตริง เพื่อนำค่ามาแสดงตามลำดับของตัวยึดตำแหน่ง การพิมพ์ทั้งตัวแปรและผลลัพธ์ของนิพจน์ในคำสั่ง println! บรรทัดเดียวจะมีรูปแบบดังนี้:
#![allow(unused)]
fn main() {
let x = 5;
let y = 10;

println!("x = {x} and y + 2 = {}", y + 2);
}
โค้ดนี้จะพิมพ์ผลลัพธ์ว่า x = 5 and y + 2 = 12
การทดสอบส่วนแรก
มาลองทดสอบการทำงานของเกมทายตัวเลขในส่วนแรกกัน โดยสั่งรันด้วย cargo run:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 6.44s
     Running `target/debug/guessing_game`
Guess the number!
Please input your guess.
6
You guessed: 6
มาถึงจุดนี้ ส่วนแรกของเกมก็ทำงานได้อย่างสมบูรณ์แล้ว โปรแกรมสามารถรับค่าอินพุตจากแป้นพิมพ์และนำมาแสดงผลออกทางหน้าจอได้อย่างถูกต้อง
การสร้างตัวเลขลับ
ขั้นตอนต่อไป เราจำเป็นต้องสร้างตัวเลขลับที่ผู้เล่นจะต้องทายขึ้นมา โดยตัวเลขนี้ควรเปลี่ยนไปในแต่ละรอบเพื่อให้เกมมีความสนุกสนานและสามารถเล่นซ้ำได้ เราจะกำหนดให้สุ่มตัวเลขระหว่าง 1 ถึง 100 เพื่อไม่ให้เกมยากจนเกินไป ทั้งนี้ ภาษา Rust ยังไม่มีฟังก์ชันการสุ่มตัวเลขมาให้ในไลบรารีมาตรฐาน แต่ทีมงาน Rust ได้จัดเตรียมเครตชื่อ rand ไว้ให้เราเรียกใช้งานความสามารถนี้ได้อย่างสะดวก
เพิ่มฟังก์ชันการทำงานด้วยเครต
จำได้ไหมว่าเครต (crate) คือชุดของไฟล์ซอร์สโค้ดในภาษา Rust โปรเจกต์ที่เรากำลังพัฒนานี้เรียกว่าเครตไบนารี (binary crate) ซึ่งสามารถคอมไพล์ออกมาเป็นไฟล์โปรแกรมที่รันได้ (executable) ส่วนเครต rand จัดเป็นเครตไลบรารี (library crate) ซึ่งประกอบด้วยโค้ดที่สร้างขึ้นเพื่อให้โปรแกรมอื่นนำไปใช้ต่อ และไม่สามารถสั่งรันได้ด้วยตัวมันเอง
การที่ Cargo ช่วยบริหารจัดการเครตภายนอกได้อย่างราบรื่นคือจุดเด่นที่ทำให้เครื่องมือนี้ยอดเยี่ยมอย่างยิ่ง ก่อนที่เราจะสามารถเรียกใช้ฟังก์ชันจาก rand ได้ เราจำเป็นต้องแก้ไขไฟล์ Cargo.toml เพื่อเพิ่มเครต rand เข้ามาเป็นดีเพนเดนซีเสียก่อน เปิดไฟล์นั้นขึ้นมาแล้วเพิ่มข้อความต่อไปนี้ไว้ด้านล่างใต้หัวข้อ [dependencies] ที่ Cargo สร้างไว้ให้ โปรดระบุชื่อ rand และหมายเลขเวอร์ชันให้ตรงกับที่ระบุไว้นี้ทุกประการ เพื่อให้โค้ดตัวอย่างในบทเรียนทำงานได้อย่างถูกต้อง:
ชื่อไฟล์: Cargo.toml
[dependencies]
rand = "0.10.1"
ในไฟล์ Cargo.toml ทุกบรรทัดที่อยู่ถัดจากหัวข้อหมวดหมู่จะถือเป็นส่วนหนึ่งของหมวดหมู่นั้น จนกว่าจะพบหัวข้อหมวดหมู่ใหม่ ในส่วน [dependencies] คุณจะเป็นผู้บอก Cargo ว่าโปรเจกต์นี้ต้องพึ่งพาเครตภายนอกตัวใดบ้าง และต้องการใช้งานเวอร์ชันใด ในที่นี้ เราได้ระบุเครต rand พร้อมหมายเลขเวอร์ชันเชิงความหมาย 0.10.1 โดย Cargo รองรับระบบการกำหนดเวอร์ชันเชิงความหมาย (semantic versioning) (มักเรียกย่อว่า SemVer) ซึ่งเป็นมาตรฐานสากลในการกำหนดหมายเลขเวอร์ชัน โดยเลข 0.10.1 เป็นรูปย่อของ ^0.10.1 ซึ่งหมายถึงเวอร์ชันใดก็ได้ตั้งแต่ 0.10.1 ขึ้นไป แต่ต้องต่ำกว่า 0.11.0
Cargo ถือว่าเวอร์ชันในช่วงนี้มี API สาธารณะที่ทำงานเข้ากันได้กับเวอร์ชัน 0.10.1 ข้อกำหนดนี้ช่วยรับประกันว่าคุณจะได้รับแพตช์แก้ไขล่าสุดที่ยังคงคอมไพล์ร่วมกับโค้ดในบทนี้ได้อย่างราบรื่น แต่จะไม่ข้ามไปใช้เวอร์ชัน 0.11.0 ขึ้นไปซึ่งอาจมีการเปลี่ยนแปลง API จนไม่ตรงกับโค้ดตัวอย่าง
ตอนนี้ โดยที่ยังไม่ต้องแก้ไขโค้ดใดๆ ให้ลองสั่งบิลด์โปรเจกต์ดู ดังแสดงในลิสติ้ง 2-2
$ cargo build
    Updating crates.io index
     Locking 8 packages to latest Rust 1.96.0 compatible versions
  Downloaded rand_core v0.10.1
  Downloaded chacha20 v0.10.1
  Downloaded rand v0.10.1
  Downloaded 3 crates (162.9KiB) in 0.59s
   Compiling libc v0.2.186
   Compiling rand_core v0.10.1
   Compiling getrandom v0.4.3
   Compiling cfg-if v1.0.4
   Compiling chacha20 v0.10.1
   Compiling rand v0.10.1
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 2.03s
คุณอาจเห็นหมายเลขเวอร์ชันย่อยที่แตกต่างไปจากนี้เล็กน้อย (แต่ทั้งหมดจะทำงานร่วมกันได้อย่างแน่นอนตามมาตรฐาน SemVer!) รวมถึงข้อความหรือลำดับบรรทัดอาจต่างไปตามระบบปฏิบัติการของคุณ
เมื่อเราเพิ่มดีเพนเดนซีภายนอกเข้ามา Cargo จะดึงข้อมูลเวอร์ชันล่าสุดของแพ็กเกจที่เกี่ยวข้องทั้งหมดมาจาก_เรจิสทรี_ (registry) ซึ่งเป็นแหล่งข้อมูลส่วนกลางที่คัดลอกมาจาก Crates.io โดย Crates.io คือพื้นที่ที่ชุมชนนักพัฒนา Rust นำโปรเจกต์โอเพนซอร์สมาแบ่งปันให้ผู้อื่นนำไปใช้งาน
หลังจากอัปเดตข้อมูลเรจิสทรีแล้ว Cargo จะตรวจสอบรายการในส่วน [dependencies] และดาวน์โหลดเครตที่ยังไม่มีในเครื่อง ในกรณีนี้ แม้ว่าเราจะระบุเพียง rand เป็นดีเพนเดนซี แต่ Cargo จะดึงเครตอื่นๆ ที่จำเป็นต่อการทำงานของ rand มาให้โดยอัตโนมัติ เมื่อดาวน์โหลดครบแล้ว Rust จะคอมไพล์เครตเหล่านั้น แล้วจึงคอมไพล์โปรเจกต์ของเราพร้อมเชื่อมโยงดีเพนเดนซีให้พร้อมใช้งาน
หากคุณสั่งรัน cargo build ซ้ำอีกครั้งทันทีโดยไม่ได้แก้ไขอะไร คุณจะไม่เห็นข้อความใดๆ ปรากฏขึ้นนอกจากบรรทัด Finished นั่นเป็นเพราะ Cargo ทราบว่าได้ดาวน์โหลดและคอมไพล์ดีเพนเดนซีเหล่านั้นเรียบร้อยแล้ว และไฟล์ Cargo.toml ก็ไม่มีการเปลี่ยนแปลงใดๆ อีกทั้งซอร์สโค้ดของคุณก็ยังคงเดิม Cargo จึงไม่จำเป็นต้องคอมไพล์ใหม่ให้เสียเวลา
แต่หากคุณเปิดไฟล์ src/main.rs แล้วแก้ไขโค้ดเล็กน้อย บันทึกไฟล์ และสั่งบิลด์ใหม่อีกครั้ง คุณจะเห็นข้อความเพียง 2 บรรทัดดังนี้:
$ cargo build
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.13s
ข้อความเหล่านี้แสดงให้เห็นว่า Cargo คอมไพล์เฉพาะส่วนที่คุณแก้ไขในไฟล์ src/main.rs เท่านั้น เนื่องจากดีเพนเดนซีต่างๆ ไม่มีการเปลี่ยนแปลง Cargo จึงนำผลลัพธ์ที่เคยคอมไพล์ไว้แล้วกลับมาใช้ใหม่ได้ทันที
การรับประกันผลการบิลด์ที่เหมือนเดิมทุกครั้ง
Cargo มีกลไกที่ช่วยรับประกันว่าผลลัพธ์จากการบิลด์โค้ดของคุณจะคงเดิมเสมอ ไม่ว่าคุณหรือใครก็ตามจะบิลด์โค้ดนี้เมื่อใด: Cargo จะยึดตามเวอร์ชันของดีเพนเดนซีที่บันทึกไว้เสมอ จนกว่าคุณจะสั่งอัปเกรดอย่างชัดเจน ตัวอย่างเช่น สมมติว่าสัปดาห์หน้ามีเครต rand เวอร์ชัน 0.10.2 ปล่อยออกมา แม้ว่าเวอร์ชันนั้นจะมีการแก้ไขบั๊กที่สำคัญ แต่ก็อาจมีข้อผิดพลาดใหม่ (regression) ที่ส่งผลกระทบต่อโค้ดของคุณได้ เพื่อป้องกันปัญหานี้ Rust จะสร้างไฟล์ Cargo.lock ขึ้นมาในการรัน cargo build ครั้งแรก ซึ่งในตอนนี้คุณจะพบไฟล์นี้อยู่ในไดเรกทอรี guessing_game เช่นกัน
เมื่อคุณสั่งบิลด์โปรเจกต์เป็นครั้งแรก Cargo จะคำนวณเวอร์ชันของดีเพนเดนซีทั้งหมดที่ตรงตามเงื่อนไข แล้วบันทึกเวอร์ชันที่แน่นอนเหล่านั้นลงในไฟล์ Cargo.lock และเมื่อสั่งบิลด์ในครั้งต่อๆ ไป Cargo จะตรวจพบว่ามีไฟล์ Cargo.lock อยู่แล้ว จึงเลือกใช้เวอร์ชันตามที่ระบุไว้ในไฟล์ทันทีโดยไม่ต้องคำนวณเวอร์ชันใหม่อีก กลไกนี้ทำให้ผลการบิลด์ของโปรเจกต์มีความแน่นอนและทำซ้ำได้ (reproducible builds) เสมอ นั่นหมายความว่าโปรเจกต์ของคุณจะยังคงใช้เวอร์ชัน 0.10.1 ต่อไปจนกว่าคุณจะสั่งอัปเกรดด้วยตนเอง และเนื่องจากไฟล์ Cargo.lock มีความสำคัญต่อการรักษาความสม่ำเสมอของโปรเจกต์ จึงเป็นแนวปฏิบัติที่ดีที่จะบันทึกไฟล์นี้ลงในระบบควบคุมเวอร์ชัน (Git) ร่วมกับซอร์สโค้ดเสมอ
การอัปเดตเครตเพื่อรับเวอร์ชันใหม่
เมื่อคุณ_ต้องการ_อัปเดตเวอร์ชันของเครตจริงๆ Cargo มีคำสั่ง update ซึ่งจะข้ามการตรวจสอบจากไฟล์ Cargo.lock แล้วค้นหาเวอร์ชันล่าสุดที่ยังคงสอดคล้องกับเงื่อนไขใน Cargo.toml จากนั้นจึงบันทึกเวอร์ชันใหม่เหล่านั้นลงใน Cargo.lock ให้โดยอัตโนมัติ โดยค่าเริ่มต้น Cargo จะมองหาเฉพาะเวอร์ชันที่มากกว่า 0.10.1 แต่ยังน้อยกว่า 0.11.0 หากเครต rand มีการปล่อยเวอร์ชันใหม่ 2 รุ่น ได้แก่ 0.10.2 และ 0.999.0 เมื่อคุณรันคำสั่ง cargo update จะปรากฏข้อความดังนี้:
$ cargo update
    Updating crates.io index
     Locking 1 package to latest Rust 1.96.0 compatible version
    Updating rand v0.10.1 -> v0.10.2 (available: v0.999.0)
Cargo จะไม่ข้ามไปใช้เวอร์ชัน 0.999.0 และเมื่อตรวจดูในไฟล์ Cargo.lock คุณจะพบว่าเวอร์ชันของเครต rand ได้รับการปรับเป็น 0.10.2 เรียบร้อยแล้ว หากคุณต้องการเปลี่ยนไปใช้ rand เวอร์ชัน 0.999.0 หรือรุ่นใดๆ ในตระกูล 0.999.x คุณจะต้องเข้าไปแก้ไขไฟล์ Cargo.toml โดยตรงดังนี้ (โปรดอย่าเพิ่งแก้ไขตามนี้จริงๆ เนื่องจากตัวอย่างโค้ดถัดไปถูกเขียนขึ้นสำหรับ rand เวอร์ชัน 0.10):
[dependencies]
rand = "0.999.0"
เมื่อคุณสั่งรัน cargo build ในครั้งต่อไป Cargo จะอัปเดตข้อมูลเรจิสทรีและประเมินข้อกำหนดของ rand ใหม่ตามเวอร์ชันที่คุณระบุ
ยังมีรายละเอียดอีกมากมายเกี่ยวกับ Cargo และระบบนิเวศของมัน ซึ่งเราจะได้เจาะลึกกันในบทที่ 14 แต่สำหรับตอนนี้ เท่านี้ก็เพียงพอแล้วสำหรับการเริ่มต้น Cargo ช่วยให้การนำไลบรารีภายนอกมาใช้งานเป็นเรื่องง่ายดาย ส่งผลให้นักพัฒนา Rust นิยมแยกโครงสร้างโปรเจกต์ออกเป็นแพ็กเกจย่อยๆ ที่ประกอบเข้าด้วยกันได้อย่างลงตัว
การสร้างตัวเลขสุ่ม
มาเริ่มใช้งาน rand เพื่อสร้างตัวเลขสำหรับทายกัน ขั้นตอนถัดไปคือการอัปเดตไฟล์ src/main.rs ตามลิสติ้ง 2-3
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");
}
ขั้นแรก เราเพิ่มบรรทัด use rand::prelude::*; เข้ามา โดยมอดูล prelude จะรวบรวมฟังก์ชันและเทรตที่นิยมใช้งานบ่อยที่สุดของเครต rand ไว้ และคำสั่ง use จะช่วยนำรายการเหล่านั้นเข้ามาสู่สโคปของโปรแกรมเพื่อให้พร้อมเรียกใช้ได้ทันที
ถัดมา เราเพิ่มโค้ดอีก 2 บรรทัดในฟังก์ชัน main บรรทัดแรกคือการเรียกฟังก์ชัน rand::rng ซึ่งจะส่งกลับตัวสร้างตัวเลขสุ่ม (random number generator) เฉพาะตัวที่เราจะใช้งาน ซึ่งทำงานอยู่ภายในเธรด (thread) ปัจจุบัน และได้รับการกำหนดค่าตั้งต้น (seed) มาจากระบบปฏิบัติการ จากนั้นเราจึงเรียกเมธอด random_range บนตัวสร้างตัวเลขสุ่มดังกล่าว โดยเมธอดนี้ถูกนิยามไว้ในเทรต RngExt ซึ่งเป็นส่วนหนึ่งของมอดูล rand::prelude ที่เรานำเข้ามาด้วย use rand::prelude::*; นั่นเอง เมธอด random_range จะรับนิพจน์แบบช่วง (range expression) เข้ามาเป็นอาร์กิวเมนต์ เพื่อสร้างตัวเลขสุ่มที่อยู่ภายในขอบเขตนั้น นิพจน์แบบช่วงที่เราเลือกใช้ในที่นี้อยู่ในรูปแบบ start..=end ซึ่งนับรวมทั้งค่าขอบเขตล่างและขอบเขตบนด้วย ดังนั้นการระบุ 1..=100 จึงหมายถึงการขอตัวเลขสุ่มระหว่าง 1 ถึง 100
หมายเหตุ: ในการใช้งานจริง คงไม่มีใครสามารถจดจำได้ทั้งหมดว่าจะต้องนำเข้าสิ่งใดหรือเรียกใช้เมธอดไหนจากเครตภายนอก ด้วยเหตุนี้ เครตแต่ละตัวจึงมักจัดทำเอกสารคู่มือพร้อมตัวอย่างการใช้งานไว้อย่างละเอียด อีกหนึ่งฟีเจอร์ที่ยอดเยี่ยมของ Cargo คือคำสั่ง
cargo doc --openซึ่งจะทำการบิลด์เอกสารคู่มือของดีเพนเดนซีทั้งหมดในเครื่องของคุณ แล้วเปิดขึ้นมาบนเว็บเบราว์เซอร์ให้โดยอัตโนมัติ หากคุณสนใจศึกษาความสามารถอื่นๆ ของเครตrandสามารถรันคำสั่งcargo doc --openแล้วคลิกเลือกrandจากแถบเมนูด้านซ้ายเพื่ออ่านเพิ่มเติมได้ทันที
บรรทัดถัดมาคือการสั่งพิมพ์ตัวเลขลับออกมาทางหน้าจอ ซึ่งมีประโยชน์อย่างยิ่งในระหว่างขั้นตอนการพัฒนาและทดสอบโค้ด แต่เราจะลบบรรทัดนี้ออกในเวอร์ชันสุดท้าย เพราะคงไม่สนุกเท่าไรหากเกมเฉลยคำตอบออกมาตั้งแต่เริ่มเล่น!
ลองสั่งรันโปรแกรมดูสักสองสามครั้ง:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.02s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 7
Please input your guess.
4
You guessed: 4

$ cargo run
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.02s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 83
Please input your guess.
5
You guessed: 5
คุณควรจะได้ตัวเลขสุ่มที่ไม่ซ้ำกันในแต่ละรอบ และทุกค่าต้องอยู่ระหว่าง 1 ถึง 100 หากมีข้อความแจ้งเตือน (warning) ปรากฏขึ้น สามารถมองข้ามไปก่อนได้ แต่หากพบข้อผิดพลาด กรุณาตรวจสอบให้แน่ใจว่าได้ระบุ rand = "0.10.1" ไว้ใน Cargo.toml เรียบร้อยแล้ว เนื่องจากเวอร์ชันใหม่ในอนาคตของ rand อาจมีการเปลี่ยนแปลง API แต่เวอร์ชันใดๆ ในตระกูล 0.10 จะยังคงทำงานร่วมกับโค้ดในบทนี้ได้อย่างสมบูรณ์
การเปรียบเทียบคำทายกับตัวเลขลับ
เมื่อเรามีทั้งข้อมูลอินพุตจากผู้เล่นและตัวเลขสุ่มแล้ว ขั้นต่อไปคือการนำค่าทั้งสองมาเปรียบเทียบกัน ดังที่แสดงในลิสติ้ง 2-4 โปรดทราบว่าโค้ดชุดนี้จะยังคอมไพล์ไม่ผ่านในตอนนี้ ซึ่งเราจะอธิบายสาเหตุให้เข้าใจในลำดับถัดไป
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    // --snip--
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    println!("Please input your guess.");

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    println!("You guessed: {guess}");

    match guess.cmp(&secret_number) {
        Ordering::Less => println!("Too small!"),
        Ordering::Greater => println!("Too big!"),
        Ordering::Equal => println!("You win!"),
    }
}
อันดับแรก เราเพิ่มคำสั่ง use อีกหนึ่งรายการ เพื่อนำชนิดข้อมูล std::cmp::Ordering จากไลบรารีมาตรฐานเข้ามาสู่สโคป ชนิด Ordering เป็น enum อีกตัวหนึ่งที่มีวาเรียนต์ให้ใช้งาน 3 ค่า ได้แก่ Less, Greater และ Equal ซึ่งเป็นผลลัพธ์ที่เป็นไปได้ทั้งหมดเมื่อนำค่าสองค่ามาเปรียบเทียบกัน
จากนั้น เราเพิ่มโค้ดใหม่อีก 5 บรรทัดที่ด้านล่างซึ่งมีการเรียกใช้ชนิด Ordering โดยเมธอด cmp จะเปรียบเทียบค่าสองค่าเข้าด้วยกัน และสามารถเรียกใช้ได้กับข้อมูลทุกชนิดที่รองรับการเปรียบเทียบ เมธอดนี้จะรับเรเฟอเรนซ์ของค่าที่ต้องการเปรียบเทียบด้วยเข้ามาเป็นอาร์กิวเมนต์ ในที่นี้คือการนำ guess ไปเปรียบเทียบกับ secret_number แล้วส่งคืนวาเรียนต์ของ enum Ordering ที่เรานำเข้ามาด้วยคำสั่ง use กลับออกมา เราจะใช้นิพจน์ match ในการตัดสินใจว่าควรทำสิ่งใดต่อไป โดยพิจารณาจากวาเรียนต์ของ Ordering ที่ได้จากการเปรียบเทียบค่าระหว่าง guess กับ secret_number
นิพจน์ match ประกอบด้วย_อาร์ม_หรือกิ่งกรณี (arms) หลายๆ กิ่ง โดยในแต่ละอาร์มจะประกอบด้วย_รูปแบบ_ (pattern) ที่ใช้สำหรับจับคู่เงื่อนไข และโค้ดที่จะทำงานหากค่านั้นตรงกับรูปแบบดังกล่าว คอมไพเลอร์ Rust จะนำค่าที่ส่งให้ match มาตรวจสอบเปรียบเทียบกับรูปแบบของแต่ละอาร์มเรียงตามลำดับจากบนลงล่าง ทั้งนี้ รูปแบบและโครงสร้าง match ถือเป็นฟีเจอร์อันทรงพลังอย่างยิ่งของ Rust เพราะช่วยให้คุณสามารถครอบคลุมทุกสถานการณ์ที่โค้ดอาจพบเจอได้อย่างรอบคอบ และมั่นใจได้ว่าจะไม่มีกรณีใดถูกละเลย ซึ่งเราจะกล่าวถึงฟีเจอร์เหล่านี้อย่างละเอียดในบทที่ 6 และบทที่ 19 ตามลำดับ
ลองมาติดตามการทำงานของนิพจน์ match ในตัวอย่างนี้กัน สมมติว่าผู้เล่นทายเลข 50 และตัวเลขลับที่สุ่มได้ในรอบนี้คือ 38
เมื่อโปรแกรมนำ 50 ไปเปรียบเทียบกับ 38 เมธอด cmp จะส่งค่า Ordering::Greater กลับมา เนื่องจาก 50 มีค่ามากกว่า 38 นิพจน์ match จึงได้รับค่า Ordering::Greater แล้วเริ่มตรวจสอบรูปแบบในแต่ละอาร์ม โดยเริ่มจากอาร์มแรกคือ Ordering::Less ซึ่งพบว่าไม่ตรงกัน จึงข้ามไปยังอาร์มถัดไป รูปแบบของอาร์มถัดมาคือ Ordering::Greater ซึ่ง_ตรงกัน_พอดีกับค่าที่ได้รับ! โค้ดในอาร์มนั้นจึงเริ่มทำงานและพิมพ์ข้อความ Too big! ออกทางหน้าจอ เมื่อการจับคู่ในนิพจน์ match สำเร็จเรียบร้อยแล้ว การทำงานของโครงสร้าง match จะสิ้นสุดลงทันที จึงไม่มีการตรวจสอบอาร์มที่เหลือต่อในสถานการณ์นี้
อย่างไรก็ดี โค้ดในลิสติ้ง 2-4 ยังคอมไพล์ไม่ผ่านในตอนนี้ ลองสั่งคอมไพล์เพื่อดูผลลัพธ์กัน:
$ cargo build
   Compiling libc v0.2.186
   Compiling rand_core v0.10.1
   Compiling cfg-if v1.0.0
   Compiling getrandom v0.4.3
   Compiling chacha20 v0.10.1
   Compiling rand v0.10.1
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
error[E0308]: mismatched types
  --> src/main.rs:23:21
   |
23 |     match guess.cmp(&secret_number) {
   |                 --- ^^^^^^^^^^^^^^ expected `&String`, found `&{integer}`
   |                 |
   |                 arguments to this method are incorrect
   |
   = note: expected reference `&String`
              found reference `&{integer}`
note: method defined here
  --> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/cmp.rs:1000:7

For more information about this error, try `rustc --explain E0308`.
error: could not compile `guessing_game` (bin "guessing_game") due to 1 previous error
ใจความสำคัญของข้อผิดพลาดระบุว่าเกิดปัญหา_ชนิดข้อมูลไม่ตรงกัน_ (mismatched types) เนื่องจาก Rust เป็นภาษาที่มีระบบชนิดข้อมูลแบบสแตติกที่เข้มงวด (strongly typed) อย่างไรก็ตาม Rust ก็มีระบบอนุมานชนิดข้อมูล (type inference) ที่ชาญฉลาด เมื่อเราเขียน let mut guess = String::new() คอมไพเลอร์สามารถอนุมานได้เองว่า guess ควรเป็นชนิด String จึงไม่ได้บังคับให้เราต้องระบุชนิดข้อมูลด้วยตนเอง ในทางตรงกันข้าม ตัวแปร secret_number มีชนิดข้อมูลเป็นตัวเลข ซึ่ง Rust มีชนิดข้อมูลตัวเลขหลายแบบที่สามารถเก็บค่า 1 ถึง 100 ได้ เช่น i32 (จำนวนเต็ม 32 บิตแบบมีเครื่องหมาย), u32 (จำนวนเต็ม 32 บิตแบบไม่มีเครื่องหมาย), i64 (จำนวนเต็ม 64 บิต) และอื่นๆ หากเราไม่ได้ระบุไว้เป็นอย่างอื่น Rust จะกำหนดให้เป็นชนิด i32 ตามค่าเริ่มต้น ซึ่งทำให้ secret_number มีชนิดเป็น i32 เว้นแต่เราจะใส่ข้อมูลชนิดอื่นที่ทำให้คอมไพเลอร์อนุมานเป็นชนิดอื่นแทน สาเหตุของข้อผิดพลาดในครั้งนี้จึงเกิดจากการที่ Rust ไม่อนุญาตให้นำสตริง (String) มาเปรียบเทียบกับชนิดข้อมูลตัวเลขโดยตรงได้นั่นเอง
ดังนั้น เราจึงต้องแปลงค่า String ที่อ่านเข้ามาจากผู้ใช้ให้กลายเป็นชนิดข้อมูลตัวเลขเสียก่อน เพื่อให้สามารถนำไปเปรียบเทียบเชิงตัวเลขกับ secret_number ได้ เราทำสิ่งนี้ได้โดยการเพิ่มบรรทัดต่อไปนี้เข้าไปในฟังก์ชัน main:
ชื่อไฟล์: src/main.rs
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    println!("Please input your guess.");

    // --snip--

    let mut guess = String::new();

    io::stdin()
        .read_line(&mut guess)
        .expect("Failed to read line");

    let guess: u32 = guess.trim().parse().expect("Please type a number!");

    println!("You guessed: {guess}");

    match guess.cmp(&secret_number) {
        Ordering::Less => println!("Too small!"),
        Ordering::Greater => println!("Too big!"),
        Ordering::Equal => println!("You win!"),
    }
}
บรรทัดที่เพิ่มเข้ามาคือ:
let guess: u32 = guess.trim().parse().expect("Please type a number!");เราประกาศตัวแปรชื่อ guess ขึ้นมาใหม่อีกครั้ง แต่โปรแกรมของเรามีตัวแปรชื่อ guess อยู่แล้วไม่ใช่หรือ? ใช่แล้ว! แต่ใน Rust เรามีความสามารถในการประกาศตัวแปรใหม่ที่มีชื่อซ้ำกับตัวแปรเดิมได้ ซึ่งเรียกว่า_การบดบังตัวแปร_ (shadowing) ฟีเจอร์นี้ช่วยให้เราสามารถนำชื่อตัวแปร guess กลับมาใช้ซ้ำได้ โดยไม่ต้องคอยตั้งชื่อตัวแปรใหม่ที่ไม่ซ้ำกัน เช่น guess_str กับ guess เราจะกล่าวถึงเรื่องนี้โดยละเอียดในบทที่ 3 แต่สำหรับตอนนี้ ให้จำไว้ว่าฟีเจอร์นี้มักถูกนำมาใช้บ่อยครั้งเมื่อเราต้องการแปลงค่าจากชนิดข้อมูลหนึ่งไปเป็นอีกชนิดหนึ่ง
เราผูกตัวแปรใหม่นี้เข้ากับผลลัพธ์ของนิพจน์ guess.trim().parse() โดย guess ในนิพจน์นี้หมายถึงตัวแปร guess ตัวเดิมที่เก็บสตริงอินพุตไว้ เมธอด trim บนอินสแตนซ์ของ String จะช่วยตัดช่องว่างทั้งหมดที่อยู่บริเวณหัวและท้ายข้อความออก ซึ่งจำเป็นต้องทำก่อนจะแปลงสตริงไปเป็น u32 ที่รองรับเฉพาะตัวเลขเท่านั้น เนื่องจากเวลาที่ผู้ใช้พิมพ์ตัวเลขแล้วกด Enter เมธอด read_line จะบันทึกอักขระขึ้นบรรทัดใหม่ติดมาด้วยเสมอ ตัวอย่างเช่น หากผู้ใช้พิมพ์ 5 แล้วกด Enter ตัวแปร guess จะมีค่าเป็น 5\n (บน Windows การกด Enter จะให้ผลเป็น carriage return และ newline คือ \r\n) เมธอด trim จึงทำหน้าที่ตัด \n หรือ \r\n ทิ้งไป ทำให้เหลือเพียงข้อความ 5 เท่านั้น
เมธอด parse บนสตริง ทำหน้าที่แปลงข้อความสตริงให้เป็นชนิดข้อมูลอื่น ในกรณีนี้ เราใช้เพื่อแปลงสตริงเป็นตัวเลข โดยเราต้องระบุชนิดข้อมูลตัวเลขที่ต้องการให้ชัดเจนด้วย let guess: u32 เครื่องหมายโคลอน (:) หลังชื่อ guess จะบอกคอมไพเลอร์ว่าเรากำลังระบุชนิดข้อมูล (type annotation) ให้กับตัวแปร ทั้งนี้ Rust มีชนิดข้อมูลตัวเลขพื้นฐานหลายประเภท โดย u32 คือจำนวนเต็ม 32 บิตแบบไม่มีเครื่องหมาย ซึ่งเหมาะอย่างยิ่งสำหรับเก็บตัวเลขจำนวนเต็มบวกขนาดเล็ก คุณจะได้ศึกษาชนิดตัวเลขอื่นๆ เพิ่มเติมในบทที่ 3
นอกจากนี้ การระบุชนิด u32 ให้กับตัวแปรและนำไปเปรียบเทียบกับ secret_number ยังส่งผลให้คอมไพเลอร์ Rust อนุมานให้ secret_number มีชนิดข้อมูลเป็น u32 ตามไปด้วยโดยอัตโนมัติ ทำให้ตอนนี้การเปรียบเทียบเกิดขึ้นระหว่างค่าของชนิดข้อมูลเดียวกันแล้ว!
เนื่องจากเมธอด parse จะแปลงค่าได้สำเร็จเฉพาะกับข้อความที่เป็นตัวเลขจริงๆ เท่านั้น การเรียกใช้จึงมีโอกาสเกิดข้อผิดพลาดได้ง่าย เช่น หากสตริงมีข้อความอย่าง A👍% เมธอดนี้จะไม่สามารถแปลงเป็นตัวเลขได้ ด้วยเหตุนี้ parse จึงส่งผลลัพธ์กลับมาเป็นชนิด Result เช่นเดียวกับที่เมธอด read_line ทำ (ดังที่ได้อธิบายไว้ในหัวข้อ “การจัดการความล้มเหลวที่อาจเกิดขึ้นด้วย Result”) เราจึงสามารถจัดการผลลัพธ์ของ Result ได้ด้วยวิธีเดิม นั่นคือการเรียกเมธอด expect หาก parse ส่งคืนวาเรียนต์ Err เนื่องจากแปลงตัวเลขไม่สำเร็จ เมธอด expect จะทำให้โปรแกรมหยุดทำงานพร้อมแสดงข้อความเตือนที่เรากำหนดไว้ แต่หาก parse แปลงสตริงเป็นตัวเลขได้สำเร็จ จะส่งคืนวาเรียนต์ Ok และ expect จะดึงค่าตัวเลขที่อยู่ภายในออกมาให้เรานำไปใช้งานต่อได้อย่างราบรื่น
มาลองสั่งรันโปรแกรมดูอีกครั้ง:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.26s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 58
Please input your guess.
  76
You guessed: 76
Too big!
ยอดเยี่ยมมาก! แม้ว่าผู้ใช้จะเผลอเคาะเว้นวรรคไว้หน้าตัวเลข โปรแกรมก็ยังคงฉลาดพอที่จะตัดช่องว่างออกและทราบว่าผู้ใช้ทายเลข 76 ลองทดสอบรันโปรแกรมหลายๆ ครั้งด้วยข้อมูลที่หลากหลายดู เช่น ทายเลขที่ถูกต้อง ทายเลขที่มากเกินไป และทายเลขที่น้อยเกินไป
ถึงตอนนี้ ส่วนประกอบหลักของเกมทำงานได้เกือบสมบูรณ์แล้ว ขาดเพียงแต่ผู้เล่นยังสามารถทายตัวเลขได้เพียงครั้งเดียวเท่านั้น เรามาแก้ไขจุดนี้ด้วยการเพิ่มลูป (loop) กัน!
รองรับการทายหลายครั้งด้วยลูป
คำสงวน loop ใช้สำหรับสร้างลูปที่ทำงานวนซ้ำอย่างไม่รู้จบ เราจะนำลูปนี้มาใช้เพื่อเปิดโอกาสให้ผู้เล่นสามารถทายตัวเลขซ้ำได้เรื่อยๆ:
ชื่อไฟล์: src/main.rs
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    // --snip--

    println!("The secret number is: {secret_number}");

    loop {
        println!("Please input your guess.");

        // --snip--


        let mut guess = String::new();

        io::stdin()
            .read_line(&mut guess)
            .expect("Failed to read line");

        let guess: u32 = guess.trim().parse().expect("Please type a number!");

        println!("You guessed: {guess}");

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("Too small!"),
            Ordering::Greater => println!("Too big!"),
            Ordering::Equal => println!("You win!"),
        }
    }
}
ดังที่คุณเห็น เราได้ย้ายคำสั่งทั้งหมดตั้งแต่การแจ้งให้ป้อนคำทายเป็นต้นไปเข้ามาไว้ภายในลูป อย่าลืมจัดย่อหน้าเว้นวรรคเพิ่มอีก 4 ช่องสำหรับโค้ดที่อยู่ภายในลูป แล้วลองสั่งรันโปรแกรมใหม่อีกครั้ง คราวนี้โปรแกรมจะวนถามคำทายไปเรื่อยๆ อย่างไม่มีที่สิ้นสุด ซึ่งทำให้เราพบปัญหาใหม่ นั่นคือผู้เล่นไม่สามารถออกจากเกมได้เลย!
แม้ว่าผู้เล่นจะสามารถสั่งหยุดโปรแกรมได้เสมอด้วยคีย์ลัด Ctrl-C แต่ก็ยังมีอีกวิธีหนึ่งที่จะหลุดออกจากวงวนที่ไม่สิ้นสุดนี้ได้ นั่นคือสิ่งที่เราได้กล่าวไว้ในหัวข้อ “การเปรียบเทียบคำทายกับตัวเลขลับ” ว่าหากผู้ใช้ป้อนข้อมูลที่ไม่ใช่ตัวเลข โปรแกรมจะหยุดทำงานทันที เราสามารถใช้ประโยชน์จากพฤติกรรมนี้เพื่อให้ผู้เล่นออกจากเกมได้ ดังตัวอย่างนี้:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.23s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 59
Please input your guess.
45
You guessed: 45
Too small!
Please input your guess.
60
You guessed: 60
Too big!
Please input your guess.
59
You guessed: 59
You win!
Please input your guess.
quit

thread 'main' (6694925) panicked at src/main.rs:28:47:
Please type a number!: ParseIntError { kind: InvalidDigit }
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
การพิมพ์คำว่า quit ช่วยให้เราออกจากเกมได้ แต่การป้อนข้อความอื่นๆ ที่ไม่ใช่ตัวเลขก็ทำให้เกิดผลแบบเดียวกัน ซึ่งวิธีนี้อาจดูไม่ค่อยเรียบร้อยเท่าใดนัก และเราต้องการให้เกมสามารถจบการทำงานได้อย่างสง่างามเมื่อผู้เล่นทายตัวเลขได้ถูกต้องอีกด้วย
ออกจากเกมเมื่อทายถูก
มาปรับปรุงให้เกมจบการทำงานโดยอัตโนมัติเมื่อผู้เล่นชนะ ด้วยการเพิ่มคำสั่ง break:
ชื่อไฟล์: src/main.rs
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    loop {
        println!("Please input your guess.");

        let mut guess = String::new();

        io::stdin()
            .read_line(&mut guess)
            .expect("Failed to read line");

        let guess: u32 = guess.trim().parse().expect("Please type a number!");

        println!("You guessed: {guess}");

        // --snip--

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("Too small!"),
            Ordering::Greater => println!("Too big!"),
            Ordering::Equal => {
                println!("You win!");
                break;
            }
        }
    }
}
การใส่คำสั่ง break ต่อท้ายข้อความ You win! จะสั่งให้โปรแกรมกระโดดออกจากลูปทันทีเมื่อผู้เล่นทายตัวเลขลับได้ถูกต้อง และเนื่องจากลูปนี้เป็นคำสั่งส่วนสุดท้ายในฟังก์ชัน main การออกจากลูปจึงทำให้โปรแกรมจบการทำงานไปโดยปริยาย
การจัดการกับอินพุตที่ไม่ถูกต้อง
เพื่อยกระดับประสบการณ์การเล่นเกมให้ดียิ่งขึ้น แทนที่จะปล่อยให้โปรแกรมแครชหยุดทำงานเมื่อผู้เล่นป้อนข้อความที่ไม่ใช่ตัวเลข เรามาปรับให้โปรแกรมมองข้ามอินพุตที่ไม่ถูกต้องเหล่านั้น แล้วเปิดโอกาสให้ผู้เล่นป้อนคำทายใหม่ต่อไปได้ โดยแก้ไขบรรทัดที่แปลงค่า guess จาก String ไปเป็น u32 ตามลิสติ้ง 2-5
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    println!("The secret number is: {secret_number}");

    loop {
        println!("Please input your guess.");

        let mut guess = String::new();

        // --snip--

        io::stdin()
            .read_line(&mut guess)
            .expect("Failed to read line");

        let guess: u32 = match guess.trim().parse() {
            Ok(num) => num,
            Err(_) => continue,
        };

        println!("You guessed: {guess}");

        // --snip--

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("Too small!"),
            Ordering::Greater => println!("Too big!"),
            Ordering::Equal => {
                println!("You win!");
                break;
            }
        }
    }
}
เราเปลี่ยนจากการเรียกใช้ expect มาใช้นิพจน์ match แทน เพื่อเปลี่ยนจากการหยุดทำงานเมื่อเกิดข้อผิดพลาด มาเป็นการควบคุมและจัดการข้อผิดพลาดด้วยตนเอง จำได้ไหมว่า parse จะส่งผลลัพธ์เป็นชนิด Result ซึ่งเป็น enum ที่มีวาเรียนต์คือ Ok และ Err เราจึงสามารถใช้ match เพื่อตรวจสอบผลลัพธ์ได้ในลักษณะเดียวกับที่เราเคยทำกับผลลัพธ์ Ordering จากเมธอด cmp
หาก parse แปลงสตริงเป็นตัวเลขได้สำเร็จ จะส่งคืนค่า Ok ที่บรรจุตัวเลขผลลัพธ์ไว้ ซึ่งจะตรงกับรูปแบบในอาร์มแรกของ match และทำให้นิพจน์ match ส่งคืนค่า num ที่ได้ออกมา ค่าตัวเลขนั้นจึงถูกนำไปจัดเก็บไว้ในตัวแปร guess ตัวใหม่ที่เราสร้างขึ้นได้อย่างสมบูรณ์
แต่หาก parse _ไม่_สามารถแปลงสตริงเป็นตัวเลขได้ จะส่งคืนค่า Err ที่บรรจุรายละเอียดของข้อผิดพลาดออกมา ซึ่งค่า Err นี้จะไม่ตรงกับรูปแบบ Ok(num) ในอาร์มแรก แต่จะไปตรงกับรูปแบบ Err(_) ในอาร์มที่สองแทน โดยสัญลักษณ์ขีดล่าง _ ทำหน้าที่เป็นรูปแบบที่จับคู่ได้กับทุกค่า (catch-all) ในตัวอย่างนี้เราบอกว่าต้องการจับคู่กับค่า Err ทั้งหมดโดยไม่สนใจว่าภายในจะมีข้อมูลข้อผิดพลาดอะไรอยู่ จากนั้นโปรแกรมจะรันคำสั่งในอาร์มที่สอง นั่นคือ continue ซึ่งสั่งให้ข้ามไปยังรอบการวนซ้ำ (iteration) ถัดไปของ loop ทันที และแสดงข้อความขอคำทายใหม่อีกครั้ง ทำให้โปรแกรมสามารถมองข้ามข้อมูลที่ไม่ถูกต้องได้อย่างนุ่มนวลโดยไม่หยุดทำงานกะทันหัน!
ตอนนี้ ทุกฟังก์ชันการทำงานของเกมควรพร้อมใช้งานอย่างสมบูรณ์แล้ว ลองสั่งรันโปรแกรมดู:
$ cargo run
   Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.13s
     Running `target/debug/guessing_game`
Guess the number!
The secret number is: 61
Please input your guess.
10
You guessed: 10
Too small!
Please input your guess.
99
You guessed: 99
Too big!
Please input your guess.
foo
Please input your guess.
61
You guessed: 61
You win!
ยอดเยี่ยมมาก! เหลือเพียงการปรับแต่งเล็กๆ อีกข้อเดียวเพื่อให้เกมของเราเสร็จสมบูรณ์อย่างแท้จริง จำได้ไหมว่าโปรแกรมยังคงพิมพ์ตัวเลขลับออกมาให้เห็นอยู่ ซึ่งมีประโยชน์ในตอนพัฒนา แต่ทำให้ตัวเกมขาดความท้าทาย เรามาลบคำสั่ง println! ที่แสดงตัวเลขลับออกกัน โดยลิสติ้ง 2-6 แสดงโค้ดฉบับสมบูรณ์ของเกมนี้
use std::cmp::Ordering;
use std::io;

use rand::prelude::*;

fn main() {
    println!("Guess the number!");

    let secret_number = rand::rng().random_range(1..=100);

    loop {
        println!("Please input your guess.");

        let mut guess = String::new();

        io::stdin()
            .read_line(&mut guess)
            .expect("Failed to read line");

        let guess: u32 = match guess.trim().parse() {
            Ok(num) => num,
            Err(_) => continue,
        };

        println!("You guessed: {guess}");

        match guess.cmp(&secret_number) {
            Ordering::Less => println!("Too small!"),
            Ordering::Greater => println!("Too big!"),
            Ordering::Equal => {
                println!("You win!");
                break;
            }
        }
    }
}
มาถึงตรงนี้ คุณได้สร้างโปรเจกต์เกมทายตัวเลขด้วยภาษา Rust ได้สำเร็จเรียบร้อยแล้ว ขอแสดงความยินดีด้วยอย่างยิ่ง!
สรุป
โปรเจกต์นี้เป็นการปูพื้นฐานภาคปฏิบัติที่ช่วยแนะนำให้คุณรู้จักกับแนวคิดใหม่ๆ มากมายในภาษา Rust เช่น คำสั่ง let, match, ฟังก์ชัน, การเรียกใช้งานเครตภายนอก และอื่นๆ อีกมากมาย ในบทต่อๆ ไป คุณจะได้ศึกษาแต่ละแนวคิดเหล่านี้ในมิติที่ลึกซึ้งยิ่งขึ้น โดยในบทที่ 3 จะครอบคลุมแนวคิดพื้นฐานที่มีในภาษาโปรแกรมทั่วไป เช่น ตัวแปร, ชนิดข้อมูล (data types) และฟังก์ชัน พร้อมแสดงวิธีเขียนสิ่งเหล่านี้ใน Rust บทที่ 4 จะพาไปเจาะลึกระบบสิทธิ์ความเป็นเจ้าของ (ownership) ซึ่งเป็นฟีเจอร์อันโดดเด่นที่ทำให้ Rust แตกต่างจากภาษาอื่นๆ บทที่ 5 จะอธิบาย struct และเมธอด ส่วนบทที่ 6 จะอธิบายการทำงานของ enum อย่างละเอียด
แนวคิดพื้นฐานของการเขียนโปรแกรม
บทนี้ครอบคลุมแนวคิดพื้นฐานที่ปรากฏในภาษาโปรแกรมแทบทุกภาษา พร้อมอธิบายการทำงานของแนวคิดเหล่านั้นในบริบทของภาษา Rust แม้ว่าแนวคิดต่างๆ ในบทนี้จะไม่ได้มีเฉพาะใน Rust เพียงภาษาเดียว แต่เราจะมาสำรวจแนวคิดเหล่านั้นพร้อมทั้งอธิบายธรรมเนียมปฏิบัติและแนวทางการใช้งานที่เป็นแบบฉบับของ Rust
โดยเฉพาะอย่างยิ่ง คุณจะได้เรียนรู้เกี่ยวกับตัวแปร, ชนิดข้อมูลพื้นฐาน, ฟังก์ชัน, คอมเมนต์ และการควบคุมทิศทางการทำงานของโปรแกรม (control flow) พื้นฐานเหล่านี้คือรากฐานสำคัญในทุกโปรแกรมของ Rust และการทำความเข้าใจสิ่งเหล่านี้ตั้งแต่เริ่มต้นจะช่วยสร้างพื้นฐานที่มั่นคงสำหรับการก้าวต่อไป
คำสงวน
เช่นเดียวกับภาษาโปรแกรมอื่นๆ ภาษา Rust มีชุดของ_คำสงวน_ (keywords) ที่สงวนไว้สำหรับการทำงานของภาษาโดยเฉพาะ ซึ่งคุณจะไม่สามารถนำคำเหล่านี้ไปใช้เป็นชื่อตัวแปรหรือชื่อฟังก์ชันได้ คำสงวนส่วนใหญ่มีความหมายเฉพาะตัวและใช้สำหรับสั่งการทำงานต่างๆ ในโปรแกรม Rust ของคุณ ขณะที่คำสงวนบางคำยังไม่ได้เปิดให้ใช้งานในปัจจุบัน แต่ถูกจองไว้สำหรับฟังก์ชันใหม่ๆ ที่อาจเพิ่มเข้ามาในอนาคต สามารถตรวจสอบรายชื่อคำสงวนทั้งหมดได้ที่ภาคผนวก A
ตัวแปรและความสามารถในการเปลี่ยนแปลงค่า
ตัวแปรและความสามารถในการเปลี่ยนแปลงค่า
ดังที่ได้อธิบายไว้ในหัวข้อ “การเก็บค่าด้วยตัวแปร” ตัวแปรใน Rust จะเป็นแบบเปลี่ยนแปลงค่าไม่ได้ (immutable) โดยค่าเริ่มต้น นี่เป็นหนึ่งในการส่งเสริมแนวทางของ Rust เพื่อช่วยให้คุณเขียนโค้ดที่ได้รับประโยชน์จากความปลอดภัยและการจัดการการทำงานพร้อมกัน (concurrency) ได้อย่างง่ายดาย อย่างไรก็ตาม คุณยังคงมีทางเลือกในการกำหนดให้ตัวแปรสามารถเปลี่ยนแปลงค่าได้ (mutable) มาสำรวจกันว่า Rust สนับสนุนให้คุณเลือกใช้ตัวแปรแบบเปลี่ยนแปลงค่าไม่ได้อย่างไรและด้วยเหตุผลใด ตลอดจนเหตุใดในบางสถานการณ์คุณจึงอาจจำเป็นต้องปรับให้เปลี่ยนแปลงค่าได้
เมื่อตัวแปรเป็นแบบเปลี่ยนแปลงค่าไม่ได้ เมื่อผูกค่าเข้ากับชื่อตัวแปรแล้ว คุณจะไม่สามารถแก้ไขค่านั้นได้อีก เพื่อทำความเข้าใจเรื่องนี้ ให้สร้างโปรเจกต์ใหม่ชื่อว่า variables ในไดเรกทอรี projects ของคุณด้วยคำสั่ง cargo new variables
จากนั้น สลับเข้าไปยังไดเรกทอรี variables เปิดไฟล์ src/main.rs แล้วแทนที่โค้ดเดิมด้วยโค้ดต่อไปนี้ ซึ่งจะยังคอมไพล์ไม่ผ่านในตอนนี้:
ชื่อไฟล์: src/main.rs
fn main() {
    let x = 5;
    println!("The value of x is: {x}");
    x = 6;
    println!("The value of x is: {x}");
}
บันทึกไฟล์แล้วสั่งรันโปรแกรมด้วย cargo run คุณจะได้รับข้อความแจ้งข้อผิดพลาดเกี่ยวกับการพยายามแก้ไขค่าตัวแปรที่ไม่สามารถเปลี่ยนแปลงค่าได้ ดังที่แสดงในผลลัพธ์นี้:
$ cargo run
   Compiling variables v0.1.0 (file:///projects/variables)
error[E0384]: cannot assign twice to immutable variable `x`
 --> src/main.rs:4:5
  |
2 |     let x = 5;
  |         - first assignment to `x`
3 |     println!("The value of x is: {x}");
4 |     x = 6;
  |     ^^^^^ cannot assign twice to immutable variable
  |
help: consider making this binding mutable
  |
2 |     let mut x = 5;
  |         +++

For more information about this error, try `rustc --explain E0384`.
error: could not compile `variables` (bin "variables") due to 1 previous error
ตัวอย่างนี้แสดงให้เห็นว่าคอมไพเลอร์ช่วยคุณค้นหาข้อผิดพลาดในโปรแกรมได้อย่างไร แม้ว่าข้อความข้อผิดพลาดจากคอมไพเลอร์อาจทำให้รู้สึกท้อแท้ได้ในบางครั้ง แต่แท้จริงแล้วมันเพียงเตือนว่าโปรแกรมของคุณยังไม่สามารถทำงานได้อย่างปลอดภัยตามที่ต้องการเท่านั้น ไม่ได้หมายความว่าคุณเป็นโปรแกรมเมอร์ที่ไม่เก่งแต่อย่างใด! แม้แต่ชาว Rustacean ผู้เชี่ยวชาญก็ยังพบเจอข้อผิดพลาดจากคอมไพเลอร์อยู่เป็นประจำ
คุณได้รับข้อความแจ้งข้อผิดพลาด cannot assign twice to immutable variable `x` เนื่องจากคุณพยายามกำหนดค่าใหม่ให้กับตัวแปร x ที่เป็นแบบเปลี่ยนแปลงค่าไม่ได้เป็นครั้งที่สอง
สิ่งสำคัญคือ คอมไพเลอร์จะตรวจจับและแจ้งข้อผิดพลาดให้เราทราบตั้งแต่ตอนคอมไพล์ทันทีที่เราพยายามเปลี่ยนแปลงค่าที่ถูกกำหนดให้แก้ไขไม่ได้ เพื่อป้องกันไม่ให้เกิดบั๊กขึ้นในระบบ หากโค้ดส่วนหนึ่งทำงานบนสมมติฐานว่าค่านั้นจะไม่มีวันเปลี่ยนแปลง แต่โค้ดอีกส่วนหนึ่งกลับไปแก้ไขค่านั้น โค้ดส่วนแรกก็ย่อมมีโอกาสที่จะทำงานผิดพลาดไปจากที่ออกแบบไว้ได้ ซึ่งสาเหตุของบั๊กในลักษณะนี้มักยากต่อการแกะรอยภายหลัง โดยเฉพาะอย่างยิ่งหากโค้ดส่วนหลังเปลี่ยนค่าเพียง_บางครั้ง_เท่านั้น แต่คอมไพเลอร์ Rust รับประกันว่าเมื่อคุณระบุว่าค่าใดจะไม่เปลี่ยนแปลง ค่านั้นจะไม่เปลี่ยนแปลงจริงๆ คุณจึงไม่ต้องคอยกังวลและติดตามตรวจสอบด้วยตนเอง ทำให้โค้ดของคุณเข้าใจง่ายและไว้ใจได้ยิ่งขึ้น
อย่างไรก็ตาม ความสามารถในการเปลี่ยนแปลงค่า (mutability) ก็มีประโยชน์อย่างมากและช่วยให้เขียนโค้ดได้สะดวกขึ้นในหลายสถานการณ์ แม้ตัวแปรจะเป็นแบบเปลี่ยนแปลงค่าไม่ได้โดยค่าเริ่มต้น แต่คุณสามารถทำให้มันเปลี่ยนแปลงค่าได้โดยใส่คำว่า mut ไว้ข้างหน้าชื่อตัวแปร ดังที่คุณได้ทำในบทที่ 2 การใส่ mut ยังเป็นการสื่อเจตนาไปยังผู้ที่อ่านโค้ดในอนาคตได้อย่างชัดเจนว่า โค้ดส่วนอื่นๆ จะมีการเปลี่ยนแปลงค่าของตัวแปรนี้
ตัวอย่างเช่น ลองแก้ไขไฟล์ src/main.rs ให้เป็นดังนี้:
ชื่อไฟล์: src/main.rs
fn main() {
    let mut x = 5;
    println!("The value of x is: {x}");
    x = 6;
    println!("The value of x is: {x}");
}
เมื่อสั่งรันโปรแกรมตอนนี้ เราจะได้ผลลัพธ์ดังนี้:
$ cargo run
   Compiling variables v0.1.0 (file:///projects/variables)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.30s
     Running `target/debug/variables`
The value of x is: 5
The value of x is: 6
เมื่อใช้ mut เราจึงได้รับอนุญาตให้เปลี่ยนค่าที่ผูกอยู่กับ x จาก 5 ไปเป็น 6 ได้ ท้ายที่สุดแล้ว การตัดสินใจว่าจะให้ตัวแปรเปลี่ยนแปลงค่าได้หรือไม่นั้นขึ้นอยู่กับคุณและวิจารณญาณว่าสิ่งใดจะทำให้โค้ดมีความชัดเจนและปลอดภัยที่สุดในสถานการณ์นั้นๆ
การประกาศค่าคงที่
เช่นเดียวกับตัวแปรที่เปลี่ยนแปลงค่าไม่ได้ ค่าคงที่ (constant) คือค่าที่ผูกไว้กับชื่อและไม่อนุญาตให้เปลี่ยนแปลงค่า แต่มีข้อแตกต่างสำคัญระหว่างค่าคงที่กับตัวแปรอยู่สองสามประการ
ประการแรก คุณไม่สามารถใช้ mut ร่วมกับค่าคงที่ได้ ค่าคงที่ไม่เพียงแต่เปลี่ยนแปลงค่าไม่ได้โดยค่าเริ่มต้นเท่านั้น แต่เป็นสิ่งที่เปลี่ยนแปลงค่าไม่ได้ตลอดกาล คุณประกาศค่าคงที่โดยใช้คำสงวน const แทนคำว่า let และ_จำเป็นต้อง_ระบุชนิดข้อมูลกำกับไว้เสมอ เราจะกล่าวถึงชนิดข้อมูล (data types) และการระบุชนิดข้อมูล (type annotations) ในหัวข้อถัดไป “ชนิดข้อมูล” ดังนั้นจึงยังไม่ต้องกังวลกับรายละเอียดในตอนนี้ เพียงจำไว้ว่าต้องระบุชนิดข้อมูลให้ค่าคงที่เสมอ
ค่าคงที่สามารถประกาศได้ในทุกสโคป รวมถึงระดับโกลบอล (global scope) ซึ่งมีประโยชน์อย่างยิ่งสำหรับค่าที่โค้ดในหลายๆ ส่วนจำเป็นต้องเข้าถึงร่วมกัน
ข้อแตกต่างประการสุดท้ายคือ ค่าคงที่จะต้องถูกกำหนดค่าด้วยนิพจน์ค่าคงที่ (constant expression) เท่านั้น ไม่สามารถกำหนดด้วยผลลัพธ์ของค่าที่ต้องคำนวณขณะรันไทม์ (runtime)
ตัวอย่างการประกาศค่าคงที่:
#![allow(unused)]
fn main() {
const THREE_HOURS_IN_SECONDS: u32 = 60 * 60 * 3;
}
ชื่อของค่าคงที่นี้คือ THREE_HOURS_IN_SECONDS และถูกกำหนดค่าเป็นผลลัพธ์จากการคูณ 60 (วินาทีในหนึ่งนาที) ด้วย 60 (นาทีในหนึ่งชั่วโมง) และด้วย 3 (จำนวนชั่วโมงที่ต้องการคำนวณในโปรแกรมนี้) โดยธรรมเนียมการตั้งชื่อค่าคงที่ของ Rust คือการใช้ตัวพิมพ์ใหญ่ทั้งหมดและคั่นระหว่างคำด้วยเครื่องหมายขีดล่าง ทั้งนี้ คอมไพเลอร์สามารถคำนวณการดำเนินการทางคณิตศาสตร์พื้นฐานได้ตั้งแต่ตอนคอมไพล์ ทำให้เราเลือกเขียนที่มาของค่าออกมาอย่างชัดเจนและตรวจสอบได้ง่าย แทนที่จะต้องเขียนตัวเลข 10,800 ตรงๆ สามารถดูข้อมูลเพิ่มเติมเกี่ยวกับการดำเนินการที่รองรับได้จากหัวข้อเกี่ยวกับการประเมินค่าคงที่ใน Rust Reference
ค่าคงที่จะคงอยู่ตลอดระยะเวลาที่โปรแกรมทำงาน ภายในสโคปที่ได้ประกาศไว้ คุณสมบัตินี้ทำให้ค่าคงที่เหมาะอย่างยิ่งสำหรับค่าเฉพาะในโดเมนของแอปพลิเคชันที่หลายส่วนของโปรแกรมต้องทราบ เช่น คะแนนสูงสุดที่ผู้เล่นสามารถทำได้ หรือค่าคงที่ทางฟิสิกส์อย่างความเร็วแสง
การตั้งชื่อค่าที่กำหนดตายตัว (hardcoded values) ในโปรแกรมให้เป็นค่าคงที่ มีประโยชน์อย่างมากในการสื่อความหมายไปยังผู้ที่ดูแลโค้ดในอนาคต อีกทั้งยังช่วยให้มีจุดแก้ไขเพียงจุดเดียวในโค้ด หากค่านั้นจำเป็นต้องมีการปรับเปลี่ยนในภายหลัง
การบังเงา
ดังที่คุณได้เห็นในบทเรียนเกมทายตัวเลขในบทที่ 2 คุณสามารถประกาศตัวแปรใหม่ที่มีชื่อซ้ำกับตัวแปรก่อนหน้าได้ ชาว Rustacean เรียกสิ่งนี้ว่าตัวแปรแรก_ถูกบังเงาหรือบดบัง_ (shadowed) โดยตัวแปรที่สอง ซึ่งหมายความว่าคอมไพเลอร์จะมองเห็นตัวแปรที่สองเมื่อคุณเรียกใช้ชื่อตัวแปรนั้น ในทางปฏิบัติ ตัวแปรที่สองจะบดบังตัวแปรแรก โดยดึงการเรียกใช้ชื่อตัวแปรทั้งหมดมาเป็นของตนเอง จนกว่าตัวมันเองจะถูกบดบังซ้ำหรือจนกระทั่งสโคปนั้นสิ้นสุดลง เราสามารถทำแชโดวิงตัวแปรได้โดยใช้ชื่อตัวแปรเดิมและประกาศด้วยคำสงวน let ซ้ำอีกครั้ง ดังนี้:
ชื่อไฟล์: src/main.rs
fn main() {
    let x = 5;

    let x = x + 1;

    {
        let x = x * 2;
        println!("The value of x in the inner scope is: {x}");
    }

    println!("The value of x is: {x}");
}
โปรแกรมนี้เริ่มต้นด้วยการผูกค่า 5 เข้ากับ x จากนั้นสร้างตัวแปร x ตัวใหม่ขึ้นมาด้วย let x = โดยนำค่าเดิมมาบวก 1 ทำให้ค่าของ x กลายเป็น 6 ต่อมา ภายในสโคปย่อยด้านในที่สร้างขึ้นด้วยวงเล็บปีกกา คำสั่ง let ตัวที่สามก็ทำการบดบัง x และสร้างตัวแปรใหม่ขึ้นมาอีกตัว โดยนำค่าก่อนหน้ามาคูณด้วย 2 ทำให้ x ในสโคปนี้มีค่าเป็น 12 เมื่อสโคปย่อยนั้นสิ้นสุดลง การบดบังเฉพาะในสโคปก็จบลงตามไปด้วย ส่งผลให้ x กลับมามีค่าเป็น 6 เช่นเดิม เมื่อสั่งรันโปรแกรมนี้ จะได้ผลลัพธ์ดังนี้:
$ cargo run
   Compiling variables v0.1.0 (file:///projects/variables)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/variables`
The value of x in the inner scope is: 12
The value of x is: 6
การบดบังตัวแปร (shadowing) แตกต่างจากการกำหนดให้ตัวแปรเป็น mut เนื่องจากเราจะได้รับข้อผิดพลาดตั้งแต่ตอนคอมไพล์ หากเผลอไปกำหนดค่าใหม่ให้ตัวแปรโดยไม่ได้ใส่คำสงวน let การใช้ let ช่วยให้เราสามารถแปลงค่าของตัวแปรได้หลายครั้ง โดยที่ตัวแปรยังคงมีสถานะเปลี่ยนแปลงค่าไม่ได้ (immutable) หลังจากการแปลงค่านั้นเสร็จสิ้น
ความแตกต่างอีกประการระหว่าง mut กับการบดบังตัวแปรคือ เมื่อเราใช้คำสงวน let อีกครั้ง เรากำลังสร้างตัวแปรตัวใหม่ขึ้นมาจริงๆ จึงทำให้เราสามารถเปลี่ยนชนิดข้อมูลของค่าได้ในขณะที่ยังใช้ชื่อเดิม ตัวอย่างเช่น สมมติว่าโปรแกรมต้องการให้ผู้ใช้ระบุจำนวนช่องว่างระหว่างข้อความโดยพิมพ์อักขระเว้นวรรคเข้ามา แล้วเราต้องการแปลงอินพุตนั้นไปเก็บเป็นตัวเลข:
fn main() {
    let spaces = "   ";
    let spaces = spaces.len();
}
ตัวแปร spaces ตัวแรกมีชนิดข้อมูลเป็นสตริง ส่วนตัวแปร spaces ตัวที่สองมีชนิดข้อมูลเป็นตัวเลข การบดบังตัวแปรช่วยให้เราไม่ต้องตั้งชื่อตัวแปรที่แตกต่างกัน เช่น spaces_str และ spaces_num แต่สามารถใช้ชื่อ spaces ที่เรียบง่ายและเข้าใจตรงกันได้ซ้ำ อย่างไรก็ตาม หากเราพยายามใช้ mut สำหรับกรณีนี้ ดังตัวอย่างต่อไปนี้ จะทำให้เกิดข้อผิดพลาดขึ้นในตอนคอมไพล์:
fn main() {
    let mut spaces = "   ";
    spaces = spaces.len();
}
ข้อผิดพลาดจะระบุชัดเจนว่าเราไม่ได้รับอนุญาตให้เปลี่ยนชนิดข้อมูลของตัวแปร:
$ cargo run
   Compiling variables v0.1.0 (file:///projects/variables)
error[E0308]: mismatched types
 --> src/main.rs:3:14
  |
2 |     let mut spaces = "   ";
  |                      ----- expected due to this value
3 |     spaces = spaces.len();
  |              ^^^^^^^^^^^^ expected `&str`, found `usize`

For more information about this error, try `rustc --explain E0308`.
error: could not compile `variables` (bin "variables") due to 1 previous error
เมื่อเราได้เรียนรู้การทำงานของตัวแปรกันแล้ว ในหัวข้อถัดไปเราจะมาดูชนิดข้อมูลต่างๆ ที่มีให้ใช้งานใน Rust กันต่อ
ชนิดข้อมูล
ชนิดข้อมูล
ทุกค่าใน Rust มี_ชนิดข้อมูล_ (data type) กำกับอยู่เสมอ ซึ่งบอกให้ Rust ทราบว่าข้อมูลนั้นเป็นข้อมูลชนิดใด เพื่อที่จะได้รู้วิธีจัดการกับข้อมูลนั้นได้อย่างถูกต้อง เราจะมาทำความรู้จักกับกลุ่มชนิดข้อมูลหลัก 2 กลุ่ม ได้แก่ สเกลาร์ (scalar) และคอมพาวด์ (compound)
โปรดจำไว้ว่า Rust เป็นภาษาที่_กำหนดชนิดข้อมูลแบบสแตติก_ (statically typed) ซึ่งหมายความว่าคอมไพเลอร์จำเป็นต้องทราบชนิดข้อมูลของตัวแปรทั้งหมดตั้งแต่ตอนคอมไพล์ โดยทั่วไปแล้ว คอมไพเลอร์สามารถอนุมานชนิดข้อมูลที่เหมาะสมได้เองจากค่าของข้อมูลและบริบทการใช้งาน แต่ในกรณีที่ค่านั้นสามารถตีความได้หลายชนิด เช่น ตอนที่เราแปลง String ไปเป็นตัวเลขด้วย parse ในหัวข้อ “การเปรียบเทียบคำทายกับตัวเลขลับ” ในบทที่ 2 เราจำเป็นต้องระบุชนิดข้อมูลกำกับไว้อย่างชัดแจ้ง ดังนี้:
#![allow(unused)]
fn main() {
let guess: u32 = "42".parse().expect("Not a number!");
}
หากเราไม่ได้ระบุชนิดข้อมูล : u32 ดังเช่นในโค้ดข้างต้น Rust จะแสดงข้อความแจ้งข้อผิดพลาดต่อไปนี้ เพื่อบอกว่าคอมไพเลอร์ต้องการข้อมูลเพิ่มเติมจากเราว่าต้องการใช้ชนิดข้อมูลใดกันแน่:
$ cargo build
   Compiling no_type_annotations v0.1.0 (file:///projects/no_type_annotations)
error[E0284]: type annotations needed
 --> src/main.rs:2:9
  |
2 |     let guess = "42".parse().expect("Not a number!");
  |         ^^^^^        ----- type must be known at this point
  |
  = note: cannot satisfy `<_ as FromStr>::Err == _`
help: consider giving `guess` an explicit type
  |
2 |     let guess: /* Type */ = "42".parse().expect("Not a number!");
  |              ++++++++++++

For more information about this error, try `rustc --explain E0284`.
error: could not compile `no_type_annotations` (bin "no_type_annotations") due to 1 previous error
คุณจะได้เห็นรูปแบบการระบุชนิดข้อมูลอื่นๆ เพิ่มเติมเมื่อพบกับชนิดข้อมูลชนิดถัดไป
ชนิดสเกลาร์
ชนิดข้อมูลแบบ_สเกลาร์_ (scalar) ใช้แทนค่าเดี่ยวเพียงค่าเดียว โดย Rust มีชนิดข้อมูลสเกลาร์พื้นฐาน 4 ชนิด ได้แก่ จำนวนเต็ม (integer), จำนวนทศนิยม (floating-point number), บูลีน (boolean) และอักขระ (character) ซึ่งคุณอาจคุ้นเคยกับสิ่งเหล่านี้มาจากภาษาโปรแกรมอื่นๆ มาดูกันว่าแต่ละชนิดทำงานอย่างไรใน Rust
ชนิดจำนวนเต็ม
จำนวนเต็ม (integer) คือตัวเลขที่ไม่มีเศษส่วน เราได้ลองใช้ชนิดจำนวนเต็มไปแล้วหนึ่งชนิดในบทที่ 2 นั่นคือ u32 โดยการประกาศชนิดนี้บ่งบอกว่าค่าดังกล่าวเป็นจำนวนเต็มแบบไม่มีเครื่องหมาย (unsigned integer) ที่ใช้พื้นที่จัดเก็บ 32 บิต ส่วนชนิดจำนวนเต็มแบบมีเครื่องหมาย (signed integer) จะขึ้นต้นด้วยตัวอักษร i แทน u ตารางที่ 3-1 แสดงชนิดจำนวนเต็มพื้นฐานทั้งหมดที่มีใน Rust ซึ่งเราสามารถเลือกใช้ชนิดใดก็ได้เหล่านี้ในการประกาศชนิดของค่าจำนวนเต็ม
ตารางที่ 3-1: ชนิดจำนวนเต็มใน Rust
| ความยาว | มีเครื่องหมาย | ไม่มีเครื่องหมาย |
|---|---|---|
| 8 บิต | i8 | u8 |
| 16 บิต | i16 | u16 |
| 32 บิต | i32 | u32 |
| 64 บิต | i64 | u64 |
| 128 บิต | i128 | u128 |
| ขึ้นอยู่กับสถาปัตยกรรม | isize | usize |
แต่ละชนิดมีทั้งแบบมีเครื่องหมายและไม่มีเครื่องหมาย และมีขนาดระบุไว้อย่างชัดเจน การระบุว่า_มีเครื่องหมาย_ (signed) หรือ_ไม่มีเครื่องหมาย_ (unsigned) หมายถึงตัวเลขนั้นสามารถมีค่าติดลบได้หรือไม่ กล่าวคือ ตัวเลขนั้นจำเป็นต้องมีเครื่องหมายบอกความเป็นบวกหรือลบ (signed) หรือเป็นค่าบวกเสมอจึงแสดงได้โดยไม่ต้องมีเครื่องหมาย (unsigned) เปรียบเหมือนการเขียนตัวเลขบนกระดาษ เมื่อเครื่องหมายมีความสำคัญ ตัวเลขจะถูกเขียนพร้อมเครื่องหมายบวกหรือลบ แต่เมื่อมั่นใจได้ว่าเป็นค่าบวกเสมอ ก็สามารถเขียนตัวเลขลอยๆ ได้โดยไม่ต้องใส่เครื่องหมาย ทั้งนี้ ตัวเลขแบบมีเครื่องหมายจะจัดเก็บข้อมูลโดยใช้รูปแบบ two’s complement
ชนิดข้อมูลแบบมีเครื่องหมายแต่ละชนิดสามารถเก็บตัวเลขได้ตั้งแต่ −(2n − 1) ไปจนถึง 2n − 1 − 1 (นับรวมขอบเขตทั้งสองฝั่ง) โดยที่ n คือจำนวนบิตของชนิดข้อมูลนั้นๆ ดังนั้น i8 จึงสามารถเก็บตัวเลขได้ตั้งแต่ −(27) ถึง 27 − 1 ซึ่งเท่ากับ −128 ถึง 127 ส่วนชนิดข้อมูลแบบไม่มีเครื่องหมายสามารถเก็บตัวเลขได้ตั้งแต่ 0 ไปจนถึง 2n − 1 ส่งผลให้ u8 เก็บตัวเลขได้ตั้งแต่ 0 ถึง 28 − 1 ซึ่งเท่ากับ 0 ถึง 255
นอกจากนี้ ชนิด isize และ usize จะมีขนาดขึ้นอยู่กับสถาปัตยกรรมของคอมพิวเตอร์ที่โปรแกรมกำลังทำงานอยู่ โดยจะมีขนาด 64 บิตบนสถาปัตยกรรม 64-bit และมีขนาด 32 บิตบนสถาปัตยกรรม 32-bit
คุณสามารถเขียนลิเทอรัลของจำนวนเต็มได้หลากหลายรูปแบบตามตารางที่ 3-2 โดยลิเทอรัลตัวเลขที่สามารถตีความได้หลายชนิด สามารถใส่คำต่อท้ายชนิดข้อมูลเพื่อระบุชนิดที่ต้องการได้โดยตรง เช่น 57u8 และยังสามารถใช้เครื่องหมายขีดล่าง _ เป็นตัวคั่นเพื่อช่วยให้อ่านตัวเลขได้ง่ายขึ้น เช่น 1_000 ซึ่งมีค่าเท่ากับ 1000 ทุกประการ
ตารางที่ 3-2: ลิเทอรัลจำนวนเต็มใน Rust
| ลิเทอรัลตัวเลข | ตัวอย่าง |
|---|---|
| ทศนิยม | 98_222 |
| เลขฐานสิบหก | 0xff |
| เลขฐานแปด | 0o77 |
| เลขฐานสอง | 0b1111_0000 |
ไบต์ (เฉพาะ u8) | b'A' |
แล้วเราควรเลือกใช้จำนวนเต็มชนิดใดดี? หากคุณไม่แน่ใจ ค่าเริ่มต้นของ Rust ถือเป็นจุดเริ่มต้นที่ดีเสมอ โดยจำนวนเต็มจะมีค่าเริ่มต้นเป็น i32 ส่วนกรณีหลักที่คุณจะได้ใช้งาน isize หรือ usize คือเมื่อต้องการใช้เป็นดัชนี (index) เพื่อเข้าถึงข้อมูลในคอลเลกชัน
การล้นของจำนวนเต็ม
สมมติว่าคุณมีตัวแปรชนิด
u8ซึ่งเก็บค่าได้ระหว่าง 0 ถึง 255 หากคุณพยายามกำหนดค่าที่อยู่นอกช่วงดังกล่าว เช่น 256 จะเกิดสภาวะที่เรียกว่า_การล้นของจำนวนเต็ม_ (integer overflow) ซึ่งจะแสดงพฤติกรรมแตกต่างกันตามโหมดการคอมไพล์: เมื่อคุณคอมไพล์ในโหมดดีบัก Rust จะเพิ่มการตรวจสอบการล้นของจำนวนเต็มเข้าไปด้วย ซึ่งจะทำให้โปรแกรมของคุณ_แพนิก_ (panic) ในขณะรันไทม์หากเกิดกรณีนี้ขึ้น โดย Rust ใช้คำว่า_การแพนิก_ (panicking) เพื่อสื่อถึงสภาวะที่โปรแกรมยุติการทำงานกะทันหันเนื่องจากพบข้อผิดพลาดร้ายแรง เราจะกล่าวถึงการแพนิกอย่างละเอียดในหัวข้อ “ข้อผิดพลาดที่กู้คืนไม่ได้ด้วยpanic!” ในบทที่ 9แต่เมื่อคุณคอมไพล์ในโหมดรีลีสด้วยแฟล็ก
--releaseRust จะ_ไม่_ได้ใส่การตรวจสอบการล้นที่ทำให้เกิดการแพนิกมาให้ หากเกิดการล้นขึ้น Rust จะใช้วิธี_การหมุนวนรอบแบบ two’s complement_ (two’s complement wrapping) อธิบายให้เข้าใจง่ายคือ ค่าที่เกินกว่าขีดจำกัดสูงสุดจะ “วนกลับ” ไปเริ่มต้นที่ค่าต่ำสุดที่ชนิดข้อมูลนั้นเก็บได้ ในกรณีของu8ค่า 256 จะกลายเป็น 0, ค่า 257 จะกลายเป็น 1 และวนไปเรื่อยๆ โปรแกรมจะไม่เกิดการแพนิก แต่ตัวแปรจะมีค่าที่คลาดเคลื่อนไปจากที่คุณคาดหวังอย่างแน่นอน การเขียนโค้ดโดยพึ่งพาพฤติกรรมการหมุนวนของการล้นของตัวเลขจึงถือเป็นข้อผิดพลาดที่ไม่ควรทำเพื่อรับมือกับโอกาสที่จะเกิดการล้นอย่างรัดกุม คุณสามารถเรียกใช้กลุ่มเมธอดที่ไลบรารีมาตรฐานจัดเตรียมไว้สำหรับชนิดข้อมูลตัวเลขพื้นฐานได้ดังนี้:
- หมุนวนค่าในทุกโหมดการคอมไพล์ด้วยกลุ่มเมธอด
wrapping_*เช่นwrapping_add- ส่งคืนค่า
Noneหากเกิดการล้นด้วยกลุ่มเมธอดchecked_*- ส่งคืนค่าผลลัพธ์พร้อมค่าบูลีนที่ระบุว่าเกิดการล้นหรือไม่ด้วยกลุ่มเมธอด
overflowing_*- ตรึงค่าไว้ที่ขีดจำกัดต่ำสุดหรือสูงสุดด้วยกลุ่มเมธอด
saturating_*
ชนิดจำนวนทศนิยม
Rust มีชนิดข้อมูลพื้นฐาน 2 ชนิดสำหรับ_จำนวนทศนิยม_ (floating-point numbers) นั่นคือ f32 และ f64 ซึ่งมีขนาด 32 บิตและ 64 บิตตามลำดับ โดยชนิดเริ่มต้นของจำนวนทศนิยมคือ f64 เนื่องจากบนหน่วยประมวลผล (CPU) ยุคใหม่ f64 ทำงานได้รวดเร็วเทียบเท่ากับ f32 แต่ให้ความละเอียดแม่นยำของตัวเลขที่สูงกว่า ทั้งนี้ ชนิดจำนวนทศนิยมทั้งหมดใน Rust จะเป็นแบบมีเครื่องหมายเสมอ
ตัวอย่างการใช้งานจำนวนทศนิยม:
ชื่อไฟล์: src/main.rs
fn main() {
    let x = 2.0; // f64

    let y: f32 = 3.0; // f32
}
จำนวนทศนิยมใน Rust จัดเก็บตามมาตรฐานสากล IEEE-754
การดำเนินการทางคณิตศาสตร์
Rust รองรับการคำนวณทางคณิตศาสตร์พื้นฐานทั่วไปสำหรับชนิดตัวเลขทั้งหมด ได้แก่ การบวก การลบ การคูณ การหาร และการหารเอาเศษ (modulo) โดยการหารจำนวนเต็มจะปัดเศษทิ้งเข้าหาศูนย์ไปยังจำนวนเต็มที่ใกล้ที่สุด โค้ดต่อไปนี้แสดงการใช้งานตัวดำเนินการทางคณิตศาสตร์แต่ละแบบในคำสั่ง let:
ชื่อไฟล์: src/main.rs
fn main() {
    // addition
    let sum = 5 + 10;

    // subtraction
    let difference = 95.5 - 4.3;

    // multiplication
    let product = 4 * 30;

    // division
    let quotient = 56.7 / 32.2;
    let truncated = -5 / 3; // Results in -1

    // remainder
    let remainder = 43 % 5;
}
แต่ละนิพจน์ในคำสั่งเหล่านี้จะคำนวณผ่านตัวดำเนินการทางคณิตศาสตร์และประเมินค่าออกมาเป็นค่าเดี่ยว แล้วจึงผูกค่านั้นเข้ากับตัวแปร สามารถดูรายการตัวดำเนินการทั้งหมดที่ Rust รองรับได้จากภาคผนวก B
ชนิดบูลีน
เช่นเดียวกับภาษาโปรแกรมส่วนใหญ่ ชนิดข้อมูลบูลีน (boolean) ใน Rust มีค่าที่เป็นไปได้ 2 ค่า คือ true และ false โดยใช้พื้นที่จัดเก็บขนาด 1 ไบต์ และใช้คำว่า bool ในการระบุชนิดข้อมูล ตัวอย่างเช่น:
ชื่อไฟล์: src/main.rs
fn main() {
    let t = true;

    let f: bool = false; // with explicit type annotation
}
ประโยชน์หลักของการใช้ค่าบูลีนคือการนำไปใช้ตรวจสอบเงื่อนไข (conditions) เช่นในนิพจน์ if ซึ่งเราจะได้เรียนรู้การทำงานของนิพจน์ if ใน Rust ในหัวข้อ “การควบคุมโฟลว์”
ชนิดอักขระ
ชนิดข้อมูล char ของ Rust เป็นชนิดตัวอักษรพื้นฐานที่สุดของภาษา ตัวอย่างการประกาศค่า char:
ชื่อไฟล์: src/main.rs
fn main() {
    let c = 'z';
    let z: char = 'ℤ'; // with explicit type annotation
    let heart_eyed_cat = '😻';
}
สังเกตว่าเราจะเขียนลิเทอรัลของ char ให้อยู่ภายในเครื่องหมายอัญประกาศเดี่ยว (single quote) ต่างจากสตริงลิเทอรัล (string literal) ที่ต้องใช้เครื่องหมายอัญประกาศคู่ (double quote) โดยชนิด char ของ Rust มีขนาด 4 ไบต์ และเป็นตัวแทนของค่าสเกลาร์ยูนิโค้ด (Unicode scalar value) ซึ่งหมายความว่ามันสามารถเก็บอักขระได้หลากหลายมากกว่าแค่รหัส ASCII ทั่วไป ไม่ว่าจะเป็นอักษรที่มีเครื่องหมายกำกับเสียง ตัวอักษรภาษาจีน ญี่ปุ่น เกาหลี สัญลักษณ์อีโมจิ ตลอดจนอักขระความกว้างศูนย์ ล้วนเป็นค่า char ที่ถูกต้องใน Rust ทั้งสิ้น โดยค่า Unicode scalar value มีช่วงตั้งแต่ U+0000 ถึง U+D7FF และ U+E000 ถึง U+10FFFF ครอบคลุมทั้งสองฝั่ง อย่างไรก็ตาม คำว่า “อักขระ” ในความรู้สึกทั่วไปของมนุษย์อาจไม่ได้ตรงกับนิยามของ Unicode หรือสิ่งที่ char เป็นใน Rust เสมอไป เราจะเจาะลึกประเด็นนี้กันในหัวข้อ “เก็บข้อความที่เข้ารหัส UTF-8 ด้วยสตริง” ในบทที่ 8
ชนิดคอมพาวด์
ชนิดข้อมูลแบบ_คอมพาวด์_ (compound) สามารถรวบรวมหลายๆ ค่าไว้ด้วยกันภายในชนิดข้อมูลเดียว โดย Rust มีชนิดข้อมูลคอมพาวด์พื้นฐาน 2 ชนิด ได้แก่ ทูเพิล (tuple) และอาร์เรย์ (array)
ชนิดทูเพิล
ทูเพิล (tuple) เป็นวิธีทั่วไปในการรวมกลุ่มข้อมูลหลายค่าที่มีชนิดข้อมูลแตกต่างกันเข้าไว้ด้วยกันเป็นหนึ่งเดียว ทูเพิลมีความยาวคงที่ เมื่อประกาศสร้างขึ้นมาแล้ว จะไม่สามารถเพิ่มหรือลดขนาดได้อีก
เราสร้างทูเพิลได้โดยเขียนรายการค่าที่คั่นด้วยเครื่องหมายจุลภาคไว้ภายในวงเล็บ โดยแต่ละตำแหน่งในทูเพิลจะมีชนิดข้อมูลของตนเอง และไม่จำเป็นต้องมีชนิดข้อมูลเหมือนกัน เราได้เพิ่มการระบุชนิดข้อมูลแบบเจาะจงไว้ในตัวอย่างนี้:
ชื่อไฟล์: src/main.rs
fn main() {
    let tup: (i32, f64, u8) = (500, 6.4, 1);
}
ตัวแปร tup จะผูกเข้ากับทูเพิลทั้งก้อน เนื่องจากทูเพิลถือเป็นหน่วยข้อมูลคอมพาวด์ชิ้นเดียว หากต้องการดึงค่าแต่ละตัวออกมาใช้งาน เราสามารถใช้การจับคู่รูปแบบ (pattern matching) เพื่อแยกโครงสร้างข้อมูลของทูเพิลออกมาได้ ดังนี้:
ชื่อไฟล์: src/main.rs
fn main() {
    let tup = (500, 6.4, 1);

    let (x, y, z) = tup;

    println!("The value of y is: {y}");
}
โปรแกรมนี้เริ่มต้นด้วยการสร้างทูเพิลแล้วผูกไว้กับตัวแปร tup จากนั้นใช้รูปแบบร่วมกับคำสั่ง let เพื่อแยกค่าใน tup ออกเป็นตัวแปรย่อย 3 ตัว ได้แก่ x, y และ z กระบวนการนี้เรียกว่า_การแยกโครงสร้างข้อมูล_ (destructuring) เพราะเป็นการกระจายทูเพิลเดี่ยวออกเป็นส่วนย่อยๆ และสุดท้าย โปรแกรมจะพิมพ์ค่าของ y ออกมา ซึ่งก็คือ 6.4
นอกจากนี้ เรายังสามารถเข้าถึงค่าในทูเพิลได้โดยตรงผ่านเครื่องหมายจุด (.) แล้วตามด้วยดัชนีของตำแหน่งที่ต้องการเข้าถึง เช่น:
ชื่อไฟล์: src/main.rs
fn main() {
    let x: (i32, f64, u8) = (500, 6.4, 1);

    let five_hundred = x.0;

    let six_point_four = x.1;

    let one = x.2;
}
โปรแกรมนี้สร้างทูเพิล x แล้วเข้าถึงค่าในแต่ละตำแหน่งตามลำดับดัชนี และเช่นเดียวกับภาษาโปรแกรมส่วนใหญ่ ดัชนีตัวแรกของทูเพิลจะเริ่มต้นที่ 0 เสมอ
ทูเพิลที่ไม่มีค่าใดๆ บรรจุอยู่เลยจะมีชื่อเรียกเฉพาะว่า unit โดยทั้งตัวค่าและชนิดข้อมูลจะเขียนแทนด้วยวงเล็บว่างเปล่า () ซึ่งทำหน้าที่แทนค่าว่างหรือชนิดที่ส่งค่ากลับแบบว่าง (empty return type) ทั้งนี้ นิพจน์ใดๆ ใน Rust จะส่งค่า unit กลับมาโดยปริยาย หากนิพจน์นั้นไม่ได้ส่งค่าอื่นใดกลับมา
ชนิดอาร์เรย์
อีกหนึ่งวิธีในการจัดเก็บคอลเลกชันของหลายค่าคือการใช้_อาร์เรย์_ (array) โดยสิ่งที่ทำให้อาร์เรย์ต่างจากทูเพิลคือ ทุกองค์ประกอบในอาร์เรย์จะต้องเป็นชนิดข้อมูลเดียวกันทั้งหมด และต่างจากอาร์เรย์ในบางภาษาตรงที่ อาร์เรย์ใน Rust จะมีความยาวคงที่เสมอ
เราสร้างอาร์เรย์โดยเขียนรายการค่าที่คั่นด้วยเครื่องหมายจุลภาคไว้ภายในวงเล็บเหลี่ยม (square brackets):
ชื่อไฟล์: src/main.rs
fn main() {
    let a = [1, 2, 3, 4, 5];
}
อาร์เรย์มีประโยชน์เมื่อคุณต้องการจัดเก็บข้อมูลไว้บนหน่วยความจำสแตก (stack) เช่นเดียวกับชนิดข้อมูลอื่นๆ ที่เราได้เห็นมา แทนที่จะเป็นหน่วยความจำฮีป (heap) (เราจะพูดถึงสแตกและฮีปเพิ่มเติมในบทที่ 4) หรือเมื่อต้องการรับประกันว่าจำนวนข้อมูลจะมีขนาดคงที่แน่นอนเสมอ อย่างไรก็ดี อาร์เรย์จะมีความยืดหยุ่นน้อยกว่าชนิดเวกเตอร์ (vector) ซึ่งเป็นคอลเลกชันอีกชนิดหนึ่งที่ไลบรารีมาตรฐานจัดเตรียมไว้ให้ โดยเวกเตอร์จะ_สามารถ_ปรับเพิ่มลดขนาดได้อย่างอิสระเนื่องจากข้อมูลถูกจัดสรรไว้บนฮีป หากคุณไม่แน่ใจว่าจะเลือกใช้อาร์เรย์หรือเวกเตอร์ดี โดยส่วนใหญ่แล้วเวกเตอร์มักเป็นตัวเลือกที่ตอบโจทย์ได้มากกว่า ซึ่งเราจะได้เรียนรู้เรื่องเวกเตอร์อย่างละเอียดในบทที่ 8
อย่างไรก็ตาม อาร์เรย์จะมีประโยชน์อย่างยิ่งเมื่อคุณทราบจำนวนองค์ประกอบที่แน่นอนและไม่มีความจำเป็นต้องเปลี่ยนแปลง เช่น หากต้องการเก็บรายชื่อเดือนทั้ง 12 เดือนในโปรแกรม การเลือกใช้อาร์เรย์จะเหมาะสมกว่าเวกเตอร์ เพราะทราบขนาดที่แน่นอนว่าจะต้องมี 12 องค์ประกอบเสมอ:
#![allow(unused)]
fn main() {
let months = ["January", "February", "March", "April", "May", "June", "July",
              "August", "September", "October", "November", "December"];
}
คุณสามารถระบุชนิดข้อมูลของอาร์เรย์ได้โดยใช้วงเล็บเหลี่ยมที่ระบุชนิดขององค์ประกอบ คั่นด้วยเครื่องหมายเซมิโคลอน แล้วตามด้วยจำนวนองค์ประกอบในอาร์เรย์ ดังนี้:
#![allow(unused)]
fn main() {
let a: [i32; 5] = [1, 2, 3, 4, 5];
}
ในที่นี้ i32 คือชนิดข้อมูลของแต่ละองค์ประกอบ และตัวเลข 5 หลังเซมิโคลอนบ่งบอกว่าอาร์เรย์นี้มีขนาด 5 องค์ประกอบ
นอกจากนี้ คุณยังสามารถกำหนดค่าเริ่มต้นให้อาร์เรย์มีค่าซ้ำกันในทุกองค์ประกอบได้ง่ายๆ โดยระบุค่าเริ่มต้น คั่นด้วยเซมิโคลอน แล้วตามด้วยความยาวของอาร์เรย์ภายในวงเล็บเหลี่ยม ดังนี้:
#![allow(unused)]
fn main() {
let a = [3; 5];
}
อาร์เรย์ชื่อ a จะมี 5 องค์ประกอบ โดยทุกตัวมีค่าเริ่มต้นเป็น 3 ซึ่งเทียบเท่ากับการเขียน let a = [3, 3, 3, 3, 3]; แต่มีความกระชับกว่ามาก
การเข้าถึงองค์ประกอบของอาร์เรย์
อาร์เรย์คือบล็อกหน่วยความจำก้อนเดียวที่มีขนาดคงที่และทราบขนาดล่วงหน้าอย่างแน่นอน ซึ่งสามารถจัดสรรไว้บนสแตกได้อย่างมีประสิทธิภาพ คุณสามารถเข้าถึงข้อมูลในแต่ละองค์ประกอบของอาร์เรย์ได้ผ่านการระบุดัชนี ดังนี้:
ชื่อไฟล์: src/main.rs
fn main() {
    let a = [1, 2, 3, 4, 5];

    let first = a[0];
    let second = a[1];
}
ในตัวอย่างนี้ ตัวแปร first จะได้ค่า 1 เนื่องจากเป็นค่าที่อยู่ที่ดัชนี [0] ของอาร์เรย์ และตัวแปร second จะได้ค่า 2 จากดัชนี [1]
การเข้าถึงองค์ประกอบของอาร์เรย์ที่ไม่ถูกต้อง
มาดูกันว่าจะเกิดอะไรขึ้นหากคุณพยายามเข้าถึงองค์ประกอบในตำแหน่งที่เกินขอบเขตความยาวของอาร์เรย์ สมมติว่าคุณรันโปรแกรมนี้ ซึ่งคล้ายกับเกมทายตัวเลขในบทที่ 2 เพื่อรับค่าดัชนีของอาร์เรย์มาจากผู้ใช้:
ชื่อไฟล์: src/main.rs
use std::io;

fn main() {
    let a = [1, 2, 3, 4, 5];

    println!("Please enter an array index.");

    let mut index = String::new();

    io::stdin()
        .read_line(&mut index)
        .expect("Failed to read line");

    let index: usize = index
        .trim()
        .parse()
        .expect("Index entered was not a number");

    let element = a[index];

    println!("The value of the element at index {index} is: {element}");
}
โค้ดนี้คอมไพล์ผ่านได้อย่างเรียบร้อย หากคุณสั่งรันโปรแกรมด้วย cargo run แล้วป้อนเลข 0, 1, 2, 3 หรือ 4 โปรแกรมจะพิมพ์ค่าที่อยู่ในดัชนีนั้นๆ ออกมา แต่หากคุณป้อนตัวเลขที่เกินความยาวของอาร์เรย์ เช่น 10 คุณจะพบข้อความผลลัพธ์ดังนี้:
thread 'main' panicked at src/main.rs:19:19:
index out of bounds: the len is 5 but the index is 10
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
โปรแกรมเกิดข้อผิดพลาดขึ้นในขณะรันไทม์ ณ จุดที่มีการใช้ดัชนีที่ไม่ถูกต้อง โปรแกรมจึงยุติการทำงานลงทันทีพร้อมแจ้งข้อผิดพลาด และไม่ได้ทำคำสั่ง println! ตัวสุดท้ายต่อ เมื่อคุณพยายามเข้าถึงข้อมูลในอาร์เรย์ผ่านดัชนี Rust จะตรวจสอบเสมอว่าดัชนีที่คุณระบุมีค่าน้อยกว่าความยาวจริงของอาร์เรย์หรือไม่ หากดัชนีมากกว่าหรือเท่ากับความยาวของอาร์เรย์ Rust จะเกิดการแพนิกทันที ซึ่งการตรวจสอบนี้จำเป็นต้องทำขณะรันไทม์ โดยเฉพาะในกรณีนี้เนื่องจากคอมไพเลอร์ไม่สามารถล่วงรู้ล่วงหน้าได้ว่าผู้ใช้จะพิมพ์เลขใดเข้ามา
นี่คือตัวอย่างเชิงประจักษ์ของหลักการความปลอดภัยของหน่วยความจำในภาษา Rust ในภาษาโปรแกรมระดับล่างหลายภาษา การตรวจสอบขอบเขตเช่นนี้มักไม่ถูกกระทำ และเมื่อคุณระบุดัชนีที่ไม่ถูกต้อง โปรแกรมอาจแอบเข้าถึงหน่วยความจำส่วนอื่นที่ไม่ได้อนุญาตได้ Rust ปกป้องคุณจากช่องโหว่ร้ายแรงประเภทนี้โดยสั่งยุติการทำงานทันที แทนที่จะปล่อยให้โค้ดเข้าถึงหน่วยความจำส่วนนั้นแล้วทำงานต่อไปอย่างผิดพลาด ในบทที่ 9 เราจะได้เรียนรู้การจัดการข้อผิดพลาดใน Rust เพิ่มเติม เพื่อเขียนโค้ดที่ทั้งปลอดภัยและไม่หยุดทำงานกะทันหัน
ฟังก์ชัน
ฟังก์ชัน
ฟังก์ชัน (function) เป็นส่วนประกอบพื้นฐานที่พบได้ทั่วไปในโค้ด Rust คุณได้เห็นหนึ่งในฟังก์ชันที่สำคัญที่สุดของภาษาไปแล้ว นั่นคือฟังก์ชัน main ซึ่งเป็นจุดเริ่มต้นการทำงานของโปรแกรมจำนวนมาก และคุณยังได้เห็นคีย์เวิร์ด fn ที่ใช้สำหรับประกาศฟังก์ชันใหม่ด้วย
โค้ด Rust ใช้สไตล์แบบ snake case เป็นธรรมเนียมปฏิบัติในการตั้งชื่อฟังก์ชันและตัวแปร โดยตัวอักษรทั้งหมดจะเป็นตัวพิมพ์เล็กและคั่นคำด้วยขีดล่าง (underscore) ตัวอย่างโปรแกรมที่มีการนิยามฟังก์ชันมีดังนี้:
ชื่อไฟล์: src/main.rs
fn main() {
    println!("Hello, world!");

    another_function();
}

fn another_function() {
    println!("Another function.");
}
เรานิยามฟังก์ชันใน Rust โดยขึ้นต้นด้วย fn ตามด้วยชื่อฟังก์ชันและคู่วงเล็บเปิดปิด ส่วนวงเล็บปีกกาจะบอกให้คอมไพเลอร์ทราบถึงขอบเขตเริ่มต้นและสิ้นสุดของเนื้อหาฟังก์ชัน (body)
เราสามารถเรียกใช้ฟังก์ชันใดก็ได้ที่นิยามไว้ โดยระบุชื่อฟังก์ชันตามด้วยคู่วงเล็บเปิดปิด เนื่องจาก another_function ถูกนิยามไว้ในโปรแกรม เราจึงสามารถเรียกใช้มันจากภายในฟังก์ชัน main ได้ โปรดสังเกตว่าเรานิยาม another_function ไว้ ต่อจาก ฟังก์ชัน main ในซอร์สโค้ด แต่จริงๆ แล้วเราจะนิยามไว้ก่อนหน้าฟังก์ชัน main ก็ได้เช่นกัน Rust ไม่สนใจว่าคุณจะเขียนนิยามฟังก์ชันไว้ที่ใด ขอเพียงแค่นิยามไว้ภายในขอบเขต (scope) ที่โค้ดผู้เรียกสามารถมองเห็นได้ก็พอ
ลองสร้างโปรเจกต์แบบไบนารีใหม่ขึ้นมาชื่อ functions เพื่อทดลองใช้งานฟังก์ชันเพิ่มเติม นำโค้ดตัวอย่างของ another_function ใส่ลงใน src/main.rs แล้วลองรันดู จะได้ผลลัพธ์ดังนี้:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.28s
     Running `target/debug/functions`
Hello, world!
Another function.
คำสั่งต่างๆ จะทำงานตามลำดับที่ปรากฏในฟังก์ชัน main เริ่มจากพิมพ์ข้อความ “Hello, world!” ก่อน จากนั้นจึงเรียกใช้ another_function แล้วพิมพ์ข้อความของฟังก์ชันนั้นตามมา
พารามิเตอร์
เราสามารถนิยามฟังก์ชันให้รับ พารามิเตอร์ (parameter) ได้ ซึ่งพารามิเตอร์ก็คือตัวแปรพิเศษที่เป็นส่วนหนึ่งของลายเซ็นฟังก์ชัน (function signature) เมื่อฟังก์ชันมีพารามิเตอร์ คุณจะสามารถส่งค่าจริงไปให้พารามิเตอร์เหล่านั้นได้ ซึ่งในทางเทคนิค ค่าจริงที่ส่งเข้าไปจะเรียกว่า อาร์กิวเมนต์ (argument) อย่างไรก็ดี ในการสื่อสารทั่วไป ผู้คนมักใช้คำว่า พารามิเตอร์ และ อาร์กิวเมนต์ สลับกัน ไม่ว่าจะหมายถึงตัวแปรที่ระบุในการนิยามฟังก์ชัน หรือค่าจริงที่ส่งเข้าไปตอนเรียกใช้ฟังก์ชันก็ตาม
ใน another_function เวอร์ชันนี้ เราได้เพิ่มพารามิเตอร์เข้าไปหนึ่งตัว:
ชื่อไฟล์: src/main.rs
fn main() {
    another_function(5);
}

fn another_function(x: i32) {
    println!("The value of x is: {x}");
}
ลองรันโปรแกรมนี้ดู คุณจะได้ผลลัพธ์ดังต่อไปนี้:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 1.21s
     Running `target/debug/functions`
The value of x is: 5
ในการประกาศ another_function มีพารามิเตอร์หนึ่งตัวชื่อ x โดยระบุชนิดข้อมูลเป็น i32 เมื่อเราส่งค่า 5 เข้าไปใน another_function มาโคร println! จะนำเลข 5 ไปแทนที่ตรงตำแหน่งของวงเล็บปีกกาที่มี x อยู่ในสตริงจัดรูปแบบ
ในลายเซ็นของฟังก์ชัน คุณ จำเป็นต้อง ประกาศชนิดข้อมูลของพารามิเตอร์แต่ละตัวเสมอ นี่เป็นการตัดสินใจออกแบบโดยตั้งใจของ Rust การบังคับให้ระบุชนิดข้อมูลในนิยามฟังก์ชัน ส่งผลให้คอมไพเลอร์แทบไม่จำเป็นต้องให้คุณไประบุชนิดข้อมูลซ้ำในส่วนอื่นๆ ของโค้ดเพื่ออนุมานว่าคุณหมายถึงชนิดข้อมูลใด นอกจากนี้ คอมไพเลอร์ยังสามารถแสดงข้อความแจ้งเตือนข้อผิดพลาดที่เป็นประโยชน์ยิ่งขึ้นได้ หากทราบล่วงหน้าว่าฟังก์ชันนั้นคาดหวังชนิดข้อมูลใด
หากต้องการกำหนดพารามิเตอร์หลายตัว ให้คั่นการประกาศพารามิเตอร์แต่ละตัวด้วยเครื่องหมายจุลภาค ดังนี้:
ชื่อไฟล์: src/main.rs
fn main() {
    print_labeled_measurement(5, 'h');
}

fn print_labeled_measurement(value: i32, unit_label: char) {
    println!("The measurement is: {value}{unit_label}");
}
ตัวอย่างนี้สร้างฟังก์ชันชื่อ print_labeled_measurement ที่มีพารามิเตอร์สองตัว ตัวแรกชื่อ value เป็นชนิด i32 ส่วนตัวที่สองชื่อ unit_label เป็นชนิด char จากนั้นตัวฟังก์ชันจะพิมพ์ข้อความที่มีทั้งค่าของ value และ unit_label ออกมา
ลองรันโค้ดนี้กัน โดยนำโค้ดตัวอย่างข้างต้นไปแทนที่ในไฟล์ src/main.rs ของโปรเจกต์ functions แล้วสั่งรันด้วย cargo run:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/functions`
The measurement is: 5h
เนื่องจากเราเรียกฟังก์ชันโดยส่ง 5 ไปเป็นค่าของ value และ 'h' ไปเป็นค่าของ unit_label ผลลัพธ์ของโปรแกรมจึงแสดงค่าเหล่านั้นออกมา
สเตตเมนต์และนิพจน์
เนื้อหาของฟังก์ชันประกอบขึ้นจากชุดของสเตตเมนต์ (statement) ซึ่งอาจปิดท้ายด้วยนิพจน์ (expression) ได้ จนถึงตอนนี้ ฟังก์ชันที่เราเขียนกันไปยังไม่มีนิพจน์ปิดท้าย แต่คุณได้เห็นนิพจน์เป็นส่วนหนึ่งของสเตตเมนต์มาบ้างแล้ว เนื่องจาก Rust เป็นภาษาที่ทำงานบนพื้นฐานของนิพจน์ (expression-based language) ความแตกต่างระหว่างสองสิ่งนี้จึงเป็นเรื่องสำคัญที่ต้องทำความเข้าใจ ภาษาโปรแกรมอื่นๆ มักไม่มีความแตกต่างในลักษณะนี้ ดังนั้นเรามาดูกันว่าสเตตเมนต์และนิพจน์คืออะไร และความแตกต่างของพวกมันส่งผลต่อเนื้อหาของฟังก์ชันอย่างไร
- สเตตเมนต์ (Statement) คือชุดคำสั่งที่ดำเนินการบางอย่างและไม่มีการคืนค่า
- นิพจน์ (Expression) คือส่วนที่ประเมินผลลัพธ์ออกมาเป็นค่าใดค่าหนึ่ง
มาดูตัวอย่างกัน
ในความเป็นจริง เราได้ใช้ทั้งสเตตเมนต์และนิพจน์กันไปแล้ว การสร้างตัวแปรและกำหนดค่าให้มันด้วยคีย์เวิร์ด let ถือเป็นสเตตเมนต์ ในลิสติ้ง 3-1 คำสั่ง let y = 6; คือสเตตเมนต์
fn main() {
    let y = 6;
}
การนิยามฟังก์ชันก็เป็นสเตตเมนต์เช่นเดียวกัน ตัวอย่างฟังก์ชันทั้งหมดที่ผ่านมาล้วนเป็นสเตตเมนต์ในตัวมันเอง (ส่วนการเรียกใช้ฟังก์ชันนั้นไม่ถือเป็นสเตตเมนต์ ดังที่เราจะได้เห็นกันในไม่ช้า)
สเตตเมนต์จะไม่มีการคืนค่า ดังนั้นคุณจึงไม่สามารถนำผลลัพธ์ของสเตตเมนต์ let ไปกำหนดให้กับตัวแปรอื่นได้ เหมือนอย่างที่โค้ดต่อไปนี้พยายามจะทำ ซึ่งจะทำให้เกิดข้อผิดพลาดในการคอมไพล์:
ชื่อไฟล์: src/main.rs
fn main() {
    let x = (let y = 6);
}
เมื่อคุณรันโปรแกรมนี้ จะพบกับข้อผิดพลาดลักษณะนี้:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
error: expected expression, found `let` statement
 --> src/main.rs:2:14
  |
2 |     let x = (let y = 6);
  |              ^^^
  |
  = note: only supported directly in conditions of `if` and `while` expressions

warning: unnecessary parentheses around assigned value
 --> src/main.rs:2:13
  |
2 |     let x = (let y = 6);
  |             ^         ^
  |
  = note: `#[warn(unused_parens)]` (part of `#[warn(unused)]`) on by default
help: remove these parentheses
  |
2 -     let x = (let y = 6);
2 +     let x = let y = 6;
  |

warning: `functions` (bin "functions") generated 1 warning
error: could not compile `functions` (bin "functions") due to 1 previous error; 1 warning emitted
สเตตเมนต์ let y = 6 ไม่มีการคืนค่า จึงไม่มีค่าใดๆ ที่จะนำไปผูกเข้ากับ x ได้ ซึ่งจุดนี้แตกต่างจากภาษาอื่นอย่างเช่น C และ Ruby ที่การกำหนดค่าจะคืนค่าของการกำหนดนั้นกลับมาด้วย ทำให้ในภาษาเหล่านั้นคุณสามารถเขียน x = y = 6 เพื่อกำหนดให้ทั้ง x และ y มีค่าเป็น 6 ได้ แต่สำหรับใน Rust คุณไม่สามารถทำเช่นนั้นได้
สำหรับนิพจน์ (expression) นั้นจะประเมินผลลัพธ์ออกมาเป็นค่าหนึ่งเสมอ และโค้ดส่วนใหญ่ที่คุณจะเขียนใน Rust ก็คือนิพจน์นี่เอง ลองพิจารณาการคำนวณทางคณิตศาสตร์อย่าง 5 + 6 ซึ่งเป็นนิพจน์ที่ประเมินผลได้เป็น 11 นอกจากนี้นิพจน์ยังสามารถเป็นส่วนประกอบย่อยของสเตตเมนต์ได้อีกด้วย เช่น ในลิสติ้ง 3-1 เลข 6 ในสเตตเมนต์ let y = 6; ก็คือนิพจน์ที่ประเมินผลได้ค่า 6 หรือแม้แต่การเรียกใช้ฟังก์ชัน การเรียกใช้มาโคร รวมถึงบล็อกขอบเขตใหม่ที่สร้างขึ้นด้วยวงเล็บปีกกา ต่างก็ล้วนเป็นนิพจน์ทั้งสิ้น ตัวอย่างเช่น:
ชื่อไฟล์: src/main.rs
fn main() {
    let y = {
        let x = 3;
        x + 1
    };

    println!("The value of y is: {y}");
}
นิพจน์ส่วนนี้:
{
    let x = 3;
    x + 1
}
คือบล็อกคำสั่งซึ่งในกรณีนี้จะประเมินผลลัพธ์ออกมาได้เป็น 4 จากนั้นค่านั้นจะถูกผูกเข้ากับตัวแปร y โดยสเตตเมนต์ let โปรดสังเกตบรรทัด x + 1 ซึ่งไม่มีเครื่องหมายอัฒภาค (semicolon) ต่อท้าย ต่างจากบรรทัดส่วนใหญ่ที่คุณเคยเห็นมา นิพจน์จะไม่มีเครื่องหมายอัฒภาคปิดท้าย หากคุณใส่อัฒภาคต่อท้ายนิพจน์ มันจะกลายสภาพเป็นสเตตเมนต์ทันที และจะไม่มีการคืนค่าใดๆ ออกมาอีก ขอให้จำจุดนี้ไว้ให้ดีในระหว่างที่เราจะไปศึกษาเรื่องค่าคืนกลับของฟังก์ชันและนิพจน์กันต่อ
ฟังก์ชันที่มีการคืนค่า
ฟังก์ชันสามารถคืนค่ากลับไปยังโค้ดส่วนที่เรียกใช้ได้ เราไม่ต้องตั้งชื่อให้กับค่าคืนกลับ แต่เราจำเป็นต้องประกาศชนิดข้อมูลของมันหลังเครื่องหมายลูกศร (->) ใน Rust ค่าที่ฟังก์ชันคืนกลับจะเทียบเท่ากับค่าของนิพจน์สุดท้ายในบล็อกเนื้อหาของฟังก์ชันเสมอ คุณสามารถสั่งคืนค่าออกจากฟังก์ชันก่อนเวลาได้โดยใช้คีย์เวิร์ด return พร้อมกับระบุค่า แต่ฟังก์ชันส่วนใหญ่จะคืนค่าของนิพจน์สุดท้ายออกมาโดยปริยาย ตัวอย่างฟังก์ชันที่มีการคืนค่ามีดังนี้:
ชื่อไฟล์: src/main.rs
fn five() -> i32 {
    5
}

fn main() {
    let x = five();

    println!("The value of x is: {x}");
}
ในฟังก์ชัน five ไม่มีทั้งการเรียกฟังก์ชันอื่น ไม่มีมาโคร และไม่มีแม้กระทั่งสเตตเมนต์ let มีเพียงตัวเลข 5 โดดๆ เท่านั้น ซึ่งนี่ถือเป็นฟังก์ชันที่ถูกต้องสมบูรณ์ในภาษา Rust โปรดสังเกตว่ามีการระบุชนิดข้อมูลคืนกลับของฟังก์ชันเป็น -> i32 ด้วย เมื่อลองรันโค้ดนี้ จะได้ผลลัพธ์ดังนี้:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.30s
     Running `target/debug/functions`
The value of x is: 5
เลข 5 ในฟังก์ชัน five ก็คือค่าคืนกลับของฟังก์ชัน ซึ่งสอดคล้องกับชนิดข้อมูลคืนกลับที่เป็น i32 ลองมาพิจารณาเรื่องนี้อย่างละเอียดกันสักนิด มีสองประเด็นสำคัญ: ประการแรก บรรทัด let x = five(); แสดงให้เห็นว่าเรานำค่าที่ได้จากฟังก์ชันมากำหนดเป็นค่าเริ่มต้นให้กับตัวแปร และเนื่องจากฟังก์ชัน five คืนค่า 5 บรรทัดดังกล่าวจึงทำงานเทียบเท่ากับคำสั่งนี้:
#![allow(unused)]
fn main() {
let x = 5;
}
ประการที่สอง ฟังก์ชัน five ไม่มีพารามิเตอร์และได้ระบุชนิดข้อมูลคืนกลับเอาไว้ โดยเนื้อหาของฟังก์ชันมีเพียงเลข 5 เดี่ยวๆ ที่ไม่มีเครื่องหมายอัฒภาคปิดท้าย เพราะนี่คือนิพจน์ที่ให้ค่าที่เราต้องการจะคืนกลับนั่นเอง
ลองมาดูอีกตัวอย่างหนึ่ง:
ชื่อไฟล์: src/main.rs
fn main() {
    let x = plus_one(5);

    println!("The value of x is: {x}");
}

fn plus_one(x: i32) -> i32 {
    x + 1
}
เมื่อรันโค้ดนี้ โปรแกรมจะพิมพ์ The value of x is: 6 ออกมา แต่จะเกิดอะไรขึ้นหากเราใส่เครื่องหมายอัฒภาคไว้ท้ายบรรทัด x + 1 จนทำให้นิพจน์กลายสภาพเป็นสเตตเมนต์?
ชื่อไฟล์: src/main.rs
fn main() {
    let x = plus_one(5);

    println!("The value of x is: {x}");
}

fn plus_one(x: i32) -> i32 {
    x + 1;
}
เมื่อนำโค้ดนี้ไปคอมไพล์ จะเกิดข้อผิดพลาดขึ้นดังนี้:
$ cargo run
   Compiling functions v0.1.0 (file:///projects/functions)
error[E0308]: mismatched types
 --> src/main.rs:7:24
  |
7 | fn plus_one(x: i32) -> i32 {
  |    --------            ^^^ expected `i32`, found `()`
  |    |
  |    implicitly returns `()` as its body has no tail or `return` expression
8 |     x + 1;
  |          - help: remove this semicolon to return this value

For more information about this error, try `rustc --explain E0308`.
error: could not compile `functions` (bin "functions") due to 1 previous error
ข้อความแจ้งข้อผิดพลาดหลักอย่าง mismatched types ได้บ่งชี้ถึงใจความสำคัญของปัญหา ในนิยามของฟังก์ชัน plus_one ระบุไว้ว่าจะคืนค่าเป็น i32 แต่สเตตเมนต์ไม่ได้ประเมินผลออกมาเป็นค่าใดๆ ซึ่งแทนด้วยชนิดข้อมูล unit หรือ () ผลก็คือฟังก์ชันไม่ได้คืนค่าใดๆ กลับไป ขัดแย้งกับข้อกำหนดในนิยามฟังก์ชันและทำให้คอมไพล์ไม่ผ่าน ในเอาต์พุตนี้ Rust ยังให้คำแนะนำที่ช่วยแก้ปัญหา โดยแนะนำให้ลบเครื่องหมายอัฒภาคออก ซึ่งจะช่วยแก้ไขข้อผิดพลาดนี้ได้
คอมเมนต์
คอมเมนต์
โปรแกรมเมอร์ทุกคนต่างพยายามเขียนโค้ดให้อ่านและเข้าใจง่าย แต่บางครั้งการเขียนคำอธิบายเพิ่มเติมก็มีประโยชน์อย่างยิ่ง ในกรณีเช่นนี้ โปรแกรมเมอร์จะเขียน คอมเมนต์ (comment) ทิ้งไว้ในซอร์สโค้ด ซึ่งคอมไพเลอร์จะมองข้ามข้อความเหล่านี้ไป แต่ผู้อ่านโค้ดจะได้รับประโยชน์จากคำอธิบายดังกล่าว
นี่คือตัวอย่างคอมเมนต์แบบเรียบง่าย:
#![allow(unused)]
fn main() {
// hello, world
}
ใน Rust รูปแบบคอมเมนต์มาตรฐานที่นิยมใช้จะเริ่มต้นด้วยเครื่องหมายทับสองตัว (//) และข้อความคอมเมนต์จะครอบคลุมไปจนจบบรรทัดนั้น สำหรับคอมเมนต์ที่มีความยาวเกินหนึ่งบรรทัด คุณจะต้องใส่ // ไว้ที่ต้นบรรทัดของแต่ละบรรทัด ดังนี้:
#![allow(unused)]
fn main() {
// So we're doing something complicated here, long enough that we need
// multiple lines of comments to do it! Whew! Hopefully, this comment will
// explain what's going on.
}
นอกจากนี้ เรายังสามารถวางคอมเมนต์ไว้ท้ายบรรทัดคำสั่งได้ด้วย:
ชื่อไฟล์: src/main.rs
fn main() {
    let lucky_number = 7; // I'm feeling lucky today
}
อย่างไรก็ดี คุณมักจะพบเห็นการเขียนคอมเมนต์ในรูปแบบแยกบรรทัดไว้เหนือโค้ดที่ต้องการอธิบายมากกว่า:
ชื่อไฟล์: src/main.rs
fn main() {
    // I'm feeling lucky today
    let lucky_number = 7;
}
Rust ยังมีคอมเมนต์อีกประเภทหนึ่ง นั่นคือคอมเมนต์เอกสาร (documentation comment) ซึ่งเราจะกล่าวถึงในหัวข้อ “การเผยแพร่เครตไปยัง Crates.io” ในบทที่ 14
การควบคุมโฟลว์
การควบคุมโฟลว์
ความสามารถในการสั่งให้โค้ดบางส่วนทำงานตามเงื่อนไข (condition) ว่าเป็นจริง (true) หรือไม่ รวมถึงความสามารถในการสั่งให้โค้ดทำงานซ้ำๆ ตราบใดที่เงื่อนไขยังเป็นจริง ถือเป็นโครงสร้างพื้นฐานที่มีอยู่ในภาษาโปรแกรมเกือบทุกภาษา สำหรับใน Rust โครงสร้างหลักๆ ที่ใช้ควบคุมลำดับการทำงาน (control flow) ของโปรแกรมก็คือนิพจน์ if และลูป (loop)
นิพจน์ if
นิพจน์ if ช่วยให้คุณสามารถแยกสายการทำงาน (branch) ของโค้ดตามเงื่อนไขที่กำหนดได้ โดยมีหลักการคือ “หากเงื่อนไขนี้เป็นจริง ให้ทำงานในบล็อกโค้ดนี้ แต่ถ้าเงื่อนไขไม่เป็นจริง ก็ไม่ต้องทำงานในบล็อกนี้”
สร้างโปรเจกต์ใหม่ชื่อ branches ในไดเรกทอรี projects ของคุณเพื่อสำรวจนิพจน์ if ในไฟล์ src/main.rs ให้ป้อนโค้ดต่อไปนี้:
ชื่อไฟล์: src/main.rs
fn main() {
    let number = 3;

    if number < 5 {
        println!("condition was true");
    } else {
        println!("condition was false");
    }
}
นิพจน์ if ทั้งหมดเริ่มต้นด้วยคำสงวน if ตามด้วยเงื่อนไข ในกรณีนี้ เงื่อนไขจะตรวจสอบว่าตัวแปร number มีค่าน้อยกว่า 5 หรือไม่ เราวางบล็อกโค้ดที่จะทำงานหากเงื่อนไขเป็น true ไว้หลังเงื่อนไขทันทีภายในวงเล็บปีกกา บล็อกโค้ดที่เชื่อมโยงกับเงื่อนไขในนิพจน์ if บางครั้งเรียกว่า_กิ่งกรณี_ หรือ แขนง (arm) เช่นเดียวกับกิ่งกรณีในนิพจน์ match ที่เราได้พูดถึงในหัวข้อ“การเปรียบเทียบคำทายกับตัวเลขลับ” ของบทที่ 2
นอกจากนี้ เรายังสามารถใส่นิพจน์ else เพิ่มเติมได้ด้วย ซึ่งเราเลือกใส่ในตัวอย่างนี้ เพื่อให้โปรแกรมมีบล็อกโค้ดทางเลือกที่จะทำงานในกรณีที่เงื่อนไขประเมินค่าเป็น false หากคุณไม่ได้ระบุนิพจน์ else และเงื่อนไขเป็น false โปรแกรมก็จะข้ามบล็อก if ไปทำงานที่โค้ดส่วนถัดไปทันที
ลองรันโค้ดนี้ดู คุณควรเห็นเอาต์พุตต่อไปนี้:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/branches`
condition was true
มาลองเปลี่ยนค่าของ number เป็นค่าที่ทำให้เงื่อนไขเป็น false เพื่อดูว่าเกิดอะไรขึ้น:
fn main() {
    let number = 7;

    if number < 5 {
        println!("condition was true");
    } else {
        println!("condition was false");
    }
}
รันโปรแกรมอีกครั้ง แล้วดูเอาต์พุต:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/branches`
condition was false
นอกจากนี้ สิ่งสำคัญที่ควรสังเกตคือเงื่อนไขในโค้ดนี้ จะต้อง เป็นชนิดข้อมูล bool เสมอ หากเงื่อนไขไม่ใช่ bool คอมไพเลอร์จะแจ้งข้อผิดพลาดทันที ตัวอย่างเช่น ลองรันโค้ดต่อไปนี้:
ชื่อไฟล์: src/main.rs
fn main() {
    let number = 3;

    if number {
        println!("number was three");
    }
}
คราวนี้เงื่อนไข if ประเมินค่าได้เป็น 3 และ Rust แจ้งข้อผิดพลาดออกมา:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
error[E0308]: mismatched types
 --> src/main.rs:4:8
  |
4 |     if number {
  |        ^^^^^^ expected `bool`, found integer

For more information about this error, try `rustc --explain E0308`.
error: could not compile `branches` (bin "branches") due to 1 previous error
ข้อความแสดงข้อผิดพลาดระบุว่า Rust คาดหวังชนิดข้อมูล bool แต่ได้รับตัวเลขจำนวนเต็มมาแทน ต่างจากภาษาอย่างเช่น Ruby หรือ JavaScript ตรงที่ Rust จะไม่พยายามแปลงชนิดข้อมูลที่ไม่ใช่บูลีนให้เป็นบูลีนโดยอัตโนมัติ คุณจะต้องระบุเงื่อนไขอย่างชัดแจ้งและกำหนดให้นิพจน์ if ได้รับค่าบูลีนเป็นเงื่อนไขเสมอ ตัวอย่างเช่น หากเราต้องการให้บล็อกโค้ด if ทำงานเฉพาะเมื่อตัวเลขไม่เท่ากับ 0 เราสามารถแก้ไขนิพจน์ if ได้ดังนี้:
ชื่อไฟล์: src/main.rs
fn main() {
    let number = 3;

    if number != 0 {
        println!("number was something other than zero");
    }
}
การรันโค้ดนี้จะพิมพ์ number was something other than zero
การจัดการหลายเงื่อนไขด้วย else if
คุณสามารถตรวจสอบหลายเงื่อนไขได้โดยการผสาน if และ else เข้าด้วยกันเป็นนิพจน์ else if ตัวอย่างเช่น:
ชื่อไฟล์: src/main.rs
fn main() {
    let number = 6;

    if number % 4 == 0 {
        println!("number is divisible by 4");
    } else if number % 3 == 0 {
        println!("number is divisible by 3");
    } else if number % 2 == 0 {
        println!("number is divisible by 2");
    } else {
        println!("number is not divisible by 4, 3, or 2");
    }
}
โปรแกรมนี้มีเส้นทางที่เป็นไปได้สี่เส้นทาง หลังจากรันแล้ว คุณควรเห็นเอาต์พุตต่อไปนี้:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.31s
     Running `target/debug/branches`
number is divisible by 3
เมื่อโปรแกรมนี้ทำงาน มันจะตรวจสอบนิพจน์ if แต่ละเงื่อนไขตามลำดับ และจะสั่งให้บล็อกแรกสุดที่เงื่อนไขประเมินค่าเป็น true ทำงาน โปรดสังเกตว่าแม้ 6 จะหารด้วย 2 ลงตัว แต่เราจะไม่เห็นเอาต์พุต number is divisible by 2 และไม่เห็นข้อความ number is not divisible by 4, 3, or 2 จากบล็อก else นั่นเป็นเพราะ Rust จะรันเฉพาะบล็อกของเงื่อนไขแรกที่เป็น true เท่านั้น และเมื่อพบเงื่อนไขที่เป็นจริงแล้ว ก็จะไม่ตรวจสอบเงื่อนไขที่เหลืออีกเลย
การใช้นิพจน์ else if ต่อกันมากเกินไปอาจทำให้โค้ดดูรกรุงรังและอ่านยาก ดังนั้นหากคุณมีเงื่อนไขมากกว่าหนึ่งเงื่อนไข คุณอาจพิจารณารีแฟกเตอร์ (refactor) โค้ดของคุณ ซึ่งในบทที่ 6 จะอธิบายถึงโครงสร้างการแยกสายการทำงานอันทรงพลังของ Rust ที่ชื่อว่า match สำหรับกรณีเหล่านี้
การใช้ if ในคำสั่ง let
เนื่องจาก if เป็นนิพจน์ เราจึงสามารถนำมันไปวางไว้ทางด้านขวาของคำสั่ง let เพื่อกำหนดค่าให้กับตัวแปรได้ ดังในลิสติ้ง 3-2
fn main() {
    let condition = true;
    let number = if condition { 5 } else { 6 };

    println!("The value of number is: {number}");
}
ตัวแปร number จะถูกผูกเข้ากับค่าตามผลลัพธ์ของนิพจน์ if ลองรันโค้ดนี้เพื่อดูสิ่งที่เกิดขึ้น:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.30s
     Running `target/debug/branches`
The value of number is: 5
โปรดจำไว้ว่า บล็อกโค้ดจะประเมินค่าเป็นนิพจน์สุดท้ายในบล็อกนั้น และตัวเลขโดดๆ ก็ถือเป็นนิพจน์เช่นกัน ในกรณีนี้ ค่าของนิพจน์ if ทั้งหมดจึงขึ้นอยู่กับว่าบล็อกโค้ดใดทำงาน ซึ่งหมายความว่าค่าที่เป็นไปได้จากแต่ละกิ่งกรณีของ if จะต้องเป็นชนิดข้อมูลเดียวกัน ในลิสติ้ง 3-2 ผลลัพธ์ของทั้งกิ่ง if และกิ่ง else ต่างเป็นจำนวนเต็ม i32 แต่หากชนิดข้อมูลไม่ตรงกัน ดังในตัวอย่างต่อไปนี้ ก็จะเกิดข้อผิดพลาดขึ้น:
ชื่อไฟล์: src/main.rs
fn main() {
    let condition = true;

    let number = if condition { 5 } else { "six" };

    println!("The value of number is: {number}");
}
เมื่อเราพยายามคอมไพล์โค้ดนี้ เราจะพบข้อผิดพลาด เนื่องจากกิ่ง if และ else มีชนิดของค่าที่เข้ากันไม่ได้ และ Rust จะระบุตำแหน่งของปัญหาในโปรแกรมไว้อย่างชัดเจน:
$ cargo run
   Compiling branches v0.1.0 (file:///projects/branches)
error[E0308]: `if` and `else` have incompatible types
 --> src/main.rs:4:44
  |
4 |     let number = if condition { 5 } else { "six" };
  |                                 -          ^^^^^ expected integer, found `&str`
  |                                 |
  |                                 expected because of this

For more information about this error, try `rustc --explain E0308`.
error: could not compile `branches` (bin "branches") due to 1 previous error
นิพจน์ในบล็อก if ประเมินค่าได้เป็นจำนวนเต็ม ส่วนนิพจน์ในบล็อก else ประเมินค่าได้เป็นสตริง โค้ดนี้ไม่สามารถทำงานได้ เนื่องจากตัวแปรต้องมีชนิดข้อมูลที่แน่นอนเพียงชนิดเดียว และ Rust จำเป็นต้องทราบอย่างแน่ชัดตั้งแต่ขั้นตอนการคอมไพล์ว่าตัวแปร number มีชนิดข้อมูลใด การทราบชนิดข้อมูลของ number ช่วยให้คอมไพเลอร์สามารถตรวจสอบความถูกต้องได้ทุกจุดที่เราเรียกใช้ number ซึ่ง Rust จะไม่สามารถตรวจสอบเช่นนั้นได้เลยหากชนิดข้อมูลของ number ถูกกำหนดเฉพาะตอนรันไทม์ (runtime) เพราะคอมไพเลอร์จะต้องมีความซับซ้อนขึ้นอย่างมาก และไม่สามารถให้การรับประกันด้านความปลอดภัยของโค้ดได้ หากต้องคอยติดตามความเป็นไปได้ของชนิดข้อมูลหลายชนิดในตัวแปรตัวหนึ่ง
การวนซ้ำด้วยลูป
การสั่งให้บล็อกโค้ดทำงานซ้ำมากกว่าหนึ่งครั้งถือเป็นงานที่พบบ่อยและมีประโยชน์อย่างยิ่ง สำหรับงานนี้ Rust มีโครงสร้าง_ลูป_ (loop) ให้เลือกใช้งานหลายรูปแบบ ซึ่งจะรันโค้ดภายในตัวลูปไปจนสุดแล้ววนกลับมาเริ่มต้นใหม่ทันที เพื่อทดลองใช้งานลูป มาสร้างโปรเจกต์ใหม่ชื่อ loops กัน
Rust มีลูปให้ใช้งานสามรูปแบบ ได้แก่ loop, while และ for มาลองดูทีละแบบกัน
การรันโค้ดซ้ำด้วย loop
คำสงวน loop จะสั่งให้ Rust รันบล็อกโค้ดซ้ำไปเรื่อยๆ อย่างไม่มีที่สิ้นสุด จนกว่าคุณจะสั่งให้มันหยุดอย่างชัดเจน
ตัวอย่างเช่น เปลี่ยนไฟล์ src/main.rs ในไดเรกทอรี loops ของคุณให้มีลักษณะดังนี้:
ชื่อไฟล์: src/main.rs
fn main() {
    loop {
        println!("again!");
    }
}
เมื่อเรารันโปรแกรมนี้ เราจะเห็นข้อความ again! ถูกพิมพ์ซ้ำไปเรื่อยๆ อย่างต่อเนื่องจนกว่าเราจะหยุดโปรแกรมด้วยตนเอง เทอร์มินัลส่วนใหญ่รองรับคีย์ลัด ctrl-C เพื่อขัดจังหวะโปรแกรมที่ติดอยู่ในลูปต่อเนื่อง ลองดูสิ:
$ cargo run
   Compiling loops v0.1.0 (file:///projects/loops)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.08s
     Running `target/debug/loops`
again!
again!
again!
again!
^Cagain!
สัญลักษณ์ ^C แสดงถึงตำแหน่งที่คุณกด ctrl-C
คุณอาจเห็นหรือไม่เห็นคำว่า again! พิมพ์ตามหลัง ^C ขึ้นอยู่กับว่าโค้ดกำลังทำงานอยู่ที่ตำแหน่งใดของลูปเมื่อได้รับสัญญาณขัดจังหวะ
โชคดีที่ Rust ยังมีวิธีออกจากลูปโดยใช้โค้ดด้วย คุณสามารถใส่คำสงวน break ไว้ภายในลูปเพื่อสั่งให้โปรแกรมหยุดการทำงานของลูปเมื่อถึงจุดที่ต้องการ ย้อนนึกดูว่าเราได้ทำเช่นนี้ในเกมทายตัวเลขในหัวข้อ“ออกจากเกมเมื่อทายถูก” ของบทที่ 2 เพื่อออกจากโปรแกรมเมื่อผู้เล่นชนะเกมด้วยการทายตัวเลขที่ถูกต้อง
นอกจากนี้ เรายังได้ใช้ continue ในเกมทายตัวเลขด้วย ซึ่งเมื่ออยู่ในลูป มันจะสั่งให้โปรแกรมข้ามโค้ดที่เหลือทั้งหมดในรอบการวนซ้ำ (iteration) ปัจจุบัน แล้วข้ามไปยังรอบถัดไปทันที
การคืนค่าจากลูป
ประโยชน์ประการหนึ่งของ loop คือการลองทำซ้ำในงานที่คุณทราบว่าอาจมีโอกาสล้มเหลว เช่น การตรวจสอบว่าเธรด (thread) ทำงานเสร็จสิ้นแล้วหรือไม่ และคุณอาจจำเป็นต้องส่งผลลัพธ์ของงานนั้นออกจากลูปกลับไปยังโค้ดส่วนที่เหลือด้วย เพื่อทำเช่นนั้น คุณสามารถระบุค่าที่ต้องการส่งกลับไว้หลังนิพจน์ break ที่คุณใช้หยุดลูป โดยค่านั้นจะถูกส่งออกมาจากลูปเพื่อให้คุณนำไปใช้งานต่อ ดังที่แสดงที่นี่:
fn main() {
    let mut counter = 0;

    let result = loop {
        counter += 1;

        if counter == 10 {
            break counter * 2;
        }
    };

    println!("The result is {result}");
}
ก่อนลูป เราประกาศตัวแปรชื่อ counter และกำหนดค่าเริ่มต้นเป็น 0 จากนั้นเราประกาศตัวแปรชื่อ result เพื่อเก็บค่าที่คืนกลับมาจากลูป ในทุกๆ รอบของการวนซ้ำ เราเพิ่มค่า 1 ให้กับตัวแปร counter แล้วตรวจสอบว่า counter มีค่าเท่ากับ 10 หรือไม่ เมื่อเท่ากัน เราจะใช้คำสงวน break พร้อมกับค่า counter * 2 หลังจบลูป เราใช้อัฒภาค (semicolon) เพื่อจบคำสั่งที่กำหนดค่าให้กับ result สุดท้าย เราพิมพ์ค่าใน result ออกมา ซึ่งในกรณีนี้คือ 20
คุณยังสามารถใช้ return จากภายในลูปได้เช่นกัน โดยขณะที่ break จะออกจากลูปปัจจุบันเท่านั้น คำสั่ง return จะออกจากฟังก์ชันปัจจุบันเสมอ
การแยกแยะลูปด้วยเลเบลของลูป
หากคุณมีลูปซ้อนอยู่ในลูป คำสั่ง break และ continue จะมีผลกับลูปชั้นในสุด ณ ตำแหน่งนั้น คุณสามารถระบุ_เลเบลของลูป_ (loop label) ให้กับลูปได้ตามต้องการ ซึ่งจากนั้นคุณสามารถนำมาใช้ร่วมกับ break หรือ continue เพื่อระบุว่าคำสงวนเหล่านั้นมีผลกับลูปที่มีเลเบลใด แทนที่จะเป็นลูปชั้นในสุด โดยเลเบลของลูปต้องขึ้นต้นด้วยเครื่องหมายอัญประกาศเดี่ยว (single quote) นี่คือตัวอย่างที่มีลูปซ้อนกันสองชั้น:
fn main() {
    let mut count = 0;
    'counting_up: loop {
        println!("count = {count}");
        let mut remaining = 10;

        loop {
            println!("remaining = {remaining}");
            if remaining == 9 {
                break;
            }
            if count == 2 {
                break 'counting_up;
            }
            remaining -= 1;
        }

        count += 1;
    }
    println!("End count = {count}");
}
ลูปชั้นนอกมีเลเบล 'counting_up และจะนับขึ้นจาก 0 ถึง 2 ลูปชั้นในที่ไม่มีเลเบลจะนับลงจาก 10 ถึง 9 break ตัวแรกที่ไม่ได้ระบุเลเบลจะออกจากลูปชั้นในเท่านั้น ส่วนคำสั่ง break 'counting_up; จะออกจากลูปชั้นนอก โค้ดนี้จะพิมพ์:
$ cargo run
   Compiling loops v0.1.0 (file:///projects/loops)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.58s
     Running `target/debug/loops`
count = 0
remaining = 10
remaining = 9
count = 1
remaining = 10
remaining = 9
count = 2
remaining = 10
End count = 2
ทำลูปแบบมีเงื่อนไขให้กระชับด้วย while
โปรแกรมมักจำเป็นต้องตรวจสอบเงื่อนไขภายในลูปอยู่เสมอ ตราบใดที่เงื่อนไขยังคงเป็น true ลูปก็จะทำงานต่อไป เมื่อเงื่อนไขไม่เป็น true อีกต่อไป โปรแกรมก็จะเรียก break เพื่อหยุดลูป ซึ่งเราสามารถสร้างพฤติกรรมเช่นนี้ได้โดยใช้การผสมผสานระหว่าง loop, if, else และ break เข้าด้วยกัน (คุณอาจลองทำในโปรแกรมตอนนี้ดูได้หากต้องการ) อย่างไรก็ตาม รูปแบบนี้พบได้บ่อยมากจน Rust มีโครงสร้างภาษาในตัวสำหรับมันโดยเฉพาะ เรียกว่าลูป while ในลิสติ้ง 3-3 เราใช้ while เพื่อวนซ้ำโปรแกรมสามรอบ โดยนับถอยหลังในแต่ละรอบ และหลังจากลูปแล้ว ก็จะพิมพ์ข้อความและจบโปรแกรม
fn main() {
    let mut number = 3;

    while number != 0 {
        println!("{number}!");

        number -= 1;
    }

    println!("LIFTOFF!!!");
}
โครงสร้างนี้ช่วยขจัดความซับซ้อนของการเขียนโค้ดซ้อนกันหลายชั้นที่จะจำเป็นหากคุณใช้ loop, if, else และ break อีกทั้งยังอ่านเข้าใจได้ชัดเจนกว่า ตราบใดที่เงื่อนไขประเมินค่าเป็น true โค้ดก็จะทำงานต่อไป มิฉะนั้นก็จะออกจากลูปทันที
การวนซ้ำผ่านคอลเลกชันด้วย for
คุณสามารถเลือกใช้โครงสร้าง while เพื่อวนซ้ำผ่านสมาชิกของคอลเลกชัน เช่น อาร์เรย์ได้ ตัวอย่างเช่น ลูปในลิสติ้ง 3-4 จะพิมพ์แต่ละสมาชิกในอาร์เรย์ a
fn main() {
    let a = [10, 20, 30, 40, 50];
    let mut index = 0;

    while index < 5 {
        println!("the value is: {}", a[index]);

        index += 1;
    }
}
ในที่นี้ โค้ดจะนับขึ้นผ่านสมาชิกต่างๆ ในอาร์เรย์ มันเริ่มที่ดัชนี 0 แล้ววนซ้ำจนกว่าจะถึงดัชนีสุดท้ายในอาร์เรย์ (นั่นคือ เมื่อ index < 5 ไม่เป็น true อีกต่อไป) การรันโค้ดนี้จะพิมพ์ทุกสมาชิกในอาร์เรย์ออกมา:
$ cargo run
   Compiling loops v0.1.0 (file:///projects/loops)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.32s
     Running `target/debug/loops`
the value is: 10
the value is: 20
the value is: 30
the value is: 40
the value is: 50
ค่าทั้งห้าตัวของอาร์เรย์จะปรากฏในเทอร์มินัลตามที่คาดไว้ แม้ว่า index จะไปถึงค่า 5 ในท้ายที่สุด แต่ลูปก็หยุดทำงานก่อนที่จะพยายามดึงค่าตัวที่หกออกมาจากอาร์เรย์
อย่างไรก็ตาม วิธีการนี้เสี่ยงต่อข้อผิดพลาดได้ง่าย (error-prone) เราอาจทำให้โปรแกรมเกิดการแพนิก (panic) ได้หากค่าดัชนีหรือเงื่อนไขการทดสอบไม่ถูกต้อง ตัวอย่างเช่น หากคุณเปลี่ยนนิยามของอาร์เรย์ a ให้มีสมาชิกสี่ตัวแต่ลืมอัปเดตเงื่อนไขเป็น while index < 4 โค้ดก็จะเกิดการแพนิกทันที นอกจากนี้ยังทำงานช้ากว่าด้วย เพราะคอมไพเลอร์ต้องเพิ่มโค้ดตอนรันไทม์เพื่อตรวจสอบเงื่อนไขว่าดัชนีอยู่ในขอบเขตของอาร์เรย์หรือไม่ในทุกๆ รอบของการวนซ้ำ
เพื่อเป็นทางเลือกที่กระชับกว่า คุณสามารถใช้ลูป for และสั่งให้โค้ดทำงานกับแต่ละรายการในคอลเลกชัน ลูป for มีลักษณะเหมือนโค้ดในลิสติ้ง 3-5
fn main() {
    let a = [10, 20, 30, 40, 50];

    for element in a {
        println!("the value is: {element}");
    }
}
เมื่อเรารันโค้ดนี้ เราจะเห็นเอาต์พุตเดียวกับในลิสติ้ง 3-4 ที่สำคัญกว่านั้น ตอนนี้เราได้เพิ่มความปลอดภัยให้กับโค้ดและขจัดโอกาสเกิดบั๊กที่อาจเกิดจากการเข้าถึงเกินจุดสิ้นสุดของอาร์เรย์ หรือการวนซ้ำไม่ครบจนพลาดบางรายการ โค้ดภาษาเครื่อง (machine code) ที่สร้างจากลูป for ยังมีประสิทธิภาพมากกว่าด้วย เพราะไม่จำเป็นต้องเปรียบเทียบดัชนีกับความยาวของอาร์เรย์ในทุกๆ รอบของการวนซ้ำ
การใช้ลูป for ช่วยให้คุณไม่จำเป็นต้องจำไปแก้ไขโค้ดส่วนอื่นหากคุณเปลี่ยนจำนวนค่าในอาร์เรย์ ซึ่งต่างจากวิธีที่ใช้ในลิสติ้ง 3-4
ความปลอดภัยและความกระชับของลูป for ทำให้มันกลายเป็นโครงสร้างลูปที่นิยมใช้งานมากที่สุดใน Rust แม้ในสถานการณ์ที่คุณต้องการรันโค้ดตามจำนวนรอบที่แน่นอน ดังในตัวอย่างการนับถอยหลังที่ใช้ลูป while ในลิสติ้ง 3-3 ชาว Rustacean ส่วนใหญ่ก็จะเลือกใช้ลูป for วิธีทำเช่นนั้นคือใช้ Range ซึ่งไลบรารีมาตรฐานจัดเตรียมไว้ให้ และจะสร้างตัวเลขทั้งหมดตามลำดับ เริ่มจากจำนวนหนึ่งและสิ้นสุดก่อนหน้าอีกจำนวนหนึ่ง
นี่คือลักษณะของการนับถอยหลังหากใช้ลูป for และเมธอดอีกตัวหนึ่งที่เรายังไม่ได้พูดถึง นั่นคือ rev เพื่อกลับลำดับของช่วงข้อมูล:
ชื่อไฟล์: src/main.rs
fn main() {
    for number in (1..4).rev() {
        println!("{number}!");
    }
    println!("LIFTOFF!!!");
}
โค้ดนี้ดูดีขึ้นเยอะเลย ใช่ไหมครับ?
สรุป
คุณทำสำเร็จแล้ว! นี่เป็นบทที่มีเนื้อหาใหญ่ทีเดียว คุณได้เรียนรู้เกี่ยวกับตัวแปร, ชนิดข้อมูลสเกลาร์และข้อมูลประกอบ, ฟังก์ชัน, คอมเมนต์, นิพจน์ if และลูป! เพื่อฝึกฝนแนวคิดที่ได้เรียนรู้ในบทนี้ ลองลงมือสร้างโปรแกรมเพื่อทำสิ่งต่อไปนี้ดู:
- แปลงอุณหภูมิระหว่างฟาเรนไฮต์และเซลเซียส
- สร้างจำนวนฟีโบนัชชีตัวที่ n
- พิมพ์เนื้อเพลงคริสต์มาส “The Twelve Days of Christmas” โดยนำประโยชน์จากการทำซ้ำในเพลงมาประยุกต์ใช้
เมื่อคุณพร้อมที่จะไปต่อ เราจะพูดถึงแนวคิดใน Rust ที่_แทบไม่ปรากฏ_ในภาษาโปรแกรมอื่น ซึ่งก็คือระบบสิทธิ์ความเป็นเจ้าของ (ownership)
ทำความเข้าใจความเป็นเจ้าของ
ระบบความเป็นเจ้าของ (ownership) ถือเป็นฟีเจอร์ที่เป็นเอกลักษณ์โดดเด่นที่สุดของ Rust และส่งผลต่อการทำงานในส่วนอื่นๆ ทั้งหมดของภาษา โดยระบบนี้ช่วยให้ Rust สามารถรับประกันความปลอดภัยของหน่วยความจำ (memory safety) ได้โดยไม่จำเป็นต้องพึ่งพาตัวเก็บขยะ (garbage collector) ดังนั้นการทำความเข้าใจว่าระบบความเป็นเจ้าของทำงานอย่างไรจึงเป็นเรื่องที่สำคัญอย่างยิ่ง ในบทนี้ เราจะพูดถึงระบบความเป็นเจ้าของ รวมถึงฟีเจอร์ที่เกี่ยวข้องอีกหลายประการ ได้แก่ การยืมข้อมูล (borrowing), สไลซ์ (slice) ตลอดจนวิธีที่ Rust จัดวางและจัดการข้อมูลในหน่วยความจำ
ความเป็นเจ้าของคืออะไร?
ความเป็นเจ้าของคืออะไร?
ระบบความเป็นเจ้าของ (ownership) คือชุดกฎเกณฑ์ที่ควบคุมวิธีที่โปรแกรม Rust จัดการกับหน่วยความจำ ทุกๆ โปรแกรมล้วนต้องจัดการกับการใช้งานหน่วยความจำของคอมพิวเตอร์ในขณะทำงาน ภาษาโปรแกรมบางภาษามีระบบเก็บขยะ (garbage collection) ที่คอยกวาดหาหน่วยความจำที่ไม่ได้ใช้งานแล้วอย่างต่อเนื่องในขณะที่โปรแกรมกำลังทำงาน ส่วนในภาษาอื่นๆ โปรแกรมเมอร์จะต้องเป็นผู้จัดสรร (allocate) และคืน (free) หน่วยความจำด้วยตนเองอย่างชัดเจน แต่ Rust เลือกใช้แนวทางที่สาม นั่นคือการจัดการหน่วยความจำผ่านระบบความเป็นเจ้าของ โดยมีชุดกฎเกณฑ์ที่คอมไพเลอร์จะคอยตรวจสอบตั้งแต่ตอนคอมไพล์ หากมีการละเมิดกฎข้อใดข้อหนึ่ง โปรแกรมจะไม่สามารถคอมไพล์ผ่านได้ และที่สำคัญคือ กลไกของระบบความเป็นเจ้าของนี้จะไม่สร้างภาระ (overhead) ใดๆ ที่ทำให้โปรแกรมทำงานช้าลงในขณะรันไทม์เลย
เนื่องจากระบบความเป็นเจ้าของเป็นแนวคิดที่ค่อนข้างใหม่สำหรับโปรแกรมเมอร์จำนวนมาก จึงอาจต้องใช้เวลาปรับตัวและทำความคุ้นเคยอยู่บ้าง แต่ข่าวดีก็คือ ยิ่งคุณเขียนโค้ด Rust และคุ้นเคยกับกฎของระบบความเป็นเจ้าของมากขึ้นเท่าใด คุณจะพบว่าการเขียนโค้ดให้ปลอดภัยและมีประสิทธิภาพสูงนั้นกลายเป็นเรื่องที่เป็นธรรมชาติขึ้นเรื่อยๆ ขอให้มุ่งมั่นต่อไป!
เมื่อคุณเข้าใจระบบความเป็นเจ้าของอย่างถ่องแท้ คุณก็จะมีรากฐานที่แข็งแกร่งสำหรับทำความเข้าใจฟีเจอร์อื่นๆ ที่ทำให้ Rust โดดเด่น ในบทนี้เราจะมาเรียนรู้เรื่องความเป็นเจ้าของผ่านตัวอย่างหลากหลายรูปแบบ โดยเน้นไปที่โครงสร้างข้อมูลที่ใช้งานบ่อยมากชนิดหนึ่ง นั่นก็คือสตริง
สแตกและฮีป
ในภาษาโปรแกรมหลายภาษา คุณอาจแทบไม่ต้องคำนึงถึงสแตก (stack) และฮีป (heap) บ่อยนัก แต่สำหรับภาษาโปรแกรมระดับระบบ (systems programming language) อย่าง Rust การที่ค่าของข้อมูลถูกจัดเก็บไว้บนสแตกหรือบนฮีปจะส่งผลโดยตรงต่อพฤติกรรมของภาษาและการตัดสินใจในการเขียนโค้ดของคุณ ในบทนี้เราจะอธิบายบางแง่มุมของระบบความเป็นเจ้าของโดยเชื่อมโยงกับสแตกและฮีป ดังนั้นเรามาทบทวนคำอธิบายสั้นๆ ของสองสิ่งนี้เพื่อเตรียมความพร้อมกันก่อน
ทั้งสแตกและฮีปต่างก็เป็นส่วนหนึ่งของหน่วยความจำที่โปรแกรมสามารถเข้าใช้งานได้ในขณะรันไทม์ แต่โครงสร้างการทำงานของทั้งสองนั้นแตกต่างกันโดยสิ้นเชิง โดยสแตกจะจัดเก็บข้อมูลตามลำดับที่ได้รับเข้ามา และนำข้อมูลออกในลำดับย้อนกลับ ซึ่งเรียกว่า เข้าทีหลังออกก่อน (last in, first out หรือ LIFO) ลองนึกภาพกองจาน เมื่อคุณวางจานเพิ่ม คุณจะวางไว้บนสุดของกอง และเมื่อต้องการหยิบจานไปใช้ คุณก็จะหยิบจานใบบนสุดออกไป การพยายามสอดจานเข้าหรือดึงจานออกจากตรงกลางหรือก้นกองย่อมไม่ใช่เรื่องที่ทำได้สะดวก การเพิ่มข้อมูลลงในสแตกจะเรียกว่า การพุช (pushing onto the stack) และการนำข้อมูลออกจะเรียกว่า การป็อป (popping off the stack) ข้อมูลทั้งหมดที่จะถูกจัดเก็บบนสแตกจะต้องมีขนาดที่แน่นอนและคงที่ตั้งแต่ตอนคอมไพล์ ส่วนข้อมูลที่ไม่ทราบขนาดล่วงหน้าตอนคอมไพล์ หรือขนาดอาจเปลี่ยนแปลงได้ตลอดเวลา จะต้องถูกนำไปจัดเก็บบนฮีปแทน
ฮีปมีโครงสร้างที่เป็นระเบียบน้อยกว่า โดยเมื่อคุณต้องการเก็บข้อมูลบนฮีป โปรแกรมจะส่งคำขอพื้นที่ขนาดตามที่ต้องการไปยังตัวจัดสรรหน่วยความจำ (memory allocator) จากนั้นตัวจัดสรรจะค้นหาช่องว่างในฮีปที่มีขนาดใหญ่เพียงพอ ทำเครื่องหมายว่าพื้นที่นั้นกำลังถูกใช้งาน และส่งพอยน์เตอร์ (pointer) ซึ่งเป็นที่อยู่ (address) ของตำแหน่งดังกล่าวกลับมา กระบวนการนี้เรียกว่า การจัดสรรหน่วยความจำบนฮีป (allocating on the heap) หรือมักเรียกสั้นๆ ว่า การจัดสรร (allocating) (การพุชข้อมูลลงบนสแตกจะไม่ถือว่าเป็นการจัดสรร) เนื่องจากพอยน์เตอร์ที่ชี้ไปยังฮีปนั้นมีขนาดที่แน่นอนและคงที่ เราจึงสามารถเก็บตัวพอยน์เตอร์ไว้บนสแตกได้ แต่เมื่อใดที่เราต้องการเข้าถึงข้อมูลจริง เราจะต้องตามพอยน์เตอร์นั้นไปยังตำแหน่งบนฮีป ลองนึกภาพการไปรับประทานอาหารที่ร้านอาหาร เมื่อคุณมาถึง คุณจะแจ้งจำนวนคนที่ต้องการนั่ง พนักงานต้อนรับจะมองหาโต๊ะว่างที่ใหญ่พอสำหรับทุกคนและพาคุณไปนั่งที่โต๊ะนั้น หากเพื่อนของคุณตามมาทีหลัง พวกเขาก็สามารถถามพนักงานว่าโต๊ะของคุณอยู่ที่ไหนเพื่อเดินตามมาได้
การพุชข้อมูลลงบนสแตกทำงานได้เร็วกว่าการจัดสรรพื้นที่บนฮีปมาก เนื่องจากตัวจัดสรรไม่จำเป็นต้องค้นหาพื้นที่ว่างใหม่เลย เพราะตำแหน่งที่จะวางข้อมูลจะอยู่ที่บนสุดของสแตกเสมอ ในทางตรงกันข้าม การจัดสรรพื้นที่บนฮีปต้องมีขั้นตอนการทำงานมากกว่า เพราะตัวจัดสรรต้องใช้เวลาค้นหาพื้นที่ว่างที่มีขนาดพอเหมาะก่อน จากนั้นจึงต้องบันทึกข้อมูลทางบัญชีเพื่อเตรียมพร้อมสำหรับการจัดสรรครั้งถัดไป
นอกจากนี้ การเข้าถึงข้อมูลบนฮีปโดยทั่วไปยังช้ากว่าการเข้าถึงข้อมูลบนสแตก เนื่องจากโปรเซสเซอร์จะต้องตามพอยน์เตอร์ไปยังตำแหน่งข้อมูล โปรเซสเซอร์ยุคใหม่จะทำงานได้เร็วยิ่งขึ้นหากไม่ต้องกระโดดข้ามไปข้ามมาในหน่วยความจำ หากเปรียบเทียบกับพนักงานเสิร์ฟในร้านอาหารที่ต้องรับออร์เดอร์จากหลายโต๊ะ การรับออร์เดอร์จากโต๊ะหนึ่งให้ครบถ้วนก่อนจะเดินไปยังโต๊ะถัดไปย่อมมีประสิทธิภาพมากกว่าการรับออร์เดอร์จากโต๊ะ A สลับกับโต๊ะ B ไปมา ในทำนองเดียวกัน โปรเซสเซอร์จะทำงานได้เต็มประสิทธิภาพมากกว่าเมื่อประมวลผลข้อมูลที่อยู่ติดๆ กัน (เช่นข้อมูลที่เรียงอยู่บนสแตก) เมื่อเทียบกับข้อมูลที่กระจัดกระจายอยู่ห่างกัน (เช่นบนฮีป)
เมื่อโปรแกรมเรียกใช้ฟังก์ชัน ค่าต่างๆ ที่ส่งเข้าไปในฟังก์ชัน (ซึ่งรวมถึงพอยน์เตอร์ที่ชี้ไปยังข้อมูลบนฮีป) ตลอดจนตัวแปรเฉพาะที่ (local variables) ของฟังก์ชันนั้น จะถูกพุชลงบนสแตก และเมื่อฟังก์ชันทำงานเสร็จสิ้น ค่าเหล่านั้นก็จะถูกป็อปออกจากสแตกทันที
การคอยติดตามว่าโค้ดส่วนใดกำลังใช้งานข้อมูลใดบนฮีปอยู่, การลดข้อมูลที่ซ้ำซ้อนบนฮีปให้เหลือน้อยที่สุด, รวมถึงการตามล้างข้อมูลที่ไม่ได้ใช้งานแล้วบนฮีปเพื่อป้องกันไม่ให้หน่วยความจำเต็ม ล้วนเป็นภาระหน้าที่ที่ระบบความเป็นเจ้าของเข้ามาจัดการให้ เมื่อคุณเข้าใจระบบความเป็นเจ้าของแล้ว คุณอาจไม่จำเป็นต้องพะวงถึงสแตกและฮีปอยู่ตลอดเวลา แต่การตระหนักว่าเป้าหมายหลักประการหนึ่งของความเป็นเจ้าของคือการจัดการข้อมูลบนฮีป จะช่วยให้คุณเข้าใจได้อย่างถ่องแท้ว่าเหตุใด Rust จึงมีพฤติกรรมและการทำงานเช่นนี้
กฎของความเป็นเจ้าของ
ก่อนอื่น เรามาดูกฎพื้นฐานของระบบความเป็นเจ้าของกัน ขอให้จำกฎเหล่านี้ให้ขึ้นใจในระหว่างที่เราศึกษาตัวอย่างต่างๆ ต่อไป:
- ค่าทุกค่าใน Rust จะต้องมี เจ้าของ (owner) หนึ่งตัวเสมอ
- ค่าหนึ่งๆ จะมีเจ้าของได้เพียง หนึ่งเดียว เท่านั้นในเวลาใดเวลาหนึ่ง
- เมื่อตัวแปรที่เป็นเจ้าของหลุดออกจากขอบเขต (scope) ค่านั้นจะถูกทำลายทิ้งทันที
สโคปของตัวแปร
เนื่องจากเราได้ผ่านการเรียนรู้ไวยากรณ์พื้นฐานของ Rust มาแล้ว ในตัวอย่างต่อจากนี้เราจะไม่เขียนบล็อก fn main() { ซ้ำในทุกโค้ด ดังนั้นหากคุณทดลองเขียนโค้ดตาม อย่าลืมนำตัวอย่างเหล่านี้ไปใส่ไว้ในฟังก์ชัน main ด้วยตนเอง ซึ่งวิธีนี้จะช่วยให้ตัวอย่างโค้ดของเรากระชับขึ้น และช่วยให้เรามุ่งความสนใจไปที่รายละเอียดของเนื้อหาได้อย่างเต็มที่ โดยไม่ต้องมีโค้ดโครงสร้างซ้ำซ้อน
ในตัวอย่างแรกของเรื่องความเป็นเจ้าของ เราจะมาดูขอบเขต (scope) ของตัวแปรกัน ขอบเขต (scope) คือช่วงของโปรแกรมที่ตัวแปรหรือไอเท็มนั้นๆ ยังคงสามารถใช้งานได้ ลองพิจารณาตัวแปรต่อไปนี้:
#![allow(unused)]
fn main() {
let s = "hello";
}
ตัวแปร s อ้างอิงไปยังสตริงลิเทอรัล (string literal) โดยค่าของสตริงจะถูกฝังอยู่ในตัวโปรแกรมของเราโดยตรง ตัวแปรนี้จะสามารถใช้งานได้ตั้งแต่จุดที่มันถูกประกาศไปจนกระทั่งสิ้นสุดขอบเขตปัจจุบัน ลิสติ้ง 4-1 แสดงตัวอย่างโปรแกรมพร้อมคอมเมนต์ที่ระบุช่วงที่ตัวแปร s มีผลใช้งานได้
fn main() {
    {                      // s is not valid here, since it's not yet declared
        let s = "hello";   // s is valid from this point forward

        // do stuff with s
    }                      // this scope is now over, and s is no longer valid
}
กล่าวอีกนัยหนึ่ง มีจุดเวลาที่สำคัญสองจุดด้วยกัน:
- เมื่อ
sเข้า สู่ ขอบเขต มันจะเริ่มใช้งานได้ - และมันจะยังคงใช้งานได้ไปจนกระทั่งหลุดออก จาก ขอบเขต
ณ จุดนี้ ความสัมพันธ์ระหว่างขอบเขตกับการใช้งานตัวแปรจะคล้ายคลึงกับภาษาโปรแกรมอื่นๆ ต่อไปเราจะต่อยอดจากความเข้าใจนี้โดยการแนะนำชนิดข้อมูล String
ชนิด String
เพื่อแสดงให้เห็นการทำงานของกฎความเป็นเจ้าของ เราจำเป็นต้องใช้ชนิดข้อมูลที่มีความซับซ้อนกว่าชนิดข้อมูลที่เราเคยพูดถึงในหัวข้อ “ชนิดข้อมูล” ในบทที่ 3 ชนิดข้อมูลที่ผ่านมาทั้งหมดมีขนาดที่แน่นอนตอนคอมไพล์ จึงสามารถจัดเก็บบนสแตกและป็อปออกจากสแตกได้ทันทีเมื่อหมดขอบเขตการทำงาน อีกทั้งยังสามารถคัดลอกค่าเพื่อสร้างอินสแตนซ์ใหม่ได้อย่างสะดวกรวดเร็วเมื่อโค้ดส่วนอื่นต้องการใช้ค่าเดียวกันในอีกขอบเขตหนึ่ง แต่ในตอนนี้เราต้องการศึกษาข้อมูลที่จัดเก็บบนฮีป เพื่อดูว่า Rust ทราบได้อย่างไรว่าเมื่อใดควรคืนหน่วยความจำเหล่านั้น และชนิดข้อมูล String ก็เป็นตัวอย่างที่ยอดเยี่ยมสำหรับการศึกษานี้
เราจะเน้นเฉพาะส่วนของ String ที่เกี่ยวข้องกับระบบความเป็นเจ้าของ ซึ่งหลักการเหล่านี้จะนำไปประยุกต์ใช้กับชนิดข้อมูลที่ซับซ้อนอื่นๆ ได้เช่นกัน ไม่ว่าจะเป็นชนิดข้อมูลที่ไลบรารีมาตรฐานจัดเตรียมไว้ให้ หรือชนิดข้อมูลที่คุณสร้างขึ้นมาเอง โดยเราจะเจาะลึกรายละเอียดแง่มุมอื่นๆ ของ String เพิ่มเติมใน บทที่ 8
เราได้เห็นสตริงลิเทอรัลกันมาแล้ว ซึ่งค่าของข้อความจะถูกฝังตายตัวอยู่ในโปรแกรม แม้ว่าสตริงลิเทอรัลจะสะดวกและรวดเร็ว แต่ก็ไม่เหมาะกับทุกสถานการณ์ เพราะประการแรกคือ มันไม่สามารถแก้ไขเปลี่ยนแปลงค่าได้ (immutable) และประการที่สองคือ เราไม่สามารถทราบค่าของสตริงล่วงหน้าได้เสมอไปในตอนเขียนโค้ด เช่น ในกรณีที่เราต้องการรับข้อความอินพุตจากผู้ใช้แล้วนำมาเก็บไว้ ด้วยเหตุนี้ Rust จึงมีชนิดข้อมูล String เตรียมไว้ให้ โดยชนิดข้อมูลนี้จะจัดการข้อมูลที่จัดสรรอยู่บนฮีป จึงทำให้สามารถเก็บข้อความที่เราไม่ทราบขนาดล่วงหน้าตอนคอมไพล์ได้ คุณสามารถสร้าง String ขึ้นมาจากสตริงลิเทอรัลได้โดยใช้ฟังก์ชัน from ดังนี้:
#![allow(unused)]
fn main() {
let s = String::from("hello");
}
เครื่องหมายโคลอนคู่ :: ช่วยให้เราสามารถระบุเนมสเปซของฟังก์ชัน from ภายใต้ชนิดข้อมูล String ได้ แทนที่จะต้องตั้งชื่อฟังก์ชันแยกต่างหากอย่างเช่น string_from เราจะอธิบายไวยากรณ์นี้เพิ่มเติมในหัวข้อ “เมธอด” ของบทที่ 5 และตอนที่พูดถึงการจัดการเนมสเปซด้วยมอดูลใน “พาธสำหรับอ้างถึงรายการในแผนผังมอดูล” ในบทที่ 7
สตริงชนิดนี้ สามารถ แก้ไขเปลี่ยนแปลงค่าได้:
fn main() {
    let mut s = String::from("hello");

    s.push_str(", world!"); // push_str() appends a literal to a String

    println!("{s}"); // this will print `hello, world!`
}
แล้วอะไรคือความแตกต่างตรงนี้? ทำไม String ถึงเปลี่ยนแปลงค่าได้ แต่สตริงลิเทอรัลกลับทำไม่ได้? ความแตกต่างอยู่ที่วิธีที่ชนิดข้อมูลทั้งสองจัดการกับหน่วยความจำ
หน่วยความจำและการจัดสรร
ในกรณีของสตริงลิเทอรัล เรารู้เนื้อหาของข้อความล่วงหน้าตั้งแต่ตอนคอมไพล์ ข้อความจึงถูกฝังลงไปในไฟล์ไบนารีที่รันได้โดยตรง นี่คือเหตุผลที่สตริงลิเทอรัลมีความรวดเร็วและมีประสิทธิภาพสูงมาก แต่ข้อดีเหล่านี้เกิดขึ้นได้ก็เพราะความไม่สามารถเปลี่ยนแปลงค่าของมันเท่านั้น เราไม่สามารถจัดสรรพื้นที่หน่วยความจำลงในไฟล์ไบนารีล่วงหน้าสำหรับข้อความที่ยังไม่ทราบขนาดแน่ชัดตอนคอมไพล์ หรือข้อความที่มีขนาดขยายเพิ่มขึ้นได้ในขณะที่โปรแกรมกำลังทำงาน
สำหรับชนิดข้อมูล String เพื่อรองรับข้อความที่สามารถเปลี่ยนแปลงแก้ไขได้ (mutable) และขยายขนาดได้ เราจำเป็นต้องจัดสรรหน่วยความจำจำนวนหนึ่งบนฮีป ซึ่งไม่ทราบขนาดล่วงหน้าตอนคอมไพล์ เพื่อใช้จัดเก็บเนื้อหานั้น นั่นหมายความว่า:
- โปรแกรมจะต้องขอหน่วยความจำจากตัวจัดสรรหน่วยความจำ ณ เวลาทำงานจริง (runtime)
- เราต้องมีวิธีคืนหน่วยความจำนี้กลับไปยังตัวจัดสรรเมื่อเราใช้งาน
Stringนั้นเสร็จสิ้นแล้ว
ในส่วนแรกนั้น เราเป็นผู้สั่งการเอง เมื่อเราเรียก String::from การทำงานภายในของฟังก์ชันจะทำหน้าที่ขอหน่วยความจำตามที่ต้องการ ซึ่งเป็นรูปแบบการทำงานตามปกติในภาษาโปรแกรมทั่วไป
อย่างไรก็ตาม ในส่วนที่สองนั้นมีความแตกต่างกันอย่างมาก ในภาษาที่มี ตัวเก็บขยะ (garbage collector หรือ GC) ตัวเก็บขยะจะคอยตรวจสอบและคืนหน่วยความจำที่ไม่ได้ใช้งานแล้วให้โดยอัตโนมัติ ทำให้โปรแกรมเมอร์ไม่ต้องกังวลกับเรื่องนี้ ส่วนในภาษาโปรแกรมส่วนใหญ่ที่ไม่มีตัวเก็บขยะ จะเป็นหน้าที่ของโปรแกรมเมอร์เองที่จะต้องคอยระบุว่าเมื่อใดที่หน่วยความจำนั้นไม่ถูกใช้งานแล้ว และต้องเขียนคำสั่งเพื่อคืนหน่วยความจำนั้นอย่างชัดเจน เช่นเดียวกับตอนที่ขอพื้นที่มา ซึ่งการจัดการเรื่องนี้ให้ถูกต้องและครบถ้วนถือเป็นปัญหาที่ยากมากในการเขียนโปรแกรม หากเราลืมคืนหน่วยความจำ ก็จะเกิดปัญหาหน่วยความจำรั่วไหล (memory leak) แต่หากเราคืนหน่วยความจำเร็วเกินไป ตัวแปรที่ยังต้องใช้งานอยู่ก็จะไม่ถูกต้อง และหากเราเผลอคืนหน่วยความจำซ้ำสองครั้ง ก็จะเกิดบั๊กขึ้นมาอีก ดังนั้นเราจึงจำเป็นต้องจับคู่คำสั่งจอง (allocate) และคำสั่งคืน (free) ให้ตรงกันอย่างสมบูรณ์แบบพอดีหนึ่งต่อหนึ่งเสมอ
Rust เลือกใช้แนวทางที่แตกต่างออกไป นั่นคือ หน่วยความจำจะถูกคืนให้โดยอัตโนมัติทันทีที่ตัวแปรที่เป็นเจ้าของหลุดออกจากขอบเขต (scope) ตัวอย่างต่อไปนี้คือการปรับปรุงโค้ดจากลิสติ้ง 4-1 โดยเปลี่ยนมาใช้ String แทนสตริงลิเทอรัล:
fn main() {
    {
        let s = String::from("hello"); // s is valid from this point forward

        // do stuff with s
    }                                  // this scope is now over, and s is no
                                       // longer valid
}
มีจุดหนึ่งที่เราสามารถคืนหน่วยความจำที่ String ร้องขอไว้กลับไปยังตัวจัดสรรได้อย่างเป็นธรรมชาติที่สุด นั่นคือจุดที่ตัวแปร s หลุดออกจากขอบเขต เมื่อตัวแปรหลุดออกจากขอบเขต Rust จะเรียกใช้ฟังก์ชันพิเศษตัวหนึ่งให้เราโดยอัตโนมัติ ฟังก์ชันนี้มีชื่อว่า drop ซึ่งเป็นจุดที่ผู้พัฒนาชนิดข้อมูล String ได้เขียนโค้ดสำหรับคืนหน่วยความจำเอาไว้ โดย Rust จะสั่งเรียกฟังก์ชัน drop นี้ให้อัตโนมัติเมื่อโปรแกรมทำงานมาถึงเครื่องหมายวงเล็บปีกกาปิด
หมายเหตุ: ในภาษา C++ รูปแบบการคืนทรัพยากรเมื่อสิ้นสุดอายุขัย (lifetime) ของออบเจกต์ในลักษณะนี้มักจะเรียกว่า Resource Acquisition Is Initialization (RAII) ดังนั้นฟังก์ชัน
dropใน Rust จะดูคุ้นเคยอย่างยิ่งสำหรับผู้ที่เคยมีประสบการณ์กับรูปแบบ RAII มาก่อน
รูปแบบการทำงานนี้ส่งผลอย่างลึกซึ้งต่อแนวทางการเขียนโค้ดใน Rust ในตอนนี้มันอาจจะดูเรียบง่ายตรงไปตรงมา แต่พฤติกรรมของโค้ดอาจแสดงผลลัพธ์ที่คาดไม่ถึงได้ในสถานการณ์ที่ซับซ้อนยิ่งขึ้น เมื่อเราต้องการให้ตัวแปรหลายตัวทำงานร่วมกับข้อมูลชุดเดียวกันที่จัดสรรไว้บนฮีป เราลองมาดูสถานการณ์เหล่านั้นกันต่อ
ตัวแปรและข้อมูลที่ปฏิสัมพันธ์กันด้วยการย้ายค่า
ตัวแปรหลายตัวสามารถมีปฏิสัมพันธ์กับข้อมูลชุดเดียวกันได้ในหลายรูปแบบใน Rust ลิสติ้ง 4-2 แสดงตัวอย่างที่ใช้ชนิดข้อมูลจำนวนเต็ม (integer)
fn main() {
    let x = 5;
    let y = x;
}
เราน่าจะพอเดาได้ว่าโค้ดนี้ทำงานอย่างไร: “นำค่า 5 ไปผูกเข้ากับ x จากนั้นคัดลอกค่าใน x แล้วนำไปผูกเข้ากับ y” ในตอนนี้เรามีตัวแปรสองตัวคือ x และ y ซึ่งต่างก็มีค่าเป็น 5 ทั้งคู่ และนั่นคือสิ่งที่เกิดขึ้นจริง เนื่องจากจำนวนเต็มเป็นค่าข้อมูลพื้นฐานที่เรียบง่าย มีขนาดที่แน่นอนและคงที่ ค่า 5 ทั้งสองค่านี้จึงถูกพุชลงบนสแตกโดยตรง
ทีนี้ลองมาดูตัวอย่างเดียวกันแต่เปลี่ยนมาใช้ String กันบ้าง:
fn main() {
    let s1 = String::from("hello");
    let s2 = s1;
}
โค้ดนี้ดูคล้ายคลึงกันมาก จนเราอาจสันนิษฐานว่ามันน่าจะทำงานเหมือนกัน นั่นคือ บรรทัดที่สองจะทำการคัดลอกค่าใน s1 แล้วนำไปผูกกับ s2 แต่ในความเป็นจริงแล้วไม่ได้เป็นเช่นนั้นเลย
ลองดูรูปที่ 4-1 เพื่อทำความเข้าใจสิ่งที่เกิดขึ้นเบื้องหลังของ String โดย String จะประกอบด้วย 3 ส่วนตามที่แสดงทางด้านซ้าย ได้แก่ พอยน์เตอร์ที่ชี้ไปยังหน่วยความจำที่เก็บเนื้อหาของสตริง, ความยาว (length), และความจุ (capacity) ข้อมูลกลุ่มนี้จะถูกจัดเก็บบนสแตก ส่วนทางด้านขวาคือพื้นที่หน่วยความจำบนฮีปที่ใช้เก็บเนื้อหาข้อความจริงๆ
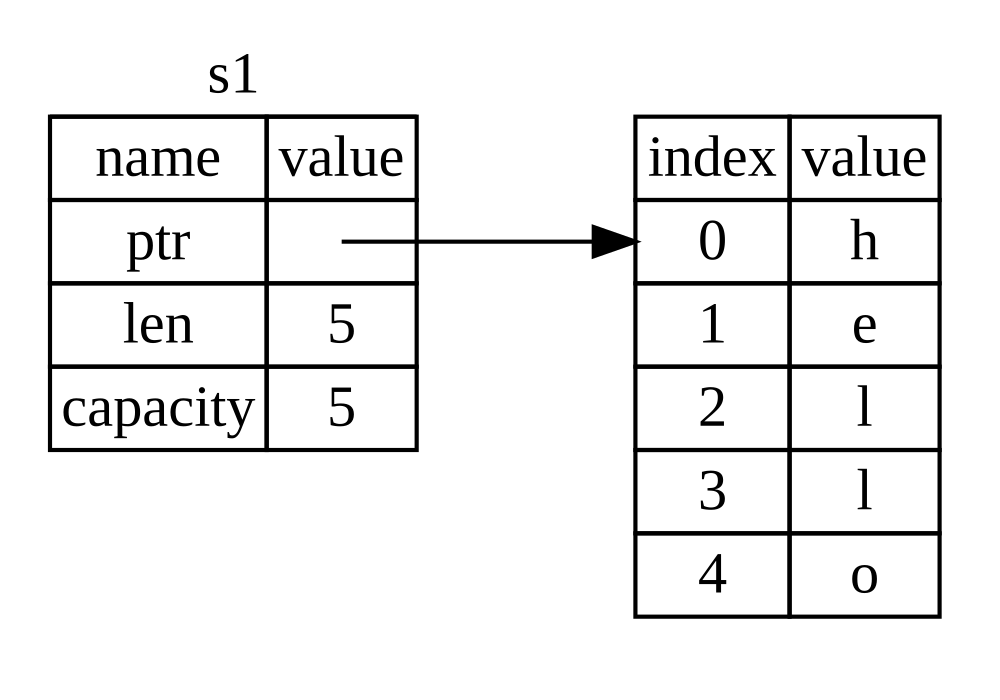
รูปที่ 4-1: การแทนค่าในหน่วยความจำของ String ที่เก็บค่า "hello" ซึ่งผูกกับ s1
ความยาว (length) คือขนาดของเนื้อหาข้อความใน String ณ ขณะนั้นในหน่วยไบต์ ส่วนความจุ (capacity) คือขนาดหน่วยความจำทั้งหมดที่ String ได้รับมาจากตัวจัดสรรในหน่วยไบต์ ความแตกต่างระหว่างความยาวและความจุนั้นมีความสำคัญ แต่ในบริบทนี้เรายังไม่จำเป็นต้องลงลึกถึงเรื่องความจุ
เมื่อเรากำหนดค่า s1 ให้กับ s2 ข้อมูลส่วนหัวของ String จะถูกคัดลอก ซึ่งหมายความว่าเราคัดลอกพอยน์เตอร์, ความยาว, และความจุที่อยู่บนสแตก แต่เรา ไม่ได้ คัดลอกข้อมูลเนื้อหาข้อความที่อยู่บนฮีปที่พอยน์เตอร์ชี้ไปแต่อย่างใด กล่าวอีกนัยหนึ่ง การแทนค่าในหน่วยความจำจะมีลักษณะดังรูปที่ 4-2
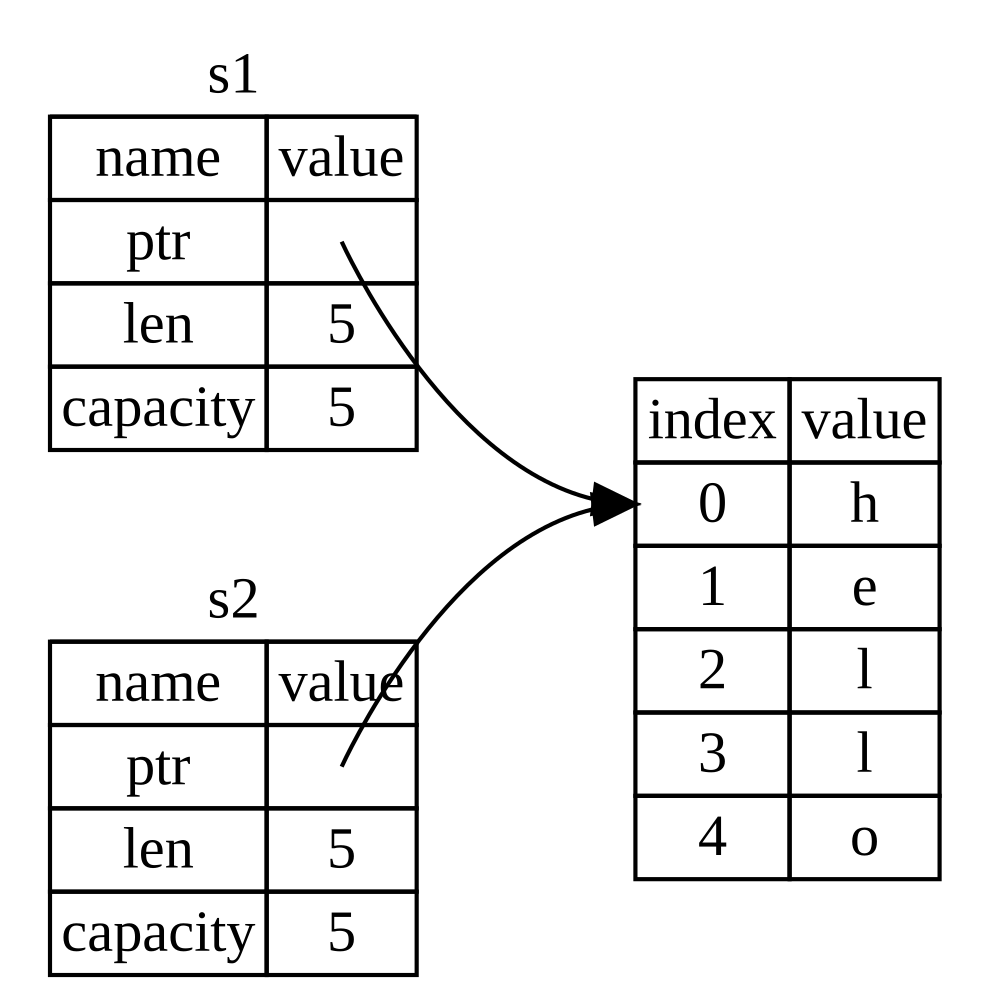
รูปที่ 4-2: การแทนค่าในหน่วยความจำของตัวแปร s2 ที่มีสำเนาของพอยน์เตอร์ ความยาว และความจุของ s1
การแทนค่านี้ ไม่เหมือน กับในรูปที่ 4-3 ซึ่งเป็นสิ่งที่จะเกิดขึ้นหาก Rust ทำการคัดลอกข้อมูลทั้งหมดบนฮีปไปด้วย หาก Rust ทำงานเช่นนั้น การดำเนินการ s2 = s1 ย่อมส่งผลกระทบต่อประสิทธิภาพการทำงานในตอนรันไทม์อย่างมาก หากข้อมูลบนฮีปมีขนาดใหญ่
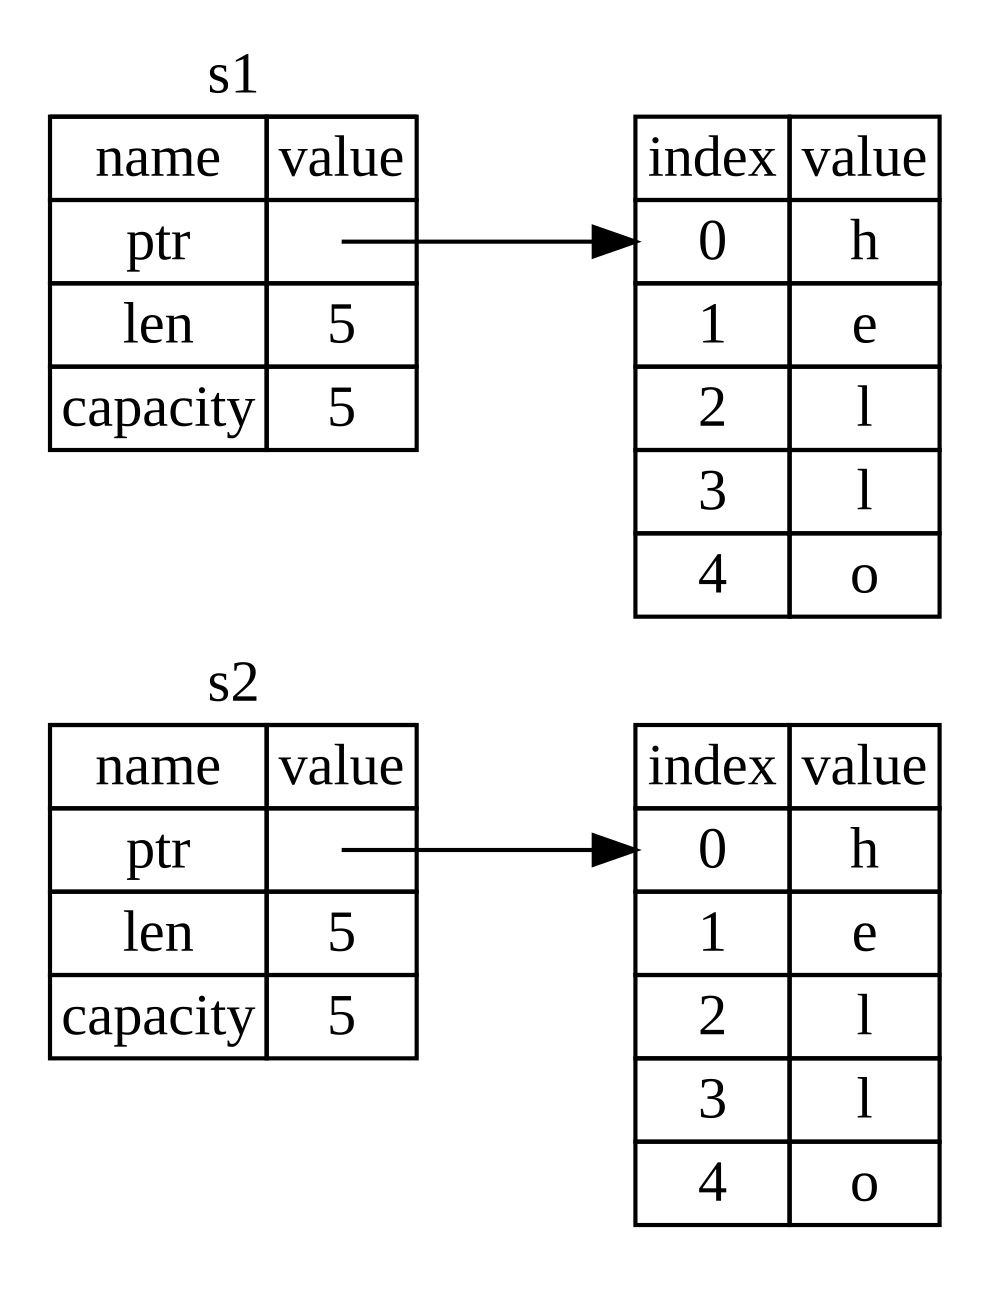
รูปที่ 4-3: ความเป็นไปได้อีกอย่างหนึ่งสำหรับสิ่งที่ s2 = s1 อาจทำ หาก Rust คัดลอกข้อมูลบนฮีปด้วย
ก่อนหน้านี้เราได้กล่าวไปว่า เมื่อตัวแปรหลุดออกจากขอบเขต Rust จะเรียกใช้ฟังก์ชัน drop โดยอัตโนมัติเพื่อล้างหน่วยความจำบนฮีปของตัวแปรนั้น แต่จากรูปที่ 4-2 จะเห็นว่าพอยน์เตอร์ของตัวแปรทั้งสองตัวต่างชี้ไปยังตำแหน่งเดียวกันบนฮีป ซึ่งนี่คือปัญหาสำคัญ เพราะเมื่อ s2 และ s1 หลุดออกจากขอบเขต ตัวแปรทั้งสองจะพยายามสั่งคืนหน่วยความจำที่ตำแหน่งเดียวกัน ซึ่งข้อผิดพลาดนี้เรียกว่า การคืนหน่วยความจำซ้ำซ้อน (double free) และเป็นหนึ่งในบั๊กความปลอดภัยของหน่วยความจำที่อันตรายอย่างยิ่ง การคืนหน่วยความจำตำแหน่งเดิมสองครั้งอาจนำไปสู่ความเสียหายของข้อมูลในหน่วยความจำ (memory corruption) และก่อให้เกิดช่องโหว่ด้านความปลอดภัยได้
เพื่อรับประกันความปลอดภัยของหน่วยความจำ หลังจากบรรทัด let s2 = s1; ทำงาน Rust จะถือว่าตัวแปร s1 ใช้งานไม่ได้อีกต่อไป (invalid) ด้วยเหตุนี้ Rust จึงไม่ต้องคืนหน่วยความจำใดๆ เมื่อ s1 หลุดออกจากขอบเขต ลองมาดูว่าจะเกิดอะไรขึ้นเมื่อคุณพยายามนำ s1 มาใช้งานต่อหลังจากสร้าง s2 ไปแล้ว:
fn main() {
    let s1 = String::from("hello");
    let s2 = s1;

    println!("{s1}, world!");
}
คุณจะพบกับข้อผิดพลาดในการคอมไพล์ เนื่องจาก Rust ป้องกันไม่ให้คุณใช้งานตัวแปรที่ถูกทำให้ใช้การไม่ได้ไปแล้ว:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0382]: borrow of moved value: `s1`
 --> src/main.rs:5:16
  |
2 |     let s1 = String::from("hello");
  |         -- move occurs because `s1` has type `String`, which does not implement the `Copy` trait
3 |     let s2 = s1;
  |              -- value moved here
4 |
5 |     println!("{s1}, world!");
  |                ^^ value borrowed here after move
  |
help: consider cloning the value if the performance cost is acceptable
  |
3 |     let s2 = s1.clone();
  |                ++++++++

For more information about this error, try `rustc --explain E0382`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
หากคุณคุ้นเคยกับคำว่า การคัดลอกแบบตื้น (shallow copy) และ การคัดลอกแบบลึก (deep copy) จากภาษาอื่นๆ แนวคิดของการคัดลอกพอยน์เตอร์, ความยาว, และความจุ โดยไม่ได้คัดลอกข้อมูลจริงบนฮีป อาจฟังดูคล้ายกับการคัดลอกแบบตื้น แต่เนื่องจาก Rust ได้ทำให้ตัวแปรเดิมหมดสภาพการใช้งานไปด้วย แทนที่จะเรียกว่าการคัดลอกแบบตื้น ใน Rust เราจึงเรียกพฤติกรรมนี้ว่า การย้ายค่า (move) ในตัวอย่างนี้ เราจะพูดว่า s1 ถูก ย้าย ไปยัง s2 แล้ว ดังนั้นสิ่งที่เกิดขึ้นจริงในหน่วยความจำจึงเป็นไปตามรูปที่ 4-4
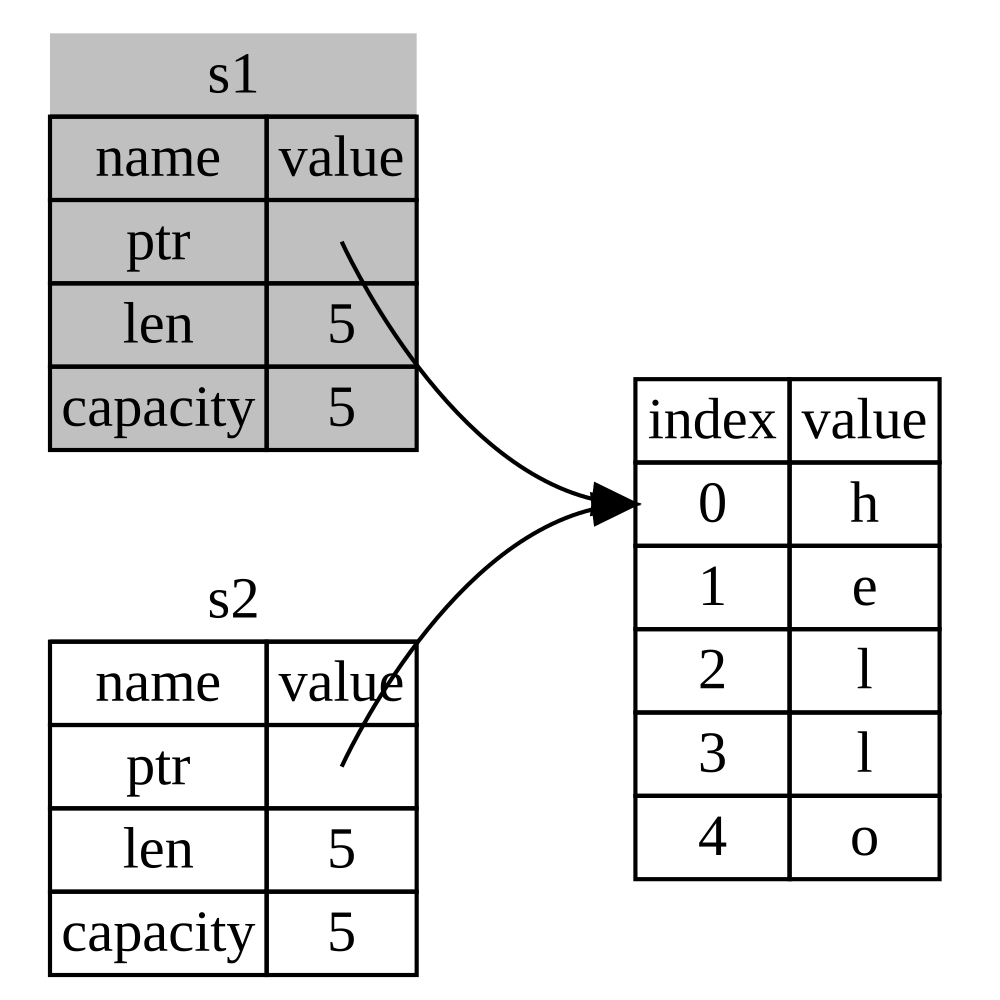
รูปที่ 4-4: การแทนค่าในหน่วยความจำหลังจากที่ s1 ถูกทำให้ไม่ถูกต้อง
และนั่นช่วยแก้ปัญหาของเราได้ทั้งหมด! เมื่อมีเพียง s2 เท่านั้นที่ยังใช้งานได้ เมื่อ s2 หลุดออกจากขอบเขต ก็จะมีเพียงมันตัวเดียวเท่านั้นที่สั่งคืนหน่วยความจำ เป็นอันเสร็จสิ้นกระบวนการอย่างปลอดภัย
นอกจากนี้ การออกแบบนี้ยังให้ผลลัพธ์โดยนัยที่สำคัญคือ Rust จะไม่มีวันสร้างสำเนาข้อมูลแบบลึก (deep copy) ให้อัตโนมัติ ดังนั้นการคัดลอกข้อมูลแบบ อัตโนมัติ ใดๆ ใน Rust จึงมั่นใจได้ว่าจะทำงานได้อย่างรวดเร็วและไม่กระทบต่อประสิทธิภาพการทำงานในตอนรันไทม์อย่างแน่นอน
สโคปและการกำหนดค่า
ในทางตรงกันข้าม ความสัมพันธ์ระหว่างขอบเขต, ความเป็นเจ้าของ, และการคืนหน่วยความจำผ่านฟังก์ชัน drop ก็ทำงานเมื่อมีการกำหนดค่าใหม่ให้กับตัวแปรเดิมเช่นกัน กล่าวคือ เมื่อคุณกำหนดค่าใหม่ให้กับตัวแปรเดิมที่มีอยู่แล้ว Rust จะสั่งเรียก drop เพื่อคืนหน่วยความจำของค่าเดิมนั้นทิ้งทันที ลองพิจารณาตัวอย่างโค้ดนี้:
fn main() {
    let mut s = String::from("hello");
    s = String::from("ahoy");

    println!("{s}, world!");
}
เราเริ่มต้นจากการประกาศตัวแปร s และผูกเข้ากับ String ที่มีค่า "hello" จากนั้นเราได้สร้าง String ตัวใหม่ที่มีค่า "ahoy" ขึ้นมา แล้วกำหนดทับลงไปในตัวแปร s ทันที ณ จุดนี้ ไม่มีสิ่งใดอ้างอิงถึงข้อมูลเดิมบนฮีปอีกต่อไป รูปที่ 4-5 แสดงสถานะของหน่วยความจำบนสแตกและฮีปในจังหวะนี้:
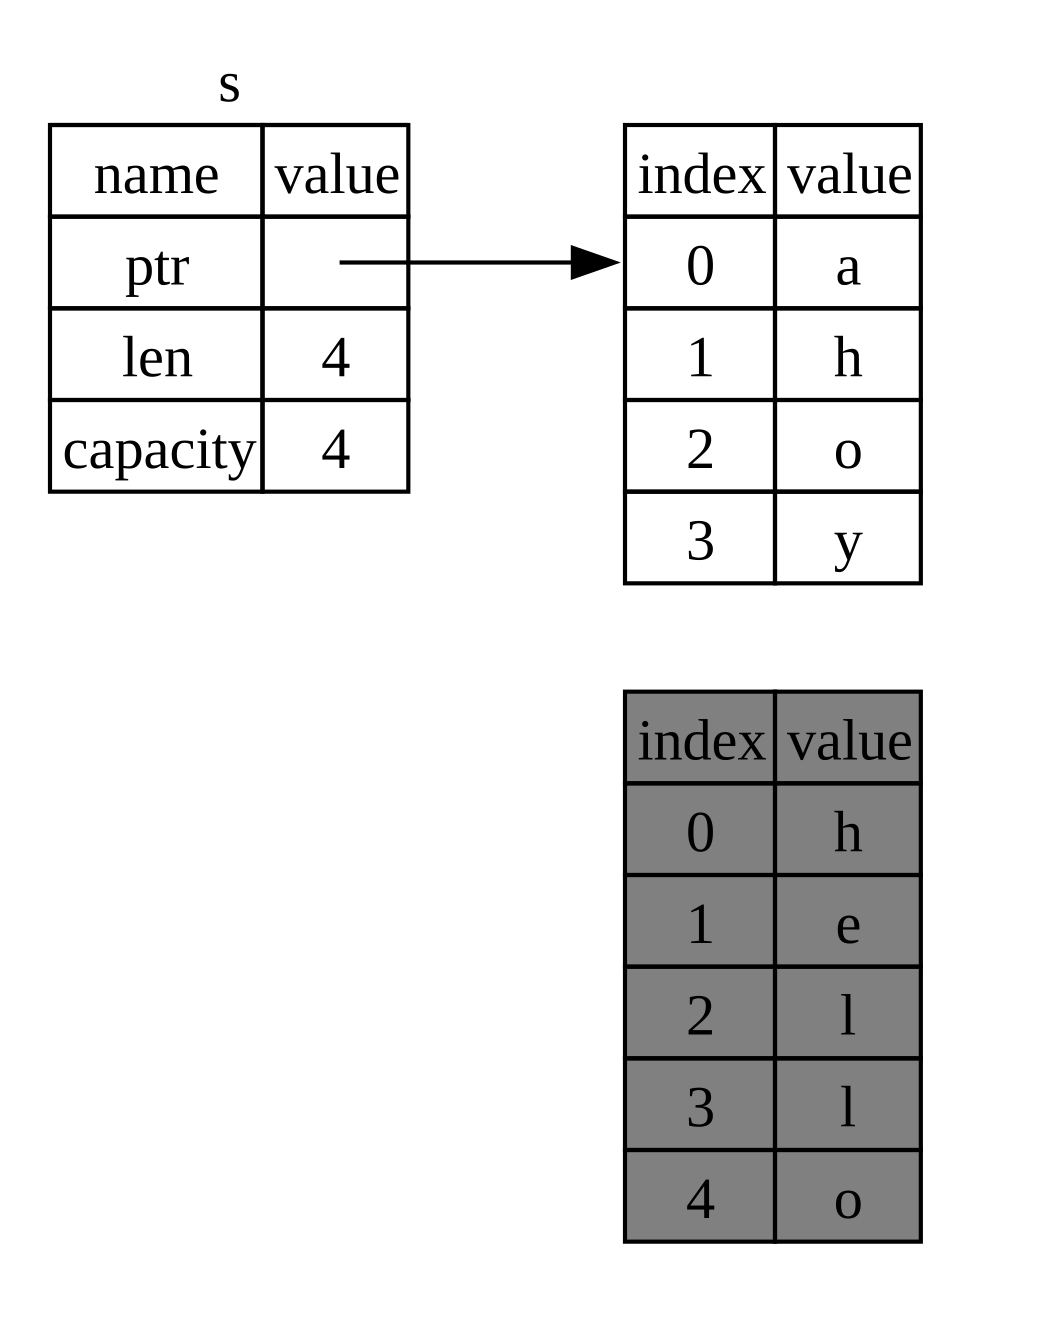
รูปที่ 4-5: การแทนค่าในหน่วยความจำหลังจากที่ค่าเริ่มต้นถูกแทนที่ทั้งหมดแล้ว
สตริงเดิมจึงหลุดออกจากขอบเขตการใช้งานทันที Rust จะสั่งรันฟังก์ชัน drop กับสตริงเดิมนั้นเพื่อคืนหน่วยความจำของมันกลับไปโดยไม่รอช้า และเมื่อเราพิมพ์ค่าของตัวแปรในตอนท้าย ผลลัพธ์ที่ได้จึงเป็น "ahoy, world!"
ตัวแปรและข้อมูลที่ปฏิสัมพันธ์กันด้วยการโคลน
หากเรา ต้องการ คัดลอกข้อมูลทั้งหมดบนฮีปของ String แบบลึกจริงๆ ไม่ใช่เพียงแค่ข้อมูลส่วนหัวบนสแตก เราสามารถเรียกใช้เมธอดทั่วไปที่ชื่อว่า clone ได้ เราจะพูดถึงไวยากรณ์ของเมธอดอย่างละเอียดในบทที่ 5 แต่เนื่องจากเมธอดเป็นฟีเจอร์พื้นฐานในภาษาโปรแกรมหลายภาษา คุณจึงน่าจะคุ้นเคยกับรูปแบบนี้มาบ้างแล้ว
นี่คือตัวอย่างการเรียกใช้งานเมธอด clone:
fn main() {
    let s1 = String::from("hello");
    let s2 = s1.clone();

    println!("s1 = {s1}, s2 = {s2}");
}
โค้ดนี้ทำงานได้อย่างสมบูรณ์ และทำให้เกิดพฤติกรรมตามที่แสดงในรูปที่ 4-3 อย่างชัดเจน โดยที่ข้อมูลบนฮีปจะ ถูกคัดลอก สำเนาขึ้นมาใหม่อีกชุดหนึ่งจริงๆ
เมื่อคุณเห็นการเรียกใช้ clone ในโค้ด คุณจะทราบได้ทันทีว่ากำลังมีโค้ดบางอย่างทำงานอยู่เบื้องหลัง และการทำงานนั้นอาจมีค่าใช้จ่ายทางทรัพยากรสูง ซึ่งเป็นจุดสังเกตที่ชัดเจนว่ากำลังมีการประมวลผลพิเศษเกิดขึ้น
ข้อมูลบนสแตกเท่านั้น: การคัดลอกค่า
ยังมีอีกหนึ่งประเด็นที่น่าสนใจและเรายังไม่ได้พูดถึง ลองพิจารณาโค้ดที่ใช้ชนิดข้อมูลจำนวนเต็มนี้ ซึ่งส่วนหนึ่งเคยปรากฏในลิสติ้ง 4-2:
fn main() {
    let x = 5;
    let y = x;

    println!("x = {x}, y = {y}");
}
แต่โค้ดชุดนี้ดูเหมือนจะขัดแย้งกับสิ่งที่เราเพิ่งเรียนรู้มา เพราะเราไม่ได้เรียก clone แต่ตัวแปร x ก็ยังคงสามารถใช้งานได้ตามปกติ โดยไม่ได้ถูกย้ายค่าไปยัง y แต่อย่างใด
เหตุผลก็คือ ชนิดข้อมูลพื้นฐานอย่างจำนวนเต็มที่มีขนาดแน่นอนตอนคอมไพล์จะถูกจัดเก็บบนสแตกทั้งหมด การทำสำเนาของค่าจริงจึงทำได้อย่างรวดเร็วมาก นั่นหมายความว่าไม่มีเหตุผลใดที่จำเป็นต้องทำให้ตัวแปร x หมดสภาพไปหลังจากสร้างตัวแปร y ขึ้นมา กล่าวอีกนัยหนึ่ง สำหรับข้อมูลประเภทนี้แล้ว ไม่มีความแตกต่างใดๆ ระหว่างการคัดลอกแบบลึกกับการคัดลอกแบบตื้นเลย ดังนั้นการเรียกใช้ clone ในกรณีนี้จึงไม่มีผลแตกต่างจากการคัดลอกแบบตื้นทั่วไป เราจึงละเว้นไม่ต้องเรียกใช้มันได้
ใน Rust มีแอตทริบิวต์พิเศษที่เรียกว่าเทรต Copy (Copy trait) ซึ่งเราสามารถนำไปกำหนดให้กับชนิดข้อมูลที่จัดเก็บบนสแตกได้อย่างจำนวนเต็ม (เราจะเจาะลึกเรื่องเทรตเพิ่มเติมใน บทที่ 10) หากชนิดข้อมูลใดอิมพลีเมนต์เทรต Copy ตัวแปรของชนิดข้อมูลนั้นจะไม่ถูกย้ายค่า แต่จะถูกคัดลอกค่าอย่างรวดเร็วแทน ทำให้ตัวแปรเดิมยังคงใช้งานต่อไปได้แม้จะถูกนำไปกำหนดให้กับตัวแปรอื่นแล้วก็ตาม
Rust จะไม่อนุญาตให้เรากำหนดเทรต Copy ให้กับชนิดข้อมูลใดๆ ก็ตาม หากชนิดข้อมูลนั้น (หรือส่วนประกอบใดๆ ในนั้น) มีการอิมพลีเมนต์เทรต Drop เอาไว้ หากชนิดข้อมูลต้องการให้มีการทำงานพิเศษบางอย่างเมื่อค่าหลุดออกจากขอบเขต แล้วเราพยายามไปใส่เทรต Copy ให้กับมัน คอมไพเลอร์จะแจ้งเตือนข้อผิดพลาดทันที หากต้องการศึกษาวิธีการกำหนดเทรต Copy ให้กับชนิดข้อมูลที่คุณสร้างขึ้น สามารถดูได้จากหัวข้อ “เทรตที่ derive ได้” ในภาคผนวก C
แล้วมีชนิดข้อมูลใดบ้างที่อิมพลีเมนต์เทรต Copy? คุณสามารถตรวจสอบเอกสารของแต่ละชนิดข้อมูลเพื่อให้แน่ใจได้ แต่ตามหลักการทั่วไปแล้ว ชนิดข้อมูลสเกลาร์ (scalar types) แบบเรียบง่ายส่วนใหญ่จะอิมพลีเมนต์ Copy และจะไม่มีชนิดข้อมูลใดที่มีการจัดสรรหน่วยความจำหรือถือครองทรัพยากรภายนอกที่สามารถอิมพลีเมนต์ Copy ได้ ตัวอย่างของชนิดข้อมูลที่อิมพลีเมนต์ Copy ได้แก่:
- ชนิดข้อมูลจำนวนเต็มทั้งหมด เช่น
u32 - ชนิดข้อมูลบูลีน
boolซึ่งมีค่าเป็นtrueและfalse - ชนิดข้อมูลทศนิยมทั้งหมด เช่น
f64 - ชนิดข้อมูลอักขระ
char - ทูเพิล (tuple) หากสมาชิกทุกตัวในทูเพิลนั้นอิมพลีเมนต์
Copyด้วย เช่น(i32, i32)จะอิมพลีเมนต์Copyแต่(i32, String)จะไม่อิมพลีเมนต์
ความเป็นเจ้าของและฟังก์ชัน
กลไกการส่งค่าเข้าไปยังฟังก์ชันนั้นทำงานคล้ายคลึงกับการกำหนดค่าให้กับตัวแปรทุกประการ การส่งตัวแปรเข้าไปในฟังก์ชันจะทำให้เกิดการย้ายค่า (move) หรือการคัดลอกค่า (copy) เช่นเดียวกับการกำหนดค่า ตัวอย่างในลิสติ้ง 4-3 แสดงให้เห็นตำแหน่งที่ตัวแปรเข้าสู่ขอบเขตและหลุดออกจากขอบเขตอย่างชัดเจน
fn main() {
    let s = String::from("hello");  // s comes into scope

    takes_ownership(s);             // s's value moves into the function...
                                    // ... and so is no longer valid here

    let x = 5;                      // x comes into scope

    makes_copy(x);                  // Because i32 implements the Copy trait,
                                    // x does NOT move into the function,
                                    // so it's okay to use x afterward.

} // Here, x goes out of scope, then s. However, because s's value was moved,
  // nothing special happens.

fn takes_ownership(some_string: String) { // some_string comes into scope
    println!("{some_string}");
} // Here, some_string goes out of scope and `drop` is called. The backing
  // memory is freed.

fn makes_copy(some_integer: i32) { // some_integer comes into scope
    println!("{some_integer}");
} // Here, some_integer goes out of scope. Nothing special happens.
หากเราพยายามนำตัวแปร s มาใช้งานต่อหลังจากการเรียก takes_ownership คอมไพเลอร์ของ Rust จะแจ้งข้อผิดพลาดทันที การตรวจสอบอย่างเข้มงวดตั้งแต่ตอนคอมไพล์นี้ช่วยปกป้องเราจากข้อผิดพลาดร้ายแรงได้อย่างมั่นใจ ลองเพิ่มโค้ดในฟังก์ชัน main เพื่อทดลองใช้งาน s และ x ดู เพื่อสังเกตจุดที่คุณสามารถใช้งานตัวแปรได้ และจุดที่กฎความเป็นเจ้าของป้องกันไม่ให้คุณใช้งาน
ค่าที่คืนกลับและสโคป
การคืนค่าจากฟังก์ชันก็สามารถถ่ายโอนความเป็นเจ้าของได้เช่นเดียวกัน ลิสติ้ง 4-4 แสดงตัวอย่างของฟังก์ชันที่มีการคืนค่า พร้อมคำอธิบายประกอบในลักษณะเดียวกับลิสติ้ง 4-3
fn main() {
    let s1 = gives_ownership();        // gives_ownership moves its return
                                       // value into s1

    let s2 = String::from("hello");    // s2 comes into scope

    let s3 = takes_and_gives_back(s2); // s2 is moved into
                                       // takes_and_gives_back, which also
                                       // moves its return value into s3
} // Here, s3 goes out of scope and is dropped. s2 was moved, so nothing
  // happens. s1 goes out of scope and is dropped.

fn gives_ownership() -> String {       // gives_ownership will move its
                                       // return value into the function
                                       // that calls it

    let some_string = String::from("yours"); // some_string comes into scope

    some_string                        // some_string is returned and
                                       // moves out to the calling
                                       // function
}

// This function takes a String and returns a String.
fn takes_and_gives_back(a_string: String) -> String {
    // a_string comes into
    // scope

    a_string  // a_string is returned and moves out to the calling function
}
ความเป็นเจ้าของของตัวแปรจะเป็นไปตามรูปแบบเดิมเสมอ: การกำหนดค่าให้กับตัวแปรอื่นจะทำการย้ายค่านั้นไป และเมื่อตัวแปรที่ถือครองข้อมูลบนฮีปหลุดออกจากขอบเขต ข้อมูลนั้นจะถูกคืนหน่วยความจำโดยอัตโนมัติผ่านฟังก์ชัน drop เว้นแต่ว่าความเป็นเจ้าของของข้อมูลนั้นได้ถูกย้ายต่อไปยังตัวแปรอื่นแล้ว
แม้ว่ากลไกนี้จะทำงานได้อย่างถูกต้องแม่นยำ แต่การที่ฟังก์ชันต้องรับความเป็นเจ้าของไปแล้วต้องคอยส่งความเป็นเจ้าของกลับคืนมาทุกครั้งย่อมเป็นเรื่องที่ยุ่งยากและไม่สะดวก หากเราต้องการให้ฟังก์ชันเพียงแค่นำค่านั้นไปใช้งานโดยไม่ต้องยึดความเป็นเจ้าของล่ะ? คงจะน่ารำคาญไม่น้อยหากทุกสิ่งที่เราส่งเข้าไปในฟังก์ชันจะต้องถูกส่งกลับคืนมาด้วยเสมอหากเรายังต้องการใช้งานมันต่อ ควบคู่ไปกับผลลัพธ์อื่นๆ ที่ฟังก์ชันต้องการคืนค่าออกมา
Rust อนุญาตให้เราคืนค่าหลายค่าออกมาพร้อมกันได้ผ่านทางทูเพิล ดังที่แสดงในลิสติ้ง 4-5
fn main() {
    let s1 = String::from("hello");

    let (s2, len) = calculate_length(s1);

    println!("The length of '{s2}' is {len}.");
}

fn calculate_length(s: String) -> (String, usize) {
    let length = s.len(); // len() returns the length of a String

    (s, length)
}
แต่กระบวนการเช่นนี้ดูเยิ่นเย้อและต้องเขียนโค้ดเพิ่มขึ้นอย่างมากสำหรับงานธรรมดาๆ ที่ควรจะทำได้ง่าย ซึ่งโชคดีที่ Rust มีฟีเจอร์ที่ยอดเยี่ยมสำหรับให้เรานำค่าไปใช้งานได้โดยไม่ต้องถ่ายโอนความเป็นเจ้าของ นั่นก็คือ การอ้างอิง (reference) นั่นเอง
เรเฟอเรนซ์และการยืม
เรเฟอเรนซ์และการยืม
ปัญหาของโค้ดทูเพิลในลิสติ้ง 4-5 คือเราจำเป็นต้องคืนค่า String กลับมายังฟังก์ชันผู้เรียก เพื่อให้เรายังสามารถนำ String นั้นไปใช้งานต่อได้หลังจากการเรียกใช้ calculate_length เพราะความเป็นเจ้าของของ String ได้ถูกย้ายเข้าไปใน calculate_length ไปแล้ว แต่เราสามารถส่ง การอ้างอิง หรือ เรเฟอเรนซ์ (reference) ไปยังค่าของ String แทนได้ เรเฟอเรนซ์ทำงานคล้ายกับพอยน์เตอร์ (pointer) ตรงที่เป็นการเก็บที่อยู่ (address) ในหน่วยความจำที่เราสามารถตามไปเข้าถึงข้อมูลจริงที่ถูกจัดเก็บไว้ ณ ตำแหน่งนั้นได้ โดยที่ข้อมูลนั้นยังคงเป็นของตัวแปรอื่นอยู่ แต่สิ่งที่แตกต่างจากพอยน์เตอร์ทั่วไปคือ เรเฟอเรนซ์ใน Rust ได้รับการรับประกันว่าจะชี้ไปยังค่าที่ถูกต้องและมีตัวตนอยู่จริงของชนิดข้อมูลนั้นๆ เสมอตลอดอายุขัยของเรเฟอเรนซ์
ตัวอย่างต่อไปนี้แสดงวิธีนิยามและเรียกใช้งานฟังก์ชัน calculate_length โดยรับเรเฟอเรนซ์ของออบเจกต์เป็นพารามิเตอร์ แทนที่จะต้องย้ายความเป็นเจ้าของของค่าเข้ามา:
fn main() {
    let s1 = String::from("hello");

    let len = calculate_length(&s1);

    println!("The length of '{s1}' is {len}.");
}

fn calculate_length(s: &String) -> usize {
    s.len()
}
ประการแรก โปรดสังเกตว่าโค้ดส่วนทูเพิลทั้งหมดในการประกาศตัวแปรและค่าคืนกลับของฟังก์ชันหายไปแล้ว ประการที่สอง สังเกตว่าเราส่ง &s1 เข้าไปยัง calculate_length และในนิยามของฟังก์ชัน เราระบุชนิดข้อมูลเป็น &String แทนที่จะเป็น String เครื่องหมายแอมเพอร์แซนด์ (&) เหล่านี้แทนการสร้างเรเฟอเรนซ์ ซึ่งช่วยให้คุณสามารถอ้างอิงถึงค่าใดค่าหนึ่งได้โดยไม่ต้องถือครองความเป็นเจ้าของค่านั้น แผนภาพในรูปที่ 4-6 แสดงแนวคิดนี้ได้อย่างชัดเจน
รูปที่ 4-6: แผนภาพของ &String s ที่ชี้ไปยัง String s1
หมายเหตุ: การทำงานที่ตรงกันข้ามกับการอ้างอิงด้วย
&คือ การดีเรเฟอเรนซ์ (dereferencing) ซึ่งทำได้โดยใช้ตัวดำเนินการ*เราจะได้เห็นการใช้งานตัวดำเนินการดีเรเฟอเรนซ์ในบทที่ 8 และจะลงลึกรายละเอียดในบทที่ 15
ลองมาพิจารณาการเรียกใช้ฟังก์ชันในจุดนี้อย่างละเอียดขึ้น:
fn main() {
    let s1 = String::from("hello");

    let len = calculate_length(&s1);

    println!("The length of '{s1}' is {len}.");
}

fn calculate_length(s: &String) -> usize {
    s.len()
}
ไวยากรณ์ &s1 ช่วยให้เราสร้างเรเฟอเรนซ์ที่ อ้างถึง ค่าของ s1 โดยไม่ได้เป็นเจ้าของค่านั้น และเนื่องจากเรเฟอเรนซ์ไม่ได้เป็นเจ้าของ ข้อมูลที่มันชี้ไปจึงจะไม่ถูกทำลายทิ้ง (drop) เมื่อเรเฟอเรนซ์นี้หมดอายุการใช้งาน
ในทำนองเดียวกัน ลายเซ็นของฟังก์ชันจะใช้เครื่องหมาย & เพื่อระบุว่าพารามิเตอร์ s เป็นเรเฟอเรนซ์ ลองมาดูคำอธิบายประกอบในโค้ดนี้:
fn main() {
    let s1 = String::from("hello");

    let len = calculate_length(&s1);

    println!("The length of '{s1}' is {len}.");
}

fn calculate_length(s: &String) -> usize { // s is a reference to a String
    s.len()
} // Here, s goes out of scope. But because s does not have ownership of what
  // it refers to, the String is not dropped.
ขอบเขตที่ตัวแปร s มีผลใช้งานได้นั้นเหมือนกับขอบเขตของพารามิเตอร์ในฟังก์ชันทั่วไป แต่ค่าที่เรเฟอเรนซ์ชี้ไปจะไม่ถูกทำลายทิ้งเมื่อ s หลุดออกจากขอบเขต เพราะ s ไม่ได้เป็นเจ้าของข้อมูลนั้น เมื่อฟังก์ชันรับพารามิเตอร์เป็นเรเฟอเรนซ์แทนที่จะเป็นค่าจริง เราจึงไม่จำเป็นต้องคืนค่านั้นกลับมาเพื่อส่งมอบความเป็นเจ้าของคืน เพราะเราไม่เคยได้รับความเป็นเจ้าของมาตั้งแต่แรก
เราเรียกกระบวนการสร้างเรเฟอเรนซ์นี้ว่า การยืม (borrowing) เช่นเดียวกับในชีวิตจริง หากสิ่งของเป็นของใครสักคน คุณสามารถขอยืมจากเขามาใช้ได้ และเมื่อใช้เสร็จแล้ว คุณก็ต้องคืนสิ่งนั้นกลับไป โดยที่คุณไม่ได้เป็นเจ้าของสิ่งนั้น
แล้วจะเกิดอะไรขึ้นหากเราพยายามแก้ไขสิ่งที่เรากำลังยืมมา? ลองดูโค้ดในลิสติ้ง 4-6 (ขอเตือนไว้ก่อนล่วงหน้าเลยว่า โค้ดนี้จะคอมไพล์ไม่ผ่าน!):
fn main() {
    let s = String::from("hello");

    change(&s);
}

fn change(some_string: &String) {
    some_string.push_str(", world");
}
และนี่คือข้อความแจ้งข้อผิดพลาด:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0596]: cannot borrow `*some_string` as mutable, as it is behind a `&` reference
 --> src/main.rs:8:5
  |
8 |     some_string.push_str(", world");
  |     ^^^^^^^^^^^ `some_string` is a `&` reference, so it cannot be borrowed as mutable
  |
help: consider changing this to be a mutable reference
  |
7 | fn change(some_string: &mut String) {
  |                         +++

For more information about this error, try `rustc --explain E0596`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
เช่นเดียวกับตัวแปรที่แก้ไขไม่ได้ (immutable) โดยค่าเริ่มต้น เรเฟอเรนซ์ก็เป็นเช่นเดียวกัน กล่าวคือเราไม่ได้รับอนุญาตให้แก้ไขข้อมูลใดๆ ที่เราถือเพียงแค่เรเฟอเรนซ์ไปยังข้อมูลนั้น
เรเฟอเรนซ์แบบเปลี่ยนแปลงได้
เราสามารถปรับแก้โค้ดจากลิสติ้ง 4-6 เพื่อให้สามารถแก้ไขค่าที่ถูกยืมมาได้ ด้วยการปรับเปลี่ยนเพียงเล็กน้อยโดยหันมาใช้ เรเฟอเรนซ์แบบเปลี่ยนแปลงได้ (mutable reference) แทน ดังนี้:
fn main() {
    let mut s = String::from("hello");

    change(&mut s);
}

fn change(some_string: &mut String) {
    some_string.push_str(", world");
}
ประการแรก เราเปลี่ยนการประกาศ s ให้เป็นตัวแปรแบบ mut จากนั้นจึงสร้างเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ด้วยคำสั่ง &mut s ในจุดที่เราเรียกฟังก์ชัน change และปรับลายเซ็นของฟังก์ชันให้รับเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ด้วย some_string: &mut String ซึ่งทำให้เห็นได้อย่างชัดเจนว่าฟังก์ชัน change จะเข้าไปแก้ไขค่าที่มันขอยืมมา
อย่างไรก็ดี เรเฟอเรนซ์แบบเปลี่ยนแปลงได้มีข้อจำกัดที่สำคัญอย่างยิ่งหนึ่งข้อคือ: หากคุณมีเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ไปยังค่าใดค่าหนึ่งอยู่แล้ว คุณจะไม่สามารถมีเรเฟอเรนซ์อื่นใดไปยังค่านั้นได้อีกเลย โค้ดที่พยายามสร้างเรเฟอเรนซ์แบบเปลี่ยนแปลงได้สองตัวพร้อมกันไปยัง s ต่อไปนี้จะคอมไพล์ไม่ผ่าน:
fn main() {
    let mut s = String::from("hello");

    let r1 = &mut s;
    let r2 = &mut s;

    println!("{r1}, {r2}");
}
นี่คือข้อผิดพลาดที่เกิดขึ้น:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0499]: cannot borrow `s` as mutable more than once at a time
 --> src/main.rs:5:14
  |
4 |     let r1 = &mut s;
  |              ------ first mutable borrow occurs here
5 |     let r2 = &mut s;
  |              ^^^^^^ second mutable borrow occurs here
6 |
7 |     println!("{r1}, {r2}");
  |                -- first borrow later used here

For more information about this error, try `rustc --explain E0499`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
ข้อผิดพลาดนี้ระบุว่าโค้ดทำงานไม่ได้เพราะเราไม่สามารถยืม s แบบเปลี่ยนแปลงได้มากกว่าหนึ่งครั้งในเวลาเดียวกัน การยืมแบบเปลี่ยนแปลงได้ครั้งแรกเกิดขึ้นที่ตัวแปร r1 และยังคงต้องมีผลใช้งานอยู่จนถึงจุดที่ถูกนำไปใช้ใน println! แต่ในระหว่างการสร้างเรเฟอเรนซ์ดังกล่าวกับการนำไปใช้งานจริง เรากลับพยายามสร้างเรเฟอเรนซ์แบบเปลี่ยนแปลงได้อีกตัวหนึ่งใน r2 เพื่อขอยืมข้อมูลชุดเดียวกันกับ r1
ข้อจำกัดที่ป้องกันไม่ให้มีเรเฟอเรนซ์แบบเปลี่ยนแปลงได้หลายตัวไปยังข้อมูลเดียวกันในเวลาเดียวกันนี้ ช่วยให้การแก้ไขข้อมูลเป็นไปอย่างรัดกุมและปลอดภัย ซึ่งอาจเป็นเรื่องที่ผู้เริ่มเขียน Rust ต้องปรับตัว เนื่องจากภาษาโปรแกรมส่วนใหญ่ยอมให้คุณแก้ไขข้อมูลได้ทุกที่ทุกเวลา แต่ข้อดีอย่างมหาศาลของข้อจำกัดนี้คือ Rust สามารถป้องกันปัญหา ดาต้าเรซ (data race) ได้ตั้งแต่ตอนคอมไพล์ ปัญหาดาต้าเรซคล้ายคลึงกับภาวะแย่งชิงทรัพยากร (race condition) และจะเกิดขึ้นเมื่อมีพฤติกรรมทั้ง 3 ข้อต่อไปนี้เกิดขึ้นพร้อมกัน:
- มีพอยน์เตอร์ตั้งแต่สองตัวขึ้นไปเข้าถึงข้อมูลชุดเดียวกันในเวลาเดียวกัน
- มีพอยน์เตอร์อย่างน้อยหนึ่งตัวที่กำลังถูกใช้เพื่อเขียนข้อมูล
- ไม่ได้ใช้กลไกการซิงโครไนซ์ใดๆ ในการควบคุมการเข้าถึงข้อมูลนั้น
ดาต้าเรซจะทำให้เกิดพฤติกรรมที่ไม่สามารถคาดเดาได้ (undefined behavior) และมักจะเป็นปัญหาที่ยากมากในการตรวจหาและแก้ไขในระหว่างรันไทม์ Rust ขจัดปัญหานี้ให้หมดสิ้นโดยการปฏิเสธที่จะคอมไพล์โค้ดที่อาจก่อให้เกิดดาต้าเรซ!
เช่นเคย เราสามารถใช้วงเล็บปีกกาเพื่อสร้างขอบเขตใหม่ ซึ่งช่วยให้เราสามารถมีเรเฟอเรนซ์แบบเปลี่ยนแปลงได้หลายตัวได้ ตราบใดที่พวกมันไม่ได้คงอยู่ พร้อมกัน:
fn main() {
    let mut s = String::from("hello");

    {
        let r1 = &mut s;
    } // r1 goes out of scope here, so we can make a new reference with no problems.

    let r2 = &mut s;
}
นอกจากนี้ Rust ยังบังคับใช้กฎในลักษณะเดียวกันสำหรับการใช้งานเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ร่วมกับเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ โค้ดต่อไปนี้จะทำให้เกิดข้อผิดพลาดในการคอมไพล์:
fn main() {
    let mut s = String::from("hello");

    let r1 = &s; // no problem
    let r2 = &s; // no problem
    let r3 = &mut s; // BIG PROBLEM

    println!("{r1}, {r2}, and {r3}");
}
นี่คือข้อผิดพลาดที่เกิดขึ้น:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0502]: cannot borrow `s` as mutable because it is also borrowed as immutable
 --> src/main.rs:6:14
  |
4 |     let r1 = &s; // no problem
  |              -- immutable borrow occurs here
5 |     let r2 = &s; // no problem
6 |     let r3 = &mut s; // BIG PROBLEM
  |              ^^^^^^ mutable borrow occurs here
7 |
8 |     println!("{r1}, {r2}, and {r3}");
  |                -- immutable borrow later used here

For more information about this error, try `rustc --explain E0502`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
นั่นคือเรา ไม่สามารถ มีเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ ในขณะที่ยังคงมีเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ชี้ไปยังค่าเดียวกันอยู่
ผู้ที่กำลังใช้งานเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ย่อมไม่คาดคิดว่าค่าที่ตนกำลังอ่านอยู่จะถูกใครอื่นแอบเปลี่ยนแปลงไปอย่างกะทันหัน! อย่างไรก็ตาม เราสามารถมีเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้หลายตัวพร้อมกันได้โดยไม่มีปัญหา เพราะการอ่านข้อมูลเพียงอย่างเดียวย่อมไม่ส่งผลกระทบต่อผู้อื่นที่กำลังอ่านข้อมูลชุดเดียวกัน
โปรดสังเกตว่าขอบเขตของเรเฟอเรนซ์จะเริ่มต้นจากจุดที่มันถูกประกาศ และสิ้นสุดลง ณ จุดสุดท้ายที่มีการนำเรเฟอเรนซ์นั้นไปใช้งานจริง ตัวอย่างเช่น โค้ดต่อไปนี้จะคอมไพล์ผ่านได้อย่างสมบูรณ์ เพราะการใช้งานครั้งสุดท้ายของเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้อยู่ใน println! ซึ่งเกิดขึ้นก่อนที่จะมีการสร้างเรเฟอเรนซ์แบบเปลี่ยนแปลงได้:
fn main() {
    let mut s = String::from("hello");

    let r1 = &s; // no problem
    let r2 = &s; // no problem
    println!("{r1} and {r2}");
    // Variables r1 and r2 will not be used after this point.

    let r3 = &mut s; // no problem
    println!("{r3}");
}
ขอบเขตของเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ r1 และ r2 สิ้นสุดลงทันทีหลังบรรทัด println! ที่พวกมันถูกเรียกใช้งานเป็นครั้งสุดท้าย ซึ่งเป็นตำแหน่งก่อนที่เรเฟอเรนซ์แบบเปลี่ยนแปลงได้ r3 จะถูกสร้างขึ้นมา ขอบเขตการทำงานของทั้งสองกลุ่มจึงไม่ได้ทับซ้อนกัน โค้ดนี้จึงได้รับอนุญาตให้ทำงานได้ เนื่องจากคอมไพเลอร์สามารถตรวจสอบได้ว่าเรเฟอเรนซ์เดิมไม่ได้ถูกนำมาใช้งานต่ออีกแล้ว ณ จุดดังกล่าวก่อนจะสิ้นสุดบล็อก
แม้ว่ากฎเรื่องการยืมอาจสร้างความหงุดหงิดให้บ้างในบางครั้ง แต่ขอให้ตระหนักไว้เสมอว่า คอมไพเลอร์ของ Rust กำลังช่วยชี้จุดที่อาจเกิดบั๊กขึ้นได้ล่วงหน้าตั้งแต่เนิ่นๆ (ตั้งแต่ตอนคอมไพล์แทนที่จะไปเกิดข้อผิดพลาดตอนรันจริง) พร้อมระบุตำแหน่งของปัญหาให้อย่างชัดเจน ทำให้คุณไม่ต้องเสียเวลาตามหาว่าทำไมข้อมูลของคุณจึงไม่เป็นไปตามที่คาดหวังในภายหลัง
เรเฟอเรนซ์ที่ชี้ไปยังหน่วยความจำที่ถูกคืนแล้ว
ในภาษาโปรแกรมที่มีพอยน์เตอร์ เป็นเรื่องง่ายมากที่จะเผลอสร้าง พอยน์เตอร์ที่ชี้ไปยังหน่วยความจำที่ถูกคืนแล้ว (dangling pointer) ซึ่งเป็นพอยน์เตอร์ที่อ้างอิงไปยังตำแหน่งในหน่วยความจำที่อาจถูกคืนหรือถูกจัดสรรให้กับข้อมูลอื่นไปแล้ว โดยเกิดจากการสั่งคืนหน่วยความจำในขณะที่ยังมีพอยน์เตอร์ชี้ค้างไว้อยู่ ในทางตรงกันข้าม สำหรับภาษา Rust คอมไพเลอร์จะรับประกันอย่างเด็ดขาดว่าจะไม่มีเรเฟอเรนซ์ใดกลายเป็นเรเฟอเรนซ์ที่ชี้ไปยังหน่วยความจำที่ถูกคืนแล้ว: หากคุณมีเรเฟอเรนซ์ไปยังข้อมูลชุดหนึ่ง คอมไพเลอร์จะตรวจสอบให้มั่นใจเสมอว่าข้อมูลจริงนั้นจะไม่หลุดออกจากขอบเขตก่อนที่เรเฟอเรนซ์ที่ชี้ไปยังข้อมูลนั้นจะหมดอายุการใช้งาน
ลองมาทดลองสร้างเรเฟอเรนซ์ที่ชี้ไปยังหน่วยความจำที่ถูกคืนแล้ว เพื่อดูว่า Rust ป้องกันปัญหานี้ผ่านข้อผิดพลาดตอนคอมไพล์อย่างไร:
fn main() {
    let reference_to_nothing = dangle();
}

fn dangle() -> &String {
    let s = String::from("hello");

    &s
}
นี่คือข้อผิดพลาดที่เกิดขึ้น:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0106]: missing lifetime specifier
 --> src/main.rs:5:16
  |
5 | fn dangle() -> &String {
  |                ^ expected named lifetime parameter
  |
  = help: this function's return type contains a borrowed value, but there is no value for it to be borrowed from
help: consider using the `'static` lifetime, but this is uncommon unless you're returning a borrowed value from a `const` or a `static`
  |
5 | fn dangle() -> &'static String {
  |                 +++++++
help: instead, you are more likely to want to return an owned value
  |
5 - fn dangle() -> &String {
5 + fn dangle() -> String {
  |

For more information about this error, try `rustc --explain E0106`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
ข้อความข้อผิดพลาดนี้ได้อ้างอิงถึงฟีเจอร์ที่เรายังไม่ได้พูดถึง นั่นก็คือเรื่องอายุขัย (lifetime) ซึ่งเราจะได้เรียนรู้เรื่องไลฟ์ไทม์อย่างละเอียดในบทที่ 10 แต่แม้จะมองข้ามส่วนของไลฟ์ไทม์ไป ข้อความแจ้งเตือนนี้ก็ได้ระบุใจความสำคัญของปัญหาไว้อย่างชัดเจน:
this function's return type contains a borrowed value, but there is no value
for it to be borrowed from
ลองมาดูสิ่งที่เกิดขึ้นในแต่ละขั้นตอนของฟังก์ชัน dangle อย่างละเอียดกัน:
fn main() {
    let reference_to_nothing = dangle();
}

fn dangle() -> &String { // dangle returns a reference to a String

    let s = String::from("hello"); // s is a new String

    &s // we return a reference to the String, s
} // Here, s goes out of scope and is dropped, so its memory goes away.
  // Danger!
เนื่องจากตัวแปร s ถูกสร้างขึ้นภายในฟังก์ชัน dangle เมื่อฟังก์ชัน dangle ทำงานจบลง หน่วยความจำของ s จึงถูกคืนกลับไปทันที แต่เรากลับพยายามส่งเรเฟอเรนซ์ที่ชี้ไปยังตัวมันกลับออกไป นั่นหมายความว่าเรเฟอเรนซ์นี้จะกลายเป็นเรเฟอเรนซ์ที่ชี้ไปยัง String ที่ไม่มีตัวตนอยู่อีกต่อไป ซึ่งเป็นสิ่งที่ไม่ถูกต้องอย่างยิ่ง! และ Rust จะไม่อนุญาตให้เราทำเช่นนี้อย่างแน่นอน
ทางออกสำหรับกรณีนี้คือการส่งคืนค่า String ออกไปโดยตรง:
fn main() {
    let string = no_dangle();
}

fn no_dangle() -> String {
    let s = String::from("hello");

    s
}
โค้ดชุดนี้ทำงานได้โดยไม่มีข้อผิดพลาดใดๆ เพราะความเป็นเจ้าของถูกส่งมอบออกไปนอกฟังก์ชัน และไม่มีหน่วยความจำส่วนใดถูกคืนทิ้งก่อนเวลาอันควร
กฎของเรเฟอเรนซ์
เรามาสรุปกฎสำคัญเกี่ยวกับเรเฟอเรนซ์กันอีกครั้ง:
- ณ เวลาใดเวลาหนึ่ง คุณสามารถมีเรเฟอเรนซ์แบบเปลี่ยนแปลงได้เพียงหนึ่งตัว หรือ มีเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้กี่ตัวก็ได้
- เรเฟอเรนซ์จะต้องชี้ไปยังข้อมูลที่ถูกต้องและมีตัวตนอยู่เสมอ
ในหัวข้อถัดไป เราจะมาดูเรเฟอเรนซ์อีกรูปแบบหนึ่ง นั่นก็คือ สไลซ์ (slice)
ชนิดสไลซ์
ชนิดสไลซ์
สไลซ์ (slice) ช่วยให้คุณสามารถอ้างอิงถึงลำดับสมาชิกที่เรียงต่อกันใน คอลเลกชัน (collection) ได้ สไลซ์ถือเป็นการอ้างอิง (reference) ชนิดหนึ่ง จึงไม่มีความเป็นเจ้าของในตัวเอง
ลองมาดูโจทย์การเขียนโปรแกรมเล็กๆ กัน: จงเขียนฟังก์ชันที่รับสตริงของข้อความที่มีคำคั่นด้วยเว้นวรรค และคืนค่าคำแรกที่พบในสตริงนั้นออกมา หากฟังก์ชันไม่พบเว้นวรรคในสตริง ก็แสดงว่าสตริงทั้งข้อความนั้นเป็นคำเดี่ยว จึงควรส่งคืนสตริงทั้งหมดกลับมา
หมายเหตุ: เพื่อความง่ายในการแนะนำเรื่องสไลซ์ ในหัวข้อนี้เราจะสมมติว่าข้อความประกอบด้วยอักขระแบบ ASCII เท่านั้น ส่วนรายละเอียดเรื่องการจัดการกับข้อความที่เข้ารหัสแบบ UTF-8 อย่างลึกซึ้งจะอยู่ในหัวข้อ “การจัดเก็บข้อความที่เข้ารหัส UTF-8 ด้วยสตริง” ในบทที่ 8
ลองมาคิดดูว่าเราจะเขียนลายเซ็น (signature) ของฟังก์ชันนี้โดยไม่ใช้สไลซ์ได้อย่างไร เพื่อให้เห็นถึงปัญหาที่สไลซ์จะเข้ามาช่วยแก้ไข:
fn first_word(s: &String) -> ?ฟังก์ชัน first_word มีพารามิเตอร์ชนิด &String เนื่องจากเราไม่จำเป็นต้องยึดความเป็นเจ้าของ การเขียนแบบนี้จึงเหมาะสมอย่างยิ่ง (ในการเขียน Rust ตามสำนวนนิยม ฟังก์ชันมักจะไม่รับความเป็นเจ้าของของอาร์กิวเมนต์หากไม่จำเป็น ซึ่งเหตุผลจะยิ่งชัดเจนขึ้นเมื่อเราศึกษาลึกขึ้นเรื่อยๆ) แต่เราควรจะคืนค่าอะไรออกมาดี? เราไม่มีวิธีระบุถึง บางส่วน ของสตริงได้โดยตรง อย่างไรก็ตาม เราสามารถส่งคืนค่าดัชนี (index) ของจุดสิ้นสุดคำแรก ซึ่งสังเกตได้จากตำแหน่งที่มีการเว้นวรรคออกมาได้ ลองทำแบบนั้นกัน ดังที่แสดงในลิสติ้ง 4-7
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
เนื่องจากเราจำเป็นต้องตรวจสอบข้อมูลใน String ทีละไบต์ว่ามีตำแหน่งใดเป็นช่องว่างหรือไม่ เราจึงแปลง String ให้กลายเป็นอาร์เรย์ของไบต์โดยใช้เมธอด as_bytes:
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
จากนั้น เราสร้างตัววนซ้ำหรืออิเทอเรเตอร์ (iterator) บนอาร์เรย์ของไบต์ด้วยเมธอด iter:
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
เราจะพูดถึงอิเทอเรเตอร์อย่างละเอียดใน บทที่ 13 แต่สำหรับตอนนี้ ขอให้เข้าใจว่า iter เป็นเมธอดที่ใช้ท่องไปทีละสมาชิกในคอลเลกชัน และเมธอด enumerate จะห่อหุ้มผลลัพธ์ของ iter เพื่อคืนค่าสมาชิกแต่ละตัวออกมาในรูปของทูเพิล (tuple) โดยสมาชิกตัวแรกของทูเพิลคือดัชนี (index) และสมาชิกตัวที่สองคือเรเฟอเรนซ์ที่ชี้ไปยังไบต์นั้น ซึ่งวิธีนี้สะดวกกว่าการที่เราต้องมาคอยคำนวณและนับดัชนีด้วยตนเอง
เนื่องจาก enumerate คืนค่าออกมาเป็นทูเพิล เราจึงสามารถใช้การจับคู่แพตเทิร์น (pattern) เพื่อกระจายโครงสร้าง (destructure) ของทูเพิลออกมาได้ (เราจะกล่าวถึงแพตเทิร์นเพิ่มเติมใน บทที่ 6) ภายในลูป for เราได้ระบุแพตเทิร์น (i, &item) โดย i คือดัชนีในทูเพิล และ &item คือตัวข้อมูลไบต์ และเนื่องจากข้อมูลที่ได้มาจาก .iter().enumerate() เป็นเรเฟอเรนซ์ เราจึงใส่ & ไว้ในแพตเทิร์นด้วย
ภายในลูป for เราทำการเปรียบเทียบไบต์เพื่อค้นหาตัวอักษรช่องว่าง โดยใช้ไวยากรณ์ลิเทอรัลของไบต์ (b' ') หากพบช่องว่าง เราจะส่งคืนดัชนีตำแหน่งนั้นออกไปทันที แต่หากวนลูปจนจบแล้วยังไม่พบช่องว่าง เราจะส่งคืนความยาวของสตริงด้วยคำสั่ง s.len() แทน:
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {}
ตอนนี้เรามีวิธีหาดัชนีจุดสิ้นสุดของคำแรกในสตริงแล้ว แต่วิธีนี้มีจุดบกพร่องที่ร้ายแรงอยู่ ค่าที่เราส่งคืนออกมาเป็นเพียงตัวเลข usize โดดๆ ซึ่งตัวเลขนี้จะมีความหมายก็ต่อเมื่อนำไปใช้ร่วมกับ &String เดิมเท่านั้น กล่าวอีกนัยหนึ่ง เนื่องจากตัวเลขนี้แยกขาดจากตัว String จึงไม่มีการรับประกันใดๆ เลยว่ามันจะยังคงใช้การได้ถูกต้องต่อไปในอนาคต ลองพิจารณาโปรแกรมในลิสติ้ง 4-8 ที่เรียกใช้ฟังก์ชัน first_word จากลิสติ้ง 4-7:
fn first_word(s: &String) -> usize {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return i;
        }
    }

    s.len()
}

fn main() {
    let mut s = String::from("hello world");

    let word = first_word(&s); // word will get the value 5

    s.clear(); // this empties the String, making it equal to ""

    // word still has the value 5 here, but s no longer has any content that we
    // could meaningfully use with the value 5, so word is now totally invalid!
}
โปรแกรมนี้คอมไพล์ผ่านโดยไม่มีข้อผิดพลาดใดๆ และจะยังคงคอมไพล์ผ่านแม้ว่าเราจะนำตัวแปร word มาใช้งานต่อหลังบรรทัด s.clear() เนื่องจาก word ไม่ได้มีความผูกพันใดๆ กับสถานะของ s เลย ตัวแปร word จึงยังคงมีค่าเป็น 5 อยู่ เรายังคงสามารถนำเลข 5 นี้ไปใช้อ้างอิงกับ s เพื่อพยายามตัดคำแรกออกมาได้ แต่การทำเช่นนั้นจะกลายเป็นบั๊กทันที เพราะเนื้อหาใน s ได้ถูกลบและเปลี่ยนแปลงไปแล้วหลังจากที่เราบันทึกค่า 5 ไว้ใน word
การต้องคอยระมัดระวังไม่ให้ดัชนีใน word หลุดการซิงค์กับข้อมูลจริงใน s เป็นเรื่องที่ยุ่งยากและเสี่ยงต่อการเกิดข้อผิดพลาดอย่างยิ่ง! และการจัดการดัชนีเหล่านี้จะยิ่งเปราะบางและซับซ้อนขึ้นไปอีกหากเราต้องการเขียนฟังก์ชัน second_word เพื่อหาคำที่สอง ซึ่งลายเซ็นของฟังก์ชันจะต้องกลายเป็นแบบนี้:
fn second_word(s: &String) -> (usize, usize) {ในตอนนี้เราต้องคอยติดตามทั้งดัชนีเริ่มต้น และ ดัชนีสิ้นสุด ยิ่งมีค่าตัวเลขที่คำนวณมาจากข้อมูลในอดีตมากขึ้นเท่าไร แต่ไม่ได้ผูกติดกับสถานะจริงของข้อมูลเลย เราก็ยิ่งมีตัวแปรลอยๆ ที่ไม่เกี่ยวข้องกันหลายตัวที่โปรแกรมเมอร์ต้องคอยดูแลให้สอดคล้องกันเอง
โชคดีที่ Rust มีทางออกที่สมบูรณ์แบบสำหรับปัญหานี้ นั่นก็คือ สตริงสไลซ์ (string slice)
สตริงสไลซ์
สตริงสไลซ์ (string slice) คือการอ้างอิง (reference) ไปยังช่วงข้อมูลที่ต่อเนื่องกันบางส่วนของ String โดยมีรูปแบบการเขียนดังนี้:
fn main() {
    let s = String::from("hello world");

    let hello = &s[0..5];
    let world = &s[6..11];
}
แทนที่จะเป็นเรเฟอเรนซ์ที่ชี้ไปยัง String ทั้งตัว ตัวแปร hello กลับเป็นเรเฟอเรนซ์ที่ชี้ไปยังบางส่วนของ String ตามที่ระบุไว้ในส่วนของเรนจ์ [0..5] เราสร้างสไลซ์ขึ้นมาโดยใช้ช่วงของดัชนีภายในวงเล็บเหลี่ยมในรูปแบบ [starting_index..ending_index] โดย starting_index คือดัชนีตำแหน่งแรกของสไลซ์ และ ending_index คือตำแหน่งที่มากกว่าตำแหน่งสุดท้ายในสไลซ์อยู่หนึ่ง (ไม่นับรวมตัวท้าย) ในระดับโครงสร้างภายใน ข้อมูลของสไลซ์จะจัดเก็บพอยน์เตอร์ที่ชี้ไปยังตำแหน่งเริ่มต้น และความยาวของสไลซ์ ซึ่งมีค่าเท่ากับ ending_index ลบด้วย starting_index ดังนั้นในกรณีของ let world = &s[6..11]; ตัวแปร world จะเป็นสไลซ์ที่เก็บพอยน์เตอร์ชี้ไปยังไบต์ที่ดัชนี 6 ของ s และมีความยาวเท่ากับ 5
รูปที่ 4-7 แสดงแผนภาพโครงสร้างในหน่วยความจำของสตริงสไลซ์
รูปที่ 4-7: สตริงสไลซ์ที่อ้างถึงบางส่วนของ String
ด้วยไวยากรณ์เรนจ์ .. ของ Rust หากคุณต้องการเริ่มต้นสไลซ์ที่ดัชนี 0 คุณสามารถละเว้นตัวเลขที่อยู่หน้าจุดสองจุดได้ กล่าวคือ โค้ดสองบรรทัดนี้ทำงานเทียบเท่ากันทุกประการ:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let slice = &s[0..2];
let slice = &s[..2];
}
ในทำนองเดียวกัน หากสไลซ์ของคุณครอบคลุมไปจนถึงไบต์สุดท้ายของ String คุณก็สามารถละเว้นตัวเลขตัวหลังได้เช่นกัน นั่นหมายความว่าโค้ดเหล่านี้ให้ผลลัพธ์เหมือนกัน:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let len = s.len();

let slice = &s[3..len];
let slice = &s[3..];
}
นอกจากนี้ คุณยังสามารถละเว้นตัวเลขทั้งสองตัวเพื่อสร้างสไลซ์ที่ครอบคลุมเนื้อหาของสตริงทั้งหมดได้ด้วย:
#![allow(unused)]
fn main() {
let s = String::from("hello");

let len = s.len();

let slice = &s[0..len];
let slice = &s[..];
}
หมายเหตุ: ดัชนีช่วงของสตริงสไลซ์จะต้องอยู่บนขอบเขตของอักขระ UTF-8 ที่ถูกต้องเสมอ หากคุณพยายามตัดสไลซ์ตรงกึ่งกลางของไบต์ที่ประกอบกันเป็นอักขระแบบหลายไบต์ โปรแกรมของคุณจะเกิดข้อผิดพลาดและแพนิกทันที
เมื่อเข้าใจหลักการแล้ว เราลองมาเขียนฟังก์ชัน first_word ใหม่โดยเปลี่ยนมาคืนค่าเป็นสไลซ์กัน ชนิดข้อมูลที่แทน “สตริงสไลซ์” จะเขียนว่า &str:
fn first_word(s: &String) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {}
เราหาดัชนีจุดสิ้นสุดของคำด้วยวิธีเดียวกับในลิสติ้ง 4-7 นั่นคือมองหาช่องว่างแรกที่พบ และเมื่อพบช่องว่าง เราจะส่งคืนสตริงสไลซ์โดยกำหนดจุดเริ่มต้นของสตริงและดัชนีของช่องว่างเป็นจุดเริ่มต้นและจุดสิ้นสุดของสไลซ์ตามลำดับ
ตอนนี้เมื่อเราเรียกใช้ first_word เราจะได้ค่าเดี่ยวๆ ที่ผูกติดอยู่กับข้อมูลสตริงต้นฉบับเบื้องหลังเสมอ ค่านี้ประกอบด้วยเรเฟอเรนซ์ที่ชี้ไปยังจุดเริ่มต้นของสไลซ์และจำนวนสมาชิกในสไลซ์นั้น
การคืนค่าเป็นสไลซ์ยังนำไปใช้กับฟังก์ชันอย่าง second_word ได้อย่างสวยงามเช่นกัน:
fn second_word(s: &String) -> &str {ในตอนนี้เราได้ API ที่ตรงไปตรงมาและปลอดภัยกว่าเดิมมาก เพราะคอมไพเลอร์ของ Rust จะช่วยรับประกันว่าเรเฟอเรนซ์ที่ชี้เข้าไปใน String จะยังคงถูกต้องสมบูรณ์อยู่เสมอ จำบั๊กในลิสติ้ง 4-8 ได้หรือไม่ ที่เราหาดัชนีของคำแรกได้แล้ว แต่หลังจากนั้นกลับไปล้างข้อมูลในสตริงทิ้งจนทำให้ดัชนีไม่ถูกต้อง? โค้ดชุดนั้นมีข้อผิดพลาดทางตรรกะแต่กลับไม่แสดงข้อผิดพลาดใดๆ ให้เห็นในทันที ซึ่งปัญหาจะไปโผล่ขึ้นในภายหลังเมื่อเราพยายามนำดัชนีไปใช้งานกับสตริงที่ว่างเปล่าไปแล้ว แต่การใช้สไลซ์จะทำให้บั๊กในลักษณะนี้ไม่สามารถเกิดขึ้นได้เลย และช่วยให้เราตรวจพบปัญหาในโค้ดได้ตั้งแต่เนิ่นๆ เพราะหากเรานำ first_word เวอร์ชันที่ใช้สไลซ์ไปใช้งาน คอมไพเลอร์จะตรวจจับและแจ้งข้อผิดพลาดทันทีตั้งแต่ตอนคอมไพล์:
fn first_word(s: &String) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let mut s = String::from("hello world");

    let word = first_word(&s);

    s.clear(); // error!

    println!("the first word is: {word}");
}
นี่คือข้อความแจ้งเตือนจากคอมไพเลอร์:
$ cargo run
   Compiling ownership v0.1.0 (file:///projects/ownership)
error[E0502]: cannot borrow `s` as mutable because it is also borrowed as immutable
  --> src/main.rs:18:5
   |
16 |     let word = first_word(&s);
   |                           -- immutable borrow occurs here
17 |
18 |     s.clear(); // error!
   |     ^^^^^^^^^ mutable borrow occurs here
19 |
20 |     println!("the first word is: {word}");
   |                                   ---- immutable borrow later used here

For more information about this error, try `rustc --explain E0502`.
error: could not compile `ownership` (bin "ownership") due to 1 previous error
ขอให้ย้อนนึกถึงกฎของการยืม: หากเรามีเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ไปยังข้อมูลใดอยู่ เราจะไม่สามารถสร้างเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ไปยังข้อมูลนั้นได้อีก และเนื่องจากเมธอด clear จำเป็นต้องตัดทอนและล้างข้อมูลใน String มันจึงต้องขอยืมเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ แต่คำสั่ง println! ที่อยู่ถัดมายังคงต้องใช้งานเรเฟอเรนซ์ใน word อยู่ ทำให้เรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ยังคงต้องมีผลใช้งานอยู่ ณ จุดนั้น Rust จึงไม่อนุญาตให้เรเฟอเรนซ์แบบเปลี่ยนแปลงได้จาก clear กับเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ใน word คงอยู่พร้อมกันได้ ส่งผลให้การคอมไพล์ไม่ผ่าน การทำเช่นนี้ไม่เพียงแต่ทำให้ API ของเราใช้งานง่ายขึ้นเท่านั้น แต่ยังช่วยกำจัดกลุ่มข้อผิดพลาดประเภทนี้ทิ้งไปอย่างสิ้นเชิงตั้งแต่ตอนคอมไพล์!
สตริงลิเทอรัลในฐานะสไลซ์
จำได้ไหมว่าเราเคยกล่าวไว้ว่า สตริงลิเทอรัลจะถูกฝังและจัดเก็บไว้ภายในไฟล์ไบนารีที่รันได้ เมื่อเราได้เรียนรู้เรื่องสไลซ์แล้ว เราจึงสามารถเข้าใจธรรมชาติที่แท้จริงของสตริงลิเทอรัลได้อย่างถ่องแท้:
#![allow(unused)]
fn main() {
let s = "Hello, world!";
}
ชนิดข้อมูลของ s ในบรรทัดนี้ก็คือ &str นั่นเอง: มันคือสไลซ์ที่ชี้ไปยังตำแหน่งของข้อความที่ถูกฝังไว้ในไฟล์ไบนารี และนี่ก็คือเหตุผลว่าทำไมสตริงลิเทอรัลจึงไม่สามารถแก้ไขเปลี่ยนแปลงค่าได้ เพราะ &str คือเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้
สตริงสไลซ์ในฐานะพารามิเตอร์
การที่เรารู้ว่าสามารถสร้างสไลซ์ขึ้นมาจากทั้งสตริงลิเทอรัลและค่าของ String ได้ นำไปสู่การปรับปรุงฟังก์ชัน first_word ให้ดียิ่งขึ้นไปอีกขั้น โดยเริ่มจากลายเซ็นของฟังก์ชัน:
fn first_word(s: &String) -> &str {โปรแกรมเมอร์ Rust ที่มีประสบการณ์จะนิยมเขียนลายเซ็นของฟังก์ชันตามที่แสดงในลิสติ้ง 4-9 แทน เพราะมันเปิดโอกาสให้เราสามารถเรียกใช้ฟังก์ชันเดียวกันนี้กับทั้งค่าชนิด &String และค่าชนิด &str ได้อย่างสะดวก:
fn first_word(s: &str) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let my_string = String::from("hello world");

    // `first_word` works on slices of `String`s, whether partial or whole.
    let word = first_word(&my_string[0..6]);
    let word = first_word(&my_string[..]);
    // `first_word` also works on references to `String`s, which are equivalent
    // to whole slices of `String`s.
    let word = first_word(&my_string);

    let my_string_literal = "hello world";

    // `first_word` works on slices of string literals, whether partial or
    // whole.
    let word = first_word(&my_string_literal[0..6]);
    let word = first_word(&my_string_literal[..]);

    // Because string literals *are* string slices already,
    // this works too, without the slice syntax!
    let word = first_word(my_string_literal);
}
หากเรามีสตริงสไลซ์ เราสามารถส่งมันเข้าไปในฟังก์ชันได้โดยตรง และหากเรามี String เราก็สามารถส่งสไลซ์ของ String นั้นหรือส่งเรเฟอเรนซ์ไปยัง String เข้าไปได้เลย ความยืดหยุ่นที่ยอดเยี่ยมนี้อาศัยประโยชน์จากคุณสมบัติ การบังคับดีเรฟ (deref coercion) ซึ่งเป็นฟีเจอร์ที่เราจะได้เรียนรู้ในหัวข้อ “การใช้การบังคับดีเรฟในฟังก์ชันและเมธอด” ในบทที่ 15
การนิยามฟังก์ชันให้รับสตริงสไลซ์แทนที่จะรับเรเฟอเรนซ์ไปยัง String จะช่วยให้ API ของเรามีความเป็นสากลและนำไปใช้งานได้หลากหลายขึ้นอย่างมาก โดยไม่สูญเสียความสามารถใดๆ ไปเลย:
fn first_word(s: &str) -> &str {
    let bytes = s.as_bytes();

    for (i, &item) in bytes.iter().enumerate() {
        if item == b' ' {
            return &s[0..i];
        }
    }

    &s[..]
}

fn main() {
    let my_string = String::from("hello world");

    // `first_word` works on slices of `String`s, whether partial or whole.
    let word = first_word(&my_string[0..6]);
    let word = first_word(&my_string[..]);
    // `first_word` also works on references to `String`s, which are equivalent
    // to whole slices of `String`s.
    let word = first_word(&my_string);

    let my_string_literal = "hello world";

    // `first_word` works on slices of string literals, whether partial or
    // whole.
    let word = first_word(&my_string_literal[0..6]);
    let word = first_word(&my_string_literal[..]);

    // Because string literals *are* string slices already,
    // this works too, without the slice syntax!
    let word = first_word(my_string_literal);
}
สไลซ์แบบอื่นๆ
สตริงสไลซ์ถูกออกแบบมาสำหรับข้อความโดยเฉพาะ แต่ใน Rust ยังมีชนิดของสไลซ์แบบทั่วไปสำหรับคอลเลกชันอื่นๆ ด้วย ลองพิจารณาอาร์เรย์ต่อไปนี้:
#![allow(unused)]
fn main() {
let a = [1, 2, 3, 4, 5];
}
เช่นเดียวกับที่เราต้องการอ้างถึงบางส่วนของสตริง เราก็อาจต้องการอ้างถึงบางส่วนของอาร์เรย์ได้เช่นกัน ซึ่งเราสามารถเขียนได้ดังนี้:
#![allow(unused)]
fn main() {
let a = [1, 2, 3, 4, 5];

let slice = &a[1..3];

assert_eq!(slice, &[2, 3]);
}
สไลซ์นี้มีชนิดข้อมูลเป็น &[i32] โดยมีหลักการทำงานแบบเดียวกับสตริงสไลซ์ทุกประการ นั่นคือการเก็บเรเฟอเรนซ์ที่ชี้ไปยังสมาชิกตัวแรกควบคู่กับความยาวของสไลซ์ คุณสามารถใช้สไลซ์ประเภทนี้กับคอลเลกชันรูปแบบอื่นๆ ได้อย่างหลากหลาย ซึ่งเราจะพูดถึงคอลเลกชันเหล่านี้อย่างละเอียดเมื่อเราศึกษาเรื่องเวกเตอร์ (vector) ในบทที่ 8
สรุป
แนวคิดของระบบความเป็นเจ้าของ (ownership), การยืมข้อมูล (borrowing), และสไลซ์ (slice) ล้วนทำงานร่วมกันเพื่อรับประกันความปลอดภัยของหน่วยความจำในโปรแกรม Rust ตั้งแต่ตอนคอมไพล์ โดยภาษา Rust มอบอำนาจในการควบคุมการใช้งานหน่วยความจำให้คุณได้อย่างเต็มที่เช่นเดียวกับภาษาโปรแกรมระดับระบบอื่นๆ แต่การที่ตัวแปรที่เป็นเจ้าของจะทำหน้าที่คืนและล้างหน่วยความจำให้อัตโนมัติเมื่อหลุดออกจากขอบเขต หมายความว่าคุณไม่จำเป็นต้องคอยเขียนคำสั่งจัดการหน่วยความจำและไม่ต้องเสียเวลาดีบักปัญหาเหล่านี้ด้วยตนเองอีกต่อไป
ระบบความเป็นเจ้าของส่งผลต่อการออกแบบและการทำงานขององค์ประกอบอื่นๆ เกือบทั้งหมดใน Rust ดังนั้นเราจึงจะพบเห็นและต่อยอดแนวคิดเหล่านี้อย่างต่อเนื่องตลอดทั้งเล่ม และในบทที่ 5 เราจะไปศึกษาการจัดกลุ่มข้อมูลที่เกี่ยวข้องกันเข้าด้วยกันผ่านโครงสร้างข้อมูลที่เรียกว่า struct
การใช้ struct เพื่อจัดโครงสร้างข้อมูลที่เกี่ยวข้องกัน
struct หรือ โครงสร้าง (structure) เป็นชนิดข้อมูลกำหนดเอง (custom data type) ที่เปิดโอกาสให้คุณรวมกลุ่มและตั้งชื่อให้กับค่าข้อมูลหลายค่าที่มีความเกี่ยวข้องกัน เพื่อประกอบขึ้นเป็นกลุ่มข้อมูลที่มีความหมาย หากคุณคุ้นเคยกับภาษาโปรแกรมเชิงวัตถุ (object-oriented language) struct ก็เปรียบเสมือนแอตทริบิวต์หรือฟิลด์ข้อมูลของออบเจกต์ ในบทนี้ เราจะเปรียบเทียบความเหมือนและความต่างระหว่างทูเพิล (tuple) กับ struct เพื่อต่อยอดจากสิ่งที่คุณได้เรียนรู้มาแล้ว และแสดงให้เห็นว่าในสถานการณ์ใดที่ struct จะเป็นวิธีที่ดีกว่าในการจัดกลุ่มข้อมูล
เราจะแสดงวิธีนิยามและสร้างอินสแตนซ์ (instance) ของ struct รวมถึงศึกษาวิธีนิยามฟังก์ชันประจำชนิดข้อมูล (associated function) โดยเฉพาะฟังก์ชันชนิดที่เรียกว่า เมธอด (method) เพื่อกำหนดพฤติกรรมการทำงานให้กับ struct นั้นๆ ทั้ง struct และ enum (ซึ่งเราจะพูดถึงในบทที่ 6) ถือเป็นองค์ประกอบพื้นฐานที่สำคัญในการสร้างชนิดข้อมูลใหม่ๆ ในโดเมนของโปรแกรมคุณ เพื่อดึงเอาประสิทธิภาพสูงสุดจากการตรวจสอบชนิดข้อมูลตอนคอมไพล์ของ Rust มาใช้งาน
การนิยามและสร้างอินสแตนซ์ของ struct
การนิยามและสร้างอินสแตนซ์ของ struct
struct มีความคล้ายคลึงกับทูเพิล (tuple) ซึ่งเราได้กล่าวถึงในหัวข้อ “ชนิดทูเพิล” ตรงที่ทั้งสองสามารถจัดเก็บค่าข้อมูลที่เกี่ยวข้องกันได้หลายค่า และสมาชิกแต่ละตัวสามารถมีชนิดข้อมูลที่แตกต่างกันได้ แต่จุดที่ต่างจากทูเพิลคือ ใน struct คุณจะสามารถตั้งชื่อให้กับข้อมูลแต่ละชิ้นได้ เพื่อระบุความหมายของค่านั้นๆ ไว้อย่างชัดเจน การมีชื่อกำกับทำให้ struct มีความยืดหยุ่นกว่าทูเพิลมาก โดยคุณไม่จำเป็นต้องพึ่งพาลำดับก่อนหลังของข้อมูลในการเข้าถึงหรือระบุค่าต่างๆ ของอินสแตนซ์ (instance) อีกต่อไป
ในการนิยาม struct เราจะขึ้นต้นด้วยคีย์เวิร์ด struct ตามด้วยชื่อที่ต้องการตั้งให้กับ struct นั้น โดยชื่อของ struct ควรสื่อถึงความหมายและความสำคัญของกลุ่มข้อมูลที่ถูกรวมเข้าไว้ด้วยกัน จากนั้นภายในเครื่องหมายวงเล็บปีกกา เราจะระบุชื่อและชนิดข้อมูลของข้อมูลแต่ละชิ้น ซึ่งเราเรียกว่า ฟิลด์ (field) ตัวอย่างเช่น ลิสติ้ง 5-1 แสดงการนิยาม struct สำหรับจัดเก็บข้อมูลเกี่ยวกับบัญชีผู้ใช้
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {}
เมื่อต้องการนำ struct ไปใช้งานหลังจากนิยามไว้แล้ว เราจะสร้าง อินสแตนซ์ (instance) ของ struct นั้นขึ้นมาโดยการกำหนดค่าจริงให้กับแต่ละฟิลด์ การสร้างอินสแตนซ์ทำได้โดยระบุชื่อของ struct ตามด้วยเครื่องหมายวงเล็บปีกกาที่บรรจุคู่ key: value โดยที่คีย์ (key) คือชื่อของฟิลด์ และค่า (value) คือข้อมูลที่เราต้องการบันทึกไว้ในฟิลด์นั้นๆ ทั้งนี้เราไม่จำเป็นต้องเรียงลำดับฟิลด์ให้ตรงกับตอนที่ประกาศไว้ใน struct แต่อย่างใด กล่าวอีกนัยหนึ่ง การนิยาม struct เปรียบเสมือนแบบพิมพ์เขียวทั่วไปของชนิดข้อมูล และอินสแตนซ์ก็คือการนำข้อมูลจริงไปเติมลงในแบบพิมพ์เขียวนั้นเพื่อสร้างเป็นค่าข้อมูลขึ้นมา ตัวอย่างเช่น เราสามารถประกาศข้อมูลของผู้ใช้รายหนึ่งได้ดังแสดงในลิสติ้ง 5-2
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {
    let user1 = User {
        active: true,
        username: String::from("someusername123"),
        email: String::from("someone@example.com"),
        sign_in_count: 1,
    };
}
เมื่อต้องการเข้าถึงค่าในฟิลด์ใดฟิลด์หนึ่งของ struct เราจะใช้สัญกรณ์จุด (dot notation) ตัวอย่างเช่น หากต้องการอ่านที่อยู่อีเมลของผู้ใช้รายนี้ เราจะเขียนว่า user1.email และหากอินสแตนซ์นั้นถูกประกาศให้เป็นตัวแปรแบบแก้ไขได้ (mutable) เราจะสามารถแก้ไขค่าในฟิลด์ได้โดยใช้สัญกรณ์จุดควบคู่กับการกำหนดค่าใหม่ลงไป ลิสติ้ง 5-3 แสดงตัวอย่างการเปลี่ยนค่าในฟิลด์ email ของอินสแตนซ์ User ที่แก้ไขได้
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {
    let mut user1 = User {
        active: true,
        username: String::from("someusername123"),
        email: String::from("someone@example.com"),
        sign_in_count: 1,
    };

    user1.email = String::from("anotheremail@example.com");
}
โปรดสังเกตว่าการกำหนดให้แก้ไขค่าได้นั้นจะต้องกระทำกับอินสแตนซ์ทั้งตัว เพราะ Rust ไม่อนุญาตให้เรากำหนดความสามารถในการแก้ไขค่าเฉพาะบางฟิลด์ได้ และเช่นเดียวกับนิพจน์ (expression) ทั่วไป เราสามารถสร้างอินสแตนซ์ใหม่ของ struct เป็นนิพจน์สุดท้ายในเนื้อหาของฟังก์ชัน เพื่อส่งคืนอินสแตนซ์ใหม่นั้นออกมาจากฟังก์ชันได้โดยปริยาย
ลิสติ้ง 5-4 แสดงฟังก์ชัน build_user ซึ่งจะส่งคืนอินสแตนซ์ของ User ที่มีอีเมลและชื่อผู้ใช้ตามที่ระบุเข้ามา โดยกำหนดให้ฟิลด์ active มีค่าเป็น true และฟิลด์ sign_in_count มีค่าเป็น 1
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn build_user(email: String, username: String) -> User {
    User {
        active: true,
        username: username,
        email: email,
        sign_in_count: 1,
    }
}

fn main() {
    let user1 = build_user(
        String::from("someone@example.com"),
        String::from("someusername123"),
    );
}
การตั้งชื่อพารามิเตอร์ของฟังก์ชันให้ตรงกับชื่อฟิลด์ของ struct ถือเป็นเรื่องที่สมเหตุสมผลและสื่อความหมายได้ดี แต่การต้องพิมพ์ชื่อตัวแปร email และ username ซ้ำๆ เช่น email: email นั้นค่อนข้างซ้ำซ้อน หาก struct มีฟิลด์มากกว่านี้ การพิมพ์ชื่อซ้ำก็จะยิ่งน่ารำคาญมากขึ้น ซึ่งโชคดีที่ Rust มีรูปแบบการเขียนย่อที่สะดวกสบายเตรียมไว้ให้!
การใช้รูปแบบย่อของฟิลด์
เนื่องจากชื่อพารามิเตอร์และชื่อฟิลด์ของ struct มีชื่อเดียวกันทุกประการในลิสติ้ง 5-4 เราจึงสามารถใช้ไวยากรณ์ รูปแบบย่อสำหรับกำหนดค่าเริ่มต้นฟิลด์ (field init shorthand) เพื่อเขียนฟังก์ชัน build_user ใหม่ให้ทำงานเหมือนเดิมทุกประการ แต่ไม่ต้องพิมพ์ username และ email ซ้ำ ดังแสดงในลิสติ้ง 5-5
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn build_user(email: String, username: String) -> User {
    User {
        active: true,
        username,
        email,
        sign_in_count: 1,
    }
}

fn main() {
    let user1 = build_user(
        String::from("someone@example.com"),
        String::from("someusername123"),
    );
}
ในตัวอย่างนี้ เรากำลังสร้างอินสแตนซ์ใหม่ของ struct User ที่มีฟิลด์ชื่อ email โดยต้องการนำค่าจากพารามิเตอร์ email ในฟังก์ชัน build_user มากำหนดให้กับฟิลด์นี้ และเนื่องจากทั้งสองมีชื่อตรงกัน เราจึงสามารถเขียนเพียงแค่ email สั้นๆ แทนที่จะต้องเขียน email: email ได้ทันที
การสร้างอินสแตนซ์ด้วยไวยากรณ์อัปเดต struct
บ่อยครั้งที่เราต้องการสร้างอินสแตนซ์ใหม่ของ struct โดยคัดลอกค่าส่วนใหญ่มาจากอินสแตนซ์เดิมของชนิดข้อมูลเดียวกัน และต้องการเปลี่ยนค่าเพียงแค่บางฟิลด์เท่านั้น ในสถานการณ์นี้ เราสามารถนำ ไวยากรณ์อัปเดต struct (struct update syntax) มาใช้งานได้
ขั้นแรก ลิสติ้ง 5-6 แสดงวิธีสร้างอินสแตนซ์ใหม่ของ User ในตัวแปร user2 ด้วยวิธีมาตรฐานโดยไม่ใช้ไวยากรณ์อัปเดต โดยเรากำหนดค่าใหม่ให้กับฟิลด์ email แต่ฟิลด์ที่เหลือทั้งหมดจะดึงค่ามาจาก user1 ที่สร้างไว้ในลิสติ้ง 5-2
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {
    // --snip--

    let user1 = User {
        email: String::from("someone@example.com"),
        username: String::from("someusername123"),
        active: true,
        sign_in_count: 1,
    };

    let user2 = User {
        active: user1.active,
        username: user1.username,
        email: String::from("another@example.com"),
        sign_in_count: user1.sign_in_count,
    };
}
เมื่อเปลี่ยนมาใช้ไวยากรณ์อัปเดต struct เราจะสามารถเขียนโค้ดที่ให้ผลลัพธ์แบบเดียวกันได้อย่างกระชับยิ่งขึ้น ดังแสดงในลิสติ้ง 5-7 โดยเครื่องหมาย .. เป็นการระบุว่าฟิลด์ที่เหลือทั้งหมดที่ไม่ได้กำหนดค่าไว้อย่างชัดเจน ให้นำค่ามาจากฟิลด์ที่ตรงกันในอินสแตนซ์ที่ระบุ
struct User {
    active: bool,
    username: String,
    email: String,
    sign_in_count: u64,
}

fn main() {
    // --snip--

    let user1 = User {
        email: String::from("someone@example.com"),
        username: String::from("someusername123"),
        active: true,
        sign_in_count: 1,
    };

    let user2 = User {
        email: String::from("another@example.com"),
        ..user1
    };
}
โค้ดในลิสติ้ง 5-7 จะสร้างอินสแตนซ์ใน user2 ที่มีค่าในฟิลด์ email ต่างออกไป แต่มีค่าในฟิลด์ username, active และ sign_in_count เหมือนกับ user1 ทุกประการ โดยคำสั่ง ..user1 จะต้องวางไว้ท้ายสุดเสมอ เพื่อบ่งชี้ว่าฟิลด์ที่เหลือให้รับค่ามาจาก user1 แต่เราสามารถเลือกกำหนดค่าให้กับฟิลด์ต่างๆ ล่วงหน้าได้มากเท่าที่ต้องการในลำดับใดก็ได้ โดยไม่จำเป็นต้องเรียงตามลำดับฟิลด์ที่นิยามไว้ใน struct
โปรดสังเกตว่าไวยากรณ์อัปเดต struct ใช้เครื่องหมาย = เช่นเดียวกับการกำหนดค่าทั่วไป จึงทำให้เกิดการย้ายค่า (move) ของข้อมูลขึ้น ดังที่เราได้เรียนรู้กันไปแล้วในหัวข้อ “ตัวแปรและข้อมูลที่ปฏิสัมพันธ์กันด้วยการย้ายค่า” ในตัวอย่างนี้ เราจะไม่สามารถนำตัวแปร user1 มาใช้งานต่อได้อีกหลังจากสร้าง user2 ไปแล้ว เนื่องจากค่า String ในฟิลด์ username ของ user1 ได้ถูกย้ายเข้าไปยัง user2 เรียบร้อยแล้ว แต่หากเรากำหนดค่า String ใหม่ให้กับ user2 ทั้งในฟิลด์ email และ username แล้วดึงมาเฉพาะค่าในฟิลด์ active และ sign_in_count จาก user1 เท่านั้น ตัวแปร user1 จะยังคงสามารถใช้งานต่อไปได้หลังจากสร้าง user2 เนื่องจากทั้ง active และ sign_in_count ต่างเป็นชนิดข้อมูลที่อิมพลีเมนต์เทรต Copy พฤติกรรมจึงเป็นไปตามที่เราได้ศึกษาในหัวข้อ “ข้อมูลบนสแตกเท่านั้น: การคัดลอกค่า” และนอกจากนี้เรายังคงสามารถเข้าถึง user1.email ในตัวอย่างนี้ได้ เพราะค่าของมันไม่ได้ถูกย้ายออกไปจาก user1
การสร้างชนิดข้อมูลที่แตกต่างกันด้วยทูเพิล struct
Rust ยังรองรับการสร้าง struct ที่มีรูปแบบคล้ายทูเพิล ซึ่งเรียกว่า ทูเพิล struct (tuple struct) โดยทูเพิล struct จะได้รับประโยชน์จากการมีชื่อของชนิดข้อมูลเพื่อบ่งบอกความหมาย แต่จะไม่มีชื่อกำกับฟิลด์แต่ละตัว โดยจะมีเพียงชนิดข้อมูลของแต่ละฟิลด์เท่านั้น ทูเพิล struct มีประโยชน์อย่างยิ่งเมื่อคุณต้องการตั้งชื่อให้กับทูเพิลทั้งชุดเพื่อสร้างเป็นชนิดข้อมูลใหม่ที่แตกต่างจากทูเพิลอื่นๆ และในกรณีที่การตั้งชื่อให้กับทุกๆ ฟิลด์เหมือนใน struct ทั่วไปดูจะเยิ่นเย้อหรือซ้ำซ้อนเกินไป
ในการนิยามทูเพิล struct ให้เริ่มต้นด้วยคีย์เวิร์ด struct ตามด้วยชื่อของ struct และตามด้วยชนิดข้อมูลของสมาชิกในทูเพิล ตัวอย่างเช่น เรานิยามและใช้งานทูเพิล struct สองตัวชื่อ Color และ Point:
struct Color(i32, i32, i32);
struct Point(i32, i32, i32);

fn main() {
    let black = Color(0, 0, 0);
    let origin = Point(0, 0, 0);
}
โปรดสังเกตว่าค่า black และ origin เป็นคนละชนิดข้อมูลกันอย่างสิ้นเชิง เนื่องจากพวกมันเป็นอินสแตนซ์ของทูเพิล struct คนละตัวกัน struct แต่ละตัวที่คุณนิยามขึ้นมาจะถือเป็นชนิดข้อมูลเฉพาะของตนเองเสมอ แม้ว่าฟิลด์ภายในจะมีชนิดข้อมูลเหมือนกันทุกประการก็ตาม ตัวอย่างเช่น ฟังก์ชันที่รับพารามิเตอร์ชนิด Color จะไม่สามารถรับอาร์กิวเมนต์ชนิด Point ได้ แม้ว่าชนิดข้อมูลทั้งสองจะประกอบขึ้นจากค่า i32 สามตัวเหมือนกันก็ตาม ส่วนการทำงานอื่นๆ ของอินสแตนซ์ทูเพิล struct จะเหมือนกับทูเพิลทั่วไป คือคุณสามารถกระจายโครงสร้างข้อมูล (destructuring) ออกเป็นชิ้นส่วนย่อยๆ ได้ และสามารถใช้เครื่องหมาย . ตามด้วยตัวเลขดัชนีเพื่อเข้าถึงสมาชิกแต่ละตัวได้ แต่จุดที่ต่างจากทูเพิลคือ ทูเพิล struct กำหนดให้คุณต้องระบุชื่อชนิดข้อมูลของ struct เมื่อต้องการกระจายโครงสร้าง เช่น เราจะเขียน let Point(x, y, z) = origin; เพื่อกระจายค่าใน origin ออกมาเป็นตัวแปร x, y และ z
การนิยาม struct ที่คล้ายยูนิต
คุณยังสามารถนิยาม struct ที่ไม่มีฟิลด์ข้อมูลใดๆ เลยได้ด้วย! เราเรียกโครงสร้างเหล่านี้ว่า struct ที่คล้ายยูนิต (unit-like struct) เนื่องจากมันทำงานคล้ายคลึงกับชนิดข้อมูลยูนิต () ที่เราเคยกล่าวถึงในหัวข้อ “ชนิดทูเพิล” โดย struct ที่คล้ายยูนิตจะมีประโยชน์อย่างมากเมื่อคุณจำเป็นต้องอิมพลีเมนต์เทรต (trait) ให้กับชนิดข้อมูลบางชนิด แต่ไม่มีข้อมูลใดๆ ที่จำเป็นต้องเก็บไว้ในตัวชนิดข้อมูลนั้น ซึ่งเราจะเจาะลึกเรื่องเทรตในบทที่ 10 ต่อไป ตัวอย่างต่อไปนี้แสดงการประกาศและสร้างอินสแตนซ์ของ struct แบบยูนิตชื่อ AlwaysEqual:
struct AlwaysEqual;

fn main() {
    let subject = AlwaysEqual;
}
ในการนิยาม AlwaysEqual เราใช้คีย์เวิร์ด struct ตามด้วยชื่อที่ต้องการ แล้วปิดท้ายด้วยเครื่องหมายอัฒภาคได้ทันที โดยไม่ต้องมีทั้งวงเล็บปีกกาหรือวงเล็บกลม! จากนั้นเราสามารถสร้างอินสแตนซ์ของ AlwaysEqual มอบให้กับตัวแปร subject ได้ในทำนองเดียวกัน คือระบุเพียงแค่ชื่อที่เรานิยามไว้โดยไม่ต้องใส่วงเล็บใดๆ ลองจินตนาการว่าในภายหลังเราจะอิมพลีเมนต์พฤติกรรมให้กับชนิดข้อมูลนี้ โดยกำหนดให้อินสแตนซ์ของ AlwaysEqual มีค่าเท่ากับทุกอินสแตนซ์ของชนิดข้อมูลอื่นเสมอ เช่น เพื่อให้ได้ผลลัพธ์ที่คาดเดาได้แน่นอนสำหรับการทดสอบ (testing) เราก็ไม่จำเป็นต้องเก็บข้อมูลใดๆ ไว้ในตัวแปรเพื่อทำงานดังกล่าวเลย! คุณจะได้เห็นวิธีนิยามและอิมพลีเมนต์เทรตให้กับชนิดข้อมูลต่างๆ รวมถึง struct ที่คล้ายยูนิตอย่างละเอียดในบทที่ 10
ความเป็นเจ้าของข้อมูลใน struct
ในการนิยาม struct
Userในลิสติ้ง 5-1 เราเลือกใช้ชนิดข้อมูลStringที่ถือครองความเป็นเจ้าของค่าข้อมูล แทนที่จะใช้สตริงสไลซ์&strซึ่งเป็นการตัดสินใจโดยเจตนา เพราะเราต้องการให้อินสแตนซ์แต่ละตัวของstructนี้เป็นเจ้าของข้อมูลทั้งหมดของมันอย่างสมบูรณ์ และให้ข้อมูลนั้นคงอยู่ตราบเท่าที่อินสแตนซ์ของstructยังคงใช้งานได้ในความเป็นจริง
structสามารถจัดเก็บการอ้างอิง (reference) ไปยังข้อมูลที่เป็นของตัวแปรอื่นได้เช่นกัน แต่การทำเช่นนั้นจะต้องใช้สิ่งที่เรียกว่า ไลฟ์ไทม์ (lifetime) ซึ่งเป็นฟีเจอร์ขั้นสูงของ Rust ที่เราจะพูดถึงในบทที่ 10 โดยไลฟ์ไทม์จะช่วยรับประกันว่าข้อมูลที่structอ้างอิงไปถึงจะยังคงมีตัวตนอยู่เสมอ ตราบใดที่structนั้นยังคงใช้งานอยู่ หากคุณพยายามเก็บเรเฟอเรนซ์ไว้ในstructโดยไม่ระบุไลฟ์ไทม์กำกับไว้ ดังเช่นตัวอย่างใน src/main.rs ต่อไปนี้ โค้ดจะไม่สามารถคอมไพล์ผ่านได้:struct User { active: bool, username: &str, email: &str, sign_in_count: u64, } fn main() { let user1 = User { active: true, username: "someusername123", email: "someone@example.com", sign_in_count: 1, }; }คอมไพเลอร์จะแจ้งเตือนว่าจำเป็นต้องระบุไลฟ์ไทม์:
$ cargo run
   Compiling structs v0.1.0 (file:///projects/structs)
error[E0106]: missing lifetime specifier
 --> src/main.rs:3:15
  |
3 |     username: &str,
  |               ^ expected named lifetime parameter
  |
help: consider introducing a named lifetime parameter
  |
1 ~ struct User<'a> {
2 |     active: bool,
3 ~     username: &'a str,
  |

error[E0106]: missing lifetime specifier
 --> src/main.rs:4:12
  |
4 |     email: &str,
  |            ^ expected named lifetime parameter
  |
help: consider introducing a named lifetime parameter
  |
1 ~ struct User<'a> {
2 |     active: bool,
3 |     username: &str,
4 ~     email: &'a str,
  |

For more information about this error, try `rustc --explain E0106`.
error: could not compile `structs` (bin "structs") due to 2 previous errors
ในบทที่ 10 เราจะได้เรียนรู้วิธีแก้ไขข้อผิดพลาดเหล่านี้ เพื่อให้คุณสามารถจัดเก็บเรเฟอเรนซ์ไว้ใน
structได้อย่างถูกต้อง แต่สำหรับในตอนนี้ เราจะแก้ไขปัญหาโดยการเลือกใช้ชนิดข้อมูลที่ถือครองความเป็นเจ้าของค่า เช่นStringแทนที่จะใช้เรเฟอเรนซ์อย่าง&str
ตัวอย่างโปรแกรมที่ใช้ struct
โปรแกรมตัวอย่างที่ใช้ struct
เพื่อให้เข้าใจว่าในสถานการณ์ใดที่เราควรนำ struct มาใช้งาน เรามาลองเขียนโปรแกรมสำหรับคำนวณพื้นที่ของรูปสี่เหลี่ยมผืนผ้ากัน โดยเราจะเริ่มต้นจากการใช้ตัวแปรเดี่ยวๆ แยกกันก่อน แล้วค่อยๆ ปรับปรุงโครงสร้างโค้ด (refactor) ไปเรื่อยๆ จนกระทั่งเปลี่ยนมาใช้ struct แทน
ให้สร้างโปรเจกต์แบบไบนารีใหม่ด้วย Cargo ในชื่อ rectangles ซึ่งจะรับค่าความกว้างและความสูงของสี่เหลี่ยมผืนผ้าในหน่วยพิกเซล แล้วนำไปคำนวณหาพื้นที่ ลิสติ้ง 5-8 แสดงโปรแกรมสั้นๆ ที่ใช้วิธีการพื้นฐานนี้ในไฟล์ src/main.rs
fn main() {
    let width1 = 30;
    let height1 = 50;

    println!(
        "The area of the rectangle is {} square pixels.",
        area(width1, height1)
    );
}

fn area(width: u32, height: u32) -> u32 {
    width * height
}
ตอนนี้ ให้ลองสั่งรันโปรแกรมนี้ด้วยคำสั่ง cargo run:
$ cargo run
   Compiling rectangles v0.1.0 (file:///projects/rectangles)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.42s
     Running `target/debug/rectangles`
The area of the rectangle is 1500 square pixels.
โค้ดนี้สามารถคำนวณพื้นที่ของสี่เหลี่ยมผืนผ้าได้ถูกต้องสมบูรณ์โดยการเรียกใช้ฟังก์ชัน area พร้อมส่งขนาดของแต่ละด้านเข้าไป แต่เรายังสามารถทำให้โค้ดนี้มีความชัดเจนและอ่านเข้าใจได้ง่ายยิ่งขึ้นกว่านี้
ปัญหาของโค้ดชุดนี้ปรากฏให้เห็นอย่างชัดเจนในลายเซ็น (signature) ของฟังก์ชัน area:
fn main() {
    let width1 = 30;
    let height1 = 50;

    println!(
        "The area of the rectangle is {} square pixels.",
        area(width1, height1)
    );
}

fn area(width: u32, height: u32) -> u32 {
    width * height
}
เป้าหมายของฟังก์ชัน area คือการคำนวณพื้นที่ของสี่เหลี่ยมผืนผ้ารูปหนึ่ง แต่ฟังก์ชันที่เราเขียนกลับรับพารามิเตอร์ 2 ตัวแยกกัน และไม่มีส่วนใดในโปรแกรมที่สื่อให้เห็นว่าพารามิเตอร์ทั้งสองมีความเกี่ยวข้องกัน การรวมความกว้างและความสูงเข้าเป็นกลุ่มเดียวกันจะช่วยให้โค้ดอ่านง่ายและจัดการได้สะดวกขึ้น ซึ่งวิธีหนึ่งที่เราเคยเรียนรู้ไปแล้วในหัวข้อ “ชนิดทูเพิล” ในบทที่ 3 ก็คือการใช้ทูเพิล
การรีแฟกเตอร์ด้วยทูเพิล
ลิสติ้ง 5-9 แสดงโปรแกรมอีกเวอร์ชันหนึ่งที่ปรับมาใช้ทูเพิล:
fn main() {
    let rect1 = (30, 50);

    println!(
        "The area of the rectangle is {} square pixels.",
        area(rect1)
    );
}

fn area(dimensions: (u32, u32)) -> u32 {
    dimensions.0 * dimensions.1
}
ในแง่หนึ่ง โปรแกรมเวอร์ชันนี้ดูดีขึ้น เพราะทูเพิลช่วยให้เราจัดโครงสร้างข้อมูลได้เป็นกลุ่มก้อน และฟังก์ชันรับอาร์กิวเมนต์เพียงตัวเดียว แต่ในอีกแง่หนึ่ง โค้ดกลับมีความชัดเจนลดลง เนื่องจากทูเพิลไม่มีการตั้งชื่อให้กับสมาชิกภายใน เราจึงต้องเข้าถึงส่วนประกอบต่างๆ ด้วยตัวเลขดัชนี ซึ่งทำให้การคำนวณสื่อความหมายได้น้อยลง
ในการคำนวณหาพื้นที่ การสลับตำแหน่งระหว่างความกว้างและความสูงอาจไม่ส่งผลกระทบต่อผลลัพธ์ แต่หากเราต้องนำขนาดเหล่านี้ไปใช้วาดรูปสี่เหลี่ยมลงบนหน้าจอย่อมส่งผลแน่นอน! เราจะต้องคอยจำให้ได้ว่า width คือดัชนี 0 และ height คือดัชนี 1 ของทูเพิล ซึ่งหากผู้อื่นต้องนำโค้ดของเราไปพัฒนาต่อ ก็จะยิ่งเข้าใจและจดจำได้ยากขึ้น และการที่โค้ดไม่ได้สื่อความหมายของข้อมูลอย่างชัดเจน ย่อมเปิดช่องให้เกิดข้อผิดพลาดได้ง่ายขึ้น
การรีแฟกเตอร์ด้วย struct
เราสามารถใช้ struct เพื่อเพิ่มความหมายให้กับข้อมูลด้วยการตั้งชื่อกำกับ โดยแปลงทูเพิลที่ใช้อยู่ให้กลายเป็น struct ที่มีชื่อของชนิดข้อมูลกำกับทั้งชุด และมีชื่อกำกับสมาชิกในแต่ละฟิลด์ ดังแสดงในลิสติ้ง 5-10
struct Rectangle {
    width: u32,
    height: u32,
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    println!(
        "The area of the rectangle is {} square pixels.",
        area(&rect1)
    );
}

fn area(rectangle: &Rectangle) -> u32 {
    rectangle.width * rectangle.height
}
ในที่นี้ เราได้นิยาม struct และตั้งชื่อว่า Rectangle โดยภายในวงเล็บปีกกา เราได้กำหนดฟิลด์ชื่อ width และ height ซึ่งทั้งคู่เป็นชนิดข้อมูล u32 จากนั้นในฟังก์ชัน main เราจึงสร้างอินสแตนซ์ของ Rectangle ขึ้นมาโดยมีความกว้าง 30 และความสูง 50
ฟังก์ชัน area ของเราในตอนนี้ถูกนิยามให้รับพารามิเตอร์เพียงตัวเดียว โดยเราตั้งชื่อว่า rectangle ซึ่งมีชนิดข้อมูลเป็นการยืมแบบแก้ไขไม่ได้ (immutable borrow) ของอินสแตนซ์ struct Rectangle ดังที่เราได้เรียนรู้ไปแล้วในบทที่ 4 ว่าเราควรยืม struct มาใช้งานแทนที่จะย้ายความเป็นเจ้าของเข้ามา เพื่อให้ฟังก์ชัน main ยังคงถือครองความเป็นเจ้าของและสามารถนำตัวแปร rect1 ไปใช้งานต่อได้ เราจึงใส่เครื่องหมาย & ไว้ในลายเซ็นของฟังก์ชันและในจุดที่เรียกใช้ฟังก์ชัน
ฟังก์ชัน area จะเข้าถึงฟิลด์ width และ height ของอินสแตนซ์ Rectangle (โปรดสังเกตว่าการเข้าถึงฟิลด์ของอินสแตนซ์ struct ที่ถูกยืมมา จะไม่ได้ทำการย้ายค่าของฟิลด์นั้นออกไป ซึ่งเป็นเหตุผลว่าทำไมคุณจึงมักเห็นการส่ง struct ด้วยการยืมอยู่เสมอ) ในตอนนี้ ลายเซ็นของฟังก์ชัน area ได้สื่อความหมายตรงตามที่เราต้องการอย่างสมบูรณ์แบบ นั่นคือ การคำนวณพื้นที่ของ Rectangle โดยใช้ข้อมูลจากฟิลด์ width และ height ของมัน ซึ่งช่วยสื่อให้เห็นอย่างชัดเจนว่าความกว้างและความสูงมีความเกี่ยวข้องกัน พร้อมทั้งระบุชื่อที่ชัดเจนให้กับค่าเหล่านั้น แทนที่จะต้องใช้ตัวเลขดัชนี 0 และ 1 ของทูเพิล ถือเป็นชัยชนะในด้านความชัดเจนของโค้ดอย่างแท้จริง
การเพิ่มความสามารถด้วยเทรตที่ derive ได้
ในระหว่างการดีบักโปรแกรม คงจะสะดวกไม่น้อยหากเราสามารถพิมพ์ค่าของอินสแตนซ์ Rectangle ออกมาเพื่อตรวจสอบค่าในทุกๆ ฟิลด์ได้ ลิสติ้ง 5-11 จึงลองใช้ มาโคร println! ตามที่เราเคยใช้งานในบทก่อนๆ แต่ทว่าวิธีนี้กลับใช้ไม่ได้:
struct Rectangle {
    width: u32,
    height: u32,
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    println!("rect1 is {rect1}");
}
เมื่อเราคอมไพล์โค้ดนี้ จะพบกับข้อผิดพลาดโดยมีใจความสำคัญดังนี้:
error[E0277]: `Rectangle` doesn't implement `std::fmt::Display`
มาโคร println! รองรับการจัดรูปแบบการแสดงผลได้หลากหลายรูปแบบ โดยตามค่าเริ่มต้น เครื่องหมายวงเล็บปีกกา {} จะสั่งให้ println! ใช้การจัดรูปแบบที่เรียกว่า Display ซึ่งมีไว้สำหรับแสดงผลข้อความให้ผู้ใช้งานปลายทางอ่านโดยตรง ชนิดข้อมูลพื้นฐานต่างๆ ที่เราเคยเห็นมาล้วนอิมพลีเมนต์ Display ไว้ตั้งแต่แรกแล้ว เพราะมีรูปแบบการแสดงผลที่ชัดเจนแน่นอน เช่น ตัวเลข 1 แต่สำหรับ struct แล้ว รูปแบบการแสดงผลที่เหมาะสมนั้นไม่สามารถคาดเดาได้ เพราะมีความเป็นไปได้หลากหลาย เช่น คุณต้องการให้มีเครื่องหมายจุลภาคคั่นหรือไม่? ต้องการให้พิมพ์วงเล็บปีกกาด้วยไหม? หรือควรจะแสดงข้อมูลครบทุกฟิลด์หรือไม่? ด้วยความไม่แน่นอนนี้ Rust จึงไม่พยายามเดาใจเรา และไม่ได้เตรียมการอิมพลีเมนต์ Display เริ่มต้นไว้ให้กับ struct สำหรับใช้งานกับตัวแทนข้อความ {} ใน println!
แต่หากเราอ่านข้อความแจ้งข้อผิดพลาดต่อไป เราจะพบคำแนะนำที่เป็นประโยชน์อย่างยิ่ง:
help: the trait `std::fmt::Display` is not implemented for `Rectangle`
  --> src/main.rs:1:1
เรามาลองทำตามคำแนะนำกัน! โดยเปลี่ยนคำสั่งในมาโครเป็น println!("rect1 is {rect1:?}"); การใส่ตัวระบุ :? ไว้ภายในวงเล็บปีกกาจะบอกให้ println! ทราบว่าเราต้องการใช้รูปแบบการแสดงผลที่เรียกว่า Debug ซึ่งเทรต Debug นี้ถูกออกแบบมาเพื่อให้นักพัฒนาสามารถพิมพ์ข้อมูลของ struct ออกมาตรวจสอบได้อย่างสะดวกในระหว่างการพัฒนาและดีบักโค้ด
ลองคอมไพล์โค้ดหลังจากแก้ไขดู… แต่ก็ยังคงพบข้อผิดพลาดอยู่ดี:
error[E0277]: `Rectangle` doesn't implement `Debug`
ทว่าคอมไพเลอร์ก็ได้ให้คำแนะนำที่เป็นประโยชน์อีกครั้ง:
   |                        required by this formatting parameter
   |
ความจริงแล้ว Rust มี ฟังก์ชันสำหรับพิมพ์ข้อมูลเพื่อการดีบักเตรียมไว้ให้อยู่แล้ว เพียงแต่เราต้องเปิดใช้งานความสามารถนี้ให้กับ struct ของเราอย่างชัดเจน โดยการเพิ่มแอตทริบิวต์ #[derive(Debug)] ไว้เหนือการนิยาม struct ดังแสดงในลิสติ้ง 5-12
#[derive(Debug)]
struct Rectangle {
    width: u32,
    height: u32,
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    println!("rect1 is {rect1:?}");
}
คราวนี้เมื่อเราสั่งรันโปรแกรม จะไม่มีข้อผิดพลาดเกิดขึ้นอีก และเราจะได้ผลลัพธ์ดังนี้:
$ cargo run
   Compiling rectangles v0.1.0 (file:///projects/rectangles)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.48s
     Running `target/debug/rectangles`
rect1 is Rectangle { width: 30, height: 50 }
ยอดเยี่ยมมาก! แม้ว่ารูปแบบที่พิมพ์ออกมาอาจจะไม่ได้สวยงามสะดุดตา แต่ก็แสดงค่าของทุกฟิลด์ในอินสแตนซ์นี้ออกมาให้เห็นอย่างครบถ้วน ซึ่งมีประโยชน์อย่างยิ่งในการดีบัก และเมื่อเราทำงานกับ struct ที่มีขนาดใหญ่ขึ้น การจัดรูปแบบให้อ่านง่ายเป็นระเบียบยิ่งขึ้นก็จะมีประโยชน์มาก ซึ่งในกรณีเช่นนี้ เราสามารถเปลี่ยนมาใช้ {:#?} แทน {:?} ในสตริงของ println! ได้ และผลลัพธ์จะออกมาในรูปแบบที่สวยงามเป็นระเบียบดังนี้:
$ cargo run
   Compiling rectangles v0.1.0 (file:///projects/rectangles)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.48s
     Running `target/debug/rectangles`
rect1 is Rectangle {
    width: 30,
    height: 50,
}
อีกวิธีหนึ่งในการพิมพ์ค่าเพื่อการตรวจสอบผ่านรูปแบบ Debug คือการใช้ มาโคร dbg! ซึ่งต่างจาก println! ที่รับเรเฟอเรนซ์ตรงที่ มาโคร dbg! จะรับความเป็นเจ้าของของนิพจน์นั้นไป พิมพ์ชื่อไฟล์และหมายเลขบรรทัดที่คำสั่ง dbg! ทำงานออกมา พร้อมกับค่าผลลัพธ์ของนิพจน์นั้น แล้วส่งมอบความเป็นเจ้าของของค่านั้นคืนกลับมาให้ใช้งานต่อ
หมายเหตุ: การเรียกใช้มาโคร
dbg!จะพิมพ์ข้อมูลไปยังสตรีมข้อผิดพลาดมาตรฐาน (stderr) ของคอนโซล ซึ่งต่างจากprintln!ที่พิมพ์ไปยังสตรีมเอาต์พุตมาตรฐาน (stdout) เราจะได้เรียนรู้เพิ่มเติมเกี่ยวกับstderrและstdoutใน หัวข้อ “การเปลี่ยนเส้นทางข้อผิดพลาดไปยังข้อผิดพลาดมาตรฐาน” ในบทที่ 12
ตัวอย่างต่อไปนี้แสดงการใช้งาน dbg! กับทั้งนิพจน์ที่กำหนดให้กับฟิลด์ width และกับค่าของ struct ทั้งตัวใน rect1:
#[derive(Debug)]
struct Rectangle {
    width: u32,
    height: u32,
}

fn main() {
    let scale = 2;
    let rect1 = Rectangle {
        width: dbg!(30 * scale),
        height: 50,
    };

    dbg!(&rect1);
}
เราสามารถครอบนิพจน์ 30 * scale ด้วย dbg! ได้โดยตรง และเนื่องจาก dbg! จะคืนความเป็นเจ้าของของค่านั้นกลับมา ฟิลด์ width จึงได้รับค่าที่ถูกต้องเช่นเดียวกับตอนที่ไม่ได้เรียกใช้ dbg! และเนื่องจากเราไม่ต้องการให้ dbg! ยึดความเป็นเจ้าของของ rect1 ไป เราจึงส่งเรเฟอเรนซ์ &rect1 เข้าไปในการเรียกใช้ครั้งถัดไป ผลลัพธ์จากการรันตัวอย่างนี้จะเป็นดังนี้:
$ cargo run
   Compiling rectangles v0.1.0 (file:///projects/rectangles)
    Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.61s
     Running `target/debug/rectangles`
[src/main.rs:10:16] 30 * scale = 60
[src/main.rs:14:5] &rect1 = Rectangle {
    width: 60,
    height: 50,
}
เราจะเห็นว่าเอาต์พุตส่วนแรกมาจากบรรทัดที่ 10 ของไฟล์ src/main.rs ซึ่งเรากำลังตรวจสอบค่านิพจน์ 30 * scale และได้ผลลัพธ์เป็น 60 (เนื่องจากการจัดรูปแบบ Debug ของจำนวนเต็มคือการพิมพ์เฉพาะค่าตัวเลข) และการเรียกใช้ dbg! ในบรรทัดที่ 14 จะพิมพ์ค่าของ &rect1 ซึ่งเป็น struct Rectangle ออกมาในรูปแบบ Debug ที่จัดย่อหน้าอย่างสวยงาม มาโคร dbg! จึงเป็นเครื่องมือที่มีประโยชน์และคล่องตัวอย่างยิ่งเมื่อคุณต้องการตรวจสอบการทำงานภายในโค้ดของคุณ!
นอกจากเทรต Debug แล้ว Rust ยังจัดเตรียมเทรตมาตรฐานอีกเป็นจำนวนมากให้เรานำมาใช้ร่วมกับแอตทริบิวต์ derive เพื่อเพิ่มพฤติกรรมที่มีประโยชน์ให้กับชนิดข้อมูลที่เรากำหนดขึ้นเองได้ โดยรายการเทรตและพฤติกรรมทั้งหมดได้ระบุไว้ใน ภาคผนวก C และเราจะไปเรียนรู้วิธีการอิมพลีเมนต์พฤติกรรมเหล่านี้ด้วยตนเอง ตลอดจนการสร้างเทรตขึ้นมาใหม่ในบทที่ 10 นอกจากนี้ Rust ยังมีแอตทริบิวต์รูปแบบอื่นๆ อีกมากมาย ซึ่งสามารถศึกษาเพิ่มเติมได้จาก หัวข้อ “Attributes” ใน Rust Reference
สำหรับฟังก์ชัน area ของเราในตอนนี้ยังคงมีลักษณะเฉพาะเจาะจงมาก เพราะคำนวณได้เฉพาะพื้นที่ของสี่เหลี่ยมผืนผ้าเท่านั้น จะดีกว่าไหมหากเราสามารถผูกพฤติกรรมการคำนวณนี้เข้าเป็นส่วนหนึ่งของ struct Rectangle ได้โดยตรง เพื่อให้โค้ดมีความเป็นกลุ่มก้อนชัดเจนยิ่งขึ้น ในหัวข้อถัดไปเราจะมาดูวิธีรีแฟกเตอร์ฟังก์ชัน area ให้กลายเป็น เมธอด (method) บนชนิดข้อมูล Rectangle กัน
เมธอด
เมธอด
เมธอด (method) มีความคล้ายคลึงกับฟังก์ชันอย่างมาก: เราประกาศด้วยคีย์เวิร์ด fn ตามด้วยชื่อ สามารถรับพารามิเตอร์ (parameter) และคืนค่า (return value) ได้ รวมถึงมีบล็อกคำสั่งที่ทำงานเมื่อถูกเรียกใช้จากที่อื่น แต่สิ่งที่ต่างจากฟังก์ชันทั่วไปคือ เมธอดจะถูกนิยามขึ้นภายในบริบทของ struct (หรือ enum หรือเทรตออบเจกต์ ซึ่งเราจะกล่าวถึงใน บทที่ 6 และ บทที่ 18 ตามลำดับ) และพารามิเตอร์ตัวแรกของเมธอดจะต้องเป็น self เสมอ ซึ่งทำหน้าที่แทนอินสแตนซ์ของ struct ที่เมธอดนั้นกำลังถูกเรียกใช้งาน
วากยสัมพันธ์ของเมธอด
เรามาลองเปลี่ยนฟังก์ชัน area ที่เดิมรับอินสแตนซ์ Rectangle เป็นพารามิเตอร์ ให้กลายเป็นเมธอด area ที่นิยามอยู่บน struct Rectangle โดยตรง ดังแสดงในลิสติ้ง 5-13
#[derive(Debug)]
struct Rectangle {
    width: u32,
    height: u32,
}

impl Rectangle {
    fn area(&self) -> u32 {
        self.width * self.height
    }
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    println!(
        "The area of the rectangle is {} square pixels.",
        rect1.area()
    );
}
ในการนิยามฟังก์ชันให้อยู่ภายในบริบทของ Rectangle เราจะเริ่มต้นด้วยการสร้างบล็อก impl (ย่อมาจาก implementation) สำหรับ Rectangle โดยทุกสิ่งทุกอย่างที่เขียนอยู่ภายในบล็อก impl นี้จะถูกผูกเข้ากับชนิดข้อมูล Rectangle จากนั้นเราย้ายฟังก์ชัน area เข้าไปไว้ในวงเล็บปีกกาของ impl แล้วเปลี่ยนพารามิเตอร์ตัวแรก (และในกรณีนี้เป็นพารามิเตอร์เพียงตัวเดียว) ให้เป็น self ทั้งในส่วนของลายเซ็นและในเนื้อหาของฟังก์ชัน และในฟังก์ชัน main ที่เดิมเคยเรียกฟังก์ชัน area โดยส่ง rect1 เข้าไปเป็นอาร์กิวเมนต์ เราจะเปลี่ยนมาใช้ ไวยากรณ์การเรียกเมธอด (method syntax) บนอินสแตนซ์ rect1 แทน โดยไวยากรณ์นี้จะเขียนต่อท้ายอินสแตนซ์ คือใส่เครื่องหมายจุด ตามด้วยชื่อเมธอด วงเล็บกลม และอาร์กิวเมนต์ต่างๆ (ถ้ามี)
ในลายเซ็นของเมธอด area เราใช้ &self แทน rectangle: &Rectangle ซึ่งแท้จริงแล้ว &self เป็นรูปย่อของ self: &Self โดยภายในบล็อก impl ชนิดข้อมูล Self จะเป็นชื่อเสมือน (alias) ที่แทนชนิดข้อมูลที่บล็อก impl นั้นสังกัดอยู่ เมธอดจะต้องมีพารามิเตอร์ตัวแรกชื่อ self และเป็นชนิดข้อมูล Self เสมอ Rust จึงอนุญาตให้เราเขียนย่อเหลือเพียงชื่อ self สั้นๆ ในตำแหน่งพารามิเตอร์แรกได้ โปรดสังเกตว่าเรายังคงต้องใส่เครื่องหมาย & ไว้ข้างหน้า self เพื่อระบุว่าเมธอดนี้เป็นการยืมอินสแตนซ์ Self มาใช้งาน เช่นเดียวกับที่เราเคยเขียน rectangle: &Rectangle ทั้งนี้ เมธอดสามารถเลือกที่จะรับความเป็นเจ้าของของ self, ยืม self แบบแก้ไขไม่ได้ (immutable borrow) ดังเช่นในตัวอย่างนี้, หรือยืม self แบบแก้ไขได้ (mutable borrow) ก็ได้เช่นเดียวกับพารามิเตอร์ตัวอื่นๆ
เราเลือกใช้ &self ในตัวอย่างนี้ด้วยเหตุผลเดียวกับตอนที่ใช้ &Rectangle ในแบบฟังก์ชัน นั่นคือเราไม่ต้องการรับความเป็นเจ้าของ และต้องการเพียงแค่อ่านข้อมูลใน struct โดยไม่ได้แก้ไขเปลี่ยนแปลงข้อมูลแต่อย่างใด หากเราต้องการให้เมธอดสามารถแก้ไขข้อมูลในอินสแตนซ์ที่เรียกใช้ได้ เราจะเปลี่ยนพารามิเตอร์แรกเป็น &mut self แทน ส่วนการสร้างเมธอดที่ยึดความเป็นเจ้าของของอินสแตนซ์ไปเลยด้วยการใช้เพียง self โดดๆ นั้นเป็นรูปแบบที่ไม่ค่อยพบบ่อยนัก โดยมักจะใช้เมื่อเมธอดนั้นทำหน้าที่แปลง self ให้กลายเป็นข้อมูลชนิดอื่น และคุณต้องการป้องกันไม่ให้ผู้เรียกสามารถนำอินสแตนซ์เดิมกลับมาใช้งานได้อีกหลังจากการแปลง
ประโยชน์หลักของการใช้เมธอดแทนฟังก์ชัน นอกเหนือจากความสะดวกของไวยากรณ์การเรียกใช้และไม่ต้องระบุชนิดข้อมูลของ self ซ้ำในทุกๆ เมธอดแล้ว ยังเป็นเรื่องของการจัดระเบียบโค้ดที่ดีเยี่ยม เพราะเราได้รวบรวมการกระทำทั้งหมดที่สามารถทำได้กับอินสแตนซ์ของชนิดข้อมูลนั้นๆ มาไว้ในบล็อก impl เดียวกัน ช่วยให้ผู้ที่นำโค้ดของเราไปใช้งานสามารถค้นหาความสามารถทั้งหมดของ Rectangle ได้จากที่เดียวอย่างเป็นระบบ
โปรดสังเกตว่าเราสามารถตั้งชื่อเมธอดให้ซ้ำกับชื่อฟิลด์ของ struct ได้ ตัวอย่างเช่น เราสามารถนิยามเมธอดบน Rectangle ที่ชื่อ width ได้เช่นกัน:
#[derive(Debug)]
struct Rectangle {
    width: u32,
    height: u32,
}

impl Rectangle {
    fn width(&self) -> bool {
        self.width > 0
    }
}

fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };

    if rect1.width() {
        println!("The rectangle has a nonzero width; it is {}", rect1.width);
    }
}
ในตัวอย่างนี้ เรากำหนดให้เมธอด width คืนค่า true หากค่าในฟิลด์ width ของอินสแตนซ์มากกว่า 0 และคืนค่า false หากเป็น 0 ซึ่งเราสามารถนำฟิลด์มาใช้งานภายในเมธอดที่มีชื่อเดียวกันเพื่อจุดประสงค์ใดก็ได้ ในฟังก์ชัน main เมื่อเราใส่วงเล็บต่อท้าย rect1.width() Rust จะทราบทันทีว่าเราหมายถึงเมธอด width แต่หากเราไม่ใส่วงเล็บ rect1.width Rust ก็จะทราบว่าเราหมายถึงฟิลด์ข้อมูล width
บ่อยครั้ง (แม้จะไม่เสมอไป) เมื่อเราตั้งชื่อเมธอดให้ตรงกับชื่อฟิลด์ เรามักต้องการให้เมธอดนั้นทำหน้าที่ส่งคืนค่าของฟิลด์นั้นออกมาเพียงอย่างเดียว ซึ่งเมธอดในลักษณะนี้จะเรียกว่า เก็ตเตอร์ (getter) โดย Rust ไม่ได้สร้างเมธอดเก็ตเตอร์ให้อัตโนมัติเหมือนบางภาษา การใช้เก็ตเตอร์มีประโยชน์ตรงที่คุณสามารถกำหนดให้ฟิลด์ข้อมูลเป็นแบบส่วนตัว (private) แต่เปิดเมธอดให้เป็นแบบสาธารณะ (public) เพื่อให้ภายนอกสามารถอ่านข้อมูลของฟิลด์นั้นได้อย่างเดียว (read-only) ผ่านทาง API สาธารณะของชนิดข้อมูล ซึ่งเราจะไปเรียนรู้เรื่อง public และ private รวมถึงการกำหนดการเข้าถึงฟิลด์และเมธอดใน บทที่ 7
ตัวดำเนินการ
->อยู่ที่ไหน?ในภาษา C และ C++ มีการใช้ตัวดำเนินการ (operator) สองตัวที่แตกต่างกันในการเรียกใช้เมธอด กล่าวคือ คุณจะใช้เครื่องหมายจุด
.หากคุณเรียกเมธอดบนออบเจกต์โดยตรง และจะใช้ลูกศร->หากคุณเรียกเมธอดผ่านพอยน์เตอร์ (pointer) ที่ชี้ไปยังออบเจกต์ ซึ่งจำเป็นต้องดีเรเฟอเรนซ์ (dereference) พอยน์เตอร์นั้นก่อน กล่าวอีกนัยหนึ่ง หากobjectเป็นพอยน์เตอร์ คำสั่งobject->something()จะเทียบเท่ากับ(*object).something()แต่ใน Rust ไม่มีตัวดำเนินการอย่าง
->เพราะ Rust มีฟีเจอร์ที่เรียกว่า การสร้างเรเฟอเรนซ์และดีเรเฟอเรนซ์อัตโนมัติ (automatic referencing and dereferencing) ซึ่งการเรียกใช้เมธอดถือเป็นหนึ่งในไม่กี่จุดใน Rust ที่มีพฤติกรรมอำนวยความสะดวกเช่นนี้กลไกการทำงานคือ: เมื่อคุณเรียกเมธอดด้วยคำสั่ง
object.something()Rust จะเติมเครื่องหมาย&,&mut, หรือ*ให้โดยอัตโนมัติเพื่อให้objectมีชนิดข้อมูลตรงกับลายเซ็นของเมธอดนั้นๆ กล่าวอีกนัยหนึ่ง โค้ดสองบรรทัดต่อไปนี้ทำงานเทียบเท่ากันทุกประการ:#![allow(unused)] fn main() { #[derive(Debug,Copy,Clone)] struct Point { x: f64, y: f64, } impl Point { fn distance(&self, other: &Point) -> f64 { let x_squared = f64::powi(other.x - self.x, 2); let y_squared = f64::powi(other.y - self.y, 2); f64::sqrt(x_squared + y_squared) } } let p1 = Point { x: 0.0, y: 0.0 }; let p2 = Point { x: 5.0, y: 6.5 }; p1.distance(&p2); (&p1).distance(&p2); }จะเห็นได้ว่าแบบแรกอ่านง่ายและสะอาดตากว่ามาก พฤติกรรมการจัดการเรเฟอเรนซ์อัตโนมัตินี้ทำงานได้อย่างราบรื่นเพราะเมธอดมีผู้รับการเรียก (receiver) ที่ชัดเจนเสมอ นั่นคือชนิดข้อมูลของ
selfเมื่อทราบทั้งผู้รับและชื่อของเมธอดแล้ว Rust จึงสามารถระบุได้อย่างแม่นยำว่าเมธอดนั้นต้องการแค่อ่านค่า (&self), ต้องการแก้ไขค่า (&mut self), หรือต้องการรับความเป็นเจ้าของไปเลย (self) การที่ Rust ช่วยจัดการเรื่องการยืมให้อัตโนมัติสำหรับตัวรับของเมธอดเช่นนี้ ถือเป็นหัวใจสำคัญที่ช่วยให้ระบบความเป็นเจ้าของมีความสะดวกสบายในการเขียนโค้ดจริงอย่างมาก
เมธอดที่มีพารามิเตอร์เพิ่มเติม
เรามาฝึกฝนการใช้งานเมธอดเพิ่มเติมด้วยการสร้างเมธอดตัวที่สองบน struct Rectangle กัน คราวนี้เราต้องการให้อินสแตนซ์ของ Rectangle สามารถรับอินสแตนซ์ของ Rectangle อีกตัวเข้ามา และส่งคืนค่า true หาก Rectangle ตัวที่สองนั้นสามารถบรรจุอยู่ภายใน self (ซึ่งเป็น Rectangle ตัวแรก) ได้อย่างสมบูรณ์ และส่งคืนค่า false ในกรณีอื่นๆ นั่นคือ เมื่อเรานิยามเมธอด can_hold แล้ว เราต้องการให้สามารถเขียนโปรแกรมได้ดังที่แสดงในลิสติ้ง 5-14
fn main() {
    let rect1 = Rectangle {
        width: 30,
        height: 50,
    };
    let rect2 = Rectangle {
        width: 10,
        height: 40,
    };
    let rect3 = Rectangle {
        width: 60,
        height: 45,
    };

    println!("Can rect1 hold rect2? {}", rect1.can_hold(&rect2));
    println!("Can rect1 hold rect3? {}", rect1.can_hold(&rect3));
}
ผลลัพธ์ที่คาดหวังควรจะเป็นดังนี้ เพราะขนาดทั้งสองด้านของ rect2 มีขนาดเล็กกว่า rect1 แต่ rect3 มีความกว้างมากกว่า rect1:
Can rect1 hold rect2? true
Can rect1 hold rect3? false
เรารู้แล้วว่าเราต้องการนิยามเมธอด ดังนั้นโค้ดนี้จะต้องอยู่ภายในบล็อก impl Rectangle โดยตั้งชื่อเมธอดว่า can_hold และรับการยืมแบบแก้ไขไม่ได้ของ Rectangle อีกตัวเป็นพารามิเตอร์ เราสามารถทราบชนิดข้อมูลของพารามิเตอร์ได้จากการสังเกตโค้ดที่เรียกใช้: คำสั่ง rect1.can_hold(&rect2) ได้ส่ง &rect2 เข้ามา ซึ่งเป็นการยืมแบบแก้ไขไม่ได้ไปยัง rect2 ที่เป็นอินสแตนซ์ของ Rectangle ซึ่งสมเหตุสมผลอย่างยิ่งเพราะเราต้องการเพียงแค่อ่านค่าใน rect2 เท่านั้น (ไม่ได้ต้องการแก้ไขค่า ซึ่งจะต้องใช้การยืมแบบแก้ไขได้) และเรายังต้องการให้ฟังก์ชัน main คงความเป็นเจ้าของใน rect2 ต่อไป เพื่อให้นำไปใช้งานอื่นต่อได้หลังจากเรียก can_hold แล้ว ค่าที่คืนกลับจาก can_hold จะเป็นชนิดข้อมูลบูลีน และการคำนวณภายในจะตรวจสอบว่าความกว้างและความสูงของ self มีค่ามากกว่าความกว้างและความสูงของ Rectangle อีกตัวตามลำดับหรือไม่ เรามาเพิ่มเมธอด can_hold ลงในบล็อก impl ต่อจากลิสติ้ง 5-13 ดังแสดงในลิสติ้ง 5-15
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn area(&self) -> u32 {
self.width * self.height
}
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}
fn main() {
let rect1 = Rectangle {
width: 30,
height: 50,
};
let rect2 = Rectangle {
width: 10,
height: 40,
};
let rect3 = Rectangle {
width: 60,
height: 45,
};
println!("Can rect1 hold rect2? {}", rect1.can_hold(&rect2));
println!("Can rect1 hold rect3? {}", rect1.can_hold(&rect3));
}เมื่อเราสั่งรันโค้ดนี้ร่วมกับฟังก์ชัน main ในลิสติ้ง 5-14 เราจะได้ผลลัพธ์ตามที่ต้องการอย่างถูกต้อง เมธอดสามารถรับพารามิเตอร์ได้หลายตัว โดยระบุต่อท้ายพารามิเตอร์ self ในลายเซ็นของเมธอด และพารามิเตอร์เหล่านั้นจะทำงานเหมือนกับพารามิเตอร์ของฟังก์ชันทั่วไปทุกประการ
ฟังก์ชันที่เชื่อมโยงกับชนิดข้อมูล
ฟังก์ชันทั้งหมดที่นิยามอยู่ภายในบล็อก impl จะเรียกว่า ฟังก์ชันประจำชนิดข้อมูล หรือ ฟังก์ชันที่เชื่อมโยงกับชนิดข้อมูล (associated function) เนื่องจากพวกมันมีความผูกพันอยู่กับชนิดข้อมูลที่ระบุชื่อไว้หลังคำสั่ง impl เราสามารถนิยามฟังก์ชันประจำชนิดข้อมูลโดยไม่ต้องมี self เป็นพารามิเตอร์แรกได้ (ซึ่งจะไม่ถือว่าเป็นเมธอด) เนื่องจากฟังก์ชันประเภทนี้ไม่จำเป็นต้องอาศัยอินสแตนซ์ของชนิดข้อมูลนั้นในการทำงาน ซึ่งเราเคยใช้งานฟังก์ชันในลักษณะนี้มาแล้ว เช่น ฟังก์ชัน String::from ที่นิยามอยู่บนชนิดข้อมูล String
ฟังก์ชันประจำชนิดข้อมูลที่ไม่ใช่เมธอดมักจะนิยมใช้เป็นคอนสตรัคเตอร์ (constructor) ที่ทำหน้าที่สร้างและส่งคืนอินสแตนซ์ใหม่ของ struct ออกมา โดยส่วนใหญ่มักจะตั้งชื่อฟังก์ชันว่า new แต่คำว่า new ไม่ใช่ชื่อพิเศษหรือคำสงวนของภาษาแต่อย่างใด ตัวอย่างเช่น เราสามารถสร้างฟังก์ชันประจำชนิดข้อมูลชื่อ square ที่รับพารามิเตอร์ขนาดเพียงค่าเดียว แล้วนำค่านั้นไปใช้เป็นทั้งความกว้างและความสูง เพื่อช่วยให้สร้างอินสแตนซ์ของ Rectangle ที่เป็นรูปสี่เหลี่ยมจัตุรัสได้อย่างสะดวก โดยไม่ต้องระบุค่าเดิมซ้ำสองครั้ง:
ชื่อไฟล์: src/main.rs
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn square(size: u32) -> Self {
Self {
width: size,
height: size,
}
}
}
fn main() {
let sq = Rectangle::square(3);
}คำว่า Self ที่ใช้ระบุชนิดข้อมูลที่คืนกลับและในเนื้อหาของฟังก์ชัน เป็นชื่อเสมือนที่แทนชนิดข้อมูลที่ปรากฏหลังคีย์เวิร์ด impl ซึ่งในที่นี้ก็คือ Rectangle
ในการเรียกใช้ฟังก์ชันประจำชนิดข้อมูลนี้ เราจะใช้ไวยากรณ์ :: ร่วมกับชื่อของ struct เช่น let sq = Rectangle::square(3); ฟังก์ชันนี้ถูกจัดไว้ภายใต้เนมสเปซของ struct นั้นๆ โดยไวยากรณ์ :: นี้ใช้ทั้งสำหรับการเรียกฟังก์ชันประจำชนิดข้อมูลและสำหรับการเข้าถึงเนมสเปซที่สร้างขึ้นโดยมอดูล (module) ซึ่งเราจะได้เรียนรู้เรื่องมอดูลใน บทที่ 7
บล็อก impl หลายบล็อก
struct แต่ละตัวสามารถมีบล็อก impl ได้หลายบล็อก ตัวอย่างเช่น ลิสติ้ง 5-15 สามารถเขียนแยกเมธอดออกเป็นคนละบล็อก impl ได้ดังแสดงในลิสติ้ง 5-16 ซึ่งให้ผลลัพธ์เหมือนกันทุกประการ
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn area(&self) -> u32 {
self.width * self.height
}
}
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}
fn main() {
let rect1 = Rectangle {
width: 30,
height: 50,
};
let rect2 = Rectangle {
width: 10,
height: 40,
};
let rect3 = Rectangle {
width: 60,
height: 45,
};
println!("Can rect1 hold rect2? {}", rect1.can_hold(&rect2));
println!("Can rect1 hold rect3? {}", rect1.can_hold(&rect3));
}ในตัวอย่างนี้ไม่มีความจำเป็นใดๆ ที่ต้องแยกเมธอดเหล่านี้ออกเป็นหลายบล็อก แต่ไวยากรณ์นี้ถือว่าถูกต้องสมบูรณ์ และเราจะได้เห็นสถานการณ์ที่การแยกบล็อก impl มีประโยชน์อย่างยิ่งในบทที่ 10 เมื่อเราศึกษาเรื่องชนิดข้อมูลเจเนอริก (generics) และเทรต (traits)
สรุป
struct ช่วยให้คุณสามารถสร้างชนิดข้อมูลกำหนดเองที่มีความหมายเฉพาะเจาะจงสำหรับโดเมนของงานคุณได้ โดยการใช้ struct คุณจะสามารถจัดกลุ่มข้อมูลที่เกี่ยวข้องกันเข้าไว้ด้วยกัน พร้อมทั้งตั้งชื่อให้กับข้อมูลแต่ละส่วนเพื่อช่วยให้โค้ดมีความชัดเจนและสื่อความหมายได้เป็นอย่างดี และในบล็อก impl คุณสามารถนิยามฟังก์ชันประจำชนิดข้อมูลขึ้นมาได้ โดยเมธอดก็คือฟังก์ชันประจำชนิดข้อมูลประเภทหนึ่งที่ช่วยให้คุณสามารถกำหนดพฤติกรรมการทำงานให้กับอินสแตนซ์ของ struct ได้โดยตรง
อย่างไรก็ตาม struct ไม่ใช่วิธีเดียวในการสร้างชนิดข้อมูลกำหนดเอง ในบทถัดไปเราจะไปศึกษาฟีเจอร์ enum ของ Rust เพื่อเพิ่มเครื่องมืออันทรงพลังอีกชิ้นหนึ่งให้กับคลังเครื่องมือของคุณ
enum และการจับคู่แพตเทิร์น
ในบทนี้ เราจะมาเรียนรู้เรื่องการแจงนับ (enumeration) หรือที่นิยมเรียกสั้นๆ ว่า enum โดย enum ช่วยให้คุณสามารถนิยามชนิดข้อมูลขึ้นมาได้ด้วยการแจกแจงค่าหรือรูปแบบที่เป็นไปได้ทั้งหมด ซึ่งเราเรียกว่า วาเรียนต์ (variant) ในตอนแรก เราจะมาดูวิธีนิยามและใช้งาน enum เพื่อทำความเข้าใจว่า enum สามารถสื่อความหมายควบคู่ไปกับการจัดเก็บข้อมูลได้อย่างไร จากนั้น เราจะไปสำรวจ enum ตัวสำคัญที่มีประโยชน์อย่างยิ่งตัวหนึ่ง นั่นก็คือ Option ซึ่งใช้แทนค่าที่อาจจะมีอยู่หรือไม่มีค่าใดๆ เลยก็ได้ ถัดมา เราจะไปดูว่าการจับคู่แพตเทิร์น (pattern matching) ด้วยนิพจน์ match ช่วยให้การเขียนโค้ดแยกการทำงานตามแต่ละวาเรียนต์ของ enum เป็นเรื่องง่ายและรัดกุมได้อย่างไร และสุดท้าย เราจะปิดท้ายด้วยโครงสร้าง if let ซึ่งเป็นอีกหนึ่งสำนวนภาษาที่สะดวกและกระชับสำหรับการจัดการกับค่า enum ในโค้ดของคุณ
การนิยาม enum
การนิยาม enum
ในขณะที่ struct เป็นเครื่องมือสำหรับจัดกลุ่มฟิลด์และข้อมูลที่เกี่ยวข้องกันเข้าไว้ด้วยกัน เช่น Rectangle ที่มี width และ height แต่ enum กลับเป็นเครื่องมือที่ใช้สำหรับบ่งบอกว่า ค่าหนึ่งๆ นั้นเป็นหนึ่งในกลุ่มของค่าที่เป็นไปได้ ตัวอย่างเช่น เราอาจต้องการระบุว่า Rectangle เป็นหนึ่งในรูปทรงเรขาคณิตที่เป็นไปได้ ซึ่งประกอบด้วย Circle และ Triangle ด้วย เป็นต้น และเพื่อรองรับการทำงานในลักษณะนี้ Rust จึงอนุญาตให้เราเขียนแทนความเป็นไปได้เหล่านี้ด้วย enum
ลองมาดูสถานการณ์ตัวอย่างจริงในโค้ด เพื่อทำความเข้าใจว่าทำไม enum จึงมีประโยชน์และเหมาะสมกว่า struct ในบางกรณี สมมติว่าเราต้องเขียนโปรแกรมจัดการกับที่อยู่ไอพี (IP address) ซึ่งในปัจจุบันมีมาตรฐานหลักอยู่ 2 แบบ คือ IPv4 และ IPv6 และเนื่องจากความเป็นไปได้ของที่อยู่ไอพีที่โปรแกรมของเราจะต้องพบเจอมีเพียง 2 แบบนี้เท่านั้น เราจึงสามารถ แจกแจง (enumerate) วาเรียนต์ (variant) ที่เป็นไปได้ทั้งหมดออกมาได้ ซึ่งนี่คือที่มาของคำว่า enumeration หรือ enum นั่นเอง
ที่อยู่ไอพีใดๆ ย่อมสามารถเป็นได้เพียง IPv4 หรือ IPv6 อย่างใดอย่างหนึ่งเท่านั้น แต่ไม่สามารถเป็นทั้งสองอย่างพร้อมกันได้ในเวลาเดียวกัน คุณลักษณะนี้ตรงกับธรรมชาติของโครงสร้างข้อมูลแบบ enum อย่างสมบูรณ์แบบ เพราะค่าของ enum หนึ่งๆ จะสามารถเป็นได้เพียงหนึ่งในวาเรียนต์ของมันเท่านั้นในขณะใดขณะหนึ่ง อย่างไรก็ตาม ทั้งที่อยู่ IPv4 และ IPv6 ต่างก็ยังคงถือเป็นที่อยู่ไอพีเหมือนกันในระดับพื้นฐาน ดังนั้นพวกมันจึงควรถูกปฏิบัติเหมือนเป็นชนิดข้อมูลเดียวกันเมื่อโค้ดกำลังทำงานในส่วนที่ใช้ได้กับที่อยู่ไอพีทุกประเภท
เราสามารถเขียนแทนแนวคิดนี้ในโค้ดได้โดยการนิยาม enum ชื่อ IpAddrKind แล้วระบุชนิดของที่อยู่ไอพีที่เป็นไปได้ นั่นคือ V4 และ V6 ซึ่งสิ่งเหล่านี้เรียกว่าเป็น วาเรียนต์ (variant) ของ enum:
enum IpAddrKind {
V4,
V6,
}
fn main() {
let four = IpAddrKind::V4;
let six = IpAddrKind::V6;
route(IpAddrKind::V4);
route(IpAddrKind::V6);
}
fn route(ip_kind: IpAddrKind) {}ในตอนนี้ IpAddrKind ได้กลายเป็นชนิดข้อมูลกำหนดเองที่เราสามารถนำไปใช้งานในส่วนอื่นๆ ของโค้ดได้แล้ว
ค่าของ enum
เราสามารถสร้างอินสแตนซ์ของแต่ละวาเรียนต์ใน IpAddrKind ได้ดังนี้:
enum IpAddrKind {
V4,
V6,
}
fn main() {
let four = IpAddrKind::V4;
let six = IpAddrKind::V6;
route(IpAddrKind::V4);
route(IpAddrKind::V6);
}
fn route(ip_kind: IpAddrKind) {}โปรดสังเกตว่าวาเรียนต์ของ enum จะถูกจัดอยู่ภายใต้เนมสเปซของชื่อ enum นั้นๆ โดยใช้เครื่องหมายโคลอนคู่ :: คั่นกลาง ซึ่งมีประโยชน์มากเพราะทำให้ทั้ง IpAddrKind::V4 และ IpAddrKind::V6 ต่างก็มีชนิดข้อมูลเดียวกันคือ IpAddrKind จากนั้น เราสามารถเขียนนิยามฟังก์ชันที่รับพารามิเตอร์เป็นชนิด IpAddrKind ใดๆ ก็ได้ ตัวอย่างเช่น:
enum IpAddrKind {
V4,
V6,
}
fn main() {
let four = IpAddrKind::V4;
let six = IpAddrKind::V6;
route(IpAddrKind::V4);
route(IpAddrKind::V6);
}
fn route(ip_kind: IpAddrKind) {}และเราสามารถเรียกใช้ฟังก์ชันนี้ได้ด้วยวาเรียนต์ใดก็ได้:
enum IpAddrKind {
V4,
V6,
}
fn main() {
let four = IpAddrKind::V4;
let six = IpAddrKind::V6;
route(IpAddrKind::V4);
route(IpAddrKind::V6);
}
fn route(ip_kind: IpAddrKind) {}การใช้ enum ยังมีข้อได้เปรียบมากกว่านั้นอีก เมื่อเราคิดต่อยอดเรื่องการเก็บข้อมูลที่อยู่ไอพี ในตอนนี้เรายังไม่ได้จัดเก็บ ข้อมูล ของที่อยู่ไอพีจริงๆ เลย เราเพียงแต่รู้ว่ามันเป็นไอพี ชนิด ใด และเนื่องจากคุณเพิ่งเรียนรู้เรื่อง struct มาในบทที่ 5 คุณจึงอาจอยากนำ struct มาแก้ปัญหานี้ ดังแสดงในลิสติ้ง 6-1
fn main() {
enum IpAddrKind {
V4,
V6,
}
struct IpAddr {
kind: IpAddrKind,
address: String,
}
let home = IpAddr {
kind: IpAddrKind::V4,
address: String::from("127.0.0.1"),
};
let loopback = IpAddr {
kind: IpAddrKind::V6,
address: String::from("::1"),
};
}ในตัวอย่างนี้ เราได้นิยาม struct IpAddr ที่มี 2 ฟิลด์ ได้แก่ ฟิลด์ kind ซึ่งมีชนิดข้อมูลเป็น IpAddrKind (enum ที่เรานิยามไว้ก่อนหน้า) และฟิลด์ address ซึ่งมีชนิดข้อมูลเป็น String และเราได้สร้างอินสแตนซ์ขึ้นมา 2 ตัว ตัวแรกคือ home ซึ่งมี kind เป็น IpAddrKind::V4 และมีข้อมูลที่อยู่คือ 127.0.0.1 ส่วนตัวที่สองคือ loopback ซึ่งมี kind เป็น IpAddrKind::V6 และมีข้อมูลที่อยู่คือ ::1 เราใช้ struct เพื่อรวมค่า kind และ address เข้าไว้ด้วยกัน ทำให้ตอนนี้แต่ละวาเรียนต์มีข้อมูลที่อยู่ผูกติดอยู่ด้วยแล้ว
อย่างไรก็ดี เราสามารถเขียนแทนแนวคิดเดียวกันนี้ด้วย enum เพียงอย่างเดียวได้อย่างกระชับและสง่างามกว่ามาก แทนที่จะต้องนำ enum ไปซ้อนอยู่ใน struct เราสามารถแนบข้อมูลเข้าไปในแต่ละวาเรียนต์ของ enum ได้โดยตรง นิยามใหม่ของ enum IpAddr ต่อไปนี้ระบุว่า ทั้งวาเรียนต์ V4 และ V6 จะมีค่า String ผูกติดอยู่ด้วย:
fn main() {
enum IpAddr {
V4(String),
V6(String),
}
let home = IpAddr::V4(String::from("127.0.0.1"));
let loopback = IpAddr::V6(String::from("::1"));
}เราแนบข้อมูลเข้ากับแต่ละวาเรียนต์ของ enum ได้โดยตรง จึงไม่จำเป็นต้องสร้าง struct เพิ่มเติมอีกเลย นอกจากนี้ยังช่วยให้เห็นรายละเอียดการทำงานของ enum ชัดเจนขึ้นด้วย นั่นคือ ชื่อของแต่ละวาเรียนต์ใน enum จะกลายเป็นฟังก์ชันคอนสตรัคเตอร์สำหรับสร้างอินสแตนซ์ของ enum นั้นโดยอัตโนมัติ กล่าวคือ IpAddr::V4() จะทำหน้าที่เป็นฟังก์ชันที่รับอาร์กิวเมนต์ชนิด String แล้วส่งคืนอินสแตนซ์ของชนิด IpAddr ออกมา ซึ่งฟังก์ชันคอนสตรัคเตอร์นี้จะถูกสร้างขึ้นให้อัตโนมัติทันทีที่เรานิยาม enum
การใช้ enum ยังมีข้อได้เปรียบเหนือกว่า struct อีกประการหนึ่งคือ: แต่ละวาเรียนต์สามารถมีชนิดข้อมูลและจำนวนข้อมูลที่ผูกติดอยู่แตกต่างกันได้อย่างอิสระ สำหรับที่อยู่ IPv4 จะประกอบด้วยตัวเลข 4 ส่วนที่มีค่าระหว่าง 0 ถึง 255 เสมอ หากเราต้องการจัดเก็บที่อยู่ V4 เป็นตัวเลข u8 จำนวน 4 ค่า แต่ยังคงต้องการจัดเก็บที่อยู่ V6 เป็นสตริง String เพียงค่าเดียว เราจะไม่สามารถทำได้สะดวกด้วย struct แต่สำหรับ enum แล้ว สามารถจัดการกรณีนี้ได้อย่างง่ายดาย:
fn main() {
enum IpAddr {
V4(u8, u8, u8, u8),
V6(String),
}
let home = IpAddr::V4(127, 0, 0, 1);
let loopback = IpAddr::V6(String::from("::1"));
}เราได้เห็นวิธีต่างๆ ในการจัดโครงสร้างข้อมูลเพื่อจัดเก็บที่อยู่ไอพีทั้งแบบ IPv4 และ IPv6 กันไปแล้ว อย่างไรก็ดี ความต้องการในการจัดเก็บที่อยู่ไอพีพร้อมระบุเวอร์ชันนั้นเป็นเรื่องที่พบได้บ่อยมากในทางปฏิบัติ จนกระทั่ง ไลบรารีมาตรฐานมีนิยามของ IpAddr เตรียมไว้ให้เราใช้งานได้ทันที! ลองมาดูกันว่าในไลบรารีมาตรฐานนิยาม IpAddr ไว้อย่างไร ซึ่งโครงสร้างมีลักษณะเหมือนกับที่เราเขียนไว้ทุกประการ เพียงแต่ข้อมูลของที่อยู่ถูกฝังไว้ในรูปของ struct 2 ตัวที่แยกกันสำหรับแต่ละวาเรียนต์:
#![allow(unused)]
fn main() {
struct Ipv4Addr {
// --snip--
}
struct Ipv6Addr {
// --snip--
}
enum IpAddr {
V4(Ipv4Addr),
V6(Ipv6Addr),
}
}โค้ดนี้แสดงให้เห็นว่าคุณสามารถใส่ข้อมูลชนิดใดก็ได้ไว้ในวาเรียนต์ของ enum ไม่ว่าจะเป็นสตริง, ตัวเลข, struct หรือแม้กระทั่งใส่ enum อีกตัวซ้อนเข้าไปข้างในก็ทำได้เช่นกัน! และชนิดข้อมูลต่างๆ ในไลบรารีมาตรฐานก็มักจะไม่ได้ซับซ้อนไปกว่าสิ่งที่คุณสามารถออกแบบขึ้นมาเองได้เลย
โปรดสังเกตว่าแม้ไลบรารีมาตรฐานจะมีนิยามของ IpAddr อยู่แล้ว เราก็ยังคงสามารถสร้างและใช้งานนิยาม IpAddr ของเราเองได้โดยไม่เกิดข้อขัดแย้งใดๆ เนื่องจากเรายังไม่ได้นำ (import) นิยามของไลบรารีมาตรฐานเข้ามาในขอบเขต (scope) ของโปรแกรม ซึ่งเราจะพูดถึงการนำชนิดข้อมูลเข้าสู่ขอบเขตการใช้งานอย่างละเอียดในบทที่ 7
ลองมาดูอีกตัวอย่างหนึ่งของ enum ในลิสติ้ง 6-2 ซึ่งแต่ละวาเรียนต์จะจัดเก็บข้อมูลที่มีความหลากหลายของชนิดข้อมูลไว้:
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(i32, i32, i32),
}
fn main() {}enum นี้มี 4 วาเรียนต์ที่มีรูปแบบข้อมูลแตกต่างกัน:
Quit: ไม่มีข้อมูลใดๆ แนบมาด้วยเลยMove: มีฟิลด์ข้อมูลที่มีชื่อกำกับเหมือนกับใน structWrite: แนบข้อมูลชนิดStringมาหนึ่งค่าChangeColor: แนบข้อมูลตัวเลขชนิดi32มาสามค่า
การนิยาม enum ที่มีวาเรียนต์หลากหลายแบบเช่นในลิสติ้ง 6-2 คล้ายกับการนิยาม struct หลายๆ ตัวแยกกัน เพียงแต่ enum ไม่ต้องใช้คีย์เวิร์ด struct ซ้ำๆ และวาเรียนต์ทั้งหมดจะถูกจัดกลุ่มรวมกันอยู่ภายใต้ชนิดข้อมูลเดียวกันคือ Message หากเราลองเขียนข้อมูลเหล่านี้ด้วย struct แยกกัน จะมีหน้าตาดังนี้:
struct QuitMessage; // unit struct
struct MoveMessage {
x: i32,
y: i32,
}
struct WriteMessage(String); // tuple struct
struct ChangeColorMessage(i32, i32, i32); // tuple struct
fn main() {}แต่หากเราใช้ struct แยกกันแบบนี้ ซึ่งแต่ละตัวเป็นคนละชนิดข้อมูลกัน เราจะไม่สามารถเขียนฟังก์ชันที่พร้อมรับข้อความชนิดใดก็ได้เหล่านี้ได้อย่างสะดวกและง่ายดายเหมือนกับการใช้ enum Message ในลิสติ้ง 6-2 ซึ่งรวมทุกรูปแบบไว้เป็นชนิดข้อมูลเดียวกัน
นอกจากนี้ ยังมีความคล้ายคลึงกันอีกประการหนึ่งระหว่าง enum กับ struct คือ เช่นเดียวกับที่เราสามารถนิยามเมธอดให้กับ struct ผ่านบล็อก impl ได้ เราก็สามารถนิยามเมธอดให้กับ enum ได้ในลักษณะเดียวกัน นี่คือตัวอย่างการนิยามเมธอดชื่อ call บน enum Message:
fn main() {
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(i32, i32, i32),
}
impl Message {
fn call(&self) {
// method body would be defined here
}
}
let m = Message::Write(String::from("hello"));
m.call();
}ภายในเนื้อหาของเมธอด เราจะใช้ self เพื่อเข้าถึงค่าของอินสแตนซ์ที่เรียกใช้เมธอดนั้น ในตัวอย่างนี้ เราได้สร้างตัวแปร m ที่มีค่าเป็น Message::Write(String::from("hello")) ซึ่งค่านี้ก็คือสิ่งที่ตัวแปร self จะได้รับภายในเมธอด call เมื่อคำสั่ง m.call() ทำงาน
คราวนี้เราลองมาดู enum อีกตัวหนึ่งในไลบรารีมาตรฐานที่มีการใช้งานบ่อยมากและทรงพลังอย่างยิ่ง นั่นคือ Option
enum Option
ในหัวข้อนี้ เราจะมาศึกษากรณีตัวอย่างของ Option ซึ่งเป็น enum อีกตัวหนึ่งที่ไลบรารีมาตรฐานของ Rust จัดเตรียมไว้ให้ โดยชนิดข้อมูล Option ถูกสร้างขึ้นมาเพื่อรองรับสถานการณ์ที่พบบ่อยมากในการเขียนโปรแกรม นั่นคือ ค่าข้อมูลที่อาจจะมีอยู่จริง หรืออาจไม่มีค่าใดๆ เลยก็ได้
ตัวอย่างเช่น หากคุณร้องขอสมาชิกตัวแรกจากรายการ (list) ที่มีข้อมูลอยู่ คุณย่อมได้ค่านั้นกลับมา แต่หากคุณร้องขอสมาชิกตัวแรกจากรายการที่ว่างเปล่า คุณย่อมไม่ได้ค่าใดๆ กลับมาเลย การนำแนวคิดนี้มาผนวกเข้าไว้ในระบบชนิดข้อมูลช่วยให้คอมไพเลอร์สามารถตรวจสอบได้ว่า คุณได้เขียนโค้ดรองรับทุกกรณีที่อาจเกิดขึ้นแล้วหรือยัง ซึ่งกลไกนี้สามารถป้องกันบั๊กที่พบบ่อยและสร้างความปวดหัวในภาษาโปรแกรมอื่นๆ ได้อย่างมหาศาล
ในการออกแบบภาษาโปรแกรม สิ่งที่ถูกใส่เข้ามามีความสำคัญฉันใด สิ่งที่ถูกตัดออกไปก็มีความสำคัญไม่ยิ่งหย่อนไปกว่ากัน โดยในภาษา Rust ไม่มีแนวคิดเรื่อง null เหมือนอย่างที่ภาษาโปรแกรมส่วนใหญ่มี Null คือค่าพิเศษที่บ่งบอกว่าไม่มีค่าอยู่ตรงนั้น ซึ่งในภาษาที่มี null ตัวแปรจะสามารถตกอยู่ในสถานะใดสถานะหนึ่งจากสองสถานะนี้เสมอ คือ เป็น null หรือ ไม่เป็น null
ในการนำเสนอเมื่อปี 2009 ในหัวข้อ “Null References: The Billion Dollar Mistake” Tony Hoare ผู้คิดค้นแนวคิดเรื่อง null ได้กล่าวไว้ว่า:
ผมเรียกมันว่าความผิดพลาดมูลค่าพันล้านดอลลาร์ของผม ในตอนนั้น ผมกำลังออกแบบระบบชนิดข้อมูลที่ครอบคลุมสำหรับเรเฟอเรนซ์เป็นครั้งแรกในภาษาเชิงวัตถุ เป้าหมายของผมคือต้องการให้การใช้งานเรเฟอเรนซ์ทุกจุดมีความปลอดภัยอย่างสมบูรณ์ โดยมีการตรวจสอบอย่างอัตโนมัติจากคอมไพเลอร์ แต่ผมกลับต้านทานความเย้ายวนใจที่จะใส่เรเฟอเรนซ์แบบ null เข้าไปไม่ไหว เพียงเพราะว่ามันเขียนอิมพลีเมนต์ได้ง่ายมาก และนั่นก็นำไปสู่ข้อผิดพลาด ช่องโหว่ความปลอดภัย และระบบล่มนับครั้งไม่ถ้วน ซึ่งน่าจะสร้างความสูญเสียและความเสียหายคิดเป็นมูลค่ารวมไม่น้อยกว่าหนึ่งพันล้านดอลลาร์ตลอดช่วงสี่สิบปีที่ผ่านมา
ปัญหาสำคัญของค่า null คือ หากคุณพยายามนำค่าที่เป็น null ไปใช้งานเสมือนว่ามันมีค่าอยู่จริง โปรแกรมจะเกิดข้อผิดพลาดรุนแรงขึ้นทันที และเนื่องจากคุณสมบัติของการเป็น null หรือไม่เป็น null นี้สามารถแฝงตัวอยู่ได้ในทุกๆ ตัวแปร จึงทำให้เกิดข้อผิดพลาดในลักษณะนี้ได้ง่ายดายมาก
อย่างไรก็ตาม แนวคิดเบื้องหลังที่ null พยายามจะสื่อนั้นยังมีประโยชน์อยู่ นั่นคือ ความต้องการจะสื่อว่าขณะนี้ยังไม่มีค่าที่ถูกต้อง หรือยังไม่มีข้อมูลอยู่ ณ เวลานั้น
ปัญหาจึงไม่ได้อยู่ที่ตัวแนวคิด แต่อยู่ที่วิธีการอิมพลีเมนต์ที่ผิดพลาด ด้วยเหตุนี้ Rust จึงไม่มีค่า null แต่หันมาใช้ enum ในการเข้ารหัสแนวคิดของค่าที่มีอยู่หรือไม่มีอยู่แทน ซึ่ง enum ตัวนี้ก็คือ Option<T> โดย ไลบรารีมาตรฐานได้นิยามไว้ ดังนี้:
#![allow(unused)]
fn main() {
enum Option<T> {
None,
Some(T),
}
}enum Option<T> มีประโยชน์และใช้งานบ่อยมากจนกระทั่งถูกรวมไว้ในพรีลูด (prelude) ของภาษา ทำให้คุณสามารถเรียกใช้งานได้ทันทีโดยไม่ต้องนำเข้าสโคปด้วยตนเอง และวาเรียนต์ของมันก็ถูกรวมไว้ในพรีลูดเช่นกัน คุณจึงสามารถเขียน Some และ None ได้โดยตรงโดยไม่ต้องมีคำนำหน้า Option:: ทั้งนี้ Option<T> ก็ยังคงเป็น enum ธรรมดาตัวหนึ่ง และ Some(T) กับ None ก็ยังคงเป็นวาเรียนต์ของชนิดข้อมูล Option<T>
ไวยากรณ์ <T> เป็นฟีเจอร์ของ Rust ที่เรายังไม่ได้พูดถึงในรายละเอียด มันคือพารามิเตอร์ชนิดข้อมูลแบบเจเนอริก (generic type parameter) ซึ่งเราจะได้เรียนรู้เรื่องเจเนอริกอย่างเจาะลึกในบทที่ 10 สำหรับตอนนี้ สิ่งที่คุณต้องเข้าใจคือ <T> หมายความว่า วาเรียนต์ Some ของ enum Option สามารถจัดเก็บข้อมูลชนิดใดก็ได้หนึ่งชิ้น และเมื่อนำชนิดข้อมูลจริงมาแทนที่ T ก็จะทำให้ Option<T> กลายเป็นชนิดข้อมูลที่มีความเฉพาะเจาะจงแตกต่างกันไป ตัวอย่างการนำ Option ไปจัดเก็บตัวเลขและอักขระมีดังนี้:
fn main() {
let some_number = Some(5);
let some_char = Some('e');
let absent_number: Option<i32> = None;
}ชนิดข้อมูลของ some_number คือ Option<i32> ส่วนของ some_char คือ Option<char> ซึ่งทั้งสองเป็นคนละชนิดข้อมูลกัน Rust สามารถอนุมานชนิดข้อมูลเหล่านี้ได้จากค่าที่เราใส่ไว้ในวาเรียนต์ Some ส่วนในกรณีของ absent_number เราจำเป็นต้องระบุชนิดข้อมูลของ Option ให้ Rust ทราบอย่างชัดเจน เนื่องจากคอมไพเลอร์ไม่สามารถอนุมานได้ว่าวาเรียนต์ Some ที่คู่กันควรจะเก็บชนิดข้อมูลใดหากมองเห็นเพียงแค่ค่า None ดังนั้นเราจึงบอก Rust ให้ชัดเจนว่า absent_number มีชนิดข้อมูลเป็น Option<i32>
เมื่อเรามีค่า Some เราจะมั่นใจได้ว่ามีข้อมูลอยู่จริง และข้อมูลนั้นบรรจุอยู่ภายใน Some และเมื่อเราได้ค่า None มันจะมีความหมายเทียบเท่ากับ null นั่นคือไม่มีข้อมูลที่ถูกต้องอยู่ แล้วทำไมการใช้ Option<T> จึงปลอดภัยและดีกว่าการใช้ null ล่ะ?
คำตอบสั้นๆ ก็คือ เนื่องจาก Option<T> และ T (โดยที่ T คือชนิดข้อมูลใดๆ) เป็นคนละชนิดข้อมูลกันโดยสิ้นเชิง คอมไพเลอร์จึงจะไม่อนุญาตให้เรานำค่าของ Option<T> ไปใช้งานเสมือนเป็นค่า T ที่ถูกต้องโดยตรงได้เลย ตัวอย่างเช่น โค้ดต่อไปนี้จะไม่สามารถคอมไพล์ผ่านได้ เพราะพยายามนำตัวเลข i8 ไปบวกเข้ากับ Option<i8>:
fn main() {
let x: i8 = 5;
let y: Option<i8> = Some(5);
let sum = x + y;
}เมื่อสั่งรันโค้ดนี้ จะพบกับข้อความแจ้งเตือนข้อผิดพลาดดังนี้:
$ cargo run
Compiling enums v0.1.0 (file:///projects/enums)
error[E0277]: cannot add `Option<i8>` to `i8`
--> src/main.rs:5:17
|
5 | let sum = x + y;
| ^ no implementation for `i8 + Option<i8>`
|
= help: the trait `Add<Option<i8>>` is not implemented for `i8`
help: the following other types implement trait `Add<Rhs>`
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/ops/arith.rs:98:8
|
= note: `i8` implements `Add`
::: /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/ops/arith.rs:113:0
|
= note: in this macro invocation
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/internal_macros.rs:22:8
|
= note: `&i8` implements `Add<i8>`
::: /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/internal_macros.rs:33:8
|
= note: `i8` implements `Add<&i8>`
::: /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/internal_macros.rs:44:8
|
= note: `&i8` implements `Add`
= note: this error originates in the macro `add_impl` (in Nightly builds, run with -Z macro-backtrace for more info)
For more information about this error, try `rustc --explain E0277`.
error: could not compile `enums` (bin "enums") due to 1 previous error
ชัดเจนและรัดกุมมาก! ใจความของข้อผิดพลาดนี้คือ Rust ไม่สามารถนำ i8 มาบวกกับ Option<i8> ได้ เพราะทั้งสองเป็นคนละชนิดข้อมูลกัน เมื่อเรามีค่าที่เป็นชนิด i8 ปกติใน Rust คอมไพเลอร์จะรับประกันเสมอว่าค่านั้นมีตัวตนอยู่จริงและถูกต้องแน่นอน เราจึงสามารถเขียนโค้ดนำค่านั้นไปคำนวณต่อได้อย่างมั่นใจ 100% โดยไม่ต้องคอยตรวจสอบเงื่อนไขว่าเป็น null หรือไม่ก่อนใช้งาน แต่หากตัวแปรนั้นเป็นชนิด Option<i8> (หรือชนิดข้อมูลใดๆ ที่อยู่ใน Option) นั่นคือจุดเดียวที่เราจะต้องตระหนักว่าค่านั้นอาจจะไม่มีอยู่จริง และคอมไพเลอร์จะบังคับให้เราต้องเขียนโค้ดจัดการกรณีที่ไม่มีค่านั้นก่อนเสมอ จึงจะสามารถดึงค่านั้นออกมาใช้งานได้
กล่าวอีกนัยหนึ่ง คุณจำเป็นต้องแปลง Option<T> ให้กลายเป็น T เสียก่อน จึงจะสามารถดำเนินการต่างๆ ในแบบของ T กับมันได้ ซึ่งกลไกนี้ช่วยกำจัดปัญหาคลาสสิกของ null ไปได้อย่างสิ้นเชิง นั่นคือปัญหาของการเผลอทึกทักเอาเองว่าตัวแปรมีค่าอยู่จริง ทั้งที่ในความจริงแล้วมันเป็น null
การตัดความเสี่ยงจากการทึกทักเอาเองว่าตัวแปรไม่ใช่ null ช่วยให้คุณมั่นใจในความปลอดภัยของโค้ดได้อย่างเต็มที่ หากคุณต้องการให้ตัวแปรใดมีโอกาสที่จะไม่มีค่าได้ คุณจะต้องประกาศชนิดข้อมูลให้เป็น Option<T> อย่างชัดเจนเสมอ และเมื่อต้องการนำค่านั้นไปใช้ คุณก็จะต้องเขียนโค้ดรองรับกรณีที่มันไม่มีค่าไว้อย่างชัดเจนด้วยเช่นกัน ในทางกลับกัน ทุกๆ ที่ในโค้ดที่ตัวแปรไม่ได้เป็น Option<T> คุณจะสามารถมั่นใจได้อย่างปลอดภัยเสมอว่าค่านั้นไม่มีทางเป็น null อย่างแน่นอน นี่คือการตัดสินใจออกแบบอย่างตั้งใจของภาษา Rust เพื่อควบคุมและจำกัดการแพร่กระจายของปัญหา null พร้อมทั้งยกระดับความปลอดภัยของโค้ดขึ้นสู่ระดับสูงสุด
แล้วเราจะดึงค่า T ออกมาจากวาเรียนต์ Some เพื่อนำไปใช้งานได้อย่างไรเมื่อมีตัวแปรชนิด Option<T>? ใน enum Option<T> มีเมธอดที่พร้อมใช้งานและมีประโยชน์อย่างมากในหลากหลายสถานการณ์ ซึ่งคุณสามารถศึกษาได้จาก เอกสารของ Option การทำความคุ้นเคยกับเมธอดต่างๆ ของ Option<T> จะเป็นประโยชน์อย่างยิ่งตลอดเส้นทางการเขียนโปรแกรมด้วยภาษา Rust ของคุณ
โดยทั่วไปแล้ว ในการใช้งานค่าของ Option<T> คุณจะต้องมีโค้ดที่คอยจัดการกับแต่ละวาเรียนต์ โดยจะมีโค้ดส่วนหนึ่งที่ทำงานเฉพาะเมื่อมีค่า Some(T) และโค้ดส่วนนี้จะได้รับอนุญาตให้เข้าถึงและใช้งานค่า T ที่อยู่ภายในได้ และมีโค้ดอีกส่วนหนึ่งที่จะทำงานเมื่อเป็นค่า None ซึ่งจะไม่มีค่า T ให้ใช้งาน นิพจน์ match คือโครงสร้างควบคุมลำดับการทำงาน (control flow) ที่ถูกออกแบบมาเพื่อจัดการเรื่องนี้กับ enum ได้อย่างสมบูรณ์แบบ โดยมันจะแยกการทำงานของโค้ดตามแต่ละวาเรียนต์ของ enum และเปิดให้โค้ดในแต่ละกิ่งสามารถดึงข้อมูลที่แนบมากับค่านั้นไปใช้งานได้อย่างปลอดภัย
โครงสร้างควบคุมโฟลว์ match
โครงสร้างควบคุมโฟลว์ match
Rust มีโครงสร้างควบคุมการทำงาน (control flow construct) ที่ทรงพลังอย่างยิ่งชื่อ match ซึ่งช่วยให้เราสามารถนำค่าหนึ่งค่าไปเปรียบเทียบกับชุดของรูปแบบหรือแพตเทิร์น (patterns) ต่างๆ แล้วสั่งให้โค้ดทำงานตามแพตเทิร์นที่จับคู่ได้ถูกต้อง ตัวแพตเทิร์นนั้นสามารถประกอบขึ้นจากค่าลิเทอรัล (literal values), ชื่อตัวแปร, ไวลด์การ์ด (wildcards) และสิ่งอื่นๆ อีกมากมาย โดยใน บทที่ 19 จะอธิบายเรื่องแพตเทิร์นชนิดต่างๆ ทั้งหมดอย่างละเอียด พลังที่แท้จริงของ match นั้นมาจากความยืดหยุ่นในการสื่อความหมายของแพตเทิร์น ร่วมกับการที่คอมไพเลอร์ช่วยตรวจสอบให้มั่นใจว่าเราได้จัดการกรณีที่เป็นไปได้ทั้งหมดอย่างครบถ้วนแล้ว
ลองจินตนาการว่านิพจน์ match นั้นเหมือนกับเครื่องคัดแยกเหรียญ โดยเหรียญจะไหลไปตามรางที่มีรูขนาดต่างๆ เจาะไว้ และเหรียญแต่ละเหรียญจะตกลงไปในรูแรกที่มีขนาดพอดีกับมัน ในทำนองเดียวกัน ข้อมูลหรือค่าต่างๆ จะไหลผ่านแต่ละแพตเทิร์นในคำสั่ง match และเมื่อเจอแพตเทิร์นแรกที่ค่านั้น “เข้ากันได้พอดี” ค่านั้นก็จะตกลงไปยังบล็อกโค้ดที่เชื่อมโยงกับแพตเทิร์นดังกล่าวเพื่อทำงานต่อไป
และเมื่อพูดถึงเหรียญแล้ว เราลองมาใช้เหรียญเป็นตัวอย่างในการใช้งาน match กันดู! เราสามารถเขียนฟังก์ชันที่รับเหรียญสหรัฐฯ ที่ไม่ทราบชนิดเข้ามา จากนั้นให้ฟังก์ชันตรวจสอบว่าเหรียญนั้นคือเหรียญอะไร และส่งค่ามูลค่าของเหรียญกลับมาเป็นหน่วยเซนต์ คล้ายกับการทำงานของเครื่องคัดแยกเหรียญ ดังที่แสดงในลิสติ้ง 6-3
enum Coin {
Penny,
Nickel,
Dime,
Quarter,
}
fn value_in_cents(coin: Coin) -> u8 {
match coin {
Coin::Penny => 1,
Coin::Nickel => 5,
Coin::Dime => 10,
Coin::Quarter => 25,
}
}
fn main() {}เราลองมาแยกดูองค์ประกอบของ match ในฟังก์ชัน value_in_cents กัน เริ่มแรก เราจะระบุคีย์เวิร์ด match ตามด้วยนิพจน์ ซึ่งในที่นี้ก็คือค่า coin โครงสร้างนี้อาจดูคล้ายกับนิพจน์แบบมีเงื่อนไขที่ใช้กับคำสั่ง if มาก แต่มีข้อแตกต่างที่สำคัญคือ: สำหรับ if เงื่อนไขจะต้องประเมินค่าออกมาเป็นบูลีน (Boolean) เสมอ แต่สำหรับ match ค่านั้นจะเป็นชนิดข้อมูลใดก็ได้ โดยชนิดข้อมูลของ coin ในตัวอย่างนี้ก็คือ enum Coin ที่เราได้นิยามไว้ในบรรทัดแรก
ถัดมาคือส่วนที่เรียกว่า อาร์ม (arms) ของ match โดยในแต่ละอาร์มจะประกอบด้วยสองส่วน ได้แก่: แพตเทิร์น และโค้ดที่จะให้ทำงาน อาร์มแรกในตัวอย่างนี้มีแพตเทิร์นเป็นค่า Coin::Penny ตามด้วยตัวดำเนินการ => ซึ่งทำหน้าที่คั่นระหว่างตัวแพตเทิร์นกับโค้ดที่จะทำงาน โค้ดในกรณีนี้เป็นเพียงแค่ค่า 1 โดดๆ และแต่ละอาร์มจะถูกคั่นออกจากกันด้วยเครื่องหมายจุลภาค (,)
เมื่อนิพจน์ match เริ่มทำงาน มันจะนำค่าที่ได้ไปเปรียบเทียบกับแพตเทิร์นของแต่ละอาร์มตามลำดับ หากแพตเทิร์นใดจับคู่กับค่านั้นได้พอดี โค้ดที่เชื่อมโยงกับแพตเทิร์นนั้นก็จะถูกเรียกทำงาน แต่ถ้าแพตเทิร์นนั้นไม่ตรงกับค่า โปรแกรมก็จะข้ามไปตรวจสอบอาร์มถัดไป คล้ายกับหลักการของเครื่องคัดแยกเหรียญ โดยเราสามารถกำหนดจำนวนอาร์มได้มากเท่าที่ต้องการ: อย่างในลิสติ้ง 6-3 นิพจน์ match ของเราก็มีทั้งหมด 4 อาร์ม
โค้ดที่เชื่อมโยงกับแต่ละอาร์มจะถือเป็นนิพจน์ (expression) และค่าผลลัพธ์ของนิพจน์ในอาร์มที่จับคู่ได้สำเร็จนั้น ก็คือค่าที่จะถูกส่งกลับออกมาเป็นผลลัพธ์ของนิพจน์ match ทั้งหมด
โดยปกติแล้ว เราไม่จำเป็นต้องใช้วงเล็บปีกกาถ้าโค้ดในอาร์มนั้นสั้น เหมือนในลิสติ้ง 6-3 ที่แต่ละอาร์มเพียงแค่ส่งค่ากลับออกมาเท่านั้น แต่หากต้องการรันคำสั่งหลายบรรทัดในอาร์มของ match เราก็จำเป็นต้องใช้วงเล็บปีกกาครอบไว้ และในกรณีนี้เครื่องหมายจุลภาคที่ต่อท้ายอาร์มก็จะไม่จำเป็นต้องใส่ก็ได้ ตัวอย่างเช่น โค้ดด้านล่างนี้จะพิมพ์ข้อความ “Lucky penny!” ออกมาทุกครั้งที่ฟังก์ชันถูกเรียกด้วย Coin::Penny แต่ยังคงส่งค่าสุดท้ายของบล็อกคือ 1 กลับออกมาเช่นเดิม:
enum Coin {
Penny,
Nickel,
Dime,
Quarter,
}
fn value_in_cents(coin: Coin) -> u8 {
match coin {
Coin::Penny => {
println!("Lucky penny!");
1
}
Coin::Nickel => 5,
Coin::Dime => 10,
Coin::Quarter => 25,
}
}
fn main() {}แพตเทิร์นที่ผูกกับค่า
คุณสมบัติที่มีประโยชน์อีกประการหนึ่งของอาร์มใน match คือความสามารถในการผูกค่า (bind) เข้ากับส่วนประกอบต่างๆ ของข้อมูลที่ตรงกับแพตเทิร์นนั้น ซึ่งนี่คือวิธีที่เราใช้ในการสกัดเอาค่าที่อยู่ภายในวาเรียนต์ของ enum ออกมาใช้งาน
ตัวอย่างเช่น ลองมาแก้ไขวาเรียนต์หนึ่งของ enum ให้สามารถเก็บข้อมูลไว้ข้างในได้ ในช่วงปี 1999 ถึง 2008 ประเทศสหรัฐอเมริกาได้ผลิตเหรียญควอเตอร์ (25 เซนต์) ที่มีลวดลายด้านหลังแตกต่างกันสำหรับทั้ง 50 รัฐ โดยไม่มีเหรียญชนิดอื่นที่มีลวดลายประจำรัฐเลย ดังนั้นจึงมีเพียงเหรียญควอเตอร์เท่านั้นที่มีข้อมูลพิเศษนี้ เราสามารถเพิ่มข้อมูลนี้เข้าไปใน enum ของเราได้โดยปรับเปลี่ยนวาเรียนต์ Quarter ให้เก็บค่า UsState ไว้ภายใน ดังที่แสดงในลิสติ้ง 6-4
#[derive(Debug)] // so we can inspect the state in a minute
enum UsState {
Alabama,
Alaska,
// --snip--
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn main() {}ลองจินตนาการว่า มีเพื่อนคนหนึ่งกำลังพยายามสะสมเหรียญควอเตอร์ให้ครบทั้ง 50 รัฐ ในขณะที่เรากำลังคัดแยกเหรียญตามชนิดของเหรียญ เราก็อยากจะขานชื่อรัฐที่อยู่บนเหรียญควอเตอร์แต่ละเหรียญออกมาด้วย เพื่อที่ว่าหากเป็นเหรียญที่เพื่อนคนนั้นยังไม่มี เขาก็จะได้นำไปเพิ่มเข้าคอลเลกชันของเขาได้
ในนิพจน์ match ของโค้ดนี้ เราได้เพิ่มตัวแปรชื่อ state เข้าไปในแพตเทิร์นที่ใช้จับคู่วาเรียนต์ Coin::Quarter และเมื่อเกิดการจับคู่ตรงกับ Coin::Quarter ตัวแปร state ดังกล่าวจะถูกผูกเข้ากับค่าของรัฐที่บรรจุอยู่ในเหรียญควอเตอร์นั้นโดยอัตโนมัติ จากนั้นเราก็สามารถนำตัวแปร state มาใช้งานในโค้ดของอาร์มนั้นได้ ดังนี้:
#[derive(Debug)]
enum UsState {
Alabama,
Alaska,
// --snip--
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn value_in_cents(coin: Coin) -> u8 {
match coin {
Coin::Penny => 1,
Coin::Nickel => 5,
Coin::Dime => 10,
Coin::Quarter(state) => {
println!("State quarter from {state:?}!");
25
}
}
}
fn main() {
value_in_cents(Coin::Quarter(UsState::Alaska));
}หากเราเรียกใช้ value_in_cents(Coin::Quarter(UsState::Alaska)) ค่าของ coin ก็จะเป็น Coin::Quarter(UsState::Alaska) และเมื่อนำค่านั้นไปเปรียบเทียบกับอาร์มแต่ละอาร์มใน match ก็จะไม่มีอาร์มใดตรงเลยจนกระทั่งมาถึง Coin::Quarter(state) ซึ่ง ณ จุดนั้น การผูกค่าของตัวแปร state จะมีค่าเท่ากับ UsState::Alaska เราจึงสามารถนำค่านั้นไปใช้งานในคำสั่ง println! ได้ และนี่คือวิธีที่เราดึงค่าที่อยู่ภายในวาเรียนต์ Quarter ของ enum Coin ออกมาใช้งาน
แพตเทิร์น match ของ Option<T>
ในหัวข้อก่อนหน้านี้ เราต้องการดึงค่า T ที่อยู่ภายในกรณี Some เมื่อใช้งาน Option<T> ซึ่งเราสามารถจัดการกับ Option<T> โดยใช้คำสั่ง match ได้เช่นกัน เหมือนกับที่เราทำกับ enum Coin! เพียงแต่เปลี่ยนจากการเปรียบเทียบเหรียญมาเป็นการเปรียบเทียบวาเรียนต์ต่างๆ ของ Option<T> แทน แต่วิธีการทำงานของนิพจน์ match นั้นยังคงเหมือนเดิมทุกประการ
สมมติว่าเราต้องการเขียนฟังก์ชันที่รับพารามิเตอร์ชนิด Option<i32> เข้ามา และหากมีค่าอยู่ภายใน ก็ให้บวกค่านั้นเพิ่มขึ้นอีก 1 แต่ถ้าไม่มีค่าอยู่ภายใน ฟังก์ชันก็ควรส่งค่า None กลับไปโดยไม่ต้องดำเนินการคำนวณใดๆ ทั้งสิ้น
ฟังก์ชันนี้สามารถเขียนได้ง่ายดายมากด้วยการใช้ match ดังที่แสดงในลิสติ้ง 6-5
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
None => None,
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}มาดูรายละเอียดการทำงานของฟังก์ชัน plus_one เมื่อถูกเรียกใช้งานครั้งแรกกัน เมื่อเราเรียก plus_one(five) ตัวแปร x ภายในตัวฟังก์ชันจะมีค่าเป็น Some(5) จากนั้นโปรแกรมจะนำค่านั้นไปเปรียบเทียบกับแต่ละอาร์มของ match:
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
None => None,
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}ค่า Some(5) ไม่ตรงกับแพตเทิร์น None โปรแกรมจึงข้ามไปยังอาร์มถัดไป:
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
None => None,
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}แล้ว Some(5) ตรงกับ Some(i) หรือไม่? คำตอบคือตรงกัน! เพราะทั้งสองเป็นวาเรียนต์ชนิดเดียวกัน ตัวแปร i จึงถูกผูกเข้ากับค่าที่บรรจุอยู่ภายใน Some ส่งผลให้ i มีค่าเท่ากับ 5 จากนั้นโค้ดในอาร์มนี้จะทำงาน โดยนำค่าของ i ไปบวกเพิ่ม 1 แล้วสร้างค่า Some ตัวใหม่ที่บรรจุผลลัพธ์ 6 เอาไว้ภายใน
คราวนี้ลองมาดูการเรียก plus_one ครั้งที่สองในลิสติ้ง 6-5 กันบ้าง ซึ่งในรอบนี้ตัวแปร x มีค่าเป็น None โปรแกรมจะเข้าสู่นิพจน์ match แล้วเปรียบเทียบกับอาร์มแรก:
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
None => None,
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}ผลปรากฏว่าตรงกัน! และเนื่องจากไม่มีค่าให้ต้องนำไปบวกเพิ่ม โปรแกรมจึงหยุดการตรวจสอบและส่งค่า None ทางด้านขวาของเครื่องหมาย => กลับออกไปทันที และเนื่องจากอาร์มแรกจับคู่ตรงกันแล้ว อาร์มอื่นๆ จึงไม่ต้องถูกนำมาเปรียบเทียบอีก
การใช้งาน match ร่วมกับ enum นั้นมีประโยชน์ในหลายๆ สถานการณ์ และคุณจะพบเห็นรูปแบบการเขียนแบบนี้บ่อยมากในโค้ด Rust: นั่นคือการใช้ match กับ enum, ผูกตัวแปรเข้ากับข้อมูลภายใน, แล้วสั่งให้โค้ดทำงานตามข้อมูลที่ได้ ในช่วงแรกอาจรู้สึกแปลกใหม่และต้องปรับตัวบ้าง แต่เมื่อคุณเริ่มคุ้นเคยแล้ว คุณจะอยากให้ภาษาอื่นๆ มีฟีเจอร์นี้เช่นกัน ซึ่งฟีเจอร์นี้มักเป็นหนึ่งในฟีเจอร์โปรดของเหล่านักพัฒนา Rust เสมอมา
การจับคู่ต้องครบถ้วนทุกกรณี
ยังมีอีกแง่มุมหนึ่งของ match ที่จำเป็นต้องพูดถึง: นั่นคือแพตเทิร์นของอาร์มทั้งหมดจะต้องครอบคลุมทุกกรณีที่เป็นไปได้ (exhaustive) ลองพิจารณาฟังก์ชัน plus_one ในเวอร์ชันนี้ ซึ่งมีบั๊กซ่อนอยู่และจะคอมไพล์ไม่ผ่าน:
fn main() {
fn plus_one(x: Option<i32>) -> Option<i32> {
match x {
Some(i) => Some(i + 1),
}
}
let five = Some(5);
let six = plus_one(five);
let none = plus_one(None);
}เนื่องจากเราไม่ได้จัดการกรณี None ไว้ โค้ดนี้จึงอาจก่อให้เกิดบั๊กขึ้นได้ แต่โชคดีที่บั๊กประเภทนี้ Rust สามารถตรวจจับได้ตั้งแต่ตอนคอมไพล์ หากเราพยายามคอมไพล์โค้ดดังกล่าว เราจะได้รับข้อผิดพลาดดังนี้:
$ cargo run
Compiling enums v0.1.0 (file:///projects/enums)
error[E0004]: non-exhaustive patterns: `None` not covered
--> src/main.rs:3:15
|
3 | match x {
| ^ pattern `None` not covered
|
note: `Option<i32>` defined here
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/option.rs:598:0
::: /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/option.rs:602:4
|
= note: not covered
= note: the matched value is of type `Option<i32>`
help: ensure that all possible cases are being handled by adding a match arm with a wildcard pattern or an explicit pattern as shown
|
4 ~ Some(i) => Some(i + 1),
5 ~ None => todo!(),
|
For more information about this error, try `rustc --explain E0004`.
error: could not compile `enums` (bin "enums") due to 1 previous error
Rust ทราบดีว่าเรายังไม่ได้ครอบคลุมทุกกรณีที่เป็นไปได้ และยังบอกได้ด้วยซ้ำว่าเราลืมแพตเทิร์นใดไป! การจับคู่ด้วย match ในภาษา Rust นั้นต้อง_ครบถ้วนทุกกรณี_ (exhaustive): เราจะต้องแจกแจงทุกกรณีที่เป็นไปได้อย่างหมดจด โค้ดจึงจะถือว่าถูกต้องสมบูรณ์ โดยเฉพาะอย่างยิ่งในกรณีของ Option<T> การที่ Rust บังคับไม่ให้เราลืมจัดการกรณี None จะช่วยป้องกันไม่ให้เราเผลอทึกทักเอาเองว่ามีค่าอยู่เสมอ ทั้งที่ในความเป็นจริงอาจเป็นค่า null ซึ่งการตรวจสอบนี้ช่วยขจัด “ความผิดพลาดมูลค่าพันล้านดอลลาร์” ที่เราพูดถึงไปก่อนหน้านี้ให้เป็นไปไม่ได้เลย
แพตเทิร์นแบบครอบคลุมทั้งหมดและตัวยึดตำแหน่ง _
เมื่อใช้ enum เรายังสามารถกำหนดการทำงานแบบพิเศษให้กับค่าเฉพาะเจาะจงบางค่าได้ ในขณะที่ค่าอื่นๆ ทั้งหมดที่เหลือ ให้ไปทำงานตามการกระทำเริ่มต้น (default action) เพียงแบบเดียว ลองจินตนาการว่าเรากำลังพัฒนาเกมกระดานเกมหนึ่ง ซึ่งหากคุณทอยลูกเต๋าได้แต้ม 3 ตัวละครจะไม่เดิน แต่จะได้หมวกใบใหม่สุดเท่แทน หากทอยได้แต้ม 7 ตัวละครจะเสียหมวกใบเท่ไปหนึ่งใบ ส่วนกรณีที่ทอยได้แต้มอื่นๆ ทั้งหมด ตัวละครจะเดินไปข้างหน้าตามจำนวนช่องเท่ากับแต้มที่ทอยได้ ด้านล่างนี้คือนิพจน์ match ที่จำลองตรรกะดังกล่าว โดยเราจะฮาร์ดโค้ดผลลัพธ์ของการทอยลูกเต๋าไว้แทนที่จะเป็นการสุ่มค่า และตรรกะอื่นๆ จะเขียนแทนด้วยฟังก์ชันเปล่าๆ เนื่องจากรายละเอียดการทำงานจริงนั้นอยู่นอกเหนือขอบเขตของตัวอย่างนี้:
fn main() {
let dice_roll = 9;
match dice_roll {
3 => add_fancy_hat(),
7 => remove_fancy_hat(),
other => move_player(other),
}
fn add_fancy_hat() {}
fn remove_fancy_hat() {}
fn move_player(num_spaces: u8) {}
}สำหรับสองอาร์มแรก แพตเทิร์นคือค่าลิเทอรัล 3 และ 7 ส่วนอาร์มสุดท้ายที่ทำหน้าที่ครอบคลุมค่าอื่นๆ ที่เป็นไปได้ทั้งหมดนั้น เราใช้แพตเทิร์นเป็นตัวแปรที่เราตั้งชื่อว่า other โดยโค้ดที่จะทำงานในอาร์ม other จะนำตัวแปรนี้ไปส่งต่อให้กับฟังก์ชัน move_player
โค้ดนี้คอมไพล์ผ่าน แม้ว่าเราจะไม่ได้แจกแจงค่าทั้งหมดที่ชนิดข้อมูล u8 สามารถเป็นไปได้ก็ตาม เพราะแพตเทิร์นสุดท้ายจะจับคู่กับค่าทั้งหมดที่ไม่ได้ระบุไว้ในอาร์มก่อนหน้า ซึ่งแพตเทิร์นแบบครอบคลุมทั้งหมด (catch-all pattern) นี้ช่วยตอบสนองข้อกำหนดของ match ที่จะต้องครอบคลุมทุกกรณีได้เป็นอย่างดี อย่างไรก็ตาม โปรดสังเกตว่าเราจำเป็นต้องวางอาร์มแบบครอบคลุมทั้งหมดนี้ไว้เป็นลำดับสุดท้ายเสมอ เนื่องจากแพตเทิร์นจะถูกตรวจสอบเรียงตามลำดับจากบนลงล่าง หากเรานำอาร์มแบบครอบคลุมทั้งหมดไปวางไว้ก่อน อาร์มอื่นๆ ที่อยู่ถัดไปจะไม่มีทางถูกเรียกทำงานเลย ซึ่ง Rust จะแจ้งเตือน (warning) ทันทีหากเราเขียนอาร์มใดๆ ต่อท้ายอาร์มแบบครอบคลุมทั้งหมด!
นอกจากนี้ Rust ยังมีแพตเทิร์นสำหรับกรณีที่เราต้องการครอบคลุมค่าที่เหลือทั้งหมด แต่_ไม่ต้องการนำค่า_เหล่านั้นมาใช้งาน: โดยตัวสัญลักษณ์ _ เป็นแพตเทิร์นพิเศษที่จะจับคู่กับค่าใดๆ ก็ได้โดยไม่มีการผูกค่านั้นเข้ากับตัวแปร ซึ่งเป็นการบอก Rust อย่างชัดเจนว่าเราไม่ได้คิดจะนำค่านั้นไปใช้ และคอมไพเลอร์ก็จะไม่แจ้งเตือนเรื่องตัวแปรที่ไม่ได้ใช้งานด้วย
คราวนี้ลองเปลี่ยนกฎของเกมกันดู: หากคุณทอยลูกเต๋าได้แต้มอื่นที่ไม่ใช่ 3 หรือ 7 คุณจะต้องทอยลูกเต๋าใหม่อีกครั้ง ในกรณีนี้เราไม่จำเป็นต้องนำค่าแต้มที่ทอยได้ไปใช้งานแล้ว เราจึงสามารถปรับโค้ดมาใช้ _ แทนตัวแปรชื่อ other ได้ดังนี้:
fn main() {
let dice_roll = 9;
match dice_roll {
3 => add_fancy_hat(),
7 => remove_fancy_hat(),
_ => reroll(),
}
fn add_fancy_hat() {}
fn remove_fancy_hat() {}
fn reroll() {}
}ตัวอย่างนี้ยังคงตอบสนองข้อกำหนดเรื่องความครอบคลุมทุกกรณีได้เช่นเดิม เพราะเราได้ระบุอย่างชัดเจนในอาร์มสุดท้ายว่าจะละเว้นค่าอื่นๆ ทั้งหมดที่เหลือ จึงมั่นใจได้ว่าเราไม่ได้หลงลืมกรณีใดไป
และสุดท้ายนี้ หากเราเปลี่ยนกฎของเกมอีกรอบหนึ่งเป็นว่า เมื่อทอยได้แต้มอื่นนอกจาก 3 หรือ 7 จะไม่มีอะไรเกิดขึ้นเลยในตานั้น เราก็สามารถสื่อความหมายดังกล่าวได้โดยใช้ค่ายูนิต (unit value - ซึ่งก็คือชนิดทูเพิลว่างเปล่าที่เราได้กล่าวถึงในหัวข้อ “ชนิดทูเพิล”) มาใส่เป็นบล็อกโค้ดในอาร์ม _:
fn main() {
let dice_roll = 9;
match dice_roll {
3 => add_fancy_hat(),
7 => remove_fancy_hat(),
_ => (),
}
fn add_fancy_hat() {}
fn remove_fancy_hat() {}
}ในตัวอย่างนี้ เรากำลังบอก Rust อย่างตรงไปตรงมาว่า เราจะไม่นำค่าอื่นๆ ที่ไม่ตรงกับแพตเทิร์นในอาร์มก่อนหน้ามาใช้งาน และเราก็ไม่ต้องการให้โค้ดส่วนใดทำงานเลยในกรณีนี้
ยังมีรายละเอียดเกี่ยวกับแพตเทิร์นและการจับคู่รูปแบบ (pattern matching) อีกมากมายที่เราจะได้เรียนรู้กันใน บทที่ 19 แต่สำหรับตอนนี้ เราจะไปต่อกันที่โครงสร้างไวยากรณ์ if let ซึ่งจะมีประโยชน์อย่างยิ่งในสถานการณ์ที่การใช้นิพจน์ match อาจดูเยิ่นเย้อเกินไป
การควบคุมโฟลว์แบบกระชับด้วย if let และ let...else
การควบคุมโฟลว์แบบกระชับด้วย if let และ let...else
ไวยากรณ์ if let ช่วยให้เราสามารถรวม if และ let เข้าด้วยกันเพื่อจัดการกับค่าที่ตรงกับแพตเทิร์นเพียงรูปแบบเดียวได้อย่างกระชับ โดยไม่ต้องสนใจกรณีอื่นๆ ที่เหลือ ลองพิจารณาโปรแกรมในลิสติ้ง 6-6 ที่นำค่า Option<u8> ในตัวแปร config_max มาจับคู่กับแพตเทิร์น แต่ต้องการให้โค้ดทำงานเฉพาะในกรณีที่ค่านั้นเป็นวาเรียนต์ Some เท่านั้น
fn main() {
let config_max = Some(3u8);
match config_max {
Some(max) => println!("The maximum is configured to be {max}"),
_ => (),
}
}หากค่านั้นเป็น Some เราจะพิมพ์ค่าที่บรรจุอยู่ภายในวาเรียนต์ Some ออกมา โดยการผูกค่านั้นเข้ากับตัวแปร max ในแพตเทิร์น และเราไม่ได้ต้องการทำอะไรกับค่า None เลย แต่เพื่อให้ตรงตามข้อกำหนดของนิพจน์ match ที่ต้องครอบคลุมทุกกรณี เราจึงจำใจต้องเพิ่ม _ => () ต่อท้ายหลังจากจัดการวาเรียนต์แรกไปแล้ว ซึ่งกลายเป็นโค้ดส่วนเกินที่ซ้ำซากและน่ารำคาญ (boilerplate code)
แทนที่จะทำเช่นนั้น เราสามารถเขียนให้สั้นและกระชับขึ้นได้ด้วยการใช้ if let โดยโค้ดด้านล่างนี้จะทำงานเหมือนกับคำสั่ง match ในลิสติ้ง 6-6 ทุกประการ:
fn main() {
let config_max = Some(3u8);
if let Some(max) = config_max {
println!("The maximum is configured to be {max}");
}
}ไวยากรณ์ if let จะรับแพตเทิร์นและนิพจน์โดยคั่นด้วยเครื่องหมายเท่ากับ (=) หลักการทำงานของมันเหมือนกับ match ทุกอย่าง โดยนิพจน์ทางขวาจะถูกส่งเข้าไปเปรียบเทียบ และแพตเทิร์นทางซ้ายจะทำหน้าที่เป็นอาร์มแรกของ match ในตัวอย่างนี้ แพตเทิร์นคือ Some(max) และตัวแปร max จะถูกผูกเข้ากับค่าที่อยู่ภายใน Some จากนั้นเราก็สามารถนำ max มาใช้งานภายในบล็อกของ if let ได้ในลักษณะเดียวกับที่เราใช้ max ในอาร์มของ match โดยโค้ดในบล็อก if let จะทำงานก็ต่อเมื่อค่านั้นตรงกับแพตเทิร์นที่กำหนดไว้เท่านั้น
การใช้ if let ช่วยให้พิมพ์โค้ดน้อยลง ย่อหน้าน้อยลง และลดโค้ด boilerplate ลงไปได้มาก อย่างไรก็ดี สิ่งที่ต้องแลกมาคือเราจะสูญเสียการตรวจสอบความครอบคลุมทุกกรณี (exhaustive checking) ที่ match บังคับใช้เพื่อป้องกันไม่ให้เราลืมจัดการกรณีใดกรณีหนึ่งไป การตัดสินใจเลือกระหว่าง match กับ if let จึงขึ้นอยู่กับสถานการณ์และลักษณะงานของคุณ ว่าความกระชับที่ได้มานั้นคุ้มค่ากับการยอมแลกการตรวจสอบความครบถ้วนของกรณีต่างๆ หรือไม่
พูดอีกอย่างหนึ่งก็คือ เราสามารถมองว่า if let เป็นน้ำตาลทางไวยากรณ์ (syntax sugar) ของคำสั่ง match ที่สั่งให้โค้ดทำงานเมื่อค่าตรงกับแพตเทิร์นหนึ่ง แล้วละเว้นค่าอื่นๆ ทั้งหมดที่เหลือ
นอกจากนี้ เรายังสามารถใส่ else คู่กับ if let ได้ด้วย โดยบล็อกโค้ดในส่วนของ else จะเทียบเท่ากับบล็อกโค้ดในกรณี _ ของนิพจน์ match หากเขียนเทียบเคียงกัน ย้อนกลับไปดูนิยามของ enum Coin ในลิสติ้ง 6-4 ที่วาเรียนต์ Quarter มีการเก็บค่า UsState เอาไว้ข้างใน หากเราต้องการนับจำนวนเหรียญทั้งหมดที่ไม่ใช่เหรียญควอเตอร์ ควบคู่ไปกับการขานชื่อรัฐของเหรียญควอเตอร์ที่พบ เราสามารถเขียนด้วยนิพจน์ match ได้ดังนี้:
#[derive(Debug)]
enum UsState {
Alabama,
Alaska,
// --snip--
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn main() {
let coin = Coin::Penny;
let mut count = 0;
match coin {
Coin::Quarter(state) => println!("State quarter from {state:?}!"),
_ => count += 1,
}
}หรือเราสามารถเขียนด้วยนิพจน์ if let และ else ได้เช่นกัน ดังนี้:
#[derive(Debug)]
enum UsState {
Alabama,
Alaska,
// --snip--
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn main() {
let coin = Coin::Penny;
let mut count = 0;
if let Coin::Quarter(state) = coin {
println!("State quarter from {state:?}!");
} else {
count += 1;
}
}อยู่บน “เส้นทางราบรื่น” ด้วย let...else
รูปแบบการเขียนที่พบได้บ่อยมากคือ การทำงานคำนวณบางอย่างเมื่อมีค่าอยู่ และส่งค่าดีฟอลต์ (default value) หรือออกจากฟังก์ชันหากไม่มีค่านั้น ต่อเนื่องจากตัวอย่างเหรียญที่เก็บค่า UsState หากเราอยากจะแสดงข้อความหยอกล้อขึ้นอยู่กับว่ารัฐบนเหรียญควอเตอร์นั้นก่อตั้งมานานแค่ไหน เราอาจจะเพิ่มเมธอดบน UsState เพื่อตรวจสอบอายุของรัฐ ดังนี้:
#[derive(Debug)] // so we can inspect the state in a minute
enum UsState {
Alabama,
Alaska,
// --snip--
}
impl UsState {
fn existed_in(&self, year: u16) -> bool {
match self {
UsState::Alabama => year >= 1819,
UsState::Alaska => year >= 1959,
// -- snip --
}
}
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn describe_state_quarter(coin: Coin) -> Option<String> {
if let Coin::Quarter(state) = coin {
if state.existed_in(1900) {
Some(format!("{state:?} is pretty old, for America!"))
} else {
Some(format!("{state:?} is relatively new."))
}
} else {
None
}
}
fn main() {
if let Some(desc) = describe_state_quarter(Coin::Quarter(UsState::Alaska)) {
println!("{desc}");
}
}จากนั้น เราอาจจะใช้ if let ในการตรวจสอบชนิดของเหรียญ พร้อมทั้งประกาศตัวแปร state ขึ้นมาใช้งานภายในบล็อกเงื่อนไข ดังที่แสดงในลิสติ้ง 6-7
#[derive(Debug)] // so we can inspect the state in a minute
enum UsState {
Alabama,
Alaska,
// --snip--
}
impl UsState {
fn existed_in(&self, year: u16) -> bool {
match self {
UsState::Alabama => year >= 1819,
UsState::Alaska => year >= 1959,
// -- snip --
}
}
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn describe_state_quarter(coin: Coin) -> Option<String> {
if let Coin::Quarter(state) = coin {
if state.existed_in(1900) {
Some(format!("{state:?} is pretty old, for America!"))
} else {
Some(format!("{state:?} is relatively new."))
}
} else {
None
}
}
fn main() {
if let Some(desc) = describe_state_quarter(Coin::Quarter(UsState::Alaska)) {
println!("{desc}");
}
}โค้ดนี้ทำงานได้ตามต้องการก็จริง แต่เป็นการผลักภาระงานทั้งหมดเข้าไปซ้อนอยู่ลึกข้างในบล็อกของคำสั่ง if let และถ้าหากงานที่ต้องทำมีความซับซ้อนมากยิ่งขึ้น ก็อาจทำให้ไล่อ่านและทำความเข้าใจความสัมพันธ์ของกิ่งเงื่อนไขระดับบนได้ยาก เราสามารถใช้ประโยชน์จากข้อเท็จจริงที่ว่านิพจน์จะส่งคืนค่าออกมา เพื่อดึงค่า state ออกมาจาก if let หรือใช้ return ออกจากฟังก์ชันก่อนกำหนด (return early) ได้ ดังที่แสดงในลิสติ้ง 6-8 (ซึ่งสามารถเขียนด้วย match ในลักษณะเดียวกันได้เช่นกัน)
#[derive(Debug)] // so we can inspect the state in a minute
enum UsState {
Alabama,
Alaska,
// --snip--
}
impl UsState {
fn existed_in(&self, year: u16) -> bool {
match self {
UsState::Alabama => year >= 1819,
UsState::Alaska => year >= 1959,
// -- snip --
}
}
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn describe_state_quarter(coin: Coin) -> Option<String> {
let state = if let Coin::Quarter(state) = coin {
state
} else {
return None;
};
if state.existed_in(1900) {
Some(format!("{state:?} is pretty old, for America!"))
} else {
Some(format!("{state:?} is relatively new."))
}
}
fn main() {
if let Some(desc) = describe_state_quarter(Coin::Quarter(UsState::Alaska)) {
println!("{desc}");
}
}อย่างไรก็ตาม การเขียนแบบนี้ก็ยังชวนให้สับสนและติดตามการทำงานได้ยากอยู่ดี! เพราะกิ่งหนึ่งของ if let มีหน้าที่ส่งค่ากลับออกมา ส่วนอีกกิ่งหนึ่งกลับ return ออกจากฟังก์ชันไปเลย
เพื่อให้การเขียนรูปแบบยอดนิยมนี้มีความสวยงามและเป็นธรรมชาติยิ่งขึ้น Rust จึงมีไวยากรณ์ let...else โดย let...else จะรับแพตเทิร์นไว้ทางฝั่งซ้าย และรับนิพจน์ไว้ทางฝั่งขวา คล้ายกับ if let มาก แต่จะไม่มีกิ่ง if มีเพียงแค่กิ่ง else เท่านั้น หากแพตเทิร์นจับคู่สำเร็จ มันจะผูกค่าจากแพตเทิร์นเข้ามาไว้ในขอบเขตภายนอก (outer scope) ทันที แต่ถ้าแพตเทิร์น_ไม่_ตรงกัน โปรแกรมจะวิ่งเข้าไปทำงานในส่วนของ else ซึ่งบังคับว่าจะต้องมีคำสั่ง return ออกจากฟังก์ชัน (หรือคำสั่งอื่นที่ทำให้หลุดจากโฟลว์การทำงาน)
ในลิสติ้ง 6-9 คุณจะเห็นว่าโค้ดจากลิสติ้ง 6-8 จะดูสะอาดตาขึ้นเพียงใดเมื่อเปลี่ยนมาใช้ let...else แทน if let
#[derive(Debug)] // so we can inspect the state in a minute
enum UsState {
Alabama,
Alaska,
// --snip--
}
impl UsState {
fn existed_in(&self, year: u16) -> bool {
match self {
UsState::Alabama => year >= 1819,
UsState::Alaska => year >= 1959,
// -- snip --
}
}
}
enum Coin {
Penny,
Nickel,
Dime,
Quarter(UsState),
}
fn describe_state_quarter(coin: Coin) -> Option<String> {
let Coin::Quarter(state) = coin else {
return None;
};
if state.existed_in(1900) {
Some(format!("{state:?} is pretty old, for America!"))
} else {
Some(format!("{state:?} is relatively new."))
}
}
fn main() {
if let Some(desc) = describe_state_quarter(Coin::Quarter(UsState::Alaska)) {
println!("{desc}");
}
}สังเกตได้ว่า โฟลว์การทำงานหลักของฟังก์ชันจะยังคงอยู่บน “เส้นทางปกติที่ราบรื่น” (happy path) เสมอ โดยไม่ต้องแยกเป็นสองกิ่งที่ควบคุมการทำงานแตกต่างกันอย่างสิ้นเชิงเหมือนกับที่ if let เคยทำ
หากคุณพบเจอสถานการณ์ที่ตรรกะในโปรแกรมดูยืดเยื้อหรือซ้ำซ้อนเกินกว่าจะใช้ match อย่าลืมว่าคุณยังมีเครื่องมืออย่าง if let และ let...else อยู่ในกล่องเครื่องมือของ Rust ให้เลือกใช้งานได้อย่างเหมาะสม
สรุป
จนถึงตอนนี้ เราได้เรียนรู้วิธีการใช้ enum เพื่อสร้างชนิดข้อมูลที่กำหนดขึ้นเอง ซึ่งสามารถเลือกเป็นค่าใดค่าหนึ่งจากกลุ่มของค่าที่แจกแจงไว้ได้อย่างชัดเจน นอกจากนี้ เรายังได้เห็นว่าชนิดข้อมูล Option<T> ในไลบรารีมาตรฐานช่วยให้เราใช้ประโยชน์จากระบบชนิดข้อมูลในการป้องกันข้อผิดพลาดได้อย่างไร และเมื่อค่าของ enum มีข้อมูลบรรจุอยู่ภายใน เราก็สามารถใช้ match หรือ if let ในการดึงข้อมูลเหล่านั้นออกมาใช้งานได้ ขึ้นอยู่กับว่าเราต้องการจัดการกับกรณีต่างๆ มากน้อยเพียงใด
ตอนนี้โปรแกรม Rust ของคุณสามารถถ่ายทอดแนวคิดต่างๆ ในโดเมนของงานได้อย่างสมบูรณ์ผ่าน struct และ enum การสร้างชนิดข้อมูลที่กำหนดขึ้นเองเพื่อใช้ใน API ยังช่วยรับประกันความปลอดภัยของชนิดข้อมูล (type safety) โดยคอมไพเลอร์จะคอยตรวจสอบอย่างเข้มงวดว่า ฟังก์ชันต่างๆ จะได้รับเฉพาะค่าที่มีชนิดข้อมูลตรงตามที่ฟังก์ชันนั้นๆ คาดหวังไว้เท่านั้น
และเพื่อที่เราจะสามารถออกแบบและส่งมอบ API ที่จัดโครงสร้างอย่างเป็นระเบียบ เรียบง่ายต่อการใช้งาน และเปิดเผยให้ผู้ใช้มองเห็นเฉพาะสิ่งที่จำเป็นต้องใช้จริงๆ ในบทถัดไปเราจะมาเรียนรู้เรื่องมอดูล (modules) ของภาษารัสต์กัน
แพ็กเกจ เครต และมอดูล
เมื่อโปรแกรมที่คุณเขียนเริ่มมีขนาดใหญ่ขึ้น การจัดระเบียบโครงสร้างโค้ดจะยิ่งทวีความสำคัญมากยิ่งขึ้น การจัดกลุ่มการทำงานที่เกี่ยวข้องกันไว้ด้วยกัน และการแยกส่วนโค้ดที่มีหน้าที่การทำงานต่างกันออกจากกัน จะช่วยให้คุณค้นหาได้ง่ายขึ้นว่าโค้ดที่ทำหน้าที่ในฟีเจอร์ใดฟีเจอร์หนึ่งอยู่ที่ไหน และควรเข้าไปแก้ไขจุดใดเมื่อต้องการปรับเปลี่ยนพฤติกรรมการทำงานของฟีเจอร์นั้นๆ
โปรแกรมทั้งหมดที่เราเขียนมาจนถึงจุดนี้ ล้วนเขียนอยู่ภายในมอดูลเดียวและรวมอยู่ในไฟล์เดียว แต่เมื่อโปรเจกต์เติบโตขึ้น เราควรจัดระเบียบโค้ดโดยแยกออกเป็นหลายๆ มอดูล และกระจายออกเป็นหลายๆ ไฟล์ตามลำดับ โดยแพ็กเกจ (package) หนึ่งแพ็กเกจสามารถบรรจุเครตไบนารี (binary crates) ได้หลายตัว และสามารถมีเครตไลบรารี (library crate) ได้อย่างมากที่สุดหนึ่งตัว และเมื่อแพ็กเกจเริ่มมีขนาดใหญ่ขึ้นอีก คุณก็สามารถแยกส่วนการทำงานบางส่วนออกมาเป็นเครตต่างหาก เพื่อใช้เป็นดีเพนเดนซีภายนอก (external dependencies) ได้ ซึ่งในบทนี้จะครอบคลุมเทคนิคเหล่านี้ทั้งหมด สำหรับโปรเจกต์ขนาดใหญ่มากที่ประกอบขึ้นจากชุดของแพ็กเกจหลายตัวที่เกี่ยวข้องกันและพัฒนาควบคู่ไปด้วยกัน ทาง Cargo ก็มีฟีเจอร์เวิร์กสเปซ (workspaces) มารองรับ ซึ่งเราจะได้เรียนรู้กันในหัวข้อ “เวิร์กสเปซของ Cargo” ในบทที่ 14
นอกจากนี้ เรายังจะได้พูดถึงเรื่องการห่อหุ้มรายละเอียดการทำงานภายใน (encapsulation) ซึ่งช่วยให้เราสามารถนำโค้ดกลับมาใช้ซ้ำในระดับที่สูงขึ้นได้: เมื่อเราเขียนการทำงานฟังก์ชันหนึ่งเสร็จเรียบร้อยแล้ว โค้ดส่วนอื่นๆ ก็สามารถเรียกใช้ฟังก์ชันดังกล่าวผ่านทางอินเทอร์เฟซสาธารณะ (public interface) ได้ทันที โดยไม่จำเป็นต้องรู้ลึกไปถึงรายละเอียดการทำงานเบื้องหลัง วิธีการเขียนโค้ดของคุณจะเป็นตัวกำหนดเองว่า ส่วนใดควรเปิดเผยเป็นสาธารณะ (public) เพื่อให้โค้ดภายนอกเรียกใช้งานได้ และส่วนใดควรเก็บไว้เป็นรายละเอียดภายในแบบส่วนตัว (private) เพื่อให้คุณมีอิสระในการปรับปรุงแก้ไขการทำงานได้ในอนาคต ซึ่งนี่เป็นอีกหนึ่งวิธีที่ช่วยลดภาระทางความคิดที่คุณต้องคอยจดจำลงไปได้อย่างมาก
อีกแนวคิดหนึ่งที่เกี่ยวข้องอย่างใกล้ชิดคือเรื่องของ ขอบเขตตัวแปรและชื่อ หรือ สโคป (scope): โดยบริบทที่ซ้อนกันอยู่ของโค้ดจะมีชุดของชื่อต่างๆ ที่ถือว่า “อยู่ในสโคป” (in scope) ในเวลาที่อ่าน เขียน และคอมไพล์โค้ด ทั้งโปรแกรมเมอร์และคอมไพเลอร์จำเป็นต้องรู้ได้อย่างชัดเจนว่า ชื่อหนึ่งๆ ณ จุดใดจุดหนึ่งกำลังอ้างอิงถึงตัวแปร, ฟังก์ชัน, struct, enum, มอดูล, ค่าคงที่ หรือไอเทมใด และไอเทมนั้นมีความหมายอย่างไร คุณสามารถสร้างสโคปใหม่ๆ ขึ้นมา และกำหนดได้ว่าชื่อใดจะอยู่ภายในหรืออยู่นอกสโคป โดยคุณจะไม่สามารถตั้งชื่อไอเทม 2 ตัวให้ซ้ำกันภายในสโคปเดียวกันได้ ซึ่ง Rust ก็มีเครื่องมือที่ช่วยแก้ไขปัญหาเมื่อเกิดความขัดแย้งของชื่อไว้ให้พร้อมสรรพ
Rust มีฟีเจอร์มากมายที่ช่วยให้คุณจัดการโครงสร้างองค์ประกอบของโค้ดได้อย่างเป็นระบบ ครอบคลุมทั้งเรื่องการกำหนดว่ารายละเอียดใดควรเปิดเผย รายละเอียดใดควรเป็นแบบส่วนตัว และมีชื่อใดบ้างที่สามารถเข้าถึงได้ในแต่ละสโคปของโปรแกรม โดยกลุ่มฟีเจอร์เหล่านี้ มักถูกเรียกโดยรวมว่า ระบบมอดูล (module system) ซึ่งประกอบด้วย:
- แพ็กเกจ (Packages): ฟีเจอร์ของ Cargo ที่ช่วยให้คุณสามารถบิลด์, ทดสอบ และเผยแพร่แบ่งปันเครตต่างๆ ได้
- เครต (Crates): โครงสร้างแบบต้นไม้ของมอดูลที่คอมไพล์ออกมาเป็นไลบรารีหรือไฟล์รันไบนารี (executable)
- มอดูล (Modules) และ use: เครื่องมือที่ช่วยให้คุณควบคุมการจัดโครงสร้าง, สโคป และความเป็นส่วนตัว (privacy) ของพาธต่างๆ
- พาธ (Paths): วิธีการระบุชื่อเพื่ออ้างอิงไปยังไอเทมต่างๆ เช่น struct, ฟังก์ชัน หรือมอดูล
ในบทนี้ เราจะมาเรียนรู้ฟีเจอร์เหล่านี้ทั้งหมด พร้อมทั้งสำรวจว่าแต่ละส่วนทำงานประสานร่วมกันอย่างไร และอธิบายวิธีนำฟีเจอร์เหล่านี้ไปใช้ในการจัดการสโคป เมื่ออ่านจบบทนี้ คุณจะมีความเข้าใจระบบมอดูลอย่างลึกซึ้งและสามารถจัดการกับสโคปในโค้ดได้อย่างมั่นใจดั่งมืออาชีพ!
แพ็กเกจและเครต
แพ็กเกจและเครต
ส่วนประกอบแรกของระบบมอดูลที่เราจะมาเรียนรู้กันคือ แพ็กเกจ (packages) และเครต (crates)
เครต (crate) คือหน่วยโค้ดที่เล็กที่สุดที่คอมไพเลอร์ Rust จะหยิบขึ้นมาประมวลผลในคราวเดียว แม้ว่าคุณจะสั่งรัน rustc โดยตรงแทนที่จะใช้ cargo และส่งไฟล์ซอร์สโค้ดไปเพียงไฟล์เดียว (เหมือนที่เราเคยทำในหัวข้อ “พื้นฐานของโปรแกรม Rust” ในบทที่ 1) ตัวคอมไพเลอร์ก็ยังถือว่าไฟล์เดี่ยวนั้นคือเครตหนึ่งตัว โดยเครตสามารถบรรจุมอดูล (modules) ต่างๆ ไว้ภายในได้ และมอดูลเหล่านั้นก็อาจถูกแยกไปนิยามไว้ในไฟล์อื่นๆ ที่จะถูกคอมไพล์รวมเข้ากับตัวเครต ดังที่เราจะได้เห็นกันในหัวข้อต่อๆ ไป
เครตสามารถแบ่งออกเป็น 2 รูปแบบ ได้แก่: เครตไบนารี (binary crate) หรือเครตไลบรารี (library crate)
เครตไบนารี คือโปรแกรมที่คุณสามารถคอมไพล์ออกมาเป็นไฟล์รันได้ (executable binary) เพื่อนำไปสั่งรัน เช่น โปรแกรมบรรทัดคำสั่ง (CLI) หรือโปรแกรมเซิร์ฟเวอร์ โดยเครตไบนารีแต่ละตัวจะต้องมีฟังก์ชันชื่อ main เสมอ เพื่อกำหนดจุดเริ่มต้นการทำงานเมื่อไฟล์รันได้เริ่มทำงาน ซึ่งเครตทั้งหมดที่เราได้สร้างขึ้นมาจนถึงจุดนี้ล้วนเป็นเครตไบนารีทั้งสิ้น
ในทางกลับกัน เครตไลบรารี จะไม่มีฟังก์ชัน main และไม่สามารถคอมไพล์ออกมาเป็นไฟล์รันได้โดยตรง แต่จะถูกสร้างขึ้นเพื่อนิยามฟังก์ชันการทำงานต่างๆ โดยมีเป้าหมายเพื่อนำไปแบ่งปันและเรียกใช้งานร่วมกับโปรเจกต์อื่นๆ ตัวอย่างเช่น เครต rand ที่เรานำมาใช้ใน บทที่ 2 ซึ่งทำหน้าที่ช่วยสุ่มตัวเลข โดยส่วนใหญ่แล้ว เมื่อชาว Rustacean พูดคำว่า “เครต” มักจะหมายถึงเครตไลบรารี และมักใช้คำว่า “เครต” ในความหมายเดียวกับคำว่า “ไลบรารี” ในการเขียนโปรแกรมทั่วไป
รากของเครต (crate root) คือไฟล์ซอร์สโค้ดตั้งต้นที่คอมไพเลอร์ Rust จะเริ่มอ่านเป็นจุดแรก และทำหน้าที่เป็นมอดูลราก (root module) ของเครตของคุณ (เราจะอธิบายเรื่องมอดูลอย่างละเอียดในหัวข้อ “ควบคุมสโคปและความเป็นส่วนตัวด้วยมอดูล”)
แพ็กเกจ (package) คือชุดของเครตตั้งแต่หนึ่งตัวขึ้นไปที่รวมกลุ่มกันเพื่อส่งมอบชุดฟังก์ชันการทำงานบางอย่าง โดยแพ็กเกจจะประกอบด้วยไฟล์ Cargo.toml ซึ่งทำหน้าที่อธิบายวิธีการบิลด์เครตเหล่านั้น ในความเป็นจริงแล้ว ตัว Cargo เองก็เป็นแพ็กเกจหนึ่งที่บรรจุเครตไบนารีสำหรับเครื่องมือบรรทัดคำสั่งที่คุณใช้สั่งบิลด์โค้ด และในแพ็กเกจ Cargo ก็ยังมีเครตไลบรารีที่เครตไบนารีตัวนั้นต้องพึ่งพาอยู่อีกด้วย ซึ่งโปรเจกต์อื่นๆ ก็สามารถเรียกใช้เครตไลบรารีของ Cargo เพื่อนำตรรกะการทำงานแบบเดียวกับที่เครื่องมือ Cargo ใช้ไปต่อยอดได้เช่นกัน
แพ็กเกจหนึ่งแพ็กเกจสามารถมีเครตไบนารีกี่ตัวก็ได้ตามต้องการ แต่จะมีเครตไลบรารีได้มากที่สุดเพียง 1 ตัวเท่านั้น และทุกแพ็กเกจจะต้องมีเครตอย่างน้อย 1 ตัวเสมอ ไม่ว่าจะเป็นเครตไลบรารีหรือเครตไบนารีก็ตาม
ลองมาดูสิ่งที่จะเกิดขึ้นเมื่อเราสร้างแพ็กเกจใหม่ขึ้นมา เริ่มแรก ให้เราป้อนคำสั่ง cargo new my-project:
$ cargo new my-project
Created binary (application) `my-project` package
$ ls my-project
Cargo.toml
src
$ ls my-project/src
main.rs
หลังจากเรารันคำสั่ง cargo new my-project แล้ว เราลองใช้คำสั่ง ls เพื่อดูสิ่งที่ Cargo สร้างขึ้นมาให้ ในไดเรกทอรี my-project จะมีไฟล์ Cargo.toml ซึ่งแสดงถึงการเป็นแพ็กเกจ นอกจากนี้ยังมีไดเรกทอรี src ที่บรรจุไฟล์ main.rs อยู่ภายใน หากคุณลองเปิดไฟล์ Cargo.toml ในโปรแกรมแก้ไขข้อความ คุณจะสังเกตเห็นว่าไม่มีส่วนใดเลยที่กล่าวถึงไฟล์ src/main.rs นั่นเป็นเพราะ Cargo มีข้อตกลงร่วมกัน (convention) ว่าไฟล์ src/main.rs คือรากของเครต (crate root) สำหรับเครตไบนารีที่มีชื่อเดียวกับชื่อแพ็กเกจ และในทำนองเดียวกัน Cargo ก็รับรู้อยู่แล้วว่า หากภายในไดเรกทอรีของแพ็กเกจมีไฟล์ src/lib.rs อยู่ แพ็กเกจนั้นก็จะมีเครตไลบรารีที่มีชื่อเดียวกับแพ็กเกจ โดยมีไฟล์ src/lib.rs ทำหน้าที่เป็นรากของเครต โดย Cargo จะเป็นผู้ส่งไฟล์รากของเครตเหล่านี้ไปให้ rustc ทำการบิลด์เป็นไลบรารีหรือไบนารีต่อไป
ในตัวอย่างนี้ เรามีแพ็กเกจที่บรรจุเพียงแค่ไฟล์ src/main.rs ซึ่งหมายความว่ามันมีเพียงเครตไบนารีชื่อ my-project ตัวเดียวเท่านั้น แต่หากแพ็กเกจใดมีทั้งไฟล์ src/main.rs และ src/lib.rs แพ็กเกจนั้นก็จะมีเครต 2 ตัว คือเครตไบนารีและเครตไลบรารี ซึ่งทั้งสองจะมีชื่อเดียวกับชื่อแพ็กเกจ นอกจากนี้ แพ็กเกจยังสามารถมีเครตไบนารีได้หลายตัว โดยการนำไฟล์ซอร์สโค้ดไปวางไว้ในไดเรกทอรี src/bin ซึ่งไฟล์แต่ละไฟล์ที่อยู่ในนั้นจะกลายเป็นเครตไบนารีแยกต่างหากแต่ละตัวทันที
ควบคุมสโคปและความเป็นส่วนตัวด้วยมอดูล
ควบคุมสโคปและความเป็นส่วนตัวด้วยมอดูล
ในหัวข้อนี้ เราจะมาพูดคุยเกี่ยวกับมอดูล (modules) รวมถึงองค์ประกอบอื่นๆ ในระบบมอดูล ได้แก่ พาธ (paths) ซึ่งช่วยให้เราสามารถระบุชื่อเพื่ออ้างอิงถึงไอเทมต่างๆ ได้, คีย์เวิร์ด use ซึ่งทำหน้าที่นำพาธเข้ามาไว้ในสโคป (scope) และคีย์เวิร์ด pub ที่ใช้กำหนดให้ไอเทมเปิดเผยเป็นสาธารณะ (public) นอกจากนี้ เรายังจะได้เรียนรู้เกี่ยวกับคีย์เวิร์ด as, การใช้งานแพ็กเกจภายนอก และตัวดำเนินการแบบ glob (*)
แผ่นสรุปมอดูล
ก่อนที่เราจะเจาะลึกในรายละเอียดของมอดูลและพาธ เราได้เตรียมคู่มือสรุปฉบับย่อเกี่ยวกับหลักการทำงานของมอดูล, พาธ, คีย์เวิร์ด use และคีย์เวิร์ด pub ในมุมมองของคอมไพเลอร์ รวมถึงแนวทางที่นักพัฒนาส่วนใหญ่นิยมใช้จัดโครงสร้างโค้ดเอาไว้ให้ แม้ว่าเราจะค่อยๆ ทยอยอธิบายตัวอย่างของแต่ละกฎเกณฑ์ตลอดทั้งบทนี้ แต่หัวข้อนี้ก็ถือเป็นจุดอ้างอิงที่ดีเยี่ยมสำหรับกลับมาทบทวนการทำงานของมอดูลในภายหลัง
- เริ่มต้นจากรากของเครต (Start from the crate root): ในการคอมไพล์เครต คอมไพเลอร์จะเริ่มต้นค้นหาโค้ดจากไฟล์รากของเครตเป็นอันดับแรกเสมอ (โดยปกติคือไฟล์ src/lib.rs สำหรับเครตไลบรารี และ src/main.rs สำหรับเครตไบนารี)
- การประกาศมอดูล (Declaring modules): ในไฟล์รากของเครต คุณสามารถประกาศมอดูลใหม่ๆ ขึ้นมาได้ เช่น หากคุณประกาศมอดูล “garden” ด้วยคำสั่ง
mod garden;ตัวคอมไพเลอร์จะมองหาโค้ดของมอดูลนั้นตามตำแหน่งต่างๆ ดังนี้:- เขียนแบบอินไลน์ (inline) ภายในวงเล็บปีกกาที่เขียนแทนเครื่องหมายอัฒภาค (semicolon) ต่อท้าย
mod garden - ในไฟล์ src/garden.rs
- ในไฟล์ src/garden/mod.rs (รูปแบบเก่าที่ยังคงรองรับ)
- เขียนแบบอินไลน์ (inline) ภายในวงเล็บปีกกาที่เขียนแทนเครื่องหมายอัฒภาค (semicolon) ต่อท้าย
- การประกาศมอดูลย่อย (Declaring submodules): ภายในไฟล์อื่นๆ ที่ไม่ใช่ไฟล์รากของเครต คุณสามารถประกาศมอดูลย่อย (submodules) ได้ เช่น คุณอาจประกาศ
mod vegetables;ไว้ในไฟล์ src/garden.rs ตัวคอมไพเลอร์จะมองหาโค้ดของมอดูลย่อยดังกล่าวภายในไดเรกทอรีที่ตั้งชื่อตามมอดูลแม่ ในตำแหน่งต่างๆ ดังนี้:- เขียนแบบอินไลน์ ต่อท้าย
mod vegetablesภายในวงเล็บปีกกาแทนการใช้อัฒภาค - ในไฟล์ src/garden/vegetables.rs
- ในไฟล์ src/garden/vegetables/mod.rs (รูปแบบเก่าที่ยังคงรองรับ)
- เขียนแบบอินไลน์ ต่อท้าย
- พาธสำหรับอ้างถึงโค้ดในมอดูล (Paths to code in modules): เมื่อมอดูลใดถูกรวมเข้าเป็นส่วนหนึ่งของเครตแล้ว คุณสามารถอ้างอิงถึงโค้ดในมอดูลนั้นจากจุดใดก็ได้ภายในเครตเดียวกัน ตราบใดที่กฎการเข้าถึง (privacy rules) อนุญาต โดยใช้พาธที่ชี้ไปยังโค้ดนั้น เช่น ชนิดข้อมูล
Asparagusในมอดูลย่อย garden vegetables สามารถอ้างอิงผ่านพาธcrate::garden::vegetables::Asparagus - สถานะส่วนตัวเทียบกับสาธารณะ (Private vs. public): โค้ดที่อยู่ภายในมอดูลจะมีสถานะเป็นแบบส่วนตัว (private) จากมอดูลแม่โดยปริยาย หากต้องการเปิดให้มอดูลเข้าถึงได้จากภายนอก จะต้องประกาศด้วย
pub modแทนที่จะเป็นmodธรรมดา และหากต้องการเปิดให้ไอเทมที่อยู่ภายในมอดูลสาธารณะนั้นเป็นสาธารณะด้วย ก็จะต้องเติมคีย์เวิร์ดpubไว้ข้างหน้าการประกาศไอเทมเหล่านั้นด้วยเช่นกัน - คีย์เวิร์ด
use: ภายในสโคปใดๆ คีย์เวิร์ดuseจะช่วยสร้างทางลัดไปยังไอเทมต่างๆ เพื่อลดความซ้ำซ้อนในการพิมพ์พาธที่ยาว ในสโคปใดก็ตามที่สามารถอ้างถึงcrate::garden::vegetables::Asparagusได้ คุณสามารถสร้างทางลัดขึ้นมาได้ด้วยคำสั่งuse crate::garden::vegetables::Asparagus;และหลังจากนั้น คุณก็เพียงแค่เขียนชื่อAsparagusสั้นๆ เพื่อเรียกใช้งานชนิดข้อมูลนั้นในสโคปได้ทันที
ในตัวอย่างนี้ เราได้สร้างเครตไบนารีชื่อ backyard ขึ้นมาเพื่อสาธิตกฎเหล่านี้ โดยไดเรกทอรีของเครต ซึ่งมีชื่อว่า backyard เช่นกัน ประกอบด้วยโครงสร้างไฟล์และโฟลเดอร์ดังต่อไปนี้:
backyard
├── Cargo.lock
├── Cargo.toml
└── src
├── garden
│ └── vegetables.rs
├── garden.rs
└── main.rs
ไฟล์รากของเครตในกรณีนี้คือ src/main.rs ซึ่งมีเนื้อหาดังนี้:
use crate::garden::vegetables::Asparagus;
pub mod garden;
fn main() {
let plant = Asparagus {};
println!("I'm growing {plant:?}!");
}บรรทัด pub mod garden; เป็นการสั่งให้คอมไพเลอร์นำโค้ดที่พบในไฟล์ src/garden.rs มารวมเข้าด้วยกัน ซึ่งไฟล์ดังกล่าวมีเนื้อหาคือ:
pub mod vegetables;ในไฟล์นี้ คำสั่ง pub mod vegetables; หมายถึงการนำโค้ดในไฟล์ src/garden/vegetables.rs เข้ามารวมด้วยเช่นกัน ซึ่งโค้ดในไฟล์นั้นมีดังนี้:
#[derive(Debug)]
pub struct Asparagus {}คราวนี้ เราลองมาเจาะลึกรายละเอียดของกฎเกณฑ์เหล่านี้ และดูการนำไปประยุกต์ใช้งานจริงกัน!
การจัดกลุ่มโค้ดที่เกี่ยวข้องไว้ในมอดูล
มอดูล (Modules) ช่วยให้เราสามารถจัดระเบียบโครงสร้างโค้ดภายในเครตให้อ่านเข้าใจง่ายและนำกลับมาใช้ซ้ำได้อย่างสะดวก นอกจากนี้ มอดูลยังช่วยให้เราควบคุม_ระดับการเข้าถึง (privacy)_ ของไอเทมต่างๆ ได้ เนื่องจากโค้ดทั้งหมดที่อยู่ภายในมอดูลจะมีสถานะเป็นแบบส่วนตัว (private) โดยปริยาย ซึ่งไอเทมส่วนตัวเหล่านี้ถือเป็นรายละเอียดการทำงานภายในที่ไม่เปิดให้โค้ดภายนอกเรียกใช้งาน แต่เราสามารถเลือกกำหนดให้มอดูลและไอเทมภายในเป็นสาธารณะ (public) ได้ เพื่อเปิดให้โค้ดจากภายนอกสามารถเรียกใช้และพึ่งพาพวกมันได้
ตัวอย่างเช่น เราลองมาเขียนเครตไลบรารีที่จำลองระบบการทำงานของร้านอาหารกัน โดยเราจะนิยามเฉพาะโครงสร้างซิกเนเจอร์ (signatures) ของฟังก์ชันไว้ และปล่อยให้เนื้อในของฟังก์ชันว่างเปล่า เพื่อมุ่งเน้นไปที่การจัดระเบียบโครงสร้างโค้ดเป็นหลัก มากกว่าการลงรายละเอียดการทำงานจริงของร้านอาหาร
ในธุรกิจร้านอาหาร เรามักจะแบ่งพื้นที่ออกเป็นสองส่วนหลักคือ หน้าร้าน (front of house) และหลังร้าน (back of house) ส่วน หน้าร้าน (Front of house) คือบริเวณที่ลูกค้าอยู่ ครอบคลุมถึงจุดที่พนักงานต้อนรับพาไปนั่งโต๊ะ, พนักงานเสิร์ฟรับออร์เดอร์และคิดเงิน ตลอดจนบาร์เทนเดอร์ชงเครื่องดื่ม ส่วน หลังร้าน (Back of house) คือบริเวณที่เชฟและกุ๊กปรุงอาหารอยู่ในครัว, พนักงานล้างจานทำความสะอาด และผู้จัดการดูแลงานเอกสารธุรการ
ในการวางโครงสร้างเครตตามแนวคิดนี้ เราสามารถจัดฟังก์ชันต่างๆ แยกเป็นมอดูลที่ซ้อนกันอยู่ได้ เริ่มต้นด้วยการสร้างไลบรารีใหม่ชื่อ restaurant โดยสั่งรันคำสั่ง cargo new restaurant --lib จากนั้นให้ใส่โค้ดในลิสติ้ง 7-1 ลงในไฟล์ src/lib.rs เพื่อนิยามมอดูลและซิกเนเจอร์ของฟังก์ชันต่างๆ ซึ่งโค้ดชุดนี้จะแทนส่วนการทำงานของหน้าร้าน
mod front_of_house {
mod hosting {
fn add_to_waitlist() {}
fn seat_at_table() {}
}
mod serving {
fn take_order() {}
fn serve_order() {}
fn take_payment() {}
}
}เรานิยามมอดูลด้วยคำสงวน mod ตามด้วยชื่อของมอดูล (ในกรณีนี้คือ front_of_house) ส่วนเนื้อหาของมอดูลจะอยู่ภายในเครื่องหมายปีกกา ภายในมอดูลเราสามารถวางมอดูลอื่นซ้อนไว้ได้ ดังในกรณีนี้ที่มีมอดูล hosting และ serving นอกจากนี้ ภายในมอดูลยังสามารถบรรจุนิยามของไอเทมอื่นๆ ได้อีกด้วย เช่น struct, enum, ค่าคงที่ (constant), เทรต (trait) และฟังก์ชันดังที่เห็นในลิสติ้ง 7-1
การใช้มอดูลช่วยให้เราสามารถจัดกลุ่มนิยามที่เกี่ยวข้องกันเข้าไว้ด้วยกัน และตั้งชื่อที่สื่อความหมายถึงความเชื่อมโยงนั้นได้อย่างชัดเจน นักพัฒนาคนอื่นๆ ที่นำโค้ดนี้ไปใช้จะสามารถทำความเข้าใจและไล่ดูโค้ดตามหมวดหมู่ได้สะดวกขึ้น แทนที่จะต้องกวาดสายตาอ่านนิยามทั้งหมด ทำให้ค้นหาสิ่งที่ต้องการได้รวดเร็ว และผู้ที่จะเพิ่มความสามารถใหม่ๆ เข้ามาในโค้ดชุดนี้ ก็จะทราบได้ทันทีว่าควรวางโค้ดไว้ที่จุดใดเพื่อให้โปรแกรมยังคงเป็นระเบียบเรียบร้อย
ก่อนหน้านี้ เราได้เกริ่นไว้ว่า src/main.rs และ src/lib.rs เรียกว่า รากของเครต (crate roots) เหตุผลที่เรียกเช่นนี้ก็เพราะว่า เนื้อหาของไฟล์ใดไฟล์หนึ่งในสองไฟล์นี้จะรวมกันเป็นมอดูลชื่อ crate ซึ่งทำหน้าที่เป็นรากฐานของโครงสร้างมอดูลทั้งหมดในเครต เรียกว่า แผนผังมอดูล (module tree)
ลิสติ้ง 7-2 แสดงแผนผังมอดูลสำหรับโครงสร้างในลิสติ้ง 7-1
crate
└── front_of_house
├── hosting
│ ├── add_to_waitlist
│ └── seat_at_table
└── serving
├── take_order
├── serve_order
└── take_payment
แผนผังนี้แสดงให้เห็นว่ามอดูลบางตัวซ้อนอยู่ภายในมอดูลอื่นอย่างไร ตัวอย่างเช่น hosting ซ้อนอยู่ภายใน front_of_house และยังแสดงว่ามอดูลบางตัวเป็น_มอดูลระดับเดียวกันหรือพี่น้อง_ (siblings) ซึ่งหมายถึงมอดูลที่นิยามอยู่ภายในมอดูลแม่เดียวกัน โดย hosting และ serving ถือเป็นมอดูลระดับเดียวกันที่นิยามไว้ภายใน front_of_house หากมอดูล A ซ้อนอยู่ภายในมอดูล B เราจะเรียกว่ามอดูล A เป็น_มอดูลลูก_ (child) ของมอดูล B และมอดูล B เป็น_มอดูลแม่_ (parent) ของมอดูล A สังเกตได้ว่าแผนผังมอดูลทั้งหมดจะมีจุดเริ่มต้นหรือรากฐานอยู่ภายใต้มอดูลโดยปริยายที่มีชื่อว่า crate
แผนผังมอดูลนี้อาจทำให้คุณนึกถึงโครงสร้างโฟลเดอร์หรือไดเรกทอรีในระบบไฟล์บนคอมพิวเตอร์ ซึ่งเป็นการเปรียบเทียบที่เห็นภาพได้อย่างชัดเจนทีเดียว! เช่นเดียวกับไดเรกทอรีในระบบไฟล์ เราใช้มอดูลเพื่อจัดระเบียบโครงสร้างของโค้ด และเช่นเดียวกับไฟล์ในไดเรกทอรี เราจำเป็นต้องมีวิธีการระบุตำแหน่งเพื่อเข้าถึงมอดูลเหล่านั้นด้วย
พาธสำหรับอ้างถึงรายการในแผนผังมอดูล
พาธสำหรับอ้างถึงรายการในแผนผังมอดูล
เพื่อที่จะบอกให้ Rust รู้ว่าจะค้นหาไอเทมใดๆ ในต้นไม้มอดูล (module tree) ได้จากที่ไหน เราจะใช้สิ่งที่เรียกว่า พาธ (path) ในลักษณะเดียวกับที่เราใช้พาธในการค้นหาไฟล์ในระบบไฟล์ของคอมพิวเตอร์ และหากเราต้องการเรียกใช้งานฟังก์ชันใดๆ เราก็จำเป็นต้องรู้พาธที่ชี้ไปยังฟังก์ชันนั้นเสียก่อน
พาธใน Rust สามารถเขียนได้ 2 รูปแบบ ได้แก่:
- พาธแบบสัมบูรณ์ (Absolute path): คือพาธแบบเต็มที่เริ่มต้นนับจากรากของเครต (crate root) สำหรับโค้ดที่มาจากเครตภายนอก พาธแบบสัมบูรณ์จะขึ้นต้นด้วยชื่อของเครตนั้นๆ ส่วนโค้ดที่อยู่ภายในเครตปัจจุบัน พาธจะขึ้นต้นด้วยคำว่า
crateเสมอ - พาธแบบสัมพัทธ์ (Relative path): คือพาธที่เริ่มต้นนับจากมอดูลปัจจุบัน โดยจะขึ้นต้นด้วย
self,superหรือชื่อของไอเทมที่อยู่ในมอดูลปัจจุบัน
ทั้งพาธแบบสัมบูรณ์และพาธแบบสัมพัทธ์จะตามด้วยตัวระบุชื่อไอเทมหนึ่งตัวขึ้นไป โดยคั่นด้วยเครื่องหมายโคลอนคู่ (::)
ย้อนกลับไปดูในลิสติ้ง 7-1 สมมติว่าเราต้องการเรียกใช้งานฟังก์ชัน add_to_waitlist นั่นก็เหมือนกับการตั้งคำถามว่า: พาธของฟังก์ชัน add_to_waitlist คืออะไร? ลิสติ้ง 7-3 ด้านล่างนี้คือโค้ดจากลิสติ้ง 7-1 ที่เราได้ตัดมอดูลและฟังก์ชันบางส่วนออกไปเพื่อให้เห็นภาพชัดเจนขึ้น
เราจะมาแสดงให้ดู 2 วิธีในการเรียกใช้ฟังก์ชัน add_to_waitlist จากฟังก์ชันใหม่ชื่อ eat_at_restaurant ซึ่งนิยามไว้ที่รากของเครต ทั้งสองพาธนี้เป็นพาธที่ถูกต้องตามหลักไวยากรณ์ แต่ยังมีปัญหาอีกประการหนึ่งที่ทำให้โค้ดตัวอย่างนี้ยังคอมไพล์ไม่ผ่านในตอนนี้ ซึ่งเราจะมาอธิบายเหตุผลกันในอีกสักครู่
ฟังก์ชัน eat_at_restaurant ถือเป็นส่วนหนึ่งของ API สาธารณะ (public API) ของเครตไลบรารีของเรา เราจึงกำกับไว้ด้วยคีย์เวิร์ด pub ซึ่งในหัวข้อ “การเปิดเผยพาธด้วยคำสงวน pub” เราจะมาลงลึกในรายละเอียดเกี่ยวกับ pub กันต่อไป
mod front_of_house {
mod hosting {
fn add_to_waitlist() {}
}
}
pub fn eat_at_restaurant() {
// Absolute path
crate::front_of_house::hosting::add_to_waitlist();
// Relative path
front_of_house::hosting::add_to_waitlist();
}การเรียกฟังก์ชัน add_to_waitlist ครั้งแรกใน eat_at_restaurant เราใช้พาธแบบสัมบูรณ์ เนื่องจากฟังก์ชัน add_to_waitlist ถูกนิยามไว้ในเครตเดียวกับ eat_at_restaurant เราจึงสามารถใช้คีย์เวิร์ด crate เป็นจุดเริ่มต้นของพาธแบบสัมบูรณ์ได้ จากนั้นเราจะระบุชื่อมอดูลแต่ละชั้นไล่เรียงกันไปเรื่อยๆ จนกระทั่งถึง add_to_waitlist คุณสามารถจินตนาการเปรียบเทียบกับระบบไฟล์ที่มีโครงสร้างแบบเดียวกันได้: นั่นคือเราจะระบุพาธเป็น /front_of_house/hosting/add_to_waitlist เพื่อสั่งรันโปรแกรม add_to_waitlist การใช้คำว่า crate เพื่อเริ่มต้นจากรากของเครต จึงเปรียบเสมือนการใช้เครื่องหมาย / เพื่อเริ่มต้นจากรากของระบบไฟล์ (root directory) ในเชลล์นั่นเอง
ส่วนการเรียกฟังก์ชัน add_to_waitlist ครั้งที่สองใน eat_at_restaurant เราเปลี่ยนมาใช้พาธแบบสัมพัทธ์ โดยพาธนี้จะเริ่มต้นด้วย front_of_house ซึ่งเป็นชื่อของมอดูลที่ถูกนิยามไว้ในระดับเดียวกันกับ eat_at_restaurant ในต้นไม้มอดูล หากเทียบเคียงกับระบบไฟล์ก็คือการใช้พาธ front_of_house/hosting/add_to_waitlist การเริ่มต้นด้วยชื่อมอดูลโดยตรงจึงบ่งบอกว่าพาธนั้นเป็นพาธแบบสัมพัทธ์
การตัดสินใจว่าจะเลือกใช้พาธแบบสัมพัทธ์หรือแบบสัมบูรณ์นั้นขึ้นอยู่กับการออกแบบโปรเจกต์ของคุณ และขึ้นอยู่กับว่า ในอนาคตคุณมีแนวโน้มที่จะย้ายโค้ดส่วนที่นิยามไอเทมแยกขาดจากกัน หรือย้ายไปพร้อมกันกับโค้ดส่วนที่เรียกใช้ไอเทมนั้นมากกว่า ตัวอย่างเช่น หากเราย้ายมอดูล front_of_house และฟังก์ชัน eat_at_restaurant ไปไว้ด้วยกันในมอดูลใหม่ชื่อ customer_experience เราจะต้องปรับแก้พาธแบบสัมบูรณ์ไปยัง add_to_waitlist แต่พาธแบบสัมพัทธ์จะยังคงใช้งานได้เหมือนเดิมโดยไม่ต้องแก้ไขใดๆ ในทางกลับกัน หากเราย้ายเฉพาะฟังก์ชัน eat_at_restaurant แยกออกไปไว้ในมอดูลชื่อ dining พาธแบบสัมบูรณ์ที่เรียกไปยัง add_to_waitlist จะยังคงเหมือนเดิมทุกประการ แต่พาธแบบสัมพัทธ์จะต้องได้รับการอัปเดต โดยทั่วไปแล้ว เรามักนิยมใช้พาธแบบสัมบูรณ์มากกว่า เพราะมีความเป็นไปได้สูงกว่าที่เราอาจต้องการย้ายนิยามของโค้ดและส่วนที่เรียกใช้งานไอเทมอย่างเป็นอิสระต่อกัน
ลองมาคอมไพล์โค้ดในลิสติ้ง 7-3 เพื่อดูว่าทำไมมันจึงยังคอมไพล์ไม่ผ่านกัน! ข้อผิดพลาดที่คอมไพเลอร์รายงานออกมาแสดงไว้ในลิสติ้ง 7-4
$ cargo build
Compiling restaurant v0.1.0 (file:///projects/restaurant)
error[E0603]: module `hosting` is private
--> src/lib.rs:9:28
|
9 | crate::front_of_house::hosting::add_to_waitlist();
| ^^^^^^^ --------------- function `add_to_waitlist` is not publicly re-exported
| |
| private module
|
note: the module `hosting` is defined here
--> src/lib.rs:2:5
|
2 | mod hosting {
| ^^^^^^^^^^^
error[E0603]: module `hosting` is private
--> src/lib.rs:12:21
|
12 | front_of_house::hosting::add_to_waitlist();
| ^^^^^^^ --------------- function `add_to_waitlist` is not publicly re-exported
| |
| private module
|
note: the module `hosting` is defined here
--> src/lib.rs:2:5
|
2 | mod hosting {
| ^^^^^^^^^^^
For more information about this error, try `rustc --explain E0603`.
error: could not compile `restaurant` (lib) due to 2 previous errors
ข้อความแสดงข้อผิดพลาดระบุว่า มอดูล hosting เป็นแบบส่วนตัว (private) กล่าวอีกนัยหนึ่งคือ เราเขียนพาธชี้ไปยังมอดูล hosting และฟังก์ชัน add_to_waitlist ได้ถูกต้องแล้ว แต่ Rust ไม่อนุญาตให้เราเรียกใช้งาน เพราะเราไม่มีสิทธิ์เข้าถึงส่วนที่เป็นการทำงานภายในแบบส่วนตัว โดยในภาษา Rust นั้น ทุกไอเทม (ไม่ว่าจะเป็นฟังก์ชัน, เมธอด, struct, enum, มอดูล ตลอดจนค่าคงที่) จะมีสถานะเป็นแบบส่วนตัว (private) ต่อมอดูลแม่โดยปริยายเสมอ หากคุณต้องการทำให้ไอเทมใดๆ มีสถานะเป็นส่วนตัว คุณก็เพียงแค่นำมันไปวางไว้ภายในมอดูล
ไอเทมที่อยู่ในมอดูลแม่จะไม่สามารถเรียกใช้ไอเทมที่เป็นแบบส่วนตัวที่อยู่ภายในมอดูลลูกได้ แต่ไอเทมในมอดูลลูกจะสามารถเข้าถึงและเรียกใช้ไอเทมที่อยู่ในมอดูลบรรพบุรุษ (ancestor modules) ของมันได้เสมอ สาเหตุที่เป็นเช่นนี้ก็เพราะว่ามอดูลลูกทำหน้าที่ห่อหุ้มและซ่อนรายละเอียดการทำงานภายในเอาไว้ แต่มอดูลลูกเองสามารถมองเห็นบริบทแวดล้อมที่มันถูกนิยามขึ้นมาได้ หากเปรียบเทียบกับภาพร้านอาหารเดิม ก็เหมือนกับห้องทำงานส่วนตัวของผู้จัดการร้าน: ลูกค้าทั่วไปไม่มีสิทธิ์เข้าไปยุ่มย่ามภายในห้องนั้น แต่ผู้จัดการร้านที่อยู่ในห้องสามารถมองเห็นและทำทุกอย่างในร้านอาหารที่ตนเองดูแลได้ทั้งหมด
Rust เลือกออกแบบให้ระบบมอดูลทำงานในลักษณะนี้ เพื่อให้การซ่อนรายละเอียดการทำงานภายในเป็นค่าเริ่มต้นโดยอัตโนมัติ ซึ่งจะช่วยให้คุณรู้ได้อย่างมั่นใจว่า โค้ดส่วนภายในจุดใดบ้างที่คุณสามารถปรับปรุงแก้ไขได้โดยไม่ต้องกังวลว่าจะส่งผลกระทบทำให้โค้ดภายนอกพังเสียหาย อย่างไรก็ตาม Rust ก็ยังเปิดโอกาสให้คุณเปิดเผยส่วนการทำงานภายในของมอดูลลูกให้มอดูลบรรพบุรุษภายนอกเข้าถึงได้ โดยการใช้คีย์เวิร์ด pub เพื่อกำหนดให้ไอเทมนั้นกลายเป็นสาธารณะ (public)
การเปิดเผยพาธด้วยคำสงวน pub
กลับมาดูข้อผิดพลาดในลิสติ้ง 7-4 ที่แจ้งว่ามอดูล hosting เป็นแบบส่วนตัว ในกรณีนี้เราต้องการให้ฟังก์ชัน eat_at_restaurant ซึ่งอยู่ในมอดูลแม่สามารถเข้าถึงฟังก์ชัน add_to_waitlist ที่อยู่ในมอดูลลูกได้ เราจึงใส่คีย์เวิร์ด pub หน้ามอดูล hosting ดังที่แสดงในลิสติ้ง 7-5
mod front_of_house {
pub mod hosting {
fn add_to_waitlist() {}
}
}
// -- snip --
pub fn eat_at_restaurant() {
// Absolute path
crate::front_of_house::hosting::add_to_waitlist();
// Relative path
front_of_house::hosting::add_to_waitlist();
}แต่น่าเสียดายที่โค้ดในลิสติ้ง 7-5 ก็ยังคงคอมไพล์ไม่ผ่านอยู่ดี ดังข้อผิดพลาดที่แสดงในลิสติ้ง 7-6
$ cargo build
Compiling restaurant v0.1.0 (file:///projects/restaurant)
error[E0603]: function `add_to_waitlist` is private
--> src/lib.rs:10:37
|
10 | crate::front_of_house::hosting::add_to_waitlist();
| ^^^^^^^^^^^^^^^ private function
|
note: the function `add_to_waitlist` is defined here
--> src/lib.rs:3:9
|
3 | fn add_to_waitlist() {}
| ^^^^^^^^^^^^^^^^^^^^
error[E0603]: function `add_to_waitlist` is private
--> src/lib.rs:13:30
|
13 | front_of_house::hosting::add_to_waitlist();
| ^^^^^^^^^^^^^^^ private function
|
note: the function `add_to_waitlist` is defined here
--> src/lib.rs:3:9
|
3 | fn add_to_waitlist() {}
| ^^^^^^^^^^^^^^^^^^^^
For more information about this error, try `rustc --explain E0603`.
error: could not compile `restaurant` (lib) due to 2 previous errors
เกิดอะไรขึ้นกันแน่? การเติมคีย์เวิร์ด pub ไว้หน้า mod hosting ทำให้มอดูลกลายเป็นสาธารณะก็จริง ซึ่งช่วยให้เราสามารถเข้าถึง hosting ได้หากเราเข้าถึง front_of_house ได้แล้ว แต่_เนื้อหาภายใน_ของ hosting ยังคงมีสถานะเป็นแบบส่วนตัวอยู่ดี! การทำให้มอดูลเป็นสาธารณะไม่ได้ส่งผลให้ไอเทมข้างในกลายเป็นสาธารณะตามไปด้วย คีย์เวิร์ด pub บนตัวมอดูลเพียงแค่อนุญาตให้โค้ดในมอดูลบรรพบุรุษสามารถอ้างอิงถึงตัวมอดูลนั้นได้เท่านั้น แต่ยังไม่ให้สิทธิ์เข้าถึงเนื้อหาข้างใน และเนื่องจากมอดูลทำหน้าที่เป็นเพียงกล่องบรรจุ การเปิดมอดูลให้เป็นสาธารณะเพียงอย่างเดียวจึงยังทำอะไรไม่ได้มากนัก เราจำเป็นต้องลงลึกไปอีกขั้นด้วยการเลือกกำหนดให้ไอเทมภายในมอดูลนั้นเป็นสาธารณะด้วยเช่นกัน
ข้อความผิดพลาดในลิสติ้ง 7-6 ระบุชัดเจนว่า ฟังก์ชัน add_to_waitlist เป็นแบบส่วนตัว เพราะกฎเรื่องการเข้าถึง (privacy rules) จะบังคับใช้กับทั้ง struct, enum, ฟังก์ชัน, เมธอด รวมถึงตัวมอดูลเองอย่างเท่าเทียมกัน
ดังนั้น เรามาทำให้ฟังก์ชัน add_to_waitlist เป็นสาธารณะด้วยการเติมคีย์เวิร์ด pub ไว้หน้าคำประกาศฟังก์ชันกัน ดังแสดงในลิสติ้ง 7-7
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
// -- snip --
pub fn eat_at_restaurant() {
// Absolute path
crate::front_of_house::hosting::add_to_waitlist();
// Relative path
front_of_house::hosting::add_to_waitlist();
}คราวนี้โค้ดก็สามารถคอมไพล์ผ่านได้อย่างสมบูรณ์! เพื่อให้เห็นภาพชัดเจนขึ้นว่าเหตุใดการเติมคีย์เวิร์ด pub จึงทำให้เราเรียกใช้พาธเหล่านี้ใน eat_at_restaurant ได้โดยถูกต้องตามกฎการเข้าถึง เราลองมาพิจารณาทีละขั้นตอนทั้งพาธแบบสัมบูรณ์และแบบสัมพัทธ์กัน
สำหรับพาธแบบสัมบูรณ์ เราเริ่มต้นจาก crate ซึ่งเป็นรากของต้นไม้มอดูลในเครตของเรา มอดูล front_of_house ถูกนิยามขึ้นที่รากของเครตนี้ และแม้ว่า front_of_house จะไม่ได้เปิดเป็นสาธารณะ แต่เนื่องจากฟังก์ชัน eat_at_restaurant ถูกนิยามอยู่ในมอดูลระดับเดียวกันกับ front_of_house (นั่นคือ eat_at_restaurant และ front_of_house เป็นมอดูลพี่น้องกัน) เราจึงมีสิทธิ์อ้างอิงถึง front_of_house จาก eat_at_restaurant ได้ ถัดมาคือมอดูล hosting ซึ่งถูกทำเครื่องหมายด้วย pub เอาไว้ และเนื่องจากเราสามารถเข้าถึงมอดูลแม่ของ hosting ได้ เราจึงเข้าถึงตัว hosting ได้ด้วยเช่นกัน และสุดท้ายคือฟังก์ชัน add_to_waitlist ซึ่งถูกทำเครื่องหมายด้วย pub ไว้เช่นกัน และเราก็เข้าถึงมอดูลแม่ของมันได้ การเรียกใช้งานฟังก์ชันผ่านพาธแบบสัมบูรณ์นี้จึงทำงานได้อย่างถูกต้องสมบูรณ์!
ส่วนพาธแบบสัมพัทธ์ ตรรกะการทำงานก็เหมือนกับพาธแบบสัมบูรณ์ทุกประการ ยกเว้นเพียงขั้นตอนแรก: พาธนี้ไม่ได้เริ่มต้นจากรากของเครต แต่เริ่มต้นจาก front_of_house ทันที และเนื่องจากมอดูล front_of_house นิยามอยู่ในมอดูลระดับเดียวกับ eat_at_restaurant พาธแบบสัมพัทธ์ที่เริ่มจากจุดที่ eat_at_restaurant นิยามอยู่จึงใช้งานได้ และต่อจากนั้น ด้วยความที่ทั้ง hosting และ add_to_waitlist ต่างถูกกำกับไว้ด้วย pub ส่วนที่เหลือของพาธจึงถูกต้อง และส่งผลให้การเรียกใช้ฟังก์ชันนี้สำเร็จลุล่วงด้วยดี!
หากคุณวางแผนที่จะแบ่งปันเครตไลบรารีของคุณเพื่อให้โปรเจกต์อื่นๆ นำโค้ดไปใช้งาน ตัว public API ของคุณก็เปรียบเสมือนพันธสัญญา (contract) ระหว่างคุณกับผู้ใช้งานเครต ซึ่งเป็นตัวกำหนดว่าพวกเขาจะสามารถมีปฏิสัมพันธ์กับโค้ดของคุณได้อย่างไรบ้าง และยังมีข้อควรคำนึงอีกมากมายเกี่ยวกับการจัดการความเปลี่ยนแปลงที่จะเกิดขึ้นกับ public API เพื่อให้ผู้ใช้งานสามารถพึ่งพาเครตของคุณได้อย่างราบรื่น ซึ่งเรื่องเหล่านี้อยู่นอกเหนือขอบเขตของหนังสือเล่มนี้ หากคุณสนใจในหัวข้อนี้ สามารถศึกษาเพิ่มเติมได้ที่ แนวทางปฏิบัติสำหรับ API ของ Rust
แนวปฏิบัติที่ดีสำหรับแพ็กเกจที่มีทั้งไบนารีและไลบรารี
เราได้กล่าวไปแล้วว่า แพ็กเกจหนึ่งๆ สามารถมีได้ทั้งรากของเครตไบนารีใน src/main.rs และรากของเครตไลบรารีใน src/lib.rs โดยค่าเริ่มต้นแล้ว เครตทั้งสองจะมีชื่อเดียวกับชื่อแพ็กเกจ โดยทั่วไป แพ็กเกจที่ใช้รูปแบบการมีทั้งไลบรารีและไบนารีอยู่ร่วมกัน จะเขียนโค้ดในเครตไบนารีไว้เพียงเท่าที่จำเป็นสำหรับการเริ่มต้นโปรแกรมเพื่อไปเรียกใช้ฟังก์ชันที่นิยามไว้ในเครตไลบรารีเท่านั้น วิธีนี้จะช่วยให้โปรเจกต์อื่นๆ สามารถใช้ประโยชน์จากฟังก์ชันการทำงานส่วนใหญ่ของแพ็กเกจได้เต็มที่ เพราะโค้ดในเครตไลบรารีสามารถนำไปแบ่งปันและเรียกใช้ซ้ำได้
โครงสร้างต้นไม้มอดูลควรถูกนิยามไว้ภายในไฟล์ src/lib.rs จากนั้นไอเทมสาธารณะใดๆ ก็สามารถถูกเรียกใช้ในเครตไบนารีได้โดยเขียนพาธเริ่มต้นด้วยชื่อของแพ็กเกจ ส่งผลให้เครตไบนารีกลายเป็นผู้ใช้งานเครตไลบรารีเสมือนเป็นเครตภายนอกตัวหนึ่ง นั่นคือสามารถเรียกใช้ได้เฉพาะ public API เท่านั้น ซึ่งการออกแบบลักษณะนี้จะช่วยให้คุณออกแบบ API ได้ดียิ่งขึ้น เพราะคุณไม่ได้เป็นเพียงแค่ผู้เขียนโค้ดเท่านั้น แต่คุณยังทำหน้าที่เป็นผู้ใช้งานโค้ดของตัวเองไปด้วยในเวลาเดียวกัน!
ใน บทที่ 12 เราจะสาธิตแนวปฏิบัติด้านการจัดโครงสร้างนี้อย่างเป็นรูปธรรมผ่านการสร้างโปรแกรมบรรทัดคำสั่งที่ประกอบด้วยทั้งเครตไบนารีและเครตไลบรารีควบคู่กัน
การเริ่มพาธแบบสัมพัทธ์ด้วย super
เราสามารถสร้างพาธแบบสัมพัทธ์ที่เริ่มต้นจากมอดูลแม่ แทนที่จะเริ่มจากมอดูลปัจจุบันหรือรากของเครตได้ โดยการใส่คำว่า super ไว้ที่จุดเริ่มต้นของพาธ ซึ่งเปรียบเสมือนการเริ่มพาธในระบบไฟล์ด้วยสัญลักษณ์ .. เพื่อถอยกลับไปยังไดเรกทอรีแม่ การใช้ super ช่วยให้เราสามารถอ้างอิงถึงไอเทมที่เรารู้อยู่แล้วว่าอยู่ในมอดูลแม่ ซึ่งจะทำให้การปรับเปลี่ยนโครงสร้างต้นไม้มอดูลในอนาคตทำได้ง่ายขึ้น โดยเฉพาะอย่างยิ่งเมื่อมอดูลลูกมีความสัมพันธ์ใกล้ชิดกับมอดูลแม่ แต่มอดูลแม่นั้นอาจถูกย้ายตำแหน่งไปอยู่ที่อื่นในต้นไม้มอดูลในภายหลัง
ลองพิจารณาโค้ดในลิสติ้ง 7-8 ที่จำลองสถานการณ์ที่เชฟปรุงอาหารผิดแล้วต้องแก้ไขออร์เดอร์นั้น พร้อมกับนำอาหารจานที่แก้ไขแล้วออกไปเสิร์ฟให้ลูกค้าด้วยตัวเอง ฟังก์ชัน fix_incorrect_order ซึ่งนิยามอยู่ในมอดูล back_of_house จะเรียกใช้ฟังก์ชัน deliver_order ที่นิยามอยู่ในมอดูลแม่ โดยระบุพาธไปยัง deliver_order ที่ขึ้นต้นด้วย super
fn deliver_order() {}
mod back_of_house {
fn fix_incorrect_order() {
cook_order();
super::deliver_order();
}
fn cook_order() {}
}ฟังก์ชัน fix_incorrect_order อยู่ภายในมอดูล back_of_house เราจึงใช้ super เพื่อถอยกลับไปยังมอดูลแม่ของ back_of_house ซึ่งในกรณีนี้ก็คือมอดูลราก crate จากจุดนั้น เรามองหาฟังก์ชัน deliver_order แล้วก็พบ สำเร็จ! เราเล็งเห็นว่ามอดูล back_of_house และฟังก์ชัน deliver_order น่าจะยังคงความสัมพันธ์ระหว่างกันเช่นนี้ต่อไป และน่าจะถูกย้ายไปด้วยกันหากในอนาคตเราตัดสินใจปรับโครงสร้างต้นไม้มอดูลของเครตใหม่ การใช้ super จึงช่วยลดจำนวนจุดที่ต้องตามแก้โค้ดลงไปได้ หากโค้ดชุดนี้ถูกย้ายไปอยู่ภายใต้มอดูลอื่นในวันข้างหน้า
การทำให้ struct และ enum เป็นแบบสาธารณะ
เรายังสามารถใช้ pub เพื่อกำหนดให้ struct และ enum กลายเป็นสาธารณะได้เช่นกัน แต่การใช้ pub กับ struct และ enum จะมีรายละเอียดปลีกย่อยเพิ่มเติมเล็กน้อย หากเราใส่ pub ไว้ข้างหน้านิยามของ struct ตัว struct นั้นจะกลายเป็นสาธารณะก็จริง แต่ฟิลด์ต่างๆ ภายใน struct จะยังคงเป็นแบบส่วนตัว (private) อยู่ โดยเราสามารถเลือกกำหนดให้แต่ละฟิลด์เปิดเป็นสาธารณะหรือไม่เป็นแบบรายฟิลด์ได้ ในลิสติ้ง 7-9 เราได้นิยาม struct สาธารณะชื่อ back_of_house::Breakfast โดยกำหนดให้ฟิลด์ toast เป็นสาธารณะ แต่ฟิลด์ seasonal_fruit เป็นแบบส่วนตัว ซึ่งจำลองสถานการณ์ในร้านอาหารที่ลูกค้าสามารถเลือกชนิดของขนมปังปิ้งที่เสิร์ฟพร้อมมื้ออาหารได้ แต่ผลไม้ตามฤดูกาลนั้นเชฟจะเป็นผู้เลือกให้ตามวัตถุดิบที่มีในสต็อกและตามฤดูกาล และเนื่องจากชนิดของผลไม้หมุนเวียนเปลี่ยนแปลงบ่อย ลูกค้าจึงไม่สามารถเลือกผลไม้เองได้ และไม่สามารถมองเห็นล่วงหน้าได้ด้วยซ้ำว่าจะได้ผลไม้ชนิดใด
mod back_of_house {
pub struct Breakfast {
pub toast: String,
seasonal_fruit: String,
}
impl Breakfast {
pub fn summer(toast: &str) -> Breakfast {
Breakfast {
toast: String::from(toast),
seasonal_fruit: String::from("peaches"),
}
}
}
}
pub fn eat_at_restaurant() {
// Order a breakfast in the summer with Rye toast.
let mut meal = back_of_house::Breakfast::summer("Rye");
// Change our mind about what bread we'd like.
meal.toast = String::from("Wheat");
println!("I'd like {} toast please", meal.toast);
// The next line won't compile if we uncomment it; we're not allowed
// to see or modify the seasonal fruit that comes with the meal.
// meal.seasonal_fruit = String::from("blueberries");
}เนื่องจากฟิลด์ toast ใน struct back_of_house::Breakfast เป็นสาธารณะ เราจึงสามารถอ่านและเขียนค่าลงในฟิลด์ toast จากภายในฟังก์ชัน eat_at_restaurant ได้โดยใช้เครื่องหมายจุด (.) แต่โปรดสังเกตว่าเราไม่สามารถเข้าถึงฟิลด์ seasonal_fruit ใน eat_at_restaurant ได้เลย เพราะฟิลด์นั้นเป็นแบบส่วนตัว ลองเปิดคอมเมนต์ในบรรทัดที่พยายามแก้ไขค่าของ seasonal_fruit ดู แล้วคุณจะเห็นข้อผิดพลาดที่คอมไพเลอร์แจ้งเตือนขึ้นมา!
นอกจากนี้ ขอให้สังเกตว่าเนื่องจาก back_of_house::Breakfast มีฟิลด์ที่เป็นส่วนตัว ตัว struct จึงจำเป็นต้องเตรียมฟังก์ชันประจำชนิดข้อมูล (associated function) ที่เป็นสาธารณะขึ้นมาเพื่อใช้สร้างอินสแตนซ์ของ Breakfast (ซึ่งในที่นี้เราตั้งชื่อว่า summer) หาก Breakfast ไม่มีฟังก์ชันดังกล่าวเตรียมไว้ เราก็จะไม่สามารถสร้างอินสแตนซ์ของ Breakfast ใน eat_at_restaurant ได้เลย เพราะเราไม่สามารถกำหนดค่าเริ่มต้นให้กับฟิลด์ส่วนตัวอย่าง seasonal_fruit ได้โดยตรงจากภายนอก
ในทางตรงกันข้าม หากเราประกาศให้ enum เป็นสาธารณะ วาเรียนต์ทั้งหมดของ enum นั้นจะกลายเป็นสาธารณะโดยอัตโนมัติ เราเพียงแค่ใส่ pub ไว้หน้าคำว่า enum เท่านั้น ดังที่แสดงในลิสติ้ง 7-10
mod back_of_house {
pub enum Appetizer {
Soup,
Salad,
}
}
pub fn eat_at_restaurant() {
let order1 = back_of_house::Appetizer::Soup;
let order2 = back_of_house::Appetizer::Salad;
}เนื่องจากเราประกาศให้ enum Appetizer เป็นสาธารณะ เราจึงสามารถเรียกใช้วาเรียนต์ Soup และ Salad ภายในฟังก์ชัน eat_at_restaurant ได้ทันที
โดยธรรมชาติแล้ว enum จะไม่ค่อยมีประโยชน์เท่าใดนักหากวาเรียนต์ของมันไม่เปิดเป็นสาธารณะ และคงเป็นเรื่องน่ารำคาญไม่น้อยหากต้องคอยใส่ pub กำกับหน้าทุกๆ วาเรียนต์ของ enum ทุกกรณี ดังนั้นค่าเริ่มต้นของวาเรียนต์ใน enum จึงถูกกำหนดให้เป็นสาธารณะเสมอ ในขณะที่ struct มักจะมีประโยชน์ได้แม้ว่าฟิลด์ต่างๆ จะไม่ได้เปิดเป็นสาธารณะ ฟิลด์ของ struct จึงยึดตามกฎทั่วไปที่ว่า ทุกสิ่งทุกอย่างจะเป็นแบบส่วนตัวโดยปริยาย เว้นแต่จะระบุ pub ไว้อย่างชัดเจน
ยังมีอีกหนึ่งสถานการณ์ที่เกี่ยวข้องกับ pub ที่เรายังไม่ได้พูดถึง นั่นคือฟีเจอร์สุดท้ายของระบบมอดูล: คีย์เวิร์ด use ซึ่งเราจะมาเรียนรู้การใช้งาน use แบบเดี่ยวๆ กันก่อน จากนั้นจึงค่อยดูวิธีการนำ pub และ use มารวมพลังใช้งานร่วมกัน
นำพาธเข้าสู่สโคปด้วยคำสงวน use
นำพาธเข้าสู่สโคปด้วยคำสงวน use
การต้องคอยเขียนพาธเต็มยาวๆ เพื่อเรียกใช้งานฟังก์ชันอาจทำให้รู้สึกไม่สะดวกและดูซ้ำซ้อน ในลิสติ้ง 7-7 ไม่ว่าเราจะเลือกใช้พาธแบบสัมบูรณ์หรือแบบสัมพัทธ์ในการเรียกฟังก์ชัน add_to_waitlist เราก็ยังต้องระบุ front_of_house และ hosting ทุกครั้งที่ต้องการเรียกใช้งาน แต่โชคดีที่ Rust มีวิธีช่วยลดทอนขั้นตอนนี้ให้เรียบง่ายขึ้น: นั่นคือเราสามารถสร้างทางลัดไปยังพาธนั้นด้วยคีย์เวิร์ด use เพียงครั้งเดียว จากนั้นก็สามารถใช้ชื่อที่สั้นลงได้ในทุกๆ จุดภายในสโคป (scope) นั้น
ในลิสติ้ง 7-11 เราได้นำมอดูล crate::front_of_house::hosting เข้ามาไว้ในสโคปของฟังก์ชัน eat_at_restaurant ทำให้เราสามารถเรียกใช้ฟังก์ชัน add_to_waitlist ได้อย่างสะดวก โดยระบุเพียงแค่ hosting::add_to_waitlist เท่านั้น
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
use crate::front_of_house::hosting;
pub fn eat_at_restaurant() {
hosting::add_to_waitlist();
}การใส่คำสั่ง use พร้อมระบุพาธลงในสโคป เปรียบเสมือนการสร้างลิงก์เชิงสัญลักษณ์ (symbolic link) ในระบบไฟล์ เมื่อเราเพิ่มคำสั่ง use crate::front_of_house::hosting ไว้ที่รากของเครต ชื่อ hosting ก็จะกลายเป็นชื่อที่ใช้งานได้อย่างถูกต้องในสโคปนั้น ราวกับว่ามอดูล hosting ถูกนิยามขึ้นที่รากของเครตโดยตรง และพาธที่นำเข้ามาด้วย use ก็ยังคงถูกตรวจสอบกฎความเป็นส่วนตัว (privacy) อย่างเข้มงวดเช่นเดียวกับพาธอื่นๆ
โปรดสังเกตว่า use จะสร้างทางลัดให้เฉพาะสำหรับสโคปที่คำสั่ง use นั้นปรากฏอยู่เท่านั้น ในลิสติ้ง 7-12 ได้มีการย้ายฟังก์ชัน eat_at_restaurant ไปไว้ในมอดูลลูกใหม่ชื่อ customer ซึ่งกลายเป็นคนละสโคปกับสเตตเมนต์ use เดิม ส่งผลให้โค้ดภายในฟังก์ชันคอมไพล์ไม่ผ่าน
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
use crate::front_of_house::hosting;
mod customer {
pub fn eat_at_restaurant() {
hosting::add_to_waitlist();
}
}ข้อผิดพลาดจากคอมไพเลอร์ชี้ให้เห็นว่า ทางลัดดังกล่าวไม่สามารถใช้งานได้อีกต่อไปเมื่ออยู่ภายในมอดูล customer:
$ cargo build
Compiling restaurant v0.1.0 (file:///projects/restaurant)
error[E0433]: cannot find module or crate `hosting` in this scope
--> src/lib.rs:11:9
|
11 | hosting::add_to_waitlist();
| ^^^^^^^ use of unresolved module or unlinked crate `hosting`
|
= help: if you wanted to use a crate named `hosting`, use `cargo add hosting` to add it to your `Cargo.toml`
help: consider importing this module through its public re-export
|
10 + use crate::hosting;
|
warning: unused import: `crate::front_of_house::hosting`
--> src/lib.rs:7:5
|
7 | use crate::front_of_house::hosting;
| ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^
|
= note: `#[warn(unused_imports)]` (part of `#[warn(unused)]`) on by default
For more information about this error, try `rustc --explain E0433`.
warning: `restaurant` (lib) generated 1 warning
error: could not compile `restaurant` (lib) due to 1 previous error; 1 warning emitted
สังเกตว่าคอมไพเลอร์ยังได้แจ้งเตือน (warning) อีกด้วยว่า คำสั่ง use นั้นไม่ได้ถูกใช้งานในสโคปเดิมของมันแล้ว! วิธีแก้ไขปัญหานี้คือ การย้ายคำสั่ง use เข้าไปไว้ในมอดูล customer ด้วยเช่นกัน หรือเลือกอ้างอิงทางลัดที่อยู่ในมอดูลแม่ผ่านคำว่า super::hosting จากภายในมอดูลลูก customer
การสร้างพาธ use ตามสำนวนนิยม
ในลิสติ้ง 7-11 คุณอาจสงสัยว่า ทำไมเราถึงเขียน use crate::front_of_house::hosting แล้วค่อยเรียก hosting::add_to_waitlist ใน eat_at_restaurant แทนที่จะระบุพาธของ use ให้ยาวไปจนถึงฟังก์ชัน add_to_waitlist เลย เพื่อให้สามารถเรียกชื่อฟังก์ชันโดดๆ ได้เหมือนในลิสติ้ง 7-13
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
use crate::front_of_house::hosting::add_to_waitlist;
pub fn eat_at_restaurant() {
add_to_waitlist();
}แม้ว่าทั้งลิสติ้ง 7-11 และลิสติ้ง 7-13 จะให้ผลลัพธ์การทำงานที่เหมือนกันทุกประการ แต่แนวทางในลิสติ้ง 7-11 ถือเป็น สำนวนนิยม (idiomatic way) ในการนำฟังก์ชันเข้าสู่สโคปด้วย use เพราะการนำเฉพาะมอดูลแม่ของฟังก์ชันเข้ามาในสโคป จะบีบให้เราต้องระบุชื่อมอดูลแม่ตอนเรียกใช้งานฟังก์ชันเสมอ ซึ่งการระบุชื่อมอดูลแม่ตอนเรียกฟังก์ชันนั้นจะช่วยให้ผู้อ่านโค้ดเข้าใจได้อย่างชัดเจนทันทีว่า ฟังก์ชันนี้ไม่ได้ถูกนิยามขึ้นภายในไฟล์หรือมอดูลปัจจุบัน ในขณะเดียวกันก็ยังช่วยลดความเยิ่นเย้อของการพิมพ์พาธแบบเต็มลงไปได้มาก ตรงกันข้ามกับโค้ดในลิสติ้ง 7-13 ที่มองเผินๆ จะไม่ชัดเจนเลยว่า add_to_waitlist ถูกนิยามมาจากที่ใด
ในทางกลับกัน เมื่อเป็นการนำ struct, enum หรือไอเทมอื่นๆ เข้าสู่สโคปด้วย use สำนวนนิยมกลับเป็นการระบุพาธแบบเต็มไปจนถึงตัวไอเทมนั้นๆ ลิสติ้ง 7-14 แสดงแนวทางตามสำนวนนิยมในการนำ struct HashMap ของไลบรารีมาตรฐานเข้ามาใช้งานในสโคปของเครตไบนารี
use std::collections::HashMap;
fn main() {
let mut map = HashMap::new();
map.insert(1, 2);
}ความจริงแล้วไม่ได้มีเหตุผลทางเทคนิคที่ซับซ้อนอยู่เบื้องหลังสำนวนนิยมนี้: มันเป็นเพียงข้อตกลงและธรรมเนียมปฏิบัติที่เกิดขึ้นในชุมชน จนทุกคนคุ้นเคยกับการอ่านและเขียนโค้ด Rust ในรูปแบบนี้ไปแล้ว
อย่างไรก็ตาม ข้อยกเว้นสำหรับสำนวนนิยมนี้คือ กรณีที่เราจำเป็นต้องนำไอเทม 2 ตัวที่มีชื่อซ้ำกันเข้ามาไว้ในสโคปด้วยคำสั่ง use เนื่องจาก Rust ไม่อนุญาตให้มีชื่อซ้ำกันในสโคปเดียวกัน ลิสติ้ง 7-15 แสดงตัวอย่างการนำชนิดข้อมูล Result 2 ตัวที่มีชื่อเหมือนกันแต่อยู่คนละมอดูลแม่เข้ามาใช้งานในสโคปเดียวกัน พร้อมทั้งวิธีเรียกใช้งานพวกมัน
use std::fmt;
use std::io;
fn function1() -> fmt::Result {
// --snip--
Ok(())
}
fn function2() -> io::Result<()> {
// --snip--
Ok(())
}ดังที่คุณจะเห็นได้ว่า การอ้างอิงผ่านมอดูลแม่ช่วยให้สามารถแยกแยะความแตกต่างระหว่างชนิดข้อมูล Result ทั้งสองตัวได้อย่างชัดเจน หากเราเปลี่ยนไปเขียนเป็น use std::fmt::Result; และ use std::io::Result; เราจะมีชนิดข้อมูลชื่อ Result 2 ตัวอยู่ในสโคปเดียวกัน ซึ่ง Rust จะไม่สามารถรู้ได้เลยว่าเมื่อเราเขียนคำว่า Result เราหมายถึงตัวใดกันแน่
การตั้งชื่อใหม่ด้วยคำสงวน as
ยังมีอีกวิธีหนึ่งที่ช่วยแก้ปัญหาการนำสองชนิดข้อมูลที่มีชื่อซ้ำกันเข้ามาในสโคปเดียวกันด้วย use: นั่นคือเราสามารถใส่คำว่า as ต่อท้ายพาธ แล้วตามด้วยชื่อเรียกเฉพาะในสโคปนั้น หรือ นามแฝง (alias) สำหรับชนิดข้อมูลดังกล่าว ลิสติ้ง 7-16 แสดงอีกหนึ่งทางเลือกในการเขียนโค้ดของลิสติ้ง 7-15 โดยการเปลี่ยนชื่อชนิดข้อมูล Result ตัวใดตัวหนึ่งด้วย as
use std::fmt::Result;
use std::io::Result as IoResult;
fn function1() -> Result {
// --snip--
Ok(())
}
fn function2() -> IoResult<()> {
// --snip--
Ok(())
}ในคำสั่ง use บรรทัดที่สอง เราได้ตั้งชื่อใหม่ให้กับชนิดข้อมูล std::io::Result ว่า IoResult ซึ่งจะไม่ชนกับชื่อ Result จาก std::fmt ที่เรานำเข้ามาในสโคปด้วย ทั้งรูปแบบในลิสติ้ง 7-15 และลิสติ้ง 7-16 ต่างถือเป็นสำนวนนิยมที่ยอมรับได้ทั้งคู่ คุณจึงสามารถเลือกใช้ได้ตามความเหมาะสมและความชอบของคุณ!
การส่งออกชื่ออีกครั้งด้วย pub use
เมื่อเรานำชื่อใดๆ เข้ามาไว้ในสโคปด้วยคีย์เวิร์ด use ชื่อนั้นจะมีสถานะเป็นแบบส่วนตัว (private) ต่อสโคปที่เรานำมันเข้ามาโดยอัตโนมัติ หากเราต้องการเปิดโอกาสให้โค้ดภายนอกสโคปนั้นสามารถอ้างอิงถึงชื่อดังกล่าวได้ ราวกับว่ามันถูกนิยามขึ้นในสโคปนั้นโดยตรง เราสามารถนำ pub และ use มารวมเข้าด้วยกันได้ ซึ่งเทคนิคนี้เรียกว่า การส่งออกอีกครั้ง (re-exporting) เพราะเราไม่ได้เพียงแค่นำไอเทมนั้นเข้ามาไว้ในสโคปของเราเท่านั้น แต่เรายังเปิดทางให้ผู้อื่นสามารถนำไอเทมนั้นไปใช้ต่อในสโคปของพวกเขาได้อีกด้วย
ลิสติ้ง 7-17 แสดงโค้ดจากลิสติ้ง 7-11 โดยเปลี่ยนคำสั่ง use ในมอดูลรากให้กลายเป็น pub use
mod front_of_house {
pub mod hosting {
pub fn add_to_waitlist() {}
}
}
pub use crate::front_of_house::hosting;
pub fn eat_at_restaurant() {
hosting::add_to_waitlist();
}ก่อนหน้าที่จะทำการเปลี่ยนแปลงนี้ โค้ดภายนอกจะต้องเรียกฟังก์ชัน add_to_waitlist ผ่านพาธเต็มอย่าง restaurant::front_of_house::hosting::add_to_waitlist() ซึ่งบังคับว่ามอดูล front_of_house จะต้องถูกกำหนดให้เป็น pub ด้วย แต่เมื่อเราใช้ pub use เพื่อส่งออกมอดูล hosting ออกมาจากมอดูลรากอีกครั้ง โค้ดภายนอกก็สามารถเรียกใช้ผ่านพาธที่สั้นลงอย่าง restaurant::hosting::add_to_waitlist() ได้ทันที
การส่งออกชื่ออีกครั้งนี้มีประโยชน์อย่างยิ่งเมื่อโครงสร้างภายในของโค้ดที่คุณเขียน แตกต่างจากมุมมองของโปรแกรมเมอร์ที่จะเข้ามาเรียกใช้โค้ดของคุณ ตัวอย่างเช่น ในการเปรียบเทียบร้านอาหาร ผู้บริหารร้านอาหารอาจคิดแยกเป็นส่วน “หน้าร้าน (front of house)” และ “หลังร้าน (back of house)” แต่ลูกค้าที่เข้ามาใช้บริการในร้านย่อมไม่ได้มองส่วนต่างๆ ของร้านในแง่มุมนั้น ด้วยการใช้ pub use เราจึงสามารถเขียนจัดโครงสร้างโค้ดภายในในรูปแบบหนึ่ง แต่เปิดเผยอินเทอร์เฟซภายนอกออกมาอีกรูปแบบหนึ่งได้ ซึ่งช่วยให้ไลบรารีของเราจัดระเบียบได้อย่างสวยงาม ทั้งสำหรับโปรแกรมเมอร์ที่พัฒนาตัวไลบรารี และสำหรับโปรแกรมเมอร์ที่นำไลบรารีไปเรียกใช้งาน เราจะได้เห็นอีกหนึ่งตัวอย่างของการใช้ pub use และผลกระทบต่อเอกสารประกอบเครตของคุณในหัวข้อ “การส่งออก API สาธารณะที่สะดวกต่อการใช้งาน” ในบทที่ 14
การใช้แพ็กเกจภายนอก
ในบทที่ 2 เราได้พัฒนาโปรเจกต์เกมทายตัวเลขซึ่งมีการเรียกใช้แพ็กเกจภายนอกชื่อ rand เพื่อสุ่มตัวเลข และในการนำ rand มาใช้งานในโปรเจกต์ เราได้เพิ่มบรรทัดนี้ลงในไฟล์ Cargo.toml:
rand = "0.10.1"
การเพิ่ม rand เป็นดีเพนเดนซี (dependency) ใน Cargo.toml จะเป็นการบอกให้ Cargo ช่วยดาวน์โหลดแพ็กเกจ rand ตลอดจนดีเพนเดนซีอื่นๆ ที่เกี่ยวข้องมาจาก crates.io และเตรียม rand ให้พร้อมสำหรับเรียกใช้งานในโปรเจกต์ของเรา
จากนั้น เพื่อนำนิยามต่างๆ ของ rand เข้ามาไว้ในสโคปของแพ็กเกจ เราจึงเพิ่มบรรทัด use ที่ขึ้นต้นด้วยชื่อเครต rand พร้อมระบุไอเทมที่ต้องการนำเข้ามา ย้อนกลับไปในหัวข้อ “การสร้างตัวเลขสุ่ม” ในบทที่ 2 เราได้นำไอเทมในมอดูลพรีลูด rand::prelude เข้าสู่สโคป และเรียกใช้งานฟังก์ชัน rand::rng:
use std::io;
use rand::prelude::*;
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
println!("The secret number is: {secret_number}");
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
println!("You guessed: {guess}");
}สมาชิกในชุมชน Rust ได้ร่วมกันแบ่งปันแพ็กเกจที่มีประโยชน์ไว้มากมายบน crates.io และขั้นตอนในการดึงแพ็กเกจเหล่านั้นมาใช้งานในโปรเจกต์ของคุณก็ใช้วิธีการเดียวกันทั้งหมด: นั่นคือระบุชื่อแพ็กเกจในไฟล์ Cargo.toml ของคุณ แล้วใช้คำสั่ง use เพื่อนำไอเทมจากเครตเหล่านั้นเข้ามาในสโคป
โปรดทราบว่า ไลบรารีมาตรฐาน std ก็ถือเป็นเครตตัวหนึ่งที่อยู่ภายนอกแพ็กเกจของเราเช่นกัน เพียงแต่เนื่องจากไลบรารีมาตรฐานถูกติดตั้งมาพร้อมกับตัวภาษา Rust อยู่แล้ว เราจึงไม่จำเป็นต้องไปแก้ไขไฟล์ Cargo.toml เพื่อรวม std เข้ามา แต่เรายังคงจำเป็นต้องใช้คำสั่ง use เพื่อดึงไอเทมจากในนั้นเข้ามาไว้ในสโคปของโปรเจกต์เรา เช่น การใช้งาน HashMap เราจะต้องเขียนคำสั่งดังนี้:
#![allow(unused)]
fn main() {
use std::collections::HashMap;
}ซึ่งนี่คือพาธแบบสัมบูรณ์ (absolute path) ที่เริ่มต้นด้วย std อันเป็นชื่อของเครตไลบรารีมาตรฐานนั่นเอง
การใช้พาธแบบซ้อนเพื่อจัดระเบียบรายการ use
หากเรามีการเรียกใช้หลายๆ ไอเทมที่นิยามอยู่ภายใต้เครตเดียวกันหรือมอดูลเดียวกัน การเขียนคำสั่งแยกบรรทัดละหนึ่งไอเทมอาจทำให้เปลืองพื้นที่ตามแนวตั้งในไฟล์โค้ดของเราอย่างมาก ตัวอย่างเช่น สเตตเมนต์ use 2 บรรทัดที่เราเคยใช้ในเกมทายตัวเลขในลิสติ้ง 2-4 เพื่อนำไอเทมจาก std เข้าสู่สโคป:
// --snip--
use std::cmp::Ordering;
use std::io;
// --snip--
use rand::prelude::*;
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
println!("The secret number is: {secret_number}");
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
println!("You guessed: {guess}");
match guess.cmp(&secret_number) {
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => println!("You win!"),
}
}แต่เราสามารถใช้ พาธแบบซ้อน (nested paths) เพื่อนำไอเทมเหล่านั้นเข้ามาในสโคปพร้อมกันภายในบรรทัดเดียวได้ โดยการระบุส่วนของพาธที่เหมือนกันไว้ข้างหน้า ตามด้วยเครื่องหมายโคลอนคู่ (::) จากนั้นเปิดวงเล็บปีกกาครอบรายการของพาธส่วนที่แตกต่างกันเอาไว้ ดังที่แสดงในลิสติ้ง 7-18
use rand::prelude::*;
// --snip--
use std::{cmp::Ordering, io};
// --snip--
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
println!("The secret number is: {secret_number}");
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
let guess: u32 = guess.trim().parse().expect("Please type a number!");
println!("You guessed: {guess}");
match guess.cmp(&secret_number) {
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => println!("You win!"),
}
}ในโปรแกรมขนาดใหญ่ การนำไอเทมจำนวนมากจากเครตหรือมอดูลเดียวกันเข้ามาในสโคปโดยใช้พาธแบบซ้อน จะช่วยลดจำนวนบรรทัดของสเตตเมนต์ use ลงไปได้อย่างมหาศาล!
เราสามารถใช้พาธแบบซ้อนได้ในทุกระดับของพาธ ซึ่งมีประโยชน์อย่างมากเมื่อต้องรวมสเตตเมนต์ use 2 บรรทัดที่มีพาธย่อย (subpath) ร่วมกัน ตัวอย่างเช่น ลิสติ้ง 7-19 แสดงสเตตเมนต์ use 2 บรรทัด: โดยบรรทัดหนึ่งนำ std::io เข้าสู่สโคป และอีกบรรทัดนำ std::io::Write เข้าสู่สโคป
use std::io;
use std::io::Write;ส่วนที่ซ้ำกันของทั้งสองพาธนี้คือ std::io ซึ่งตรงกับพาธแรกทั้งหมด หากต้องการรวมพาธทั้งสองนี้เข้าเป็นคำสั่ง use เดียว เราสามารถใช้คำว่า self ไว้ภายในพาธแบบซ้อนได้ ดังแสดงในลิสติ้ง 7-20
use std::io::{self, Write};คำสั่งบรรทัดนี้จะนำทั้ง std::io และ std::io::Write เข้ามาไว้ในสโคปพร้อมกันทันที
การนำเข้ารายการด้วยตัวดำเนินการ glob
หากเราต้องการนำไอเทมสาธารณะ (public) ทั้งหมด ที่นิยามอยู่ภายใต้พาธหนึ่งเข้ามาไว้ในสโคป เราสามารถระบุพาธนั้นแล้วตามด้วยตัวดำเนินการ glob (glob operator) คือเครื่องหมายดอกจัน *:
#![allow(unused)]
fn main() {
use std::collections::*;
}สเตตเมนต์ use บรรทัดนี้จะนำทุกๆ ไอเทมสาธารณะที่นิยามอยู่ใน std::collections เข้ามาไว้ในสโคปปัจจุบันทั้งหมด แต่จงใช้ตัวดำเนินการ glob ด้วยความระมัดระวัง! เพราะ glob อาจทำให้ยากต่อการตรวจสอบว่ามีชื่ออะไรบ้างที่อยู่ในสโคป และชื่อแต่ละชื่อที่ถูกเรียกใช้ในโปรแกรมนั้นถูกนิยามมาจากที่ใดกันแน่ ยิ่งไปกว่านั้น หากดีเพนเดนซีภายนอกมีการปรับเปลี่ยนนิยามในเวอร์ชันใหม่ สิ่งที่คุณนำเข้ามาก็จะเปลี่ยนตามไปด้วย ซึ่งอาจก่อให้เกิดข้อผิดพลาดในการคอมไพล์เมื่อคุณอัปเกรดเวอร์ชันของดีเพนเดนซี ตัวอย่างเช่น หากดีเพนเดนซีนั้นเพิ่มนิยามใหม่ที่มีชื่อตรงกับชื่อที่คุณเคยนิยามไว้ในสโคปเดียวกัน
ตัวดำเนินการ glob มักถูกนำไปใช้ในกระบวนการเขียนเทสต์ เพื่อนำโค้ดทั้งหมดที่ต้องการทดสอบเข้ามาไว้ในมอดูล tests ซึ่งเราจะได้เรียนรู้กันในหัวข้อ “วิธีเขียนเทสต์” ในบทที่ 11 นอกจากนี้ ตัวดำเนินการ glob ยังถูกนำมาใช้เป็นส่วนหนึ่งของรูปแบบพรีลูด (prelude pattern) อีกด้วย โดยคุณสามารถดูรายละเอียดเพิ่มเติมได้ที่ เอกสารของไลบรารีมาตรฐาน
แยกมอดูลออกเป็นไฟล์ต่างๆ
แยกมอดูลออกเป็นไฟล์ต่างๆ
จนถึงตอนนี้ ตัวอย่างทั้งหมดในบทนี้ล้วนเป็นการนิยามหลายๆ มอดูลรวมไว้ภายในไฟล์เดียวกัน แต่เมื่อมอดูลเริ่มมีขนาดใหญ่และซับซ้อนขึ้น คุณอาจต้องการย้ายนิยามของมอดูลเหล่านั้นออกไปไว้ในไฟล์แยกต่างหาก เพื่อให้ง่ายต่อการค้นหาและไล่อ่านโค้ด
ตัวอย่างเช่น เราลองมาเริ่มต้นจากโค้ดในลิสติ้ง 7-17 ที่มีหลายมอดูลของร้านอาหารรวมกันอยู่ เราจะแยกมอดูลต่างๆ ออกเป็นไฟล์ย่อยๆ แทนที่จะนิยามมอดูลทั้งหมดไว้ในไฟล์รากของเครต (crate root) ซึ่งในกรณีนี้ ไฟล์รากของเครตคือ src/lib.rs แต่กระบวนการนี้สามารถนำไปใช้กับเครตไบนารีที่มีไฟล์รากเป็น src/main.rs ได้เช่นเดียวกันทุกประการ
อันดับแรก เราจะแยกมอดูล front_of_house ออกไปเป็นไฟล์ของตัวเอง ให้ลบโค้ดที่อยู่ภายในวงเล็บปีกกาของมอดูล front_of_house ออกทั้งหมด โดยคงเหลือไว้เพียงคำประกาศ mod front_of_house; เท่านั้น ส่งผลให้ไฟล์ src/lib.rs มีเนื้อหาดังที่แสดงในลิสติ้ง 7-21 โปรดทราบว่าโค้ดนี้จะยังคอมไพล์ไม่ผ่าน จนกว่าเราจะสร้างไฟล์ src/front_of_house.rs ตามลิสติ้ง 7-22 ขึ้นมา
mod front_of_house;
pub use crate::front_of_house::hosting;
pub fn eat_at_restaurant() {
hosting::add_to_waitlist();
}ถัดมา ให้นำโค้ดที่เคยอยู่ในวงเล็บปีกกาไปใส่ไว้ในไฟล์ใหม่ชื่อ src/front_of_house.rs ดังที่แสดงในลิสติ้ง 7-22 คอมไพเลอร์จะรู้ได้เองโดยอัตโนมัติว่าต้องเข้ามาค้นหาโค้ดในไฟล์นี้ เพราะพบคำประกาศมอดูลที่ชื่อ front_of_house อยู่ที่รากของเครต
pub mod hosting {
pub fn add_to_waitlist() {}
}โปรดสังเกตว่า คุณจำเป็นต้องโหลดไฟล์ด้วยคำประกาศ mod เพียง_ครั้งเดียว_เท่านั้นในต้นไม้มอดูลของคุณ และเมื่อคอมไพเลอร์รับรู้แล้วว่าไฟล์ดังกล่าวเป็นส่วนหนึ่งของโปรเจกต์ (และรู้ว่าโค้ดนั้นอยู่ตรงตำแหน่งใดในต้นไม้มอดูลจากจุดที่คุณเขียนสเตตเมนต์ mod) ไฟล์อื่นๆ ในโปรเจกต์ก็ควรจะอ้างอิงถึงโค้ดในไฟล์ที่โหลดมาแล้วนั้น ผ่านทางพาธ (path) ที่ชี้ไปยังตำแหน่งที่มันถูกประกาศเอาไว้ ดังที่เราได้เรียนรู้กันไปในหัวข้อ “พาธสำหรับอ้างถึงรายการในแผนผังมอดูล” หรือพูดอีกอย่างก็คือ คำว่า mod นั้น ไม่ใช่ คำสั่ง “include” เหมือนอย่างที่คุณอาจคุ้นเคยในภาษาโปรแกรมอื่นๆ
ถัดไป เราจะแยกมอดูล hosting ออกไปเป็นไฟล์ของตัวเองอีกทอดหนึ่ง ซึ่งขั้นตอนนี้จะแตกต่างออกไปเล็กน้อย เพราะมอดูล hosting เป็นมอดูลลูกของ front_of_house ไม่ใช่มอดูลลูกของมอดูลราก เราจึงต้องนำไฟล์ของ hosting ไปวางไว้ในไดเรกทอรีใหม่ที่ตั้งชื่อตามมอดูลบรรพบุรุษของมันในต้นไม้มอดูล ซึ่งในกรณีนี้ก็คือไดเรกทอรี src/front_of_house
ในการเริ่มต้นย้าย hosting เราจะปรับแก้ไฟล์ src/front_of_house.rs ให้เหลือเพียงแค่คำประกาศของมอดูล hosting:
pub mod hosting;จากนั้น เราจึงสร้างไดเรกทอรี src/front_of_house ขึ้นมา แล้วสร้างไฟล์ hosting.rs ไว้ข้างใน เพื่อบรรจุนิยามต่างๆ ของมอดูล hosting:
pub fn add_to_waitlist() {}หากเรานำไฟล์ hosting.rs ไปวางไว้ในไดเรกทอรี src โดยตรงแทน คอมไพเลอร์จะเข้าใจว่าโค้ดใน hosting.rs นั้นเป็นมอดูล hosting ที่ประกาศไว้ที่รากของเครต ไม่ใช่มอดูลลูกของ front_of_house ซึ่งกฎของคอมไพเลอร์ในการจับคู่ไฟล์กับมอดูลนี้ ทำให้โครงสร้างโฟลเดอร์และไฟล์บนดิสก์สะท้อนโครงสร้างต้นไม้มอดูลได้อย่างแม่นยำและเป็นธรรมชาติ
พาธไฟล์ทางเลือก
จนถึงตอนนี้ เราได้อธิบายรูปแบบพาธไฟล์ที่เป็นสำนวนนิยมที่สุดซึ่งคอมไพเลอร์ Rust ใช้ แต่จริงๆ แล้ว Rust ยังคงรองรับรูปแบบพาธไฟล์แบบเก่าอยู่อีกด้วย สำหรับมอดูลชื่อ
front_of_houseที่ประกาศไว้ที่รากของเครต คอมไพเลอร์จะมองหาโค้ดของมอดูลจากตำแหน่งเหล่านี้:
- src/front_of_house.rs (รูปแบบสำนวนนิยมที่เราได้อธิบายไป)
- src/front_of_house/mod.rs (รูปแบบเก่า ซึ่งยังคงรองรับอยู่)
และสำหรับมอดูลชื่อ
hostingซึ่งเป็นมอดูลย่อยของfront_of_houseคอมไพเลอร์จะมองหาโค้ดของมอดูลจากตำแหน่งเหล่านี้:
- src/front_of_house/hosting.rs (รูปแบบสำนวนนิยมที่เราได้อธิบายไป)
- src/front_of_house/hosting/mod.rs (รูปแบบเก่า ซึ่งยังคงรองรับอยู่)
หากคุณใช้ทั้งสองรูปแบบซ้ำซ้อนกันในมอดูลเดียวกัน คอมไพเลอร์จะแจ้งข้อผิดพลาดขึ้นมาทันที แม้ว่าการใช้รูปแบบผสมผสานกันในแต่ละมอดูลภายในโปรเจกต์เดียวกันจะสามารถทำได้ แต่ก็อาจสร้างความสับสนให้กับผู้ที่เข้ามาอ่านโค้ดในโปรเจกต์ของคุณ
ข้อเสียสำคัญของรูปแบบที่ใช้ไฟล์ชื่อ mod.rs คือ โปรเจกต์ของคุณอาจเต็มไปด้วยไฟล์ที่ชื่อ mod.rs ซ้ำๆ กันหลายไฟล์ ซึ่งสร้างความสับสนได้ง่ายมากเวลาที่คุณเปิดไฟล์เหล่านั้นขึ้นมาพร้อมๆ กันในโปรแกรมแก้ไขโค้ด
ในตอนนี้ เราได้ย้ายโค้ดของแต่ละมอดูลออกไปยังไฟล์แยกต่างหากเรียบร้อยแล้ว โดยที่โครงสร้างต้นไม้มอดูลยังคงเหมือนเดิมทุกประการ ทำให้การเรียกฟังก์ชันต่างๆ ใน eat_at_restaurant ยังคงทำงานได้ตามปกติโดยไม่ต้องแก้ไขโค้ดเลยแม้แต่น้อย แม้ว่านิยามของฟังก์ชันจะกระจายไปอยู่ในคนละไฟล์แล้วก็ตาม เทคนิคนี้จะช่วยให้คุณสามารถแยกมอดูลออกเป็นไฟล์ใหม่ๆ ได้อย่างคล่องตัวเมื่อขนาดของมอดูลเติบโตขึ้น
โปรดสังเกตด้วยว่า สเตตเมนต์ pub use crate::front_of_house::hosting; ใน src/lib.rs ก็ไม่ได้มีการเปลี่ยนแปลงใดๆ เช่นกัน และคำสั่ง use ก็ไม่มีผลใดๆ ต่อการที่ไฟล์จะถูกนำไปคอมไพล์เป็นส่วนหนึ่งของเครตหรือไม่ เพราะคำว่า mod ต่างหากที่เป็นตัวประกาศสร้างมอดูล และ Rust จะคอยค้นหาโค้ดสำหรับมอดูลนั้นจากไฟล์ที่มีชื่อตรงกับชื่อของมอดูลเสมอ
สรุป
Rust ช่วยให้คุณสามารถแยกแพ็กเกจ (package) ออกเป็นหลายๆ เครต (crates) และแยกเครตออกเป็นมอดูลต่างๆ ได้ เพื่อให้คุณสามารถอ้างอิงถึงไอเทมที่นิยามไว้ในมอดูลหนึ่งจากอีกมอดูลหนึ่งได้อย่างเป็นระบบ โดยทำได้ผ่านการระบุพาธแบบสัมบูรณ์หรือแบบสัมพัทธ์ และพาธเหล่านี้สามารถนำเข้ามาไว้ในสโคปได้ด้วยสเตตเมนต์ use เพื่อช่วยลดทอนความยาวของพาธเมื่อต้องเรียกใช้งานซ้ำๆ ในสโคปนั้น โค้ดทั้งหมดในมอดูลจะมีสถานะเป็นแบบส่วนตัว (private) โดยปริยาย แต่คุณก็สามารถเปิดเผยนิยามต่างๆ ให้เป็นสาธารณะ (public) ได้อย่างยืดหยุ่นด้วยการเติมคีย์เวิร์ด pub
ในบทถัดไป เราจะมาเรียนรู้เกี่ยวกับโครงสร้างข้อมูลแบบคอลเลกชัน (collection data structures) ในไลบรารีมาตรฐาน ซึ่งคุณสามารถนำมาปรับใช้ร่วมกับโค้ดที่ได้รับการจัดระเบียบอย่างประณีตของคุณได้ทันที
คอลเลกชันที่ใช้บ่อย
ไลบรารีมาตรฐานของ Rust มาพร้อมกับโครงสร้างข้อมูลที่มีประโยชน์อย่างยิ่งจำนวนมาก ซึ่งเรียกว่า คอลเลกชัน (collections) ในขณะที่ชนิดข้อมูลพื้นฐานส่วนใหญ่มักจะใช้แทนค่าเดี่ยวๆ เพียงค่าเดียว แต่คอลเลกชันสามารถบรรจุหลายๆ ค่าไว้ด้วยกันได้ และสิ่งที่ทำให้คอลเลกชันแตกต่างไปจากอาร์เรย์ (arrays) หรือทูเพิล (tuples) พื้นฐานที่มีมาให้ในตัวภาษาก็คือ ข้อมูลที่คอลเลกชันเหล่านี้ชี้ไปจะถูกจัดเก็บบนฮีป (heap) ซึ่งหมายความว่าเราไม่จำเป็นต้องทราบขนาดหรือปริมาณข้อมูลล่วงหน้าตั้งแต่ตอนคอมไพล์ และขนาดของข้อมูลสามารถขยายใหญ่ขึ้นหรือหดเล็กลงได้แบบไดนามิกระหว่างที่โปรแกรมกำลังทำงาน คอลเลกชันแต่ละชนิดต่างมีความสามารถและต้นทุนในการประมวลผล (performance costs) ที่แตกต่างกันไป ซึ่งการเลือกใช้ชนิดคอลเลกชันให้เหมาะสมกับสถานการณ์จึงเป็นทักษะที่คุณจะค่อยๆ สั่งสมและพัฒนาได้เมื่อมีประสบการณ์มากขึ้น ในบทนี้ เราจะมาเรียนรู้คอลเลกชัน 3 ชนิดยอดนิยมที่ถูกนำมาใช้งานบ่อยที่สุดในโปรแกรม Rust:
- เวกเตอร์ (Vector): ช่วยให้คุณสามารถจัดเก็บข้อมูลหลายๆ ค่าเรียงต่อกันในหน่วยความจำ โดยมีจำนวนข้อมูลที่ปรับเปลี่ยนเพิ่มลดได้ตามต้องการ
- สตริง (String): คือคอลเลกชันที่รวบรวมตัวอักขระ (characters) เอาไว้ แม้ว่าเราจะเคยกล่าวถึงชนิดข้อมูล
Stringกันไปบ้างแล้วก่อนหน้านี้ แต่ในบทนี้เราจะมาเจาะลึกรายละเอียดการทำงานของมันอย่างแท้จริง - แฮชแมป (Hash Map): ช่วยให้คุณสามารถผูกจับคู่ระหว่างค่า (value) เข้ากับคีย์เฉพาะ (key) แต่ละตัว ซึ่งเป็นการนำโครงสร้างข้อมูลทั่วไปที่เรียกว่า แมป (map) มาอิมพลีเมนต์ใช้งานจริง
หากคุณต้องการศึกษาเพิ่มเติมเกี่ยวกับคอลเลกชันชนิดอื่นๆ ที่มีให้ใช้งานในไลบรารีมาตรฐาน สามารถอ่านต่อได้ที่ เอกสารประกอบฉบับทางการ
เราจะมาเรียนรู้วิธีการสร้างและอัปเดตข้อมูลของทั้งเวกเตอร์, สตริง และแฮชแมป พร้อมทั้งสำรวจจุดเด่นเฉพาะตัวที่ทำให้แต่ละชนิดมีความพิเศษ
เก็บรายการค่าด้วยเวกเตอร์
เก็บรายการค่าด้วยเวกเตอร์
คอลเลกชันชนิดแรกที่เราจะมาศึกษากันคือ Vec<T> หรือที่รู้จักกันทั่วไปในชื่อ เวกเตอร์ (vector) เวกเตอร์ช่วยให้คุณสามารถจัดเก็บข้อมูลมากกว่าหนึ่งค่าไว้ในโครงสร้างข้อมูลเดี่ยวชิ้นเดียว โดยวางค่าทั้งหมดเรียงต่อกันเป็นแถวยาวในหน่วยความจำ และเวกเตอร์จะสามารถจัดเก็บได้เฉพาะค่าที่มีชนิดข้อมูลเดียวกันทั้งหมดเท่านั้น เวกเตอร์จึงมีประโยชน์อย่างยิ่งเมื่อคุณต้องการจัดเก็บรายการของข้อมูล เช่น แต่ละบรรทัดของข้อความในไฟล์ หรือราคาสินค้าแต่ละชิ้นในตะกร้าสินค้า
การสร้างเวกเตอร์ใหม่
ในการสร้างเวกเตอร์ใหม่ที่ว่างเปล่า เราสามารถเรียกใช้ฟังก์ชัน Vec::new ได้ดังที่แสดงในลิสติ้ง 8-1
fn main() {
let v: Vec<i32> = Vec::new();
}โปรดสังเกตว่าเราได้ระบุชนิดข้อมูล (type annotation) กำกับไว้ตรงนี้ด้วย เนื่องจากเรายังไม่ได้ใส่ค่าใดๆ ลงไปในเวกเตอร์ Rust จึงไม่สามารถรู้ได้เองว่าเราตั้งใจจะจัดเก็บข้อมูลชนิดใด ซึ่งนี่เป็นประเด็นที่สำคัญมาก เพราะเวกเตอร์ถูกอิมพลีเมนต์ขึ้นมาโดยใช้เจเนอริก (generics - เราจะได้เรียนรู้วิธีการสร้างเจเนอริกสำหรับชนิดข้อมูลของเราเองในบทที่ 10) แต่สำหรับตอนนี้ ขอให้ทราบไว้ว่าชนิดข้อมูล Vec<T> ในไลบรารีมาตรฐานนั้นสามารถบรรจุข้อมูลชนิดใดก็ได้ และเมื่อเราต้องการสร้างเวกเตอร์ขึ้นมาเพื่อเก็บข้อมูลชนิดใดชนิดหนึ่งเป็นการเฉพาะ เราก็สามารถระบุชนิดข้อมูลนั้นไว้ภายในวงเล็บสามเหลี่ยมมุมแหลม (<...>) ได้ ในลิสติ้ง 8-1 นี้ เราจึงบอกกับ Rust ว่าตัวแปร v ของเราคือ Vec<T> ที่จะใช้เก็บข้อมูลชนิด i32
แต่ในทางปฏิบัติแล้ว บ่อยครั้งคุณมักจะสร้าง Vec<T> ขึ้นมาพร้อมกับกำหนดค่าเริ่มต้นให้กับมันไปเลย ซึ่งจะช่วยให้ Rust สามารถอนุมาน (infer) ชนิดของข้อมูลที่คุณต้องการจัดเก็บได้เองโดยอัตโนมัติ ทำให้แทบไม่จำเป็นต้องเขียนระบุชนิดข้อมูลด้วยตนเอง นอกจากนี้ Rust ยังเตรียมมาโครอำนวยความสะดวกอย่าง vec! เอาไว้ให้ ซึ่งจะช่วยสร้างเวกเตอร์ใหม่ที่บรรจุค่าเริ่มต้นตามที่คุณกำหนดไว้อย่างง่ายดาย ในลิสติ้ง 8-2 จะเป็นการสร้าง Vec<i32> ตัวใหม่ที่บรรจุค่า 1, 2 และ 3 เอาไว้ โดยค่าเหล่านี้จะเป็นชนิด i32 เพราะเป็นชนิดจำนวนเต็มปริยายของภาษา ตามที่เราได้อธิบายไว้ในหัวข้อ “ชนิดข้อมูล” ในบทที่ 3
fn main() {
let v = vec![1, 2, 3];
}เนื่องจากเราได้กำหนดค่าเริ่มต้นเป็นเลขจำนวนเต็มชนิด i32 ไปแล้ว Rust จึงอนุมานได้ทันทีว่าตัวแปร v มีชนิดข้อมูลเป็น Vec<i32> จึงไม่จำเป็นต้องเขียนระบุชนิดข้อมูลอีกต่อไป ลำดับถัดไป เราจะมาดูวิธีการแก้ไขข้อมูลในเวกเตอร์กัน
การอัปเดตเวกเตอร์
ในการสร้างเวกเตอร์ขึ้นมาแล้วค่อยๆ เพิ่มข้อมูลเข้าไปในภายหลัง เราสามารถเรียกใช้เมธอด push ได้ดังที่แสดงในลิสติ้ง 8-3
fn main() {
let mut v = Vec::new();
v.push(5);
v.push(6);
v.push(7);
v.push(8);
}และเช่นเดียวกับตัวแปรทั่วไปใน Rust หากเราต้องการแก้ไขเปลี่ยนแปลงค่าในตัวแปรได้ เราจะต้องประกาศให้ตัวแปรนั้นเปลี่ยนแปลงค่าได้ (mutable) ด้วยคีย์เวิร์ด mut ดังที่ได้กล่าวถึงในบทที่ 3 สำหรับตัวเลขที่เราเพิ่มเข้าไปนั้นล้วนเป็นชนิด i32 ซึ่ง Rust สามารถอนุมานได้จากข้อมูลโดยตรง เราจึงไม่จำเป็นต้องเขียนระบุ Vec<i32> แต่อย่างใด
การอ่านองค์ประกอบของเวกเตอร์
การอ้างอิงถึงค่าที่จัดเก็บอยู่ในเวกเตอร์สามารถทำได้ 2 วิธี ได้แก่: การเข้าถึงผ่านดัชนี (indexing) หรือการเรียกใช้เมธอด get ในตัวอย่างถัดไปนี้ เราได้เขียนระบุชนิดข้อมูลของค่าที่ส่งกลับมาจากฟังก์ชันเหล่านี้ไว้ด้วยเพื่อความชัดเจนเป็นพิเศษ
ลิสติ้ง 8-4 แสดงทั้งสองวิธีในการเข้าถึงค่าในเวกเตอร์ ทั้งการใช้วากยสัมพันธ์ดัชนีและการใช้เมธอด get
fn main() {
let v = vec![1, 2, 3, 4, 5];
let third: &i32 = &v[2];
println!("The third element is {third}");
let third: Option<&i32> = v.get(2);
match third {
Some(third) => println!("The third element is {third}"),
None => println!("There is no third element."),
}
}โปรดสังเกตรายละเอียดที่น่าสนใจตรงนี้ เราใช้ค่าดัชนี 2 เพื่อดึงข้อมูลตัวที่ 3 ออกมา เนื่องจากเวกเตอร์จะเริ่มต้นนับดัชนีจากเลขศูนย์ (0) เสมอ การใช้เครื่องหมาย & ร่วมกับวงเล็บก้ามปู [] จะให้ผลลัพธ์เป็นเรเฟอเรนซ์ (reference) ที่ชี้ไปยังข้อมูล ณ ตำแหน่งดัชนีนั้น ส่วนการเรียกใช้เมธอด get โดยส่งค่าดัชนีเข้าไปเป็นอาร์กิวเมนต์ จะให้ผลลัพธ์กลับมาเป็น Option<&T> ซึ่งเราสามารถนำไปใช้งานต่อร่วมกับคำสั่ง match ได้อย่างสะดวก
Rust จัดเตรียมสองวิธีนี้ไว้ให้ เพื่อให้คุณสามารถเลือกได้ว่าต้องการให้โปรแกรมทำงานอย่างไร เมื่อมีการพยายามเข้าถึงค่าดัชนีที่อยู่นอกช่วงข้อมูลที่มีอยู่จริง ลองมาดูตัวอย่างสิ่งที่จะเกิดขึ้นเมื่อเรามีเวกเตอร์ที่บรรจุข้อมูลอยู่ 5 ตัว แล้วเราพยายามเข้าถึงข้อมูลที่ตำแหน่งดัชนี 100 ด้วยแต่ละเทคนิคกัน ดังแสดงในลิสติ้ง 8-5
fn main() {
let v = vec![1, 2, 3, 4, 5];
let does_not_exist = &v[100];
let does_not_exist = v.get(100);
}เมื่อเราสั่งรันโค้ดชุดนี้ วิธีการแรกที่ใช้เครื่องหมายก้ามปู [] จะส่งผลให้โปรแกรมเกิดการแพนิก (panic) ทันที เนื่องจากเป็นการพยายามเข้าถึงตำแหน่งข้อมูลที่ไม่มีอยู่จริง วิธีนี้จึงเหมาะสมที่สุดเมื่อคุณต้องการให้โปรแกรมหยุดทำงานและแครชไปเลย หากมีโค้ดส่วนใดพยายามเข้าถึงข้อมูลเกินขอบเขตของเวกเตอร์
ในทางตรงกันข้าม เมื่อเราส่งค่าดัชนีที่อยู่นอกขอบเขตของเวกเตอร์เข้าไปยังเมธอด get มันจะส่งค่า None กลับมาอย่างนุ่มนวลโดยไม่ทำให้โปรแกรมแพนิก ซึ่งคุณควรเลือกใช้วิธีนี้เมื่อการเข้าถึงข้อมูลนอกช่วงมีโอกาสเกิดขึ้นได้เป็นปกติในสถานการณ์ทั่วไป จากนั้นโค้ดของคุณก็จะมีตรรกะคอยดักจับจัดการกับทั้งกรณี Some(&element) หรือกรณี None ดังที่เราได้เรียนรู้กันไปแล้วในบทที่ 6 ตัวอย่างเช่น หากค่าดัชนีนั้นได้รับมาจากการที่ผู้ใช้กรอกตัวเลขเข้ามา แล้วผู้ใช้เผลอพิมพ์ตัวเลขที่มากเกินไปจนได้ค่า None โปรแกรมของคุณก็สามารถแจ้งเตือนผู้ใช้ได้อย่างสุภาพว่าในเวกเตอร์มีข้อมูลอยู่กี่ตัว พร้อมทั้งเปิดโอกาสให้พวกเขากรอกค่าใหม่อีกครั้ง ซึ่งย่อมเป็นมิตรต่อผู้ใช้งานมากกว่าการปล่อยให้โปรแกรมแครชดับไปต่อหน้าต่อตาเพียงเพราะพิมพ์ผิด!
เมื่อโปรแกรมถือเรเฟอเรนซ์ที่ถูกต้องเอาไว้ ตัวตรวจการยืม (borrow checker) จะคอยบังคับใช้กฎความเป็นเจ้าของและการยืม (ownership and borrowing rules - จากบทที่ 4) อย่างเคร่งครัด เพื่อให้มั่นใจได้ว่าเรเฟอเรนซ์นี้ รวมถึงเรเฟอเรนซ์อื่นๆ ทั้งหมดที่ชี้ไปยังข้อมูลภายในเวกเตอร์จะยังคงถูกต้องและปลอดภัยตลอดเวลา ย้อนกลับไปดูกฎสำคัญที่ระบุว่า คุณไม่สามารถถือเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ (mutable reference) และเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ (immutable reference) ร่วมกันภายในสโคปเดียวกันได้ กฎข้อนี้จะแสดงให้เห็นชัดเจนในลิสติ้ง 8-6 เมื่อเราถือเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ของข้อมูลตัวแรกในเวกเตอร์เอาไว้ แล้วพยายามจะเพิ่มข้อมูลตัวใหม่ต่อท้ายเวกเตอร์ ซึ่งโปรแกรมนี้จะคอมไพล์ไม่ผ่านอย่างแน่นอน หากเราพยายามนำเรเฟอเรนซ์ของตัวแรกนั้นมาเรียกใช้งานต่อในภายหลัง
fn main() {
let mut v = vec![1, 2, 3, 4, 5];
let first = &v[0];
v.push(6);
println!("The first element is: {first}");
}เมื่อพยายามคอมไพล์โค้ดดังกล่าว จะได้รับข้อผิดพลาดดังนี้:
$ cargo run
Compiling collections v0.1.0 (file:///projects/collections)
error[E0502]: cannot borrow `v` as mutable because it is also borrowed as immutable
--> src/main.rs:6:5
|
4 | let first = &v[0];
| - immutable borrow occurs here
5 |
6 | v.push(6);
| ^^^^^^^^^ mutable borrow occurs here
7 |
8 | println!("The first element is: {first}");
| ----- immutable borrow later used here
For more information about this error, try `rustc --explain E0502`.
error: could not compile `collections` (bin "collections") due to 1 previous error
เมื่อมองดูผิวเผิน โค้ดในลิสติ้ง 8-6 อาจดูเหมือนไม่น่าจะมีปัญหาอะไร: ทำไมการถือเรเฟอเรนซ์ชี้ไปยังสมาชิกตัวแรก ถึงต้องไปแคร์การเปลี่ยนแปลงที่เกิดขึ้นตรงส่วนท้ายของเวกเตอร์ด้วยล่ะ? สาเหตุของข้อผิดพลาดนี้มาจากกลไกการทำงานของเวกเตอร์ในระดับล่าง: เนื่องจากเวกเตอร์จะจัดเก็บข้อมูลเรียงติดต่อกันเป็นผืนเดียวในหน่วยความจำ ดังนั้นการเพิ่มสมาชิกตัวใหม่เข้าไปต่อท้ายเวกเตอร์ อาจบีบให้ต้องมีการจัดสรรหน่วยความจำก้อนใหม่ที่มีขนาดใหญ่ขึ้นบนฮีป แล้วคัดลอกข้อมูลเดิมทั้งหมดไปยังพื้นที่ใหม่ หากพื้นที่เดิมที่เวกเตอร์อาศัยอยู่มีที่ว่างไม่เพียงพอที่จะวางข้อมูลใหม่ต่อท้าย และในกรณีเช่นนั้น เรเฟอเรนซ์เดิมที่ชี้ไปยังสมาชิกตัวแรกก็จะกลายสภาพเป็นพอยน์เตอร์ที่ชี้ไปยังหน่วยความจำที่ถูกปลดปล่อยคืนไปแล้ว (deallocated memory / dangling reference)! กฎการยืมของ Rust จึงเข้ามาทำหน้าที่ป้องกันไม่ให้โปรแกรมของคุณตกอยู่ในสถานการณ์ที่อันตรายเช่นนี้ตั้งแต่ตอนคอมไพล์
หมายเหตุ: หากต้องการศึกษาลึกซึ้งถึงรายละเอียดการอิมพลีเมนต์ภายในของชนิดข้อมูล
Vec<T>เพิ่มเติม สามารถอ่านต่อได้ใน “The Rustonomicon”
การวนซ้ำค่าต่างๆ ในเวกเตอร์
หากเราต้องการเข้าถึงสมาชิกแต่ละตัวในเวกเตอร์เรียงตามลำดับ เรามักจะเลือกใช้วิธีการวนลูป (iterate) ผ่านสมาชิกทั้งหมด มากกว่าการใช้ดัชนีเข้าถึงทีละตำแหน่ง ลิสติ้ง 8-7 แสดงวิธีการใช้ลูป for เพื่อรับเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ (immutable references) ของสมาชิกแต่ละตัวในเวกเตอร์ชนิด i32 แล้วพิมพ์ค่านั้นออกมา
fn main() {
let v = vec![100, 32, 57];
for i in &v {
println!("{i}");
}
}นอกจากนี้ เรายังสามารถวนลูปผ่านเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ (mutable references) ของสมาชิกแต่ละตัวในเวกเตอร์ที่ mutable ได้ เพื่อปรับแก้ค่าของสมาชิกทุกตัวพร้อมกัน ลูป for ในลิสติ้ง 8-8 จะบวกค่า 50 เพิ่มเข้าไปในสมาชิกแต่ละตัว
fn main() {
let mut v = vec![100, 32, 57];
for i in &mut v {
*i += 50;
}
}ในการปรับเปลี่ยนค่าที่ตัวเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ชี้ไป เราจำเป็นต้องใช้ตัวดำเนินการดีเรเฟอเรนซ์ (dereference operator) คือเครื่องหมายดอกจัน * เพื่อเข้าถึงตัวข้อมูลจริงที่อยู่ใน i เสียก่อน จึงจะสามารถใช้ตัวดำเนินการ += ได้ ซึ่งเราจะได้พูดคุยเกี่ยวกับตัวดำเนินการดีเรเฟอเรนซ์อย่างละเอียดในหัวข้อ “การตามเรเฟอเรนซ์ไปยังค่า” ในบทที่ 15
การวนลูปผ่านเวกเตอร์ ไม่ว่าจะเป็นแบบอ่านอย่างเดียวหรือแบบแก้ไขข้อมูล ล้วนมีความปลอดภัยอย่างยิ่งด้วยกฎเกณฑ์ของ borrow checker หากเราพยายามแทรกหรือลบสมาชิกภายในตัวลูป for ในลิสติ้ง 8-7 หรือลิสติ้ง 8-8 คอมไพเลอร์จะปฏิเสธและแจ้งข้อผิดพลาดออกมาคล้ายกับในลิสติ้ง 8-6 ทันที เพราะเรเฟอเรนซ์ของเวกเตอร์ที่ลูป for ถือครองอยู่นั้น จะช่วยป้องกันไม่ให้เกิดการแก้ไขโครงสร้างของเวกเตอร์ทั้งหมดไปพร้อมๆ กัน
การใช้ enum เพื่อจัดเก็บหลายชนิดข้อมูล
เวกเตอร์สามารถจัดเก็บได้เฉพาะข้อมูลที่เป็นชนิดเดียวกันเท่านั้น ซึ่งในบางกรณีอาจทำให้รู้สึกไม่สะดวกเท่าใดนัก เพราะแน่นอนว่าย่อมมีหลายสถานการณ์ที่เราจำเป็นต้องจัดเก็บรายการข้อมูลที่มีชนิดแตกต่างกันคละกันไป แต่โชคดีที่วาเรียนต์ต่างๆ ของ enum ล้วนถูกนิยามอยู่ภายใต้ชนิดข้อมูล enum เดียวกัน ดังนั้นเมื่อเราต้องการชนิดข้อมูลเดี่ยวชนิดเดียวที่สามารถเป็นตัวแทนของข้อมูลต่างชนิดกันได้ เราจึงสามารถนิยามและใช้งาน enum เข้ามาช่วยได้!
ตัวอย่างเช่น สมมติว่าเราต้องการอ่านค่าจากแถวหนึ่งในโปรแกรมสเปรดชีต ซึ่งข้อมูลในแต่ละคอลัมน์ของแถวนั้นมีทั้งตัวเลขจำนวนเต็ม, ตัวเลขทศนิยม และข้อความสตริง เราสามารถนิยาม enum ที่แต่ละวาเรียนต์ทำหน้าที่เก็บชนิดข้อมูลที่แตกต่างกันเหล่านั้น และวาเรียนต์ทั้งหมดก็จะถือว่าเป็นชนิดข้อมูลเดียวกัน นั่นคือชนิดของ enum ตัวนั้น จากนั้นเราก็สร้างเวกเตอร์ขึ้นมาเพื่อจัดเก็บ enum ดังกล่าว ซึ่งในทางปฏิบัติแล้ว ก็คือการทำให้เวกเตอร์สามารถจัดเก็บข้อมูลต่างชนิดกันได้นั่นเอง ดังที่แสดงไว้ในลิสติ้ง 8-9
fn main() {
enum SpreadsheetCell {
Int(i32),
Float(f64),
Text(String),
}
let row = vec![
SpreadsheetCell::Int(3),
SpreadsheetCell::Text(String::from("blue")),
SpreadsheetCell::Float(10.12),
];
}Rust จำเป็นต้องรู้ชนิดข้อมูลที่จะบรรจุอยู่ในเวกเตอร์ให้ได้อย่างแน่ชัดตั้งแต่ตอนคอมไพล์ เพื่อที่คอมไพเลอร์จะได้คำนวณขนาดหน่วยความจำบนฮีปที่จะต้องใช้สำหรับจัดเก็บสมาชิกแต่ละตัวได้อย่างถูกต้องแม่นยำ นอกจากนี้ เรายังต้องระบุให้ชัดเจนด้วยว่าอนุญาตให้มีชนิดข้อมูลใดบ้างในเวกเตอร์นี้ หาก Rust ยอมให้เวกเตอร์เก็บชนิดข้อมูลใดๆ ก็ได้อย่างอิสระ ก็อาจมีความเสี่ยงที่ชนิดข้อมูลบางชนิดจะทำให้เกิดข้อผิดพลาดขึ้นเมื่อมีคำสั่งมาดำเนินการกับสมาชิกในเวกเตอร์ การนำ enum มาใช้ควบคู่กับคำสั่ง match จะช่วยให้ Rust มั่นใจได้ตั้งแต่ตอนคอมไพล์ว่า ทุกกรณีที่เป็นไปได้จะได้รับการจัดการอย่างครบถ้วนแน่นอน ดังที่เราได้พูดคุยกันในบทที่ 6
แต่ถ้าหากคุณไม่สามารถล่วงรู้ชนิดข้อมูลทั้งหมดที่โปรแกรมจะต้องรับเข้ามาในเวกเตอร์ในตอนรันไทม์ได้อย่างครบถ้วน เทคนิคการใช้ enum นี้ก็อาจจะไม่ตอบโจทย์ ในกรณีเช่นนั้น คุณสามารถเปลี่ยนไปใช้เทคนิคที่เรียกว่า เทรตออบเจกต์ (trait object) แทนได้ ซึ่งเราจะได้เรียนรู้กันในบทที่ 18
หลังจากที่เราได้เรียนรู้วิธีการใช้งานเวกเตอร์ที่พบบ่อยกันไปแล้ว อย่าลืมเข้าไปอ่าน เอกสารประกอบ API ของ Vec<T> เพื่อศึกษาเมธอดที่มีประโยชน์อื่นๆ อีกมากมายที่ไลบรารีมาตรฐานเตรียมไว้ให้ เช่น นอกเหนือจากเมธอด push แล้ว ยังมีเมธอด pop ที่ใช้สำหรับลบและส่งค่าสมาชิกตัวสุดท้ายกลับออกมา เป็นต้น
การทิ้งเวกเตอร์จะปลดปล่อยองค์ประกอบทั้งหมดไปพร้อมกัน
และเช่นเดียวกับโครงสร้าง struct ทั่วไป เวกเตอร์จะถูกปลดปล่อยหน่วยความจำ (dropped) ทันทีเมื่อมันหลุดออกจากสโคป ดังที่กำกับไว้ในลิสติ้ง 8-10
fn main() {
{
let v = vec![1, 2, 3, 4];
// do stuff with v
} // <- v goes out of scope and is freed here
}เมื่อเวกเตอร์ถูก drop ข้อมูลทั้งหมดที่บรรจุอยู่ภายในก็จะถูก drop ตามไปด้วย ซึ่งหมายความว่าตัวเลขจำนวนเต็มทั้งหมดที่มันถือครองอยู่จะถูกล้างเคลียร์ออกจากหน่วยความจำอย่างหมดจด โดยที่ borrow checker จะคอยดูแลให้มั่นใจเสมอว่า เรเฟอเรนซ์ใดๆ ที่ชี้ไปยังข้อมูลในเวกเตอร์ จะถูกเรียกใช้งานเฉพาะในช่วงเวลาที่ตัวเวกเตอร์นั้นยังคงมีชีวิตอยู่และถูกต้องเท่านั้น
คราวนี้ เรามาดูคอลเลกชันตัวถัดไปกัน: String!
เก็บข้อความที่เข้ารหัส UTF-8 ด้วยสตริง
เก็บข้อความที่เข้ารหัส UTF-8 ด้วยสตริง
เราได้เคยพูดถึงสตริง (strings) กันไปบ้างแล้วในบทที่ 4 แต่ในหัวข้อนี้ เราจะมาเจาะลึกรายละเอียดการทำงานของมันกันอย่างจริงจัง ชาว Rustacean มือใหม่มักจะรู้สึกติดขัดและสับสนกับเรื่องสตริงอยู่บ่อยครั้ง ซึ่งเกิดจากปัจจัย 3 ประการรวมกัน ได้แก่: ความมุ่งมั่นของ Rust ที่พยายามเปิดเผยข้อผิดพลาดที่อาจเกิดขึ้นทั้งหมดออกมาตั้งแต่ต้น, ความจริงที่ว่าสตริงเป็นโครงสร้างข้อมูลที่มีความซับซ้อนมากกว่าที่โปรแกรมเมอร์หลายคนคิด และการเข้ารหัสแบบ UTF-8 ปัจจัยเหล่านี้เมื่อมารวมเข้าด้วยกัน จึงทำให้เรื่องสตริงดูยากขึ้น โดยเฉพาะอย่างยิ่งหากคุณย้ายมาจากภาษาโปรแกรมอื่นๆ
สาเหตุที่เรานำเรื่องสตริงมาพูดคุยในบริบทของคอลเลกชัน ก็เพราะว่าสตริงถูกอิมพลีเมนต์ขึ้นมาในฐานะคอลเลกชันของไบต์ ร่วมกับเมธอดอำนวยความสะดวกต่างๆ เพื่อช่วยจัดการเมื่อไบต์เหล่านั้นถูกนำมาตีความเป็นตัวอักษรหรือข้อความ ในหัวข้อนี้ เราจะมาเรียนรู้การดำเนินการพื้นฐานกับ String ที่พบได้ในคอลเลกชันทุกชนิด เช่น การสร้าง, การอัปเดต และการอ่านค่า นอกจากนี้ เรายังจะได้สำรวจข้อแตกต่างระหว่าง String กับคอลเลกชันอื่นๆ โดยเฉพาะอย่างยิ่ง เหตุใดการเข้าถึงข้อมูลผ่านดัชนี (indexing) ของ String จึงกลายเป็นเรื่องซับซ้อน อันเนื่องมาจากความแตกต่างระหว่างมุมมองของมนุษย์กับคอมพิวเตอร์ในการตีความข้อมูลสตริง
การนิยามสตริง
อันดับแรก เรามานิยามความหมายของคำว่า สตริง (string) ให้ตรงกันก่อน ในแก่นของภาษา Rust (core language) มีชนิดข้อมูลสตริงเพียงชนิดเดียวเท่านั้น นั่นคือสตริงสไลซ์ (string slice) str ซึ่งเรามักจะพบเห็นในรูปแบบที่ถูกยืมมาใช้งานคือ &str โดยในบทที่ 4 เราได้เรียนรู้แล้วว่า สตริงสไลซ์คือการอ้างอิง (reference) ไปยังข้อมูลสตริงที่เข้ารหัสแบบ UTF-8 ซึ่งถูกจัดเก็บไว้ที่อื่น ตัวอย่างเช่น สตริงลิเทอรัล (string literals) จะถูกฝังเก็บไว้ภายในไฟล์ไบนารีของตัวโปรแกรม ดังนั้นพวกมันจึงมีชนิดข้อมูลเป็นสตริงสไลซ์
ส่วนชนิดข้อมูล String นั้น เป็นสิ่งที่เตรียมไว้ให้โดยไลบรารีมาตรฐานของ Rust ไม่ได้ถูกฮาร์ดโค้ดไว้ในแก่นของตัวภาษา โดย String จะเป็นสตริงชนิดที่สามารถขยายขนาดได้, แก้ไขเปลี่ยนแปลงข้อมูลได้, เป็นเจ้าของข้อมูลในตัวเอง (owned) และเข้ารหัสด้วย UTF-8 เสมอ เมื่อชาว Rustacean พูดถึงคำว่า “สตริง” ในภาษา Rust จึงอาจหมายถึงชนิดข้อมูล String หรือสตริงสไลซ์ &str ตัวใดตัวหนึ่งก็ได้ และแม้ว่าเนื้อหาในหัวข้อนี้จะเน้นหนักไปที่ String เป็นหลัก แต่ทั้งสองชนิดต่างก็ถูกนำมาใช้งานอย่างหนักหน่วงในไลบรารีมาตรฐานของ Rust และทั้งคู่ต่างก็เข้ารหัสด้วย UTF-8 เหมือนกันทั้งสิ้น
การสร้างสตริงใหม่
การดำเนินการหลายๆ อย่างที่มีให้ใช้งานใน Vec<T> ก็สามารถใช้งานกับ String ได้เช่นเดียวกัน เพราะความจริงแล้ว String ถูกอิมพลีเมนต์ขึ้นมาเป็นตัวห่อหุ้ม (wrapper) ครอบรอบเวกเตอร์ของไบต์ โดยมีการเพิ่มการรับประกันความถูกต้อง (guarantees), ข้อจำกัด และฟังก์ชันการทำงานพิเศษเพิ่มเติมเข้าไป ตัวอย่างของฟังก์ชันที่ทำงานเหมือนกันทุกประการระหว่าง Vec<T> และ String ก็คือฟังก์ชัน new สำหรับสร้างอินสแตนซ์ใหม่ ดังที่แสดงในลิสติ้ง 8-11
fn main() {
let mut s = String::new();
}คำสั่งบรรทัดนี้จะสร้างสตริงว่างตัวใหม่ชื่อ s ซึ่งเราสามารถทยอยโหลดข้อมูลใส่เข้าไปในภายหลังได้ แต่บ่อยครั้งเรามักจะมีข้อมูลข้อความเริ่มต้นที่ต้องการนำมาสร้างเป็นสตริงทันที ซึ่งในกรณีนั้น เราสามารถเรียกใช้เมธอด to_string ได้ โดยเมธอดนี้จะพร้อมใช้งานสำหรับทุกชนิดข้อมูลที่อิมพลีเมนต์เทรต Display เช่นเดียวกับสตริงลิเทอรัล ลิสติ้ง 8-12 แสดงตัวอย่างการใช้งาน 2 แบบ
fn main() {
let data = "initial contents";
let s = data.to_string();
// The method also works on a literal directly:
let s = "initial contents".to_string();
}โค้ดนี้จะสร้างสตริงที่บรรจุข้อความ initial contents ขึ้นมา
นอกจากนี้ เรายังสามารถใช้ฟังก์ชัน String::from ในการสร้าง String ขึ้นมาจากสตริงลิเทอรัลได้เช่นเดียวกัน โดยโค้ดในลิสติ้ง 8-13 จะให้ผลลัพธ์เทียบเท่ากับโค้ดในลิสติ้ง 8-12 ที่ใช้ to_string ทุกประการ
fn main() {
let s = String::from("initial contents");
}และเนื่องจากสตริงถูกนำไปใช้งานในหลากหลายบริบท Rust จึงจัดเตรียม API แบบเจเนอริกไว้ให้เลือกใช้งานมากมาย ซึ่งแม้ว่าบางคำสั่งอาจดูเหมือนทำงานซ้ำซ้อนกัน แต่แต่ละคำสั่งต่างก็มีสถานการณ์ที่เหมาะสมของตนเอง ในกรณีนี้ ทั้ง String::from และ to_string ต่างทำหน้าที่แบบเดียวกันอย่างสมบูรณ์แบบ ดังนั้นการจะเลือกใช้คำสั่งใดจึงขึ้นอยู่กับสไตล์ความชอบและความอ่านง่ายของโค้ดเป็นสำคัญ
และอย่าลืมว่า สตริงใน Rust จะเข้ารหัสด้วย UTF-8 เสมอ ดังนั้นเราจึงสามารถใส่ข้อมูลภาษาใดๆ ที่เข้ารหัสอย่างถูกต้องลงไปได้อย่างอิสระ ดังที่แสดงในลิสติ้ง 8-14
fn main() {
let hello = String::from("السلام عليكم");
let hello = String::from("Dobrý den");
let hello = String::from("Hello");
let hello = String::from("שלום");
let hello = String::from("नमस्ते");
let hello = String::from("こんにちは");
let hello = String::from("안녕하세요");
let hello = String::from("你好");
let hello = String::from("Olá");
let hello = String::from("Здравствуйте");
let hello = String::from("Hola");
}ข้อความทั้งหมดนี้ล้วนเป็นค่าของ String ที่ถูกต้องสมบูรณ์
การอัปเดตสตริง
ขนาดของ String สามารถขยายเพิ่มขึ้นได้ และข้อมูลภายในก็สามารถแก้ไขเปลี่ยนแปลงได้ เช่นเดียวกับ Vec<T> เมื่อคุณดันข้อมูลใหม่เข้าไปข้างใน นอกจากนี้ คุณยังสามารถใช้ตัวดำเนินการ + หรือมาโคร format! ในการเชื่อมต่อค่าของ String เข้าด้วยกันได้อย่างสะดวกง่ายดาย
การต่อท้ายด้วย push_str หรือ push
เราสามารถเพิ่มความยาวของ String ได้โดยการใช้เมธอด push_str เพื่อนำสตริงสไลซ์มาต่อท้าย ดังแสดงในลิสติ้ง 8-15
fn main() {
let mut s = String::from("foo");
s.push_str("bar");
}หลังจากโค้ดสองบรรทัดนี้ทำงานเสร็จ ตัวแปร s จะมีข้อความภายในเป็น foobar โดยเมธอด push_str จะรับพารามิเตอร์เป็นสตริงสไลซ์ เพราะเราไม่จำเป็นต้องถ่ายโอนสิทธิ์ความเป็นเจ้าของ (ownership) ของพารามิเตอร์นั้นเข้ามา ตัวอย่างเช่น ในโค้ดของลิสติ้ง 8-16 เรายังต้องการนำตัวแปร s2 ไปใช้งานต่อได้ หลังจากที่นำเนื้อหาของมันไปต่อท้าย s1 แล้ว
fn main() {
let mut s1 = String::from("foo");
let s2 = "bar";
s1.push_str(s2);
println!("s2 is {s2}");
}หากเมธอด push_str ยึดสิทธิ์ความเป็นเจ้าของของ s2 ไป เราก็จะไม่สามารถนำค่าของมันมาพิมพ์ในบรรทัดสุดท้ายได้อีก แต่โค้ดนี้สามารถทำงานได้อย่างถูกต้องตามที่เราคาดหวัง!
ส่วนเมธอด push จะรับพารามิเตอร์เป็นตัวอักขระเดี่ยวๆ เพียงหนึ่งตัว (char) แล้วนำไปต่อท้ายสตริง ในลิสติ้ง 8-17 เป็นการนำตัวอักษร l ไปต่อท้าย String โดยใช้เมธอด push
fn main() {
let mut s = String::from("lo");
s.push('l');
}ผลลัพธ์ที่ได้คือตัวแปร s จะมีข้อความเป็น lol
การเชื่อมด้วย + หรือ format!
บ่อยครั้งที่คุณอาจต้องการนำสตริงสองตัวที่มีอยู่แล้วมารวมเข้าด้วยกัน วิธีหนึ่งที่ทำได้คือการใช้ตัวดำเนินการบวก (+) ดังที่แสดงในลิสติ้ง 8-18
fn main() {
let s1 = String::from("Hello, ");
let s2 = String::from("world!");
let s3 = s1 + &s2; // note s1 has been moved here and can no longer be used
}สตริง s3 จะมีข้อความเป็น Hello, world! สาเหตุที่ทำให้ s1 ไม่สามารถนำมาใช้งานได้อีกต่อไปหลังจากการบวก และสาเหตุที่เราต้องส่งเรเฟอเรนซ์ของ s2 เข้าไปนั้น มีความเกี่ยวข้องโดยตรงกับซิกเนเจอร์ของเมธอดที่ถูกเรียกทำงานเบื้องหลังเมื่อเราใช้ตัวดำเนินการ + โดยตัวดำเนินการ + จะเรียกใช้เมธอด add ซึ่งมีหน้าตาของซิกเนเจอร์ประมาณนี้:
fn add(self, s: &str) -> String {ในไลบรารีมาตรฐานจริงๆ เมธอด add จะถูกนิยามขึ้นโดยใช้เจเนอริกและชนิดข้อมูลร่วม (associated types) แต่ในที่นี้เราแทนที่ด้วยชนิดข้อมูลรูปธรรมเพื่อให้เห็นภาพชัดเจน ซึ่งตรงกับสิ่งที่จะเกิดขึ้นเมื่อเราเรียกใช้เมธอดนี้กับค่าของ String (เราจะได้เรียนรู้เรื่องเจเนอริกในบทที่ 10) ซิกเนเจอร์นี้จะช่วยไขข้อข้องใจว่าเหตุใดตัวดำเนินการ + จึงมีพฤติกรรมเช่นนั้น
ประการแรก พารามิเตอร์ s2 มีเครื่องหมาย & นำหน้า ซึ่งหมายความว่าเรากำลังนำเรเฟอเรนซ์ของสตริงตัวที่สองไปบวกเข้ากับสตริงตัวแรก นั่นเป็นไปตามที่กำหนดไว้ในพารามิเตอร์ s ของฟังก์ชัน add: นั่นคือเราสามารถนำสตริงสไลซ์มาบวกต่อท้าย String ได้เท่านั้น แต่ไม่สามารถนำค่า String สองตัวมาบวกกันตรงๆ ได้ ทว่าคุณอาจสังเกตว่าชนิดข้อมูลของ &s2 จริงๆ แล้วคือ &String ไม่ใช่ &str ตามที่ระบุไว้ในพารามิเตอร์ตัวที่สองของ add แล้วเหตุใดโค้ดในลิสติ้ง 8-18 จึงคอมไพล์ผ่านได้ล่ะ?
สาเหตุที่เราสามารถส่ง &s2 เข้าไปในการเรียก add ได้ เป็นเพราะคอมไพเลอร์สามารถแปลงค่าอาร์กิวเมนต์จาก &String ให้กลายเป็น &str ได้โดยอัตโนมัติ เมื่อเราเรียกเมธอด add ทาง Rust จะใช้กลไกที่เรียกว่า deref coercion ซึ่งในกรณีนี้จะช่วยแปลง &s2 ให้กลายเป็น &s2[..] (เราจะได้พูดคุยเกี่ยวกับ deref coercion อย่างละเอียดในบทที่ 15) และเนื่องจาก add ไม่ได้ยึดสิทธิ์ความเป็นเจ้าของของพารามิเตอร์ s ไป ตัวแปร s2 จึงยังคงเป็น String ที่สามารถนำไปใช้งานต่อได้ตามปกติหลังจากการบวกนี้
ประการที่สอง เมื่อสังเกตในซิกเนเจอร์ของฟังก์ชัน จะเห็นว่า add รับความเป็นเจ้าของของ self ไป เนื่องจากตัวแปร self ไม่มี เครื่องหมาย & กำกับอยู่ ซึ่งหมายความว่าตัวแปร s1 ในลิสติ้ง 8-18 จะถูกย้ายกรรมสิทธิ์ (moved) เข้าไปในฟังก์ชัน add และจะไม่สามารถนำมาใช้งานได้อีกต่อไปหลังจากนั้น ดังนั้น แม้ว่าคำสั่ง let s3 = s1 + &s2; จะดูเหมือนการคัดลอกสตริงทั้งสองตัวเพื่อสร้างสตริงตัวที่สามขึ้นมาใหม่ แต่ในความเป็นจริงแล้ว สเตตเมนต์นี้จะยึดเอา s1 เข้าไป แล้วนำสำเนาของข้อความใน s2 มาต่อท้าย จากนั้นจึงส่งมอบกรรมสิทธิ์ของผลลัพธ์กลับออกมา ซึ่งการทำเช่นนี้มีประสิทธิภาพในการทำงานสูงกว่าการสร้างและคัดลอกข้อมูลใหม่ทั้งหมดหลายเท่า
อย่างไรก็ตาม หากเราจำเป็นต้องเชื่อมต่อสตริงหลายๆ ตัวเข้าด้วยกัน พฤติกรรมของตัวดำเนินการ + ก็จะเริ่มดูเกะกะและอ่านยาก:
fn main() {
let s1 = String::from("tic");
let s2 = String::from("tac");
let s3 = String::from("toe");
let s = s1 + "-" + &s2 + "-" + &s3;
}ณ จุดนี้ ตัวแปร s จะมีค่าเป็น tic-tac-toe แต่ด้วยเครื่องหมาย + และเครื่องหมายคำพูด " ที่กระจายอยู่เต็มไปหมด จึงทำให้ไล่อ่านและทำความเข้าใจได้ยากว่าเกิดอะไรขึ้น สำหรับการนำสตริงหลายตัวมารวมกันในลักษณะนี้ เราสามารถเปลี่ยนมาใช้มาโคร format! แทนได้อย่างสวยงาม:
fn main() {
let s1 = String::from("tic");
let s2 = String::from("tac");
let s3 = String::from("toe");
let s = format!("{s1}-{s2}-{s3}");
}โค้ดนี้ก็กำหนดค่าให้ s เป็น tic-tac-toe เช่นเดียวกัน โดยมาโคร format! จะทำงานคล้ายกับ println! ทุกประการ เพียงแต่แทนที่จะพิมพ์ข้อความออกทางหน้าจอ มันจะสร้างและส่งค่า String ที่บรรจุข้อความดังกล่าวกลับออกมาแทน โค้ดเวอร์ชันที่ใช้ format! จะอ่านทำความเข้าใจได้ง่ายกว่ามากอย่างเห็นได้ชัด และโค้ดที่มาโคร format! สร้างขึ้นจะทำงานผ่านเรเฟอเรนซ์ทั้งหมด การเรียกคำสั่งนี้จึงไม่มีการยึดสิทธิ์ความเป็นเจ้าของของพารามิเตอร์ตัวใดไปเลย
การจัดดัชนีสตริง
ในภาษาโปรแกรมอื่นๆ ส่วนใหญ่ การเข้าถึงอักขระแต่ละตัวในสตริงด้วยการระบุดัชนีถือเป็นการทำงานพื้นฐานทั่วไปที่ทำได้ตามปกติ อย่างไรก็ตาม หากคุณพยายามเข้าถึงตัวอักษรใน String ด้วยวากยสัมพันธ์ดัชนีในภาษา Rust คุณจะพบกับข้อผิดพลาดทันที ลองพิจารณาโค้ดที่ไม่ถูกต้องในลิสติ้ง 8-19
fn main() {
let s1 = String::from("hi");
let h = s1[0];
}โค้ดนี้จะส่งผลให้คอมไพเลอร์แจ้งข้อผิดพลาดดังต่อไปนี้:
$ cargo run
Compiling collections v0.1.0 (file:///projects/collections)
error[E0277]: the type `str` cannot be indexed by `{integer}`
--> src/main.rs:3:16
|
3 | let h = s1[0];
| ^ string indices are ranges of `usize`
|
= help: the trait `SliceIndex<str>` is not implemented for `{integer}`
= note: you can use `.chars().nth()` or `.bytes().nth()`
for more information, see chapter 8 in The Book: <https://doc.rust-lang.org/book/ch08-02-strings.html#indexing-into-strings>
help: `usize` implements trait `SliceIndex<T>`
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/slice/index.rs:179:0
|
= note: `SliceIndex<[T]>`
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/core/src/bstr/traits.rs:197:0
|
= note: `SliceIndex<ByteStr>`
= note: required for `String` to implement `Index<{integer}>`
For more information about this error, try `rustc --explain E0277`.
error: could not compile `collections` (bin "collections") due to 1 previous error
ข้อความผิดพลาดนี้บอกเรื่องราวไว้อย่างชัดเจนว่า: สตริงในภาษา Rust ไม่รองรับการเข้าถึงผ่านดัชนี แต่ทำไมถึงเป็นเช่นนั้นล่ะ? ในการตอบคำถามนี้ เราจำเป็นต้องทำความเข้าใจวิธีการที่ Rust จัดเก็บสตริงไว้ในหน่วยความจำเสียก่อน
การแทนข้อมูลภายใน
แท้จริงแล้ว String คือตัวห่อหุ้มที่ครอบอยู่เหนือ Vec<u8> ลองมาดูตัวอย่างข้อความที่เข้ารหัส UTF-8 อย่างถูกต้องจากลิสติ้ง 8-14 กัน เริ่มจากข้อความนี้:
fn main() {
let hello = String::from("السلام عليكم");
let hello = String::from("Dobrý den");
let hello = String::from("Hello");
let hello = String::from("שלום");
let hello = String::from("नमस्ते");
let hello = String::from("こんにちは");
let hello = String::from("안녕하세요");
let hello = String::from("你好");
let hello = String::from("Olá");
let hello = String::from("Здравствуйте");
let hello = String::from("Hola");
}ในกรณีนี้ ค่า len จะมีค่าเท่ากับ 4 ซึ่งหมายความว่าเวกเตอร์ที่จัดเก็บสตริง "Hola" มีความยาวเท่ากับ 4 ไบต์ เนื่องจากตัวอักษรละตินแต่ละตัวจะใช้พื้นที่จัดเก็บ 1 ไบต์พอดีเมื่อเข้ารหัสด้วย UTF-8 แต่บรรทัดถัดไปนี้อาจทำให้คุณประหลาดใจ (โปรดสังเกตว่าสตริงนี้เริ่มต้นด้วยตัวอักษรซีริลลิกตัวพิมพ์ใหญ่ Ze ไม่ใช่เลข 3):
fn main() {
let hello = String::from("السلام عليكم");
let hello = String::from("Dobrý den");
let hello = String::from("Hello");
let hello = String::from("שלום");
let hello = String::from("नमस्ते");
let hello = String::from("こんにちは");
let hello = String::from("안녕하세요");
let hello = String::from("你好");
let hello = String::from("Olá");
let hello = String::from("Здравствуйте");
let hello = String::from("Hola");
}หากมีคนถามคุณว่าข้อความนี้มีความยาวกี่ตัวอักษร คุณอาจตอบว่า 12 ตัว แต่ในความเป็นจริงแล้ว คำตอบของ Rust คือ 24 ไบต์: นั่นคือจำนวนไบต์ที่ต้องใช้ในการเข้ารหัสคำว่า “Здравствуйте” ในแบบ UTF-8 เนื่องจากค่าสเกลาร์ยูนิโคดแต่ละตัวในข้อความนี้ ต้องใช้พื้นที่จัดเก็บถึง 2 ไบต์ ดังนั้น ตำแหน่งดัชนีไบต์ในสตริงจึงไม่ได้ตรงกับตัวอักษรยูนิโคดที่สมบูรณ์เสมอไป เพื่อสาธิตให้เห็นภาพ ลองพิจารณาโค้ดที่ไม่ถูกต้องด้านล่างนี้:
let hello = "Здравствуйте";
let answer = &hello[0];คุณคงพอเดาได้แล้วว่า answer จะไม่ได้เป็นตัวอักษร З อย่างแน่นอน เพราะเมื่อเข้ารหัสเป็น UTF-8 ไบต์แรกของ З คือ 208 และไบต์ที่สองคือ 151 ดังนั้นหากดึงค่าออกมาได้ answer ก็ควรจะเป็นตัวเลข 208 แต่ 208 เพียงโดดๆ นั้นไม่ใช่ตัวอักษรที่สมบูรณ์และถูกต้องในตัวเองเลย การส่งค่า 208 กลับออกมาย่อมไม่ใช่สิ่งที่ผู้ใช้ต้องการเมื่อพวกเขาต้องการตัวอักษรตัวแรกของข้อความนี้อย่างแน่นอน แต่ทว่านั่นคือข้อมูลเพียงสิ่งเดียวที่ Rust มีอยู่ที่ตำแหน่งไบต์ดัชนีที่ 0 โดยทั่วไปแล้วผู้ใช้ย่อมไม่ต้องการให้โปรแกรมส่งค่าไบต์ดิบกลับออกมา แม้ว่าข้อความนั้นจะมีแต่ตัวอักษรภาษาอังกฤษก็ตาม: เพราะหากคำสั่งอย่าง &"hi"[0] ใช้งานได้จริงและคืนค่าไบต์ออกมา มันก็จะได้ค่าเป็น 104 ไม่ใช่ตัวอักษร h
ดังนั้น คำตอบก็คือ เพื่อหลีกเลี่ยงการส่งค่าที่ไม่ตรงกับความคาดหวังกลับออกมา ซึ่งอาจกลายเป็นบั๊กที่ตรวจพบได้ยากในภายหลัง Rust จึงเลือกที่จะไม่อนุญาตให้คอมไพล์โค้ดประเภทนี้ผ่านเลยตั้งแต่แรก เพื่อช่วยตัดไฟแต่ต้นลมตั้งแต่ในขั้นตอนการพัฒนา
ไบต์ ค่าสเกลาร์ และกลุ่มกราฟีม
อีกประเด็นหนึ่งที่สำคัญเกี่ยวกับ UTF-8 ก็คือ ในมุมมองของภาษา Rust นั้น มีวิธีการมองข้อมูลสตริงที่เกี่ยวข้องอยู่ 3 มุมมองด้วยกัน: นั่นคือมองเป็น ไบต์ (bytes), มองเป็น ค่าสเกลาร์ (scalar values) และมองเป็น กลุ่มกราฟีม (grapheme clusters - ซึ่งเป็นสิ่งที่ใกล้เคียงกับคำว่า ตัวอักษร ในสายตามนุษย์มากที่สุด)
หากเราลองดูคำในภาษาฮินดีว่า “नमस्ते” ซึ่งเขียนด้วยอักษรเทวนาครี มันจะถูกจัดเก็บไว้ในหน่วยความจำเป็นเวกเตอร์ของค่า u8 ดังนี้:
[224, 164, 168, 224, 164, 174, 224, 164, 184, 224, 165, 141, 224, 164, 164,
224, 165, 135]
รวมทั้งหมด 18 ไบต์ และนี่คือรูปแบบที่คอมพิวเตอร์ใช้จัดเก็บข้อมูลนี้จริงๆ ในระดับล่าง แต่หากเรามองข้อมูลชุดนี้เป็นค่าสเกลาร์ยูนิโคด ซึ่งตรงกับชนิดข้อมูล char ของ Rust ไบต์เหล่านั้นจะถูกแปลงออกมาได้ดังนี้:
['न', 'म', 'स', '्', 'त', 'े']
ตรงนี้จะมีค่า char ทั้งหมด 6 ตัว แต่ตัวที่ 4 และตัวที่ 6 ไม่ใช่ตัวพยัญชนะเดี่ยวๆ: หากแต่เป็นเครื่องหมายวรรณยุกต์หรือสระผสม (diacritics) ที่ไม่สามารถสื่อความหมายได้ด้วยตัวเอง และสุดท้าย หากเรามองพวกมันในฐานะกลุ่มกราฟีม (grapheme clusters) เราก็จะได้สิ่งที่มนุษย์ทั่วไปมองเห็นเป็นตัวอักษร 4 ตัวที่ประกอบกันเป็นคำภาษาฮินดีนี้:
["न", "म", "स्", "ते"]
Rust ได้จัดเตรียมวิธีการตีความข้อมูลสตริงดิบที่คอมพิวเตอร์จัดเก็บไว้ในหลากหลายมุมมอง เพื่อให้แต่ละโปรแกรมสามารถเลือกวิธีการตีความที่เหมาะสมกับความต้องการของตนเองได้ ไม่ว่าข้อมูลนั้นจะเขียนขึ้นด้วยภาษาใดในโลกก็ตาม
และเหตุผลประการสุดท้ายที่ Rust ไม่อนุญาตให้เราเข้าถึงตัวอักษรใน String ผ่านดัชนีได้ ก็คือ โดยทั่วไปแล้วการเข้าถึงผ่านดัชนีจะถูกคาดหวังว่าต้องใช้เวลาคงที่ระดับ O(1) เสมอ แต่สำหรับ String นั้น Rust ไม่สามารถการันตีประสิทธิภาพระดับดังกล่าวได้เลย เพราะ Rust จะต้องคอยไล่อ่านข้อมูลตั้งแต่ต้นข้อความไปจนถึงตำแหน่งดัชนี เพื่อตรวจสอบว่ามีตัวอักษรที่สมบูรณ์อยู่กี่ตัว
การสไลซ์สตริง
การเข้าถึงข้อมูลในสตริงด้วยดัชนีมักเป็นแนวทางที่ไม่ดี เพราะไม่สามารถระบุได้อย่างชัดเจนว่าผลลัพธ์ที่ได้ควรเป็นชนิดข้อมูลใด: จะเป็นค่าไบต์, ตัวอักษร, กลุ่มกราฟีม หรือสตริงสไลซ์กันแน่ ดังนั้น หากคุณมีความจำเป็นต้องใช้ดัชนีเพื่อตัดแบ่งสตริงสไลซ์จริงๆ Rust จึงบังคับให้คุณต้องระบุอย่างเฉพาะเจาะจงมากยิ่งขึ้น
แทนที่จะใช้เครื่องหมายก้ามปู [] กับตัวเลขเดี่ยวๆ คุณสามารถใช้ [] ร่วมกับช่วง (range) เพื่อตัดแบ่งสตริงสไลซ์ที่ครอบคลุมช่วงของไบต์ที่ต้องการออกมาได้:
#![allow(unused)]
fn main() {
let hello = "Здравствуйте";
let s = &hello[0..4];
}ในตัวอย่างนี้ s จะมีชนิดข้อมูลเป็น &str ที่บรรจุข้อมูล 4 ไบต์แรกของข้อความ และเนื่องจากเราทราบมาก่อนหน้านี้แล้วว่าอักษรแต่ละตัวในข้อความนี้ใช้พื้นที่ 2 ไบต์ นั่นหมายความว่าค่าของ s ก็คือ Зд
แต่หากเราพยายามตัดแบ่งสตริงเพียงแค่บางส่วนของไบต์ที่ประกอบเป็นตัวอักษร เช่น เขียนว่า &hello[0..1] ตัว Rust จะเกิดการแพนิก (panic) ในตอนรันไทม์ทันที ในลักษณะเดียวกับเมื่อมีการเข้าถึงดัชนีที่อยู่นอกช่วงในเวกเตอร์:
$ cargo run
Compiling collections v0.1.0 (file:///projects/collections)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.43s
Running `target/debug/collections`
thread 'main' (6017738) panicked at src/main.rs:4:19:
end byte index 1 is not a char boundary; it is inside 'З' (bytes 0..2 of string)
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
คุณจึงควรใช้ความระมัดระวังอย่างยิ่งเมื่อสร้างสตริงสไลซ์ด้วยช่วงตัวเลข เพราะการระบุตำแหน่งผิดอาจทำให้โปรแกรมของคุณแครชดับได้
การวนซ้ำบนสตริง
วิธีที่ดีที่สุดในการจัดการกับส่วนประกอบย่อยๆ ของสตริง คือการระบุอย่างชัดเจนว่าคุณต้องการแยกเป็นรายตัวอักษรหรือแยกเป็นรายไบต์ หากคุณต้องการทำงานกับค่าสเกลาร์ยูนิโคดแต่ละตัว ให้เรียกใช้เมธอด chars โดยการเรียก chars บนข้อความ “Зд” จะแยกและส่งค่าชนิด char 2 ตัวกลับออกมา ซึ่งคุณสามารถวนลูปเพื่อเข้าถึงสมาชิกแต่ละตัวได้ดังนี้:
#![allow(unused)]
fn main() {
for c in "Зд".chars() {
println!("{c}");
}
}โค้ดนี้จะพิมพ์ผลลัพธ์ออกมาดังนี้:
З
д
หรืออีกทางเลือกหนึ่ง หากงานของคุณต้องการข้อมูลในระดับไบต์ดิบ เมธอด bytes ก็จะส่งแต่ละไบต์กลับออกมา ซึ่งอาจเหมาะสมกับโดเมนงานของคุณมากกว่า:
#![allow(unused)]
fn main() {
for b in "Зд".bytes() {
println!("{b}");
}
}โค้ดนี้จะพิมพ์ค่าทั้ง 4 ไบต์ที่ประกอบกันเป็นข้อความนี้ออกมา:
208
151
208
180
แต่โปรดจำไว้เสมอว่า ค่าสเกลาร์ยูนิโคดที่ถูกต้องหนึ่งตัว อาจประกอบขึ้นจากข้อมูลมากกว่า 1 ไบต์
ส่วนการดึงข้อมูลออกมาเป็นกลุ่มกราฟีม (grapheme clusters) จากสตริง เช่น ในกรณีของอักษรเทวนาครีนั้น มีความซับซ้อนอย่างมาก ไลบรารีมาตรฐานของ Rust จึงไม่ได้รวมฟังก์ชันการทำงานนี้ไว้ในตัว แต่คุณสามารถค้นหาเครตที่มีฟังก์ชันดังกล่าวมาใช้งานได้จาก crates.io หากโปรเจกต์ของคุณต้องการความสามารถนี้
การจัดการความซับซ้อนของสตริง
โดยสรุปแล้ว เรื่องของสตริงนั้นมีความซับซ้อนอย่างยิ่ง ภาษาโปรแกรมแต่ละภาษาต่างก็เลือกแนวทางในการนำเสนอความซับซ้อนนี้แก่โปรแกรมเมอร์แตกต่างกันไป แต่สำหรับภาษา Rust นั้น ได้เลือกที่จะให้ความถูกต้องแม่นยำในการจัดการข้อมูล String เป็นพฤติกรรมเริ่มต้นของโปรแกรมทุกโปรแกรม ซึ่งหมายความว่าโปรแกรมเมอร์จะต้องใส่ใจและคิดทบทวนเกี่ยวกับการจัดการข้อมูล UTF-8 อย่างรอบคอบตั้งแต่ขั้นตอนแรก แม้ว่าการแลกเปลี่ยนนี้จะทำให้เราต้องเผชิญกับความซับซ้อนของสตริงอย่างตรงไปตรงมามากกว่าภาษาอื่นๆ แต่ก็ช่วยป้องกันไม่ให้คุณต้องไปปวดหัวกับข้อผิดพลาดที่เกี่ยวกับอักขระที่ไม่ใช่ ASCII ในช่วงท้ายของการพัฒนาซอฟต์แวร์
และข่าวดีก็คือ ไลบรารีมาตรฐานของ Rust ได้จัดเตรียมฟังก์ชันและเมธอดที่มีประโยชน์มากมายที่สร้างขึ้นบนชนิดข้อมูล String และ &str เพื่อช่วยให้คุณสามารถจัดการกับสถานการณ์ที่ซับซ้อนเหล่านี้ได้อย่างถูกต้องและปลอดภัย อย่าลืมศึกษาเอกสารประกอบเพื่อค้นหาเมธอดดีๆ เช่น contains สำหรับค้นหาข้อความภายในสตริง หรือ replace สำหรับแทนที่ข้อความบางส่วนด้วยข้อความอื่น
คราวนี้ เราลองมาดูคอลเลกชันอีกตัวที่มีความซับซ้อนน้อยกว่ากันดีกว่า: นั่นคือ แฮชแมป (hash maps)!
เก็บคีย์พร้อมค่าที่เชื่อมโยงกันในแฮชแมป
เก็บคีย์พร้อมค่าที่เชื่อมโยงกันในแฮชแมป
คอลเลกชันพื้นฐานตัวสุดท้ายที่เราจะพูดถึงคือ แฮชแมป (hash map) โดยประเภท HashMap<K, V> จะเก็บการจับคู่ระหว่างคีย์ประเภท K กับค่าประเภท V โดยอาศัย ฟังก์ชันแฮช (hashing function) ซึ่งเป็นตัวกำหนดวิธีการจัดวางคีย์และค่าเหล่านี้ลงในหน่วยความจำ ภาษาโปรแกรมหลายภาษารองรับโครงสร้างข้อมูลแบบนี้ แต่มักเรียกด้วยชื่อที่ต่างกันไป เช่น hash, map, object, hash table, dictionary หรือ associative array
แฮชแมปมีประโยชน์เมื่อคุณต้องการค้นหาข้อมูลด้วยคีย์ (ซึ่งเป็นประเภทข้อมูลใดก็ได้) แทนที่จะค้นหาด้วยดัชนีเหมือนกับเวกเตอร์ ตัวอย่างเช่น ในเกม คุณสามารถใช้แฮชแมปเก็บคะแนนของแต่ละทีม โดยใช้ชื่อทีมเป็นคีย์ และคะแนนของทีมนั้นเป็นค่า เพียงแค่ระบุชื่อทีม คุณก็สามารถดึงคะแนนของทีมดังกล่าวออกมาได้ทันที
ในหัวข้อนี้เราจะแนะนำ API พื้นฐานของแฮชแมป แต่ยังมีฟังก์ชันและลูกเล่นอีกมากมายที่ไลบรารีมาตรฐานนิยามไว้สำหรับ HashMap<K, V> ซึ่งคุณสามารถดูรายละเอียดเพิ่มเติมได้จากเอกสารประกอบของไลบรารีมาตรฐานเช่นเคย
การสร้างแฮชแมปใหม่
วิธีหนึ่งในการสร้างแฮชแมปว่างเปล่าคือการเรียกใช้ new แล้วเพิ่มข้อมูลด้วย insert ในลิสติ้ง 8-20 เราจะเก็บคะแนนของสองทีมชื่อ Blue และ Yellow โดยทีม Blue เริ่มต้นด้วย 10 คะแนน และทีม Yellow เริ่มต้นด้วย 50 คะแนน
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.insert(String::from("Yellow"), 50);
}สังเกตว่าเราจำเป็นต้อง use ตัว HashMap มาจากส่วนคอลเลกชันของไลบรารีมาตรฐานก่อน เพราะในบรรดาคอลเลกชันพื้นฐานทั้งสามชนิดนี้ แฮชแมปถูกใช้งานน้อยที่สุด จึงไม่ได้ถูกดึงเข้าสู่ขอบเขต (scope) โดยอัตโนมัติใน prelude นอกจากนี้ แฮชแมปยังได้รับการสนับสนุนจากไลบรารีมาตรฐานน้อยกว่า เช่น ไม่มีแมโครในตัวสำหรับสร้างแฮชแมปเหมือนกับ vec!
เช่นเดียวกับเวกเตอร์ แฮชแมปจัดเก็บข้อมูลไว้บนฮีป (heap) โดย HashMap ในตัวอย่างนี้มีคีย์เป็นประเภท String และค่าเป็นประเภท i32 และเฉกเช่นเดียวกับเวกเตอร์ ข้อมูลในแฮชแมปจะต้องเป็นประเภทเดียวกันทั้งหมด (homogeneous) นั่นคือ คีย์ทุกตัวจะต้องเป็นประเภทเดียวกัน และค่าทุกตัวก็จะต้องเป็นประเภทเดียวกันด้วย
การเข้าถึงค่าในแฮชแมป
เราสามารถดึงค่าออกจากแฮชแมปได้โดยส่งคีย์ของมันให้เมธอด get ดังที่แสดงในลิสติ้ง 8-21
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.insert(String::from("Yellow"), 50);
let team_name = String::from("Blue");
let score = scores.get(&team_name).copied().unwrap_or(0);
}ในตัวอย่างนี้ ตัวแปร score จะได้รับค่าของทีม Blue ซึ่งผลลัพธ์คือ 10 โดยเมธอด get จะคืนค่าเป็น Option<&V> หากไม่มีคีย์ดังกล่าวอยู่ในแฮชแมป เมธอด get จะคืนค่า None โปรแกรมนี้จัดการกับ Option ดังกล่าวโดยการเรียกใช้ copied เพื่อเปลี่ยนจาก Option<&i32> ให้กลายเป็น Option<i32> (คัดลอกค่าออกมา) จากนั้นใช้ unwrap_or เพื่อกำหนดให้ score มีค่าเป็น 0 หาก scores ไม่มีคีย์นั้นอยู่
เราสามารถวนซ้ำผ่านคู่คีย์-ค่าทุกคู่ในแฮชแมปในลักษณะคล้ายกับที่เราทำกับเวกเตอร์ โดยใช้ลูป for:
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.insert(String::from("Yellow"), 50);
for (key, value) in &scores {
println!("{key}: {value}");
}
}โค้ดนี้จะพิมพ์แต่ละคู่ในลำดับใดก็ได้:
Yellow: 50
Blue: 10
การจัดการความเป็นเจ้าของในแฮชแมป
สำหรับประเภทข้อมูลที่อิมพลีเมนต์เทรต Copy อย่างเช่น i32 ค่าจะถูกคัดลอกเข้าไปยังแฮชแมป ส่วนประเภทข้อมูลที่ถือครองความเป็นเจ้าของอย่างเช่น String ค่าจะถูกย้าย (move) และแฮชแมปจะกลายเป็นเจ้าของค่าเหล่านั้นแทน ดังที่แสดงในลิสติ้ง 8-22
fn main() {
use std::collections::HashMap;
let field_name = String::from("Favorite color");
let field_value = String::from("Blue");
let mut map = HashMap::new();
map.insert(field_name, field_value);
// field_name and field_value are invalid at this point, try using them and
// see what compiler error you get!
}เราจะไม่สามารถใช้งานตัวแปร field_name และ field_value ได้อีกต่อไปหลังจากที่พวกมันถูกย้ายเข้าไปในแฮชแมปด้วยการเรียก insert
หากเราแทรกเรเฟอเรนซ์ของค่าต่างๆ เข้าไปในแฮชแมป ตัวค่าเองจะไม่ถูกย้ายเข้าไปในแฮชแมป แต่ค่าที่เรเฟอเรนซ์นั้นชี้อยู่จะต้องมีอายุใช้งาน (valid) อย่างน้อยนานเท่ากับที่แฮชแมปยังคงใช้งานได้ เราจะพูดคุยเรื่องนี้กันอย่างละเอียดในหัวข้อ “การตรวจสอบความถูกต้องของเรเฟอเรนซ์ด้วยไลฟ์ไทม์” ในบทที่ 10
การอัปเดตแฮชแมป
แม้ว่าจำนวนคู่คีย์-ค่าในแฮชแมปจะเพิ่มขึ้นได้เรื่อยๆ แต่ละคีย์ที่ไม่ซ้ำกันสามารถเชื่อมโยงกับค่าได้เพียงค่าเดียวในเวลาเดียวกันเท่านั้น (แต่ไม่ใช่ในทางกลับกัน ตัวอย่างเช่น ทั้งทีม Blue และทีม Yellow ต่างก็อาจมีคะแนนเป็น 10 เก็บอยู่ในแฮชแมป scores ได้พร้อมกัน)
เมื่อคุณต้องการปรับเปลี่ยนข้อมูลในแฮชแมป คุณต้องตัดสินใจว่าจะจัดการอย่างไรเมื่อคีย์นั้นมีค่าถูกกำหนดไว้อยู่ก่อนแล้ว คุณอาจเลือกแทนที่ค่าเดิมด้วยค่าใหม่ไปเลยโดยไม่สนใจค่าเดิม หรือจะเก็บค่าเดิมไว้โดยไม่สนใจค่าใหม่ และจะเพิ่มค่าใหม่เข้าไปก็ต่อเมื่อคีย์นั้น ยังไม่มี ค่าอยู่ หรือคุณอาจเลือกที่จะรวมค่าเดิมเข้ากับค่าใหม่ มาดูวิธีการทำในแต่ละกรณีกัน!
การเขียนทับค่า
หากเราแทรกคีย์และค่าคู่หนึ่งลงในแฮชแมป แล้วแทรกคีย์เดิมซ้ำอีกครั้งด้วยค่าใหม่ ค่าเดิมที่ผูกกับคีย์นั้นจะถูกแทนที่ แม้ว่าโค้ดในลิสติ้ง 8-23 จะเรียก insert สองครั้ง แต่แฮชแมปจะมีคู่คีย์-ค่าเพียงคู่เดียวเท่านั้น เพราะเราแทรกค่าให้กับคีย์ของทีม Blue ทั้งสองครั้ง
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.insert(String::from("Blue"), 25);
println!("{scores:?}");
}โค้ดนี้จะพิมพ์ {"Blue": 25} ออกมา ซึ่งค่าเดิมที่เป็น 10 ได้ถูกเขียนทับไปแล้ว
การเพิ่มคีย์และค่าเฉพาะเมื่อยังไม่มีคีย์นั้น
การตรวจสอบว่าคีย์ใดคีย์หนึ่งมีอยู่ในแฮชแมปพร้อมกับค่าอยู่แล้วหรือไม่ แล้วดำเนินการตามเงื่อนไขต่อไปนี้ถือเป็นกรณีที่พบได้บ่อย: ถ้าคีย์นั้นมีอยู่ในแฮชแมปอยู่แล้ว ก็ให้คงค่าเดิมไว้เช่นนั้น แต่ถ้ายังไม่มีคีย์นั้นอยู่ ให้แทรกคีย์และค่าใหม่เข้าไป
แฮชแมปมี API พิเศษสำหรับงานนี้โดยเฉพาะชื่อว่า entry ซึ่งรับคีย์ที่คุณต้องการตรวจสอบเป็นพารามิเตอร์ ค่าที่ส่งกลับจากเมธอด entry คือ enum ชื่อ Entry ซึ่งเป็นตัวแทนของค่าที่อาจจะมีอยู่หรือไม่มีอยู่ก็ได้ สมมติว่าเราต้องการตรวจสอบว่าคีย์ของทีม Yellow มีค่าผูกอยู่แล้วหรือไม่ ถ้ายังไม่มี เราต้องการแทรกค่า 50 เข้าไป และทำแบบเดียวกันนี้กับทีม Blue เมื่อใช้ API entry โค้ดจะเขียนได้ดังลิสติ้ง 8-24
fn main() {
use std::collections::HashMap;
let mut scores = HashMap::new();
scores.insert(String::from("Blue"), 10);
scores.entry(String::from("Yellow")).or_insert(50);
scores.entry(String::from("Blue")).or_insert(50);
println!("{scores:?}");
}เมธอด or_insert บน Entry ถูกกำหนดมาให้คืนค่าเป็นเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ไปยังค่าของคีย์ Entry นั้นหากมีคีย์ดังกล่าวอยู่แล้ว แต่ถ้ายังไม่มี มันจะแทรกค่าจากพารามิเตอร์เข้าไปเป็นค่าใหม่ของคีย์นี้ แล้วส่งคืนเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ไปยังค่าใหม่นั้น เทคนิคนี้ช่วยให้โค้ดดูสะอาดตาขึ้นมากเมื่อเทียบกับการเขียนตรรกะตรวจสอบด้วยตัวเอง และยังทำงานร่วมกับตัวตรวจการยืม (borrow checker) ได้อย่างราบรื่นอีกด้วย
เมื่อรันโค้ดในลิสติ้ง 8-24 จะพิมพ์ {"Yellow": 50, "Blue": 10} ออกมา การเรียก entry ครั้งแรกจะแทรกคีย์ของทีม Yellow พร้อมค่า 50 เพราะทีม Yellow ยังไม่มีค่าอยู่ก่อน แต่การเรียก entry ครั้งที่สองจะไม่มีการเปลี่ยนแปลงใดๆ ในแฮชแมป เพราะทีม Blue มีค่าเป็น 10 อยู่แล้ว
การอัปเดตค่าจากค่าเดิม
อีกกรณีการใช้งานหนึ่งที่พบบ่อยสำหรับแฮชแมปคือ การค้นหาค่าของคีย์แล้วนำมาอัปเดตต่อยอดจากค่าเดิม ตัวอย่างเช่น ลิสติ้ง 8-25 แสดงโค้ดที่นับจำนวนครั้งที่แต่ละคำปรากฏในข้อความ โดยเราจะใช้แฮชแมปที่มีคำเป็นคีย์ และเพิ่มค่าตัวนับขึ้นเรื่อยๆ เพื่อติดตามว่าเราพบคำนั้นไปแล้วกี่ครั้ง หากเพิ่งเคยพบคำนั้นเป็นครั้งแรก เราจะแทรกค่าเริ่มต้นเป็น 0 เข้าไปก่อน
fn main() {
use std::collections::HashMap;
let text = "hello world wonderful world";
let mut map = HashMap::new();
for word in text.split_whitespace() {
let count = map.entry(word).or_insert(0);
*count += 1;
}
println!("{map:?}");
}โค้ดนี้จะพิมพ์ {"world": 2, "hello": 1, "wonderful": 1} ออกมา ซึ่งคุณอาจเห็นคู่คีย์-ค่าเหล่านี้แสดงในลำดับที่ต่างไปจากนี้ได้: อย่าลืมว่าจากหัวข้อ “การเข้าถึงค่าในแฮชแมป” การวนซ้ำในแฮชแมปจะเกิดขึ้นในลำดับที่ไม่แน่นอน (arbitrary order)
เมธอด split_whitespace จะคืนค่าเป็นตัววนซ้ำ (iterator) บนสับสไลซ์ที่ถูกคั่นด้วยช่องว่างของข้อความใน text ส่วนเมธอด or_insert จะคืนค่าเป็นเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ (&mut V) ไปยังค่าของคีย์ที่ระบุ ในที่นี้เราจัดเก็บเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ดังกล่าวไว้ในตัวแปร count ดังนั้นหากต้องการกำหนดค่าใหม่ให้กับค่านั้น เราจะต้องดีเรเฟอเรนซ์ (dereference) count โดยใช้เครื่องหมายดอกจัน (*) เสียก่อน และเรเฟอเรนซ์แบบเปลี่ยนแปลงได้นี้จะหลุดออกจากขอบเขตเมื่อจบลูป for แต่ละรอบ การแก้ไขค่าทั้งหมดนี้จึงปลอดภัยและถูกต้องตามกฎการยืมทุกประการ
ฟังก์ชันแฮช
โดยค่าเริ่มต้น HashMap จะใช้ฟังก์ชันแฮชที่ชื่อว่า SipHash ซึ่งมีความสามารถในการป้องกันการโจมตีแบบปฏิเสธการให้บริการ (denial-of-service หรือ DoS) ที่พุ่งเป้าไปที่ตารางแฮช1 แม้นี่จะไม่ใช่อัลกอริทึมการแฮชที่เร็วที่สุด แต่ข้อแลกเปลี่ยนในเรื่องความปลอดภัยที่เพิ่มขึ้นเพื่อแลกกับประสิทธิภาพที่ลดลงเล็กน้อยนั้นถือว่าคุ้มค่า หากคุณทำโพรไฟล์ (profile) โค้ดแล้วพบว่าฟังก์ชันแฮชเริ่มต้นนี้ทำงานช้าเกินไปสำหรับความต้องการของคุณ คุณสามารถสลับไปใช้ฟังก์ชันอื่นได้โดยการระบุแฮชเชอร์ (hasher) ตัวอื่น โดย แฮชเชอร์ คือประเภทข้อมูลที่อิมพลีเมนต์เทรต BuildHasher ซึ่งเราจะพูดถึงเทรตและวิธีอิมพลีเมนต์เทรตใน บทที่ 10 และคุณไม่จำเป็นต้องเขียนแฮชเชอร์ขึ้นมาเองตั้งแต่ต้นเสมอไป เพราะบน crates.io มีไลบรารีที่ชุมชนผู้ใช้ Rust ร่วมกันแบ่งปัน ซึ่งมีแฮชเชอร์ที่อิมพลีเมนต์อัลกอริทึมแฮชยอดนิยมต่างๆ ไว้อย่างครบถ้วน
สรุป
เวกเตอร์, สตริง และแฮชแมปช่วยมอบความสามารถมากมายที่จำเป็นสำหรับโปรแกรมเวลาที่คุณต้องจัดเก็บ เข้าถึง และแก้ไขข้อมูล ต่อไปนี้คือแบบฝึกหัดที่คุณน่าจะพร้อมลงมือทำได้แล้วในตอนนี้:
- กำหนดรายการของจำนวนเต็มมาให้ ให้ใช้เวกเตอร์ในการหาและส่งคืนค่ามัธยฐาน (median ซึ่งเมื่อเรียงลำดับแล้วคือค่าที่อยู่ตำแหน่งกึ่งกลาง) และฐานนิยม (mode ซึ่งเป็นค่าที่ปรากฏบ่อยที่สุด โดยแฮชแมปจะมีประโยชน์มากในส่วนนี้) ของรายการนั้น
- แปลงข้อความสตริงเป็นภาษาพิกละติน (Pig Latin) โดยพยัญชนะตัวแรกของแต่ละคำจะถูกย้ายไปไว้ท้ายคำแล้วต่อท้ายด้วย -ay ดังนั้นคำว่า first จะกลายเป็น irst-fay ส่วนคำที่ขึ้นต้นด้วยสระ ให้เติม -hay ต่อท้ายแทน (เช่น apple จะกลายเป็น apple-hay) และอย่าลืมคำนึงถึงรายละเอียดเกี่ยวกับการเข้ารหัส UTF-8 ด้วย!
- ใช้แฮชแมปและเวกเตอร์เพื่อสร้างอินเทอร์เฟซแบบข้อความที่อนุญาตให้ผู้ใช้เพิ่มชื่อพนักงานเข้าสู่แผนกต่างๆ ของบริษัทได้ เช่น “Add Sally to Engineering” หรือ “Add Amir to Sales” จากนั้นเปิดให้ผู้ใช้สามารถเรียกดูรายชื่อพนักงานทั้งหมดในแผนกใดแผนกหนึ่ง หรือพนักงานทุกคนในบริษัทโดยจัดกลุ่มตามแผนก และเรียงลำดับตามตัวอักษร
เอกสาร API ของไลบรารีมาตรฐานมีคำอธิบายเมธอดต่างๆ ของเวกเตอร์ สตริง และแฮชแมป ซึ่งจะเป็นประโยชน์อย่างยิ่งสำหรับแบบฝึกหัดเหล่านี้!
จากนี้ไปเรากำลังจะก้าวเข้าสู่การเขียนโปรแกรมที่มีความซับซ้อนยิ่งขึ้น ซึ่งการทำงานต่างๆ อาจเกิดข้อผิดพลาดขึ้นได้ ดังนั้นจึงเป็นจังหวะที่เหมาะสมที่สุดที่เราจะมาพูดคุยกันถึงเรื่องการจัดการข้อผิดพลาด (error handling) ในบทถัดไป!
การจัดการข้อผิดพลาด
ความผิดพลาดเป็นเรื่องที่หลีกเลี่ยงไม่ได้ในการพัฒนาซอฟต์แวร์ Rust จึงมีฟีเจอร์มากมายสำหรับรับมือกับสถานการณ์ที่ไม่เป็นไปตามที่คาดหวัง ในหลายๆ กรณี Rust กำหนดให้คุณต้องตระหนักถึงโอกาสที่จะเกิดข้อผิดพลาดและเขียนโค้ดจัดการเตรียมไว้ก่อน โค้ดจึงจะสามารถคอมไพล์ผ่านได้ ข้อกำหนดนี้ช่วยให้โปรแกรมของคุณมีความเสถียรและทนทาน (robust) ยิ่งขึ้น เพราะมั่นใจได้ว่าคุณจะตรวจพบและจัดการกับข้อผิดพลาดได้อย่างเหมาะสมตั้งแต่ก่อนที่จะนำโค้ดขึ้นสู่ระบบจริง (production)!
Rust แบ่งข้อผิดพลาดออกเป็นสองกลุ่มหลัก ได้แก่ ข้อผิดพลาดที่กู้คืนได้และข้อผิดพลาดที่กู้คืนไม่ได้ สำหรับ ข้อผิดพลาดที่กู้คืนได้ (recoverable error) เช่น การเกิดข้อผิดพลาดประเภท ไม่พบไฟล์ (file not found) เรามักต้องการเพียงแค่แจ้งเตือนปัญหาให้ผู้ใช้ทราบแล้วลองทำงานใหม่อีกครั้ง ส่วน ข้อผิดพลาดที่กู้คืนไม่ได้ (unrecoverable error) มักเป็นสัญญาณของบั๊กเสมอ เช่น การพยายามเข้าถึงตำแหน่งที่เกินขอบเขตของอาร์เรย์ ซึ่งในกรณีนี้เราต้องการให้โปรแกรมหยุดทำงานในทันที
ภาษาโปรแกรมส่วนใหญ่ไม่ได้แยกความแตกต่างระหว่างข้อผิดพลาดทั้งสองประเภทนี้ และมักจัดการทั้งสองแบบด้วยวิธีเดียวกันผ่านกลไกอย่างข้อยกเว้น (exception) แต่ Rust ไม่มี exception ทว่าจะมีประเภทข้อมูล Result<T, E> สำหรับจัดการข้อผิดพลาดที่กู้คืนได้ และมีแมโคร panic! ที่จะสั่งหยุดการทำงานทันทีเมื่อโปรแกรมพบกับข้อผิดพลาดที่กู้คืนไม่ได้ ในบทนี้เราจะเริ่มต้นด้วยการเรียกใช้ panic! ก่อน จากนั้นจึงตามด้วยการส่งคืนค่า Result<T, E> นอกจากนี้ เรายังจะมาดูข้อพิจารณาว่าเมื่อใดที่เราควรพยายามกู้คืนจากข้อผิดพลาด และเมื่อใดที่เราควรปล่อยให้โปรแกรมหยุดทำงาน
ข้อผิดพลาดที่กู้คืนไม่ได้ด้วย panic!
ข้อผิดพลาดที่กู้คืนไม่ได้ด้วย panic!
ในบางครั้ง ข้อผิดพลาดร้ายแรงอาจเกิดขึ้นในโค้ดของคุณโดยที่โปรแกรมไม่สามารถจัดการอะไรต่อไปได้ ในสถานการณ์เช่นนี้ Rust มีแมโคร panic! ไว้รองรับ ในทางปฏิบัติ มีสองวิธีที่จะทำให้เกิดการแพนิก (panic): วิธีแรกคือการกระทำบางอย่างที่ทำให้โค้ดเกิด panic (เช่น การเข้าถึงข้อมูลในอาร์เรย์เกินตำแหน่งสิ้นสุด) หรือวิธีที่สองคือการเรียกใช้แมโคร panic! อย่างโจ่งแจ้งด้วยตัวเอง ไม่ว่าจะเป็นกรณีใด ทั้งคู่ล้วนส่งผลให้โปรแกรมของเราเกิด panic ขึ้น โดยตามค่าเริ่มต้นแล้ว เมื่อเกิด panic โปรแกรมจะพิมพ์ข้อความแสดงความผิดพลาด ทำการคลี่คลายสแตก (unwind) เคลียร์ข้อมูลออกจากสแตก แล้วปิดโปรแกรม นอกจากนี้ คุณยังสามารถตั้งค่าตัวแปรสภาพแวดล้อมเพื่อให้ Rust แสดงคอลสแตก (call stack) ในขณะที่เกิด panic ได้ ซึ่งจะช่วยให้คุณติดตามหาต้นตอของปัญหาได้ง่ายขึ้น
การคลี่คลายสแตกหรือการยกเลิกทันทีเมื่อเกิดการแพนิก
โดยค่าเริ่มต้น เมื่อเกิด panic โปรแกรมจะเริ่มทำการ คลี่คลายสแตก (unwinding) ซึ่งหมายความว่า Rust จะเดินย้อนกลับขึ้นไปตามสแตกและทำความสะอาด (clean up) ข้อมูลของแต่ละฟังก์ชันที่พบ ทว่ากระบวนการเดินย้อนและทำความสะอาดนี้ต้องใช้ทรัพยากรและการทำงานค่อนข้างมาก Rust จึงเปิดโอกาสให้คุณเลือกอีกทางเลือกหนึ่งได้ นั่นคือการ ยกเลิกทันที (aborting) ซึ่งจะยุติการทำงานของโปรแกรมลงทันทีโดยไม่ต้องเสียเวลาทำความสะอาดสแตก
ส่วนหน่วยความจำที่โปรแกรมเคยใช้งานอยู่นั้นจะถูกปล่อยให้เป็นหน้าที่ของระบบปฏิบัติการในการกวาดล้างคืนเอง หากในโปรเจกต์ของคุณต้องการให้ไฟล์ไบนารีผลลัพธ์มีขนาดเล็กที่สุดเท่าที่จะทำได้ คุณสามารถเปลี่ยนพฤติกรรมจาก unwinding เป็น aborting ได้เมื่อเกิด panic โดยการเพิ่ม
panic = 'abort'เข้าไปในส่วน[profile]ที่เกี่ยวข้องภายในไฟล์ Cargo.toml ตัวอย่างเช่น หากคุณต้องการให้ยกเลิกทันทีเมื่อเกิด panic ในโหมด release ให้กำหนดค่าดังนี้:[profile.release] panic = 'abort'
มาลองเรียกใช้ panic! ในโปรแกรมง่ายๆ กันดู:
fn main() {
panic!("crash and burn");
}เมื่อคุณรันโปรแกรม คุณจะเห็นผลลัพธ์ประมาณนี้:
$ cargo run
Compiling panic v0.1.0 (file:///projects/panic)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.25s
Running `target/debug/panic`
thread 'main' (6018279) panicked at src/main.rs:2:5:
crash and burn
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
การเรียกใช้ panic! ส่งผลให้เกิดข้อความแสดงข้อผิดพลาดในสองบรรทัดสุดท้าย โดยบรรทัดแรกจะแสดงข้อความ panic ของเราพร้อมกับตำแหน่งในซอร์สโค้ดที่เกิด panic ขึ้น: ตัวเลข src/main.rs:2:5 บ่งบอกว่ามันคือบรรทัดที่ 2 ตัวอักษรที่ 5 ในไฟล์ src/main.rs ของเรา
ในกรณีนี้ บรรทัดที่ถูกระบุเป็นโค้ดที่เราเขียนขึ้นเอง และหากเราเปิดไปดูที่บรรทัดนั้น เราจะเห็นคำสั่งเรียกแมโคร panic! พอดี แต่ในกรณีอื่นๆ การเรียกใช้ panic! อาจเกิดขึ้นภายในโค้ดภายนอกที่โค้ดเราเรียกใช้อีกทอดหนึ่ง ซึ่งในกรณีนั้น ชื่อไฟล์และหมายเลขบรรทัดที่แสดงในข้อความแจ้งข้อผิดพลาดจะชี้ไปยังโค้ดของผู้อื่นที่มีการเรียกแมโคร panic! ไม่ใช่บรรทัดในโค้ดของเราที่ส่งผลให้เกิดการเรียก panic! ดังกล่าว
เราสามารถใช้แบ็กเทรซ (backtrace) ของฟังก์ชันที่ส่งผลให้เกิดการเรียก panic! เพื่อสืบหาว่าส่วนใดในโค้ดของเราที่เป็นต้นเหตุของปัญหา และเพื่อทำความเข้าใจวิธีการใช้งานแบ็กเทรซของ panic! มาดูอีกตัวอย่างหนึ่งว่าจะเป็นอย่างไรเมื่อคำสั่ง panic! ถูกเรียกขึ้นจากภายในไลบรารีอันเนื่องมาจากบั๊กในโค้ดของเรา แทนที่จะมาจากการที่เราเรียกใช้แมโครโดยตรง ลิสติ้ง 9-1 แสดงโค้ดที่พยายามเข้าถึงดัชนีในเวกเตอร์ที่เกินขอบเขตของดัชนีที่มีอยู่จริง
fn main() {
let v = vec![1, 2, 3];
v[99];
}ในตัวอย่างนี้ เราพยายามเข้าถึงสมาชิกตัวที่ 100 ของเวกเตอร์ (ซึ่งอยู่ที่ดัชนี 99 เพราะการระบุดัชนีเริ่มต้นจากศูนย์) แต่เวกเตอร์กลับมีสมาชิกเพียงแค่สามตัวเท่านั้น ในสถานการณ์นี้ Rust จะเกิด panic ขึ้นมา การใช้วงเล็บ [] นั้นควรจะต้องคืนค่าสมาชิกออกมาหนึ่งตัว แต่เมื่อคุณระบุดัชนีที่ไม่ถูกต้อง ย่อมไม่มีสมาชิกใดที่ Rust จะสามารถส่งคืนกลับมาได้อย่างถูกต้อง
ในภาษา C การพยายามอ่านข้อมูลเกินขอบเขตของโครงสร้างข้อมูลถือเป็นพฤติกรรมที่ไม่พึงประสงค์และไม่ได้นิยามไว้ (undefined behavior) คุณอาจได้ค่าอะไรก็ตามที่อยู่ในตำแหน่งหน่วยความจำถัดไป แม้ว่าหน่วยความจำนั้นจะไม่ได้เป็นของโครงสร้างข้อมูลดังกล่าวเลยก็ตาม ปัญหานี้เรียกว่า การอ่านเกินบัฟเฟอร์ (buffer overread) ซึ่งอาจนำไปสู่ช่องโหว่ด้านความปลอดภัยร้ายแรงได้ หากผู้โจมตีสามารถควบคุมค่าดัชนีเพื่อแอบอ่านข้อมูลสำคัญอื่นๆ ที่เก็บอยู่ถัดจากโครงสร้างข้อมูลนั้น
เพื่อปกป้องโปรแกรมของคุณจากช่องโหว่ประเภทนี้ หากคุณพยายามอ่านสมาชิกที่ดัชนีที่ไม่มีอยู่จริง Rust จะสั่งหยุดการทำงานทันทีและปฏิเสธที่จะทำงานต่อ มาลองรันดูผลลัพธ์กัน:
$ cargo run
Compiling panic v0.1.0 (file:///projects/panic)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.27s
Running `target/debug/panic`
thread 'main' (6017887) panicked at src/main.rs:4:6:
index out of bounds: the len is 3 but the index is 99
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
ข้อผิดพลาดนี้ชี้ไปที่บรรทัดที่ 4 ของไฟล์ main.rs ซึ่งเป็นจุดที่เราพยายามเข้าถึงดัชนี 99 ของเวกเตอร์ในตัวแปร v
บรรทัด note: แนะนำให้เราทราบว่า เราสามารถตั้งค่าตัวแปรสภาพแวดล้อม RUST_BACKTRACE เพื่อดูแบ็กเทรซของลำดับเหตุการณ์ทั้งหมดที่ทำให้เกิดข้อผิดพลาดได้ โดย แบ็กเทรซ (backtrace) คือรายการของฟังก์ชันทั้งหมดที่ถูกเรียกใช้ไล่มาจนถึงจุดนี้ แบ็กเทรซใน Rust ทำงานในลักษณะเดียวกับภาษาอื่นๆ: หัวใจสำคัญในการอ่านแบ็กเทรซคือ ให้เริ่มดูจากด้านบนสุดแล้วไล่อ่านลงมาจนกระทั่งเจอบรรทัดที่เป็นไฟล์ที่คุณเขียนขึ้นเอง นั่นคือจุดเริ่มต้นที่เป็นต้นตอของปัญหา บรรทัดที่อยู่เหนือจุดนั้นขึ้นไปคือโค้ดภายในที่โค้ดของคุณเรียกใช้ ส่วนบรรทัดที่อยู่ต่ำลงมาคือโค้ดที่เป็นตัวเรียกโค้ดของคุณ ซึ่งบรรทัดก่อนหน้าและหลังจากนั้นอาจประกอบไปด้วยโค้ดแกนหลักของ Rust โค้ดของไลบรารีมาตรฐาน หรือเครตภายนอกที่คุณดึงมาใช้งาน มาลองดูแบ็กเทรซโดยการตั้งค่าตัวแปรสภาพแวดล้อม RUST_BACKTRACE ให้เป็นค่าใดก็ได้ที่ไม่ใช่ 0 กันดู ซึ่งลิสติ้ง 9-2 แสดงผลลัพธ์คล้ายกับสิ่งที่คุณจะได้เห็น
$ RUST_BACKTRACE=1 cargo run
thread 'main' panicked at src/main.rs:4:6:
index out of bounds: the len is 3 but the index is 99
stack backtrace:
0: rust_begin_unwind
at /rustc/4d91de4e48198da2e33413efdcd9cd2cc0c46688/library/std/src/panicking.rs:692:5
1: core::panicking::panic_fmt
at /rustc/4d91de4e48198da2e33413efdcd9cd2cc0c46688/library/core/src/panicking.rs:75:14
2: core::panicking::panic_bounds_check
at /rustc/4d91de4e48198da2e33413efdcd9cd2cc0c46688/library/core/src/panicking.rs:273:5
3: <usize as core::slice::index::SliceIndex<[T]>>::index
at file:///home/.rustup/toolchains/1.85/lib/rustlib/src/rust/library/core/src/slice/index.rs:274:10
4: core::slice::index::<impl core::ops::index::Index<I> for [T]>::index
at file:///home/.rustup/toolchains/1.85/lib/rustlib/src/rust/library/core/src/slice/index.rs:16:9
5: <alloc::vec::Vec<T,A> as core::ops::index::Index<I>>::index
at file:///home/.rustup/toolchains/1.85/lib/rustlib/src/rust/library/alloc/src/vec/mod.rs:3361:9
6: panic::main
at ./src/main.rs:4:6
7: core::ops::function::FnOnce::call_once
at file:///home/.rustup/toolchains/1.85/lib/rustlib/src/rust/library/core/src/ops/function.rs:250:5
note: Some details are omitted, run with `RUST_BACKTRACE=full` for a verbose backtrace.
ผลลัพธ์ที่แสดงออกมานั้นมีรายละเอียดเยอะมาก! ซึ่งสิ่งที่คุณเห็นจริงอาจมีความแตกต่างกันไปบ้าง ขึ้นอยู่กับระบบปฏิบัติการและเวอร์ชันของ Rust ที่คุณใช้งาน และเพื่อให้ได้แบ็กเทรซที่มีข้อมูลครบถ้วนเช่นนี้ ตัวโปรแกรมจะต้องเปิดใช้งานสัญลักษณ์ดีบัก (debug symbols) ไว้ด้วย ซึ่งโดยค่าเริ่มต้นแล้ว debug symbols จะถูกเปิดใช้งานเสมอเมื่อเรารันคำสั่ง cargo build หรือ cargo run โดยไม่ได้ระบุแฟล็ก --release ดังเช่นในตัวอย่างนี้
ในผลลัพธ์ของลิสติ้ง 9-2 บรรทัดที่ 6 ของแบ็กเทรซจะชี้ไปยังบรรทัดในโปรเจกต์ของเราที่เป็นต้นตอของปัญหา นั่นคือบรรทัดที่ 4 ของไฟล์ src/main.rs หากเราไม่ต้องการให้โปรแกรมเกิด panic เราก็ควรเริ่มตรวจสอบจากตำแหน่งที่บรรทัดแรกซึ่งกล่าวถึงไฟล์ที่เราเขียนขึ้นชี้ไป ในลิสติ้ง 9-1 ซึ่งเป็นโค้ดที่เราตั้งใจเขียนให้เกิด panic นั้น วิธีแก้ไขก็คือการไม่ขอเข้าถึงสมาชิกที่อยู่นอกเหนือช่วงดัชนีของเวกเตอร์ และเมื่อใดก็ตามที่โค้ดของคุณเกิด panic ขึ้นในอนาคต คุณก็จะต้องสืบหาว่าโค้ดกำลังทำงานอะไรและใช้ค่าอะไรที่ทำให้เกิด panic รวมถึงพิจารณาว่าโค้ดควรจะทำงานอย่างไรแทนจึงจะถูกต้อง
เราจะกลับมาพูดถึง panic! รวมถึงประเด็นที่ว่าเมื่อใดที่เราควรหรือไม่ควรใช้ panic! เพื่อจัดการกับเงื่อนไขข้อผิดพลาดในหัวข้อ “จะ panic! หรือไม่ panic!” ในช่วงท้ายของบทนี้ ส่วนต่อไปเราจะไปดูวิธีจัดการและกู้คืนจากข้อผิดพลาดโดยใช้ Result กัน
ข้อผิดพลาดที่กู้คืนได้ด้วย Result
ข้อผิดพลาดที่กู้คืนได้ด้วย Result
ข้อผิดพลาดส่วนใหญ่ไม่ได้ร้ายแรงถึงขั้นที่ต้องทำให้โปรแกรมหยุดทำงานทั้งหมด บางครั้งเมื่อฟังก์ชันทำงานล้มเหลว มักเกิดจากสาเหตุที่คุณสามารถแปลความหมายและรับมือแก้ไขได้ง่าย เช่น หากคุณพยายามเปิดไฟล์แล้วการทำงานล้มเหลวเนื่องจากยังไม่มีไฟล์นั้นอยู่ คุณอาจเลือกที่จะสร้างไฟล์ขึ้นมาใหม่แทนการสั่งยุติการทำงานของโปรเซส
จากหัวข้อ “การจัดการความล้มเหลวที่อาจเกิดขึ้นด้วย Result” ในบทที่ 2 เราได้ทราบกันแล้วว่า enum Result ถูกนิยามให้มีสองวาเรียนต์ คือ Ok และ Err ดังนี้:
#![allow(unused)]
fn main() {
enum Result<T, E> {
Ok(T),
Err(E),
}
}T และ E คือพารามิเตอร์ประเภทข้อมูลแบบเจเนอริก (generic type parameters) ซึ่งเราจะอธิบายรายละเอียดของเจเนอริกเพิ่มเติมในบทที่ 10 แต่สิ่งที่คุณควรรู้ในตอนนี้คือ T เป็นตัวแทนของประเภทของค่าที่จะส่งกลับเมื่อการทำงานสำเร็จภายในวาเรียนต์ Ok ส่วน E เป็นตัวแทนของประเภทของข้อผิดพลาดที่จะส่งกลับเมื่อการทำงานล้มเหลวภายในวาเรียนต์ Err และด้วยความที่ Result ใช้พารามิเตอร์ประเภทข้อมูลแบบเจเนอริกเหล่านี้ เราจึงสามารถนำประเภท Result และฟังก์ชันต่างๆ ที่นิยามไว้สำหรับมันไปประยุกต์ใช้ได้ในหลากหลายสถานการณ์ ซึ่งค่าที่ส่งกลับเมื่อสำเร็จหรือล้มเหลวอาจแตกต่างกันไปในแต่ละฟังก์ชัน
มาลองเรียกใช้ฟังก์ชันที่คืนค่าเป็น Result เพราะฟังก์ชันนั้นมีโอกาสล้มเหลวได้ ในลิสติ้ง 9-3 เราจะพยายามเปิดไฟล์ขึ้นมาไฟล์หนึ่ง
use std::fs::File;
fn main() {
let greeting_file_result = File::open("hello.txt");
}ประเภทข้อมูลที่ส่งกลับจาก File::open คือ Result<T, E> โดยการอิมพลีเมนต์ของ File::open ได้ระบุพารามิเตอร์เจเนอริก T ให้เป็นประเภทข้อมูลเมื่อสำเร็จ นั่นคือ std::fs::File ซึ่งเป็นตัวจัดการไฟล์ (file handle) ส่วนประเภท E ที่ใช้สำหรับค่าข้อผิดพลาดคือ std::io::Error การคืนค่าประเภทนี้หมายความว่าการเรียก File::open อาจจะสำเร็จและส่งแฮนเดิลไฟล์ที่เราสามารถอ่านหรือเขียนข้อมูลกลับมา หรือการเรียกฟังก์ชันนี้อาจจะล้มเหลวก็ได้ เช่น ไฟล์นั้นอาจไม่มีอยู่จริง หรือเราอาจไม่มีสิทธิ์เข้าถึงไฟล์ดังกล่าว ดังนั้นฟังก์ชัน File::open จึงต้องมีวิธีแจ้งให้เราทราบว่าการทำงานสำเร็จหรือล้มเหลว พร้อมกับส่งคืนแฮนเดิลไฟล์หรือข้อมูลข้อผิดพลาดมาให้เรา ซึ่ง enum Result ถูกออกแบบมาเพื่อสื่อสารสิ่งเหล่านี้โดยตรง
ในกรณีที่ File::open ทำงานสำเร็จ ค่าในตัวแปร greeting_file_result จะเป็นอินสแตนซ์ของ Ok ที่บรรจุแฮนเดิลไฟล์ไว้ข้างใน ส่วนในกรณีที่ล้มเหลว ค่าใน greeting_file_result จะเป็นอินสแตนซ์ของ Err ที่บรรจุข้อมูลเพิ่มเติมเกี่ยวกับสาเหตุของข้อผิดพลาดที่เกิดขึ้น
เราจำเป็นต้องเขียนโค้ดต่อยอดจากลิสติ้ง 9-3 เพื่อจัดการให้เหมาะสมตามค่าที่ File::open ส่งกลับมา ลิสติ้ง 9-4 แสดงวิธีหนึ่งในการจัดการกับ Result โดยใช้เครื่องมือพื้นฐานอย่างนิพจน์ match ที่เราได้เรียนรู้กันไปแล้วในบทที่ 6
use std::fs::File;
fn main() {
let greeting_file_result = File::open("hello.txt");
let greeting_file = match greeting_file_result {
Ok(file) => file,
Err(error) => panic!("Problem opening the file: {error:?}"),
};
}สังเกตว่าเช่นเดียวกับ enum Option ตัว enum Result และวาเรียนต์ต่างๆ ของมันถูกดึงเข้าสู่ขอบเขต (scope) โดยอัตโนมัติผ่าน prelude แล้ว ดังนั้นเราจึงไม่จำเป็นต้องใส่คำนำหน้า Result:: ให้กับวาเรียนต์ Ok และ Err ภายในแขนของ match
เมื่อผลลัพธ์เป็น Ok โค้ดนี้จะดึงค่า file ที่อยู่ภายในวาเรียนต์ Ok ออกมา จากนั้นเราจึงกำหนดค่าแฮนเดิลไฟล์นั้นให้กับตัวแปร greeting_file และหลังจากจบนิพจน์ match เราก็สามารถนำแฮนเดิลไฟล์นั้นไปใช้ในการอ่านหรือเขียนข้อมูลต่อไปได้
ส่วนอีกแขนหนึ่งของ match จะทำหน้าที่จัดการกรณีที่เราได้ค่า Err จาก File::open ในตัวอย่างนี้ เราเลือกที่จะเรียกใช้แมโคร panic! หากไม่มีไฟล์ชื่อ hello.txt อยู่ในไดเรกทอรีปัจจุบันของเราแล้วเรารันโค้ดนี้ เราจะเห็นผลลัพธ์ต่อไปนี้จากแมโคร panic!:
$ cargo run
Compiling error-handling v0.1.0 (file:///projects/error-handling)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.73s
Running `target/debug/error-handling`
thread 'main' (6018048) panicked at src/main.rs:8:23:
Problem opening the file: Os { code: 2, kind: NotFound, message: "No such file or directory" }
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
เช่นเคย ข้อความผลลัพธ์นี้บอกเราได้อย่างชัดเจนว่าเกิดข้อผิดพลาดอะไรขึ้น
การจับคู่กับข้อผิดพลาดที่แตกต่างกัน
โค้ดในลิสติ้ง 9-4 จะสั่ง panic! เสมอไม่ว่า File::open จะล้มเหลวด้วยสาเหตุใดก็ตาม อย่างไรก็ดี เราอาจต้องการรับมือกับสาเหตุความล้มเหลวที่ต่างกันด้วยวิธีที่แตกต่างกันออกไป: หาก File::open ล้มเหลวเพราะยังไม่มีไฟล์นั้นอยู่ เราต้องการสร้างไฟล์ขึ้นมาใหม่แล้วส่งคืนแฮนเดิลของไฟล์ใหม่นั้น แต่ถ้า File::open ล้มเหลวด้วยเหตุผลอื่น เช่น เราไม่มีสิทธิ์ในการเปิดไฟล์ เราก็ยังคงต้องการให้โค้ดเกิด panic! เหมือนกับในลิสติ้ง 9-4 ในกรณีนี้ เราสามารถเพิ่มนิพจน์ match ซ้อนอยู่ข้างในได้ ดังที่แสดงในลิสติ้ง 9-5
use std::fs::File;
use std::io::ErrorKind;
fn main() {
let greeting_file_result = File::open("hello.txt");
let greeting_file = match greeting_file_result {
Ok(file) => file,
Err(error) => match error.kind() {
ErrorKind::NotFound => match File::create("hello.txt") {
Ok(fc) => fc,
Err(e) => panic!("Problem creating the file: {e:?}"),
},
_ => {
panic!("Problem opening the file: {error:?}");
}
},
};
}ประเภทของค่าที่ File::open ส่งกลับมาภายในวาเรียนต์ Err คือ io::Error ซึ่งเป็น struct ที่ไลบรารีมาตรฐานจัดเตรียมไว้ให้ โดย struct นี้มีเมธอดชื่อ kind ที่เราสามารถเรียกเพื่อดูค่า io::ErrorKind ได้ enum io::ErrorKind ของไลบรารีมาตรฐานมีวาเรียนต์ต่างๆ ที่เป็นตัวแทนของประเภทข้อผิดพลาดหลากหลายแบบซึ่งอาจเกิดจากการดำเนินการของ io โดยวาเรียนต์ที่เราสนใจใช้งานคือ ErrorKind::NotFound ซึ่งบ่งบอกว่าไฟล์ที่เราพยายามเปิดนั้นยังไม่มีอยู่ ดังนั้นเราจึงจับคู่กับ greeting_file_result และยังมีนิพจน์ match ชั้นในที่จับคู่กับ error.kind() อีกด้วย
เงื่อนไขที่เราต้องการตรวจสอบใน match ชั้นในคือ ค่าที่ส่งกลับมาจาก error.kind() เป็นวาเรียนต์ NotFound ของ enum ErrorKind หรือไม่ หากใช่ เราจะพยายามสร้างไฟล์ขึ้นมาใหม่ด้วย File::create ทว่าเนื่องจาก File::create เองก็มีโอกาสทำงานล้มเหลวได้เช่นกัน เราจึงต้องมีแขนที่สองในนิพจน์ match ชั้นในด้วย เพื่อให้เมื่อสร้างไฟล์ไม่สำเร็จ จะมีการพิมพ์ข้อความแจ้งข้อผิดพลาดอีกแบบหนึ่งออกมา ส่วนแขนที่สองของ match ชั้นนอกยังคงเหมือนเดิม ทำให้โปรแกรมจะเกิด panic เมื่อเจอกับข้อผิดพลาดอื่นๆ นอกเหนือจากกรณีไฟล์สูญหาย
ทางเลือกอื่นนอกจากการใช้
matchกับResult<T, E>นั่นมีการใช้
matchซ้อนกันเยอะมาก! แม้นิพจน์matchจะมีประโยชน์อย่างยิ่ง แต่มันก็ค่อนข้างยืดยาวและเป็นเครื่องมือระดับพื้นฐาน ในบทที่ 13 คุณจะได้เรียนรู้เกี่ยวกับโคลเชอร์ (closure) ซึ่งถูกนำไปใช้ร่วมกับเมธอดตัวช่วยต่างๆ บนResult<T, E>โดยเมธอดเหล่านี้จะช่วยให้คุณจัดการกับค่าResult<T, E>ในโค้ดได้อย่างกระชับและคลีนกว่าการใช้matchมากตัวอย่างเช่น นี่คืออีกวิธีในการเขียนตรรกะเดียวกันกับลิสติ้ง 9-5 โดยเปลี่ยนมาใช้โคลเชอร์และเมธอด
unwrap_or_else:use std::fs::File; use std::io::ErrorKind; fn main() { let greeting_file = File::open("hello.txt").unwrap_or_else(|error| { if error.kind() == ErrorKind::NotFound { File::create("hello.txt").unwrap_or_else(|error| { panic!("Problem creating the file: {error:?}"); }) } else { panic!("Problem opening the file: {error:?}"); } }); }แม้ว่าโค้ดนี้จะมีพฤติกรรมการทำงานเหมือนกับลิสติ้ง 9-5 ทุกประการ แต่มันกลับไม่มีนิพจน์
matchซ้อนกันเลยแม้แต่น้อย และอ่านทำความเข้าใจได้ง่ายกว่ามาก คุณสามารถย้อนกลับมาดูตัวอย่างนี้อีกครั้งหลังจากอ่านบทที่ 13 จบแล้ว และลองค้นหาเมธอดunwrap_or_elseในเอกสารของไลบรารีมาตรฐานดู ซึ่งยังมีเมธอดทำนองนี้อีกมากที่จะช่วยให้คุณไม่ต้องเขียนmatchซ้อนกันจนรกตาเวลาจัดการกับข้อผิดพลาด
ทางลัดสำหรับแพนิกเมื่อเกิดข้อผิดพลาด
การใช้ match นั้นทำงานได้ดีในระดับหนึ่ง แต่มันอาจจะดูยืดยาวและไม่ได้สื่อเจตนารมณ์ของโค้ดได้ชัดเจนเสมอไป ประเภทข้อมูล Result<T, E> จึงมีเมธอดตัวช่วยมากมายสำหรับทำงานเฉพาะเจาะจงต่างๆ โดยเมธอด unwrap เป็นเมธอดทางลัดที่อิมพลีเมนต์การทำงานเหมือนกับนิพจน์ match ในลิสติ้ง 9-4 ทุกประการ: ถ้าค่า Result เป็นวาเรียนต์ Ok ตัว unwrap จะส่งคืนค่าที่อยู่ข้างใน Ok ออกมา แต่ถ้าค่า Result เป็นวาเรียนต์ Err ตัว unwrap จะเรียกแมโคร panic! ให้เราโดยอัตโนมัติ นี่คือตัวอย่างการใช้งาน unwrap:
use std::fs::File;
fn main() {
let greeting_file = File::open("hello.txt").unwrap();
}หากเรารันโค้ดนี้โดยไม่มีไฟล์ hello.txt เราจะเห็นข้อความแสดงข้อผิดพลาดจากการเรียก panic! ที่เมธอด unwrap ทำขึ้น:
thread 'main' panicked at src/main.rs:4:49:
called `Result::unwrap()` on an `Err` value: Os { code: 2, kind: NotFound, message: "No such file or directory" }
ในทำนองเดียวกัน เมธอด expect ก็ทำงานคล้ายกันแต่เปิดโอกาสให้เรากำหนดข้อความแสดงข้อผิดพลาดของ panic! เองได้ การเลือกใช้ expect แทน unwrap พร้อมกับระบุข้อความแจ้งข้อผิดพลาดที่มีความหมาย จะช่วยสื่อเจตนาของโค้ดและทำให้การติดตามหาต้นตอของ panic ทำได้ง่ายขึ้นมาก โดยไวยากรณ์ของ expect มีหน้าตาดังนี้:
use std::fs::File;
fn main() {
let greeting_file = File::open("hello.txt")
.expect("hello.txt should be included in this project");
}เราใช้งาน expect ในลักษณะเดียวกับ unwrap นั่นคือส่งคืนแฮนเดิลไฟล์ออกมาเมื่อสำเร็จ หรือเรียกแมโคร panic! เมื่อเกิดข้อผิดพลาด โดยข้อความแจ้งข้อผิดพลาดที่ expect ใช้ส่งให้ panic! จะเป็นข้อความจากพารามิเตอร์ที่เราส่งให้ expect แทนที่จะเป็นข้อความเริ่มต้นของ unwrap ดังตัวอย่างผลลัพธ์นี้:
thread 'main' panicked at src/main.rs:5:10:
hello.txt should be included in this project: Os { code: 2, kind: NotFound, message: "No such file or directory" }
ในโค้ดระดับโปรดักชันที่ได้มาตรฐาน ชาว Rustacean ส่วนใหญ่จะนิยมใช้ expect มากกว่า unwrap พร้อมทั้งให้บริบทเพิ่มเติมว่าเหตุใดการทำงานนี้จึงคาดว่าจะสำเร็จเสมอ ด้วยวิธีนี้ หากสมมติฐานที่คุณคิดไว้เกิดผิดพลาดขึ้นมาในภายหลัง คุณก็จะมีข้อมูลที่เพียงพอสำหรับใช้ในการดีบักได้อย่างรวดเร็ว
การส่งต่อข้อผิดพลาด
เมื่อการทำงานภายในฟังก์ชันมีการเรียกสิ่งที่อาจล้มเหลวได้ แทนที่คุณจะจัดการกับข้อผิดพลาดนั้นอยู่ภายในฟังก์ชันเอง คุณสามารถเลือกที่จะส่งคืนข้อผิดพลาดกลับไปให้โค้ดส่วนที่เรียกใช้ฟังก์ชันนั้นเป็นผู้ตัดสินใจแทนได้ กระบวนการนี้เรียกว่า การส่งต่อข้อผิดพลาด (propagating the error) ซึ่งจะมอบอำนาจการควบคุมให้แก่โค้ดต้นทางที่เรียกใช้ เพราะโค้ดต้นทางนั้นอาจมีข้อมูลหรือตรรกะที่เหมาะสมต่อการตัดสินใจรับมือกับข้อผิดพลาดได้ดีกว่าบริบทที่ฟังก์ชันของคุณมี
ตัวอย่างเช่น ลิสติ้ง 9-6 แสดงฟังก์ชันสำหรับอ่านชื่อผู้ใช้จากไฟล์ หากไฟล์ไม่มีอยู่จริงหรืออ่านไม่ได้ ฟังก์ชันนี้จะส่งคืนข้อผิดพลาดดังกล่าวกลับไปยังโค้ดที่เรียกใช้ฟังก์ชัน
#![allow(unused)]
fn main() {
use std::fs::File;
use std::io::{self, Read};
fn read_username_from_file() -> Result<String, io::Error> {
let username_file_result = File::open("hello.txt");
let mut username_file = match username_file_result {
Ok(file) => file,
Err(e) => return Err(e),
};
let mut username = String::new();
match username_file.read_to_string(&mut username) {
Ok(_) => Ok(username),
Err(e) => Err(e),
}
}
}ฟังก์ชันนี้สามารถเขียนให้กระชับและสั้นลงกว่านี้ได้มาก แต่เราจะเริ่มเขียนแบบตรงไปตรงมาด้วยตัวเองก่อนเพื่อศึกษาการทำงานของการจัดการข้อผิดพลาด แล้วในตอนท้ายเราจะแสดงวิธีที่สั้นกว่าให้ดู มาเริ่มพิจารณาจากประเภทข้อมูลที่ส่งกลับของฟังก์ชันนี้ก่อน นั่นคือ Result<String, io::Error> ซึ่งหมายความว่าฟังก์ชันนี้จะส่งคืนค่าประเภท Result<T, E> โดยระบุพารามิเตอร์เจเนอริก T ให้เป็นประเภทรูปธรรม String และระบุพารามิเตอร์เจเนอริก E ให้เป็นประเภทรูปธรรม io::Error
หากฟังก์ชันนี้ทำงานสำเร็จโดยไม่ติดขัด โค้ดที่เรียกใช้ฟังก์ชันจะได้รับค่า Ok ที่บรรจุข้อมูล String ซึ่งก็คือ username ที่อ่านได้จากไฟล์ แต่หากฟังก์ชันนี้เจอปัญหาใดๆ โค้ดที่เรียกใช้จะได้รับค่า Err ที่บรรจุอินสแตนซ์ของ io::Error พร้อมรายละเอียดเกี่ยวกับปัญหาที่เกิดขึ้น สาเหตุที่เราเลือก io::Error เป็นประเภทข้อผิดพลาดที่ส่งกลับของฟังก์ชันนี้ ก็เพราะมันเป็นประเภทของข้อผิดพลาดที่ส่งกลับจากการทำงานทั้งสองอย่างภายในเนื้อหาของฟังก์ชันนี้ที่มีโอกาสล้มเหลว ได้แก่ ฟังก์ชัน File::open และเมธอด read_to_string
เนื้อหาของฟังก์ชันเริ่มต้นด้วยการเรียกใช้ฟังก์ชัน File::open จากนั้นเราจัดการกับค่า Result ด้วยนิพจน์ match ในลักษณะเดียวกับลิสติ้ง 9-4 หาก File::open ทำงานสำเร็จ แฮนเดิลไฟล์ในตัวแปรแพตเทิร์น file จะถูกนำมากำหนดให้กับตัวแปรแบบเปลี่ยนแปลงได้ username_file แล้วฟังก์ชันจะทำงานบรรทัดต่อไป แต่ในกรณี Err แทนที่เราจะสั่ง panic! เราจะใช้คีย์เวิร์ด return เพื่อส่งคืนค่าและออกจากฟังก์ชันทันที (early return) พร้อมกับส่งค่าข้อผิดพลาดจาก File::open ซึ่งอยู่ในตัวแปรแพตเทิร์น e กลับไปยังโค้ดต้นทางที่เรียกใช้ในฐานะค่าข้อผิดพลาดของฟังก์ชันนี้
หลังจากนั้น หากเราได้แฮนเดิลไฟล์มาเก็บไว้ใน username_file แล้ว ฟังก์ชันจะสร้างตัวแปร username ขึ้นมาเป็น String ใหม่ แล้วเรียกเมธอด read_to_string บนแฮนเดิลไฟล์ใน username_file เพื่ออ่านเนื้อหาทั้งหมดในไฟล์เข้ามาเก็บไว้ใน username ซึ่งเมธอด read_to_string นี้ก็คืนค่าเป็น Result เช่นกันเนื่องจากมันมีโอกาสอ่านล้มเหลวได้แม้ว่าจะเปิดไฟล์ผ่าน File::open สำเร็จก็ตาม เราจึงต้องมี match อีกตัวเพื่อจัดการกับ Result นั้น: หาก read_to_string ทำงานสำเร็จ ฟังก์ชันของเราก็จะถือว่าทำงานสำเร็จตามไปด้วย และจะส่งคืนชื่อผู้ใช้ที่อยู่ใน username ออกมาโดยห่อหุ้มไว้ใน Ok แต่ถ้า read_to_string ล้มเหลว เราก็จะส่งคืนค่าข้อผิดพลาดกลับไปในลักษณะเดียวกับที่เราเคยทำใน match ของ File::open เพียงแต่ในกรณีนี้เราไม่จำเป็นต้องใส่คีย์เวิร์ด return อย่างโจ่งแจ้ง เพราะมันเป็นนิพจน์สุดท้ายของฟังก์ชันอยู่แล้ว
โค้ดต้นทางที่เรียกใช้ฟังก์ชันนี้จะได้รับค่าไม่ว่าจะเป็น Ok ที่บรรจุชื่อผู้ใช้ หรือ Err ที่บรรจุ io::Error ซึ่งขึ้นอยู่กับโค้ดต้นทางเองว่าจะตัดสินใจจัดการกับค่านั้นอย่างไร เช่น หากได้ค่า Err มันอาจจะเลือกเรียก panic! เพื่อหยุดโปรแกรม, หันไปใช้ชื่อผู้ใช้เริ่มต้น (default), หรือลองค้นหาชื่อผู้ใช้จากแหล่งอื่นแทนไฟล์ เป็นต้น เราไม่มีข้อมูลเพียงพอที่จะรู้ว่าโค้ดต้นทางต้องการจะทำอะไรต่อ เราจึงเลือกที่จะส่งต่อข้อมูลความสำเร็จหรือข้อผิดพลาดทั้งหมดกลับขึ้นไปให้โค้ดต้นทางเป็นผู้พิจารณาเอง
รูปแบบการส่งต่อข้อผิดพลาด (propagating errors) เช่นนี้พบได้บ่อยมากในการเขียน Rust จนกระทั่ง Rust มีตัวดำเนินการเครื่องหมายคำถาม (question mark operator) ? เพื่อช่วยให้การเขียนโค้ดลักษณะนี้ทำได้ง่ายและสะดวกขึ้นอย่างมาก
ทางลัดของตัวดำเนินการ ?
ลิสติ้ง 9-7 แสดงการอิมพลีเมนต์ของ read_username_from_file ที่มีฟังก์ชันการทำงานเหมือนกับในลิสติ้ง 9-6 แต่การอิมพลีเมนต์นี้ใช้ตัวดำเนินการ ?
#![allow(unused)]
fn main() {
use std::fs::File;
use std::io::{self, Read};
fn read_username_from_file() -> Result<String, io::Error> {
let mut username_file = File::open("hello.txt")?;
let mut username = String::new();
username_file.read_to_string(&mut username)?;
Ok(username)
}
}การวางเครื่องหมาย ? ไว้ต่อท้ายค่า Result ถูกกำหนดให้ทำงานแทบจะเหมือนกับนิพจน์ match ที่เราเขียนเพื่อจัดการกับ Result ในลิสติ้ง 9-6: ถ้าค่าของ Result เป็น Ok ค่าที่อยู่ภายใน Ok จะถูกดึงออกมาเป็นผลลัพธ์ของนิพจน์นั้นแล้วโปรแกรมจะทำงานต่อไป แต่ถ้าค่าเป็น Err วาเรียนต์ Err นั้นจะถูกส่งคืนออกจากฟังก์ชันทั้งหมดทันทีประหนึ่งว่าเราใช้คีย์เวิร์ด return เพื่อให้ค่าข้อผิดพลาดถูกส่งต่อไปยังโค้ดต้นทางที่เรียกใช้
อย่างไรก็ตาม มีความแตกต่างประการหนึ่งระหว่างสิ่งที่นิพจน์ match ในลิสติ้ง 9-6 ทำกับสิ่งที่ตัวดำเนินการ ? ทำ: ค่าข้อผิดพลาดที่ถูกประมวลผลด้วยตัวดำเนินการ ? จะถูกส่งผ่านฟังก์ชัน from ซึ่งนิยามอยู่ในเทรต From ของไลบรารีมาตรฐาน และใช้สำหรับแปลงค่าจากประเภทหนึ่งไปเป็นอีกประเภทหนึ่ง เมื่อตัวดำเนินการ ? เรียกฟังก์ชัน from ประเภทของข้อผิดพลาดที่ได้รับมาจะถูกแปลงเป็นประเภทข้อผิดพลาดที่ระบุไว้ในประเภทส่งกลับของฟังก์ชันปัจจุบันโดยอัตโนมัติ ซึ่งมีประโยชน์มากเมื่อฟังก์ชันหนึ่งต้องการส่งคืนประเภทข้อผิดพลาดเพียงประเภทเดียวเพื่อเป็นตัวแทนของความล้มเหลวทุกรูปแบบ แม้ว่าจุดต่างๆ ภายในฟังก์ชันจะล้มเหลวด้วยสาเหตุที่แตกต่างกันอย่างสิ้นเชิงก็ตาม
ตัวอย่างเช่น เราสามารถแก้ฟังก์ชัน read_username_from_file ในลิสติ้ง 9-7 ให้ส่งคืนประเภทข้อผิดพลาดที่เรากำหนดขึ้นเองชื่อ OurError ได้ และหากเรานิยาม impl From<io::Error> for OurError เพื่อแปลง io::Error ไปเป็น OurError แล้วล่ะก็ ตัวดำเนินการ ? ภายในฟังก์ชัน read_username_from_file จะเรียกใช้ from และแปลงประเภทข้อผิดพลาดให้อัตโนมัติ โดยที่เราไม่ต้องเขียนโค้ดแปลงค่าเพิ่มเติมในฟังก์ชันเลยแม้แต่บรรทัดเดียว
ในบริบทของลิสติ้ง 9-7 เครื่องหมาย ? ที่ต่อท้ายการเรียก File::open จะส่งคืนค่าที่อยู่ภายใน Ok ออกมาเก็บไว้ในตัวแปร username_file แต่หากเกิดข้อผิดพลาดขึ้น ตัวดำเนินการ ? จะออกจากฟังก์ชันทันทีและส่งค่า Err กลับไปยังโค้ดที่เรียกใช้ และในทำนองเดียวกัน เครื่องหมาย ? ที่ต่อท้ายการเรียก read_to_string ก็ทำงานเช่นนี้เช่นกัน
ตัวดำเนินการ ? ช่วยกำจัดโค้ดพิมพ์ซ้ำซาก (boilerplate) ออกไปได้มากมาย และทำให้การเขียนฟังก์ชันนี้ดูเรียบง่ายขึ้นมาก ยิ่งไปกว่านั้น เรายังสามารถย่อโค้ดนี้ให้สั้นลงได้อีกโดยการเรียกเมธอดเชื่อมต่อ (chaining) ต่อท้าย ? ได้ทันที ดังแสดงในลิสติ้ง 9-8
#![allow(unused)]
fn main() {
use std::fs::File;
use std::io::{self, Read};
fn read_username_from_file() -> Result<String, io::Error> {
let mut username = String::new();
File::open("hello.txt")?.read_to_string(&mut username)?;
Ok(username)
}
}เราได้ย้ายคำสั่งสร้าง String ใหม่ในตัวแปร username ไปไว้ที่บรรทัดแรกของฟังก์ชัน ซึ่งการทำงานส่วนนี้ยังคงเหมือนเดิม แต่แทนที่จะสร้างตัวแปร username_file ขึ้นมาพักไว้ เราเชื่อมการเรียกเมธอด read_to_string ต่อเข้ากับผลลัพธ์ของ File::open("hello.txt")? โดยตรง และเรายังคงใส่ ? ไว้ที่ท้ายคำสั่งเรียก read_to_string พร้อมทั้งยังคงส่งคืนค่า Ok ที่บรรจุ username ออกมาเมื่อทั้ง File::open และ read_to_string ทำงานสำเร็จ ซึ่งการทำงานทั้งหมดก็เหมือนกับในลิสติ้ง 9-6 และลิสติ้ง 9-7 ทุกประการ เพียงแต่นี่เป็นวิธีเขียนที่กระชับและสะดวกสบาย (ergonomic) กว่ามาก
และในลิสติ้ง 9-9 เรายังสามารถทำให้โค้ดสั้นลงกว่านี้ได้อีกโดยใช้ฟังก์ชัน fs::read_to_string
#![allow(unused)]
fn main() {
use std::fs;
use std::io;
fn read_username_from_file() -> Result<String, io::Error> {
fs::read_to_string("hello.txt")
}
}การอ่านข้อมูลจากไฟล์เข้ามาเก็บไว้ในสตริงเป็นงานที่พบได้บ่อยมาก ไลบรารีมาตรฐานจึงจัดเตรียมฟังก์ชันที่แสนสะดวกอย่าง fs::read_to_string มาให้ ซึ่งจะช่วยเปิดไฟล์, สร้าง String ใหม่, อ่านเนื้อหาในไฟล์ใส่ลงใน String นั้น แล้วส่งคืนออกมาให้ทันที แน่นอนว่าการใช้ fs::read_to_string ตั้งแต่แรกคงไม่เปิดโอกาสให้เราได้อธิบายกลไกการจัดการข้อผิดพลาดอย่างละเอียด เราจึงเริ่มต้นด้วยวิธีที่ยาวกว่าก่อน
ใช้ตัวดำเนินการ ? ได้ที่ไหน
ตัวดำเนินการ ? สามารถใช้งานได้เฉพาะภายในฟังก์ชันที่มีประเภทการส่งกลับ (return type) เข้ากันได้กับค่าที่นำ ? ไปต่อท้ายเท่านั้น สาเหตุเพราะตัวดำเนินการ ? ถูกนิยามให้ทำการส่งคืนค่าและออกจากฟังก์ชันทันที (early return) ในลักษณะเดียวกับนิพจน์ match ในลิสติ้ง 9-6 ซึ่งในลิสติ้ง 9-6 นั้น ตัว match จัดการกับค่า Result และแขนที่คืนค่าออกมาก่อนจะส่งคืนค่า Err(e) ออกมา ดังนั้นประเภทการส่งกลับของฟังก์ชันจึงต้องเป็น Result เพื่อให้เข้ากันได้กับคำสั่ง return นี้
ในลิสติ้ง 9-10 มาดูข้อผิดพลาดที่จะเกิดขึ้นหากเรานำตัวดำเนินการ ? ไปใช้ในฟังก์ชัน main ที่มีประเภทการส่งกลับไม่เข้ากันกับค่าที่เรานำ ? ไปใช้ด้วย:
use std::fs::File;
fn main() {
let greeting_file = File::open("hello.txt")?;
}โค้ดนี้พยายามเปิดไฟล์ซึ่งอาจล้มเหลวได้ ตัวดำเนินการ ? ถูกวางไว้ต่อท้ายค่า Result ที่ได้จาก File::open แต่ฟังก์ชัน main นี้กลับมีประเภทการส่งกลับเป็น () ไม่ใช่ Result เมื่อเราคอมไพล์โค้ดนี้ จึงได้รับข้อความแสดงข้อผิดพลาดดังนี้:
$ cargo run
Compiling error-handling v0.1.0 (file:///projects/error-handling)
error[E0277]: the `?` operator can only be used in a function that returns `Result` or `Option` (or another type that implements `FromResidual`)
--> src/main.rs:4:48
|
3 | fn main() {
| --------- this function should return `Result` or `Option` to accept `?`
4 | let greeting_file = File::open("hello.txt")?;
| ^ cannot use the `?` operator in a function that returns `()`
|
help: consider adding return type
|
3 ~ fn main() -> Result<(), Box<dyn std::error::Error>> {
4 | let greeting_file = File::open("hello.txt")?;
5 + Ok(())
|
For more information about this error, try `rustc --explain E0277`.
error: could not compile `error-handling` (bin "error-handling") due to 1 previous error
ข้อผิดพลาดนี้ชี้แจงอย่างชัดเจนว่า เราได้รับอนุญาตให้ใช้ตัวดำเนินการ ? ได้เฉพาะในฟังก์ชันที่ส่งคืนค่าประเภท Result, Option หรือประเภทอื่นที่อิมพลีเมนต์ FromResidual เท่านั้น
ในการแก้ไขข้อผิดพลาดนี้ คุณมีทางเลือกอยู่สองทาง ทางเลือกแรกคือ เปลี่ยนประเภทการส่งกลับของฟังก์ชันให้เข้ากันได้กับค่าที่คุณกำลังใช้ตัวดำเนินการ ? อยู่ (ตราบใดที่ไม่มีข้อจำกัดอื่นห้ามไว้) ส่วนอีกทางเลือกหนึ่งคือ ใช้ match หรือใช้เมธอดตัวช่วยของ Result<T, E> เพื่อจัดการกับค่า Result<T, E> นั้นตามความเหมาะสม
ข้อความแสดงข้อผิดพลาดยังระบุด้วยว่า เราสามารถใช้ ? ร่วมกับค่าประเภท Option<T> ได้เช่นกัน และเช่นเดียวกับการใช้ ? บน Result คุณจะสามารถใช้ ? บน Option ได้เฉพาะในฟังก์ชันที่ส่งคืนค่าเป็น Option เท่านั้น โดยพฤติกรรมของตัวดำเนินการ ? เมื่อเรียกใช้บน Option<T> จะคล้ายคลึงกับพฤติกรรมบน Result<T, E> มาก: หากค่านั้นเป็น None ตัวฟังก์ชันจะส่งคืน None ออกไปทันที ณ จุดนั้น แต่หากค่านั้นเป็น Some ค่าที่อยู่ภายใน Some จะถูกดึงออกมาเป็นผลลัพธ์ของนิพจน์ และฟังก์ชันจะทำงานบรรทัดถัดไปต่อ ลิสติ้ง 9-11 แสดงตัวอย่างของฟังก์ชันที่ค้นหาตัวอักษรสุดท้ายของบรรทัดแรกในข้อความที่กำหนด:
fn last_char_of_first_line(text: &str) -> Option<char> {
text.lines().next()?.chars().last()
}
fn main() {
assert_eq!(
last_char_of_first_line("Hello, world\nHow are you today?"),
Some('d')
);
assert_eq!(last_char_of_first_line(""), None);
assert_eq!(last_char_of_first_line("\nhi"), None);
}ฟังก์ชันนี้ส่งคืนค่าเป็น Option<char> เพราะมีความเป็นไปได้ว่าอาจมีตัวอักษรอยู่ หรืออาจไม่มีตัวอักษรใดๆ อยู่เลยก็ได้ โค้ดนี้รับอาร์กิวเมนต์เป็นสตริงสไลซ์ text แล้วเรียกเมธอด lines ซึ่งจะส่งคืนตัววนซ้ำ (iterator) บนแต่ละบรรทัดของสตริง และเนื่องจากฟังก์ชันนี้ต้องการตรวจสอบเฉพาะบรรทัดแรก มันจึงเรียกเมธอด next บน iterator เพื่อดึงค่าบรรทัดแรกออกมา หาก text เป็นสตริงว่าง การเรียก next จะส่งคืน None ซึ่งในกรณีนี้เครื่องหมาย ? จะหยุดการทำงานและส่งคืน None ออกจากฟังก์ชัน last_char_of_first_line ทันที แต่ถ้า text ไม่ใช่สตริงว่าง next จะส่งคืนค่า Some ที่บรรจุสตริงสไลซ์ของบรรทัดแรกไว้
จากนั้น ? จะดึงสตริงสไลซ์นั้นออกมา และเราเรียก chars บนสตริงสไลซ์ดังกล่าวเพื่อรับ iterator ของตัวอักษรในบรรทัดนั้น และเนื่องจากเราสนใจตัวอักษรตัวสุดท้ายของบรรทัดแรก เราจึงเรียก last เพื่อส่งคืนไอเท็มตัวสุดท้ายจาก iterator ซึ่งผลลัพธ์นี้ก็เป็น Option เช่นกัน เพราะมีความเป็นไปได้ที่บรรทัดแรกจะเป็นบรรทัดว่าง เช่น กรณีที่ text เริ่มต้นด้วยการขึ้นบรรทัดใหม่แต่มีตัวอักษรในบรรทัดถัดไปอย่างใน "\nhi" แต่ถ้ามีตัวอักษรตัวสุดท้ายในบรรทัดแรกจริง มันก็จะถูกส่งคืนออกมาในวาเรียนต์ Some ตัวดำเนินการ ? ที่อยู่ตรงกลางช่วยให้เราเขียนตรรกะนี้ได้อย่างกระชับจนสามารถอิมพลีเมนต์ทั้งฟังก์ชันได้จบในบรรทัดเดียว หากเราไม่สามารถใช้ ? กับ Option ได้ เราก็คงต้องเขียนตรรกะนี้ด้วยการเรียกเมธอดซ้อนกันหลายขั้นหรือเขียนนิพจน์ match ยืดยาวแทน
โปรดทราบว่า คุณสามารถใช้ตัวดำเนินการ ? กับ Result ได้ในฟังก์ชันที่ส่งคืน Result และสามารถใช้ ? กับ Option ได้ในฟังก์ชันที่ส่งคืน Option แต่คุณไม่สามารถนำมาใช้ปะปนข้ามชนิดกันได้ ตัวดำเนินการ ? จะไม่แปลง Result เป็น Option หรือในทางกลับกันให้โดยอัตโนมัติ ในกรณีที่คุณต้องการแปลงข้ามชนิด คุณสามารถใช้เมธอดอย่าง ok บน Result หรือเมธอด ok_or บน Option เพื่อทำการแปลงประเภทข้อมูลอย่างชัดเจนก่อนได้
จนถึงตอนนี้ ฟังก์ชัน main ทั้งหมดที่เราใช้งานมาล้วนส่งคืนค่าเป็น () ฟังก์ชัน main มีความพิเศษตรงที่เป็นจุดเริ่มต้น (entry point) และจุดสิ้นสุด (exit point) ของโปรแกรมที่สามารถรันได้ จึงมีข้อจำกัดเกี่ยวกับประเภทข้อมูลส่งกลับ เพื่อให้โปรแกรมสามารถทำงานและสื่อสารกับระบบปฏิบัติการได้อย่างถูกต้อง
แต่โชคดีที่ฟังก์ชัน main สามารถส่งคืนค่าเป็น Result<(), E> ได้ด้วยเช่นกัน ในลิสติ้ง 9-12 เรานำโค้ดจากลิสติ้ง 9-10 มาปรับแก้ประเภทการส่งกลับของ main ให้เป็น Result<(), Box<dyn Error>> และเพิ่มค่าส่งกลับ Ok(()) ไว้ที่บรรทัดสุดท้าย คราวนี้โค้ดจะสามารถคอมไพล์ผ่านได้อย่างสมบูรณ์!
use std::error::Error;
use std::fs::File;
fn main() -> Result<(), Box<dyn Error>> {
let greeting_file = File::open("hello.txt")?;
Ok(())
}ประเภทข้อมูล Box<dyn Error> เป็นเทรตออบเจกต์ (trait object) ซึ่งเราจะอธิบายอย่างละเอียดในหัวข้อ “การใช้เทรตออบเจกต์เพื่อนามธรรมพฤติกรรมร่วม” ในบทที่ 18 สำหรับตอนนี้ คุณสามารถมอง Box<dyn Error> ง่ายๆ ว่าหมายถึง “ข้อผิดพลาดประเภทใดก็ได้” การใช้ ? กับค่า Result ในฟังก์ชัน main ที่ระบุประเภทข้อผิดพลาดเป็น Box<dyn Error> นั้นได้รับอนุญาตเพราะมันเปิดให้ส่งคืนค่า Err ชนิดใดๆ ออกมาก่อนได้ แม้ว่าในตอนนี้เนื้อหาของฟังก์ชัน main จะส่งคืนเฉพาะข้อผิดพลาดประเภท std::io::Error แต่การระบุ Box<dyn Error> จะช่วยให้ลายเซ็นฟังก์ชัน (signature) นี้ยังคงใช้ได้เสมอ แม้ในอนาคตจะมีโค้ดส่วนอื่นใน main ที่คืนค่าข้อผิดพลาดประเภทอื่นเพิ่มเข้ามาก็ตาม
เมื่อฟังก์ชัน main ส่งคืนค่าเป็น Result<(), E> ตัวโปรแกรมจะส่งรหัสสถานะออก (exit code) เป็น 0 หาก main คืนค่า Ok(()) และจะส่งรหัสสถานะออกเป็นค่าที่ไม่ใช่ศูนย์หาก main คืนค่า Err ซึ่งโปรแกรมที่เขียนด้วยภาษา C ก็คืนค่าจำนวนเต็มเมื่อสิ้นสุดการทำงานเช่นกัน โดยโปรแกรมที่ทำงานสำเร็จสมบูรณ์จะส่งค่าจำนวนเต็ม 0 ส่วนโปรแกรมที่เกิดข้อผิดพลาดจะส่งค่าจำนวนเต็มอื่นที่ไม่ใช่ 0 และ Rust ก็ปฏิบัติตามแบบแผน (convention) เดียวกันนี้เพื่อให้ทำงานร่วมกับระบบปฏิบัติการได้อย่างราบรื่น
ฟังก์ชัน main ยังสามารถส่งคืนประเภทข้อมูลใดๆ ก็ตามที่อิมพลีเมนต์ เทรต std::process::Termination ซึ่งมีฟังก์ชัน report ที่ส่งคืนค่า ExitCode คุณสามารถศึกษาเอกสารของไลบรารีมาตรฐานเพิ่มเติมหากต้องการอิมพลีเมนต์เทรต Termination ให้กับประเภทข้อมูลของคุณเอง
เมื่อเราได้เรียนรู้รายละเอียดเกี่ยวกับการเรียกใช้ panic! และการส่งคืนค่า Result กันไปแล้ว ในหัวข้อถัดไปเราจะกลับมาดูแนวทางการตัดสินใจว่า ในสถานการณ์ใดควรเลือกใช้แบบไหนจึงจะเหมาะสมที่สุด
จะ panic! หรือไม่ panic!
จะ panic! หรือไม่ panic!
แล้วเราจะตัดสินใจอย่างไรว่าเมื่อใดควรเรียก panic! และเมื่อใดควรส่งคืนค่า Result? เมื่อโค้ดเกิดการแพนิก (panic) ขึ้น จะไม่มีทางกู้คืนสถานะกลับมาได้อีก คุณอาจจะเลือกเรียกใช้ panic! กับทุกสถานการณ์ที่เกิดข้อผิดพลาด ไม่ว่าจะมีหนทางกู้คืนได้หรือไม่ก็ตาม แต่การทำเช่นนั้นเท่ากับว่าคุณกำลังตัดสินใจแทนโค้ดต้นทางที่เรียกใช้ว่าสถานการณ์นั้นๆ เป็นสิ่งที่ไม่สามารถกู้คืนได้ ทว่าเมื่อคุณเลือกที่จะส่งคืนค่าเป็น Result คุณกำลังมอบทางเลือกให้แก่โค้ดต้นทางที่เรียกใช้ ซึ่งโค้ดต้นทางอาจเลือกที่จะพยายามกู้คืนด้วยวิธีที่เหมาะสมกับบริบทของมัน หรืออาจตัดสินว่าค่า Err ในกรณีนี้ไม่สามารถกู้คืนได้ แล้วจึงเป็นฝ่ายเรียก panic! เพื่อเปลี่ยนข้อผิดพลาดที่กู้คืนได้ (recoverable error) ของคุณให้กลายเป็นข้อผิดพลาดที่กู้คืนไม่ได้ (unrecoverable error) เสียเอง ดังนั้น การส่งคืนค่า Result จึงเป็นตัวเลือกเริ่มต้นที่ดีเสมอเมื่อคุณนิยามฟังก์ชันที่มีโอกาสทำงานล้มเหลว
อย่างไรก็ดี ในบางสถานการณ์ เช่น โค้ดตัวอย่าง, โค้ดต้นแบบ (prototype) และการเขียนเทสต์ การเขียนโค้ดให้เกิด panic มักจะเหมาะสมกว่าการส่งคืน Result มาดูกันว่าทำไมจึงเป็นเช่นนั้น จากนั้นเราจะพูดคุยถึงสถานการณ์ที่คอมไพเลอร์ไม่สามารถบอกได้ว่าข้อผิดพลาดจะไม่มีทางเกิดขึ้น แต่คุณในฐานะมนุษย์สามารถล่วงรู้ได้ และเราจะปิดท้ายบทนี้ด้วยแนวทางปฏิบัติทั่วไปในการตัดสินใจว่าจะสั่ง panic ในโค้ดไลบรารีหรือไม่
ตัวอย่าง โค้ดต้นแบบ และการทดสอบ
เมื่อคุณเขียนโค้ดตัวอย่างเพื่ออธิบายแนวคิดอะไรบางอย่าง การใส่โค้ดจัดการข้อผิดพลาดแบบเต็มรูปแบบเข้าไปด้วยอาจทำให้ตัวอย่างนั้นดูซับซ้อนและเข้าใจยากขึ้น ในโค้ดตัวอย่างจึงเป็นที่เข้าใจกันดีว่า การเรียกเมธอดอย่าง unwrap ที่อาจทำให้เกิด panic นั้น มีเจตนาเพื่อเป็นตัวแทนชั่วคราว (placeholder) สำหรับจุดที่คุณต้องการให้แอปพลิเคชันจัดการกับข้อผิดพลาด ซึ่งอาจแตกต่างกันไปตามบริบทของโค้ดส่วนอื่นๆ
ในทำนองเดียวกัน เมธอด unwrap และ expect นั้นสะดวกและมีประโยชน์อย่างยิ่งในขั้นตอนการทำต้นแบบ (prototyping) ก่อนที่คุณจะพร้อมตัดสินใจว่าจะจัดการกับข้อผิดพลาดแต่ละจุดอย่างไร โดยพวกมันจะทำหน้าที่เป็นจุดสังเกตที่ชัดเจนในโค้ด เพื่อให้คุณกลับมาปรับปรุงโค้ดให้รัดกุมยิ่งขึ้นในภายหลัง
และหากการเรียกเมธอดใดทำงานล้มเหลวในระหว่างการรันเทสต์ คุณย่อมต้องการให้เทสต์เคสนั้นล้มเหลวทันที แม้ว่าเมธอดดังกล่าวจะไม่ใช่ฟังก์ชันการทำงานหลักที่กำลังถูกทดสอบอยู่ก็ตาม และเนื่องจากกลไกการแพนิกคือวิธีที่ Rust ใช้ระบุว่าเทสต์เคสนั้นไม่ผ่าน (failure) การเรียกใช้ unwrap หรือ expect จึงเป็นสิ่งที่เหมาะสมและควรทำอย่างยิ่งในการเขียนเทสต์
เมื่อคุณมีข้อมูลมากกว่าคอมไพเลอร์
นอกจากนี้ การเรียกใช้ expect ยังเหมาะสมอย่างยิ่งเมื่อคุณมีตรรกะอื่นที่รับประกันได้แน่นอนว่าค่า Result จะเป็น Ok เสมอ แต่ตรรกะนั้นอยู่นอกเหนือสิ่งที่คอมไพเลอร์จะเข้าใจได้ คุณจึงยังคงต้องรับมือกับค่า Result อยู่: ไม่ว่าการทำงานที่คุณเรียกใช้จะมีโอกาสล้มเหลวได้ในกรณีทั่วไป แต่ในสถานการณ์เฉพาะของคุณนั้นในทางตรรกะแล้วย่อมไม่มีทางล้มเหลวได้อย่างแน่นอน หากคุณตรวจสอบโค้ดอย่างถี่ถ้วนแล้วมั่นใจว่าจะไม่มีทางได้วาเรียนต์ Err เด็ดขาด การเรียกใช้ expect พร้อมกับบันทึกเหตุผลลงในข้อความแจ้งเตือนว่าทำไมจึงไม่มีทางเกิด Err ขึ้นได้ จึงเป็นแนวทางปฏิบัติที่ยอมรับได้และดีอย่างยิ่ง ดังตัวอย่างนี้:
fn main() {
use std::net::IpAddr;
let home: IpAddr = "127.0.0.1"
.parse()
.expect("Hardcoded IP address should be valid");
}เรากำลังสร้างอินสแตนซ์ของ IpAddr โดยการพาร์สสตริงที่ฮาร์ดโค้ดไว้ เรามองเห็นได้ชัดเจนว่า 127.0.0.1 เป็นไอพีแอดเดรสที่ถูกต้องแน่นอน จึงยอมรับได้ที่จะใช้ expect ตรงจุดนี้ ทว่าการฮาร์ดโค้ดสตริงที่ถูกต้องไม่ได้เปลี่ยนประเภทข้อมูลส่งกลับของเมธอด parse: เรายังคงได้ค่า Result กลับมา และคอมไพเลอร์ก็ยังคงบังคับให้เราจัดการกับ Result นั้นเสมือนว่าอาจเกิดวาเรียนต์ Err ขึ้นได้ เพราะคอมไพเลอร์ไม่ได้ฉลาดพอที่จะรู้ว่าสตริงนี้เป็นไอพีแอดเดรสที่ถูกต้องเสมอ แต่หากสตริงไอพีแอดเดรสนั้นรับมาจากผู้ใช้แทนที่จะฮาร์ดโค้ดไว้ในโปรแกรม ซึ่งย่อม มี โอกาสเกิดข้อผิดพลาดขึ้นได้แน่นอน เราก็ควรจัดการกับ Result นั้นด้วยวิธีที่รัดกุมกว่านี้ การระบุสมมติฐานไว้ในข้อความของ expect ว่าไอพีนี้มาจากการฮาร์ดโค้ด จะช่วยเตือนสติเราให้เปลี่ยนไปใช้โค้ดจัดการข้อผิดพลาดที่เหมาะสมกว่า หากในอนาคตเราต้องเปลี่ยนไปรับไอพีแอดเดรสจากแหล่งอื่นแทน
แนวทางสำหรับการจัดการข้อผิดพลาด
ขอแนะนำให้โค้ดของคุณเกิด panic ขึ้นเมื่อมีความเป็นไปได้ว่าโปรแกรมอาจตกอยู่ในสภาวะที่ไม่พึงประสงค์ (bad state) ในบริบทนี้ สภาวะที่ไม่พึงประสงค์ หมายถึง การที่สมมติฐาน, ข้อรับประกัน, ข้อตกลง (contract) หรือความคงเส้นคงวา (invariant) บางประการถูกทำลายลง เช่น มีการส่งค่าที่ไม่ถูกต้อง, ค่าที่ขัดแย้งกันเอง หรือค่าที่ขาดหายเข้ามายังโค้ดของคุณ ร่วมกับเงื่อนไขข้อใดข้อหนึ่งหรือหลายข้อดังต่อไปนี้:
- สภาวะที่ไม่พึงประสงค์นั้นเป็นสิ่งที่ไม่ควรเกิดขึ้นอย่างสิ้นเชิง (unexpected) ซึ่งต่างจากสิ่งที่อาจเกิดขึ้นได้เป็นธรรมดา เช่น การที่ผู้ใช้กรอกข้อมูลผิดรูปแบบ
- โค้ดที่ทำงานต่อหลังจากจุดนี้จำเป็นต้องเชื่อมั่นได้ว่าโปรแกรมไม่ได้อยู่ในสภาวะที่ไม่พึงประสงค์ดังกล่าว แทนที่จะต้องคอยเขียนโค้ดตรวจสอบปัญหาซ้ำซากในทุกๆ ขั้นตอน
- ไม่มีหนทางที่ดีในการเข้ารหัสข้อมูลนี้ไว้ในระบบประเภทข้อมูลที่คุณใช้งาน (เราจะยกตัวอย่างเรื่องนี้ให้เห็นชัดเจนในหัวข้อ “การเข้ารหัสสถานะและพฤติกรรมเป็นชนิดข้อมูล” ในบทที่ 18)
หากมีคนเรียกใช้โค้ดของคุณโดยส่งค่าที่ไม่สมเหตุสมผลเข้ามา วิธีที่ดีที่สุดคือการส่งคืนข้อผิดพลาดกลับไปถ้าทำได้ เพื่อให้ผู้เรียกใช้ไลบรารีตัดสินใจเองว่าจะทำอย่างไรในกรณีนั้น อย่างไรก็ตาม หากการทำงานต่อไปอาจก่อให้เกิดความไม่ปลอดภัยหรือความเสียหาย ทางเลือกที่ดีที่สุดอาจเป็นการเรียกใช้ panic! เพื่อแจ้งเตือนผู้ใช้งานไลบรารีให้ทราบถึงบั๊กในโค้ดของพวกเขา เพื่อที่พวกเขาจะได้แก้ไขให้ถูกต้องในระหว่างการพัฒนา ในทำนองเดียวกัน การเรียก panic! มักจะเหมาะสมเมื่อคุณเรียกใช้โค้ดภายนอกที่อยู่นอกเหนือการควบคุมของคุณ แล้วโค้ดนั้นส่งสถานะที่ไม่ถูกต้องกลับมาจนคุณไม่มีทางแก้ไขอะไรได้
แต่เมื่อใดที่ความล้มเหลวเป็นสิ่งที่คาดการณ์ได้อยู่แล้ว การส่งคืนค่า Result ย่อมเหมาะสมกว่าการสั่ง panic! เสมอ ตัวอย่างเช่น โมดูลพาร์เซอร์ที่ได้รับข้อมูลผิดรูปแบบ หรือคำขอ HTTP ที่ส่งสถานะแจ้งว่าคุณเรียกใช้งานเกินโควตา (rate limit) ในสถานการณ์เหล่านี้ การส่งคืน Result เป็นการส่งสัญญาณว่าความล้มเหลวเป็นสิ่งที่มีโอกาสเกิดขึ้นได้ และโค้ดต้นทางที่เรียกใช้จะต้องเตรียมการรับมือเอาไว้
เมื่อโค้ดของคุณต้องทำงานที่มีความเสี่ยงต่อความปลอดภัยหากถูกเรียกใช้ด้วยค่าที่ไม่ถูกต้อง โค้ดของคุณควรตรวจสอบความถูกต้องของค่านั้นก่อน และสั่ง panic หากพบว่าค่านั้นไม่ถูกต้อง ทั้งนี้เพื่อความปลอดภัยเป็นหลัก: เพราะการฝืนประมวลผลข้อมูลที่ไม่ถูกต้องต่อไปอาจเปิดช่องโหว่ด้านความปลอดภัยร้ายแรงได้ นี่คือเหตุผลสำคัญที่ไลบรารีมาตรฐานจะเรียก panic! ทันทีหากคุณพยายามเข้าถึงหน่วยความจำเกินขอบเขต เพราะการเข้าถึงหน่วยความจำที่ไม่ได้เป็นของโครงสร้างข้อมูลนั้นถือเป็นปัญหาความปลอดภัยที่พบบ่อย นอกจากนี้ ฟังก์ชันมักจะมี ข้อตกลง (contracts): พฤติกรรมของมันจะได้รับการรับประกันก็ต่อเมื่ออินพุตตรงตามเงื่อนไขที่กำหนดเท่านั้น การสั่ง panic เมื่อข้อตกลงถูกละเมิดจึงเป็นสิ่งที่สมเหตุสมผล เพราะการละเมิดข้อตกลงบ่งชี้ถึงบั๊กของฝั่งผู้เรียกใช้เสมอ และไม่ใช่ข้อผิดพลาดประเภทที่โค้ดต้นทางควรจะดักจับไปทำงานต่อ เพราะในความเป็นจริง โค้ดต้นทางไม่มีทางกู้คืนสถานะได้อย่างสมเหตุสมผลเลย แต่เป็นตัว โปรแกรมเมอร์ เองที่ต้องไปแก้โค้ดให้ถูกต้อง โดยข้อตกลงของฟังก์ชัน (โดยเฉพาะอย่างยิ่งกรณีที่การละเมิดจะทำให้เกิด panic) ควรได้รับการอธิบายไว้อย่างชัดเจนในเอกสาร API ของฟังก์ชันนั้น
อย่างไรก็ตาม การใส่โค้ดตรวจเช็กข้อผิดพลาดจำนวนมหาศาลไว้ในทุกฟังก์ชันย่อมทำให้โค้ดยืดยาวและน่ารำคาญ โชคดีที่คุณสามารถใช้ระบบประเภทข้อมูลของ Rust (และการตรวจสอบประเภทข้อมูลโดยคอมไพเลอร์) มาช่วยทำงานตรวจสอบเหล่านี้แทนคุณได้ หากฟังก์ชันของคุณกำหนดพารามิเตอร์เป็นประเภทข้อมูลที่เฉพาะเจาะจง คุณก็สามารถเขียนตรรกะของโค้ดต่อไปได้อย่างสบายใจโดยรู้ว่าคอมไพเลอร์ได้รับประกันความถูกต้องของค่านั้นไว้แล้ว ตัวอย่างเช่น หากคุณกำหนดประเภทข้อมูลแบบตรงๆ แทนที่จะเป็น Option โปรแกรมของคุณก็คาดหวังว่าจะได้รับ ข้อมูลบางอย่าง เสมอโดยไม่มีทาง ว่างเปล่า โค้ดของคุณจึงไม่ต้องคอยจัดการสองกรณีระหว่างวาเรียนต์ Some และ None: แต่จะมีเพียงกรณีเดียวที่มั่นใจได้ว่ามีค่าแน่นอน โค้ดที่พยายามส่งค่าว่างเปล่ามายังฟังก์ชันจะไม่สามารถคอมไพล์ผ่านได้เลย ฟังก์ชันของคุณจึงไม่ต้องเสียเวลาตรวจสอบกรณีนั้นในตอนรันไทม์ หรืออีกตัวอย่างหนึ่งคือการใช้ประเภทจำนวนเต็มไม่มีเครื่องหมายอย่าง u32 ซึ่งจะช่วยรับประกันได้ทันทีว่าพารามิเตอร์นั้นจะไม่มีทางเป็นค่าติดลบอย่างแน่นอน
ชนิดข้อมูลที่กำหนดเองสำหรับการตรวจสอบความถูกต้อง
มาต่อยอดแนวคิดเรื่องการใช้ระบบประเภทข้อมูลของ Rust เพื่อรับประกันความถูกต้องของค่าให้ลึกซึ้งยิ่งขึ้น โดยการสร้างประเภทข้อมูลที่กำหนดขึ้นเอง (custom type) เพื่อใช้ในการตรวจสอบความถูกต้อง ย้อนกลับไปดูเกมทายตัวเลขในบทที่ 2 ซึ่งโค้ดของเราขอให้ผู้ใช้ทายตัวเลขระหว่าง 1 ถึง 100 ในตอนนั้นเราไม่ได้ตรวจสอบเลยว่าตัวเลขที่ผู้ใช้ทายเข้ามานั้นอยู่ในช่วง 1 ถึง 100 หรือไม่ ก่อนที่จะนำไปเปรียบเทียบกับตัวเลขลับ แต่เราตรวจสอบเพียงแค่ว่าค่าที่ป้อนเข้ามาเป็นจำนวนบวกเท่านั้น ซึ่งในกรณีนั้น ผลลัพธ์ไม่ได้เลวร้ายอะไรมากนัก: ข้อความแจ้งเตือน “สูงเกินไป” หรือ “ต่ำเกินไป” ของเราก็ยังคงทำงานได้อย่างถูกต้อง แต่จะดีกว่ามากหากเราปรับปรุงให้โปรแกรมสามารถแนะนำผู้ใช้ให้ทายตัวเลขที่ถูกต้อง และมีพฤติกรรมการตอบสนองที่แตกต่างกันอย่างชัดเจนเมื่อผู้ใช้ทายตัวเลขที่อยู่นอกช่วง เทียบกับกรณีที่ผู้ใช้พิมพ์ตัวอักษรเข้ามา
วิธีหนึ่งในการทำเช่นนี้คือ การพาร์สคำทายให้เป็น i32 แทนที่จะเป็นแค่ u32 เพื่อเปิดรับตัวเลขที่อาจติดลบได้ แล้วจึงเพิ่มการตรวจสอบว่าตัวเลขดังกล่าวอยู่ในช่วงที่กำหนดหรือไม่ ดังนี้:
use std::cmp::Ordering;
use std::io;
use rand::prelude::*;
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
loop {
// --snip--
println!("Please input your guess.");
let mut guess = String::new();
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
let guess: i32 = match guess.trim().parse() {
Ok(num) => num,
Err(_) => continue,
};
if guess < 1 || guess > 100 {
println!("The secret number will be between 1 and 100.");
continue;
}
match guess.cmp(&secret_number) {
// --snip--
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => {
println!("You win!");
break;
}
}
}
}นิพจน์ if จะตรวจสอบว่าค่าของเราอยู่นอกช่วงหรือไม่ หากนอกช่วงก็จะแจ้งเตือนปัญหาให้ผู้ใช้ทราบ แล้วเรียกใช้ continue เพื่อเริ่มต้นลูปรอบถัดไปและขอให้ทายตัวเลขใหม่ และหลังจากผ่านนิพจน์ if ไปได้ เราก็สามารถทำการเปรียบเทียบระหว่าง guess กับตัวเลขลับได้อย่างมั่นใจว่า guess จะมีค่าอยู่ระหว่าง 1 ถึง 100 แน่นอน
อย่างไรก็ตาม นี่ไม่ใช่วิธีแก้ปัญหาในอุดมคติ: หากการจำกัดให้โปรแกรมทำงานเฉพาะกับค่าระหว่าง 1 ถึง 100 เป็นเรื่องสำคัญยิ่งยวด และมีหลายๆ ฟังก์ชันที่ต้องปฏิบัติตามข้อกำหนดนี้ การที่ต้องมาคอยเขียนโค้ดตรวจสอบแบบนี้ซ้ำๆ ในทุกฟังก์ชันย่อมเป็นเรื่องที่น่าเบื่อหน่าย (และอาจส่งผลกระทบต่อประสิทธิภาพการทำงานด้วย)
แทนที่จะทำเช่นนั้น เราสามารถสร้างประเภทข้อมูลใหม่ขึ้นมาในมอดูลแยกต่างหาก แล้วรวมตรรกะการตรวจสอบความถูกต้องไว้ในฟังก์ชันสร้างอินสแตนซ์ของประเภทนั้น แทนที่จะต้องเขียนโค้ดตรวจสอบซ้ำไปซ้ำมาในทุกที่ ด้วยวิธีนี้ ฟังก์ชันต่างๆ จะสามารถนำประเภทข้อมูลใหม่นี้ไปใช้ในลายเซ็นของฟังก์ชันได้อย่างปลอดภัย และสามารถนำค่าที่ได้รับไปใช้งานต่อได้อย่างมั่นใจ ลิสติ้ง 9-13 แสดงวิธีหนึ่งในการนิยามประเภท Guess ซึ่งจะสร้างอินสแตนซ์ของ Guess ได้ก็ต่อเมื่อฟังก์ชัน new ได้รับค่าที่อยู่ระหว่าง 1 ถึง 100 เท่านั้น
#![allow(unused)]
fn main() {
pub struct Guess {
value: i32,
}
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 || value > 100 {
panic!("Guess value must be between 1 and 100, got {value}.");
}
Guess { value }
}
pub fn value(&self) -> i32 {
self.value
}
}
}โปรดทราบว่าโค้ดใน src/guessing_game.rs นี้ขึ้นอยู่กับการประกาศมอดูล mod guessing_game; ในไฟล์ src/lib.rs ซึ่งเราไม่ได้แสดงไว้ในที่นี้ โดยภายในไฟล์มอดูลใหม่นี้ เราได้นิยาม struct ชื่อ Guess ที่มีฟิลด์ชื่อ value เก็บค่าประเภท i32 ซึ่งเป็นจุดที่จะใช้จัดเก็บตัวเลข
จากนั้น เราได้อิมพลีเมนต์ฟังก์ชันที่เชื่อมโยงกับชนิดข้อมูล (associated function) ชื่อ new บน Guess เพื่อทำหน้าที่สร้างอินสแตนซ์ของ Guess โดยฟังก์ชัน new ถูกนิยามให้รับพารามิเตอร์หนึ่งตัวชื่อ value ประเภท i32 และส่งคืนค่าเป็น Guess โค้ดภายในฟังก์ชัน new จะทดสอบค่า value เพื่อให้แน่ใจว่าอยู่ระหว่าง 1 ถึง 100 หาก value ไม่ผ่านเงื่อนไขนี้ เราจะสั่งเรียก panic! เพื่อแจ้งเตือนโปรแกรมเมอร์ที่เขียนโค้ดเรียกใช้ฟังก์ชันว่าพวกเขามีบั๊กที่ต้องแก้ไข เพราะการสร้าง Guess ด้วย value ที่อยู่นอกช่วงนี้ถือเป็นการละเมิดข้อตกลงที่ Guess::new กำหนดไว้ โดยเงื่อนไขที่อาจทำให้ Guess::new เกิด panic นั้นควรระบุไว้ในเอกสาร API สาธารณะของฟังก์ชัน ซึ่งเราจะพูดถึงธรรมเนียมการเขียนเอกสารแจ้งเตือนโอกาสที่จะเกิด panic! ในเอกสาร API ในบทที่ 14 และหากค่า value ผ่านเงื่อนไขการทดสอบ เราจะสร้างอินสแตนซ์ Guess ใหม่โดยกำหนดฟิลด์ value ให้มีค่าตามพารามิเตอร์ value แล้วส่งคืน Guess นั้นออกมา
ลำดับถัดไป เราได้อิมพลีเมนต์เมธอดชื่อ value ซึ่งยืม self โดยไม่มีพารามิเตอร์อื่น และส่งคืนค่าเป็น i32 เมธอดลักษณะนี้บางครั้งเรียกว่า เก็ตเตอร์ (getter) เพราะมีเป้าหมายเพื่อดึงข้อมูลจากฟิลด์ภายในส่งคืนออกไป โดยเมธอดสาธารณะนี้จำเป็นต้องมีเนื่องจากฟิลด์ value ของ struct Guess ถูกกำหนดให้เป็นแบบส่วนตัว (private) การทำให้ฟิลด์ value เป็น private นั้นมีความสำคัญอย่างยิ่ง เพื่อป้องกันไม่ให้โค้ดภายนอกที่นำ struct Guess ไปใช้สามารถแก้ไขค่า value ได้โดยตรง นั่นทำให้โค้ดภายนอกมอดูล guessing_game จำเป็นต้อง เรียกผ่านฟังก์ชัน Guess::new เพื่อสร้างอินสแตนซ์ของ Guess เสมอ ซึ่งช่วยรับประกันได้ว่า Guess จะไม่มีทางมีค่า value ที่เล็ดลอดการตรวจสอบเงื่อนไขในฟังก์ชัน Guess::new ไปได้เลย
ดังนั้น ฟังก์ชันอื่นๆ ที่ต้องการรับพารามิเตอร์หรือส่งคืนเฉพาะตัวเลขระหว่าง 1 ถึง 100 ก็สามารถประกาศในลายเซ็นฟังก์ชันได้ทันทีว่ารับหรือคืนค่าประเภท Guess แทนที่จะเป็น i32 และไม่จำเป็นต้องเขียนโค้ดตรวจสอบเงื่อนไขเพิ่มเติมในเนื้อหาของฟังก์ชันอีกต่อไป
สรุป
ฟีเจอร์การจัดการข้อผิดพลาดของ Rust ได้รับการออกแบบมาเพื่อช่วยให้คุณเขียนโค้ดที่มีความทนทานและเสถียร (robust) ยิ่งขึ้น โดยแมโคร panic! จะทำหน้าที่ส่งสัญญาณเตือนว่าโปรแกรมกำลังตกอยู่ในสภาวะที่ไม่สามารถจัดการต่อไปได้ และช่วยสั่งให้โปรเซสหยุดทำงานแทนที่จะฝืนประมวลผลต่อด้วยค่าที่ไม่ถูกต้อง ส่วน enum Result อาศัยระบบประเภทข้อมูลอันทรงพลังของ Rust เพื่อบ่งบอกว่าการทำงานอาจเกิดความล้มเหลวในลักษณะที่โค้ดของคุณสามารถกู้คืนได้ คุณสามารถใช้ Result เพื่อแจ้งให้โค้ดต้นทางที่เรียกใช้เตรียมพร้อมรับมือกับผลลัพธ์ทั้งกรณีที่สำเร็จและล้มเหลว การเลือกใช้ panic! และ Result อย่างเหมาะสมตามสถานการณ์จะช่วยให้โค้ดของคุณมีความน่าเชื่อถือและพร้อมรับมือกับปัญหาต่างๆ ที่อาจเกิดขึ้นได้อย่างมั่นใจ
หลังจากที่คุณได้เห็นตัวอย่างอันทรงพลังที่ไลบรารีมาตรฐานนำเจเนอริกมาใช้ร่วมกับ enum Option และ Result ไปแล้ว ในบทถัดไปเราจะมาเจาะลึกกันว่า เจเนอริกทำงานอย่างไร และคุณจะสามารถนำมันมาประยุกต์ใช้ในโค้ดของคุณได้อย่างไร
เจเนอริก เทรต และไลฟ์ไทม์
ภาษาโปรแกรมทุกภาษามักมีเครื่องมือสำหรับจัดการกับความซ้ำซ้อนของแนวคิดหรือโค้ดอย่างมีประสิทธิภาพ ในภาษา Rust เครื่องมือสำคัญอย่างหนึ่งก็คือ เจเนอริก (generics) ซึ่งเป็นตัวแทนเชิงนามธรรม (abstract stand-ins) ของประเภทข้อมูลรูปธรรมหรือคุณสมบัติอื่นๆ เราสามารถเขียนกำหนดพฤติกรรมของเจเนอริกหรือความสัมพันธ์ของมันกับเจเนอริกอื่นๆ ได้ โดยไม่ต้องรู้ล่วงหน้าว่าจะมีประเภทข้อมูลใดมาแทนที่ตำแหน่งนั้นในตอนคอมไพล์และรันโค้ดจริง
ฟังก์ชันสามารถรับพารามิเตอร์ที่เป็นประเภทข้อมูลแบบเจเนอริก แทนที่จะเป็นประเภทข้อมูลรูปธรรมอย่าง i32 หรือ String ได้ เช่นเดียวกับที่ฟังก์ชันรับพารามิเตอร์ที่ไม่ทราบค่าล่วงหน้าเพื่อรันโค้ดชุดเดียวกันบนค่ารูปธรรมที่หลากหลาย ที่จริงแล้ว เราได้ใช้งานเจเนอริกกันมาแล้วในบทที่ 6 กับ Option<T>, ในบทที่ 8 กับ Vec<T> และ HashMap<K, V> รวมถึงในบทที่ 9 กับ Result<T, E> และในบทนี้ คุณจะได้สำรวจวิธีการนิยามประเภทข้อมูล, ฟังก์ชัน และเมธอดของคุณเองด้วยเจเนอริก!
ขั้นแรก เราจะมาทบทวนวิธีการแยกฟังก์ชัน (extract a function) ออกมาเพื่อลดความซ้ำซ้อนของโค้ด จากนั้นเราจะนำเทคนิคเดียวกันนี้มาประยุกต์เพื่อสร้างฟังก์ชันเจเนอริกขึ้นจากสองฟังก์ชันที่มีจุดแตกต่างกันเพียงแค่ประเภทของพารามิเตอร์เท่านั้น นอกจากนี้ เรายังจะอธิบายวิธีการนำประเภทเจเนอริกไปใช้ในการนิยาม struct และ enum อีกด้วย
ถัดมา คุณจะได้เรียนรู้วิธีการใช้เทรต (traits) เพื่อนิยามพฤติกรรมในรูปแบบเจเนอริก ซึ่งคุณสามารถนำเทรตมารวมเข้ากับประเภทเจเนอริก เพื่อกำหนดข้อจำกัด (constraint) ให้ประเภทเจเนอริกนั้นยอมรับเฉพาะประเภทข้อมูลที่มีพฤติกรรมตามที่ระบุไว้เท่านั้น แทนที่จะยอมรับประเภทใดก็ได้แบบไร้ขอบเขต
และสุดท้าย เราจะพูดถึงเรื่อง ไลฟ์ไทม์ (lifetimes): ซึ่งเป็นรูปแบบหนึ่งของเจเนอริกที่ช่วยส่งต่อข้อมูลให้แก่คอมไพเลอร์เกี่ยวกับความสัมพันธ์ของเรเฟอเรนซ์ต่างๆ โดยไลฟ์ไทม์จะช่วยให้เราสามารถบอกข้อมูลเกี่ยวกับค่าที่ถูกยืมให้คอมไพเลอร์ทราบอย่างเพียงพอ เพื่อให้คอมไพเลอร์สามารถรับประกันได้ว่าเรเฟอเรนซ์เหล่านั้นจะยังคงถูกต้องและใช้งานได้ในหลากหลายสถานการณ์มากยิ่งขึ้นโดยไม่เกิดข้อผิดพลาด
ขจัดความซ้ำซ้อนโดยการแยกฟังก์ชันออกมา
เจเนอริกช่วยให้เราสามารถแทนที่ประเภทข้อมูลที่เฉพาะเจาะจงด้วยตัวยึดตำแหน่ง (placeholder) ที่เป็นตัวแทนของหลากหลายประเภท เพื่อขจัดความซ้ำซ้อนของโค้ด แต่ก่อนที่เราจะดำดิ่งสู่ไวยากรณ์ของเจเนอริก มาเริ่มต้นดูวิธีการขจัดความซ้ำซ้อนในแบบที่ไม่เกี่ยวข้องกับประเภทเจเนอริกกันก่อน โดยการแยกฟังก์ชันที่แทนที่ค่าเฉพาะเจาะจงด้วยตัวยึดตำแหน่งที่เป็นตัวแทนของหลายๆ ค่าออกมา จากนั้นเราจึงจะนำเทคนิคแบบเดียวกันนี้มาประยุกต์ใช้เพื่อแยกฟังก์ชันเจเนอริก! การทำความเข้าใจวิธีสังเกตโค้ดซ้ำซ้อนที่สามารถแยกเป็นฟังก์ชันได้ จะช่วยให้คุณเริ่มมองเห็นโค้ดซ้ำซ้อนที่สามารถนำเจเนอริกมาประยุกต์ใช้ได้เช่นกัน
เราจะเริ่มด้วยโปรแกรมสั้นๆ ในลิสติ้ง 10-1 ที่ค้นหาตัวเลขที่มากที่สุดในรายการ
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let mut largest = &number_list[0];
for number in &number_list {
if number > largest {
largest = number;
}
}
println!("The largest number is {largest}");
assert_eq!(*largest, 100);
}เราเก็บรายการจำนวนเต็มไว้ในตัวแปร number_list แล้วกำหนดให้เรเฟอเรนซ์ที่ชี้ไปยังตัวเลขตัวแรกในรายการไปเก็บไว้ในตัวแปรชื่อ largest จากนั้นเราวนลูปผ่านตัวเลขทุกตัวในรายการ หากตัวเลขปัจจุบันมีค่ามากกว่าตัวเลขที่เก็บไว้ใน largest เราจะแทนที่เรเฟอเรนซ์ในตัวแปรนั้นด้วยตัวเลขใหม่ แต่หากตัวเลขปัจจุบันมีค่าน้อยกว่าหรือเท่ากับตัวเลขที่มากที่สุดที่พบจนถึงตอนนี้ ตัวแปรดังกล่าวก็จะไม่เปลี่ยนแปลง และโค้ดจะข้ามไปพิจารณาตัวเลขตัวถัดไปในรายการ เมื่อพิจารณาตัวเลขครบทุกตัวในรายการแล้ว largest ก็จะชี้ไปยังตัวเลขที่มีค่ามากที่สุด ซึ่งในกรณีนี้คือ 100
คราวนี้ หากเราได้รับโจทย์ให้ค้นหาตัวเลขที่มากที่สุดในรายการตัวเลขสองชุดที่แตกต่างกัน เราก็อาจเลือกทำสำเนาโค้ดจากลิสติ้ง 10-1 ซ้ำ และใช้ตรรกะเดิมในสองจุดที่ต่างกันของโปรแกรม ดังแสดงในลิสติ้ง 10-2
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let mut largest = &number_list[0];
for number in &number_list {
if number > largest {
largest = number;
}
}
println!("The largest number is {largest}");
let number_list = vec![102, 34, 6000, 89, 54, 2, 43, 8];
let mut largest = &number_list[0];
for number in &number_list {
if number > largest {
largest = number;
}
}
println!("The largest number is {largest}");
}แม้ว่าโค้ดนี้จะทำงานได้ แต่การเขียนโค้ดซ้ำซ้อนเช่นนี้นอกจากจะน่าเบื่อแล้ว ยังเสี่ยงต่อการเกิดข้อผิดพลาดได้ง่าย และเรายังต้องคอยจำว่าต้องตามไปแก้ไขโค้ดในหลายๆ จุดเมื่อต้องการปรับปรุงตรรกะในอนาคต
เพื่อขจัดความซ้ำซ้อนนี้ เราสามารถสร้างนามธรรมขึ้นมา โดยการนิยามฟังก์ชันที่สามารถทำงานกับสไลซ์ของจำนวนเต็มใดๆ ที่ส่งเข้ามาเป็นพารามิเตอร์ วิธีนี้จะช่วยให้โค้ดของเราดูสะอาดตาขึ้น และเปิดโอกาสให้เราถ่ายทอดแนวคิดเรื่องการหาตัวเลขที่มากที่สุดในรายการออกมาในเชิงนามธรรมได้อย่างชัดเจน
ในลิสติ้ง 10-3 เราได้แยกโค้ดที่ใช้ค้นหาตัวเลขที่มากที่สุดออกมาเป็นฟังก์ชันชื่อ largest จากนั้นเราเรียกใช้ฟังก์ชันนี้เพื่อหาตัวเลขที่มากที่สุดจากรายการทั้งสองชุดในลิสติ้ง 10-2 นอกจากนี้เรายังสามารถนำฟังก์ชันนี้ไปใช้กับรายการของค่า i32 อื่นๆ ในอนาคตได้อย่างง่ายดาย
fn largest(list: &[i32]) -> &i32 {
let mut largest = &list[0];
for item in list {
if item > largest {
largest = item;
}
}
largest
}
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let result = largest(&number_list);
println!("The largest number is {result}");
assert_eq!(*result, 100);
let number_list = vec![102, 34, 6000, 89, 54, 2, 43, 8];
let result = largest(&number_list);
println!("The largest number is {result}");
assert_eq!(*result, 6000);
}ฟังก์ชัน largest มีพารามิเตอร์ชื่อ list ซึ่งทำหน้าที่เป็นตัวแทนของสไลซ์ของค่า i32 รูปธรรมใดๆ ที่เราส่งเข้ามา ส่งผลให้เมื่อเราเรียกใช้ฟังก์ชัน โค้ดจะทำงานบนค่าเฉพาะเจาะจงที่เราส่งเข้าไป
สรุปขั้นตอนที่เราใช้ในการปรับแก้โค้ดจากลิสติ้ง 10-2 มาเป็นลิสติ้ง 10-3 ได้ดังนี้:
- ระบุจุดที่มีโค้ดซ้ำซ้อน
- แยกโค้ดที่ซ้ำซ้อนนั้นออกมาใส่ไว้ในเนื้อหาของฟังก์ชัน พร้อมทั้งระบุพารามิเตอร์นำเข้าและค่าส่งกลับในลายเซ็นของฟังก์ชันให้ชัดเจน
- ปรับปรุงโค้ดเดิมทั้งสองจุดให้เปลี่ยนมาเรียกใช้ฟังก์ชันดังกล่าวแทน
ในขั้นตอนต่อไป เราจะนำกระบวนการเดียวกันนี้ไปปรับใช้ร่วมกับเจเนอริกเพื่อลดความซ้ำซ้อนของโค้ด ในทำนองเดียวกับที่เนื้อหาของฟังก์ชันสามารถทำงานกับ list ที่เป็นนามธรรมแทนค่าเฉพาะเจาะจงได้ เจเนอริกก็เปิดโอกาสให้โค้ดสามารถทำงานกับประเภทข้อมูลที่เป็นนามธรรมได้เช่นกัน
ตัวอย่างเช่น สมมติว่าเรามีสองฟังก์ชัน: ฟังก์ชันหนึ่งใช้ค้นหาค่าที่มากที่สุดในสไลซ์ของ i32 และอีกฟังก์ชันหนึ่งใช้ค้นหาค่าที่มากที่สุดในสไลซ์ของ char เราจะกำจัดความซ้ำซ้อนนั้นได้อย่างไร? มาค้นหาคำตอบกัน!
ชนิดข้อมูลเจเนอริก
ชนิดข้อมูลเจเนอริก
เราใช้เจเนอริก (generics) เพื่อสร้างนิยามสำหรับสิ่งต่างๆ เช่น ลายเซ็นฟังก์ชัน (function signatures) หรือ struct ซึ่งช่วยให้เราสามารถนำโครงสร้างเดียวกันไปใช้งานร่วมกับประเภทข้อมูลรูปธรรมที่หลากหลายได้ มาเริ่มต้นดูวิธีการนิยามฟังก์ชัน, struct, enum และเมธอดโดยใช้เจเนอริกกันก่อน จากนั้นเราจะมาพูดคุยกันว่าเจเนอริกส่งผลต่อประสิทธิภาพของโค้ดอย่างไรบ้าง
ในนิยามฟังก์ชัน
เมื่อนิยามฟังก์ชันที่ใช้งานเจเนอริก เราจะวางเจเนอริกไว้ในลายเซ็นของฟังก์ชัน ตรงตำแหน่งที่เรามักจะระบุประเภทข้อมูลของพารามิเตอร์และค่าส่งกลับ การทำเช่นนี้ช่วยให้โค้ดของเรามีความยืดหยุ่นสูงขึ้น สามารถรองรับการทำงานได้หลากหลายยิ่งขึ้นสำหรับผู้เรียกใช้ ขณะเดียวกันก็ช่วยป้องกันการเขียนโค้ดซ้ำซ้อนได้อย่างมีประสิทธิภาพ
ต่อเนื่องจากฟังก์ชัน largest ของเรา ในลิสติ้ง 10-4 แสดงฟังก์ชันสองตัวที่ต่างก็ทำหน้าที่ค้นหาค่าที่มากที่สุดในสไลซ์เหมือนกัน ซึ่งหลังจากนี้เราจะรวมฟังก์ชันทั้งสองเข้าด้วยกันเป็นฟังก์ชันเดียวที่ใช้เจเนอริก
fn largest_i32(list: &[i32]) -> &i32 {
let mut largest = &list[0];
for item in list {
if item > largest {
largest = item;
}
}
largest
}
fn largest_char(list: &[char]) -> &char {
let mut largest = &list[0];
for item in list {
if item > largest {
largest = item;
}
}
largest
}
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let result = largest_i32(&number_list);
println!("The largest number is {result}");
assert_eq!(*result, 100);
let char_list = vec!['y', 'm', 'a', 'q'];
let result = largest_char(&char_list);
println!("The largest char is {result}");
assert_eq!(*result, 'y');
}ฟังก์ชัน largest_i32 คือฟังก์ชันที่เราแยกออกมาในลิสติ้ง 10-3 ซึ่งค้นหาค่า i32 ที่มากที่สุดในสไลซ์ ส่วนฟังก์ชัน largest_char ใช้ค้นหาค่า char ที่มากที่สุดในสไลซ์ เนื้อหาของฟังก์ชันทั้งสองชุดนี้เหมือนกันทุกประการ ดังนั้นเรามาขจัดความซ้ำซ้อนโดยการใส่พารามิเตอร์ประเภทข้อมูล (type parameter) แบบเจเนอริกลงในฟังก์ชันเพียงฟังก์ชันเดียวกัน
ในการกำหนดพารามิเตอร์ให้กับประเภทข้อมูลในฟังก์ชันใหม่นี้ เราจำเป็นต้องตั้งชื่อให้กับพารามิเตอร์ประเภทข้อมูลนั้น เช่นเดียวกับที่เราตั้งชื่อให้กับพารามิเตอร์ค่าของฟังก์ชัน คุณสามารถใช้ชื่อระบุ (identifier) ใดๆ ก็ได้เป็นชื่อพารามิเตอร์ประเภทข้อมูล แต่เราจะใช้ T เพราะตามธรรมเนียมปฏิบัติแล้ว ชื่อพารามิเตอร์ประเภทข้อมูลใน Rust จะเป็นชื่อสั้นๆ มักนิยมใช้ตัวอักษรพิมพ์ใหญ่ตัวเดียวตามรูปแบบ UpperCamelCase โดย T ย่อมาจากคำว่า type และเป็นตัวเลือกเริ่มต้นที่ชาว Rust นิยมใช้กันมากที่สุด
เวลาที่เราใช้พารามิเตอร์ในเนื้อหาของฟังก์ชัน เราต้องประกาศชื่อพารามิเตอร์นั้นไว้ในลายเซ็นฟังก์ชันก่อนเพื่อให้คอมไพเลอร์เข้าใจว่าชื่อนั้นหมายถึงอะไร เช่นเดียวกัน เมื่อเราใช้ชื่อพารามิเตอร์ประเภทข้อมูลในลายเซ็นฟังก์ชัน เราก็ต้องประกาศชื่อพารามิเตอร์ประเภทข้อมูลนั้นไว้ก่อนที่จะนำไปใช้ ในการนิยามฟังก์ชัน largest ให้เป็นเจเนอริก เราจะใส่การประกาศชื่อประเภทไว้ภายในวงเล็บสามเหลี่ยม <> ระหว่างชื่อฟังก์ชันกับรายการพารามิเตอร์ ดังนี้:
fn largest<T>(list: &[T]) -> &T {เราอ่านนิยามนี้ได้ว่า: “ฟังก์ชัน largest เป็นเจเนอริกเหนือประเภท T ใดๆ” ฟังก์ชันนี้รับพารามิเตอร์หนึ่งตัวชื่อ list ซึ่งเป็นสไลซ์ของค่าประเภท T และฟังก์ชัน largest จะส่งคืนเรเฟอเรนซ์ที่ชี้ไปยังค่าประเภท T เดียวกันนั้นออกมา
ลิสติ้ง 10-5 แสดงนิยามของฟังก์ชัน largest ที่รวมทั้งสองฟังก์ชันเข้าด้วยกันโดยใช้ประเภทข้อมูลเจเนอริกในลายเซ็นของมัน พร้อมทั้งแสดงวิธีการเรียกใช้ฟังก์ชันด้วยสไลซ์ของค่า i32 หรือค่า char ทว่าโปรดสังเกตว่า โค้ดนี้จะยังคอมไพล์ไม่ผ่าน!
fn largest<T>(list: &[T]) -> &T {
let mut largest = &list[0];
for item in list {
if item > largest {
largest = item;
}
}
largest
}
fn main() {
let number_list = vec![34, 50, 25, 100, 65];
let result = largest(&number_list);
println!("The largest number is {result}");
let char_list = vec!['y', 'm', 'a', 'q'];
let result = largest(&char_list);
println!("The largest char is {result}");
}หากเราคอมไพล์โค้ดนี้ในตอนนี้ เราจะพบกับข้อผิดพลาดดังนี้:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0369]: binary operation `>` cannot be applied to type `&T`
--> src/main.rs:5:17
|
5 | if item > largest {
| ---- ^ ------- &T
| |
| &T
|
help: consider restricting type parameter `T` with trait `PartialOrd`
|
1 | fn largest<T: std::cmp::PartialOrd>(list: &[T]) -> &T {
| ++++++++++++++++++++++
For more information about this error, try `rustc --explain E0369`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
ข้อความแนะนำ (help note) ได้กล่าวถึง std::cmp::PartialOrd ซึ่งเป็น เทรต (trait) โดยเราจะมาเจาะลึกเรื่องเทรตกันในหัวข้อถัดไป แต่สำหรับตอนนี้ ให้เข้าใจก่อนว่าข้อผิดพลาดนี้ชี้แจงว่า เนื้อหาของฟังก์ชัน largest จะไม่สามารถทำงานได้กับทุกประเภทข้อมูลที่ T จะเป็นไปได้ เพราะในเนื้อหาฟังก์ชันเราต้องการเปรียบเทียบค่าประเภท T เราจึงใช้งานได้เฉพาะกับประเภทข้อมูลที่สามารถนำค่ามาเปรียบเทียบเรียงลำดับกันได้เท่านั้น และเพื่อเปิดใช้งานความสามารถในการเปรียบเทียบ ไลบรารีมาตรฐานจึงมีเทรต std::cmp::PartialOrd ที่คุณสามารถอิมพลีเมนต์ให้กับประเภทข้อมูลได้ (ดูรายละเอียดเพิ่มเติมเกี่ยวกับเทรตนี้ได้ในภาคผนวก C) หากเราปฏิบัติตามคำแนะนำของคอมไพเลอร์โดยจำกัดประเภทข้อมูลของ T ให้รับเฉพาะประเภทที่อิมพลีเมนต์ PartialOrd ตัวอย่างนี้ก็จะสามารถคอมไพล์ผ่านได้ทันที เพราะไลบรารีมาตรฐานได้อิมพลีเมนต์ PartialOrd ให้กับทั้ง i32 และ char ไว้เรียบร้อยแล้ว
ในนิยาม struct
เรายังสามารถนิยาม struct ให้ใช้พารามิเตอร์ประเภทข้อมูลแบบเจเนอริกในฟิลด์ต่างๆ ได้ โดยใช้ไวยากรณ์ <> ลิสติ้ง 10-6 นิยาม struct Point<T> เพื่อเก็บค่าพิกัด x และ y ของประเภทข้อมูลใดๆ ก็ได้
struct Point<T> {
x: T,
y: T,
}
fn main() {
let integer = Point { x: 5, y: 10 };
let float = Point { x: 1.0, y: 4.0 };
}ไวยากรณ์สำหรับการใช้เจเนอริกในนิยาม struct นั้นคล้ายคลึงกับที่ใช้ในนิยามฟังก์ชันมาก เริ่มต้นด้วยการประกาศชื่อพารามิเตอร์ประเภทข้อมูลไว้ในวงเล็บสามเหลี่ยมต่อท้ายชื่อ struct จากนั้นเราจึงนำประเภทเจเนอริกนั้นไปใช้ระบุในฟิลด์ของ struct ตรงจุดที่เรามักจะใส่ประเภทข้อมูลรูปธรรม
สังเกตว่า เนื่องด้วยเราใช้พารามิเตอร์เจเนอริกเพียงตัวเดียวในการนิยาม Point<T> นิยามนี้จึงระบุว่า struct Point<T> เป็นเจเนอริกเหนือประเภท T และฟิลด์ x กับ y จะต้องเป็นประเภทเดียวกัน ทั้งคู่ ไม่ว่าประเภทนั้นจะเป็นอะไรก็ตาม หากเราสร้างอินสแตนซ์ของ Point<T> ที่มีค่าคนละประเภทกัน ดังในลิสติ้ง 10-7 โค้ดของเราจะไม่สามารถคอมไพล์ผ่านได้
struct Point<T> {
x: T,
y: T,
}
fn main() {
let wont_work = Point { x: 5, y: 4.0 };
}ในตัวอย่างนี้ เมื่อเรากำหนดจำนวนเต็ม 5 ให้กับ x คอมไพเลอร์จะเข้าใจทันทีว่าประเภทเจเนอริก T ของอินสแตนซ์ Point<T> ตัวนี้คือจำนวนเต็ม ดังนั้นเมื่อเราระบุค่า 4.0 (ซึ่งเป็นเลขทศนิยม) ให้กับ y ที่ถูกนิยามไว้ว่าต้องเป็นประเภทเดียวกับ x เราจึงได้รับข้อผิดพลาดเรื่องประเภทข้อมูลไม่ตรงกันดังนี้:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0308]: mismatched types
--> src/main.rs:7:38
|
7 | let wont_work = Point { x: 5, y: 4.0 };
| ^^^ expected integer, found floating-point number
For more information about this error, try `rustc --explain E0308`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
หากต้องการนิยาม struct Point ให้ x และ y เป็นเจเนอริกที่สามารถมีประเภทข้อมูลต่างกันได้ เราสามารถใช้พารามิเตอร์ประเภทข้อมูลแบบเจเนอริกหลายตัวพร้อมกันได้ ตัวอย่างเช่น ในลิสติ้ง 10-8 เราได้ปรับนิยามของ Point ให้เป็นเจเนอริกเหนือประเภท T และ U โดยที่ x มีประเภทเป็น T และ y มีประเภทเป็น U
struct Point<T, U> {
x: T,
y: U,
}
fn main() {
let both_integer = Point { x: 5, y: 10 };
let both_float = Point { x: 1.0, y: 4.0 };
let integer_and_float = Point { x: 5, y: 4.0 };
}คราวนี้ อินสแตนซ์ทั้งหมดของ Point ที่แสดงในตัวอย่างก็จะสามารถใช้งานได้อย่างถูกต้องสมบูรณ์! คุณสามารถใส่พารามิเตอร์ประเภทข้อมูลแบบเจเนอริกได้มากเท่าที่ต้องการในหนึ่งนิยาม ทว่าการใช้เกินสองถึงสามตัวอาจทำให้โค้ดของคุณอ่านและทำความเข้าใจได้ยาก หากคุณพบว่าโค้ดจำเป็นต้องพึ่งพาประเภทเจเนอริกเป็นจำนวนมาก นั่นอาจเป็นสัญญาณบ่งบอกว่าคุณควรปรับโครงสร้างโค้ดใหม่โดยแยกย่อยออกเป็นส่วนๆ ให้เล็กลง
ในนิยาม enum
เช่นเดียวกับ struct เราสามารถนิยาม enum ให้เก็บประเภทข้อมูลแบบเจเนอริกไว้ภายในวาเรียนต์ต่างๆ ได้ มาย้อนดู enum Option<T> ของไลบรารีมาตรฐานที่เราเคยใช้กันในบทที่ 6 อีกครั้ง:
#![allow(unused)]
fn main() {
enum Option<T> {
Some(T),
None,
}
}ถึงตอนนี้ นิยามนี้น่าจะดูเข้าใจง่ายและชัดเจนขึ้นมากสำหรับคุณแล้ว ดังที่คุณเห็น enum Option<T> เป็นเจเนอริกเหนือประเภท T และมีสองวาเรียนต์ ได้แก่: Some ซึ่งบรรจุค่าหนึ่งค่าประเภท T และวาเรียนต์ None ซึ่งไม่บรรจุค่าใดๆ เลย การใช้ enum Option<T> ช่วยให้เราสามารถถ่ายทอดแนวคิดเชิงนามธรรมของค่าที่อาจมีหรือไม่มีก็ได้ และด้วยความที่ Option<T> เป็นเจเนอริก เราจึงสามารถนำนามธรรมนี้ไปประยุกต์ใช้ได้กับทุกประเภทข้อมูล ไม่ว่าค่านั้นจะเป็นประเภทใดก็ตาม
นอกจากนี้ enum ยังสามารถใช้ประเภทเจเนอริกหลายตัวพร้อมกันได้ด้วย ตัวอย่างเช่น นิยามของ enum Result ที่เราเพิ่งใช้งานกันในบทที่ 9:
#![allow(unused)]
fn main() {
enum Result<T, E> {
Ok(T),
Err(E),
}
}enum Result เป็นเจเนอริกเหนือสองประเภทข้อมูลคือ T และ E โดยมีสองวาเรียนต์ ได้แก่ Ok ซึ่งบรรจุค่าประเภท T และ Err ซึ่งบรรจุค่าประเภท E นิยามนี้ช่วยให้เราสามารถนำ enum Result ไปใช้งานได้อย่างสะดวกสบายในทุกที่ที่มีการดำเนินการซึ่งอาจสำเร็จ (ส่งคืนค่าประเภท T) หรืออาจล้มเหลว (ส่งคืนข้อผิดพลาดประเภท E) ซึ่งที่จริงนี่คือสิ่งที่เราใช้ในการเปิดไฟล์ในลิสติ้ง 9-3 โดย T ถูกแทนที่ด้วยประเภท std::fs::File เมื่อเปิดไฟล์สำเร็จ และ E ถูกแทนที่ด้วยประเภท std::io::Error เมื่อเกิดปัญหาในการเปิดไฟล์
เมื่อใดก็ตามที่คุณสังเกตเห็นว่า ในโค้ดของคุณมีนิยามของ struct หรือ enum หลายตัวที่แตกต่างกันเพียงแค่ประเภทของค่าที่บรรจุอยู่ภายใน คุณสามารถหลีกเลี่ยงการเขียนโค้ดซ้ำซ้อนได้ด้วยการหันมาใช้ประเภทเจเนอริกแทน
ในนิยามเมธอด
เราสามารถอิมพลีเมนต์เมธอดบน struct และ enum (ดังที่เราเคยทำในบทที่ 5) และนำประเภทเจเนอริกมาใช้ในนิยามของเมธอดเหล่านั้นได้ด้วยเช่นกัน ลิสติ้ง 10-9 แสดง struct Point<T> ที่เรานิยามไว้ในลิสติ้ง 10-6 พร้อมกับเมธอดชื่อ x ที่อิมพลีเมนต์ขึ้นสำหรับมัน
struct Point<T> {
x: T,
y: T,
}
impl<T> Point<T> {
fn x(&self) -> &T {
&self.x
}
}
fn main() {
let p = Point { x: 5, y: 10 };
println!("p.x = {}", p.x());
}ในตัวอย่างนี้ เราได้นิยามเมธอดชื่อ x บน Point<T> ซึ่งจะส่งคืนเรเฟอเรนซ์ที่ชี้ไปยังข้อมูลในฟิลด์ x
สังเกตว่าเราจำเป็นต้องประกาศ T ไว้หลัง impl เพื่อให้เราสามารถใช้ T ในการระบุว่าเรากำลังอิมพลีเมนต์เมธอดให้กับประเภท Point<T> การประกาศ T เป็นประเภทเจเนอริกหลัง impl ช่วยให้ Rust แยกแยะได้ว่าประเภทในวงเล็บสามเหลี่ยมของ Point นั้นเป็นประเภทเจเนอริก ไม่ใช่ประเภทรูปธรรม ที่จริงเราสามารถเลือกใช้ชื่อพารามิเตอร์เจเนอริกอื่นแทนชื่อเดียวกับที่ประกาศใน struct ก็ได้ แต่ตามธรรมเนียมปฏิบัตินิยมใช้ชื่อเดียวกัน เมธอดที่เขียนอยู่ภายในบล็อก impl ที่ประกาศประเภทเจเนอริกเช่นนี้จะพร้อมใช้งานบนทุกๆ อินสแตนซ์ของประเภทนั้นเสมอ ไม่ว่าประเภทรูปธรรมใดจะถูกนำมาแทนที่เจเนอริกในภายหลังก็ตาม
นอกจากนี้ เรายังสามารถระบุข้อจำกัดให้กับประเภทเจเนอริกในการนิยามเมธอดได้อีกด้วย ตัวอย่างเช่น เราสามารถเลือกอิมพลีเมนต์เมธอดเฉพาะบนอินสแตนซ์ของ Point<f32> เท่านั้น แทนที่จะอิมพลีเมนต์บนอินสแตนซ์ Point<T> ที่เป็นประเภทเจเนอริกใดๆ ในลิสติ้ง 10-10 เราเลือกใช้ประเภทรูปธรรม f32 โดยตรง ซึ่งหมายความว่าเราไม่จำเป็นต้องประกาศประเภทใดๆ หลัง impl เลย
struct Point<T> {
x: T,
y: T,
}
impl<T> Point<T> {
fn x(&self) -> &T {
&self.x
}
}
impl Point<f32> {
fn distance_from_origin(&self) -> f32 {
(self.x.powi(2) + self.y.powi(2)).sqrt()
}
}
fn main() {
let p = Point { x: 5, y: 10 };
println!("p.x = {}", p.x());
}โค้ดนี้หมายความว่า เฉพาะประเภท Point<f32> เท่านั้นที่จะมีเมธอด distance_from_origin ส่วนอินสแตนซ์อื่นๆ ของ Point<T> ที่ค่า T ไม่ใช่ f32 จะไม่มีเมธอดนี้ โดยเมธอดนี้ทำหน้าที่คำนวณระยะห่างระหว่างจุดของเรากับจุดพิกัด (0.0, 0.0) ซึ่งต้องอาศัยการคำนวณทางคณิตศาสตร์ที่มีให้ใช้เฉพาะกับประเภทตัวเลขทศนิยม (floating-point) เท่านั้น
พารามิเตอร์ประเภทข้อมูลแบบเจเนอริกในนิยามของ struct ไม่จำเป็นต้องเหมือนกับพารามิเตอร์เจเนอริกที่ใช้ในลายเซ็นเมธอดของ struct นั้นเสมอไป ในลิสติ้ง 10-11 เราใช้ประเภทเจเนอริก X1 และ Y1 สำหรับ struct Point และใช้ X2 กับ Y2 สำหรับลายเซ็นของเมธอด mixup เพื่อให้เห็นภาพตัวอย่างได้อย่างชัดเจน โดยเมธอดนี้จะสร้างอินสแตนซ์ Point ตัวใหม่ขึ้นมาจากการนำค่า x ของ self (ซึ่งเป็นประเภท X1) มารวมกับค่า y ของ Point ที่ส่งเข้ามาเป็นพารามิเตอร์ (ซึ่งเป็นประเภท Y2)
struct Point<X1, Y1> {
x: X1,
y: Y1,
}
impl<X1, Y1> Point<X1, Y1> {
fn mixup<X2, Y2>(self, other: Point<X2, Y2>) -> Point<X1, Y2> {
Point {
x: self.x,
y: other.y,
}
}
}
fn main() {
let p1 = Point { x: 5, y: 10.4 };
let p2 = Point { x: "Hello", y: 'c' };
let p3 = p1.mixup(p2);
println!("p3.x = {}, p3.y = {}", p3.x, p3.y);
}ในฟังก์ชัน main เราได้สร้าง Point ที่มีค่า x เป็น i32 (ค่า 5) และมีค่า y เป็น f64 (ค่า 10.4) ส่วนตัวแปร p2 เป็น struct Point ที่มีค่า x เป็นสตริงสไลซ์ (ค่า "Hello") และมีค่า y เป็น char (ค่า 'c') การเรียกเมธอด mixup บน p1 โดยส่ง p2 เข้าไปเป็นอาร์กิวเมนต์ จะทำให้เราได้ p3 ซึ่งมีค่า x เป็น i32 (เพราะ x มาจาก p1) และมีค่า y เป็น char (เพราะ y มาจาก p2) การเรียกใช้แมโคร println! จึงพิมพ์ผลลัพธ์ออกมาเป็น p3.x = 5, p3.y = c
จุดประสงค์ของตัวอย่างนี้คือ เพื่อแสดงให้เห็นถึงสถานการณ์ที่พารามิเตอร์เจเนอริกบางตัวถูกประกาศไว้ร่วมกับ impl ในขณะที่พารามิเตอร์เจเนอริกบางตัวถูกประกาศไว้เฉพาะในนิยามของเมธอด ในที่นี้พารามิเตอร์เจเนอริก X1 และ Y1 ถูกประกาศไว้หลัง impl เพราะพวกมันผูกอยู่กับนิยามของ struct ส่วนพารามิเตอร์เจเนอริก X2 และ Y2 ถูกประกาศไว้หลัง fn mixup เพราะพวกมันเกี่ยวข้องกับการทำงานของเมธอดนั้นเท่านั้น
ประสิทธิภาพของโค้ดที่ใช้เจเนอริก
คุณอาจกำลังสงสัยว่า การใช้พารามิเตอร์ประเภทข้อมูลแบบเจเนอริกจะมีผลต่อประสิทธิภาพการทำงานในตอนรันไทม์ (runtime cost) หรือไม่ ข่าวดีก็คือ การใช้งานประเภทเจเนอริกจะไม่ทำให้โปรแกรมของคุณทำงานช้าลงไปกว่าการเขียนด้วยประเภทรูปธรรมเลยแม้แต่น้อย
Rust สามารถทำเช่นนี้ได้โดยการใช้กระบวนการที่เรียกว่า โมโนมอร์ไฟเซชัน (monomorphization) กับโค้ดที่ใช้เจเนอริกตั้งแต่ตอนคอมไพล์ โดย โมโนมอร์ไฟเซชัน คือกระบวนการแปลงโค้ดที่เป็นเจเนอริกให้กลายเป็นโค้ดเฉพาะเจาะจง โดยการนำประเภทข้อมูลรูปธรรมที่มีการใช้งานจริงตอนคอมไพล์มาใส่แทนที่ ในขั้นตอนนี้ คอมไพเลอร์จะทำสิ่งตรงกันข้ามกับขั้นตอนที่เราเคยทำเพื่อสร้างฟังก์ชันเจเนอริกในลิสติ้ง 10-5: คอมไพเลอร์จะกวาดดูทุกจุดที่มีการเรียกใช้โค้ดเจเนอริก แล้วสร้างโค้ดชุดใหม่สำหรับประเภทรูปธรรมแต่ละประเภทที่มีการเรียกใช้ขึ้นมา
มาดูตัวอย่างการทำงานของกระบวนการนี้ผ่าน enum Option<T> ของไลบรารีมาตรฐานกัน:
#![allow(unused)]
fn main() {
let integer = Some(5);
let float = Some(5.0);
}เมื่อ Rust ทำการคอมไพล์โค้ดนี้ มันจะเริ่มกระบวนการโมโนมอร์ไฟเซชัน โดยคอมไพเลอร์จะอ่านค่าที่ถูกส่งเข้าไปในอินสแตนซ์ของ Option<T> แล้วระบุได้ว่ามี Option<T> อยู่สองประเภท: ประเภทแรกคือ i32 และอีกประเภทหนึ่งคือ f64 จากนั้นคอมไพเลอร์จะแตกนิยามเจเนอริกของ Option<T> ออกเป็นสองนิยามที่เจาะจงสำหรับ i32 และ f64 แล้วนำนิยามเฉพาะเจาะจงเหล่านี้ไปแทนที่นิยามเจเนอริกเดิม
โค้ดหลังผ่านกระบวนการโมโนมอร์ไฟเซชันจะมีหน้าตาประมาณนี้ (คอมไพเลอร์จริงจะใช้ชื่อที่ต่างไปจากนี้เล็กน้อย แต่เราจำลองชื่อขึ้นเพื่อให้เข้าใจง่าย):
enum Option_i32 {
Some(i32),
None,
}
enum Option_f64 {
Some(f64),
None,
}
fn main() {
let integer = Option_i32::Some(5);
let float = Option_f64::Some(5.0);
}ตัว Option<T> ที่เป็นเจเนอริกจะถูกแทนที่ด้วยนิยามเฉพาะเจาะจงที่คอมไพเลอร์สร้างขึ้น และด้วยความที่ Rust คอมไพล์โค้ดเจเนอริกให้กลายเป็นโค้ดที่ระบุประเภทชัดเจนในแต่ละอินสแตนซ์ เราจึงไม่ต้องเสียค่าใช้จ่ายด้านประสิทธิภาพใดๆ ตอนรันไทม์เลยจากการใช้เจเนอริก เมื่อโค้ดทำงาน มันจะมีประสิทธิภาพเทียบเท่ากับการที่เรามานั่งคัดลอกและเขียนนิยามของแต่ละประเภทข้อมูลด้วยตัวเองทุกประการ กระบวนการโมโนมอร์ไฟเซชันนี้เองที่ทำให้เจเนอริกของ Rust มีประสิทธิภาพสูงสุดในตอนรันไทม์
นิยามพฤติกรรมร่วมด้วยเทรต
นิยามพฤติกรรมร่วมด้วยเทรต
เทรต (trait) ทำหน้าที่กำหนดฟังก์ชันการทำงานที่ประเภทข้อมูลหนึ่งๆ มีและสามารถนำไปแบ่งปันให้กับประเภทข้อมูลอื่นๆ ได้ เราสามารถนำเทรตมาใช้ในการนิยามพฤติกรรมร่วม (shared behavior) ในเชิงนามธรรม และสามารถใช้ บาวด์ของเทรต (trait bounds) เพื่อระบุว่าประเภทข้อมูลแบบเจเนอริกจะเป็นประเภทใดก็ได้ที่มีพฤติกรรมตามที่กำหนด
หมายเหตุ: เทรตมีความคล้ายคลึงกับฟีเจอร์ที่ภาษาโปรแกรมอื่นๆ มักเรียกว่า อินเทอร์เฟซ (interface) แม้ว่าจะมีรายละเอียดปลีกย่อยที่แตกต่างกันอยู่บ้างก็ตาม
การนิยามเทรต
พฤติกรรมของประเภทข้อมูลประกอบไปด้วยเมธอดต่างๆ ที่เราสามารถเรียกใช้งานบนประเภทข้อมูลนั้นได้ และประเภทข้อมูลที่แตกต่างกันจะถือว่ามีพฤติกรรมร่วมกัน หากเราสามารถเรียกใช้เมธอดเดียวกันบนประเภทข้อมูลเหล่านั้นได้ทั้งหมด การนิยามเทรตจึงเป็นเสมือนการจัดกลุ่มลายเซ็นของเมธอด (method signatures) เข้าไว้ด้วยกัน เพื่อกำหนดชุดของพฤติกรรมที่จำเป็นต่อการบรรลุเป้าหมายอย่างใดอย่างหนึ่ง
ตัวอย่างเช่น สมมติว่าเรามี struct หลายตัวที่เก็บข้อความประเภทและปริมาณที่แตกต่างกัน: struct NewsArticle ใช้เก็บข่าวสารที่รายงานมาจากสถานที่ใดที่หนึ่ง และ SocialPost ใช้เก็บข้อความความยาวไม่เกิน 280 ตัวอักษร พร้อมกับข้อมูลเมทาดาตาที่ระบุว่าเป็นโพสต์ใหม่, รีโพสต์ หรือเป็นการตอบกลับโพสต์อื่น
เราต้องการสร้างเครตไลบรารีรวบรวมสื่อชื่อ aggregator ที่สามารถแสดงบทสรุปข้อมูลของสิ่งที่จัดเก็บอยู่ในอินสแตนซ์ของ NewsArticle หรือ SocialPost ได้ ในการทำเช่นนี้ เราจำเป็นต้องดึงบทสรุปออกมาจากแต่ละประเภทข้อมูล โดยการเรียกใช้เมธอด summarize บนอินสแตนซ์นั้นๆ ลิสติ้ง 10-12 แสดงการนิยามเทรตสาธารณะ (public trait) ชื่อ Summary ที่ทำหน้าที่กำหนดพฤติกรรมนี้
pub trait Summary {
fn summarize(&self) -> String;
}ในตัวอย่างนี้ เราประกาศเทรตโดยใช้คีย์เวิร์ด trait ตามด้วยชื่อของเทรต ซึ่งในที่นี้คือ Summary นอกจากนี้เรายังประกาศให้เทรตนี้เป็น pub เพื่อให้เครตอื่นที่นำเครตนี้ไปใช้เป็น dependency สามารถนำเทรตนี้ไปใช้งานต่อได้ด้วย ดังที่เราจะได้เห็นในตัวอย่างถัดไป ภายในวงเล็บปีกกา เราจะประกาศลายเซ็นของเมธอดที่อธิบายพฤติกรรมของประเภทข้อมูลที่อิมพลีเมนต์เทรตนี้ ซึ่งในที่นี้คือ fn summarize(&self) -> String
สังเกตว่าต่อท้ายลายเซ็นของเมธอด แทนที่เราจะใส่วงเล็บปีกกาเพื่อเขียนโค้ดการทำงาน เรากลับลงท้ายด้วยเครื่องหมายเซมิโคลอน (;) แทน นั่นเพราะประเภทข้อมูลแต่ละประเภทที่อิมพลีเมนต์เทรตนี้จะต้องเป็นผู้กำหนดพฤติกรรมเฉพาะของตนเองลงในเนื้อหาของเมธอด โดยคอมไพเลอร์จะคอยบังคับว่า ประเภทข้อมูลใดก็ตามที่ระบุว่าตนเองมีเทรต Summary จะต้องมีเมธอด summarize ที่มีลายเซ็นตรงตามนี้ทุกประการ
เทรตหนึ่งๆ สามารถบรรจุเมธอดไว้ภายในได้หลายเมธอด โดยระบุลายเซ็นของแต่ละเมธอดไว้บรรทัดละหนึ่งอัน และลงท้ายแต่ละบรรทัดด้วยเซมิโคลอน
การอิมพลีเมนต์เทรตบนชนิดข้อมูล
เมื่อเราได้นิยามลายเซ็นของเมธอดที่ต้องการในเทรต Summary เรียบร้อยแล้ว เราก็สามารถนำมันไปอิมพลีเมนต์ให้กับประเภทข้อมูลต่างๆ ในไลบรารีรวบรวมสื่อของเราได้ ลิสติ้ง 10-13 แสดงการอิมพลีเมนต์เทรต Summary ให้กับ struct NewsArticle โดยนำพาดหัวข่าว, ผู้เขียน และสถานที่มารวมกันเป็นข้อความสรุปของ summarize ส่วนสำหรับ struct SocialPost เรานิยาม summarize ให้ส่งคืนชื่อผู้ใช้ตามด้วยข้อความทั้งหมดของโพสต์ โดยถือว่าเนื้อหาของโพสต์ถูกจำกัดไว้ที่ไม่เกิน 280 ตัวอักษรอยู่แล้ว
pub trait Summary {
fn summarize(&self) -> String;
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {
fn summarize(&self) -> String {
format!("{}, by {} ({})", self.headline, self.author, self.location)
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}การอิมพลีเมนต์เทรตให้กับประเภทข้อมูลจะคล้ายคลึงกับการเขียนเมธอดทั่วไปเป็นส่วนใหญ่ จุดที่แตกต่างคือ หลังคำสั่ง impl เราจะระบุชื่อเทรตที่ต้องการอิมพลีเมนต์ ตามด้วยคีย์เวิร์ด for แล้วจึงตามด้วยชื่อของประเภทข้อมูลที่เราต้องการอิมพลีเมนต์เทรตให้ และภายในบล็อก impl เราจะใส่ลายเซ็นของเมธอดตามที่เทรตได้กำหนดไว้ แต่แทนที่จะลงท้ายด้วยเซมิโคลอน เราจะเปิดวงเล็บปีกกาแล้วเขียนเนื้อหาของเมธอดเพื่อกำหนดพฤติกรรมเฉพาะของประเภทข้อมูลนั้นๆ ลงไป
หลังจากที่ไลบรารีได้อิมพลีเมนต์เทรต Summary ให้กับ NewsArticle และ SocialPost เรียบร้อยแล้ว ผู้ใช้งานเครตนี้ก็จะสามารถเรียกใช้เมธอดของเทรตบนอินสแตนซ์ของ NewsArticle และ SocialPost ได้เฉกเช่นเดียวกับการเรียกใช้เมธอดทั่วไป ข้อแตกต่างเพียงอย่างเดียวคือ ผู้ใช้จำเป็นต้อง use ดึงตัวเทรตเข้าสู่ขอบเขต (scope) ร่วมกับประเภทข้อมูลด้วย นี่คือตัวอย่างการใช้งานเครตไลบรารี aggregator จากเครตไบนารีภายนอก:
use aggregator::{SocialPost, Summary};
fn main() {
let post = SocialPost {
username: String::from("horse_ebooks"),
content: String::from(
"of course, as you probably already know, people",
),
reply: false,
repost: false,
};
println!("1 new post: {}", post.summarize());
}โค้ดนี้จะพิมพ์ 1 new post: horse_ebooks: of course, as you probably already know, people ออกมา
เครตอื่นๆ ที่ดึงเครต aggregator ไปเป็น dependency ก็สามารถนำเทรต Summary เข้าสู่สโคปเพื่อนำไปอิมพลีเมนต์ให้กับประเภทข้อมูลของพวกเขาเองได้เช่นกัน แต่มีข้อจำกัดสำคัญประการหนึ่งที่ต้องรู้ นั่นคือ เราจะสามารถอิมพลีเมนต์เทรตให้กับประเภทข้อมูลใดๆ ได้ก็ต่อเมื่อ เทรต หรือ ประเภทข้อมูลนั้น (อย่างใดอย่างหนึ่ง หรือทั้งคู่) ต้องเป็นของเครตเราเอง (local) ตัวอย่างเช่น เราสามารถอิมพลีเมนต์เทรตของไลบรารีมาตรฐานอย่าง Display ให้กับประเภทข้อมูลที่เราสร้างขึ้นเองอย่าง SocialPost ได้ เพราะ SocialPost เป็นประเภทข้อมูลที่อยู่ในเครต aggregator ของเรา หรือในทางกลับกัน เราก็สามารถอิมพลีเมนต์ Summary ให้กับ Vec<T> ในเครต aggregator ของเราได้ เพราะเทรต Summary เป็นของเครตเรา
ทว่า เราไม่สามารถอิมพลีเมนต์เทรตภายนอกให้กับประเภทข้อมูลภายนอกได้ เช่น เราไม่สามารถอิมพลีเมนต์เทรต Display ให้กับ Vec<T> ภายในเครต aggregator ของเราได้ เพราะทั้ง Display และ Vec<T> ต่างก็ถูกนิยามขึ้นในไลบรารีมาตรฐาน และไม่ได้เป็นของเครต aggregator เลย ข้อจำกัดนี้เป็นส่วนหนึ่งของคุณสมบัติที่เรียกว่า ความสอดคล้อง (coherence) หรือที่รู้จักกันอย่างเจาะจงว่า กฎเด็กกำพร้า (orphan rule) ซึ่งตั้งชื่อตามลักษณะที่ประเภทข้อมูลต้นกำเนิดไม่ได้อยู่ร่วมด้วย กฎนี้ช่วยรับประกันได้ว่า โค้ดของคนอื่นจะไม่สามารถทำให้โค้ดของคุณพัง และโค้ดของคุณก็จะไม่ไปทำให้โค้ดของคนอื่นพังเช่นกัน เพราะหากไม่มีกฎนี้ เครตสองเครตอาจจะต่างคนต่างอิมพลีเมนต์เทรตเดียวกันให้กับประเภทข้อมูลเดียวกัน จนทำให้ Rust สับสนและไม่รู้ว่าจะเลือกใช้การอิมพลีเมนต์ของใคร
การใช้การอิมพลีเมนต์ค่าเริ่มต้น
ในบางสถานการณ์ การกำหนดพฤติกรรมเริ่มต้น (default behavior) ให้กับบางเมธอดหรือทุกเมธอดในเทรตก็มีประโยชน์อย่างมาก แทนที่จะต้องบังคับให้ทุกประเภทข้อมูลต้องมานั่งเขียนโค้ดอิมพลีเมนต์ทุกเมธอดใหม่ทั้งหมด จากนั้นเมื่อเรานำเทรตไปอิมพลีเมนต์ให้กับประเภทข้อมูลใด เราจะเลือกคงพฤติกรรมเริ่มต้นนั้นไว้ หรือจะเขียนทับ (override) พฤติกรรมเริ่มต้นของแต่ละเมธอดก็ได้
ในลิสติ้ง 10-14 เราได้กำหนดข้อความเริ่มต้นให้กับเมธอด summarize ของเทรต Summary แทนที่จะปล่อยว่างไว้เฉพาะลายเซ็นของเมธอดเหมือนในลิสติ้ง 10-12
pub trait Summary {
fn summarize(&self) -> String {
String::from("(Read more...)")
}
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}หากต้องการใช้พฤติกรรมเริ่มต้นเพื่อสรุปข้อมูลของอินสแตนซ์ NewsArticle เราเพียงแค่ระบุบล็อก impl ว่างๆ ไว้ว่า impl Summary for NewsArticle {}
แม้ว่าเราจะไม่ได้เขียนเนื้อหาของเมธอด summarize ลงใน NewsArticle โดยตรงอีกต่อไป แต่เนื่องจากเราได้จัดเตรียมการอิมพลีเมนต์ค่าเริ่มต้นไว้แล้ว และได้ประกาศว่า NewsArticle อิมพลีเมนต์เทรต Summary ผลลัพธ์คือเราจึงยังสามารถเรียกใช้เมธอด summarize บนอินสแตนซ์ของ NewsArticle ได้ตามปกติ ดังนี้:
use aggregator::{self, NewsArticle, Summary};
fn main() {
let article = NewsArticle {
headline: String::from("Penguins win the Stanley Cup Championship!"),
location: String::from("Pittsburgh, PA, USA"),
author: String::from("Iceburgh"),
content: String::from(
"The Pittsburgh Penguins once again are the best \
hockey team in the NHL.",
),
};
println!("New article available! {}", article.summarize());
}โค้ดนี้จะพิมพ์ New article available! (Read more...) ออกมา
การสร้างการอิมพลีเมนต์ค่าเริ่มต้นนี้ ไม่ได้ส่งผลให้เราต้องไปแก้ไขโค้ดการอิมพลีเมนต์ของ Summary บน SocialPost ในลิสติ้ง 10-13 แต่อย่างใด เนื่องจากไวยากรณ์ในการเขียนทับการอิมพลีเมนต์ค่าเริ่มต้นนั้นเหมือนกับไวยากรณ์ในการอิมพลีเมนต์เมธอดของเทรตที่ไม่มีค่าเริ่มต้นทุกประการ
นอกจากนี้ การอิมพลีเมนต์ค่าเริ่มต้นยังสามารถเรียกใช้เมธอดอื่นๆ ภายในเทรตเดียวกันได้ด้วย แม้ว่าเมธอดอื่นๆ เหล่านั้นจะไม่มีการอิมพลีเมนต์ค่าเริ่มต้นก็ตาม ด้วยวิธีนี้ เทรตจะสามารถมอบความสามารถที่มีประโยชน์มากมายได้ โดยต้องการให้ผู้อิมพลีเมนต์เขียนโค้ดเพิ่มเพียงแค่ส่วนเล็กๆ เท่านั้น ตัวอย่างเช่น เราสามารถนิยามเทรต Summary ให้มีเมธอด summarize_author ที่บังคับให้ต้องอิมพลีเมนต์เอง แล้วนิยามเมธอด summarize ที่มีการอิมพลีเมนต์ค่าเริ่มต้นซึ่งเรียกใช้ summarize_author อีกทอดหนึ่ง:
pub trait Summary {
fn summarize_author(&self) -> String;
fn summarize(&self) -> String {
format!("(Read more from {}...)", self.summarize_author())
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize_author(&self) -> String {
format!("@{}", self.username)
}
}เมื่อต้องการใช้งาน Summary เวอร์ชันนี้ เราจึงจำเป็นต้องนิยามเฉพาะเมธอด summarize_author เท่านั้นเมื่ออิมพลีเมนต์เทรตให้กับประเภทข้อมูล:
pub trait Summary {
fn summarize_author(&self) -> String;
fn summarize(&self) -> String {
format!("(Read more from {}...)", self.summarize_author())
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize_author(&self) -> String {
format!("@{}", self.username)
}
}หลังจากที่เรานิยาม summarize_author เสร็จแล้ว เราก็สามารถเรียกใช้ summarize บนอินสแตนซ์ของ struct SocialPost ได้ทันที โดยการอิมพลีเมนต์ค่าเริ่มต้นของ summarize จะไปเรียกการทำงานของ summarize_author ที่เราเขียนไว้ให้เองโดยอัตโนมัติ และเพราะเราได้อิมพลีเมนต์ summarize_author ไปแล้ว เทรต Summary จึงมอบความสามารถของเมธอด summarize ให้เราใช้งานได้ทันทีโดยไม่ต้องเขียนโค้ดเพิ่มเติม นี่คือตัวอย่างการเรียกใช้งาน:
use aggregator::{self, SocialPost, Summary};
fn main() {
let post = SocialPost {
username: String::from("horse_ebooks"),
content: String::from(
"of course, as you probably already know, people",
),
reply: false,
repost: false,
};
println!("1 new post: {}", post.summarize());
}โค้ดนี้จะพิมพ์ 1 new post: (Read more from @horse_ebooks...) ออกมา
ข้อควรจำคือ เราไม่สามารถเรียกใช้การอิมพลีเมนต์ค่าเริ่มต้นจากภายในเมธอดที่เขียนทับการอิมพลีเมนต์นั้นได้
การใช้เทรตเป็นพารามิเตอร์
เมื่อคุณได้เรียนรู้วิธีการนิยามและอิมพลีเมนต์เทรตแล้ว เรามาดูวิธีการนำเทรตไปใช้เพื่อนิยามฟังก์ชันที่สามารถเปิดรับประเภทข้อมูลที่หลากหลายกันต่อ เราจะนำเทรต Summary ที่เราอิมพลีเมนต์ให้กับประเภท NewsArticle และ SocialPost ในลิสติ้ง 10-13 มาใช้ในการนิยามฟังก์ชัน notify ซึ่งจะเรียกใช้เมธอด summarize บนพารามิเตอร์ item ที่เป็นประเภทข้อมูลใดๆ ก็ตามที่อิมพลีเมนต์เทรต Summary ในการทำเช่นนี้ เราจะใช้ไวยากรณ์ impl Trait ดังนี้:
pub trait Summary {
fn summarize(&self) -> String;
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {
fn summarize(&self) -> String {
format!("{}, by {} ({})", self.headline, self.author, self.location)
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}
pub fn notify(item: &impl Summary) {
println!("Breaking news! {}", item.summarize());
}แทนที่จะระบุประเภทข้อมูลรูปธรรมให้กับพารามิเตอร์ item เรากลับใส่คีย์เวิร์ด impl ตามด้วยชื่อเทรต ซึ่งพารามิเตอร์นี้จะยอมรับประเภทข้อมูลใดก็ได้ที่อิมพลีเมนต์เทรตที่ระบุไว้ และภายในเนื้อหาของฟังก์ชัน notify เราจะสามารถเรียกใช้เมธอดใดๆ บน item ที่มาจากเทรต Summary ได้ เช่น summarize ทำให้เราสามารถเรียกใช้ notify โดยส่งอินสแตนซ์ของ NewsArticle หรือ SocialPost เข้ามาได้อย่างอิสระ แต่หากโค้ดใดพยายามเรียกฟังก์ชันนี้ด้วยประเภทข้อมูลอื่น เช่น String หรือ i32 โค้ดนั้นจะไม่สามารถคอมไพล์ผ่านได้ เพราะประเภทเหล่านั้นไม่ได้อิมพลีเมนต์เทรต Summary
ไวยากรณ์บาวด์ของเทรต
ไวยากรณ์ impl Trait นั้นเหมาะกับกรณีที่ตรงไปตรงมา แต่ในความเป็นจริงแล้ว มันคือไวยากรณ์แบบย่อ (syntax sugar) ของรูปแบบที่ยาวกว่าซึ่งเรียกว่า บาวด์ของเทรต (trait bound) โดยมีหน้าตาดังนี้:
pub fn notify<T: Summary>(item: &T) {
println!("Breaking news! {}", item.summarize());
}รูปแบบที่ยาวกว่านี้ให้ผลลัพธ์เทียบเท่ากับตัวอย่างในหัวข้อก่อนหน้าทุกประการ เพียงแต่มีความยาวกว่า โดยเราจะวางบาวด์ของเทรตไว้ร่วมกับการประกาศพารามิเตอร์ประเภทข้อมูลเจเนอริก ต่อท้ายเครื่องหมายโคลอน (:) ภายในวงเล็บสามเหลี่ยม
ไวยากรณ์ impl Trait ให้ความสะดวกและช่วยให้โค้ดดูกระชับในกรณีง่ายๆ ทว่าไวยากรณ์บาวด์ของเทรตแบบเต็มรูปจะสามารถแสดงความซับซ้อนได้มากกว่าในกรณีอื่นๆ ตัวอย่างเช่น สมมติว่าเรามีสองพารามิเตอร์ที่อิมพลีเมนต์เทรต Summary หากเขียนด้วยไวยากรณ์ impl Trait จะเป็นดังนี้:
pub fn notify(item1: &impl Summary, item2: &impl Summary) {การใช้ impl Trait เช่นนี้เหมาะสมหากเราต้องการให้ฟังก์ชันเปิดให้ item1 และ item2 เป็นประเภทข้อมูลที่ต่างกันได้ (ตราบใดที่ทั้งคู่ต่างก็อิมพลีเมนต์ Summary) แต่หากเราต้องการบังคับให้พารามิเตอร์ทั้งสองต้องเป็นประเภทข้อมูลเดียวกันเสมอ เราจำเป็นต้องใช้บาวด์ของเทรต ดังนี้:
pub fn notify<T: Summary>(item1: &T, item2: &T) {การระบุประเภทเจเนอริก T ให้เป็นประเภทของทั้งพารามิเตอร์ item1 และ item2 จะเป็นการกำหนดข้อจำกัดให้กับฟังก์ชันว่า ค่ารูปธรรมที่ส่งเข้ามาเป็นอาร์กิวเมนต์ของ item1 และ item2 จะต้องเป็นประเภทเดียวกันเท่านั้น
บาวด์ของเทรตหลายตัวด้วยไวยากรณ์ +
เรายังสามารถกำหนดบาวด์ของเทรตมากกว่าหนึ่งตัวได้ด้วย สมมติว่าเราต้องการให้ฟังก์ชัน notify สามารถแสดงผลด้วย {} ไปพร้อมๆ กับการเรียกใช้ summarize บน item: เราก็สามารถระบุในนิยามของ notify ได้ว่า item จะต้องอิมพลีเมนต์ทั้งเทรต Display และ Summary โดยใช้ไวยากรณ์เครื่องหมายบวก + ดังนี้:
pub fn notify(item: &(impl Summary + Display)) {ไวยากรณ์ + นี้ยังสามารถนำไปใช้กับบาวด์ของเทรตบนประเภทเจเนอริกได้เช่นกัน:
pub fn notify<T: Summary + Display>(item: &T) {เมื่อกำหนดบาวด์ของเทรตทั้งสองตัวเรียบร้อยแล้ว เนื้อหาของฟังก์ชัน notify ก็จะสามารถเรียกใช้ summarize และใช้ {} เพื่อจัดรูปแบบการแสดงผลของ item ได้อย่างถูกต้อง
บาวด์ของเทรตที่ชัดเจนขึ้นด้วยอนุประโยค where
การใส่บาวด์ของเทรตมากเกินไปก็มีข้อเสีย เนื่องจากเจเนอริกแต่ละตัวต่างมีบาวด์ของตนเอง ฟังก์ชันที่มีพารามิเตอร์ประเภทข้อมูลเจเนอริกหลายตัวจึงอาจเต็มไปด้วยข้อกำหนดบาวด์ของเทรตที่อัดแน่นอยู่ระหว่างชื่อฟังก์ชันกับรายการพารามิเตอร์ ซึ่งทำให้ลายเซ็นฟังก์ชันอ่านยากมาก ด้วยเหตุนี้ Rust จึงมีไวยากรณ์ทางเลือกสำหรับระบุบาวด์ของเทรตไว้ภายในอนุประโยค (clause) where หลังลายเซ็นฟังก์ชัน ดังนั้นแทนที่จะเขียนแบบนี้:
fn some_function<T: Display + Clone, U: Clone + Debug>(t: &T, u: &U) -> i32 {เราสามารถเปลี่ยนมาใช้อนุประโยค where ได้ดังนี้:
fn some_function<T, U>(t: &T, u: &U) -> i32
where
T: Display + Clone,
U: Clone + Debug,
{
unimplemented!()
}ลายเซ็นของฟังก์ชันนี้จะดูสะอาดตาและเป็นระเบียบขึ้นมาก: ชื่อฟังก์ชัน, รายการพารามิเตอร์ และประเภทส่งกลับจะอยู่ติดกัน คล้ายกับฟังก์ชันทั่วไปที่ไม่ได้มีบาวด์ของเทรตมากมายมารบกวนสายตา
การคืนชนิดข้อมูลที่อิมพลีเมนต์เทรต
เรายังสามารถนำไวยากรณ์ impl Trait ไปใช้ในตำแหน่งของค่าส่งกลับ เพื่อส่งคืนค่าของประเภทข้อมูลใดๆ ที่อิมพลีเมนต์เทรตนั้นได้ด้วย ดังแสดงในตัวอย่างนี้:
pub trait Summary {
fn summarize(&self) -> String;
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {
fn summarize(&self) -> String {
format!("{}, by {} ({})", self.headline, self.author, self.location)
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}
fn returns_summarizable() -> impl Summary {
SocialPost {
username: String::from("horse_ebooks"),
content: String::from(
"of course, as you probably already know, people",
),
reply: false,
repost: false,
}
}การระบุ impl Summary เป็นประเภทส่งกลับ เป็นการประกาศว่าฟังก์ชัน returns_summarizable จะส่งคืนค่าของประเภทข้อมูลบางประเภทที่อิมพลีเมนต์เทรต Summary โดยที่เราไม่จำเป็นต้องระบุชื่อประเภทรูปธรรมที่แท้จริง ในกรณีนี้ ฟังก์ชัน returns_summarizable ส่งคืนค่า SocialPost ออกมา แต่โค้ดภายนอกที่เรียกใช้ฟังก์ชันนี้ไม่จำเป็นต้องรู้ถึงรายละเอียดนั้นเลย
ความสามารถในการระบุประเภทส่งกลับด้วยเทรตที่มันอิมพลีเมนต์เพียงอย่างเดียวนั้น มีประโยชน์อย่างยิ่งเมื่อใช้งานร่วมกับโคลเชอร์ (closures) และตัววนซ้ำ (iterators) ซึ่งเราจะกล่าวถึงในบทที่ 13 เนื่องจากโคลเชอร์และตัววนซ้ำมักสร้างประเภทข้อมูลที่มีเพียงคอมไพเลอร์เท่านั้นที่รู้จัก หรือเป็นประเภทข้อมูลที่มีชื่อยาวเหยียดจนเขียนระบุได้ยาก ไวยากรณ์ impl Trait จึงช่วยให้คุณระบุได้อย่างกระชับว่าฟังก์ชันจะส่งคืนประเภทข้อมูลที่อิมพลีเมนต์เทรต Iterator ออกมา โดยไม่ต้องมานั่งพิมพ์ชื่อประเภทข้อมูลที่ยาวเป็นหางว่าว
อย่างไรก็ตาม คุณจะสามารถใช้ impl Trait ได้ก็ต่อเมื่อฟังก์ชันนั้นส่งคืนประเภทข้อมูลเพียงประเภทเดียวเท่านั้น ตัวอย่างเช่น โค้ดที่พยายามส่งคืนค่าไม่เป็น NewsArticle ก็เป็น SocialPost โดยระบุประเภทส่งกลับเป็น impl Summary แบบนี้จะใช้งานไม่ได้:
pub trait Summary {
fn summarize(&self) -> String;
}
pub struct NewsArticle {
pub headline: String,
pub location: String,
pub author: String,
pub content: String,
}
impl Summary for NewsArticle {
fn summarize(&self) -> String {
format!("{}, by {} ({})", self.headline, self.author, self.location)
}
}
pub struct SocialPost {
pub username: String,
pub content: String,
pub reply: bool,
pub repost: bool,
}
impl Summary for SocialPost {
fn summarize(&self) -> String {
format!("{}: {}", self.username, self.content)
}
}
fn returns_summarizable(switch: bool) -> impl Summary {
if switch {
NewsArticle {
headline: String::from(
"Penguins win the Stanley Cup Championship!",
),
location: String::from("Pittsburgh, PA, USA"),
author: String::from("Iceburgh"),
content: String::from(
"The Pittsburgh Penguins once again are the best \
hockey team in the NHL.",
),
}
} else {
SocialPost {
username: String::from("horse_ebooks"),
content: String::from(
"of course, as you probably already know, people",
),
reply: false,
repost: false,
}
}
}การส่งคืนค่าที่ไม่แน่นอนระหว่าง NewsArticle หรือ SocialPost นั้นไม่ได้รับอนุญาตเนื่องจากข้อจำกัดในการอิมพลีเมนต์ไวยากรณ์ impl Trait ภายในคอมไพเลอร์ ซึ่งเราจะอธิบายวิธีการเขียนฟังก์ชันที่มีพฤติกรรมในลักษณะนี้ในหัวข้อ “การใช้เทรตออบเจกต์เพื่อนามธรรมพฤติกรรมร่วม” ในบทที่ 18
การใช้บาวด์ของเทรตเพื่ออิมพลีเมนต์เมธอดแบบมีเงื่อนไข
การนำบาวด์ของเทรตมาใช้ร่วมกับบล็อก impl ที่ใช้พารามิเตอร์ประเภทข้อมูลเจเนอริก จะช่วยให้เราสามารถอิมพลีเมนต์เมธอดแบบมีเงื่อนไข (conditionally) ให้กับประเภทข้อมูลที่อิมพลีเมนต์เทรตตามที่ระบุไว้ได้ ตัวอย่างเช่น ประเภท Pair<T> ในลิสติ้ง 10-15 จะอิมพลีเมนต์ฟังก์ชัน new เพื่อส่งคืนอินสแตนซ์ใหม่ของ Pair<T> เสมอ (จำได้ไหมจากหัวข้อ “วากยสัมพันธ์ของเมธอด” ในบทที่ 5 ว่า Self เป็นนามแฝงประเภทข้อมูลของบล็อก impl ซึ่งในที่นี้คือ Pair<T>) ทว่าในบล็อก impl ถัดมา Pair<T> จะอิมพลีเมนต์เมธอด cmp_display ก็ต่อเมื่อประเภทข้อมูลภายใน T ของมันอิมพลีเมนต์ทั้งเทรต PartialOrd ที่เปิดใช้งานการเปรียบเทียบ และ เทรต Display ที่เปิดใช้งานการพิมพ์ผลลัพธ์เท่านั้น
use std::fmt::Display;
struct Pair<T> {
x: T,
y: T,
}
impl<T> Pair<T> {
fn new(x: T, y: T) -> Self {
Self { x, y }
}
}
impl<T: Display + PartialOrd> Pair<T> {
fn cmp_display(&self) {
if self.x >= self.y {
println!("The largest member is x = {}", self.x);
} else {
println!("The largest member is y = {}", self.y);
}
}
}ยิ่งไปกว่านั้น เรายังสามารถอิมพลีเมนต์เทรตแบบมีเงื่อนไขให้กับประเภทข้อมูลใดๆ ก็ตามที่อิมพลีเมนต์เทรตอื่นอยู่แล้วได้ด้วย การอิมพลีเมนต์เทรตให้กับประเภทข้อมูลใดก็ตามที่ผ่านเงื่อนไขของบาวด์ของเทรตเช่นนี้ เรียกว่า การอิมพลีเมนต์แบบครอบคลุม (blanket implementation) ซึ่งถูกนำมาใช้อย่างแพร่หลายในไลบรารีมาตรฐานของ Rust ตัวอย่างเช่น ไลบรารีมาตรฐานจะอิมพลีเมนต์เทรต ToString ให้กับทุกประเภทข้อมูลที่อิมพลีเมนต์เทรต Display โดยบล็อก impl ในไลบรารีมาตรฐานจะมีหน้าตาคล้ายกับโค้ดนี้:
impl<T: Display> ToString for T {
// --snip--
}และด้วยความที่ไลบรารีมาตรฐานมีการอิมพลีเมนต์แบบครอบคลุมเช่นนี้ เราจึงสามารถเรียกใช้เมธอด to_string ของเทรต ToString บนทุกประเภทข้อมูลที่อิมพลีเมนต์เทรต Display ได้ทันที ตัวอย่างเช่น เราสามารถแปลงจำนวนเต็มให้กลายเป็นค่า String ได้ดังนี้ เพราะประเภทจำนวนเต็มได้อิมพลีเมนต์ Display ไว้แล้ว:
#![allow(unused)]
fn main() {
let s = 3.to_string();
}การอิมพลีเมนต์แบบครอบคลุมนี้จะปรากฏให้เห็นในเอกสารประกอบของเทรตภายใต้หัวข้อ “Implementors”
เทรตและบาวด์ของเทรตช่วยให้เราสามารถเขียนโค้ดที่ใช้พารามิเตอร์ประเภทข้อมูลเจเนอริกเพื่อลดความซ้ำซ้อน ขณะเดียวกันก็ยังสามารถระบุให้คอมไพเลอร์ทราบได้อย่างแม่นยำว่าเราต้องการให้ประเภทเจเนอริกนั้นมีพฤติกรรมอย่างไร ซึ่งคอมไพเลอร์จะนำข้อมูลบาวด์ของเทรตนี้ไปตรวจสอบว่าประเภทข้อมูลรูปธรรมทั้งหมดที่นำมาใช้กับโค้ดของเรามีพฤติกรรมที่ถูกต้องครบถ้วนหรือไม่ ในภาษาแบบไดนามิก (dynamically typed languages) เราอาจต้องเผชิญกับข้อผิดพลาดในตอนรันไทม์หากเราเผลอเรียกใช้เมธอดบนประเภทข้อมูลที่ไม่ได้นิยามเมธอดนั้นไว้ แต่ Rust ได้เลื่อนการตรวจสอบข้อผิดพลาดเหล่านี้มาไว้ตั้งแต่ตอนคอมไพล์ เพื่อบังคับให้เราแก้ไขปัญหาให้เรียบร้อยตั้งแต่ก่อนที่โค้ดจะสามารถรันได้ด้วยซ้ำ นอกจากนี้ เรายังไม่ต้องเสียเวลาเขียนโค้ดเพื่อตรวจสอบพฤติกรรมในตอนรันไทม์อีก เพราะคอมไพเลอร์ได้ตรวจสอบให้เรียบร้อยแล้ว ซึ่งช่วยเพิ่มประสิทธิภาพการทำงานให้สูงสุดโดยไม่ต้องสูญเสียความยืดหยุ่นของเจเนอริกไปเลย
ตรวจสอบความถูกต้องของเรเฟอเรนซ์ด้วยไลฟ์ไทม์
การตรวจสอบความถูกต้องของเรเฟอเรนซ์ด้วยไลฟ์ไทม์
ไลฟ์ไทม์ (lifetime) เป็นเจเนอริกอีกรูปแบบหนึ่งที่เราเคยใช้งานกันมาแล้ว แต่แทนที่จะเป็นการรับประกันว่าชนิดข้อมูลจะมีพฤติกรรมตามที่เราต้องการ ไลฟ์ไทม์จะช่วยรับประกันว่าเรเฟอเรนซ์ (reference) จะยังคงถูกต้องและใช้งานได้ตราบเท่าที่เรายังจำเป็นต้องใช้มัน
รายละเอียดอย่างหนึ่งที่เรายังไม่ได้พูดถึงในหัวข้อ“เรเฟอเรนซ์และการยืม” ในบทที่ 4 ก็คือ ทุกเรเฟอเรนซ์ใน Rust ต่างก็มีไลฟ์ไทม์ ซึ่งก็คือขอบเขต (scope) ที่เรเฟอเรนซ์นั้นสามารถใช้งานได้อย่างถูกต้อง โดยส่วนใหญ่แล้ว ไลฟ์ไทม์จะถูกอนุมาน (infer) ขึ้นมาโดยปริยาย เช่นเดียวกับชนิดข้อมูลที่คอมไพเลอร์มักอนุมานให้เอง เราจำเป็นต้องระบุชนิดข้อมูลกำกับไว้เฉพาะเมื่อมีชนิดข้อมูลที่เป็นไปได้หลายแบบเท่านั้น ในทำนองเดียวกัน เราต้องระบุไลฟ์ไทม์เมื่อความสัมพันธ์ระหว่างไลฟ์ไทม์ของเรเฟอเรนซ์ต่างๆ อาจเป็นไปได้หลายรูปแบบ Rust กำหนดให้เราระบุความสัมพันธ์เหล่านั้นด้วยพารามิเตอร์ไลฟ์ไทม์แบบเจเนอริก (generic lifetime parameters) เพื่อให้มั่นใจได้ว่าเรเฟอเรนซ์จริงที่ใช้งานตอนรันไทม์จะยังคงถูกต้องและใช้งานได้อย่างแน่นอน
การระบุไลฟ์ไทม์ (lifetime annotation) เป็นแนวคิดที่ภาษาโปรแกรมส่วนใหญ่ไม่มีด้วยซ้ำ จึงอาจทำให้คุณรู้สึกไม่คุ้นเคยอยู่บ้าง แม้ว่าในบทนี้เราจะไม่ได้ครอบคลุมเรื่องไลฟ์ไทม์อย่างครบถ้วนทุกแง่มุม แต่เราจะอธิบายรูปแบบวากยสัมพันธ์ของไลฟ์ไทม์ที่คุณมักพบเจอบ่อยๆ เพื่อให้คุณเริ่มคุ้นเคยกับแนวคิดนี้
เรเฟอเรนซ์ที่ชี้ไปยังหน่วยความจำที่ถูกคืนแล้ว
เป้าหมายหลักของไลฟ์ไทม์คือการป้องกัน dangling reference (เรเฟอเรนซ์ที่ชี้ไปยังข้อมูลที่ถูกคืนหน่วยความจำไปแล้ว) ซึ่งหากยอมให้เกิดขึ้นได้ ก็จะทำให้โปรแกรมไปอ้างอิงข้อมูลอื่นที่ไม่ใช่ข้อมูลที่ตั้งใจไว้ ลองพิจารณาโปรแกรมในลิสติ้ง 10-16 ซึ่งมีสโคปชั้นนอกและสโคปชั้นใน
fn main() {
let r;
{
let x = 5;
r = &x;
}
println!("r: {r}");
}หมายเหตุ: ตัวอย่างในลิสติ้ง 10-16, 10-17 และ 10-23 มีการประกาศตัวแปรโดยไม่กำหนดค่าเริ่มต้น ชื่อตัวแปรจึงมีตัวตนอยู่ในสโคปชั้นนอก เมื่อมองแวบแรก อาจดูเหมือนขัดแย้งกับความจริงที่ว่า Rust ไม่มีค่า null ทว่าหากเราพยายามนำตัวแปรไปใช้งานก่อนที่จะกำหนดค่าให้ มันจะเกิดข้อผิดพลาดขึ้นตอนคอมไพล์ ซึ่งแสดงให้เห็นว่า Rust ไม่อนุญาตให้มีค่า null อย่างแท้จริง
สโคปชั้นนอกประกาศตัวแปรชื่อ r โดยไม่มีค่าเริ่มต้น ส่วนสโคปชั้นในประกาศตัวแปรชื่อ x ที่มีค่าเริ่มต้นเป็น 5 ภายในสโคปชั้นใน เราพยายามกำหนดค่าให้ r เป็นเรเฟอเรนซ์ที่ชี้ไปยัง x จากนั้นเมื่อสโคปชั้นในสิ้นสุดลง เราจึงพยายามพิมพ์ค่าของ r ออกมา โค้ดนี้จะไม่สามารถคอมไพล์ได้ เพราะค่าที่ r อ้างอิงอยู่นั้นหลุดออกจากสโคปไปแล้วก่อนที่เราจะนำมันมาใช้งาน นี่คือข้อความแสดงข้อผิดพลาดที่เกิดขึ้น:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0597]: `x` does not live long enough
--> src/main.rs:6:13
|
5 | let x = 5;
| - binding `x` declared here
6 | r = &x;
| ^^ borrowed value does not live long enough
7 | }
| - `x` dropped here while still borrowed
8 |
9 | println!("r: {r}");
| - borrow later used here
For more information about this error, try `rustc --explain E0597`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
ข้อความแสดงข้อผิดพลาดระบุว่าตัวแปร x “does not live long enough” (อยู่ได้ไม่นานพอ) สาเหตุก็คือ x จะหลุดออกจากสโคปเมื่อสโคปชั้นในสิ้นสุดลงที่บรรทัดที่ 7 แต่ r ยังคงใช้งานได้ในสโคปชั้นนอก เนื่องจากสโคปของมันกว้างกว่า เราจึงกล่าวว่ามัน “มีอายุยืนยาวกว่า (lives longer)” หาก Rust ปล่อยให้โค้ดนี้ทำงานได้ r ก็จะไปอ้างถึงตำแหน่งหน่วยความจำที่ถูกคืน (deallocated) ไปแล้วตั้งแต่ตอนที่ x หลุดจากสโคป และไม่ว่าเราจะพยายามทำอะไรกับ r ก็จะไม่สามารถทำงานได้อย่างถูกต้อง แล้ว Rust ตรวจสอบได้อย่างไรว่าโค้ดนี้ไม่ถูกต้อง? คำตอบคือ Rust ใช้ระบบที่เรียกว่าตัวตรวจการยืม (borrow checker)
ตัวตรวจการยืม
คอมไพเลอร์ของ Rust มี ตัวตรวจการยืม (borrow checker) ที่คอยเปรียบเทียบสโคปต่างๆ เพื่อประเมินว่าการยืมทั้งหมดนั้นถูกต้องหรือไม่ ลิสติ้ง 10-17 แสดงโค้ดชุดเดิมจากลิสติ้ง 10-16 แต่เพิ่มคำอธิบายกำกับเพื่อแสดงช่วงอายุ (lifetime) ของตัวแปรแต่ละตัว
fn main() {
let r; // ---------+-- 'a
// |
{ // |
let x = 5; // -+-- 'b |
r = &x; // | |
} // -+ |
// |
println!("r: {r}"); // |
} // ---------+ในที่นี้ เราได้กำกับไลฟ์ไทม์ของ r ด้วย 'a และไลฟ์ไทม์ของ x ด้วย 'b อย่างที่คุณเห็น บล็อก 'b ชั้นในนั้นมีขนาดเล็กกว่าบล็อกไลฟ์ไทม์ 'a ชั้นนอกมาก ในตอนคอมไพล์ Rust จะเปรียบเทียบขนาดของไลฟ์ไทม์ทั้งสอง และพบว่า r มีไลฟ์ไทม์เป็น 'a แต่มันกลับไปอ้างถึงหน่วยความจำที่มีไลฟ์ไทม์เพียงแค่ 'b โปรแกรมจึงถูกปฏิเสธเนื่องจากช่วงชีวิตของ 'b สั้นกว่า 'a' นั่นคือ ข้อมูลที่ถูกเรเฟอเรนซ์อ้างถึงอยู่ได้ไม่นานเท่ากับตัวเรเฟอเรนซ์เอง
ลิสติ้ง 10-18 แก้ไขโค้ดไม่ให้มี dangling reference อีกต่อไป ทำให้สามารถคอมไพล์ผ่านได้โดยไม่มีข้อผิดพลาดใดๆ
fn main() {
let x = 5; // ----------+-- 'b
// |
let r = &x; // --+-- 'a |
// | |
println!("r: {r}"); // | |
// --+ |
} // ----------+ในตัวอย่างนี้ x มีไลฟ์ไทม์ 'b ซึ่งกว้างกว่า 'a นั่นหมายความว่า r สามารถอ้างถึง x ได้อย่างปลอดภัย เพราะ Rust ทราบว่าเรเฟอเรนซ์ใน r จะยังคงถูกต้องและใช้งานได้เสมอ ตราบใดที่ x ยังคงมีชีวิตอยู่
เมื่อคุณเข้าใจแล้วว่าไลฟ์ไทม์ของเรเฟอเรนซ์ทำงานอย่างไร และ Rust วิเคราะห์ไลฟ์ไทม์เพื่อรับประกันความถูกต้องของเรเฟอเรนซ์อย่างไร ต่อไปเรามาสำรวจการใช้ไลฟ์ไทม์แบบเจเนอริกในพารามิเตอร์และค่าที่ส่งคืนจากฟังก์ชันกัน
ไลฟ์ไทม์แบบเจเนอริกในฟังก์ชัน
เราจะเขียนฟังก์ชันที่คืนค่าที่ยาวกว่าระหว่างสตริงสไลซ์ (string slice) สองตัว ฟังก์ชันนี้จะรับสตริงสไลซ์สองตัวและคืนสตริงสไลซ์เพียงตัวเดียว หลังจากที่เราอิมพลีเมนต์ฟังก์ชัน longest แล้ว โค้ดในลิสติ้ง 10-19 ควรพิมพ์ The longest string is abcd
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}โปรดสังเกตว่าเราต้องการให้ฟังก์ชันรับสตริงสไลซ์ (string slice) ซึ่งเป็นเรเฟอเรนซ์ แทนที่จะเป็นชนิดข้อมูลสตริงที่เป็นเจ้าของค่า เพราะเราไม่ต้องการให้ฟังก์ชัน longest เข้ามาเป็นเจ้าของพารามิเตอร์เหล่านั้น สามารถดูรายละเอียดเพิ่มเติมได้ที่หัวข้อ“สตริงสไลซ์ในฐานะพารามิเตอร์” ในบทที่ 4 ว่าเหตุใดพารามิเตอร์ที่เราใช้ในลิสติ้ง 10-19 จึงเป็นทางเลือกที่เหมาะสมที่สุด
หากเราพยายามอิมพลีเมนต์ฟังก์ชัน longest ตามที่แสดงในลิสติ้ง 10-20 มันจะไม่คอมไพล์
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}
fn longest(x: &str, y: &str) -> &str {
if x.len() > y.len() { x } else { y }
}แต่ผลลัพธ์กลับกลายเป็นข้อผิดพลาดต่อไปนี้ที่กล่าวถึงเรื่องไลฟ์ไทม์:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0106]: missing lifetime specifier
--> src/main.rs:9:33
|
9 | fn longest(x: &str, y: &str) -> &str {
| ---- ---- ^ expected named lifetime parameter
|
= help: this function's return type contains a borrowed value, but the signature does not say whether it is borrowed from `x` or `y`
help: consider introducing a named lifetime parameter
|
9 | fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
| ++++ ++ ++ ++
For more information about this error, try `rustc --explain E0106`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
ข้อความช่วยเหลือ (help text) ชี้แจงว่าชนิดข้อมูลที่ส่งคืนจำเป็นต้องมีพารามิเตอร์ไลฟ์ไทม์แบบเจเนอริกกำกับอยู่ด้วย เนื่องจาก Rust ไม่สามารถบอกได้ว่าเรเฟอเรนซ์ที่ส่งคืนนั้นอ้างถึง x หรือ y กันแน่ ซึ่งอันที่จริงแล้ว แม้แต่เราเองก็ไม่ทราบ เพราะบล็อก if ในเนื้อหาของฟังก์ชันจะคืนเรเฟอเรนซ์ของ x ส่วนบล็อก else จะคืนเรเฟอเรนซ์ของ y!
ในตอนที่เรานิยามฟังก์ชันนี้ เราไม่รู้ค่าจริงที่จะถูกส่งเข้ามา เราจึงไม่อาจทราบล่วงหน้าได้ว่าโค้ดจะเข้าไปทำงานในกรณี if หรือ else ยิ่งไปกว่านั้น เรายังไม่รู้ไลฟ์ไทม์ที่แท้จริงของเรเฟอเรนซ์ที่จะถูกส่งเข้ามาด้วย จึงไม่สามารถตรวจสอบสโคปแบบที่เราทำในลิสติ้ง 10-17 และ 10-18 เพื่อชี้ขาดว่าเรเฟอเรนซ์ที่เราส่งคืนจะยังใช้งานได้อย่างถูกต้องเสมอหรือไม่ ตัวตรวจการยืมเองก็ตัดสินไม่ได้เช่นกัน เพราะมันไม่รู้ว่าไลฟ์ไทม์ของ x และ y เชื่อมโยงกับไลฟ์ไทม์ของค่าที่ส่งคืนอย่างไร เพื่อแก้ไขข้อผิดพลาดนี้ เราจำเป็นต้องเพิ่มพารามิเตอร์ไลฟ์ไทม์แบบเจเนอริกเพื่อกำหนดความสัมพันธ์ระหว่างเรเฟอเรนซ์เหล่านั้น ซึ่งจะช่วยให้ตัวตรวจการยืมสามารถวิเคราะห์ความถูกต้องได้อย่างสมบูรณ์
วากยสัมพันธ์ของการระบุไลฟ์ไทม์
การระบุไลฟ์ไทม์ (lifetime annotation) ไม่ได้เป็นการเปลี่ยนแปลงช่วงชีวิตของเรเฟอเรนซ์ใดๆ เลย แต่มีไว้เพื่ออธิบายความสัมพันธ์ระหว่างช่วงชีวิตของเรเฟอเรนซ์หลายๆ ตัวเข้าด้วยกัน โดยไม่ส่งผลกระทบต่อไลฟ์ไทม์เดิมของพวกมัน เช่นเดียวกับที่ฟังก์ชันสามารถรับชนิดข้อมูลใดๆ ก็ได้เมื่อในซิกเนเจอร์มีพารามิเตอร์ชนิดข้อมูลแบบเจเนอริก ฟังก์ชันก็สามารถรับเรเฟอเรนซ์ที่มีไลฟ์ไทม์ใดๆ ก็ได้โดยการระบุพารามิเตอร์ไลฟ์ไทม์แบบเจเนอริกเช่นกัน
การระบุไลฟ์ไทม์มีวากยสัมพันธ์ที่ค่อนข้างแปลกตาเล็กน้อย: ชื่อของพารามิเตอร์ไลฟ์ไทม์จะต้องขึ้นต้นด้วยเครื่องหมายอะพอสทรอฟี (') และมักจะเป็นตัวพิมพ์เล็กทั้งหมดที่มีความยาวสั้นมากๆ เช่นเดียวกับชนิดข้อมูลเจเนอริก โดยธรรมเนียมแล้วคนส่วนใหญ่มักจะตั้งชื่อ 'a เป็นการระบุไลฟ์ไทม์ตัวแรก เราจะวางการระบุพารามิเตอร์ไลฟ์ไทม์ไว้หลังเครื่องหมาย & ของเรเฟอเรนซ์ และคั่นด้วยการเว้นวรรคหนึ่งช่องก่อนจะตามด้วยชนิดข้อมูลของเรเฟอเรนซ์นั้น
นี่คือตัวอย่างบางส่วน—เรเฟอเรนซ์ที่ชี้ไปยัง i32 แบบไม่มีพารามิเตอร์ไลฟ์ไทม์, เรเฟอเรนซ์ที่ชี้ไปยัง i32 ที่มีพารามิเตอร์ไลฟ์ไทม์ชื่อ 'a กำกับอยู่, และเรเฟอเรนซ์แบบแก้ไขได้ (mutable reference) ที่ชี้ไปยัง i32 ซึ่งมีไลฟ์ไทม์ 'a กำกับไว้เช่นกัน:
&i32 // a reference
&'a i32 // a reference with an explicit lifetime
&'a mut i32 // a mutable reference with an explicit lifetimeการระบุไลฟ์ไทม์โดดๆ เพียงตัวเดียวจะไม่มีความหมายอะไรมากนัก เนื่องจากการระบุไลฟ์ไทม์มีจุดประสงค์หลักเพื่อบอก Rust ว่าพารามิเตอร์ไลฟ์ไทม์แบบเจเนอริกของเรเฟอเรนซ์หลายๆ ตัวนั้นสัมพันธ์กันอย่างไร มาดูกันว่าการระบุไลฟ์ไทม์มีความเกี่ยวข้องกันอย่างไรในบริบทของฟังก์ชัน longest
ในซิกเนเจอร์ของฟังก์ชัน
ในการระบุไลฟ์ไทม์ในซิกเนเจอร์ของฟังก์ชัน เราจะต้องประกาศพารามิเตอร์ไลฟ์ไทม์แบบเจเนอริกไว้ภายในวงเล็บสามเหลี่ยมคั่นกลางระหว่างชื่อฟังก์ชันกับรายการพารามิเตอร์ เช่นเดียวกับวิธีที่เราทำกับพารามิเตอร์ชนิดข้อมูลแบบเจเนอริก
เราต้องการให้ซิกเนเจอร์สื่อถึงเงื่อนไขข้อจำกัดว่า: เรเฟอเรนซ์ที่ส่งคืนจะยังคงใช้งานได้ตราบเท่าที่พารามิเตอร์ทั้งสองตัวยังคงใช้งานได้ นี่คือความสัมพันธ์ระหว่างไลฟ์ไทม์ของพารามิเตอร์กับค่าที่ส่งคืน เราจะตั้งชื่อไลฟ์ไทม์นี้ว่า 'a แล้วนำไปใส่กำกับให้กับเรเฟอเรนซ์แต่ละตัว ดังที่แสดงในลิสติ้ง 10-21
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}
fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
if x.len() > y.len() { x } else { y }
}โค้ดนี้จะสามารถคอมไพล์ผ่านและให้ผลลัพธ์ตามที่เราต้องการเมื่อนำไปใช้งานร่วมกับฟังก์ชัน main ในลิสติ้ง 10-19
ในตอนนี้ ซิกเนเจอร์ของฟังก์ชันได้บอกให้ Rust ทราบว่า สำหรับไลฟ์ไทม์ 'a หนึ่งๆ ฟังก์ชันนี้จะรับพารามิเตอร์สองตัว ซึ่งทั้งคู่เป็นสตริงสไลซ์ที่มีอายุยืนยาวอย่างน้อยเท่ากับไลฟ์ไทม์ 'a นอกจากนี้ ซิกเนเจอร์ยังบอก Rust อีกว่า สตริงสไลซ์ที่ส่งคืนจากฟังก์ชันก็จะมีอายุยืนยาวอย่างน้อยเท่ากับไลฟ์ไทม์ 'a ด้วยเช่นกัน ในทางปฏิบัติ นั่นหมายความว่าไลฟ์ไทม์ของเรเฟอเรนซ์ที่ฟังก์ชัน longest ส่งคืนจะมีขนาดเท่ากับไลฟ์ไทม์ที่สั้นกว่าระหว่างไลฟ์ไทม์ของค่าที่อาร์กิวเมนต์ทั้งสองตัวอ้างถึง ความสัมพันธ์เหล่านี้คือสิ่งที่ Rust จะนำไปใช้ในการวิเคราะห์โค้ด
โปรดจำไว้ว่า การระบุพารามิเตอร์ไลฟ์ไทม์ในซิกเนเจอร์ของฟังก์ชันนี้ เราไม่ได้ไปเปลี่ยนแปลงไลฟ์ไทม์ของค่าใดๆ ที่ส่งเข้ามาหรือส่งคืนกลับไปเลย แต่เป็นการระบุข้อกำหนดเพื่อให้ตัวตรวจการยืมปฏิเสธค่าใดๆ ก็ตามที่ไม่สอดคล้องกับเงื่อนไขเหล่านี้ โปรดสังเกตว่าฟังก์ชัน longest ไม่จำเป็นต้องรู้ว่า x และ y จะมีอายุอยู่ได้นานเท่าใดกันแน่ ขอเพียงแค่มีสโคปบางสโคปที่สามารถนำมาแทนค่า 'a แล้วทำให้ซิกเนเจอร์นี้ถูกต้องสมบูรณ์ได้ก็เพียงพอแล้ว
เมื่อระบุไลฟ์ไทม์ในฟังก์ชัน คำระบุเหล่านั้นจะวางอยู่ในซิกเนเจอร์ของฟังก์ชัน ไม่ใช่ในเนื้อหาของฟังก์ชัน การระบุไลฟ์ไทม์จึงกลายมาเป็นส่วนหนึ่งของสัญญา (contract) ของฟังก์ชัน คล้ายกับการระบุชนิดข้อมูลในซิกเนเจอร์ การมีสัญญาเรื่องไลฟ์ไทม์อยู่ในซิกเนเจอร์ของฟังก์ชันทำให้การวิเคราะห์ของคอมไพเลอร์ Rust ทำได้ง่ายขึ้นและตรงไปตรงมา หากมีจุดผิดพลาดเกี่ยวกับการระบุไลฟ์ไทม์หรือวิธีการเรียกใช้งานฟังก์ชัน ข้อผิดพลาดจากคอมไพเลอร์ก็จะสามารถชี้ไปยังตำแหน่งของโค้ดและข้อจำกัดต่างๆ ได้อย่างแม่นยำ ในทางตรงกันข้าม หากคอมไพเลอร์ Rust พยายามอนุมานเจตนาความสัมพันธ์ของไลฟ์ไทม์เอาเองมากเกินไป คอมไพเลอร์อาจชี้ได้เพียงแค่จุดที่เรียกใช้โค้ด ซึ่งอาจอยู่ห่างจากต้นตอของปัญหาจริงๆ ไปหลายขั้นตอน
เมื่อเราส่งเรเฟอเรนซ์จริงๆ เข้าไปยัง longest ไลฟ์ไทม์ที่แท้จริงซึ่งจะถูกนำมาแทนที่ 'a ก็คือส่วนของสโคปของ x ที่ทับซ้อนกับสโคปของ y กล่าวอีกนัยหนึ่ง ไลฟ์ไทม์แบบเจเนอริก 'a จะได้รับไลฟ์ไทม์จริงที่มีขนาดเท่ากับไลฟ์ไทม์ที่สั้นกว่าระหว่าง x กับ y และเนื่องจากเรากำกับเรเฟอเรนซ์ที่ส่งคืนด้วยพารามิเตอร์ไลฟ์ไทม์ 'a ตัวเดียวกัน เรเฟอเรนซ์ที่ส่งคืนจึงมีอายุใช้งานได้ยาวนานเท่ากับไลฟ์ไทม์ที่สั้นกว่าระหว่าง x กับ y ด้วยเช่นกัน
มาดูกันว่าการระบุไลฟ์ไทม์จำกัดการทำงานของฟังก์ชัน longest อย่างไรเมื่อเราส่งเรเฟอเรนซ์ที่มีไลฟ์ไทม์จริงๆ แตกต่างกัน ลิสติ้ง 10-22 เป็นตัวอย่างที่ชัดเจนและตรงไปตรงมา
fn main() {
let string1 = String::from("long string is long");
{
let string2 = String::from("xyz");
let result = longest(string1.as_str(), string2.as_str());
println!("The longest string is {result}");
}
}
fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
if x.len() > y.len() { x } else { y }
}ในตัวอย่างนี้ string1 สามารถใช้งานได้จนกระทั่งสิ้นสุดสโคปชั้นนอก ส่วน string2 สามารถใช้งานได้จนสิ้นสุดสโคปชั้นใน และ result อ้างถึงข้อมูลที่ใช้งานได้จนสิ้นสุดสโคปชั้นใน เมื่อรันโค้ดนี้จะพบว่าตัวตรวจการยืมอนุญาตให้ผ่านได้ โดยจะคอมไพล์ผ่านและพิมพ์ The longest string is long string is long
ถัดไป มาลองดูตัวอย่างที่แสดงให้เห็นว่าไลฟ์ไทม์ของเรเฟอเรนซ์ใน result จะต้องเป็นไลฟ์ไทม์ที่สั้นกว่าระหว่างอาร์กิวเมนต์ทั้งสองตัว เราจะย้ายการประกาศตัวแปร result ออกไปไว้นอกสโคปชั้นใน แต่ยังคงการกำหนดค่าให้ตัวแปร result ไว้ภายในสโคปที่มี string2 จากนั้นเราจะย้ายคำสั่ง println! ที่เรียกใช้ result ออกไปไว้นอกสโคปชั้นใน หลังจากที่สโคปชั้นในสิ้นสุดลงแล้ว โค้ดในลิสติ้ง 10-23 จะคอมไพล์ไม่ผ่าน
fn main() {
let string1 = String::from("long string is long");
let result;
{
let string2 = String::from("xyz");
result = longest(string1.as_str(), string2.as_str());
}
println!("The longest string is {result}");
}
fn longest<'a>(x: &'a str, y: &'a str) -> &'a str {
if x.len() > y.len() { x } else { y }
}เมื่อเราพยายามคอมไพล์โค้ดนี้ เราจะได้ข้อผิดพลาดนี้:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0597]: `string2` does not live long enough
--> src/main.rs:6:44
|
5 | let string2 = String::from("xyz");
| ------- binding `string2` declared here
6 | result = longest(string1.as_str(), string2.as_str());
| ^^^^^^^ borrowed value does not live long enough
7 | }
| - `string2` dropped here while still borrowed
8 | println!("The longest string is {result}");
| ------ borrow later used here
For more information about this error, try `rustc --explain E0597`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
ข้อผิดพลาดแสดงว่า การที่ result จะสามารถใช้งานในคำสั่ง println! ได้นั้น string2 จะต้องมีอายุใช้งานได้จนถึงจุดสิ้นสุดของสโคปชั้นนอกด้วย Rust ทราบเรื่องนี้เพราะเราได้ระบุไลฟ์ไทม์ของพารามิเตอร์และค่าที่ส่งคืนด้วยพารามิเตอร์ไลฟ์ไทม์ 'a ตัวเดียวกัน
ในฐานะมนุษย์ เราอาจมองโค้ดนี้แล้วเห็นว่า string1 ยาวกว่า string2 ดังนั้น result ย่อมต้องเก็บเรเฟอเรนซ์ที่ชี้ไปยัง string1 อย่างแน่นอน และเนื่องจาก string1 ยังไม่ได้หลุดออกจากสโคป เรเฟอเรนซ์ไปยัง string1 ก็น่าจะยังคงใช้งานในคำสั่ง println! ได้ อย่างไรก็ตาม คอมไพเลอร์ไม่สามารถมองเห็นความจริงเฉพาะหน้านี้ได้ เราได้บอกกับ Rust เอาไว้ว่าไลฟ์ไทม์ของเรเฟอเรนซ์ที่ส่งคืนจากฟังก์ชัน longest มีขนาดเท่ากับไลฟ์ไทม์ที่สั้นกว่าระหว่างเรเฟอเรนซ์ที่ส่งเข้ามา ดังนั้น ตัวตรวจการยืมจึงไม่อนุญาตโค้ดในลิสติ้ง 10-23 เนื่องจากมองว่ามีความเสี่ยงที่จะเกิดเรเฟอเรนซ์ที่ไม่ถูกต้องขึ้น
ลองออกแบบการทดลองเพิ่มเติมโดยปรับเปลี่ยนค่าและไลฟ์ไทม์ของเรเฟอเรนซ์ที่ส่งเข้าฟังก์ชัน longest รวมถึงวิธีนำเรเฟอเรนซ์ที่ได้กลับไปใช้งาน แล้วลองตั้งสมมติฐานดูก่อนคอมไพล์ว่าการทดลองของคุณจะผ่านตัวตรวจการยืมหรือไม่ จากนั้นลองคอมไพล์เพื่อดูว่าผลลัพธ์ตรงกับที่คุณคาดไว้หรือไม่!
ความสัมพันธ์
วิธีที่คุณจำเป็นต้องระบุพารามิเตอร์ไลฟ์ไทม์นั้นขึ้นอยู่กับการทำงานของฟังก์ชัน ตัวอย่างเช่น หากเราเปลี่ยนการทำงานของฟังก์ชัน longest ให้ส่งคืนพารามิเตอร์ตัวแรกเสมอแทนที่จะเป็นสตริงสไลซ์ที่ยาวกว่า เราก็ไม่จำเป็นต้องระบุไลฟ์ไทม์ให้กับพารามิเตอร์ y เลย โค้ดต่อไปนี้จะสามารถคอมไพล์ผ่านได้:
fn main() {
let string1 = String::from("abcd");
let string2 = "efghijklmnopqrstuvwxyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}
fn longest<'a>(x: &'a str, y: &str) -> &'a str {
x
}เราได้ระบุพารามิเตอร์ไลฟ์ไทม์ 'a ให้กับพารามิเตอร์ x และชนิดข้อมูลที่ส่งคืน แต่ไม่ได้ระบุให้กับพารามิเตอร์ y เนื่องจากไลฟ์ไทม์ของ y ไม่ได้มีความสัมพันธ์ใดๆ กับไลฟ์ไทม์ของ x หรือค่าที่ส่งคืน
เมื่อฟังก์ชันมีการส่งคืนเรเฟอเรนซ์ พารามิเตอร์ไลฟ์ไทม์ของชนิดข้อมูลที่ส่งคืนจะต้องตรงกับพารามิเตอร์ไลฟ์ไทม์ของพารามิเตอร์ตัวใดตัวหนึ่งเสมอ หากเรเฟอเรนซ์ที่ส่งคืนไม่ได้อ้างถึงพารามิเตอร์ตัวใดตัวหนึ่ง ก็แสดงว่ามันจะต้องอ้างถึงค่าที่ถูกสร้างขึ้นภายในฟังก์ชันนั้นเอง ซึ่งนั่นจะทำให้กลายเป็น dangling reference ไปทันที เพราะค่านั้นจะหลุดออกจากสโคปและถูกทำลายไปเมื่อสิ้นสุดการทำงานของฟังก์ชัน ลองพิจารณาความพยายามอิมพลีเมนต์ฟังก์ชัน longest ต่อไปนี้ ซึ่งจะคอมไพล์ไม่ผ่าน:
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest(string1.as_str(), string2);
println!("The longest string is {result}");
}
fn longest<'a>(x: &str, y: &str) -> &'a str {
let result = String::from("really long string");
result.as_str()
}ในกรณีนี้ แม้ว่าเราจะระบุพารามิเตอร์ไลฟ์ไทม์ 'a ให้กับชนิดข้อมูลที่ส่งคืนแล้วก็ตาม การอิมพลีเมนต์นี้ก็จะยังคอมไพล์ไม่ผ่านอยู่ดี เพราะไลฟ์ไทม์ของค่าที่ส่งคืนไม่ได้มีความสัมพันธ์ใดๆ กับไลฟ์ไทม์ของพารามิเตอร์เลย นี่คือข้อความแสดงข้อผิดพลาดที่เราได้รับ:
$ cargo run
Compiling chapter10 v0.1.0 (file:///projects/chapter10)
error[E0515]: cannot return value referencing local variable `result`
--> src/main.rs:11:5
|
11 | result.as_str()
| ------^^^^^^^^^
| |
| returns a value referencing data owned by the current function
| `result` is borrowed here
For more information about this error, try `rustc --explain E0515`.
error: could not compile `chapter10` (bin "chapter10") due to 1 previous error
ปัญหาคือ result จะหลุดออกจากสโคปและถูกคืนหน่วยความจำเมื่อสิ้นสุดฟังก์ชัน longest แต่เรากลับพยายามส่งคืนเรเฟอเรนซ์ที่ชี้ไปยัง result จากฟังก์ชัน ไม่มีทางที่การระบุพารามิเตอร์ไลฟ์ไทม์ใดๆ จะสามารถแก้ไขเรเฟอเรนซ์ที่ชี้ไปยังหน่วยความจำที่ถูกคืนไปแล้วได้ และ Rust ก็ไม่อนุญาตให้เราสร้าง dangling reference อย่างเด็ดขาด ในกรณีนี้ ทางแก้ที่ดีที่สุดคือการส่งคืนชนิดข้อมูลที่เป็นเจ้าของค่า (owned data type) แทนที่จะเป็นเรเฟอเรนซ์ เพื่อให้ฟังก์ชันผู้เรียกเป็นผู้รับผิดชอบการทำความสะอาดและคืนหน่วยความจำของค่านั้นต่อไป
โดยสรุปแล้ว วากยสัมพันธ์ของไลฟ์ไทม์มีไว้เพื่อเชื่อมโยงความสัมพันธ์ของไลฟ์ไทม์ระหว่างพารามิเตอร์ต่างๆ กับค่าที่ส่งคืนของฟังก์ชันเข้าด้วยกัน เมื่อเชื่อมโยงกันแล้ว Rust ก็จะมีข้อมูลเพียงพอที่จะอนุญาตให้การดำเนินการที่ปลอดภัยต่อหน่วยความจำทำงานได้ และไม่อนุญาตการกระทำที่จะก่อให้เกิด dangling pointer หรือละเมิดความปลอดภัยของหน่วยความจำในรูปแบบอื่นๆ
ในนิยามของ struct
จนถึงตอนนี้ struct ทั้งหมดที่เราเคยนิยามมาล้วนเก็บชนิดข้อมูลที่เป็นเจ้าของค่า (owned types) ทั้งสิ้น เราสามารถนิยาม struct ให้เก็บเรเฟอเรนซ์ได้เช่นกัน แต่ในกรณีนั้น เราจำเป็นต้องระบุไลฟ์ไทม์กำกับไว้บนเรเฟอเรนซ์ทุกตัวในนิยามของ struct ดังตัวอย่างในลิสติ้ง 10-24 ซึ่งมี struct ชื่อ ImportantExcerpt ที่เก็บสตริงสไลซ์
struct ImportantExcerpt<'a> {
part: &'a str,
}
fn main() {
let novel = String::from("Call me Ishmael. Some years ago...");
let first_sentence = novel.split('.').next().unwrap();
let i = ImportantExcerpt {
part: first_sentence,
};
}struct นี้มีฟิลด์เดียวคือ part ซึ่งเก็บสตริงสไลซ์ที่เป็นเรเฟอเรนซ์ เช่นเดียวกับชนิดข้อมูลเจเนอริก เราจะประกาศชื่อพารามิเตอร์ไลฟ์ไทม์แบบเจเนอริกไว้ภายในวงเล็บสามเหลี่ยมหลังชื่อ struct เพื่อให้สามารถนำพารามิเตอร์ไลฟ์ไทม์นั้นไปใช้งานในเนื้อหาของนิยาม struct ได้ การระบุนี้หมายความว่า อินสแตนซ์ของ ImportantExcerpt จะไม่สามารถมีอายุยืนยาวไปกว่าเรเฟอเรนซ์ที่มันถือครองอยู่ในฟิลด์ part ได้
ฟังก์ชัน main ในตัวอย่างนี้สร้างอินสแตนซ์ของ ImportantExcerpt ที่เก็บเรเฟอเรนซ์ชี้ไปยังประโยคแรกของ String ซึ่งตัวแปร novel เป็นเจ้าของ ข้อมูลใน novel มีตัวตนอยู่ก่อนที่อินสแตนซ์ของ ImportantExcerpt จะถูกสร้างขึ้น นอกจากนี้ novel ก็ยังไม่หลุดออกจากสโคปจนกระทั่งหลังจากที่ ImportantExcerpt หลุดออกจากสโคปไปแล้ว ดังนั้น เรเฟอเรนซ์ที่อยู่ในอินสแตนซ์ของ ImportantExcerpt จึงมีความถูกต้องและใช้งานได้อย่างปลอดภัย
การละไลฟ์ไทม์
คุณได้เรียนรู้แล้วว่าทุกเรเฟอเรนซ์ต่างก็มีไลฟ์ไทม์ และเราจำเป็นต้องระบุพารามิเตอร์ไลฟ์ไทม์ให้กับฟังก์ชันหรือ struct ที่มีการใช้งานเรเฟอเรนซ์ อย่างไรก็ตาม ในลิสติ้ง 4-9 ซึ่งนำมาแสดงอีกครั้งในลิสติ้ง 10-25 ฟังก์ชันกลับสามารถคอมไพล์ผ่านได้โดยไม่ต้องระบุไลฟ์ไทม์ใดๆ เลย
fn first_word(s: &str) -> &str {
let bytes = s.as_bytes();
for (i, &item) in bytes.iter().enumerate() {
if item == b' ' {
return &s[0..i];
}
}
&s[..]
}
fn main() {
let my_string = String::from("hello world");
// first_word works on slices of `String`s
let word = first_word(&my_string[..]);
let my_string_literal = "hello world";
// first_word works on slices of string literals
let word = first_word(&my_string_literal[..]);
// Because string literals *are* string slices already,
// this works too, without the slice syntax!
let word = first_word(my_string_literal);
}เหตุผลที่ฟังก์ชันนี้สามารถคอมไพล์ผ่านได้โดยไม่ต้องระบุไลฟ์ไทม์นั้นเป็นเรื่องราวทางประวัติศาสตร์: ในยุคแรกเริ่มของ Rust (ก่อนเวอร์ชัน 1.0) โค้ดนี้จะไม่สามารถคอมไพล์ได้เลย เพราะทุกเรเฟอเรนซ์จำเป็นต้องมีการระบุไลฟ์ไทม์อย่างชัดเจน ในยุคนั้น ซิกเนเจอร์ของฟังก์ชันจะต้องถูกเขียนดังนี้:
fn first_word<'a>(s: &'a str) -> &'a str {หลังจากเขียนโค้ด Rust ไปเป็นจำนวนมาก ทีมพัฒนา Rust ก็พบว่าเหล่านักพัฒนาต่างต้องเขียนระบุไลฟ์ไทม์แบบเดิมซ้ำๆ ในสถานการณ์เดิมๆ อยู่เสมอ ซึ่งรูปแบบเหล่านี้สามารถคาดเดาได้และเป็นไปตามแพตเทิร์นที่แน่นอนไม่กี่แบบ นักพัฒนาคอมไพเลอร์จึงได้บรรจุแพตเทิร์นเหล่านั้นลงในตัวคอมไพเลอร์ เพื่อให้ตัวตรวจการยืมสามารถอนุมานไลฟ์ไทม์ในสถานการณ์ดังกล่าวได้เองโดยไม่จำเป็นต้องระบุอย่างโจ่งแจ้งอีกต่อไป
ประวัติศาสตร์ส่วนนี้ของ Rust มีความสำคัญ เพราะเป็นไปได้ว่าในอนาคตอาจมีแพตเทิร์นที่แน่นอนเพิ่มเติมถูกนำมาใส่ในคอมไพเลอร์อีก ทำให้เราอาจต้องเขียนระบุไลฟ์ไทม์น้อยลงไปกว่าเดิม
แพตเทิร์นที่ถูกกำหนดไว้ในการวิเคราะห์เรเฟอเรนซ์ของ Rust นี้เรียกว่า กฎการละไลฟ์ไทม์ (lifetime elision rules) กฎเหล่านี้ไม่ใช่กฎที่โปรแกรมเมอร์ต้องคอยท่องจำเพื่อปฏิบัติตาม แต่เป็นชุดเงื่อนไขเฉพาะที่คอมไพเลอร์จะนำมาพิจารณา และหากโค้ดของคุณตรงตามเงื่อนไขเหล่านี้ คุณก็ไม่จำเป็นต้องเขียนระบุไลฟ์ไทม์ด้วยตนเอง
กฎการละไลฟ์ไทม์ไม่ได้ครอบคลุมการอนุมานในทุกกรณี หากคอมไพเลอร์ประยุกต์ใช้กฎเหล่านี้แล้วยังคงมีความคลุมเครือว่าเรเฟอเรนซ์ควรมีไลฟ์ไทม์ใด คอมไพเลอร์จะไม่คาดเดาไปเอง แต่จะรายงานเป็นข้อผิดพลาดออกมาเพื่อให้คุณแก้ไขด้วยการระบุไลฟ์ไทม์ด้วยตนเอง
ไลฟ์ไทม์ที่อยู่บนพารามิเตอร์ของฟังก์ชันหรือเมธอดจะเรียกว่า ไลฟ์ไทม์ขาเข้า (input lifetimes) ส่วนไลฟ์ไทม์ที่อยู่บนค่าที่ส่งคืนจะเรียกว่า ไลฟ์ไทม์ขาออก (output lifetimes)
คอมไพเลอร์จะใช้กฎ 3 ข้อในการหาไลฟ์ไทม์ของเรเฟอเรนซ์เมื่อไม่มีการระบุไว้อย่างชัดแจ้ง โดยกฎข้อแรกจะใช้กับไลฟ์ไทม์ขาเข้า ส่วนกฎข้อที่สองและสามจะใช้กับไลฟ์ไทม์ขาออก หากคอมไพเลอร์พิจารณาจนครบทั้งสามข้อแล้วยังมีเรเฟอเรนซ์ที่ระบุไลฟ์ไทม์ไม่ได้ คอมไพเลอร์จะหยุดการทำงานพร้อมแจ้งข้อผิดพลาด กฎเหล่านี้ใช้ได้กับทั้งนิยามของ fn และบล็อก impl
กฎข้อแรกคือ คอมไพเลอร์จะกำหนดพารามิเตอร์ไลฟ์ไทม์ให้แก่พารามิเตอร์ทุกตัวที่เป็นเรเฟอเรนซ์ กล่าวคือ ฟังก์ชันที่มีพารามิเตอร์หนึ่งตัวจะได้พารามิเตอร์ไลฟ์ไทม์หนึ่งตัว: fn foo<'a>(x: &'a i32) ส่วนฟังก์ชันที่มีสองพารามิเตอร์ก็จะได้พารามิเตอร์ไลฟ์ไทม์แยกกันสองตัว: fn foo<'a, 'b>(x: &'a i32, y: &'b i32) และเป็นเช่นนี้เรื่อยไป
กฎข้อที่สองคือ หากมีพารามิเตอร์ไลฟ์ไทม์ขาเข้าเพียงตัวเดียวเท่านั้น ไลฟ์ไทม์นั้นจะถูกกำหนดให้กับพารามิเตอร์ไลฟ์ไทม์ขาออกทั้งหมดโดยอัตโนมัติ: fn foo<'a>(x: &'a i32) -> &'a i32
กฎข้อที่สามคือ หากมีพารามิเตอร์ไลฟ์ไทม์ขาเข้าหลายตัว แต่มีตัวใดตัวหนึ่งเป็น &self หรือ &mut self (เนื่องจากเป็นเมธอด) ไลฟ์ไทม์ของ self จะถูกกำหนดให้กับพารามิเตอร์ไลฟ์ไทม์ขาออกทั้งหมด กฎข้อที่สามนี้ช่วยให้การเขียนและอ่านเมธอดสะดวกสบายขึ้นมาก เพราะไม่ต้องใส่สัญลักษณ์ให้รกตา
ลองสมมติตัวเราเป็นคอมไพเลอร์ แล้วนำกฎเหล่านี้มาใช้หาไลฟ์ไทม์ของเรเฟอเรนซ์ในซิกเนเจอร์ของฟังก์ชัน first_word ในลิสติ้ง 10-25 ซิกเนเจอร์เริ่มต้นจะไม่มีไลฟ์ไทม์ใดๆ ผูกอยู่กับเรเฟอเรนซ์:
fn first_word(s: &str) -> &str {จากนั้น คอมไพเลอร์จะใช้กฎข้อแรก ซึ่งระบุว่าพารามิเตอร์แต่ละตัวจะได้ไลฟ์ไทม์เป็นของตัวเอง เราจะตั้งชื่อว่า 'a ตามปกติ ซิกเนเจอร์จึงเปลี่ยนเป็นแบบนี้:
fn first_word<'a>(s: &'a str) -> &str {ต่อมากฎข้อที่สองจะถูกนำมาใช้ เนื่องจากมีไลฟ์ไทม์ขาเข้าเพียงตัวเดียวพอดี กฎข้อที่สองระบุว่าไลฟ์ไทม์ของพารามิเตอร์ขาเข้าจะถูกนำไปกำหนดให้กับไลฟ์ไทม์ขาออก ซิกเนเจอร์จึงกลายเป็นแบบนี้:
fn first_word<'a>(s: &'a str) -> &'a str {ในตอนนี้ เรเฟอเรนซ์ทั้งหมดในซิกเนเจอร์ของฟังก์ชันต่างก็มีไลฟ์ไทม์ครบถ้วนแล้ว คอมไพเลอร์จึงสามารถวิเคราะห์โค้ดต่อไปได้ โดยที่โปรแกรมเมอร์ไม่ต้องมาคอยระบุไลฟ์ไทม์ในซิกเนเจอร์ของฟังก์ชันนี้เลย
มาดูอีกตัวอย่างหนึ่ง คราวนี้ใช้ฟังก์ชัน longest ที่ยังไม่ได้ระบุพารามิเตอร์ไลฟ์ไทม์ตอนที่เราเริ่มเขียนในลิสติ้ง 10-20:
fn longest(x: &str, y: &str) -> &str {เมื่อนำกฎข้อแรกมาใช้: พารามิเตอร์แต่ละตัวจะได้ไลฟ์ไทม์ของตัวเอง คราวนี้เรามีพารามิเตอร์สองตัว จึงได้ไลฟ์ไทม์สองตัวแยกกัน:
fn longest<'a, 'b>(x: &'a str, y: &'b str) -> &str {คุณจะเห็นว่ากฎข้อที่สองไม่สามารถนำมาใช้ได้ เพราะมีไลฟ์ไทม์ขาเข้ามากกว่าหนึ่งตัว และกฎข้อที่สามก็ใช้ไม่ได้เช่นกัน เพราะ longest เป็นฟังก์ชันธรรมดาไม่ใช่เมธอด จึงไม่มีพารามิเตอร์ที่เป็น self เลย หลังจากพิจารณาผ่านกฎทั้งสามข้อแล้ว คอมไพเลอร์ก็ยังคงไม่สามารถระบุได้ว่าไลฟ์ไทม์ของชนิดข้อมูลที่ส่งคืนคืออะไร นี่คือสาเหตุที่เราพบข้อผิดพลาดเมื่อพยายามคอมไพล์โค้ดในลิสติ้ง 10-20: คอมไพเลอร์ไล่ดูกฎการละไลฟ์ไทม์จนครบแล้ว แต่ก็ยังไม่สามารถหาไลฟ์ไทม์ของเรเฟอเรนซ์ทั้งหมดในซิกเนเจอร์ได้
เนื่องจากกฎข้อที่สามนั้นจะใช้กับซิกเนเจอร์ของเมธอดเท่านั้น ต่อไปเราจะมาดูเรื่องไลฟ์ไทม์ในบริบทของเมธอดกัน เพื่อดูว่าทำไมกฎข้อที่สามจึงช่วยให้เราแทบไม่ต้องระบุไลฟ์ไทม์ในซิกเนเจอร์ของเมธอดเลย
ในนิยามของเมธอด
เมื่อเราอิมพลีเมนต์เมธอดให้กับ struct ที่มีไลฟ์ไทม์ เราจะใช้วากยสัมพันธ์แบบเดียวกับพารามิเตอร์ชนิดข้อมูลแบบเจเนอริกดังที่แสดงในลิสติ้ง 10-11 ตำแหน่งที่เราจะประกาศและนำพารามิเตอร์ไลฟ์ไทม์ไปใช้นั้น ขึ้นอยู่กับว่ามันเกี่ยวข้องกับฟิลด์ของ struct หรือเกี่ยวข้องกับพารามิเตอร์และค่าที่ส่งคืนของเมธอด
ชื่อของไลฟ์ไทม์สำหรับฟิลด์ของ struct จำเป็นต้องประกาศไว้หลังคีย์เวิร์ด impl เสมอ และนำไปใช้หลังชื่อของ struct เพราะไลฟ์ไทม์เหล่านั้นถือเป็นส่วนหนึ่งของชนิดข้อมูลของ struct
ในซิกเนเจอร์ของเมธอดภายในบล็อก impl เรเฟอเรนซ์อาจจะผูกติดอยู่กับไลฟ์ไทม์ของเรเฟอเรนซ์ในฟิลด์ของ struct หรืออาจจะเป็นอิสระต่อกันก็ได้ นอกจากนี้ กฎการละไลฟ์ไทม์ยังช่วยให้เราแทบไม่ต้องระบุไลฟ์ไทม์ในซิกเนเจอร์ของเมธอดเลย มาดูตัวอย่างบางส่วนโดยใช้ struct ชื่อ ImportantExcerpt ที่เรานิยามไว้ในลิสติ้ง 10-24
อันดับแรก เราจะใช้เมธอดชื่อ level ที่มีพารามิเตอร์เพียงตัวเดียวคือเรเฟอเรนซ์ไปยัง self และมีค่าที่ส่งคืนเป็น i32 ซึ่งไม่ใช่เรเฟอเรนซ์:
struct ImportantExcerpt<'a> {
part: &'a str,
}
impl<'a> ImportantExcerpt<'a> {
fn level(&self) -> i32 {
3
}
}
impl<'a> ImportantExcerpt<'a> {
fn announce_and_return_part(&self, announcement: &str) -> &str {
println!("Attention please: {announcement}");
self.part
}
}
fn main() {
let novel = String::from("Call me Ishmael. Some years ago...");
let first_sentence = novel.split('.').next().unwrap();
let i = ImportantExcerpt {
part: first_sentence,
};
}การประกาศพารามิเตอร์ไลฟ์ไทม์หลัง impl และการนำไปใช้หลังชื่อชนิดข้อมูลนั้นเป็นสิ่งจำเป็น แต่ด้วยกฎการละไลฟ์ไทม์ข้อแรก เราจึงไม่จำเป็นต้องระบุไลฟ์ไทม์ให้กับเรเฟอเรนซ์ที่ชี้ไปยัง self เลย
ต่อไปนี้เป็นตัวอย่างที่กฎการละไลฟ์ไทม์ข้อที่สามถูกนำมาใช้งาน:
struct ImportantExcerpt<'a> {
part: &'a str,
}
impl<'a> ImportantExcerpt<'a> {
fn level(&self) -> i32 {
3
}
}
impl<'a> ImportantExcerpt<'a> {
fn announce_and_return_part(&self, announcement: &str) -> &str {
println!("Attention please: {announcement}");
self.part
}
}
fn main() {
let novel = String::from("Call me Ishmael. Some years ago...");
let first_sentence = novel.split('.').next().unwrap();
let i = ImportantExcerpt {
part: first_sentence,
};
}ในที่นี้มีไลฟ์ไทม์ขาเข้าสองตัว Rust จึงนำกฎการละไลฟ์ไทม์ข้อแรกมาใช้ โดยกำหนดไลฟ์ไทม์เฉพาะตัวให้กับทั้ง &self และ announcement จากนั้น เมื่อพิจารณาว่ามีพารามิเตอร์ตัวหนึ่งเป็น &self ชนิดข้อมูลที่ส่งคืนจึงได้รับไลฟ์ไทม์ของ &self ไปโดยอัตโนมัติ ทำให้เรเฟอเรนซ์ทั้งหมดได้รับการระบุไลฟ์ไทม์อย่างครบถ้วนสมบูรณ์
ไลฟ์ไทม์ 'static
ไลฟ์ไทม์พิเศษตัวหนึ่งที่เราต้องกล่าวถึงคือ 'static ซึ่งระบุว่าเรเฟอเรนซ์ดังกล่าว สามารถ มีอายุอยู่ได้ตลอดระยะเวลาการทำงานทั้งหมดของโปรแกรม โดยสตริงลิเทอรัล (string literal) ทั้งหมดต่างก็มีไลฟ์ไทม์เป็น 'static ซึ่งเราสามารถเขียนกำกับได้ดังนี้:
#![allow(unused)]
fn main() {
let s: &'static str = "I have a static lifetime.";
}ข้อความของสตริงนี้จะถูกฝังและจัดเก็บไว้ในไฟล์ไบนารีของโปรแกรมโดยตรง ซึ่งพร้อมใช้งานอยู่ตลอดเวลา ดังนั้น ไลฟ์ไทม์ของสตริงลิเทอรัลทุกตัวจึงเป็น 'static เสมอ
คุณอาจเคยเห็นคำแนะนำในข้อความแสดงข้อผิดพลาดที่บอกให้ลองใช้ไลฟ์ไทม์ 'static แต่ก่อนที่คุณจะระบุ 'static ให้กับเรเฟอเรนซ์ใดๆ ควรไตร่ตรองให้รอบคอบก่อนว่าเรเฟอเรนซ์นั้นจำเป็นต้องมีชีวิตอยู่ตลอดอายุการทำงานของโปรแกรมจริงๆ หรือไม่ และคุณต้องการให้เป็นเช่นนั้นจริงหรือ เพราะส่วนใหญ่แล้ว ข้อความแสดงข้อผิดพลาดที่แนะนำให้ใช้ไลฟ์ไทม์ 'static มักเกิดจากความพยายามสร้าง dangling reference หรือเกิดจากไลฟ์ไทม์ที่มีอยู่ไม่สอดคล้องกัน ในกรณีเช่นนั้น วิธีแก้ที่ถูกต้องคือการจัดการกับปัญหาความสัมพันธ์ของไลฟ์ไทม์ ไม่ใช่การแก้ปัญหาเฉพาะหน้าด้วยการยัดเยียดไลฟ์ไทม์ 'static ลงไป
พารามิเตอร์ชนิดข้อมูลแบบเจเนอริก บาวด์ของเทรต และไลฟ์ไทม์
มาดูวากยสัมพันธ์ในการระบุทั้งพารามิเตอร์ชนิดข้อมูลแบบเจเนอริก บาวด์ของเทรต (trait bound) และไลฟ์ไทม์พร้อมกันทั้งหมดในฟังก์ชันเดียวกันอย่างกระชับกัน!
fn main() {
let string1 = String::from("abcd");
let string2 = "xyz";
let result = longest_with_an_announcement(
string1.as_str(),
string2,
"Today is someone's birthday!",
);
println!("The longest string is {result}");
}
use std::fmt::Display;
fn longest_with_an_announcement<'a, T>(
x: &'a str,
y: &'a str,
ann: T,
) -> &'a str
where
T: Display,
{
println!("Announcement! {ann}");
if x.len() > y.len() { x } else { y }
}นี่คือฟังก์ชัน longest จากลิสติ้ง 10-21 ที่ส่งคืนสตริงสไลซ์ที่ยาวกว่าระหว่างสองตัว แต่คราวนี้มีพารามิเตอร์เพิ่มเติมชื่อ ann ซึ่งมีชนิดข้อมูลเจเนอริก T โดยสามารถเป็นชนิดข้อมูลใดก็ได้ที่อิมพลีเมนต์เทรต Display ตามที่ระบุไว้ในอนุประโยค where พารามิเตอร์เพิ่มเติมนี้จะถูกนำไปพิมพ์ด้วย {} ซึ่งเป็นเหตุผลที่จำเป็นต้องมีบาวด์ของเทรต Display และเนื่องจากไลฟ์ไทม์ก็เป็นเจเนอริกรูปแบบหนึ่ง การประกาศพารามิเตอร์ไลฟ์ไทม์ 'a และพารามิเตอร์ชนิดข้อมูลแบบเจเนอริก T จึงรวมอยู่ในรายการเดียวกันภายในวงเล็บสามเหลี่ยมหลังชื่อฟังก์ชัน
สรุป
เราได้เรียนรู้เนื้อหาไปมากมายในบทนี้! ตอนนี้คุณเข้าใจทั้งเรื่องพารามิเตอร์ชนิดข้อมูลแบบเจเนอริก เทรตและบาวด์ของเทรต ตลอดจนพารามิเตอร์ไลฟ์ไทม์แบบเจเนอริกแล้ว คุณจึงพร้อมที่จะเขียนโค้ดที่ไม่ต้องทำซ้ำซ้อนและสามารถทำงานได้ในสถานการณ์ที่หลากหลาย พารามิเตอร์ชนิดข้อมูลแบบเจเนอริกช่วยให้คุณนำโค้ดเดิมไปประยุกต์ใช้กับชนิดข้อมูลที่แตกต่างกันได้ เทรตและบาวด์ของเทรตช่วยรับประกันว่าแม้จะเป็นชนิดข้อมูลแบบเจเนอริก แต่พวกมันก็จะมีพฤติกรรมตามที่โค้ดต้องการ และคุณยังได้เรียนรู้วิธีการใช้การระบุไลฟ์ไทม์เพื่อรับประกันว่าโค้ดที่มีความยืดหยุ่นนี้จะไม่มี dangling reference อยู่เลยแม้แต่น้อย ที่สำคัญคือการวิเคราะห์ทั้งหมดนี้เกิดขึ้นในตอนคอมไพล์ จึงไม่ส่งผลกระทบต่อประสิทธิภาพการทำงานตอนรันไทม์เลยแม้แต่นิดเดียว!
เชื่อหรือไม่ว่า ยังมีเนื้อหาให้ศึกษาเพิ่มเติมอีกมากเกี่ยวกับหัวข้อที่เราได้พูดคุยกันในบทนี้: ในบทที่ 18 เราจะพูดถึงเทรตออบเจกต์ (trait objects) ซึ่งเป็นอีกหนึ่งวิธีในการใช้งานเทรต นอกจากนี้ยังมีสถานการณ์ที่ซับซ้อนยิ่งขึ้นเกี่ยวกับการระบุไลฟ์ไทม์ ซึ่งคุณจะได้ใช้งานเฉพาะในกรณีขั้นสูงจริงๆ สำหรับหัวข้อเหล่านั้น คุณสามารถศึกษาเพิ่มเติมได้จาก Rust Reference แต่ในบทถัดไป คุณจะได้เรียนรู้วิธีการเขียนชุดทดสอบ (tests) ใน Rust เพื่อให้มั่นใจได้ว่าโค้ดของคุณจะทำงานได้อย่างถูกต้องตามที่คาดหวังเสมอ
การเขียนเทสต์อัตโนมัติ
ในเรียงความปี 1972 หัวข้อ “The Humble Programmer” ของเขา Edsger W. Dijkstra ได้กล่าวไว้ว่า “การทดสอบโปรแกรม (program testing) เป็นวิธีที่มีประสิทธิภาพอย่างยิ่งในการแสดงให้เห็นว่ามีบั๊กอยู่ แต่กลับไม่อาจพิสูจน์ได้เลยว่าโปรแกรมนั้นปลอดบั๊กอย่างแท้จริง” กระนั้น ก็ไม่ได้หมายความว่าเราไม่ควรพยายามทดสอบโค้ดให้มากที่สุดเท่าที่จะทำได้!
ความถูกต้อง (correctness) ของโปรแกรม หมายถึงระดับที่โค้ดของเราสามารถทำงานได้ตรงตามสิ่งที่เราตั้งใจให้ทำอย่างแท้จริง ภาษา Rust ได้รับการออกแบบโดยให้ความสำคัญอย่างยิ่งยวดกับความถูกต้องของโปรแกรม แต่ความถูกต้องเป็นเรื่องซับซ้อนและพิสูจน์ได้ไม่ง่ายนัก แม้ว่าระบบชนิดข้อมูลของ Rust จะช่วยแบกรับภาระส่วนใหญ่ตรงนี้ไป แต่ระบบชนิดข้อมูลก็ไม่สามารถดักจับข้อผิดพลาดเชิงตรรกะได้ทั้งหมด ด้วยเหตุนี้ Rust จึงมีเครื่องมือสนับสนุนการเขียนชุดทดสอบซอฟต์แวร์แบบอัตโนมัติมาให้ในตัว
สมมติว่าเราเขียนฟังก์ชัน add_two เพื่อนำ 2 ไปบวกเข้ากับตัวเลขใดๆ ก็ตามที่ส่งเข้ามา ซิกเนเจอร์ของฟังก์ชันนี้จะรับเลขจำนวนเต็มเป็นพารามิเตอร์และส่งคืนผลลัพธ์เป็นเลขจำนวนเต็ม เมื่อเราอิมพลีเมนต์และคอมไพล์ฟังก์ชันดังกล่าว Rust จะทำการตรวจสอบชนิดข้อมูล (type checking) และตรวจสอบการยืม (borrow checking) ทั้งหมดตามที่คุณได้เรียนรู้มาจนถึงตอนนี้ เพื่อให้แน่ใจว่า เช่น เราไม่ได้ส่งค่า String หรือเรเฟอเรนซ์ที่ไม่ถูกต้องเข้าไปในฟังก์ชัน แต่ Rust ไม่สามารถ ตรวจสอบได้ว่าฟังก์ชันนี้ทำงานได้ตรงตามเจตนาของเราอย่างแม่นยำหรือไม่ ซึ่งในที่นี้คือการส่งคืนค่าพารามิเตอร์บวก 2 ไม่ใช่พารามิเตอร์บวก 10 หรือพารามิเตอร์ลบ 50! และนี่คือจุดที่การทดสอบ (test) เข้ามามีบทบาทสำคัญ
เราสามารถเขียนเทสต์เพื่อยืนยันว่า เช่น เมื่อเราส่งค่า 3 ให้กับฟังก์ชัน add_two ค่าที่ได้กลับคืนมาจะต้องเป็น 5 เสมอ และเราสามารถรันชุดทดสอบเหล่านี้ได้ทุกครั้งที่มีการแก้ไขโค้ด เพื่อให้มั่นใจได้ว่าพฤติกรรมที่ถูกต้องซึ่งมีอยู่เดิมจะไม่ผิดเพี้ยนไป
การทดสอบซอฟต์แวร์เป็นทักษะที่มีความลึกซึ้งและซับซ้อน แม้ว่าเราไม่อาจครอบคลุมรายละเอียดทุกแง่มุมของการเขียนเทสต์ที่ดีได้ภายในบทเดียว แต่ในบทนี้เราจะมาเจาะลึกกลไกและเครื่องมืออำนวยความสะดวกด้านการทดสอบของ Rust เราจะพูดถึงแอตทริบิวต์กำกับ (annotations) และมาโครที่คุณสามารถนำมาใช้ในการเขียนเทสต์ พฤติกรรมเริ่มต้นและตัวเลือกต่างๆ สำหรับการสั่งรันเทสต์ รวมถึงวิธีจัดระเบียบโครงสร้างของชุดทดสอบออกเป็นยูนิตเทสต์ (unit test) และอินทิเกรชันเทสต์ (integration test)
วิธีเขียนเทสต์
วิธีเขียนเทสต์
เทสต์ (test หรือการทดสอบ) คือฟังก์ชันใน Rust ที่ทำหน้าที่ตรวจสอบว่าโค้ดส่วนอื่นๆ ที่ไม่ใช่เทสต์ทำงานได้ถูกต้องตรงตามความคาดหวังหรือไม่ โดยทั่วไปแล้ว เนื้อหาภายในฟังก์ชันเทสต์มักจะดำเนินการตาม 3 ขั้นตอนนี้:
- ตระเตรียมข้อมูลหรือสถานะ (state) ที่จำเป็น
- สั่งทำงานโค้ดส่วนที่คุณต้องการทดสอบ
- ยืนยัน (assert) ว่าผลลัพธ์ที่ได้ตรงตามสิ่งที่คุณคาดหวังไว้
มาดูฟีเจอร์ต่างๆ ที่ Rust มีให้สำหรับการเขียนเทสต์โดยเฉพาะ ซึ่งรวมถึงแอตทริบิวต์ test มาโครสำหรับการตรวจสอบค่า และแอตทริบิวต์ should_panic
โครงสร้างของฟังก์ชันเทสต์
ในรูปแบบที่เรียบง่ายที่สุด เทสต์ใน Rust คือฟังก์ชันที่กำกับไว้ด้วยแอตทริบิวต์ (attribute) test โดยแอตทริบิวต์คือข้อมูลเมทาดาทาที่ใช้อธิบายส่วนต่างๆ ของโค้ด Rust ตัวอย่างเช่น แอตทริบิวต์ derive ที่เราเคยใช้กับ struct ในบทที่ 5 การจะเปลี่ยนฟังก์ชันทั่วไปให้กลายเป็นฟังก์ชันเทสต์ ทำได้โดยเพิ่ม #[test] ไว้บนบรรทัดก่อนหน้า fn เมื่อคุณสั่งรันเทสต์ด้วยคำสั่ง cargo test Rust จะคอมไพล์ไบนารีสำหรับตัวรันทดสอบ (test runner binary) ขึ้นมา เพื่อรันฟังก์ชันทั้งหมดที่มีแอตทริบิวต์นี้กำกับอยู่ พร้อมทั้งรายงานผลลัพธ์ว่าฟังก์ชันเทสต์แต่ละตัวนั้นผ่าน (pass) หรือล้มเหลว (fail)
ทุกครั้งที่เราสร้างโปรเจกต์ไลบรารีใหม่ขึ้นมาด้วย Cargo ระบบจะสร้างมอดูลเทสต์พร้อมฟังก์ชันเทสต์ตัวอย่างมาให้เราโดยอัตโนมัติ มอดูลนี้เปรียบเสมือนแม่แบบ (template) ในการเขียนเทสต์ของคุณ ช่วยให้คุณไม่ต้องคอยเปิดหาโครงสร้างและวากยสัมพันธ์ที่ถูกต้องทุกครั้งที่เริ่มโปรเจกต์ใหม่ และคุณสามารถเพิ่มฟังก์ชันเทสต์รวมถึงมอดูลเทสต์เพิ่มเติมได้มากเท่าที่ต้องการ!
เราจะมาสำรวจแง่มุมต่างๆ เกี่ยวกับการทำงานของเทสต์ด้วยการทดลองปรับแต่งเทมเพลตเทสต์นี้ดูก่อน จากนั้นเราจะเขียนชุดทดสอบสำหรับการใช้งานจริงที่เรียกใช้โค้ดที่เราเขียนขึ้น เพื่อยืนยันว่าโค้ดนั้นทำงานได้อย่างถูกต้อง
มาสร้างโปรเจกต์ไลบรารีใหม่ชื่อ adder ที่จะบวกตัวเลขสองตัวกัน:
$ cargo new adder --lib
Created library `adder` project
$ cd adder
เนื้อหาของไฟล์ src/lib.rs ในไลบรารี adder ของคุณควรมีหน้าตาดังลิสติ้ง 11-1
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() {
let result = add(2, 2);
assert_eq!(result, 4);
}
}ไฟล์นี้เริ่มต้นด้วยฟังก์ชัน add ตัวอย่าง เพื่อให้เรามีฟังก์ชันสำหรับนำมาทดสอบ
สำหรับตอนนี้ ขอให้เราโฟกัสเฉพาะฟังก์ชัน it_works เพียงอย่างเดียวก่อน โปรดสังเกตการกำกับด้วย #[test] แอตทริบิวต์นี้เป็นตัวบ่งบอกว่านี่คือฟังก์ชันเทสต์ ตัวรันทดสอบจึงทราบว่าจะต้องปฏิบัติต่อฟังก์ชันนี้ในฐานะการทดสอบ เราอาจมีฟังก์ชันที่ไม่ใช่เทสต์อยู่ภายในมอดูล tests ด้วย เพื่อช่วยเตรียมสถานการณ์จำลองหรือดำเนินการทั่วไป ดังนั้นเราจึงจำเป็นต้องระบุให้ชัดเจนเสมอว่าฟังก์ชันใดบ้างที่เป็นเทสต์
เนื้อหาภายในฟังก์ชันตัวอย่างจะใช้มาโคร assert_eq! เพื่อยืนยันว่า result ซึ่งเก็บผลลัพธ์จากการเรียก add ด้วยค่า 2 และ 2 มีค่าเท่ากับ 4 การตรวจสอบแบบยืนยันค่า (assertion) นี้เป็นตัวอย่างรูปแบบของเทสต์ทั่วไป มาลองรันคำสั่งเพื่อดูว่าเทสต์นี้ผ่านหรือไม่
คำสั่ง cargo test รันเทสต์ทั้งหมดในโปรเจกต์ของเรา ดังที่แสดงในลิสติ้ง 11-2
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.57s
Running unittests src/lib.rs (target/debug/deps/adder-01ad14159ff659ab)
running 1 test
test tests::it_works ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Cargo ได้คอมไพล์และรันเทสต์เรียบร้อยแล้ว เราจะเห็นบรรทัด running 1 test บรรทัดถัดมาแสดงชื่อของฟังก์ชันเทสต์ที่ถูกสร้างขึ้นคือ tests::it_works และผลลัพธ์ของการรันเทสต์นั้นคือ ok ส่วนข้อความสรุปภาพรวม test result: ok. หมายความว่าเทสต์ทั้งหมดผ่าน และข้อความ 1 passed; 0 failed เป็นการสรุปยอดรวมของจำนวนเทสต์ที่ผ่านหรือล้มเหลว
เราสามารถทำเครื่องหมายให้ข้าม (ignore) เทสต์บางตัวได้ เพื่อไม่ให้ถูกรันในแต่ละรอบ ซึ่งเราจะอธิบายเรื่องนี้ในหัวข้อ“การข้ามเทสต์เว้นแต่จะถูกร้องขออย่างเจาะจง” ในช่วงถัดไปของบทนี้ และเนื่องจากตอนนี้เรายังไม่ได้ข้ามเทสต์ใดๆ ข้อความสรุปจึงแสดง 0 ignored นอกจากนี้ เรายังสามารถส่งอาร์กิวเมนต์ให้กับคำสั่ง cargo test เพื่อเลือกสั่งรันเฉพาะเทสต์ที่มีชื่อตรงกับข้อความที่ระบุได้ ซึ่งสิ่งนี้เรียกว่า_การกรอง_ (filtering) โดยจะกล่าวถึงในหัวข้อ“การรันเทสต์บางส่วนตามชื่อ” ในที่นี้เราไม่ได้กรองเทสต์ใดๆ ออก ท้ายบรรทัดสรุปจึงแสดง 0 filtered out
สถิติ 0 measured มีไว้สำหรับเทสต์วัดประสิทธิภาพ (benchmark tests) ซึ่ง ณ ตอนที่เขียนนี้ เบนช์มาร์กเทสต์มีให้ใช้งานเฉพาะใน Rust เวอร์ชัน nightly เท่านั้น สามารถดูรายละเอียดเพิ่มเติมได้ที่เอกสารเกี่ยวกับเทสต์แบบเบนช์มาร์ก
ส่วนถัดไปของเอาต์พุตที่ขึ้นต้นด้วย Doc-tests adder เป็นผลลัพธ์ของด็อกเทสต์ (documentation tests) แม้ว่าตอนนี้เราจะยังไม่ได้เขียนด็อกเทสต์ไว้ แต่ Rust มีความสามารถในการนำตัวอย่างโค้ดที่ปรากฏอยู่ในเอกสารประกอบ API มาคอมไพล์และทดสอบได้ ฟีเจอร์นี้ช่วยให้เอกสารและโค้ดของคุณตรงกันอยู่เสมอ! เราจะพูดถึงวิธีการเขียนด็อกเทสต์ในหัวข้อ“คอมเมนต์เอกสารประกอบในฐานะเทสต์” ของบทที่ 14 แต่ในตอนนี้เราจะข้ามผลลัพธ์ในส่วน Doc-tests ไปก่อน
มาเริ่มปรับแต่งเทสต์ให้ตรงตามความต้องการของเรากัน อันดับแรก ให้เปลี่ยนชื่อฟังก์ชัน it_works เป็นชื่ออื่น เช่น exploration ดังนี้:
ชื่อไฟล์: src/lib.rs
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn exploration() {
let result = add(2, 2);
assert_eq!(result, 4);
}
}จากนั้นรัน cargo test อีกครั้ง เอาต์พุตจะแสดงชื่อ exploration แทนที่ it_works:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.59s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::exploration ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
คราวนี้เราจะเพิ่มเทสต์อีกตัวหนึ่ง แต่รอบนี้เราจะตั้งใจสร้างเทสต์ที่ล้มเหลว! เทสต์จะถือว่าล้มเหลวเมื่อมีบางอย่างในฟังก์ชันเทสต์เกิดการแพนิก (panic) ขึ้น โดยเทสต์แต่ละตัวจะถูกรันแยกในเธรด (thread) ใหม่ และเมื่อเธรดหลักตรวจพบว่าเธรดของเทสต์ตัวนั้นยุติลงอย่างกะทันหัน เทสต์ดังกล่าวก็จะถูกบันทึกว่าล้มเหลว ในบทที่ 9 เราได้เรียนรู้ไปแล้วว่าวิธีที่ง่ายที่สุดในการทำให้เกิดการแพนิกก็คือการเรียกใช้มาโคร panic! ให้เพิ่มฟังก์ชันเทสต์ใหม่ชื่อ another เพื่อให้ไฟล์ src/lib.rs ของคุณมีลักษณะดังลิสติ้ง 11-3
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn exploration() {
let result = add(2, 2);
assert_eq!(result, 4);
}
#[test]
fn another() {
panic!("Make this test fail");
}
}รันเทสต์อีกครั้งโดยใช้ cargo test เอาต์พุตควรมีหน้าตาดังลิสติ้ง 11-4 ซึ่งแสดงว่าเทสต์ exploration ของเราผ่านและ another ล้มเหลว
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.72s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 2 tests
test tests::another ... FAILED
test tests::exploration ... ok
failures:
---- tests::another stdout ----
thread 'tests::another' (6019162) panicked at src/lib.rs:17:9:
Make this test fail
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::another
test result: FAILED. 1 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
แทนที่จะแสดงผลลัพธ์เป็น ok บรรทัด test tests::another กลับแสดงเป็น FAILED และมีส่วนแสดงผลใหม่ 2 ส่วนปรากฏขึ้นคั่นระหว่างผลลัพธ์รายตัวกับข้อความสรุป: ส่วนแรกจะแสดงเหตุผลอย่างละเอียดของความล้มเหลวในแต่ละเทสต์ ในที่นี้เราระบุรายละเอียดได้ว่า tests::another ล้มเหลวเพราะเกิดการแพนิกพร้อมข้อความ Make this test fail ที่บรรทัดที่ 17 ของไฟล์ src/lib.rs ส่วนถัดมาจะสรุปเฉพาะรายชื่อของเทสต์ทั้งหมดที่ล้มเหลว ซึ่งมีประโยชน์มากเมื่อชุดทดสอบมีจำนวนมากและมีข้อความแสดงความล้มเหลวที่ยาวเหยียด เราสามารถนำชื่อของเทสต์ที่ล้มเหลวนี้ไปใช้สั่งรันเฉพาะเทสต์นั้นเพื่อดีบักโค้ดได้ง่ายขึ้น เราจะพูดถึงวิธีควบคุมการรันเทสต์เพิ่มเติมในหัวข้อ“ควบคุมวิธีการรันเทสต์”
บรรทัดสรุปภาพรวมจะแสดงที่ตอนท้ายสุด: โดยรวมแล้วผลลัพธ์ของเทสต์คือ FAILED โดยเรามีเทสต์ที่ผ่าน 1 ตัว และเทสต์ที่ล้มเหลว 1 ตัว
เมื่อคุณได้เห็นหน้าตาของผลลัพธ์จากการรันเทสต์ในสถานการณ์ต่างๆ แล้ว ต่อไปเรามาดูมาโครอื่นๆ นอกเหนือจาก panic! ที่มีประโยชน์อย่างยิ่งในการเขียนเทสต์
การตรวจสอบผลลัพธ์ด้วย assert!
มาโคร assert! จากไลบรารีมาตรฐาน มีประโยชน์มากเมื่อคุณต้องการตรวจสอบให้มั่นใจว่าเงื่อนไขบางอย่างในการทดสอบให้ผลลัพธ์เป็น true เราจะส่งอาร์กิวเมนต์ที่ประเมินค่าออกมาเป็นค่าบูลีนให้กับมาโคร assert! หากค่านั้นเป็น true จะไม่มีอะไรเกิดขึ้นและเทสต์จะผ่าน แต่หากค่านั้นเป็น false มาโคร assert! จะเรียกใช้คำสั่ง panic! ส่งผลให้เทสต์นั้นล้มเหลวทันที การใช้มาโคร assert! จึงช่วยให้เราตรวจสอบยืนยันได้อย่างมั่นใจว่าโค้ดกำลังทำงานได้ตรงตามที่เราตั้งใจไว้
ในบทที่ 5 ลิสติ้ง 5-15 เราเคยใช้งาน struct Rectangle และเมธอด can_hold ซึ่งนำมาแสดงซ้ำอีกครั้งในลิสติ้ง 11-5 ให้เรานำโค้ดนี้ไปใส่ไว้ในไฟล์ src/lib.rs แล้วเขียนเทสต์สำหรับทดสอบเมธอดดังกล่าวโดยใช้มาโคร assert!
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}เมธอด can_hold จะส่งคืนค่าเป็นบูลีน ซึ่งเหมาะเจาะอย่างยิ่งกับการใช้งานร่วมกับมาโคร assert! ในลิสติ้ง 11-6 เราได้เขียนเทสต์เพื่อทดสอบเมธอด can_hold โดยสร้างอินสแตนซ์ Rectangle ที่มีความกว้าง 8 และความสูง 7 ขึ้นมา แล้วยืนยันว่ามันสามารถบรรจุอินสแตนซ์ Rectangle อีกตัวที่มีความกว้าง 5 และความสูง 1 ได้
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn larger_can_hold_smaller() {
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(larger.can_hold(&smaller));
}
}โปรดสังเกตบรรทัด use super::*; ภายในมอดูล tests มอดูล tests นั้นเป็นมอดูลธรรมดาทั่วไปที่ปฏิบัติตามกฎเรื่องการเปิดเผย (visibility) ตามที่เราได้เรียนรู้กันไปในบทที่ 7 หัวข้อ“พาธสำหรับอ้างถึงรายการในแผนผังมอดูล” และเนื่องจากมอดูล tests เป็นมอดูลชั้นใน เราจึงจำเป็นต้องนำโค้ดที่ต้องการทดสอบซึ่งอยู่ในมอดูลชั้นนอกเข้ามายังสโคปของมอดูลชั้นในนี้ การใช้เครื่องหมายดอกจัน (glob) ตรงนี้จะช่วยให้ทุกสิ่งที่เรานิยามไว้ในมอดูลชั้นนอกสามารถเรียกใช้งานในมอดูล tests ได้ทั้งหมด
เราตั้งชื่อเทสต์นี้ว่า larger_can_hold_smaller และสร้างอินสแตนซ์ Rectangle สองตัวที่ต้องการ จากนั้นจึงเรียกใช้มาโคร assert! โดยส่งผลลัพธ์ของ larger.can_hold(&smaller) ให้มัน เอ็กซ์เพรสชันนี้ควรให้ผลลัพธ์เป็น true ดังนั้นเทสต์ของเราจึงควรจะผ่าน มาลองรันดูกันเลย!
$ cargo test
Compiling rectangle v0.1.0 (file:///projects/rectangle)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.66s
Running unittests src/lib.rs (target/debug/deps/rectangle-6584c4561e48942e)
running 1 test
test tests::larger_can_hold_smaller ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests rectangle
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
มันผ่านจริงด้วย! มาเพิ่มเทสต์อีกตัว ครั้งนี้ยืนยันว่าสี่เหลี่ยมที่เล็กกว่าไม่สามารถบรรจุสี่เหลี่ยมที่ใหญ่กว่าได้:
ชื่อไฟล์: src/lib.rs
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width > other.width && self.height > other.height
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn larger_can_hold_smaller() {
// --snip--
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(larger.can_hold(&smaller));
}
#[test]
fn smaller_cannot_hold_larger() {
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(!smaller.can_hold(&larger));
}
}เนื่องจากผลลัพธ์ที่ถูกต้องของฟังก์ชัน can_hold ในกรณีนี้จะต้องเป็น false เราจึงต้องกลับค่าผลลัพธ์นั้น (negate) ด้วยตัวดำเนินการ ! ก่อนส่งให้กับมาโคร assert! ส่งผลให้เทสต์ของเราจะผ่านก็ต่อเมื่อ can_hold ส่งคืนค่า false:
$ cargo test
Compiling rectangle v0.1.0 (file:///projects/rectangle)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.66s
Running unittests src/lib.rs (target/debug/deps/rectangle-6584c4561e48942e)
running 2 tests
test tests::larger_can_hold_smaller ... ok
test tests::smaller_cannot_hold_larger ... ok
test result: ok. 2 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests rectangle
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
เทสต์ทั้งสองตัวผ่านฉลุย! คราวนี้มาดูกันว่าจะเกิดอะไรขึ้นกับผลลัพธ์ของเทสต์ หากเราลองใส่บั๊กลงไปในโค้ด เราจะลองแก้ไขการทำงานของเมธอด can_hold โดยเปลี่ยนเครื่องหมายมากกว่า (>) ให้กลายเป็นเครื่องหมายน้อยกว่า (<) ในขั้นตอนการเปรียบเทียบความกว้าง:
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
// --snip--
impl Rectangle {
fn can_hold(&self, other: &Rectangle) -> bool {
self.width < other.width && self.height > other.height
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn larger_can_hold_smaller() {
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(larger.can_hold(&smaller));
}
#[test]
fn smaller_cannot_hold_larger() {
let larger = Rectangle {
width: 8,
height: 7,
};
let smaller = Rectangle {
width: 5,
height: 1,
};
assert!(!smaller.can_hold(&larger));
}
}การรันเทสต์ตอนนี้ให้ผลลัพธ์ดังนี้:
$ cargo test
Compiling rectangle v0.1.0 (file:///projects/rectangle)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.66s
Running unittests src/lib.rs (target/debug/deps/rectangle-6584c4561e48942e)
running 2 tests
test tests::larger_can_hold_smaller ... FAILED
test tests::smaller_cannot_hold_larger ... ok
failures:
---- tests::larger_can_hold_smaller stdout ----
thread 'tests::larger_can_hold_smaller' (6020788) panicked at src/lib.rs:28:9:
assertion failed: larger.can_hold(&smaller)
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::larger_can_hold_smaller
test result: FAILED. 1 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
เทสต์ของเราสามารถตรวจจับบั๊กได้ทันที! เนื่องจาก larger.width มีค่าเป็น 8 และ smaller.width มีค่าเป็น 5 การเปรียบเทียบความกว้างใน can_hold ตอนนี้จึงได้ผลลัพธ์เป็น false: เพราะ 8 ไม่ได้น้อยกว่า 5
การทดสอบความเท่ากันด้วย assert_eq! และ assert_ne!
วิธีทั่วไปในการตรวจสอบการทำงานของโค้ดคือ การทดสอบความเท่ากันระหว่างผลลัพธ์ที่ได้จากการทำงานจริงกับค่าที่เราคาดหวังไว้ คุณสามารถทำสิ่งนี้ได้โดยใช้มาโคร assert! แล้วส่งเอ็กซ์เพรสชันที่ใช้ตัวดำเนินการเปรียบเทียบ == เข้าไป อย่างไรก็ตาม รูปแบบการทดสอบเช่นนี้พบได้บ่อยมากจนไลบรารีมาตรฐานได้จัดเตรียมมาโครคู่หนึ่งมาให้โดยเฉพาะ นั่นคือ assert_eq! และ assert_ne! เพื่อให้การทดสอบสะดวกสบายยิ่งขึ้น มาโครทั้งสองจะเปรียบเทียบอาร์กิวเมนต์ 2 ตัวเพื่อดูว่าเท่ากันหรือไม่เท่ากันตามลำดับ และที่สำคัญคือ หากการยืนยันค่านั้นล้มเหลว มาโครเหล่านี้จะพิมพ์ค่าของอาร์กิวเมนต์ทั้งสองตัวออกมาให้เห็นด้วย ซึ่งช่วยให้เราทราบได้ทันทีว่า_เหตุใด_เทสต์จึงล้มเหลว ในทางตรงกันข้าม มาโคร assert! จะบอกเพียงแค่ว่าเอ็กซ์เพรสชัน == ได้ผลลัพธ์เป็น false โดยไม่แสดงให้เห็นค่าที่นำไปสู่ผลลัพธ์ false นั้นเลย
ในลิสติ้ง 11-7 เราได้เขียนฟังก์ชันชื่อ add_two ที่จะนำ 2 ไปบวกเข้ากับพารามิเตอร์ของมัน จากนั้นจึงทำการทดสอบฟังก์ชันนี้ด้วยมาโคร assert_eq!
pub fn add_two(a: u64) -> u64 {
a + 2
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_adds_two() {
let result = add_two(2);
assert_eq!(result, 4);
}
}มาตรวจสอบว่ามันผ่านกันเถอะ!
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.58s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::it_adds_two ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
เราสร้างตัวแปรชื่อ result เพื่อเก็บผลลัพธ์จากการเรียก add_two(2) จากนั้นส่ง result และ 4 เป็นอาร์กิวเมนต์ให้กับมาโคร assert_eq! ผลการทดสอบสำหรับเทสต์นี้คือ test tests::it_adds_two ... ok ซึ่งข้อความ ok เป็นตัวบ่งชี้ว่าเทสต์ของเราผ่านเรียบร้อย!
คราวนี้มาลองใส่บั๊กลงในโค้ดเพื่อดูว่าเมื่อมาโคร assert_eq! ล้มเหลวจะมีหน้าตาเป็นอย่างไร โดยแก้ไขการทำงานของฟังก์ชัน add_two ให้บวกด้วย 3 แทน:
pub fn add_two(a: u64) -> u64 {
a + 3
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_adds_two() {
let result = add_two(2);
assert_eq!(result, 4);
}
}รันเทสต์อีกครั้ง:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.61s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::it_adds_two ... FAILED
failures:
---- tests::it_adds_two stdout ----
thread 'tests::it_adds_two' (6020955) panicked at src/lib.rs:12:9:
assertion `left == right` failed
left: 5
right: 4
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::it_adds_two
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
เทสต์ของเราตรวจจับบั๊กได้อีกแล้ว! เทสต์ tests::it_adds_two ล้มเหลว และข้อความรายงานว่าแอสเซอร์ชันที่ล้มเหลวคือ left == right พร้อมทั้งแสดงให้เห็นชัดเจนว่าค่า left และ right คืออะไร ข้อความนี้ช่วยให้เราเริ่มดีบักได้ทันที: อาร์กิวเมนต์ฝั่งซ้าย (left) ซึ่งเก็บผลลัพธ์จากการเรียก add_two(2) มีค่าเป็น 5 ในขณะที่อาร์กิวเมนต์ฝั่งขวา (right) มีค่าเป็น 4 คุณคงจินตนาการได้ว่าสิ่งนี้มีประโยชน์มหาศาลเพียงใด โดยเฉพาะเมื่อเรามีชุดทดสอบจำนวนมากที่กำลังรันอยู่
โปรดสังเกตว่า ในบางภาษาและบางเฟรมเวิร์กการทดสอบ พารามิเตอร์สำหรับฟังก์ชันตรวจสอบความเท่ากันมักจะใช้ชื่อว่า expected (ค่าที่คาดหวัง) และ actual (ค่าที่ได้จริง) ซึ่งลำดับการส่งอาร์กิวเมนต์จะมีผลต่อความหมายอย่างมาก แต่ใน Rust พารามิเตอร์เหล่านี้จะเรียกว่า left และ right ดังนั้นลำดับการส่งระหว่างค่าที่เราคาดหวังกับค่าที่โค้ดสร้างขึ้นจึงไม่มีความแตกต่างกัน เราสามารถเขียนแอสเซอร์ชันในเทสต์นี้เป็น assert_eq!(4, result) ก็ได้ ซึ่งจะให้ข้อความแสดงความล้มเหลวแบบเดียวกันว่า assertion `left == right` failed
สำหรับมาโคร assert_ne! จะผ่านเมื่อค่าสองค่าที่ส่งเข้าไปไม่เท่ากัน และจะล้มเหลวหากค่าทั้งสองเท่ากัน มาโครนี้มีประโยชน์อย่างยิ่งในกรณีที่เราไม่อาจทราบแน่ชัดว่าค่าลัพธ์_จะต้อง_เป็นอะไร แต่เรารู้ได้อย่างแน่นอนว่าค่านั้น_ต้องไม่ใช่_อะไร ตัวอย่างเช่น หากเรากำลังทดสอบฟังก์ชันที่รับประกันว่าจะต้องแปลงค่าอินพุตเป็นอย่างอื่นเสมอ แต่วิธีการแปลงขึ้นอยู่กับวันในสัปดาห์ที่เรารันเทสต์ สิ่งที่ดีที่สุดในการยืนยันผลลัพธ์อาจเป็นการตรวจสอบว่าผลลัพธ์ที่ได้ออกมาจะต้องไม่เท่ากับอินพุตเดิม
เบื้องหลังการทำงาน มาโคร assert_eq! และ assert_ne! จะใช้ตัวดำเนินการ == และ != ตามลำดับ และเมื่อแอสเซอร์ชันล้มเหลว มาโครเหล่านี้จะพิมพ์ค่าของอาร์กิวเมนต์ออกมาด้วยรูปแบบการแสดงผลแบบดีบัก (debug formatting) นั่นหมายความว่าค่าที่นำมาเปรียบเทียบกันจะต้องอิมพลีเมนต์เทรต PartialEq และ Debug เสมอ โดยชนิดข้อมูลพื้นฐานทั้งหมดรวมถึงชนิดข้อมูลส่วนใหญ่ในไลบรารีมาตรฐานต่างก็ได้อิมพลีเมนต์เทรตเหล่านี้ไว้เรียบร้อยแล้ว สำหรับ struct และ enum ที่คุณนิยามขึ้นเอง คุณจำเป็นต้องอิมพลีเมนต์ PartialEq เพื่อให้สามารถตรวจสอบความเท่ากันได้ และต้องอิมพลีเมนต์ Debug เพื่อให้สามารถพิมพ์ค่าออกมาได้เมื่อการตรวจสอบล้มเหลว เนื่องจากเทรตทั้งสองเป็นเทรตที่สามารถทำ derive ได้ (derivable traits) ดังที่กล่าวไว้ในลิสติ้ง 5-12 ของบทที่ 5 โดยทั่วไปจึงทำได้ง่ายๆ เพียงเพิ่มแอนโนเทชัน #[derive(PartialEq, Debug)] กำกับไว้ที่นิยาม struct หรือ enum ของคุณเท่านั้น ดูภาคผนวก C “เทรตที่ derive ได้” สำหรับรายละเอียดเพิ่มเติมเกี่ยวกับเทรตเหล่านี้และเทรตอื่นๆ ที่ derive ได้
การเพิ่มข้อความความล้มเหลวแบบกำหนดเอง
คุณยังสามารถเพิ่มข้อความแบบกำหนดเอง (custom message) เพื่อให้พิมพ์ออกมาพร้อมกับข้อความแจ้งความล้มเหลวได้ โดยส่งเป็นอาร์กิวเมนต์เพิ่มเติมให้กับมาโคร assert!, assert_eq!, และ assert_ne! อาร์กิวเมนต์ใดๆ ที่ใส่ต่อท้ายอาร์กิวเมนต์บังคับจะถูกส่งต่อไปยังมาโคร format! (ซึ่งเราเคยพูดถึงใน“การเชื่อมด้วย + หรือ format!” ในบทที่ 8) คุณจึงสามารถส่งสตริงรูปแบบ (format string) ที่มีตัวยึดตำแหน่ง {} พร้อมค่าที่จะนำไปแทนที่ในตัวยึดตำแหน่งเหล่านั้นได้ ข้อความกำหนดเองเหล่านี้มีประโยชน์อย่างมากในการอธิบายความหมายของแอสเซอร์ชันนั้นๆ เมื่อเทสต์เกิดล้มเหลว คุณจะเข้าใจได้รวดเร็วยิ่งขึ้นว่าปัญหาที่แท้จริงของโค้ดคืออะไร
ตัวอย่างเช่น สมมติว่าเรามีฟังก์ชันสำหรับกล่าวคำทักทายผู้คนตามชื่อ และเราต้องการทดสอบว่าชื่อที่เราส่งเข้าไปในฟังก์ชันปรากฏอยู่ในข้อความเอาต์พุตจริงๆ หรือไม่:
ชื่อไฟล์: src/lib.rs
pub fn greeting(name: &str) -> String {
format!("Hello {name}!")
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn greeting_contains_name() {
let result = greeting("Carol");
assert!(result.contains("Carol"));
}
}ข้อกำหนด (requirements) ของโปรแกรมนี้ยังไม่ได้ข้อสรุปที่แน่นอน และเราค่อนข้างมั่นใจว่าข้อความ Hello ในช่วงต้นของคำทักทายอาจมีการเปลี่ยนแปลงในภายหลัง เราจึงไม่อยากต้องมาคอยอัปเดตเทสต์ทุกครั้งที่ข้อกำหนดเปลี่ยน ดังนั้นแทนที่จะตรวจสอบความเท่ากันแบบตรงตัวทุกตัวอักษรกับค่าที่ส่งคืนจากฟังก์ชัน greeting เราจะเลือกตรวจสอบเพียงว่าข้อความเอาต์พุตมีชื่อจากพารามิเตอร์อินพุตรวมอยู่ด้วยหรือไม่
คราวนี้มาลองใส่บั๊กลงในโค้ด โดยเปลี่ยนฟังก์ชัน greeting ไม่ให้นำ name ไปใส่ในผลลัพธ์ เพื่อดูว่าข้อความความล้มเหลวเริ่มต้นของเทสต์จะมีหน้าตาเป็นอย่างไร:
pub fn greeting(name: &str) -> String {
String::from("Hello!")
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn greeting_contains_name() {
let result = greeting("Carol");
assert!(result.contains("Carol"));
}
}การรันเทสต์นี้ให้ผลลัพธ์ดังนี้:
$ cargo test
Compiling greeter v0.1.0 (file:///projects/greeter)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.91s
Running unittests src/lib.rs (target/debug/deps/greeter-170b942eb5bf5e3a)
running 1 test
test tests::greeting_contains_name ... FAILED
failures:
---- tests::greeting_contains_name stdout ----
thread 'tests::greeting_contains_name' (6021143) panicked at src/lib.rs:12:9:
assertion failed: result.contains("Carol")
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::greeting_contains_name
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
ผลลัพธ์นี้บอกเพียงแค่ว่าแอสเซอร์ชันล้มเหลวและอยู่ที่บรรทัดใด แต่ข้อความความล้มเหลวที่มีประโยชน์กว่านั้นควรจะพิมพ์ค่าที่ได้จริงจากฟังก์ชัน greeting ออกมาด้วย ให้เราเพิ่มข้อความแจ้งความล้มเหลวแบบกำหนดเอง ซึ่งประกอบด้วยสตริงรูปแบบที่มีตัวยึดตำแหน่งสำหรับใส่ค่าจริงที่ได้รับจากฟังก์ชัน greeting:
pub fn greeting(name: &str) -> String {
String::from("Hello!")
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn greeting_contains_name() {
let result = greeting("Carol");
assert!(
result.contains("Carol"),
"Greeting did not contain name, value was `{result}`"
);
}
}ตอนนี้เมื่อเรารันเทสต์ เราจะได้ข้อความแสดงข้อผิดพลาดที่ให้ข้อมูลมากกว่าเดิม:
$ cargo test
Compiling greeter v0.1.0 (file:///projects/greeter)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.93s
Running unittests src/lib.rs (target/debug/deps/greeter-170b942eb5bf5e3a)
running 1 test
test tests::greeting_contains_name ... FAILED
failures:
---- tests::greeting_contains_name stdout ----
thread 'tests::greeting_contains_name' (6021333) panicked at src/lib.rs:12:9:
Greeting did not contain name, value was `Hello!`
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::greeting_contains_name
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
เราสามารถมองเห็นค่าที่ได้รับมาจริงๆ ในเอาต์พุตของเทสต์ ซึ่งช่วยให้เราดีบักได้ทันทีว่าเกิดอะไรขึ้น แทนที่จะเห็นแค่สิ่งที่เราคาดหวังว่าจะเกิดขึ้น
การตรวจสอบการแพนิกด้วย should_panic
นอกเหนือจากการตรวจสอบค่าที่ส่งคืนแล้ว การตรวจสอบว่าโค้ดของเราจัดการกับเงื่อนไขข้อผิดพลาดได้อย่างถูกต้องตามที่คาดหวังหรือไม่ก็มีความสำคัญไม่แพ้กัน ตัวอย่างเช่น ชนิดข้อมูล Guess ที่เราสร้างขึ้นในบทที่ 9 ลิสติ้ง 9-13 โค้ดส่วนอื่นๆ ที่เรียกใช้ Guess จะพึ่งพาการรับประกันว่าอินสแตนซ์ของ Guess จะเก็บเฉพาะค่าที่อยู่ระหว่าง 1 ถึง 100 เท่านั้น เราจึงสามารถเขียนเทสต์เพื่อตรวจสอบให้มั่นใจได้ว่าความพยายามสร้างอินสแตนซ์ Guess ด้วยค่าที่อยู่นอกช่วงดังกล่าวจะต้องเกิดการแพนิกขึ้น
เราทำเช่นนี้ได้โดยการเพิ่มแอตทริบิวต์ should_panic ให้กับฟังก์ชันเทสต์ เทสต์จะถือว่าผ่านหากโค้ดภายในฟังก์ชันเกิดการแพนิก และจะถือว่าล้มเหลวหากโค้ดภายในฟังก์ชันไม่เกิดการแพนิก
ลิสติ้ง 11-8 แสดงเทสต์ที่ตรวจสอบว่าเงื่อนไขข้อผิดพลาดของ Guess::new เกิดขึ้นเมื่อเราคาดหวังให้มันเกิดขึ้น
pub struct Guess {
value: i32,
}
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 || value > 100 {
panic!("Guess value must be between 1 and 100, got {value}.");
}
Guess { value }
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
#[should_panic]
fn greater_than_100() {
Guess::new(200);
}
}เราจะวางแอตทริบิวต์ #[should_panic] ไว้ถัดจากแอตทริบิวต์ #[test] บนบรรทัดก่อนหน้าฟังก์ชันเทสต์ที่ต้องการใช้ มาดูผลลัพธ์เมื่อเทสต์นี้ผ่าน:
$ cargo test
Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.58s
Running unittests src/lib.rs (target/debug/deps/guessing_game-57d70c3acb738f4d)
running 1 test
test tests::greater_than_100 - should panic ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests guessing_game
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
ดูดี! ตอนนี้มาใส่บั๊กในโค้ดของเราโดยลบเงื่อนไขที่ว่าฟังก์ชัน new จะแพนิกหากค่ามากกว่า 100:
pub struct Guess {
value: i32,
}
// --snip--
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 {
panic!("Guess value must be between 1 and 100, got {value}.");
}
Guess { value }
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
#[should_panic]
fn greater_than_100() {
Guess::new(200);
}
}เมื่อเรารันเทสต์ในลิสติ้ง 11-8 มันจะล้มเหลว:
$ cargo test
Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.62s
Running unittests src/lib.rs (target/debug/deps/guessing_game-57d70c3acb738f4d)
running 1 test
test tests::greater_than_100 - should panic ... FAILED
failures:
---- tests::greater_than_100 stdout ----
note: test did not panic as expected at src/lib.rs:21:8
failures:
tests::greater_than_100
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
ในกรณีนี้เราไม่ได้ข้อความที่ช่วยอะไรมากนัก แต่เมื่อเราดูฟังก์ชันเทสต์ เราจะเห็นว่ามันถูกกำกับด้วย #[should_panic] ความล้มเหลวที่เราได้หมายความว่าโค้ดในฟังก์ชันเทสต์ไม่ได้ทำให้เกิดการแพนิก
การทดสอบด้วย should_panic เพียงอย่างเดียวอาจขาดความแม่นยำ เพราะเทสต์จะผ่านเสมอขอเพียงแค่เกิดการแพนิกขึ้น ไม่ว่าการแพนิกนั้นจะเกิดจากสาเหตุที่เราคาดไว้ หรือเกิดจากสาเหตุอื่นที่คาดไม่ถึงก็ตาม เพื่อให้เทสต์ should_panic มีความแม่นยำยิ่งขึ้น เราสามารถระบุพารามิเตอร์ expected เสริมเข้าไปในแอตทริบิวต์ should_panic ได้ โดยระบบรันทดสอบ (test harness) จะคอยตรวจสอบว่าข้อความแสดงการแพนิกนั้นมีข้อความที่เรากำหนดไว้รวมอยู่ด้วยหรือไม่ ตัวอย่างเช่น โค้ดของ Guess ที่ปรับปรุงใหม่ในลิสติ้ง 11-9 ซึ่งฟังก์ชัน new จะแพนิกด้วยข้อความที่แตกต่างกัน ขึ้นอยู่กับว่าค่าที่ส่งเข้ามามีขนาดเล็กเกินไปหรือใหญ่เกินไป
pub struct Guess {
value: i32,
}
// --snip--
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 {
panic!(
"Guess value must be greater than or equal to 1, got {value}."
);
} else if value > 100 {
panic!(
"Guess value must be less than or equal to 100, got {value}."
);
}
Guess { value }
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
#[should_panic(expected = "less than or equal to 100")]
fn greater_than_100() {
Guess::new(200);
}
}เทสต์นี้จะผ่านได้เนื่องจากค่าที่เราระบุไว้ในพารามิเตอร์ expected ของแอตทริบิวต์ should_panic เป็นสตริงย่อย (substring) ของข้อความที่ฟังก์ชัน Guess::new แพนิกออกมา เราจะเลือกใส่ข้อความแพนิกแบบเต็มทั้งหมดตามที่คาดหวังก็ได้ ซึ่งในกรณีนี้คือ Guess value must be less than or equal to 100, got 200 สิ่งที่คุณเลือกระบุขึ้นอยู่กับว่าข้อความแพนิกส่วนไหนที่มีความเฉพาะเจาะจงหรือมีการเปลี่ยนแปลงตามตัวแปร และคุณต้องการให้การทดสอบมีความแม่นยำเพียงใด ในกรณีนี้ เพียงแค่สตริงย่อยของข้อความแพนิกก็เพียงพอที่จะยืนยันได้แล้วว่าโค้ดในฟังก์ชันเทสต์ได้ทำงานตรงตามกรณี else if value > 100 จริงๆ
เพื่อดูว่าจะเกิดอะไรขึ้นเมื่อเทสต์ should_panic ที่มีข้อความ expected ล้มเหลว มาลองใส่บั๊กลงในโค้ดอีกครั้ง โดยสลับเนื้อหาภายในบล็อก if value < 1 กับ else if value > 100:
pub struct Guess {
value: i32,
}
impl Guess {
pub fn new(value: i32) -> Guess {
if value < 1 {
panic!(
"Guess value must be less than or equal to 100, got {value}."
);
} else if value > 100 {
panic!(
"Guess value must be greater than or equal to 1, got {value}."
);
}
Guess { value }
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
#[should_panic(expected = "less than or equal to 100")]
fn greater_than_100() {
Guess::new(200);
}
}ครั้งนี้เมื่อเรารันเทสต์ should_panic มันจะล้มเหลว:
$ cargo test
Compiling guessing_game v0.1.0 (file:///projects/guessing_game)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.66s
Running unittests src/lib.rs (target/debug/deps/guessing_game-57d70c3acb738f4d)
running 1 test
test tests::greater_than_100 - should panic ... FAILED
failures:
---- tests::greater_than_100 stdout ----
thread 'tests::greater_than_100' (6021675) panicked at src/lib.rs:12:13:
Guess value must be greater than or equal to 1, got 200.
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
note: panic did not contain expected string
panic message: "Guess value must be greater than or equal to 1, got 200."
expected substring: "less than or equal to 100"
failures:
tests::greater_than_100
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
ข้อความแสดงความล้มเหลวชี้แจงว่า เทสต์นี้เกิดการแพนิกขึ้นจริงๆ ตามที่คาดไว้ แต่ข้อความของการแพนิกกลับไม่มีสตริงที่คาดหวังคือ less than or equal to 100 รวมอยู่ด้วย โดยข้อความแพนิกที่เราได้รับจริงในกรณีนี้คือ Guess value must be greater than or equal to 1, got 200 ตอนนี้เราจึงรู้จุดเริ่มต้นในการตามหาบั๊กในโค้ดของเราได้ทันที!
การใช้ Result<T, E> ในเทสต์
เทสต์ทั้งหมดที่เราเขียนมาจนถึงตอนนี้จะใช้วิธีการแพนิกเมื่อการทดสอบล้มเหลว แต่เรายังสามารถเขียนเทสต์โดยใช้ชนิดข้อมูล Result<T, E> ได้อีกด้วย! นี่คือเทสต์จากลิสติ้ง 11-1 ที่ถูกเขียนขึ้นใหม่ให้ใช้ Result<T, E> และส่งคืนค่า Err แทนที่จะเป็นการแพนิก:
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() -> Result<(), String> {
let result = add(2, 2);
if result == 4 {
Ok(())
} else {
Err(String::from("two plus two does not equal four"))
}
}
}ฟังก์ชัน it_works ในตอนนี้มีชนิดข้อมูลที่ส่งคืนเป็น Result<(), String> โดยภายในเนื้อหาของฟังก์ชัน แทนที่เราจะเรียกใช้มาโคร assert_eq! เราจะส่งคืน Ok(()) เมื่อเทสต์ผ่าน และส่งคืน Err ที่บรรจุข้อความ String ไว้ข้างในเมื่อเทสต์ล้มเหลว
การเขียนเทสต์ให้ส่งคืน Result<T, E> ช่วยให้คุณสามารถใช้งานตัวดำเนินการเครื่องหมายคำถาม (?) ภายในเนื้อหาของเทสต์ได้ ซึ่งเป็นวิธีที่สะดวกมากในการเขียนเทสต์ที่ควรล้มเหลวทันทีหากมีการดำเนินการใดๆ ภายในส่งคืนวาเรียนต์ Err ออกมา
คุณไม่สามารถใช้แอนโนเทชัน #[should_panic] กับเทสต์ที่ใช้ Result<T, E> ได้ หากต้องการยืนยันว่าการดำเนินการหนึ่งคืนค่าวาเรียนต์ Err อย่า ใช้ตัวดำเนินการเครื่องหมายคำถามกับค่า Result<T, E> แต่ให้ใช้ assert!(value.is_err()) แทน
เมื่อคุณได้เรียนรู้วิธีการเขียนเทสต์หลากหลายรูปแบบแล้ว ต่อไปเรามาดูสิ่งที่เกิดขึ้นเมื่อสั่งรันเทสต์ และสำรวจตัวเลือกคำสั่งต่างๆ ที่เราสามารถใช้งานร่วมกับ cargo test ได้
ควบคุมวิธีการรันเทสต์
ควบคุมวิธีการรันเทสต์
เช่นเดียวกับที่คำสั่ง cargo run จะคอมไพล์โค้ดของคุณแล้วสั่งรันไฟล์ไบนารีผลลัพธ์ คำสั่ง cargo test ก็จะคอมไพล์โค้ดของคุณในโหมดทดสอบ (test mode) แล้วสั่งรันไฟล์ไบนารีสำหรับการทดสอบผลลัพธ์เช่นกัน โดยพฤติกรรมเริ่มต้นของไบนารีที่ cargo test สร้างขึ้นคือจะรันเทสต์ทั้งหมดแบบคู่ขนาน (parallel) และจะดักจับ (capture) เอาต์พุตทั้งหมดที่เกิดขึ้นในระหว่างการรันเทสต์เอาไว้ ไม่ให้แสดงออกมาในเทอร์มินัล เพื่อให้อ่านผลลัพธ์สรุปของเทสต์ได้ง่ายและเป็นระเบียบ อย่างไรก็ดี คุณสามารถระบุตัวเลือกผ่านคอมมานด์ไลน์เพื่อปรับเปลี่ยนพฤติกรรมเริ่มต้นนี้ได้ตามต้องการ
ตัวเลือกคอมมานด์ไลน์บางตัวจะถูกส่งไปยังคำสั่ง cargo test โดยตรง ในขณะที่บางตัวจะถูกส่งต่อไปยังไบนารีทดสอบ ในการแยกอาร์กิวเมนต์ทั้งสองประเภทนี้ออกจากกัน คุณจะต้องระบุอาร์กิวเมนต์ที่ส่งให้ cargo test ก่อน ตามด้วยตัวคั่น -- แล้วจึงตามด้วยตัวเลือกที่จะส่งต่อไปยังไบนารีทดสอบ การสั่งรัน cargo test --help จะแสดงตัวเลือกที่คุณสามารถใช้กับ cargo test ได้ และการรัน cargo test -- --help จะแสดงตัวเลือกที่คุณสามารถระบุต่อท้ายตัวคั่นได้ ตัวเลือกเหล่านี้ยังมีเอกสารอธิบายไว้อย่างละเอียดใน หัวข้อ “Tests” ของหนังสือ The rustc Book
การรันเทสต์แบบขนานหรือแบบทีละตัว
เมื่อคุณสั่งรันเทสต์หลายๆ ตัว โดยค่าเริ่มต้นพวกมันจะถูกรันแบบคู่ขนาน (parallel) ผ่านเธรด (threads) ซึ่งช่วยให้การรันทดสอบเสร็จสิ้นอย่างรวดเร็วและคุณได้รับผลตอบรับทันท่วงที ทว่าเนื่องจากเทสต์ต่างๆ ทำงานพร้อมกัน คุณจึงต้องมั่นใจว่าชุดทดสอบของคุณไม่มีการพึ่งพาซึ่งกันและกัน หรือพึ่งพาสถานะที่ใช้ร่วมกัน (shared state) ใดๆ รวมถึงสภาพแวดล้อมส่วนกลาง เช่น ไดเรกทอรีทำงานปัจจุบันหรือตัวแปรสภาพแวดล้อม (environment variables)
ตัวอย่างเช่น สมมติว่าเทสต์แต่ละตัวของคุณรันโค้ดที่สร้างไฟล์บนดิสก์ชื่อ test-output.txt แล้วเขียนข้อมูลบางอย่างลงไป จากนั้นเทสต์แต่ละตัวจะอ่านข้อมูลจากไฟล์นั้นขึ้นมาตรวจสอบยืนยันค่า ซึ่งแต่ละเทสต์ก็คาดหวังค่าที่แตกต่างกันออกไป เมื่อเทสต์เหล่านี้รันพร้อมกัน เทสต์ตัวหนึ่งอาจเข้าไปเขียนทับไฟล์ในช่วงจังหวะเวลาระหว่างที่อีกเทสต์หนึ่งกำลังเขียนและเตรียมอ่านไฟล์ ส่งผลให้เทสต์ตัวที่สองเกิดล้มเหลวขึ้นมา ซึ่งไม่ได้เป็นเพราะโค้ดมีข้อผิดพลาด แต่เป็นเพราะเทสต์รบกวนการทำงานซึ่งกันและกันขณะรันแบบขนาน วิธีแก้ปัญหาประการหนึ่งคือการทำให้มั่นใจว่าแต่ละเทสต์จะเขียนข้อมูลลงในไฟล์ที่ต่างกัน หรืออีกวิธีหนึ่งคือการสั่งให้เทสต์ทำงานทีละตัวตามลำดับ
หากคุณไม่ต้องการให้เทสต์ทำงานแบบขนาน หรือต้องการควบคุมจำนวนเธรดที่ใช้งานอย่างเจาะจง คุณสามารถส่งแฟล็ก --test-threads พร้อมระบุจำนวนเธรดที่ต้องการไปยังไบนารีทดสอบได้ ดังตัวอย่างต่อไปนี้:
$ cargo test -- --test-threads=1
เรากำหนดจำนวนเธรดทดสอบเป็น 1 เพื่อบอกให้โปรแกรมไม่ต้องใช้การทำงานแบบขนาน แม้ว่าการรันเทสต์ด้วยเธรดเดียวจะใช้เวลานานกว่าการรันแบบขนาน แต่ก็ช่วยให้มั่นใจได้ว่าเทสต์จะไม่รบกวนกันเองหากจำเป็นต้องใช้สถานะร่วมกัน
การแสดงเอาต์พุตของฟังก์ชัน
โดยค่าเริ่มต้น หากเทสต์นั้นผ่าน ไลบรารีการทดสอบของ Rust จะดักจับ (capture) ทุกข้อความที่พิมพ์ออกสู่เอาต์พุตมาตรฐาน (standard output) เอาไว้ ตัวอย่างเช่น หากเราเรียกใช้คำสั่ง println! ภายในเทสต์แล้วเทสต์นั้นผ่าน เราจะไม่เห็นข้อความของ println! ในเทอร์มินัลเลย โดยจะเห็นเพียงบรรทัดที่รายงานว่าเทสต์ผ่านเท่านั้น แต่หากเทสต์ล้มเหลว ข้อความทั้งหมดที่พิมพ์ออกทางเอาต์พุตมาตรฐานจะแสดงออกมาให้เห็นร่วมกับข้อความแจ้งความล้มเหลว
ตัวอย่างเช่น ในลิสติ้ง 11-10 มีฟังก์ชันสมมติที่พิมพ์ค่าของพารามิเตอร์ออกมาและส่งคืนค่า 10 พร้อมทั้งมีเทสต์ที่ผ่านและเทสต์ที่ล้มเหลวอย่างละหนึ่งตัว
fn prints_and_returns_10(a: i32) -> i32 {
println!("I got the value {a}");
10
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn this_test_will_pass() {
let value = prints_and_returns_10(4);
assert_eq!(value, 10);
}
#[test]
fn this_test_will_fail() {
let value = prints_and_returns_10(8);
assert_eq!(value, 5);
}
}เมื่อเรารันเทสต์เหล่านี้ด้วย cargo test เราจะเห็นเอาต์พุตดังนี้:
$ cargo test
Compiling silly-function v0.1.0 (file:///projects/silly-function)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.58s
Running unittests src/lib.rs (target/debug/deps/silly_function-160869f38cff9166)
running 2 tests
test tests::this_test_will_fail ... FAILED
test tests::this_test_will_pass ... ok
failures:
---- tests::this_test_will_fail stdout ----
I got the value 8
thread 'tests::this_test_will_fail' (6019863) panicked at src/lib.rs:19:9:
assertion `left == right` failed
left: 10
right: 5
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::this_test_will_fail
test result: FAILED. 1 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
โปรดสังเกตว่าในเอาต์พุตนี้ เราจะไม่พบข้อความ I got the value 4 ซึ่งเป็นข้อความที่ถูกพิมพ์ในขณะที่เทสต์ที่ผ่านกำลังทำงาน เนื่องจากเอาต์พุตนั้นถูกดักจับเอาไว้ ส่วนข้อความจากเทสต์ที่ล้มเหลวคือ I got the value 8 จะปรากฏอยู่ในส่วนสรุปของเอาต์พุต ซึ่งแสดงสาเหตุความล้มเหลวของเทสต์นั้นด้วย
หากเราต้องการดูข้อความที่พิมพ์ออกมาจากเทสต์ที่ผ่านด้วย เราสามารถบอกให้ Rust แสดงเอาต์พุตของเทสต์ที่สำเร็จออกมาได้ โดยใช้แฟล็ก --show-output:
$ cargo test -- --show-output
เมื่อเรารันเทสต์ในลิสติ้ง 11-10 อีกครั้งพร้อมกับแฟล็ก --show-output เราจะเห็นผลลัพธ์ดังนี้:
$ cargo test -- --show-output
Compiling silly-function v0.1.0 (file:///projects/silly-function)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.60s
Running unittests src/lib.rs (target/debug/deps/silly_function-160869f38cff9166)
running 2 tests
test tests::this_test_will_fail ... FAILED
test tests::this_test_will_pass ... ok
successes:
---- tests::this_test_will_pass stdout ----
I got the value 4
successes:
tests::this_test_will_pass
failures:
---- tests::this_test_will_fail stdout ----
I got the value 8
thread 'tests::this_test_will_fail' (6022313) panicked at src/lib.rs:19:9:
assertion `left == right` failed
left: 10
right: 5
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::this_test_will_fail
test result: FAILED. 1 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
การรันเทสต์บางส่วนตามชื่อ
การรันชุดทดสอบทั้งหมดในบางครั้งอาจใช้เวลานาน หากคุณกำลังพัฒนาหรือแก้ไขโค้ดเฉพาะจุดใดจุดหนึ่ง คุณอาจต้องการรันเฉพาะเทสต์ที่เกี่ยวข้องกับโค้ดส่วนนั้นเท่านั้น คุณสามารถเลือกสั่งรันเฉพาะเทสต์ที่ต้องการได้ โดยส่งชื่อของฟังก์ชันเทสต์เป็นอาร์กิวเมนต์ให้กับคำสั่ง cargo test
เพื่อสาธิตวิธีการรันเทสต์เพียงบางส่วน ก่อนอื่นเราจะสร้างเทสต์ขึ้นมา 3 ตัวสำหรับฟังก์ชัน add_two ดังที่แสดงในลิสติ้ง 11-11 แล้วลองเลือกสั่งรันเฉพาะบางตัว
pub fn add_two(a: u64) -> u64 {
a + 2
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn add_two_and_two() {
let result = add_two(2);
assert_eq!(result, 4);
}
#[test]
fn add_three_and_two() {
let result = add_two(3);
assert_eq!(result, 5);
}
#[test]
fn one_hundred() {
let result = add_two(100);
assert_eq!(result, 102);
}
}หากเราสั่งรันเทสต์โดยไม่ส่งอาร์กิวเมนต์ใดๆ เทสต์ทั้งหมดจะถูกรันแบบคู่ขนานตามที่เราเคยเห็นมาก่อน:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.62s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 3 tests
test tests::add_three_and_two ... ok
test tests::add_two_and_two ... ok
test tests::one_hundred ... ok
test result: ok. 3 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
การรันเทสต์เดี่ยว
เราสามารถส่งชื่อของฟังก์ชันเทสต์ใดๆ ให้กับ cargo test เพื่อสั่งรันเฉพาะเทสต์นั้นเพียงตัวเดียวได้:
$ cargo test one_hundred
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.69s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::one_hundred ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 2 filtered out; finished in 0.00s
มีเพียงเทสต์ชื่อ one_hundred เท่านั้นที่ถูกรัน ส่วนเทสต์อีก 2 ตัวที่มีชื่อไม่ตรงกันจะไม่ถูกนำมารัน เอาต์พุตของเทสต์จะแจ้งให้เราทราบว่ามีเทสต์อื่นๆ ที่ไม่ได้ถูกรัน โดยแสดงข้อความ 2 filtered out ที่ส่วนท้าย
เราไม่สามารถระบุชื่อของเทสต์หลายๆ ตัวพร้อมกันด้วยวิธีนี้ได้ เพราะมีเพียงค่าแรกที่ส่งให้ cargo test เท่านั้นที่จะถูกนำไปใช้ อย่างไรก็ตาม ยังมีอีกวิธีหนึ่งในการสั่งรันเทสต์หลายตัวพร้อมกัน
การกรองเพื่อรันเทสต์หลายตัว
เราสามารถระบุเพียงคำบางส่วนของชื่อเทสต์ และเทสต์ใดๆ ก็ตามที่มีชื่อตรงกับคำนั้นก็จะถูกนำมารัน ตัวอย่างเช่น เนื่องจากเทสต์ของเรามี 2 ตัวที่มีคำว่า add อยู่ในชื่อ เราจึงสามารถสั่งรันทั้งสองตัวนี้ได้ด้วยคำสั่ง cargo test add:
$ cargo test add
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.61s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 2 tests
test tests::add_three_and_two ... ok
test tests::add_two_and_two ... ok
test result: ok. 2 passed; 0 failed; 0 ignored; 0 measured; 1 filtered out; finished in 0.00s
คำสั่งนี้จะรันเทสต์ทั้งหมดที่มีคำว่า add อยู่ในชื่อ และกรองเทสต์ชื่อ one_hundred ออกไป นอกจากนี้โปรดสังเกตว่าชื่อมอดูลที่เทสต์สังกัดอยู่จะกลายมาเป็นส่วนหนึ่งของชื่อเทสต์ด้วย ดังนั้นเราจึงสามารถสั่งรันเทสต์ทั้งหมดภายในมอดูลใดมอดูลหนึ่งได้โดยการกรองด้วยชื่อของมอดูลนั้น
การข้ามเทสต์เว้นแต่จะถูกร้องขออย่างเจาะจง
ในบางครั้ง เทสต์เฉพาะบางตัวอาจต้องใช้เวลาในการทำงานนานมาก คุณจึงอาจต้องการละเว้นเทสต์เหล่านั้นในการรันคำสั่ง cargo test ประจำวัน แทนที่จะต้องมาคอยพิมพ์ชื่อเทสต์ทั้งหมดที่ต้องการรันเป็นอาร์กิวเมนต์ คุณสามารถใช้แอตทริบิวต์ ignore กำกับไว้บนเทสต์ที่ใช้เวลานานเพื่อยกเว้นการรันได้ ดังที่แสดงในตัวอย่างนี้:
ชื่อไฟล์: src/lib.rs
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() {
let result = add(2, 2);
assert_eq!(result, 4);
}
#[test]
#[ignore]
fn expensive_test() {
// code that takes an hour to run
}
}บนบรรทัดถัดจาก #[test] เราได้เพิ่ม #[ignore] ให้กับเทสต์ที่เราต้องการยกเว้น คราวนี้เมื่อเราสั่งรันเทสต์ it_works จะถูกรันตามปกติ แต่ expensive_test จะไม่ถูกรัน:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.60s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 2 tests
test tests::expensive_test ... ignored
test tests::it_works ... ok
test result: ok. 1 passed; 0 failed; 1 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
ฟังก์ชัน expensive_test จะถูกระบุสถานะเป็น ignored และหากเราต้องการสั่งรันเฉพาะเทสต์ที่ถูกข้ามไป เราสามารถสั่งได้ด้วยคำสั่ง cargo test -- --ignored:
$ cargo test -- --ignored
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.61s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::expensive_test ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 1 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
การควบคุมว่าจะให้เทสต์ใดทำงานบ้างจะช่วยให้คุณได้รับผลการทดสอบจาก cargo test อย่างรวดเร็ว และเมื่อถึงจังหวะที่เหมาะสมที่คุณต้องการตรวจสอบผลลัพธ์ของเทสต์ที่ถูก ignored ไว้ และมีเวลารอผลลัพธ์ คุณก็สามารถรัน cargo test -- --ignored ได้ และหากคุณต้องการสั่งรันเทสต์ทั้งหมดไม่ว่าตัวนั้นจะถูกทำเครื่องหมายว่าละเว้นไว้หรือไม่ก็ตาม คุณสามารถสั่งรันด้วยคำสั่ง cargo test -- --include-ignored
การจัดระเบียบเทสต์
การจัดระเบียบเทสต์
ดังที่ได้กล่าวไว้ในตอนต้นบท การทดสอบ (testing) เป็นศาสตร์ที่มีความละเอียดซับซ้อน และแต่ละคนอาจใช้คำศัพท์ตลอดจนวิธีการจัดระเบียบที่แตกต่างกันไป ในชุมชน Rust เราจะแบ่งประเภทของเทสต์ออกเป็น 2 หมวดหมู่หลัก ได้แก่: ยูนิตเทสต์ (unit tests) และอินทิเกรชันเทสต์ (integration tests) โดย ยูนิตเทสต์ จะมีขอบเขตขนาดเล็กและมุ่งเน้นความเฉพาะเจาะจง ทำหน้าที่ทดสอบแต่ละมอดูล (module) แบบแยกเดี่ยวทีละส่วน และสามารถเข้าถึงเพื่อทดสอบอินเทอร์เฟซที่เป็นส่วนตัว (private interface) ได้ ส่วน อินทิเกรชันเทสต์ จะอยู่ภายนอกไลบรารีของคุณโดยสมบูรณ์ และเรียกใช้งานโค้ดของคุณในลักษณะเดียวกับที่โค้ดภายนอกอื่นๆ ใช้งาน โดยจะเข้าถึงได้เฉพาะอินเทอร์เฟซที่เป็นสาธารณะ (public interface) เท่านั้น และเทสต์แต่ละตัวอาจครอบคลุมการทำงานร่วมกันของหลายๆ มอดูลพร้อมกัน
การเขียนชุดทดสอบทั้งสองประเภทนี้มีความสำคัญอย่างยิ่ง เพื่อให้มั่นใจได้ว่าส่วนประกอบต่างๆ ในไลบรารีของคุณสามารถทำงานได้ตรงตามที่คาดหวัง ทั้งในระดับแยกส่วนเดี่ยวๆ และในระดับการทำงานประสานกัน
การทดสอบระดับยูนิต
จุดประสงค์ของยูนิตเทสต์คือ การทดสอบโค้ดแต่ละหน่วยย่อยโดยแยกขาดจากโค้ดส่วนอื่นๆ เพื่อให้สามารถระบุตำแหน่งได้อย่างรวดเร็วว่าโค้ดส่วนใดทำงานถูกต้อง และส่วนใดไม่ทำงานตามที่คาดหวัง เราจะวางยูนิตเทสต์ไว้ในไดเรกทอรี src ภายในไฟล์เดียวกันกับโค้ดที่ต้องการทดสอบ โดยธรรมเนียมปฏิบัติคือ ให้สร้างมอดูลชื่อ tests ขึ้นมาในแต่ละไฟล์เพื่อบรรจุฟังก์ชันเทสต์ และกำกับมอดูลนั้นไว้ด้วย cfg(test)
มอดูล tests และ #[cfg(test)]
แอตทริบิวต์กำกับ #[cfg(test)] บนมอดูล tests จะสั่งให้ Rust คอมไพล์และรันโค้ดทดสอบเฉพาะเมื่อเราสั่งรันคำสั่ง cargo test เท่านั้น ไม่ใช่ตอนที่เราสั่งรัน cargo build ซึ่งช่วยประหยัดเวลาในการคอมไพล์เมื่อเราต้องการเพียงแค่บิลด์ไลบรารีไปใช้งาน และช่วยลดขนาดของไฟล์ไบนารีผลลัพธ์ลงเนื่องจากไม่มีโค้ดเทสต์แฝงอยู่ คุณจะเห็นว่าเนื่องจากอินทิเกรชันเทสต์จะถูกจัดเก็บไว้ในอีกไดเรกทอรีหนึ่งต่างหาก จึงไม่จำเป็นต้องใส่ #[cfg(test)] กำกับไว้ แต่สำหรับยูนิตเทสต์ที่เขียนอยู่ภายในไฟล์เดียวกับโค้ดหลัก เราจึงต้องใช้ #[cfg(test)] เพื่อระบุไม่ให้นำโค้ดเหล่านี้ไปรวมไว้ในผลลัพธ์การบิลด์ทั่วไป
ย้อนกลับไปตอนที่เราสร้างโปรเจกต์ adder ใหม่ในหัวข้อแรกของบทนี้ Cargo ได้สร้างโค้ดเริ่มต้นมาให้เราดังนี้:
ชื่อไฟล์: src/lib.rs
pub fn add(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() {
let result = add(2, 2);
assert_eq!(result, 4);
}
}ในมอดูล tests ที่สร้างขึ้นอัตโนมัตินี้ แอตทริบิวต์ cfg ย่อมาจากคำว่า configuration (การกำหนดค่า) ซึ่งคอยบอก Rust ว่ารายการโค้ดที่ตามมาควรถูกนำมารวมในการคอมไพล์เฉพาะเมื่อมีตัวเลือกการกำหนดค่าที่ระบุไว้เท่านั้น ในกรณีนี้ ตัวเลือกการกำหนดค่าคือ test ซึ่ง Rust จัดเตรียมไว้สำหรับการคอมไพล์และรันเทสต์โดยเฉพาะ การใช้แอตทริบิวต์ cfg ทำให้ Cargo จะคอมไพล์โค้ดเทสต์ของเราก็ต่อเมื่อเราตั้งใจสั่งรันเทสต์ด้วย cargo test เท่านั้น ซึ่งครอบคลุมไปถึงฟังก์ชันตัวช่วย (helper functions) ใดๆ ที่อาจเขียนไว้ภายในมอดูลนี้ นอกเหนือจากฟังก์ชันที่กำกับด้วย #[test]
การทดสอบฟังก์ชันแบบส่วนตัว
ในแวดวงการทดสอบซอฟต์แวร์ยังคงมีการถกเถียงกันอยู่เสมอว่า เราควรทดสอบฟังก์ชันแบบส่วนตัว (private functions) โดยตรงหรือไม่ ซึ่งในภาษาโปรแกรมอื่นๆ หลายภาษาอาจทำให้การทดสอบฟังก์ชันส่วนตัวเป็นเรื่องยากหรือทำไม่ได้เลย แต่ไม่ว่าคุณจะยึดถือแนวคิดการทดสอบแบบใด กฎเรื่องการเปิดเผย (privacy rules) ของ Rust อนุญาตให้คุณสามารถทดสอบฟังก์ชันแบบส่วนตัวได้อย่างเต็มที่ ลองพิจารณาโค้ดในลิสติ้ง 11-12 ซึ่งมีฟังก์ชันแบบส่วนตัวชื่อ internal_adder
pub fn add_two(a: u64) -> u64 {
internal_adder(a, 2)
}
fn internal_adder(left: u64, right: u64) -> u64 {
left + right
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn internal() {
let result = internal_adder(2, 2);
assert_eq!(result, 4);
}
}โปรดสังเกตว่าฟังก์ชัน internal_adder ไม่ได้ถูกประกาศด้วยคำว่า pub เลย เทสต์ก็เป็นเพียงโค้ด Rust ธรรมดา และมอดูล tests ก็เป็นเพียงมอดูลหนึ่งเท่านั้น ตามที่เราได้อธิบายไว้ในหัวข้อ“พาธสำหรับอ้างถึงรายการในแผนผังมอดูล” รายการต่างๆ ที่อยู่ในมอดูลลูกสามารถเรียกใช้งานรายการที่อยู่ในมอดูลบรรพบุรุษของมันได้เสมอ ในเทสต์นี้ เรานำรายการทั้งหมดของมอดูลแม่เข้ามาสู่สโคปด้วย use super::* ฟังก์ชันเทสต์จึงสามารถเรียกใช้งาน internal_adder ได้โดยตรง และหากคุณมองว่าไม่จำเป็นต้องทดสอบฟังก์ชันแบบส่วนตัว Rust ก็ไม่ได้มีข้อบังคับใดๆ ให้คุณต้องทำเช่นนั้น
การทดสอบแบบอินทิเกรชัน
ในภาษา Rust อินทิเกรชันเทสต์ (integration tests) จะอยู่ภายนอกไลบรารีของคุณโดยสมบูรณ์ พวกมันจะเรียกใช้งานไลบรารีในลักษณะเดียวกับที่โค้ดภายนอกอื่นๆ ใช้งาน ซึ่งหมายความว่ามันจะสามารถเรียกใช้ได้เฉพาะฟังก์ชันที่เป็นส่วนหนึ่งของ API สาธารณะ (public API) ของไลบรารีเท่านั้น จุดประสงค์หลักของอินทิเกรชันเทสต์คือการตรวจสอบว่าส่วนประกอบต่างๆ ของไลบรารีสามารถทำงานร่วมกันได้อย่างถูกต้องหรือไม่ เพราะหน่วยของโค้ดที่ทำงานได้ดีเมื่ออยู่เดี่ยวๆ อาจเกิดปัญหาขึ้นได้เมื่อนำมาเชื่อมต่อเข้าด้วยกัน ดังนั้นความครอบคลุมของการทดสอบในระดับบูรณาการจึงมีความสำคัญอย่างยิ่ง ในการสร้างอินทิเกรชันเทสต์ ขั้นตอนแรกที่คุณต้องมีคือไดเรกทอรี tests
ไดเรกทอรี tests
เราจะสร้างไดเรกทอรีชื่อ tests ไว้ที่ระดับบนสุดของไดเรกทอรีโปรเจกต์ ซึ่งจะอยู่คู่กับไดเรกทอรี src โดย Cargo จะทราบโดยอัตโนมัติว่าจะต้องค้นหาไฟล์อินทิเกรชันเทสต์ในไดเรกทอรีนี้ จากนั้นเราสามารถสร้างไฟล์เทสต์ได้มากเท่าที่ต้องการ และ Cargo จะคอมไพล์แต่ละไฟล์ให้เป็นเครต (crate) แยกต่างหากออกจากกัน
มาลองสร้างอินทิเกรชันเทสต์กัน โดยคงโค้ดในลิสติ้ง 11-12 ไว้ในไฟล์ src/lib.rs ให้สร้างไดเรกทอรี tests ขึ้นมา แล้วสร้างไฟล์ใหม่ชื่อ tests/integration_test.rs โครงสร้างไดเรกทอรีของคุณควรมีหน้าตาดังนี้:
adder
├── Cargo.lock
├── Cargo.toml
├── src
│ └── lib.rs
└── tests
└── integration_test.rs
จากนั้นให้ใส่โค้ดในลิสติ้ง 11-13 ลงในไฟล์ tests/integration_test.rs
use adder::add_two;
#[test]
fn it_adds_two() {
let result = add_two(2);
assert_eq!(result, 4);
}เนื่องจากแต่ละไฟล์ในไดเรกทอรี tests ถือเป็นเครตแยกต่างหากกัน เราจึงจำเป็นต้องอิมพอร์ตไลบรารีของเราเข้ามายังสโคปของแต่ละเครตเทสต์ ด้วยเหตุนี้ เราจึงต้องเพิ่ม use adder::add_two; ไว้ที่ตอนต้นของโค้ด ซึ่งเป็นสิ่งที่เราไม่ต้องทำในยูนิตเทสต์
เราไม่จำเป็นต้องใส่แอตทริบิวต์ #[cfg(test)] กำกับไว้บนโค้ดใดๆ ใน tests/integration_test.rs เลย เพราะ Cargo มีกลไกพิเศษสำหรับไดเรกทอรี tests โดยจะคอมไพล์ไฟล์ในไดเรกทอรีนี้เฉพาะเมื่อเราสั่งรัน cargo test เท่านั้น ลองรัน cargo test ดูตอนนี้:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 1.31s
Running unittests src/lib.rs (target/debug/deps/adder-1082c4b063a8fbe6)
running 1 test
test tests::internal ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running tests/integration_test.rs (target/debug/deps/integration_test-1082c4b063a8fbe6)
running 1 test
test it_adds_two ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
เอาต์พุตที่แสดงผลออกมาจะแบ่งเป็น 3 ส่วนหลัก ได้แก่ ยูนิตเทสต์, อินทิเกรชันเทสต์, และด็อกเทสต์ (doc test) โปรดสังเกตว่าหากมีเทสต์ในส่วนใดส่วนหนึ่งล้มเหลว ส่วนที่เหลือถัดไปจะไม่ถูกรัน ตัวอย่างเช่น หากมียูนิตเทสต์ล้มเหลว จะไม่มีเอาต์พุตของอินทิเกรชันเทสต์และด็อกเทสต์แสดงออกมาเลย เนื่องจากเทสต์เหล่านั้นจะถูกสั่งรันก็ต่อเมื่อยูนิตเทสต์ทั้งหมดผ่านอย่างสมบูรณ์แล้วเท่านั้น
ส่วนแรกสำหรับยูนิตเทสต์จะมีลักษณะเช่นเดียวกับที่เราเคยเห็น: แสดงหนึ่งบรรทัดต่อหนึ่งฟังก์ชันยูนิตเทสต์ (มีตัวหนึ่งชื่อ internal ที่เราเพิ่มไว้ในลิสติ้ง 11-12) ตามด้วยบรรทัดสรุปผลลัพธ์ของยูนิตเทสต์
ส่วนของอินทิเกรชันเทสต์จะเริ่มต้นด้วยบรรทัด Running tests/integration_test.rs จากนั้นจะมีบรรทัดแสดงผลของแต่ละฟังก์ชันเทสต์ในไฟล์อินทิเกรชันเทสต์นั้น และตามด้วยบรรทัดสรุปผลลัพธ์ของอินทิเกรชันเทสต์ ก่อนที่ส่วน Doc-tests adder จะเริ่มต้นขึ้น
ไฟล์อินทิเกรชันเทสต์แต่ละไฟล์จะมีส่วนแสดงผลแยกเป็นของตนเอง ดังนั้นหากเราเพิ่มไฟล์เข้าไปในไดเรกทอรี tests อีก ก็จะมีส่วนแสดงผลของอินทิเกรชันเทสต์เพิ่มขึ้นตามไปด้วย
เรายังคงสามารถสั่งรันเฉพาะฟังก์ชันอินทิเกรชันเทสต์ที่เจาะจงได้ โดยระบุชื่อของฟังก์ชันเทสต์เป็นอาร์กิวเมนต์ให้กับ cargo test และหากต้องการรันเทสต์ทั้งหมดที่อยู่ในไฟล์อินทิเกรชันเทสต์ไฟล์ใดไฟล์หนึ่งโดยเฉพาะ ให้ใช้อาร์กิวเมนต์ --test ของ cargo test ตามด้วยชื่อของไฟล์นั้น:
$ cargo test --test integration_test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.64s
Running tests/integration_test.rs (target/debug/deps/integration_test-82e7799c1bc62298)
running 1 test
test it_adds_two ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
คำสั่งนี้จะรันเฉพาะเทสต์ที่อยู่ในไฟล์ tests/integration_test.rs เท่านั้น
มอดูลย่อยในการทดสอบแบบอินทิเกรชัน
เมื่อคุณเริ่มมีอินทิเกรชันเทสต์มากขึ้น คุณอาจต้องการสร้างไฟล์เพิ่มเติมในไดเรกทอรี tests เพื่อช่วยจัดหมวดหมู่ให้เป็นระเบียบ เช่น การจัดกลุ่มฟังก์ชันเทสต์ตามฟังก์ชันการทำงานที่ต้องการทดสอบ ดังที่ได้กล่าวไปแล้วว่า แต่ละไฟล์ในไดเรกทอรี tests จะถูกคอมไพล์ให้เป็นเครตแยกจากกัน ซึ่งมีประโยชน์อย่างยิ่งในการจำลองสโคปแบบแยกส่วนให้ใกล้เคียงกับวิธีที่ผู้ใช้งานจริงจะเรียกใช้เครตของคุณ อย่างไรก็ตาม สิ่งนี้ส่งผลให้ไฟล์ในไดเรกทอรี tests มีพฤติกรรมไม่เหมือนกับไฟล์ในไดเรกทอรี src ตามที่คุณเคยเรียนรู้ในบทที่ 7 เกี่ยวกับการแยกโค้ดออกเป็นมอดูลและไฟล์
ความแตกต่างของพฤติกรรมนี้จะเห็นได้ชัดเจนที่สุดเมื่อคุณมีชุดฟังก์ชันตัวช่วย (helper functions) ที่ต้องการใช้ร่วมกันในหลายๆ ไฟล์อินทิเกรชันเทสต์ และคุณพยายามทำตามขั้นตอนในหัวข้อ“แยกมอดูลออกเป็นไฟล์ต่างๆ” ของบทที่ 7 เพื่อแยกโค้ดเหล่านั้นออกมาเป็นมอดูลส่วนกลาง ตัวอย่างเช่น หากเราสร้างไฟล์ tests/common.rs แล้วใส่ฟังก์ชันชื่อ setup ไว้ข้างใน เพื่อให้สามารถเรียกใช้ได้จากหลายฟังก์ชันเทสต์ในหลายไฟล์:
ชื่อไฟล์: tests/common.rs
pub fn setup() {
// setup code specific to your library's tests would go here
}เมื่อเราสั่งรันเทสต์อีกครั้ง เราจะเห็นส่วนใหม่ปรากฏขึ้นมาในเอาต์พุตสำหรับไฟล์ common.rs ทั้งๆ ที่ไฟล์นี้ไม่มีฟังก์ชันเทสต์อยู่เลย และเราก็ยังไม่ได้เรียกฟังก์ชัน setup จากที่ไหนด้วยซ้ำ:
$ cargo test
Compiling adder v0.1.0 (file:///projects/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.89s
Running unittests src/lib.rs (target/debug/deps/adder-92948b65e88960b4)
running 1 test
test tests::internal ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running tests/common.rs (target/debug/deps/common-92948b65e88960b4)
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running tests/integration_test.rs (target/debug/deps/integration_test-92948b65e88960b4)
running 1 test
test it_adds_two ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests adder
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
การที่ common โผล่ขึ้นมาในผลการทดสอบพร้อมข้อความ running 0 tests ไม่ใช่สิ่งที่เราต้องการ เพราะเราเพียงแค่ต้องการแชร์โค้ดตัวช่วยร่วมกับไฟล์อินทิเกรชันเทสต์อื่นๆ เท่านั้น เพื่อหลีกเลี่ยงไม่ให้ common ปรากฏในเอาต์พุตการทดสอบ แทนที่เราจะสร้างไฟล์ tests/common.rs ให้เราสร้างเป็น tests/common/mod.rs แทน ซึ่งทำให้โครงสร้างไดเรกทอรีมีหน้าตาดังนี้:
├── Cargo.lock
├── Cargo.toml
├── src
│ └── lib.rs
└── tests
├── common
│ └── mod.rs
└── integration_test.rs
นี่คือธรรมเนียมการตั้งชื่อรูปแบบดั้งเดิมที่ Rust เข้าใจได้เช่นกัน ตามที่เราเคยกล่าวถึงใน“พาธไฟล์ทางเลือก” ในบทที่ 7 การตั้งชื่อไฟล์ในรูปแบบนี้จะบอกให้ Rust ทราบว่าอย่าปฏิบัติต่อมอดูล common ในฐานะไฟล์อินทิเกรชันเทสต์ และเมื่อเราย้ายโค้ดฟังก์ชัน setup ไปไว้ใน tests/common/mod.rs พร้อมทั้งลบไฟล์ tests/common.rs ทิ้งไป ส่วนของ common ในเอาต์พุตเทสต์ก็จะไม่ปรากฏขึ้นอีก ไฟล์ทั้งหมดที่อยู่ในไดเรกทอรีย่อยของ tests จะไม่ถูกคอมไพล์เป็นเครตแยกเดี่ยว และจะไม่มีส่วนแสดงผลในเอาต์พุตการทดสอบ
หลังจากที่เราสร้างไฟล์ tests/common/mod.rs เรียบร้อยแล้ว เราจะสามารถเรียกใช้งานมันในฐานะมอดูลจากไฟล์อินทิเกรชันเทสต์ใดๆ ก็ได้ ต่อไปนี้เป็นตัวอย่างการเรียกฟังก์ชัน setup จากเทสต์ it_adds_two ในไฟล์ tests/integration_test.rs:
ชื่อไฟล์: tests/integration_test.rs
use adder::add_two;
mod common;
#[test]
fn it_adds_two() {
common::setup();
let result = add_two(2);
assert_eq!(result, 4);
}โปรดสังเกตว่าการประกาศ mod common; นั้นเป็นรูปแบบเดียวกับที่เราเคยแสดงไว้ในลิสติ้ง 7-21 จากนั้นภายในฟังก์ชันเทสต์ เราจึงสามารถเรียกใช้คำสั่ง common::setup() ได้อย่างราบรื่น
การทดสอบแบบอินทิเกรชันสำหรับเครตไบนารี
หากโปรเจกต์ของเราเป็นเครตไบนารี (binary crate) ที่มีเพียงไฟล์ src/main.rs และไม่มีไฟล์ src/lib.rs เราจะไม่สามารถสร้างอินทิเกรชันเทสต์ในไดเรกทอรี tests เพื่อนำฟังก์ชันที่นิยามในไฟล์ src/main.rs เข้ามาสู่สโคปด้วยคำสั่ง use ได้ เพราะมีเพียงเครตไลบรารี (library crate) เท่านั้นที่เปิดเผยฟังก์ชันให้เครตอื่นๆ เรียกใช้งานได้ ส่วนเครตไบนารีถูกออกแบบมาเพื่อให้รันการทำงานด้วยตัวมันเองโดยเฉพาะ
นี่จึงเป็นหนึ่งในเหตุผลสำคัญที่โปรเจกต์ Rust ที่เป็นไบนารีมักจะมีไฟล์ src/main.rs ที่เรียบง่ายและทำหน้าที่เพียงแค่เรียกใช้ตรรกะการทำงานหลักที่อยู่ในไฟล์ src/lib.rs การใช้โครงสร้างเช่นนี้ทำให้อินทิเกรชันเทสต์_สามารถ_ทดสอบเครตไลบรารีผ่านคำสั่ง use เพื่อเข้าถึงฟังก์ชันการทำงานที่สำคัญได้ และหากฟังก์ชันการทำงานหลักเหล่านั้นทำงานได้ถูกต้อง โค้ดเพียงเล็กน้อยที่อยู่ใน src/main.rs ก็จะทำงานได้อย่างถูกต้องตามไปด้วย โดยไม่จำเป็นต้องเขียนชุดทดสอบให้กับโค้ดส่วนเล็กๆ นั้นแยกต่างหาก
สรุป
ฟีเจอร์การทดสอบของ Rust มอบแนวทางในการกำหนดและตรวจสอบพฤติกรรมการทำงานของโค้ด เพื่อให้มั่นใจได้ว่าโปรแกรมจะยังคงทำงานได้ถูกต้องตรงตามความคาดหวังเสมอ แม้ในยามที่คุณต้องแก้ไขปรับปรุงโค้ดก็ตาม ยูนิตเทสต์ช่วยให้เราทดสอบชิ้นส่วนต่างๆ ของไลบรารีแยกจากกัน และสามารถทดสอบลงลึกไปถึงรายละเอียดการทำงานแบบส่วนตัวได้ ส่วนอินทิเกรชันเทสต์จะช่วยตรวจสอบว่าส่วนต่างๆ ของไลบรารีสามารถทำงานร่วมกันได้อย่างสมบูรณ์ โดยเรียกใช้ผ่าน API สาธารณะของไลบรารีในลักษณะเดียวกับที่โค้ดภายนอกนำไปใช้งาน แม้ว่าระบบชนิดข้อมูลและกฎความเป็นเจ้าของของ Rust จะช่วยป้องกันข้อผิดพลาดได้มากมายหลายประเภท แต่การเขียนชุดทดสอบก็ยังคงเป็นหัวใจสำคัญในการลดทอนข้อผิดพลาดเชิงตรรกะ (logic bugs) เกี่ยวกับพฤติกรรมที่โค้ดควรจะเป็น
มานำความรู้ทั้งหมดที่คุณได้เรียนรู้ในบทนี้และบทก่อนๆ มาผสมผสานเพื่อร่วมกันลงมือพัฒนาโปรเจกต์จริงกันเถอะ!
โปรเจกต์ I/O: สร้างโปรแกรมบรรทัดคำสั่ง
บทนี้จะเป็นการประมวลและทบทวนทักษะต่างๆ ที่คุณได้เรียนรู้มาทั้งหมดจนถึงตอนนี้ ควบคู่ไปกับการสำรวจฟีเจอร์เพิ่มเติมอีกเล็กน้อยของไลบรารีมาตรฐาน เราจะร่วมกันสร้างเครื่องมือคอมมานด์ไลน์ (command line tool) ที่มีการจัดการไฟล์และระบบอินพุต/เอาต์พุต เพื่อฝึกฝนและนำแนวคิดต่างๆ ในภาษา Rust ที่คุณได้สั่งสมมาประยุกต์ใช้ในการพัฒนาจริง
ทั้งความเร็ว ความปลอดภัย การให้ผลลัพธ์เป็นไฟล์ไบนารีเดี่ยวที่ทำงานได้ทันที ตลอดจนการรองรับการทำงานข้ามแพลตฟอร์ม ทำให้ Rust เป็นภาษาที่เหมาะสมอย่างยิ่งสำหรับการสร้างเครื่องมือคอมมานด์ไลน์ ดังนั้นสำหรับโปรเจกต์ของเรา เราจะสร้างเครื่องมือค้นหาข้อความคลาสสิกอย่าง grep (globally search a regular expression and print) ในเวอร์ชันของเราเอง ในกรณีการใช้งานที่เรียบง่ายที่สุด grep จะทำหน้าที่ค้นหาข้อความสตริงที่ระบุภายในไฟล์ที่กำหนด โดยรับพาธของไฟล์และข้อความสตริงที่ต้องการค้นหาเป็นอาร์กิวเมนต์ (arguments) จากนั้นจะอ่านข้อมูลในไฟล์ ค้นหาทุกบรรทัดที่มีข้อความดังกล่าว แล้วพิมพ์บรรทัดเหล่านั้นออกมาแสดงผล
ตลอดเส้นทางการพัฒนา เราจะแสดงให้เห็นถึงวิธีทำให้เครื่องมือคอมมานด์ไลน์ของเราใช้งานฟีเจอร์ต่างๆ ของเทอร์มินัลเฉกเช่นเดียวกับเครื่องมือยอดนิยมอื่นๆ เราจะอ่านค่าจากตัวแปรสภาพแวดล้อม (environment variables) เพื่อเปิดให้ผู้ใช้สามารถปรับแต่งพฤติกรรมการทำงานของเครื่องมือได้ตามต้องการ นอกจากนี้ เรายังจะส่งข้อความแจ้งข้อผิดพลาดไปยังสตรีมข้อผิดพลาดมาตรฐาน (stderr) แทนที่จะส่งไปยังเอาต์พุตมาตรฐาน (stdout) เพื่อให้ผู้ใช้สามารถเปลี่ยนเส้นทาง (redirect) ผลลัพธ์ที่สำเร็จไปบันทึกลงในไฟล์ได้ โดยที่ยังคงมองเห็นข้อความแจ้งข้อผิดพลาดแสดงอยู่บนหน้าจอเทอร์มินัลตามปกติ
สมาชิกท่านหนึ่งในชุมชน Rust คือ Andrew Gallant ได้เคยสร้างเครื่องมือ grep ในเวอร์ชันที่มีฟีเจอร์ครบครันและทำงานได้อย่างรวดเร็วเป็นพิเศษในชื่อ ripgrep มาแล้ว แม้ว่าเวอร์ชันที่เรากำลังจะสร้างขึ้นร่วมกันนี้จะเรียบง่ายกว่ามากเมื่อเทียบกัน แต่บทนี้จะมอบความรู้พื้นฐานที่จำเป็นทั้งหมดสำหรับช่วยให้คุณเข้าใจโปรเจกต์ระดับการใช้งานจริงอย่าง ripgrep ได้เป็นอย่างดี
โปรเจกต์ grep ของเราจะนำแนวคิดหลากหลายด้านที่คุณได้เรียนรู้มาผสมผสานเข้าด้วยกัน:
- การจัดระเบียบโค้ดและโครงสร้างโปรเจกต์ (บทที่ 7)
- การใช้งานเวกเตอร์ (vector) และสตริง (string) (บทที่ 8)
- การจัดการข้อผิดพลาดอย่างเป็นระบบ (บทที่ 9)
- การประยุกต์ใช้เทรต (trait) และไลฟ์ไทม์ (lifetime) อย่างเหมาะสม (บทที่ 10)
- การเขียนชุดทดสอบอัตโนมัติ (บทที่ 11)
นอกจากนี้ เรายังจะแนะนำแนวคิดเรื่องโคลเชอร์ (closures), อิเทอเรเตอร์ (iterators) และเทรตออบเจกต์ (trait objects) อย่างกระชับ ซึ่งจะมีเนื้อหาอธิบายอย่างละเอียดใน บทที่ 13 และ บทที่ 18
รับอาร์กิวเมนต์จากบรรทัดคำสั่ง
รับอาร์กิวเมนต์จากบรรทัดคำสั่ง
มาเริ่มต้นสร้างโปรเจกต์ใหม่กันเช่นเคยด้วยคำสั่ง cargo new โดยเราจะตั้งชื่อโปรเจกต์ว่า minigrep เพื่อแยกความแตกต่างจากเครื่องมือ grep ที่อาจมีติดตั้งอยู่ในระบบของคุณอยู่แล้ว:
$ cargo new minigrep
Created binary (application) `minigrep` project
$ cd minigrep
ภารกิจแรกของเราคือการทำให้ minigrep สามารถรับอาร์กิวเมนต์ (arguments) จากคอมมานด์ไลน์ได้ 2 ตัว ได้แก่: พาธของไฟล์ และข้อความสตริงที่ต้องการค้นหา กล่าวคือ เราต้องการสั่งรันโปรแกรมของเราด้วยคำสั่ง cargo run ตามด้วยเครื่องหมายยัติภังค์ 2 ตัว (--) เพื่อระบุว่าอาร์กิวเมนต์ที่ตามมาหลังจากนี้เป็นของโปรแกรมเรา ไม่ใช่ของ cargo จากนั้นจึงตามด้วยสตริงที่ต้องการค้นหา และพาธของไฟล์เป้าหมาย ดังนี้:
$ cargo run -- searchstring example-filename.txt
ในตอนนี้ โปรแกรมเริ่มต้นที่สร้างขึ้นโดย cargo new ยังไม่สามารถประมวลผลอาร์กิวเมนต์ที่เราส่งเข้าไปได้ แม้ว่าจะมีไลบรารีสำเร็จรูปบน crates.io ที่ช่วยอำนวยความสะดวกในการเขียนโปรแกรมรับอาร์กิวเมนต์คอมมานด์ไลน์อยู่มากมาย แต่เนื่องจากคุณกำลังศึกษาเรียนรู้แนวคิดนี้ เรามาลองอิมพลีเมนต์ความสามารถนี้ด้วยตัวเราเองกันก่อน
การอ่านค่าอาร์กิวเมนต์
เพื่อให้ minigrep สามารถอ่านค่าอาร์กิวเมนต์จากคอมมานด์ไลน์ที่เราส่งเข้าไปได้ เราจะต้องใช้ฟังก์ชัน std::env::args ที่มีอยู่ในไลบรารีมาตรฐานของ Rust ฟังก์ชันนี้จะส่งคืนค่าเป็นอิเทอเรเตอร์ (iterator) ของอาร์กิวเมนต์คอมมานด์ไลน์ที่ส่งให้กับ minigrep ซึ่งเราจะได้เรียนรู้เรื่องอิเทอเรเตอร์อย่างละเอียดในบทที่ 13 สำหรับตอนนี้ คุณจำเป็นต้องรู้คุณลักษณะของอิเทอเรเตอร์เพียง 2 ประการก่อน: อิเทอเรเตอร์จะทยอยส่งมอบลำดับของค่าออกมาทีละตัว และเราสามารถเรียกใช้เมธอด collect บนอิเทอเรเตอร์เพื่อแปลงมันให้กลายเป็นคอลเลกชัน (collection) เช่น เวกเตอร์ (vector) ที่บรรจุสมาชิกทั้งหมดที่อิเทอเรเตอร์ส่งมอบออกมา
โค้ดในลิสติ้ง 12-1 จะช่วยให้โปรแกรม minigrep ของคุณอ่านอาร์กิวเมนต์คอมมานด์ไลน์ทั้งหมดที่ส่งเข้ามา แล้วรวบรวมค่าเหล่านั้นจัดเก็บไว้ในเวกเตอร์
use std::env;
fn main() {
let args: Vec<String> = env::args().collect();
dbg!(args);
}อันดับแรก เราจะนำมอดูล std::env เข้ามาสู่สโคปด้วยคำสั่ง use เพื่อให้สามารถเรียกใช้ฟังก์ชัน args ได้ โปรดสังเกตว่าฟังก์ชัน std::env::args มีการซ้อนอยู่ภายในมอดูล 2 ระดับ ตามที่เราเคยอธิบายไว้ในบทที่ 7 ว่าในกรณีที่ฟังก์ชันเป้าหมายซ้อนอยู่ในมอดูลมากกว่าหนึ่งระดับ เรามักเลือกนำมอดูลแม่เข้ามาสู่สโคปแทนที่จะนำตัวฟังก์ชันเข้ามาโดยตรง การทำเช่นนี้ทำให้เราสามารถเรียกใช้ฟังก์ชันอื่นๆ จาก std::env ได้อย่างสะดวก และยังลดความคลุมเครือลงเมื่อเทียบกับการประกาศ use std::env::args แล้วเรียกใช้ด้วยชื่อ args สั้นๆ เพราะ args อาจถูกเข้าใจผิดว่าเป็นฟังก์ชันที่นิยามขึ้นภายในมอดูลปัจจุบันได้ง่าย
ฟังก์ชัน
argsและ Unicode ที่ไม่ถูกต้องโปรดทราบว่า
std::env::argsจะเกิดการแพนิก (panic) หากมีอาร์กิวเมนต์ใดก็ตามที่มีรหัส Unicode ไม่ถูกต้อง หากโปรแกรมของคุณจำเป็นต้องรองรับอาร์กิวเมนต์ที่อาจมีรหัส Unicode ไม่ถูกต้อง ให้เปลี่ยนไปใช้ฟังก์ชันstd::env::args_osแทน โดยฟังก์ชันดังกล่าวจะส่งคืนอิเทอเรเตอร์ที่ให้ผลลัพธ์เป็นค่าชนิดOsStringแทนที่จะเป็นStringแต่ในที่นี้เราเลือกใช้std::env::argsเพื่อความเรียบง่าย เนื่องจากค่าOsStringจะมีความแตกต่างกันไปในแต่ละระบบปฏิบัติการและจัดการได้ซับซ้อนกว่าค่าString
ในบรรทัดแรกของฟังก์ชัน main เราได้เรียกใช้ env::args() และตามด้วยเมธอด collect() ทันทีเพื่อแปลงอิเทอเรเตอร์ให้กลายเป็นเวกเตอร์ที่บรรจุค่าทั้งหมดที่ได้จากอิเทอเรเตอร์ เนื่องจากเมธอด collect สามารถนำไปสร้างคอลเลกชันได้หลากหลายชนิด เราจึงต้องระบุชนิดข้อมูลกำกับไว้ให้กับตัวแปร args อย่างชัดเจน เพื่อบอกว่าเราต้องการเวกเตอร์ของสตริง แม้ว่าตามปกติคุณแทบไม่ต้องระบุชนิดข้อมูลด้วยตนเองใน Rust แต่ collect เป็นหนึ่งในฟังก์ชันที่คุณจำเป็นต้องระบุชนิดข้อมูลอยู่เสมอ เพราะคอมไพเลอร์ Rust ไม่สามารถคาดเดาได้ว่าคุณต้องการคอลเลกชันชนิดใด
สุดท้าย เราสั่งพิมพ์ค่าในเวกเตอร์ออกมาด้วยรูปแบบการแสดงผลแบบดีบัก มาลองรันโค้ดนี้ดูก่อน โดยรอบแรกไม่ต้องใส่อาร์กิวเมนต์ และรอบที่สองให้ใส่อาร์กิวเมนต์ไป 2 ตัว:
$ cargo run
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.61s
Running `target/debug/minigrep`
[src/main.rs:5:5] args = [
"target/debug/minigrep",
]
$ cargo run -- needle haystack
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 1.57s
Running `target/debug/minigrep needle haystack`
[src/main.rs:5:5] args = [
"target/debug/minigrep",
"needle",
"haystack",
]
โปรดสังเกตว่าค่าตัวแรกในเวกเตอร์คือ "target/debug/minigrep" ซึ่งก็คือชื่อของไฟล์ไบนารีโปรแกรมของเรา นั่นตรงกับพฤติกรรมของรายการอาร์กิวเมนต์ในภาษา C ซึ่งเปิดให้โปรแกรมสามารถทราบชื่อที่ใช้ในการสั่งรันตัวเองได้ การเข้าถึงชื่อโปรแกรมได้นั้นมีประโยชน์ในกรณีที่คุณต้องการพิมพ์ชื่อนั้นในข้อความแจ้งเตือน หรือต้องการปรับเปลี่ยนพฤติกรรมของโปรแกรมตามชื่อเรียกที่ใช้เรียกโปรแกรม แต่สำหรับเป้าหมายในบทนี้ เราจะมองข้ามค่าแรกนี้ไป และจะเก็บไว้เฉพาะอาร์กิวเมนต์ 2 ตัวที่เราจำเป็นต้องใช้เท่านั้น
การบันทึกค่าอาร์กิวเมนต์ลงในตัวแปร
ในตอนนี้ โปรแกรมของเราสามารถเข้าถึงค่าต่างๆ ที่ส่งเข้ามาเป็นอาร์กิวเมนต์คอมมานด์ไลน์ได้แล้ว ขั้นตอนถัดไปคือการบันทึกค่าของอาร์กิวเมนต์ทั้งสองตัวลงในตัวแปร เพื่อให้สามารถนำค่าเหล่านั้นไปใช้งานตลอดการทำงานส่วนที่เหลือของโปรแกรมได้ ดังที่แสดงในลิสติ้ง 12-2
use std::env;
fn main() {
let args: Vec<String> = env::args().collect();
let query = &args[1];
let file_path = &args[2];
println!("Searching for {query}");
println!("In file {file_path}");
}ตามที่เราเห็นในตอนสั่งพิมพ์เวกเตอร์ ชื่อของโปรแกรมจะถูกจัดเก็บไว้ที่ตำแหน่งแรกของเวกเตอร์คือ args[0] ดังนั้นอาร์กิวเมนต์จริงของเราจึงเริ่มต้นที่ดัชนี 1 โดยอาร์กิวเมนต์แรกที่ minigrep รับเข้ามาคือข้อความสตริงที่เราต้องการค้นหา เราจึงกำหนดให้ตัวแปร query เก็บเรเฟอเรนซ์ของอาร์กิวเมนต์แรก ส่วนอาร์กิวเมนต์ที่สองคือพาธของไฟล์ เราจึงกำหนดให้ตัวแปร file_path เก็บเรเฟอเรนซ์ของอาร์กิวเมนต์ที่สอง
เราได้เพิ่มคำสั่งพิมพ์ค่าของตัวแปรเหล่านี้ชั่วคราวเพื่อพิสูจน์ว่าโค้ดทำงานได้ตรงตามที่ตั้งใจ มาลองรันโปรแกรมนี้อีกครั้งโดยส่งอาร์กิวเมนต์ test และ sample.txt:
$ cargo run -- test sample.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep test sample.txt`
Searching for test
In file sample.txt
ยอดเยี่ยม โปรแกรมทำงานได้ถูกต้องแล้ว! ค่าของอาร์กิวเมนต์ที่เราต้องการถูกบันทึกลงในตัวแปรอย่างถูกต้อง ในภายหลังเราจะเพิ่มการจัดการข้อผิดพลาด (error handling) เพื่อรับมือกับสถานการณ์ที่อาจมีข้อผิดพลาดเกิดขึ้น เช่น กรณีที่ผู้ใช้ไม่ได้ระบุอาร์กิวเมนต์ใดๆ เข้ามาเลย แต่สำหรับตอนนี้ เราจะข้ามกรณีดังกล่าวไปก่อน แล้วมุ่งไปเพิ่มความสามารถในการอ่านไฟล์ให้กับโปรแกรมกัน
การอ่านไฟล์
การอ่านไฟล์
ในตอนนี้ เราจะเพิ่มฟังก์ชันการทำงานสำหรับอ่านไฟล์ตามที่ระบุไว้ในอาร์กิวเมนต์ file_path อันดับแรก เราจำเป็นต้องมีไฟล์ตัวอย่างสำหรับใช้ทดสอบ: เราจะใช้ไฟล์ข้อความสั้นๆ ที่มีความยาวหลายบรรทัดและมีคำที่ซ้ำกันอยู่บ้าง โดยในลิสติ้ง 12-3 มีบทกวีของ Emily Dickinson ที่เหมาะเจาะอย่างยิ่ง! ให้สร้างไฟล์ชื่อ poem.txt ไว้ที่โฟลเดอร์ราก (root) ของโปรเจกต์คุณ แล้วใส่บทกวี “I’m Nobody! Who are you?” ลงไป
I'm nobody! Who are you?
Are you nobody, too?
Then there's a pair of us - don't tell!
They'd banish us, you know.
How dreary to be somebody!
How public, like a frog
To tell your name the livelong day
To an admiring bog!
เมื่อเตรียมไฟล์ข้อความเรียบร้อยแล้ว ให้เปิดแก้ไขไฟล์ src/main.rs เพื่อเพิ่มโค้ดสำหรับอ่านไฟล์ ดังที่แสดงในลิสติ้ง 12-4
use std::env;
use std::fs;
fn main() {
// --snip--
let args: Vec<String> = env::args().collect();
let query = &args[1];
let file_path = &args[2];
println!("Searching for {query}");
println!("In file {file_path}");
let contents = fs::read_to_string(file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}อันดับแรก เราจะนำเข้าส่วนที่เกี่ยวข้องจากไลบรารีมาตรฐานด้วยคำสั่ง use: ซึ่งเราจำเป็นต้องใช้ std::fs สำหรับการจัดการไฟล์
ภายในฟังก์ชัน main คำสั่งใหม่อย่าง fs::read_to_string จะรับค่า file_path เข้าไป เปิดไฟล์ดังกล่าว แล้วส่งคืนผลลัพธ์เป็นชนิดข้อมูล std::io::Result<String> ที่บรรจุเนื้อหาทั้งหมดของไฟล์
หลังจากนั้น เราได้เพิ่มคำสั่ง println! ชั่วคราวเพื่อพิมพ์ค่าของ contents ออกมาหลังจากที่อ่านไฟล์เสร็จแล้ว ซึ่งช่วยให้เราตรวจสอบได้ว่าโปรแกรมทำงานได้ถูกต้องจนถึงจุดนี้
มาลองสั่งรันโค้ดนี้โดยส่งข้อความสตริงใดๆ ก็ได้เป็นอาร์กิวเมนต์ตัวแรก (เนื่องจากเรายังไม่ได้อิมพลีเมนต์ส่วนการค้นหา) และส่งไฟล์ poem.txt เป็นอาร์กิวเมนต์ตัวที่สอง:
$ cargo run -- the poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep the poem.txt`
Searching for the
In file poem.txt
With text:
I'm nobody! Who are you?
Are you nobody, too?
Then there's a pair of us - don't tell!
They'd banish us, you know.
How dreary to be somebody!
How public, like a frog
To tell your name the livelong day
To an admiring bog!
ยอดเยี่ยม! โค้ดสามารถอ่านและพิมพ์เนื้อหาของไฟล์ออกมาได้อย่างถูกต้อง แต่โค้ดยังคงมีข้อบกพร่องอยู่ 2-3 จุด กล่าวคือ ในขณะนี้ ฟังก์ชัน main มีหน้าที่ความรับผิดชอบหลายอย่างปะปนกัน: โดยทั่วไปแล้ว ฟังก์ชันจะมีความชัดเจนและดูแลรักษาง่ายกว่ามาก หากแต่ละฟังก์ชันรับผิดชอบเพียงแนวคิดเดียว นอกจากนี้ เรายังไม่ได้จัดการกับข้อผิดพลาดอย่างรัดกุมเท่าที่ควร เนื่องจากโปรแกรมยังคงมีขนาดเล็ก ข้อบกพร่องเหล่านี้จึงยังไม่ส่งผลกระทบที่รุนแรงนัก แต่เมื่อโปรแกรมขยายใหญ่ขึ้น การจะแก้ไขโครงสร้างในภายหลังให้เรียบร้อยหมดจดจะทำได้ยากยิ่งขึ้น การเริ่มต้นรีแฟกเตอร์ (refactor) โค้ดตั้งแต่เนิ่นๆ ในระหว่างการพัฒนาจึงเป็นแนวทางปฏิบัติที่ดี เพราะการปรับโครงสร้างโค้ดจำนวนน้อยๆ นั้นทำได้ง่ายกว่ามาก และนี่คือสิ่งที่เราจะทำกันในขั้นตอนถัดไป
รีแฟกเตอร์เพื่อปรับปรุงโครงสร้างและการจัดการข้อผิดพลาด
รีแฟกเตอร์เพื่อปรับปรุงโครงสร้างและการจัดการข้อผิดพลาด
เพื่อพัฒนาโปรแกรมของเราให้ดียิ่งขึ้น เราจะมาแก้ไขปัญหา 4 ประการที่เกี่ยวข้องกับโครงสร้างของโปรแกรมและวิธีจัดการกับข้อผิดพลาดที่อาจเกิดขึ้น ประการแรก ในตอนนี้ฟังก์ชัน main ของเราต้องแบกรับภาระหน้าที่ 2 อย่างพร้อมกัน นั่นคือการแยกวิเคราะห์อาร์กิวเมนต์ (parse arguments) และการอ่านไฟล์ เมื่อโปรแกรมเติบโตขึ้น จำนวนหน้าที่แยกย่อยที่ฟังก์ชัน main ต้องดูแลก็จะเพิ่มขึ้นตามไปด้วย และเมื่อฟังก์ชันหนึ่งๆ มีความรับผิดชอบมากเกินไป มันจะกลายเป็นเรื่องยากต่อการทำความเข้าใจ ยากต่อการทดสอบ และยากที่จะแก้ไขโดยไม่ไปกระทบกระเทือนให้ส่วนอื่นๆ พัง ทางเลือกที่ดีที่สุดคือการแยกฟังก์ชันการทำงานออกจากกัน เพื่อให้แต่ละฟังก์ชันรับผิดชอบเพียงหน้าที่เดียวอย่างชัดเจน
ประเด็นนี้ยังเชื่อมโยงกับปัญหาประการที่สอง: แม้ว่าตัวแปร query และ file_path จะเป็นตัวแปรสำหรับกำหนดค่า (configuration) ของโปรแกรม แต่ตัวแปรอย่าง contents กลับถูกนำมาใช้เพื่อดำเนินตรรกะการทำงาน ยิ่งฟังก์ชัน main มีขนาดยาวขึ้นเท่าไร เราก็ยิ่งต้องประกาศตัวแปรเข้ามาไว้ในสโคปมากขึ้นเท่านั้น และยิ่งมีตัวแปรในสโคปมากเท่าใด การจะคอยติดตามจุดประสงค์ของแต่ละตัวแปรก็ยิ่งทำได้ยากขึ้น ทางที่ดีที่สุดคือการจัดกลุ่มตัวแปรที่ใช้กำหนดค่าเหล่านี้ไว้ในโครงสร้างเดียวกัน เพื่อให้วัตถุประสงค์ในการใช้งานมีความชัดเจน
ปัญหาประการที่สามคือ เราใช้ expect เพื่อพิมพ์ข้อความแจ้งเตือนเมื่อการอ่านไฟล์ล้มเหลว แต่ข้อความนั้นกลับพิมพ์เพียงแค่ Should have been able to read the file ทว่าการอ่านไฟล์อาจล้มเหลวได้จากหลายสาเหตุ เช่น ไฟล์อาจไม่มีอยู่จริง หรือเราอาจไม่มีสิทธิ์ (permission) ในการเปิดอ่านไฟล์นั้น ในตอนนี้ ไม่ว่าจะเกิดปัญหาจากสาเหตุใด โปรแกรมก็จะพิมพ์ข้อความเดิมซ้ำๆ ออกมา ซึ่งไม่ได้ให้ข้อมูลที่เป็นประโยชน์แก่ผู้ใช้งานเลยแม้แต่น้อย!
ประการที่สี่ เราใช้ expect ในการจัดการข้อผิดพลาด ซึ่งหากผู้ใช้สั่งรันโปรแกรมโดยระบุอาร์กิวเมนต์ไม่ครบถ้วน พวกเขาจะได้รับข้อผิดพลาด index out of bounds จาก Rust ซึ่งไม่ได้อธิบายสาเหตุของปัญหาให้ผู้ใช้เข้าใจได้อย่างชัดเจน ทางออกที่ดีที่สุดคือการรวบรวมโค้ดจัดการข้อผิดพลาด (error handling) ทั้งหมดไว้ที่จุดเดียวกัน เพื่อให้ผู้ที่จะเข้ามาดูแลโค้ดในอนาคตมีจุดให้ตรวจสอบเพียงจุดเดียวหากจำเป็นต้องแก้ไขตรรกะการจัดการข้อผิดพลาด และการรวมโค้ดจัดการข้อผิดพลาดไว้ในที่เดียวยังช่วยรับประกันว่าเราจะสามารถพิมพ์ข้อความที่สื่อความหมายและมีประโยชน์ต่อผู้ใช้งานจริงได้เสมอ
เรามาจัดการกับปัญหาทั้ง 4 ประการนี้ด้วยการรีแฟกเตอร์ (refactor) โครงสร้างโปรเจกต์ของเรากัน
การแยกความรับผิดชอบในโปรเจกต์ไบนารี
ปัญหาเรื่องโครงสร้างจากการมอบหมายหน้าที่ความรับผิดชอบหลายอย่างให้ฟังก์ชัน main ถือเป็นเรื่องที่พบได้ทั่วไปในโปรเจกต์ไบนารี ด้วยเหตุนี้ นักพัฒนา Rust จำนวนมากจึงพบว่า การแยกแยะขอบเขตความรับผิดชอบ (separation of concerns) ของโปรแกรมไบนารีให้เป็นสัดส่วนนั้นมีประโยชน์อย่างยิ่งเมื่อฟังก์ชัน main เริ่มมีขนาดใหญ่ขึ้น โดยกระบวนการนี้จะประกอบด้วยขั้นตอนดังต่อไปนี้:
- แยกโปรแกรมของคุณออกเป็นไฟล์ main.rs และไฟล์ lib.rs แล้วย้ายตรรกะการทำงานหลักของโปรแกรมไปไว้ใน lib.rs
- ตราบใดที่ตรรกะการแยกวิเคราะห์อาร์กิวเมนต์คอมมานด์ไลน์ยังคงมีขนาดเล็ก มันก็สามารถอยู่ในฟังก์ชัน
mainต่อไปได้ - เมื่อตรรกะการแยกวิเคราะห์คอมมานด์ไลน์เริ่มมีความซับซ้อน ให้แยกมันออกจากฟังก์ชัน
mainไปสร้างเป็นฟังก์ชันหรือชนิดข้อมูลต่างหาก
หน้าที่ความรับผิดชอบที่ยังคงเหลืออยู่ในฟังก์ชัน main หลังผ่านกระบวนการนี้ ควรจำกัดอยู่เพียงเรื่องต่อไปนี้เท่านั้น:
- การเรียกใช้ตรรกะแยกวิเคราะห์คอมมานด์ไลน์ด้วยค่าอาร์กิวเมนต์
- การตั้งค่าคอนฟิกูเรชันอื่นๆ ที่เกี่ยวข้อง
- การเรียกใช้ฟังก์ชัน
runใน lib.rs - การจัดการข้อผิดพลาดในกรณีที่ฟังก์ชัน
runส่งคืนข้อผิดพลาดกลับมา
รูปแบบ (pattern) นี้คือการแยกความรับผิดชอบอย่างชัดเจน: โดย main.rs จะดูแลเรื่องการเริ่มต้นสั่งทำงานโปรแกรม ส่วน lib.rs จะดูแลตรรกะการทำงานทั้งหมดของโปรแกรม และเนื่องจากคุณไม่สามารถเขียนเทสต์เพื่อทดสอบฟังก์ชัน main ได้โดยตรง โครงสร้างนี้จึงเปิดโอกาสให้คุณสามารถทดสอบตรรกะการทำงานทั้งหมดของโปรแกรมได้อย่างทั่วถึง เพราะตรรกะเหล่านั้นถูกย้ายออกจากฟังก์ชัน main มาอยู่ในไลบรารีแล้ว ทำให้โค้ดที่หลงเหลืออยู่ในฟังก์ชัน main มีขนาดกะทัดรัดพอที่จะตรวจสอบความถูกต้องได้เพียงแค่อ่านด้วยสายตา เรามาปรับปรุงโครงสร้างโปรแกรมของเราตามขั้นตอนเหล่านี้กัน
การแยกตัวแยกวิเคราะห์อาร์กิวเมนต์ออกมา
เราจะแยกฟังก์ชันการทำงานสำหรับแยกวิเคราะห์อาร์กิวเมนต์ออกมาเป็นฟังก์ชันใหม่เพื่อให้ main เรียกใช้ ลิสติ้ง 12-5 แสดงจุดเริ่มต้นใหม่ของฟังก์ชัน main ที่เรียกฟังก์ชันใหม่ชื่อ parse_config ซึ่งเราจะนิยามไว้ในไฟล์ src/main.rs
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let (query, file_path) = parse_config(&args);
// --snip--
println!("Searching for {query}");
println!("In file {file_path}");
let contents = fs::read_to_string(file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
fn parse_config(args: &[String]) -> (&str, &str) {
let query = &args[1];
let file_path = &args[2];
(query, file_path)
}เรายังคงรวบรวมอาร์กิวเมนต์คอมมานด์ไลน์เข้ามาไว้ในเวกเตอร์เช่นเดิม แต่แทนที่จะกำหนดค่าอาร์กิวเมนต์ดัชนีที่ 1 ให้กับตัวแปร query และค่าดัชนีที่ 2 ให้กับตัวแปร file_path ภายในฟังก์ชัน main เราจะส่งเวกเตอร์ทั้งชุดไปยังฟังก์ชัน parse_config แทน ฟังก์ชัน parse_config จะเป็นผู้ดูแลตรรกะในการระบุว่าอาร์กิวเมนต์ใดควรเป็นของตัวแปรใด แล้วส่งค่าเหล่านั้นกลับคืนมาให้ main แม้เราจะยังคงประกาศตัวแปร query และ file_path ใน main อยู่ แต่ main ก็ไม่ต้องแบกรับหน้าที่ในการจับคู่อาร์กิวเมนต์คอมมานด์ไลน์เข้ากับตัวแปรต่างๆ อีกต่อไป
การปรับเปลี่ยนโครงสร้างนี้อาจดูเหมือนทำเกินความจำเป็นสำหรับโปรแกรมขนาดเล็กของเรา แต่เรากำลังทำการรีแฟกเตอร์เป็นขั้นย่อยๆ ทีละสเต็ปอย่างรอบคอบ หลังจากแก้ไขจุดนี้แล้ว ให้ลองสั่งรันโปรแกรมอีกครั้งเพื่อตรวจสอบว่าการแยกวิเคราะห์อาร์กิวเมนต์ยังคงทำงานได้ถูกต้อง การหมั่นตรวจสอบผลงานเป็นระยะๆ จะช่วยให้คุณระบุสาเหตุของปัญหาได้อย่างรวดเร็วหากมีสิ่งใดผิดพลาด
การจัดกลุ่มค่าการกำหนดค่า
เราสามารถก้าวไปอีกขั้นหนึ่งเพื่อปรับปรุงฟังก์ชัน parse_config ให้ดียิ่งขึ้น ในขณะนี้ ฟังก์ชันของเราส่งคืนผลลัพธ์เป็นทูเพิล แต่หลังจากนั้นเรากลับแยกทูเพิลออกเป็นตัวแปรเดี่ยวๆ ในทันที ซึ่งเป็นสัญญาณที่บ่งชี้ว่าการออกแบบแอบสแทร็กชันของเราอาจยังไม่เหมาะสมที่สุด
ข้อสังเกตอีกประการหนึ่งคือ คำว่า config ในชื่อ parse_config สื่อเป็นนัยว่าค่าทั้งสองค่าที่เราส่งคืนนั้นมีความเกี่ยวข้องกันอย่างใกล้ชิด และต่างเป็นส่วนประกอบของค่าคอนฟิกูเรชันชุดเดียวกัน ทว่าในปัจจุบันโครงสร้างข้อมูลของเรายังไม่ได้สื่อความหมายนี้เลย นอกเหนือจากการรวมพวกมันไว้ในทูเพิล ดังนั้น เราจึงควรนำค่าทั้งสองมาจัดเก็บไว้ใน struct เดียวกัน พร้อมทั้งตั้งชื่อฟิลด์ของ struct ให้สื่อความหมายอย่างชัดเจน การทำเช่นนี้จะช่วยให้ผู้ที่จะเข้ามาดูแลโค้ดนี้ในอนาคตเข้าใจได้ง่ายขึ้นว่าค่าต่างๆ มีความสัมพันธ์กันอย่างไรและมีจุดประสงค์เพื่ออะไร
ลิสติ้ง 12-6 แสดงการปรับปรุงฟังก์ชัน parse_config
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let config = parse_config(&args);
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
// --snip--
println!("With text:\n{contents}");
}
struct Config {
query: String,
file_path: String,
}
fn parse_config(args: &[String]) -> Config {
let query = args[1].clone();
let file_path = args[2].clone();
Config { query, file_path }
}เราได้เพิ่ม struct ชื่อ Config ที่มีฟิลด์ query และ file_path โดยซิกเนเจอร์ของ parse_config ในตอนนี้ระบุว่าจะส่งคืนค่าเป็น Config ในเนื้อหาของ parse_config เดิมทีเราเคยส่งคืนสตริงสไลซ์ (string slice) ที่อ้างอิงไปยังค่า String ใน args แต่ตอนนี้เราได้นิยาม Config ให้ถือครองค่า String ที่เป็นเจ้าของข้อมูลเอง เนื่องจากตัวแปร args ในฟังก์ชัน main เป็นเจ้าของค่าของอาร์กิวเมนต์ และเพียงแค่เปิดให้ฟังก์ชัน parse_config ยืมค่าเหล่านั้นไปใช้งานเท่านั้น หาก Config พยายามเข้าครอบครองความเป็นเจ้าของค่าใน args โดยตรง ก็จะถือเป็นการละเมิดกฎการยืมของ Rust
มีหลายวิธีในการจัดการกับข้อมูล String นี้ ซึ่งวิธีที่ง่ายที่สุดแม้จะสิ้นเปลืองทรัพยากรอยู่บ้าง คือการเรียกใช้เมธอด clone บนค่านั้น วิธีนี้จะสร้างสำเนาข้อมูลชุดใหม่ขึ้นมาให้อินสแตนซ์ของ Config เป็นเจ้าของ ซึ่งย่อมใช้เวลาและหน่วยความจำมากกว่าการเก็บเพียงแค่เรเฟอเรนซ์ ทว่าการโคลนข้อมูลจะช่วยให้โค้ดของเราเข้าใจง่ายและตรงไปตรงมามาก เนื่องจากเราไม่ต้องคอยจัดการเรื่องไลฟ์ไทม์ของเรเฟอเรนซ์ ในบริบทนี้ การยอมแลกประสิทธิภาพเพียงเล็กน้อยเพื่อให้ได้โค้ดที่เรียบง่ายจึงเป็นการแลกเปลี่ยนที่คุ้มค่า
ข้อแลกเปลี่ยนของการใช้
cloneนักพัฒนา Rust ส่วนใหญ่มักพยายามหลีกเลี่ยงการใช้
cloneในการแก้ปัญหาความเป็นเจ้าของ เนื่องจากมีต้นทุนตอนรันไทม์ ในบทที่ 13 คุณจะได้เรียนรู้วิธีการที่มีประสิทธิภาพสูงกว่านี้ในการจัดการกับสถานการณ์ดังกล่าว แต่สำหรับตอนนี้ การทำสำเนาสตริงเพียงไม่กี่ตัวเพื่อช่วยให้การพัฒนาคืบหน้าต่อไปได้ถือเป็นเรื่องที่ยอมรับได้ เพราะเราทำสำเนาเพียงแค่ครั้งเดียว อีกทั้งพาธไฟล์และสตริง query ก็มีขนาดเล็กมาก การมีโปรแกรมที่ทำงานได้ถูกต้องแม้จะด้อยประสิทธิภาพไปบ้าง ย่อมดีกว่าการพยายามปรับแต่งโค้ดให้เร็วที่สุดตั้งแต่รอบแรก เมื่อคุณสั่งสมประสบการณ์กับ Rust มากขึ้น คุณจะสามารถเริ่มต้นด้วยแนวทางที่มีประสิทธิภาพสูงได้อย่างเป็นธรรมชาติ แต่ในเวลานี้ การเรียกใช้cloneถือเป็นเรื่องที่ยอมรับได้อย่างสมบูรณ์
เราได้อัปเดตฟังก์ชัน main ให้นำอินสแตนซ์ของ Config ที่ส่งคืนจาก parse_config ไปเก็บไว้ในตัวแปรชื่อ config และอัปเดตโค้ดส่วนที่เคยเรียกใช้ตัวแปร query และ file_path แยกกัน ให้เปลี่ยนมาเรียกใช้ผ่านฟิลด์ของ struct Config แทน
ในตอนนี้ โค้ดของเราสื่อสารได้อย่างชัดเจนแล้วว่า query และ file_path มีความเกี่ยวข้องกัน และมีวัตถุประสงค์เพื่อใช้กำหนดค่าการทำงานของโปรแกรม ไม่ว่าโค้ดส่วนใดที่ต้องการใช้ค่าเหล่านี้ ก็จะทราบได้ทันทีว่าจะค้นพบมันได้ในอินสแตนซ์ config ภายใต้ชื่อฟิลด์ที่ตรงกับจุดประสงค์การใช้งาน
การสร้างคอนสตรัคเตอร์ให้ Config
จนถึงตอนนี้ เราได้แยกตรรกะการแยกวิเคราะห์อาร์กิวเมนต์คอมมานด์ไลน์ออกจาก main มาไว้ในฟังก์ชัน parse_config เรียบร้อยแล้ว ซึ่งช่วยให้เรามองเห็นว่าค่า query และ file_path มีความสัมพันธ์กัน และควรสะท้อนความสัมพันธ์นั้นออกมาในโค้ด จากนั้นเราได้สร้าง struct Config เพื่อระบุวัตถุประสงค์ร่วมกันของ query และ file_path และทำให้สามารถส่งคืนค่าเหล่านั้นในรูปของฟิลด์ภายใน struct ออกมาจากฟังก์ชัน parse_config ได้
ดังนั้น ในเมื่อจุดประสงค์ของฟังก์ชัน parse_config คือการสร้างอินสแตนซ์ของ Config เราจึงสามารถเปลี่ยน parse_config จากฟังก์ชันธรรมดาให้กลายเป็นฟังก์ชันชื่อ new ที่ผูกอยู่กับ struct Config ได้ การปรับเปลี่ยนนี้จะช่วยให้โค้ดเป็นไปตามสำนวนนิยมของ Rust มากยิ่งขึ้น เช่นเดียวกับการสร้างอินสแตนซ์ของชนิดข้อมูลในไลบรารีมาตรฐานอย่าง String ด้วยคำสั่ง String::new การเปลี่ยน parse_config ให้เป็นฟังก์ชัน new ของ Config ก็จะทำให้เราสามารถสร้างอินสแตนซ์ของ Config ได้ด้วยคำสั่ง Config::new ลิสติ้ง 12-7 แสดงการปรับเปลี่ยนที่เราต้องทำ
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::new(&args);
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
// --snip--
}
// --snip--
struct Config {
query: String,
file_path: String,
}
impl Config {
fn new(args: &[String]) -> Config {
let query = args[1].clone();
let file_path = args[2].clone();
Config { query, file_path }
}
}เราได้อัปเดต main ตรงที่เราเคยเรียก parse_config ให้เรียก Config::new แทน เราเปลี่ยนชื่อ parse_config เป็น new และย้ายมันเข้าไปในบล็อก impl ซึ่งเชื่อมโยงฟังก์ชัน new กับ Config ลองคอมไพล์โค้ดนี้อีกครั้งเพื่อให้แน่ใจว่ามันทำงานได้
การแก้ไขการจัดการข้อผิดพลาด
คราวนี้เราจะมาปรับปรุงการจัดการข้อผิดพลาดให้รัดกุมยิ่งขึ้น ย้อนกลับไปก่อนหน้านี้ การพยายามเข้าถึงค่าในเวกเตอร์ args ที่ดัชนี 1 หรือ 2 จะทำให้โปรแกรมเกิดการแพนิก (panic) ทันทีหากเวกเตอร์มีสมาชิกน้อยกว่า 3 ตัว ลองรันโปรแกรมโดยไม่ใส่อาร์กิวเมนต์ใดๆ เลย จะได้ผลลัพธ์ดังนี้:
$ cargo run
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep`
thread 'main' (6023615) panicked at src/main.rs:27:21:
index out of bounds: the len is 1 but the index is 1
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
บรรทัด index out of bounds: the len is 1 but the index is 1 เป็นข้อความแสดงข้อผิดพลาดที่มุ่งหมายสำหรับโปรแกรมเมอร์ มันไม่ช่วยให้ผู้ใช้ปลายทางของเราเข้าใจว่าพวกเขาควรทำอะไรแทน มาลองแก้ปัญหานี้กันเลย
การปรับปรุงข้อความแสดงข้อผิดพลาด
ในลิสติ้ง 12-8 เราได้เพิ่มการตรวจสอบเงื่อนไขในฟังก์ชัน new เพื่อยืนยันว่าสไลซ์มีความยาวเพียงพอก่อนที่จะพยายามเข้าถึงดัชนี 1 และดัชนี 2 หากสไลซ์มีความยาวไม่พอ โปรแกรมจะแพนิกพร้อมแสดงข้อความแจ้งเตือนที่เข้าใจง่ายขึ้น
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::new(&args);
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
struct Config {
query: String,
file_path: String,
}
impl Config {
// --snip--
fn new(args: &[String]) -> Config {
if args.len() < 3 {
panic!("not enough arguments");
}
// --snip--
let query = args[1].clone();
let file_path = args[2].clone();
Config { query, file_path }
}
}โค้ดนี้คล้ายกับฟังก์ชัน Guess::new ที่เราเขียนในลิสติ้ง 9-13 ซึ่งเราเรียก panic! เมื่ออาร์กิวเมนต์ value อยู่นอกช่วงของค่าที่ถูกต้อง แทนที่จะตรวจสอบช่วงของค่าที่นี่ เราตรวจสอบว่าความยาวของ args อย่างน้อย 3 และส่วนที่เหลือของฟังก์ชันสามารถทำงานภายใต้สมมติฐานว่าเงื่อนไขนี้เป็นจริงได้ หาก args มีสมาชิกน้อยกว่าสามรายการ เงื่อนไขนี้จะเป็น true และเราเรียกมาโคร panic! เพื่อยุติโปรแกรมทันที
หลังจากเพิ่มโค้ดไม่กี่บรรทัดนี้ลงใน new ลองสั่งรันโปรแกรมโดยไม่ใส่อาร์กิวเมนต์อีกครั้ง เพื่อดูว่าข้อความข้อผิดพลาดเปลี่ยนไปอย่างไร:
$ cargo run
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep`
thread 'main' (6023776) panicked at src/main.rs:26:13:
not enough arguments
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
ผลลัพธ์นี้ดูดีขึ้นมาก: ตอนนี้เรามีข้อความแสดงข้อผิดพลาดที่สมเหตุสมผลแล้ว ทว่าก็ยังมีข้อมูลส่วนเกินอื่นๆ แสดงออกมาด้วย ซึ่งเป็นข้อมูลที่ผู้ใช้งานไม่จำเป็นต้องเห็น เทคนิคที่เราเคยใช้ในลิสติ้ง 9-13 อาจไม่ใช่ทางเลือกที่ดีที่สุดสำหรับกรณีนี้: เนื่องจากการเรียก panic! เหมาะสมกับข้อผิดพลาดเชิงการเขียนโปรแกรมมากกว่าปัญหาด้านการใช้งานของผู้ใช้ ดังที่เราได้อธิบายไว้ในบทที่ 9 ดังนั้น เราจะเปลี่ยนมาใช้เทคนิคอีกแบบหนึ่งที่คุณได้เรียนรู้ในบทที่ 9 แทน นั่นคือการคืนค่า Result ที่บ่งชี้ว่าสำเร็จหรือเกิดข้อผิดพลาด
การคืนค่า Result แทนการเรียก panic!
เราสามารถปรับเปลี่ยนมาส่งคืนค่าชนิด Result ซึ่งจะบรรจุอินสแตนซ์ของ Config ในกรณีที่สำเร็จ และจะอธิบายสาเหตุของปัญหาในกรณีที่เกิดข้อผิดพลาด นอกจากนี้ เราจะเปลี่ยนชื่อฟังก์ชันจาก new เป็น build เนื่องจากนักพัฒนาส่วนใหญ่มักคาดหวังว่าฟังก์ชัน new จะต้องไม่ล้มเหลว เมื่อ Config::build ติดต่อสื่อสารกับ main เราสามารถใช้ชนิดข้อมูล Result เพื่อส่งสัญญาณเตือนว่าเกิดปัญหาขึ้นได้ จากนั้นเราจะปรับแก้ฟังก์ชัน main ให้แปลงวาเรียนต์ Err ออกมาเป็นข้อความแจ้งข้อผิดพลาดที่เหมาะสมกับผู้ใช้งาน โดยไม่มีข้อความรกรุงรังเกี่ยวกับ thread 'main' และ RUST_BACKTRACE ที่เกิดจากการเรียก panic! ติดมาด้วย
ลิสติ้ง 12-9 แสดงการเปลี่ยนแปลงที่เราต้องทำกับค่าที่คืนกลับของฟังก์ชันที่ตอนนี้เราเรียกว่า Config::build และเนื้อในของฟังก์ชันที่จำเป็นในการคืนค่า Result โปรดสังเกตว่ามันจะยังไม่คอมไพล์จนกว่าเราจะอัปเดต main ด้วย ซึ่งเราจะทำในลิสติ้งถัดไป
use std::env;
use std::fs;
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::new(&args);
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}ฟังก์ชัน build ของเราจะส่งคืนค่า Result ที่บรรจุอินสแตนซ์ของ Config ในกรณีสำเร็จ และบรรจุสตริงลิเทอรัลในกรณีที่เกิดข้อผิดพลาด โดยค่าข้อผิดพลาดของเราจะเป็นสตริงลิเทอรัลที่มีไลฟ์ไทม์เป็น 'static เสมอ
เราได้ทำการแก้ไขเนื้อหาของฟังก์ชัน 2 จุด: แทนที่จะเรียกใช้ panic! เมื่อผู้ใช้ส่งอาร์กิวเมนต์มาไม่ครบถ้วน ตอนนี้เราจะส่งคืนค่า Err แทน และเราได้ห่อหุ้มค่า Config ที่ส่งคืนไว้ภายใน Ok การเปลี่ยนแปลงเหล่านี้ทำให้การทำงานของฟังก์ชันสอดคล้องกับซิกเนเจอร์ชนิดข้อมูลใหม่ของมันอย่างสมบูรณ์
การส่งคืนค่า Err จาก Config::build เปิดโอกาสให้ฟังก์ชัน main สามารถจัดการกับค่า Result ที่ได้รับ และสามารถสั่งปิดโปรเซสการทำงานได้อย่างนุ่มนวลและเรียบร้อยยิ่งขึ้นในยามที่เกิดข้อผิดพลาด
การเรียก Config::build และการจัดการข้อผิดพลาด
เพื่อจัดการกับกรณีที่เกิดข้อผิดพลาดและพิมพ์ข้อความที่เป็นมิตรต่อผู้ใช้งาน เราจำเป็นต้องอัปเดตฟังก์ชัน main ให้คอยจัดการกับค่า Result ที่ส่งคืนมาจาก Config::build ดังที่แสดงในลิสติ้ง 12-10 นอกจากนี้เราจะออกจากโปรแกรมคอมมานด์ไลน์ด้วยรหัสสถานะที่ไม่ใช่ศูนย์ (nonzero error code) โดยเขียนจัดการด้วยตนเองแทนการพึ่งพา panic! ทั้งนี้ รหัสสถานะการออกที่ไม่ใช่ศูนย์ถือเป็นธรรมเนียมปฏิบัติสากลเพื่อส่งสัญญาณบอกโปรเซสที่เรียกใช้โปรแกรมของเราว่า โปรแกรมได้ยุติการทำงานลงเนื่องจากเกิดข้อผิดพลาดขึ้น
use std::env;
use std::fs;
use std::process;
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
// --snip--
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}ในลิสติ้งนี้ เราได้ใช้เมธอดที่เรายังไม่ได้อธิบายอย่างละเอียด นั่นคือ unwrap_or_else ซึ่งถูกนิยามไว้บน Result<T, E> ในไลบรารีมาตรฐาน การใช้ unwrap_or_else ช่วยให้เราสามารถกำหนดตรรกะการจัดการข้อผิดพลาดในแบบของเราเองได้โดยไม่ต้องเกิด panic! หากค่า Result เป็น Ok พฤติกรรมของเมธอดนี้จะเหมือนกับ unwrap คือจะแกะค่าภายในที่ Ok ห่อหุ้มไว้ออกมาให้ แต่หากค่านั้นเป็น Err เมธอดนี้จะเรียกใช้โค้ดที่อยู่ใน_โคลเชอร์_ (closure) ซึ่งเป็นฟังก์ชันนิรนามที่เรานิยามและส่งเป็นอาร์กิวเมนต์ให้กับ unwrap_or_else เราจะได้เรียนรู้เรื่องโคลเชอร์อย่างละเอียดในบทที่ 13 สำหรับตอนนี้ คุณเพียงแค่ต้องทราบว่า unwrap_or_else จะส่งค่าภายในของ Err ซึ่งในกรณีนี้คือสตริงสแตติก "not enough arguments" ที่เรากำหนดไว้ในลิสติ้ง 12-9 เข้ามายังโคลเชอร์ผ่านทางอาร์กิวเมนต์ err ที่อยู่ระหว่างเส้นแนวตั้ง ทำให้โค้ดในโคลเชอร์สามารถนำค่า err นี้ไปใช้งานได้
เราได้เพิ่มบรรทัด use ใหม่เพื่อนำเข้ามอดูล process จากไลบรารีมาตรฐาน โดยโค้ดในโคลเชอร์ที่จะทำงานเมื่อเกิดข้อผิดพลาดมีเพียง 2 บรรทัดเท่านั้น: บรรทัดแรกสั่งพิมพ์ค่า err ออกมา และบรรทัดถัดไปเรียกใช้คำสั่ง process::exit โดยฟังก์ชัน process::exit จะสั่งหยุดการทำงานของโปรแกรมในทันที และส่งคืนตัวเลขที่ระบุเป็นรหัสสถานะการออก สิ่งนี้คล้ายกับการจัดการที่ใช้ panic! ซึ่งเราใช้ในลิสติ้ง 12-8 แต่เราไม่ต้องเห็นเอาต์พุตเกินจำเป็นทั้งหมดอีกต่อไป มาลองกัน:
$ cargo run
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.48s
Running `target/debug/minigrep`
Problem parsing arguments: not enough arguments
ยอดเยี่ยม! ผลลัพธ์ที่ได้มีความเป็นมิตรและเข้าใจง่ายสำหรับผู้ใช้งานมากขึ้นอย่างเห็นได้ชัด
การแยกตรรกะออกจาก main
เมื่อเรารีแฟกเตอร์ส่วนแยกวิเคราะห์การกำหนดค่าเสร็จเรียบร้อยแล้ว คราวนี้เรามามุ่งเน้นที่ตรรกะการทำงานหลักของโปรแกรมกันบ้าง ตามที่เราได้วางแผนไว้ใน“การแยกความรับผิดชอบในโปรเจกต์ไบนารี” เราจะแยกฟังก์ชันใหม่ชื่อ run ออกมา เพื่อบรรจุตรรกะการทำงานทั้งหมดที่เคยอยู่ในฟังก์ชัน main ซึ่งไม่เกี่ยวข้องกับการตั้งค่าคอนฟิกูเรชันหรือการจัดการข้อผิดพลาด เมื่อทำเสร็จสิ้น ฟังก์ชัน main จะมีความกระชับและตรวจสอบความถูกต้องได้ง่ายเพียงแค่กวาดสายตาอ่าน อีกทั้งเรายังสามารถเขียนชุดทดสอบให้กับตรรกะส่วนอื่นๆ ทั้งหมดได้อีกด้วย
ลิสติ้ง 12-11 แสดงการปรับปรุงแบบค่อยเป็นค่อยไปเล็กๆ ด้วยการแยกฟังก์ชัน run ออกมา
use std::env;
use std::fs;
use std::process;
fn main() {
// --snip--
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
run(config);
}
fn run(config: Config) {
let contents = fs::read_to_string(config.file_path)
.expect("Should have been able to read the file");
println!("With text:\n{contents}");
}
// --snip--
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}ในตอนนี้ ฟังก์ชัน run ได้รวบรวมตรรกะการทำงานที่เหลือทั้งหมดจาก main เริ่มตั้งแต่การอ่านไฟล์ โดยฟังก์ชัน run จะรับอินสแตนซ์ของ Config เป็นอาร์กิวเมนต์
การคืนค่าข้อผิดพลาดจาก run
เมื่อตรรกะส่วนที่เหลือของโปรแกรมถูกแยกออกมาอยู่ในฟังก์ชัน run เรียบร้อยแล้ว เราก็สามารถปรับปรุงการจัดการข้อผิดพลาดให้ดียิ่งขึ้นได้ เช่นเดียวกับที่เราเคยทำกับ Config::build ในลิสติ้ง 12-9 แทนที่จะปล่อยให้โปรแกรมเกิดการแพนิกด้วยการเรียก expect เราจะให้ฟังก์ชัน run ส่งคืนค่า Result<T, E> เมื่อมีสิ่งใดผิดพลาด ซึ่งจะช่วยให้เราสามารถรวบรวมตรรกะการจัดการข้อผิดพลาดทั้งหมดไปไว้ที่ main ในรูปแบบที่เป็นมิตรต่อผู้ใช้งาน ลิสติ้ง 12-12 แสดงการเปลี่ยนแปลงที่เราต้องทำกับซิกเนเจอร์และเนื้อหาของฟังก์ชัน run
use std::env;
use std::fs;
use std::process;
use std::error::Error;
// --snip--
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
run(config);
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
println!("With text:\n{contents}");
Ok(())
}
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}เราได้ทำการเปลี่ยนแปลงสำคัญ 3 ประการด้วยกัน อย่างแรก เราเปลี่ยนชนิดข้อมูลที่ส่งคืนของฟังก์ชัน run เป็น Result<(), Box<dyn Error>> โดยเดิมทีฟังก์ชันนี้ส่งคืนยูนิตไทป์ (unit type) คือ () และเรายังคงค่านั้นไว้เป็นค่าที่ส่งคืนในกรณีที่เป็น Ok
สำหรับชนิดข้อผิดพลาด เราได้ใช้เทรตออบเจกต์ (trait object) คือ Box<dyn Error> (และเราได้นำเข้า std::error::Error สู่สโคปด้วยคำสั่ง use ที่ด้านบน) เราจะได้เรียนรู้เรื่องเทรตออบเจกต์อย่างละเอียดในบทที่ 18 สำหรับตอนนี้ ขอให้เข้าใจว่า Box<dyn Error> หมายความว่าฟังก์ชันจะส่งคืนชนิดข้อมูลใดๆ ก็ตามที่อิมพลีเมนต์เทรต Error โดยที่เราไม่ต้องเจาะจงระบุชนิดข้อมูลที่แน่นอน ซึ่งมอบความยืดหยุ่นในการส่งคืนข้อผิดพลาดที่อาจมีชนิดแตกต่างกันในแต่ละสถานการณ์ โดยคีย์เวิร์ด dyn ย่อมาจากคำว่า dynamic
ประการที่สอง เราได้ตัดการเรียกใช้ expect ออก แล้วแทนที่ด้วยตัวดำเนินการ ? ตามที่เราเคยเรียนรู้ในบทที่ 9 แทนที่จะเกิด panic! เมื่อมีข้อผิดพลาด ตัวดำเนินการ ? จะส่งต่อ (propagate) ค่าข้อผิดพลาดนั้นออกจากฟังก์ชันปัจจุบันเพื่อให้ฟังก์ชันผู้เรียกเป็นผู้จัดการแทน
ประการที่สาม ฟังก์ชัน run จะส่งคืนค่า Ok ในกรณีที่ทำงานสำเร็จ เนื่องจากเราได้ประกาศชนิดข้อมูลสำหรับกรณีสำเร็จในซิกเนเจอร์เป็น () เราจึงต้องห่อค่ายูนิตไทป์ไว้ภายใน Ok รูปแบบวากยสัมพันธ์ Ok(()) นี้อาจดูแปลกตาไปบ้างในตอนแรก แต่การใช้ () เช่นนี้ถือเป็นสำนวนนิยมใน Rust ที่บ่งบอกว่าเราเรียกใช้ฟังก์ชัน run เพื่อผลข้างเคียง (side effects) เท่านั้น โดยไม่ได้ต้องการค่าผลลัพธ์ใดๆ กลับคืนมา
เมื่อคุณสั่งรันโค้ดนี้ โปรแกรมจะสามารถคอมไพล์ผ่านได้ แต่จะแสดงคำเตือน (warning) ออกมา:
$ cargo run -- the poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
warning: unused `Result` that must be used
--> src/main.rs:19:5
|
19 | run(config);
| ^^^^^^^^^^^
|
= note: this `Result` may be an `Err` variant, which should be handled
= note: `#[warn(unused_must_use)]` (part of `#[warn(unused)]`) on by default
help: use `let _ = ...` to ignore the resulting value
|
19 | let _ = run(config);
| +++++++
warning: `minigrep` (bin "minigrep") generated 1 warning
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.71s
Running `target/debug/minigrep the poem.txt`
Searching for the
In file poem.txt
With text:
I'm nobody! Who are you?
Are you nobody, too?
Then there's a pair of us - don't tell!
They'd banish us, you know.
How dreary to be somebody!
How public, like a frog
To tell your name the livelong day
To an admiring bog!
Rust กำลังเตือนว่าโค้ดของเราไม่ได้สนใจค่า Result ที่ได้รับมาเลย ซึ่งค่า Result นั้นอาจเป็นตัวบ่งบอกว่าเกิดข้อผิดพลาดขึ้น แต่เรากลับไม่ได้ตรวจสอบอะไร และคอมไพเลอร์จึงเตือนสติเราว่า เราน่าจะลืมเขียนโค้ดสำหรับจัดการข้อผิดพลาดตรงจุดนี้! มาแก้ไขปัญหานี้กันต่อเลย
การจัดการข้อผิดพลาดที่คืนกลับจาก run ใน main
เราจะตรวจสอบและจัดการกับข้อผิดพลาดโดยใช้เทคนิคที่คล้ายคลึงกับที่เราเคยใช้กับ Config::build ในลิสติ้ง 12-10 แต่มีความแตกต่างกันเล็กน้อย:
ชื่อไฟล์: src/main.rs
use std::env;
use std::error::Error;
use std::fs;
use std::process;
fn main() {
// --snip--
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
println!("Searching for {}", config.query);
println!("In file {}", config.file_path);
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
println!("With text:\n{contents}");
Ok(())
}
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}เราเลือกใช้ if let แทน unwrap_or_else ในการตรวจสอบว่าฟังก์ชัน run ส่งคืนค่าเป็น Err หรือไม่ และสั่งเรียก process::exit(1) หากเกิดข้อผิดพลาดขึ้น เนื่องจากฟังก์ชัน run ไม่ได้ส่งคืนค่าที่เราต้องการนำมา unwrap เหมือนกรณีของ Config::build ที่ส่งคืนอินสแตนซ์ของ Config และเนื่องจากในกรณีสำเร็จ run จะส่งคืนเพียงแค่ () เราจึงสนใจเพียงแค่การตรวจจับข้อผิดพลาดเท่านั้น โดยไม่จำเป็นต้องใช้ unwrap_or_else เพื่อแกะเอาค่า () ออกมา
เนื้อหาการทำงานภายในบล็อก if let ก็จะเหมือนกับใน unwrap_or_else ทุกประการ: คือเราจะสั่งพิมพ์ข้อความข้อผิดพลาดออกมา แล้วสั่งปิดโปรแกรม
การแยกโค้ดออกเป็นเครตไลบรารี
โปรเจกต์ minigrep ของเราเริ่มเป็นรูปเป็นร่างและมีโครงสร้างที่ดีขึ้นมาก! คราวนี้เราจะทำการแยกไฟล์ src/main.rs โดยย้ายโค้ดบางส่วนไปไว้ในไฟล์ src/lib.rs ซึ่งจะช่วยให้เราสามารถเขียนชุดทดสอบให้กับโค้ดได้ และทำให้ไฟล์ src/main.rs มีภาระหน้าที่น้อยลง
เราจะย้ายโค้ดส่วนที่รับผิดชอบเรื่องการค้นหาข้อความไปไว้ใน src/lib.rs แทนที่จะอยู่ใน src/main.rs ซึ่งจะเปิดโอกาสให้เรา (หรือใครก็ตามที่นำไลบรารี minigrep ของเราไปใช้) สามารถเรียกใช้ฟังก์ชันค้นหานี้ในบริบทอื่นๆ นอกเหนือจากโปรแกรมไบนารี minigrep ได้
อันดับแรก เราจะนิยามซิกเนเจอร์ของฟังก์ชัน search ใน src/lib.rs ดังที่แสดงในลิสติ้ง 12-13 โดยใส่เนื้อหาชั่วคราวเป็นคำสั่งเรียกใช้มาโคร unimplemented! เราจะอธิบายซิกเนเจอร์นี้อย่างละเอียดอีกครั้งเมื่อเราเริ่มลงมือเขียนการทำงานจริง
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
unimplemented!();
}เราได้ใส่คีย์เวิร์ด pub ไว้หน้าการนิยามฟังก์ชัน เพื่อกำหนดให้ search กลายมาเป็นส่วนหนึ่งของ API สาธารณะในเครตไลบรารีของเรา ในตอนนี้เราจึงมีเครตไลบรารีที่พร้อมให้เครตไบนารีเรียกใช้งาน และพร้อมสำหรับการเขียนชุดทดสอบแล้ว!
ขั้นตอนถัดไป เราต้องนำโค้ดที่นิยามไว้ใน src/lib.rs เข้ามาสู่สโคปของเครตไบนารีใน src/main.rs แล้วเรียกใช้งาน ดังที่แสดงในลิสติ้ง 12-14
use std::env;
use std::error::Error;
use std::fs;
use std::process;
// --snip--
use minigrep::search;
fn main() {
// --snip--
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
// --snip--
struct Config {
query: String,
file_path: String,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
for line in search(&config.query, &contents) {
println!("{line}");
}
Ok(())
}เราเพิ่มคำสั่ง use minigrep::search; เพื่อนำฟังก์ชัน search จากเครตไลบรารีเข้ามาสู่สโคปของเครตไบนารี จากนั้นในฟังก์ชัน run แทนที่เราจะพิมพ์เนื้อหาทั้งหมดของไฟล์ออกมาเฉยๆ เราจะเรียกใช้ฟังก์ชัน search โดยส่งค่า config.query และ contents เข้าไปเป็นอาร์กิวเมนต์ แล้วฟังก์ชัน run จะใช้ลูป for วนพิมพ์แต่ละบรรทัดที่ฟังก์ชัน search ส่งคืนกลับมาซึ่งตรงกับคำค้นหา นอกจากนี้ จังหวะนี้ยังเป็นโอกาสอันดีที่เราจะตัดคำสั่ง println! ในฟังก์ชัน main ที่เคยพิมพ์ค่า query และพาธไฟล์ออกไป เพื่อให้โปรแกรมของเราพิมพ์เฉพาะผลลัพธ์การค้นหาล้วนๆ (หากไม่เกิดข้อผิดพลาดใดๆ)
โปรดสังเกตว่า ฟังก์ชันค้นหาจะรวบรวมผลลัพธ์ทั้งหมดเก็บไว้ในเวกเตอร์ก่อนที่จะส่งคืนกลับมา แล้วจึงค่อยเริ่มพิมพ์ผลลัพธ์ออกมาทีละบรรทัด การอิมพลีเมนต์เช่นนี้อาจทำให้การแสดงผลลัพธ์เกิดความล่าช้าได้เมื่อค้นหาในไฟล์ขนาดใหญ่มาก เนื่องจากผลลัพธ์ไม่ได้ถูกพิมพ์ออกมาทันทีที่ตรวจพบ ซึ่งเราจะพูดถึงแนวทางแก้ไขปัญหานี้ด้วยการใช้อิเทอเรเตอร์ (iterator) ในบทที่ 13
เฮ้อ! แม้จะต้องลงแรงปรับเปลี่ยนโค้ดไปพอสมควร แต่เราก็ได้วางรากฐานอันมั่นคงไว้สำหรับก้าวต่อไปในอนาคตเรียบร้อยแล้ว ในตอนนี้การจัดการข้อผิดพลาดทำได้ง่ายขึ้นมาก โค้ดก็มีความเป็นโมดูลาร์อย่างเป็นระเบียบ และนับจากนี้เป็นต้นไป การพัฒนาเกือบทั้งหมดของเราจะทำอยู่ในไฟล์ src/lib.rs
มาใช้ประโยชน์จากโครงสร้างที่แยกเป็นโมดูลนี้ ทำสิ่งที่จะทำได้ยากยิ่งหากใช้โค้ดแบบเดิม แต่กลับทำได้ง่ายดายด้วยโค้ดโครงสร้างใหม่: เราจะมาเขียนชุดทดสอบกัน!
เพิ่มฟังก์ชันการทำงานด้วยการพัฒนาแบบขับเคลื่อนด้วยเทสต์
เพิ่มฟังก์ชันการทำงานด้วยการพัฒนาแบบขับเคลื่อนด้วยเทสต์
เมื่อเราแยกตรรกะการค้นหามาไว้ใน src/lib.rs ต่างหากจากฟังก์ชัน main แล้ว การเขียนเทสต์สำหรับฟังก์ชันการทำงานหลักของโค้ดเราจึงง่ายขึ้นมาก เราสามารถเรียกใช้ฟังก์ชันโดยตรงพร้อมส่งอาร์กิวเมนต์ต่าง ๆ แล้วตรวจสอบค่าที่ส่งกลับมาได้ โดยไม่ต้องสั่งรันโปรแกรมไบนารีของเราจากบรรทัดคำสั่ง
ในหัวข้อนี้ เราจะเพิ่มตรรกะการค้นหาให้กับโปรแกรม minigrep โดยใช้กระบวนการพัฒนาแบบขับเคลื่อนด้วยเทสต์ (test-driven development หรือ TDD) ซึ่งมีขั้นตอนดังต่อไปนี้:
- เขียนเทสต์ที่ล้มเหลว แล้วรันดูเพื่อให้แน่ใจว่ามันล้มเหลวด้วยเหตุผลที่คุณคาดไว้จริง ๆ
- เขียนหรือแก้ไขโค้ดเพียงพอที่จะทำให้เทสต์ใหม่นั้นผ่าน
- รีแฟกเตอร์ (refactor) โค้ดที่คุณเพิ่งเพิ่มหรือแก้ไข และตรวจสอบให้แน่ใจว่าเทสต์ยังคงผ่านอยู่
- ทำซ้ำตั้งแต่ขั้นตอนที่ 1!
แม้ว่า TDD จะเป็นเพียงหนึ่งในหลาย ๆ วิธีในการพัฒนาซอฟต์แวร์ แต่มันก็ช่วยชี้นำการออกแบบโค้ดได้เป็นอย่างดี การเขียนเทสต์ก่อนเขียนโค้ดที่ทำให้เทสต์ผ่าน จะช่วยรักษาความครอบคลุมของการทดสอบ (test coverage) ให้อยู่ในระดับสูงตลอดทั้งกระบวนการ
เราจะใช้แนวทาง TDD ในการอิมพลีเมนต์ฟังก์ชันการทำงานที่จะค้นหาสตริงคำค้น (query) ในเนื้อหาของไฟล์จริง ๆ และสร้างรายการบรรทัดที่ตรงกับคำค้นนั้น โดยเราจะเพิ่มฟังก์ชันการทำงานนี้ไว้ในฟังก์ชันชื่อ search
การเขียนเทสต์ที่ล้มเหลว
ใน src/lib.rs เราจะเพิ่มมอดูล tests พร้อมกับฟังก์ชันเทสต์ ดังที่เราได้ทำไปในบทที่ 11 ฟังก์ชันเทสต์นี้จะระบุพฤติกรรมที่เราต้องการให้ฟังก์ชัน search มี นั่นคือ: รับคำค้นและข้อความที่ต้องการค้นหา แล้วส่งกลับเฉพาะบรรทัดจากข้อความที่มีคำค้นนั้นอยู่ ลิสติ้ง 12-15 แสดงให้เห็นเทสต์นี้
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
unimplemented!();
}
// --snip--
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}เทสต์นี้จะค้นหาสตริง "duct" โดยข้อความที่เราค้นหานั้นมีสามบรรทัด ซึ่งมีเพียงบรรทัดเดียวเท่านั้นที่มีคำว่า "duct" (โปรดสังเกตว่าเครื่องหมายแบ็กสแลชหลังเครื่องหมายคำพูดเปิดบอกให้ Rust ทราบว่าไม่ต้องใส่ตัวอักษรขึ้นบรรทัดใหม่ที่จุดเริ่มต้นของสตริงลิเทอรัลนี้) เราใช้คำสั่งยืนยัน (assert) ว่าค่าที่ฟังก์ชัน search ส่งกลับมานั้นมีเฉพาะบรรทัดที่เราคาดหวังไว้
หากเรารันเทสต์นี้ ตอนนี้มันจะล้มเหลวเพราะมาโคร unimplemented! จะแพนิก (panic) ด้วยข้อความ “not implemented” ตามหลักการของ TDD เราจะค่อย ๆ ก้าวทีละขั้นโดยเพิ่มโค้ดให้เพียงพอที่จะทำให้ฟังก์ชันไม่แพนิกเมื่อถูกเรียกใช้งาน ซึ่งทำได้โดยนิยามฟังก์ชัน search ให้ส่งกลับเวกเตอร์ว่างเสมอ ดังที่แสดงในลิสติ้ง 12-16 จากนั้นเทสต์จะคอมไพล์ผ่าน แต่จะล้มเหลวในการทดสอบเนื่องจากเวกเตอร์ว่างไม่ตรงกับเวกเตอร์ที่มีบรรทัด "safe, fast, productive."
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
vec![]
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}คราวนี้เรามาทำความเข้าใจกันว่าทำไมเราต้องระบุไลฟ์ไทม์ (lifetime) 'a อย่างชัดแจ้งในซิกเนเจอร์ของ search และใช้ไลฟ์ไทม์นั้นกับอาร์กิวเมนต์ contents รวมถึงค่าที่ส่งกลับด้วย ดังที่จำกันได้จากบทที่ 10 ว่าพารามิเตอร์ไลฟ์ไทม์จะระบุว่าไลฟ์ไทม์ของอาร์กิวเมนต์ตัวใดเชื่อมโยงกับไลฟ์ไทม์ของค่าที่ส่งกลับ ในกรณีนี้ เราระบุว่าเวกเตอร์ที่ส่งกลับควรบรรจุสตริงสไลซ์ที่อ้างอิงไปยังสไลซ์ของอาร์กิวเมนต์ contents (ไม่ใช่ของอาร์กิวเมนต์ query)
กล่าวอีกนัยหนึ่งคือ เราบอกให้ Rust ทราบว่าข้อมูลที่ฟังก์ชัน search ส่งกลับมานั้นจะมีอายุยืนยาวเท่ากับข้อมูลที่ส่งเข้ามาในฟังก์ชัน search ผ่านทางอาร์กิวเมนต์ contents จุดนี้สำคัญมาก! ข้อมูลที่ถูกสไลซ์_อ้างถึง_จะต้องมีอายุอยู่จริงเพื่อให้เรเฟอเรนซ์นั้นยังคงถูกต้องและใช้งานได้ หากคอมไพเลอร์สันนิษฐานว่าเรากำลังสร้างสตริงสไลซ์จาก query แทนที่จะเป็น contents การตรวจสอบความปลอดภัยของมันก็จะผิดพลาดไป
หากเราลืมระบุไลฟ์ไทม์แล้วลองคอมไพล์ฟังก์ชันนี้ เราจะได้รับข้อผิดพลาดดังนี้:
$ cargo build
Compiling minigrep v0.1.0 (file:///projects/minigrep)
error[E0106]: missing lifetime specifier
--> src/lib.rs:1:51
|
1 | pub fn search(query: &str, contents: &str) -> Vec<&str> {
| ---- ---- ^ expected named lifetime parameter
|
= help: this function's return type contains a borrowed value, but the signature does not say whether it is borrowed from `query` or `contents`
help: consider introducing a named lifetime parameter
|
1 | pub fn search<'a>(query: &'a str, contents: &'a str) -> Vec<&'a str> {
| ++++ ++ ++ ++
For more information about this error, try `rustc --explain E0106`.
error: could not compile `minigrep` (lib) due to 1 previous error
Rust ไม่อาจทราบได้เองว่าเราต้องการให้อาร์กิวเมนต์ตัวใดในสองตัวนี้เชื่อมโยงกับเอาต์พุต เราจึงต้องบอกมันอย่างชัดแจ้ง โปรดสังเกตว่าข้อความช่วยเหลือแนะนำให้ระบุพารามิเตอร์ไลฟ์ไทม์เดียวกันกับทุกพารามิเตอร์และชนิดข้อมูลของเอาต์พุต ซึ่งนั่นไม่ถูกต้อง! เนื่องจาก contents เป็นพารามิเตอร์ที่เก็บข้อความทั้งหมดของเรา และเราต้องการส่งกลับส่วนต่าง ๆ ของข้อความนั้นที่ตรงกับเงื่อนไข เราจึงรู้ว่า contents เป็นพารามิเตอร์เพียงตัวเดียวที่ควรเชื่อมโยงกับค่าที่ส่งกลับโดยใช้ไวยากรณ์ไลฟ์ไทม์
ภาษาโปรแกรมอื่น ๆ มักไม่กำหนดให้คุณต้องเชื่อมโยงอาร์กิวเมนต์เข้ากับค่าที่ส่งกลับในซิกเนเจอร์ แต่เมื่อคุณคุ้นเคยไปเรื่อย ๆ คุณจะพบว่าเรื่องนี้ไม่ได้ยากอย่างที่คิด คุณอาจลองเปรียบเทียบตัวอย่างนี้กับตัวอย่างในหัวข้อ“การตรวจสอบความถูกต้องของเรเฟอเรนซ์ด้วยไลฟ์ไทม์” ในบทที่ 10 เพิ่มเติมได้
การเขียนโค้ดให้เทสต์ผ่าน
ตอนนี้เทสต์ของเรายังคงล้มเหลวอยู่เพราะเราส่งกลับเวกเตอร์ว่างเสมอ เพื่อแก้ไขปัญหานี้และอิมพลีเมนต์ฟังก์ชัน search ให้สมบูรณ์ โปรแกรมของเราต้องทำตามขั้นตอนดังต่อไปนี้:
- วนซ้ำผ่านแต่ละบรรทัดของเนื้อหา
- ตรวจสอบว่าบรรทัดนั้นมีสตริงคำค้น (query) ของเราอยู่หรือไม่
- ถ้ามี ให้เพิ่มบรรทัดนั้นลงในรายการของค่าที่เราจะส่งกลับ
- ถ้าไม่มี ก็ไม่ต้องทำอะไร
- ส่งกลับรายการของผลลัพธ์ที่ตรงกับคำค้น
เรามาลงมือทำทีละขั้นตอนกัน โดยเริ่มจากการวนซ้ำผ่านแต่ละบรรทัดก่อน
การวนซ้ำผ่านบรรทัดด้วยเมธอด lines
Rust มีเมธอดที่เป็นประโยชน์มากในการวนซ้ำอ่านสตริงทีละบรรทัด ซึ่งตั้งชื่อไว้อย่างตรงไปตรงมาว่า lines และทำงานดังที่แสดงในลิสติ้ง 12-17 โปรดสังเกตว่าโค้ดนี้จะยังคอมไพล์ไม่ผ่านในตอนนี้
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
for line in contents.lines() {
// do something with line
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}เมธอด lines จะส่งกลับค่าเป็นอิเทอเรเตอร์ (iterator) เราจะพูดถึงเรื่องอิเทอเรเตอร์อย่างละเอียดในบทที่ 13 แต่หากจำกันได้ คุณเคยเห็นวิธีใช้งานอิเทอเรเตอร์ในลักษณะนี้มาแล้วในลิสติ้ง 3-5 ซึ่งเราใช้ลูป for ร่วมกับอิเทอเรเตอร์เพื่อรันโค้ดกับแต่ละสมาชิกในคอลเลกชัน
การค้นหา query ในแต่ละบรรทัด
ขั้นต่อไป เราจะตรวจสอบว่าบรรทัดปัจจุบันมีสตริง query ของเราอยู่หรือไม่ โชคดีที่สตริงมีเมธอดที่มีประโยชน์มากชื่อ contains ซึ่งช่วยทำงานนี้ให้เราได้ทันที! ให้เพิ่มการเรียกใช้เมธอด contains เข้าไปในฟังก์ชัน search ดังแสดงในลิสติ้ง 12-18 โปรดทราบว่าโค้ดนี้จะยังคงคอมไพล์ไม่ผ่านเช่นกัน
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
for line in contents.lines() {
if line.contains(query) {
// do something with line
}
}
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}ในตอนนี้ เรากำลังค่อย ๆ ทยอยสร้างการทำงานขึ้นมาทีละส่วน และเพื่อให้โค้ดคอมไพล์ผ่านได้ เราจำเป็นต้องส่งค่ากลับจากเนื้อในตามที่เราได้ระบุไว้ในซิกเนเจอร์ของฟังก์ชัน
การจัดเก็บบรรทัดที่ตรงกัน
และเพื่อทำให้ฟังก์ชันนี้เสร็จสมบูรณ์ เราต้องการวิธีจัดเก็บบรรทัดที่ตรงกับคำค้นเพื่อส่งกลับไป เราสามารถสร้างเวกเตอร์แบบเปลี่ยนแปลงค่าได้ (mutable vector) ไว้ก่อนลูป for แล้วเรียกใช้เมธอด push เพื่อนำแต่ละ line ไปเก็บไว้ในเวกเตอร์ จากนั้นเมื่อจบลูป for จึงค่อยส่งเวกเตอร์นั้นกลับไป ดังแสดงในลิสติ้ง 12-19
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
let mut results = Vec::new();
for line in contents.lines() {
if line.contains(query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}ตอนนี้ฟังก์ชัน search ควรจะส่งกลับเฉพาะบรรทัดที่มี query เท่านั้น และเทสต์ของเราก็น่าจะผ่านแล้ว มาลองรันเทสต์กันดู:
$ cargo test
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `test` profile [unoptimized + debuginfo] target(s) in 1.22s
Running unittests src/lib.rs (target/debug/deps/minigrep-9cd200e5fac0fc94)
running 1 test
test tests::one_result ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running unittests src/main.rs (target/debug/deps/minigrep-9cd200e5fac0fc94)
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests minigrep
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
เทสต์ของเราผ่านแล้ว แปลว่าฟังก์ชันทำงานได้ถูกต้องตามที่ต้องการ!
ณ จุดนี้ เราอาจพิจารณาหาโอกาสในการรีแฟกเตอร์โค้ดของฟังก์ชันค้นหา โดยยังคงรักษาให้เทสต์ผ่านอยู่เสมอเพื่อให้มั่นใจว่าฟังก์ชันการทำงานยังคงเดิม โค้ดในฟังก์ชันค้นหานี้ก็ไม่ได้แย่อะไร แต่ยังไม่ได้ใช้ประโยชน์จากฟีเจอร์ที่ทรงพลังของอิเทอเรเตอร์ เราจะกลับมาดูตัวอย่างนี้อีกครั้งในบทที่ 13 ซึ่งเราจะได้เจาะลึกเรื่องอิเทอเรเตอร์และดูวิธีปรับปรุงโค้ดนี้ให้ดียิ่งขึ้น
ตอนนี้ทั้งโปรแกรมของเราควรจะทำงานได้สมบูรณ์แล้ว! มาลองทดสอบใช้งานกันจริง ๆ ดู โดยเริ่มจากคำที่ควรจะได้ผลลัพธ์กลับมาเพียงบรรทัดเดียวจากบทกวีของ Emily Dickinson นั่นคือคำว่า: frog
$ cargo run -- frog poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.38s
Running `target/debug/minigrep frog poem.txt`
How public, like a frog
ยอดเยี่ยม! คราวนี้มาลองค้นหาคำที่ตรงกับหลายบรรทัดดูบ้าง เช่นคำว่า body:
$ cargo run -- body poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep body poem.txt`
I'm nobody! Who are you?
Are you nobody, too?
How dreary to be somebody!
และสุดท้าย เพื่อให้แน่ใจว่าเราจะไม่พบบรรทัดใด ๆ เลยเมื่อค้นหาคำที่ไม่มีอยู่ในบทกวี เช่นคำว่า monomorphization:
$ cargo run -- monomorphization poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep monomorphization poem.txt`
ยอดเยี่ยมมาก! เราได้สร้างเครื่องมือคลาสสิกฉบับย่อของเราเองขึ้นมาสำเร็จ และได้เรียนรู้อะไรมากมายเกี่ยวกับวิธีจัดโครงสร้างแอปพลิเคชัน นอกจากนี้เรายังได้เรียนรู้เกี่ยวกับการจัดการอินพุตและเอาต์พุตของไฟล์ ไลฟ์ไทม์ การทดสอบ และการแยกวิเคราะห์บรรทัดคำสั่ง
เพื่อปิดท้ายโปรเจกต์นี้ให้สมบูรณ์ เราจะสาธิตสั้น ๆ ถึงวิธีทำงานร่วมกับตัวแปรสภาพแวดล้อม (environment variable) และวิธีพิมพ์ข้อความไปยัง standard error ซึ่งทั้งสองสิ่งนี้มีประโยชน์อย่างยิ่งเมื่อคุณพัฒนาโปรแกรมบรรทัดคำสั่ง
การใช้งานตัวแปรสภาพแวดล้อม
การใช้งานตัวแปรสภาพแวดล้อม
เราจะพัฒนาโปรแกรม minigrep เพิ่มเติมด้วยการเพิ่มฟีเจอร์ใหม่: ตัวเลือกสำหรับการค้นหาแบบไม่สนใจตัวพิมพ์เล็ก-ใหญ่ (case-insensitive) ที่ผู้ใช้งานสามารถเปิดใช้งานผ่านตัวแปรสภาพแวดล้อม (environment variable) ได้ เราอาจเลือกสร้างฟีเจอร์นี้เป็นออปชันของคำสั่งบรรทัดคำสั่ง และกำหนดให้ผู้ใช้ต้องระบุทุกครั้งที่ต้องการใช้งานก็ได้ แต่การเลือกใช้ตัวแปรสภาพแวดล้อมจะช่วยให้ผู้ใช้ตั้งค่าเพียงครั้งเดียว แล้วการค้นหาหลังจากนั้นทั้งหมดในเซสชันของเทอร์มินัลนั้นจะทำงานแบบไม่สนใจตัวพิมพ์เล็ก-ใหญ่โดยอัตโนมัติ
การเขียนเทสต์ที่ล้มเหลวสำหรับการค้นหาแบบไม่คำนึงถึงตัวพิมพ์เล็ก-ใหญ่
ก่อนอื่น เราจะเพิ่มฟังก์ชันใหม่ชื่อ search_case_insensitive ซึ่งจะถูกเรียกใช้งานเมื่อมีการตั้งค่าตัวแปรสภาพแวดล้อมขึ้นมา เราจะยังคงปฏิบัติตามแนวทาง TDD ต่อไป ดังนั้นขั้นตอนแรกจึงเป็นการเขียนเทสต์ที่ล้มเหลวอีกครั้ง โดยเราจะเพิ่มเทสต์ใหม่สำหรับฟังก์ชัน search_case_insensitive และเปลี่ยนชื่อเทสต์เดิมของเราจาก one_result เป็น case_sensitive เพื่อแยกแยะความแตกต่างระหว่างเทสต์ทั้งสองให้ชัดเจนยิ่งขึ้น ดังแสดงในลิสติ้ง 12-20
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
let mut results = Vec::new();
for line in contents.lines() {
if line.contains(query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn case_sensitive() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Duct tape.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
#[test]
fn case_insensitive() {
let query = "rUsT";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Trust me.";
assert_eq!(
vec!["Rust:", "Trust me."],
search_case_insensitive(query, contents)
);
}
}โปรดสังเกตว่าเราได้ปรับแก้ค่า contents ในเทสต์เดิมด้วย โดยเพิ่มบรรทัดใหม่ที่มีข้อความ "Duct tape." ซึ่งขึ้นต้นด้วยตัวอักษร D ตัวพิมพ์ใหญ่ ซึ่งต้องไม่ตรงกับคำค้น "duct" เมื่อเราค้นหาแบบคำนึงถึงตัวพิมพ์เล็ก-ใหญ่ การแก้ไขเทสต์เดิมในลักษณะนี้จะช่วยให้มั่นใจได้ว่าเราจะไม่เผลอทำให้ระบบค้นหาแบบคำนึงถึงตัวพิมพ์เล็ก-ใหญ่ที่เราพัฒนาไว้แล้วเสียหาย เทสต์นี้ควรผ่านตั้งแต่ตอนนี้ และควรจะยังคงผ่านต่อไปในระหว่างที่เรากำลังพัฒนาฟังก์ชันการค้นหาแบบไม่คำนึงถึงตัวพิมพ์เล็ก-ใหญ่
ส่วนเทสต์ใหม่สำหรับการค้นหาแบบ_ไม่คำนึงถึง_ตัวพิมพ์เล็ก-ใหญ่จะใช้คำค้นเป็น "rUsT" ในฟังก์ชัน search_case_insensitive ที่เรากำลังจะสร้างขึ้น คำค้น "rUsT" นี้จะต้องจับคู่ตรงกับทั้งบรรทัดที่มีข้อความ "Rust:" (ซึ่งขึ้นต้นด้วยตัวพิมพ์ใหญ่ R) และบรรทัด "Trust me." ได้ แม้ว่าทั้งสองบรรทัดจะมีตัวพิมพ์ที่ต่างไปจากคำค้นก็ตาม นี่คือเทสต์ที่ล้มเหลวของเรา และในตอนนี้มันจะยังคอมไพล์ไม่ผ่านเนื่องจากเรายังไม่ได้นิยามฟังก์ชัน search_case_insensitive ขึ้นมา คุณสามารถเขียนโครงร่างฟังก์ชัน (skeleton implementation) ที่คืนค่าเป็นเวกเตอร์ว่างไปก่อนได้ คล้ายกับที่เราเคยทำกับฟังก์ชัน search ในลิสติ้ง 12-16 เพื่อตรวจสอบว่าเทสต์สามารถคอมไพล์ได้และล้มเหลวตามที่คาดไว้
การอิมพลีเมนต์ฟังก์ชัน search_case_insensitive
ฟังก์ชัน search_case_insensitive ดังแสดงในลิสติ้ง 12-21 จะมีโครงสร้างเกือบเหมือนกับฟังก์ชัน search เดิมทุกประการ ความแตกต่างเพียงอย่างเดียวคือเราจะแปลงทั้งคำค้น query และแต่ละบรรทัด line ให้เป็นตัวพิมพ์เล็ก เพื่อให้ไม่ว่าอาร์กิวเมนต์ที่ส่งเข้ามาจะมีตัวพิมพ์แบบใด ทั้งสองส่วนก็จะมีตัวพิมพ์เหมือนกันเมื่อเราตรวจสอบว่าบรรทัดนั้นมีคำค้นอยู่หรือไม่
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
let mut results = Vec::new();
for line in contents.lines() {
if line.contains(query) {
results.push(line);
}
}
results
}
pub fn search_case_insensitive<'a>(
query: &str,
contents: &'a str,
) -> Vec<&'a str> {
let query = query.to_lowercase();
let mut results = Vec::new();
for line in contents.lines() {
if line.to_lowercase().contains(&query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn case_sensitive() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Duct tape.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
#[test]
fn case_insensitive() {
let query = "rUsT";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Trust me.";
assert_eq!(
vec!["Rust:", "Trust me."],
search_case_insensitive(query, contents)
);
}
}ก่อนอื่น เราแปลงสตริง query ให้เป็นตัวพิมพ์เล็กทั้งหมด แล้วเก็บไว้ในตัวแปรใหม่ที่มีชื่อเดียวกัน ซึ่งเป็นการบดบังตัวแปร (shadowing) query ตัวเดิม การเรียกใช้ to_lowercase บนตัวแปรคำค้นเป็นสิ่งจำเป็น เพื่อให้ไม่ว่าผู้ใช้จะป้อนคำค้นเข้ามาเป็น "rust", "RUST", "Rust" หรือ "rUsT" เราก็จะปฏิบัติต่อคำค้นนั้นเสมือนเป็น "rust" เสมอโดยไม่สนใจตัวพิมพ์ แม้ว่า to_lowercase จะจัดการกับอักขระ Unicode พื้นฐานได้ แต่อาจไม่ได้แม่นยำร้อยเปอร์เซ็นต์ หากเรากำลังพัฒนาแอปพลิเคชันใช้งานจริง เราอาจต้องจัดการรายละเอียดเพิ่มเติมตรงจุดนี้ ทว่าในหัวข้อนี้เราเน้นเรื่องตัวแปรสภาพแวดล้อม ไม่ใช่เรื่อง Unicode จึงขอละไว้ในฐานที่เข้าใจ
โปรดสังเกตว่าตอนนี้ query มีชนิดเป็น String ไม่ใช่สตริงสไลซ์ (&str) อีกต่อไป เนื่องจากเมธอด to_lowercase จะสร้างข้อมูลใหม่ขึ้นมาแทนที่จะอ้างอิงข้อมูลเดิม ตัวอย่างเช่น หากคำค้นคือ "rUsT": สตริงสไลซ์เดิมนั้นไม่มีตัวอักษร u หรือ t ตัวพิมพ์เล็กให้เราใช้อ้างอิง เราจึงจำเป็นต้องจัดสรร String ก้อนใหม่ที่เก็บข้อความ "rust" ดังนั้นเมื่อเราส่ง query เป็นอาร์กิวเมนต์ให้กับเมธอด contains เราจึงต้องใส่เครื่องหมายแอมเพอร์แซนด์ (&) เนื่องจากซิกเนเจอร์ของเมธอด contains กำหนดไว้ว่าต้องรับสตริงสไลซ์
จากนั้น เราจึงเรียกใช้ to_lowercase บนแต่ละบรรทัด line เพื่อแปลงตัวอักขระทั้งหมดให้เป็นตัวพิมพ์เล็กเช่นกัน เมื่อเราแปลงทั้ง line และ query ให้เป็นตัวพิมพ์เล็กเหมือนกันแล้ว เราก็จะสามารถตรวจหาคำที่ตรงกันได้เสมอ ไม่ว่าคำค้นเดิมจะมีตัวพิมพ์แบบใดก็ตาม
มาดูกันว่าการอิมพลีเมนต์นี้ผ่านเทสต์หรือไม่:
$ cargo test
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `test` profile [unoptimized + debuginfo] target(s) in 1.33s
Running unittests src/lib.rs (target/debug/deps/minigrep-9cd200e5fac0fc94)
running 2 tests
test tests::case_insensitive ... ok
test tests::case_sensitive ... ok
test result: ok. 2 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running unittests src/main.rs (target/debug/deps/minigrep-9cd200e5fac0fc94)
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests minigrep
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
ยอดเยี่ยมมาก! เทสต์ผ่านเรียบร้อยแล้ว ตอนนี้มาเรียกใช้ฟังก์ชัน search_case_insensitive ใหม่นี้จากฟังก์ชัน run กันครับ ก่อนอื่น เราจะเพิ่มตัวเลือกการกำหนดค่าลงใน struct Config เพื่อสลับการทำงานระหว่างการค้นหาแบบคำนึงถึงตัวพิมพ์เล็ก-ใหญ่กับการค้นหาแบบไม่คำนึงถึงตัวพิมพ์ การเพิ่มฟิลด์นี้จะทำให้คอมไพเลอร์แจ้งข้อผิดพลาด เนื่องจากเรายังไม่ได้กำหนดค่าเริ่มต้นให้กับฟิลด์นี้ในจุดอื่นๆ:
ชื่อไฟล์: src/main.rs
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
// --snip--
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}เราได้เพิ่มฟิลด์ ignore_case ซึ่งเก็บค่าบูลีน จากนั้น เราต้องแก้ไขฟังก์ชัน run ให้ตรวจสอบค่าของฟิลด์ ignore_case นี้ เพื่อใช้ตัดสินใจว่าจะเรียกใช้ฟังก์ชัน search หรือ search_case_insensitive ดังแสดงในลิสติ้ง 12-22 (ซึ่งโค้ดนี้จะยังคอมไพล์ไม่ผ่านในตอนนี้)
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
// --snip--
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
Ok(Config { query, file_path })
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}สุดท้าย เราต้องตรวจสอบตัวแปรสภาพแวดล้อม ฟังก์ชันสำหรับการทำงานกับตัวแปรสภาพแวดล้อมจะอยู่ในมอดูล env ของไลบรารีมาตรฐาน ซึ่งเราได้นำเข้ามาไว้ในสโคปที่ด้านบนของ src/main.rs เรียบร้อยแล้ว เราจะใช้ฟังก์ชัน var จากมอดูล env เพื่อตรวจสอบว่ามีการกำหนดค่าให้กับตัวแปรสภาพแวดล้อมที่ชื่อ IGNORE_CASE ไว้หรือไม่ ดังแสดงในลิสติ้ง 12-23
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}ในที่นี้ เราสร้างตัวแปรใหม่ชื่อ ignore_case โดยกำหนดค่าจากการเรียกใช้ฟังก์ชัน env::var พร้อมส่งชื่อตัวแปรสภาพแวดล้อม IGNORE_CASE เข้าไป ฟังก์ชัน env::var จะส่งคืนค่าเป็น Result ซึ่งจะเป็นวาเรียนต์ Ok ที่เก็บค่าของตัวแปรสภาพแวดล้อมไว้หากตัวแปรสภาพแวดล้อมนั้นได้รับการกำหนดค่าใดๆ เอาไว้ และจะส่งคืนวาเรียนต์ Err หากไม่มีการตั้งค่าตัวแปรสภาพแวดล้อมดังกล่าว
เราใช้เมธอด is_ok บน Result เพื่อตรวจสอบว่าตัวแปรสภาพแวดล้อมนั้นถูกตั้งค่าไว้หรือไม่ ซึ่งหากมีการตั้งค่าไว้ ก็แสดงว่าโปรแกรมควรค้นหาแบบไม่คำนึงถึงตัวพิมพ์เล็ก-ใหญ่ แต่หากตัวแปรสภาพแวดล้อม IGNORE_CASE ไม่ได้ถูกตั้งค่าไว้ เมธอด is_ok จะส่งคืนค่า false และโปรแกรมจะค้นหาแบบคำนึงถึงตัวพิมพ์ตามปกติ ในที่นี้เราไม่ได้สนใจว่า_ค่า_ของตัวแปรสภาพแวดล้อมจะเป็นอะไร สนใจเพียงแค่ว่ามันถูกตั้งค่าไว้หรือไม่เท่านั้น เราจึงตรวจสอบด้วย is_ok แทนที่จะใช้ unwrap, expect หรือเมธอดอื่นๆ บน Result
เราส่งค่าในตัวแปร ignore_case ไปยังอินสแตนซ์ของ Config เพื่อให้ฟังก์ชัน run อ่านค่านั้นไปใช้ตัดสินใจว่าจะเรียก search_case_insensitive หรือ search ตามที่เราได้พัฒนาไว้ในลิสติ้ง 12-22
มาลองทดสอบกันดูครับ! ก่อนอื่น เราจะรันโปรแกรมโดยยังไม่ตั้งค่าตัวแปรสภาพแวดล้อม และค้นหาด้วยคำว่า to ซึ่งควรตรงกับบรรทัดที่มีคำว่า to เป็นตัวพิมพ์เล็กทั้งหมดเท่านั้น:
$ cargo run -- to poem.txt
Compiling minigrep v0.1.0 (file:///projects/minigrep)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.0s
Running `target/debug/minigrep to poem.txt`
Are you nobody, too?
How dreary to be somebody!
ดูเหมือนว่าการทำงานยังถูกต้องดี! ตอนนี้ลองรันโปรแกรมโดยกำหนดค่า IGNORE_CASE ให้เป็น 1 แต่ยังคงค้นหาด้วยคำว่า to เช่นเดิม:
$ IGNORE_CASE=1 cargo run -- to poem.txt
หากคุณใช้ PowerShell คุณจะต้องตั้งค่าตัวแปรสภาพแวดล้อมและรันโปรแกรมเป็นคำสั่งแยกกัน:
PS> $Env:IGNORE_CASE=1; cargo run -- to poem.txt
การทำเช่นนี้จะทำให้ค่า IGNORE_CASE คงอยู่ตลอดช่วงที่เหลือของเซสชันเชลล์ของคุณ คุณสามารถยกเลิกการตั้งค่าได้ด้วย cmdlet Remove-Item:
PS> Remove-Item Env:IGNORE_CASE
เราควรได้บรรทัดที่มีคำว่า to ซึ่งอาจมีตัวอักษรพิมพ์ใหญ่ปนอยู่ด้วย:
Are you nobody, too?
How dreary to be somebody!
To tell your name the livelong day
To an admiring bog!
ยอดเยี่ยมมาก! เราได้บรรทัดที่มีคำว่า To ติดมาด้วยแล้ว! ตอนนี้โปรแกรม minigrep ของเราสามารถค้นหาแบบไม่คำนึงถึงตัวพิมพ์เล็ก-ใหญ่โดยควบคุมผ่านตัวแปรสภาพแวดล้อมได้เรียบร้อยแล้ว ถึงตรงนี้คุณก็ได้เรียนรู้วิธีจัดการตัวเลือกการทำงานของโปรแกรม ทั้งผ่านทางอาร์กิวเมนต์ของบรรทัดคำสั่งและผ่านตัวแปรสภาพแวดล้อม
บางโปรแกรมอาจเปิดให้ระบุการกำหนดค่าแบบเดียวกันผ่านทั้งอาร์กิวเมนต์_และ_ตัวแปรสภาพแวดล้อม ในกรณีเช่นนั้น ตัวโปรแกรมจะเป็นผู้ตัดสินว่าตัวเลือกใดควรมีลำดับความสำคัญสูงกว่ากัน เพื่อเป็นแบบฝึกหัดทบทวนด้วยตนเอง ลองปรับให้โปรแกรมควบคุมการค้นหาแบบไม่สนใจตัวพิมพ์เล็ก-ใหญ่ได้ทั้งผ่านอาร์กิวเมนต์บรรทัดคำสั่งหรือตัวแปรสภาพแวดล้อมดูครับ และลองตัดสินใจว่าระหว่างอาร์กิวเมนต์กับตัวแปรสภาพแวดล้อม อย่างใดควรมีลำดับความสำคัญสูงกว่า หากผู้ใช้สั่งรันโดยตั้งค่าให้ตัวหนึ่งค้นหาแบบคำนึงถึงตัวพิมพ์ แต่อีกตัวหนึ่งสั่งให้ไม่คำนึงถึงตัวพิมพ์
มอดูล std::env ยังมีฟังก์ชันที่มีประโยชน์อีกมากมายสำหรับการจัดการตัวแปรสภาพแวดล้อม ลองศึกษาเอกสารประกอบเพื่อดูว่ามีฟังก์ชันอะไรให้เรียกใช้งานได้บ้าง
เปลี่ยนเส้นทางข้อผิดพลาดไปยัง standard error
เปลี่ยนเส้นทางข้อผิดพลาดไปยัง standard error
ในตอนนี้ เราส่งเอาต์พุตทั้งหมดของโปรแกรมออกไปยังเทอร์มินัลผ่านทางมาโคร println! เพียงอย่างเดียว แต่ในเทอร์มินัลส่วนใหญ่ เอาต์พุตจะถูกแบ่งออกเป็นสองประเภท ได้แก่: เอาต์พุตมาตรฐาน (standard output หรือ stdout) สำหรับข้อมูลทั่วไป และ ข้อผิดพลาดมาตรฐาน (standard error หรือ stderr) สำหรับข้อความแสดงข้อผิดพลาด การแยกสองสิ่งนี้ออกจากกันช่วยให้ผู้ใช้สามารถเลือกส่งต่อเอาต์พุตจากการทำงานปกติที่สำเร็จไปยังไฟล์ได้ ในขณะที่ยังคงแสดงข้อความแจ้งเตือนข้อผิดพลาดออกทางหน้าจอได้อยู่
เนื่องจากมาโคร println! สามารถพิมพ์ข้อมูลไปยังเอาต์พุตมาตรฐานได้เพียงอย่างเดียว เราจึงต้องใช้วิธีอื่นในการพิมพ์ข้อมูลไปยังข้อผิดพลาดมาตรฐานแทน
การตรวจสอบว่าข้อผิดพลาดถูกเขียนไปที่ใด
ก่อนอื่น เรามาสังเกตดูก่อนว่าเนื้อหาที่ minigrep พิมพ์ออกมาในปัจจุบันถูกเขียนไปยังเอาต์พุตมาตรฐานอย่างไร ซึ่งรวมไปถึงข้อความแสดงข้อผิดพลาดใด ๆ ที่เราต้องการให้ส่งไปยังข้อผิดพลาดมาตรฐานแทนด้วย เราจะทำเช่นนั้นโดยการเปลี่ยนเส้นทาง (redirect) สตรีมของเอาต์พุตมาตรฐานไปยังไฟล์ ควบคู่ไปกับการจงใจทำให้เกิดข้อผิดพลาดขึ้น โดยเราจะไม่เปลี่ยนเส้นทางสตรีมของข้อผิดพลาดมาตรฐาน ดังนั้นข้อมูลใด ๆ ที่ถูกส่งไปยังข้อผิดพลาดมาตรฐานจะยังคงแสดงบนหน้าจอ
โปรแกรมบรรทัดคำสั่ง (command line) ถูกคาดหวังให้ส่งข้อความแสดงข้อผิดพลาดไปยังสตรีมข้อผิดพลาดมาตรฐาน เพื่อให้เรายังคงเห็นข้อความแสดงข้อผิดพลาดบนหน้าจอได้แม้ว่าจะเปลี่ยนเส้นทางสตรีมเอาต์พุตมาตรฐานไปยังไฟล์ แต่โปรแกรมของเราในตอนนี้ยังทำงานได้ไม่ดีเท่าที่ควร: เรากำลังจะได้เห็นกันว่ามันกลับบันทึกข้อความแสดงข้อผิดพลาดลงไปในไฟล์แทน!
เพื่อแสดงให้เห็นพฤติกรรมนี้ เราจะรันโปรแกรมด้วย > และพาธไฟล์ output.txt ที่เราต้องการเปลี่ยนเส้นทางสตรีมเอาต์พุตมาตรฐานไปลง โดยเราจะไม่ส่งอาร์กิวเมนต์ (argument) ใด ๆ เข้าไป ซึ่งควรทำให้เกิดข้อผิดพลาด:
$ cargo run > output.txt
ไวยากรณ์ > สั่งให้เชลล์เขียนเนื้อหาจากเอาต์พุตมาตรฐานไปยัง output.txt แทนที่จะแสดงออกทางหน้าจอ เมื่อรันคำสั่งแล้วเราไม่เห็นข้อความแสดงข้อผิดพลาดที่คาดว่าจะถูกพิมพ์บนหน้าจอ ซึ่งแสดงว่ามันต้องถูกเขียนลงไปในไฟล์ นี่คือสิ่งที่อยู่ใน output.txt:
Problem parsing arguments: not enough arguments
ใช่แล้ว ข้อความแสดงข้อผิดพลาดของเราถูกพิมพ์ไปยังเอาต์พุตมาตรฐาน การพิมพ์ข้อความแสดงข้อผิดพลาดแบบนี้ไปยังข้อผิดพลาดมาตรฐานมีประโยชน์กว่ามาก เพื่อให้มีเฉพาะข้อมูลจากการรันที่สำเร็จเท่านั้นที่ถูกบันทึกลงในไฟล์ เรามาแก้ไขเรื่องนี้กัน
การพิมพ์ข้อผิดพลาดไปยังข้อผิดพลาดมาตรฐาน
เราจะใช้โค้ดในลิสติ้ง 12-24 เพื่อเปลี่ยนวิธีพิมพ์ข้อความแสดงข้อผิดพลาด เนื่องจากการรีแฟกเตอร์ (refactor) ที่เราทำไปก่อนหน้าในบทนี้ โค้ดทั้งหมดที่พิมพ์ข้อความแสดงข้อผิดพลาดจึงรวมอยู่ในฟังก์ชันเดียวคือ main ไลบรารีมาตรฐานมีมาโคร eprintln! ที่พิมพ์ไปยังสตรีมข้อผิดพลาดมาตรฐาน ดังนั้นมาเปลี่ยนสองจุดที่เราเรียก println! เพื่อพิมพ์ข้อผิดพลาดให้หันมาใช้ eprintln! แทนกัน
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}ตอนนี้มาลองรันโปรแกรมอีกครั้งในแบบเดียวกัน โดยไม่ใส่อาร์กิวเมนต์และเปลี่ยนเส้นทางเอาต์พุตมาตรฐานด้วย >:
$ cargo run > output.txt
Problem parsing arguments: not enough arguments
ตอนนี้เราจะเห็นข้อผิดพลาดปรากฏบนหน้าจอ และ output.txt ไม่บรรจุอะไรเลย ซึ่งเป็นพฤติกรรมที่เราคาดหวังจากโปรแกรมบรรทัดคำสั่ง
มาลองรันโปรแกรมอีกครั้งด้วยอาร์กิวเมนต์ที่ไม่ทำให้เกิดข้อผิดพลาด แต่ยังคงเปลี่ยนเส้นทางเอาต์พุตมาตรฐานไปยังไฟล์ ดังนี้:
$ cargo run -- to poem.txt > output.txt
เราจะไม่เห็นเอาต์พุตใด ๆ ไปยังเทอร์มินัล และ output.txt จะบรรจุผลลัพธ์ของเรา:
ชื่อไฟล์: output.txt
Are you nobody, too?
How dreary to be somebody!
สิ่งนี้แสดงให้เห็นว่าตอนนี้เราใช้เอาต์พุตมาตรฐานสำหรับผลลัพธ์ที่สำเร็จ และใช้ข้อผิดพลาดมาตรฐานสำหรับเอาต์พุตข้อผิดพลาดอย่างเหมาะสมแล้ว
สรุป
บทนี้ได้ทบทวนแนวคิดสำคัญหลาย ๆ ประการที่คุณได้เรียนรู้มาจนถึงตอนนี้ และครอบคลุมวิธีจัดการงาน I/O พื้นฐานใน Rust ด้วยการใช้อาร์กิวเมนต์บรรทัดคำสั่ง ไฟล์ ตัวแปรสภาพแวดล้อม (environment variable) และมาโคร eprintln! สำหรับพิมพ์ข้อผิดพลาด ตอนนี้คุณพร้อมแล้วที่จะเขียนแอปพลิเคชันบรรทัดคำสั่ง เมื่อรวมกับแนวคิดในบทก่อน ๆ โค้ดของคุณจะถูกจัดระเบียบอย่างดี จัดเก็บข้อมูลอย่างมีประสิทธิภาพในโครงสร้างข้อมูลที่เหมาะสม จัดการข้อผิดพลาดได้อย่างรัดกุม และผ่านการทดสอบมาเป็นอย่างดี
ต่อไป เราจะสำรวจฟีเจอร์ของ Rust บางอย่างที่ได้รับอิทธิพลจากภาษาเชิงฟังก์ชัน: โคลเชอร์ (closure) และอิเทอเรเตอร์ (iterator)
ฟีเจอร์ภาษาเชิงฟังก์ชัน: อิเทอเรเตอร์และโคลเชอร์
การออกแบบของภาษา Rust ได้รับแรงบันดาลใจมาจากภาษาและเทคนิคมากมายที่มีอยู่ก่อนหน้า และหนึ่งในอิทธิพลที่สำคัญอย่างยิ่งก็คือ การเขียนโปรแกรมเชิงฟังก์ชัน (functional programming) ซึ่งการเขียนโปรแกรมในสไตล์เชิงฟังก์ชันนี้ มักจะรวมถึงการปฏิบัติต่อฟังก์ชันในฐานะที่เป็นค่าของข้อมูล เช่น การส่งฟังก์ชันเป็นอาร์กิวเมนต์, การส่งคืนฟังก์ชันกลับมาจากฟังก์ชันอื่น, การกำหนดฟังก์ชันให้กับตัวแปรเพื่อเรียกใช้งานในภายหลัง และอื่น ๆ
ในบทนี้ เราจะไม่ถกเถียงกันในประเด็นเชิงทฤษฎีว่าอะไรคือหรือไม่คือการเขียนโปรแกรมเชิงฟังก์ชัน แต่เราจะมาพูดคุยกันถึงฟีเจอร์ต่าง ๆ ใน Rust ที่มีลักษณะคล้ายคลึงกับฟีเจอร์ในภาษาอื่น ๆ ที่มักถูกจัดว่าเป็นภาษาเชิงฟังก์ชันแทน
โดยเฉพาะอย่างยิ่ง เราจะเรียนรู้เกี่ยวกับเรื่องต่อไปนี้:
- โคลเชอร์ (closures) โครงสร้างที่มีลักษณะการทำงานคล้ายฟังก์ชันซึ่งคุณสามารถนำไปเก็บไว้ในตัวแปรได้
- อิเทอเรเตอร์ (iterators) เครื่องมือสำหรับวนลูปประมวลผลลำดับของชุดข้อมูล
- วิธีการนำโคลเชอร์และอิเทอเรเตอร์มาใช้ปรับปรุงโปรเจกต์ I/O จากบทที่ 12
- ประสิทธิภาพของโคลเชอร์และอิเทอเรเตอร์ (แอบสปอยล์ไว้ก่อนเลยว่า: มันทำงานได้เร็วกว่าที่คุณคิดไว้แน่นอน!)
เราได้เรียนรู้ฟีเจอร์อื่น ๆ ของ Rust กันไปแล้ว เช่น การจับคู่แพตเทิร์น (pattern matching) และ enum ซึ่งต่างก็ได้รับอิทธิพลมาจากสไตล์เชิงฟังก์ชันเช่นเดียวกัน และเนื่องจากการทำความเข้าใจโคลเชอร์และอิเทอเรเตอร์อย่างเชี่ยวชาญนั้นเป็นหัวใจสำคัญของการเขียนโค้ด Rust ให้ทำงานได้รวดเร็วและเป็นไปตามสำนวนของภาษา (idiomatic) เราจึงขออุทิศเนื้อหาตลอดทั้งบทนี้ให้กับหัวข้อดังกล่าวโดยเฉพาะ
โคลเชอร์
โคลเชอร์
โคลเชอร์ (closure) ในภาษา Rust คือฟังก์ชันแบบไม่ระบุชื่อ (anonymous function) ที่คุณสามารถจัดเก็บไว้ในตัวแปร หรือส่งเป็นอาร์กิวเมนต์ไปยังฟังก์ชันอื่นได้ คุณสามารถนิยามโคลเชอร์ขึ้นมาที่จุดหนึ่ง แล้วนำไปเรียกประมวลผลที่จุดอื่นในบริบทที่แตกต่างออกไปได้ นอกจากนี้ โคลเชอร์ยังมีความพิเศษต่างจากฟังก์ชันทั่วไปตรงที่มันสามารถจับค่า (capture) จากสโคปที่มันถูกสร้างขึ้นมาได้ด้วย เราจะมาดูกันว่าฟีเจอร์เหล่านี้ของโคลเชอร์ช่วยให้เราสามารถนำโค้ดกลับมาใช้ซ้ำ (code reuse) และปรับแต่งพฤติกรรมการทำงานได้อย่างไร
การจับสภาพแวดล้อม
อันดับแรก เราจะมาดูวิธีใช้โคลเชอร์เพื่อจับค่าจากสภาพแวดล้อมที่มันถูกนิยามขึ้นมาสำหรับนำไปใช้งานในภายหลัง ลองพิจารณาสถานการณ์จำลองนี้: ในบางโอกาส บริษัทเสื้อยืดของเราจะแจกเสื้อรุ่นพิเศษแบบลิมิเต็ดเอดิชันให้กับผู้โชคดีในรายชื่ออีเมลของเราเพื่อการส่งเสริมการขาย โดยผู้รับอีเมลสามารถเลือกใส่สีเสื้อที่ตนชอบลงในโปรไฟล์ได้ตามความสมัครใจ หากผู้โชคดีที่ได้รับรางวัลได้ระบุสีโปรดไว้ พวกเขาก็จะได้เสื้อสีนั้นไป แต่หากไม่ได้ระบุสีโปรดไว้ พวกเขาจะได้เสื้อสีที่ทางบริษัทมีอยู่ในสต็อกมากที่สุดในขณะนั้นแทน
เราสามารถพัฒนาโจทย์นี้ได้หลากหลายวิธี สำหรับตัวอย่างนี้ เราจะใช้ enum ชื่อ ShirtColor ซึ่งมีวาเรียนต์ Red และ Blue (เพื่อความเรียบง่าย เราจะจำกัดไว้เพียงสองสี) เราจะจำลองคลังสินค้าของบริษัทด้วย struct ชื่อ Inventory ที่มีฟิลด์ shirts เก็บข้อมูลชนิด Vec<ShirtColor> แทนสีของเสื้อที่ยังมีอยู่ในสต็อกปัจจุบัน ส่วนเมธอด giveaway ที่นิยามบน Inventory จะรับค่าความชอบเรื่องสีเสื้อของผู้โชคดี (ซึ่งอาจระบุหรือไม่ระบุก็ได้) และจะส่งคืนสีเสื้อที่คนนั้นจะได้รับ โครงสร้างทั้งหมดนี้แสดงไว้ในลิสติ้ง 13-1
#[derive(Debug, PartialEq, Copy, Clone)]
enum ShirtColor {
Red,
Blue,
}
struct Inventory {
shirts: Vec<ShirtColor>,
}
impl Inventory {
fn giveaway(&self, user_preference: Option<ShirtColor>) -> ShirtColor {
user_preference.unwrap_or_else(|| self.most_stocked())
}
fn most_stocked(&self) -> ShirtColor {
let mut num_red = 0;
let mut num_blue = 0;
for color in &self.shirts {
match color {
ShirtColor::Red => num_red += 1,
ShirtColor::Blue => num_blue += 1,
}
}
if num_red > num_blue {
ShirtColor::Red
} else {
ShirtColor::Blue
}
}
}
fn main() {
let store = Inventory {
shirts: vec![ShirtColor::Blue, ShirtColor::Red, ShirtColor::Blue],
};
let user_pref1 = Some(ShirtColor::Red);
let giveaway1 = store.giveaway(user_pref1);
println!(
"The user with preference {:?} gets {:?}",
user_pref1, giveaway1
);
let user_pref2 = None;
let giveaway2 = store.giveaway(user_pref2);
println!(
"The user with preference {:?} gets {:?}",
user_pref2, giveaway2
);
}ตัวแปร store ที่สร้างขึ้นในฟังก์ชัน main มีเสื้อสีน้ำเงิน 2 ตัวและเสื้อสีแดง 1 ตัวเหลืออยู่สำหรับแจกในแคมเปญนี้ เราได้เรียกใช้เมธอด giveaway กับผู้ใช้ที่ระบุว่าชอบเสื้อสีแดง และผู้ใช้ที่ไม่ได้ระบุความชอบใดๆ
เช่นเดิม โค้ดนี้สามารถเขียนได้หลายแบบ แต่เพื่อให้เรามุ่งเน้นไปที่เรื่องโคลเชอร์ เราจึงเลือกใช้แนวคิดพื้นฐานที่คุณคุ้นเคยกันดีอยู่แล้ว ยกเว้นเนื้อในเมธอด giveaway ที่นำโคลเชอร์เข้ามาช่วย ในเมธอด giveaway เราได้รับความชอบของผู้ใช้ผ่านพารามิเตอร์ชนิด Option<ShirtColor> แล้วเรียกเมธอด unwrap_or_else บน user_preference โดยเมธอด unwrap_or_else บน Option<T> นี้ถูกนิยามไว้ในไลบรารีมาตรฐาน ซึ่งรับอาร์กิวเมนต์หนึ่งตัวเป็นโคลเชอร์ที่ไม่ต้องรับพารามิเตอร์ใดๆ แต่ส่งคืนค่าชนิด T ออกมา (ซึ่งเป็นชนิดเดียวกับที่เก็บอยู่ในวาเรียนต์ Some ของ Option<T> ซึ่งในที่นี้ก็คือ ShirtColor) หาก Option<T> เป็นวาเรียนต์ Some เมธอด unwrap_or_else จะดึงค่าที่อยู่ข้างใน Some ออกมาส่งกลับให้ทันที แต่ถ้า Option<T> เป็นวาเรียนต์ None เมธอด unwrap_or_else จะเรียกสั่งรันโคลเชอร์ แล้วนำค่าที่โคลเชอร์ส่งกลับมานั้นมาส่งคืนต่อไป
เราระบุนิพจน์ของโคลเชอร์เป็น || self.most_stocked() ส่งเป็นอาร์กิวเมนต์ให้กับ unwrap_or_else โคลเชอร์นี้เป็นโคลเชอร์ที่ไม่รับพารามิเตอร์ใดๆ เลย (หากโคลเชอร์มีพารามิเตอร์ พารามิเตอร์เหล่านั้นจะอยู่ระหว่างเส้นขีดแนวตั้งหรือเครื่องหมายไปป์ | | สองอัน) และบอดี้ของโคลเชอร์จะสั่งเรียก self.most_stocked() ตรงนี้เราแค่นิยามโคลเชอร์เตรียมไว้ แล้วการทำงานภายในของ unwrap_or_else จะเป็นฝ่ายเรียกประเมินผลโคลเชอร์นี้ในภายหลังเมื่อมีความจำเป็นต้องใช้ผลลัพธ์เท่านั้น
การรันโค้ดนี้จะแสดงผลลัพธ์ต่อไปนี้:
$ cargo run
Compiling shirt-company v0.1.0 (file:///projects/shirt-company)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.27s
Running `target/debug/shirt-company`
The user with preference Some(Red) gets Red
The user with preference None gets Blue
จุดที่น่าสนใจเป็นพิเศษตรงนี้คือ เราได้ส่งโคลเชอร์ที่เรียกคำสั่ง self.most_stocked() บนอินสแตนซ์ Inventory ปัจจุบันเข้าไป โดยที่ไลบรารีมาตรฐานไม่จำเป็นต้องรู้จักชนิดข้อมูล Inventory หรือ ShirtColor ที่เรานิยามขึ้นเอง หรือตรรกะเฉพาะทางในสถานการณ์นี้เลยแม้แต่น้อย โคลเชอร์นี้จะจับเรเฟอเรนซ์แบบเปลี่ยนแปลงค่าไม่ได้ (immutable reference) ของอินสแตนซ์ self ซึ่งเป็น Inventory เอาไว้ แล้วส่งต่อเรเฟอเรนซ์นั้นพร้อมกับบล็อกโค้ดที่เรากำหนดไปยังเมธอด unwrap_or_else ซึ่งฟังก์ชันธรรมดาทั่วไปไม่สามารถจับค่าจากสภาพแวดล้อมในลักษณะนี้ได้
การอนุมานและการระบุชนิดของโคลเชอร์
ยังมีข้อแตกต่างอื่นๆ ระหว่างฟังก์ชันกับโคลเชอร์อีก โดยทั่วไปแล้วโคลเชอร์ไม่จำเป็นต้องให้คุณระบุชนิดข้อมูล (type annotation) ของพารามิเตอร์หรือค่าที่ส่งกลับเหมือนกับฟังก์ชัน fn เหตุผลที่ฟังก์ชันจำเป็นต้องระบุชนิดข้อมูลกำกับไว้เสมอ เพราะชนิดข้อมูลเป็นส่วนหนึ่งของอินเทอร์เฟซสาธารณะที่เปิดเผยต่อผู้เรียกใช้งาน การกำหนดอินเทอร์เฟซนี้ไว้อย่างชัดเจนและตายตัวจึงมีความสำคัญต่อการรับประกันว่าทุกคนเข้าใจตรงกันว่าฟังก์ชันนั้นรับและส่งกลับข้อมูลชนิดใด ในทางกลับกัน โคลเชอร์ไม่ได้ถูกนำไปใช้งานเป็นอินเทอร์เฟซที่เปิดเผยภายนอกเช่นนั้น โดยมากมันจะถูกจัดเก็บไว้ในตัวแปร และถูกเรียกใช้งานเฉพาะจุดโดยไม่ต้องตั้งชื่อหรือเปิดเผยให้ผู้ใช้ไลบรารีเห็น
โคลเชอร์มักจะมีขนาดสั้นและเกี่ยวข้องอยู่เฉพาะในบริบทที่แคบ แทนที่จะเป็นบริบทกว้างๆ ทั่วไป ภายในขอบเขตจำกัดเหล่านี้ คอมไพเลอร์จึงสามารถอนุมาน (infer) ชนิดข้อมูลของพารามิเตอร์และชนิดของค่าที่ส่งกลับได้เอง คล้ายกับวิธีที่มันอนุมานชนิดของตัวแปรส่วนใหญ่ (แม้ว่าจะมีกรณีที่พบได้ยากอยู่บ้างที่คอมไพเลอร์ต้องการให้ระบุชนิดของโคลเชอร์ด้วยเช่นกัน)
เช่นเดียวกับตัวแปร หากเราต้องการเพิ่มความชัดเจนให้เห็นอย่างชัดเจน เราก็สามารถเขียนระบุชนิดข้อมูลกำกับไว้ได้ แม้จะต้องแลกมาด้วยความยาวของโค้ดที่มากกว่าที่จำเป็นก็ตาม การระบุชนิดข้อมูลให้โคลเชอร์จะมีหน้าตาดังแสดงในลิสติ้ง 13-2 ซึ่งในตัวอย่างนี้ เราจะนิยามโคลเชอร์แล้วเก็บไว้ในตัวแปร แทนที่จะนิยามตรงจุดที่ส่งเป็นอาร์กิวเมนต์แบบที่เราทำในลิสติ้ง 13-1
use std::thread;
use std::time::Duration;
fn generate_workout(intensity: u32, random_number: u32) {
let expensive_closure = |num: u32| -> u32 {
println!("calculating slowly...");
thread::sleep(Duration::from_secs(2));
num
};
if intensity < 25 {
println!("Today, do {} pushups!", expensive_closure(intensity));
println!("Next, do {} situps!", expensive_closure(intensity));
} else {
if random_number == 3 {
println!("Take a break today! Remember to stay hydrated!");
} else {
println!(
"Today, run for {} minutes!",
expensive_closure(intensity)
);
}
}
}
fn main() {
let simulated_user_specified_value = 10;
let simulated_random_number = 7;
generate_workout(simulated_user_specified_value, simulated_random_number);
}เมื่อใส่การระบุชนิดข้อมูลเข้าไปแล้ว ไวยากรณ์ของโคลเชอร์จะดูคล้ายกับไวยากรณ์ของฟังก์ชันมากยิ่งขึ้น ในตัวอย่างนี้ เราจะนิยามฟังก์ชันที่บวกค่า 1 ให้กับพารามิเตอร์ เทียบกับโคลเชอร์ที่มีพฤติกรรมเดียวกันเพื่อเปรียบเทียบให้เห็นชัดเจน โดยเราได้เว้นวรรคช่องว่างบางส่วนเพื่อให้ส่วนที่ตรงกันวางเรียงตรงกันพอดี ซึ่งจะแสดงให้เห็นว่าไวยากรณ์ของโคลเชอร์คล้ายกับฟังก์ชันเพียงใด ยกเว้นการเปลี่ยนมาใช้เครื่องหมายไปป์และปริมาณไวยากรณ์ที่เป็นทางเลือก:
fn add_one_v1 (x: u32) -> u32 { x + 1 }
let add_one_v2 = |x: u32| -> u32 { x + 1 };
let add_one_v3 = |x| { x + 1 };
let add_one_v4 = |x| x + 1 ;บรรทัดแรกแสดงการนิยามฟังก์ชัน ส่วนบรรทัดที่สองแสดงการนิยามโคลเชอร์แบบระบุชนิดข้อมูลอย่างสมบูรณ์ ในบรรทัดที่สาม เราตัดการระบุชนิดข้อมูลออกจากโคลเชอร์ และในบรรทัดที่สี่ เราตัดเครื่องหมายปีกกาออกด้วย ซึ่งสามารถทำได้เนื่องจากบอดี้ของโคลเชอร์มีเพียงนิพจน์เดียว ทั้งหมดนี้ถือเป็นนิยามที่ถูกต้องตามไวยากรณ์และจะให้ผลลัพธ์เหมือนกันทุกประการเมื่อถูกเรียกใช้งาน สำหรับบรรทัด add_one_v3 และ add_one_v4 นั้น จำเป็นต้องมีการเรียกใช้งานโคลเชอร์ในโค้ดด้วยจึงจะคอมไพล์ผ่าน เพราะคอมไพเลอร์จำเป็นต้องอนุมานชนิดข้อมูลจากการนำไปใช้งานจริง ซึ่งคล้ายกับคำสั่ง let v = Vec::new(); ที่จำเป็นต้องมี type annotation หรือต้องมีการเพิ่มสมาชิกบางชนิดเข้าไปใน Vec ก่อน เพื่อให้ Rust อนุมานชนิดข้อมูลที่แน่นอนได้
สำหรับการนิยามโคลเชอร์ คอมไพเลอร์จะอนุมานชนิดข้อมูลที่เป็นรูปธรรม (concrete type) เพียงชนิดเดียวให้กับแต่ละพารามิเตอร์และค่าที่ส่งกลับ ตัวอย่างเช่น ลิสติ้ง 13-3 แสดงการนิยามโคลเชอร์สั้นๆ ที่ทำหน้าที่เพียงส่งค่าพารามิเตอร์ที่ได้รับกลับไปทันที โคลเชอร์นี้ไม่ได้มีประโยชน์ในทางปฏิบัติมากนักนอกจากใช้เป็นตัวอย่างประกอบ โปรดสังเกตว่าเราไม่ได้ระบุชนิดข้อมูลกำกับไว้เลย ซึ่งหมายความว่าเราสามารถเรียกใช้โคลเชอร์นี้กับข้อมูลชนิดใดก็ได้ โดยในการเรียกครั้งแรกเราได้ส่งค่า String เข้าไป แต่หากหลังจากนั้นเราพยายามเรียก example_closure ซ้ำด้วยตัวเลขจำนวนเต็ม เราจะพบกับข้อผิดพลาด
fn main() {
let example_closure = |x| x;
let s = example_closure(String::from("hello"));
let n = example_closure(5);
}คอมไพเลอร์จะแจ้งข้อผิดพลาดดังนี้:
$ cargo run
Compiling closure-example v0.1.0 (file:///projects/closure-example)
error[E0308]: mismatched types
--> src/main.rs:5:29
|
5 | let n = example_closure(5);
| --------------- ^ expected `String`, found integer
| |
| arguments to this function are incorrect
|
note: expected because the closure was earlier called with an argument of type `String`
--> src/main.rs:4:29
|
4 | let s = example_closure(String::from("hello"));
| --------------- ^^^^^^^^^^^^^^^^^^^^^ expected because this argument is of type `String`
| |
| in this closure call
note: closure parameter defined here
--> src/main.rs:2:28
|
2 | let example_closure = |x| x;
| ^
help: try using a conversion method
|
5 | let n = example_closure(5.to_string());
| ++++++++++++
For more information about this error, try `rustc --explain E0308`.
error: could not compile `closure-example` (bin "closure-example") due to 1 previous error
ในการเรียกใช้งาน example_closure ครั้งแรกด้วยค่า String คอมไพเลอร์จะอนุมานให้ชนิดข้อมูลของ x และค่าที่ส่งกลับของโคลเชอร์กลายเป็น String และชนิดข้อมูลดังกล่าวจะถูกล็อกเข้ากับโคลเชอร์ในตัวแปร example_closure นั้นทันที ทำให้เราได้รับข้อผิดพลาดเรื่องชนิดข้อมูลหากพยายามนำข้อมูลชนิดอื่นมาใช้กับโคลเชอร์เดิมในครั้งถัดไป
การจับเรเฟอเรนซ์หรือการย้ายความเป็นเจ้าของ
โคลเชอร์สามารถจับค่าจากสภาพแวดล้อมได้ 3 วิธี ซึ่งสอดคล้องกับ 3 วิธีที่ฟังก์ชันรับพารามิเตอร์โดยตรง ได้แก่: การยืมแบบเปลี่ยนแปลงไม่ได้ การยืมแบบเปลี่ยนแปลงได้ และการรับสิทธิ์ความเป็นเจ้าของ (ownership) โดยโคลเชอร์จะตัดสินใจเองว่าจะใช้วิธีใด ขึ้นอยู่กับสิ่งที่โค้ดภายในบอดี้ของมันกระทำกับค่าที่ถูกจับมา
ในลิสติ้ง 13-4 เรานิยามโคลเชอร์ที่จับเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ของเวกเตอร์ชื่อ list เนื่องจากมันต้องการเพียงเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้เพื่อพิมพ์ค่าออกมา
fn main() {
let list = vec![1, 2, 3];
println!("Before defining closure: {list:?}");
let only_borrows = || println!("From closure: {list:?}");
println!("Before calling closure: {list:?}");
only_borrows();
println!("After calling closure: {list:?}");
}ตัวอย่างนี้ยังแสดงให้เห็นด้วยว่า ตัวแปรสามารถผูกกับนิยามของโคลเชอร์ได้ และเราสามารถเรียกใช้โคลเชอร์ได้ในภายหลังโดยใช้ชื่อตัวแปรนั้นตามด้วยวงเล็บ เสมือนว่าชื่อตัวแปรนั้นเป็นชื่อฟังก์ชัน
เนื่องจากเราสามารถมีเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้หลายตัวชี้ไปยัง list พร้อมกันได้ ตัวแปร list จึงยังคงเข้าถึงได้จากโค้ดทั้งก่อนนิยามโคลเชอร์, หลังนิยามโคลเชอร์แต่ก่อนเรียกใช้งาน และหลังจากที่โคลเชอร์ถูกเรียกใช้งานแล้ว โค้ดนี้สามารถคอมไพล์ รัน และพิมพ์ผลลัพธ์ออกมาดังนี้:
$ cargo run
Compiling closure-example v0.1.0 (file:///projects/closure-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.43s
Running `target/debug/closure-example`
Before defining closure: [1, 2, 3]
Before calling closure: [1, 2, 3]
From closure: [1, 2, 3]
After calling closure: [1, 2, 3]
ถัดมาในลิสติ้ง 13-5 เราเปลี่ยนบอดี้ของโคลเชอร์ให้เพิ่มสมาชิกเข้าไปในเวกเตอร์ list ซึ่งตอนนี้โคลเชอร์จะจับเรเฟอเรนซ์แบบเปลี่ยนแปลงได้แทน
fn main() {
let mut list = vec![1, 2, 3];
println!("Before defining closure: {list:?}");
let mut borrows_mutably = || list.push(7);
borrows_mutably();
println!("After calling closure: {list:?}");
}โค้ดนี้สามารถคอมไพล์ รัน และพิมพ์ผลลัพธ์ออกมาดังนี้:
$ cargo run
Compiling closure-example v0.1.0 (file:///projects/closure-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.43s
Running `target/debug/closure-example`
Before defining closure: [1, 2, 3]
After calling closure: [1, 2, 3, 7]
โปรดสังเกตว่าไม่มีคำสั่ง println! คั่นระหว่างจุดที่นิยามกับการเรียกใช้งานโคลเชอร์ borrows_mutably อีกต่อไปแล้ว: ทันทีที่ borrows_mutably ถูกนิยาม มันจะจับเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ (mutable reference) ของ list เอาไว้ และเนื่องจากเราไม่ได้เรียกใช้โคลเชอร์นั้นอีกหลังจากการเรียกใช้งานครั้งแรก การยืมแบบเปลี่ยนแปลงได้จึงสิ้นสุดลงตรงจุดนั้น แต่ในช่วงระหว่างการนิยามโคลเชอร์ไปจนถึงการเรียกใช้งาน เราจะไม่สามารถยืมแบบเปลี่ยนแปลงไม่ได้เพื่อพิมพ์ค่าออกมาได้เลย เนื่องจากกฎการยืมของ Rust ไม่อนุญาตให้มีการยืมอื่นใดเกิดขึ้นในขณะที่มีการยืมแบบเปลี่ยนแปลงได้คงอยู่ ลองเพิ่ม println! ในจุดดังกล่าวดูเพื่อศึกษาข้อความแสดงข้อผิดพลาดที่คอมไพเลอร์จะแจ้งเตือน!
หากคุณต้องการบังคับให้โคลเชอร์รับสิทธิ์ความเป็นเจ้าของในค่าที่มันใช้ในสภาพแวดล้อม แม้ว่าบอดี้ของโคลเชอร์จะไม่จำเป็นต้องใช้ความเป็นเจ้าของอย่างเคร่งครัดก็ตาม คุณสามารถใช้คำสงวน move หน้ารายการพารามิเตอร์ได้
เทคนิคนี้มีประโยชน์อย่างยิ่งเมื่อต้องส่งโคลเชอร์ไปยังเธรดใหม่ เพื่อย้ายข้อมูลไปให้เธรดใหม่เป็นเจ้าของ เราจะพูดคุยถึงเธรดและเหตุผลที่คุณอาจต้องการใช้มันโดยละเอียดในบทที่ 16 เมื่อเราพูดคุยถึงการทำงานพร้อมกัน แต่สำหรับตอนนี้ มาสำรวจอย่างสั้นๆ เกี่ยวกับการสร้างเธรดใหม่โดยใช้โคลเชอร์ที่ต้องใช้คำสงวน move ลิสติ้ง 13-6 แสดงลิสติ้ง 13-4 ที่ถูกแก้ไขให้พิมพ์เวกเตอร์ในเธรดใหม่แทนที่จะเป็นในเธรดหลัก
use std::thread;
fn main() {
let list = vec![1, 2, 3];
println!("Before defining closure: {list:?}");
thread::spawn(move || println!("From thread: {list:?}"))
.join()
.unwrap();
}เราสร้างเธรดใหม่ขึ้นมา โดยส่งโคลเชอร์ที่จะให้รันเป็นอาร์กิวเมนต์แก่เธรด บอดี้ของโคลเชอร์พิมพ์รายการออกมา ในลิสติ้ง 13-4 โคลเชอร์จะจับ list ด้วยเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้เท่านั้น เนื่องจากนั่นเป็นระดับการเข้าถึงน้อยที่สุดที่จำเป็นต่อการพิมพ์ค่าออกมา แต่ในตัวอย่างนี้ แม้ว่าบอดี้ของโคลเชอร์จะต้องการเพียงเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ แต่เราจำเป็นต้องระบุให้ย้ายความเป็นเจ้าของ list เข้าไปไว้ในโคลเชอร์อย่างชัดเจน โดยวางคำสงวน move ไว้หน้าการนิยามโคลเชอร์ เหตุผลคือหากเธรดหลักทำงานอื่นต่อไปก่อนที่จะเรียก join เธรดใหม่อาจทำงานเสร็จก่อน หรือเธรดหลักอาจทำงานเสร็จก่อนและจบการทำงานลง ซึ่งหากเธรดหลักยังคงถือสิทธิ์ความเป็นเจ้าของ list อยู่แล้วจบการทำงานไปก่อน ข้อมูลใน list ก็จะถูกทิ้ง (drop) ไป ส่งผลให้เรเฟอเรนซ์ในเธรดใหม่กลายเป็นเรเฟอเรนซ์ที่ไม่ถูกต้องทันที ด้วยเหตุนี้ คอมไพเลอร์จึงบังคับให้ต้องย้าย list เข้าไปอยู่ในโคลเชอร์ของเธรดใหม่ เพื่อรับประกันว่าข้อมูลจะยังมีชีวิตอยู่ตราบเท่าที่เธรดใหม่ทำงาน ลองทดสอบโดยลบคำสงวน move ออก หรือลองเรียกใช้ list ในเธรดหลักหลังการนิยามโคลเชอร์ดู เพื่อศึกษาข้อความแสดงข้อผิดพลาดที่คอมไพเลอร์แจ้งเตือน!
การย้ายค่าที่ถูกจับออกจากโคลเชอร์
เมื่อโคลเชอร์ได้จับเรเฟอเรนซ์หรือรับสิทธิ์ความเป็นเจ้าของในค่าต่างๆ จากสภาพแวดล้อมที่มันถูกนิยาม (ซึ่งส่งผลต่อสิ่งที่จะถูกย้าย_เข้าไป_ในโคลเชอร์ หากมี) โค้ดในบอดี้ของโคลเชอร์จะเป็นตัวกำหนดต่อไปว่า จะเกิดอะไรขึ้นกับเรเฟอเรนซ์หรือค่านั้นเมื่อโคลเชอร์ถูกประเมินค่าในภายหลัง (ซึ่งส่งผลต่อสิ่งที่จะถูกย้าย_ออกจาก_โคลเชอร์ หากมี)
บอดี้ของโคลเชอร์สามารถกระทำการอย่างใดอย่างหนึ่งต่อไปนี้ได้: ย้ายค่าที่ถูกจับออกจากโคลเชอร์, เปลี่ยนแปลงค่าที่ถูกจับ, ไม่ย้ายและไม่เปลี่ยนแปลงค่า หรือไม่จับสิ่งใดจากสภาพแวดล้อมมาตั้งแต่แรก
วิธีที่โคลเชอร์จับและจัดการค่าจากสภาพแวดล้อมจะส่งผลต่อว่าโคลเชอร์นั้นอิมพลีเมนต์เทรต (trait) ใด และเทรตคือวิธีที่ฟังก์ชันและ struct ระบุได้ว่ามันรองรับการใช้งานโคลเชอร์ชนิดใดได้บ้าง โดยโคลเชอร์จะอิมพลีเมนต์เทรตกลุ่ม Fn หนึ่งตัว สองตัว หรือทั้งสามตัวนี้โดยอัตโนมัติ ในลักษณะเพิ่มพูนสะสม ขึ้นอยู่กับว่าบอดี้ของโคลเชอร์จัดการกับค่านั้นอย่างไร:
FnOnceใช้กับโคลเชอร์ที่เรียกได้ครั้งเดียว โคลเชอร์ทั้งหมดจะอิมพลีเมนต์เทรตนี้เป็นอย่างน้อย เพราะโคลเชอร์ทั้งหมดสามารถถูกเรียกได้ โคลเชอร์ที่ย้ายค่าที่ถูกจับออกจากบอดี้ของมันจะอิมพลีเมนต์เพียงFnOnceและไม่อิมพลีเมนต์เทรตFnอื่นๆ เลย เพราะมันสามารถเรียกได้เพียงครั้งเดียวเท่านั้นFnMutใช้กับโคลเชอร์ที่ไม่ย้ายค่าที่ถูกจับออกจากบอดี้ของมัน แต่อาจเปลี่ยนแปลงค่าที่ถูกจับได้ โคลเชอร์เหล่านี้สามารถเรียกได้มากกว่าหนึ่งครั้งFnใช้กับโคลเชอร์ที่ไม่ย้ายค่าที่ถูกจับออกจากบอดี้ของมันและไม่เปลี่ยนแปลงค่าที่ถูกจับ รวมถึงโคลเชอร์ที่ไม่จับสิ่งใดจากสภาพแวดล้อมของมันเลย โคลเชอร์เหล่านี้สามารถเรียกได้มากกว่าหนึ่งครั้งโดยไม่เปลี่ยนแปลงสภาพแวดล้อม ซึ่งมีความสำคัญอย่างยิ่งในกรณีเช่นการเรียกใช้โคลเชอร์หลายครั้งพร้อมกัน
มาดูนิยามของเมธอด unwrap_or_else บน Option<T> ที่เราใช้ในลิสติ้ง 13-1:
impl<T> Option<T> {
pub fn unwrap_or_else<F>(self, f: F) -> T
where
F: FnOnce() -> T
{
match self {
Some(x) => x,
None => f(),
}
}
}ย้อนนึกว่า T คือชนิดข้อมูลแบบเจเนอริก (generic) ที่เป็นตัวแทนของชนิดค่าภายในวาเรียนต์ Some ของ Option ชนิด T นั้นยังเป็นชนิดที่ส่งกลับของฟังก์ชัน unwrap_or_else ด้วย: ตัวอย่างเช่น โค้ดที่เรียก unwrap_or_else บน Option<String> จะได้ String ออกมา
ต่อไป โปรดสังเกตว่าฟังก์ชัน unwrap_or_else มีพารามิเตอร์ชนิดข้อมูลแบบเจเนอริกเพิ่มเติมคือ F ซึ่งชนิด F คือชนิดของพารามิเตอร์ชื่อ f อันเป็นโคลเชอร์ที่เราส่งเข้าไปเมื่อเรียกใช้ unwrap_or_else
ข้อกำหนดเทรต (trait bound) ที่ระบุบนชนิดเจเนอริก F คือ FnOnce() -> T ซึ่งหมายความว่า F ต้องสามารถถูกเรียกได้หนึ่งครั้ง ไม่รับอาร์กิวเมนต์ และส่งกลับค่าชนิด T การใช้ FnOnce ในข้อกำหนดเทรตเป็นการระบุข้อจำกัดว่า unwrap_or_else จะไม่เรียก f มากกว่าหนึ่งครั้งแน่นอน ในบอดี้ของ unwrap_or_else เราจะเห็นว่าหาก Option เป็น Some ตัวฟังก์ชัน f จะไม่ถูกเรียกเลย แต่หาก Option เป็น None ตัวฟังก์ชัน f จะถูกเรียกทำงานหนึ่งครั้ง และเนื่องจากโคลเชอร์ทั้งหมดอิมพลีเมนต์ FnOnce อยู่แล้ว เมธอด unwrap_or_else จึงยอมรับโคลเชอร์ได้ทั้งสามชนิดและมีความยืดหยุ่นสูงสุดเท่าที่จะเป็นไปได้
หมายเหตุ: หากสิ่งที่เราต้องการทำไม่จำเป็นต้องจับค่าจากสภาพแวดล้อม เราสามารถใช้ชื่อของฟังก์ชันธรรมดาแทนโคลเชอร์ในจุดที่ต้องการบางสิ่งที่อิมพลีเมนต์เทรต
Fnตัวใดตัวหนึ่งได้ ตัวอย่างเช่น บนค่าOption<Vec<T>>เราสามารถเรียกunwrap_or_else(Vec::new)เพื่อสร้างเวกเตอร์ใหม่ที่ว่างเปล่าหากค่าเป็นNoneโดยคอมไพเลอร์จะอิมพลีเมนต์เทรตFnตัวใดก็ตามที่เข้ากันได้กับนิยามของฟังก์ชันนั้นให้โดยอัตโนมัติ
ตอนนี้ มาดูเมธอด sort_by_key ของไลบรารีมาตรฐาน ซึ่งนิยามไว้บนสไลซ์ เพื่อดูว่ามันแตกต่างจาก unwrap_or_else อย่างไร และเพราะเหตุใด sort_by_key จึงใช้ FnMut แทน FnOnce สำหรับข้อกำหนดเทรต โดยโคลเชอร์จะได้รับอาร์กิวเมนต์หนึ่งตัวในรูปของเรเฟอเรนซ์ไปยังสมาชิกปัจจุบันในสไลซ์ที่กำลังพิจารณา และจะส่งกลับค่าชนิด K ที่สามารถนำไปจัดเรียงลำดับได้ ฟังก์ชันนี้มีประโยชน์มากเมื่อคุณต้องการเรียงลำดับสมาชิกในสไลซ์ตามคุณลักษณะเฉพาะอย่างของแต่ละสมาชิก ในลิสติ้ง 13-7 เรามีรายการของอินสแตนซ์ Rectangle และเราใช้ sort_by_key เพื่อจัดเรียงพวกมันตามคุณลักษณะ width จากน้อยไปมาก
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
fn main() {
let mut list = [
Rectangle { width: 10, height: 1 },
Rectangle { width: 3, height: 5 },
Rectangle { width: 7, height: 12 },
];
list.sort_by_key(|r| r.width);
println!("{list:#?}");
}โค้ดนี้พิมพ์:
$ cargo run
Compiling rectangles v0.1.0 (file:///projects/rectangles)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.41s
Running `target/debug/rectangles`
[
Rectangle {
width: 3,
height: 5,
},
Rectangle {
width: 7,
height: 12,
},
Rectangle {
width: 10,
height: 1,
},
]
เหตุผลที่ sort_by_key ถูกนิยามให้รับโคลเชอร์ที่อิมพลีเมนต์ FnMut เป็นเพราะมันจำเป็นต้องเรียกโคลเชอร์หลายครั้ง: ครั้งละหนึ่งรอบต่อสมาชิกแต่ละตัวในสไลซ์ โคลเชอร์ |r| r.width ไม่ได้จับ ไม่ได้เปลี่ยนแปลง และไม่ได้ย้ายสิ่งใดออกจากสภาพแวดล้อมของมัน มันจึงสอดคล้องกับเงื่อนไขของข้อกำหนดเทรตทุกประการ
ในทางตรงกันข้าม ลิสติ้ง 13-8 แสดงตัวอย่างของโคลเชอร์ที่อิมพลีเมนต์ได้เพียงเทรต FnOnce เพราะมันย้ายค่าออกจากสภาพแวดล้อม คอมไพเลอร์จึงไม่อนุญาตให้เรานำโคลเชอร์นี้ไปใช้กับ sort_by_key
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
fn main() {
let mut list = [
Rectangle { width: 10, height: 1 },
Rectangle { width: 3, height: 5 },
Rectangle { width: 7, height: 12 },
];
let mut sort_operations = vec![];
let value = String::from("closure called");
list.sort_by_key(|r| {
sort_operations.push(value);
r.width
});
println!("{list:#?}");
}นี่เป็นตัวอย่างการเขียนโค้ดที่ตั้งใจสร้างขึ้นมา (และใช้งานไม่ได้จริง) เพื่อพยายามนับจำนวนครั้งที่ sort_by_key เรียกสั่งรันโคลเชอร์ขณะจัดเรียงสมาชิกใน list โค้ดนี้พยายามนับจำนวนรอบโดยการพุช (push) ค่า value ซึ่งเป็น String จากสภาพแวดล้อมเข้าไปในเวกเตอร์ sort_operations ในกรณีนี้ โคลเชอร์จะจับ value และย้าย value นั้นออกจากโคลเชอร์โดยโอนสิทธิ์ความเป็นเจ้าของไปให้เวกเตอร์ sort_operations ส่งผลให้โคลเชอร์นี้สามารถถูกเรียกใช้งานได้เพียงครั้งเดียวเท่านั้น หากพยายามเรียกซ้ำเป็นครั้งที่สองย่อมทำไม่ได้ เพราะค่า value ไม่ได้คงอยู่ในสภาพแวดล้อมให้พุชเข้าไปใน sort_operations ได้อีกต่อไป! ดังนั้น โคลเชอร์นี้จึงอิมพลีเมนต์ได้เพียงเทรต FnOnce และเมื่อเราพยายามคอมไพล์โค้ดนี้ เราจึงได้รับข้อผิดพลาดแจ้งว่า value ไม่สามารถย้ายออกจากโคลเชอร์ได้ เนื่องจาก sort_by_key กำหนดให้โคลเชอร์ต้องอิมพลีเมนต์เทรต FnMut:
$ cargo run
Compiling rectangles v0.1.0 (file:///projects/rectangles)
error[E0507]: cannot move out of `value`, a captured variable in an `FnMut` closure
--> src/main.rs:18:30
|
15 | let value = String::from("closure called");
| ----- ------------------------------ move occurs because `value` has type `String`, which does not implement the `Copy` trait
| |
| captured outer variable
16 |
17 | list.sort_by_key(|r| {
| --- captured by this `FnMut` closure
18 | sort_operations.push(value);
| ^^^^^ `value` is moved here
|
help: `Fn` and `FnMut` closures require captured values to be able to be consumed multiple times, but `FnOnce` closures may consume them only once
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/alloc/src/slice.rs:249:11
help: consider cloning the value if the performance cost is acceptable
|
18 | sort_operations.push(value.clone());
| ++++++++
For more information about this error, try `rustc --explain E0507`.
error: could not compile `rectangles` (bin "rectangles") due to 1 previous error
ข้อความแสดงข้อผิดพลาดชี้ไปยังบรรทัดในบอดี้ของโคลเชอร์ที่ย้าย value ออกจากสภาพแวดล้อม เพื่อแก้ไขปัญหานี้ เราจำเป็นต้องปรับเปลี่ยนโค้ดภายในบอดี้ของโคลเชอร์ไม่ให้ย้ายค่าออกจากสภาพแวดล้อม การสร้างตัวแปรนับจำนวน (counter) ไว้ในสภาพแวดล้อมแล้วเพิ่มค่าของมันภายในโคลเชอร์ถือเป็นวิธีที่ตรงไปตรงมาและเหมาะสมกว่าสำหรับการนับจำนวนรอบที่โคลเชอร์ถูกเรียก โคลเชอร์ในลิสติ้ง 13-9 สามารถทำงานร่วมกับ sort_by_key ได้อย่างราบรื่น เพราะมันจับเพียงเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ของตัวแปรนับ num_sort_operations จึงสามารถถูกเรียกใช้งานซ้ำได้หลายครั้ง
#[derive(Debug)]
struct Rectangle {
width: u32,
height: u32,
}
fn main() {
let mut list = [
Rectangle { width: 10, height: 1 },
Rectangle { width: 3, height: 5 },
Rectangle { width: 7, height: 12 },
];
let mut num_sort_operations = 0;
list.sort_by_key(|r| {
num_sort_operations += 1;
r.width
});
println!("{list:#?}, sorted in {num_sort_operations} operations");
}เทรตกลุ่ม Fn มีความสำคัญอย่างยิ่งทั้งในการนิยามและการเรียกใช้ฟังก์ชันหรือชนิดข้อมูลที่ทำงานร่วมกับโคลเชอร์ ในหัวข้อถัดไป เราจะได้เรียนรู้เกี่ยวกับตัววนซ้ำหรืออิเทอเรเตอร์ (iterators) ซึ่งเมธอดของอิเทอเรเตอร์จำนวนมากจะรับอาร์กิวเมนต์เป็นโคลเชอร์ ดังนั้นขอให้จดจำรายละเอียดเกี่ยวกับโคลเชอร์เหล่านี้ไว้เพื่อนำไปต่อยอดในหัวข้อถัดไปครับ!
ประมวลผลลำดับรายการด้วยอิเทอเรเตอร์
ประมวลผลลำดับรายการด้วยอิเทอเรเตอร์
รูปแบบอิเทอเรเตอร์ (iterator pattern) ช่วยให้คุณทำงานกับชุดลำดับของข้อมูลทีละสมาชิกได้อย่างเป็นระเบียบ ตัวอิเทอเรเตอร์ (iterator) จะรับหน้าที่จัดการตรรกะในการวนลูปผ่านสมาชิกแต่ละตัว และคอยตรวจสอบว่าลำดับข้อมูลนั้นสิ้นสุดลงเมื่อใด ทำให้เมื่อคุณใช้งานอิเทอเรเตอร์ คุณจึงไม่จำเป็นต้องเขียนตรรกะการวนลูปเหล่านั้นขึ้นมาใหม่ด้วยตัวเอง
ในภาษา Rust อิเทอเรเตอร์จะทำงานแบบ_ประเมินผลตามความต้องการ_ หรือ เลซี่ (lazy evaluation) ซึ่งหมายความว่ามันจะยังไม่เริ่มประมวลผลข้อมูลใดๆ จนกว่าคุณจะเรียกใช้เมธอดที่ดึงข้อมูลจากอิเทอเรเตอร์ไปใช้งานจริง ตัวอย่างเช่น โค้ดในลิสติ้ง 13-10 เป็นการสร้างอิเทอเรเตอร์เพื่อวนอ่านสมาชิกในเวกเตอร์ v1 โดยเรียกเมธอด iter ที่นิยามไว้บน Vec<T> ซึ่งลำพังโค้ดชุดนี้เพียงอย่างเดียวยังไม่ได้ก่อให้เกิดผลลัพธ์ที่เป็นประโยชน์ใดๆ
fn main() {
let v1 = vec![1, 2, 3];
let v1_iter = v1.iter();
}อิเทอเรเตอร์จะถูกจัดเก็บไว้ในตัวแปร v1_iter และเมื่อเราสร้างอิเทอเรเตอร์ขึ้นมาแล้ว เราก็สามารถนำไปใช้งานต่อได้หลากหลายรูปแบบ ในลิสติ้ง 3-5 เราเคยวนลูปผ่านอาร์เรย์โดยใช้ลูป for เพื่อรันโค้ดกับสมาชิกแต่ละตัว ซึ่งเบื้องหลังการทำงานนั้น ลูป for ได้สร้างอิเทอเรเตอร์ขึ้นมาโดยปริยายแล้วดึงข้อมูลไปใช้จนหมด แต่เราข้ามรายละเอียดการทำงานเบื้องลึกตรงนั้นมาจนถึงบทนี้
ในตัวอย่างลิสติ้ง 13-11 เราได้แยกขั้นตอนการสร้างอิเทอเรเตอร์ ออกจากการนำอิเทอเรเตอร์ไปใช้ในลูป for อย่างชัดเจน เมื่อลูป for เริ่มทำงานกับอิเทอเรเตอร์ใน v1_iter สมาชิกแต่ละตัวจากอิเทอเรเตอร์ก็จะถูกดึงมาประมวลผลในลูปแต่ละรอบเพื่อพิมพ์ค่าออกมา
fn main() {
let v1 = vec![1, 2, 3];
let v1_iter = v1.iter();
for val in v1_iter {
println!("Got: {val}");
}
}ในภาษาโปรแกรมที่ไม่มีอิเทอเรเตอร์เตรียมไว้ให้ในไลบรารีมาตรฐาน คุณมักจะต้องเขียนการทำงานลักษณะนี้ด้วยตนเอง โดยเริ่มประกาศตัวแปรดัชนี (index) ที่ค่า 0 แล้วใช้ดัชนีนั้นเข้าถึงข้อมูลในเวกเตอร์ทีละตำแหน่ง พร้อมกับคอยบวกค่าดัชนีเพิ่มขึ้นทีละ 1 ในลูปไปเรื่อยๆ จนกว่าจะครบตามจำนวนสมาชิกทั้งหมดของเวกเตอร์
อิเทอเรเตอร์ช่วยจัดการตรรกะทั้งหมดเหล่านั้นแทนคุณ จึงช่วยลดโค้ดที่ซ้ำซ้อนและลดโอกาสเกิดข้อผิดพลาด นอกจากนี้ อิเทอเรเตอร์ยังให้ความยืดหยุ่นที่สูงกว่ามาก เพราะคุณสามารถนำตรรกะแบบเดียวกันนี้ไปประยุกต์ใช้กับลำดับของข้อมูลได้หลากหลายประเภท ไม่จำกัดเฉพาะโครงสร้างข้อมูลที่เข้าถึงผ่านดัชนีได้อย่างเวกเตอร์เท่านั้น เรามาเจาะลึกกันว่าอิเทอเรเตอร์ทำงานเช่นนั้นได้อย่างไร
เทรต Iterator และเมธอด next
อิเทอเรเตอร์ทุกตัวใน Rust จะต้องอิมพลีเมนต์เทรต (trait) ที่ชื่อว่า Iterator ซึ่งถูกนิยามไว้ในไลบรารีมาตรฐาน โดยนิยามของเทรตนี้มีหน้าตาดังนี้:
#![allow(unused)]
fn main() {
pub trait Iterator {
type Item;
fn next(&mut self) -> Option<Self::Item>;
// methods with default implementations elided
}
}โปรดสังเกตว่านิยามนี้ใช้ไวยากรณ์ใหม่: type Item และ Self::Item ซึ่งเป็นการนิยามชนิดข้อมูลประจำเทรต (associated type) ร่วมกับเทรตนี้ เราจะพูดถึง associated type อย่างละเอียดในบทที่ 20 สำหรับตอนนี้ สิ่งที่คุณต้องทราบคือ โค้ดนี้ระบุว่าการจะอิมพลีเมนต์เทรต Iterator ได้นั้น คุณจะต้องกำหนดชนิดข้อมูล Item ด้วยเสมอ และชนิดข้อมูล Item นี้จะถูกนำไปใช้เป็นชนิดของค่าที่ส่งกลับจากเมธอด next หรือกล่าวอีกนัยหนึ่งคือ ชนิดข้อมูล Item จะเป็นชนิดข้อมูลของสมาชิกที่อิเทอเรเตอร์ตัวนั้นส่งออกมา
เทรต Iterator กำหนดให้ผู้อิมพลีเมนต์ต้องเขียนนิยามเพียงเมธอดเดียวเท่านั้น นั่นคือเมธอด next ซึ่งจะส่งสมาชิกของอิเทอเรเตอร์ออกมาทีละตัวโดยห่อหุ้มไว้ใน Some และเมื่อวนจนครบข้อมูลลำดับสุดท้ายแล้ว มันก็จะส่งกลับเป็น None
เราสามารถเรียกใช้เมธอด next บนอิเทอเรเตอร์ได้โดยตรง ลิสติ้ง 13-12 สาธิตให้เห็นว่าค่าใดบ้างที่จะถูกส่งกลับมาจากการเรียกใช้ next ซ้ำๆ บนอิเทอเรเตอร์ที่สร้างขึ้นจากเวกเตอร์
#[cfg(test)]
mod tests {
#[test]
fn iterator_demonstration() {
let v1 = vec![1, 2, 3];
let mut v1_iter = v1.iter();
assert_eq!(v1_iter.next(), Some(&1));
assert_eq!(v1_iter.next(), Some(&2));
assert_eq!(v1_iter.next(), Some(&3));
assert_eq!(v1_iter.next(), None);
}
}โปรดสังเกตว่าเราจำเป็นต้องประกาศให้ v1_iter เปลี่ยนแปลงค่าได้ (mut): การเรียกเมธอด next บนอิเทอเรเตอร์จะไปเปลี่ยนสถานะภายในที่อิเทอเรเตอร์ใช้คอยติดตามลำดับตำแหน่งของข้อมูล กล่าวคือ โค้ดชุดนี้จะ_ดึงใช้ข้อมูล (consume)_ จากอิเทอเรเตอร์ โดยการเรียก next แต่ละครั้งจะดึงข้อมูลสมาชิกหนึ่งตัวออกจากอิเทอเรเตอร์ไป ทั้งนี้เราไม่จำเป็นต้องทำให้ v1_iter เปลี่ยนแปลงค่าได้เมื่อเราใช้ลูป for เนื่องจากลูป for จะรับสิทธิ์ความเป็นเจ้าของ v1_iter และจัดการให้มันเปลี่ยนแปลงค่าได้อยู่เบื้องหลังโดยอัตโนมัติ
โปรดสังเกตเพิ่มเติมว่า ค่าที่เราได้จากการเรียก next จะเป็นเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ (immutable reference) ที่ชี้ไปยังค่าในเวกเตอร์ เนื่องจากการเรียกเมธอด iter จะสร้างอิเทอเรเตอร์ที่วนซ้ำบนเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ แต่หากเราต้องการสร้างอิเทอเรเตอร์ที่รับสิทธิ์ความเป็นเจ้าของ v1 และส่งคืนค่าที่เป็นเจ้าของโดยตรง เราสามารถเรียกใช้เมธอด into_iter แทน iter ได้ ในทำนองเดียวกัน หากเราต้องการวนซ้ำเพื่อแก้ไขข้อมูลผ่านเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ เราก็สามารถเรียกใช้เมธอด iter_mut แทนได้เช่นกัน
เมธอดที่บริโภคอิเทอเรเตอร์
เทรต Iterator มีเมธอดต่างๆ มากมายที่มีการอิมพลีเมนต์ค่าเริ่มต้นจากไลบรารีมาตรฐาน คุณสามารถเรียนรู้เกี่ยวกับเมธอดเหล่านี้ได้โดยดูในเอกสาร API ของไลบรารีมาตรฐานสำหรับเทรต Iterator เมธอดเหล่านี้บางตัวเรียกเมธอด next ในนิยามของมัน ซึ่งเป็นเหตุผลว่าทำไมคุณจึงต้องอิมพลีเมนต์เมธอด next เมื่ออิมพลีเมนต์เทรต Iterator
เมธอดที่เรียกใช้ next ภายในตัวเองจะเรียกว่า ตัวปรับที่ดึงใช้ข้อมูลจนหมด (consuming adaptors) เนื่องจากการเรียกเมธอดเหล่านี้จะดึงข้อมูลจากอิเทอเรเตอร์ไปจนหมด ตัวอย่างหนึ่งคือเมธอด sum ซึ่งจะรับสิทธิ์ความเป็นเจ้าของของอิเทอเรเตอร์ และวนซ้ำผ่านสมาชิกแต่ละตัวโดยเรียก next ซ้ำๆ จึงถือเป็นการดึงใช้ข้อมูลจากอิเทอเรเตอร์จนหมด ในระหว่างที่วนซ้ำ มันจะนำสมาชิกแต่ละตัวมาบวกสะสมเข้าด้วยกัน แล้วส่งคืนผลรวมออกมาเมื่อวนซ้ำจนเสร็จสมบูรณ์ ลิสติ้ง 13-13 แสดงตัวอย่างการทดสอบการใช้งานเมธอด sum
#[cfg(test)]
mod tests {
#[test]
fn iterator_sum() {
let v1 = vec![1, 2, 3];
let v1_iter = v1.iter();
let total: i32 = v1_iter.sum();
assert_eq!(total, 6);
}
}เราจะไม่สามารถใช้งาน v1_iter ต่อหลังจากการเรียก sum ได้อีก เนื่องจาก sum ได้รับสิทธิ์ความเป็นเจ้าของของอิเทอเรเตอร์ตัวนั้นไปแล้ว
เมธอดที่สร้างอิเทอเรเตอร์อื่น
ตัวปรับอิเทอเรเตอร์ (iterator adaptors) คือเมธอดที่นิยามไว้บนเทรต Iterator ซึ่งไม่ได้ดึงใช้ข้อมูลจากอิเทอเรเตอร์เดิมจนหมด แต่จะสร้างอิเทอเรเตอร์ตัวใหม่ขึ้นมาแทน โดยปรับเปลี่ยนพฤติกรรมบางประการไปจากอิเทอเรเตอร์ต้นฉบับ
ลิสติ้ง 13-14 แสดงตัวอย่างการเรียกเมธอดตัวปรับอิเทอเรเตอร์ map ซึ่งรับโคลเชอร์ (closure) เข้าไปเรียกทำงานกับสมาชิกแต่ละตัวในระหว่างวนซ้ำ เมธอด map จะส่งคืนอิเทอเรเตอร์ตัวใหม่ที่ผลิตสมาชิกที่ผ่านการปรับแก้แล้วออกมา โคลเชอร์ในตัวอย่างนี้จะสร้างอิเทอเรเตอร์ตัวใหม่ที่สมาชิกแต่ละตัวจากเวกเตอร์เดิมจะถูกบวกเพิ่มค่าทีละ 1
fn main() {
let v1: Vec<i32> = vec![1, 2, 3];
v1.iter().map(|x| x + 1);
}อย่างไรก็ตาม โค้ดนี้สร้างคำเตือน:
$ cargo run
Compiling iterators v0.1.0 (file:///projects/iterators)
warning: unused `Map` that must be used
--> src/main.rs:4:5
|
4 | v1.iter().map(|x| x + 1);
| ^^^^^^^^^^^^^^^^^^^^^^^^
|
= note: iterators are lazy and do nothing unless consumed
= note: `#[warn(unused_must_use)]` (part of `#[warn(unused)]`) on by default
help: use `let _ = ...` to ignore the resulting value
|
4 | let _ = v1.iter().map(|x| x + 1);
| +++++++
warning: `iterators` (bin "iterators") generated 1 warning
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.47s
Running `target/debug/iterators`
โค้ดในลิสติ้ง 13-14 ไม่ได้ทำอะไรเป็นชิ้นเป็นอันเลย โคลเชอร์ที่เราระบุไว้ไม่เคยถูกเรียกให้ทำงานด้วยซ้ำ ข้อความเตือนช่วยย้ำเตือนให้เราเห็นเหตุผล: นั่นคือตัวปรับอิเทอเรเตอร์ทำงานแบบเลซี่ (lazy) และเราจำเป็นต้องเรียกใช้เมธอดที่ดึงข้อมูลไปใช้งานจริงในจุดนี้
เพื่อแก้ไขข้อความเตือนนี้และดึงข้อมูลจากอิเทอเรเตอร์ไปใช้งาน เราจะเรียกใช้เมธอด collect ซึ่งเราเคยใช้ร่วมกับ env::args ในลิสติ้ง 12-1 โดยเมธอดนี้จะดึงข้อมูลจากอิเทอเรเตอร์จนหมด แล้วรวบรวมค่าผลลัพธ์เหล่านั้นจัดเก็บไว้ในโครงสร้างข้อมูลแบบคอลเลกชัน (collection)
ในลิสติ้ง 13-15 เราเก็บผลลัพธ์ของการวนซ้ำผ่านอิเทอเรเตอร์ที่ถูกคืนกลับจากการเรียก map ไว้ในเวกเตอร์ เวกเตอร์นี้จะบรรจุสมาชิกแต่ละตัวจากเวกเตอร์ต้นฉบับที่ถูกเพิ่มค่า 1 ในที่สุด
fn main() {
let v1: Vec<i32> = vec![1, 2, 3];
let v2: Vec<_> = v1.iter().map(|x| x + 1).collect();
assert_eq!(v2, vec![2, 3, 4]);
}เนื่องจาก map รับโคลเชอร์ เราจึงสามารถระบุตรรกะการประมวลผลใดๆ ที่ต้องการกระทำกับสมาชิกแต่ละตัวได้อย่างอิสระ นี่เป็นตัวอย่างอันยอดเยี่ยมที่แสดงให้เห็นว่าโคลเชอร์ช่วยให้เราปรับแต่งพฤติกรรมการทำงานเฉพาะจุดได้อย่างไร ในขณะที่ยังคงนำตรรกะการวนซ้ำที่เทรต Iterator เตรียมไว้มาใช้ซ้ำได้อย่างเต็มที่
คุณสามารถเชื่อมโยง (chain) การเรียกตัวปรับอิเทอเรเตอร์หลายตัวต่อกันเป็นทอดๆ เพื่อทำงานที่ซับซ้อนได้อย่างเป็นระเบียบและอ่านเข้าใจง่าย แต่เนื่องจากอิเทอเรเตอร์ทั้งหมดทำงานแบบเลซี่ คุณจึงต้องเรียกเมธอดตัวปรับที่ดึงใช้ข้อมูล (consuming adaptor) ตัวใดตัวหนึ่งปิดท้ายเสมอ เพื่อให้เกิดการประมวลผลและได้ผลลัพธ์จากการเชื่อมโยงตัวปรับอิเทอเรเตอร์เหล่านั้นออกมา
โคลเชอร์ที่จับสภาพแวดล้อมของมัน
ตัวปรับอิเทอเรเตอร์หลายตัวรับโคลเชอร์เป็นอาร์กิวเมนต์ และโดยทั่วไปโคลเชอร์ที่เราส่งเข้าไปก็มักจะเป็นโคลเชอร์ที่จับค่าจากสภาพแวดล้อมของมัน
สำหรับตัวอย่างนี้ เราจะใช้เมธอด filter ซึ่งรับโคลเชอร์เข้ามา โดยโคลเชอร์จะได้รับสมาชิกหนึ่งตัวจากอิเทอเรเตอร์และส่งคืนค่าเป็นบูลีน (bool) หากโคลเชอร์ส่งคืนค่า true สมาชิกนั้นจะถูกเก็บไว้ในอิเทอเรเตอร์ตัวใหม่ที่ filter สร้างขึ้น แต่หากโคลเชอร์ส่งคืนค่า false สมาชิกนั้นจะถูกคัดทิ้งไป
ในลิสติ้ง 13-16 เราใช้ filter ร่วมกับโคลเชอร์ที่จับค่าตัวแปร shoe_size จากสภาพแวดล้อม เพื่อวนซ้ำผ่านคอลเลกชันของอินสแตนซ์ struct Shoe ซึ่งจะคัดกรองและส่งคืนเฉพาะรองเท้าที่มีขนาดตามที่ระบุเท่านั้น
#[derive(PartialEq, Debug)]
struct Shoe {
size: u32,
style: String,
}
fn shoes_in_size(shoes: Vec<Shoe>, shoe_size: u32) -> Vec<Shoe> {
shoes.into_iter().filter(|s| s.size == shoe_size).collect()
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn filters_by_size() {
let shoes = vec![
Shoe {
size: 10,
style: String::from("sneaker"),
},
Shoe {
size: 13,
style: String::from("sandal"),
},
Shoe {
size: 10,
style: String::from("boot"),
},
];
let in_my_size = shoes_in_size(shoes, 10);
assert_eq!(
in_my_size,
vec![
Shoe {
size: 10,
style: String::from("sneaker")
},
Shoe {
size: 10,
style: String::from("boot")
},
]
);
}
}ฟังก์ชัน shoes_in_size รับสิทธิ์ความเป็นเจ้าของเวกเตอร์ของรองเท้าและขนาดรองเท้าเป็นพารามิเตอร์ และจะส่งคืนเวกเตอร์ที่มีเฉพาะรองเท้าขนาดที่ต้องการกลับออกมา
ในบอดี้ของ shoes_in_size เราเรียก into_iter เพื่อสร้างอิเทอเรเตอร์ที่รับสิทธิ์ความเป็นเจ้าของเวกเตอร์ จากนั้นเรียก filter เพื่อปรับเปลี่ยนให้อิเทอเรเตอร์นั้นส่งคืนเฉพาะสมาชิกที่โคลเชอร์ประเมินค่าได้เป็น true
ตัวโคลเชอร์จะจับค่าพารามิเตอร์ shoe_size จากสภาพแวดล้อมเข้ามาเปรียบเทียบกับขนาดของรองเท้าแต่ละคู่ โดยเลือกเก็บเฉพาะคู่ที่มีขนาดตรงกัน สุดท้าย การเรียกเมธอด collect จะรวบรวมค่าที่อิเทอเรเตอร์คัดกรองได้ทั้งหมดเก็บลงในเวกเตอร์ แล้วส่งคืนออกจากฟังก์ชัน
ผลการทดสอบแสดงให้เห็นว่า เมื่อเราเรียกใช้ shoes_in_size เราจะได้เฉพาะรองเท้าที่มีขนาดตรงตามที่เราระบุไว้กลับคืนมาอย่างถูกต้อง
ปรับปรุงโปรเจกต์ I/O ของเรา
ปรับปรุงโปรเจกต์ I/O ของเรา
ด้วยความรู้ใหม่เกี่ยวกับอิเทอเรเตอร์ (iterator) นี้ เราสามารถนำมาปรับปรุงโปรเจกต์ I/O จากบทที่ 12 ให้โค้ดในหลายๆ จุดมีความชัดเจนและกระชับยิ่งขึ้นได้ มาดูกันว่าอิเทอเรเตอร์จะช่วยยกระดับการอิมพลีเมนต์ฟังก์ชัน Config::build และฟังก์ชัน search ของเราได้อย่างไรบ้าง
ขจัด clone ด้วยอิเทอเรเตอร์
ในลิสติ้ง 12-6 เราได้เพิ่มโค้ดที่รับสไลซ์ของค่า String เข้ามา แล้วสร้างอินสแตนซ์ของ struct Config ขึ้นมาโดยการเข้าถึงตำแหน่งดัชนีในสไลซ์และทำการโคลน (clone) ค่าเหล่านั้น เพื่อให้ struct Config ได้รับสิทธิ์ความเป็นเจ้าของในค่านั้น ในลิสติ้ง 13-17 เราได้นำการพัฒนาฟังก์ชัน Config::build จากลิสติ้ง 12-23 มาแสดงให้ดูอีกครั้ง
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
println!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
println!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}ในตอนนั้น เราได้บอกไว้ว่าไม่ต้องกังวลเรื่องการเรียกคำสั่ง clone ที่อาจดูไม่มีประสิทธิภาพ เพราะเราจะกลับมาปรับปรุงโค้ดส่วนนี้ในภายหลัง และตอนนี้ก็ถึงเวลาแล้วครับ!
สาเหตุที่เราจำเป็นต้องใช้ clone ในตอนนั้นก็เพราะว่า พารามิเตอร์ args เป็นเพียงสไลซ์ที่เก็บเรเฟอเรนซ์ของ String และตัวฟังก์ชัน build เองก็ไม่ได้เป็นเจ้าของข้อมูลใน args แต่การจะส่งคืนอินสแตนซ์ของ Config ที่สมบูรณ์ออกมาได้นั้น เราจำเป็นต้องโคลนค่าในฟิลด์ query และ file_path เพื่อให้ Config ได้รับสิทธิ์เป็นเจ้าของข้อมูลเหล่านั้นอย่างแท้จริง
ด้วยความรู้เรื่องอิเทอเรเตอร์ที่เราเพิ่งได้เรียนรู้ไป เราสามารถปรับเปลี่ยนฟังก์ชัน build ให้รับสิทธิ์ความเป็นเจ้าของของอิเทอเรเตอร์เข้ามาเป็นอาร์กิวเมนต์โดยตรงแทนการยืมข้อมูลผ่านสไลซ์ และนำความสามารถของอิเทอเรเตอร์มาใช้งานแทนโค้ดเดิมที่ต้องคอยตรวจนับความยาวของสไลซ์และเข้าถึงข้อมูลด้วยดัชนี ซึ่งช่วยให้โค้ดของ Config::build สื่อความหมายและเจตนาในการทำงานได้ชัดเจนยิ่งขึ้น
และเมื่อ Config::build ได้รับสิทธิ์ความเป็นเจ้าของในตัวอิเทอเรเตอร์ และไม่ต้องเข้าถึงข้อมูลผ่านดัชนีที่เกิดจากการยืมอีกต่อไป เราจึงสามารถย้ายค่า (move) ของ String ออกจากอิเทอเรเตอร์เข้าไปเก็บไว้ใน Config ได้โดยตรง โดยไม่ต้องเรียกใช้ clone เพื่อจัดสรรหน่วยความจำใหม่อีกเลย
การใช้อิเทอเรเตอร์ที่ถูกคืนกลับโดยตรง
เปิดไฟล์ src/main.rs ของโปรเจกต์ I/O ของคุณ ซึ่งควรมีหน้าตาดังนี้:
ชื่อไฟล์: src/main.rs
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let args: Vec<String> = env::args().collect();
let config = Config::build(&args).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
// --snip--
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}ก่อนอื่น เราจะเปลี่ยนจุดเริ่มต้นของฟังก์ชัน main ที่เรามีในลิสติ้ง 12-24 เป็นโค้ดในลิสติ้ง 13-18 ซึ่งครั้งนี้ใช้อิเทอเรเตอร์ โค้ดนี้จะยังไม่คอมไพล์จนกว่าเราจะอัปเดต Config::build ด้วยเช่นกัน
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let config = Config::build(env::args()).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
// --snip--
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(args: &[String]) -> Result<Config, &'static str> {
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}ฟังก์ชัน env::args ส่งคืนค่าเป็นอิเทอเรเตอร์! แทนที่เราจะรวบรวมค่าจากอิเทอเรเตอร์เก็บลงในเวกเตอร์แล้วค่อยส่งสไลซ์ไปให้ Config::build ตอนนี้เราสามารถส่งสิทธิ์ความเป็นเจ้าของของอิเทอเรเตอร์ที่ได้จาก env::args ให้กับ Config::build ได้โดยตรงเลย
ต่อไป เราต้องอัปเดตนิยามของ Config::build มาปรับเปลี่ยนซิกเนเจอร์ของ Config::build ให้เป็นดังลิสติ้ง 13-19 กันครับ โค้ดนี้จะยังคอมไพล์ไม่ผ่าน เนื่องจากเรายังไม่ได้ปรับปรุงเนื้อหาภายในฟังก์ชัน
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let config = Config::build(env::args()).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(
mut args: impl Iterator<Item = String>,
) -> Result<Config, &'static str> {
// --snip--
if args.len() < 3 {
return Err("not enough arguments");
}
let query = args[1].clone();
let file_path = args[2].clone();
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}เอกสารของไลบรารีมาตรฐานสำหรับฟังก์ชัน env::args ระบุว่า ชนิดข้อมูลของอิเทอเรเตอร์ที่ส่งคืนกลับมาคือ std::env::Args ซึ่งชนิดข้อมูลนี้ได้อิมพลีเมนต์เทรต Iterator และส่งคืนสมาชิกออกมาเป็นชนิด String
เราได้อัปเดตซิกเนเจอร์ของฟังก์ชัน Config::build เพื่อให้พารามิเตอร์ args มีชนิดข้อมูลแบบเจเนอริกที่มีข้อกำหนดเทรต (trait bound) เป็น impl Iterator<Item = String> แทนที่จะเป็น &[String] การใช้ไวยากรณ์ impl Trait ที่เราได้เรียนรู้ในหัวข้อ“การใช้เทรตเป็นพารามิเตอร์” ของบทที่ 10 หมายความว่า args สามารถเป็นชนิดข้อมูลใดๆ ก็ได้ที่อิมพลีเมนต์เทรต Iterator และส่งคืนสมาชิกเป็นชนิด String
และเนื่องจากเราได้รับสิทธิ์ความเป็นเจ้าของใน args เข้ามา และเราจำเป็นต้องแก้ไขสถานะภายในของ args ผ่านการวนซ้ำ เราจึงต้องใส่คำสงวน mut กำกับไว้หน้าพารามิเตอร์ args เพื่อทำให้มันเปลี่ยนแปลงค่าได้
การใช้เมธอดของเทรต Iterator
ต่อไป เราจะปรับปรุงโค้ดภายในบอดี้ของ Config::build เนื่องจากเรารู้ว่า args อิมพลีเมนต์เทรต Iterator เราจึงสามารถเรียกใช้เมธอด next บนมันได้โดยตรง! ลิสติ้ง 13-20 แสดงการปรับปรุงโค้ดจากลิสติ้ง 12-23 ให้เปลี่ยนมาใช้เมธอด next
use std::env;
use std::error::Error;
use std::fs;
use std::process;
use minigrep::{search, search_case_insensitive};
fn main() {
let config = Config::build(env::args()).unwrap_or_else(|err| {
eprintln!("Problem parsing arguments: {err}");
process::exit(1);
});
if let Err(e) = run(config) {
eprintln!("Application error: {e}");
process::exit(1);
}
}
pub struct Config {
pub query: String,
pub file_path: String,
pub ignore_case: bool,
}
impl Config {
fn build(
mut args: impl Iterator<Item = String>,
) -> Result<Config, &'static str> {
args.next();
let query = match args.next() {
Some(arg) => arg,
None => return Err("Didn't get a query string"),
};
let file_path = match args.next() {
Some(arg) => arg,
None => return Err("Didn't get a file path"),
};
let ignore_case = env::var("IGNORE_CASE").is_ok();
Ok(Config {
query,
file_path,
ignore_case,
})
}
}
fn run(config: Config) -> Result<(), Box<dyn Error>> {
let contents = fs::read_to_string(config.file_path)?;
let results = if config.ignore_case {
search_case_insensitive(&config.query, &contents)
} else {
search(&config.query, &contents)
};
for line in results {
println!("{line}");
}
Ok(())
}จำไว้ว่าค่าแรกในค่าที่คืนกลับของ env::args คือชื่อของโปรแกรม เราต้องการข้ามค่านั้นและไปยังค่าถัดไป ดังนั้นก่อนอื่นเราเรียก next และไม่ทำอะไรกับค่าที่คืนกลับ จากนั้นเราเรียก next เพื่อดึงค่าที่เราต้องการใส่ในฟิลด์ query ของ Config หาก next คืน Some เราใช้ match เพื่อแยกค่าออกมา หากมันคืน None หมายความว่าให้อาร์กิวเมนต์มาไม่เพียงพอ และเราคืนค่าออกก่อนกำหนดด้วยค่า Err เราทำเช่นเดียวกันกับค่า file_path
ทำให้โค้ดชัดเจนขึ้นด้วยตัวปรับอิเทอเรเตอร์
เรายังใช้ประโยชน์จากอิเทอเรเตอร์ในฟังก์ชัน search ในโปรเจกต์ I/O ของเราได้ด้วย ซึ่งถูกจำลองขึ้นใหม่ที่นี่ในลิสติ้ง 13-21 ตามที่มีในลิสติ้ง 12-19
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
let mut results = Vec::new();
for line in contents.lines() {
if line.contains(query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn one_result() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
}เราสามารถเขียนโค้ดนี้ให้กระชับและอ่านง่ายยิ่งขึ้นได้โดยใช้เมธอดตัวปรับอิเทอเรเตอร์ (iterator adaptors) ซึ่งช่วยให้เราไม่ต้องสร้างเวกเตอร์ชั่วคราว results ที่เปลี่ยนแปลงค่าได้อีกต่อไป ในแนวทางการเขียนโปรแกรมเชิงฟังก์ชัน (functional programming) มักนิยมลดการใช้สถานะที่เปลี่ยนแปลงค่าได้ (mutable state) ให้เหลือน้อยที่สุดเพื่อให้โค้ดอ่านเข้าใจได้ชัดเจนยิ่งขึ้น การกำจัดสถานะที่เปลี่ยนแปลงได้นี้ยังช่วยเปิดทางให้เราสามารถขยายฟังก์ชันการทำงานในอนาคต เช่น การค้นหาแบบขนาน (parallel search) ได้อย่างง่ายดาย เพราะเราไม่ต้องกังวลเรื่องการจัดการสิทธิ์เข้าถึงเวกเตอร์ results พร้อมกัน ลิสติ้ง 13-22 แสดงการปรับปรุงโค้ดดังกล่าว
pub fn search<'a>(query: &str, contents: &'a str) -> Vec<&'a str> {
contents
.lines()
.filter(|line| line.contains(query))
.collect()
}
pub fn search_case_insensitive<'a>(
query: &str,
contents: &'a str,
) -> Vec<&'a str> {
let query = query.to_lowercase();
let mut results = Vec::new();
for line in contents.lines() {
if line.to_lowercase().contains(&query) {
results.push(line);
}
}
results
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn case_sensitive() {
let query = "duct";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Duct tape.";
assert_eq!(vec!["safe, fast, productive."], search(query, contents));
}
#[test]
fn case_insensitive() {
let query = "rUsT";
let contents = "\
Rust:
safe, fast, productive.
Pick three.
Trust me.";
assert_eq!(
vec!["Rust:", "Trust me."],
search_case_insensitive(query, contents)
);
}
}ย้อนนึกว่าจุดประสงค์ของฟังก์ชัน search คือการค้นหาและส่งคืนทุกบรรทัดใน contents ที่มี query อยู่ คล้ายกับตัวอย่าง filter ในลิสติ้ง 13-16 โค้ดนี้ใช้ตัวปรับ filter เพื่อคัดกรองเฉพาะบรรทัดที่ line.contains(query) คืน true จากนั้นเราเก็บบรรทัดที่ตรงกันไว้ในเวกเตอร์อีกตัวด้วย collect ดูเรียบง่ายและกระชับขึ้นมากเลยใช่ไหมครับ! คุณสามารถนำแนวคิดเดียวกันนี้ไปปรับใช้กับฟังก์ชัน search_case_insensitive เพื่อให้ทำงานผ่านเมธอดของอิเทอเรเตอร์ได้เช่นกัน
สำหรับการปรับปรุงเพิ่มเติม ให้ลองปรับให้ฟังก์ชัน search ส่งคืนอิเทอเรเตอร์ออกมาโดยตรง โดยตัดการเรียก collect ออก และเปลี่ยนชนิดของค่าที่ส่งกลับเป็น impl Iterator<Item = &'a str> ซึ่งจะทำให้ฟังก์ชันกลายเป็นตัวปรับอิเทอเรเตอร์ไปในตัว (โปรดสังเกตว่าคุณจะต้องอัปเดตโค้ดในส่วนของเทสต์ตามไปด้วย!) ลองค้นหาในไฟล์ขนาดใหญ่โดยใช้เครื่องมือ minigrep ของคุณก่อนและหลังการเปลี่ยนแปลงนี้เพื่อสังเกตความแตกต่างของพฤติกรรม: ก่อนการปรับปรุง โปรแกรมจะไม่พิมพ์ผลลัพธ์ใดๆ จนกว่าจะรวบรวมผลลัพธ์ทั้งหมดเสร็จ แต่หลังการเปลี่ยนแปลง ผลลัพธ์จะถูกพิมพ์ทันทีที่พบบรรทัดที่ตรงกันแต่ละบรรทัด เพราะลูป for ในฟังก์ชัน run สามารถใช้ประโยชน์จากการประเมินผลตามความต้องการ (lazy evaluation) ของอิเทอเรเตอร์ได้ทันที
การเลือกระหว่างลูปกับอิเทอเรเตอร์
คำถามเชิงตรรกะข้อถัดไปคือ แล้วคุณควรเลือกเขียนโค้ดแบบใดในโปรเจกต์ของคุณเองและเพราะเหตุใด: ระหว่างการอิมพลีเมนต์ต้นฉบับในลิสติ้ง 13-21 หรือเวอร์ชันที่ใช้อิเทอเรเตอร์ในลิสติ้ง 13-22 (สมมติว่าเรารวบรวมผลลัพธ์ทั้งหมดก่อนส่งคืน แทนที่จะส่งคืนอิเทอเรเตอร์) โปรแกรมเมอร์ Rust ส่วนใหญ่ชอบใช้สไตล์อิเทอเรเตอร์มากกว่า ในตอนแรกอาจต้องใช้เวลาปรับตัวเพื่อทำความเข้าใจอยู่บ้าง แต่เมื่อคุณคุ้นเคยกับตัวปรับอิเทอเรเตอร์ต่างๆ และการทำงานของพวกมันแล้ว โค้ดที่ใช้อิเทอเรเตอร์จะอ่านและทำความเข้าใจได้ง่ายกว่ามาก แทนที่จะต้องมาคอยพะวงกับรายละเอียดการจัดการลูปและการสร้างเวกเตอร์ใหม่ โค้ดจะมุ่งเน้นไปที่เป้าหมายระดับสูงของการประมวลผลโดยตรง ซึ่งช่วยซ่อนรายละเอียดทางเทคนิคที่ซ้ำซากออกไป และทำให้เห็นเจตนาสำคัญของโค้ดได้ง่ายขึ้น เช่น เงื่อนไขการกรองข้อมูลที่สมาชิกแต่ละตัวในอิเทอเรเตอร์ต้องผ่าน
แต่คำถามคือ ทั้งสองวิธีนี้มีประสิทธิภาพเทียบเท่ากันจริงหรือไม่? ตามสัญชาตญาณ หลายคนอาจคิดว่าลูปในระดับล่างน่าจะทำงานได้เร็วกว่า ในหัวข้อถัดไปเราจะมาพูดคุยถึงเรื่องประสิทธิภาพกันครับ
ประสิทธิภาพของลูปเทียบกับอิเทอเรเตอร์
ประสิทธิภาพของลูปเทียบกับอิเทอเรเตอร์
ในการตัดสินใจว่าจะเลือกใช้ลูปหรืออิเทอเรเตอร์ คุณอาจอยากทราบว่าการอิมพลีเมนต์แบบไหนทำงานได้เร็วกว่ากัน: ระหว่างเวอร์ชันของฟังก์ชัน search ที่เขียนลูป for ไว้อย่างชัดเจน กับเวอร์ชันที่หันมาใช้อิเทอเรเตอร์ (iterator)
เราได้ทำการทดสอบวัดประสิทธิภาพ (benchmark) โดยโหลดเนื้อหาทั้งหมดของหนังสือเรื่อง The Adventures of Sherlock Holmes ของเซอร์อาร์เธอร์ โคนัน ดอยล์ เข้าไปใน String แล้วสั่งค้นหาคำว่า the ในเนื้อหาทั้งหมด และนี่คือผลลัพธ์การวัดประสิทธิภาพระหว่างฟังก์ชัน search ที่ใช้ลูป for เทียบกับเวอร์ชันที่ใช้อิเทอเรเตอร์:
test bench_search_for ... bench: 19,620,300 ns/iter (+/- 915,700)
test bench_search_iter ... bench: 19,234,900 ns/iter (+/- 657,200)
การอิมพลีเมนต์ทั้งสองแบบให้ประสิทธิภาพที่ใกล้เคียงกันมาก! เราจะไม่ลงลึกในโค้ดของการวัดประสิทธิภาพตรงนี้ เพราะเป้าหมายไม่ใช่การพิสูจน์ว่าทั้งสองแบบมีความเท่ากันทุกประการ แต่เพื่อให้เห็นภาพรวมว่าทั้งสองวิธีนี้เทียบเคียงกันอย่างไรในแง่ของความเร็ว
หากต้องการวัดประสิทธิภาพอย่างครอบคลุมรอบด้านยิ่งขึ้น คุณอาจต้องทดสอบกับข้อความหลากขนาดใน contents, ทดสอบคำค้นหลายรูปแบบและมีความยาวต่างกันใน query รวมถึงรูปแบบตัวแปรอื่น ๆ อีกมากมาย แต่ประเด็นสำคัญมีอยู่ว่า: แม้ว่าอิเทอเรเตอร์จะเป็นแนวคิดแบบนามธรรมระดับสูง (high-level abstraction) แต่มันกลับถูกคอมไพล์ลงมาเป็นโค้ดที่มีประสิทธิภาพเทียบเท่ากับการที่คุณเขียนโค้ดระดับล่างด้วยตนเอง อิเทอเรเตอร์จึงจัดเป็นหนึ่งใน_นามธรรมไร้ต้นทุน_ (zero-cost abstractions) ของ Rust ซึ่งหมายความว่า การเรียกใช้นามธรรมเหล่านี้จะไม่ก่อให้เกิดภาระงานเพิ่มเติม (runtime overhead) ตอนรันไทม์เลยแม้แต่น้อย สิ่งนี้สอดคล้องกับคำนิยามของหลักการ zero-overhead ที่ Bjarne Stroustrup ผู้ริเริ่มออกแบบและพัฒนาภาษา C++ ได้เคยกล่าวไว้ในสุนทรพจน์หลักงาน ETAPS ปี 2012 หัวข้อ “Foundations of C++”:
โดยทั่วไปแล้ว การอิมพลีเมนต์ของ C++ จะยึดถือหลักการ zero-overhead นั่นคือ: สิ่งที่คุณไม่ได้ใช้งาน คุณก็ไม่ต้องจ่ายต้นทุนให้มัน และยิ่งไปกว่านั้น: สิ่งที่คุณนำมาใช้งาน คุณก็ไม่สามารถเขียนโค้ดให้ดีกว่านี้ได้แล้ว
ในหลาย ๆ กรณี โค้ดภาษา Rust ที่ใช้อิเทอเรเตอร์สามารถคอมไพล์ออกมาเป็นโค้ดภาษาแอสเซมบลีที่เหมือนกับโค้ดที่คุณเขียนปรับแต่งด้วยมือทุกประการ การปรับแต่งระดับคอมไพเลอร์ (optimization) เช่น การคลี่ลูป (loop unrolling) และการตัดการตรวจสอบขอบเขต (eliminating bounds checking) ในการเข้าถึงอาร์เรย์ จะถูกนำมาประยุกต์ใช้อัตโนมัติ ทำให้โค้ดที่ได้มีประสิทธิภาพการทำงานสูงอย่างยิ่ง เมื่อทราบเช่นนี้แล้ว คุณจึงสามารถใช้งานอิเทอเรเตอร์และโคลเชอร์ (closure) ได้อย่างมั่นใจไร้กังวล! เพราะพวกมันช่วยให้โค้ดของคุณดูเป็นระเบียบและอ่านเข้าใจง่ายในระดับสูง โดยไม่สูญเสียความเร็วและประสิทธิภาพการทำงานตอนรันไทม์เลยแม้แต่น้อย
บทสรุป
โคลเชอร์และอิเทอเรเตอร์เป็นฟีเจอร์ของ Rust ที่ได้รับแรงบันดาลใจมาจากแนวคิดของการเขียนโปรแกรมเชิงฟังก์ชัน (functional programming) ฟีเจอร์ทั้งสองนี้ช่วยเสริมพลังให้ภาษา Rust สามารถถ่ายทอดแนวคิดการทำงานระดับสูงได้อย่างชัดเจนและกระชับ โดยยังคงรักษาประสิทธิภาพความเร็วระดับโค้ดระดับล่างไว้ได้อย่างยอดเยี่ยม การอิมพลีเมนต์โคลเชอร์และอิเทอเรเตอร์ใน Rust ถูกออกแบบมาอย่างพิถีพิถันจนไม่ส่งผลกระทบต่อประสิทธิภาพตอนรันไทม์เลย ซึ่งทั้งหมดนี้เป็นส่วนหนึ่งของเป้าหมายหลักใน Rust ที่มุ่งมั่นส่งมอบนามธรรมไร้ต้นทุน (zero-cost abstractions) ให้แก่นักพัฒนาเสมอมา
เมื่อเราได้ยกระดับความชัดเจนและสละสลวยให้กับโค้ดในโปรเจกต์ I/O ของเราเรียบร้อยแล้ว ในบทถัดไป เราจะไปทำความรู้จักกับฟีเจอร์เพิ่มเติมของ cargo ที่จะช่วยให้เราสามารถเผยแพร่และแบ่งปันโปรเจกต์ของเราสู่สายตาชาวโลกได้
เพิ่มเติมเกี่ยวกับ Cargo และ Crates.io
จนถึงตอนนี้ เราได้ใช้งานเพียงฟีเจอร์พื้นฐานที่สุดของ Cargo เพื่อบิลด์ (build), รัน (run) และทดสอบ (test) โค้ดของเราเท่านั้น ทว่า Cargo ยังมีความสามารถอื่น ๆ อีกมากมาย ในบทนี้ เราจะมาพูดคุยถึงฟีเจอร์ขั้นสูงอื่น ๆ ของมัน เพื่อแสดงให้เห็นวิธีทำสิ่งต่าง ๆ ดังต่อไปนี้:
- การปรับแต่งตัวเลือกการบิลด์ผ่านโปรไฟล์การรีลีส (release profiles)
- การเผยแพร่ไลบรารีบน crates.io
- การจัดโครงสร้างโปรเจกต์ขนาดใหญ่ด้วยเวิร์กสเปซ (workspaces)
- การติดตั้งโปรแกรมไบนารีจาก crates.io
- การขยายขีดความสามารถของ Cargo ด้วยคำสั่งเสริมที่คุณกำหนดเอง (custom commands)
แท้จริงแล้ว Cargo ยังมีความสามารถอีกมากมายนอกเหนือจากสิ่งที่เราจะกล่าวถึงในบทนี้ หากต้องการศึกษารายละเอียดและฟีเจอร์ทั้งหมดอย่างครบถ้วน สามารถเข้าไปดูเพิ่มเติมได้ที่ เอกสารคู่มือของ Cargo
ปรับแต่งการบิลด์ด้วยโปรไฟล์การรีลีส
ปรับแต่งการบิลด์ด้วยโปรไฟล์การรีลีส
ในภาษา Rust โปรไฟล์การรีลีส (release profiles) คือโปรไฟล์การตั้งค่าที่ถูกกำหนดไว้ล่วงหน้าและสามารถปรับแต่งได้ ซึ่งช่วยให้โปรแกรมเมอร์สามารถควบคุมตัวเลือกต่าง ๆ สำหรับการคอมไพล์โค้ดได้อย่างยืดหยุ่น โดยแต่ละโปรไฟล์จะถูกตั้งค่าแยกต่างหากเป็นอิสระจากกัน
Cargo มีโปรไฟล์หลักอยู่สองโปรไฟล์ ได้แก่: โปรไฟล์ dev ที่ Cargo จะเลือกใช้เมื่อคุณสั่ง cargo build และโปรไฟล์ release ที่ Cargo จะใช้เมื่อคุณสั่ง cargo build --release โดยโปรไฟล์ dev จะถูกกำหนดค่าเริ่มต้นให้เหมาะสำหรับการพัฒนาโปรแกรม ส่วนโปรไฟล์ release จะมีค่าเริ่มต้นที่เหมาะสมสำหรับการบิลด์เพื่อนำไปใช้งานจริง (release builds)
ชื่อของโปรไฟล์เหล่านี้อาจดูคุ้นตาจากข้อความผลลัพธ์การบิลด์ของคุณ:
$ cargo build
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.00s
$ cargo build --release
Finished `release` profile [optimized] target(s) in 0.32s
คำว่า dev และ release เหล่านี้ก็คือโปรไฟล์ที่แตกต่างกันซึ่งคอมไพเลอร์เลือกนำมาใช้นั่นเอง
Cargo มีการกำหนดค่าเริ่มต้นสำหรับแต่ละโปรไฟล์ไว้แล้ว ซึ่งจะมีผลทำงานโดยอัตโนมัติหากคุณยังไม่ได้ระบุส่วน [profile.*] ใด ๆ ในไฟล์ Cargo.toml ของโปรเจกต์ แต่หากคุณต้องการปรับแต่งค่าของโปรไฟล์ใด คุณก็สามารถเพิ่มส่วน [profile.*] เพื่อเขียนทับ (override) ค่าเริ่มต้นเฉพาะบางส่วนได้ตามต้องการ ตัวอย่างเช่น นี่คือค่าเริ่มต้นของตัวเลือก opt-level สำหรับโปรไฟล์ dev และ release:
ชื่อไฟล์: Cargo.toml
[profile.dev]
opt-level = 0
[profile.release]
opt-level = 3
ตัวเลือก opt-level จะควบคุมระดับการปรับแต่งประสิทธิภาพ (optimization) ที่ Rust จะนำไปใช้กับโค้ดของคุณ โดยมีค่าตั้งแต่ระดับ 0 ถึง 3 ยิ่งระดับการปรับแต่งสูงขึ้น คอมไพเลอร์ก็จะต้องใช้เวลาในการคอมไพล์นานขึ้นตามไปด้วย ดังนั้นในระหว่างช่วงพัฒนาที่คุณต้องคอมไพล์โค้ดบ่อย ๆ คุณจึงต้องการให้คอมไพเลอร์ปรับแต่งโค้ดให้น้อยที่สุดเพื่อให้คอมไพล์ได้เร็ว แม้ว่าโค้ดที่ได้จะทำงานช้าลงก็ตาม ด้วยเหตุนี้ ค่าเริ่มต้นของ opt-level สำหรับโปรไฟล์ dev จึงเป็น 0 ในทางตรงกันข้าม เมื่อคุณพร้อมที่จะรีลีสโปรแกรมออกไปใช้งานจริง การยอมเสียเวลาคอมไพล์ให้นานขึ้นย่อมคุ้มค่ากว่า เพราะคุณจะคอมไพล์ในโหมด release เพียงครั้งเดียว แต่ผู้ใช้จะนำโปรแกรมที่คอมไพล์เสร็จแล้วไปรันใช้งานซ้ำ ๆ หลายครั้ง โหมด release จึงยอมแลกเวลาคอมไพล์ที่นานขึ้นกับประสิทธิภาพความเร็วของโปรแกรมที่ทำงานได้เร็วขึ้นอย่างยิ่ง นั่นคือเหตุผลที่ค่าเริ่มต้นของ opt-level ในโปรไฟล์ release ถูกตั้งไว้ที่ 3
คุณสามารถเขียนทับค่าเริ่มต้นได้ง่าย ๆ เพียงแค่ระบุค่าใหม่ลงในไฟล์ Cargo.toml ตัวอย่างเช่น หากเราต้องการใช้ระดับการปรับแต่งประสิทธิภาพเลเวล 1 ในโปรไฟล์สำหรับการพัฒนา เราก็สามารถเพิ่มสองบรรทัดนี้ลงในไฟล์ Cargo.toml ของโปรเจกต์ได้:
ชื่อไฟล์: Cargo.toml
[profile.dev]
opt-level = 1
โค้ดส่วนนี้จะเข้าไปเขียนทับค่าเริ่มต้นเดิมซึ่งเป็น 0 และเมื่อเราสั่งรันคำสั่ง cargo build หลังจากนี้ Cargo จะใช้ค่าเริ่มต้นทั้งหมดของโปรไฟล์ dev บวกกับการปรับแต่งค่า opt-level ที่เรากำหนดไว้ และเนื่องจากเราตั้ง opt-level ไว้ที่ 1 Cargo จึงจะปรับแต่งโค้ดให้มากกว่าค่าเริ่มต้นเล็กน้อย แต่จะไม่มากเท่ากับในบิลด์รีลีส
หากต้องการดูรายการตัวเลือกการตั้งค่าทั้งหมดและค่าเริ่มต้นของแต่ละโปรไฟล์ สามารถดูเพิ่มเติมได้ที่ เอกสารคู่มือของ Cargo
เผยแพร่เครตไปยัง Crates.io
เผยแพร่เครตไปยัง Crates.io
ที่ผ่านมาเราเคยใช้แพ็กเกจ (packages) จาก crates.io เป็นดีเพนเดนซี (dependency) ในโปรเจกต์ของเรากันมาแล้ว แต่คุณเองก็สามารถแบ่งปันโค้ดของคุณให้กับผู้อื่นได้เช่นกันผ่านการเผยแพร่แพ็กเกจของคุณเอง ระบบเรจิสทรีของเครตที่ crates.io จะทำหน้าที่แจกจ่ายซอร์สโค้ดของแพ็กเกจของคุณ ดังนั้นมันจึงถูกออกแบบมาเพื่อโฮสต์โค้ดที่เป็นโอเพนซอร์ส (open source) เป็นหลัก
ทั้ง Rust และ Cargo มีฟีเจอร์มากมายที่ช่วยให้ผู้คนสามารถค้นหาและนำแพ็กเกจที่คุณเผยแพร่ไปใช้งานได้ง่ายขึ้น เราจะมาดูฟีเจอร์เหล่านี้กันก่อน จากนั้นจึงจะอธิบายขั้นตอนการเผยแพร่แพ็กเกจสู่สาธารณะ
การเขียนคอมเมนต์เอกสารประกอบที่มีประโยชน์
การเขียนเอกสารประกอบ (documentation) ของแพ็กเกจอย่างถูกต้องและครบถ้วนจะช่วยให้ผู้ใช้คนอื่นเข้าใจได้ว่าควรนำแพ็กเกจของคุณไปใช้งานอย่างไรและในกรณีใดบ้าง จึงคุ้มค่าอย่างยิ่งที่คุณจะสละเวลาเขียนเอกสารประกอบ ในบทที่ 3 เราเคยพูดถึงการเขียนคอมเมนต์ในโค้ด Rust โดยใช้เครื่องหมายทับสองตัว // ไปแล้ว นอกจากนี้ Rust ยังมีคอมเมนต์รูปแบบพิเศษสำหรับทำเอกสารประกอบโดยเฉพาะ ซึ่งเรียกกันว่า คอมเมนต์เอกสารประกอบ (documentation comment หรือ doc comment) ที่จะถูกนำไปสร้างเป็นเอกสารเว็บแบบ HTML โดยเอกสาร HTML นี้จะนำเนื้อหาจากคอมเมนต์เอกสารประกอบของรายการใน API สาธารณะมาแสดง เพื่อให้โปรแกรมเมอร์ที่สนใจนำเครตของคุณไปใช้เข้าใจวิธี_เรียกใช้งาน_ แทนที่จะต้องไปแกะดูว่าเครตของคุณถูก_อิมพลีเมนต์_ ไว้อย่างไร
คอมเมนต์เอกสารประกอบจะใช้เครื่องหมายทับสามตัว /// แทนที่จะเป็นสองตัว และรองรับการจัดรูปแบบข้อความด้วยภาษา Markdown โดยเราจะวางคอมเมนต์เอกสารประกอบไว้หน้าบรรทัดของรายการที่เราต้องการอธิบายพอดี ลิสติ้ง 14-1 แสดงตัวอย่างคอมเมนต์เอกสารประกอบสำหรับฟังก์ชัน add_one ในเครตชื่อ my_crate
/// Adds one to the number given.
///
/// # Examples
///
/// ```
/// let arg = 5;
/// let answer = my_crate::add_one(arg);
///
/// assert_eq!(6, answer);
/// ```
pub fn add_one(x: i32) -> i32 {
x + 1
}ตรงนี้ เราเขียนคำอธิบายว่าฟังก์ชัน add_one ทำงานอะไร จากนั้นขึ้นหัวข้อย่อยด้วยหัวเรื่อง Examples แล้วใส่ตัวอย่างโค้ดที่สาธิตวิธีเรียกใช้ฟังก์ชัน add_one เราสามารถสร้างเอกสาร HTML จากคอมเมนต์เอกสารประกอบนี้ได้ด้วยคำสั่ง cargo doc ซึ่งคำสั่งนี้จะเรียกใช้เครื่องมือ rustdoc ที่ติดตั้งมาพร้อมกับ Rust และบันทึกไฟล์เอกสาร HTML ที่สร้างขึ้นไว้ในไดเรกทอรี target/doc
และเพื่อความสะดวก การรันคำสั่ง cargo doc --open จะทำการบิลด์เอกสาร HTML สำหรับเครตปัจจุบันของคุณ (รวมถึงเอกสารของดีเพนเดนซีทั้งหมดที่เครตของคุณใช้งาน) แล้วเปิดผลลัพธ์ในเว็บเบราว์เซอร์ให้ทันที หากคุณคลิกเข้าไปดูที่ฟังก์ชัน add_one คุณจะเห็นว่าข้อความในคอมเมนต์เอกสารประกอบถูกเรนเดอร์ออกมาอย่างสวยงามดังแสดงในรูปที่ 14-1
รูปที่ 14-1: เอกสารประกอบ HTML สำหรับฟังก์ชัน add_one
หัวข้อที่ใช้บ่อย
เราใช้หัวเรื่อง Markdown # Examples ในลิสติ้ง 14-1 เพื่อสร้างหัวข้อย่อยใน HTML ที่ชื่อว่า “Examples” นอกจากนี้ยังมีหัวข้อย่อยอื่นๆ ที่ผู้พัฒนาเครตนิยมนำมาใส่ไว้ในเอกสารประกอบ ดังนี้:
- Panics: อธิบายถึงสถานการณ์ที่อาจทำให้ฟังก์ชันเกิดการแพนิก (panic) เพื่อให้ผู้เรียกใช้งานฟังก์ชันระมัดระวังและหลีกเลี่ยงการเรียกใช้ในกรณีดังกล่าว
- Errors: หากฟังก์ชันส่งคืนค่าเป็น
Resultการอธิบายถึงชนิดของข้อผิดพลาดที่อาจเกิดขึ้น รวมถึงเงื่อนไขที่จะทำให้เกิดข้อผิดพลาดเหล่านั้น จะมีประโยชน์อย่างยิ่งต่อผู้เรียกใช้งาน เพื่อให้พวกเขาสามารถเขียนโค้ดจัดการข้อผิดพลาดแต่ละรูปแบบได้อย่างถูกต้อง - Safety: หากฟังก์ชันนั้นเป็นฟังก์ชันแบบ
unsafe(ซึ่งเราจะได้เรียนรู้เรื่อง unsafe ในบทที่ 20) ควรอธิบายเหตุผลว่าทำไมฟังก์ชันจึงไม่ปลอดภัย พร้อมระบุเงื่อนไขคงที่ (invariants) ที่ผู้เรียกใช้งานจำเป็นต้องรักษาความถูกต้องไว้
คอมเมนต์เอกสารประกอบส่วนใหญ่ไม่จำเป็นต้องมีหัวข้อเหล่านี้ทั้งหมด แต่นี่เป็นเช็กลิสต์ที่ดีเพื่อเตือนให้คุณคำนึงถึงแง่มุมต่างๆ ของโค้ดที่ผู้ใช้งานจะสนใจอยากรู้
คอมเมนต์เอกสารประกอบในฐานะเทสต์
การเพิ่มบล็อกโค้ดตัวอย่างลงในคอมเมนต์เอกสารประกอบไม่เพียงแต่ช่วยสาธิตวิธีใช้งานไลบรารีของคุณเท่านั้น แต่ยังมีโบนัสพิเศษอีกด้วย: นั่นคือการรัน cargo test จะนำตัวอย่างโค้ดในเอกสารประกอบของคุณไปรันเป็นเทสต์ให้โดยอัตโนมัติ! ไม่มีสิ่งใดดีไปกว่าเอกสารประกอบที่มีตัวอย่างโค้ดประกอบ แต่ก็ไม่มีสิ่งใดแย่ไปกว่าตัวอย่างโค้ดที่ใช้งานไม่ได้จริงเพราะโค้ดหลักถูกแก้ไขไปแล้วหลังจากเขียนเอกสารประกอบ หากเรารัน cargo test กับเอกสารประกอบของฟังก์ชัน add_one จากลิสติ้ง 14-1 เราจะเห็นส่วนผลลัพธ์การทดสอบดังนี้:
Doc-tests my_crate
running 1 test
test src/lib.rs - add_one (line 5) ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.27s
ทีนี้ หากเราลองแก้ไขฟังก์ชันหรือโค้ดตัวอย่างจนทำให้ assert_eq! ในตัวอย่างเกิดการแพนิก แล้วสั่งรัน cargo test อีกครั้ง เราจะเห็นว่าการทดสอบเอกสารประกอบ (documentation tests หรือ doc-tests) สามารถตรวจจับความไม่สอดคล้องกันระหว่างโค้ดตัวอย่างกับโค้ดจริงได้อย่างแม่นยำ!
คอมเมนต์ของรายการที่ครอบอยู่
รูปแบบคอมเมนต์เอกสารประกอบ //! จะทำหน้าที่เพิ่มคำอธิบายให้กับรายการที่ครอบคอมเมนต์นี้อยู่ แทนที่จะให้กับรายการที่ตามหลังคอมเมนต์ เรามักจะใช้คอมเมนต์รูปแบบนี้ไว้ที่ต้นไฟล์รากของเครต (ตามธรรมเนียมคือ src/lib.rs) หรือภายในมอดูล เพื่อเขียนคำอธิบายภาพรวมของเครตหรือมอดูลนั้นๆ
ตัวอย่างเช่น ในการเพิ่มเอกสารประกอบที่อธิบายจุดประสงค์ของเครต my_crate ที่บรรจุฟังก์ชัน add_one เราเพิ่มคอมเมนต์เอกสารประกอบที่เริ่มต้นด้วย //! ไว้ที่ต้นไฟล์ src/lib.rs ดังที่แสดงในลิสติ้ง 14-2
//! # My Crate
//!
//! `my_crate` is a collection of utilities to make performing certain
//! calculations more convenient.
/// Adds one to the number given.
// --snip--
///
/// # Examples
///
/// ```
/// let arg = 5;
/// let answer = my_crate::add_one(arg);
///
/// assert_eq!(6, answer);
/// ```
pub fn add_one(x: i32) -> i32 {
x + 1
}โปรดสังเกตว่าไม่มีโค้ดใดๆ ต่อจากบรรทัดสุดท้ายที่เริ่มต้นด้วย //! เพราะเราเริ่มคอมเมนต์ด้วย //! แทนที่จะเป็น /// เราจึงกำลังทำเอกสารประกอบให้กับรายการที่บรรจุคอมเมนต์นี้ มากกว่ารายการที่ตามหลังคอมเมนต์นี้ ในกรณีนี้ รายการนั้นคือไฟล์ src/lib.rs ซึ่งเป็นรากของเครต คอมเมนต์เหล่านี้จึงอธิบายภาพรวมของเครตทั้งหมด
เมื่อเรารัน cargo doc --open คอมเมนต์เหล่านี้จะแสดงบนหน้าแรกของเอกสารประกอบสำหรับ my_crate เหนือรายการสาธารณะในเครต ดังที่แสดงในรูปที่ 14-2
คอมเมนต์เอกสารประกอบภายในรายการมีประโยชน์โดยเฉพาะอย่างยิ่งสำหรับการอธิบายเครตและมอดูล ใช้มันเพื่ออธิบายจุดประสงค์โดยรวมของสิ่งที่บรรจุอยู่ เพื่อช่วยให้ผู้ใช้ของคุณเข้าใจการจัดระเบียบของเครต
รูปที่ 14-2: เอกสารประกอบที่เรนเดอร์แล้วสำหรับ my_crate รวมถึงคอมเมนต์ที่อธิบายเครตโดยรวม
การส่งออก API สาธารณะที่สะดวกต่อการใช้งาน
โครงสร้างของ API สาธารณะของคุณเป็นข้อพิจารณาสำคัญเมื่อเผยแพร่เครต ผู้ที่ใช้เครตของคุณคุ้นเคยกับโครงสร้างน้อยกว่าคุณ และอาจมีปัญหาในการค้นหาส่วนที่พวกเขาต้องการใช้หากเครตของคุณมีลำดับชั้นของมอดูลขนาดใหญ่
ในบทที่ 7 เราได้เรียนรู้วิธีเปิดให้ไอเทมเป็นสาธารณะด้วยคำสงวน pub และวิธีนำไอเทมเข้าสู่สโคปด้วยคำสงวน use ไปแล้ว อย่างไรก็ตาม โครงสร้างที่สมเหตุสมผลสำหรับคุณขณะพัฒนาเครตอาจไม่สะดวกมากนักสำหรับผู้ใช้ของคุณ คุณอาจต้องการจัดระเบียบ struct ของคุณในลำดับชั้นที่มีหลายระดับ แต่แล้วผู้ที่ต้องการใช้ชนิดข้อมูลที่คุณนิยามไว้ลึกในลำดับชั้นนั้นอาจมีปัญหาในการค้นพบว่าชนิดข้อมูลนั้นมีอยู่ พวกเขาอาจหงุดหงิดที่ต้องพิมพ์ use my_crate::some_module::another_module::UsefulType; แทนที่จะเป็น use my_crate::UsefulType;
ข่าวดีก็คือ หากโครงสร้างนั้น_ไม่_สะดวกสำหรับผู้อื่นในการใช้จากไลบรารีอื่น คุณไม่จำเป็นต้องจัดเรียงโครงสร้างภายในของคุณใหม่: แต่คุณสามารถส่งออกรายการซ้ำ (re-export) เพื่อสร้างโครงสร้างสาธารณะที่แตกต่างจากโครงสร้างส่วนตัวของคุณได้โดยใช้ pub use การส่งออกซ้ำ (re-exporting) จะนำรายการสาธารณะจากตำแหน่งหนึ่งมาเปิดเผยเป็นสาธารณะในอีกตำแหน่งหนึ่ง ราวกับว่ามันถูกนิยามไว้ในตำแหน่งใหม่นั้นโดยตรง
ตัวอย่างเช่น สมมติว่าเราสร้างไลบรารีชื่อ art สำหรับจำลองแนวคิดทางศิลปะ ภายในไลบรารีนี้มีสองมอดูล: มอดูล kinds ที่บรรจุ enum สองตัวชื่อ PrimaryColor และ SecondaryColor และมอดูล utils ที่บรรจุฟังก์ชันชื่อ mix ดังที่แสดงในลิสติ้ง 14-3
//! # Art
//!
//! A library for modeling artistic concepts.
pub mod kinds {
/// The primary colors according to the RYB color model.
pub enum PrimaryColor {
Red,
Yellow,
Blue,
}
/// The secondary colors according to the RYB color model.
pub enum SecondaryColor {
Orange,
Green,
Purple,
}
}
pub mod utils {
use crate::kinds::*;
/// Combines two primary colors in equal amounts to create
/// a secondary color.
pub fn mix(c1: PrimaryColor, c2: PrimaryColor) -> SecondaryColor {
// --snip--
unimplemented!();
}
}รูปที่ 14-3 แสดงว่าหน้าแรกของเอกสารประกอบสำหรับเครตนี้ที่สร้างโดย cargo doc จะมีหน้าตาอย่างไร
รูปที่ 14-3: หน้าแรกของเอกสารประกอบสำหรับ art ที่แสดงรายการมอดูล kinds และ utils
โปรดสังเกตว่าชนิด PrimaryColor และ SecondaryColor ไม่ได้แสดงอยู่ในหน้าแรก และฟังก์ชัน mix ก็เช่นกัน เราต้องคลิก kinds และ utils เพื่อดูมัน
เครตอื่นที่พึ่งพาไลบรารีนี้จะต้องมีคำสั่ง use ที่นำรายการจาก art เข้าสู่สโคป โดยระบุโครงสร้างมอดูลที่ถูกนิยามอยู่ในปัจจุบัน ลิสติ้ง 14-4 แสดงตัวอย่างของเครตที่ใช้รายการ PrimaryColor และ mix จากเครต art
use art::kinds::PrimaryColor;
use art::utils::mix;
fn main() {
let red = PrimaryColor::Red;
let yellow = PrimaryColor::Yellow;
mix(red, yellow);
}ผู้เขียนโค้ดในลิสติ้ง 14-4 ซึ่งใช้เครต art ต้องค้นหาให้ได้ว่า PrimaryColor อยู่ในมอดูล kinds และ mix อยู่ในมอดูล utils โครงสร้างมอดูลของเครต art เกี่ยวข้องกับนักพัฒนาที่ทำงานกับเครต art มากกว่าผู้ที่ใช้มัน โครงสร้างภายในไม่มีข้อมูลที่มีประโยชน์สำหรับผู้ที่พยายามเข้าใจวิธีใช้เครต art แต่กลับก่อความสับสน เพราะนักพัฒนาที่ใช้มันต้องค้นหาว่าควรมองตรงไหน และต้องระบุชื่อมอดูลในคำสั่ง use
เพื่อขจัดการจัดระเบียบภายในออกจาก API สาธารณะ เราสามารถแก้ไขโค้ดเครต art ในลิสติ้ง 14-3 เพื่อเพิ่มคำสั่ง pub use ที่ส่งออกรายการอีกครั้งที่ระดับบนสุด ดังที่แสดงในลิสติ้ง 14-5
//! # Art
//!
//! A library for modeling artistic concepts.
pub use self::kinds::PrimaryColor;
pub use self::kinds::SecondaryColor;
pub use self::utils::mix;
pub mod kinds {
// --snip--
/// The primary colors according to the RYB color model.
pub enum PrimaryColor {
Red,
Yellow,
Blue,
}
/// The secondary colors according to the RYB color model.
pub enum SecondaryColor {
Orange,
Green,
Purple,
}
}
pub mod utils {
// --snip--
use crate::kinds::*;
/// Combines two primary colors in equal amounts to create
/// a secondary color.
pub fn mix(c1: PrimaryColor, c2: PrimaryColor) -> SecondaryColor {
SecondaryColor::Orange
}
}เอกสาร API ที่ cargo doc สร้างให้กับเครตนี้จะแสดงรายการและลิงก์การส่งออกอีกครั้งบนหน้าแรก ดังที่แสดงในรูปที่ 14-4 ทำให้ชนิด PrimaryColor และ SecondaryColor กับฟังก์ชัน mix ค้นหาได้ง่ายขึ้น
รูปที่ 14-4: หน้าแรกของเอกสารประกอบสำหรับ art ที่แสดงรายการการส่งออกอีกครั้ง
ผู้ใช้เครต art ยังคงเห็นและใช้โครงสร้างภายในจากลิสติ้ง 14-3 ได้ ดังที่สาธิตในลิสติ้ง 14-4 หรือพวกเขาจะใช้โครงสร้างที่สะดวกกว่าในลิสติ้ง 14-5 ก็ได้ ดังที่แสดงในลิสติ้ง 14-6
use art::PrimaryColor;
use art::mix;
fn main() {
// --snip--
let red = PrimaryColor::Red;
let yellow = PrimaryColor::Yellow;
mix(red, yellow);
}ในกรณีที่มีมอดูลซ้อนกันหลายชั้น การส่งออกรายการอีกครั้งที่ระดับบนสุดด้วย pub use สามารถสร้างความแตกต่างอย่างมีนัยสำคัญต่อประสบการณ์ของผู้ใช้เครต การใช้งาน pub use ที่พบบ่อยอีกอย่างคือการส่งออกนิยามของดีเพนเดนซีในเครตปัจจุบันอีกครั้ง เพื่อทำให้คำนิยามของเครตนั้นกลายเป็นส่วนหนึ่งของ API สาธารณะของเครตคุณ
การสร้างโครงสร้าง API สาธารณะที่มีประโยชน์เป็นศิลปะมากกว่าศาสตร์ และคุณสามารถวนปรับปรุงเพื่อค้นหา API ที่เหมาะกับผู้ใช้ของคุณที่สุดได้ การเลือกใช้ pub use ให้ความยืดหยุ่นกับคุณในวิธีจัดโครงสร้างเครตของคุณภายใน และแยกโครงสร้างภายในนั้นออกจากสิ่งที่คุณนำเสนอต่อผู้ใช้ของคุณ ลองดูโค้ดบางส่วนของเครตที่คุณได้ติดตั้ง เพื่อดูว่าโครงสร้างภายในของพวกมันแตกต่างจาก API สาธารณะหรือไม่
การตั้งค่าบัญชี Crates.io
ก่อนที่คุณจะเผยแพร่เครตใดๆ ได้ คุณต้องสร้างบัญชีบน crates.io และรับโทเค็น API ในการทำเช่นนั้น โปรดไปที่หน้าแรกที่ crates.io และลงชื่อเข้าใช้ผ่านบัญชี GitHub (ปัจจุบันบัญชี GitHub เป็นข้อกำหนด แต่เว็บไซต์อาจรองรับวิธีอื่นในการสร้างบัญชีในอนาคต) เมื่อคุณลงชื่อเข้าใช้แล้ว โปรดไปที่การตั้งค่าบัญชีของคุณที่ https://crates.io/me/ และสร้างคีย์ API ของคุณ จากนั้นรันคำสั่ง cargo login แล้ววางคีย์ API ของคุณเมื่อถูกร้องขอ เช่นนี้:
$ cargo login
abcdefghijklmnopqrstuvwxyz012345
คำสั่งนี้จะแจ้งโทเค็น API ของคุณให้ Cargo ทราบและจัดเก็บไว้ในเครื่องที่ ~/.cargo/credentials.toml โปรดสังเกตว่าโทเค็นนี้เป็นความลับ: อย่าแชร์มันกับใครอื่น หากคุณแชร์มันกับใครด้วยเหตุผลใดก็ตาม คุณควรเพิกถอนมันและสร้างโทเค็นใหม่บน crates.io ทันที
การเพิ่มเมทาดาทาให้เครตใหม่
สมมติว่าคุณมีเครตที่คุณต้องการเผยแพร่ ก่อนการเผยแพร่ คุณจะต้องเพิ่มข้อมูลเมทาดาทาบางอย่างในส่วน [package] ของไฟล์ Cargo.toml ของเครต
เครตของคุณจะต้องมีชื่อที่ไม่ซ้ำใคร ในขณะที่คุณทำงานกับเครตในเครื่อง คุณจะตั้งชื่อเครตอะไรก็ได้ตามใจ แต่ชื่อเครตบน crates.io ถูกจัดสรรตามหลักมาก่อนได้ก่อน เมื่อชื่อเครตถูกใช้ไปแล้ว ไม่มีใครอื่นสามารถเผยแพร่เครตด้วยชื่อนั้นได้ ก่อนพยายามเผยแพร่เครต โปรดค้นหาชื่อที่คุณต้องการใช้ หากชื่อนั้นถูกใช้ไปแล้ว คุณจะต้องหาชื่ออื่นและแก้ไขฟิลด์ name ในไฟล์ Cargo.toml ใต้ส่วน [package] เพื่อใช้ชื่อใหม่ในการเผยแพร่ เช่นนี้:
ชื่อไฟล์: Cargo.toml
[package]
name = "guessing_game"
แม้ว่าคุณจะเลือกชื่อที่ไม่ซ้ำใครแล้ว เมื่อคุณรัน cargo publish เพื่อเผยแพร่เครต ณ จุดนี้ คุณจะได้คำเตือน (warning) แล้วจึงได้ข้อผิดพลาด:
$ cargo publish
Updating crates.io index
warning: manifest has no description, license, license-file, documentation, homepage or repository.
See https://doc.rust-lang.org/cargo/reference/manifest.html#package-metadata for more info.
--snip--
error: failed to publish to registry at https://crates.io
Caused by:
the remote server responded with an error (status 400 Bad Request): missing or empty metadata fields: description, license. Please see https://doc.rust-lang.org/cargo/reference/manifest.html for more information on configuring these fields
สิ่งนี้นำไปสู่ข้อผิดพลาดเพราะคุณขาดข้อมูลสำคัญบางอย่าง: คำอธิบายและสัญญาอนุญาตเป็นสิ่งที่จำเป็น เพื่อให้ผู้คนรู้ว่าเครตของคุณทำอะไรและใช้มันได้ภายใต้เงื่อนไขใด ใน Cargo.toml ให้เพิ่มคำอธิบายสักหนึ่งหรือสองประโยค เพราะมันจะปรากฏพร้อมกับเครตของคุณในผลการค้นหา สำหรับฟิลด์ license คุณต้องระบุ_รหัสระบุสัญญาอนุญาต_ Linux Foundation’s Software Package Data Exchange (SPDX) แสดงรายการรหัสที่คุณใช้เป็นค่านี้ได้ ตัวอย่างเช่น หากต้องการระบุว่าคุณได้ให้สัญญาอนุญาตเครตของคุณภายใต้ MIT License ให้เพิ่มรหัส MIT:
ชื่อไฟล์: Cargo.toml
[package]
name = "guessing_game"
license = "MIT"
หากคุณต้องการใช้สัญญาอนุญาตที่ไม่มีอยู่ใน SPDX คุณต้องวางข้อความของสัญญาอนุญาตนั้นไว้ในไฟล์ รวมไฟล์นั้นไว้ในโปรเจกต์ของคุณ แล้วใช้ license-file เพื่อระบุชื่อไฟล์นั้นแทนการใช้คีย์ license
คำแนะนำว่าสัญญาอนุญาตใดเหมาะสมกับโปรเจกต์ของคุณนั้นอยู่นอกขอบเขตของหนังสือเล่มนี้ ผู้คนจำนวนมากในชุมชน Rust ให้สัญญาอนุญาตโปรเจกต์ของพวกเขาในแบบเดียวกับ Rust โดยใช้สัญญาอนุญาตคู่แบบ MIT OR Apache-2.0 แนวปฏิบัตินี้แสดงให้เห็นว่าคุณยังสามารถระบุรหัสสัญญาอนุญาตหลายตัวคั่นด้วย OR เพื่อให้โปรเจกต์ของคุณมีสัญญาอนุญาตหลายแบบได้
เมื่อมีชื่อที่ไม่ซ้ำใคร เวอร์ชัน คำอธิบาย และสัญญาอนุญาตแล้ว ไฟล์ Cargo.toml สำหรับโปรเจกต์ที่พร้อมเผยแพร่อาจมีหน้าตาดังนี้:
ชื่อไฟล์: Cargo.toml
[package]
name = "guessing_game"
version = "0.1.0"
edition = "2024"
description = "A fun game where you guess what number the computer has chosen."
license = "MIT OR Apache-2.0"
[dependencies]
เอกสารของ Cargo อธิบายเมทาดาทาอื่นๆ ที่คุณสามารถระบุได้ เพื่อทำให้แน่ใจว่าผู้อื่นสามารถค้นพบและใช้เครตของคุณได้ง่ายขึ้น
การเผยแพร่ไปยัง Crates.io
ตอนนี้คุณได้สร้างบัญชี จัดเก็บโทเค็น API เลือกชื่อให้เครต และระบุเมทาดาทาที่จำเป็นแล้ว คุณพร้อมที่จะเผยแพร่! การเผยแพร่เครตจะอัปโหลดเวอร์ชันที่เจาะจงไปยัง crates.io เพื่อให้ผู้อื่นใช้งานได้
โปรดระวัง เพราะการเผยแพร่เป็นสิ่งที่_ถาวร_ เวอร์ชันไม่สามารถถูกเขียนทับได้เลย และโค้ดไม่สามารถลบได้ยกเว้นในสถานการณ์บางอย่าง เป้าหมายสำคัญประการหนึ่งของ Crates.io คือการทำหน้าที่เป็นคลังเก็บโค้ดถาวร เพื่อให้การบิลด์ของทุกโปรเจกต์ที่พึ่งพาเครตจาก crates.io ยังคงทำงานได้ การอนุญาตให้ลบเวอร์ชันจะทำให้การบรรลุเป้าหมายนั้นเป็นไปไม่ได้ อย่างไรก็ตาม ไม่มีขีดจำกัดจำนวนเวอร์ชันของเครตที่คุณเผยแพร่ได้
รันคำสั่ง cargo publish อีกครั้ง ตอนนี้มันควรสำเร็จ:
$ cargo publish
Updating crates.io index
Packaging guessing_game v0.1.0 (file:///projects/guessing_game)
Packaged 6 files, 1.2KiB (895.0B compressed)
Verifying guessing_game v0.1.0 (file:///projects/guessing_game)
Compiling guessing_game v0.1.0
(file:///projects/guessing_game/target/package/guessing_game-0.1.0)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.19s
Uploading guessing_game v0.1.0 (file:///projects/guessing_game)
Uploaded guessing_game v0.1.0 to registry `crates-io`
note: waiting for `guessing_game v0.1.0` to be available at registry
`crates-io`.
You may press ctrl-c to skip waiting; the crate should be available shortly.
Published guessing_game v0.1.0 at registry `crates-io`
ยินดีด้วย! ตอนนี้คุณได้แบ่งปันโค้ดของคุณกับชุมชน Rust แล้ว และใครก็สามารถเพิ่มเครตของคุณเป็นดีเพนเดนซีของโปรเจกต์ของพวกเขาได้อย่างง่ายดาย
การเผยแพร่เวอร์ชันใหม่ของเครตที่มีอยู่
เมื่อคุณได้ทำการเปลี่ยนแปลงเครตของคุณและพร้อมที่จะปล่อยเวอร์ชันใหม่ คุณจะเปลี่ยนค่า version ที่ระบุในไฟล์ Cargo.toml ของคุณและเผยแพร่ใหม่ ใช้กฎการกำหนดเวอร์ชันเชิงความหมาย (semantic versioning) ในการตัดสินว่าเลขเวอร์ชันถัดไปที่เหมาะสมคืออะไร โดยอิงจากชนิดของการเปลี่ยนแปลงที่คุณได้ทำ จากนั้นรัน cargo publish เพื่ออัปโหลดเวอร์ชันใหม่
การเลิกใช้เวอร์ชันจาก Crates.io
แม้ว่าคุณจะลบเวอร์ชันก่อนหน้าของเครตไม่ได้ แต่คุณสามารถป้องกันไม่ให้โปรเจกต์ในอนาคตเพิ่มมันเป็นดีเพนเดนซีใหม่ได้ สิ่งนี้มีประโยชน์เมื่อเวอร์ชันของเครตเสียด้วยเหตุผลใดเหตุผลหนึ่ง ในสถานการณ์เช่นนี้ Cargo รองรับการถอน (yanking) เวอร์ชันของเครต
การถอน (yanking) เวอร์ชันหนึ่งป้องกันไม่ให้โปรเจกต์ใหม่พึ่งพาเวอร์ชันนั้น ขณะที่อนุญาตให้โปรเจกต์ที่มีอยู่ทั้งหมดซึ่งพึ่งพามันทำงานต่อไปได้ โดยพื้นฐานแล้ว การถอนหมายความว่าโปรเจกต์ทั้งหมดที่มี Cargo.lock จะไม่พัง และไฟล์ Cargo.lock ใหม่ใดๆ ที่ถูกสร้างขึ้นในอนาคตจะไม่ใช้เวอร์ชันที่ถูกถอน
ในการถอนเวอร์ชันของเครต ในไดเรกทอรีของเครตที่คุณได้เผยแพร่ไว้ก่อนหน้านี้ ให้รัน cargo yank และระบุว่าเวอร์ชันใดที่คุณต้องการถอน ตัวอย่างเช่น หากเราได้เผยแพร่เครตชื่อ guessing_game เวอร์ชัน 1.0.1 และเราต้องการถอนมัน เราจะรันคำสั่งต่อไปนี้ในไดเรกทอรีโปรเจกต์ของ guessing_game:
$ cargo yank --vers 1.0.1
Updating crates.io index
Yank guessing_game@1.0.1
ด้วยการเพิ่ม --undo ต่อท้ายคำสั่ง คุณยังสามารถย้อนกลับการถอนและอนุญาตให้โปรเจกต์เริ่มพึ่งพาเวอร์ชันนั้นได้อีกครั้ง:
$ cargo yank --vers 1.0.1 --undo
Updating crates.io index
Unyank guessing_game@1.0.1
การถอน_ไม่ได้_ลบโค้ดใดๆ ตัวอย่างเช่น มันไม่สามารถลบความลับที่ถูกอัปโหลดไปโดยไม่ตั้งใจได้ หากสิ่งนั้นเกิดขึ้น คุณต้องรีเซ็ตความลับเหล่านั้นทันที
เวิร์กสเปซของ Cargo
เวิร์กสเปซของ Cargo
ในบทที่ 12 เราได้สร้างแพ็กเกจที่ประกอบด้วยเครตไบนารีและเครตไลบรารี เมื่อโปรเจกต์ของคุณเติบโตขึ้น คุณอาจพบว่าเครตไลบรารีเริ่มมีขนาดใหญ่ขึ้นเรื่อย ๆ จนคุณต้องการแยกแพ็กเกจออกเป็นเครตไลบรารีหลายตัว Cargo มีฟีเจอร์ที่เรียกว่า_เวิร์กสเปซ (workspaces)_ ซึ่งช่วยจัดการแพ็กเกจที่เกี่ยวข้องกันหลายแพ็กเกจและพัฒนาควบคู่กันไปได้
การสร้างเวิร์กสเปซ
เวิร์กสเปซ (workspace) คือชุดของแพ็กเกจที่แชร์ไฟล์ Cargo.lock และไดเรกทอรีเอาต์พุตเดียวกัน มาสร้างโปรเจกต์ที่ใช้เวิร์กสเปซกัน โดยเราจะใช้โค้ดตัวอย่างแบบเรียบง่าย เพื่อให้โฟกัสที่โครงสร้างของเวิร์กสเปซได้อย่างเต็มที่ การจัดโครงสร้างเวิร์กสเปซมีได้หลายวิธี ในที่นี้เราจะแสดงวิธีหนึ่งที่นิยมใช้กัน เราจะสร้างเวิร์กสเปซที่มีไบนารีหนึ่งตัวและไลบรารีสองตัว โดยไบนารีซึ่งทำหน้าที่หลักจะพึ่งพาไลบรารีทั้งสอง ตัวหนึ่งมีฟังก์ชัน add_one และอีกตัวมีฟังก์ชัน add_two เครตทั้งสามตัวนี้จะอยู่ร่วมกันในเวิร์กสเปซเดียวกัน เราจะเริ่มด้วยการสร้างไดเรกทอรีใหม่สำหรับเวิร์กสเปซ:
$ mkdir add
$ cd add
ถัดมา ในไดเรกทอรี add เราจะสร้างไฟล์ Cargo.toml เพื่อกำหนดค่าให้กับทั้งเวิร์กสเปซ ไฟล์นี้จะไม่มีเซกชัน [package] แต่จะเริ่มต้นด้วยเซกชัน [workspace] ซึ่งช่วยให้เราเพิ่มสมาชิก (members) เข้ามาในเวิร์กสเปซได้ นอกจากนี้เรายังเลือกใช้อัลกอริทึม resolver เวอร์ชันล่าสุดของ Cargo ในเวิร์กสเปซของเรา โดยกำหนดค่า resolver เป็น "3":
ชื่อไฟล์: Cargo.toml
[workspace]
resolver = "3"
จากนั้น เราจะสร้างเครตไบนารี adder โดยรัน cargo new ภายในไดเรกทอรี add:
$ cargo new adder
Created binary (application) `adder` package
Adding `adder` as member of workspace at `file:///projects/add`
การรัน cargo new ภายในเวิร์กสเปซจะเพิ่มแพ็กเกจที่เพิ่งสร้างใหม่เข้าไปในคีย์ members ของนิยาม [workspace] ในไฟล์ Cargo.toml ของเวิร์กสเปซให้โดยอัตโนมัติ ดังนี้:
[workspace]
resolver = "3"
members = ["adder"]
ณ จุดนี้ เราสามารถบิลด์เวิร์กสเปซได้โดยรัน cargo build โดยโครงสร้างไฟล์ในไดเรกทอรี add ของคุณควรมีหน้าตาดังนี้:
├── Cargo.lock
├── Cargo.toml
├── adder
│ ├── Cargo.toml
│ └── src
│ └── main.rs
└── target
เวิร์กสเปซจะมีไดเรกทอรี target เพียงแห่งเดียวอยู่ที่ระดับบนสุดสำหรับเก็บอาร์ติแฟกต์ที่คอมไพล์แล้ว โดยแพ็กเกจ adder จะไม่มีไดเรกทอรี target เป็นของตัวเอง และแม้ว่าเราจะรัน cargo build จากภายในไดเรกทอรี adder อาร์ติแฟกต์ที่คอมไพล์แล้วก็ยังคงถูกวางไว้ใน add/target ไม่ใช่ add/adder/target ที่ Cargo จัดโครงสร้างไดเรกทอรี target ในเวิร์กสเปซเช่นนี้ ก็เพราะเครตต่าง ๆ ในเวิร์กสเปซถูกออกแบบมาให้พึ่งพากันเอง หากแต่ละเครตมีไดเรกทอรี target แยกเป็นของตัวเอง แต่ละเครตก็จะต้องคอมไพล์เครตอื่น ๆ ในเวิร์กสเปซซ้ำใหม่เพื่อนำอาร์ติแฟกต์มาไว้ในไดเรกทอรี target ของตนเอง การแชร์ไดเรกทอรี target ร่วมกันจึงช่วยหลีกเลี่ยงการคอมไพล์ซ้ำซ้อนโดยไม่จำเป็น
การสร้างแพ็กเกจที่สองในเวิร์กสเปซ
ถัดมา มาสร้างแพ็กเกจสมาชิกอีกตัวในเวิร์กสเปซและตั้งชื่อว่า add_one โดยสร้างเป็นเครตไลบรารีใหม่:
$ cargo new add_one --lib
Created library `add_one` package
Adding `add_one` as member of workspace at `file:///projects/add`
ตอนนี้ไฟล์ Cargo.toml ระดับบนสุดจะรวมพาธ add_one ไว้ในรายการ members เรียบร้อยแล้ว:
ชื่อไฟล์: Cargo.toml
[workspace]
resolver = "3"
members = ["adder", "add_one"]
ไดเรกทอรี add ของคุณตอนนี้ควรมีไดเรกทอรีและไฟล์ดังต่อไปนี้:
├── Cargo.lock
├── Cargo.toml
├── add_one
│ ├── Cargo.toml
│ └── src
│ └── lib.rs
├── adder
│ ├── Cargo.toml
│ └── src
│ └── main.rs
└── target
ในไฟล์ add_one/src/lib.rs เราจะเพิ่มฟังก์ชัน add_one ดังนี้:
ชื่อไฟล์: add_one/src/lib.rs
pub fn add_one(x: i32) -> i32 {
x + 1
}ตอนนี้เราสามารถกำหนดให้แพ็กเกจ adder ซึ่งเป็นไบนารี พึ่งพาแพ็กเกจ add_one ซึ่งเป็นไลบรารีของเราได้แล้ว ก่อนอื่นเราต้องเพิ่มดีเพนเดนซีแบบพาธ (path dependency) ไปยัง add_one ในไฟล์ adder/Cargo.toml
ชื่อไฟล์: adder/Cargo.toml
[dependencies]
add_one = { path = "../add_one" }
เนื่องจาก Cargo จะไม่ทึกทักเอาเองว่าเครตในเวิร์กสเปซจะพึ่งพากันเอง เราจึงต้องระบุความสัมพันธ์ของดีเพนเดนซีให้ชัดเจนเสมอ
ถัดไป มาลองเรียกใช้ฟังก์ชัน add_one (จากเครต add_one) ในเครต adder กัน ให้เปิดไฟล์ adder/src/main.rs แล้วแก้ไขฟังก์ชัน main ให้เรียกใช้ฟังก์ชัน add_one ดังที่แสดงในลิสติ้ง 14-7
fn main() {
let num = 10;
println!("Hello, world! {num} plus one is {}!", add_one::add_one(num));
}มาลองบิลด์เวิร์กสเปซกันโดยรัน cargo build ในไดเรกทอรี add ระดับบนสุด!
$ cargo build
Compiling add_one v0.1.0 (file:///projects/add/add_one)
Compiling adder v0.1.0 (file:///projects/add/adder)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.22s
ในการรันเครตไบนารีจากไดเรกทอรี add เราสามารถระบุแพ็กเกจในเวิร์กสเปซที่ต้องการรันได้ โดยส่งอาร์กิวเมนต์ -p พร้อมกับชื่อแพ็กเกจให้กับ cargo run:
$ cargo run -p adder
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.00s
Running `target/debug/adder`
Hello, world! 10 plus one is 11!
คำสั่งนี้จะรันโค้ดใน adder/src/main.rs ซึ่งพึ่งพาเครต add_one
การพึ่งพาแพ็กเกจภายนอก
โปรดสังเกตว่าเวิร์กสเปซจะมีไฟล์ Cargo.lock เพียงไฟล์เดียวอยู่ที่ระดับบนสุด แทนที่จะมีไฟล์ Cargo.lock แยกในไดเรกทอรีของแต่ละเครต จุดนี้ช่วยรับประกันว่าเครตทั้งหมดจะใช้เวอร์ชันเดียวกันของทุกดีเพนเดนซี หากเราเพิ่มแพ็กเกจ rand ลงในไฟล์ adder/Cargo.toml และ add_one/Cargo.toml ทาง Cargo จะรีโซล์ฟ (resolve) ทั้งคู่ให้เป็นเวอร์ชันเดียวกันของ rand และบันทึกไว้ใน Cargo.lock เพียงไฟล์เดียว การที่เครตทุกตัวในเวิร์กสเปซใช้ดีเพนเดนซีร่วมกันเช่นนี้ทำให้มั่นใจได้ว่าเครตต่าง ๆ จะทำงานร่วมกันได้อย่างราบรื่นเสมอ มาลองเพิ่มเครต rand ลงในเซกชัน [dependencies] ของไฟล์ add_one/Cargo.toml เพื่อให้เราเรียกใช้ rand ในเครต add_one ได้:
ชื่อไฟล์: add_one/Cargo.toml
[dependencies]
rand = "0.10.1"
ตอนนี้เราสามารถเพิ่ม use rand; ลงในไฟล์ add_one/src/lib.rs ได้ และเมื่อบิลด์ทั้งเวิร์กสเปซด้วยคำสั่ง cargo build ในไดเรกทอรี add Cargo ก็จะดาวน์โหลดและคอมไพล์เครต rand เข้ามา เราจะเห็นคำเตือนหนึ่งข้อความเนื่องจากเรายังไม่ได้อ้างอิงถึง rand ที่เรานำเข้าสู่สโคป:
$ cargo build
Updating crates.io index
Downloaded rand v0.10.1
--snip--
Compiling rand v0.10.1
Compiling add_one v0.1.0 (file:///projects/add/add_one)
warning: unused import: `rand`
--> add_one/src/lib.rs:1:5
|
1 | use rand;
| ^^^^
|
= note: `#[warn(unused_imports)]` (part of `#[warn(unused)]`) on by default
warning: `add_one` (lib) generated 1 warning (run `cargo fix --lib -p add_one` to apply 1 suggestion)
Compiling adder v0.1.0 (file:///projects/add/adder)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.95s
ตอนนี้ไฟล์ Cargo.lock ระดับบนสุดจะมีข้อมูลที่ดีเพนเดนซี add_one พึ่งพา rand บันทึกไว้เรียบร้อยแล้ว อย่างไรก็ตาม แม้ว่า rand จะถูกนำมาใช้ที่จุดใดจุดหนึ่งในเวิร์กสเปซแล้ว แต่เราก็ยังไม่สามารถเรียกใช้มันในเครตอื่น ๆ ของเวิร์กสเปซได้ เว้นแต่เราจะเพิ่ม rand ลงในไฟล์ Cargo.toml ของเครตนั้น ๆ ด้วยเช่นกัน ตัวอย่างเช่น หากเราเพิ่ม use rand; ลงในไฟล์ adder/src/main.rs ของแพ็กเกจ adder เราจะพบกับข้อผิดพลาด:
$ cargo build
--snip--
Compiling adder v0.1.0 (file:///projects/add/adder)
error[E0432]: unresolved import `rand`
--> adder/src/main.rs:2:5
|
2 | use rand;
| ^^^^ no external crate `rand`
ในการแก้ไขปัญหานี้ ให้แก้ไขไฟล์ Cargo.toml ของแพ็กเกจ adder เพื่อระบุว่า rand เป็นหนึ่งในดีเพนเดนซีของมันด้วย การบิลด์แพ็กเกจ adder จะเพิ่ม rand เข้าไปในรายการดีเพนเดนซีของ adder ใน Cargo.lock โดยจะไม่มีการดาวน์โหลดชุดโค้ดของ rand ซ้ำซ้อนอีก Cargo จะคอยดูแลให้ทุกเครตในทุกแพ็กเกจของเวิร์กสเปซที่ใช้แพ็กเกจ rand ได้ใช้เวอร์ชันเดียวกัน ตราบใดที่พวกมันระบุเวอร์ชันที่เข้ากันได้ ซึ่งช่วยประหยัดพื้นที่จัดเก็บและรับประกันว่าเครตต่าง ๆ ภายในเวิร์กสเปซจะเข้ากันได้เสมอ
หากเครตต่าง ๆ ในเวิร์กสเปซระบุเวอร์ชันที่ไม่สามารถเข้ากันได้ของดีเพนเดนซีตัวเดียวกัน Cargo จะรีโซล์ฟเวอร์ชันของแต่ละตัวแยกกัน แต่ก็จะพยายามรีโซล์ฟให้มีจำนวนเวอร์ชันน้อยที่สุดเท่าที่จะเป็นไปได้
การเพิ่มเทสต์ให้เวิร์กสเปซ
เพื่อเพิ่มประสิทธิภาพและความสมบูรณ์อีกขั้น มาลองเพิ่มเทสต์สำหรับฟังก์ชัน add_one::add_one ภายในเครต add_one กัน:
ชื่อไฟล์: add_one/src/lib.rs
pub fn add_one(x: i32) -> i32 {
x + 1
}
#[cfg(test)]
mod tests {
use super::*;
#[test]
fn it_works() {
assert_eq!(3, add_one(2));
}
}คราวนี้ลองรัน cargo test ในไดเรกทอรี add ระดับบนสุด การรัน cargo test ในเวิร์กสเปซที่มีโครงสร้างเช่นนี้จะดำเนินการรันเทสต์ของทุกเครตในเวิร์กสเปซ:
$ cargo test
Compiling add_one v0.1.0 (file:///projects/add/add_one)
Compiling adder v0.1.0 (file:///projects/add/adder)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.20s
Running unittests src/lib.rs (target/debug/deps/add_one-93c49ee75dc46543)
running 1 test
test tests::it_works ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Running unittests src/main.rs (target/debug/deps/adder-3a47283c568d2b6a)
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests add_one
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
เอาต์พุตส่วนแรกแสดงว่าเทสต์ it_works ในเครต add_one ผ่าน ส่วนถัดมาแสดงว่าไม่พบเทสต์ใด ๆ ในเครต adder และส่วนสุดท้ายแสดงว่าไม่พบด็อกเทสต์ (doc-test) ใด ๆ ในเครต add_one
นอกจากนี้ เรายังสามารถรันเทสต์เฉพาะเครตที่ต้องการในเวิร์กสเปซจากไดเรกทอรีระดับบนสุดได้ โดยใช้แฟล็ก -p แล้วระบุชื่อเครตที่ต้องการทดสอบ:
$ cargo test -p add_one
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.00s
Running unittests src/lib.rs (target/debug/deps/add_one-93c49ee75dc46543)
running 1 test
test tests::it_works ... ok
test result: ok. 1 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
Doc-tests add_one
running 0 tests
test result: ok. 0 passed; 0 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
เอาต์พุตนี้แสดงให้เห็นว่า cargo test รันเฉพาะเทสต์ของเครต add_one เท่านั้น และไม่ได้รันเทสต์ของเครต adder
หากคุณต้องการเผยแพร่เครตในเวิร์กสเปซไปยัง crates.io แต่ละเครตในเวิร์กสเปซจะต้องถูกเผยแพร่แยกจากกัน และเช่นเดียวกับ cargo test เราสามารถเผยแพร่เฉพาะเครตใดเครตหนึ่งในเวิร์กสเปซได้โดยใช้แฟล็ก -p แล้วตามด้วยชื่อเครตที่ต้องการเผยแพร่
เพื่อเป็นการฝึกฝนเพิ่มเติม ลองเพิ่มเครต add_two เข้ามาในเวิร์กสเปซนี้ด้วยวิธีการเดียวกับเครต add_one ดูสิ!
เมื่อโปรเจกต์ของคุณเริ่มขยายใหญ่ขึ้น ลองพิจารณาใช้เวิร์กสเปซ เพราะจะช่วยให้คุณทำงานกับคอมโพเนนต์ย่อย ๆ ที่เข้าใจง่ายได้ดีกว่าการรวมเป็นโค้ดก้อนใหญ่เพียงก้อนเดียว นอกจากนี้ การรวมเครตไว้ในเวิร์กสเปซเดียวกันยังช่วยให้การประสานงานและจัดการระหว่างเครตต่าง ๆ ทำได้ง่ายขึ้น โดยเฉพาะอย่างยิ่งหากพวกมันมักจะต้องถูกแก้ไขไปพร้อม ๆ กัน
ติดตั้งไบนารีด้วย cargo install
ติดตั้งไบนารีด้วย cargo install
คำสั่ง cargo install ช่วยให้คุณสามารถติดตั้งและเรียกใช้งานเครตไบนารี (binary crate) บนเครื่องของคุณได้ เป้าหมายของคำสั่งนี้ไม่ได้มีไว้เพื่อแทนที่ตัวจัดการแพ็กเกจของระบบปฏิบัติการ แต่มันเป็นวิธีที่สะดวกสบายสำหรับนักพัฒนา Rust ในการติดตั้งเครื่องมือต่าง ๆ ที่มีผู้อื่นแบ่งปันไว้บน crates.io โปรดสังเกตว่าคุณจะสามารถติดตั้งได้เฉพาะแพ็กเกจที่มีเป้าหมายเป็นไบนารี (binary target) เท่านั้น โดย ไบนารีทาร์เก็ต (binary target) คือโปรแกรมที่สามารถรันได้ ซึ่งจะถูกสร้างขึ้นเมื่อเครตมีไฟล์ src/main.rs หรือไฟล์อื่นที่กำหนดไว้ให้เป็นไบนารี ซึ่งต่างจากไลบรารีทาร์เก็ต (library target) ที่ไม่สามารถรันแยกเดี่ยวได้ด้วยตนเอง แต่เหมาะสำหรับการนำไปรวมไว้ในโปรแกรมอื่น ๆ โดยปกติแล้วแต่ละเครตจะมีข้อมูลในไฟล์ README ที่ระบุไว้ชัดเจนว่าเครตนั้นเป็นไลบรารี, มีไบนารีทาร์เก็ต หรือมีทั้งสองอย่าง
ไบนารีทั้งหมดที่ติดตั้งผ่าน cargo install จะถูกเก็บไว้ในโฟลเดอร์ bin ภายใต้ไดเรกทอรีรากของการติดตั้ง (installation root) หากคุณติดตั้ง Rust โดยใช้ rustup.rs และไม่ได้ปรับแต่งการตั้งค่าใด ๆ เป็นพิเศษ ไดเรกทอรีนี้จะอยู่ที่ $HOME/.cargo/bin โปรดตรวจสอบให้แน่ใจว่าไดเรกทอรีดังกล่าวถูกเพิ่มไว้ในตัวแปรสภาพแวดล้อม $PATH ของคุณแล้ว เพื่อให้สามารถเรียกใช้โปรแกรมที่คุณติดตั้งผ่าน cargo install ได้จากทุกที่
ตัวอย่างเช่น ในบทที่ 12 เราได้กล่าวถึงเครื่องมือค้นหาข้อความในไฟล์ที่เขียนด้วย Rust เพื่อเลียนแบบเครื่องมือ grep ซึ่งมีชื่อว่า ripgrep ในการติดตั้ง ripgrep เราสามารถรันคำสั่งต่อไปนี้:
$ cargo install ripgrep
Updating crates.io index
Downloaded ripgrep v14.1.1
Downloaded 1 crate (213.6 KB) in 0.40s
Installing ripgrep v14.1.1
--snip--
Compiling grep v0.3.2
Finished `release` profile [optimized + debuginfo] target(s) in 6.73s
Installing ~/.cargo/bin/rg
Installed package `ripgrep v14.1.1` (executable `rg`)
บรรทัดรองสุดท้ายของเอาต์พุตจะแสดงตำแหน่งและชื่อของไฟล์ไบนารีที่ติดตั้ง ซึ่งในกรณีของ ripgrep ก็คือคำสั่ง rg ตราบใดที่ไดเรกทอรีติดตั้งถูกรวมไว้ใน $PATH ของคุณแล้วตามที่กล่าวไปก่อนหน้านี้ คุณก็สามารถรันคำสั่ง rg --help และเริ่มใช้งานเครื่องมือค้นหาไฟล์ที่รวดเร็วและมีความเป็น Rust ยิ่งกว่าได้ทันที!
ขยายความสามารถของ Cargo ด้วยคำสั่งกำหนดเอง
ขยายความสามารถของ Cargo ด้วยคำสั่งกำหนดเอง
Cargo ได้รับการออกแบบมาเพื่อให้คุณสามารถขยายความสามารถด้วยคำสั่งย่อยใหม่ ๆ ได้โดยไม่จำเป็นต้องแก้ไขตัวโปรแกรม Cargo เลยแม้แต่น้อย หากมีไฟล์ไบนารีใด ๆ ใน $PATH ของคุณที่ตั้งชื่อในรูปแบบ cargo-something คุณก็สามารถเรียกใช้งานมันได้เสมือนเป็นคำสั่งย่อยของ Cargo ด้วยคำสั่ง cargo something คำสั่งกำหนดเองเหล่านี้จะแสดงขึ้นมาในรายการคำสั่งด้วยเมื่อคุณรัน cargo --list ความสามารถในการใช้ cargo install เพื่อติดตั้งส่วนขยายแล้วเรียกใช้งานได้ทันทีราวกับเป็นเครื่องมือที่มีมาในตัวของ Cargo นั้น ถือเป็นข้อได้เปรียบที่ออกแบบมาได้อย่างสะดวกสบายเป็นอย่างยิ่ง!
สรุป
การแบ่งปันโค้ดผ่าน Cargo และ crates.io ถือเป็นหัวใจสำคัญอย่างหนึ่งที่ทำให้ระบบนิเวศของ Rust ทรงพลังและตอบโจทย์งานที่หลากหลาย ไลบรารีมาตรฐานของ Rust มีขนาดกะทัดรัดและเน้นความเสถียร แต่เครตในชุมชนนั้นง่ายต่อการแบ่งปัน นำไปใช้ และพัฒนาต่อยอดได้อย่างรวดเร็วโดยไม่ต้องรอรอบการอัปเดตของตัวภาษาเอง ดังนั้นอย่าลังเลที่จะแบ่งปันโค้ดที่คุณเขียนขึ้นและพบว่ามีประโยชน์ขึ้นสู่ crates.io เพราะมันน่าจะเป็นประโยชน์สำหรับผู้อื่นด้วยเช่นกัน!
สมาร์ตพอยน์เตอร์
พอยน์เตอร์ (pointer) เป็นแนวคิดทั่วไปของตัวแปรที่เก็บแอดเดรส (address) ในหน่วยความจำ โดยแอดเดรสนี้จะอ้างถึง หรือ “ชี้ไปที่” ข้อมูลอื่น ๆ ชนิดของพอยน์เตอร์ที่พบได้บ่อยที่สุดใน Rust ก็คือการอ้างอิงหรือเรเฟอเรนซ์ (reference) ซึ่งคุณได้เรียนรู้ไปแล้วในบทที่ 4 เรเฟอเรนซ์จะใช้สัญลักษณ์ & และทำหน้าที่ยืมค่าที่มันชี้ไป โดยไม่มีความสามารถพิเศษอื่นใดนอกจากการอ้างถึงข้อมูล และไม่มีต้นทุนการทำงานส่วนเกิน (overhead) ใด ๆ
ในทางกลับกัน สมาร์ตพอยน์เตอร์ (smart pointer) คือโครงสร้างข้อมูลที่ทำงานเสมือนเป็นพอยน์เตอร์ แต่มีเมทาดาตา (metadata) และความสามารถเพิ่มเติม แนวคิดของสมาร์ตพอยน์เตอร์ไม่ได้มีเฉพาะใน Rust เท่านั้น แต่มีต้นกำเนิดมาจากภาษา C++ และมีอยู่ในภาษาอื่น ๆ ด้วยเช่นกัน ในไลบรารีมาตรฐานของ Rust มีสมาร์ตพอยน์เตอร์หลากหลายชนิดที่ให้ฟังก์ชันการทำงานเหนือกว่าเรเฟอเรนซ์ทั่วไป เพื่อทำความเข้าใจแนวคิดพื้นฐานนี้ เราจะไปดูตัวอย่างของสมาร์ตพอยน์เตอร์หลาย ๆ แบบ รวมถึงชนิดสมาร์ตพอยน์เตอร์แบบ_นับจำนวนการอ้างอิง (reference counting)_ พอยน์เตอร์ชนิดนี้จะช่วยให้ข้อมูลหนึ่งชิ้นสามารถมีเจ้าของหลายรายพร้อมกันได้ โดยจะคอยนับติดตามจำนวนเจ้าของที่มีอยู่ และเมื่อไม่มีเจ้าของเหลืออยู่แล้ว ก็จะคืนพื้นที่หน่วยความจำและเก็บกวาดข้อมูลนั้นโดยอัตโนมัติ
สำหรับ Rust ด้วยแนวคิดเรื่องความเป็นเจ้าของ (ownership) และการยืม (borrowing) จึงมีความแตกต่างที่ชัดเจนระหว่างเรเฟอเรนซ์กับสมาร์ตพอยน์เตอร์ กล่าวคือ ในขณะที่เรเฟอเรนซ์ทำหน้าที่เพียงแค่ยืมข้อมูล แต่ในหลายกรณี สมาร์ตพอยน์เตอร์จะเป็น_เจ้าของ_ข้อมูลที่มันชี้ไปด้วย
สมาร์ตพอยน์เตอร์มักจะถูกสร้างขึ้นด้วย struct แต่สิ่งที่ต่างจาก struct ทั่วไปคือ สมาร์ตพอยน์เตอร์จะอิมพลีเมนต์เทรต Deref และ Drop โดยเทรต Deref ช่วยให้อินสแตนซ์ของ struct สมาร์ตพอยน์เตอร์ทำงานเสมือนเรเฟอเรนซ์ได้ ทำให้คุณสามารถเขียนโค้ดที่ใช้งานได้ทั้งกับเรเฟอเรนซ์และสมาร์ตพอยน์เตอร์ ส่วนเทรต Drop จะเปิดโอกาสให้คุณกำหนดโค้ดที่ต้องการให้ทำงานโดยอัตโนมัติเมื่ออินสแตนซ์ของสมาร์ตพอยน์เตอร์หลุดออกจากขอบเขต (scope) ในบทนี้ เราจะมาเจาะลึกเทรตทั้งสองนี้และแสดงให้เห็นว่าเหตุใดพวกมันจึงสำคัญต่อสมาร์ตพอยน์เตอร์
เนื่องจากรูปแบบการออกแบบ (design pattern) ของสมาร์ตพอยน์เตอร์เป็นรูปแบบทั่วไปที่ใช้กันบ่อยมากใน Rust บทนี้จึงไม่ได้ครอบคลุมสมาร์ตพอยน์เตอร์ทั้งหมดที่มีอยู่ เพราะไลบรารีภายนอกหลายแห่งต่างก็สร้างสมาร์ตพอยน์เตอร์เป็นของตนเอง และคุณเองก็สามารถสร้างขึ้นมาใช้เองได้เช่นกัน ในบทนี้เราจะเน้นศึกษาเฉพาะสมาร์ตพอยน์เตอร์ตัวหลัก ๆ ที่พบบ่อยที่สุดในไลบรารีมาตรฐาน:
Box<T>, สำหรับจัดสรรค่าบนฮีป (heap)Rc<T>, ชนิดข้อมูลแบบนับจำนวนการอ้างอิง ที่เปิดให้ข้อมูลมีเจ้าของได้หลายรายพร้อมกันRef<T>และRefMut<T>, ซึ่งเข้าถึงผ่านRefCell<T>เป็นชนิดข้อมูลที่ตรวจสอบและบังคับใช้กฎการยืมในขณะรันไทม์แทนที่จะเป็นตอนคอมไพล์
นอกจากนี้ เรายังจะศึกษาแพตเทิร์น_ความสามารถในการเปลี่ยนแปลงค่าภายใน (interior mutability)_ ซึ่งเป็นรูปแบบที่ชนิดข้อมูลแบบแก้ไขไม่ได้ (immutable) เปิดเผย API ให้เราแก้ไขค่าที่อยู่ข้างในได้ และเราจะมาพูดคุยกันถึงเรื่องวงรอบการอ้างอิง (reference cycle) ว่ามันทำให้หน่วยความจำรั่วไหล (memory leak) ได้อย่างไร และเราจะมีวิธีป้องกันได้อย่างไรบ้าง
มาเริ่มเจาะลึกกันเลย!
ใช้ Box<T> ชี้ไปยังข้อมูลบนฮีป
ใช้ Box<T> ชี้ไปยังข้อมูลบนฮีป
สมาร์ตพอยน์เตอร์ (smart pointer) ที่เข้าใจง่ายและตรงไปตรงมาที่สุดก็คือบ็อกซ์ (box) ซึ่งเขียนแทนด้วยชนิดข้อมูล Box<T> โดย บ็อกซ์ ช่วยให้คุณสามารถเก็บข้อมูลไว้บนฮีป (heap) แทนที่จะเป็นบนสแตก (stack) สิ่งที่ยังคงอยู่บนสแตกจะมีเพียงแค่พอยน์เตอร์ที่ชี้ไปยังข้อมูลบนฮีปเท่านั้น หากต้องการทบทวนความแตกต่างระหว่างสแตกและฮีป สามารถย้อนกลับไปอ่านได้ในบทที่ 4
บ็อกซ์แทบไม่มีต้นทุนประสิทธิภาพส่วนเกิน (overhead) นอกเหนือจากการนำข้อมูลไปจัดเก็บไว้บนฮีปแทนที่จะเป็นบนสแตก แต่ในขณะเดียวกัน บ็อกซ์ก็ไม่ได้มีความสามารถพิเศษเพิ่มเติมมากมายนักเช่นกัน โดยคุณมักจะได้ใช้งานบ็อกซ์บ่อยที่สุดในสถานการณ์ดังต่อไปนี้:
- เมื่อคุณมีชนิดข้อมูลที่ไม่สามารถทราบขนาดได้ในขณะคอมไพล์ และคุณต้องการนำค่าของชนิดข้อมูลนั้นไปใช้ในบริบทที่ต้องการขนาดของหน่วยความจำที่แน่นอน
- เมื่อคุณมีข้อมูลขนาดใหญ่มาก และต้องการโอนย้ายสิทธิ์ความเป็นเจ้าของ แต่ต้องการรับประกันว่าข้อมูลจะไม่ถูกคัดลอกซ้ำซ้อน
- เมื่อคุณต้องการครอบครองค่าหนึ่ง และสนใจเพียงแค่ว่าค่านั้นต้องเป็นชนิดข้อมูลที่อิมพลีเมนต์เทรต (trait) ตัวใดตัวหนึ่ง มากกว่าที่จะเจาะจงชนิดข้อมูลที่แท้จริง
เราจะแสดงให้เห็นสถานการณ์แรกใน “การเปิดใช้ชนิดข้อมูลแบบเรียกซ้ำด้วยบ็อกซ์” ส่วนกรณีที่สอง การโอนย้ายสิทธิ์ความเป็นเจ้าของข้อมูลขนาดใหญ่อาจใช้เวลานานหากข้อมูลต้องถูกคัดลอกไปมาบนสแตก เพื่อปรับปรุงประสิทธิภาพในกรณีนี้ เราสามารถนำข้อมูลขนาดใหญ่นั้นไปเก็บไว้บนฮีปภายในบ็อกซ์ ซึ่งจะทำให้มีเพียงข้อมูลพอยน์เตอร์ขนาดเล็กเท่านั้นที่ถูกคัดลอกไปมาบนสแตก ในขณะที่ตัวข้อมูลจริงยังคงอยู่ที่เดิมบนฮีป สำหรับกรณีที่สามนั้นเรียกว่า เทรตออบเจกต์ (trait object) ซึ่งหัวข้อ “การใช้เทรตออบเจกต์เพื่อนามธรรมพฤติกรรมร่วม” ในบทที่ 18 ได้อุทิศเนื้อหาให้กับเรื่องนี้โดยเฉพาะ ดังนั้นสิ่งที่คุณได้เรียนรู้ที่นี่ จะได้นำไปต่อยอดใช้อีกครั้งในบทนั้น!
การเก็บข้อมูลบนฮีป
ก่อนที่เราจะพูดคุยถึงกรณีการใช้งานการเก็บข้อมูลบนฮีปของ Box<T> เราจะมาดูไวยากรณ์และวิธีเข้าถึงค่าที่เก็บอยู่ภายใน Box<T> กันก่อน
ลิสติ้ง 15-1 แสดงวิธีใช้บ็อกซ์เพื่อเก็บค่า i32 ไว้บนฮีป
fn main() {
let b = Box::new(5);
println!("b = {b}");
}เรากำหนดตัวแปร b ให้มีค่าเป็น Box ที่ชี้ไปยังค่า 5 ซึ่งได้รับการจัดสรรไว้บนฮีป โปรแกรมนี้จะพิมพ์ b = 5 ออกมา ในกรณีนี้ เราสามารถเข้าถึงข้อมูลภายในบ็อกซ์ได้คล้ายกับตอนที่ข้อมูลอยู่บนสแตก และเช่นเดียวกับค่าที่มีความเป็นเจ้าของทั่วไป เมื่อบ็อกซ์หลุดออกจากขอบเขต (scope) เหมือนที่ตัวแปร b หลุดออกจากขอบเขตเมื่อสิ้นสุดฟังก์ชัน main มันก็จะถูกคืนหน่วยความจำ (deallocate) โดยการคืนหน่วยความจำนี้จะเกิดขึ้นทั้งกับตัวบ็อกซ์เอง (ที่เก็บอยู่บนสแตก) และข้อมูลที่มันชี้ไป (ที่เก็บอยู่บนฮีป)
การนำค่าเดี่ยว ๆ เพียงค่าเดียวไปไว้บนฮีปนั้นไม่ได้มีประโยชน์มากนัก คุณจึงไม่ค่อยได้ใช้บ็อกซ์โดด ๆ ในลักษณะนี้บ่อยเท่าใด การเก็บค่าอย่าง i32 เพียงค่าเดียวไว้บนสแตกตามค่าเริ่มต้นนั้นเหมาะสมกว่าในสถานการณ์ส่วนใหญ่ คราวนี้มาดูสถานการณ์ที่บ็อกซ์ช่วยให้เราสามารถนิยามชนิดข้อมูลที่ไม่สามารถนิยามได้หากไม่มีบ็อกซ์กัน
การเปิดใช้ชนิดข้อมูลแบบเรียกซ้ำด้วยบ็อกซ์
ค่าของ_ชนิดข้อมูลแบบเรียกซ้ำ (recursive type)_ สามารถมีค่าอื่นที่เป็นชนิดเดียวกันเป็นส่วนประกอบภายในตัวมันเองได้ แต่ชนิดข้อมูลแบบเรียกซ้ำจะก่อให้เกิดปัญหา เพราะ Rust จำเป็นต้องรู้ตั้งแต่ตอนคอมไพล์ว่าชนิดข้อมูลนั้น ๆ ต้องใช้พื้นที่หน่วยความจำเท่าใด ทว่าการซ้อนทับกันของค่าในชนิดข้อมูลแบบเรียกซ้ำอาจเกิดขึ้นต่อไปเรื่อย ๆ ได้อย่างไม่สิ้นสุดในทางทฤษฎี ทำให้ Rust ไม่สามารถรู้ได้ว่าค่านั้นต้องใช้พื้นที่เท่าใด แต่เนื่องจากบ็อกซ์มีขนาดที่แน่นอนและทราบได้ล่วงหน้าเสมอ เราจึงสามารถเปิดใช้ชนิดข้อมูลแบบเรียกซ้ำได้โดยการแทรกบ็อกซ์เข้าไปในนิยามของชนิดข้อมูลนั้น
ในฐานะตัวอย่างของชนิดข้อมูลแบบเรียกซ้ำ เรามาลองศึกษา cons list กัน นี่คือโครงสร้างข้อมูลที่พบได้ทั่วไปในภาษาโปรแกรมเชิงฟังก์ชัน (functional programming) โดยชนิดข้อมูล cons list ที่เราจะนิยามนั้นมีโครงสร้างที่ตรงไปตรงมามาก เว้นแต่เพียงส่วนที่มีการเรียกซ้ำเท่านั้น ดังนั้นแนวคิดจากตัวอย่างนี้จะมีประโยชน์อย่างยิ่งเมื่อใดก็ตามที่คุณต้องเผชิญกับสถานการณ์ที่ซับซ้อนยิ่งขึ้นซึ่งเกี่ยวข้องกับชนิดข้อมูลแบบเรียกซ้ำ
การทำความเข้าใจ Cons List
cons list เป็นโครงสร้างข้อมูลที่มาจากภาษาโปรแกรม Lisp และภาษาในตระกูลของมัน ซึ่งประกอบขึ้นจากคู่ข้อมูล (pairs) ซ้อนกัน และเทียบได้กับลิงก์ลิสต์ (linked list) ในเวอร์ชันของ Lisp โดยชื่อของมันมาจากฟังก์ชัน cons (ย่อมาจาก construct function) ใน Lisp ที่ใช้สร้างคู่ข้อมูลใหม่ขึ้นมาจากอาร์กิวเมนต์สองตัว การเรียกฟังก์ชัน cons ซ้อนกันโดยส่งค่าและคู่อื่นเข้าไป ทำให้เราสามารถสร้าง cons list ที่ประกอบด้วยคู่ข้อมูลแบบเรียกซ้ำได้
ตัวอย่างเช่น ซูโดโค้ดด้านล่างนี้แสดง cons list ที่เก็บลิสต์ 1, 2, 3 โดยแต่ละคู่จะอยู่ในวงเล็บ:
(1, (2, (3, Nil)))
แต่ละไอเท็มใน cons list จะประกอบด้วยสององค์ประกอบ ได้แก่ ค่าของไอเท็มปัจจุบัน และไอเท็มตัวถัดไป ส่วนไอเท็มสุดท้ายในลิสต์จะมีเพียงค่าที่เรียกว่า Nil โดยไม่มีไอเท็มตัวถัดไป cons list ถูกสร้างขึ้นจากการเรียกฟังก์ชัน cons ซ้ำ ๆ โดยชื่อมาตรฐานที่ใช้แสดงกรณีฐาน (base case) เพื่อหยุดการเรียกซ้ำคือ Nil โปรดสังเกตว่าสิ่งนี้ไม่เหมือนกับแนวคิดเรื่อง “null” หรือ “nil” ที่เราพูดถึงในบทที่ 6 ซึ่งหมายถึงค่าที่ไม่ถูกต้องหรือการไม่มีค่า
cons list ไม่ใช่โครงสร้างข้อมูลที่นิยมใช้กันทั่วไปใน Rust เพราะเวลาส่วนใหญ่ที่คุณต้องการเก็บรายการของสิ่งต่าง ๆ ใน Rust ชนิดข้อมูล Vec<T> จะเป็นตัวเลือกที่ดีและเหมาะสมกว่า โครงสร้างข้อมูลแบบเรียกซ้ำชนิดอื่น ๆ ที่ซับซ้อนกว่านี้_มี_ประโยชน์ในสถานการณ์ต่าง ๆ แต่การเริ่มต้นด้วย cons list ในบทนี้จะช่วยให้เราเห็นภาพได้ชัดเจนว่าบ็อกซ์ช่วยให้เรานิยามชนิดข้อมูลแบบเรียกซ้ำได้อย่างไรโดยไม่ทำให้เนื้อหาซับซ้อนเกินไป
ลิสติ้ง 15-2 แสดงนิยามของ enum สำหรับ cons list โปรดสังเกตว่าโค้ดนี้จะยังคอมไพล์ไม่ผ่าน เนื่องจากชนิดข้อมูล List ยังไม่ทราบขนาดที่แน่นอน ซึ่งเราจะสาธิตให้เห็นต่อไป
enum List {
Cons(i32, List),
Nil,
}
fn main() {}หมายเหตุ: ในตัวอย่างนี้เรากำลังสร้าง cons list ที่เก็บเฉพาะค่า
i32แต่จริง ๆ แล้วเราสามารถอิมพลีเมนต์โดยใช้เจเนอริก (generics) ดังที่เราได้เรียนรู้ในบทที่ 10 เพื่อสร้างชนิดข้อมูล cons list ที่สามารถเก็บค่าของชนิดข้อมูลใดก็ได้
การนำชนิดข้อมูล List ไปใช้เก็บลิสต์ 1, 2, 3 จะมีหน้าตาดังโค้ดในลิสติ้ง 15-3
enum List {
Cons(i32, List),
Nil,
}
// --snip--
use crate::List::{Cons, Nil};
fn main() {
let list = Cons(1, Cons(2, Cons(3, Nil)));
}ค่า Cons ตัวแรกเก็บ 1 และค่า List อีกค่าหนึ่ง ซึ่งค่า List นี้ก็คือค่า Cons อีกตัวที่เก็บ 2 และค่า List อีกค่าหนึ่ง และค่า List นั้นก็คือค่า Cons อีกตัวที่เก็บ 3 และค่า List ตัวสุดท้าย ซึ่งก็คือ Nil อันเป็นวาเรียนต์แบบไม่เรียกซ้ำที่ทำหน้าที่บอกจุดสิ้นสุดของลิสต์
หากเราพยายามคอมไพล์โค้ดในลิสติ้ง 15-3 เราจะพบข้อผิดพลาดดังที่แสดงในลิสติ้ง 15-4
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
error[E0072]: recursive type `List` has infinite size
--> src/main.rs:1:1
|
1 | enum List {
| ^^^^^^^^^
2 | Cons(i32, List),
| ---- recursive without indirection
|
help: insert some indirection (e.g., a `Box`, `Rc`, or `&`) to break the cycle
|
2 | Cons(i32, Box<List>),
| ++++ +
For more information about this error, try `rustc --explain E0072`.
error: could not compile `cons-list` (bin "cons-list") due to 1 previous error
ข้อผิดพลาดระบุว่าชนิดข้อมูลนี้ “มีขนาดไม่สิ้นสุด (has infinite size)” สาเหตุก็เพราะเราได้นิยาม List ด้วยวาเรียนต์ที่มีการเรียกซ้ำ นั่นคือมันเก็บค่าชนิดเดียวกันไว้ภายในตัวเองโดยตรง ส่งผลให้ Rust ไม่สามารถคำนวณได้ว่าต้องใช้พื้นที่หน่วยความจำเท่าใดในการเก็บค่า List เรามาแยกย่อยวิเคราะห์กันว่าทำไมจึงเกิดข้อผิดพลาดนี้ โดยเริ่มจากการดูว่าปกติแล้ว Rust คำนวณขนาดหน่วยความจำสำหรับชนิดข้อมูลที่ไม่เรียกซ้ำอย่างไร
การคำนวณขนาดของชนิดข้อมูลที่ไม่เรียกซ้ำ
ลองนึกย้อนกลับไปถึง enum Message ที่เราเคยนิยามไว้ในลิสติ้ง 6-2 ตอนที่เราพูดคุยเรื่องนิยาม enum ในบทที่ 6:
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(i32, i32, i32),
}
fn main() {}ในการกำหนดว่าจะต้องจัดสรรพื้นที่หน่วยความจำเท่าใดสำหรับค่า Message นั้น Rust จะไล่ดูแต่ละวาเรียนต์เพื่อดูว่าวาเรียนต์ใดต้องการพื้นที่มากที่สุด Rust จะพบว่า Message::Quit ไม่จำเป็นต้องใช้พื้นที่เก็บข้อมูลใด ๆ, Message::Move ต้องใช้พื้นที่เพียงพอสำหรับเก็บค่า i32 สองค่า เป็นต้น และเนื่องจากในเวลาใดเวลาหนึ่งจะมีเพียงวาเรียนต์เดียวเท่านั้นที่ถูกใช้งาน พื้นที่หน่วยความจำมากที่สุดที่ค่า Message จะต้องใช้จึงเท่ากับพื้นที่ที่ใช้เก็บวาเรียนต์ที่มีขนาดใหญ่ที่สุดของมัน
คราวนี้ลองเปรียบเทียบกับสิ่งที่เกิดขึ้นเมื่อ Rust พยายามคำนวณพื้นที่สำหรับชนิดข้อมูลแบบเรียกซ้ำอย่าง enum List ในลิสติ้ง 15-2 ดูบ้าง คอมไพเลอร์จะเริ่มจากการดูวาเรียนต์ Cons ซึ่งเก็บค่าชนิด i32 และค่าชนิด List ดังนั้น Cons จึงต้องใช้พื้นที่เท่ากับขนาดของ i32 บวกกับขนาดของ List และในการคำนวณว่าชนิด List ต้องใช้หน่วยความจำเท่าใด คอมไพเลอร์ก็ต้องกลับไปดูแต่ละวาเรียนต์อีกครั้ง โดยเริ่มจาก Cons ซึ่ง Cons ก็เก็บ i32 และ List ต่อไปอีกเรื่อย ๆ กระบวนการนี้จึงดำเนินไปอย่างไม่สิ้นสุด ดังที่แสดงในรูปที่ 15-1
รูปที่ 15-1: List ที่ไม่สิ้นสุดซึ่งประกอบด้วยวาเรียนต์ Cons ที่ไม่สิ้นสุด
การได้มาซึ่งชนิดข้อมูลแบบเรียกซ้ำที่มีขนาดที่รู้ได้
เนื่องจาก Rust ไม่สามารถคำนวณได้ว่าต้องจัดสรรพื้นที่เท่าใดสำหรับชนิดข้อมูลที่นิยามแบบเรียกซ้ำ คอมไพเลอร์จึงแจ้งข้อผิดพลาดพร้อมคำแนะนำที่เป็นประโยชน์นี้:
help: insert some indirection (e.g., a `Box`, `Rc`, or `&`) to break the cycle
|
2 | Cons(i32, Box<List>),
| ++++ +
ในคำแนะนำนี้ คำว่า การชี้ทางอ้อม (indirection) หมายความว่าแทนที่จะเก็บค่าไว้โดยตรง เราควรปรับโครงสร้างข้อมูลให้เก็บค่าทางอ้อมด้วยการเก็บพอยน์เตอร์ที่ชี้ไปยังค่านั้นแทน
เนื่องจาก Box<T> มีสถานะเป็นพอยน์เตอร์ตัวหนึ่ง Rust จึงรู้ขนาดที่แน่นอนของ Box<T> เสมอ เพราะขนาดของพอยน์เตอร์จะไม่เปลี่ยนแปลงไปตามปริมาณข้อมูลที่มันชี้ไป นั่นหมายความว่าเราสามารถใส่ Box<T> ไว้ข้างในวาเรียนต์ Cons แทนที่จะเก็บค่า List อีกค่าหนึ่งโดยตรงได้ โดย Box<T> จะชี้ไปยังค่า List ถัดไปซึ่งถูกนำไปวางไว้บนฮีปแทนที่จะอยู่ภายในวาเรียนต์ Cons ในเชิงมโนทัศน์แล้ว เราก็ยังคงมีลิสต์ที่เกิดจากการซ้อนกันของลิสต์อื่น ๆ อยู่เช่นเดิม เพียงแต่การอิมพลีเมนต์ในลักษณะนี้จะเหมือนกับการนำไอเท็มมาวางเคียงข้างกัน มากกว่าที่จะนำมาบรรจุซ้อนไว้ข้างในกัน
เราสามารถแก้ไขนิยามของ enum List ในลิสติ้ง 15-2 และการใช้งาน List ในลิสติ้ง 15-3 ให้เป็นโค้ดในลิสติ้ง 15-5 ซึ่งจะสามารถคอมไพล์ผ่านได้อย่างสมบูรณ์
enum List {
Cons(i32, Box<List>),
Nil,
}
use crate::List::{Cons, Nil};
fn main() {
let list = Cons(1, Box::new(Cons(2, Box::new(Cons(3, Box::new(Nil))))));
}ตอนนี้วาเรียนต์ Cons จะต้องการพื้นที่เท่ากับขนาดของ i32 บวกกับพื้นที่สำหรับเก็บข้อมูลพอยน์เตอร์ของบ็อกซ์ ส่วนวาเรียนต์ Nil ไม่ได้เก็บค่าใด ๆ จึงใช้พื้นที่บนสแตกน้อยกว่าวาเรียนต์ Cons ตอนนี้เราจึงรู้ได้แน่นอนแล้วว่าค่า List ใด ๆ จะใช้พื้นที่เท่ากับขนาดของ i32 บวกกับขนาดพอยน์เตอร์ของบ็อกซ์ การใช้บ็อกซ์ช่วยตัดวงจรการเรียกซ้ำที่ไม่สิ้นสุดลง ทำให้คอมไพเลอร์สามารถคำนวณขนาดที่แน่นอนสำหรับจัดเก็บค่า List ได้ รูปที่ 15-2 แสดงให้เห็นว่าโครงสร้างของวาเรียนต์ Cons มีหน้าตาเป็นอย่างไรในตอนนี้
รูปที่ 15-2: List ที่ไม่ได้มีขนาดไม่สิ้นสุด เพราะ Cons เก็บ Box
บ็อกซ์ทำหน้าที่เพียงแค่ชี้ทางอ้อมและจัดสรรหน่วยความจำบนฮีปเท่านั้น โดยไม่มีความสามารถพิเศษอื่นใดเหมือนอย่างที่เราจะได้เห็นในสมาร์ตพอยน์เตอร์ชนิดอื่น ๆ แต่ในขณะเดียวกัน มันก็ไม่มีต้นทุนประสิทธิภาพส่วนเกินที่ความสามารถพิเศษเหล่านั้นต้องแลกมาด้วย บ็อกซ์จึงมีประโยชน์อย่างยิ่งในกรณีเช่น cons list ซึ่งการชี้ทางอ้อมเป็นเพียงสิ่งเดียวที่เราต้องการ เราจะได้เห็นกรณีการใช้งานบ็อกซ์เพิ่มเติมในบทที่ 18
ชนิดข้อมูล Box<T> ถือเป็นสมาร์ตพอยน์เตอร์เพราะมันอิมพลีเมนต์เทรต Deref ซึ่งอนุญาตให้ค่า Box<T> ถูกใช้งานเสมือนเป็นเรเฟอเรนซ์ และเมื่อค่า Box<T> หลุดออกจากขอบเขต ข้อมูลบนฮีปที่บ็อกซ์ชี้ไปก็จะถูกคืนหน่วยความจำและเก็บกวาดให้โดยอัตโนมัติเนื่องจากการอิมพลีเมนต์เทรต Drop เทรตทั้งสองนี้จะยิ่งมีความสำคัญมากขึ้นไปอีกในสมาร์ตพอยน์เตอร์ชนิดอื่น ๆ ที่เราจะพูดถึงในส่วนที่เหลือของบทนี้ มาศึกษาเทรตทั้งสองนี้อย่างละเอียดกันต่อเลย
ปฏิบัติกับสมาร์ตพอยน์เตอร์เหมือนเรเฟอเรนซ์ทั่วไป
ปฏิบัติกับสมาร์ตพอยน์เตอร์เหมือนเรเฟอเรนซ์ทั่วไป
การอิมพลีเมนต์เทรต Deref ช่วยให้คุณสามารถปรับแต่งพฤติกรรมของ_ตัวดำเนินการดีเรเฟอเรนซ์ (dereference operator)_ * ได้ (อย่าสับสนกับตัวดำเนินการคูณหรือตัวดำเนินการ glob) การอิมพลีเมนต์ Deref ในลักษณะที่ทำให้สมาร์ตพอยน์เตอร์ (smart pointer) ถูกปฏิบัติเสมือนเป็นเรเฟอเรนซ์ (reference) ทั่วไป จะช่วยให้คุณเขียนโค้ดที่ทำงานร่วมกับเรเฟอเรนซ์ และนำโค้ดนั้นไปใช้งานกับสมาร์ตพอยน์เตอร์ได้ด้วยเช่นกัน
ก่อนอื่น เราจะมาดูกันว่าตัวดำเนินการดีเรเฟอเรนซ์ทำงานกับเรเฟอเรนซ์ทั่วไปอย่างไร จากนั้น เราจะลองนิยามชนิดข้อมูลแบบกำหนดเองที่ทำงานคล้าย Box<T> แล้วดูว่าเหตุใดตัวดำเนินการดีเรเฟอเรนซ์จึงยังไม่ทำงานเสมือนเรเฟอเรนซ์บนชนิดข้อมูลที่เพิ่งสร้างขึ้นใหม่นี้ ถัดมา เราจะไปสำรวจว่าการอิมพลีเมนต์เทรต Deref ช่วยให้สมาร์ตพอยน์เตอร์ทำงานคล้ายเรเฟอเรนซ์ได้อย่างไร และท้ายที่สุด เราจะศึกษาฟีเจอร์การแปลงชนิดข้อมูลด้วยการดีเรฟ หรือ การบังคับดีเรฟ (deref coercion) ของ Rust พร้อมดูว่ามันช่วยให้เราทำงานร่วมกับทั้งเรเฟอเรนซ์หรือสมาร์ตพอยน์เตอร์ได้อย่างไร
การตามเรเฟอเรนซ์ไปยังค่า
เรเฟอเรนซ์ทั่วไปเป็นพอยน์เตอร์ชนิดหนึ่ง ซึ่งวิธีทำความเข้าใจพอยน์เตอร์วิธีหนึ่งก็คือการมองว่ามันเป็นลูกศรที่ชี้ไปยังค่าซึ่งถูกจัดเก็บไว้ที่อื่น ในลิสติ้ง 15-6 เราได้สร้างเรเฟอเรนซ์ที่ชี้ไปยังค่า i32 จากนั้นจึงใช้ตัวดำเนินการดีเรเฟอเรนซ์เพื่อตามเรเฟอเรนซ์ไปยังค่านั้น
fn main() {
let x = 5;
let y = &x;
assert_eq!(5, x);
assert_eq!(5, *y);
}ตัวแปร x เก็บค่า i32 ซึ่งก็คือ 5 และเรากำหนดให้ y มีค่าเท่ากับเรเฟอเรนซ์ที่ชี้ไปยัง x เราสามารถยืนยันได้ว่า x มีค่าเท่ากับ 5 อย่างไรก็ตาม หากเราต้องการสร้างเงื่อนไขยืนยัน (assertion) เกี่ยวกับค่าใน y เราจำเป็นต้องใช้ *y เพื่อตามเรเฟอเรนซ์ไปยังค่าที่มันชี้ไป (จึงเรียกว่า_การดีเรเฟอเรนซ์_) เพื่อให้คอมไพเลอร์สามารถเปรียบเทียบค่าจริงได้ เมื่อเราดีเรเฟอเรนซ์ y แล้ว เราจะเข้าถึงค่าจำนวนเต็มที่ y กำลังชี้อยู่ ซึ่งสามารถนำมาเปรียบเทียบกับ 5 ได้
หากเราลองเขียน assert_eq!(5, y); แทน เราจะได้รับข้อผิดพลาดในขั้นตอนคอมไพล์นี้:
$ cargo run
Compiling deref-example v0.1.0 (file:///projects/deref-example)
error[E0277]: can't compare `{integer}` with `&{integer}`
--> src/main.rs:6:5
|
6 | assert_eq!(5, y);
| ^^^^^^^^^^^^^^^^ no implementation for `{integer} == &{integer}`
|
= help: the trait `PartialEq<&{integer}>` is not implemented for `{integer}`
= help: the following other types implement trait `PartialEq<Rhs>`:
f128
f16
f32
f64
i128
i16
i32
i64
and 8 others
For more information about this error, try `rustc --explain E0277`.
error: could not compile `deref-example` (bin "deref-example") due to 1 previous error
การเปรียบเทียบตัวเลขกับเรเฟอเรนซ์ที่ชี้ไปยังตัวเลขนั้นไม่ได้รับอนุญาต เนื่องจากเป็นข้อมูลคนละชนิดกัน เราจึงจำเป็นต้องใช้ตัวดำเนินการดีเรเฟอเรนซ์เพื่อตามเรเฟอเรนซ์ไปยังค่าที่มันชี้อยู่เสมอ
การใช้ Box<T> เหมือนเรเฟอเรนซ์
เราสามารถเขียนโค้ดในลิสติ้ง 15-6 ขึ้นมาใหม่โดยใช้ Box<T> แทนเรเฟอเรนซ์ได้ ซึ่งตัวดำเนินการดีเรเฟอเรนซ์ที่นำมาใช้กับ Box<T> ในลิสติ้ง 15-7 จะทำงานในลักษณะเดียวกับตัวดำเนินการดีเรเฟอเรนซ์ที่ใช้กับเรเฟอเรนซ์ในลิสติ้ง 15-6 ทุกประการ
fn main() {
let x = 5;
let y = Box::new(x);
assert_eq!(5, x);
assert_eq!(5, *y);
}ความแตกต่างหลักระหว่างลิสติ้ง 15-7 กับลิสติ้ง 15-6 ก็คือ ในตัวอย่างนี้เรากำหนดให้ y เป็นอินสแตนซ์ของบ็อกซ์ที่ชี้ไปยังสำเนาค่าของ x แทนที่จะเป็นเรเฟอเรนซ์ที่ชี้ไปยังค่าของ x และในบรรทัด assertion สุดท้าย เราสามารถใช้ตัวดำเนินการดีเรเฟอเรนซ์เพื่อตามพอยน์เตอร์ของบ็อกซ์ได้ในลักษณะเดียวกับตอนที่ y เป็นเรเฟอเรนซ์ ลำดับถัดไป เราจะมาสำรวจกันว่ามีอะไรพิเศษใน Box<T> ที่ทำให้เราสามารถใช้ตัวดำเนินการดีเรเฟอเรนซ์ได้ โดยเราจะลองสร้างชนิดข้อมูลบ็อกซ์ขึ้นมาด้วยตัวเอง
การนิยามสมาร์ตพอยน์เตอร์ของเราเอง
มาลองสร้างชนิดข้อมูลแบบห่อหุ้ม (wrapper type) ที่คล้ายคลึงกับชนิดข้อมูล Box<T> ในไลบรารีมาตรฐาน เพื่อสัมผัสด้วยตนเองว่าชนิดข้อมูลสมาร์ตพอยน์เตอร์มีพฤติกรรมแตกต่างจากเรเฟอเรนซ์ตามค่าเริ่มต้นอย่างไร จากนั้นเราจะดูวิธีเพิ่มความสามารถในการใช้งานตัวดำเนินการดีเรเฟอเรนซ์เข้าไป
หมายเหตุ: มีความแตกต่างสำคัญประการหนึ่งระหว่างชนิดข้อมูล
MyBox<T>ที่เรากำลังจะสร้างขึ้น กับBox<T>ของจริง นั่นคือ เวอร์ชันของเราจะไม่เก็บข้อมูลไว้บนฮีป เนื่องจากเรามุ่งเน้นตัวอย่างนี้ไปที่เรื่องDerefดังนั้นสถานที่ที่เก็บข้อมูลจริงจึงมีความสำคัญน้อยกว่าพฤติกรรมที่เสมือนพอยน์เตอร์
แท้จริงแล้วชนิดข้อมูล Box<T> ถูกนิยามขึ้นในรูปแบบทูเพิลสตรัค (tuple struct) ที่มีสมาชิกเพียงตัวเดียว ลิสติ้ง 15-8 จึงนิยามชนิดข้อมูล MyBox<T> ในรูปแบบเดียวกัน นอกจากนี้เรายังจะนิยามฟังก์ชัน new เพื่อให้สอดคล้องกับฟังก์ชัน new ของ Box<T> ด้วย
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn main() {}เรานิยาม struct ชื่อ MyBox และประกาศพารามิเตอร์เจเนอริก (generic) T เนื่องจากเราต้องการให้ชนิดข้อมูลนี้สามารถเก็บค่าชนิดใดก็ได้ โดยชนิด MyBox เป็นทูเพิลสตรัคที่มีสมาชิกหนึ่งตัวชนิด T และฟังก์ชัน MyBox::new จะรับพารามิเตอร์หนึ่งตัวชนิด T แล้วส่งคืนอินสแตนซ์ของ MyBox ที่เก็บค่านั้นไว้ข้างใน
คราวนี้มาลองนำฟังก์ชัน main จากลิสติ้ง 15-7 มาใส่ในลิสติ้ง 15-8 แล้วเปลี่ยนมาใช้ชนิดข้อมูล MyBox<T> ที่เรานิยามขึ้นแทนที่ Box<T> โค้ดในลิสติ้ง 15-9 จะคอมไพล์ไม่ผ่าน เนื่องจาก Rust ยังไม่รู้วิธีดีเรเฟอเรนซ์ MyBox
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn main() {
let x = 5;
let y = MyBox::new(x);
assert_eq!(5, x);
assert_eq!(5, *y);
}ผลลัพธ์ข้อผิดพลาดจากการคอมไพล์มีดังนี้:
$ cargo run
Compiling deref-example v0.1.0 (file:///projects/deref-example)
error[E0614]: type `MyBox<{integer}>` cannot be dereferenced
--> src/main.rs:14:19
|
14 | assert_eq!(5, *y);
| ^^ can't be dereferenced
For more information about this error, try `rustc --explain E0614`.
error: could not compile `deref-example` (bin "deref-example") due to 1 previous error
ชนิดข้อมูล MyBox<T> ของเราไม่สามารถดีเรเฟอเรนซ์ได้ เนื่องจากเรายังไม่ได้อิมพลีเมนต์ความสามารถดังกล่าวให้กับชนิดข้อมูลนี้ และเพื่อเปิดใช้งานการดีเรเฟอเรนซ์ด้วยตัวดำเนินการ * เราจึงจำเป็นต้องอิมพลีเมนต์เทรต Deref
การอิมพลีเมนต์เทรต Deref
ดังที่ได้พูดคุยกันใน “การอิมพลีเมนต์เทรตบนชนิดข้อมูล” ในบทที่ 10 ในการอิมพลีเมนต์เทรต เราจำเป็นต้องจัดเตรียมโค้ดการทำงานสำหรับเมธอดที่เทรตนั้นกำหนดไว้ โดยเทรต Deref ที่ไลบรารีมาตรฐานจัดเตรียมไว้ให้นั้น กำหนดให้เราต้องอิมพลีเมนต์เมธอดหนึ่งตัวชื่อ deref ซึ่งจะทำการยืม self และคืนค่าเป็นเรเฟอเรนซ์ที่ชี้ไปยังข้อมูลภายใน ลิสติ้ง 15-10 แสดงการอิมพลีเมนต์ Deref เพื่อนำไปเพิ่มเข้ากับนิยามของ MyBox<T>
use std::ops::Deref;
impl<T> Deref for MyBox<T> {
type Target = T;
fn deref(&self) -> &Self::Target {
&self.0
}
}
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn main() {
let x = 5;
let y = MyBox::new(x);
assert_eq!(5, x);
assert_eq!(5, *y);
}ไวยากรณ์ type Target = T; เป็นการนิยามชนิดข้อมูลที่เกี่ยวข้อง (associated type) ให้เทรต Deref นำไปใช้งาน โดยชนิดข้อมูลที่เกี่ยวข้องเป็นอีกวิธีหนึ่งในการประกาศพารามิเตอร์เจเนอริก ซึ่งคุณยังไม่ต้องกังวลกับมันในตอนนี้ เพราะเราจะไปเจาะลึกรายละเอียดกันในบทที่ 20
เราเขียนเนื้อหาภายในเมธอด deref ด้วย &self.0 เพื่อให้ deref คืนเรเฟอเรนซ์ที่ชี้ไปยังค่าที่เราต้องการเข้าถึงด้วยตัวดำเนินการ * (จำได้ไหมว่าจากหัวข้อ “การสร้างชนิดข้อมูลที่แตกต่างกันด้วยทูเพิล struct” ในบทที่ 5 การใช้ .0 เป็นการเข้าถึงค่าตัวแรกในทูเพิลสตรัค) เมื่อเพิ่มโค้ดนี้แล้ว ฟังก์ชัน main ในลิสติ้ง 15-9 ที่เรียกใช้ * บนค่า MyBox<T> ก็จะคอมไพล์ผ่าน และการยืนยันเงื่อนไขทั้งหมดก็ทำงานได้อย่างถูกต้อง!
หากไม่มีเทรต Deref คอมไพเลอร์จะสามารถดีเรเฟอเรนซ์ได้เฉพาะเรเฟอเรนซ์ & เท่านั้น แต่เมธอด deref ได้มอบความสามารถให้คอมไพเลอร์สามารถรับค่าของชนิดข้อมูลใด ๆ ที่อิมพลีเมนต์ Deref แล้วเรียกเมธอด deref เพื่อแปลงให้กลายเป็นเรเฟอเรนซ์ที่คอมไพเลอร์รู้วิธีดีเรเฟอเรนซ์ได้
เมื่อเราเขียน *y ในลิสติ้ง 15-9 แท้จริงแล้วเบื้องหลัง Rust ได้รันโค้ดต่อไปนี้:
*(y.deref())Rust จะแทนที่ตัวดำเนินการ * ด้วยการเรียกเมธอด deref แล้วตามด้วยการดีเรเฟอเรนซ์แบบธรรมดาหนึ่งครั้ง ทำให้เราไม่จำเป็นต้องมาคอยพะวงว่าเมื่อใดจะต้องเรียกใช้เมธอด deref ด้วยตนเอง ฟีเจอร์นี้ของ Rust ช่วยให้เราสามารถเขียนโค้ดที่ทำงานได้เหมือนกันทุกประการ ไม่ว่าเราจะส่งเรเฟอเรนซ์ธรรมดา หรือส่งชนิดข้อมูลที่อิมพลีเมนต์ Deref มาให้ก็ตาม
เหตุผลที่เมธอด deref ต้องคืนค่าเป็นเรเฟอเรนซ์ที่ชี้ไปยังค่า และเหตุใดการดีเรเฟอเรนซ์แบบธรรมดานอกวงเล็บใน *(y.deref()) จึงยังคงจำเป็นอยู่นั้น เกี่ยวข้องกับระบบความเป็นเจ้าของ (ownership) เพราะหากเมธอด deref คืนค่านั้นออกมาโดยตรงแทนที่จะเป็นเรเฟอเรนซ์ ค่านั้นก็จะถูกย้ายออกจาก self แต่เราไม่ได้ต้องการเข้ายึดครองสิทธิ์ความเป็นเจ้าของค่าที่อยู่ภายใน MyBox<T> ในกรณีนี้ หรือในกรณีส่วนใหญ่ที่เราใช้ตัวดำเนินการดีเรเฟอเรนซ์
โปรดสังเกตว่า ทุกครั้งที่เราใช้ * ในโค้ด ตัวดำเนินการ * จะถูกแทนที่ด้วยการเรียกเมธอด deref ตามด้วยการใช้ตัวดำเนินการ * อีกเพียงหนึ่งครั้งเท่านั้น และเนื่องจากการแทนที่ตัวดำเนินการ * นี้ไม่ได้เกิดการเรียกซ้ำอย่างไม่สิ้นสุด เราจึงได้ข้อมูลชนิด i32 ซึ่งตรงกับค่า 5 ในคำสั่ง assert_eq! ของลิสติ้ง 15-9 ในที่สุด
การใช้การบังคับดีเรฟในฟังก์ชันและเมธอด
การบังคับดีเรฟ (deref coercion) คือการแปลงเรเฟอเรนซ์ของชนิดข้อมูลที่อิมพลีเมนต์เทรต Deref ให้กลายเป็นเรเฟอเรนซ์ของอีกชนิดข้อมูลหนึ่ง ตัวอย่างเช่น การบังคับดีเรฟสามารถแปลง &String ให้เป็น &str ได้ เนื่องจาก String ได้อิมพลีเมนต์เทรต Deref ในรูปแบบที่คืนค่าเป็น &str การบังคับดีเรฟเป็นคุณสมบัติอำนวยความสะดวกที่ Rust จัดการให้อัตโนมัติกับอาร์กิวเมนต์ที่ส่งให้กับฟังก์ชันและเมธอด และจะทำงานเฉพาะกับชนิดข้อมูลที่อิมพลีเมนต์เทรต Deref เท่านั้น โดยจะเกิดขึ้นโดยอัตโนมัติเมื่อเราส่งเรเฟอเรนซ์ของชนิดข้อมูลหนึ่งเป็นอาร์กิวเมนต์ให้กับฟังก์ชันหรือเมธอด แต่ชนิดของมันไม่ตรงกับชนิดของพารามิเตอร์ที่นิยามไว้ ซึ่งชุดการเรียกเมธอด deref อย่างต่อเนื่องจะช่วยแปลงชนิดข้อมูลที่เราส่งเข้าไปให้ตรงกับชนิดข้อมูลที่พารามิเตอร์ต้องการ
ฟีเจอร์การบังคับดีเรฟถูกเพิ่มเข้ามาใน Rust เพื่อให้นักพัฒนาที่เขียนโค้ดเรียกใช้ฟังก์ชันและเมธอดไม่ต้องมาคอยใส่การอ้างอิงและการดีเรเฟอเรนซ์ด้วย & และ * อย่างโจ่งแจ้งมากเกินไป นอกจากนี้ ฟีเจอร์ดังกล่าวยังช่วยให้เราเขียนโค้ดที่สามารถนำไปประยุกต์ใช้ได้ทั้งกับเรเฟอเรนซ์และสมาร์ตพอยน์เตอร์ได้มากยิ่งขึ้น
เพื่อให้เห็นภาพการบังคับดีเรฟในการใช้งานจริง เราจะนำชนิดข้อมูล MyBox<T> ที่เรานิยามไว้ในลิสติ้ง 15-8 ร่วมกับการอิมพลีเมนต์ Deref ในลิสติ้ง 15-10 มาใช้งาน โดยลิสติ้ง 15-11 แสดงนิยามของฟังก์ชันที่มีพารามิเตอร์เป็นสตริงสไลซ์ (string slice)
fn hello(name: &str) {
println!("Hello, {name}!");
}
fn main() {}เราสามารถเรียกฟังก์ชัน hello โดยส่งสตริงสไลซ์เป็นอาร์กิวเมนต์ เช่น hello("Rust"); ได้ และด้วยการบังคับดีเรฟนี้เอง เราจึงสามารถเรียกใช้ hello โดยส่งเรเฟอเรนซ์ที่ชี้ไปยังค่าชนิด MyBox<String> ได้เช่นกัน ดังที่แสดงในลิสติ้ง 15-12
use std::ops::Deref;
impl<T> Deref for MyBox<T> {
type Target = T;
fn deref(&self) -> &T {
&self.0
}
}
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn hello(name: &str) {
println!("Hello, {name}!");
}
fn main() {
let m = MyBox::new(String::from("Rust"));
hello(&m);
}ในที่นี้เราเรียกฟังก์ชัน hello ด้วยอาร์กิวเมนต์ &m ซึ่งเป็นเรเฟอเรนซ์ไปยังค่า MyBox<String> และเนื่องจากเราได้อิมพลีเมนต์เทรต Deref ให้กับ MyBox<T> ไว้ในลิสติ้ง 15-10 ทาง Rust จึงสามารถแปลง &MyBox<String> ให้เป็น &String ได้ด้วยการเรียกใช้ deref นอกจากนี้ ไลบรารีมาตรฐานยังมีการอิมพลีเมนต์ Deref ให้กับ String ซึ่งจะคืนค่าเป็นสตริงสไลซ์ (มีระบุไว้ในเอกสาร API ของ Deref) Rust จึงเรียก deref อีกหนึ่งครั้งเพื่อแปลง &String ให้กลายเป็น &str ซึ่งตรงกับนิยามของฟังก์ชัน hello พอดี
หาก Rust ไม่ได้รองรับการบังคับดีเรฟ เราจะต้องเขียนโค้ดดังในลิสติ้ง 15-13 แทนโค้ดในลิสติ้ง 15-12 เพื่อเรียกใช้ hello ด้วยค่าชนิด &MyBox<String>
use std::ops::Deref;
impl<T> Deref for MyBox<T> {
type Target = T;
fn deref(&self) -> &T {
&self.0
}
}
struct MyBox<T>(T);
impl<T> MyBox<T> {
fn new(x: T) -> MyBox<T> {
MyBox(x)
}
}
fn hello(name: &str) {
println!("Hello, {name}!");
}
fn main() {
let m = MyBox::new(String::from("Rust"));
hello(&(*m)[..]);
}นิพจน์ (*m) จะทำการดีเรเฟอเรนซ์ MyBox<String> ให้กลายเป็น String จากนั้น & และ [..] จะดึงสตริงสไลซ์ของ String ทั้งข้อความออกมาเพื่อให้ตรงกับลายเซ็น (signature) ของฟังก์ชัน hello โค้ดที่ไม่มีการบังคับดีเรฟเช่นนี้จะอ่าน เขียน และทำความเข้าใจได้ยากกว่ามากเพราะเต็มไปด้วยสัญลักษณ์ต่าง ๆ การบังคับดีเรฟจึงช่วยให้ Rust สามารถจัดการการแปลงชนิดข้อมูลเหล่านี้แทนเราได้อย่างราบรื่นและเป็นอัตโนมัติ
เมื่อมีการนิยามเทรต Deref ให้กับชนิดข้อมูลที่เกี่ยวข้อง Rust จะวิเคราะห์ชนิดข้อมูลเหล่านั้นและเรียกใช้ Deref::deref ต่อเนื่องกันกี่ครั้งก็ได้ตามความจำเป็น เพื่อให้ได้เรเฟอเรนซ์ที่ตรงกับชนิดของพารามิเตอร์ โดยจำนวนครั้งที่ต้องแทรกการเรียก Deref::deref นั้นจะถูกคำนวณและกำหนดไว้เรียบร้อยแล้วตั้งแต่ตอนคอมไพล์ จึงไม่มีต้นทุนสูญเปล่าด้านประสิทธิภาพในขณะรันไทม์เลยแม้แต่น้อย!
การจัดการการบังคับดีเรฟกับเรเฟอเรนซ์แบบเปลี่ยนแปลงได้
ในทำนองเดียวกับที่คุณใช้เทรต Deref เพื่อเขียนทับพฤติกรรม (override) ของตัวดำเนินการ * บนเรเฟอเรนซ์แบบแก้ไขไม่ได้ (immutable reference) คุณก็สามารถใช้เทรต DerefMut เพื่อเขียนทับพฤติกรรมของตัวดำเนินการ * บนเรเฟอเรนซ์แบบแก้ไขได้ (mutable reference) ได้เช่นกัน
Rust จะดำเนินการบังคับดีเรฟเมื่อพบชนิดข้อมูลและการอิมพลีเมนต์เทรตใน 3 กรณีต่อไปนี้:
- จาก
&Tไปยัง&Uเมื่อT: Deref<Target=U> - จาก
&mut Tไปยัง&mut Uเมื่อT: DerefMut<Target=U> - จาก
&mut Tไปยัง&Uเมื่อT: Deref<Target=U>
สองกรณีแรกนั้นเหมือนกันทุกประการ เว้นแต่กรณีที่สองจะจัดการกับความสามารถในการเปลี่ยนแปลงค่า (mutability) โดยกรณีแรกระบุว่า หากคุณมี &T และ T อิมพลีเมนต์ Deref ไปยังชนิดข้อมูล U คุณจะสามารถแปลงไปเป็น &U ได้อย่างโปร่งใส และกรณีที่สองก็ระบุว่าการบังคับดีเรฟแบบเดียวกันนี้จะเกิดขึ้นกับเรเฟอเรนซ์แบบเปลี่ยนแปลงได้เช่นกัน
ส่วนกรณีที่สามจะมีความซับซ้อนยิ่งขึ้น: กล่าวคือ Rust สามารถแปลงเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ให้กลายเป็นเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ได้ แต่ในทางกลับกันจะ_ไม่_สามารถทำได้ นั่นคือ เรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้จะไม่มีวันถูกบังคับให้เป็นเรเฟอเรนซ์แบบเปลี่ยนแปลงได้เด็ดขาด ทั้งนี้เป็นไปตามกฎการยืม (borrowing rules) เพราะหากคุณมีเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ เรเฟอเรนซ์นั้นจะต้องเป็นการอ้างอิงเพียงหนึ่งเดียวไปยังข้อมูลชิ้นนั้น (มิฉะนั้นโปรแกรมจะคอมไพล์ไม่ผ่าน) ดังนั้นการแปลงเรเฟอเรนซ์แบบเปลี่ยนแปลงได้หนึ่งตัวให้กลายเป็นเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้หนึ่งตัวจึงไม่มีทางละเมิดกฎการยืม ในขณะที่การแปลงเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ให้กลายเป็นเรเฟอเรนซ์แบบเปลี่ยนแปลงได้นั้น จะต้องมั่นใจก่อนว่าเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ตัวแรกเป็นเรเฟอเรนซ์เพียงตัวเดียวที่มีอยู่จริง ๆ ซึ่งกฎการยืมไม่ได้รับประกันเช่นนั้น Rust จึงไม่สามารถสันนิษฐานได้ว่าการแปลงเรเฟอเรนซ์แบบเปลี่ยนแปลงไม่ได้ให้เป็นเรเฟอเรนซ์แบบเปลี่ยนแปลงได้นั้นจะปลอดภัยและเป็นไปได้
รันโค้ดเมื่อทำความสะอาดด้วยเทรต Drop
รันโค้ดเมื่อทำความสะอาดด้วยเทรต Drop
เทรตที่สองที่มีความสำคัญต่อรูปแบบสมาร์ตพอยน์เตอร์ก็คือ Drop ซึ่งช่วยให้คุณสามารถกำหนดพฤติกรรมที่จะเกิดขึ้นเมื่อค่าของตัวแปรหนึ่งกำลังจะหลุดออกจากขอบเขต (scope) ได้ คุณสามารถอิมพลีเมนต์เทรต Drop ให้กับชนิดข้อมูลใดก็ได้ และโค้ดดังกล่าวมักถูกนำมาใช้เพื่อปลดปล่อยและคืนทรัพยากรต่าง ๆ เช่น ไฟล์ หรือการเชื่อมต่อเครือข่าย
เราแนะนำเทรต Drop ในบริบทของสมาร์ตพอยน์เตอร์ เพราะการทำงานของเทรตนี้ถูกนำมาใช้อยู่เสมอในการสร้างสมาร์ตพอยน์เตอร์ ตัวอย่างเช่น เมื่อ Box<T> ถูกทิ้ง (drop) ตัวมันเองก็จะคืนพื้นที่หน่วยความจำบนฮีปที่บ็อกซ์นั้นชี้อยู่ให้โดยอัตโนมัติ
ในบางภาษาและกับชนิดข้อมูลบางประเภท โปรแกรมเมอร์จะต้องเรียกใช้คำสั่งเพื่อคืนหน่วยความจำหรือทรัพยากรด้วยตนเองทุกครั้งที่ใช้งานอินสแตนซ์เหล่านั้นเสร็จสิ้น เช่น ตัวจัดการไฟล์ (file handles), ซ็อกเก็ต (sockets) หรือล็อก (locks) หากโปรแกรมเมอร์ลืม ระบบก็อาจทำงานหนักเกินไปจนเกิดการล่ม (crash) ได้ แต่ใน Rust คุณสามารถกำหนดโค้ดเฉพาะเจาะจงให้ทำงานโดยอัตโนมัติเมื่อใดก็ตามที่ค่านั้นหลุดออกจากขอบเขต โดยที่คอมไพเลอร์จะเป็นผู้แทรกโค้ดนี้ให้เอง ส่งผลให้คุณไม่ต้องคอยกังวลกับการวางโค้ดเก็บกวาดทรัพยากรไว้ทุกหนทุกแห่งในโปรแกรมหลังจากเลิกใช้งานอินสแตนซ์ของชนิดข้อมูลนั้น ๆ โดยไม่มีการรั่วไหลของทรัพยากรเกิดขึ้นเลย!
คุณสามารถกำหนดโค้ดที่จะให้ทำงานเมื่อค่าหลุดออกจากขอบเขตได้ด้วยการอิมพลีเมนต์เทรต Drop โดยเทรต Drop กำหนดให้คุณต้องอิมพลีเมนต์เมธอดหนึ่งตัวชื่อ drop ซึ่งรับพารามิเตอร์เป็นเรเฟอเรนซ์แบบเปลี่ยนแปลงได้ที่ชี้ไปยัง self เพื่อให้เห็นภาพชัดเจนว่า Rust เรียกใช้งาน drop เมื่อใด เราจะมาลองเขียนเมธอด drop โดยใส่คำสั่ง println! ไว้ในเบื้องต้นกันก่อน
ลิสติ้ง 15-14 แสดง struct CustomSmartPointer ที่มีฟังก์ชันการทำงานกำหนดเองเพียงอย่างเดียวคือมันจะพิมพ์ Dropping CustomSmartPointer! เมื่ออินสแตนซ์ออกจากสโคป เพื่อแสดงว่า Rust รันเมธอด drop เมื่อใด
struct CustomSmartPointer {
data: String,
}
impl Drop for CustomSmartPointer {
fn drop(&mut self) {
println!("Dropping CustomSmartPointer with data `{}`!", self.data);
}
}
fn main() {
let c = CustomSmartPointer {
data: String::from("my stuff"),
};
let d = CustomSmartPointer {
data: String::from("other stuff"),
};
println!("CustomSmartPointers created");
}เนื่องจากเทรต Drop ถูกรวมไว้ในพรีลูด (prelude) อยู่แล้ว เราจึงไม่จำเป็นต้องนำเข้าสู่ขอบเขตด้วยตนเอง เราอิมพลีเมนต์เทรต Drop ให้กับ CustomSmartPointer และเขียนการทำงานของเมธอด drop ให้เรียกใช้ println! โดยเนื้อหาภายในเมธอด drop นี้คือจุดที่คุณสามารถใส่ตรรกะใด ๆ ก็ตามที่ต้องการให้ทำงานเมื่ออินสแตนซ์ของชนิดข้อมูลของคุณหลุดออกจากขอบเขต ในตัวอย่างนี้เราพิมพ์ข้อความออกมาเพื่อให้เห็นภาพชัดเจนว่า Rust เรียกใช้ drop ในจังหวะใด
ในฟังก์ชัน main เราสร้างอินสแตนซ์ของ CustomSmartPointer ขึ้นมาสองตัว จากนั้นจึงพิมพ์ข้อความ CustomSmartPointers created เมื่อสิ้นสุดฟังก์ชัน main อินสแตนซ์ของ CustomSmartPointer จะหลุดออกจากขอบเขต และ Rust ก็จะเรียกโค้ดที่เราใส่ไว้ในเมธอด drop ซึ่งจะพิมพ์ข้อความปิดท้ายของเราออกมา โปรดสังเกตว่าเราไม่จำเป็นต้องเรียกเมธอด drop ด้วยตนเองอย่างโจ่งแจ้งเลย
เมื่อเรารันโปรแกรมนี้ เราจะเห็นผลลัพธ์ต่อไปนี้:
$ cargo run
Compiling drop-example v0.1.0 (file:///projects/drop-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.60s
Running `target/debug/drop-example`
CustomSmartPointers created
Dropping CustomSmartPointer with data `other stuff`!
Dropping CustomSmartPointer with data `my stuff`!
Rust ได้เรียกใช้ drop ให้เราโดยอัตโนมัติเมื่ออินสแตนซ์หลุดออกจากขอบเขต โดยรันโค้ดตามที่เรากำหนดไว้ ตัวแปรต่าง ๆ จะถูกทิ้งตามลำดับย้อนกลับจากการสร้าง ดังนั้น d จึงถูกทิ้งก่อน c จุดประสงค์ของตัวอย่างนี้คือการแสดงให้เห็นภาพการทำงานของเมธอด drop อย่างเป็นรูปธรรม ซึ่งในการใช้งานจริงคุณจะใส่โค้ดสำหรับเก็บกวาดทรัพยากรที่จำเป็น แทนที่จะเป็นเพียงการพิมพ์ข้อความ
ทว่าการปิดใช้งานการทำงานอัตโนมัติของ drop นั้นไม่ใช่เรื่องที่จะทำได้โดยตรง ซึ่งโดยปกติแล้วการปิดการทำงานของ drop ก็ไม่มีความจำเป็นอยู่แล้ว เพราะจุดประสงค์หลักของเทรต Drop คือการดูแลเรื่องนี้ให้โดยอัตโนมัติ อย่างไรก็ตาม ในบางครั้งคุณอาจจำเป็นต้องเก็บกวาดค่าใดค่าหนึ่งก่อนเวลาอันควร ตัวอย่างเช่น การใช้สมาร์ตพอยน์เตอร์ที่คอยจัดการล็อก (locks) คุณอาจต้องการบังคับให้เมธอด drop ปลดล็อกทันที เพื่อให้โค้ดส่วนอื่นในขอบเขตเดียวกันสามารถเข้าถือครองล็อกต่อไปได้ Rust จะไม่อนุญาตให้คุณเรียกเมธอด drop ของเทรต Drop ด้วยตนเอง แต่คุณจะต้องเรียกใช้ฟังก์ชัน std::mem::drop ที่ไลบรารีมาตรฐานจัดเตรียมไว้ให้แทน หากคุณต้องการบังคับให้ค่านั้นถูกทิ้งก่อนที่จะสิ้นสุดขอบเขตของมัน
การพยายามเรียกเมธอด drop ของเทรต Drop ด้วยตัวเองโดยการแก้ไขฟังก์ชัน main จากลิสติ้ง 15-14 จะไม่ทำงาน ดังที่แสดงในลิสติ้ง 15-15
struct CustomSmartPointer {
data: String,
}
impl Drop for CustomSmartPointer {
fn drop(&mut self) {
println!("Dropping CustomSmartPointer with data `{}`!", self.data);
}
}
fn main() {
let c = CustomSmartPointer {
data: String::from("some data"),
};
println!("CustomSmartPointer created");
c.drop();
println!("CustomSmartPointer dropped before the end of main");
}เมื่อเราพยายามคอมไพล์โค้ดนี้ เราจะได้ข้อผิดพลาดนี้:
$ cargo run
Compiling drop-example v0.1.0 (file:///projects/drop-example)
error[E0040]: explicit use of destructor method
--> src/main.rs:16:7
|
16 | c.drop();
| ^^^^ explicit destructor calls not allowed
|
help: consider using `drop` function
|
16 - c.drop();
16 + drop(c);
|
For more information about this error, try `rustc --explain E0040`.
error: could not compile `drop-example` (bin "drop-example") due to 1 previous error
ข้อความแสดงข้อผิดพลาดนี้ระบุชัดเจนว่าเราไม่ได้รับอนุญาตให้เรียกใช้ drop อย่างโจ่งแจ้งด้วยตนเอง โดยข้อความนี้ใช้คำว่า destructor ซึ่งเป็นคำศัพท์ทั่วไปในการเขียนโปรแกรมสำหรับฟังก์ชันที่ทำหน้าที่เก็บกวาดทำลายอินสแตนซ์ คำว่า destructor เปรียบได้กับคู่ตรงข้ามของ constructor ที่ทำหน้าที่สร้างอินสแตนซ์ขึ้นมา โดยฟังก์ชัน drop ใน Rust ก็จัดเป็น destructor รูปแบบหนึ่งนั่นเอง
สาเหตุที่ Rust ไม่อนุญาตให้เราเรียกใช้ drop ด้วยตนเอง ก็เพราะ Rust จะยังคงเรียกใช้ drop กับค่านั้นโดยอัตโนมัติเมื่อสิ้นสุดฟังก์ชัน main อยู่ดี ซึ่งจะนำไปสู่ข้อผิดพลาด double free (การพยายามปลดปล่อยหน่วยความจำซ้ำซ้อน) เนื่องจาก Rust พยายามจะเก็บกวาดค่าเดิมถึงสองครั้ง
ในเมื่อเราไม่สามารถปิดการแทรกคำสั่ง drop อัตโนมัติเมื่อค่าหลุดออกจากขอบเขตได้ และไม่สามารถเรียกเมธอด drop ด้วยตนเองได้ ดังนั้นหากเราจำเป็นต้องบังคับให้เก็บกวาดค่าหนึ่งก่อนเวลาจริง ๆ เราจึงต้องใช้งานฟังก์ชัน std::mem::drop
ฟังก์ชัน std::mem::drop แตกต่างจากเมธอด drop ในเทรต Drop เราเรียกมันโดยส่งค่าที่ต้องการบังคับให้ทิ้งเป็นอาร์กิวเมนต์ ฟังก์ชันนี้อยู่ในพรีลูด เราจึงแก้ไข main ในลิสติ้ง 15-15 ให้เรียกฟังก์ชัน drop ได้ ดังที่แสดงในลิสติ้ง 15-16
struct CustomSmartPointer {
data: String,
}
impl Drop for CustomSmartPointer {
fn drop(&mut self) {
println!("Dropping CustomSmartPointer with data `{}`!", self.data);
}
}
fn main() {
let c = CustomSmartPointer {
data: String::from("some data"),
};
println!("CustomSmartPointer created");
drop(c);
println!("CustomSmartPointer dropped before the end of main");
}การรันโค้ดนี้จะพิมพ์ผลลัพธ์ต่อไปนี้:
$ cargo run
Compiling drop-example v0.1.0 (file:///projects/drop-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.73s
Running `target/debug/drop-example`
CustomSmartPointer created
Dropping CustomSmartPointer with data `some data`!
CustomSmartPointer dropped before the end of main
ข้อความ Dropping CustomSmartPointer with data `some data`! ถูกพิมพ์คั่นอยู่ระหว่างข้อความ CustomSmartPointer created และ CustomSmartPointer dropped before the end of main ซึ่งแสดงให้เห็นว่าโค้ดของเมธอด drop ถูกเรียกเพื่อทิ้งค่า c ณ ตำแหน่งนั้นทันที
คุณสามารถนำโค้ดที่กำหนดไว้ในการอิมพลีเมนต์เทรต Drop ไปประยุกต์ใช้งานได้หลากหลายรูปแบบ เพื่อให้การเก็บกวาดทรัพยากรทำได้อย่างสะดวกและปลอดภัย ตัวอย่างเช่น คุณอาจใช้มันเพื่อสร้างตัวจัดสรรหน่วยความจำ (memory allocator) ขึ้นมาใช้เอง! ด้วยเทรต Drop ร่วมกับระบบความเป็นเจ้าของ (ownership) ของ Rust คุณจึงไม่ต้องคอยจำว่าต้องเก็บกวาดทรัพยากรเมื่อใด เพราะ Rust จะจัดการทุกอย่างให้โดยอัตโนมัติ
นอกจากนี้ คุณยังไม่ต้องกังวลกับปัญหาที่เกิดจากการเผลอไปเก็บกวาดค่าที่ยังถูกใช้งานอยู่ เพราะระบบความเป็นเจ้าของที่คอยดูแลให้เรเฟอเรนซ์มีความถูกต้องสมบูรณ์อยู่เสมอนั้น ยังรับประกันด้วยว่า drop จะถูกเรียกเพียงครั้งเดียวเมื่อค่านั้นไม่มีการใช้งานอีกต่อไปแล้วเท่านั้น
หลังจากที่เราได้ศึกษา Box<T> และคุณลักษณะสำคัญของสมาร์ตพอยน์เตอร์ไปแล้ว ต่อไปเรามาดูสมาร์ตพอยน์เตอร์ตัวอื่น ๆ ที่น่าสนใจในไลบรารีมาตรฐานกันต่อ
Rc<T> สมาร์ตพอยน์เตอร์แบบนับจำนวนเรเฟอเรนซ์
Rc<T> สมาร์ตพอยน์เตอร์แบบนับจำนวนเรเฟอเรนซ์
ในกรณีส่วนใหญ่ ความเป็นเจ้าของ (ownership) มีความชัดเจน กล่าวคือคุณจะรู้ได้อย่างแน่ชัดว่าตัวแปรใดเป็นเจ้าของค่าข้อมูลนั้น ๆ อย่างไรก็ตาม มีบางกรณีที่ค่าข้อมูลเพียงค่าเดียวอาจมีเจ้าของหลายรายพร้อมกันได้ ตัวอย่างเช่น ในโครงสร้างข้อมูลแบบกราฟ เส้นเชื่อมหลายเส้นอาจชี้ไปยังโหนดเดียวกัน และในทางมโนทัศน์แล้ว โหนดดังกล่าวจะถือว่าถูกครอบครองโดยเส้นเชื่อมทั้งหมดที่ชี้มายังมัน ดังนั้นโหนดจึงไม่ควรถูกทำลายหรือเก็บกวาด เว้นแต่ว่าจะไม่มีเส้นเชื่อมใด ๆ ชี้มายังมันอีกแล้ว และกลายเป็นโหนดที่ไม่มีเจ้าของหลงเหลืออยู่
คุณจำเป็นต้องเปิดใช้งานการเป็นเจ้าของร่วมหลายรายอย่างชัดแจ้ง โดยใช้ชนิดข้อมูล Rc<T> ของ Rust ซึ่งย่อมาจาก การนับจำนวนการอ้างอิง (reference counting) ชนิดข้อมูล Rc<T> จะคอยติดตามจำนวนเรเฟอเรนซ์ที่ชี้ไปยังค่าหนึ่ง ๆ เพื่อตรวจสอบว่าค่านั้นยังถูกใช้งานอยู่หรือไม่ หากไม่มีเรเฟอเรนซ์ใดชี้ไปยังค่านั้นแล้ว (จำนวนการอ้างอิงเป็นศูนย์) ค่านั้นก็จะถูกคืนหน่วยความจำและเก็บกวาดให้โดยอัตโนมัติ โดยไม่ส่งผลให้เรเฟอเรนซ์ใด ๆ กลายเป็นเรเฟอเรนซ์ที่ไม่ถูกต้อง
ลองจินตนาการว่า Rc<T> เปรียบเสมือนโทรทัศน์ในห้องนั่งเล่นของครอบครัว เมื่อมีคนแรกเดินเข้ามาดูทีวี เขาก็จะเปิดมันขึ้นมา คนอื่น ๆ ก็สามารถเดินเข้ามาในห้องและร่วมดูทีวีเครื่องเดียวกันได้ และเมื่อคนสุดท้ายเดินออกจากห้องไป เขาก็จะปิดทีวีเพราะไม่มีใครดูอีกแล้ว หากมีใครไปปิดทีวีในขณะที่คนอื่น ๆ ยังคงนั่งดูอยู่ ก็ย่อมเกิดเสียงโวยวายจากผู้ชมที่เหลืออย่างแน่นอน!
เราเลือกใช้ชนิดข้อมูล Rc<T> เมื่อเราต้องการจัดสรรข้อมูลไว้บนฮีปเพื่อให้หลายส่วนของโปรแกรมสามารถอ่านได้ร่วมกัน และเราไม่สามารถระบุได้ตั้งแต่ตอนคอมไพล์ว่าส่วนใดจะเลิกใช้งานข้อมูลนั้นเป็นส่วนสุดท้าย หากเราทราบแน่ชัดว่าส่วนใดจะทำงานเสร็จสิ้นเป็นลำดับสุดท้าย เราก็เพียงแค่กำหนดให้ส่วนนั้นเป็นเจ้าของข้อมูล และให้กฎความเป็นเจ้าของตามปกติที่ตรวจสอบในขณะคอมไพล์ทำงานไปตามเดิม
โปรดทราบว่า Rc<T> มีไว้สำหรับใช้งานในบริบทแบบเธรดเดียว (single-threaded) เท่านั้น เมื่อเราพูดถึงการทำงานพร้อมกัน (concurrency) ในบทที่ 16 เราจะได้เรียนรู้วิธีการนับจำนวนการอ้างอิงในโปรแกรมที่ทำงานแบบหลายเธรด
การแชร์ข้อมูล
ลองกลับมาดูตัวอย่าง cons list ในลิสติ้ง 15-5 กันอีกครั้ง จำได้ไหมว่าเราเคยนิยามมันโดยใช้ Box<T> คราวนี้เราจะสร้างลิสต์สองชุดที่แชร์ความเป็นเจ้าของลิสต์ชุดที่สามร่วมกัน ในเชิงมโนทัศน์แล้ว โครงสร้างนี้จะมีหน้าตาคล้ายกับรูปที่ 15-3
รูปที่ 15-3: ลิสต์สองลิสต์ คือ b และ c ที่แชร์ความเป็นเจ้าของลิสต์ที่สามคือ a
เราจะสร้างลิสต์ a ที่เก็บค่า 5 แล้วตามด้วย 10 จากนั้นเราจะสร้างลิสต์ขึ้นมาอีกสองชุด ได้แก่ b ที่เริ่มต้นด้วย 3 และ c ที่เริ่มต้นด้วย 4 โดยทั้งลิสต์ b และ c จะเชื่อมต่อไปยังลิสต์ a แรกที่เก็บ 5 และ 10 กล่าวอีกนัยหนึ่งก็คือ ทั้งสองลิสต์จะแชร์ลิสต์ตัวแรกที่เก็บค่า 5 และ 10 ร่วมกัน
การพยายามอิมพลีเมนต์สถานการณ์นี้โดยใช้นิยาม List ของเรากับ Box<T> จะใช้ไม่ได้ ดังที่แสดงในลิสติ้ง 15-17
enum List {
Cons(i32, Box<List>),
Nil,
}
use crate::List::{Cons, Nil};
fn main() {
let a = Cons(5, Box::new(Cons(10, Box::new(Nil))));
let b = Cons(3, Box::new(a));
let c = Cons(4, Box::new(a));
}เมื่อเราคอมไพล์โค้ดนี้ เราจะได้ข้อผิดพลาดนี้:
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
error[E0382]: use of moved value: `a`
--> src/main.rs:11:30
|
9 | let a = Cons(5, Box::new(Cons(10, Box::new(Nil))));
| - move occurs because `a` has type `List`, which does not implement the `Copy` trait
10 | let b = Cons(3, Box::new(a));
| - value moved here
11 | let c = Cons(4, Box::new(a));
| ^ value used here after move
|
note: if `List` implemented `Clone`, you could clone the value
--> src/main.rs:1:1
|
1 | enum List {
| ^^^^^^^^^ consider implementing `Clone` for this type
...
10 | let b = Cons(3, Box::new(a));
| - you could clone this value
For more information about this error, try `rustc --explain E0382`.
error: could not compile `cons-list` (bin "cons-list") due to 1 previous error
วาเรียนต์ Cons เป็นเจ้าของข้อมูลที่มันบรรจุอยู่ ดังนั้นเมื่อเราสร้างลิสต์ b ค่า a จึงถูกย้าย (move) เข้าไปอยู่ใน b และ b จะกลายเป็นเจ้าของ a จากนั้น เมื่อเราพยายามนำ a กลับมาใช้อีกครั้งตอนสร้าง c คอมไพเลอร์จึงไม่อนุญาตเนื่องจาก a ถูกย้ายไปเรียบร้อยแล้ว
เราอาจปรับเปลี่ยนนิยามของ Cons ให้เก็บเรเฟอเรนซ์แทนได้ แต่ก็จะต้องระบุพารามิเตอร์ไลฟ์ไทม์ (lifetime parameters) เพิ่มเติม ซึ่งการระบุพารามิเตอร์ไลฟ์ไทม์จะเป็นการบังคับว่าทุก ๆ สมาชิกในลิสต์จะต้องมีช่วงชีวิตยืนยาวอย่างน้อยเท่ากับลิสต์ทั้งชุด แม้ว่าในลิสติ้ง 15-17 สมาชิกและลิสต์จะมีอายุยืนยาวเช่นนั้นจริง แต่มันก็ไม่ได้เป็นเช่นนั้นเสมอไปในทุกสถานการณ์
แต่เราจะเปลี่ยนนิยามของ List ให้มาใช้ Rc<T> แทน Box<T> ดังที่แสดงในลิสติ้ง 15-18 โดยในตอนนี้วาเรียนต์ Cons แต่ละตัวจะเก็บค่าข้อมูลหนึ่งค่าและ Rc<T> ที่ชี้ไปยัง List และเมื่อเราสร้าง b แทนที่จะเป็นการยึดครองสิทธิ์ความเป็นเจ้าของของ a เราจะทำการโคลน (clone) ตัว Rc<List> ที่ a ถืออยู่ ซึ่งการทำเช่นนี้จะเพิ่มจำนวนการอ้างอิงจากหนึ่งเป็นสอง และเปิดให้ทั้ง a และ b แชร์ความเป็นเจ้าของข้อมูลใน Rc<List> นั้นร่วมกัน นอกจากนี้เรายังโคลน a อีกครั้งตอนสร้าง c ซึ่งจะเพิ่มจำนวนการอ้างอิงจากสองเป็นสาม ทุกครั้งที่เราเรียกใช้ Rc::clone จำนวนการอ้างอิงของข้อมูลภายใน Rc<List> จะเพิ่มขึ้นทีละหนึ่ง และข้อมูลนั้นจะไม่มีทางถูกคืนหน่วยความจำ เว้นแต่ว่าจำนวนการอ้างอิงจะลดลงจนเหลือศูนย์
enum List {
Cons(i32, Rc<List>),
Nil,
}
use crate::List::{Cons, Nil};
use std::rc::Rc;
fn main() {
let a = Rc::new(Cons(5, Rc::new(Cons(10, Rc::new(Nil)))));
let b = Cons(3, Rc::clone(&a));
let c = Cons(4, Rc::clone(&a));
}เราจำเป็นต้องเพิ่มคำสั่ง use เพื่อนำ Rc<T> เข้าสู่ขอบเขตการทำงาน เนื่องจากมันไม่ได้รวมอยู่ในพรีลูด (prelude) ในฟังก์ชัน main เราสร้างลิสต์ที่เก็บ 5 และ 10 แล้วจัดเก็บไว้ใน Rc<List> ตัวใหม่ในตัวแปร a จากนั้นเมื่อเราสร้าง b และ c เราจะเรียกฟังก์ชัน Rc::clone โดยส่งเรเฟอเรนซ์ที่ชี้ไปยัง Rc<List> ใน a เข้าไปเป็นอาร์กิวเมนต์
จริง ๆ แล้วเราสามารถเขียน a.clone() แทน Rc::clone(&a) ได้ แต่ธรรมเนียมปฏิบัติของชาว Rust คือการใช้ Rc::clone ในกรณีเช่นนี้ เนื่องจากการอิมพลีเมนต์ของ Rc::clone ไม่ได้ทำการคัดลอกข้อมูลทั้งหมดอย่างลึกซึ้ง (deep copy) เหมือนที่การอิมพลีเมนต์ clone ของชนิดข้อมูลส่วนใหญ่ทำ การเรียก Rc::clone ทำหน้าที่เพียงแค่เพิ่มตัวเลขนับจำนวนการอ้างอิงเท่านั้น ซึ่งใช้เวลาในการทำงานน้อยมาก ในขณะที่การทำ deep copy อาจใช้เวลาและทรัพยากรสูง การใช้ Rc::clone สำหรับการนับจำนวนการอ้างอิงจึงช่วยให้เราแยกแยะความแตกต่างระหว่างการโคลนแบบคัดลอกข้อมูลทั้งหมด กับการโคลนเพื่อเพิ่มตัวนับการอ้างอิงได้อย่างชัดเจน เมื่อเราตรวจสอบโค้ดเพื่อหาคอขวดด้านประสิทธิภาพ เราจึงพิจารณาเฉพาะการโคลนแบบ deep copy และสามารถมองข้ามการเรียก Rc::clone ไปได้เลย
การโคลนเพื่อเพิ่มจำนวนเรเฟอเรนซ์
ลองมาปรับเปลี่ยนโค้ดตัวอย่างในลิสติ้ง 15-18 เพื่อให้เราเห็นการเปลี่ยนแปลงของจำนวนการอ้างอิงอย่างชัดเจน ในขณะที่เราสร้างและทิ้ง (drop) การอ้างอิงไปยัง Rc<List> ใน a
ในลิสติ้ง 15-19 เราจะแก้ไขฟังก์ชัน main โดยสร้างขอบเขตชั้นใน (inner scope) ครอบตัวแปรลิสต์ c เอาไว้ เพื่อให้เห็นว่าจำนวนการอ้างอิงเปลี่ยนแปลงไปอย่างไรเมื่อ c หลุดออกจากขอบเขต
enum List {
Cons(i32, Rc<List>),
Nil,
}
use crate::List::{Cons, Nil};
use std::rc::Rc;
// --snip--
fn main() {
let a = Rc::new(Cons(5, Rc::new(Cons(10, Rc::new(Nil)))));
println!("count after creating a = {}", Rc::strong_count(&a));
let b = Cons(3, Rc::clone(&a));
println!("count after creating b = {}", Rc::strong_count(&a));
{
let c = Cons(4, Rc::clone(&a));
println!("count after creating c = {}", Rc::strong_count(&a));
}
println!("count after c goes out of scope = {}", Rc::strong_count(&a));
}ในแต่ละจุดของโปรแกรมที่มีการเปลี่ยนแปลงจำนวนการอ้างอิง เราจะพิมพ์จำนวนการอ้างอิงออกมา ซึ่งได้มาจากการเรียกฟังก์ชัน Rc::strong_count สาเหตุที่ฟังก์ชันนี้ใช้ชื่อว่า strong_count แทนที่จะเป็น count ธรรมดา ก็เพราะชนิดข้อมูล Rc<T> ยังมีฟังก์ชัน weak_count อยู่อีกตัวหนึ่งด้วย ซึ่งเราจะได้เห็นว่า weak_count นำไปใช้งานอย่างไรในหัวข้อ “การป้องกันวงจรเรเฟอเรนซ์ด้วย Weak<T>”
โค้ดนี้พิมพ์ผลลัพธ์ต่อไปนี้:
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.45s
Running `target/debug/cons-list`
count after creating a = 1
count after creating b = 2
count after creating c = 3
count after c goes out of scope = 2
เราจะเห็นว่า Rc<List> ใน a เริ่มต้นด้วยจำนวนการอ้างอิงเท่ากับ 1 จากนั้นทุกครั้งที่เราเรียก clone จำนวนนับก็จะเพิ่มขึ้นทีละ 1 และเมื่อ c หลุดออกจากขอบเขต จำนวนนับก็จะลดลง 1 เราไม่จำเป็นต้องเรียกใช้ฟังก์ชันเพื่อลดจำนวนการอ้างอิงเหมือนอย่างที่เราต้องเรียก Rc::clone เพื่อเพิ่มจำนวนนับ เนื่องจากการอิมพลีเมนต์เทรต Drop จะช่วยลดจำนวนการอ้างอิงให้โดยอัตโนมัติเมื่อค่า Rc<T> หลุดออกจากขอบเขต
สิ่งที่ไม่ได้แสดงให้เห็นในเอาต์พุตของตัวอย่างนี้ก็คือ เมื่อ b และตามด้วย a หลุดออกจากขอบเขตเมื่อสิ้นสุดฟังก์ชัน main จำนวนการอ้างอิงจะกลายเป็น 0 และ Rc<List> ก็จะถูกคืนหน่วยความจำและเก็บกวาดไปอย่างสมบูรณ์ การใช้ Rc<T> ช่วยให้ค่าข้อมูลค่าเดียวสามารถมีเจ้าของหลายรายได้ และตัวนับการอ้างอิงนี้จะคอยรับประกันว่าค่านั้นจะยังคงใช้งานได้อยู่เสมอ ตราบใดที่ยังมีเจ้าของรายใดรายหนึ่งยังคงอยู่
การแชร์ข้อมูลผ่าน Rc<T> นั้นเป็นการแชร์ข้อมูลผ่านเรเฟอเรนซ์แบบแก้ไขไม่ได้ (immutable reference) ซึ่งเปิดให้หลายส่วนของโปรแกรมอ่านข้อมูลร่วมกันได้เท่านั้น หาก Rc<T> อนุญาตให้เรามีเรเฟอเรนซ์แบบแก้ไขได้หลายตัวพร้อมกัน ก็อาจจะละเมิดกฎการยืมข้อสำคัญที่เราพูดถึงในบทที่ 4 ซึ่งระบุว่า การยืมแบบแก้ไขได้หลายจุดในตำแหน่งเดียวกันอาจทำให้เกิดการแย่งชิงข้อมูล (data race) และความไม่สอดคล้องกันของข้อมูลได้ แต่ความสามารถในการแก้ไขข้อมูลได้นั้นมีประโยชน์อย่างยิ่ง! ในหัวข้อถัดไป เราจะมาพูดคุยกันถึงรูปแบบความสามารถในการเปลี่ยนแปลงค่าภายใน (interior mutability) และชนิดข้อมูล RefCell<T> ซึ่งคุณสามารถนำมาใช้งานร่วมกับ Rc<T> เพื่อก้าวข้ามข้อจำกัดเรื่องการไม่สามารถแก้ไขค่านี้ได้
RefCell<T> และแพตเทิร์นการเปลี่ยนแปลงค่าภายใน
RefCell<T> และแพตเทิร์นการเปลี่ยนแปลงค่าภายใน
ความสามารถในการเปลี่ยนแปลงค่าภายใน (interior mutability) เป็นรูปแบบการออกแบบ (design pattern) ใน Rust ที่ช่วยให้คุณสามารถแก้ไขข้อมูลได้ แม้ว่าจะมีเรเฟอเรนซ์แบบแก้ไขไม่ได้ (immutable references) ชี้ไปยังข้อมูลนั้นอยู่ก็ตาม ซึ่งตามปกติแล้วการกระทำเช่นนี้จะถูกห้ามโดยกฎการยืม ในการแก้ไขข้อมูล รูปแบบนี้จะใช้โค้ด unsafe ภายในโครงสร้างข้อมูลเพื่อผ่อนปรนกฎเกณฑ์ตามปกติของ Rust ที่ควบคุมการแก้ไขข้อมูลและการยืม โค้ด unsafe จะเป็นการส่งสัญญาณบอกคอมไพเลอร์ว่าเรากำลังตรวจสอบกฎเกณฑ์ต่าง ๆ ด้วยตนเอง แทนที่จะพึ่งพาให้คอมไพเลอร์ตรวจสอบให้เรา โดยเราจะพูดถึงโค้ด unsafe กันอย่างละเอียดมากขึ้นในบทที่ 20
เราสามารถเลือกใช้ชนิดข้อมูลที่ใช้รูปแบบการเปลี่ยนแปลงค่าภายในได้ ก็ต่อเมื่อเรามั่นใจได้ว่ากฎการยืมจะได้รับการปฏิบัติตามอย่างถูกต้องในขณะรันไทม์ แม้ว่าคอมไพเลอร์จะไม่สามารถรับประกันสิ่งนั้นในขณะคอมไพล์ได้ก็ตาม โดยโค้ด unsafe ที่เกี่ยวข้องจะถูกห่อหุ้มไว้ภายใน API ที่ปลอดภัย ทำให้ชนิดข้อมูลภายนอกยังคงมีสถานะเป็นชนิดข้อมูลที่แก้ไขไม่ได้ตามปกติ
เรามาลองสำรวจแนวคิดนี้ผ่านชนิดข้อมูล RefCell<T> ซึ่งนำรูปแบบการเปลี่ยนแปลงค่าภายในมาใช้งานกัน
การบังคับใช้กฎการยืมตอนรันไทม์
สิ่งที่ต่างจาก Rc<T> คือ ชนิดข้อมูล RefCell<T> แสดงถึงความเป็นเจ้าของเพียงรายเดียว (single ownership) เหนือข้อมูลที่มันถืออยู่ แล้วอะไรที่ทำให้ RefCell<T> แตกต่างจากชนิดข้อมูลอย่าง Box<T>? ลองนึกย้อนกลับไปถึงกฎการยืมที่คุณได้เรียนรู้ในบทที่ 4:
- ในเวลาใดเวลาหนึ่ง คุณสามารถมีเรเฟอเรนซ์แบบแก้ไขได้เพียงหนึ่งตัว หรือ เรเฟอเรนซ์แบบแก้ไขไม่ได้กี่ตัวก็ได้ (แต่ต้องไม่ใช่ทั้งสองแบบพร้อมกัน)
- เรเฟอเรนซ์ต้องถูกต้องและชี้ไปยังข้อมูลที่ยังมีอยู่เสมอ (valid)
สำหรับเรเฟอเรนซ์ทั่วไปและ Box<T> เงื่อนไขคงที่ (invariants) ของกฎการยืมจะถูกบังคับใช้ตั้งแต่ตอนคอมไพล์ แต่สำหรับ RefCell<T> เงื่อนไขเหล่านี้จะถูกตรวจสอบและบังคับใช้_ในขณะรันไทม์_ หากคุณละเมิดกฎเหล่านี้เมื่อใช้เรเฟอเรนซ์ทั่วไป คุณจะได้รับข้อผิดพลาดจากคอมไพเลอร์ แต่หากคุณละเมิดกฎเหล่านี้เมื่อใช้ RefCell<T> โปรแกรมของคุณจะแพนิก (panic!) และยุติการทำงานลงทันที
ข้อดีของการตรวจสอบกฎการยืมในขั้นตอนคอมไพล์คือ ข้อผิดพลาดจะถูกตรวจพบได้อย่างรวดเร็วตั้งแต่ในกระบวนการพัฒนา และไม่มีต้นทุนสูญเปล่าด้านประสิทธิภาพในขณะรันไทม์ เพราะการวิเคราะห์ทั้งหมดได้เสร็จสิ้นล่วงหน้าไปแล้ว ด้วยเหตุผลเหล่านี้ การตรวจสอบกฎการยืมตอนคอมไพล์จึงเป็นทางเลือกที่ดีที่สุดในกรณีส่วนใหญ่ และเป็นเหตุผลว่าทำไม Rust จึงกำหนดให้สิ่งนี้เป็นพฤติกรรมเริ่มต้น
ส่วนข้อดีของการตรวจสอบกฎการยืมในขณะรันไทม์ก็คือ มันจะเปิดโอกาสให้สามารถทำบางสิ่งที่ปลอดภัยต่อหน่วยความจำได้ ซึ่งหากเป็นการตรวจสอบในขณะคอมไพล์อาจจะไม่อนุญาต เนื่องจากการวิเคราะห์โค้ดแบบสถิต (static analysis) เช่นเดียวกับที่คอมไพเลอร์ของ Rust ทำนั้น โดยเนื้อแท้แล้วจำเป็นต้องระมัดระวังเป็นพิเศษ (conservative) เพราะมีคุณสมบัติบางประการของโค้ดที่ไม่สามารถตรวจจับได้ผ่านการวิเคราะห์โค้ด ตัวอย่างที่โด่งดังที่สุดคือปัญหาการยุติการทำงาน (Halting Problem) ซึ่งอยู่นอกเหนือขอบเขตของหนังสือเล่มนี้ แต่นับเป็นหัวข้อที่น่าสนใจอย่างยิ่ง
เนื่องจากการวิเคราะห์บางอย่างเป็นไปไม่ได้ในทางทฤษฎี หากคอมไพเลอร์ของ Rust ไม่มั่นใจว่าโค้ดนั้นปฏิบัติตามกฎความเป็นเจ้าของอย่างสมบูรณ์ มันก็อาจจะปฏิเสธโปรแกรมที่เขียนมาอย่างถูกต้องได้ ซึ่งในแง่นี้ถือว่าคอมไพเลอร์เลือกที่จะปลอดภัยไว้ก่อน เพราะหาก Rust ยอมรับโปรแกรมที่มีข้อผิดพลาด ผู้ใช้ก็จะไม่สามารถเชื่อถือการรับประกันความปลอดภัยของ Rust ได้อีกต่อไป ทว่าหาก Rust ปฏิเสธโปรแกรมที่ทำงานถูกต้อง แม้นักพัฒนาจะรู้สึกไม่สะดวกสบาย แต่ก็ไม่มีความเสียหายร้ายแรงใด ๆ เกิดขึ้นกับระบบ ชนิดข้อมูล RefCell<T> จึงมีประโยชน์อย่างยิ่งเมื่อคุณมั่นใจว่าโค้ดของคุณปฏิบัติตามกฎการยืมอย่างแน่นอน แต่คอมไพเลอร์ไม่ฉลาดพอที่จะเข้าใจและรับประกันสิ่งนั้นให้คุณได้
เช่นเดียวกับ Rc<T> ชนิดข้อมูล RefCell<T> มีไว้สำหรับใช้งานในบริบทแบบเธรดเดียว (single-threaded) เท่านั้น และจะเกิดข้อผิดพลาดในการคอมไพล์ทันทีหากคุณพยายามนำมันไปใช้ในงานแบบหลายเธรด โดยเราจะพูดถึงวิธีการนำความสามารถของ RefCell<T> ไปใช้ในโปรแกรมแบบหลายเธรดในบทที่ 16
นี่คือข้อสรุปในการเลือกระหว่าง Box<T>, Rc<T> หรือ RefCell<T>:
Rc<T>เปิดให้ข้อมูลเดียวกันมีเจ้าของได้หลายราย ส่วนBox<T>และRefCell<T>มีเจ้าของได้เพียงรายเดียวBox<T>อนุญาตให้มีการยืมแบบแก้ไขไม่ได้หรือแก้ไขได้ โดยตรวจสอบในขั้นตอนคอมไพล์ ส่วนRc<T>อนุญาตเฉพาะการยืมแบบแก้ไขไม่ได้ที่ตรวจสอบตอนคอมไพล์ และRefCell<T>อนุญาตให้มีการยืมแบบแก้ไขไม่ได้หรือแก้ไขได้ โดยตรวจสอบในขณะรันไทม์- เนื่องจาก
RefCell<T>อนุญาตให้มีการยืมแบบแก้ไขได้ที่ตรวจสอบในขณะรันไทม์ คุณจึงสามารถแก้ไขค่าที่อยู่ภายในRefCell<T>ได้ แม้ว่าตัวแปรRefCell<T>นั้นจะมีสถานะเป็นค่าที่แก้ไขไม่ได้ก็ตาม
การแก้ไขค่าที่อยู่ภายในค่าที่ไม่สามารถแก้ไขได้นี้ก็คือ รูปแบบความสามารถในการเปลี่ยนแปลงค่าภายใน (interior mutability pattern) เรามาดูสถานการณ์ที่รูปแบบนี้มีประโยชน์และศึกษาว่ามันทำงานได้อย่างไร
การใช้การเปลี่ยนแปลงค่าภายใน
ผลสืบเนื่องจากกฎการยืมก็คือ เมื่อคุณมีค่าที่ไม่สามารถแก้ไขได้ คุณจะไม่สามารถขอยืมค่านั้นแบบแก้ไขได้ ตัวอย่างเช่น โค้ดต่อไปนี้จะคอมไพล์ไม่ผ่าน:
fn main() {
let x = 5;
let y = &mut x;
}หากคุณลองคอมไพล์โค้ดนี้ คุณจะพบกับข้อผิดพลาดต่อไปนี้:
$ cargo run
Compiling borrowing v0.1.0 (file:///projects/borrowing)
error[E0596]: cannot borrow `x` as mutable, as it is not declared as mutable
--> src/main.rs:3:13
|
3 | let y = &mut x;
| ^^^^^^ cannot borrow as mutable
|
help: consider changing this to be mutable
|
2 | let mut x = 5;
| +++
For more information about this error, try `rustc --explain E0596`.
error: could not compile `borrowing` (bin "borrowing") due to 1 previous error
อย่างไรก็ตาม มีบางสถานการณ์ที่จะเป็นประโยชน์อย่างมากหากค่าหนึ่งสามารถปรับปรุงแก้ไขตัวเองภายในเมธอดของมันได้ แต่ยังคงแสดงตัวเป็นค่าที่แก้ไขไม่ได้ต่อโค้ดภายนอก โดยโค้ดภายนอกจะไม่สามารถแก้ไขค่านั้นได้เลย การใช้ RefCell<T> เป็นวิธีหนึ่งที่ช่วยให้ได้มาซึ่งความสามารถในการเปลี่ยนแปลงค่าภายในนี้ แต่ RefCell<T> ก็ไม่ได้หลบเลี่ยงกฎการยืมอย่างสิ้นเชิง ตัวตรวจสอบการยืม (borrow checker) ในคอมไพเลอร์จะยอมผ่อนปรนให้เกิดการเปลี่ยนแปลงค่าภายในได้ และกฎการยืมจะถูกนำไปตรวจสอบในขณะรันไทม์แทน หากคุณละเมิดกฎ คุณจะได้รับคำสั่ง panic! แทนที่จะเป็นข้อผิดพลาดจากคอมไพเลอร์
เรามาลองดูตัวอย่างการใช้งานจริงที่เราสามารถใช้ RefCell<T> เพื่อแก้ไขค่าที่ไม่สามารถแก้ไขได้ และดูว่าทำไมสิ่งนี้จึงมีประโยชน์
การทดสอบด้วยม็อกออบเจกต์
บางครั้งในระหว่างการทดสอบ นักพัฒนามักจะใช้ชนิดข้อมูลจำลองขึ้นมาแทนที่ชนิดข้อมูลจริง เพื่อคอยสังเกตพฤติกรรมเฉพาะเจาะจงและตรวจสอบยืนยันว่าโค้ดได้รับการอิมพลีเมนต์อย่างถูกต้อง ชนิดข้อมูลตัวแทนนี้เรียกว่า ตัวแทนทดสอบ (test double) เปรียบได้กับตัวแสดงแทน (stunt double) ในการถ่ายทำภาพยนตร์ ที่จะมีคนเข้ามาแสดงแทนดารานำในฉากที่ยากหรืออันตรายเป็นพิเศษ ตัวแทนทดสอบจะทำหน้าที่เป็นตัวแสดงแทนให้กับชนิดข้อมูลอื่น ๆ เมื่อเรารันการทดสอบ โดย ม็อกออบเจกต์ (mock object) เป็นชนิดหนึ่งของตัวแทนทดสอบที่คอยบันทึกสิ่งที่เกิดขึ้นระหว่างการทดสอบ เพื่อให้คุณสามารถตรวจสอบยืนยันได้ว่าการทำงานต่าง ๆ เกิดขึ้นอย่างถูกต้องตรงตามที่คาดหมาย
Rust ไม่ได้มีแนวคิดของออบเจกต์ในความหมายเดียวกับที่ภาษาอื่นมี และ Rust ก็ไม่มีฟังก์ชันการทำงานของม็อกออบเจกต์สำเร็จรูปมาให้ในไลบรารีมาตรฐานเหมือนกับบางภาษา อย่างไรก็ตาม คุณสามารถสร้าง struct ขึ้นมาทำหน้าที่เช่นเดียวกับม็อกออบเจกต์ได้อย่างแน่นอน
นี่คือสถานการณ์จำลองที่เราจะใช้ทดสอบ: เราจะสร้างไลบรารีสำหรับติดตามค่าตัวเลขหนึ่งเปรียบเทียบกับค่าสูงสุด และส่งข้อความแจ้งเตือนตามระดับความใกล้ของค่าปัจจุบันเทียบกับค่าสูงสุด ตัวอย่างเช่น ไลบรารีนี้อาจนำไปใช้ติดตามโควตาการเรียกใช้งาน API ของผู้ใช้ที่ได้รับอนุญาต
ไลบรารีของเราจะทำหน้าที่เฉพาะการติดตามดูว่าค่าตัวเลขใกล้ถึงค่าสูงสุดเพียงใด และควรส่งข้อความอะไรในเวลาใด โดยแอปพลิเคชันที่นำไลบรารีของเราไปใช้จะต้องเป็นผู้จัดเตรียมกลไกในการส่งข้อความจริงเอง เช่น แอปพลิเคชันอาจแสดงข้อความบนหน้าจอ, ส่งอีเมล, ส่งข้อความ SMS หรืออื่น ๆ โดยที่ไลบรารีไม่จำเป็นต้องรับรู้รายละเอียดเหล่านั้น สิ่งที่ไลบรารีต้องการมีเพียงแค่บางสิ่งที่อิมพลีเมนต์เทรตที่เราเตรียมไว้ให้ ซึ่งมีชื่อว่า Messenger โดยลิสติ้ง 15-20 แสดงโค้ดของไลบรารีนี้
pub trait Messenger {
fn send(&self, msg: &str);
}
pub struct LimitTracker<'a, T: Messenger> {
messenger: &'a T,
value: usize,
max: usize,
}
impl<'a, T> LimitTracker<'a, T>
where
T: Messenger,
{
pub fn new(messenger: &'a T, max: usize) -> LimitTracker<'a, T> {
LimitTracker {
messenger,
value: 0,
max,
}
}
pub fn set_value(&mut self, value: usize) {
self.value = value;
let percentage_of_max = self.value as f64 / self.max as f64;
if percentage_of_max >= 1.0 {
self.messenger.send("Error: You are over your quota!");
} else if percentage_of_max >= 0.9 {
self.messenger
.send("Urgent warning: You've used up over 90% of your quota!");
} else if percentage_of_max >= 0.75 {
self.messenger
.send("Warning: You've used up over 75% of your quota!");
}
}
}หัวใจสำคัญส่วนหนึ่งของโค้ดนี้คือ เทรต Messenger จะมีเมธอดหนึ่งตัวชื่อ send ซึ่งรับเรเฟอเรนซ์แบบแก้ไขไม่ได้ที่ชี้ไปยัง self และข้อความที่จะส่ง เทรตนี้ทำหน้าที่เป็นอินเทอร์เฟซที่ม็อกออบเจกต์ของเราต้องอิมพลีเมนต์ เพื่อให้สามารถนำม็อกไปใช้งานได้ในลักษณะเดียวกับออบเจกต์จริง ส่วนสำคัญอีกประการคือ เราต้องการทดสอบพฤติกรรมของเมธอด set_value บน LimitTracker ซึ่งแม้ว่าเราจะสามารถเปลี่ยนค่าตัวเลขที่ส่งเข้าไปในพารามิเตอร์ value ได้ แต่ set_value ก็ไม่ได้ส่งคืนค่าใด ๆ ออกมาให้เราตรวจสอบเงื่อนไข (assertion) ได้โดยตรง สิ่งที่เราต้องการยืนยันก็คือ หากเราสร้าง LimitTracker ขึ้นมาโดยใช้บางสิ่งที่อิมพลีเมนต์เทรต Messenger และระบุค่า max ไว้ เมื่อเราส่งตัวเลข value ในระดับต่าง ๆ เข้าไป ตัวเมสเซนเจอร์จะถูกสั่งให้ส่งข้อความแจ้งเตือนที่ถูกต้องเหมาะสมออกมาหรือไม่
เราจึงต้องการม็อกออบเจกต์ที่เมื่อถูกเรียกใช้เมธอด send แทนที่จะส่งอีเมลหรือข้อความ SMS จริง ๆ มันจะทำเพียงแค่คอยบันทึกข้อความที่ได้รับคำสั่งให้ส่งเอาไว้ เราสามารถสร้างอินสแตนซ์ใหม่ของม็อกออบเจกต์, สร้าง LimitTracker ที่เรียกใช้ม็อกออบเจกต์นั้น, เรียกเมธอด set_value บน LimitTracker แล้วจึงตรวจสอบว่าม็อกออบเจกต์มีข้อความบันทึกไว้ตรงตามที่เราคาดหวังหรือไม่ ลิสติ้ง 15-21 แสดงความพยายามในการสร้างม็อกออบเจกต์ดังกล่าว แต่ตัวตรวจสอบการยืมของ Rust จะไม่อนุญาตให้โค้ดนี้ผ่านได้
pub trait Messenger {
fn send(&self, msg: &str);
}
pub struct LimitTracker<'a, T: Messenger> {
messenger: &'a T,
value: usize,
max: usize,
}
impl<'a, T> LimitTracker<'a, T>
where
T: Messenger,
{
pub fn new(messenger: &'a T, max: usize) -> LimitTracker<'a, T> {
LimitTracker {
messenger,
value: 0,
max,
}
}
pub fn set_value(&mut self, value: usize) {
self.value = value;
let percentage_of_max = self.value as f64 / self.max as f64;
if percentage_of_max >= 1.0 {
self.messenger.send("Error: You are over your quota!");
} else if percentage_of_max >= 0.9 {
self.messenger
.send("Urgent warning: You've used up over 90% of your quota!");
} else if percentage_of_max >= 0.75 {
self.messenger
.send("Warning: You've used up over 75% of your quota!");
}
}
}
#[cfg(test)]
mod tests {
use super::*;
struct MockMessenger {
sent_messages: Vec<String>,
}
impl MockMessenger {
fn new() -> MockMessenger {
MockMessenger {
sent_messages: vec![],
}
}
}
impl Messenger for MockMessenger {
fn send(&self, message: &str) {
self.sent_messages.push(String::from(message));
}
}
#[test]
fn it_sends_an_over_75_percent_warning_message() {
let mock_messenger = MockMessenger::new();
let mut limit_tracker = LimitTracker::new(&mock_messenger, 100);
limit_tracker.set_value(80);
assert_eq!(mock_messenger.sent_messages.len(), 1);
}
}โค้ดทดสอบนี้กำหนด struct MockMessenger ที่มีฟิลด์ sent_messages เป็นชนิด Vec<String> เพื่อคอยบันทึกข้อความที่ได้รับคำสั่งให้ส่ง นอกจากนี้เรายังนิยามฟังก์ชันที่สัมพันธ์กัน (associated function) new เพื่ออำนวยความสะดวกในการสร้างอินสแตนซ์ของ MockMessenger ใหม่ที่เริ่มต้นด้วยเวกเตอร์ว่างเปล่า จากนั้นเราอิมพลีเมนต์เทรต Messenger ให้กับ MockMessenger เพื่อให้สามารถส่ง MockMessenger ให้กับ LimitTracker ได้ และในการนิยามเมธอด send เรานำข้อความที่ส่งเข้ามาเป็นพารามิเตอร์ไปจัดเก็บไว้ในลิสต์ sent_messages ของ MockMessenger
ในส่วนของการทดสอบ เรากำลังทดสอบสถานการณ์ที่ LimitTracker ได้รับคำสั่งให้ตั้งค่า value เป็นค่าที่มากกว่า 75 เปอร์เซ็นต์ของค่า max ขั้นแรกเราสร้าง MockMessenger ตัวใหม่ขึ้นมา ซึ่งจะเริ่มต้นด้วยรายการข้อความที่ว่างเปล่า จากนั้นเราสร้าง LimitTracker ตัวใหม่โดยส่งเรเฟอเรนซ์ของ MockMessenger ใหม่นั้น และกำหนดค่า max เป็น 100 แล้วจึงเรียกเมธอด set_value บน LimitTracker ด้วยค่า 80 ซึ่งมากกว่า 75 เปอร์เซ็นต์ของ 100 หลังจากนั้นเราทำการยืนยันเงื่อนไข (assert) ว่ารายการข้อความที่ MockMessenger บันทึกไว้นั้นควรจะมีข้อความอยู่หนึ่งข้อความ
อย่างไรก็ตาม เกิดปัญหาขึ้นกับเทสต์นี้ ดังที่แสดงในข้อผิดพลาดต่อไปนี้:
$ cargo test
Compiling limit-tracker v0.1.0 (file:///projects/limit-tracker)
error[E0596]: cannot borrow `self.sent_messages` as mutable, as it is behind a `&` reference
--> src/lib.rs:58:13
|
58 | self.sent_messages.push(String::from(message));
| ^^^^^^^^^^^^^^^^^^ `self` is a `&` reference, so it cannot be borrowed as mutable
|
help: consider changing this to be a mutable reference in the `impl` method and the `trait` definition
|
2 ~ fn send(&mut self, msg: &str);
3 | }
...
56 | impl Messenger for MockMessenger {
57 ~ fn send(&mut self, message: &str) {
|
For more information about this error, try `rustc --explain E0596`.
error: could not compile `limit-tracker` (lib test) due to 1 previous error
เราไม่สามารถแก้ไขข้อมูลใน MockMessenger เพื่อบันทึกข้อความได้ เพราะเมธอด send รับเรเฟอเรนซ์แบบแก้ไขไม่ได้ที่ชี้ไปยัง self และเราก็ไม่สามารถทำตามคำแนะนำของข้อความผิดพลาดที่บอกให้เปลี่ยนไปใช้ &mut self ได้เช่นกัน เพราะนั่นจะต้องเปลี่ยนทั้งในบล็อก impl และในนิยามของเทรต ซึ่งเราไม่ต้องการแก้ไขนิยามของเทรต Messenger เพียงเพื่อการเขียนเทสต์เท่านั้น แต่เราจำเป็นต้องหาวิธีทำให้โค้ดทดสอบทำงานร่วมกับโครงสร้างเดิมที่มีอยู่ให้ได้
นี่แหละคือสถานการณ์ที่ความสามารถในการเปลี่ยนแปลงค่าภายในสามารถช่วยเราได้! โดยเราจะนำ sent_messages ไปเก็บไว้ภายใน RefCell<T> ซึ่งจะทำให้เมธอด send สามารถปรับปรุงแก้ไขข้อมูลใน sent_messages เพื่อบันทึกข้อความที่ได้รับเข้ามาได้ ลิสติ้ง 15-22 แสดงให้เห็นว่าโครงสร้างใหม่นี้มีหน้าตาเป็นอย่างไร
pub trait Messenger {
fn send(&self, msg: &str);
}
pub struct LimitTracker<'a, T: Messenger> {
messenger: &'a T,
value: usize,
max: usize,
}
impl<'a, T> LimitTracker<'a, T>
where
T: Messenger,
{
pub fn new(messenger: &'a T, max: usize) -> LimitTracker<'a, T> {
LimitTracker {
messenger,
value: 0,
max,
}
}
pub fn set_value(&mut self, value: usize) {
self.value = value;
let percentage_of_max = self.value as f64 / self.max as f64;
if percentage_of_max >= 1.0 {
self.messenger.send("Error: You are over your quota!");
} else if percentage_of_max >= 0.9 {
self.messenger
.send("Urgent warning: You've used up over 90% of your quota!");
} else if percentage_of_max >= 0.75 {
self.messenger
.send("Warning: You've used up over 75% of your quota!");
}
}
}
#[cfg(test)]
mod tests {
use super::*;
use std::cell::RefCell;
struct MockMessenger {
sent_messages: RefCell<Vec<String>>,
}
impl MockMessenger {
fn new() -> MockMessenger {
MockMessenger {
sent_messages: RefCell::new(vec![]),
}
}
}
impl Messenger for MockMessenger {
fn send(&self, message: &str) {
self.sent_messages.borrow_mut().push(String::from(message));
}
}
#[test]
fn it_sends_an_over_75_percent_warning_message() {
// --snip--
let mock_messenger = MockMessenger::new();
let mut limit_tracker = LimitTracker::new(&mock_messenger, 100);
limit_tracker.set_value(80);
assert_eq!(mock_messenger.sent_messages.borrow().len(), 1);
}
}ตอนนี้ฟิลด์ sent_messages จะเปลี่ยนเป็นชนิด RefCell<Vec<String>> แทนที่จะเป็น Vec<String> และในฟังก์ชัน new เราจะสร้างอินสแตนซ์ของ RefCell<Vec<String>> ครอบเวกเตอร์ที่ว่างเปล่าเอาไว้
สำหรับการอิมพลีเมนต์เมธอด send พารามิเตอร์ตัวแรกยังคงเป็นการยืม self แบบแก้ไขไม่ได้เหมือนเดิม ซึ่งตรงกับนิยามของเทรตทุกประการ แต่เราจะเรียกใช้เมธอด borrow_mut บน RefCell<Vec<String>> ใน self.sent_messages เพื่อขอเรเฟอเรนซ์แบบแก้ไขได้ที่ชี้ไปยังค่าภายใน RefCell<Vec<String>> ซึ่งก็คือเวกเตอร์ จากนั้นเราจึงสามารถเรียกใช้ push บนเรเฟอเรนซ์แบบแก้ไขได้ของเวกเตอร์นั้น เพื่อบันทึกข้อความที่ถูกส่งเข้ามาในระหว่างการทดสอบได้
การเปลี่ยนแปลงจุดสุดท้ายที่เราต้องทำก็คือในขั้นตอนการยืนยันเงื่อนไข (assertion): ในการตรวจสอบจำนวนสมาชิกในเวกเตอร์ภายใน เราจะเรียกใช้เมธอด borrow บน RefCell<Vec<String>> เพื่อขอเรเฟอเรนซ์แบบแก้ไขไม่ได้ที่ชี้ไปยังเวกเตอร์นั้น
เมื่อคุณได้เห็นวิธีการใช้งาน RefCell<T> ไปแล้ว ต่อไปเรามาเจาะลึกกันว่ากลไกการทำงานภายในของมันเป็นอย่างไร!
การติดตามการยืมตอนรันไทม์
เมื่อเราต้องการสร้างเรเฟอเรนซ์แบบแก้ไขไม่ได้และแบบแก้ไขได้ เราจะใช้ไวยากรณ์ & และ &mut ตามลำดับ แต่สำหรับ RefCell<T> เราจะใช้เมธอด borrow และ borrow_mut ซึ่งเป็นส่วนหนึ่งของ API ที่ปลอดภัยของ RefCell<T> โดยเมธอด borrow จะส่งคืนสมาร์ตพอยน์เตอร์ชนิด Ref<T> และ borrow_mut จะส่งคืนสมาร์ตพอยน์เตอร์ชนิด RefMut<T> ซึ่งทั้งสองชนิดต่างอิมพลีเมนต์เทรต Deref จึงทำให้เราสามารถปฏิบัติต่อพวกมันได้เสมือนเป็นเรเฟอเรนซ์ทั่วไป
ตัว RefCell<T> จะคอยติดตามอยู่ตลอดเวลาว่ามีสมาร์ตพอยน์เตอร์ Ref<T> และ RefMut<T> กำลังทำงานอยู่จำนวนเท่าใด ทุกครั้งที่เราเรียกใช้ borrow ทาง RefCell<T> จะเพิ่มตัวนับการยืมแบบแก้ไขไม่ได้ที่กำลังทำงานอยู่ขึ้นหนึ่ง และเมื่อค่า Ref<T> หลุดออกจากขอบเขต ตัวนับการยืมแบบแก้ไขไม่ได้ก็จะลดลงหนึ่ง และเช่นเดียวกับกฎการยืมในขั้นตอนคอมไพล์ RefCell<T> จะอนุญาตให้เรามีการยืมแบบแก้ไขไม่ได้หลายตัวพร้อมกัน หรือมีการยืมแบบแก้ไขได้เพียงตัวเดียว ณ ช่วงเวลาใดเวลาหนึ่งเท่านั้น
หากเราพยายามละเมิดกฎเหล่านี้ แทนที่จะได้รับข้อผิดพลาดจากคอมไพเลอร์เหมือนตอนใช้เรเฟอเรนซ์ทั่วไป ตัว RefCell<T> จะสั่งให้โปรแกรมแพนิก (panic!) ในขณะรันไทม์ทันที ลิสติ้ง 15-23 แสดงการปรับปรุงโค้ดเมธอด send จากลิสติ้ง 15-22 โดยเราจงใจสร้างการยืมแบบแก้ไขได้สองตัวพร้อมกันในขอบเขตเดียวกัน เพื่อแสดงให้เห็นว่า RefCell<T> จะป้องกันไม่ให้เราทำเช่นนั้นในขณะรันไทม์ได้อย่างไร
pub trait Messenger {
fn send(&self, msg: &str);
}
pub struct LimitTracker<'a, T: Messenger> {
messenger: &'a T,
value: usize,
max: usize,
}
impl<'a, T> LimitTracker<'a, T>
where
T: Messenger,
{
pub fn new(messenger: &'a T, max: usize) -> LimitTracker<'a, T> {
LimitTracker {
messenger,
value: 0,
max,
}
}
pub fn set_value(&mut self, value: usize) {
self.value = value;
let percentage_of_max = self.value as f64 / self.max as f64;
if percentage_of_max >= 1.0 {
self.messenger.send("Error: You are over your quota!");
} else if percentage_of_max >= 0.9 {
self.messenger
.send("Urgent warning: You've used up over 90% of your quota!");
} else if percentage_of_max >= 0.75 {
self.messenger
.send("Warning: You've used up over 75% of your quota!");
}
}
}
#[cfg(test)]
mod tests {
use super::*;
use std::cell::RefCell;
struct MockMessenger {
sent_messages: RefCell<Vec<String>>,
}
impl MockMessenger {
fn new() -> MockMessenger {
MockMessenger {
sent_messages: RefCell::new(vec![]),
}
}
}
impl Messenger for MockMessenger {
fn send(&self, message: &str) {
let mut one_borrow = self.sent_messages.borrow_mut();
let mut two_borrow = self.sent_messages.borrow_mut();
one_borrow.push(String::from(message));
two_borrow.push(String::from(message));
}
}
#[test]
fn it_sends_an_over_75_percent_warning_message() {
let mock_messenger = MockMessenger::new();
let mut limit_tracker = LimitTracker::new(&mock_messenger, 100);
limit_tracker.set_value(80);
assert_eq!(mock_messenger.sent_messages.borrow().len(), 1);
}
}เราสร้างตัวแปร one_borrow เพื่อเก็บสมาร์ตพอยน์เตอร์ RefMut<T> ที่ได้จาก borrow_mut จากนั้นเราสร้างการยืมแบบแก้ไขได้อีกตัวหนึ่งด้วยวิธีเดียวกันในตัวแปร two_borrow การทำเช่นนี้ทำให้มีเรเฟอเรนซ์แบบแก้ไขได้สองตัวอยู่ในขอบเขตเดียวกัน ซึ่งเป็นสิ่งที่ไม่ได้รับอนุญาต เมื่อเรารันการทดสอบของไลบรารี โค้ดในลิสติ้ง 15-23 จะคอมไพล์ผ่านได้โดยไม่มีข้อผิดพลาดใด ๆ แต่การทดสอบจะล้มเหลว:
$ cargo test
Compiling limit-tracker v0.1.0 (file:///projects/limit-tracker)
Finished `test` profile [unoptimized + debuginfo] target(s) in 0.91s
Running unittests src/lib.rs (target/debug/deps/limit_tracker-e599811fa246dbde)
running 1 test
test tests::it_sends_an_over_75_percent_warning_message ... FAILED
failures:
---- tests::it_sends_an_over_75_percent_warning_message stdout ----
thread 'tests::it_sends_an_over_75_percent_warning_message' (6028024) panicked at src/lib.rs:60:53:
RefCell already borrowed
note: run with `RUST_BACKTRACE=1` environment variable to display a backtrace
failures:
tests::it_sends_an_over_75_percent_warning_message
test result: FAILED. 0 passed; 1 failed; 0 ignored; 0 measured; 0 filtered out; finished in 0.00s
error: test failed, to rerun pass `--lib`
โปรดสังเกตว่าโปรแกรมเกิดการแพนิกพร้อมข้อความ already borrowed: BorrowMutError นี่คือกลไกที่ RefCell<T> ใช้จัดการกับการละเมิดกฎการยืมในขณะรันไทม์
การเลือกที่จะตรวจจับข้อผิดพลาดของการยืมในขณะรันไทม์แทนที่จะเป็นตอนคอมไพล์ดังที่เราทำในตัวอย่างนี้ หมายความว่าคุณอาจจะตรวจพบข้อผิดพลาดในโค้ดล่าช้ากว่าเดิมในกระบวนการพัฒนา ซึ่งอาจตรวจไม่พบจนกระทั่งโค้ดถูกนำไปใช้งานจริงบนระบบโปรดักชัน นอกจากนี้ โค้ดของคุณจะต้องแบกรับภาระด้านประสิทธิภาพ (runtime performance penalty) เล็กน้อยจากการที่ต้องคอยติดตามการยืมในขณะรันไทม์ อย่างไรก็ตาม การใช้ RefCell<T> ช่วยให้เราสามารถสร้างม็อกออบเจกต์ที่สามารถแก้ไขข้อมูลตัวเองเพื่อบันทึกข้อความที่ตรวจพบได้ ในขณะที่ตัวมันเองถูกนำไปใช้งานในบริบทที่อนุญาตเฉพาะค่าที่แก้ไขไม่ได้เท่านั้น คุณจึงสามารถเลือกใช้ RefCell<T> แม้จะมีข้อแลกเปลี่ยนเหล่านี้ เพื่อให้ได้มาซึ่งฟังก์ชันการทำงานที่ยืดหยุ่นกว่าที่เรเฟอเรนซ์ทั่วไปมอบให้ได้
การอนุญาตเจ้าของหลายรายของข้อมูลที่เปลี่ยนแปลงได้
วิธีหนึ่งที่นิยมใช้ RefCell<T> กันมากคือการนำไปใช้งานร่วมกับ Rc<T> จำได้ไหมว่า Rc<T> ช่วยให้ข้อมูลชิ้นหนึ่งสามารถมีเจ้าของได้หลายราย แต่จะให้สิทธิ์การเข้าถึงข้อมูลนั้นแบบอ่านได้อย่างเดียว (immutable) เท่านั้น หากคุณมี Rc<T> ที่ถือครอง RefCell<T> อยู่ข้างใน คุณก็จะได้ค่าข้อมูลที่สามารถมีเจ้าของได้หลายราย และ สามารถแก้ไขข้อมูลนั้นได้ด้วยพร้อมกัน!
ตัวอย่างเช่น ลองนึกย้อนกลับไปถึงตัวอย่าง cons list ในลิสติ้ง 15-18 ที่เราใช้ Rc<T> เพื่อให้ลิสต์หลายชุดแชร์ความเป็นเจ้าของลิสต์อีกชุดหนึ่งร่วมกัน เนื่องจาก Rc<T> เก็บได้เฉพาะค่าที่ไม่สามารถแก้ไขได้ เราจึงไม่สามารถเปลี่ยนแปลงค่าใด ๆ ในลิสต์ได้เลยหลังจากสร้างมันขึ้นมาแล้ว คราวนี้เราจะนำ RefCell<T> เข้ามาเสริมเพื่อเพิ่มความสามารถในการแก้ไขค่าในลิสต์ ลิสติ้ง 15-24 แสดงให้เห็นว่าการใช้ RefCell<T> ในนิยามของ Cons ช่วยให้เราสามารถปรับปรุงแก้ไขค่าที่จัดเก็บอยู่ในลิสต์ทั้งหมดได้
#[derive(Debug)]
enum List {
Cons(Rc<RefCell<i32>>, Rc<List>),
Nil,
}
use crate::List::{Cons, Nil};
use std::cell::RefCell;
use std::rc::Rc;
fn main() {
let value = Rc::new(RefCell::new(5));
let a = Rc::new(Cons(Rc::clone(&value), Rc::new(Nil)));
let b = Cons(Rc::new(RefCell::new(3)), Rc::clone(&a));
let c = Cons(Rc::new(RefCell::new(4)), Rc::clone(&a));
*value.borrow_mut() += 10;
println!("a after = {a:?}");
println!("b after = {b:?}");
println!("c after = {c:?}");
}เราสร้างค่าอินสแตนซ์ของ Rc<RefCell<i32>> แล้วเก็บไว้ในตัวแปรชื่อ value เพื่อให้เราสามารถเข้าถึงมันได้โดยตรงในภายหลัง จากนั้นเราสร้าง List ในตัวแปร a ด้วยวาเรียนต์ Cons ที่ถือครอง value ไว้ โดยเราจำเป็นต้องทำการโคลน value เพื่อให้ทั้ง a และ value ต่างมีสิทธิ์ความเป็นเจ้าของในค่า 5 ที่อยู่ภายใน แทนที่จะเป็นการโอนย้ายสิทธิ์ความเป็นเจ้าของจาก value ไปให้ a หรือให้ a ยืมจาก value
เราห่อหุ้มลิสต์ a ไว้ใน Rc<T> เพื่อให้เมื่อเราสร้างลิสต์ b และ c ทั้งสองลิสต์จะสามารถอ้างอิงมายัง a ได้ เช่นเดียวกับที่เราเคยทำในลิสติ้ง 15-18
หลังจากที่เราสร้างลิสต์ใน a, b และ c เรียบร้อยแล้ว เราต้องการบวก 10 เพิ่มเข้าไปในค่าของ value เราทำสิ่งนี้ได้โดยการเรียก borrow_mut บน value ซึ่งจะใช้ฟีเจอร์การดีเรเฟอเรนซ์อัตโนมัติ (automatic dereferencing) ที่เราเคยพูดถึงในหัวข้อ “ตัวดำเนินการ -> อยู่ที่ไหน?” ในบทที่ 5 เพื่อทำการดีเรเฟอเรนซ์ Rc<T> ไปยังค่า RefCell<T> ที่อยู่ภายใน เมธอด borrow_mut จะส่งคืนสมาร์ตพอยน์เตอร์ RefMut<T> ออกมา แล้วเราจึงใช้ตัวดำเนินการดีเรเฟอเรนซ์กับมันเพื่อแก้ไขค่าที่อยู่ข้างใน
เมื่อเราพิมพ์ค่าของ a, b และ c ออกมาดู เราจะพบว่าทั้งหมดมีค่าที่ได้รับการแก้ไขเป็น 15 แทนที่จะเป็น 5 ตามเดิม:
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.63s
Running `target/debug/cons-list`
a after = Cons(RefCell { value: 15 }, Nil)
b after = Cons(RefCell { value: 3 }, Cons(RefCell { value: 15 }, Nil))
c after = Cons(RefCell { value: 4 }, Cons(RefCell { value: 15 }, Nil))
เทคนิคนี้ยอดเยี่ยมมาก! การใช้ RefCell<T> ช่วยให้เรามีค่า List ที่ภายนอกดูเหมือนแก้ไขไม่ได้ แต่เราสามารถเรียกใช้เมธอดบน RefCell<T> ที่เปิดทางให้เข้าถึงความสามารถในการเปลี่ยนแปลงค่าภายใน เพื่อแก้ไขข้อมูลตามที่ต้องการได้ การตรวจสอบกฎการยืมในขณะรันไทม์ช่วยปกป้องเราจากการแย่งชิงข้อมูล (data race) และในบางครั้งการยอมแลกความเร็วเล็กน้อยเพื่อให้ได้มาซึ่งความยืดหยุ่นของโครงสร้างข้อมูลเช่นนี้ก็ถือว่าคุ้มค่ามาก อย่างไรก็ตาม โปรดทราบว่า RefCell<T> ไม่สามารถใช้งานร่วมกับโค้ดที่ทำงานแบบหลายเธรดได้! โดยชนิดข้อมูล Mutex<T> จะเป็นเวอร์ชันที่ปลอดภัยต่อเธรด (thread-safe) ของ RefCell<T> ซึ่งเราจะได้พูดคุยกันถึง Mutex<T> ในบทที่ 16
วงจรเรเฟอเรนซ์ทำให้หน่วยความจำรั่วไหลได้
วงจรเรเฟอเรนซ์ทำให้หน่วยความจำรั่วไหลได้
การรับประกันความปลอดภัยของหน่วยความจำใน Rust ทำให้การเผลอสร้างหน่วยความจำที่ไม่มีวันถูกคืนหรือเก็บกวาดเลย (ซึ่งเรียกว่า หน่วยความจำรั่วไหล (memory leak)) เป็นเรื่องที่เกิดขึ้นได้ยาก แต่ก็ไม่ได้เป็นไปไม่ได้เลยเสียทีเดียว การป้องกันไม่ให้เกิดหน่วยความจำรั่วไหลอย่างสมบูรณ์ 100% ไม่ได้เป็นหนึ่งในการรับประกันของ Rust ซึ่งหมายความว่าในมุมมองของ Rust แล้ว การเกิดหน่วยความจำรั่วไหลยังถือว่าปลอดภัยต่อหน่วยความจำ (memory safe) เราสามารถเห็นได้ว่า Rust ยอมให้เกิดหน่วยความจำรั่วไหลได้เมื่อมีการใช้ Rc<T> ร่วมกับ RefCell<T>: โดยเราสามารถสร้างการอ้างอิงที่ไอเท็มต่าง ๆ อ้างถึงกันและกันเป็นวงรอบ หรือที่เรียกว่า วงรอบการอ้างอิง (reference cycle) สิ่งนี้ทำให้เกิดหน่วยความจำรั่วไหล เพราะตัวนับจำนวนการอ้างอิงของแต่ละไอเท็มในวงรอบจะไม่มีวันลดลงจนเหลือ 0 และค่าเหล่านั้นก็จะไม่ถูกทิ้ง (drop) หรือคืนหน่วยความจำเลย
การสร้างวงจรเรเฟอเรนซ์
มาดูว่าวงรอบการอ้างอิงเกิดขึ้นได้อย่างไรและเราจะป้องกันมันได้อย่างไร โดยเริ่มจากนิยามของ enum List และเมธอด tail ในลิสติ้ง 15-25
use crate::List::{Cons, Nil};
use std::cell::RefCell;
use std::rc::Rc;
#[derive(Debug)]
enum List {
Cons(i32, RefCell<Rc<List>>),
Nil,
}
impl List {
fn tail(&self) -> Option<&RefCell<Rc<List>>> {
match self {
Cons(_, item) => Some(item),
Nil => None,
}
}
}
fn main() {}เรานำรูปแบบนิยามของ List จากลิสติ้ง 15-5 มาปรับเปลี่ยนอีกครั้ง โดยสมาชิกตัวที่สองในวาเรียนต์ Cons ตอนนี้กลายเป็น RefCell<Rc<List>> ซึ่งหมายความว่าแทนที่เราจะแก้ไขค่าตัวเลข i32 เหมือนในลิสติ้ง 15-24 เรากลับต้องการแก้ไขค่า List ที่วาเรียนต์ Cons กำลังชี้อยู่แทน นอกจากนี้เรายังเพิ่มเมธอด tail เข้ามา เพื่ออำนวยความสะดวกในการเข้าถึงสมาชิกตัวที่สองเมื่อเราถือครองวาเรียนต์ Cons
ในลิสติ้ง 15-26 เราได้เพิ่มฟังก์ชัน main ที่นำนิยามในลิสติ้ง 15-25 มาใช้งาน โค้ดนี้สร้างลิสต์ใน a และลิสต์ใน b ที่ชี้ไปยังลิสต์ใน a จากนั้นจึงแก้ไขลิสต์ใน a ให้ชี้วนกลับมายัง b ซึ่งทำให้เกิดวงรอบการอ้างอิงขึ้น และระหว่างทางจะมีคำสั่ง println! เพื่อแสดงตัวเลขนับการอ้างอิง ณ แต่ละขั้นตอนของกระบวนการนี้
use crate::List::{Cons, Nil};
use std::cell::RefCell;
use std::rc::Rc;
#[derive(Debug)]
enum List {
Cons(i32, RefCell<Rc<List>>),
Nil,
}
impl List {
fn tail(&self) -> Option<&RefCell<Rc<List>>> {
match self {
Cons(_, item) => Some(item),
Nil => None,
}
}
}
fn main() {
let a = Rc::new(Cons(5, RefCell::new(Rc::new(Nil))));
println!("a initial rc count = {}", Rc::strong_count(&a));
println!("a next item = {:?}", a.tail());
let b = Rc::new(Cons(10, RefCell::new(Rc::clone(&a))));
println!("a rc count after b creation = {}", Rc::strong_count(&a));
println!("b initial rc count = {}", Rc::strong_count(&b));
println!("b next item = {:?}", b.tail());
if let Some(link) = a.tail() {
*link.borrow_mut() = Rc::clone(&b);
}
println!("b rc count after changing a = {}", Rc::strong_count(&b));
println!("a rc count after changing a = {}", Rc::strong_count(&a));
// Uncomment the next line to see that we have a cycle;
// it will overflow the stack.
// println!("a next item = {:?}", a.tail());
}เราสร้างอินสแตนซ์ของ Rc<List> ที่เก็บค่า List ไว้ในตัวแปร a โดยเริ่มต้นเป็นลิสต์ 5, Nil จากนั้นเราสร้างอินสแตนซ์ Rc<List> ที่เก็บค่า List อีกชุดหนึ่งไว้ในตัวแปร b ซึ่งเก็บค่า 10 และชี้ไปยังลิสต์ใน a
จากนั้นเราแก้ไขค่าใน a ให้ชี้ไปยัง b แทนที่จะเป็น Nil ซึ่งทำให้เกิดวงรอบขึ้นมา โดยเราเรียกใช้เมธอด tail เพื่อขอเรเฟอเรนซ์ที่ชี้ไปยัง RefCell<Rc<List>> ใน a แล้วเก็บไว้ในตัวแปร link จากนั้นจึงใช้เมธอด borrow_mut บน RefCell<Rc<List>> นั้น เพื่อเปลี่ยนค่าภายในจาก Rc<List> ที่เคยเก็บ Nil ให้กลายมาเป็น Rc<List> ใน b
เมื่อเรารันโค้ดนี้ โดยคอมเมนต์คำสั่ง println! บรรทัดสุดท้ายเอาไว้ก่อนชั่วคราว เราจะได้ผลลัพธ์ดังนี้:
$ cargo run
Compiling cons-list v0.1.0 (file:///projects/cons-list)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.53s
Running `target/debug/cons-list`
a initial rc count = 1
a next item = Some(RefCell { value: Nil })
a rc count after b creation = 2
b initial rc count = 1
b next item = Some(RefCell { value: Cons(5, RefCell { value: Nil }) })
b rc count after changing a = 2
a rc count after changing a = 2
จำนวนการอ้างอิงของอินสแตนซ์ Rc<List> ทั้งใน a และ b จะกลายเป็น 2 หลังจากที่เราเปลี่ยนลิสต์ใน a ให้ชี้ไปยัง b และเมื่อสิ้นสุดฟังก์ชัน main ทาง Rust จะทิ้งตัวแปร b ซึ่งจะลดจำนวนการอ้างอิงของอินสแตนซ์ Rc<List> ของ b จาก 2 เหลือ 1 หน่วยความจำที่ Rc<List> นี้ถือครองอยู่บนฮีปจะไม่ถูกคืน ณ จุดนี้ เนื่องจากจำนวนการอ้างอิงยังเป็น 1 ไม่ใช่ 0 จากนั้น Rust ก็จะทิ้งตัวแปร a ซึ่งลดจำนวนการอ้างอิงของ Rc<List> ของ a จาก 2 เหลือ 1 เช่นกัน หน่วยความจำของอินสแตนซ์นี้ก็ไม่สามารถถูกคืนได้เช่นกัน เพราะอินสแตนซ์ Rc<List> อีกตัวยังคงอ้างอิงถึงมันอยู่ ส่งผลให้หน่วยความจำที่จัดสรรไว้ให้กับลิสต์นี้จะตกค้างอยู่ตลอดไปโดยไม่มีวันถูกเรียกคืน เพื่อให้เห็นภาพวงรอบการอ้างอิงนี้ได้ชัดเจนยิ่งขึ้น เราได้วาดแผนภาพแสดงไว้ในรูปที่ 15-4
รูปที่ 15-4: วงจรเรเฟอเรนซ์ของลิสต์ a และ b ที่ชี้ไปยังกันและกัน
หากคุณยกเลิกการคอมเมนต์คำสั่ง println! บรรทัดสุดท้ายออกแล้วรันโปรแกรมดู Rust จะพยายามพิมพ์ค่าในวงรอบนี้วนซ้ำไปเรื่อย ๆ โดย a ชี้ไปยัง b และ b ชี้วนกลับมายัง a จนกระทั่งหน่วยความจำสแตกเต็มและเกิดสแตกโอเวอร์โฟลว์ (stack overflow)
เมื่อเทียบกับโปรแกรมที่ใช้งานจริง ผลกระทบของการสร้างวงรอบการอ้างอิงในตัวอย่างนี้อาจดูไม่ร้ายแรงนัก เพราะทันทีที่เราสร้างวงรอบการอ้างอิงเสร็จสิ้น โปรแกรมก็จบการทำงานลงทันที อย่างไรก็ตาม หากเป็นโปรแกรมขนาดใหญ่และซับซ้อนที่มีการจัดสรรหน่วยความจำปริมาณมากเป็นวงรอบและถือครองค้างไว้เป็นเวลานาน โปรแกรมก็จะกินพื้นที่หน่วยความจำมากเกินความจำเป็น และอาจทำให้ระบบทำงานหนักจนหน่วยความจำหมดลงได้
การสร้างวงรอบการอ้างอิงนั้นไม่ใช่เรื่องที่จะเกิดขึ้นได้ง่าย ๆ แต่ก็ไม่ใช่ว่าจะเป็นไปไม่ได้ หากคุณมีค่า RefCell<T> ที่เก็บค่า Rc<T> ไว้ข้างใน หรือโครงสร้างข้อมูลที่มีการซ้อนทับกันระหว่างความสามารถในการเปลี่ยนแปลงค่าภายใน (interior mutability) กับการนับจำนวนการอ้างอิง (reference counting) ในลักษณะนี้ คุณจะต้องตรวจสอบให้รอบคอบว่าไม่ได้เผลอสร้างวงรอบขึ้นมา เพราะคุณไม่สามารถพึ่งพาให้ Rust ตรวจจับสิ่งนี้ให้ได้ การเกิดวงรอบการอ้างอิงถือเป็นข้อผิดพลาดเชิงตรรกะ (logic bug) ในโปรแกรมของคุณ ซึ่งคุณควรใช้การทดสอบแบบอัตโนมัติ (automated tests), การตรวจทานโค้ด (code review) และแนวปฏิบัติด้านวิศวกรรมซอฟต์แวร์อื่น ๆ เข้ามาช่วยลดความเสี่ยงให้เหลือน้อยที่สุด
อีกแนวทางหนึ่งในการหลีกเลี่ยงวงรอบการอ้างอิงคือ การจัดโครงสร้างข้อมูลใหม่เพื่อให้การอ้างอิงบางส่วนแสดงถึงสิทธิ์ความเป็นเจ้าของ ในขณะที่การอ้างอิงบางส่วนไม่แสดงความเป็นเจ้าของ ผลลัพธ์ก็คือ คุณสามารถมีวงรอบที่ประกอบด้วยความสัมพันธ์แบบเป็นเจ้าของร่วมกับความสัมพันธ์แบบไม่เป็นเจ้าของได้ โดยจะมีเพียงความสัมพันธ์แบบเป็นเจ้าของเท่านั้นที่ส่งผลต่อการคืนหน่วยความจำและการทิ้งค่า ในลิสติ้ง 15-25 เราต้องการให้วาเรียนต์ Cons เป็นเจ้าของลิสต์ของมันเสมอ การจัดโครงสร้างใหม่ในลักษณะนั้นจึงทำไม่ได้ในตัวอย่าง cons list แต่เราลองมาดูตัวอย่างโครงสร้างข้อมูลแบบกราฟที่ประกอบด้วยโหนดแม่และโหนดลูก เพื่อดูว่าความสัมพันธ์แบบไม่เป็นเจ้าของสามารถนำมาใช้ป้องกันวงรอบการอ้างอิงได้อย่างไร
การป้องกันวงจรเรเฟอเรนซ์ด้วย Weak<T>
จนถึงตอนนี้ เราได้เห็นแล้วว่าการเรียก Rc::clone จะเพิ่มค่า strong_count ของอินสแตนซ์ Rc<T> และอินสแตนซ์ของ Rc<T> จะถูกคืนหน่วยความจำและเก็บกวาดก็ต่อเมื่อ strong_count ของมันลดลงเหลือ 0 เท่านั้น นอกจากนี้ คุณยังสามารถสร้างการอ้างอิงแบบอ่อน หรือ เรเฟอเรนซ์แบบวีค (weak reference) ไปยังค่าที่อยู่ภายในอินสแตนซ์ Rc<T> ได้ด้วยการเรียกใช้ฟังก์ชัน Rc::downgrade โดยส่งเรเฟอเรนซ์ของ Rc<T> เข้าไป ทั้งนี้ เรเฟอเรนซ์แบบสตรอง (strong reference) คือวิธีที่คุณใช้แชร์สิทธิ์ความเป็นเจ้าของในอินสแตนซ์ Rc<T> ในขณะที่ เรเฟอเรนซ์แบบวีค จะไม่ได้แสดงถึงความสัมพันธ์เชิงความเป็นเจ้าของ และจำนวนของมันจะไม่ส่งผลต่อจังหวะเวลาที่อินสแตนซ์ Rc<T> จะถูกเก็บกวาดเลยแม้แต่น้อย เรเฟอเรนซ์แบบวีคจึงไม่มีทางทำให้เกิดวงรอบการอ้างอิง เพราะวงรอบใดก็ตามที่เกี่ยวข้องกับเรเฟอเรนซ์แบบวีคจะถูกตัดขาดลงทันทีเมื่อจำนวนเรเฟอเรนซ์แบบสตรองของค่าที่เกี่ยวข้องกลายเป็น 0
เมื่อคุณเรียก Rc::downgrade คุณจะได้รับสมาร์ตพอยน์เตอร์ชนิด Weak<T> ออกมา โดยแทนที่จะเป็นการเพิ่ม strong_count ขึ้น 1 การเรียก Rc::downgrade จะไปเพิ่มค่า weak_count ขึ้น 1 แทน ชนิดข้อมูล Rc<T> จะใช้ weak_count ในการคอยติดตามว่ามีเรเฟอเรนซ์ Weak<T> หลงเหลืออยู่กี่ตัว เช่นเดียวกับ strong_count เพียงแต่จุดต่างคือ weak_count ไม่จำเป็นต้องลดลงเหลือ 0 ก็สามารถเก็บกวาดอินสแตนซ์ Rc<T> ได้
และเนื่องจากค่าที่ Weak<T> อ้างอิงถึงอาจจะถูกทิ้งและคืนหน่วยความจำไปแล้ว ดังนั้นก่อนที่จะทำสิ่งใดกับค่าที่ Weak<T> กำลังชี้อยู่ คุณจะต้องตรวจสอบให้แน่ใจก่อนว่าค่านั้นยังมีอยู่จริง โดยทำได้ผ่านการเรียกเมธอด upgrade บนอินสแตนซ์ของ Weak<T> ซึ่งจะส่งคืนค่าเป็น Option<Rc<T>> คุณจะได้ผลลัพธ์เป็น Some หากค่า Rc<T> นั้นยังไม่ถูกทิ้ง และจะได้ผลลัพธ์เป็น None หากค่า Rc<T> ถูกทิ้งไปเรียบร้อยแล้ว และเนื่องจากเมธอด upgrade คืนค่าเป็น Option<Rc<T>> ทาง Rust จึงรับประกันว่าทั้งกรณี Some และ None จะได้รับการจัดการอย่างถูกต้องเสมอ และจะไม่มีทางเกิดพอยน์เตอร์ที่ไม่ถูกต้องหรือชี้ไปที่ความว่างเปล่า (dangling pointer) อย่างแน่นอน
เพื่อเป็นตัวอย่าง แทนที่จะใช้ลิสต์ที่แต่ละสมาชิกรับรู้เพียงสมาชิกตัวถัดไปเท่านั้น เราจะมาสร้างโครงสร้างข้อมูลแบบทรี (tree) ที่สมาชิกแต่ละตัวรับรู้ทั้งสมาชิกที่เป็นโหนดลูก (children) และ สมาชิกที่เป็นโหนดแม่ (parent) ของมัน
การสร้างโครงสร้างข้อมูลแบบทรี
เริ่มต้นด้วย เราจะสร้างทรีที่มีโหนด (node) ซึ่งรู้จักโหนดลูกของมัน เราจะสร้าง struct ชื่อ Node ที่ถือค่า i32 ของตัวเองรวมทั้งเรเฟอเรนซ์ไปยังค่า Node ที่เป็นโหนดลูกของมัน:
ชื่อไฟล์: src/main.rs
use std::cell::RefCell;
use std::rc::Rc;
#[derive(Debug)]
struct Node {
value: i32,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
children: RefCell::new(vec![]),
});
let branch = Rc::new(Node {
value: 5,
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
}เราต้องการให้ Node เป็นเจ้าของโหนดลูกของมัน และเราต้องการแชร์ความเป็นเจ้าของนั้นกับตัวแปร เพื่อให้เราเข้าถึงแต่ละ Node ในทรีได้โดยตรง ในการทำเช่นนี้ เรากำหนดให้สมาชิกของ Vec<T> เป็นค่าชนิด Rc<Node> เรายังต้องการแก้ไขว่าโหนดใดเป็นโหนดลูกของโหนดอื่น ดังนั้นเราจึงมี RefCell<T> อยู่ใน children ครอบ Vec<Rc<Node>>
ต่อไป เราจะใช้นิยาม struct ของเราและสร้างอินสแตนซ์ Node หนึ่งตัวชื่อ leaf ที่มีค่า 3 และไม่มีโหนดลูก และอีกอินสแตนซ์หนึ่งชื่อ branch ที่มีค่า 5 และมี leaf เป็นหนึ่งในโหนดลูกของมัน ดังที่แสดงในลิสติ้ง 15-27
use std::cell::RefCell;
use std::rc::Rc;
#[derive(Debug)]
struct Node {
value: i32,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
children: RefCell::new(vec![]),
});
let branch = Rc::new(Node {
value: 5,
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
}เราโคลน Rc<Node> ใน leaf และเก็บมันไว้ใน branch หมายความว่า Node ใน leaf ตอนนี้มีเจ้าของสองราย: leaf และ branch เราสามารถไปจาก branch ถึง leaf ผ่าน branch.children ได้ แต่ไม่มีทางที่จะไปจาก leaf ถึง branch ได้ เหตุผลคือ leaf ไม่มีเรเฟอเรนซ์ไปยัง branch และไม่รู้ว่าพวกมันเกี่ยวข้องกัน เราต้องการให้ leaf รู้ว่า branch เป็นโหนดแม่ของมัน เราจะทำเช่นนั้นต่อไป
การเพิ่มเรเฟอเรนซ์จากโหนดลูกไปยังโหนดแม่
เพื่อให้โหนดลูกรับรู้ถึงโหนดแม่ของมัน เราจำเป็นต้องเพิ่มฟิลด์ parent เข้าไปในนิยามของ struct Node แต่ปัญหาอยู่ที่การตัดสินใจว่าชนิดข้อมูลของ parent ควรเป็นชนิดใด เรารู้ว่ามันไม่สามารถเก็บ Rc<T> ได้ เพราะนั่นจะสร้างวงรอบการอ้างอิงขึ้นมา โดย leaf.parent ชี้ไปยัง branch และ branch.children ชี้ไปยัง leaf ซึ่งจะส่งผลให้ค่า strong_count ของพวกมันไม่มีวันลดลงเหลือ 0
หากมองความสัมพันธ์ในอีกมุมหนึ่ง โหนดแม่ควรมีสิทธิ์ความเป็นเจ้าของในโหนดลูกของมัน นั่นคือ หากโหนดแม่ถูกทิ้ง โหนดลูกก็ควรถูกทิ้งตามไปด้วย อย่างไรก็ตาม โหนดลูกไม่ควรเป็นเจ้าของโหนดแม่ เพราะหากเราทิ้งโหนดลูก โหนดแม่ก็ยังควรที่จะคงอยู่ต่อไปได้ นี่แหละคือกรณีการใช้งานที่เหมาะอย่างยิ่งกับเรเฟอเรนซ์แบบวีค!
ดังนั้น แทนที่จะใช้ Rc<T> เราจะกำหนดให้ชนิดของฟิลด์ parent ใช้ Weak<T> โดยเจาะจงให้เป็นชนิด RefCell<Weak<Node>> ตอนนี้โครงสร้าง struct Node ของเราจะมีหน้าตาดังนี้:
ชื่อไฟล์: src/main.rs
use std::cell::RefCell;
use std::rc::{Rc, Weak};
#[derive(Debug)]
struct Node {
value: i32,
parent: RefCell<Weak<Node>>,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![]),
});
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
let branch = Rc::new(Node {
value: 5,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
*leaf.parent.borrow_mut() = Rc::downgrade(&branch);
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
}โหนดจะสามารถอ้างถึงโหนดแม่ของมันได้โดยไม่ได้เป็นเจ้าของโหนดแม่ ในลิสติ้ง 15-28 เราอัปเดตฟังก์ชัน main ให้ใช้นิยามใหม่นี้ เพื่อให้โหนด leaf มีช่องทางในการอ้างอิงไปยังโหนดแม่ของมัน ซึ่งก็คือ branch
use std::cell::RefCell;
use std::rc::{Rc, Weak};
#[derive(Debug)]
struct Node {
value: i32,
parent: RefCell<Weak<Node>>,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![]),
});
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
let branch = Rc::new(Node {
value: 5,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
*leaf.parent.borrow_mut() = Rc::downgrade(&branch);
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
}การสร้างโหนด leaf มีลักษณะคล้ายกับในลิสติ้ง 15-27 เว้นแต่เพียงฟิลด์ parent: โดย leaf จะเริ่มต้นขึ้นโดยยังไม่มีโหนดแม่ เราจึงสร้างอินสแตนซ์ของเรเฟอเรนซ์ Weak<Node> ที่ว่างเปล่าขึ้นมา
ณ จุดนี้ เมื่อเราพยายามขอเรเฟอเรนซ์ที่ชี้ไปยังโหนดแม่ของ leaf ด้วยการเรียกใช้เมธอด upgrade เราจะได้รับค่า None ซึ่งเราจะเห็นสิ่งนี้ได้ในเอาต์พุตจากคำสั่ง println! แรก:
leaf parent = None
เมื่อเราสร้างโหนด branch ตัวมันก็จะมีเรเฟอเรนซ์ Weak<Node> ว่างเปล่าตัวใหม่ในฟิลด์ parent เช่นกัน เนื่องจาก branch ไม่มีโหนดแม่ และเรายังคงกำหนดให้ leaf เป็นหนึ่งในโหนดลูกของ branch เมื่อเรามีอินสแตนซ์ Node ใน branch เรียบร้อยแล้ว เราจึงสามารถแก้ไข leaf เพื่อมอบเรเฟอเรนซ์ Weak<Node> ที่ชี้ไปยังโหนดแม่ให้กับมันได้ เราเรียกใช้เมธอด borrow_mut บน RefCell<Weak<Node>> ในฟิลด์ parent ของ leaf แล้วจึงใช้ฟังก์ชัน Rc::downgrade เพื่อสร้างเรเฟอเรนซ์ Weak<Node> ที่ชี้ไปยัง branch จากอินสแตนซ์ Rc<Node> ใน branch
เมื่อเราสั่งพิมพ์โหนดแม่ของ leaf อีกครั้ง คราวนี้เราจะได้รับวาเรียนต์ Some ที่ถือครอง branch นั่นคือตอนนี้ leaf สามารถเข้าถึงโหนดแม่ของมันได้แล้ว! และเมื่อเราสั่งพิมพ์ leaf ทั้งหมด เราก็สามารถหลีกเลี่ยงวงรอบการอ้างอิงที่จะนำไปสู่การเกิดสแตกโอเวอร์โฟลว์เหมือนในลิสติ้ง 15-26 ได้ โดยเรเฟอเรนซ์ Weak<Node> จะถูกพิมพ์ออกมาเป็นข้อความ (Weak):
leaf parent = Some(Node { value: 5, parent: RefCell { value: (Weak) },
children: RefCell { value: [Node { value: 3, parent: RefCell { value: (Weak) },
children: RefCell { value: [] } }] } })
การที่โปรแกรมไม่พิมพ์เอาต์พุตวนซ้ำอย่างไม่สิ้นสุด แสดงให้เห็นว่าโค้ดนี้ไม่ได้สร้างวงรอบการอ้างอิงขึ้นมา นอกจากนี้เรายังสามารถยืนยันสิ่งนี้ได้จากการตรวจสอบค่าที่ได้จากการเรียก Rc::strong_count และ Rc::weak_count
การเห็นภาพการเปลี่ยนแปลงของ strong_count และ weak_count
มาลองดูว่าค่า strong_count และ weak_count ของอินสแตนซ์ Rc<Node> เปลี่ยนแปลงไปอย่างไร โดยการสร้างขอบเขตชั้นในขึ้นมาใหม่ แล้วย้ายโค้ดสร้าง branch เข้าไปไว้ในขอบเขตนั้น ด้วยวิธีนี้ เราจะสามารถสังเกตสิ่งที่เกิดขึ้นเมื่อ branch ถูกสร้างขึ้น แล้วถูกทิ้งเมื่อมันหลุดออกจากขอบเขต การปรับปรุงโค้ดแสดงไว้ในลิสติ้ง 15-29
use std::cell::RefCell;
use std::rc::{Rc, Weak};
#[derive(Debug)]
struct Node {
value: i32,
parent: RefCell<Weak<Node>>,
children: RefCell<Vec<Rc<Node>>>,
}
fn main() {
let leaf = Rc::new(Node {
value: 3,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![]),
});
println!(
"leaf strong = {}, weak = {}",
Rc::strong_count(&leaf),
Rc::weak_count(&leaf),
);
{
let branch = Rc::new(Node {
value: 5,
parent: RefCell::new(Weak::new()),
children: RefCell::new(vec![Rc::clone(&leaf)]),
});
*leaf.parent.borrow_mut() = Rc::downgrade(&branch);
println!(
"branch strong = {}, weak = {}",
Rc::strong_count(&branch),
Rc::weak_count(&branch),
);
println!(
"leaf strong = {}, weak = {}",
Rc::strong_count(&leaf),
Rc::weak_count(&leaf),
);
}
println!("leaf parent = {:?}", leaf.parent.borrow().upgrade());
println!(
"leaf strong = {}, weak = {}",
Rc::strong_count(&leaf),
Rc::weak_count(&leaf),
);
}หลังจากสร้าง leaf ขึ้นมาแล้ว ตัว Rc<Node> ของมันจะมีค่าตัวนับแบบสตรอง (strong count) เป็น 1 และตัวนับแบบวีค (weak count) เป็น 0 ในขอบเขตชั้นใน เราสร้าง branch และเชื่อมโยงมันเข้ากับ leaf ซึ่ง ณ จุดนั้น เมื่อเราพิมพ์ตัวนับออกมาดู Rc<Node> ใน branch จะมี strong count เป็น 1 และ weak count เป็น 1 (จาก leaf.parent ที่ชี้มายัง branch ด้วย Weak<Node>) และเมื่อเราพิมพ์ตัวนับใน leaf เราจะเห็นว่ามันมี strong count เป็น 2 เพราะ branch ถือครองโคลนของ Rc<Node> ของ leaf เอาไว้ใน branch.children แต่จะมี weak count เป็น 0 ตามเดิม
เมื่อขอบเขตชั้นในสิ้นสุดลง ตัวแปร branch จะหลุดออกจากขอบเขต และค่า strong count ของ Rc<Node> จะลดลงเหลือ 0 ส่งผลให้ตัว Node ของมันถูกทิ้งและคืนหน่วยความจำทันที โดยที่ weak count ที่มีค่าเป็น 1 จาก leaf.parent นั้น ไม่ได้มีผลใด ๆ ต่อการตัดสินใจว่าจะทิ้ง Node หรือไม่ เราจึงไม่มีปัญหาหน่วยความจำรั่วไหลเกิดขึ้นเลยแม้แต่น้อย!
และหากเราพยายามเข้าถึงโหนดแม่ของ leaf อีกครั้งหลังจากสิ้นสุดขอบเขตดังกล่าว เราก็จะได้ค่า None กลับมา และเมื่อถึงจุดสิ้นสุดของโปรแกรม Rc<Node> ใน leaf จะมี strong count เป็น 1 และ weak count เป็น 0 เพราะตัวแปร leaf ได้กลายเป็นการอ้างอิงเพียงหนึ่งเดียวไปยัง Rc<Node> อีกครั้ง
ตรรกะทั้งหมดที่คอยดูแลเรื่องตัวนับการอ้างอิงและการทิ้งค่านั้น ได้รับการสร้างไว้ภายใน Rc<T> และ Weak<T> ร่วมกับการอิมพลีเมนต์เทรต Drop ของพวกมันเรียบร้อยแล้ว การระบุให้ความสัมพันธ์จากโหนดลูกไปยังโหนดแม่เป็นเรเฟอเรนซ์ชนิด Weak<T> ในนิยามของ Node จึงช่วยให้คุณสามารถกำหนดให้โหนดแม่ชี้ไปยังโหนดลูก และโหนดลูกชี้ไปยังโหนดแม่ได้พร้อมกัน โดยไม่ก่อให้เกิดวงรอบการอ้างอิงและปัญหาหน่วยความจำรั่วไหล
สรุป
บทนี้ได้กล่าวถึงการใช้งานสมาร์ตพอยน์เตอร์เพื่อสร้างการรับประกันและข้อแลกเปลี่ยนที่แตกต่างไปจากสิ่งที่ Rust กำหนดไว้เป็นค่าเริ่มต้นกับเรเฟอเรนซ์ทั่วไป ชนิดข้อมูล Box<T> มีขนาดที่แน่นอนและชี้ไปยังข้อมูลที่ได้รับการจัดสรรไว้บนฮีป, ชนิดข้อมูล Rc<T> คอยติดตามจำนวนการอ้างอิงไปยังข้อมูลบนฮีปเพื่อเปิดให้ข้อมูลมีเจ้าของได้หลายรายพร้อมกัน, ส่วนชนิดข้อมูล RefCell<T> ร่วมกับรูปแบบความสามารถในการเปลี่ยนแปลงค่าภายใน ช่วยให้เรามีชนิดข้อมูลที่สามารถใช้งานในบริบทที่ต้องการความไม่สามารถแก้ไขได้ แต่ยังคงเปิดทางให้เราแก้ไขค่าภายในของมันได้ พร้อมทั้งตรวจสอบและบังคับใช้กฎการยืมในขณะรันไทม์แทนที่จะเป็นตอนคอมไพล์
นอกจากนี้ เรายังได้พูดถึงเทรต Deref และ Drop ซึ่งเป็นหัวใจสำคัญที่ขับเคลื่อนความสามารถอันหลากหลายของสมาร์ตพอยน์เตอร์ และเราได้ศึกษาเรื่องวงรอบการอ้างอิงที่อาจนำไปสู่ปัญหาหน่วยความจำรั่วไหล พร้อมทั้งวิธีป้องกันอย่างมีประสิทธิภาพโดยใช้ Weak<T>
หากเนื้อหาในบทนี้จุดประกายความสนใจของคุณ และคุณต้องการศึกษาการสร้างสมาร์ตพอยน์เตอร์ขึ้นมาใช้งานด้วยตนเอง สามารถเข้าไปอ่านข้อมูลเพิ่มเติมที่มีประโยชน์อย่างยิ่งได้ที่ “The Rustonomicon”
ในบทถัดไป เราจะมาพูดคุยกันถึงเรื่องการทำงานพร้อมกัน (concurrency) ใน Rust ซึ่งคุณยังจะได้ทำความรู้จักกับสมาร์ตพอยน์เตอร์ตัวใหม่อีกสองสามตัวด้วย!
การทำงานพร้อมกันอย่างไร้ความกลัว
การจัดการกับการเขียนโปรแกรมแบบทำงานพร้อมกันอย่างปลอดภัยและมีประสิทธิภาพเป็นอีกหนึ่งเป้าหมายสำคัญของ Rust การเขียนโปรแกรมแบบทำงานพร้อมกัน (concurrent programming) ซึ่งส่วนต่างๆ ของโปรแกรมทำงานอย่างเป็นอิสระต่อกัน และ_การเขียนโปรแกรมแบบขนาน_ (parallel programming) ซึ่งส่วนต่างๆ ของโปรแกรมทำงานในเวลาเดียวกัน กำลังทวีความสำคัญมากขึ้นเรื่อยๆ เนื่องจากคอมพิวเตอร์ในปัจจุบันใช้ประโยชน์จากหน่วยประมวลผลหลายตัว (multiple processors) มากขึ้น ในอดีต การเขียนโปรแกรมในบริบทเหล่านี้มักจะทำได้ยากและเกิดข้อผิดพลาดได้ง่าย Rust จึงมุ่งหวังที่จะเปลี่ยนแปลงสิ่งนั้น
ในตอนแรก ทีมงานของ Rust คิดว่าการรับประกันความปลอดภัยของหน่วยความจำและการป้องกันปัญหาจากการทำงานพร้อมกันเป็นความท้าทายสองเรื่องที่แยกจากกันและต้องแก้ด้วยวิธีที่ต่างกัน แต่เมื่อเวลาผ่านไป ทีมงานกลับพบว่าระบบความเป็นเจ้าของ (ownership) และระบบชนิดข้อมูล (type system) นั้นเป็นชุดเครื่องมืออันทรงพลังที่ช่วยจัดการทั้งความปลอดภัยของหน่วยความจำ_และ_ปัญหาจากการทำงานพร้อมกันไปพร้อมกันได้! ด้วยการใช้ประโยชน์จากระบบความเป็นเจ้าของและการตรวจสอบชนิดข้อมูล ข้อผิดพลาดจากการทำงานพร้อมกันหลายอย่างจึงกลายเป็นข้อผิดพลาดตั้งแต่ตอนคอมไพล์ (compile-time error) แทนที่จะหลุดไปเป็นข้อผิดพลาดตอนรันไทม์ (runtime error) ดังนั้น แทนที่จะต้องเสียเวลามากมายไปกับการพยายามจำลองสถานการณ์เพื่อหาสาเหตุของบั๊กจากการทำงานพร้อมกันที่เกิดขึ้นตอนรันไทม์ โค้ดที่ไม่ถูกต้องจะไม่สามารถคอมไพล์ผ่านได้เลย พร้อมทั้งแจ้งข้อผิดพลาดที่อธิบายปัญหาออกมาอย่างชัดเจน ส่งผลให้คุณสามารถแก้ไขโค้ดได้ทันทีในระหว่างพัฒนา แทนที่จะต้องมารอแก้หลังจากนำขึ้นใช้งานจริงบนระบบโปรดักชันแล้ว เราจึงเรียกแง่มุมนี้ของ Rust ว่า_การทำงานพร้อมกันอย่างไร้ความกลัว_ (fearless concurrency) ซึ่งช่วยให้คุณเขียนโค้ดที่ปราศจากบั๊กที่ซ่อนเร้น และสามารถรีแฟกเตอร์โค้ดได้อย่างง่ายดายโดยไม่เผลอสร้างบั๊กใหม่ขึ้นมา
หมายเหตุ: เพื่อความกระชับและเข้าใจง่าย เราจะเรียกปัญหาเหล่านี้โดยรวมว่า_การทำงานพร้อมกัน_ (concurrent) แทนที่จะต้องระบุอย่างละเอียดทุกครั้งว่าเป็น_การทำงานพร้อมกันและ/หรือการประมวลผลแบบขนาน_ (concurrent and/or parallel) ดังนั้นสำหรับในบทนี้ ขอให้คุณทำความเข้าใจในใจว่าหมายถึง_การทำงานพร้อมกันและ/หรือการประมวลผลแบบขนาน_ ทุกครั้งที่เราใช้คำว่า_การทำงานพร้อมกัน_ ส่วนในบทถัดไปซึ่งความแตกต่างระหว่างสองคำนี้มีความสำคัญมากขึ้น เราจะระบุให้เจาะจงยิ่งขึ้น
หลายภาษาโปรแกรมมีแนวทางที่ยึดติดหรือจำกัดวิธีแก้ปัญหาสำหรับการจัดการกับการทำงานพร้อมกัน ตัวอย่างเช่น ภาษา Erlang มีฟังก์ชันการทำงานที่ยอดเยี่ยมสำหรับการทำงานพร้อมกันแบบส่งผ่านข้อความ (message-passing) แต่กลับมีเพียงวิธีที่ยุ่งยากและคลุมเครือในการแชร์สถานะระหว่างเธรด (threads) การสนับสนุนเพียงแค่บางส่วนของแนวทางแก้ปัญหาที่เป็นไปได้นั้นถือเป็นกลยุทธ์ที่สมเหตุสมผลสำหรับภาษาระดับสูง (higher-level languages) เพราะภาษาระดับสูงเน้นการยอมสละการควบคุมบางอย่างเพื่อแลกกับเลเยอร์นามธรรม (abstraction) ที่สะดวกสบายกว่า อย่างไรก็ตาม ภาษาในระดับล่างกว่า (lower-level languages) มักถูกคาดหวังว่าจะต้องมอบแนวทางแก้ปัญหาที่มีประสิทธิภาพสูงสุดในทุกสถานการณ์ และมีเลเยอร์นามธรรมครอบฮาร์ดแวร์ให้น้อยที่สุด ด้วยเหตุนี้ Rust จึงมีเครื่องมือที่หลากหลายให้เลือกใช้ในการจำลองและแก้ปัญหาตามความเหมาะสมกับสถานการณ์และความต้องการของคุณ
นี่คือหัวข้อต่างๆ ที่เราจะครอบคลุมในบทนี้:
- วิธีสร้างเธรดเพื่อรันโค้ดหลายส่วนในเวลาเดียวกัน
- การทำงานพร้อมกันแบบ_ส่งผ่านข้อความ_ (message passing) โดยให้แชนเนล (channels) ส่งข้อความระหว่างเธรด
- การทำงานพร้อมกันแบบ_ใช้สถานะร่วมกัน_ (shared state) โดยให้หลายเธรดสามารถเข้าถึงข้อมูลชิ้นเดียวกันได้
- เทรต
SyncและSendซึ่งขยายการรับประกันด้านการทำงานพร้อมกันของ Rust ไปยังชนิดข้อมูลที่ผู้ใช้กำหนดขึ้นเอง รวมถึงชนิดข้อมูลที่ไลบรารีมาตรฐานจัดเตรียมไว้
ใช้เธรดรันโค้ดพร้อมกัน
ใช้เธรดรันโค้ดพร้อมกัน
ในระบบปฏิบัติการปัจจุบันส่วนใหญ่ โค้ดของโปรแกรมที่กำลังทำงานจะรันอยู่ภายใน_โปรเซส_ (process) หนึ่ง และระบบปฏิบัติการจะทำหน้าที่จัดการหลายโปรเซสไปพร้อมๆ กัน นอกจากนี้ ภายในโปรแกรมเดียวกัน คุณยังสามารถแบ่งการทำงานออกเป็นส่วนๆ ที่เป็นอิสระต่อกันและรันไปพร้อมๆ กันได้ ซึ่งกลไกหรือฟีเจอร์ที่ใช้รันส่วนต่างๆ เหล่านี้เรียกว่า_เธรด_ (threads) ตัวอย่างเช่น เว็บเซิร์ฟเวอร์อาจทำงานด้วยหลายเธรด เพื่อให้สามารถตอบสนองคำขอ (requests) ได้มากกว่าหนึ่งคำขอในเวลาเดียวกัน
การแบ่งการคำนวณในโปรแกรมของคุณออกเป็นหลายเธรดเพื่อรันหลายงานในเวลาเดียวกันสามารถช่วยเพิ่มประสิทธิภาพได้ แต่มันก็เพิ่มความซับซ้อนตามมาด้วยเช่นกัน เนื่องจากเธรดสามารถรันไปพร้อมๆ กันได้ จึงไม่มีหลักประกันโดยธรรมชาติว่าส่วนต่างๆ ของโค้ดบนแต่ละเธรดจะทำงานตามลำดับใด ซึ่งอาจนำไปสู่ปัญหาต่างๆ เช่น:
- สภาวะแย่งชิง (race conditions) เมื่อเธรดต่างๆ เข้าถึงข้อมูลหรือทรัพยากรด้วยลำดับที่ไม่แน่นอนหรือไม่สอดคล้องกัน
- เดดล็อก (deadlocks) เมื่อเธรดสองตัวต่างรอคอยซึ่งกันและกัน ส่งผลให้ทั้งสองเธรดไม่สามารถทำงานต่อได้
- บั๊กที่เกิดขึ้นเฉพาะในบางสถานการณ์เท่านั้น ทำให้ยากต่อการจำลองปัญหาและแก้ไขได้อย่างแน่นอน
Rust พยายามช่วยลดผลกระทบเชิงลบจากการใช้เธรด แต่ถึงกระนั้น การเขียนโปรแกรมในบริบทที่มีหลายเธรดก็ยังต้องอาศัยความรอบคอบ และจำเป็นต้องจัดโครงสร้างโค้ดที่แตกต่างไปจากโปรแกรมที่รันบนเธรดเดียว
ภาษาโปรแกรมต่างๆ มีวิธีอิมพลีเมนต์เธรดที่แตกต่างกันไปสองสามวิธี และระบบปฏิบัติการส่วนใหญ่ก็มี API ให้ภาษาโปรแกรมเรียกใช้เพื่อสร้างเธรดใหม่ ไลบรารีมาตรฐานของ Rust ใช้โมเดลการทำงานของเธรดแบบ 1:1 กล่าวคือ โปรแกรมจะใช้เธรดของระบบปฏิบัติการ 1 ตัวต่อเธรดของภาษา Rust 1 ตัว นอกจากนี้ยังมีเครต (crates) อื่นๆ ที่อิมพลีเมนต์โมเดลเธรดแบบทางเลือก ซึ่งมีการแลกเปลี่ยนข้อดีข้อเสีย (trade-offs) ที่แตกต่างจากโมเดล 1:1 (ทั้งนี้ ระบบ async ของ Rust ซึ่งเราจะได้เรียนรู้ในบทถัดไป ก็เป็นอีกหนึ่งแนวทางในการจัดการกับการทำงานพร้อมกันเช่นกัน)
การสร้างเธรดใหม่ด้วย spawn
ในการสร้างเธรดใหม่ เราจะเรียกใช้ฟังก์ชัน thread::spawn และส่งโคลเชอร์ (closure) เข้าไป (เราได้พูดถึงโคลเชอร์ไปแล้วในบทที่ 13) ซึ่งภายในโคลเชอร์จะบรรจุโค้ดที่เราต้องการให้รันบนเธรดใหม่ ตัวอย่างในลิสติ้ง 16-1 จะพิมพ์ข้อความบางส่วนจากเธรดหลัก (main thread) และข้อความอื่นๆ จากเธรดใหม่ที่สร้างขึ้น
use std::thread;
use std::time::Duration;
fn main() {
thread::spawn(|| {
for i in 1..10 {
println!("hi number {i} from the spawned thread!");
thread::sleep(Duration::from_millis(1));
}
});
for i in 1..5 {
println!("hi number {i} from the main thread!");
thread::sleep(Duration::from_millis(1));
}
}โปรดสังเกตว่าเมื่อเธรดหลักของโปรแกรม Rust ทำงานเสร็จสิ้น เธรดใหม่ทั้งหมดที่ถูกสร้างขึ้นจะถูกยุติการทำงานลงทันที ไม่ว่าเธรดเหล่านั้นจะทำงานเสร็จแล้วหรือไม่ก็ตาม เอาต์พุตจากการรันโปรแกรมนี้ในแต่ละครั้งอาจแตกต่างกันไปเล็กน้อย แต่จะมีลักษณะคล้ายกับตัวอย่างต่อไปนี้:
hi number 1 from the main thread!
hi number 1 from the spawned thread!
hi number 2 from the main thread!
hi number 2 from the spawned thread!
hi number 3 from the main thread!
hi number 3 from the spawned thread!
hi number 4 from the main thread!
hi number 4 from the spawned thread!
hi number 5 from the spawned thread!
การเรียก thread::sleep จะบังคับให้เธรดหยุดการทำงานชั่วคราวเป็นระยะเวลาสั้นๆ เพื่อเปิดโอกาสให้เธรดอื่นได้ทำงาน เธรดต่างๆ อาจจะสลับกันทำงาน แต่ก็ไม่มีการรับประกัน เพราะขึ้นอยู่กับว่าระบบปฏิบัติการจัดตารางเวลาการทำงาน (schedule) ให้กับเธรดอย่างไร ในการรันรอบนี้ เธรดหลักพิมพ์ออกมาก่อน แม้ว่าคำสั่งพิมพ์ของเธรดใหม่จะปรากฏเป็นบรรทัดแรกในโค้ดก็ตาม และถึงแม้ว่าเราจะสั่งให้เธรดใหม่พิมพ์วนลูปไปจนกระทั่ง i เท่ากับ 9 แต่มันก็ทำได้ถึงแค่ 5 ก่อนที่เธรดหลักจะทำงานเสร็จและปิดโปรแกรมไป
หากคุณรันโค้ดนี้แล้วเห็นเพียงเอาต์พุตจากเธรดหลัก หรือไม่เห็นการสลับกันของเอาต์พุตเลย ให้ลองเพิ่มตัวเลขในช่วง (range) ของลูป เพื่อเปิดโอกาสให้ระบบปฏิบัติการสลับการทำงานระหว่างเธรดได้มากขึ้น
การรอให้เธรดทั้งหมดทำงานเสร็จ
โค้ดในลิสติ้ง 16-1 ไม่เพียงแต่มักจะหยุดการทำงานของเธรดใหม่ก่อนเวลาอันควรเนื่องจากเธรดหลักทำงานเสร็จสิ้นก่อนเท่านั้น แต่เนื่องจากไม่มีการรับประกันลำดับการทำงานของแต่ละเธรด เราจึงไม่สามารถรับประกันได้เลยว่าเธรดใหม่จะมีโอกาสได้เริ่มรันหรือไม่!
เราสามารถแก้ปัญหาที่เธรดใหม่ไม่ได้รันหรือหยุดทำงานก่อนเวลาอันควรได้ โดยการเก็บค่าที่คืนกลับมาจาก thread::spawn ไว้ในตัวแปร ซึ่งชนิดข้อมูลที่คืนกลับมาจาก thread::spawn คือ JoinHandle<T> โดย JoinHandle<T> คือค่าที่ถือครองความเป็นเจ้าของ ซึ่งเมื่อเราเรียกเมธอด join บนแฮนเดิลนี้ มันจะรอจนกว่าเธรดของมันจะทำงานเสร็จสิ้น ลิสติ้ง 16-2 แสดงวิธีใช้ JoinHandle<T> ของเธรดที่เราสร้างในลิสติ้ง 16-1 และการเรียก join เพื่อให้แน่ใจว่าเธรดใหม่จะรันจนเสร็จก่อนที่ main จะจบการทำงาน
use std::thread;
use std::time::Duration;
fn main() {
let handle = thread::spawn(|| {
for i in 1..10 {
println!("hi number {i} from the spawned thread!");
thread::sleep(Duration::from_millis(1));
}
});
for i in 1..5 {
println!("hi number {i} from the main thread!");
thread::sleep(Duration::from_millis(1));
}
handle.join().unwrap();
}การเรียก join บนแฮนเดิล (handle) จะบล็อก (block) เธรดที่กำลังทำงานอยู่ ณ ขณะนั้นไว้ จนกว่าเธรดที่แฮนเดิลนั้นเป็นตัวแทนจะทำงานเสร็จสิ้น การบล็อก เธรดหมายความว่าเธรดดังกล่าวจะถูกระงับไม่ให้ทำงานอื่นต่อหรือจบการทำงาน และเนื่องจากเราวางการเรียก join ไว้หลังจากลูป for ของเธรดหลัก การรันลิสติ้ง 16-2 จึงควรให้เอาต์พุตที่คล้ายกับสิ่งนี้:
hi number 1 from the main thread!
hi number 2 from the main thread!
hi number 1 from the spawned thread!
hi number 3 from the main thread!
hi number 2 from the spawned thread!
hi number 4 from the main thread!
hi number 3 from the spawned thread!
hi number 4 from the spawned thread!
hi number 5 from the spawned thread!
hi number 6 from the spawned thread!
hi number 7 from the spawned thread!
hi number 8 from the spawned thread!
hi number 9 from the spawned thread!
ทั้งสองเธรดยังคงสลับกันทำงาน แต่เธรดหลักจะหยุดรอเนื่องจากมีการเรียก handle.join() และจะไม่จบการทำงานจนกว่าเธรดใหม่จะทำงานเสร็จสิ้น
แต่ลองมาดูกันว่าจะเกิดอะไรขึ้นหากเราย้าย handle.join() มาไว้ก่อนหน้าลูป for ใน main แทน ดังนี้:
use std::thread;
use std::time::Duration;
fn main() {
let handle = thread::spawn(|| {
for i in 1..10 {
println!("hi number {i} from the spawned thread!");
thread::sleep(Duration::from_millis(1));
}
});
handle.join().unwrap();
for i in 1..5 {
println!("hi number {i} from the main thread!");
thread::sleep(Duration::from_millis(1));
}
}เธรดหลักจะรอจนกว่าเธรดใหม่จะทำงานเสร็จสิ้นก่อน แล้วจึงค่อยเริ่มรันลูป for ของตัวเอง ทำให้เอาต์พุตไม่สลับกันอีกต่อไป ดังที่แสดงที่นี่:
hi number 1 from the spawned thread!
hi number 2 from the spawned thread!
hi number 3 from the spawned thread!
hi number 4 from the spawned thread!
hi number 5 from the spawned thread!
hi number 6 from the spawned thread!
hi number 7 from the spawned thread!
hi number 8 from the spawned thread!
hi number 9 from the spawned thread!
hi number 1 from the main thread!
hi number 2 from the main thread!
hi number 3 from the main thread!
hi number 4 from the main thread!
รายละเอียดเล็กๆ น้อยๆ เช่น ตำแหน่งที่มีการเรียก join สามารถส่งผลได้ว่าเธรดของคุณจะทำงานไปพร้อมๆ กันหรือไม่
การใช้โคลเชอร์ move กับเธรด
เรามักจะใช้คำสงวน move ร่วมกับโคลเชอร์ที่ส่งไปยัง thread::spawn บ่อยครั้ง เนื่องจากโคลเชอร์จะรับความเป็นเจ้าของ (ownership) ในค่าต่างๆ ที่มันใช้งานมาจากสภาพแวดล้อม ซึ่งเป็นการถ่ายโอนความเป็นเจ้าของค่าเหล่านั้นจากเธรดหนึ่งไปยังอีกเธรดหนึ่ง ใน“การจับเรเฟอเรนซ์หรือการย้ายความเป็นเจ้าของ” ในบทที่ 13 เราได้พูดคุยถึง move ในบริบทของโคลเชอร์ ตอนนี้เราจะมุ่งเน้นไปที่ปฏิสัมพันธ์ระหว่าง move กับ thread::spawn มากขึ้น
โปรดสังเกตว่าในลิสติ้ง 16-1 โคลเชอร์ที่เราส่งให้ thread::spawn ไม่ได้รับอาร์กิวเมนต์ใดๆ: เราไม่ได้ใช้ข้อมูลใดจากเธรดหลักในโค้ดของเธรดใหม่เลย แต่หากเราต้องการนำข้อมูลจากเธรดหลักไปใช้งานในเธรดใหม่ โคลเชอร์ของเธรดใหม่จำเป็นต้องจับค่าที่ต้องการจากสภาพแวดล้อม ลิสติ้ง 16-3 แสดงตัวอย่างความพยายามสร้างเวกเตอร์ในเธรดหลักแล้วนำไปใช้งานในเธรดใหม่ อย่างไรก็ตาม โค้ดนี้จะยังคอมไพล์ไม่ผ่าน ดังที่คุณจะได้เห็นในไม่ช้า
use std::thread;
fn main() {
let v = vec![1, 2, 3];
let handle = thread::spawn(|| {
println!("Here's a vector: {v:?}");
});
handle.join().unwrap();
}เนื่องจากโคลเชอร์เรียกใช้ v มันจึงจับค่า v เข้ามาเป็นส่วนหนึ่งของสภาพแวดล้อมของโคลเชอร์ และเนื่องจาก thread::spawn รันโคลเชอร์นี้บนเธรดใหม่ เราจึงควรสามารถเข้าถึง v ภายในเธรดใหม่นั้นได้ แต่เมื่อเราคอมไพล์ตัวอย่างนี้ เราจะพบกับข้อผิดพลาดต่อไปนี้:
$ cargo run
Compiling threads v0.1.0 (file:///projects/threads)
error[E0373]: closure may outlive the current function, but it borrows `v`, which is owned by the current function
--> src/main.rs:6:32
|
6 | let handle = thread::spawn(|| {
| ^^ may outlive borrowed value `v`
7 | println!("Here's a vector: {v:?}");
| - `v` is borrowed here
|
note: function requires argument type to outlive `'static`
--> src/main.rs:6:18
|
6 | let handle = thread::spawn(|| {
| __________________^
7 | | println!("Here's a vector: {v:?}");
8 | | });
| |______^
help: to force the closure to take ownership of `v` (and any other referenced variables), use the `move` keyword
|
6 | let handle = thread::spawn(move || {
| ++++
For more information about this error, try `rustc --explain E0373`.
error: could not compile `threads` (bin "threads") due to 1 previous error
Rust จะ_อนุมาน_วิธีที่โคลเชอร์ควรใช้ในการจับค่า v และเนื่องจากคำสั่ง println! ต้องการเพียงเรเฟอเรนซ์ไปยัง v เท่านั้น โคลเชอร์จึงพยายามยืม (borrow) ค่า v แต่ปัญหาคือ: Rust ไม่สามารถล่วงรู้ได้เลยว่าเธรดใหม่จะทำงานนานเท่าใด จึงไม่อาจรับประกันได้ว่าเรเฟอเรนซ์ที่ชี้ไปยัง v นั้นจะยังคงใช้งานได้ตลอดไปหรือไม่
ลิสติ้ง 16-4 แสดงสถานการณ์ที่ชี้ให้เห็นชัดเจนว่าทำไมเรเฟอเรนซ์ไปยัง v จึงอาจกลายเป็นเรเฟอเรนซ์ที่ไม่ถูกต้องได้
use std::thread;
fn main() {
let v = vec![1, 2, 3];
let handle = thread::spawn(|| {
println!("Here's a vector: {v:?}");
});
drop(v); // oh no!
handle.join().unwrap();
}หาก Rust ยอมให้โค้ดนี้ทำงาน มีความเป็นไปได้ว่าเธรดใหม่ที่ถูกสร้างขึ้นอาจยังไม่ทันได้เริ่มทำงานเลยด้วยซ้ำ ในขณะที่เธรดหลักทำงานต่อและสั่งทิ้ง (drop) ค่า v ทันทีด้วยฟังก์ชัน drop ที่เราได้เรียนรู้ในบทที่ 15 เมื่อเธรดใหม่ได้คิวเริ่มทำงานในภายหลัง ค่า v ก็ไม่อยู่ในหน่วยความจำอีกต่อไปแล้ว ส่งผลให้เรเฟอเรนซ์ที่เธรดใหม่ถืออยู่ชี้ไปยังหน่วยความจำที่ไม่ถูกต้องทันที!
ในการแก้ข้อผิดพลาดของคอมไพเลอร์ในลิสติ้ง 16-3 เราสามารถใช้คำแนะนำจากข้อความแสดงข้อผิดพลาดได้:
help: to force the closure to take ownership of `v` (and any other referenced variables), use the `move` keyword
|
6 | let handle = thread::spawn(move || {
| ++++
การใส่คำสงวน move ไว้หน้าโคลเชอร์จะบังคับให้โคลเชอร์รับสิทธิ์ความเป็นเจ้าของในค่าต่างๆ ที่มันใช้งานโดยตรง แทนที่จะปล่อยให้ Rust อนุมานว่าควรยืมค่านั้นมา การแก้ไขลิสติ้ง 16-3 ดังแสดงในลิสติ้ง 16-5 จะทำให้โค้ดสามารถคอมไพล์ผ่านและทำงานได้ตามที่เราตั้งใจไว้
use std::thread;
fn main() {
let v = vec![1, 2, 3];
let handle = thread::spawn(move || {
println!("Here's a vector: {v:?}");
});
handle.join().unwrap();
}เราอาจสงสัยว่าจะลองใช้วิธีเดียวกันนี้เพื่อแก้ไขโค้ดในลิสติ้ง 16-4 ที่เธรดหลักเรียก drop ได้หรือไม่ แต่การเติม move จะไม่ช่วยให้โค้ดนั้นทำงานได้ เพราะสิ่งที่ลิสติ้ง 16-4 พยายามทำนั้นขัดต่อกฎด้วยเหตุผลอีกประการหนึ่ง: หากเราใส่ move ให้กับโคลเชอร์ เราจะย้ายสิทธิ์ความเป็นเจ้าของของ v เข้าไปในโคลเชอร์ ทำให้เธรดหลักไม่สามารถเรียก drop บนตัวแปร v ได้อีกต่อไป คอมไพเลอร์จะแจ้งข้อผิดพลาดดังนี้แทน:
$ cargo run
Compiling threads v0.1.0 (file:///projects/threads)
error[E0382]: use of moved value: `v`
--> src/main.rs:10:10
|
4 | let v = vec![1, 2, 3];
| - move occurs because `v` has type `Vec<i32>`, which does not implement the `Copy` trait
5 |
6 | let handle = thread::spawn(move || {
| ------- value moved into closure here
7 | println!("Here's a vector: {v:?}");
| - variable moved due to use in closure
...
10 | drop(v); // oh no!
| ^ value used here after move
|
help: consider cloning the value before moving it into the closure
|
6 ~ let value = v.clone();
7 ~ let handle = thread::spawn(move || {
8 ~ println!("Here's a vector: {value:?}");
|
For more information about this error, try `rustc --explain E0382`.
error: could not compile `threads` (bin "threads") due to 1 previous error
กฎความเป็นเจ้าของของ Rust ช่วยปกป้องเราไว้อีกครั้ง! ในลิสติ้ง 16-3 เราพบข้อผิดพลาดเพราะ Rust ทำงานด้วยความระมัดระวังสูงสุด โดยเลือกที่จะยืม v ให้กับเธรดใหม่ ซึ่งในทางทฤษฎีแล้ว เธรดหลักอาจทำให้เรเฟอเรนซ์นั้นกลายเป็นโมฆะได้ แต่เมื่อเราสั่งให้ย้ายสิทธิ์ความเป็นเจ้าของของ v ไปยังเธรดใหม่ Rust ก็มั่นใจได้ทันทีว่าเธรดหลักจะไม่ยุ่งเกี่ยวกับ v อีกต่อไป ส่วนในลิสติ้ง 16-4 หากเราพยายามทำแบบเดียวกัน ก็จะกลายเป็นการละเมิดกฎความเป็นเจ้าของเมื่อเราพยายามเรียกใช้ v ในเธรดหลักซ้ำอีก คำสงวน move มีไว้เพื่อแทนที่พฤติกรรมการยืมโดยปริยายของ Rust แต่ไม่ได้เปิดช่องให้เราละเมิดกฎความเป็นเจ้าของได้แต่อย่างใด
เมื่อเราเข้าใจแล้วว่าเธรดคืออะไร และเมธอดต่างๆ ใน API ของเธรดทำงานอย่างไร ต่อไปเรามาดูสถานการณ์การใช้งานจริงในรูปแบบต่างๆ ของเธรดกันครับ
ส่งข้อมูลระหว่างเธรดด้วยการส่งผ่านข้อความ
ส่งข้อมูลระหว่างเธรดด้วยการส่งผ่านข้อความ
แนวทางหนึ่งที่ได้รับความนิยมเพิ่มขึ้นเรื่อยๆ ในการรับประกันความปลอดภัยของการทำงานพร้อมกัน (concurrency) คือการส่งผ่านข้อความ (message passing) โดยที่เธรด (threads) หรือแอกเตอร์ (actors) จะสื่อสารกันโดยการส่งข้อความที่มีข้อมูลบรรจุอยู่ให้แก่กันและกัน แนวคิดนี้สรุปไว้เป็นสโลแกนในเอกสารภาษา Go ว่า: “อย่าสื่อสารกันด้วยการแชร์หน่วยความจำ แต่จงแชร์หน่วยความจำด้วยการสื่อสารกัน”
เพื่อให้สามารถทำงานพร้อมกันแบบส่งผ่านข้อความได้ ไลบรารีมาตรฐานของ Rust จึงได้เตรียมการอิมพลีเมนต์แชนเนล (channels) ไว้ โดย_แชนเนล_ถือเป็นแนวคิดทั่วไปในการเขียนโปรแกรมที่ใช้สำหรับส่งข้อมูลจากเธรดหนึ่งไปยังอีกเธรดหนึ่ง
คุณสามารถจินตนาการถึงแชนเนลในการเขียนโปรแกรมว่าเปรียบเสมือนลำน้ำที่มีทิศทางการไหล เช่น ลำธารหรือแม่น้ำ หากคุณปล่อยวัตถุอย่างเป็ดยางลงไปในแม่น้ำ มันก็จะลอยตามน้ำไปจนถึงปลายน้ำ
แชนเนลประกอบด้วยสองส่วนหลักคือ: ฝั่งส่ง (transmitter) และฝั่งรับ (receiver) ฝั่งส่งคือตำแหน่งต้นน้ำที่คุณปล่อยเป็ดยางลงน้ำ และฝั่งรับคือตำแหน่งปลายน้ำที่เป็ดยางลอยไปถึง โค้ดส่วนหนึ่งของคุณจะเรียกเมธอดบนฝั่งส่งพร้อมส่งข้อมูลที่ต้องการส่งออกไป และอีกส่วนหนึ่งจะคอยตรวจสอบฝั่งรับว่ามีข้อความส่งมาถึงหรือไม่ แชนเนลจะถือว่า_ปิดตัวลง_ (closed) หากฝั่งส่งหรือฝั่งรับฝั่งใดฝั่งหนึ่งถูกทิ้ง (dropped) หรือทำลายไป
ในที่นี้ เราจะค่อยๆ พัฒนาโปรแกรมที่มีเธรดหนึ่งคอยสร้างค่าและส่งค่าเหล่านั้นผ่านแชนเนล และอีกเธรดหนึ่งคอยรับค่าเพื่อนำมาพิมพ์แสดงผล เราจะส่งค่าง่ายๆ ระหว่างเธรดโดยใช้แชนเนลเพื่อแสดงให้เห็นการทำงานของฟีเจอร์นี้ เมื่อคุณเข้าใจและคุ้นเคยกับเทคนิคนี้แล้ว คุณสามารถนำแชนเนลไปประยุกต์ใช้กับเธรดใดๆ ที่จำเป็นต้องสื่อสารกัน เช่น ระบบแชต หรือระบบที่หลายๆ เธรดช่วยกันคำนวณงานย่อยแล้วส่งผลลัพธ์มารวมกันที่เธรดเดียว
ก่อนอื่น ในลิสติ้ง 16-6 เราจะเริ่มจากการสร้างแชนเนลขึ้นมาก่อนแต่ยังไม่ทำอะไรกับมัน โปรดทราบว่าโค้ดนี้จะยังไม่สามารถคอมไพล์ผ่านได้ เพราะ Rust ไม่สามารถอนุมานได้ว่าเราต้องการส่งค่าชนิดข้อมูลใดผ่านแชนเนล
use std::sync::mpsc;
fn main() {
let (tx, rx) = mpsc::channel();
}เราสร้างแชนเนลใหม่โดยใช้ฟังก์ชัน mpsc::channel โดยที่คำว่า mpsc ย่อมาจาก ผู้ผลิตหลายราย ผู้บริโภครายเดียว (multiple producer, single consumer) สรุปง่ายๆ ก็คือ วิธีที่ไลบรารีมาตรฐานของ Rust อิมพลีเมนต์แชนเนลนั้นอนุญาตให้แชนเนลมีฝั่งส่ง (sending ends) ที่คอยผลิตค่าได้หลายตัว แต่สามารถมีฝั่งรับ (receiving end) ที่คอยนำค่านั้นไปใช้งานได้เพียงตัวเดียวเท่านั้น ลองนึกภาพลำธารหลายสายที่ไหลมารวมกันเป็นแม่น้ำใหญ่สายเดียว: สิ่งใดก็ตามที่ถูกปล่อยลงในลำธารสายใดสายหนึ่ง สุดท้ายก็จะลอยมารวมอยู่ที่แม่น้ำสายเดียวกันในที่สุด ตอนนี้เราจะเริ่มต้นด้วยผู้ผลิตเพียงรายเดียวก่อน แล้วค่อยเพิ่มผู้ผลิตหลายรายเมื่อตัวอย่างนี้ทำงานได้เรียบร้อยแล้ว
ฟังก์ชัน mpsc::channel จะคืนค่ากลับมาเป็นทูเพิล (tuple) โดยสมาชิกตัวแรกคือฝั่งส่ง—ตัวส่ง (transmitter)—และสมาชิกตัวที่สองคือฝั่งรับ—ตัวรับ (receiver) ตัวย่อ tx และ rx เป็นคำที่นิยมใช้กันตามธรรมเนียมในหลายวงการสำหรับแทน_ตัวส่ง_ (transmitter) และ_ตัวรับ_ (receiver) ตามลำดับ เราจึงตั้งชื่อตัวแปรตามนั้นเพื่อระบุถึงแต่ละฝั่ง เราใช้คำสั่ง let ร่วมกับแพตเทิร์นเพื่อแจกแจงโครงสร้าง (destructuring) สมาชิกของทูเพิลออกมา ซึ่งเราจะได้เรียนรู้การใช้แพตเทิร์นและ destructuring ในคำสั่ง let เพิ่มเติมในบทที่ 19 สำหรับตอนนี้ ขอให้เข้าใจว่าการใช้คำสั่ง let ในลักษณะนี้เป็นวิธีที่สะดวกในการดึงชิ้นส่วนต่างๆ ของทูเพิลที่ mpsc::channel คืนกลับมา
คราวนี้เรามาย้ายฝั่งส่งเข้าไปไว้ในเธรดที่ถูกสร้างขึ้นและสั่งให้มันส่งข้อความสตริงข้อความหนึ่ง เพื่อให้เธรดที่ถูกสร้างสื่อสารกับเธรดหลักได้ ดังแสดงในลิสติ้ง 16-7 ซึ่งเปรียบเหมือนการใส่เป็ดยางลงในแม่น้ำทางต้นน้ำ หรือการส่งข้อความแชตจากเธรดหนึ่งไปยังอีกเธรดหนึ่ง
use std::sync::mpsc;
use std::thread;
fn main() {
let (tx, rx) = mpsc::channel();
thread::spawn(move || {
let val = String::from("hi");
tx.send(val).unwrap();
});
}เช่นเคย เราใช้ thread::spawn เพื่อสร้างเธรดใหม่ จากนั้นใช้คำสงวน move เพื่อย้าย tx เข้าไปในโคลเชอร์ (closure) ทำให้เธรดใหม่ได้รับสิทธิ์ความเป็นเจ้าของใน tx ซึ่งเธรดใหม่จำเป็นต้องเป็นเจ้าของตัวส่งนี้เพื่อจะสามารถส่งข้อความผ่านแชนเนลได้
ตัวส่งมีเมธอด send ที่รับค่าที่เราต้องการส่งเข้ามา โดยเมธอด send จะส่งคืนค่าเป็นชนิด Result<T, E> ดังนั้นหากฝั่งตัวรับถูกทิ้ง (drop) ไปแล้วและไม่มีผู้ใดคอยรอรับค่าอีกต่อไป การดำเนินการส่งข้อความก็จะส่งคืนค่าเป็นข้อผิดพลาดออกมา ในตัวอย่างนี้ เราเรียก unwrap เพื่อให้เกิดการแพนิก (panic) หากมีข้อผิดพลาดเกิดขึ้น แต่ในแอปพลิเคชันจริง เราควรจัดการข้อผิดพลาดอย่างเหมาะสม ซึ่งคุณสามารถทบทวนกลยุทธ์การจัดการข้อผิดพลาดได้จากบทที่ 9
ในลิสติ้ง 16-8 เราจะรับค่าจากตัวรับในเธรดหลัก ซึ่งเปรียบเหมือนการเก็บเป็ดยางขึ้นมาจากน้ำที่ปลายแม่น้ำ หรือการรับข้อความแชต
use std::sync::mpsc;
use std::thread;
fn main() {
let (tx, rx) = mpsc::channel();
thread::spawn(move || {
let val = String::from("hi");
tx.send(val).unwrap();
});
let received = rx.recv().unwrap();
println!("Got: {received}");
}ฝั่งตัวรับมีเมธอดที่มีประโยชน์สองตัว ได้แก่: recv และ try_recv ในที่นี้เราเลือกใช้ recv ซึ่งย่อมาจาก receive โดยเมธอดนี้จะบล็อก (block) การทำงานของเธรดหลักไว้เพื่อรอจนกว่าจะมีค่าถูกส่งมาตามแชนเนล และเมื่อมีค่าส่งมาถึง recv จะส่งคืนค่านั้นออกมาในห่อ Result<T, E> และเมื่อฝั่งตัวส่งปิดตัวลง (closed) เมธอด recv ก็จะส่งคืนข้อผิดพลาดออกมาเพื่อส่งสัญญาณแจ้งว่า จะไม่มีข้อมูลใดๆ ถูกส่งมาอีกแล้ว
ส่วนเมธอด try_recv จะไม่บล็อกการทำงานของเธรด แต่จะส่งคืนค่าเป็น Result<T, E> ออกมาทันที: หากมีข้อความรออยู่ ก็จะส่งคืนค่า Ok ที่บรรจุข้อความนั้นออกมา และจะส่งคืนค่า Err หากในขณะนั้นยังไม่มีข้อความใดๆ ส่งมาถึงเลย การใช้ try_recv มีประโยชน์อย่างยิ่งหากเธรดนั้นมีงานอื่นที่ต้องทำระหว่างรอข้อความ เช่น เราอาจเขียนลูปที่คอยเรียก try_recv เป็นระยะๆ เพื่อประมวลผลข้อความหากมีเข้ามา และหากยังไม่มี ก็สามารถสลับไปทำงานอื่นก่อนได้แล้วค่อยวนกลับมาตรวจสอบใหม่
ในตัวอย่างนี้เราเลือกใช้ recv เพื่อความเรียบง่าย เนื่องจากเธรดหลักไม่มีงานอื่นที่ต้องทำนอกจากการรอข้อความ การสั่งบล็อกเธรดหลักไว้จึงเป็นแนวทางที่เหมาะสม
เมื่อเรารันโค้ดในลิสติ้ง 16-8 เราจะเห็นค่าที่ถูกพิมพ์ออกมาจากเธรดหลัก:
Got: hi
ยอดเยี่ยมมาก!
การถ่ายโอนความเป็นเจ้าของผ่านแชนเนล
กฎความเป็นเจ้าของมีบทบาทสำคัญอย่างยิ่งต่อการส่งข้อความ เพราะมันช่วยรับประกันว่าโค้ดที่ทำงานพร้อมกันจะปลอดภัยเสมอ การป้องกันข้อผิดพลาดในการทำงานพร้อมกันถือเป็นข้อได้เปรียบสำคัญของการนำระบบความเป็นเจ้าของมาใช้ทั่วทั้งโปรแกรม Rust มาลองทำการทดลองเพื่อดูว่าแชนเนลและระบบความเป็นเจ้าของทำงานประสานกันอย่างไรในการป้องกันปัญหา: เราจะลองเรียกใช้ค่า val ในเธรดใหม่_หลังจาก_ที่ได้ส่งค่านั้นผ่านแชนเนลไปแล้ว ลองคอมไพล์โค้ดในลิสติ้ง 16-9 เพื่อดูว่าทำไม Rust จึงไม่อนุญาตให้ทำเช่นนั้น
use std::sync::mpsc;
use std::thread;
fn main() {
let (tx, rx) = mpsc::channel();
thread::spawn(move || {
let val = String::from("hi");
tx.send(val).unwrap();
println!("val is {val}");
});
let received = rx.recv().unwrap();
println!("Got: {received}");
}ในตัวอย่างนี้ เราพยายามพิมพ์ค่า val ออกมาหลังจากที่ได้ส่งมันผ่านแชนเนลไปด้วย tx.send ไปแล้ว การยินยอมให้ทำเช่นนี้ย่อมเป็นอันตรายอย่างยิ่ง: เพราะเมื่อค่านั้นถูกส่งไปยังอีกเธรดหนึ่งแล้ว เธรดปลายทางอาจแก้ไขหรือทิ้งค่านั้นไปก่อนที่เราจะเรียกใช้มันซ้ำ การที่เธรดอื่นแอบแก้ไขข้อมูลอาจทำให้เกิดข้อผิดพลาดร้ายแรงหรือได้ผลลัพธ์ที่ผิดเพี้ยนไป เนื่องจากข้อมูลอาจไม่สอดคล้องกันหรือไม่คงอยู่อีกต่อไปแล้ว ทว่า Rust จะแจ้งข้อผิดพลาดทันทีตั้งแต่ตอนคอมไพล์โค้ดในลิสติ้ง 16-9:
$ cargo run
Compiling message-passing v0.1.0 (file:///projects/message-passing)
error[E0382]: borrow of moved value: `val`
--> src/main.rs:10:27
|
8 | let val = String::from("hi");
| --- move occurs because `val` has type `String`, which does not implement the `Copy` trait
9 | tx.send(val).unwrap();
| --- value moved here
10 | println!("val is {val}");
| ^^^ value borrowed here after move
For more information about this error, try `rustc --explain E0382`.
error: could not compile `message-passing` (bin "message-passing") due to 1 previous error
ความผิดพลาดในการเขียนโปรแกรมแบบทำงานพร้อมกันของเราถูกตรวจจับได้ตั้งแต่ขั้นตอนการคอมไพล์! ฟังก์ชัน send จะรับสิทธิ์ความเป็นเจ้าของในพารามิเตอร์ของมัน และเมื่อค่านั้นถูกย้าย (move) ฝั่งตัวรับก็จะกลายเป็นเจ้าของใหม่ของค่านั้นทันที กลไกนี้ช่วยป้องกันไม่ให้เราเผลอนำค่านั้นกลับมาใช้งานซ้ำหลังจากส่งมันออกไปแล้ว ระบบความเป็นเจ้าของจึงทำหน้าที่เป็นเกราะป้องกันข้อผิดพลาดได้อย่างสมบูรณ์แบบ
การส่งหลายค่า
โค้ดในลิสติ้ง 16-8 สามารถคอมไพล์และรันได้ก็จริง แต่มันยังไม่ได้แสดงให้เราเห็นอย่างชัดเจนว่า เธรดทั้งสองตัวกำลังทำงานและสื่อสารกันไปพร้อมๆ กันจริงหรือไม่
ในลิสติ้ง 16-10 เราจึงปรับปรุงโค้ดเพื่อพิสูจน์ให้เห็นว่าโค้ดกำลังทำงานแบบพร้อมกันจริงๆ: คราวนี้เธรดใหม่จะส่งข้อความหลายข้อความ โดยหยุดพักเป็นเวลาหนึ่งวินาทีระหว่างการส่งแต่ละข้อความ
use std::sync::mpsc;
use std::thread;
use std::time::Duration;
fn main() {
let (tx, rx) = mpsc::channel();
thread::spawn(move || {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("thread"),
];
for val in vals {
tx.send(val).unwrap();
thread::sleep(Duration::from_secs(1));
}
});
for received in rx {
println!("Got: {received}");
}
}ในครั้งนี้ เธรดใหม่จะมีเวกเตอร์ของสตริงที่ต้องการส่งไปยังเธรดหลัก เราวนซ้ำส่งข้อความทีละตัว และหยุดพักระหว่างแต่ละข้อความโดยเรียกฟังก์ชัน thread::sleep กำหนดช่วงเวลา Duration เป็นหนึ่งวินาที
ส่วนในเธรดหลัก เราไม่ได้เรียกฟังก์ชัน recv ด้วยตนเองอีกต่อไป: แต่เราสามารถมอง rx ให้ทำหน้าที่เป็นอิเทอเรเตอร์ (iterator) ได้โดยตรง โดยในแต่ละรอบของการวนซ้ำ เราจะพิมพ์ค่าที่ได้รับออกมา และเมื่อแชนเนลถูกปิดตัวลง การวนซ้ำของลูปก็จะสิ้นสุดลงโดยอัตโนมัติ
เมื่อรันโค้ดในลิสติ้ง 16-10 คุณควรเห็นเอาต์พุตต่อไปนี้โดยมีช่วงหยุดพักหนึ่งวินาทีระหว่างแต่ละบรรทัด:
Got: hi
Got: from
Got: the
Got: thread
เนื่องจากเราไม่ได้ใส่โค้ดหน่วงเวลาใดๆ ไว้ในลูป for ของเธรดหลักเลย เราจึงเห็นได้อย่างชัดเจนว่า เธรดหลักกำลังหยุดรอรับค่าที่ทยอยส่งมาจากเธรดใหม่อยู่จริงๆ
การสร้างผู้ผลิตหลายราย
ก่อนหน้านี้เราได้กล่าวไว้ว่า mpsc ย่อมาจาก ผู้ผลิตหลายราย ผู้บริโภครายเดียว (multiple producer, single consumer) ตอนนี้เรามาใช้ประโยชน์จากความสามารถนี้ ด้วยการขยายโค้ดในลิสติ้ง 16-10 เพื่อสร้างหลายๆ เธรดที่ต่างส่งข้อความเข้ามายังตัวรับตัวเดียวกัน เราสามารถทำได้โดยการโคลน (clone) ฝั่งตัวส่ง ดังแสดงในลิสติ้ง 16-11
use std::sync::mpsc;
use std::thread;
use std::time::Duration;
fn main() {
// --snip--
let (tx, rx) = mpsc::channel();
let tx1 = tx.clone();
thread::spawn(move || {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("thread"),
];
for val in vals {
tx1.send(val).unwrap();
thread::sleep(Duration::from_secs(1));
}
});
thread::spawn(move || {
let vals = vec![
String::from("more"),
String::from("messages"),
String::from("for"),
String::from("you"),
];
for val in vals {
tx.send(val).unwrap();
thread::sleep(Duration::from_secs(1));
}
});
for received in rx {
println!("Got: {received}");
}
// --snip--
}ในคราวนี้ ก่อนที่เราจะสร้างเธรดใหม่ตัวแรก เราได้เรียก clone บนตัวส่ง tx ซึ่งจะทำให้เราได้ตัวส่งตัวใหม่มาอีกหนึ่งตัว เพื่อส่งมอบให้เธรดแรกนำไปใช้ จากนั้นเราจึงส่งตัวส่งตัวเดิมให้กับเธรดที่สอง ทำให้เรามีสองเธรดที่ต่างส่งข้อความไปยังตัวรับตัวเดียวกันได้พร้อมๆ กัน
เมื่อคุณรันโค้ด เอาต์พุตของคุณควรมีหน้าตาประมาณนี้:
Got: hi
Got: more
Got: from
Got: messages
Got: for
Got: the
Got: thread
Got: you
คุณอาจเห็นลำดับของข้อความเหล่านี้แตกต่างกันไป ขึ้นอยู่กับระบบของคุณ ซึ่งนี่คือเสน่ห์และความท้าทายของการเขียนโปรแกรมแบบทำงานพร้อมกัน หากคุณลองปรับเปลี่ยนระยะเวลาหน่วงใน thread::sleep บนแต่ละเธรด การรันในแต่ละครั้งก็จะยิ่งให้ลำดับผลลัพธ์ที่หลากหลายและคาดเดาได้ยากขึ้น
เมื่อเราได้เห็นการทำงานของแชนเนลไปแล้ว ต่อไปเรามาดูอีกหนึ่งแนวทางสำคัญในการทำงานพร้อมกัน นั่นคือการแชร์สถานะร่วมกันครับ
การทำงานพร้อมกันแบบใช้สถานะร่วมกัน
การทำงานพร้อมกันแบบใช้สถานะร่วมกัน
การส่งผ่านข้อความ (message passing) เป็นวิธีที่ดีในการจัดการการทำงานพร้อมกัน (concurrency) แต่นั่นไม่ใช่วิธีเดียว อีกวิธีหนึ่งคือการให้หลายๆ เธรดสามารถเข้าถึงข้อมูลที่ใช้งานร่วมกัน (shared data) ได้ ลองพิจารณาส่วนหนึ่งของสโลแกนจากเอกสารภาษา Go อีกครั้ง: “อย่าสื่อสารกันด้วยการแชร์หน่วยความจำ”
แล้วการสื่อสารด้วยการแชร์หน่วยความจำจะมีลักษณะเป็นอย่างไร? นอกจากนี้ ทำไมผู้ที่สนับสนุนการส่งผ่านข้อความจึงเตือนไม่ให้ใช้การแชร์หน่วยความจำ?
ในแง่หนึ่ง แชนเนล (channel) ในภาษาโปรแกรมใดๆ จะมีความคล้ายคลึงกับระบบความเป็นเจ้าของแบบเดี่ยว (single ownership) เพราะเมื่อคุณส่งค่าผ่านแชนเนลไปแล้ว คุณก็ไม่ควรนำค่านั้นกลับมาใช้งานอีกต่อไป ส่วนการทำงานพร้อมกันโดยใช้หน่วยความจำร่วมกันนั้นจะคล้ายกับความเป็นเจ้าของหลายราย (multiple ownership) นั่นคือหลายเธรดสามารถเข้าถึงตำแหน่งหน่วยความจำเดียวกันได้ในเวลาเดียวกัน ดังที่คุณได้เห็นในบทที่ 15 ว่าสมาร์ตพอยน์เตอร์ (smart pointer) ช่วยให้สามารถมีความเป็นเจ้าของหลายรายได้ แต่ความเป็นเจ้าของหลายรายก็เพิ่มความซับซ้อนตามมา เพราะเราจำเป็นต้องบริหารจัดการเจ้าของแต่ละรายให้ถูกต้อง อย่างไรก็ตาม ระบบชนิดข้อมูลและกฎความเป็นเจ้าของของ Rust จะช่วยให้คุณจัดการเรื่องเหล่านี้ได้อย่างถูกต้องและปลอดภัย ตัวอย่างเช่น ลองมาดูมิวเท็กซ์ (mutex) ซึ่งเป็นหนึ่งในพริมิทีฟการทำงานพร้อมกัน (concurrency primitive) ที่นิยมใช้กันทั่วไปสำหรับหน่วยความจำร่วม
การควบคุมการเข้าถึงด้วยมิวเท็กซ์
คำว่า มิวเท็กซ์ (mutex) เป็นคำย่อของ mutual exclusion (การกีดกันซึ่งกันและกัน) ซึ่งหมายความว่ามิวเท็กซ์จะอนุญาตให้มีเพียงเธรดเดียวเท่านั้นที่สามารถเข้าถึงข้อมูลได้ ณ ขณะใดขณะหนึ่ง ในการเข้าถึงข้อมูลในมิวเท็กซ์ เธรดจะต้องส่งสัญญาณขอก่อนโดยการขอถือครองล็อก (acquire the lock) ของมิวเท็กซ์ โดยที่_ล็อก_ (lock) เป็นโครงสร้างข้อมูลส่วนหนึ่งของมิวเท็กซ์ที่คอยติดตามว่าใครคือผู้ที่ถือครองสิทธิ์การเข้าถึงข้อมูลแต่เพียงผู้เดียวในขณะนั้น ดังนั้น เราจึงมักพูดว่ามิวเท็กซ์ทำหน้าที่_เฝ้าปกป้อง_ (guard) ข้อมูลที่มันเก็บรักษาไว้ผ่านระบบล็อก
มิวเท็กซ์ขึ้นชื่อเรื่องความยุ่งยากในการใช้งาน เพราะคุณต้องจำกฎเหล็กสองข้อนี้ให้ดี:
- คุณต้องพยายามขอถือครองล็อกก่อนจะนำข้อมูลไปใช้งาน
- เมื่อคุณใช้งานข้อมูลที่มิวเท็กซ์เฝ้าปกป้องเสร็จเรียบร้อยแล้ว คุณต้องปลดล็อกข้อมูลเพื่อให้เธรดอื่นสามารถเข้ามาถือครองล็อกได้
หากจะเปรียบเทียบมิวเท็กซ์กับสถานการณ์ในชีวิตจริง ลองนึกภาพเวทีเสวนาในงานประชุมที่มีไมโครโฟนเพียงตัวเดียว ก่อนที่นักเสวนาจะพูดได้ พวกเขาจะต้องขอหรือส่งสัญญาณว่าต้องการใช้ไมโครโฟน เมื่อได้รับไมโครโฟนมาแล้ว พวกเขาสามารถพูดได้นานเท่าที่ต้องการ แล้วจึงส่งไมโครโฟนต่อให้นักเสวนาคนถัดไปที่ขอพูด หากนักเสวนาคนหนึ่งลืมส่งต่อไมโครโฟนเมื่อใช้เสร็จแล้ว ก็จะไม่มีใครอื่นสามารถพูดได้เลย และหากการบริหารจัดการไมโครโฟนที่ใช้ร่วมกันนี้ผิดพลาด การเสวนาก็จะไม่เป็นไปตามที่วางแผนไว้!
การจัดการมิวเท็กซ์ให้ถูกต้องสมบูรณ์นั้นอาจซับซ้อนอย่างเหลือเชื่อ ซึ่งเป็นเหตุผลที่หลายคนชื่นชอบแชนเนลมาก อย่างไรก็ตาม ต้องขอบคุณระบบชนิดข้อมูลและกฎความเป็นเจ้าของของ Rust คุณจึงแทบไม่มีโอกาสทำการล็อกและปลดล็อกผิดพลาดเลย
API ของ Mutex<T>
เพื่อดูตัวอย่างวิธีใช้มิวเท็กซ์ เรามาเริ่มจากการใช้งานในบริบทแบบเธรดเดียวก่อน ดังแสดงในลิสติ้ง 16-12
use std::sync::Mutex;
fn main() {
let m = Mutex::new(5);
{
let mut num = m.lock().unwrap();
*num = 6;
}
println!("m = {m:?}");
}เช่นเดียวกับหลายๆ ชนิดข้อมูล เราสร้าง Mutex<T> ขึ้นมาได้โดยใช้ฟังก์ชันสัมพันธ์ (associated function) new และหากต้องการเข้าถึงข้อมูลภายในมิวเท็กซ์ เราจะต้องเรียกใช้เมธอด lock เพื่อขอถือครองล็อก ซึ่งการเรียกนี้จะบล็อก (block) การทำงานของเธรดปัจจุบันไว้ จนกว่าจะถึงคิวที่เธรดของเราได้รับล็อกมาครอบครอง
การเรียก lock จะล้มเหลวหากเธรดอื่นที่ถือครองล็อกอยู่ก่อนหน้าเกิดแพนิก (panic) ขึ้น เพราะในกรณีนั้นจะไม่มีใครสามารถขอถือครองล็อกได้อีกต่อไป เราจึงเลือกใช้ unwrap เพื่อให้เธรดนี้แพนิกตามไปด้วยหากตกอยู่ในสถานการณ์ดังกล่าว
เมื่อถือครองล็อกสำเร็จแล้ว เราสามารถปฏิบัติต่อค่าที่ได้รับกลับมา (ซึ่งในที่นี้คือ num) เสมือนเป็นเรเฟอเรนซ์แบบเปลี่ยนแปลงค่าได้ (mutable reference) ไปยังข้อมูลข้างในได้ทันที โดยระบบชนิดข้อมูลจะคอยรับประกันว่าเราต้องถือครองล็อกก่อนใช้งานค่าใน m เสมอ ชนิดข้อมูลของ m คือ Mutex<i32> ไม่ใช่ i32 เราจึง_จำเป็นต้อง_เรียก lock ก่อนจึงจะเข้าถึงค่า i32 ได้ เราไม่มีทางลืมขั้นตอนนี้ได้เลย เพราะหากไม่ทำ ระบบชนิดข้อมูลจะไม่ยอมให้เราเข้าถึงค่า i32 ข้างในอย่างเด็ดขาด
แท้จริงแล้วการเรียก lock จะคืนค่าชนิด MutexGuard ที่ถูกห่อหุ้มไว้ใน LockResult ซึ่งเราจัดการด้วยการเรียก unwrap โดยชนิดข้อมูล MutexGuard นั้นได้อิมพลีเมนต์ Deref เพื่อชี้ไปยังข้อมูลภายใน และยังอิมพลีเมนต์ Drop เพื่อปล่อยล็อกโดยอัตโนมัติเมื่อ MutexGuard หลุดออกจากสโคป (ซึ่งเกิดขึ้นเมื่อสิ้นสุดบล็อกสโคปชั้นใน) ส่งผลให้เราไม่ต้องกังวลว่าจะลืมปล่อยล็อกจนขัดขวางไม่ให้เธรดอื่นใช้งานมิวเท็กซ์ เพราะกระบวนการปล่อยล็อกจะทำงานโดยอัตโนมัติเสมอ
หลังจากทิ้งล็อกไปแล้ว เราสามารถพิมพ์ค่าของมิวเท็กซ์ออกมาดู และจะเห็นว่าค่า i32 ภายในถูกแก้ไขเป็น 6 ได้เรียบร้อยแล้ว
การเข้าถึง Mutex<T> ร่วมกัน
คราวนี้เรามาลองแชร์ค่าร่วมกันระหว่างหลายๆ เธรดโดยใช้ Mutex<T> กันดูบ้าง เราจะสร้างเธรดขึ้นมา 10 เธรด และให้แต่ละเธรดเพิ่มค่าตัวนับขึ้นทีละ 1 เพื่อให้ตัวนับวิ่งจาก 0 ไปจนถึง 10 ตัวอย่างในลิสติ้ง 16-13 นี้จะมีข้อผิดพลาดจากคอมไพเลอร์ ซึ่งเราจะใช้ข้อผิดพลาดดังกล่าวมาทำความเข้าใจการทำงานของ Mutex<T> และดูว่า Rust ช่วยให้เราใช้งานได้อย่างถูกต้องอย่างไร
use std::sync::Mutex;
use std::thread;
fn main() {
let counter = Mutex::new(0);
let mut handles = vec![];
for _ in 0..10 {
let handle = thread::spawn(move || {
let mut num = counter.lock().unwrap();
*num += 1;
});
handles.push(handle);
}
for handle in handles {
handle.join().unwrap();
}
println!("Result: {}", *counter.lock().unwrap());
}เราสร้างตัวแปร counter เพื่อเก็บ i32 ไว้ภายใน Mutex<T> เช่นเดียวกับในลิสติ้ง 16-12 จากนั้นเราสร้างเธรดขึ้นมา 10 เธรดด้วยการวนลูปตามช่วงตัวเลข และใช้ thread::spawn โดยส่งโคลเชอร์ตัวเดียวกันให้ทุกเธรด นั่นคือโคลเชอร์ที่จะย้าย (move) ตัวนับเข้าไปในเธรด ขอถือครองล็อกบน Mutex<T> ด้วยการเรียกเมธอด lock แล้วบวก 1 เข้าไปที่ค่าในมิวเท็กซ์ เมื่อเธรดทำงานในโคลเชอร์เสร็จสิ้น num จะหลุดออกจากสโคปและปล่อยล็อก ทำให้เธรดตัวอื่นสามารถเข้ามาถือครองล็อกต่อได้
ในเธรดหลัก เราเก็บแฮนเดิลการรวม (join handle) ทั้งหมดไว้ จากนั้นเรียก join บนแต่ละแฮนเดิลเหมือนในลิสติ้ง 16-2 เพื่อรอให้เธรดทั้งหมดทำงานจนเสร็จสิ้น จากนั้นเธรดหลักจึงจะขอถือครองล็อกแล้วพิมพ์ผลลัพธ์ของโปรแกรมนี้ออกมา
เราได้บอกเป็นนัยไว้แล้วว่าตัวอย่างนี้จะไม่คอมไพล์ ตอนนี้มาดูกันว่าทำไม!
$ cargo run
Compiling shared-state v0.1.0 (file:///projects/shared-state)
error[E0382]: borrow of moved value: `counter`
--> src/main.rs:21:29
|
5 | let counter = Mutex::new(0);
| ------- move occurs because `counter` has type `std::sync::Mutex<i32>`, which does not implement the `Copy` trait
...
8 | for _ in 0..10 {
| -------------- inside of this loop
9 | let handle = thread::spawn(move || {
| ------- value moved into closure here, in previous iteration of loop
...
21 | println!("Result: {}", *counter.lock().unwrap());
| ^^^^^^^ value borrowed here after move
For more information about this error, try `rustc --explain E0382`.
error: could not compile `shared-state` (bin "shared-state") due to 1 previous error
ข้อความแจ้งข้อผิดพลาดระบุว่าค่า counter ถูกย้าย (move) ไปแล้วตั้งแต่การวนซ้ำรอบก่อนหน้าของลูป Rust กำลังบอกเราว่าเราไม่สามารถย้ายความเป็นเจ้าของของล็อก counter ไปให้กับหลายๆ เธรดได้พร้อมกัน เรามาแก้ไขข้อผิดพลาดนี้ด้วยวิธีจัดการความเป็นเจ้าของหลายราย (multiple ownership) ตามที่เคยเรียนรู้กันมาในบทที่ 15
ความเป็นเจ้าของหลายรายกับหลายเธรด
ในบทที่ 15 เราทำให้ค่ามีเจ้าของได้หลายรายโดยใช้สมาร์ตพอยน์เตอร์ Rc<T> เพื่อสร้างค่าที่มีการนับจำนวนเรเฟอเรนซ์ (reference-counted) เราลองมาทำแบบเดียวกันในที่นี้แล้วดูผลลัพธ์กัน เราจะนำ Rc<T> มาห่อหุ้ม Mutex<T> ในลิสติ้ง 16-14 และโคลน (clone) Rc<T> ก่อนที่จะย้ายความเป็นเจ้าของไปยังเธรด
use std::rc::Rc;
use std::sync::Mutex;
use std::thread;
fn main() {
let counter = Rc::new(Mutex::new(0));
let mut handles = vec![];
for _ in 0..10 {
let counter = Rc::clone(&counter);
let handle = thread::spawn(move || {
let mut num = counter.lock().unwrap();
*num += 1;
});
handles.push(handle);
}
for handle in handles {
handle.join().unwrap();
}
println!("Result: {}", *counter.lock().unwrap());
}เมื่อสั่งคอมไพล์อีกครั้ง เรากลับพบกับ… ข้อผิดพลาดชุดใหม่! แต่คอมไพเลอร์กำลังสอนอะไรหลายอย่างให้กับเรา:
$ cargo run
Compiling shared-state v0.1.0 (file:///projects/shared-state)
error[E0277]: `Rc<std::sync::Mutex<i32>>` cannot be sent between threads safely
--> src/main.rs:11:36
|
11 | let handle = thread::spawn(move || {
| ------------- ^------
| | |
| ______________________|_____________within this `{closure@src/main.rs:11:36: 11:43}`
| | |
| | required by a bound introduced by this call
12 | | let mut num = counter.lock().unwrap();
13 | |
14 | | *num += 1;
15 | | });
| |_________^ `Rc<std::sync::Mutex<i32>>` cannot be sent between threads safely
|
= help: within `{closure@src/main.rs:11:36: 11:43}`, the trait `Send` is not implemented for `Rc<std::sync::Mutex<i32>>`
note: required because it's used within this closure
--> src/main.rs:11:36
|
11 | let handle = thread::spawn(move || {
| ^^^^^^^
note: required by a bound in `spawn`
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/std/src/thread/functions.rs:125:0
For more information about this error, try `rustc --explain E0277`.
error: could not compile `shared-state` (bin "shared-state") due to 1 previous error
ข้อความแจ้งข้อผิดพลาดนี้ยาวพอสมควรทีเดียว! แต่ส่วนสำคัญที่สุดที่ควรโฟกัสคือ: `Rc<Mutex<i32>>` cannot be sent between threads safely และคอมไพเลอร์ยังบอกเหตุผลประกอบไว้ด้วยว่า: the trait `Send` is not implemented for `Rc<Mutex<i32>>` เราจะพูดถึงเทรต Send ในหัวข้อถัดไป ซึ่งเป็นหนึ่งในเทรตที่คอยรับประกันว่าชนิดข้อมูลที่เรานำมาใช้กับเธรดนั้นถูกออกแบบมาให้ใช้งานในการทำงานพร้อมกันได้อย่างปลอดภัย
น่าเสียดายที่ Rc<T> ไม่ปลอดภัยสำหรับการแชร์ข้ามเธรด เพราะในขณะที่ Rc<T> จัดการจำนวนเรเฟอเรนซ์ มันจะเพิ่มค่านับทุกครั้งที่มีการเรียก clone และลดค่านับลงเมื่อโคลนแต่ละตัวถูกทำลาย (drop) ทว่ามันไม่ได้ใช้พริมิทีฟการทำงานพร้อมกันใดๆ มาควบคุมเพื่อให้แน่ใจว่าการปรับเปลี่ยนค่านับจะไม่ถูกขัดจังหวะโดยเธรดอื่น ซึ่งอาจส่งผลให้การนับจำนวนคลาดเคลื่อน—กลายเป็นบั๊กที่แอบแฝงและอาจนำไปสู่ปัญหาหน่วยความจำรั่วไหล (memory leak) หรือทำให้ค่าถูกทำลายไปก่อนที่เราจะใช้งานเสร็จ สิ่งที่เราต้องการอย่างแท้จริงคือชนิดข้อมูลที่ทำงานเหมือน Rc<T> ทุกประการ แต่ปรับเปลี่ยนจำนวนเรเฟอเรนซ์ด้วยวิธีการที่ปลอดภัยต่อเธรด (thread-safe)
การนับจำนวนเรเฟอเรนซ์แบบอะตอมมิกด้วย Arc<T>
โชคดีที่ Arc<T> คือ_ชนิดข้อมูลลักษณะเดียวกับ Rc<T> ที่ปลอดภัยต่อการใช้งานในสถานการณ์การทำงานพร้อมกัน ตัวอักษร a นั้นย่อมาจาก atomic ซึ่งหมายความว่าเป็นชนิดข้อมูลที่_นับจำนวนเรเฟอเรนซ์แบบอะตอมมิก (atomically reference-counted) ทั้งนี้ อะตอมมิก (atomic) เป็นพริมิทีฟการทำงานพร้อมกันอีกรูปแบบหนึ่งที่เราจะไม่ลงลึกในรายละเอียดที่นี่ หากสนใจโปรดดูเอกสารของไลบรารีมาตรฐานสำหรับ std::sync::atomic เพิ่มเติม ณ จุดนี้ คุณเพียงแค่ต้องรู้ว่าการทำงานแบบอะตอมมิกนั้นทำหน้าที่คล้ายกับชนิดข้อมูลพื้นฐานทั่วไป แต่ปลอดภัยสำหรับการแชร์ข้ามเธรด
คุณอาจสงสัยว่าแล้วทำไมชนิดข้อมูลพื้นฐานทั้งหมดจึงไม่ถูกทำเป็นแบบอะตอมมิกไปเสียเลย และทำไมชนิดข้อมูลในไลบรารีมาตรฐานถึงไม่ถูกสร้างให้ใช้ Arc<T> เป็นค่าเริ่มต้น เหตุผลก็คือความปลอดภัยต่อเธรดนั้นมีต้นทุนด้านประสิทธิภาพ (performance penalty) แลกมาด้วย ซึ่งเป็นต้นทุนที่คุณควรจ่ายเฉพาะเมื่อจำเป็นต้องใช้จริงๆ เท่านั้น หากคุณเพียงแค่จัดการค่าต่างๆ ภายในเธรดเดียว โค้ดของคุณจะทำงานได้เร็วกว่าหากไม่ต้องแบกรับการบังคับใช้มาตรการความปลอดภัยที่อะตอมมิกจัดเตรียมไว้
คราวนี้กลับมาที่ตัวอย่างของเรา: เนื่องจาก Arc<T> และ Rc<T> มี API เหมือนกันทุกประการ เราจึงแก้โปรแกรมได้ง่ายๆ เพียงเปลี่ยนบรรทัด use, การเรียก new และการเรียก clone แล้วโค้ดในลิสติ้ง 16-15 ก็จะคอมไพล์และรันได้สำเร็จในที่สุด
use std::sync::{Arc, Mutex};
use std::thread;
fn main() {
let counter = Arc::new(Mutex::new(0));
let mut handles = vec![];
for _ in 0..10 {
let counter = Arc::clone(&counter);
let handle = thread::spawn(move || {
let mut num = counter.lock().unwrap();
*num += 1;
});
handles.push(handle);
}
for handle in handles {
handle.join().unwrap();
}
println!("Result: {}", *counter.lock().unwrap());
}โค้ดนี้จะพิมพ์สิ่งต่อไปนี้:
Result: 10
เราทำสำเร็จแล้ว! เราสามารถนับค่าจาก 0 ไปถึง 10 ได้สำเร็จ แม้ตัวอย่างนี้อาจดูเรียบง่าย แต่ก็ได้สอนอะไรมากมายเกี่ยวกับ Mutex<T> และความปลอดภัยของเธรด คุณยังสามารถนำโครงสร้างของโปรแกรมนี้ไปประยุกต์ใช้กับงานที่ซับซ้อนกว่าการเพิ่มค่าตัวนับได้อีกด้วย ด้วยแนวทางนี้ คุณสามารถแบ่งการคำนวณออกเป็นส่วนๆ ที่เป็นอิสระต่อกัน แล้วกระจายงานเหล่านั้นไปให้เธรดต่างๆ ทำ จากนั้นจึงใช้ Mutex<T> เพื่อให้แต่ละเธรดเข้ามาอัปเดตผลลัพธ์สุดท้ายในส่วนของตน
ข้อสังเกตคือ หากคุณต้องการเพียงแค่ดำเนินการทางคณิตศาสตร์กับตัวเลขอย่างง่าย ในมอดูล std::sync::atomic ของไลบรารีมาตรฐาน ยังมีชนิดข้อมูลที่เรียบง่ายกว่า Mutex<T> ให้เลือกใช้อีกด้วย ซึ่งชนิดข้อมูลเหล่านั้นช่วยให้เข้าถึงชนิดข้อมูลพื้นฐานได้อย่างปลอดภัย พร้อมกัน และเป็นแบบอะตอมมิก แต่ที่เราเลือกใช้ Mutex<T> กับชนิดข้อมูลพื้นฐานในตัวอย่างนี้ ก็เพื่อให้เราสามารถโฟกัสไปที่กลไกการทำงานของ Mutex<T> ได้อย่างชัดเจน
การเปรียบเทียบ RefCell<T>/Rc<T> กับ Mutex<T>/Arc<T>
คุณอาจสังเกตเห็นว่า counter เป็นตัวแปรที่เปลี่ยนแปลงค่าไม่ได้ แต่เรากลับได้รับเรเฟอเรนซ์แบบเปลี่ยนแปลงค่าได้ไปยังข้อมูลข้างใน นั่นหมายความว่า Mutex<T> มอบความสามารถในการเปลี่ยนแปลงค่าภายใน (interior mutability) ให้เช่นเดียวกับที่ตระกูล Cell ทำ และในทำนองเดียวกับที่เราใช้ RefCell<T> ในบทที่ 15 เพื่อให้สามารถแก้ไขข้อมูลภายใน Rc<T> ได้ เราจึงใช้ Mutex<T> เพื่อแก้ไขข้อมูลภายใน Arc<T> นั่นเอง
รายละเอียดอีกประการที่พึงระวังคือ Rust ไม่สามารถป้องกันข้อผิดพลาดทางตรรกะ (logic error) ได้ทุกรูปแบบเมื่อคุณใช้งาน Mutex<T> หากยังจำได้จากบทที่ 15 การใช้ Rc<T> มีความเสี่ยงที่จะเกิดวงจรเรเฟอเรนซ์ (reference cycle) ที่ค่า Rc<T> สองตัวชี้อ้างอิงถึงกันจนทำให้หน่วยความจำรั่วไหล ในทำนองเดียวกัน Mutex<T> ก็มาพร้อมกับความเสี่ยงที่จะเกิด_เดดล็อก (deadlock)_ ซึ่งจะเกิดขึ้นเมื่อการทำงานหนึ่งจำเป็นต้องล็อกทรัพยากรสองชิ้นพร้อมกัน และมีเธรดสองตัวถือครองล็อกไปคนละชิ้น ทำให้ต่างฝ่ายต่างรอคอยกันไปตลอดกาล หากคุณสนใจศึกษาเรื่องเดดล็อกเพิ่มเติม ลองเขียนโปรแกรม Rust ที่ทำให้เกิดเดดล็อกขึ้นมาดู จากนั้นค้นคว้ากลยุทธ์การป้องกันและบรรเทาปัญหาเดดล็อกสำหรับมิวเท็กซ์ในภาษาใดก็ได้ แล้วลองนำมาอิมพลีเมนต์ใน Rust ซึ่งเอกสาร API ของไลบรารีมาตรฐานสำหรับ Mutex<T> และ MutexGuard มีข้อมูลที่เป็นประโยชน์อย่างยิ่ง
เราจะปิดท้ายบทนี้ด้วยการกล่าวถึงเทรต Send และ Sync รวมถึงวิธีนำพวกมันไปประยุกต์ใช้กับชนิดข้อมูลที่เราสร้างขึ้นเอง
การทำงานพร้อมกันแบบขยายได้ด้วย Send และ Sync
การทำงานพร้อมกันแบบขยายได้ด้วย Send และ Sync
สิ่งที่น่าสนใจคือ ฟีเจอร์ด้านการทำงานพร้อมกัน (concurrency) เกือบทั้งหมดที่เราได้พูดถึงในบทนี้จนถึงปัจจุบัน ล้วนเป็นส่วนหนึ่งของไลบรารีมาตรฐาน ไม่ได้ฝังแน่นอยู่ในตัวภาษา ทางเลือกของคุณในการจัดการกับการทำงานพร้อมกันจึงไม่ได้จำกัดอยู่เพียงแค่สิ่งที่ตัวภาษาหรือไลบรารีมาตรฐานจัดเตรียมไว้ให้เท่านั้น แต่คุณยังสามารถเขียนฟีเจอร์การทำงานพร้อมกันขึ้นมาเอง หรือนำฟีเจอร์ที่ผู้อื่นเขียนไว้มาใช้งานได้อีกด้วย
อย่างไรก็ดี ท่ามกลางแนวคิดสำคัญด้านการทำงานพร้อมกันที่ฝังลึกอยู่ในตัวภาษาโดยตรง ไม่ใช่ในไลบรารีมาตรฐาน ก็คือมาร์กเกอร์เทรต (marker trait) ใน std::marker อย่าง Send และ Sync
การถ่ายโอนความเป็นเจ้าของระหว่างเธรด
มาร์กเกอร์เทรต Send บ่งชี้ว่า ค่าของชนิดข้อมูลที่อิมพลีเมนต์ Send สามารถถ่ายโอนสิทธิ์ความเป็นเจ้าของ (ownership) ข้ามระหว่างเธรดได้ ชนิดข้อมูลในภาษา Rust เกือบทุกชนิดต่างอิมพลีเมนต์ Send แต่ก็มีข้อยกเว้นบางประการ เช่น Rc<T> ซึ่งไม่สามารถอิมพลีเมนต์ Send ได้ เพราะหากคุณโคลนค่า Rc<T> แล้วพยายามถ่ายโอนความเป็นเจ้าของของตัวโคลนนั้นไปยังอีกเธรดหนึ่ง ทั้งสองเธรดอาจพยายามเข้าไปอัปเดตตัวนับเรเฟอเรนซ์พร้อมๆ กัน ด้วยเหตุนี้ Rc<T> จึงถูกออกแบบมาสำหรับใช้งานในสถานการณ์แบบเธรดเดียว (single-threaded) ที่คุณไม่ต้องการแบกรับต้นทุนด้านประสิทธิภาพเพื่อแลกกับความปลอดภัยของเธรด
ดังนั้น ระบบชนิดข้อมูลและข้อกำหนดเทรต (trait bounds) ของ Rust จึงช่วยรับประกันว่า คุณจะไม่มีทางเผลอส่งค่า Rc<T> ข้ามเธรดอย่างไม่ปลอดภัยโดยไม่ตั้งใจเด็ดขาด ตอนที่เราพยายามทำเช่นนั้นในลิสติ้ง 16-14 เราจึงพบข้อผิดพลาดว่า the trait `Send` is not implemented for `Rc<Mutex<i32>>` และเมื่อเราเปลี่ยนมาใช้ Arc<T> ซึ่งอิมพลีเมนต์ Send โค้ดก็สามารถคอมไพล์ผ่านได้ในที่สุด
ชนิดข้อมูลใดๆ ก็ตามที่ประกอบขึ้นจากสมาชิกที่เป็นชนิดข้อมูลแบบ Send ทั้งหมด จะได้รับการมาร์ก (mark) ว่าเป็น Send โดยอัตโนมัติเช่นกัน ชนิดข้อมูลพื้นฐาน (primitive types) แทบทั้งหมดล้วนเป็น Send ยกเว้นแต่รอว์พอยน์เตอร์ (raw pointer) ซึ่งเราจะได้กล่าวถึงกันในบทที่ 20
การเข้าถึงจากหลายเธรด
มาร์กเกอร์เทรต Sync บ่งชี้ว่า ชนิดข้อมูลที่อิมพลีเมนต์ Sync นั้นปลอดภัยที่จะถูกอ้างอิง (reference) จากหลายๆ เธรดพร้อมกัน กล่าวอีกนัยหนึ่งคือ ชนิดข้อมูล T ใดๆ จะถือว่าอิมพลีเมนต์ Sync ก็ต่อเมื่อ &T (เรเฟอเรนซ์แบบเปลี่ยนแปลงค่าไม่ได้ไปยัง T) อิมพลีเมนต์ Send ซึ่งหมายความว่าเรเฟอเรนซ์ดังกล่าวสามารถส่งต่อไปยังอีกเธรดหนึ่งได้อย่างปลอดภัย เช่นเดียวกับ Send ชนิดข้อมูลพื้นฐานเกือบทั้งหมดต่างอิมพลีเมนต์ Sync และชนิดข้อมูลใดที่ประกอบขึ้นจากสมาชิกที่อิมพลีเมนต์ Sync ทั้งหมด ก็จะอิมพลีเมนต์ Sync ไปด้วยโดยอัตโนมัติ
สมาร์ตพอยน์เตอร์ Rc<T> ไม่ได้อิมพลีเมนต์ Sync ด้วยเหตุผลเดียวกับที่มันไม่อิมพลีเมนต์ Send ส่วนชนิดข้อมูล RefCell<T> (ที่เราได้เรียนรู้กันในบทที่ 15) ตลอดจนตระกูลของชนิดข้อมูล Cell<T> ที่เกี่ยวข้อง ก็ไม่อิมพลีเมนต์ Sync เช่นกัน เนื่องจากการตรวจสอบการยืมที่ RefCell<T> ทำในตอนรันไทม์นั้นไม่ได้ปลอดภัยต่อเธรด แต่สมาร์ตพอยน์เตอร์ Mutex<T> นั้นอิมพลีเมนต์ Sync และสามารถนำไปใช้แชร์การเข้าถึงข้อมูลร่วมกันระหว่างหลายๆ เธรดได้ ดังที่คุณได้เห็นใน“การเข้าถึง Mutex<T> ร่วมกัน”
การอิมพลีเมนต์ Send และ Sync ด้วยตัวเองนั้นเป็น unsafe
เนื่องจากชนิดข้อมูลใดๆ ที่ประกอบขึ้นจากชนิดข้อมูลอื่นที่อิมพลีเมนต์เทรต Send และ Sync อยู่แล้ว จะอิมพลีเมนต์ Send และ Sync ให้โดยอัตโนมัติ เราจึงแทบไม่จำเป็นต้องอิมพลีเมนต์เทรตเหล่านี้ด้วยตนเองเลย และในฐานะที่เป็นมาร์กเกอร์เทรต พวกมันจึงไม่มีเมธอดใดๆ ให้ต้องอิมพลีเมนต์แม้แต่อย่างเดียว ประโยชน์ของพวกมันมีไว้เพื่อบังคับใช้เงื่อนไขคงตัว (invariants) ที่เกี่ยวข้องกับความปลอดภัยในการทำงานพร้อมกันเท่านั้น
การลงมืออิมพลีเมนต์เทรตเหล่านี้ด้วยตนเองจำเป็นต้องเขียนโค้ด Rust ที่ไม่ปลอดภัย (unsafe code) ซึ่งเราจะได้กล่าวถึงการใช้โค้ด unsafe ในบทที่ 20 แต่สำหรับตอนนี้ ประเด็นสำคัญคือการสร้างชนิดข้อมูลสำหรับการทำงานพร้อมกันแบบใหม่ที่ไม่ได้ประกอบขึ้นจากส่วนที่เป็น Send และ Sync นั้น จำเป็นต้องพิจารณาอย่างรอบคอบเป็นพิเศษเพื่อรักษาข้อกำหนดการรับประกันความปลอดภัยเอาไว้ โดย “The Rustonomicon” มีข้อมูลเพิ่มเติมเกี่ยวกับเงื่อนไขการรับประกันเหล่านี้และวิธีปฏิบัติเพื่อรักษาความปลอดภัยดังกล่าว
สรุป
นี่ไม่ใช่ครั้งสุดท้ายที่คุณจะได้พบกับเรื่องการทำงานพร้อมกันในหนังสือเล่มนี้: บทถัดไปจะมุ่งเน้นไปที่การเขียนโปรแกรมแบบอะซิงโครนัส (async programming) และโปรเจกต์ในบทที่ 21 จะนำแนวคิดจากบทนี้ไปประยุกต์ใช้ในสถานการณ์จริงที่สมบูรณ์ยิ่งกว่าตัวอย่างสั้นๆ ที่เราได้เห็นกันไป
ดังที่กล่าวไว้ในตอนต้น เนื่องจากกลไกการจัดการการทำงานพร้อมกันของ Rust มีเพียงส่วนน้อยนิดเท่านั้นที่ฝังอยู่ในตัวภาษา โซลูชันด้านการทำงานพร้อมกันจำนวนมากจึงถูกพัฒนาขึ้นในรูปของเครตภายนอก เครตเหล่านี้มักมีการพัฒนาและปรับปรุงที่รวดเร็วกว่าไลบรารีมาตรฐาน ดังนั้นอย่าลืมค้นคว้าทางออนไลน์เพื่อเลือกใช้เครตที่มีความทันสมัยและเป็นที่ยอมรับในการพัฒนาโปรแกรมแบบมัลติเธรด
ไลบรารีมาตรฐานของ Rust มีทั้งแชนเนล (channel) สำหรับการส่งผ่านข้อความ ตลอดจนชนิดข้อมูลสมาร์ตพอยน์เตอร์อย่าง Mutex<T> และ Arc<T> ซึ่งปลอดภัยต่อการใช้งานในบริบทของการทำงานพร้อมกัน ระบบชนิดข้อมูลและตัวตรวจสอบการยืม (borrow checker) จะช่วยรับประกันว่า โค้ดที่ใช้เครื่องมือเหล่านี้จะไม่เกิดปัญหาการแย่งชิงข้อมูล (data race) หรือมีเรเฟอเรนซ์ที่ไม่ถูกต้องหลุดรอดไปได้ เมื่อใดที่คุณทำให้โค้ดคอมไพล์ผ่าน คุณก็สามารถวางใจได้ว่ามันจะทำงานบนหลายๆ เธรดได้อย่างราบรื่น โดยปราศจากบั๊กแฝงเร้นที่ตามรอยได้ยากดังที่มักพบในภาษาอื่นๆ การเขียนโปรแกรมให้ทำงานพร้อมกันจึงไม่ใช่เรื่องที่น่าหวาดกลัวอีกต่อไป จงก้าวออกไปเขียนโปรแกรมที่ทำงานพร้อมกันได้อย่างมั่นใจและไร้ความกลัว!
พื้นฐานของการเขียนโปรแกรมแบบอะซิงโครนัส: Async, Await, ฟิวเจอร์ และสตรีม
งานหรือการประมวลผลหลายๆ อย่างที่เราสั่งให้คอมพิวเตอร์ทำอาจต้องใช้เวลาสักพักกว่าจะเสร็จสิ้น คงจะดีไม่น้อยหากเราสามารถทำอย่างอื่นควบคู่ไปด้วยได้ในระหว่างรอให้กระบวนการที่ใช้เวลานานเหล่านั้นทำงานจนเสร็จ คอมพิวเตอร์ยุคใหม่มีสองเทคนิคหลักสำหรับการทำงานมากกว่าหนึ่งอย่างไปพร้อมกัน นั่นคือการทำงานแบบขนาน (parallelism) และการทำงานพร้อมกัน (concurrency) ทว่าตรรกะของโปรแกรมโดยทั่วไปมักถูกเขียนขึ้นในลักษณะเรียงตามลำดับเป็นเส้นตรง แต่สิ่งที่เราต้องการจริงๆ คือการระบุการทำงานที่โปรแกรมต้องทำ พร้อมทั้งกำหนดจุดที่ฟังก์ชันสามารถหยุดพักชั่วคราวเพื่อให้ส่วนอื่นของโปรแกรมทำงานแทนได้ โดยไม่ต้องมาคอยระบุเจาะจงล่วงหน้าว่าโค้ดแต่ละส่วนจะต้องทำงานด้วยลำดับและลักษณะใดอย่างเคร่งครัด การเขียนโปรแกรมแบบอะซิงโครนัส (asynchronous programming) คือแอ็บสแตรกชันที่เปิดโอกาสให้เราเขียนโค้ดโดยอิงจากจุดพักที่อาจเกิดขึ้นและผลลัพธ์สุดท้ายที่จะได้รับ โดยที่ตัวระบบจะเข้ามาดูแลจัดการรายละเอียดของการประสานงานทั้งหมดให้เราเอง
บทนี้ต่อยอดจากการใช้เธรด (thread) เพื่อการทำงานขนานและการทำงานพร้อมกันในบทที่ 16 โดยจะแนะนำแนวทางเลือกใหม่ในการเขียนโค้ด ได้แก่ ฟิวเจอร์ (future), สตรีม (stream) และไวยากรณ์ async กับ await ของ Rust ซึ่งเปิดทางให้เราแสดงลักษณะการทำงานแบบอะซิงโครนัสได้อย่างเป็นธรรมชาติ ตลอดจนการใช้งานเครตภายนอกที่อิมพลีเมนต์รันไทม์อะซิงโครนัส (asynchronous runtime) ซึ่งเป็นโค้ดที่คอยควบคุมและประสานการประมวลผลงานแบบอะซิงโครนัสทั้งหมด
ลองพิจารณาตัวอย่าง: สมมติว่าคุณกำลังเอ็กซ์พอร์ต (export) วิดีโองานฉลองครอบครัวที่คุณตัดต่อขึ้น ซึ่งเป็นกระบวนการที่อาจกินเวลาตั้งแต่หลายนาทีไปจนถึงหลายชั่วโมง การเอ็กซ์พอร์ตวิดีโอนี้จะดึงพลังของ CPU และ GPU ไปใช้อย่างเต็มที่ หากเครื่องของคุณมีซีพียูเพียงคอร์เดียว และระบบปฏิบัติการไม่คอยสลับพักการเอ็กซ์พอร์ตนั้นเลยจนกว่าจะเสร็จ (กล่าวคือ รันการเอ็กซ์พอร์ตแบบ_ซิงโครนัส_) คุณก็จะไม่สามารถทำสิ่งอื่นใดบนคอมพิวเตอร์ได้เลยในระหว่างที่งานนั้นกำลังรันอยู่ ซึ่งคงเป็นประสบการณ์ที่น่าหงุดหงิดอย่างยิ่ง แต่โชคดีที่ระบบปฏิบัติการของคอมพิวเตอร์สามารถเข้ามาขัดจังหวะการเอ็กซ์พอร์ตอยู่เบื้องหลังได้บ่อยพอที่จะช่วยให้คุณทำงานอื่นไปพร้อมกันได้
คราวนี้ สมมติว่าคุณกำลังดาวน์โหลดวิดีโอที่มีคนแชร์มา ซึ่งงานนี้อาจต้องใช้เวลาพอสมควรเช่นกันแต่ไม่ได้กินเวลาของ CPU มากนัก ในกรณีนี้ ซีพียูจำเป็นต้องรอให้ข้อมูลส่งข้ามเครือข่ายมาถึง แม้คุณจะเริ่มอ่านข้อมูลได้ทันทีที่ข้อมูลบางส่วนเริ่มทยอยมาถึง แต่มันก็ยังต้องใช้เวลากว่าข้อมูลทั้งหมดจะมาครบถ้วน ยิ่งไปกว่านั้น แม้ข้อมูลจะมาครบแล้ว หากวิดีโอมีขนาดใหญ่มาก การโหลดไฟล์ทั้งหมดก็อาจกินเวลาอย่างน้อย 1-2 วินาที ซึ่งอาจฟังดูสั้นมากสำหรับมนุษย์ แต่ถือเป็นช่วงเวลาที่ยาวนานมหาศาลสำหรับหน่วยประมวลผลยุคใหม่ที่สามารถคำนวณได้หลายพันล้านคำสั่งในแต่ละวินาที และเช่นเคย ระบบปฏิบัติการจะคอยสลับขัดจังหวะโปรแกรมของคุณอยู่เบื้องหลัง เพื่อให้ซีพียูหันไปทำงานอื่นได้ในระหว่างรอการเรียกใช้งานเครือข่ายให้เสร็จสิ้น
การเอ็กซ์พอร์ตวิดีโอจึงเป็นตัวอย่างของงานที่_ผูกติดกับซีพียู (CPU-bound หรือ compute-bound)_ ซึ่งประสิทธิภาพจะถูกจำกัดด้วยขีดความสามารถในการประมวลผลข้อมูลของ CPU หรือ GPU และปริมาณพลังประมวลผลที่สามารถทุ่มเทให้กับงานนั้นได้ ส่วนการดาวน์โหลดวิดีโอเป็นตัวอย่างของงานที่_ผูกติดกับ I/O (I/O-bound)_ เพราะประสิทธิภาพจะถูกจำกัดด้วยความเร็วของ_อินพุตและเอาต์พุต (input and output)_ ของคอมพิวเตอร์ โดยจะทำงานได้เร็วเท่าที่ข้อมูลสามารถรับส่งผ่านเครือข่ายได้เท่านั้น
ในตัวอย่างทั้งสองนี้ การสลับขัดจังหวะอยู่เบื้องหลังของระบบปฏิบัติการถือเป็นการทำงานพร้อมกันรูปแบบหนึ่ง ทว่าการทำงานพร้อมกันดังกล่าวเกิดขึ้นเฉพาะในระดับของโปรแกรมทั้งโปรแกรมเท่านั้น โดยระบบปฏิบัติการจะสลับการทำงานระหว่างโปรแกรมต่างๆ เพื่อให้ทุกโปรแกรมได้ทำงาน แต่ในความเป็นจริง เนื่องจากเราผู้เขียนโปรแกรมเข้าใจการทำงานภายในโปรแกรมของเราในระดับที่ละเอียดยิ่งกว่าระบบปฏิบัติการมาก เราจึงสามารถมองเห็นโอกาสในการจัดการทำงานพร้อมกันในจุดที่ระบบปฏิบัติการมองไม่เห็นได้
ตัวอย่างเช่น หากเรากำลังสร้างเครื่องมือจัดการดาวน์โหลดไฟล์ เราควรเขียนโปรแกรมให้การเริ่มดาวน์โหลดไฟล์หนึ่งไม่ทำให้หน้าจอส่วนติดต่อผู้ใช้ (UI) ค้าง และเปิดให้ผู้ใช้เริ่มดาวน์โหลดหลายๆ ไฟล์ได้พร้อมกัน ทว่า API ของระบบปฏิบัติการสำหรับการสื่อสารผ่านเครือข่ายหลายตัวกลับเป็นแบบ_บล็อก (blocking)_ กล่าวคือ API เหล่านี้จะระงับการทำงานของโปรแกรมไว้จนกว่าข้อมูลที่กำลังประมวลผลจะพร้อมใช้งานอย่างสมบูรณ์
หมายเหตุ: หากลองพิจารณาดู นี่คือลักษณะการทำงานตามปกติของฟังก์ชัน_เกือบทั้งหมด_ แต่คำว่า บล็อก (blocking) มักจะถูกใช้เรียกการเรียกใช้ฟังก์ชันที่มีปฏิสัมพันธ์กับไฟล์ เครือข่าย หรือทรัพยากรอื่นๆ ของคอมพิวเตอร์ เพราะนั่นคือกรณีที่โปรแกรมของเราจะได้ประโยชน์อย่างชัดเจนหากเปลี่ยนการทำงานให้เป็นแบบ_ไม่บล็อก (non-blocking)_
เราอาจหลีกเลี่ยงการบล็อกเธรดหลักได้ด้วยการแยกสร้างเธรดเฉพาะกิจเพื่อใช้ดาวน์โหลดแต่ละไฟล์ขึ้นมา ทว่าภาระ overhead จากการใช้ทรัพยากรระบบของเธรดเหล่านั้นจะกลายเป็นปัญหาคอขวดในท้ายที่สุด คงจะดีกว่ามากหากการเรียกฟังก์ชันไม่บล็อกการทำงานตั้งแต่แรก และเปิดให้เรากำหนดชุดของงาน (tasks) ที่ต้องการให้โปรแกรมทำให้เสร็จ แล้วปล่อยให้ตัวรันไทม์เป็นผู้ตัดสินใจเลือกลำดับและวิธีรันงานเหล่านั้นให้มีประสิทธิภาพสูงสุดแทน
และนั่นคือสิ่งที่แอ็บสแตรกชัน async (ย่อมาจาก asynchronous) ของ Rust มอบให้กับเราพอดี ในบทนี้คุณจะได้เรียนรู้ทุกแง่มุมเกี่ยวกับ async โดยครอบคลุมหัวข้อดังต่อไปนี้:
- วิธีใช้งานไวยากรณ์
asyncและawaitของ Rust ตลอดจนการรันฟังก์ชันแบบอะซิงโครนัสด้วยรันไทม์ - วิธีประยุกต์ใช้โมเดลแบบ async เพื่อแก้ไขโจทย์และปัญหาความท้าทายแบบเดียวกับที่เราได้ศึกษาในบทที่ 16
- วิธีที่การเขียนโปรแกรมแบบมัลติเธรดและแบบ async เติมเต็มซึ่งกันและกัน จนคุณสามารถนำทั้งสองแนวทางมาผสานร่วมกันได้ในหลายสถานการณ์
แต่ก่อนจะไปดูว่า async ทำงานอย่างไรในทางปฏิบัติ เราขอแวะทำความเข้าใจความแตกต่างระหว่างการทำงานขนาน (parallelism) และการทำงานพร้อมกัน (concurrency) กันก่อนสักเล็กน้อย
การทำงานขนานและการทำงานพร้อมกัน
ที่ผ่านมา เราอาจใช้คำว่าการทำงานขนานและการทำงานพร้อมกันแทนกันได้เกือบตลอด แต่ ณ จุดนี้ เราจำเป็นต้องแยกแยะความแตกต่างของทั้งสองแนวคิดนี้ให้ชัดเจนยิ่งขึ้น เพราะความแตกต่างของพวกมันจะมีบทบาทสำคัญเมื่อเราเริ่มลงมือปฏิบัติจริง
ลองพิจารณาตัวอย่างการแบ่งงานในทีมพัฒนาซอฟต์แวร์ คุณอาจมอบหมายงานหลายๆ อย่างให้สมาชิกคนเดียวทำ, มอบหมายงานให้สมาชิกแต่ละคนรับผิดชอบคนละหนึ่งงาน, หรือใช้ทั้งสองแนวทางผสมผสานกัน
เมื่อคนคนหนึ่งสลับทำงานหลายๆ อย่างก่อนที่งานใดงานหนึ่งจะเสร็จสิ้นลง นี่คือ_การทำงานพร้อมกัน (concurrency)_ วิธีหนึ่งในการทำความเข้าใจการทำงานพร้อมกันก็เหมือนกับการที่คุณเปิดสองโปรเจกต์ค้างไว้บนคอมพิวเตอร์ และเมื่อคุณรู้สึกเบื่อหรือติดขัดในโปรเจกต์หนึ่ง คุณก็สลับไปทำอีกโปรเจกต์หนึ่ง เนื่องจากคุณมีเพียงคนเดียว คุณจึงไม่สามารถขยับงานทั้งสองอย่างไปข้างหน้าพร้อมกันเป๊ะๆ ในเสี้ยววินาทีเดียวกันได้ แต่คุณสามารถสลับการทำงาน (multitask) เพื่อให้งานแต่ละชิ้นคืบหน้าไปทีละนิดด้วยการสลับไปมาระหว่างกันได้ (ดูรูปที่ 17-1)
แต่เมื่อทีมแบ่งงานโดยให้สมาชิกแต่ละคนรับงานไปทำคนละชิ้นและแยกย้ายกันทำ นี่คือ_การทำงานขนาน (parallelism)_ เพราะสมาชิกแต่ละคนในทีมสามารถขับเคลื่อนงานของตนให้คืบหน้าไปได้ในเวลาเดียวกันอย่างแท้จริง (ดูรูปที่ 17-2)
ในเวิร์กโฟลว์ทั้งสองรูปแบบ คุณอาจจำเป็นต้องประสานงานระหว่างแต่ละงาน บางทีคุณอาจคิดว่างานที่มอบหมายให้คนคนหนึ่งนั้นเป็นอิสระจากงานของคนอื่นโดยสิ้นเชิง แต่ในความเป็นจริงกลับต้องรอให้อีกคนทำงานของเขาให้เสร็จเสียก่อน งานบางส่วนจึงอาจทำแบบขนานได้ แต่งานบางส่วนแท้จริงแล้วกลับเป็นแบบ_อนุกรม (serial)_ คือต้องทำเรียงตามลำดับทีละงาน ต่อเนื่องกันไปดังแสดงในรูปที่ 17-3
ในทำนองเดียวกัน คุณอาจพบว่างานชิ้นหนึ่งของคุณจำเป็นต้องรองานอีกชิ้นของตัวคุณเองให้เสร็จก่อน ซึ่งจะทำให้การทำงานพร้อมกันของคุณกลายเป็นการทำงานแบบอนุกรมไปโดยปริยาย
การทำงานขนานและการทำงานพร้อมกันยังสามารถคาบเกี่ยวกันได้อีกด้วย หากคุณทราบว่าเพื่อนร่วมงานกำลังติดขัดรอคุณทำงานชิ้นหนึ่งให้เสร็จ คุณก็คงจะต้องทุ่มเทสรรพกำลังทั้งหมดไปที่งานชิ้นนั้นเพื่อ “ปลดบล็อก” ให้เพื่อนร่วมงาน ซึ่งในจังหวะนั้น คุณและเพื่อนร่วมงานก็ไม่สามารถทำงานแบบขนานกันได้อีกต่อไป และตัวคุณเองก็ไม่สามารถสลับไปทำงานอื่นพร้อมๆ กันได้เช่นกัน
พลวัตพื้นฐานรูปแบบเดียวกันนี้เกิดขึ้นกับการทำงานของซอฟต์แวร์และฮาร์ดแวร์เช่นเดียวกัน บนคอมพิวเตอร์ที่มีซีพียูเพียงคอร์เดียว ซีพียูสามารถประมวลผลคำสั่งได้ครั้งละหนึ่งอย่างเท่านั้น แต่ก็ยังสามารถทำงานแบบพร้อมกัน (concurrently) ได้ โดยอาศัยเครื่องมืออย่างเธรด (threads), โปรเซส (processes) และ async ที่ทำให้คอมพิวเตอร์สามารถพักกิจกรรมหนึ่งไว้ชั่วคราว แล้วสลับไปทำกิจกรรมอื่น ก่อนจะวนกลับมาทำกิจกรรมแรกใหม่อีกครั้ง ในทางกลับกัน บนเครื่องที่มีซีพียูหลายคอร์ คอมพิวเตอร์จะสามารถทำงานแบบขนาน (in parallel) ได้อย่างแท้จริง คอร์หนึ่งอาจกำลังประมวลผลงานหนึ่ง ในขณะที่อีกคอร์หนึ่งกำลังทำงานอื่นที่ไม่เกี่ยวข้องกันเลยไปพร้อมๆ กันในเสี้ยววินาทีเดียวกัน
การรันโค้ด async ใน Rust มักจะทำงานในลักษณะแบบพร้อมกัน (concurrently) และอาจนำการทำงานแบบขนาน (parallelism) มาใช้ร่วมกันอยู่เบื้องหลัง ทั้งนี้ขึ้นอยู่กับฮาร์ดแวร์ ระบบปฏิบัติการ ตลอดจนรันไทม์ async ที่เราเลือกใช้ (ซึ่งเราจะได้กล่าวถึงรันไทม์ async เพิ่มเติมในอีกไม่ช้า)
คราวนี้ เรามาเจาะลึกกลไกการทำงานที่แท้จริงของการเขียนโปรแกรมแบบ async ใน Rust กันเลย
ฟิวเจอร์และวากยสัมพันธ์ async
ฟิวเจอร์และวากยสัมพันธ์ async
หัวใจสำคัญของการเขียนโปรแกรมแบบอะซิงโครนัสใน Rust คือ_ฟิวเจอร์ (futures)_ ตลอดจนคีย์เวิร์ด async และ await ของภาษา
ฟิวเจอร์ (future) คือค่าที่อาจจะยังไม่พร้อมใช้งานในตอนนี้ แต่จะพร้อมใช้งาน ณ จุดใดจุดหนึ่งในอนาคต (แนวคิดนี้ปรากฏในภาษาโปรแกรมหลายภาษา แต่อาจใช้ชื่ออื่น เช่น task หรือ promise) โดยภาษา Rust ได้จัดเตรียมเทรต Future ไว้เป็นรากฐาน เพื่อให้การทำงานแบบอะซิงโครนัสรูปแบบต่างๆ สามารถอิมพลีเมนต์ด้วยโครงสร้างข้อมูลที่แตกต่างกันได้ แต่ยังคงมีอินเทอร์เฟซมาตรฐานร่วมกัน ใน Rust ชนิดข้อมูลใดที่อิมพลีเมนต์เทรต Future จะถือว่าเป็นฟิวเจอร์ โดยแต่ละฟิวเจอร์จะเก็บข้อมูลความคืบหน้าของตนเองเอาไว้ ตลอดจนระบุว่าสถานะ “พร้อมใช้งาน” ของมันหมายถึงอะไร
คุณสามารถระบุคีย์เวิร์ด async ให้กับบล็อกหรือฟังก์ชัน เพื่อกำหนดว่าพวกมันสามารถหยุดพักการทำงานชั่วคราวและกลับมาทำต่อได้ และภายในบล็อกหรือฟังก์ชัน async คุณสามารถใช้คีย์เวิร์ด await เพื่อ await ฟิวเจอร์ (นั่นคือรอให้ฟิวเจอร์นั้นพร้อมใช้งาน) ทุกจุดที่คุณเรียก await ฟิวเจอร์ภายในบล็อกหรือฟังก์ชัน async ถือเป็นจุดที่บล็อกหรือฟังก์ชันดังกล่าวอาจหยุดพักและกลับมาทำต่อในภายหลัง กระบวนการตรวจสอบกับฟิวเจอร์ว่าค่าผลลัพธ์พร้อมใช้งานแล้วหรือยังนั้นเรียกว่า การโพลล์ (polling)
ภาษาโปรแกรมอื่นๆ เช่น C# และ JavaScript ก็ใช้คีย์เวิร์ด async และ await สำหรับการเขียนโปรแกรมแบบ async เช่นเดียวกัน หากคุณคุ้นเคยกับภาษาเหล่านั้น คุณอาจสังเกตเห็นความแตกต่างอย่างมีนัยสำคัญในวิธีที่ Rust ออกแบบไวยากรณ์นี้ ซึ่งมีเหตุผลรองรับที่ดีอยู่เบื้องหลัง ดังที่เราจะได้เห็นกันต่อไป!
ในการเขียนโค้ด async ใน Rust เราจะใช้คีย์เวิร์ด async และ await เป็นหลัก ซึ่งคอมไพเลอร์ของ Rust จะแปลงพวกมันไปเป็นโค้ดที่เทียบเท่ากันโดยใช้เทรต Future คล้ายกับการแปลงลูป for ไปเป็นโค้ดที่เรียกใช้เทรต Iterator และเนื่องจาก Rust จัดเตรียมเทรต Future ไว้ให้ คุณจึงสามารถนำเทรตนี้ไปอิมพลีเมนต์ให้กับชนิดข้อมูลของคุณเองได้เมื่อจำเป็น ฟังก์ชันหลายตัวที่เราจะได้เห็นตลอดทั้งบทนี้จะคืนค่าชนิดข้อมูลที่มีการอิมพลีเมนต์ Future อยู่ในตัว เราจะย้อนกลับมาดูนิยามของเทรตนี้อย่างละเอียดอีกครั้งในตอนท้ายของบท แต่สำหรับตอนนี้ รายละเอียดเท่านี้ก็เพียงพอที่จะให้เราเริ่มต้นก้าวต่อไปได้แล้ว
ทั้งหมดนี้อาจจะฟังดูเป็นนามธรรมไปสักหน่อย เราจึงมาลองลงมือเขียนโปรแกรม async ตัวแรกกันเลย นั่นคือเว็บสแครปเปอร์ (web scraper) ขนาดเล็ก โดยเราจะส่ง URL เข้าไปสองรายการผ่านทางบรรทัดคำสั่ง แล้วให้โปรแกรมดึงข้อมูลของทั้งสองเว็บเพจมาพร้อมๆ กัน จากนั้นคืนผลลัพธ์ของหน้าเพจที่ประมวลผลเสร็จก่อน ตัวอย่างนี้จะมีไวยากรณ์ใหม่ๆ พอสมควร แต่ไม่ต้องกังวล เราจะอธิบายทุกสิ่งที่คุณจำเป็นต้องรู้ไปทีละขั้นตอน
โปรแกรม async โปรแกรมแรกของเรา
เพื่อให้บทนี้มุ่งเน้นไปที่การเรียนรู้กลไกของ async เป็นหลักโดยไม่ต้องกังวลกับการหยิบจับเครื่องมือชิ้นต่างๆ ในระบบนิเวศ เราจึงสร้างเครต trpl ขึ้นมา (trpl ย่อมาจาก “The Rust Programming Language”) เครตนี้จะทำการรีเอ็กซ์พอร์ต (re-export) ชนิดข้อมูล เทรต และฟังก์ชันที่จำเป็นทั้งหมดที่คุณต้องใช้ ซึ่งส่วนใหญ่มาจากเครต futures และ tokio ทั้งนี้ เครต futures เป็นแหล่งรวมการทดลองอย่างเป็นทางการสำหรับโค้ด async ของ Rust และเป็นที่ที่เทรต Future ถูกออกแบบขึ้นในตอนแรก ส่วน Tokio คือรันไทม์ async ที่ได้รับความนิยมและถูกใช้งานแพร่หลายที่สุดในโลกของ Rust ยุคปัจจุบัน โดยเฉพาะอย่างยิ่งสำหรับเว็บแอปพลิเคชัน แน่นอนว่ายังมีรันไทม์ชั้นยอดตัวอื่นๆ อีกมากมาย ซึ่งอาจจะเหมาะสมกับความต้องการเฉพาะทางของคุณมากกว่า แต่เราเลือกใช้เครต tokio อยู่เบื้องหลังของ trpl เพราะมันผ่านการทดสอบมาอย่างเข้มข้นและมีการใช้งานอย่างแพร่หลาย
ในบางกรณี trpl ยังเปลี่ยนชื่อหรือห่อหุ้ม API ดั้งเดิมเอาไว้ เพื่อให้คุณโฟกัสกับรายละเอียดที่เกี่ยวข้องกับบทนี้ได้โดยตรง หากคุณต้องการทำความเข้าใจว่าเครตนี้ทำอะไรบ้าง เราขอแนะนำให้เข้าไปดูซอร์สโค้ดของเครตนี้ คุณจะเห็นได้ชัดเจนว่าแต่ละสิ่งที่ถูกนำมาส่งออกซ้ำนั้นมาจากเครตใด และเราได้ใส่คำอธิบายประกอบ (comment) ไว้อย่างละเอียด
สร้างโปรเจกต์ไบนารีใหม่ชื่อ hello-async และเพิ่มเครต trpl เป็นดีเพนเดนซี:
$ cargo new hello-async
$ cd hello-async
$ cargo add trpl
ตอนนี้เราสามารถนำเครื่องมือต่างๆ ที่ trpl จัดเตรียมไว้มาใช้เขียนโปรแกรม async ตัวแรกได้แล้ว โดยเราจะสร้างเครื่องมือบรรทัดคำสั่งขนาดเล็กที่ดึงข้อมูลเว็บเพจสองหน้า สกัดเอาเอลิเมนต์ <title> จากแต่ละหน้าออกมา แล้วพิมพ์ชื่อเรื่องของหน้าเพจที่เสร็จสิ้นกระบวนการทั้งหมดเป็นอันดับแรก
การนิยามฟังก์ชัน page_title
เรามาเริ่มจากการเขียนฟังก์ชันที่รับ URL ของหน้าเพจหนึ่งหน้าเป็นพารามิเตอร์ ทำการส่งคำขอไปยัง URL ดังกล่าว แล้วคืนข้อความในเอลิเมนต์ <title> ออกมา (ดูในลิสติ้ง 17-1)
extern crate trpl; // required for mdbook test
fn main() {
// TODO: we'll add this next!
}
use trpl::Html;
async fn page_title(url: &str) -> Option<String> {
let response = trpl::get(url).await;
let response_text = response.text().await;
Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html())
}ขั้นแรก เรานิยามฟังก์ชันชื่อ page_title และกำกับด้วยคีย์เวิร์ด async จากนั้นเราใช้ฟังก์ชัน trpl::get เพื่อดึงข้อมูลจาก URL ที่ส่งเข้ามา แล้วใส่คีย์เวิร์ด await เพื่อรอรับการตอบกลับ (response) และในการดึงข้อความของ response เราเรียกเมธอด text ของมันแล้วรออีกครั้งด้วยคีย์เวิร์ด await ซึ่งทั้งสองขั้นตอนนี้เป็นการทำงานแบบอะซิงโครนัส สำหรับฟังก์ชัน get นั้นเราต้องรอให้เซิร์ฟเวอร์ส่งส่วนแรกของการตอบกลับมา ซึ่งรวมถึง HTTP header, คุกกี้ ฯลฯ ที่อาจถูกส่งแยกจากบอดี้ (body) ของการตอบกลับ และโดยเฉพาะอย่างยิ่งหากบอดี้มีขนาดใหญ่ ก็อาจต้องใช้เวลากว่าข้อมูลทั้งหมดจะมาถึง และเนื่องจากเราต้องรอให้ข้อมูลการตอบกลับมาถึง_ทั้งหมด_ เมธอด text จึงต้องเป็นแบบ async ด้วยเช่นกัน
เราจำเป็นต้องเรียก await ฟิวเจอร์ทั้งสองตัวนี้อย่างชัดแจ้ง เพราะฟิวเจอร์ในภาษา Rust มีคุณสมบัติแบบ_เลซี่ (lazy)_: พวกมันจะไม่เริ่มทำอะไรเลยจนกว่าคุณจะสั่งให้ทำด้วยคีย์เวิร์ด await (ในความเป็นจริง Rust จะแสดงคำเตือนจากคอมไพเลอร์หากคุณสร้างฟิวเจอร์ขึ้นมาแต่ไม่ได้นำไปใช้งาน) สิ่งนี้อาจทำให้คุณนึกถึงเรื่องอิเทอเรเตอร์ (iterator) ในหัวข้อ“ประมวลผลลำดับรายการด้วยอิเทอเรเตอร์” ในบทที่ 13 อิเทอเรเตอร์จะไม่ทำอะไรจนกว่าคุณจะเรียกเมธอด next—ไม่ว่าจะเรียกโดยตรง หรือผ่านลูป for หรือเมธอดอย่าง map ที่เรียกใช้ next อยู่เบื้องหลัง ในทำนองเดียวกัน ฟิวเจอร์จะไม่ทำสิ่งใดจนกว่าคุณจะสั่งให้ทำงานอย่างชัดเจน พฤติกรรมแบบเลซี่นี้ช่วยให้ Rust หลีกเลี่ยงการรันโค้ด async จนกว่าจะถึงเวลาที่จำเป็นจริงๆ
หมายเหตุ: พฤติกรรมนี้แตกต่างจากสิ่งที่เราเห็นเมื่อใช้
thread::spawnในหัวข้อ“การสร้างเธรดใหม่ด้วย spawn” ในบทที่ 16 ซึ่งโคลเชอร์ที่เราส่งข้ามไปยังอีกเธรดหนึ่งจะเริ่มทำงานทันที และยังแตกต่างจากวิธีที่ภาษาอื่นๆ หลายภาษาจัดการกับ async อีกด้วย แต่สิ่งนี้มีความสำคัญอย่างยิ่งต่อการรับประกันด้านประสิทธิภาพของ Rust เช่นเดียวกับในกรณีของอิเทอเรเตอร์
เมื่อได้ response_text มาแล้ว เราสามารถพาร์ส (parse) มันให้เป็นอินสแตนซ์ของชนิดข้อมูล Html ได้โดยใช้ Html::parse ทำให้แทนที่จะเป็นเพียงสตริงดิบ ตอนนี้เรามีชนิดข้อมูลที่ช่วยจัดการ HTML ในฐานะโครงสร้างข้อมูลที่สมบูรณ์ยิ่งขึ้น โดยเฉพาะอย่างยิ่ง เราสามารถใช้เมธอด select_first เพื่อค้นหาเอลิเมนต์แรกที่ตรงกับตัวเลือก CSS (CSS selector) ที่กำหนด การส่งสตริง "title" เข้าไปจะทำให้เราได้เอลิเมนต์ <title> ตัวแรกในเอกสาร (หากมีอยู่) และเนื่องจากอาจไม่มีเอลิเมนต์ที่ตรงกับเงื่อนไขเลย เมธอด select_first จึงคืนค่าเป็น Option<ElementRef> สุดท้าย เราใช้เมธอด Option::map ซึ่งเปิดโอกาสให้เราจัดการกับค่าภายใน Option หากมีค่านั้นอยู่ และไม่ทำอะไรหากไม่มี (เราจะใช้คำสั่ง match ในจุดนี้ก็ได้ แต่การใช้ map จะตรงกับสำนวนของ Rust มากกว่า) ในบอดี้ของฟังก์ชันที่เราส่งให้ map เราเรียก inner_html บน title เพื่อดึงเนื้อหาภายในออกมา ซึ่งเป็น String และเมื่อทำทุกขั้นตอนเสร็จสิ้น เราก็จะได้ค่าชนิด Option<String> ออกมา
โปรดสังเกตว่าคีย์เวิร์ด await ของ Rust จะวางอยู่_ต่อท้าย (postfix)_ นิพจน์ที่คุณต้องการ await ไม่ใช่วางไว้ข้างหน้า ซึ่งอาจแตกต่างจากสิ่งที่คุณคุ้นเคยหากเคยใช้ async ในภาษาอื่น แต่สำหรับ Rust แล้ว รูปแบบนี้ช่วยให้การเรียกเมธอดต่อกันเป็นลูกโซ่ (method chaining) ทำได้อย่างลื่นไหลและสวยงามขึ้นมาก ส่งผลให้เราสามารถปรับเปลี่ยนบอดี้ของฟังก์ชัน page_title ให้เชื่อมการเรียกฟังก์ชัน trpl::get และ text เข้าด้วยกันโดยมี await คั่นกลางได้ ดังแสดงในลิสติ้ง 17-2
extern crate trpl; // required for mdbook test
use trpl::Html;
fn main() {
// TODO: we'll add this next!
}
async fn page_title(url: &str) -> Option<String> {
let response_text = trpl::get(url).await.text().await;
Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html())
}เท่านี้เราก็เขียนฟังก์ชัน async ฟังก์ชันแรกของเราสำเร็จแล้ว! แต่ก่อนที่จะเพิ่มโค้ดใน main เพื่อเรียกใช้งานมัน เรามาทำความเข้าใจสิ่งที่เราเพิ่งเขียนไปและความหมายเบื้องหลังของมันกันสักนิด
เมื่อ Rust พบ_บล็อก_ที่กำกับด้วยคีย์เวิร์ด async มันจะคอมไพล์บล็อกนั้นให้กลายเป็นชนิดข้อมูลนิรนาม (anonymous type) เฉพาะตัวที่อิมพลีเมนต์เทรต Future และเมื่อ Rust พบ_ฟังก์ชัน_ที่กำกับด้วย async มันจะคอมไพล์ฟังก์ชันนั้นให้กลายเป็นฟังก์ชันธรรมดา (ไม่ใช่ async) ที่มีเนื้อหาบอดี้เป็นบล็อก async โดยที่ชนิดข้อมูลที่คืนกลับของฟังก์ชัน async ก็คือชนิดข้อมูลนิรนามที่คอมไพเลอร์สร้างขึ้นสำหรับบล็อก async นั้นนั่นเอง
ดังนั้น การเขียน async fn จึงเทียบเท่ากับการเขียนฟังก์ชันที่คืนค่าเป็น_ฟิวเจอร์_ของชนิดข้อมูลที่คืนกลับมา สำหรับคอมไพเลอร์แล้ว นิยามฟังก์ชันอย่าง async fn page_title ในลิสติ้ง 17-1 จะเทียบเท่ากับฟังก์ชันธรรมดาที่นิยามในลักษณะนี้โดยประมาณ:
#![allow(unused)]
fn main() {
extern crate trpl; // required for mdbook test
use std::future::Future;
use trpl::Html;
fn page_title(url: &str) -> impl Future<Output = Option<String>> {
async move {
let text = trpl::get(url).await.text().await;
Html::parse(&text)
.select_first("title")
.map(|title| title.inner_html())
}
}
}เรามาไล่ดูแต่ละส่วนของฟังก์ชันเวอร์ชันที่แปลงแล้วนี้กัน:
- ฟังก์ชันนี้ใช้ไวยากรณ์
impl Traitที่เราเคยกล่าวถึงในบทที่ 10 ในหัวข้อ“การใช้เทรตเป็นพารามิเตอร์” - ค่าที่คืนกลับมานั้นอิมพลีเมนต์เทรต
Futureโดยมีชนิดข้อมูลสัมพันธ์ (associated type) ชื่อOutputและโปรดสังเกตว่าชนิดข้อมูลของOutputคือOption<String>ซึ่งตรงกับชนิดข้อมูลที่คืนกลับดั้งเดิมของpage_titleในเวอร์ชันasync fn - โค้ดทั้งหมดในบอดี้ของฟังก์ชันเดิมจะถูกห่อหุ้มไว้ในบล็อก
async moveอย่าลืมว่าบล็อกใน Rust คือนิพจน์ (expression) ดังนั้นบล็อกทั้งหมดนี้จึงเป็นนิพจน์ที่ฟังก์ชันคืนค่ากลับออกไป - บล็อก async นี้ให้ผลลัพธ์เป็นค่าชนิด
Option<String>ตามที่เพิ่งอธิบายไป ซึ่งค่านั้นตรงกับชนิดข้อมูลOutputในชนิดคืนค่าของฟังก์ชันพอดี เช่นเดียวกับบล็อกอื่นๆ ที่คุณเคยพบเห็น - บอดี้ของฟังก์ชันใหม่กลายเป็นบล็อก
async moveก็เนื่องมาจากลักษณะการนำพารามิเตอร์urlไปใช้งาน (เราจะมาพูดคุยเรื่องความแตกต่างระหว่างasyncกับasync moveกันอย่างละเอียดอีกครั้งในบทนี้)
ตอนนี้เราสามารถเรียก page_title ใน main ได้แล้ว
การเรียกใช้ฟังก์ชัน async ด้วยรันไทม์
ในการเริ่มต้น เราจะดึงชื่อเรื่องของหน้าเพจเพียงหน้าเดียวก่อน ดังแสดงในลิสติ้ง 17-3 แต่น่าเสียดายที่โค้ดนี้จะยังคอมไพล์ไม่ผ่าน
extern crate trpl; // required for mdbook test
use trpl::Html;
async fn main() {
let args: Vec<String> = std::env::args().collect();
let url = &args[1];
match page_title(url).await {
Some(title) => println!("The title for {url} was {title}"),
None => println!("{url} had no title"),
}
}
async fn page_title(url: &str) -> Option<String> {
let response_text = trpl::get(url).await.text().await;
Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html())
}เราทำตามรูปแบบเดิมที่เคยใช้รับอาร์กิวเมนต์จากบรรทัดคำสั่งในหัวข้อ“รับอาร์กิวเมนต์จากบรรทัดคำสั่ง” ในบทที่ 12 จากนั้นจึงส่งอาร์กิวเมนต์ URL ให้แก่ page_title แล้วทำการ await ผลลัพธ์ และเนื่องจากค่าที่ฟิวเจอร์ส่งกลับมาเป็น Option<String> เราจึงใช้นิพจน์ match เพื่อพิมพ์ข้อความที่แตกต่างกันตามเงื่อนไขว่าหน้าเพจนั้นมี <title> หรือไม่
จุดเดียวที่เราสามารถใช้คีย์เวิร์ด await ได้คือภายในฟังก์ชันหรือบล็อกที่เป็น async เท่านั้น และ Rust จะไม่อนุญาตให้เรากำกับฟังก์ชันพิเศษอย่าง main ด้วย async เป็นอันขาด
error[E0752]: `main` function is not allowed to be `async`
--> src/main.rs:6:1
|
6 | async fn main() {
| ^^^^^^^^^^^^^^^ `main` function is not allowed to be `async`
เหตุผลที่ main ไม่สามารถเป็น async ได้ก็เพราะโค้ดแบบ async จำเป็นต้องมี_รันไทม์ (runtime)_ ซึ่งเป็นเครต Rust ที่ทำหน้าที่ดูแลจัดการรายละเอียดในการประมวลผลโค้ดแบบอะซิงโครนัส ฟังก์ชัน main ของโปรแกรมสามารถ_เริ่มต้นสร้าง_รันไทม์ขึ้นมาได้ แต่ตัวฟังก์ชัน main เองไม่ได้เป็นรันไทม์ (เราจะได้เห็นเหตุผลเพิ่มเติมในอีกไม่ช้า) ทุกโปรแกรมของ Rust ที่ประมวลผลโค้ด async จะต้องมีอย่างน้อยหนึ่งจุดที่ทำหน้าที่สร้างรันไทม์เพื่อนำฟิวเจอร์ไปรันต่อ
ภาษาโปรแกรมส่วนใหญ่ที่รองรับ async มักจะแถมรันไทม์มาให้พร้อมในตัวภาษา แต่ Rust ไม่ได้ทำเช่นนั้น กลับเปิดให้มีรันไทม์ async หลากหลายตัวให้เลือกใช้ตามความเหมาะสม โดยแต่ละตัวจะมีการชั่งน้ำหนักข้อดีข้อเสีย (trade-offs) ที่เหมาะกับกรณีการใช้งานที่แตกต่างกัน ตัวอย่างเช่น เว็บเซิร์ฟเวอร์ที่ต้องการปริมาณงานสูง (high-throughput) ซึ่งทำงานบนเครื่องที่มีหลายซีพียูคอร์และแรมปริมาณมหาศาล ย่อมมีความต้องการที่แตกต่างไปจากไมโครคอนโทรลเลอร์ที่มีเพียงคอร์เดียว แรมน้อยนิด และไม่สามารถจัดสรรหน่วยความจำบนฮีปได้ นอกจากนี้ เครตที่จัดเตรียมรันไทม์เหล่านั้นมักจะมีฟังก์ชันการทำงานพื้นฐานเวอร์ชัน async เช่น ระบบ I/O สำหรับไฟล์หรือเครือข่ายมาให้ใช้งานควบคู่กันด้วย
ณ จุดนี้ และตลอดทั้งบทที่เหลือ เราจะใช้ฟังก์ชัน block_on จากเครต trpl ซึ่งจะรับฟิวเจอร์เข้ามาเป็นอาร์กิวเมนต์ แล้วทำการบล็อกเธรดปัจจุบันเอาไว้จนกว่าฟิวเจอร์นั้นจะทำงานเสร็จสิ้นสมบูรณ์ เบื้องหลังแล้ว การเรียก block_on จะเตรียมรันไทม์ขึ้นมาโดยใช้เครต tokio เพื่อนำฟิวเจอร์ที่ส่งเข้ามาไปประมวลผล (โดยพฤติกรรมของ block_on ในเครต trpl จะคล้ายคลึงกับฟังก์ชัน block_on ของเครตรันไทม์อื่นๆ) และเมื่อฟิวเจอร์ทำงานเสร็จสิ้น ฟังก์ชัน block_on ก็จะคืนค่าที่ฟิวเจอร์นั้นสร้างขึ้นออกมา
เราอาจจะส่งฟิวเจอร์ที่ได้จาก page_title เข้าไปยัง block_on โดยตรงก็ได้ และเมื่อมันทำงานเสร็จ เราก็สามารถใช้ pattern matching กับ Option<String> ตามที่เคยพยายามทำในลิสติ้ง 17-3 ทว่าสำหรับตัวอย่างส่วนใหญ่ในบทนี้ (รวมถึงโค้ด async ในชีวิตจริงเกือบทั้งหมด) เรามักจะทำอะไรมากกว่าแค่การเรียกฟังก์ชัน async เพียงฟังก์ชันเดียว ดังนั้นเราจึงจะส่งบล็อก async เข้าไปแทน แล้วทำการ await ผลลัพธ์จากการเรียก page_title อย่างชัดเจน ดังแสดงในลิสติ้ง 17-4
extern crate trpl; // required for mdbook test
use trpl::Html;
fn main() {
let args: Vec<String> = std::env::args().collect();
trpl::block_on(async {
let url = &args[1];
match page_title(url).await {
Some(title) => println!("The title for {url} was {title}"),
None => println!("{url} had no title"),
}
})
}
async fn page_title(url: &str) -> Option<String> {
let response_text = trpl::get(url).await.text().await;
Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html())
}เมื่อเรารันโค้ดนี้ เราจะได้พฤติกรรมที่เราคาดหวังไว้ตั้งแต่แรก:
$ cargo run -- "https://www.rust-lang.org"
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.05s
Running `target/debug/async_await 'https://www.rust-lang.org'`
The title for https://www.rust-lang.org was
Rust Programming Language
ในที่สุดเราก็มีโค้ด async ที่ทำงานได้จริงแล้ว! แต่ก่อนที่เราจะเพิ่มโค้ดเพื่อจับเว็บสองแห่งมาประชันความเร็วกัน เรามาแวะทำความเข้าใจกลไกการทำงานของฟิวเจอร์กันอีกสักเล็กน้อย
จุด await (await point) แต่ละจุด—กล่าวคือ ทุกๆ จุดในโค้ดที่มีการใช้คีย์เวิร์ด await—เป็นตัวแทนของตำแหน่งที่การควบคุมจะถูกส่งมอบกลับคืนให้แก่รันไทม์ และเพื่อให้กลไกนี้ทำงานได้ Rust จำเป็นต้องบันทึกและติดตามสถานะทั้งหมดที่เกี่ยวข้องในบล็อก async เอาไว้ เพื่อเปิดทางให้รันไทม์สามารถสลับไปเริ่มงานอื่นได้ แล้วค่อยย้อนกลับมาเดินหน้างานแรกต่อเมื่อพร้อม ซึ่งสิ่งนี้ก็คือสเตตแมชชีน (state machine) ที่ซ่อนอยู่เบื้องหลัง เสมือนกับว่าคุณได้เขียน enum ขึ้นมาเพื่อคอยบันทึกสถานะปัจจุบัน ณ แต่ละจุด await ดังนี้:
#![allow(unused)]
fn main() {
extern crate trpl; // required for mdbook test
enum PageTitleFuture<'a> {
Initial { url: &'a str },
GetAwaitPoint { url: &'a str },
TextAwaitPoint { response: trpl::Response },
}
}ทว่าการมานั่งเขียนโค้ดจัดการเปลี่ยนสถานะไปมาระหว่างแต่ละสเตตด้วยตนเองคงเป็นเรื่องที่น่าเบื่อหน่ายและเสี่ยงต่อความผิดพลาดอย่างยิ่ง โดยเฉพาะอย่างยิ่งเมื่อคุณต้องเพิ่มเติมฟังก์ชันการทำงานและสถานะใหม่ๆ ให้แก่โค้ดในภายหลัง โชคดีที่คอมไพเลอร์ของ Rust จะสร้างและจัดการโครงสร้างข้อมูลของสเตตแมชชีนสำหรับโค้ด async ให้โดยอัตโนมัติ กฎการยืมและกฎความเป็นเจ้าของตามปกติของ Rust ยังคงมีผลบังคับใช้อย่างสมบูรณ์กับโครงสร้างข้อมูลเหล่านี้ และน่ายินดีที่คอมไพเลอร์ยังคอยตรวจสอบกฎเหล่านั้นให้เราพร้อมทั้งให้ข้อความแจ้งข้อผิดพลาดที่เป็นประโยชน์อย่างมาก ซึ่งเราจะได้เห็นตัวอย่างข้อผิดพลาดเหล่านี้ในบทต่อไป
และในท้ายที่สุด ย่อมต้องมีผู้ที่นำสเตตแมชชีนนี้ไปประมวลผล ซึ่งผู้นั้นก็คือรันไทม์ (นี่คือเหตุผลว่าทำไมคุณจึงอาจพบคำว่า เอ็กซิคิวเตอร์ (executor) เมื่อศึกษารันไทม์ โดยเอ็กซิคิวเตอร์คือส่วนประกอบของรันไทม์ที่รับผิดชอบการประมวลผลโค้ด async โดยตรง)
ตอนนี้คุณคงเข้าใจแล้วว่าทำไมคอมไพเลอร์จึงห้ามไม่ให้เราประกาศฟังก์ชัน main เป็นฟังก์ชัน async ในลิสติ้ง 17-3 เพราะหาก main เป็นฟังก์ชัน async ย่อมต้องมีระบบอื่นเข้ามาคอยจัดการสเตตแมชชีนของฟิวเจอร์ที่ main ส่งกลับออกมา แต่ฟังก์ชัน main คือจุดเริ่มต้นของโปรแกรมทั้งหมด! ด้วยเหตุนี้ เราจึงต้องเรียกฟังก์ชัน trpl::block_on ภายใน main เพื่อสร้างรันไทม์ขึ้นมา แล้วสั่งรันฟิวเจอร์ที่บล็อก async ส่งกลับมาจนเสร็จสิ้น
หมายเหตุ: รันไทม์บางตัวมีมาโครที่ช่วยให้คุณ_สามารถ_เขียนฟังก์ชัน
mainแบบ async ได้ โดยเบื้องหลังแล้ว มาโครเหล่านั้นจะแปลงasync fn main() { ... }ให้กลายเป็นfn mainแบบปกติ ซึ่งทำสิ่งเดียวกันกับที่เราลงมือทำด้วยตนเองในลิสติ้ง 17-4 นั่นคือการเรียกฟังก์ชันเพื่อรันฟิวเจอร์จนเสร็จสิ้นในแบบเดียวกับที่trpl::block_onทำ
คราวนี้ เรามานำชิ้นส่วนทั้งหมดมาประกอบเข้าด้วยกัน แล้วดูวิธีเขียนโค้ดให้ทำงานพร้อมกัน (concurrent) กันดีกว่า
การแข่งสอง URL เข้าด้วยกันแบบพร้อมกัน
ในลิสติ้ง 17-5 เราจะเรียกใช้ page_title ด้วย URL สองรายการที่แตกต่างกันซึ่งรับมาจากบรรทัดคำสั่ง แล้วนำทั้งสองมารันประชันกันโดยเลือกใช้ผลลัพธ์ของฟิวเจอร์ที่ทำงานเสร็จก่อน
extern crate trpl; // required for mdbook test
use trpl::{Either, Html};
fn main() {
let args: Vec<String> = std::env::args().collect();
trpl::block_on(async {
let title_fut_1 = page_title(&args[1]);
let title_fut_2 = page_title(&args[2]);
let (url, maybe_title) =
match trpl::select(title_fut_1, title_fut_2).await {
Either::Left(left) => left,
Either::Right(right) => right,
};
println!("{url} returned first");
match maybe_title {
Some(title) => println!("Its page title was: '{title}'"),
None => println!("It had no title."),
}
})
}
async fn page_title(url: &str) -> (&str, Option<String>) {
let response_text = trpl::get(url).await.text().await;
let title = Html::parse(&response_text)
.select_first("title")
.map(|title| title.inner_html());
(url, title)
}เราเริ่มต้นด้วยการเรียก page_title สำหรับแต่ละ URL ที่ผู้ใช้ระบุเข้ามา แล้วเก็บผลลัพธ์ของฟิวเจอร์ไว้ในตัวแปร title_fut_1 และ title_fut_2 อย่าลืมว่าฟิวเจอร์เหล่านี้จะยังไม่เริ่มทำงานใดๆ เพราะฟิวเจอร์มีลักษณะแบบเลซี่และเรายังไม่ได้ทำการ await พวกมัน จากนั้นเราจึงส่งฟิวเจอร์ทั้งสองตัวไปยัง trpl::select ซึ่งจะคืนค่าที่ระบุว่าฟิวเจอร์ตัวใดทำงานเสร็จเป็นอันดับแรก
หมายเหตุ: เบื้องหลังการทำงานนั้น
trpl::selectถูกสร้างขึ้นบนฟังก์ชันselectที่มีความเป็นทั่วไปมากกว่าในเครตfuturesโดยฟังก์ชันselectของเครตfuturesสามารถทำอะไรได้หลายอย่างที่trpl::selectทำไม่ได้ แต่ก็มีความซับซ้อนเพิ่มขึ้นที่เราสามารถละไว้ก่อนได้ในตอนนี้
เนื่องจากฟิวเจอร์ตัวใดตัวหนึ่งย่อมสามารถ “ชนะ” ได้อย่างถูกต้องตามปกติ การคืนค่าเป็น Result จึงไม่สมเหตุสมผล ด้วยเหตุนี้ trpl::select จึงคืนค่าเป็นชนิดข้อมูลที่เราไม่เคยเห็นมาก่อน นั่นคือ trpl::Either ชนิดข้อมูล Either มีความคล้ายคลึงกับ Result ตรงที่มีสองกรณี (variant) แต่ต่างกันตรงที่ Either ไม่ได้แฝงความหมายของความสำเร็จหรือความล้มเหลวเอาไว้เลย แต่มันใช้ Left และ Right เพื่อบ่งบอกถึงความหมายว่า “อย่างใดอย่างหนึ่ง”:
#![allow(unused)]
fn main() {
enum Either<A, B> {
Left(A),
Right(B),
}
}ฟังก์ชัน select จะคืนค่า Left พร้อมข้อมูลเอาต์พุตของฟิวเจอร์นั้นหากอาร์กิวเมนต์แรกเป็นฝ่ายชนะ และคืนค่า Right พร้อมข้อมูลเอาต์พุตของฟิวเจอร์ตัวที่สองหากตัว_นั้น_เป็นฝ่ายชนะ ซึ่งสอดคล้องกับลำดับของอาร์กิวเมนต์ตอนเรียกฟังก์ชัน นั่นคืออาร์กิวเมนต์แรกอยู่ทางซ้าย (Left) ของอาร์กิวเมนต์ที่สอง (Right)
นอกจากนี้ เรายังได้อัปเดตให้ page_title คืนค่า URL เดิมที่ส่งเข้าไปกลับออกมาด้วย เพื่อที่ว่าหากหน้าเพจที่เสร็จก่อนไม่มี <title> ให้ดึงออกมา เราก็ยังสามารถพิมพ์ข้อความที่สื่อความหมายชัดเจนได้ และเมื่อมีข้อมูลดังกล่าวพร้อมแล้ว เราก็ปิดท้ายด้วยการอัปเดตเอาต์พุตของ println! เพื่อแสดงให้เห็นว่า URL ใดทำงานเสร็จก่อน และแท็ก <title> ของเว็บเพจนั้นคืออะไร (หากมี)
ในตอนนี้คุณได้สร้างเว็บสแครปเปอร์ขนาดเล็กที่ใช้งานได้จริงสำเร็จแล้ว! ลองเลือก URL สัก 2-3 เว็บแล้วทดลองรันเครื่องมือบรรทัดคำสั่งนี้ดู คุณอาจพบว่าบางเว็บไซต์เร็วกว่าอีกเว็บหนึ่งอย่างสม่ำเสมอ ในขณะที่บางคู่อาจผลัดกันเร็วขึ้นอยู่กับการรันแต่ละครั้ง แต่ที่สำคัญที่สุดคือ คุณได้เรียนรู้พื้นฐานของการทำงานกับฟิวเจอร์แล้ว และตอนนี้เราก็พร้อมที่จะเจาะลึกถึงสิ่งต่างๆ ที่เราสามารถทำได้ด้วย async ต่อไป
ประยุกต์ใช้การทำงานพร้อมกันด้วย async
การนำ async มาประยุกต์ใช้กับการทำงานพร้อมกัน
ในหัวข้อนี้ เราจะนำ async มาจัดการกับโจทย์ความท้าทายด้านการทำงานพร้อมกัน (concurrency) บางส่วนที่เราเคยจัดการด้วยเธรด (thread) ในบทที่ 16 เนื่องจากเราได้พูดถึงแนวคิดสำคัญหลายอย่างไปแล้วในบทนั้น ในหัวข้อนี้เราจึงจะเน้นไปที่สิ่งที่แตกต่างกันระหว่างเธรดกับฟิวเจอร์ (future)
ในหลายกรณี API สำหรับการทำงานพร้อมกันด้วย async จะคล้ายกับ API สำหรับเธรดมาก แต่ในบางกรณีก็แตกต่างกันค่อนข้างมาก และถึงแม้ว่า API ของเธรดกับ async จะดู_คล้ายกัน_ แต่พฤติกรรมการทำงานก็มักจะแตกต่างกัน—รวมถึงแทบทุกครั้งจะมีลักษณะเฉพาะด้านประสิทธิภาพที่ต่างกันด้วย
การสร้างทาสก์ใหม่ด้วย spawn_task
สิ่งแรกที่เราได้ลงมือทำในหัวข้อ“การสร้างเธรดใหม่ด้วย spawn” ในบทที่ 16 คือการนับเลขพร้อมกันบนสองเธรดที่แยกจากกัน เรามาทำแบบเดียวกันนี้โดยใช้ async กัน เครต trpl มีฟังก์ชัน spawn_task ที่มีหน้าตาคล้ายกับ API thread::spawn มาก และมีฟังก์ชัน sleep ซึ่งเป็นเวอร์ชัน async ของ API thread::sleep เราสามารถใช้สองฟังก์ชันนี้ร่วมกันเพื่อสร้างตัวอย่างการนับเลขแบบเดียวกันได้ ดังแสดงในลิสติ้ง 17-6
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
trpl::spawn_task(async {
for i in 1..10 {
println!("hi number {i} from the first task!");
trpl::sleep(Duration::from_millis(500)).await;
}
});
for i in 1..5 {
println!("hi number {i} from the second task!");
trpl::sleep(Duration::from_millis(500)).await;
}
});
}ในจุดเริ่มต้น เราเตรียมฟังก์ชัน main ด้วย trpl::block_on เพื่อให้ฟังก์ชันระดับบนสุดของเราสามารถเป็น async ได้
หมายเหตุ: ตั้งแต่นี้เป็นต้นไปในบทนี้ ทุกตัวอย่างจะถูกครอบด้วย
trpl::block_onในmainเหมือนกันหมด เราจึงมักจะละเว้นส่วนนี้ไว้เหมือนที่เราละเว้นโครงสร้างของmainดังนั้นอย่าลืมใส่ลงในโค้ดของคุณด้วย!
จากนั้น เราเขียนลูปสองลูปไว้ข้างในบล็อกดังกล่าว โดยแต่ละลูปจะเรียก trpl::sleep ซึ่งรอเวลาครึ่งวินาที (500 มิลลิวินาที) ก่อนพิมพ์ข้อความถัดไป เรานำลูปหนึ่งไปไว้ในเนื้อของ trpl::spawn_task และนำอีกลูปไปไว้ในลูป for ระดับบนสุด นอกจากนี้เรายังใส่ await ต่อท้ายการเรียก sleep ด้วย
โค้ดนี้ทำงานคล้ายกับการทำงานด้วยเธรด—รวมถึงการที่คุณอาจเห็นข้อความปรากฏในลำดับที่ต่างออกไปในเทอร์มินัลเมื่อรันโปรแกรม:
hi number 1 from the second task!
hi number 1 from the first task!
hi number 2 from the first task!
hi number 2 from the second task!
hi number 3 from the first task!
hi number 3 from the second task!
hi number 4 from the first task!
hi number 4 from the second task!
hi number 5 from the first task!
เวอร์ชันนี้จะหยุดทำงานทันทีที่ลูป for ในเนื้อของบล็อก async หลักทำงานเสร็จ เพราะทาสก์ (task) ที่สร้างขึ้นด้วย spawn_task จะถูกปิดตัวลงเมื่อฟังก์ชัน main สิ้นสุดลง หากคุณต้องการให้มันรันไปจนกระทั่งทาสก์ทั้งหมดทำงานเสร็จ คุณจะต้องใช้ join handle เพื่อรอให้ทาสก์แรกทำงานเสร็จสิ้น สำหรับเธรด เราใช้เมธอด join เพื่อ “บล็อก” จนกว่าเธรดจะทำงานเสร็จ ส่วนในลิสติ้ง 17-7 เราสามารถใช้ await เพื่อทำสิ่งเดียวกันได้ เพราะตัว handle ของทาสก์เองก็เป็นฟิวเจอร์เช่นกัน ชนิด Output ของมันคือ Result เราจึง unwrap มันหลังจากการ await ด้วย
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let handle = trpl::spawn_task(async {
for i in 1..10 {
println!("hi number {i} from the first task!");
trpl::sleep(Duration::from_millis(500)).await;
}
});
for i in 1..5 {
println!("hi number {i} from the second task!");
trpl::sleep(Duration::from_millis(500)).await;
}
handle.await.unwrap();
});
}เวอร์ชันที่อัปเดตนี้จะรันไปจนกว่าลูป_ทั้งสอง_จะทำงานเสร็จสิ้น:
hi number 1 from the second task!
hi number 1 from the first task!
hi number 2 from the first task!
hi number 2 from the second task!
hi number 3 from the first task!
hi number 3 from the second task!
hi number 4 from the first task!
hi number 4 from the second task!
hi number 5 from the first task!
hi number 6 from the first task!
hi number 7 from the first task!
hi number 8 from the first task!
hi number 9 from the first task!
จนถึงตอนนี้ ดูเหมือนว่า async กับเธรดจะให้ผลลัพธ์ที่คล้ายกัน เพียงแต่ใช้วากยสัมพันธ์ต่างกัน: คือใช้ await แทนการเรียก join บน join handle และ await การเรียก sleep
ความแตกต่างที่สำคัญกว่านั้นคือ เราไม่จำเป็นต้องสร้างเธรดของระบบปฏิบัติการขึ้นมาอีกเธรดเพื่อทำงานนี้ ที่จริงแล้ว เราไม่จำเป็นต้องสร้างทาสก์เลยด้วยซ้ำ เพราะบล็อก async จะถูกคอมไพล์เป็นฟิวเจอร์นิรนาม (anonymous future) เราจึงสามารถนำแต่ละลูปไปใส่ไว้ในบล็อก async แล้วให้รันไทม์รันทั้งสองลูปจนเสร็จสมบูรณ์ได้โดยใช้ฟังก์ชัน trpl::join
ในหัวข้อ“การรอให้เธรดทั้งหมดทำงานเสร็จสิ้นด้วย JoinHandle” ในบทที่ 16 เราได้แสดงวิธีใช้เมธอด join บนชนิด JoinHandle ที่ได้จากการเรียก std::thread::spawn ฟังก์ชัน trpl::join ก็คล้ายกันแต่ใช้กับฟิวเจอร์ เมื่อคุณส่งฟิวเจอร์สองตัวเข้าไป มันจะสร้างฟิวเจอร์ใหม่ขึ้นมาหนึ่งตัว ซึ่งเอาต์พุตของมันคือทูเพิลที่บรรจุผลลัพธ์ของฟิวเจอร์แต่ละตัวที่คุณส่งเข้าไป เมื่อฟิวเจอร์_ทั้งสอง_ทำงานเสร็จสิ้นแล้ว ดังนั้นในลิสติ้ง 17-8 เราจึงใช้ trpl::join เพื่อรอให้ทั้ง fut1 และ fut2 ทำงานเสร็จ เราจะ_ไม่_ await fut1 และ fut2 โดยตรง แต่จะ await ฟิวเจอร์ใหม่ที่สร้างขึ้นโดย trpl::join แทน เราละเว้นเอาต์พุตของมันไว้ เพราะเป็นเพียงทูเพิลที่เก็บค่ายูนิตสองค่าเท่านั้น
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let fut1 = async {
for i in 1..10 {
println!("hi number {i} from the first task!");
trpl::sleep(Duration::from_millis(500)).await;
}
};
let fut2 = async {
for i in 1..5 {
println!("hi number {i} from the second task!");
trpl::sleep(Duration::from_millis(500)).await;
}
};
trpl::join(fut1, fut2).await;
});
}เมื่อเรารันโค้ดนี้ เราจะเห็นฟิวเจอร์ทั้งสองทำงานจนเสร็จสิ้น:
hi number 1 from the first task!
hi number 1 from the second task!
hi number 2 from the first task!
hi number 2 from the second task!
hi number 3 from the first task!
hi number 3 from the second task!
hi number 4 from the first task!
hi number 4 from the second task!
hi number 5 from the first task!
hi number 6 from the first task!
hi number 7 from the first task!
hi number 8 from the first task!
hi number 9 from the first task!
คราวนี้ คุณจะเห็นลำดับเดิมแบบนี้เป๊ะๆ ทุกครั้ง ซึ่งแตกต่างอย่างมากจากสิ่งที่เราเคยเห็นกับเธรดและกับ trpl::spawn_task ในลิสติ้ง 17-7 นั่นเป็นเพราะฟังก์ชัน trpl::join นั้นมี_ความยุติธรรม_ (fair) หมายความว่ามันจะตรวจสอบฟิวเจอร์แต่ละตัวบ่อยเท่าๆ กัน โดยสลับการทำงานระหว่างกันและไม่ปล่อยให้อีกตัวนำหน้าไปหากอีกตัวก็พร้อมทำงานเช่นกัน สำหรับเธรด ระบบปฏิบัติการจะเป็นผู้ตัดสินใจว่าจะสลับไปตรวจสอบเธรดใดและปล่อยให้รันนานแค่ไหน ส่วน async ใน Rust รันไทม์จะเป็นผู้ตัดสินใจว่าจะตรวจสอบทาสก์ใด (ในทางปฏิบัติ รายละเอียดจะซับซ้อนขึ้นเนื่องจากรันไทม์ของ async อาจใช้เธรดของระบบปฏิบัติการอยู่เบื้องหลังเพื่อช่วยจัดการการทำงานพร้อมกัน การรับประกันความยุติธรรมจึงเป็นภาระงานที่มากขึ้นสำหรับรันไทม์—แต่ก็ยังสามารถทำได้!) รันไทม์ไม่จำเป็นต้องรับประกันความยุติธรรมสำหรับการดำเนินการใดๆ เสมอไป และมักจะมี API หลากหลายให้คุณเลือกได้ว่าจะต้องการความยุติธรรมหรือไม่
ลองปรับเปลี่ยนวิธี await ฟิวเจอร์เหล่านี้ดู แล้วสังเกตผลการทำงาน:
- ลบบล็อก async ที่ครอบลูปใดลูปหนึ่งหรือทั้งสองลูปออก
- Await บล็อก async แต่ละตัวทันทีหลังจากที่นิยามมันขึ้นมา
- ครอบเฉพาะลูปแรกด้วยบล็อก async แล้ว await ฟิวเจอร์ที่ได้หลังจากจบลูปที่สอง
และเพื่อความท้าทายยิ่งขึ้น ลองดูว่าคุณจะสามารถคาดเดาเอาต์พุตในแต่ละกรณีได้หรือไม่_ก่อน_ที่จะรันโค้ดจริง!
การส่งข้อมูลระหว่างสองทาสก์ด้วยการส่งผ่านข้อความ
การแชร์ข้อมูลระหว่างฟิวเจอร์ก็ดูคุ้นเคยเช่นกัน: เราจะใช้การส่งผ่านข้อความ (message passing) อีกครั้ง แต่คราวนี้เป็นชนิดข้อมูลและฟังก์ชันเวอร์ชัน async เราจะใช้วิธีที่ต่างออกไปเล็กน้อยจากที่เราทำในหัวข้อ“ส่งข้อมูลระหว่างเธรดด้วยการส่งผ่านข้อความ” ในบทที่ 16 เพื่อแสดงให้เห็นความแตกต่างสำคัญบางประการระหว่างการทำงานพร้อมกันโดยใช้เธรดกับแบบใช้ฟิวเจอร์ ในลิสติ้ง 17-9 เราจะเริ่มต้นด้วยบล็อก async เพียงบล็อกเดียว—โดย_ไม่ได้_สร้างทาสก์แยกต่างหากเหมือนที่เราเคยสร้างเธรดแยก
extern crate trpl; // required for mdbook test
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let val = String::from("hi");
tx.send(val).unwrap();
let received = rx.recv().await.unwrap();
println!("received '{received}'");
});
}ในที่นี้ เราใช้ trpl::channel ซึ่งเป็นเวอร์ชัน async ของ API แชนเนล (channel) แบบผู้ผลิตหลายราย ผู้บริโภครายเดียว (multiple producer, single consumer) ที่เราเคยใช้กับเธรดในบทที่ 16 เวอร์ชัน async ของ API นี้แตกต่างจากเวอร์ชันเธรดเพียงเล็กน้อย: คือใช้ตัวรับ rx ที่เปลี่ยนแปลงค่าได้ (mutable) แทนแบบที่เปลี่ยนแปลงไม่ได้ และเมธอด recv ของมันจะให้ผลลัพธ์เป็นฟิวเจอร์ที่เราต้อง await แทนที่จะสร้างค่าโดยตรง ตอนนี้เราสามารถส่งข้อความจากฝั่งผู้ส่งไปยังฝั่งผู้รับได้แล้ว สังเกตว่าเราไม่จำเป็นต้องสร้างเธรดแยกหรือแม้แต่ทาสก์เลย เราเพียงแค่ await การเรียก rx.recv เท่านั้น
เมธอด Receiver::recv แบบซิงโครนัสใน std::mpsc::channel จะบล็อกการทำงานจนกว่าจะได้รับข้อความ แต่เมธอด trpl::Receiver::recv จะไม่บล็อก เพราะมันเป็น async โดยแทนที่จะบล็อก มันจะส่งคืนการควบคุมกลับไปยังรันไทม์จนกว่าจะได้รับข้อความ หรือจนกว่าฝั่งผู้ส่งของแชนเนลจะปิดลง ในทางตรงกันข้าม เราไม่ต้อง await การเรียก send เพราะมันไม่ได้บล็อก และไม่จำเป็นต้องบล็อกเนื่องจากแชนเนลที่เราส่งข้อความเข้าไปนั้นไม่มีการจำกัดขนาด (unbounded)
หมายเหตุ: เนื่องจากโค้ด async ทั้งหมดนี้ทำงานอยู่ในบล็อก async ภายในการเรียก
trpl::block_onทุกอย่างภายในนั้นจึงไม่ต้องบล็อกการทำงาน อย่างไรก็ตาม โค้ดที่อยู่_ภายนอก_บล็อกจะยังคงบล็อกเพื่อรอให้ฟังก์ชันblock_onทำงานเสร็จและคืนค่ากลับมา นั่นคือจุดประสงค์หลักของฟังก์ชันtrpl::block_on: เพื่อให้คุณสามารถ_เลือก_ได้ว่าจะบล็อกตรงจุดไหนสำหรับชุดโค้ด async และช่วยกำหนดจุดเปลี่ยนผ่านระหว่างโค้ดแบบซิงโครนัสและอะซิงโครนัส
มีสองสิ่งสำคัญที่ควรสังเกตจากตัวอย่างนี้ ข้อแรก ข้อความส่งถึงทันที ข้อสอง แม้ว่าเราจะใช้ฟิวเจอร์ที่นี่ แต่ก็ยังไม่มีการทำงานพร้อมกันเกิดขึ้น ทุกอย่างในลิสติ้งนี้เกิดขึ้นตามลำดับทีละขั้นตอน เช่นเดียวกับตอนที่ไม่ได้ใช้ฟิวเจอร์
เรามาจัดการกับข้อแรกกันก่อน โดยการส่งข้อความหลายข้อความและมีการหน่วงเวลาด้วยการหลับ (sleep) คั่นระหว่างแต่ละข้อความ ดังแสดงในลิสติ้ง 17-10
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_millis(500)).await;
}
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
});
}นอกจากการส่งข้อความแล้ว เรายังต้องรับข้อความด้วย ในกรณีนี้ เนื่องจากเรารู้อยู่แล้วว่าจะมีข้อความเข้ามาทั้งหมดกี่ข้อความ เราจึงทำด้วยตนเองได้โดยเรียก rx.recv().await สี่ครั้ง อย่างไรก็ตาม ในโลกจริง เรามักจะไม่รู้จำนวนข้อความที่แน่นอนล่วงหน้า ดังนั้นเราจึงต้องรอต่อไปจนกว่าจะแน่ใจว่าไม่มีข้อความเหลืออยู่อีกแล้ว
ในลิสติ้ง 16-10 เราใช้ลูป for เพื่อประมวลผลสมาชิกทั้งหมดที่รับมาจากแชนเนลแบบซิงโครนัส อย่างไรก็ตาม Rust ยังไม่มีวิธีใช้ลูป for กับลำดับสมาชิกที่_ถูกสร้างขึ้นแบบอะซิงโครนัส_ เราจึงจำเป็นต้องใช้ลูปแบบมีเงื่อนไข while let ซึ่งเป็นเวอร์ชันลูปของโครงสร้าง if let ที่เราเคยเห็นในหัวข้อ“การควบคุมโฟลว์แบบกระชับด้วย if let และ let...else” ในบทที่ 6 ลูปนี้จะทำงานต่อไปตราบเท่าที่แพตเทิร์นที่กำหนดไว้ยังคงแมตช์กับค่าอยู่
การเรียก rx.recv จะให้ผลลัพธ์เป็นฟิวเจอร์ ซึ่งเรา await รันไทม์จะหยุดพักฟิวเจอร์ไว้ชั่วคราวจนกว่ามันจะพร้อม เมื่อมีข้อความมาถึง ฟิวเจอร์จะคลี่คลาย (resolve) เป็น Some(message) ทุกครั้งที่มีข้อความเข้ามา และเมื่อแชนเนลปิด ไม่ว่าจะมีข้อความมาถึง_หรือไม่_ก็ตาม ฟิวเจอร์จะคลี่คลายเป็น None แทน เพื่อบ่งบอกว่าไม่มีค่าใดๆ เหลืออยู่อีกแล้ว และเราควรหยุดการโพลล์ (polling)—นั่นคือ หยุดการ await
ลูป while let รวบรวมทั้งหมดนี้เข้าด้วยกัน หากผลลัพธ์ของการเรียก rx.recv().await คือ Some(message) เราจะเข้าถึงข้อความได้และนำไปใช้ในบอดี้ของลูปได้ เช่นเดียวกับที่เราทำได้กับ if let หากผลลัพธ์เป็น None ลูปก็จะสิ้นสุดลง ทุกครั้งที่ลูปทำงานครบรอบ มันจะแตะจุด await อีกครั้ง ทำให้รันไทม์หยุดพักมันชั่วคราวอีกรอบจนกว่าข้อความใหม่จะมาถึง
ตอนนี้โค้ดส่งและรับข้อความทั้งหมดได้สำเร็จแล้ว แต่น่าเสียดายที่ยังมีปัญหาอยู่สองประการ อย่างแรก ข้อความไม่ได้ทยอยเข้ามาทีละช่วงครึ่งวินาที แต่กลับมาถึงพร้อมกันทั้งหมดในคราวเดียวหลังจากโปรแกรมเริ่มทำงานไปแล้ว 2 วินาที (2,000 มิลลิวินาที) อย่างที่สอง โปรแกรมนี้ก็ไม่ยอมออกจากโปรแกรมเหมือนกัน! มันกลับรอรับข้อความใหม่ไปตลอดกาล คุณจะต้องปิดมันด้วยปุ่ม ctrl-C
โค้ดภายในบล็อก async หนึ่งบล็อกทำงานเป็นเส้นตรง
เรามาเริ่มต้นด้วยการตรวจสอบว่าทำไมข้อความจึงเข้ามาพร้อมกันทั้งหมดหลังความหน่วงเต็มจำนวน แทนที่จะค่อยๆ เข้ามาโดยมีความหน่วงคั่นระหว่างกัน ภายในบล็อก async ที่กำหนด ลำดับที่คีย์เวิร์ด await ปรากฏในโค้ดจะเป็นลำดับที่พวกมันถูกเรียกใช้เมื่อโปรแกรมรันเช่นกัน
ในลิสติ้ง 17-10 มีบล็อก async เพียงบล็อกเดียว ทุกอย่างในนั้นจึงทำงานเป็นเส้นตรง (linearly) ซึ่งยังไม่มีการทำงานพร้อมกันเกิดขึ้น การเรียก tx.send ทั้งหมดจะเกิดขึ้นสลับกับการเรียก trpl::sleep และจุด await ที่เกี่ยวข้องคั่นอยู่ตลอด จากนั้นลูป while let ถึงจะได้เริ่มผ่านจุด await ใดๆ บนการเรียก recv
เพื่อให้ได้พฤติกรรมที่เราต้องการ ซึ่งก็คือมีความหน่วงจากการหลับคั่นระหว่างแต่ละข้อความ เราต้องวางการดำเนินการของ tx และ rx ไว้ในบล็อก async ของตัวเอง ดังแสดงในลิสติ้ง 17-11 จากนั้นรันไทม์จึงจะเรียกใช้แต่ละบล็อกแยกกันได้โดยใช้ trpl::join เช่นเดียวกับในลิสติ้ง 17-8 และอีกครั้งที่เราจะ await ผลลัพธ์ของการเรียก trpl::join ไม่ใช่ await ฟิวเจอร์แต่ละตัว หากเรา await ฟิวเจอร์แต่ละตัวตามลำดับ เราก็จะกลับไปสู่โฟลว์การทำงานแบบเรียงตามลำดับเหมือนเดิม—ซึ่งเป็นสิ่งที่เราพยายาม_ไม่_ทำอย่างยิ่ง
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx_fut = async {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_millis(500)).await;
}
};
let rx_fut = async {
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
};
trpl::join(tx_fut, rx_fut).await;
});
}ด้วยโค้ดที่อัปเดตในลิสติ้ง 17-11 ข้อความจะถูกพิมพ์ออกมาเป็นช่วงๆ ทุก 500 มิลลิวินาที แทนที่จะพิมพ์รวดเดียวทั้งหมดหลังจากผ่านไป 2 วินาที
การย้ายความเป็นเจ้าของเข้าสู่บล็อก async
อย่างไรก็ตาม โปรแกรมยังคงไม่ยอมออกจากการทำงาน เนื่องจากวิธีที่ลูป while let โต้ตอบกับ trpl::join:
- ฟิวเจอร์ที่คืนค่าจาก
trpl::joinจะเสร็จสมบูรณ์ก็ต่อเมื่อฟิวเจอร์_ทั้งสอง_ที่ส่งเข้าไปทำงานเสร็จสิ้นแล้วเท่านั้น - ฟิวเจอร์
tx_futเสร็จสิ้นเมื่อมันหลับเสร็จหลังส่งข้อความสุดท้ายในvalsเรียบร้อยแล้ว - ฟิวเจอร์
rx_futจะไม่เสร็จสิ้นจนกว่าลูปwhile letจะสิ้นสุดลง - ลูป
while letจะไม่สิ้นสุดลงจนกว่าการ awaitrx.recvจะให้ผลลัพธ์เป็นNone - การ await
rx.recvจะคืนค่าNoneก็ต่อเมื่อปลายทางอีกฝั่งของแชนเนลปิดลงแล้วเท่านั้น - แชนเนลจะปิดลงก็ต่อเมื่อเราเรียก
rx.closeหรือเมื่อฝั่งผู้ส่งtxถูกทิ้ง (drop) - เราไม่ได้เรียก
rx.closeที่ใดเลย และtxจะไม่ถูกทิ้งจนกว่าบล็อก async ชั้นนอกสุดที่ส่งให้trpl::block_onจะสิ้นสุดลง - บล็อกนั้นสิ้นสุดไม่ได้เพราะมันถูกบล็อกรอให้
trpl::joinเสร็จสิ้น ซึ่งพาเราวนกลับไปยังต้นรายการนี้
ในตอนนี้ บล็อก async ที่เราใช้ส่งข้อความนั้นเพียงแค่_ยืม_ tx เท่านั้น เพราะการส่งข้อความไม่ต้องใช้ความเป็นเจ้าของ แต่หากเราสามารถ_ย้าย_ (move) tx เข้าไปในบล็อก async นั้นได้ มันก็จะถูกทิ้งเมื่อบล็อกนั้นสิ้นสุดลง ในหัวข้อ“การจับเรเฟอเรนซ์หรือการย้ายความเป็นเจ้าของ” ในบทที่ 13 คุณได้เรียนรู้วิธีใช้คีย์เวิร์ด move กับโคลเชอร์ไปแล้ว และดังที่อภิปรายในหัวข้อ“การใช้โคลเชอร์ move กับเธรด” ในบทที่ 16 เรามักต้องย้ายข้อมูลเข้าไปในโคลเชอร์เมื่อทำงานกับเธรด กลไกพื้นฐานเดียวกันนี้ก็นำมาใช้กับบล็อก async ด้วย ดังนั้นคีย์เวิร์ด move จึงทำงานกับบล็อก async ได้เช่นเดียวกับที่มันทำกับโคลเชอร์
ในลิสติ้ง 17-12 เราเปลี่ยนบล็อกที่ใช้ส่งข้อความจาก async เป็น async move
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx_fut = async move {
// --snip--
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_millis(500)).await;
}
};
let rx_fut = async {
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
};
trpl::join(tx_fut, rx_fut).await;
});
}เมื่อเรารันโค้ดเวอร์ชัน_นี้_ มันจะปิดการทำงานอย่างราบรื่นหลังจากข้อความสุดท้ายถูกส่งและรับแล้ว ต่อไปเรามาดูกันว่าต้องปรับแก้อะไรบ้างเพื่อส่งข้อมูลจากฟิวเจอร์มากกว่าหนึ่งตัว
การ join ฟิวเจอร์หลายตัวด้วยมาโคร join!
แชนเนล async นี้ยังเป็นแชนเนลแบบผู้ผลิตหลายรายด้วยเช่นกัน เราจึงเรียก clone บน tx ได้หากต้องการส่งข้อความจากฟิวเจอร์หลายตัว ดังแสดงในลิสติ้ง 17-13
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx1 = tx.clone();
let tx1_fut = async move {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx1.send(val).unwrap();
trpl::sleep(Duration::from_millis(500)).await;
}
};
let rx_fut = async {
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
};
let tx_fut = async move {
let vals = vec![
String::from("more"),
String::from("messages"),
String::from("for"),
String::from("you"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_millis(1500)).await;
}
};
trpl::join!(tx1_fut, tx_fut, rx_fut);
});
}อันดับแรก เราโคลน tx เพื่อสร้าง tx1 ไว้นอกบล็อก async แรก เราย้าย tx1 เข้าไปในบล็อกนั้นเหมือนที่เราทำกับ tx ก่อนหน้านี้ จากนั้นเราย้าย tx ตัวเดิมเข้าไปในบล็อก async ใหม่ ซึ่งเราจะส่งข้อความเพิ่มเติมโดยมีความหน่วงที่ช้าลงเล็กน้อย ในที่นี้เราวางบล็อก async ใหม่นี้ไว้หลังบล็อก async สำหรับรับข้อความ แต่มันจะวางไว้ก่อนหน้าก็ให้ผลลัพธ์เหมือนกัน หัวใจสำคัญอยู่ที่ลำดับที่ฟิวเจอร์ถูก await ไม่ใช่ลำดับที่พวกมันถูกสร้างขึ้นมา
บล็อก async ทั้งสองสำหรับการส่งข้อความจำเป็นต้องเป็นบล็อก async move เพื่อให้ทั้ง tx และ tx1 ถูกทิ้งเมื่อบล็อกเหล่านั้นทำงานเสร็จ มิฉะนั้น เราจะกลับไปติดอยู่ในลูปอนันต์เดิมที่เราเริ่มต้น
สุดท้าย เราเปลี่ยนจาก trpl::join เป็น trpl::join! เพื่อจัดการกับฟิวเจอร์ที่เพิ่มเข้ามา: มาโคร join! สามารถ await ฟิวเจอร์ตามจำนวนใดก็ได้โดยที่เรารู้จำนวนฟิวเจอร์ตอนคอมไพล์ เราจะพูดถึงการ await คอลเลกชันของฟิวเจอร์จำนวนไม่ทราบแน่นอนในภายหลังของบทนี้
ตอนนี้เราจะเห็นข้อความทั้งหมดจากฟิวเจอร์ฝั่งส่งทั้งสองตัว และเนื่องจากฟิวเจอร์ฝั่งส่งใช้ความหน่วงที่ต่างกันเล็กน้อยหลังการส่ง ข้อความจึงถูกรับในช่วงเวลาที่ต่างกันเหล่านั้นด้วย:
received 'hi'
received 'more'
received 'from'
received 'the'
received 'messages'
received 'future'
received 'for'
received 'you'
เราได้สำรวจวิธีใช้การส่งผ่านข้อความเพื่อส่งข้อมูลระหว่างฟิวเจอร์, วิธีที่โค้ดภายในบล็อก async ทำงานตามลำดับ, วิธีการย้ายความเป็นเจ้าของเข้าสู่บล็อก async, และวิธี join ฟิวเจอร์หลายตัว ต่อไป มาพูดถึงวิธีการและเหตุผลในการบอกให้รันไทม์สลับไปทำงานอื่นได้
ทำงานกับฟิวเจอร์จำนวนเท่าใดก็ได้
การคืนการควบคุมให้รันไทม์
หากยังจำได้จากหัวข้อ“โปรแกรม async โปรแกรมแรกของเรา” ณ จุด await แต่ละจุดนั้น Rust จะเปิดโอกาสให้รันไทม์ (runtime) พักการทำงานของทาสก์ (task) ไว้ชั่วคราว แล้วสลับไปทำงานอื่นแทนได้หากฟิวเจอร์ (future) ที่กำลังถูก await ยังไม่พร้อมทำงาน และในทางตรงกันข้ามก็เป็นจริงเช่นกัน: นั่นคือ Rust จะหยุดพักบล็อก async และส่งมอบการควบคุมกลับคืนให้แก่รันไทม์_เฉพาะ_ ณ จุด await เท่านั้น การทำงานทุกอย่างที่อยู่คั่นระหว่างจุด await จะดำเนินไปแบบซิงโครนัสเสมอ
นั่นหมายความว่า หากคุณเขียนการประมวลผลไว้เป็นจำนวนมากภายในบล็อก async โดยไม่มีจุด await เลยแม้แต่จุดเดียว ฟิวเจอร์นั้นจะบล็อกการทำงานจนฟิวเจอร์ตัวอื่นๆ ไม่สามารถคืบหน้าไปได้เลย บางครั้งคุณอาจได้ยินคำเรียกปรากฏการณ์นี้ว่า ฟิวเจอร์หนึ่ง_แย่งทรัพยากรจนฟิวเจอร์อื่นอดอยาก (starving)_ แม้ในบางกรณีสิ่งนี้อาจไม่ใช่เรื่องใหญ่นัก แต่หากคุณกำลังทำงานที่มีการเตรียมทรัพยากรหนักๆ หรืองานที่กินเวลายาวนาน หรือมีฟิวเจอร์ที่ต้องรันงานเฉพาะบางอย่างวนซ้ำไปเรื่อยๆ อย่างไม่มีที่สิ้นสุด คุณจำเป็นต้องพิจารณาอย่างรอบคอบว่าเมื่อใดและ ณ จุดใดที่ควรจะส่งมอบการควบคุมกลับคืนให้แก่รันไทม์
เรามาลองจำลองการทำงานที่ใช้เวลานานเพื่อเห็นภาพปัญหาการอดอยากนี้ให้ชัดเจน แล้วสำรวจดูวิธีแก้ไขกัน โดยในลิสติ้ง 17-14 เราจะสร้างฟังก์ชันชื่อ slow ขึ้นมา
extern crate trpl; // required for mdbook test
use std::{thread, time::Duration};
fn main() {
trpl::block_on(async {
// We will call `slow` here later
});
}
fn slow(name: &str, ms: u64) {
thread::sleep(Duration::from_millis(ms));
println!("'{name}' ran for {ms}ms");
}โค้ดนี้ใช้ std::thread::sleep แทนที่จะเป็น trpl::sleep เพื่อให้การเรียก slow บล็อกเธรดปัจจุบันตามจำนวนมิลลิวินาทีที่กำหนด โดยเราสามารถใช้ slow เป็นตัวแทนของการทำงานในโลกความจริงที่ทั้งกินเวลานานและมีพฤติกรรมแบบบล็อกการทำงาน
ในลิสติ้ง 17-15 เราใช้ slow จำลองการทำงานที่ผูกติดกับซีพียู (CPU-bound) เช่นนี้ภายในฟิวเจอร์คู่หนึ่ง
extern crate trpl; // required for mdbook test
use std::{thread, time::Duration};
fn main() {
trpl::block_on(async {
let a = async {
println!("'a' started.");
slow("a", 30);
slow("a", 10);
slow("a", 20);
trpl::sleep(Duration::from_millis(50)).await;
println!("'a' finished.");
};
let b = async {
println!("'b' started.");
slow("b", 75);
slow("b", 10);
slow("b", 15);
slow("b", 350);
trpl::sleep(Duration::from_millis(50)).await;
println!("'b' finished.");
};
trpl::select(a, b).await;
});
}
fn slow(name: &str, ms: u64) {
thread::sleep(Duration::from_millis(ms));
println!("'{name}' ran for {ms}ms");
}ฟิวเจอร์แต่ละตัวจะส่งมอบการควบคุมกลับคืนให้แก่รันไทม์ก็ต่อเมื่อทำงานที่ช้าเสร็จสิ้นลงไปทั้งชุด_แล้วเท่านั้น_ หากคุณรันโค้ดนี้ จะเห็นเอาต์พุตดังนี้:
'a' started.
'a' ran for 30ms
'a' ran for 10ms
'a' ran for 20ms
'b' started.
'b' ran for 75ms
'b' ran for 10ms
'b' ran for 15ms
'b' ran for 350ms
'a' finished.
เช่นเดียวกับในลิสติ้ง 17-5 ที่เราใช้ trpl::select รันประชันฟิวเจอร์เพื่อดึงข้อมูลจากสอง URL ตัว select ก็จะทำงานเสร็จสิ้นลงทันทีที่ a ทำงานเสร็จ ทว่ากลับไม่มีการสลับแทรกการทำงานระหว่างการเรียก slow ของฟิวเจอร์ทั้งสองตัวเลย ฟิวเจอร์ a กวาดทำงานของตนทั้งหมดไปจนกระทั่งถึงจุด await ของการเรียก trpl::sleep จากนั้นฟิวเจอร์ b ถึงจะได้เริ่มทำงานทั้งหมดของตนจนกระทั่งถึงจุด await ของ trpl::sleep ในฝั่งมัน และสุดท้ายฟิวเจอร์ a จึงทำงานเสร็จสมบูรณ์ เพื่อให้ฟิวเจอร์ทั้งสองสามารถสลับกันคืบหน้างานระหว่างที่ประมวลผลงานที่ช้าของตนได้ เราจำเป็นต้องมีจุด await เพื่อส่งมอบการควบคุมกลับคืนให้แก่รันไทม์ และนั่นหมายความว่าเราจำเป็นต้องมีสิ่งที่เราสามารถ await ได้!
เราเห็นการส่งมอบการควบคุมลักษณะนี้เกิดขึ้นแล้วในลิสติ้ง 17-15: หากเราลบ trpl::sleep ที่ส่วนท้ายของฟิวเจอร์ a ออก ฟิวเจอร์ a ก็จะทำงานเสร็จสิ้นลงโดยที่ฟิวเจอร์ b ไม่มีโอกาสได้รัน_เลยแม้แต่นิดเดียว_ เราลองมาใช้ฟังก์ชัน trpl::sleep เป็นจุดเริ่มต้นในการเปิดทางให้แต่ละงานสลับกันเดินหน้าดู ดังแสดงในลิสติ้ง 17-16
extern crate trpl; // required for mdbook test
use std::{thread, time::Duration};
fn main() {
trpl::block_on(async {
let one_ms = Duration::from_millis(1);
let a = async {
println!("'a' started.");
slow("a", 30);
trpl::sleep(one_ms).await;
slow("a", 10);
trpl::sleep(one_ms).await;
slow("a", 20);
trpl::sleep(one_ms).await;
println!("'a' finished.");
};
let b = async {
println!("'b' started.");
slow("b", 75);
trpl::sleep(one_ms).await;
slow("b", 10);
trpl::sleep(one_ms).await;
slow("b", 15);
trpl::sleep(one_ms).await;
slow("b", 350);
trpl::sleep(one_ms).await;
println!("'b' finished.");
};
trpl::select(a, b).await;
});
}
fn slow(name: &str, ms: u64) {
thread::sleep(Duration::from_millis(ms));
println!("'{name}' ran for {ms}ms");
}เราได้เพิ่มการเรียก trpl::sleep พร้อมระบุจุด await คั่นระหว่างการเรียก slow แต่ละครั้ง ตอนนี้การทำงานของฟิวเจอร์ทั้งสองจะสลับแทรกเข้าหากันแล้ว:
'a' started.
'a' ran for 30ms
'b' started.
'b' ran for 75ms
'a' ran for 10ms
'b' ran for 10ms
'a' ran for 20ms
'b' ran for 15ms
'a' finished.
ฟิวเจอร์ a ยังคงทำงานไปครู่หนึ่งก่อนจะส่งมอบการควบคุมให้ b เพราะมันเรียก slow ก่อนที่จะมีการเรียก trpl::sleep ใดๆ แต่หลังจากนั้นฟิวเจอร์ทั้งสองจะสลับการทำงานไปมาทุกครั้งที่ตัวใดตัวหนึ่งเดินทางมาถึงจุด await ในกรณีนี้เราใส่คั่นไว้หลังการเรียก slow ทุกครั้ง แต่ในความเป็นจริง เราสามารถแบ่งย่อยงานด้วยรูปแบบใดก็ได้ที่สมเหตุสมผลที่สุดสำหรับเรา
ทว่าในความเป็นจริง เราไม่ได้ต้องการที่จะ_หยุดหลับ (sleep)_ จริงๆ แต่อย่างใด เพราะสิ่งที่เราต้องการคือการผลักดันงานให้คืบหน้าไปอย่างรวดเร็วที่สุดเท่าที่จะทำได้ เราเพียงแค่อยากส่งมอบการควบคุมกลับคืนให้แก่รันไทม์เท่านั้น ซึ่งเราสามารถทำสิ่งนี้ได้โดยตรงด้วยฟังก์ชัน trpl::yield_now ในลิสติ้ง 17-17 เราจึงแทนที่การเรียก trpl::sleep เหล่านั้นทั้งหมดด้วย trpl::yield_now
extern crate trpl; // required for mdbook test
use std::{thread, time::Duration};
fn main() {
trpl::block_on(async {
let a = async {
println!("'a' started.");
slow("a", 30);
trpl::yield_now().await;
slow("a", 10);
trpl::yield_now().await;
slow("a", 20);
trpl::yield_now().await;
println!("'a' finished.");
};
let b = async {
println!("'b' started.");
slow("b", 75);
trpl::yield_now().await;
slow("b", 10);
trpl::yield_now().await;
slow("b", 15);
trpl::yield_now().await;
slow("b", 350);
trpl::yield_now().await;
println!("'b' finished.");
};
trpl::select(a, b).await;
});
}
fn slow(name: &str, ms: u64) {
thread::sleep(Duration::from_millis(ms));
println!("'{name}' ran for {ms}ms");
}โค้ดนี้ไม่เพียงแต่สื่อเจตนาที่แท้จริงได้ชัดเจนยิ่งขึ้นเท่านั้น แต่ยังทำงานได้เร็วกว่าการใช้ sleep อย่างมีนัยสำคัญอีกด้วย เนื่องจากตัวจับเวลาที่ sleep ใช้นั้นมักจะมีขีดจำกัดในเรื่องความละเอียดของเวลา ตัวอย่างเช่น ฟังก์ชัน sleep เวอร์ชันที่เราใช้นี้จะหยุดหลับอย่างน้อย 1 มิลลิวินาทีเสมอ แม้ว่าเราจะส่งค่า Duration เพียง 1 นาโนวินาทีเข้าไปก็ตาม และขอเน้นย้ำอีกครั้งว่า คอมพิวเตอร์ยุคปัจจุบันนั้น_เร็วมาก_: ในเวลาเพียง 1 มิลลิวินาที มันสามารถคำนวณและประมวลผลงานได้มหาศาล!
นั่นหมายความว่า async มีประโยชน์แม้กระทั่งกับงานประเภทประมวลผลหนัก (compute-bound) ขึ้นอยู่กับว่าโปรแกรมของคุณกำลังทำงานอื่นใดควบคู่ไปด้วยหรือไม่ เพราะมันเป็นเครื่องมือชั้นยอดในการจัดโครงสร้างความสัมพันธ์ระหว่างแต่ละส่วนของโปรแกรม (แม้จะมีต้นทุน overhead จากสเตตแมชชีนของ async แลกมาด้วยก็ตาม) นี่คือรูปแบบหนึ่งของ_การทำงานหลายงานแบบร่วมมือกัน (cooperative multitasking)_ ซึ่งฟิวเจอร์แต่ละตัวมีอำนาจตัดสินใจว่าเมื่อใดจะยอมส่งมอบการควบคุมผ่านจุด await และด้วยเหตุนี้ ฟิวเจอร์แต่ละตัวจึงมีความรับผิดชอบที่จะต้องไม่บล็อกการทำงานไว้นานจนเกินไปด้วย ในระบบปฏิบัติการสมองกลฝังตัว (embedded OS) บางระบบที่พัฒนาด้วย Rust นี่คือรูปแบบการทำงานหลายงาน_เพียงรูปแบบเดียว_ที่มีให้ใช้งาน!
แน่นอนว่าในโค้ดการใช้งานจริง คุณคงไม่ได้เขียนสลับการเรียกฟังก์ชันกับจุด await ในทุกๆ บรรทัดเช่นนี้ แม้ว่าการยอมสละการควบคุม (yielding control) ในลักษณะนี้จะมีต้นทุนค่อนข้างต่ำ แต่ก็ไม่ได้เกิดขึ้นฟรีๆ ในหลายกรณี การพยายามแบ่งย่อยงานที่ประมวลผลหนักๆ อาจทำให้การทำงานโดยรวมช้าลงอย่างเห็นได้ชัด ดังนั้นบางครั้งการยอมให้งานบล็อกเพียงครู่สั้นๆ อาจให้ประสิทธิภาพ_โดยรวม_ที่ดีกว่า จงคอยตรวจวัดประสิทธิภาพจริงของโค้ดอยู่เสมอเพื่อค้นหาว่าคอขวดที่แท้จริงอยู่ที่ใด แต่ไม่ว่าอย่างไร กลไกพื้นฐานนี้คือหัวใจสำคัญที่คุณควรตระหนักไว้ หากคุณ_เริ่มสังเกตเห็น_ว่างานจำนวนมากกำลังรันเรียงลำดับกันไป ทั้งๆ ที่คุณตั้งใจให้มันทำงานพร้อมกัน!
การสร้างนามธรรม async ของเราเอง
เรายังสามารถนำฟิวเจอร์มาประกอบเข้าด้วยกัน (compose) เพื่อสร้างแพตเทิร์นใหม่ๆ ได้อีกด้วย ตัวอย่างเช่น เราสามารถสร้างฟังก์ชัน timeout ขึ้นมาจากองค์ประกอบ async พื้นฐานที่เรามีอยู่แล้ว และเมื่อเสร็จสิ้น ฟังก์ชันนี้ก็จะกลายเป็นองค์ประกอบพื้นฐานชิ้นใหม่ที่เราสามารถนำไปต่อยอดสร้างแอ็บสแตรกชัน async อื่นๆ เพิ่มขึ้นไปได้อีก
ลิสติ้ง 17-18 แสดงให้เห็นว่าเราคาดหวังให้ timeout นี้ทำงานร่วมกับฟิวเจอร์ที่ทำงานช้าอย่างไร
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let slow = async {
trpl::sleep(Duration::from_secs(5)).await;
"Finally finished"
};
match timeout(slow, Duration::from_secs(2)).await {
Ok(message) => println!("Succeeded with '{message}'"),
Err(duration) => {
println!("Failed after {} seconds", duration.as_secs())
}
}
});
}เรามาลองลงมืออิมพลีเมนต์สิ่งนี้กัน! เริ่มต้นจากการวางแผน API ของ timeout:
- ฟังก์ชันนี้ต้องเป็นฟังก์ชัน async ในตัวเอง เพื่อให้เราสามารถ await มันได้
- พารามิเตอร์แรกควรเป็นฟิวเจอร์ที่ต้องการสั่งให้รัน โดยเราสามารถกำหนดให้เป็นเจเนอริก (generic) เพื่อให้ทำงานกับฟิวเจอร์ชนิดใดก็ได้
- พารามิเตอร์ที่สองคือระยะเวลาสูงสุดที่จะรอ ซึ่งหากเราใช้
Durationก็จะทำให้ส่งต่อให้แก่trpl::sleepได้อย่างง่ายดาย - ฟังก์ชันควรคืนค่าเป็น
Resultโดยหากฟิวเจอร์ทำงานสำเร็จResultจะเป็นOkพร้อมกับค่าที่ฟิวเจอร์สร้างขึ้น แต่หากหมดเวลาเสียก่อนResultจะเป็นErrพร้อมระยะเวลาที่ตัวไทม์เอาต์รอไป
ลิสติ้ง 17-19 แสดงการประกาศฟังก์ชันนี้
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let slow = async {
trpl::sleep(Duration::from_secs(5)).await;
"Finally finished"
};
match timeout(slow, Duration::from_secs(2)).await {
Ok(message) => println!("Succeeded with '{message}'"),
Err(duration) => {
println!("Failed after {} seconds", duration.as_secs())
}
}
});
}
async fn timeout<F: Future>(
future_to_try: F,
max_time: Duration,
) -> Result<F::Output, Duration> {
// Here is where our implementation will go!
}นั่นตอบโจทย์ในแง่ของชนิดข้อมูลครบถ้วนแล้ว คราวนี้มาพิจารณาถึง_พฤติกรรมการทำงาน_ที่เราต้องการ: เราต้องการนำฟิวเจอร์ที่ส่งเข้ามามารันแข่งกับระยะเวลาที่กำหนด เราสามารถใช้ trpl::sleep สร้างฟิวเจอร์ตัวจับเวลาขึ้นมาจากระยะเวลานั้น แล้วใช้ trpl::select รันตัวจับเวลาแข่งกับฟิวเจอร์ที่ผู้เรียกส่งเข้ามา
ในลิสติ้ง 17-20 เราอิมพลีเมนต์ timeout ด้วยการใช้ pattern matching กับผลลัพธ์ที่ได้จากการ await trpl::select
extern crate trpl; // required for mdbook test
use std::time::Duration;
use trpl::Either;
// --snip--
fn main() {
trpl::block_on(async {
let slow = async {
trpl::sleep(Duration::from_secs(5)).await;
"Finally finished"
};
match timeout(slow, Duration::from_secs(2)).await {
Ok(message) => println!("Succeeded with '{message}'"),
Err(duration) => {
println!("Failed after {} seconds", duration.as_secs())
}
}
});
}
async fn timeout<F: Future>(
future_to_try: F,
max_time: Duration,
) -> Result<F::Output, Duration> {
match trpl::select(future_to_try, trpl::sleep(max_time)).await {
Either::Left(output) => Ok(output),
Either::Right(_) => Err(max_time),
}
}การอิมพลีเมนต์ของ trpl::select นั้นไม่ได้กระจายความยุติธรรมเท่ากัน: กล่าวคือ มันจะทำการโพลล์ (poll) อาร์กิวเมนต์ตามลำดับที่ส่งเข้ามาเสมอ (ในขณะที่การอิมพลีเมนต์ select แบบอื่นๆ อาจสุ่มเลือกว่าจะโพลล์อาร์กิวเมนต์ใดก่อน) ดังนั้น เราจึงส่ง future_to_try เข้าไปยัง select เป็นตัวแรก เพื่อให้มันมีโอกาสทำงานจนเสร็จแม้ว่า max_time จะสั้นมากก็ตาม หาก future_to_try ทำงานเสร็จก่อน select จะคืนค่า Left พร้อมข้อมูลเอาต์พุตจาก future_to_try แต่หาก timer เสร็จก่อน select จะคืนค่า Right พร้อมเอาต์พุต () ของตัวจับเวลา
หาก future_to_try ทำงานสำเร็จและเราได้รับ Left(output) เราจะคืนค่า Ok(output) แต่หากตัวจับเวลานับถอยหลังหมดลงก่อนและเราได้รับ Right(()) เราจะละเลยค่า () ด้วยเครื่องหมาย _ แล้วคืนค่า Err(max_time) ออกไปแทน
เพียงเท่านี้เราก็ได้ฟังก์ชัน timeout ที่ใช้งานได้จริง ซึ่งประกอบขึ้นจากตัวช่วย async สองตัว และหากเรารันโค้ด มันจะแสดงผลกรณีหมดเวลาดังนี้:
Failed after 2 seconds
และเนื่องจากฟิวเจอร์สามารถนำมาประกอบร่วมกับฟิวเจอร์อื่นๆ ได้ คุณจึงสามารถสร้างเครื่องมือที่ทรงพลังอย่างยิ่งขึ้นมาจากองค์ประกอบย่อยๆ แบบ async ตัวอย่างเช่น คุณสามารถใช้แนวทางนี้ผสานไทม์เอาต์เข้ากับระบบลองใหม่ (retries) แล้วนำไปประยุกต์ใช้กับการเรียกใช้งานเครือข่าย (ดังเช่นในลิสติ้ง 17-5) ได้
ในทางปฏิบัติ คุณมักจะเขียนโค้ดโดยใช้ async และ await เป็นหลัก และใช้งานฟังก์ชันอย่าง select ตลอดจนมาโครอย่าง join! ในลำดับรองลงมา เพื่อควบคุมจังหวะการประมวลผลของฟิวเจอร์ชั้นนอกสุด
จนถึงตอนนี้ เราได้เห็นหลากหลายวิธีในการทำงานกับฟิวเจอร์หลายๆ ตัวไปพร้อมกันแล้ว ในหัวข้อถัดไป เราจะมาดูกันว่าเราสามารถจัดการกับฟิวเจอร์ที่ทยอยมาอย่างต่อเนื่องตามลำดับเวลาด้วย_สตรีม (stream)_ ได้อย่างไร
สตรีม: ฟิวเจอร์แบบเป็นลำดับ
สตรีม: ฟิวเจอร์ที่เรียงต่อกันเป็นลำดับ
ย้อนนึกถึงวิธีที่เราใช้ตัวรับของแชนเนลแบบ async ไปก่อนหน้านี้ในบทนี้ที่หัวข้อ“การส่งผ่านข้อความ” เมธอด recv แบบ async จะให้ลำดับของรายการข้อมูลออกมาตามช่วงเวลา ซึ่งนี่เป็นตัวอย่างหนึ่งของรูปแบบการทำงานที่กว้างกว่ามากที่เรียกว่า_สตรีม_ (stream) แนวคิดหลายอย่างสามารถแสดงออกมาในรูปของสตรีมได้อย่างเป็นธรรมชาติ เช่น ข้อมูลที่ทยอยพร้อมใช้งานในคิว, ชิ้นส่วนข้อมูลที่ค่อยๆ ถูกดึงมาจากระบบไฟล์เมื่อชุดข้อมูลทั้งหมดมีขนาดใหญ่เกินกว่าจะเก็บไว้ในหน่วยความจำของคอมพิวเตอร์ได้ทั้งหมด, หรือข้อมูลที่ทยอยส่งมาผ่านเครือข่ายตามลำดับเวลา และเนื่องจากสตรีมก็คือฟิวเจอร์ชนิดหนึ่ง เราจึงสามารถใช้สตรีมร่วมกับฟิวเจอร์ชนิดอื่นๆ และนำมารวมเข้าด้วยกันในวิธีที่น่าสนใจได้ ตัวอย่างเช่น เราสามารถรวมอีเวนต์เป็นชุด (batch) เพื่อหลีกเลี่ยงการส่งคำขอผ่านเครือข่ายบ่อยเกินไป, ตั้งไทม์เอาต์ให้กับลำดับของการทำงานที่ใช้เวลานาน, หรือจำกัดอัตราการเกิดอีเวนต์บนหน้าจอผู้ใช้ (throttle) เพื่อหลีกเลี่ยงการประมวลผลที่ไม่จำเป็น
เราเคยเห็นลำดับของข้อมูลกันไปแล้วในบทที่ 13 เมื่อเราศึกษาเทรต Iterator ในหัวข้อ“เทรต Iterator และเมธอด next” แต่มีความแตกต่างอยู่สองประการระหว่างอิเทอเรเตอร์ (iterator) กับตัวรับของแชนเนลแบบ async ประการแรกคือเรื่องของเวลา: อิเทอเรเตอร์เป็นแบบซิงโครนัส ในขณะที่ตัวรับของแชนเนลเป็นแบบอะซิงโครนัส ประการที่สองคือ API: เมื่อทำงานกับ Iterator โดยตรง เราจะเรียกเมธอด next แบบซิงโครนัสของมัน แต่สำหรับสตรีมของ trpl::Receiver เราเรียกเมธอด recv ซึ่งเป็นแบบอะซิงโครนัสแทน นอกเหนือจากนั้นแล้ว API ทั้งสองแบบให้ความรู้สึกที่คล้ายกันมาก และความคล้ายคลึงนั้นก็ไม่ใช่เรื่องบังเอิญ สตรีมเปรียบเสมือนรูปแบบอะซิงโครนัสของการวนซ้ำ (iteration) อย่างไรก็ตาม ในขณะที่ trpl::Receiver เจาะจงเฉพาะการรอรับข้อความ แต่ API ของสตรีมสำหรับใช้งานทั่วไปนั้นครอบคลุมกว้างกว่ามาก: มันจะจัดเตรียมข้อมูลตัวถัดไปเหมือนกับที่ Iterator ทำ แต่ทำในแบบอะซิงโครนัส
ความคล้ายคลึงกันระหว่างอิเทอเรเตอร์กับสตรีมใน Rust ทำให้เราสามารถสร้างสตรีมขึ้นมาจากอิเทอเรเตอร์ใดๆ ก็ได้ เช่นเดียวกับอิเทอเรเตอร์ เราสามารถทำงานกับสตรีมได้โดยการเรียกเมธอด next ของมันแล้ว await เพื่อรอรับเอาต์พุต ดังแสดงในลิสติ้ง 17-21 ซึ่งในตอนนี้จะยังคอมไพล์ไม่ผ่าน
extern crate trpl; // required for mdbook test
fn main() {
trpl::block_on(async {
let values = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10];
let iter = values.iter().map(|n| n * 2);
let mut stream = trpl::stream_from_iter(iter);
while let Some(value) = stream.next().await {
println!("The value was: {value}");
}
});
}เราเริ่มต้นด้วยอาร์เรย์ของตัวเลข ซึ่งเราแปลงเป็นอิเทอเรเตอร์แล้วเรียกใช้ map เพื่อเพิ่มค่าทั้งหมดเป็นสองเท่า จากนั้นเราแปลงอิเทอเรเตอร์ให้กลายเป็นสตรีมโดยใช้ฟังก์ชัน trpl::stream_from_iter ต่อไปเราวนลูปข้อมูลในสตรีมที่ทยอยเข้ามาด้วยลูป while let
แต่น่าเสียดาย เมื่อเราลองรันโค้ด มันกลับคอมไพล์ไม่ผ่านและรายงานข้อผิดพลาดว่าไม่มีเมธอด next ให้ใช้งาน:
error[E0599]: no method named `next` found for struct `tokio_stream::iter::Iter` in the current scope
--> src/main.rs:10:40
|
10 | while let Some(value) = stream.next().await {
| ^^^^
|
= help: items from traits can only be used if the trait is in scope
help: the following traits which provide `next` are implemented but not in scope; perhaps you want to import one of them
|
1 + use crate::trpl::StreamExt;
|
1 + use futures_util::stream::stream::StreamExt;
|
1 + use std::iter::Iterator;
|
1 + use std::str::pattern::Searcher;
|
help: there is a method `try_next` with a similar name
|
10 | while let Some(value) = stream.try_next().await {
| ~~~~~~~~
ดังที่เอาต์พุตนี้ได้อธิบายไว้ สาเหตุของข้อผิดพลาดจากคอมไพเลอร์ก็คือ เราจำเป็นต้องมีเทรตที่ถูกต้องอยู่ในสโคป (scope) เพื่อให้สามารถใช้เมธอด next ได้ จากสิ่งที่เราพูดคุยกันมา คุณอาจคาดหวังว่าเทรตดังกล่าวน่าจะเป็น Stream แต่ในความเป็นจริงแล้วมันคือ StreamExt คำว่า Ext นั้นย่อมาจาก extension (ส่วนขยาย) ซึ่งเป็นแพตเทิร์นที่พบได้ทั่วไปในชุมชน Rust สำหรับใช้ขยายขีดความสามารถของเทรตหนึ่งด้วยอีกเทรตหนึ่ง
เทรต Stream นิยามอินเทอร์เฟซระดับต่ำที่รวมเทรต Iterator และ Future เข้าด้วยกันอย่างลงตัว ส่วน StreamExt จะเตรียมชุด API ระดับสูงกว่าไว้บนพื้นฐานของ Stream ซึ่งรวมถึงเมธอด next ตลอดจนเมธอดอรรถประโยชน์อื่นๆ ที่คล้ายกับเมธอดที่เทรต Iterator มีให้ ปัจจุบัน Stream และ StreamExt ยังไม่ได้เป็นส่วนหนึ่งของไลบรารีมาตรฐานของ Rust แต่เครตส่วนใหญ่ในระบบนิเวศต่างก็นิยามและใช้งานในรูปแบบที่คล้ายคลึงกันนี้
วิธีแก้ข้อผิดพลาดของคอมไพเลอร์คือการเพิ่มสเตตเมนต์ use สำหรับ trpl::StreamExt ดังแสดงในลิสติ้ง 17-22
extern crate trpl; // required for mdbook test
use trpl::StreamExt;
fn main() {
trpl::block_on(async {
let values = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10];
// --snip--
let iter = values.iter().map(|n| n * 2);
let mut stream = trpl::stream_from_iter(iter);
while let Some(value) = stream.next().await {
println!("The value was: {value}");
}
});
}เมื่อประกอบชิ้นส่วนทั้งหมดเข้าด้วยกัน โค้ดนี้ก็ทำงานได้ตามที่เราต้องการ! ยิ่งไปกว่านั้น เมื่อเรามี StreamExt อยู่ในสโคปแล้ว เราก็สามารถใช้เมธอดอรรถประโยชน์ทั้งหมดของมันได้ เช่นเดียวกับที่เราทำกับอิเทอเรเตอร์
เจาะลึกเทรตสำหรับ async
เจาะลึกเทรตสำหรับ async
ตลอดทั้งบทนี้ เราได้ใช้เทรต (trait) Future, Stream และ StreamExt ในหลากหลายรูปแบบ อย่างไรก็ตาม จนถึงตอนนี้เรายังหลีกเลี่ยงการลงลึกในรายละเอียดว่าพวกมันทำงานอย่างไรหรือประกอบเข้าด้วยกันอย่างไร ซึ่งโดยทั่วไปแล้วเพียงพอสำหรับการเขียนโค้ด Rust ในชีวิตประจำวันของคุณ แต่ในบางครั้ง คุณอาจต้องเจอกับสถานการณ์ที่จำเป็นต้องเข้าใจรายละเอียดเพิ่มเติมของเทรตเหล่านี้ พร้อมทั้งชนิดข้อมูล Pin และเทรต Unpin ในหัวข้อนี้ เราจะเจาะลึกพอให้คุณสามารถรับมือกับสถานการณ์เหล่านั้นได้ โดยขอละเว้นการลงลึก_ระดับโครงสร้างภายในจริงๆ_ ไว้ให้เอกสารอ้างอิงอื่นๆ
เทรต Future
เรามาเริ่มต้นด้วยการพิจารณาอย่างละเอียดว่าเทรต Future ทำงานอย่างไร นี่คือนิยามที่ Rust กำหนดไว้:
#![allow(unused)]
fn main() {
use std::pin::Pin;
use std::task::{Context, Poll};
pub trait Future {
type Output;
fn poll(self: Pin<&mut Self>, cx: &mut Context<'_>) -> Poll<Self::Output>;
}
}คำนิยามเทรตดังกล่าวมีชนิดข้อมูลใหม่หลายชนิด และยังมีวากยสัมพันธ์บางอย่างที่เราไม่เคยเห็นมาก่อน ดังนั้นเรามาพิจารณานิยามนี้ทีละส่วนกัน
อย่างแรก ชนิดข้อมูลสัมพันธ์ (associated type) Output ของ Future จะระบุว่าฟิวเจอร์นี้จะคืนผลลัพธ์ (resolve) ออกมาเป็นค่าชนิดใด ซึ่งเทียบได้กับชนิดข้อมูลสัมพันธ์ Item ของเทรต Iterator อย่างที่สอง Future มีเมธอด poll ซึ่งรับเรเฟอเรนซ์พิเศษแบบ Pin เป็นพารามิเตอร์ self และรับเรเฟอเรนซ์แบบมิวเทเบิลไปยังชนิด Context จากนั้นจะคืนค่าเป็น Poll<Self::Output> เราจะพูดถึง Pin และ Context กันในอีกสักครู่ ตอนนี้เรามาดูสิ่งที่เมธอดนี้คืนค่ากลับมาก่อน นั่นคือชนิดข้อมูล Poll:
#![allow(unused)]
fn main() {
pub enum Poll<T> {
Ready(T),
Pending,
}
}ชนิดข้อมูล Poll นี้คล้ายกับ Option: คือมีวาเรียนต์ที่มีค่าอยู่ภายในคือ Ready(T) และวาเรียนต์ที่ไม่มีค่าคือ Pending อย่างไรก็ตาม Poll มีความหมายที่แตกต่างจาก Option อย่างมาก! โดยวาเรียนต์ Pending จะบ่งบอกว่าฟิวเจอร์ยังมีงานที่ต้องทำค้างอยู่ ผู้เรียกจึงต้องกลับมาตรวจสอบใหม่อีกครั้งในภายหลัง ส่วนวาเรียนต์ Ready จะบ่งบอกว่า Future ทำงานเสร็จสิ้นแล้ว และมีค่า T พร้อมให้ใช้งาน
หมายเหตุ: แทบจะไม่มีกรณีที่คุณต้องเรียก
pollโดยตรง แต่หากคุณจำเป็นต้องเรียกจริงๆ พึงระลึกไว้ว่าสำหรับฟิวเจอร์ส่วนใหญ่แล้ว ผู้เรียกไม่ควรเรียกpollซ้ำอีกหลังจากที่ฟิวเจอร์คืนค่าReadyออกมาแล้ว ฟิวเจอร์หลายตัวจะแพนิกหากถูกโพลล์ซ้ำหลังจากพร้อมแล้ว ฟิวเจอร์ตัวใดที่ปลอดภัยต่อการโพลล์ซ้ำจะระบุไว้อย่างชัดเจนในเอกสารประกอบของมัน ซึ่งพฤติกรรมนี้จะคล้ายคลึงกับIterator::next
เมื่อคุณเห็นโค้ดที่ใช้ await เบื้องหลังแล้ว Rust จะคอมไพล์มันให้กลายเป็นโค้ดที่เรียก poll หากคุณย้อนกลับไปดูในลิสติ้ง 17-4 ที่เราพิมพ์ชื่อเรื่องของเพจสำหรับ URL เดียวเมื่อมันได้ผลลัพธ์แล้ว Rust จะคอมไพล์โค้ดดังกล่าวออกมาเป็นสิ่งที่ใกล้เคียง (แม้จะไม่เหมือนเป๊ะๆ) กับโค้ดนี้:
match page_title(url).poll() {
Ready(page_title) => match page_title {
Some(title) => println!("The title for {url} was {title}"),
None => println!("{url} had no title"),
}
Pending => {
// But what goes here?
}
}เมื่อฟิวเจอร์ยังคงเป็น Pending อยู่ เราควรทำอย่างไรต่อไป? เราจำเป็นต้องมีวิธีลองใหม่ซ้ำแล้วซ้ำเล่าจนกว่าฟิวเจอร์จะพร้อมในที่สุด หรือพูดอีกอย่างหนึ่งคือ เราจำเป็นต้องมีลูป:
let mut page_title_fut = page_title(url);
loop {
match page_title_fut.poll() {
Ready(value) => match page_title {
Some(title) => println!("The title for {url} was {title}"),
None => println!("{url} had no title"),
}
Pending => {
// continue
}
}
}อย่างไรก็ตาม หาก Rust คอมไพล์มันออกมาเป็นโค้ดแบบนั้นเป๊ะๆ ทุกๆ await ก็จะกลายเป็นการบล็อกการทำงาน—ซึ่งตรงกันข้ามกับสิ่งที่เราต้องการอย่างสิ้นเชิง! แทนที่จะทำเช่นนั้น Rust จะทำให้แน่ใจว่าลูปดังกล่าวสามารถส่งต่อการควบคุมไปยังสิ่งอื่นที่สามารถหยุดพักการทำงานของฟิวเจอร์นี้ชั่วคราว เพื่อสลับไปทำงานกับฟิวเจอร์อื่นๆ แล้วค่อยกลับมาตรวจสอบฟิวเจอร์นี้ใหม่ในภายหลัง และดังที่เราได้เห็นมาแล้ว สิ่งนั้นก็คือรันไทม์ (runtime) แบบ async ซึ่งการจัดตารางเวลาและการประสานงานนี้ก็คืองานหลักอย่างหนึ่งของมัน
ในหัวข้อ“การส่งข้อมูลระหว่างสองทาสก์ด้วยการส่งผ่านข้อความ” เราได้อธิบายการรอ rx.recv ไปแล้ว การเรียก recv จะคืนค่าเป็นฟิวเจอร์ และการ await ฟิวเจอร์นั้นก็คือการโพลล์มัน เราได้ตั้งข้อสังเกตไว้ว่ารันไทม์จะหยุดพักฟิวเจอร์ไว้ชั่วคราวจนกว่ามันจะพร้อมใช้งานด้วยค่า Some(message) หรือเป็น None เมื่อแชนเนลปิดลง ด้วยความเข้าใจที่ลึกซึ้งยิ่งขึ้นของเราเกี่ยวกับเทรต Future และโดยเฉพาะอย่างยิ่ง Future::poll ทำให้เราเห็นแล้วว่ามันทำงานอย่างไร รันไทม์จะรู้ว่าฟิวเจอร์ยังไม่พร้อมเมื่อมันคืนค่า Poll::Pending ในทางกลับกัน รันไทม์จะรู้ว่าฟิวเจอร์_พร้อม_แล้วและผลักดันการทำงานของมันต่อไปเมื่อ poll คืนค่า Poll::Ready(Some(message)) หรือ Poll::Ready(None)
รายละเอียดที่แน่ชัดว่ารันไทม์จัดการเรื่องนี้อย่างไรนั้นอยู่นอกเหนือขอบเขตของหนังสือเล่มนี้ แต่หัวใจสำคัญคือการเข้าใจกลไกพื้นฐานของฟิวเจอร์: รันไทม์จะ_โพลล์_ฟิวเจอร์แต่ละตัวที่อยู่ในความรับผิดชอบของมัน และสั่งให้ฟิวเจอร์กลับไปหลับเมื่อมันยังไม่พร้อมทำงาน
ชนิด Pin และเทรต Unpin
ย้อนกลับไปในลิสติ้ง 17-13 เราใช้มาโคร trpl::join! เพื่อ await ฟิวเจอร์สามตัว อย่างไรก็ตาม ในการใช้งานจริงมักจะมีคอลเลกชัน เช่น เวกเตอร์ที่บรรจุฟิวเจอร์จำนวนหนึ่งซึ่งเราจะไม่รู้จำนวนที่แน่นอนจนกว่าจะถึงเวลาทำงานจริง (runtime) เรามาลองเปลี่ยนลิสติ้ง 17-13 ให้เป็นโค้ดในลิสติ้ง 17-23 ที่นำฟิวเจอร์ทั้งสามตัวใส่ลงในเวกเตอร์แล้วเรียกใช้ฟังก์ชัน trpl::join_all แทน ซึ่งตอนนี้จะยังคอมไพล์ไม่ผ่าน
extern crate trpl; // required for mdbook test
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx1 = tx.clone();
let tx1_fut = async move {
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx1.send(val).unwrap();
trpl::sleep(Duration::from_secs(1)).await;
}
};
let rx_fut = async {
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
};
let tx_fut = async move {
// --snip--
let vals = vec![
String::from("more"),
String::from("messages"),
String::from("for"),
String::from("you"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_secs(1)).await;
}
};
let futures: Vec<Box<dyn Future<Output = ()>>> =
vec![Box::new(tx1_fut), Box::new(rx_fut), Box::new(tx_fut)];
trpl::join_all(futures).await;
});
}เราใส่ฟิวเจอร์แต่ละตัวไว้ใน Box เพื่อให้มันกลายเป็น_เทรตออบเจกต์_ (trait object) เช่นเดียวกับที่เราเคยทำในหัวข้อ “การคืนค่าข้อผิดพลาดจาก run” ในบทที่ 12 (เราจะอธิบายเรื่องเทรตออบเจกต์อย่างละเอียดในบทที่ 18) การใช้เทรตออบเจกต์ช่วยให้เราสามารถจัดการกับฟิวเจอร์นิรนามแต่ละตัวที่ถูกสร้างขึ้นให้เป็นชนิดเดียวกันได้ เนื่องจากทุกตัวต่างก็อิมพลีเมนต์เทรต Future เหมือนกัน
สิ่งนี้อาจฟังดูน่าแปลกใจ เพราะอย่างไรเสีย ไม่มีบล็อก async ตัวใดเลยที่คืนค่าใดๆ กลับมา ดังนั้นแต่ละตัวจึงสร้าง Future<Output = ()> ขึ้นมา แต่พึงระลึกไว้ว่า Future เป็นเทรต และคอมไพเลอร์จะสร้าง enum ที่ไม่ซ้ำกันขึ้นมาสำหรับแต่ละบล็อก async แม้ว่าพวกมันจะมีชนิดข้อมูลของเอาต์พุตที่เหมือนกันก็ตาม เช่นเดียวกับที่คุณไม่สามารถใส่ struct สองชนิดที่เขียนขึ้นมาต่างกันลงใน Vec เดียวกันได้ คุณก็ไม่สามารถใส่ enum ที่คอมไพเลอร์สร้างขึ้นต่างชนิดกันลงไปด้วยเช่นกัน
จากนั้นเราส่งคอลเลกชันของฟิวเจอร์ให้กับฟังก์ชัน trpl::join_all แล้ว await ผลลัพธ์ แต่โค้ดนี้คอมไพล์ไม่ผ่าน นี่คือส่วนสำคัญของข้อความแสดงข้อผิดพลาด:
error[E0277]: `dyn Future<Output = ()>` cannot be unpinned
--> src/main.rs:48:33
|
48 | trpl::join_all(futures).await;
| ^^^^^ the trait `Unpin` is not implemented for `dyn Future<Output = ()>`
|
= note: consider using the `pin!` macro
consider using `Box::pin` if you need to access the pinned value outside of the current scope
= note: required for `Box<dyn Future<Output = ()>>` to implement `Future`
note: required by a bound in `futures_util::future::join_all::JoinAll`
--> file:///home/.cargo/registry/src/index.crates.io-1949cf8c6b5b557f/futures-util-0.3.30/src/future/join_all.rs:29:8
|
27 | pub struct JoinAll<F>
| ------- required by a bound in this struct
28 | where
29 | F: Future,
| ^^^^^^ required by this bound in `JoinAll`
หมายเหตุในข้อความแสดงข้อผิดพลาดนี้บอกให้เราใช้มาโคร pin! เพื่อ_ตรึง_ (pin) ค่าเหล่านั้น ซึ่งหมายถึงการนำค่านั้นไปใส่ไว้ในชนิดข้อมูล Pin ที่รับประกันว่าค่านั้นจะไม่ถูกย้ายตำแหน่งในหน่วยความจำ ข้อความแสดงข้อผิดพลาดบอกว่าจำเป็นต้องตรึงค่าเพราะ dyn Future<Output = ()> ต้องอิมพลีเมนต์เทรต Unpin แต่ในตอนนี้มันยังไม่ได้อิมพลีเมนต์
ฟังก์ชัน trpl::join_all คืนค่า struct ที่ชื่อ JoinAll ซึ่ง struct ดังกล่าวเป็นเจเนอริกบนชนิดข้อมูล F ที่ถูกจำกัดให้อิมพลีเมนต์เทรต Future การ await ฟิวเจอร์โดยตรงด้วยคีย์เวิร์ด await จะทำการตรึงฟิวเจอร์นั้นโดยปริยาย นั่นคือเหตุผลที่เราไม่จำเป็นต้องใช้ pin! ในทุกๆ ที่ที่เราต้องการ await ฟิวเจอร์
อย่างไรก็ตาม ในกรณีนี้เราไม่ได้ await ฟิวเจอร์โดยตรง แต่เรากำลังสร้างฟิวเจอร์ใหม่ที่ชื่อ JoinAll ขึ้นมาด้วยการส่งคอลเลกชันของฟิวเจอร์เข้าไปยังฟังก์ชัน join_all ซิกเนเจอร์ (signature) ของ join_all กำหนดให้สมาชิกทุกตัวในคอลเลกชันต้องอิมพลีเมนต์เทรต Future และ Box<T> จะอิมพลีเมนต์ Future ได้ก็ต่อเมื่อ T ที่มันห่อหุ้มอยู่นั้นเป็นฟิวเจอร์ที่อิมพลีเมนต์เทรต Unpin เท่านั้น
นั่นเป็นเรื่องที่มีรายละเอียดค่อนข้างมาก! เพื่อให้เข้าใจได้อย่างถ่องแท้ เรามาเจาะลึกกันอีกเล็กน้อยว่าเทรต Future ทำงานอย่างไร โดยเฉพาะอย่างยิ่งในเรื่องของการตรึง เรามาดูคำนิยามของเทรต Future กันอีกครั้ง:
#![allow(unused)]
fn main() {
use std::pin::Pin;
use std::task::{Context, Poll};
pub trait Future {
type Output;
// Required method
fn poll(self: Pin<&mut Self>, cx: &mut Context<'_>) -> Poll<Self::Output>;
}
}พารามิเตอร์ cx และชนิดข้อมูล Context ของมันคือกุญแจสำคัญที่ทำให้รันไทม์รู้ว่าเมื่อใดควรกลับมาตรวจสอบฟิวเจอร์ที่กำหนด ในขณะที่ยังคงคุณสมบัติความเลซี่ (lazy) ไว้ได้ และย้ำอีกครั้งว่า รายละเอียดการทำงานของมันอยู่นอกเหนือขอบเขตของบทนี้ โดยทั่วไปคุณจะต้องคำนึงถึงเรื่องนี้เฉพาะตอนเขียนการอิมพลีเมนต์ Future ขึ้นมาเองเท่านั้น เราจะเน้นไปที่ชนิดข้อมูลของ self แทน เพราะนี่เป็นครั้งแรกที่เราได้เห็นเมธอดที่มีการระบุชนิดข้อมูล (type annotation) ให้กับ self การระบุชนิดข้อมูลให้กับ self จะทำงานเหมือนกับการระบุชนิดข้อมูลให้พารามิเตอร์อื่นๆ ของฟังก์ชัน แต่มีความแตกต่างสำคัญสองประการ:
- มันบอกให้ Rust ทราบว่า
selfต้องเป็นชนิดข้อมูลใดจึงจะสามารถเรียกใช้เมธอดนี้ได้ - มันไม่ใช่ชนิดข้อมูลอะไรก็ได้ตามใจชอบ แต่ถูกจำกัดให้ต้องเป็นชนิดที่เมธอดนั้นถูกอิมพลีเมนต์อยู่, เป็นเรเฟอเรนซ์หรือสมาร์ตพอยน์เตอร์ไปยังชนิดนั้น, หรือเป็น
Pinที่ห่อหุ้มเรเฟอเรนซ์ไปยังชนิดนั้น
เราจะได้เห็นวากยสัมพันธ์นี้เพิ่มเติมในบทที่ 18 สำหรับตอนนี้ ขอเพียงรู้ว่าหากเราต้องการโพลล์ฟิวเจอร์เพื่อตรวจดูว่ามันเป็น Pending หรือ Ready(Output) เราจำเป็นต้องมีเรเฟอเรนซ์แบบมิวเทเบิลที่ถูกห่อหุ้มด้วย Pin ชี้ไปยังชนิดข้อมูลนั้น
Pin คือตัวห่อหุ้ม (wrapper) สำหรับชนิดข้อมูลที่ทำหน้าที่เสมือนพอยน์เตอร์ เช่น &, &mut, Box และ Rc (ในทางเทคนิค Pin ทำงานกับชนิดข้อมูลใดก็ตามที่อิมพลีเมนต์เทรต Deref หรือ DerefMut ซึ่งในทางปฏิบัติก็เทียบเท่ากับการทำงานกับเรเฟอเรนซ์และสมาร์ตพอยน์เตอร์นั่นเอง) ตัว Pin เองไม่ใช่พอยน์เตอร์และไม่มีพฤติกรรมเฉพาะตัวแบบที่ Rc หรือ Arc มีการนับจำนวนเรเฟอเรนซ์ (reference counting) มันเป็นเพียงเครื่องมือที่คอมไพเลอร์ใช้บังคับใช้ข้อจำกัดในการใช้งานพอยน์เตอร์เท่านั้น
การระลึกได้ว่า await ถูกอิมพลีเมนต์ขึ้นจากการเรียก poll เริ่มช่วยอธิบายข้อความแสดงข้อผิดพลาดที่เราเห็นก่อนหน้านี้ได้ แต่ข้อความนั้นพูดถึง Unpin ไม่ใช่ Pin แล้ว Pin กับ Unpin สัมพันธ์กันอย่างไรกันแน่ และทำไม Future ถึงต้องการให้ self อยู่ในชนิด Pin เพื่อเรียก poll?
ย้อนนึกถึงตอนต้นบทนี้ว่า ชุดของจุด await ในฟิวเจอร์จะถูกคอมไพล์ให้กลายเป็นสเตตแมชชีน และคอมไพเลอร์จะทำให้แน่ใจว่าสเตตแมชชีนนั้นปฏิบัติตามกฎความปลอดภัยปกติทั้งหมดของ Rust รวมถึงการยืมและความเป็นเจ้าของ เพื่อให้กลไกนี้ทำงานได้ Rust จะตรวจสอบว่าต้องใช้ข้อมูลใดบ้างระหว่างจุด await หนึ่งไปยังจุด await ถัดไป หรือจนถึงจุดสิ้นสุดของบล็อก async จากนั้นมันจะสร้างวาเรียนต์ที่สอดคล้องกันขึ้นในสเตตแมชชีนที่ถูกคอมไพล์แล้ว วาเรียนต์แต่ละตัวจะได้รับสิทธิ์ในการเข้าถึงข้อมูลที่จำเป็นสำหรับโค้ดส่วนนั้น ไม่ว่าจะโดยการรับความเป็นเจ้าของข้อมูล หรือโดยการถือเรเฟอเรนซ์แบบมิวเทเบิลหรืออิมมิวเทเบิลไปยังข้อมูลนั้น
จนถึงตอนนี้ทุกอย่างก็ดูราบรื่นดี: หากเราทำสิ่งใดผิดพลาดเกี่ยวกับความเป็นเจ้าของหรือเรเฟอเรนซ์ในบล็อก async ตัวตรวจการยืม (borrow checker) ก็จะแจ้งเตือนเรา แต่เมื่อเราต้องการย้ายฟิวเจอร์ที่สอดคล้องกับบล็อกนั้นไปมา—เช่น การย้ายมันเข้าไปใน Vec เพื่อส่งให้ join_all—เรื่องราวก็จะเริ่มซับซ้อนขึ้น
เมื่อเราย้ายฟิวเจอร์ ไม่ว่าจะเป็นการพุชมันเข้าไปในโครงสร้างข้อมูลเพื่อนำไปใช้เป็นอิเทอเรเตอร์กับ join_all หรือการส่งคืนค่ามันกลับมาจากฟังก์ชัน นั่นหมายถึงการย้ายสเตตแมชชีนที่ Rust สร้างขึ้นให้เราจริงๆ และไม่เหมือนกับชนิดข้อมูลอื่นๆ ส่วนใหญ่ใน Rust ฟิวเจอร์ที่ Rust สร้างขึ้นสำหรับบล็อก async อาจมีเรเฟอเรนซ์ที่ชี้กลับมายังตัวเอง (self-referential) อยู่ในฟิลด์ของวาเรียนต์ใดวาเรียนต์หนึ่งได้ ดังแสดงในภาพประกอบอย่างง่ายในรูปที่ 17-4
อย่างไรก็ตาม โดยปริยายแล้ว วัตถุใดๆ ที่มีเรเฟอเรนซ์ชี้กลับมายังตัวเองจะไม่ปลอดภัยต่อการย้ายตำแหน่ง เพราะเรเฟอเรนซ์จะชี้ไปยังแอดเดรสหน่วยความจำจริงของสิ่งที่มันอ้างถึงเสมอ (ดูรูปที่ 17-5) หากคุณย้ายตัวโครงสร้างข้อมูลนั้นเอง เรเฟอเรนซ์ภายในเหล่านั้นจะยังคงชี้ไปยังตำแหน่งเดิม แต่ตำแหน่งหน่วยความจำเดิมนั้นไม่ถูกต้องอีกต่อไปแล้ว ประการหนึ่ง ค่าของมันจะไม่ถูกอัปเดตเมื่อคุณแก้ไขโครงสร้างข้อมูล และอีกประการหนึ่ง—ซึ่งสำคัญยิ่งกว่า—คอมพิวเตอร์สามารถนำพื้นที่หน่วยความจำตรงนั้นไปใช้ซ้ำสำหรับงานอื่นได้แล้ว! คุณอาจลงเอยด้วยการอ่านข้อมูลที่ไม่เกี่ยวข้องกันเลยในภายหลัง
ในทางทฤษฎี คอมไพเลอร์ของ Rust อาจพยายามอัปเดตทุกเรเฟอเรนซ์ที่ชี้ไปยังวัตถุทุกครั้งที่มีการย้ายตำแหน่ง แต่นั่นอาจเพิ่ม overhead ด้านประสิทธิภาพอย่างมหาศาล โดยเฉพาะอย่างยิ่งหากต้องอัปเดตเครือข่ายของเรเฟอเรนซ์ที่เชื่อมโยงกันทั้งหมด แต่หากเราสามารถทำให้มั่นใจได้ว่าโครงสร้างข้อมูลนั้น_จะไม่เคลื่อนย้ายในหน่วยความจำ_ เราก็ไม่จำเป็นต้องอัปเดตเรเฟอเรนซ์ใดๆ เลย นี่คือสิ่งที่ตัวตรวจการยืมของ Rust มีหน้าที่จัดการพอดี: ในโค้ดที่ปลอดภัย (safe code) มันจะป้องกันไม่ให้คุณย้ายข้อมูลใดๆ ที่มีเรเฟอเรนซ์ที่ยังใช้งานอยู่ชี้ไปยังมัน
Pin ต่อยอดจากแนวคิดดังกล่าวเพื่อมอบการรับประกันตามที่เราต้องการ เมื่อเรา_ตรึง_ค่าด้วยการห่อหุ้มพอยน์เตอร์ที่ชี้ไปยังค่านั้นไว้ใน Pin ค่านั้นจะไม่สามารถเคลื่อนย้ายตำแหน่งได้อีกต่อไป ดังนั้น หากคุณมี Pin<Box<SomeType>> คุณกำลังตรึงค่า SomeType จริงๆ _ไม่ใช่_การตรึงพอยน์เตอร์ Box รูปที่ 17-6 แสดงภาพของกระบวนการนี้
ในความเป็นจริง พอยน์เตอร์ Box ยังคงเคลื่อนย้ายไปมาได้อย่างอิสระ พึงระลึกว่า: สิ่งที่เราให้ความสำคัญคือการทำให้แน่ใจว่าข้อมูลปลายทางที่ถูกอ้างถึงนั้นจะอยู่กับที่เดิม หากพอยน์เตอร์ถูกย้าย แต่ข้อมูลที่มันชี้ไป ยังคงอยู่ที่เดิม ดังในรูปที่ 17-7 ก็จะไม่เกิดปัญหาใดๆ ทั้งสิ้น (ในฐานะแบบฝึกหัดเพิ่มเติม ลองเปิดดูเอกสารประกอบของชนิดข้อมูลเหล่านี้รวมถึงมอดูล std::pin แล้วลองคิดดูว่าคุณจะทำเช่นนี้กับ Pin ที่ห่อ Box ได้อย่างไร) หัวใจสำคัญคือ ชนิดข้อมูลที่อ้างถึงตัวเองจะต้องไม่ขยับย้ายที่ เพราะมันยังคงถูกตรึงอยู่
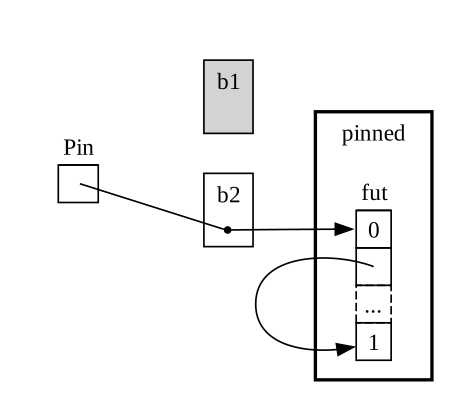
อย่างไรก็ตาม ชนิดข้อมูลส่วนใหญ่มีความปลอดภัยอย่างสมบูรณ์ในการย้ายไปมา แม้ว่ามันจะอยู่เบื้องหลังพอยน์เตอร์ Pin ก็ตาม เราจำเป็นต้องคำนึงถึงการตรึงเฉพาะเมื่อข้อมูลนั้นมีเรเฟอเรนซ์ภายในเท่านั้น ค่าพื้นฐานดั้งเดิม (primitive) เช่น ตัวเลขและบูลีนนั้นปลอดภัยแน่นอนเพราะพวกมันไม่มีเรเฟอเรนซ์ภายใน ชนิดข้อมูลส่วนใหญ่ที่คุณใช้งานทั่วไปใน Rust ก็เช่นกัน คุณสามารถย้าย Vec ไปมาได้โดยไม่ต้องกังวล ตัวอย่างเช่น จากสิ่งที่เราเห็นมา หากคุณมี Pin<Vec<String>> คุณจะต้องทำทุกอย่างผ่าน API ที่ปลอดภัยแต่เข้มงวดที่ Pin กำหนดไว้ ทั้งๆ ที่ความจริงแล้ว Vec<String> นั้นปลอดภัยที่จะย้ายตำแหน่งเสมอหากไม่มีเรเฟอเรนซ์อื่นชี้ไปยังมัน เราจึงจำเป็นต้องมีวิธีบอกคอมไพเลอร์ว่าการย้ายข้อมูลในกรณีเช่นนี้เป็นเรื่องที่ปลอดภัยอย่างสมบูรณ์ และนั่นคือจุดที่ Unpin เข้ามามีบทบาท
Unpin เป็นเทรตมาร์กเกอร์ (marker trait) คล้ายกับเทรต Send และ Sync ที่เราเห็นในบทที่ 16 ดังนั้นมันจึงไม่มีฟังก์ชันการทำงานเป็นของตัวเอง เทรตมาร์กเกอร์มีอยู่เพียงเพื่อบอกคอมไพเลอร์ว่าการใช้ชนิดข้อมูลที่อิมพลีเมนต์เทรตนั้นในบริบทเฉพาะเป็นเรื่องที่ปลอดภัย Unpin จะแจ้งให้คอมไพเลอร์ทราบว่าชนิดข้อมูลดังกล่าว_ไม่_จำเป็นต้องยึดถือการรับประกันใดๆ ในเรื่องการห้ามย้ายค่า
เช่นเดียวกับ Send และ Sync คอมไพเลอร์จะอิมพลีเมนต์ Unpin ให้โดยอัตโนมัติสำหรับทุกชนิดข้อมูลที่สามารถพิสูจน์ได้ว่าปลอดภัย ส่วนกรณีพิเศษ ซึ่งก็คล้ายกับ Send และ Sync อีกเช่นกัน คือกรณีที่ Unpin _ไม่ได้_ถูกอิมพลีเมนต์สำหรับชนิดข้อมูลนั้น สัญลักษณ์สำหรับกรณีนี้คือ impl !Unpin for SomeType โดยที่ SomeType คือชื่อของชนิดข้อมูลที่_จำเป็น_ต้องยึดถือการรับประกันเหล่านั้นเพื่อให้ปลอดภัยทุกครั้งที่พอยน์เตอร์ไปยังชนิดนั้นถูกนำไปใช้ใน Pin
กล่าวอีกนัยหนึ่ง มีสองสิ่งสำคัญที่ต้องจำเกี่ยวกับความสัมพันธ์ระหว่าง Pin กับ Unpin: ข้อแรก Unpin คือกรณี “ปกติ” และ !Unpin คือกรณีพิเศษ ข้อสอง ชนิดข้อมูลจะอิมพลีเมนต์ Unpin หรือ !Unpin จะ_มีความหมาย_ก็ต่อเมื่อคุณใช้พอยน์เตอร์ที่ถูกตรึงไปยังชนิดข้อมูลนั้น เช่น Pin<&mut
SomeType> เท่านั้น
เพื่อให้เห็นภาพชัดเจนขึ้น ลองนึกถึง String: มันมีความยาวและอักขระ Unicode ที่ประกอบกันขึ้นมา เราสามารถห่อหุ้ม String ไว้ใน Pin ได้ ดังแสดงในรูปที่ 17-8 อย่างไรก็ตาม String จะอิมพลีเมนต์ Unpin โดยอัตโนมัติ เช่นเดียวกับชนิดข้อมูลอื่นๆ ส่วนใหญ่ใน Rust
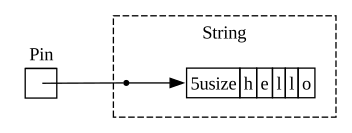
ด้วยเหตุนี้ เราจึงสามารถทำสิ่งที่จะถือว่าผิดกฎได้หาก String อิมพลีเมนต์ !Unpin เช่น การแทนที่สตริงเดิมด้วยสตริงใหม่ ณ ตำแหน่งเดียวกันเป๊ะในหน่วยความจำ ดังในรูปที่ 17-9 การกระทำนี้ไม่ละเมิดข้อตกลงของ Pin เพราะ String ไม่มีเรเฟอเรนซ์ภายในที่ทำให้ไม่ปลอดภัยต่อการย้ายตำแหน่ง นั่นคือเหตุผลที่มันอิมพลีเมนต์ Unpin แทนที่จะเป็น !Unpin
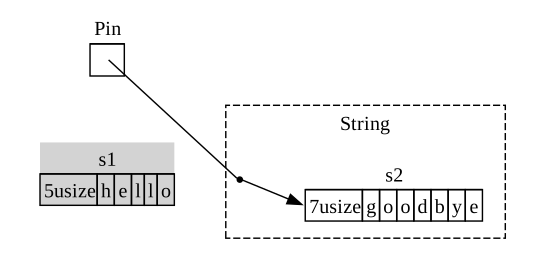
ตอนนี้เรามีความรู้เพียงพอที่จะเข้าใจข้อผิดพลาดที่รายงานจากการเรียก join_all ในลิสติ้ง 17-23 แล้ว เดิมทีเราพยายามย้ายฟิวเจอร์ที่สร้างขึ้นจากบล็อก async เข้าไปใน Vec<Box<dyn Future<Output = ()>>> แต่ดังที่เราได้เห็นไปแล้ว ฟิวเจอร์เหล่านั้นอาจมีเรเฟอเรนซ์ภายใน จึงไม่ได้อิมพลีเมนต์ Unpin โดยอัตโนมัติ แต่เมื่อเราตรึงพวกมันแล้ว เราก็สามารถส่งชนิดข้อมูล Pin ที่ได้เข้าไปยัง Vec ได้อย่างมั่นใจว่าข้อมูลภายในฟิวเจอร์จะ_ไม่_ถูกเคลื่อนย้าย ลิสติ้ง 17-24 แสดงวิธีแก้ไขโค้ดด้วยการเรียกใช้มาโคร pin! ตรงจุดที่ฟิวเจอร์ทั้งสามตัวถูกนิยาม และปรับชนิดข้อมูลของเทรตออบเจกต์ให้สอดคล้องกัน
extern crate trpl; // required for mdbook test
use std::pin::{Pin, pin};
// --snip--
use std::time::Duration;
fn main() {
trpl::block_on(async {
let (tx, mut rx) = trpl::channel();
let tx1 = tx.clone();
let tx1_fut = pin!(async move {
// --snip--
let vals = vec![
String::from("hi"),
String::from("from"),
String::from("the"),
String::from("future"),
];
for val in vals {
tx1.send(val).unwrap();
trpl::sleep(Duration::from_secs(1)).await;
}
});
let rx_fut = pin!(async {
// --snip--
while let Some(value) = rx.recv().await {
println!("received '{value}'");
}
});
let tx_fut = pin!(async move {
// --snip--
let vals = vec![
String::from("more"),
String::from("messages"),
String::from("for"),
String::from("you"),
];
for val in vals {
tx.send(val).unwrap();
trpl::sleep(Duration::from_secs(1)).await;
}
});
let futures: Vec<Pin<&mut dyn Future<Output = ()>>> =
vec![tx1_fut, rx_fut, tx_fut];
trpl::join_all(futures).await;
});
}ตัวอย่างนี้สามารถคอมไพล์และรันได้สำเร็จแล้ว และเราสามารถเพิ่มหรือลบฟิวเจอร์ออกจากเวกเตอร์ตอนรันไทม์แล้ว join พวกมันทั้งหมดได้
Pin และ Unpin ส่วนใหญ่แล้วจะมีความสำคัญสำหรับการสร้างไลบรารีระดับล่าง หรือเมื่อคุณกำลังพัฒนารันไทม์ขึ้นมาเอง มากกว่าการเขียนโค้ด Rust ในชีวิตประจำวันทั่วไป อย่างไรก็ตาม เมื่อคุณพบเห็นเทรตเหล่านี้ในข้อความแสดงข้อผิดพลาด ตอนนี้คุณก็เข้าใจชัดเจนขึ้นแล้วว่าจะแก้ไขโค้ดของคุณได้อย่างไร!
หมายเหตุ: การผสมผสานระหว่าง
PinและUnpinทำให้เราสามารถอิมพลีเมนต์กลุ่มชนิดข้อมูลที่ซับซ้อนได้อย่างปลอดภัยใน Rust ซึ่งหากไม่มีกลไกนี้ก็คงจะเป็นเรื่องยากลำบากอย่างยิ่งเนื่องจากมันอ้างถึงตัวเอง ชนิดข้อมูลที่จำเป็นต้องใช้Pinมักพบได้บ่อยที่สุดใน async Rust ยุคปัจจุบัน แต่ในบางครั้ง คุณก็อาจพบเห็นมันในบริบทอื่นๆ ได้เช่นกันรายละเอียดเฉพาะเจาะจงว่า
PinและUnpinทำงานอย่างไร และกฎเกณฑ์ที่พวกมันต้องปฏิบัติตาม มีการอธิบายไว้อย่างละเอียดในเอกสาร API ของstd::pinดังนั้นหากคุณสนใจที่จะเรียนรู้เพิ่มเติม ที่นั่นจึงเป็นจุดเริ่มต้นที่ยอดเยี่ยมหากคุณต้องการทำความเข้าใจกลไกการทำงานเบื้องลึกในรายละเอียดมากยิ่งขึ้น สามารถอ่านเพิ่มเติมได้ที่บทที่ 2 และ 4 ของหนังสือ Asynchronous Programming in Rust
เทรต Stream
เมื่อคุณมีความเข้าใจเกี่ยวกับเทรต Future, Pin และ Unpin ลึกซึ้งยิ่งขึ้นแล้ว เราก็สามารถหันมาให้ความสนใจกับเทรต Stream ได้ ดังที่คุณได้เรียนรู้ไปแล้วในตอนต้นของบทนี้ สตรีมนั้นคล้ายกับอิเทอเรเตอร์แบบอะซิงโครนัส อย่างไรก็ตาม ต่างจาก Iterator และ Future ตรงที่ ณ ช่วงเวลาที่เขียนหนังสือเล่มนี้ Stream ยังไม่มีนิยามอย่างเป็นทางการในไลบรารีมาตรฐาน แต่_มี_นิยามที่นิยมใช้กันอย่างแพร่หลายจากเครต futures ซึ่งใช้งานกันทั่วทั้งระบบนิเวศ
เรามาทบทวนคำนิยามของเทรต Iterator และ Future กันก่อนที่จะดูว่าเทรต Stream รวมทั้งสองเข้าด้วยกันอย่างไร จาก Iterator เรามีแนวคิดเรื่องลำดับข้อมูล: เมธอด next ของมันจะให้ Option<Self::Item> จาก Future เรามีแนวคิดเรื่องความพร้อมของข้อมูลตามลำดับเวลา: เมธอด poll ของมันจะให้ Poll<Self::Output> และเพื่อแทนลำดับของข้อมูลที่ทยอยพร้อมใช้งานตามลำดับเวลา เราจึงนิยามเทรต Stream ที่รวมคุณสมบัติเหล่านั้นเข้าด้วยกันดังนี้:
#![allow(unused)]
fn main() {
use std::pin::Pin;
use std::task::{Context, Poll};
trait Stream {
type Item;
fn poll_next(
self: Pin<&mut Self>,
cx: &mut Context<'_>
) -> Poll<Option<Self::Item>>;
}
}เทรต Stream นิยามชนิดข้อมูลสัมพันธ์ชื่อ Item สำหรับระบุชนิดข้อมูลของไอเท็มที่สตรีมสร้างขึ้น ซึ่งคล้ายกับ Iterator ที่อาจมีข้อมูลตั้งแต่ศูนย์ไปจนถึงหลายตัว และต่างจาก Future ที่จะมี Output เพียงค่าเดียวเสมอ แม้ว่าจะเป็นยูนิตไทป์ () ก็ตาม
Stream ยังนิยามเมธอดสำหรับดึงข้อมูลเหล่านั้นด้วย เราตั้งชื่อมันว่า poll_next เพื่อให้ชัดเจนว่ามันทำหน้าที่โพลล์ในลักษณะเดียวกับ Future::poll และให้ลำดับของข้อมูลออกมาในลักษณะเดียวกับ Iterator::next ชนิดข้อมูลที่มันคืนค่ากลับมาจะรวม Poll เข้ากับ Option โดยชนิดชั้นนอกคือ Poll เพราะต้องมีการตรวจสอบความพร้อมเช่นเดียวกับฟิวเจอร์ ส่วนชนิดชั้นในคือ Option เพราะต้องส่งสัญญาณบอกว่ายังมีข้อมูลอีกหรือไม่เช่นเดียวกับอิเทอเรเตอร์
นิยามที่มีลักษณะใกล้เคียงกับสิ่งนี้น่าจะได้กลายมาเป็นส่วนหนึ่งของไลบรารีมาตรฐานของ Rust ในที่สุด ในระหว่างนี้ มันเป็นส่วนหนึ่งของชุดเครื่องมือในรันไทม์ส่วนใหญ่ ดังนั้นคุณจึงสามารถพึ่งพาและใช้งานมันได้ และทุกสิ่งที่เราจะพูดถึงต่อไปนี้ก็สามารถนำไปประยุกต์ใช้ได้ทั่วไป!
อย่างไรก็ตาม ในตัวอย่างที่เราเห็นในหัวข้อ“สตรีม: ฟิวเจอร์ที่เรียงต่อกันเป็นลำดับ” เราไม่ได้ใช้ poll_next หรือ Stream แต่เราใช้ next และ StreamExt แทน แน่นอนว่าเรา_สามารถ_ทำงานกับ API poll_next โดยตรงได้ด้วยการเขียนสเตตแมชชีนของ Stream ขึ้นมาด้วยตนเอง เช่นเดียวกับที่เรา_สามารถ_ทำงานกับฟิวเจอร์โดยตรงผ่านเมธอด poll ได้ แต่การใช้ await นั้นสะดวกและสวยงามกว่ามาก และเทรต StreamExt ก็เตรียมเมธอด next ไว้เพื่อให้เราใช้งานเช่นนั้นได้เลย:
#![allow(unused)]
fn main() {
use std::pin::Pin;
use std::task::{Context, Poll};
trait Stream {
type Item;
fn poll_next(
self: Pin<&mut Self>,
cx: &mut Context<'_>,
) -> Poll<Option<Self::Item>>;
}
trait StreamExt: Stream {
async fn next(&mut self) -> Option<Self::Item>
where
Self: Unpin;
// other methods...
}
}หมายเหตุ: คำนิยามจริงที่เราใช้ตอนต้นบทนั้นดูแตกต่างจากนี้นิดหน่อย เพราะมันรองรับ เวอร์ชันของ Rust ที่ยังไม่รองรับการใช้ฟังก์ชัน async ในเทรต ด้วยเหตุนี้ มันจึง มีหน้าตาแบบนี้:
fn next(&mut self) -> Next<'_, Self> where Self: Unpin;ชนิด
Nextนั้นเป็นstructที่อิมพลีเมนต์Futureและช่วยให้เราระบุชื่อ ไลฟ์ไทม์ (lifetime) ของเรเฟอเรนซ์ไปยังselfได้ด้วยNext<'_, Self>เพื่อให้awaitทำงานกับเมธอดนี้ได้
เทรต StreamExt ยังเป็นแหล่งรวมเมธอดที่น่าสนใจทั้งหมดสำหรับการใช้งานกับสตรีม โดย StreamExt จะถูกอิมพลีเมนต์โดยอัตโนมัติสำหรับทุกชนิดข้อมูลที่อิมพลีเมนต์ Stream แต่เทรตเหล่านี้ถูกนิยามแยกออกจากกันเพื่อให้ชุมชนสามารถพัฒนาต่อยอด API อำนวยความสะดวกต่างๆ ได้อย่างต่อเนื่องโดยไม่กระทบต่อเทรตพื้นฐาน
ในเวอร์ชันของ StreamExt ที่ใช้ในเครต trpl ตัวเทรตไม่ได้เพียงแค่นิยามเมธอด next เท่านั้น แต่ยังเตรียมการอิมพลีเมนต์เริ่มต้นของ next ที่จัดการรายละเอียดในการเรียก Stream::poll_next ให้อย่างถูกต้องอีกด้วย ซึ่งหมายความว่า แม้ว่าคุณจะต้องเขียนชนิดข้อมูลสตรีมของคุณขึ้นมาเอง คุณก็_เพียงแค่_อิมพลีเมนต์ Stream เท่านั้น จากนั้นใครก็ตามที่นำชนิดข้อมูลของคุณไปใช้ก็จะสามารถใช้งาน StreamExt และเมธอดต่างๆ ของมันได้โดยอัตโนมัติทันที
นั่นคือทั้งหมดที่เราจะครอบคลุมสำหรับรายละเอียดระดับล่างของเทรตเหล่านี้ เพื่อเป็นการส่งท้าย เรามาดูกันว่าฟิวเจอร์ (รวมถึงสตรีม), ทาสก์ (task) และเธรด (thread) ทั้งหมดประกอบเข้าด้วยกันอย่างไร!
ฟิวเจอร์ ทาสก์ และเธรด
ประกอบทุกอย่างเข้าด้วยกัน: ฟิวเจอร์ ทาสก์ และเธรด
ดังที่เราได้เห็นในบทที่ 16 เธรด (thread) เป็นแนวทางหนึ่งสำหรับการทำงานพร้อมกัน (concurrency) และเราก็ได้เห็นอีกแนวทางหนึ่งในบทนี้: นั่นคือการใช้ async ร่วมกับฟิวเจอร์ (future) และสตรีม (stream) หากคุณกำลังสงสัยว่าเมื่อใดควรเลือกวิธีหนึ่งแทนอีกวิธี คำตอบคือ: ขึ้นอยู่กับสถานการณ์! และในหลายๆ กรณี ทางเลือกไม่ได้เป็นเรื่องของเธรด_หรือ_ async แต่เป็นเรื่องของการใช้เธรด_และ_ async ร่วมกันต่างหาก
ระบบปฏิบัติการหลายตัวมีโมเดลการทำงานพร้อมกันแบบใช้เธรดมานานหลายทศวรรษแล้ว และด้วยเหตุนี้ภาษาโปรแกรมจำนวนมากจึงรองรับโมเดลเหล่านี้ อย่างไรก็ตาม โมเดลเหล่านี้ก็มีข้อแลกเปลี่ยน (trade-offs) อยู่เช่นกัน บนระบบปฏิบัติการหลายตัว เธรดแต่ละตัวใช้หน่วยความจำค่อนข้างมาก นอกจากนี้ เธรดยังเป็นทางเลือกได้เฉพาะเมื่อระบบปฏิบัติการและฮาร์ดแวร์ของคุณรองรับเท่านั้น ซึ่งต่างจากคอมพิวเตอร์เดสก์ท็อปและสมาร์ตโฟนทั่วไป เพราะระบบสมองกลฝังตัว (embedded system) บางระบบไม่มีระบบปฏิบัติการเลย ดังนั้นพวกมันจึงไม่มีเธรดให้ใช้งานด้วยเช่นกัน
โมเดลของ async นำเสนอข้อแลกเปลี่ยนที่แตกต่างออกไป—และส่งเสริมซึ่งกันและกันในที่สุด ในโมเดล async การทำงานพร้อมกันไม่จำเป็นต้องมีเธรดของตัวเองเป็นเอกเทศ แต่สามารถรันบนทาสก์ (task) ได้ เช่นเดียวกับตอนที่เราใช้ trpl::spawn_task เพื่อเริ่มการทำงานจากฟังก์ชันแบบซิงโครนัสในหัวข้อสตรีม ทาสก์นั้นคล้ายกับเธรด แต่แทนที่จะถูกจัดการโดยระบบปฏิบัติการ มันจะถูกจัดการโดยโค้ดในระดับไลบรารี นั่นคือรันไทม์ (runtime)
มีเหตุผลว่าทำไม API สำหรับการสร้างเธรดและการสร้างทาสก์จึงคล้ายคลึงกันมาก เธรดทำหน้าที่เป็นขอบเขตสำหรับชุดการทำงานแบบซิงโครนัส การทำงานพร้อมกันจะเกิดขึ้นได้_ระหว่าง_เธรด ส่วนทาสก์ทำหน้าที่เป็นขอบเขตสำหรับชุดการทำงานแบบ_อะซิงโครนัส_ (asynchronous) ซึ่งการทำงานพร้อมกันจะเกิดขึ้นได้ทั้ง_ระหว่าง_ทาสก์และ_ภายใน_ทาสก์เดียวกัน เพราะทาสก์สามารถสลับการทำงานระหว่างฟิวเจอร์ต่างๆ ภายในตัวมันได้ สุดท้ายนี้ ฟิวเจอร์คือหน่วยการทำงานพร้อมกันที่ย่อยที่สุดใน Rust และฟิวเจอร์แต่ละตัวอาจเป็นตัวแทนของต้นไม้โครงสร้างของฟิวเจอร์อื่นๆ ได้ รันไทม์—โดยเฉพาะเอ็กซีคิวเตอร์ (executor) ของมัน—จะเป็นตัวจัดการทาสก์ และทาสก์ก็จะเป็นตัวจัดการฟิวเจอร์ ในแง่นั้น ทาสก์จึงเปรียบเสมือนเธรดน้ำหนักเบา (lightweight thread) ที่ถูกจัดการโดยรันไทม์ พร้อมด้วยความสามารถเพิ่มเติมที่ได้จากการถูกจัดการโดยรันไทม์แทนที่จะเป็นระบบปฏิบัติการ
นี่ไม่ได้หมายความว่าทาสก์แบบ async จะดีกว่าเธรดเสมอไป (หรือในทางกลับกัน) การทำงานพร้อมกันด้วยเธรดในบางแง่มุมเป็นโมเดลการเขียนโปรแกรมที่เรียบง่ายกว่าการทำงานพร้อมกันด้วย async ซึ่งนั่นอาจเป็นได้ทั้งจุดแข็งหรือจุดอ่อน เธรดมีลักษณะแบบ “สั่งแล้วลืม” (fire and forget) อยู่บ้าง เพราะพวกมันไม่มีแนวคิดที่เทียบเท่ากับฟิวเจอร์โดยตรง ดังนั้นพวกมันจึงรันจนเสร็จสมบูรณ์ไปเลยโดยไม่ถูกขัดจังหวะ ยกเว้นโดยตัวระบบปฏิบัติการเอง
และปรากฏว่าเธรดกับทาสก์มักจะทำงานร่วมกันได้เป็นอย่างดี เพราะทาสก์สามารถ (อย่างน้อยก็ในบางรันไทม์) ถูกย้ายข้ามไปมาระหว่างเธรดได้ ที่จริงแล้ว เบื้องหลังรันไทม์ที่เราใช้งานอยู่—รวมถึงฟังก์ชัน spawn_blocking และ spawn_task—ทำงานแบบหลายเธรด (multithreaded) โดยค่าเริ่มต้น! รันไทม์จำนวนมากใช้วิธีการที่เรียกว่า การขโมยงาน (work stealing) เพื่อย้ายทาสก์ไปมาระหว่างเธรดได้อย่างโปร่งใส โดยประเมินจากการใช้งานเธรดในขณะนั้น เพื่อเพิ่มประสิทธิภาพโดยรวมของระบบ แนวทางดังกล่าวจำเป็นต้องใช้ทั้งเธรด_และ_ทาสก์ ซึ่งก็ย่อมต้องมีฟิวเจอร์ด้วย
เมื่อต้องพิจารณาว่าจะเลือกใช้วิธีใดในสถานการณ์ใด ลองพิจารณากฎเกณฑ์คร่าวๆ (rule of thumb) เหล่านี้:
- หากงานนั้น_สามารถแบ่งทำแบบขนานได้ดีมาก_ (เน้นใช้ CPU หรือ CPU-bound) เช่น การประมวลผลชุดข้อมูลขนาดใหญ่ที่แต่ละส่วนสามารถประมวลผลแยกจากกันได้อย่างอิสระ การใช้เธรดจะเป็นทางเลือกที่ดีกว่า
- หากงานนั้น_เน้นการทำงานพร้อมกันสูง_ (เน้น I/O หรือ I/O-bound) เช่น การจัดการข้อความจากแหล่งต่างๆ มากมายที่อาจทยอยเข้ามาในช่วงเวลาหรืออัตราความเร็วที่ไม่แน่นอน async จะเป็นทางเลือกที่ดีกว่า
และหากคุณต้องการทั้งการทำงานแบบขนาน (parallelism) และการทำงานพร้อมกัน (concurrency) คุณก็ไม่จำเป็นต้องเลือกอย่างใดอย่างหนึ่งระหว่างเธรดกับ async เลย คุณสามารถนำทั้งสองมาใช้ร่วมกันได้อย่างอิสระ โดยปล่อยให้แต่ละอย่างทำหน้าที่ในส่วนที่มันถนัดที่สุด ตัวอย่างเช่น ลิสติ้ง 17-25 แสดงตัวอย่างที่พบได้บ่อยของการผสมผสานทั้งสองรูปแบบนี้เข้าด้วยกันในโค้ด Rust สำหรับใช้งานจริง
extern crate trpl; // for mdbook test
use std::{thread, time::Duration};
fn main() {
let (tx, mut rx) = trpl::channel();
thread::spawn(move || {
for i in 1..11 {
tx.send(i).unwrap();
thread::sleep(Duration::from_secs(1));
}
});
trpl::block_on(async {
while let Some(message) = rx.recv().await {
println!("{message}");
}
});
}เราเริ่มต้นด้วยการสร้างแชนเนลแบบ async จากนั้นสร้างเธรดที่รับความเป็นเจ้าของ (ownership) ของฝั่งผู้ส่งในแชนเนลโดยใช้คีย์เวิร์ด move ภายในเธรด เราส่งตัวเลข 1 ถึง 10 โดยมีการนอนหลับหนึ่งวินาทีคั่นระหว่างแต่ละตัวเลข สุดท้าย เราสั่งรันฟิวเจอร์ที่สร้างขึ้นด้วยบล็อก async ที่ส่งให้กับ trpl::block_on เช่นเดียวกับที่เราทำมาตลอดทั้งบท ในฟิวเจอร์นั้น เรา await ข้อความเหล่านั้น เช่นเดียวกับในตัวอย่างการส่งผ่านข้อความอื่นๆ ที่เราได้เห็นมา
เพื่อย้อนกลับไปยังสถานการณ์ที่เราเปิดประเด็นไว้ในตอนต้นบท ลองจินตนาการถึงการรันชุดทาสก์การเข้ารหัสวิดีโอ (video encoding) โดยใช้เธรดเฉพาะสำหรับการประมวลผล (เนื่องจากการเข้ารหัสวิดีโอเป็นงานที่เน้นใช้พลังการประมวลผลสูง) แต่แจ้งเตือนไปยัง UI ว่าการทำงานเหล่านั้นเสร็จสิ้นแล้วผ่านทางแชนเนลแบบ async มีตัวอย่างการผสมผสานเช่นนี้ในกรณีการใช้งานจริงนับไม่ถ้วน
สรุป
นี่ไม่ใช่ครั้งสุดท้ายที่คุณจะได้เห็นเรื่องการทำงานพร้อมกันในหนังสือเล่มนี้ โปรเจกต์ในบทที่ 21 จะนำแนวคิดเหล่านี้ไปประยุกต์ใช้ในสถานการณ์ที่สมจริงยิ่งขึ้นกว่าตัวอย่างง่ายๆ ที่เราพูดคุยกันในบทนี้ และจะเปรียบเทียบการแก้ปัญหาด้วยการใช้เธรดกับการใช้ทาสก์และฟิวเจอร์ให้เห็นภาพชัดเจนยิ่งขึ้น
ไม่ว่าคุณจะเลือกแนวทางใดในเหล่านี้ Rust ก็มอบเครื่องมือที่คุณต้องการเพื่อเขียนโค้ดที่ปลอดภัย รวดเร็ว และทำงานพร้อมกันได้อย่างมั่นใจ—ไม่ว่าจะสำหรับเว็บเซิร์ฟเวอร์ที่ต้องรองรับปริมาณงานสูง (high-throughput) หรือสำหรับระบบปฏิบัติการบนสมองกลฝังตัวก็ตาม
ในบทถัดไป เราจะพูดถึงแนวทางตามธรรมเนียมปฏิบัติ (idiomatic) ในการจำลองโมเดลปัญหาและจัดโครงสร้างของทางแก้ปัญหาเมื่อโปรแกรม Rust ของคุณมีขนาดใหญ่ขึ้น นอกจากนี้ เราจะร่วมพูดคุยกันว่าแนวคิดของ Rust เชื่อมโยงอย่างไรกับสิ่งที่คุณอาจคุ้นเคยจากการเขียนโปรแกรมเชิงวัตถุ (object-oriented programming)
ฟีเจอร์การเขียนโปรแกรมเชิงวัตถุ
การเขียนโปรแกรมเชิงวัตถุ (object-oriented programming หรือ OOP) เป็นกระบวนทัศน์หนึ่งในการจำลองและสร้างแบบจำลองของโปรแกรม แนวคิดเรื่องออบเจกต์ (object) ในการเขียนโปรแกรมถูกนำมาใช้ครั้งแรกในภาษา Simula ในช่วงทศวรรษ 1960 แนวคิดออบเจกต์เหล่านั้นมีอิทธิพลต่อสถาปัตยกรรมการเขียนโปรแกรมของ Alan Kay ซึ่งออบเจกต์จะส่งข้อความถึงกันและกัน และเพื่ออธิบายสถาปัตยกรรมนี้ เขาจึงได้บัญญัติคำว่า การเขียนโปรแกรมเชิงวัตถุ ขึ้นในปี 1967 มีคำนิยามที่หลากหลายและแตกต่างกันไปว่า OOP คืออะไร ซึ่งหากมองตามคำนิยามบางข้อ Rust ก็ถือเป็นภาษาเชิงวัตถุ แต่หากมองตามคำนิยามอื่นๆ ก็อาจจะไม่ใช่ ในบทนี้ เราจะสำรวจคุณลักษณะบางประการที่มักถูกพิจารณาว่าเป็นเชิงวัตถุ และดูว่าคุณลักษณะเหล่านั้นถ่ายทอดมาเป็นแนวทางตามธรรมเนียมปฏิบัติ (idiomatic) ของ Rust อย่างไร จากนั้นเราจะแสดงวิธีอิมพลีเมนต์แพตเทิร์นการออกแบบเชิงวัตถุใน Rust พร้อมทั้งร่วมพูดคุยถึงข้อแลกเปลี่ยน (trade-offs) ของการเลือกใช้วิธีดังกล่าว เทียบกับการแก้ปัญหาโดยใช้จุดแข็งเฉพาะตัวของ Rust แทน
ลักษณะเด่นของภาษาเชิงวัตถุ
ลักษณะเด่นของภาษาเชิงวัตถุ
ในแวดวงการเขียนโปรแกรมไม่มีความเห็นพ้องกันว่าภาษาหนึ่ง ๆ ต้องมีฟีเจอร์อะไรบ้างจึงจะถือว่าเป็นภาษาเชิงวัตถุ Rust ได้รับอิทธิพลจากกระบวนทัศน์การเขียนโปรแกรมหลายแบบ รวมถึงการเขียนโปรแกรมเชิงวัตถุ (OOP) ตัวอย่างเช่น เราได้สำรวจฟีเจอร์ที่มาจากการเขียนโปรแกรมเชิงฟังก์ชัน (functional programming) ในบทที่ 13 เราอาจกล่าวได้ว่าภาษา OOP นั้นมีคุณลักษณะร่วมบางประการ ได้แก่ ออบเจกต์ (object), การห่อหุ้ม (encapsulation) และการสืบทอด (inheritance) ลองมาดูกันว่าคุณลักษณะแต่ละอย่างหมายถึงอะไร และ Rust รองรับสิ่งเหล่านั้นหรือไม่
ออบเจกต์บรรจุข้อมูลและพฤติกรรม
หนังสือ Design Patterns: Elements of Reusable Object-Oriented Software โดย Erich Gamma, Richard Helm, Ralph Johnson และ John Vlissides (Addison-Wesley, 1994) ซึ่งมักเรียกกันทั่วไปว่าหนังสือ The Gang of Four ถือเป็นแคตตาล็อกรวบรวมแบบแผนการออกแบบเชิงวัตถุ (design patterns) หนังสือเล่มนี้นิยาม OOP ไว้ดังนี้:
โปรแกรมเชิงวัตถุนั้นประกอบขึ้นจากออบเจกต์ โดย ออบเจกต์ จะรวมทั้งข้อมูลและกระบวนการทำงานที่กระทำกับข้อมูลนั้นไว้ด้วยกัน กระบวนการเหล่านี้มักถูกเรียกว่า เมธอด (method) หรือ การดำเนินการ (operation)
หากใช้คำนิยามนี้ Rust ก็ถือเป็นภาษาเชิงวัตถุได้: ทั้ง struct และ enum ต่างมีข้อมูล และบล็อก impl ก็จัดเตรียมเมธอดให้แก่ struct และ enum เหล่านั้น แม้ว่า struct และ enum ที่มีเมธอดจะไม่ได้ถูก_เรียกว่า_ออบเจกต์ตรง ๆ แต่ก็มีฟังก์ชันการทำงานแบบเดียวกันตามคำนิยามออบเจกต์ของ Gang of Four
การห่อหุ้มที่ซ่อนรายละเอียดการอิมพลีเมนต์
อีกแง่มุมหนึ่งที่มักเชื่อมโยงกับ OOP คือแนวคิดเรื่อง_การห่อหุ้ม_ (encapsulation) ซึ่งหมายความว่าโค้ดภายนอกที่เรียกใช้ออบเจกต์จะไม่สามารถเข้าถึงรายละเอียดการอิมพลีเมนต์ภายในออบเจกต์นั้นได้ ดังนั้น วิธีเดียวในการมีปฏิสัมพันธ์กับออบเจกต์คือผ่านทาง public API ของมัน โค้ดที่ใช้ออบเจกต์จึงไม่สามารถล้วงเข้าไปแก้ไขข้อมูลหรือพฤติกรรมภายในของออบเจกต์ได้โดยตรง สิ่งนี้ช่วยให้โปรแกรมเมอร์สามารถปรับเปลี่ยนและรีแฟกเตอร์กลไกภายในของออบเจกต์ได้ โดยไม่จำเป็นต้องแก้ไขโค้ดส่วนอื่นที่เรียกใช้ออบเจกต์นั้น
เราได้พูดถึงวิธีควบคุมการห่อหุ้มไปแล้วในบทที่ 7: เราใช้คีย์เวิร์ด pub ในการกำหนดว่ามอดูล ชนิดข้อมูล ฟังก์ชัน และเมธอดใดในโค้ดควรเปิดเป็นสาธารณะ (public) และโดยดีฟอลต์สิ่งอื่น ๆ ทั้งหมดจะเป็นแบบส่วนตัว (private) ตัวอย่างเช่น เราสามารถนิยาม struct AveragedCollection ที่มีฟิลด์เก็บเวกเตอร์ของค่า i32 และยังมีอีกฟิลด์หนึ่งที่เก็บค่าเฉลี่ยของข้อมูลในเวกเตอร์นั้น ซึ่งหมายความว่าเราไม่จำเป็นต้องคำนวณค่าเฉลี่ยใหม่ทุกครั้งที่ต้องการใช้งาน กล่าวอีกนัยหนึ่งคือ AveragedCollection จะแคชค่าเฉลี่ยที่คำนวณไว้แล้วให้เรา ลิสติ้ง 18-1 แสดงนิยามของ struct AveragedCollection
pub struct AveragedCollection {
list: Vec<i32>,
average: f64,
}struct นี้ถูกระบุเป็น pub เพื่อให้โค้ดส่วนอื่นสามารถเรียกใช้ได้ แต่ฟิลด์ภายใน struct ยังคงเป็นแบบไพรเวต (private) ซึ่งมีความสำคัญในกรณีนี้ เพราะเราต้องการให้แน่ใจว่า เมื่อใดก็ตามที่มีการเพิ่มหรือลบค่าออกจากรายการ ค่าเฉลี่ยจะได้รับการอัปเดตตามไปด้วยเสมอ เราทำเช่นนี้ได้ด้วยการอิมพลีเมนต์เมธอด add, remove และ average ให้กับ struct ดังแสดงในลิสติ้ง 18-2
pub struct AveragedCollection {
list: Vec<i32>,
average: f64,
}
impl AveragedCollection {
pub fn add(&mut self, value: i32) {
self.list.push(value);
self.update_average();
}
pub fn remove(&mut self) -> Option<i32> {
let result = self.list.pop();
match result {
Some(value) => {
self.update_average();
Some(value)
}
None => None,
}
}
pub fn average(&self) -> f64 {
self.average
}
fn update_average(&mut self) {
let total: i32 = self.list.iter().sum();
self.average = total as f64 / self.list.len() as f64;
}
}พับลิกเมธอดอย่าง add, remove และ average เป็นหนทางเดียวในการเข้าถึงหรือแก้ไขข้อมูลในอินสแตนซ์ของ AveragedCollection เมื่อมีการเพิ่มสมาชิกเข้าไปใน list ผ่านเมธอด add หรือลบออกด้วยเมธอด remove โค้ดของแต่ละเมธอดจะเรียกใช้เมธอดไพรเวต update_average ซึ่งคอยจัดการอัปเดตฟิลด์ average ให้เสมอ
เราปล่อยให้ฟิลด์ list และ average เป็นไพรเวต เพื่อไม่ให้โค้ดภายนอกสามารถเพิ่มหรือลบสมาชิกในฟิลด์ list ได้โดยตรง มิฉะนั้น ฟิลด์ average อาจไม่สอดคล้องกับความเป็นจริงเมื่อ list เกิดการเปลี่ยนแปลง เมธอด average จะคืนค่าในฟิลด์ average ออกไป ทำให้โค้ดภายนอกอ่านค่า average ได้แต่ไม่สามารถแก้ไขได้
เนื่องจากเราได้ห่อหุ้มรายละเอียดการอิมพลีเมนต์ของ struct AveragedCollection ไว้แล้ว ในอนาคตเราจึงปรับเปลี่ยนโครงสร้างภายใน เช่น โครงสร้างข้อมูล ได้อย่างง่ายดาย ตัวอย่างเช่น เราสามารถเปลี่ยนไปใช้ HashSet<i32> แทน Vec<i32> สำหรับฟิลด์ list ได้ โดยตราบใดที่ลายเซ็น (signature) ของพับลิกเมธอด add, remove และ average ยังคงเดิม โค้ดภายนอกที่เรียกใช้ AveragedCollection ก็ไม่จำเป็นต้องแก้ไขอะไรเลย แต่ถ้าหากเราเปิด list ให้เป็นพับลิก ผลลัพธ์อาจไม่เป็นเช่นนั้น เพราะ HashSet<i32> และ Vec<i32> มีเมธอดในการเพิ่มและลบสมาชิกที่แตกต่างกัน โค้ดภายนอกจึงอาจต้องแก้ตามหากมีการเข้าถึงและดัดแปลง list โดยตรง
หากการห่อหุ้มเป็นคุณสมบัติจำเป็นที่ทำให้ภาษาหนึ่งถือเป็นภาษาเชิงวัตถุได้ Rust ก็ตอบโจทย์ข้อกำหนดนั้นอย่างแน่นอน การเลือกระบุหรือไม่ระบุ pub ให้กับส่วนต่าง ๆ ของโค้ด ช่วยให้เราสามารถห่อหุ้มรายละเอียดการอิมพลีเมนต์ได้อย่างสมบูรณ์
การสืบทอดในฐานะระบบชนิดข้อมูลและในฐานะการแบ่งปันโค้ด
การสืบทอด (inheritance) เป็นกลไกที่ออบเจกต์หนึ่งสามารถสืบทอดองค์ประกอบจากนิยามของอีกออบเจกต์หนึ่งได้ ทำให้ได้รับข้อมูลและพฤติกรรมของออบเจกต์แม่มาโดยที่คุณไม่ต้องนิยามซ้ำอีกรอบ
หากภาษานั้นจำเป็นต้องมีการสืบทอดจึงจะนับเป็นภาษาเชิงวัตถุได้ Rust ก็ไม่ใช่ภาษานั้น เพราะไม่มีวิธีใดที่จะนิยาม struct ให้สืบทอดฟิลด์และการอิมพลีเมนต์เมธอดจาก struct แม่ได้โดยไม่พึ่งพามาโคร
อย่างไรก็ดี หากคุณคุ้นเคยกับการใช้การสืบทอดในการเขียนโปรแกรม คุณก็สามารถเลือกใช้วิธีแก้ปัญหาแบบอื่นใน Rust ได้ ขึ้นอยู่กับเหตุผลที่คุณเลือกหยิบการสืบทอดมาใช้ตั้งแต่แรก
ปกติแล้วคุณจะเลือกใช้การสืบทอดด้วยเหตุผลหลักสองประการ เหตุผลแรกคือการนำโค้ดกลับมาใช้ใหม่ (code reuse): คุณสามารถอิมพลีเมนต์พฤติกรรมบางอย่างให้กับชนิดข้อมูลหนึ่ง แล้วใช้การสืบทอดเพื่อนำการอิมพลีเมนต์นั้นไปใช้ซ้ำกับชนิดข้อมูลอื่นได้ คุณสามารถทำสิ่งนี้ในโค้ด Rust ได้ในขอบเขตหนึ่ง โดยใช้การอิมพลีเมนต์เมธอดแบบดีฟอลต์ของเทรต ดังที่คุณได้เห็นในลิสติ้ง 10-14 เมื่อเราเพิ่มการอิมพลีเมนต์ดีฟอลต์ของเมธอด summarize ไว้ในเทรต Summary ชนิดข้อมูลใดก็ตามที่อิมพลีเมนต์เทรต Summary ก็จะมีเมธอด summarize ให้ใช้งานได้ทันทีโดยไม่ต้องเขียนโค้ดเพิ่ม ซึ่งคล้ายกับคลาสแม่ที่มีการอิมพลีเมนต์เมธอดไว้ และคลาสลูกที่สืบทอดไปก็จะได้การอิมพลีเมนต์เมธอดนั้นไปด้วย นอกจากนี้เรายังสามารถเขียนทับ (override) การอิมพลีเมนต์ดีฟอลต์ของเมธอด summarize เมื่อเราอิมพลีเมนต์เทรต Summary ได้เช่นกัน ซึ่งเทียบได้กับคลาสลูกที่ override เมธอดที่สืบทอดมาจากคลาสแม่
อีกเหตุผลหนึ่งในการใช้การสืบทอดเกี่ยวข้องกับระบบชนิดข้อมูล: นั่นคือเพื่อให้ชนิดข้อมูลลูกสามารถนำไปใช้ในตำแหน่งเดียวกับชนิดข้อมูลแม่ได้ สิ่งนี้เรียกว่า_พอลิมอร์ฟิซึม_ (polymorphism) ซึ่งหมายถึงการที่คุณสามารถใช้ออบเจกต์หลายตัวแทนที่กันได้ ณ ตอนรันไทม์หากพวกมันมีลักษณะเฉพาะบางอย่างร่วมกัน
พอลิมอร์ฟิซึม
สำหรับหลาย ๆ คน พอลิมอร์ฟิซึมมักถูกมองว่ามีความหมายเหมือนกับการสืบทอด แต่ความจริงแล้วมันเป็นแนวคิดที่กว้างกว่านั้น โดยหมายถึงโค้ดที่สามารถทำงานร่วมกับข้อมูลได้หลากหลายชนิด สำหรับการสืบทอด ชนิดข้อมูลเหล่านั้นมักจะเป็นคลาสย่อย (subclass)
ในทางกลับกัน Rust เลือกใช้เจเนอริก (generics) เพื่อสร้างนามธรรมครอบคลุมชนิดข้อมูลที่เป็นไปได้ต่าง ๆ และใช้ข้อกำหนดเทรต (trait bounds) ในการจำกัดว่าชนิดข้อมูลเหล่านั้นต้องมีความสามารถหรือพฤติกรรมอะไรบ้าง ซึ่งบางครั้งเรียกว่า_พอลิมอร์ฟิซึมแบบพาราเมตริกที่มีขอบเขต_ (bounded parametric polymorphism)
Rust เลือกข้อแลกเปลี่ยนที่แตกต่างออกไปโดยไม่เปิดให้มีการสืบทอด เนื่องจากการสืบทอดมักมีความเสี่ยงที่จะแชร์โค้ดมากเกินความจำเป็น โดยคลาสลูกไม่จำเป็นต้องมีคุณลักษณะทั้งหมดของคลาสแม่เสมอไป แต่การสืบทอดจะบังคับให้ต้องรับมาทั้งหมด สิ่งนี้ทำให้การออกแบบโปรแกรมมีความยืดหยุ่นน้อยลง ทั้งยังเพิ่มความเสี่ยงที่จะเกิดการเรียกใช้เมธอดบนคลาสลูกซึ่งไม่สมเหตุสมผลหรือไม่เข้ากับบริบท จนนำไปสู่ข้อผิดพลาดได้ นอกจากนี้ บางภาษายังอนุญาตให้มีเฉพาะ_การสืบทอดเชิงเดี่ยว_ (single inheritance) เท่านั้น (หมายความว่าคลาสลูกสามารถสืบทอดได้จากคลาสเดียวเท่านั้น) ซึ่งยิ่งจำกัดความยืดหยุ่นในการออกแบบโปรแกรมลงไปอีก
ด้วยเหตุผลเหล่านี้ Rust จึงเลือกใช้แนวทางที่แตกต่าง โดยนำเทรตออบเจกต์ (trait object) มาใช้แทนการสืบทอดเพื่อสร้างพอลิมอร์ฟิซึม ณ ตอนรันไทม์ ลองมาดูกันว่าเทรตออบเจกต์ทำงานอย่างไร
ใช้เทรตออบเจกต์เพื่อนามธรรมพฤติกรรมร่วม
การใช้เทรตออบเจกต์เพื่อนามธรรมพฤติกรรมร่วม
ในบทที่ 8 เราได้พูดถึงข้อจำกัดประการหนึ่งของเวกเตอร์ นั่นคือสามารถเก็บสมาชิกได้เพียงชนิดเดียวเท่านั้น ซึ่งเราได้ทำวิธีแก้ไขชั่วคราวไว้ในลิสติ้ง 8-9 โดยการนิยาม enum SpreadsheetCell ที่มีวาเรียนต์สำหรับเก็บจำนวนเต็ม จำนวนทศนิยม และข้อความ ซึ่งช่วยให้เราสามารถเก็บข้อมูลต่างชนิดกันในแต่ละเซลล์ และยังคงใช้เวกเตอร์เป็นตัวแทนของแถวเซลล์ได้ นี่เป็นทางออกที่ยอดเยี่ยมเมื่อสมาชิกที่สับเปลี่ยนกันได้ของเราเป็นชุดชนิดข้อมูลที่คงที่และทราบล่วงหน้าอยู่แล้วในตอนที่โค้ดถูกคอมไพล์
อย่างไรก็ตาม บางครั้งเราต้องการให้ผู้ใช้ไลบรารีสามารถต่อขยายชุดของชนิดข้อมูลที่นำมาใช้ในสถานการณ์นั้น ๆ ได้ เพื่อแสดงให้เห็นว่าทำได้อย่างไร เราจะสร้างตัวอย่างเครื่องมือส่วนติดต่อผู้ใช้แบบกราฟิก (graphical user interface หรือ GUI) ที่วนลูปผ่านรายการของไอเทม แล้วเรียกใช้เมธอด draw กับแต่ละตัวเพื่อวาดมันลงบนหน้าจอ ซึ่งเป็นเทคนิคที่พบได้ทั่วไปสำหรับเครื่องมือ GUI เราจะสร้างเครตไลบรารีชื่อ gui ที่บรรจุโครงสร้างของไลบรารี GUI ไว้ เครตนี้อาจมีชนิดข้อมูลบางตัวเตรียมไว้ให้ใช้งาน เช่น Button หรือ TextField นอกจากนี้ ผู้ใช้ gui ยังต้องการสร้างชนิดข้อมูลของตนเองที่สามารถวาดลงจอได้ด้วย เช่น โปรแกรมเมอร์คนหนึ่งอาจเพิ่ม Image ขณะที่อีกคนอาจเพิ่ม SelectBox
ในขณะที่เขียนไลบรารี เราไม่มีทางรู้ล่วงหน้าหรือนิยามชนิดข้อมูลทั้งหมดที่โปรแกรมเมอร์คนอื่นอาจต้องการสร้างขึ้นได้ แต่สิ่งที่เรารู้คือ gui จำเป็นต้องติดตามค่าจำนวนมากที่มีชนิดข้อมูลแตกต่างกัน และต้องเรียกเมธอด draw บนค่าแต่ละตัวเหล่านั้น โดยตัวไลบรารีไม่จำเป็นต้องรู้รายละเอียดที่แน่ชัดว่าเกิดอะไรขึ้นเมื่อเรียกเมธอด draw ขอเพียงแค่ค่านั้นมีเมธอดดังกล่าวให้เรียกใช้ก็พอ
หากทำสิ่งนี้ในภาษาที่มีการสืบทอด เราอาจนิยามคลาสชื่อ Component ที่มีเมธอดชื่อ draw ขึ้นมา จากนั้นคลาสอื่น ๆ เช่น Button, Image และ SelectBox ก็จะสืบทอดมาจาก Component ทำให้ได้รับเมธอด draw ติดตัวมาด้วย แต่ละคลาสสามารถเขียนทับ (override) เมธอด draw เพื่อกำหนดพฤติกรรมเฉพาะของตนเองได้ โดยตัวเฟรมเวิร์กสามารถปฏิบัติต่อทุกชนิดข้อมูลราวกับว่าเป็นอินสแตนซ์ของ Component และเรียก draw บนพวกมันได้เลย แต่เนื่องจาก Rust ไม่มีการสืบทอด เราจึงต้องใช้วิธีอื่นในการจัดโครงสร้างไลบรารี gui เพื่อเปิดทางให้ผู้ใช้นำชนิดข้อมูลใหม่เข้ามาทำงานร่วมกับไลบรารีได้
การนิยามเทรตสำหรับพฤติกรรมร่วม
เพื่ออิมพลีเมนต์พฤติกรรมที่เราต้องการให้ gui มี เราจะนิยามเทรตชื่อ Draw ที่มีเมธอดหนึ่งตัวชื่อ draw จากนั้นเรานิยามเวกเตอร์ที่รับเทรตออบเจกต์ได้ เทรตออบเจกต์ (trait object) ชี้ไปยังทั้งอินสแตนซ์ (instance) ของชนิดข้อมูลที่อิมพลีเมนต์เทรตที่เราระบุ และตารางที่ใช้ค้นหาเมธอดของเทรตบนชนิดข้อมูลนั้นตอนรันไทม์ เราสร้างเทรตออบเจกต์โดยระบุพอยน์เตอร์บางชนิด เช่น เรเฟอเรนซ์ (reference) หรือสมาร์ตพอยน์เตอร์ (smart pointer) Box<T> จากนั้นตามด้วยคำสงวน dyn แล้วระบุเทรตที่เกี่ยวข้อง (เราจะพูดถึงเหตุผลที่เทรตออบเจกต์ต้องใช้พอยน์เตอร์ใน“ชนิดข้อมูลขนาดไม่คงที่และเทรต Sized” ในบทที่ 20) เราใช้เทรตออบเจกต์แทนชนิดเจเนอริก (generic) หรือชนิดที่เป็นรูปธรรมได้ ทุกที่ที่เราใช้เทรตออบเจกต์ ระบบชนิดข้อมูลของ Rust จะรับประกันตอนคอมไพล์ว่าค่าใดก็ตามที่ใช้ในบริบทนั้นจะอิมพลีเมนต์เทรตของเทรตออบเจกต์นั้น ดังนั้น เราจึงไม่จำเป็นต้องรู้ชนิดข้อมูลที่เป็นไปได้ทั้งหมดตอนคอมไพล์
เราเคยกล่าวไว้ก่อนหน้านี้ว่า ใน Rust เราจะหลีกเลี่ยงการเรียก struct และ enum ว่า “ออบเจกต์” เพื่อแยกความแตกต่างจากออบเจกต์ในภาษาอื่น ๆ ใน struct หรือ enum ข้อมูลในฟิลด์และพฤติกรรมในบล็อก impl จะถูกแยกออกจากกัน ในขณะที่ภาษาอื่น ๆ ข้อมูลและพฤติกรรมที่รวมอยู่ด้วยกันในแนวคิดเดียวนั้นมักจะถูกเรียกว่าออบเจกต์ ส่วนเทรตออบเจกต์จะแตกต่างจากออบเจกต์ในภาษาอื่นตรงที่เราไม่สามารถใส่ข้อมูลเพิ่มเข้าไปในเทรตออบเจกต์ได้ เทรตออบเจกต์จึงไม่ได้มีประโยชน์ครอบคลุมรอบด้านเหมือนออบเจกต์ในภาษาอื่น แต่มีจุดประสงค์เฉพาะทางคือเพื่อสร้างนามธรรมครอบคลุมพฤติกรรมที่มีร่วมกัน
ลิสติ้ง 18-3 แสดงวิธีนิยามเทรตชื่อ Draw ที่มีเมธอดหนึ่งตัวชื่อ draw
pub trait Draw {
fn draw(&self);
}ไวยากรณ์นี้น่าจะดูคุ้นเคยจากที่เราได้พูดคุยเรื่องการนิยามเทรตในบทที่ 10 ถัดไปเป็นไวยากรณ์ใหม่บางส่วน: ในลิสติ้ง 18-4 เราได้นิยาม struct ชื่อ Screen ที่เก็บเวกเตอร์ชื่อ components ไว้ โดยเวกเตอร์นี้มีชนิดข้อมูลเป็น Box<dyn Draw> ซึ่งก็คือเทรตออบเจกต์ โดยทำหน้าที่เป็นตัวแทนของชนิดข้อมูลใดก็ตามภายใน Box ที่อิมพลีเมนต์เทรต Draw
pub trait Draw {
fn draw(&self);
}
pub struct Screen {
pub components: Vec<Box<dyn Draw>>,
}ใน struct Screen เราจะนิยามเมธอดชื่อ run ซึ่งจะเรียกเมธอด draw บนแต่ละตัวใน components ดังแสดงในลิสติ้ง 18-5
pub trait Draw {
fn draw(&self);
}
pub struct Screen {
pub components: Vec<Box<dyn Draw>>,
}
impl Screen {
pub fn run(&self) {
for component in self.components.iter() {
component.draw();
}
}
}การทำงานของสิ่งนี้จะแตกต่างจากการนิยาม struct ที่ใช้พารามิเตอร์ชนิดข้อมูลเจเนอริก (generic type parameter) ร่วมกับข้อกำหนดเทรต (trait bound) เพราะพารามิเตอร์ชนิดข้อมูลเจเนอริกสามารถแทนที่ด้วยชนิดข้อมูลรูปธรรมได้เพียงชนิดเดียวในคราวหนึ่ง ในขณะที่เทรตออบเจกต์อนุญาตให้มีชนิดข้อมูลรูปธรรมได้หลายชนิดเข้ามาแทนที่เทรตออบเจกต์ ณ ตอนรันไทม์ ตัวอย่างเช่น เราอาจนิยาม struct Screen โดยใช้ชนิดข้อมูลเจเนอริกและข้อกำหนดเทรตได้ดังในลิสติ้ง 18-6
pub trait Draw {
fn draw(&self);
}
pub struct Screen<T: Draw> {
pub components: Vec<T>,
}
impl<T> Screen<T>
where
T: Draw,
{
pub fn run(&self) {
for component in self.components.iter() {
component.draw();
}
}
}วิธีนี้จะจำกัดให้อินสแตนซ์ของ Screen หนึ่ง ๆ มีรายการคอมโพเนนต์ที่เป็นชนิด Button ทั้งหมด หรือไม่ก็เป็นชนิด TextField ทั้งหมด หากคุณต้องการใช้คอลเลกชันที่เป็นชนิดเดียวกันทั้งหมด (homogeneous collection) เสมอ การใช้เจเนอริกและข้อกำหนดเทรตย่อมเป็นตัวเลือกที่ดีกว่า เพราะนิยามจะถูกมอโนมอร์ไฟซ์ (monomorphize) ตั้งแต่ตอนคอมไพล์เพื่อเจาะจงไปที่ชนิดข้อมูลรูปธรรมนั้น ๆ
ในทางกลับกัน ด้วยวิธีที่ใช้เทรตออบเจกต์ อินสแตนซ์ของ Screen ตัวหนึ่งจะสามารถเก็บ Vec<T> ที่บรรจุทั้ง Box<Button> และ Box<TextField> ผสมกันได้ ลองมาดูกันว่าสิ่งนี้ทำงานอย่างไร แล้วเราจะพูดถึงผลกระทบด้านประสิทธิภาพตอนรันไทม์กันต่อไป
การอิมพลีเมนต์เทรต
คราวนี้เราจะเพิ่มชนิดข้อมูลบางตัวที่อิมพลีเมนต์เทรต Draw โดยเราจะเตรียมชนิดข้อมูล Button ขึ้นมา แต่เนื่องจากการอิมพลีเมนต์ไลบรารี GUI จริง ๆ อยู่นอกเหนือขอบเขตของหนังสือเล่มนี้ ตัวเมธอด draw จึงไม่มีโค้ดการทำงานจริงที่ทำอะไรเป็นชิ้นเป็นอัน เพื่อให้เห็นภาพว่าการอิมพลีเมนต์อาจมีหน้าตาอย่างไร struct Button อาจมีฟิลด์สำหรับ width, height และ label ดังแสดงในลิสติ้ง 18-7
pub trait Draw {
fn draw(&self);
}
pub struct Screen {
pub components: Vec<Box<dyn Draw>>,
}
impl Screen {
pub fn run(&self) {
for component in self.components.iter() {
component.draw();
}
}
}
pub struct Button {
pub width: u32,
pub height: u32,
pub label: String,
}
impl Draw for Button {
fn draw(&self) {
// code to actually draw a button
}
}ฟิลด์ width, height และ label ใน Button จะแตกต่างจากฟิลด์ในคอมโพเนนต์อื่น ๆ ตัวอย่างเช่น ชนิดข้อมูล TextField อาจมีฟิลด์เหล่านี้เหมือนกันบวกกับฟิลด์ placeholder เพิ่มเข้ามา โดยชนิดข้อมูลแต่ละตัวที่เราต้องการวาดลงบนหน้าจอจะอิมพลีเมนต์เทรต Draw เหมือนกัน แต่จะใช้โค้ดในเมธอด draw แตกต่างกันไปตามวิธีการวาดของชนิดข้อมูลนั้น ๆ ดังที่ Button ทำไว้ที่นี่ (โดยไม่มีโค้ด GUI จริงตามที่ได้เกริ่นไว้) ตัวอย่างเช่น ชนิดข้อมูล Button อาจมีบล็อก impl เพิ่มเติมสำหรับเมธอดที่เกี่ยวข้องกับสิ่งที่จะเกิดขึ้นเมื่อผู้ใช้คลิกปุ่ม ซึ่งเมธอดประเภทนี้ย่อมไม่เกี่ยวข้องกับชนิดข้อมูลอย่าง TextField
หากผู้ใช้ไลบรารีของเราต้องการสร้าง struct SelectBox ที่มีฟิลด์ width, height และ options พวกเขาก็แค่อิมพลีเมนต์เทรต Draw ให้กับชนิดข้อมูล SelectBox ด้วยเช่นกัน ดังแสดงในลิสติ้ง 18-8
use gui::Draw;
struct SelectBox {
width: u32,
height: u32,
options: Vec<String>,
}
impl Draw for SelectBox {
fn draw(&self) {
// code to actually draw a select box
}
}
fn main() {}ตอนนี้ผู้ใช้ไลบรารีของเราสามารถเขียนฟังก์ชัน main เพื่อสร้างอินสแตนซ์ของ Screen ได้แล้ว และในอินสแตนซ์ของ Screen นั้น พวกเขาสามารถเพิ่มทั้ง SelectBox และ Button เข้าไปได้โดยการครอบแต่ละตัวไว้ใน Box<T> เพื่อให้กลายเป็นเทรตออบเจกต์ จากนั้นก็สามารถเรียกเมธอด run บนอินสแตนซ์ของ Screen ซึ่งจะไปเรียก draw ให้กับแต่ละคอมโพเนนต์ ลิสติ้ง 18-9 แสดงการเขียนโค้ดในลักษณะนี้
use gui::Draw;
struct SelectBox {
width: u32,
height: u32,
options: Vec<String>,
}
impl Draw for SelectBox {
fn draw(&self) {
// code to actually draw a select box
}
}
use gui::{Button, Screen};
fn main() {
let screen = Screen {
components: vec![
Box::new(SelectBox {
width: 75,
height: 10,
options: vec![
String::from("Yes"),
String::from("Maybe"),
String::from("No"),
],
}),
Box::new(Button {
width: 50,
height: 10,
label: String::from("OK"),
}),
],
};
screen.run();
}ในตอนที่เราเขียนไลบรารี เราไม่รู้เลยว่าจะมีใครเพิ่มชนิดข้อมูลอย่าง SelectBox เข้ามาในอนาคตหรือไม่ แต่การอิมพลีเมนต์ของ Screen ก็สามารถทำงานร่วมกับชนิดข้อมูลใหม่นี้และวาดมันขึ้นมาได้ เพราะ SelectBox ได้อิมพลีเมนต์เทรต Draw ซึ่งหมายความว่ามันมีเมธอด draw ให้เรียกใช้นั่นเอง
แนวคิดนี้—คือการสนใจเพียงแค่ว่าค่านั้น ๆ ตอบสนองต่อคำสั่งหรือเมธอดใดได้บ้าง แทนที่จะสนใจชนิดข้อมูลรูปธรรมที่แท้จริง—มีความคล้ายคลึงกับแนวคิด duck typing ในภาษาที่มีระบบชนิดข้อมูลแบบไดนามิก: กล่าวคือ “ถ้ามันเดินเหมือนเป็ดและร้องก้าบ ๆ เหมือนเป็ด มันก็คือเป็ด!” ในการอิมพลีเมนต์ run บน Screen ในลิสติ้ง 18-5 เมธอด run จึงไม่จำเป็นต้องรู้เลยว่าชนิดข้อมูลรูปธรรมที่แท้จริงของแต่ละคอมโพเนนต์คืออะไร และไม่จำเป็นต้องตรวจเช็กว่าคอมโพเนนต์ตัวนั้นเป็นอินสแตนซ์ของ Button หรือ SelectBox หรือไม่ มันเพียงแค่เรียกใช้เมธอด draw บนคอมโพเนนต์นั้นเท่านั้น ด้วยการระบุ Box<dyn Draw> เป็นชนิดข้อมูลของสมาชิกในเวกเตอร์ components เราจึงได้กำหนดไว้ว่า Screen ต้องการเพียงค่าใดก็ตามที่เราสามารถเรียกเมธอด draw ได้
ข้อดีของการใช้เทรตออบเจกต์และระบบชนิดข้อมูลของ Rust เพื่อเขียนโค้ดในลักษณะที่คล้ายกับ duck typing คือ เราไม่จำเป็นต้องคอยตรวจสอบว่าค่านั้น ๆ อิมพลีเมนต์เมธอดที่ต้องการหรือไม่ในตอนรันไทม์ และไม่ต้องกังวลว่าจะเกิด runtime error หากเผลอไปเรียกเมธอดที่ค่านั้นไม่ได้อิมพลีเมนต์ไว้ เพราะ Rust จะไม่ยอมคอมไพล์โค้ดของเราตั้งแต่แรก หากค่าเหล่านั้นไม่ได้อิมพลีเมนต์เทรตที่เทรตออบเจกต์กำหนดไว้
ตัวอย่างเช่น ลิสติ้ง 18-10 แสดงสิ่งที่จะเกิดขึ้นเมื่อเราพยายามสร้าง Screen โดยส่ง String เข้าไปเป็นคอมโพเนนต์ตัวหนึ่ง
use gui::Screen;
fn main() {
let screen = Screen {
components: vec![Box::new(String::from("Hi"))],
};
screen.run();
}เราจะได้รับข้อผิดพลาดนี้เพราะ String ไม่ได้อิมพลีเมนต์เทรต Draw:
$ cargo run
Compiling gui v0.1.0 (file:///projects/gui)
error[E0277]: the trait bound `String: Draw` is not satisfied
--> src/main.rs:5:26
|
5 | components: vec![Box::new(String::from("Hi"))],
| ^^^^^^^^^^^^^^^^^^^^^^^^^^^^ the trait `Draw` is not implemented for `String`
|
help: the trait `Draw` is implemented for `Button`
--> src/lib.rs:23:1
|
23 | impl Draw for Button {
| ^^^^^^^^^^^^^^^^^^^^
= note: required for the cast from `Box<String>` to `Box<dyn Draw>`
For more information about this error, try `rustc --explain E0277`.
error: could not compile `gui` (bin "gui") due to 1 previous error
ข้อผิดพลาดนี้ชี้แจงให้เราทราบว่า เราอาจกำลังส่งค่าบางอย่างให้กับ Screen โดยไม่ได้ตั้งใจ และควรเปลี่ยนไปส่งชนิดข้อมูลอื่นแทน หรือไม่ก็เราจำเป็นต้องอิมพลีเมนต์เทรต Draw ให้กับ String เพื่อให้ Screen สามารถเรียกใช้ draw กับมันได้
การดิสแพตช์แบบไดนามิก
ย้อนกลับไปในหัวข้อ “ประสิทธิภาพของโค้ดที่ใช้เจเนอริก” ในบทที่ 10 ที่เราได้อธิบายถึงกระบวนการมอโนมอร์ไฟเซชัน (monomorphization) ซึ่งคอมไพเลอร์จะทำให้กับโค้ดเจเนอริก: โดยคอมไพเลอร์จะสร้างการอิมพลีเมนต์ฟังก์ชันและเมธอดแบบไม่ใช้เจเนอริกขึ้นมาสำหรับแต่ละชนิดข้อมูลรูปธรรมที่เรานำมาแทนที่พารามิเตอร์ชนิดข้อมูลเจเนอริก โค้ดที่ได้จากกระบวนการนี้จะทำงานแบบ_การดิสแพตช์แบบสแตติก_ (static dispatch) ซึ่งหมายถึงคอมไพเลอร์รู้ตั้งแต่ตอนคอมไพล์แล้วว่าจะต้องเรียกใช้เมธอดตัวใด สิ่งนี้ตรงกันข้ามกับ_การดิสแพตช์แบบไดนามิก_ (dynamic dispatch) ซึ่งคอมไพเลอร์ไม่สามารถบอกได้ในตอนคอมไพล์ว่าเมธอดใดจะถูกเรียก โดยในกรณีนี้ คอมไพเลอร์จะสร้างโค้ดที่ไปค้นหาและตัดสินใจ ณ ตอนรันไทม์ว่าจะต้องเรียกใช้เมธอดใด
เมื่อเราใช้เทรตออบเจกต์ Rust จำเป็นต้องใช้การดิสแพตช์แบบไดนามิก เนื่องจากคอมไพเลอร์ไม่อาจล่วงรู้ชนิดข้อมูลทั้งหมดที่จะถูกนำมาใช้ร่วมกับโค้ดส่วนนั้น จึงไม่รู้ว่าควรเรียกเมธอดของชนิดข้อมูลใด แต่ ณ ตอนรันไทม์ Rust จะใช้พอยน์เตอร์ที่อยู่ภายในเทรตออบเจกต์เพื่อระบุเมธอดที่ต้องเรียกใช้ การค้นหาเมธอดนี้มีต้นทุนการประมวลผล (overhead) เพิ่มเติมตอนรันไทม์ซึ่งไม่เกิดขึ้นกับการดิสแพตช์แบบสแตติก นอกจากนี้ การดิสแพตช์แบบไดนามิกยังทำให้คอมไพเลอร์ไม่สามารถเลือกทำอินไลน์ (inline) โค้ดของเมธอดได้ ซึ่งส่งผลให้ไม่สามารถทำออปติไมเซชัน (optimization) บางอย่างได้ตามไปด้วย ทั้งนี้ Rust ยังมีกฎเกณฑ์ที่กำหนดว่าจุดใดบ้างที่สามารถหรือไม่สามารถใช้การดิสแพตช์แบบไดนามิกได้ ซึ่งเรียกว่า ความเข้ากันได้ของ dyn (dyn compatibility) กฎเหล่านั้นอยู่นอกเหนือขอบเขตของเนื้อหาในส่วนนี้ แต่คุณสามารถอ่านเพิ่มเติมได้ในเรเฟอเรนซ์ อย่างไรก็ดี เราได้รับความยืดหยุ่นเพิ่มขึ้นอย่างมากในโค้ดที่เราเขียนไว้ในลิสติ้ง 18-5 และลิสติ้ง 18-9 จึงถือเป็นข้อแลกเปลี่ยนที่คุณควรพิจารณาให้เหมาะสมกับการใช้งาน
อิมพลีเมนต์แพตเทิร์นการออกแบบเชิงวัตถุ
อิมพลีเมนต์แพตเทิร์นการออกแบบเชิงวัตถุ
แพตเทิร์นสถานะ (state pattern) เป็นหนึ่งในแบบแผนการออกแบบเชิงวัตถุ หัวใจสำคัญของแพตเทิร์นนี้คือการนิยามชุดของสถานะที่ค่าหนึ่ง ๆ สามารถมีได้ภายในตัว สถานะเหล่านี้จะถูกแทนด้วยชุดของ_ออบเจกต์สถานะ_ (state objects) และพฤติกรรมของค่านั้นจะเปลี่ยนไปตามสถานะที่เป็นอยู่ เราจะมาลงมือทำตัวอย่าง struct โพสต์บล็อกที่มีฟิลด์เก็บสถานะของมัน ซึ่งจะเป็นออบเจกต์สถานะจากชุด “draft” (ฉบับร่าง), “review” (รอตรวจสอบ) หรือ “published” (เผยแพร่แล้ว)
ออบเจกต์สถานะเหล่านี้จะใช้ฟังก์ชันการทำงานร่วมกัน: แน่นอนว่าใน Rust เราจะใช้ struct และเทรต แทนที่จะเป็นออบเจกต์และการสืบทอด ออบเจกต์สถานะแต่ละตัวจะรับผิดชอบพฤติกรรมของตนเองและคอยควบคุมว่าจะเปลี่ยนผ่านไปยังอีกสถานะหนึ่งเมื่อใด โดยที่ค่าตัวนอกที่ถือออบเจกต์สถานะนั้นไว้ ไม่จำเป็นต้องรู้เรื่องพฤติกรรมที่แตกต่างกันของแต่ละสถานะ หรือจังหวะเวลาในการเปลี่ยนสถานะเลย
ข้อดีของการใช้แพตเทิร์นสถานะคือ เมื่อความต้องการทางธุรกิจของโปรแกรมเปลี่ยนไป เราไม่จำเป็นต้องแก้ไขโค้ดของค่าที่เก็บสถานะหรือโค้ดส่วนอื่นที่เรียกใช้ค่านั้นเลย เราเพียงแค่อัปเดตโค้ดภายในออบเจกต์สถานะตัวใดตัวหนึ่งเพื่อปรับเปลี่ยนกฎเกณฑ์ หรือเพิ่มออบเจกต์สถานะใหม่เข้าไปเท่านั้น
ก่อนอื่น เราจะมาอิมพลีเมนต์แพตเทิร์นสถานะในสไตล์เชิงวัตถุแบบดั้งเดิมกันก่อน จากนั้นเราจะขยับไปใช้วิธีการที่เป็นธรรมชาติและเข้ากับ Rust มากกว่าเดิม ลองมาเจาะลึกเพื่ออิมพลีเมนต์เวิร์กโฟลว์ของโพสต์บล็อกโดยใช้แพตเทิร์นสถานะทีละขั้นตอนกัน
ฟังก์ชันการทำงานขั้นสุดท้ายจะมีหน้าตาดังนี้:
- โพสต์บล็อกจะเริ่มต้นจากการเป็นแบบร่างที่ว่างเปล่า (empty draft)
- เมื่อเขียนแบบร่างเสร็จแล้ว จะมีการส่งคำขอให้ตรวจสอบโพสต์ (request review)
- เมื่อโพสต์ได้รับการอนุมัติ (approved) จึงจะถูกเผยแพร่ (published)
- มีเพียงโพสต์บล็อกที่เผยแพร่แล้วเท่านั้นที่จะส่งคืนเนื้อหาออกมาพิมพ์ได้ เพื่อป้องกันไม่ให้โพสต์ที่ยังไม่ได้รับอนุมัติถูกเผยแพร่โดยไม่ได้ตั้งใจ
การพยายามเปลี่ยนแปลงอื่นใดนอกเหนือจากนี้กับโพสต์จะต้องไม่มีผลอะไรเกิดขึ้น ตัวอย่างเช่น หากเราพยายามอนุมัติโพสต์บล็อกที่ยังเป็นฉบับร่างอยู่ก่อนที่จะส่งคำขอตรวจสอบ โพสต์นั้นก็จะต้องยังคงเป็นฉบับร่างที่ยังไม่เผยแพร่อยู่เช่นเดิม
การลองใช้สไตล์เชิงวัตถุแบบดั้งเดิม
มีวิธีจัดโครงสร้างโค้ดเพื่อแก้ปัญหาเดียวกันนี้ได้หลากหลายรูปแบบนับไม่ถ้วน โดยแต่ละวิธีก็มีข้อแลกเปลี่ยนที่ต่างกันไป การอิมพลีเมนต์ในหัวข้อนี้จะเน้นไปที่สไตล์เชิงวัตถุแบบดั้งเดิม ซึ่งแม้จะสามารถเขียนใน Rust ได้ แต่ก็ยังไม่ได้ใช้ประโยชน์จากจุดแข็งหลายประการของ Rust อย่างเต็มที่ ในภายหลังเราจะสาธิตอีกวิธีแก้ปัญหาหนึ่งซึ่งยังคงประยุกต์ใช้แบบแผนการออกแบบเชิงวัตถุอยู่ แต่ถูกจัดโครงสร้างในรูปแบบที่อาจดูแปลกตาสำหรับโปรแกรมเมอร์ที่คุ้นชินกับ OOP มาก่อน เราจะเปรียบเทียบวิธีแก้ปัญหาทั้งสองแบบ เพื่อให้เห็นถึงข้อแลกเปลี่ยนในการออกแบบโค้ด Rust ที่แตกต่างไปจากภาษาอื่น ๆ
ลิสติ้ง 18-11 แสดงเวิร์กโฟลว์นี้ในรูปของโค้ด: นี่คือตัวอย่างการใช้งานของ API ที่เราจะอิมพลีเมนต์ในเครตไลบรารี (library crate) ชื่อ blog โค้ดนี้ยังไม่คอมไพล์เพราะเรายังไม่ได้อิมพลีเมนต์เครต blog
use blog::Post;
fn main() {
let mut post = Post::new();
post.add_text("I ate a salad for lunch today");
assert_eq!("", post.content());
post.request_review();
assert_eq!("", post.content());
post.approve();
assert_eq!("I ate a salad for lunch today", post.content());
}เราต้องการให้ผู้ใช้สามารถสร้างโพสต์บล็อกฉบับร่างใหม่ด้วย Post::new ได้ และสามารถเพิ่มข้อความลงในโพสต์ได้ หากเราพยายามอ่านเนื้อหาของโพสต์ทันทีก่อนที่จะได้รับการอนุมัติ เราก็ไม่ควรได้รับข้อความใด ๆ ออกมาเลย เพราะโพสต์ยังคงเป็นฉบับร่าง เราได้ใส่ assert_eq! ไว้ในโค้ดเพื่อจุดประสงค์ในการสาธิต โดยการเขียนยูนิตเทสต์ (unit test) ที่เหมาะสมสำหรับกรณีนี้คือการยืนยันว่าโพสต์บล็อกฉบับร่างจะต้องคืนสตริงว่างออกมาจากเมธอด content แต่ในตัวอย่างนี้เราจะไม่เขียนเทสต์จริง ๆ
ถัดไป เราต้องการให้สามารถส่งคำขอตรวจสอบโพสต์ได้ และต้องการให้ content ยังคงคืนสตริงว่างออกมาในระหว่างที่รอการตรวจสอบ และเมื่อโพสต์ได้รับการอนุมัติแล้ว มันก็ควรถูกเผยแพร่ ซึ่งหมายความว่าเมธอด content จะคืนข้อความทั้งหมดของโพสต์กลับมาเมื่อถูกเรียกใช้
โปรดสังเกตว่า ชนิดข้อมูลเดียวที่เรามีปฏิสัมพันธ์ด้วยจากเครตนี้คือชนิดข้อมูล Post ชนิดข้อมูลนี้จะประยุกต์ใช้แพตเทิร์นสถานะและถือค่าที่จะเป็นหนึ่งในสามออบเจกต์สถานะเพื่อแทนสถานะต่าง ๆ ของโพสต์ ได้แก่ draft (ฉบับร่าง), review (รอตรวจสอบ) หรือ published (เผยแพร่แล้ว) การเปลี่ยนผ่านจากสถานะหนึ่งไปยังอีกสถานะหนึ่งจะถูกจัดการอยู่ภายในชนิดข้อมูล Post ทั้งหมด สถานะจะเปลี่ยนไปตามเมธอดต่าง ๆ ที่ผู้ใช้ไลบรารีเรียกใช้บนอินสแตนซ์ของ Post โดยที่ผู้ใช้ไม่ต้องมาคอยจัดการการเปลี่ยนสถานะด้วยตนเอง นอกจากนี้ ผู้ใช้ยังไม่สามารถสร้างข้อผิดพลาดเกี่ยวกับสถานะได้ เช่น การเผยแพร่โพสต์ก่อนที่มันจะผ่านการตรวจสอบ
การนิยาม Post และการสร้างอินสแตนซ์ใหม่
มาเริ่มลงมืออิมพลีเมนต์ไลบรารีกันเลย! เรารู้ว่าเราต้องการ struct Post แบบพับลิกที่เก็บเนื้อหาเอาไว้ ดังนั้นเราจึงเริ่มต้นด้วยนิยามของ struct และฟังก์ชันแอสโซซิเอตแบบพับลิก new เพื่อสร้างอินสแตนซ์ของ Post ดังแสดงในลิสติ้ง 18-12 นอกจากนี้เรายังสร้างเทรต State แบบไพรเวตขึ้นมา เพื่อกำหนดพฤติกรรมร่วมที่ออบเจกต์สถานะทั้งหมดของ Post จำเป็นต้องมี
จากนั้น Post จะเก็บเทรตออบเจกต์ Box<dyn State> ไว้ภายใน Option<T> ในฟิลด์ไพรเวตชื่อ state เพื่อถือออบเจกต์สถานะนั้นไว้ เดี๋ยวคุณจะได้เห็นว่าทำไม Option<T> จึงจำเป็นในอีกสักครู่
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
}
trait State {}
struct Draft {}
impl State for Draft {}เทรต State จะนิยามพฤติกรรมร่วมกันระหว่างสถานะต่าง ๆ ของโพสต์ โดยออบเจกต์สถานะได้แก่ Draft, PendingReview และ Published ซึ่งทั้งหมดนี้จะต้องอิมพลีเมนต์เทรต State ในตอนนี้ ตัวเทรตยังไม่มีเมธอดใด ๆ และเราจะเริ่มต้นด้วยการนิยามเฉพาะสถานะ Draft ก่อน เพราะเป็นสถานะเริ่มต้นของโพสต์
เมื่อเราสร้าง Post ขึ้นมาใหม่ เราจะกำหนดค่าฟิลด์ state ให้เป็น Some ที่บรรจุ Box เอาไว้ โดย Box นี้จะชี้ไปยังอินสแตนซ์ใหม่ของ struct Draft สิ่งนี้รับประกันว่าเมื่อใดก็ตามที่เราสร้างอินสแตนซ์ Post ใหม่ โพสต์นั้นจะเริ่มต้นเป็นแบบร่างเสมอ และเนื่องจากฟิลด์ state ของ Post เป็นแบบไพรเวต จึงไม่มีทางเลยที่จะสร้าง Post ในสถานะอื่นขึ้นมาได้โดยตรง! ในฟังก์ชัน Post::new เรายังได้กำหนดฟิลด์ content ให้เป็น String เปล่าตัวใหม่อีกด้วย
การจัดเก็บข้อความของเนื้อหาของโพสต์
จากลิสติ้ง 18-11 เราเห็นว่าเราต้องการเรียกใช้เมธอดชื่อ add_text พร้อมส่ง &str เข้าไปเพื่อเพิ่มข้อความลงในเนื้อหาของโพสต์บล็อก เราเลือกที่จะอิมพลีเมนต์สิ่งนี้เป็นเมธอด แทนที่จะเปิดฟิลด์ content ให้เป็น pub เพื่อให้เราสามารถเขียนเมธอดที่คอยควบคุมวิธีการอ่านข้อมูลจากฟิลด์ content ในภายหลังได้ เมธอด add_text ค่อนข้างตรงไปตรงมา เราจึงเพิ่มการอิมพลีเมนต์ในลิสติ้ง 18-13 เข้าไปในบล็อก impl Post
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --snip--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
}
trait State {}
struct Draft {}
impl State for Draft {}เมธอด add_text จะรับเรเฟอเรนซ์แบบเปลี่ยนแปลงค่าได้ของ self เพราะเราจำเป็นต้องแก้ไขอินสแตนซ์ของ Post ที่เรียกใช้ add_text จากนั้นเราจะเรียก push_str บน String ในฟิลด์ content โดยส่งอาร์กิวเมนต์ text เข้าไปเพื่อต่อท้ายข้อความเดิม พฤติกรรมนี้ไม่ได้ขึ้นอยู่กับว่าโพสต์อยู่ในสถานะใด จึงไม่ได้เป็นส่วนหนึ่งของแพตเทิร์นสถานะ และเมธอด add_text ก็ไม่ได้ยุ่งเกี่ยวกับฟิลด์ state เลย เพียงแต่มันเป็นหนึ่งในพฤติกรรมที่เราต้องการรองรับการทำงาน
การตรวจสอบให้แน่ใจว่าเนื้อหาของโพสต์ฉบับร่างว่างเปล่า
แม้หลังจากที่เราเรียก add_text และเพิ่มข้อความลงในโพสต์ไปแล้ว เราก็ยังคงต้องการให้เมธอด content คืนค่าสตริงสไลซ์ (string slice) ที่ว่างเปล่ากลับมา เพราะโพสต์ยังอยู่ในสถานะฉบับร่าง ดังที่แสดงใน assert_eq! ตัวแรกของลิสติ้ง 18-11 ในตอนนี้ เรามาอิมพลีเมนต์เมธอด content ด้วยวิธีที่เรียบง่ายที่สุดเพื่อตอบโจทย์นี้กันก่อน: นั่นคือการคืนสตริงสไลซ์ว่างเปล่าเสมอ แล้วค่อยกลับมาแก้ไขในภายหลังเมื่อเราอิมพลีเมนต์ความสามารถในการเปลี่ยนสถานะของโพสต์จนเผยแพร่ได้สำเร็จ เมื่อโพสต์ยังอยู่ในสถานะฉบับร่างได้เพียงอย่างเดียว เนื้อหาของมันจึงควรว่างเปล่าเสมอ ลิสติ้ง 18-14 แสดงการอิมพลีเมนต์ชั่วคราวนี้
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --snip--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
""
}
}
trait State {}
struct Draft {}
impl State for Draft {}ด้วยเมธอด content ที่เพิ่มเข้ามานี้ ทุกอย่างในลิสติ้ง 18-11 จนถึง assert_eq! ตัวแรกก็ทำงานได้ตามที่ตั้งใจไว้
การขอให้ตรวจสอบ ซึ่งเปลี่ยนสถานะของโพสต์
ถัดไป เราต้องเพิ่มฟังก์ชันการทำงานสำหรับขอให้ตรวจสอบโพสต์ ซึ่งควรเปลี่ยนสถานะจาก Draft ไปเป็น PendingReview ลิสติ้ง 18-15 แสดงโค้ดในส่วนนี้
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --snip--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
""
}
pub fn request_review(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.request_review())
}
}
}
trait State {
fn request_review(self: Box<Self>) -> Box<dyn State>;
}
struct Draft {}
impl State for Draft {
fn request_review(self: Box<Self>) -> Box<dyn State> {
Box::new(PendingReview {})
}
}
struct PendingReview {}
impl State for PendingReview {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
}เราเพิ่มพับลิกเมธอดชื่อ request_review ให้กับ Post ซึ่งจะรับเรเฟอเรนซ์แบบเปลี่ยนแปลงค่าได้ของ self จากนั้นเราจะเรียกใช้เมธอด request_review ภายในบนสถานะปัจจุบันของ Post โดยเมธอด request_review ตัวที่สองนี้จะบริโภค (consume) สถานะปัจจุบันแล้วส่งคืนสถานะใหม่ออกมา
เราเพิ่มเมธอด request_review เข้าไปในเทรต State ดังนั้นทุกชนิดข้อมูลที่อิมพลีเมนต์เทรตนี้จะต้องมีเมธอด request_review ด้วย โปรดสังเกตว่า แทนที่จะใช้ self, &self หรือ &mut self เป็นพารามิเตอร์ตัวแรกของเมธอด เรากลับใช้ self: Box<Self> ไวยากรณ์นี้หมายความว่า เมธอดนี้จะเรียกใช้ได้เฉพาะเมื่อถูกเรียกบน Box ที่ถือชนิดข้อมูลนั้นอยู่เท่านั้น และไวยากรณ์นี้จะรับความเป็นเจ้าของ (ownership) Box<Self> ไป ทำให้สถานะเดิมใช้งานไม่ได้อีก เพื่อเปิดทางให้ค่าสถานะของ Post แปลงร่างไปเป็นสถานะใหม่
ในการบริโภคสถานะเดิม เมธอด request_review จำเป็นต้องรับความเป็นเจ้าของค่าของสถานะนั้น นี่คือจุดที่ Option ในฟิลด์ state ของ Post เข้ามามีบทบาทสำคัญ: เราจะเรียกเมธอด take เพื่อดึงค่า Some ออกจากฟิลด์ state แล้ววางค่า None ไว้แทนที่ เพราะ Rust ไม่อนุญาตให้เราปล่อยฟิลด์ใน struct ว่างเปล่าโดยไม่มีค่า สิ่งนี้ช่วยให้เราย้ายค่า (move) ของ state ออกจาก Post ได้แทนที่จะเป็นการยืม จากนั้นเราจะกำหนดค่า state ของโพสต์ให้เป็นผลลัพธ์ที่ได้จากการดำเนินการนี้
เราจำเป็นต้องตั้งค่า state ให้เป็น None ชั่วคราว แทนที่จะกำหนดค่าทับไปตรง ๆ ด้วยโค้ดอย่าง self.state = self.state.request_review(); เพื่อให้ได้รับความเป็นเจ้าของค่าของ state มา สิ่งนี้รับประกันว่า Post จะไม่สามารถนำค่า state เดิมกลับมาใช้ได้อีกหลังจากที่เราแปลงมันไปเป็นสถานะใหม่แล้ว
เมธอด request_review บน Draft จะคืนอินสแตนซ์ใหม่ที่อยู่ในบ็อกซ์ของ struct PendingReview ซึ่งเป็นตัวแทนของสถานะที่โพสต์กำลังรอการตรวจสอบ ส่วน struct PendingReview ก็อิมพลีเมนต์เมธอด request_review เช่นกัน แต่ไม่ได้ทำการแปลงร่างใด ๆ โดยจะคืนตัวมันเองกลับไป เพราะเมื่อเราส่งคำขอตรวจสอบโพสต์ที่อยู่ในสถานะ PendingReview อยู่แล้ว โพสต์นั้นก็ควรจะคงอยู่ในสถานะ PendingReview ต่อไป
ตอนนี้เราเริ่มเห็นข้อดีของแพตเทิร์นสถานะแล้ว: นั่นคือเมธอด request_review บน Post จะยังคงทำงานเหมือนเดิมไม่ว่าค่าของ state จะเป็นอะไร เพราะแต่ละสถานะจะรับผิดชอบกฎเกณฑ์ของตนเอง
เราจะปล่อยให้เมธอด content บน Post ทำงานเหมือนเดิม คือคืนค่าสตริงสไลซ์ว่างเปล่า แม้ว่าตอนนี้เราจะมี Post ที่อยู่ในสถานะ PendingReview เพิ่มขึ้นมา แต่เราก็ยังต้องการพฤติกรรมเดิมในสถานะนี้เช่นกัน ทำให้ตอนนี้โค้ดในลิสติ้ง 18-11 สามารถทำงานได้ถึงการเรียก assert_eq! ตัวที่สองแล้ว!
การเพิ่ม approve เพื่อเปลี่ยนพฤติกรรมของ content
เมธอด approve จะทำงานคล้ายกับเมธอด request_review: โดยจะกำหนดค่า state ให้เป็นค่าที่สถานะปัจจุบันระบุว่าควรเปลี่ยนไปเมื่อได้รับการอนุมัติ ดังแสดงในลิสติ้ง 18-16
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --snip--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
""
}
pub fn request_review(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.request_review())
}
}
pub fn approve(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.approve())
}
}
}
trait State {
fn request_review(self: Box<Self>) -> Box<dyn State>;
fn approve(self: Box<Self>) -> Box<dyn State>;
}
struct Draft {}
impl State for Draft {
// --snip--
fn request_review(self: Box<Self>) -> Box<dyn State> {
Box::new(PendingReview {})
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}
struct PendingReview {}
impl State for PendingReview {
// --snip--
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
Box::new(Published {})
}
}
struct Published {}
impl State for Published {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}เราเพิ่มเมธอด approve เข้าไปในเทรต State และเพิ่ม struct ใหม่ที่อิมพลีเมนต์ State นั่นคือสถานะ Published
ในทำนองเดียวกับที่ request_review บน PendingReview ทำงาน หากเราเรียกเมธอด approve บน Draft มันจะไม่มีผลอะไรเกิดขึ้น เพราะ approve จะคืน self กลับมา แต่เมื่อเราเรียก approve บน PendingReview มันจะคืนอินสแตนซ์ใหม่ที่อยู่ในบ็อกซ์ของ struct Published กลับมา โดย struct Published นี้จะอิมพลีเมนต์เทรต State และสำหรับทั้งเมธอด request_review และ approve มันจะคืนตัวมันเองกลับไป เพราะโพสต์ควรคงอยู่ในสถานะ Published ต่อไปในกรณีเหล่านั้น
คราวนี้เราจำเป็นต้องอัปเดตเมธอด content บน Post เราต้องการให้ค่าที่คืนจาก content ขึ้นอยู่กับสถานะปัจจุบันของ Post เราจึงจะให้ Post มอบหมายงาน (delegate) ต่อไปยังเมธอด content ที่นิยามไว้บน state ของมัน ดังแสดงในลิสติ้ง 18-17
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
// --snip--
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
self.state.as_ref().unwrap().content(self)
}
// --snip--
pub fn request_review(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.request_review())
}
}
pub fn approve(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.approve())
}
}
}
trait State {
fn request_review(self: Box<Self>) -> Box<dyn State>;
fn approve(self: Box<Self>) -> Box<dyn State>;
}
struct Draft {}
impl State for Draft {
fn request_review(self: Box<Self>) -> Box<dyn State> {
Box::new(PendingReview {})
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}
struct PendingReview {}
impl State for PendingReview {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
Box::new(Published {})
}
}
struct Published {}
impl State for Published {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}เนื่องจากเป้าหมายคือการเก็บกฎเกณฑ์ทั้งหมดนี้ไว้ใน struct ที่อิมพลีเมนต์ State เราจึงเรียกเมธอด content บนค่าที่อยู่ใน state พร้อมกับส่งอินสแตนซ์ของโพสต์ (นั่นคือ self) ไปเป็นอาร์กิวเมนต์ จากนั้นเราจึงส่งคืนค่าที่ได้จากการเรียกใช้เมธอด content บนค่านั้นกลับไป
เราเรียกเมธอด as_ref บน Option เพราะเราต้องการเพียงเรเฟอเรนซ์ไปยังค่าข้างใน Option ไม่ใช่ความเป็นเจ้าของค่านั้น เนื่องจาก state มีชนิดข้อมูลเป็น Option<Box<dyn State>> เมื่อเราเรียก as_ref เราจึงได้ Option<&Box<dyn State>> กลับมา หากเราไม่เรียก as_ref เราจะเจอกับข้อผิดพลาดของคอมไพเลอร์ เพราะเราไม่สามารถย้าย (move) state ออกมาจาก &self ที่ถูกยืมมาในพารามิเตอร์ของฟังก์ชันได้
จากนั้นเราจึงเรียกเมธอด unwrap ซึ่งเรารู้ดีว่าจะไม่มีทางเกิดการแพนิก (panic) อย่างแน่นอน เพราะเมธอดต่าง ๆ บน Post รับประกันว่า state จะมีค่าเป็น Some เสมอเมื่อเมธอดเหล่านั้นทำงานเสร็จสิ้น นี่คือหนึ่งในกรณีที่เราได้พูดคุยกันในหัวข้อ “เมื่อคุณมีข้อมูลมากกว่าคอมไพเลอร์” ในบทที่ 9 ซึ่งเรารู้แน่ชัดว่าค่า None ไม่มีทางเกิดขึ้นได้ แม้ว่าคอมไพเลอร์จะไม่สามารถล่วงรู้ในจุดนี้ก็ตาม
ณ จุดนี้ เมื่อเราเรียก content บน &Box<dyn State> การแปลงชนิดข้อมูลอัตโนมัติด้วยการดีเรฟ (deref coercion) จะมีผลกับทั้ง & และ Box ส่งผลให้ท้ายที่สุดแล้ว เมธอด content จะถูกเรียกบนชนิดข้อมูลที่อิมพลีเมนต์เทรต State จริง ๆ นั่นหมายความว่า เราต้องเพิ่ม content เข้าไปในนิยามของเทรต State ด้วย และนั่นคือจุดที่เราจะใส่ตรรกะว่าควรคืนเนื้อหาอะไรออกมาตามสถานะที่เป็นอยู่ ดังแสดงในลิสติ้ง 18-18
pub struct Post {
state: Option<Box<dyn State>>,
content: String,
}
impl Post {
pub fn new() -> Post {
Post {
state: Some(Box::new(Draft {})),
content: String::new(),
}
}
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn content(&self) -> &str {
self.state.as_ref().unwrap().content(self)
}
pub fn request_review(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.request_review())
}
}
pub fn approve(&mut self) {
if let Some(s) = self.state.take() {
self.state = Some(s.approve())
}
}
}
trait State {
// --snip--
fn request_review(self: Box<Self>) -> Box<dyn State>;
fn approve(self: Box<Self>) -> Box<dyn State>;
fn content<'a>(&self, post: &'a Post) -> &'a str {
""
}
}
// --snip--
struct Draft {}
impl State for Draft {
fn request_review(self: Box<Self>) -> Box<dyn State> {
Box::new(PendingReview {})
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
}
struct PendingReview {}
impl State for PendingReview {
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
Box::new(Published {})
}
}
struct Published {}
impl State for Published {
// --snip--
fn request_review(self: Box<Self>) -> Box<dyn State> {
self
}
fn approve(self: Box<Self>) -> Box<dyn State> {
self
}
fn content<'a>(&self, post: &'a Post) -> &'a str {
&post.content
}
}เราเพิ่มการอิมพลีเมนต์ดีฟอลต์สำหรับเมธอด content ให้คืนค่าเป็นสตริงสไลซ์ว่างเปล่า ซึ่งหมายความว่าเราไม่จำเป็นต้องเขียนการอิมพลีเมนต์ content บน struct Draft และ PendingReview ซ้ำอีก โดย struct Published จะเป็นตัวเขียนทับ (override) เมธอด content และคืนค่าใน post.content ออกมา แม้ว่าวิธีนี้จะสะดวก แต่การให้เมธอด content บน State เป็นตัวกำหนดเนื้อหาของ Post ก็ทำให้เส้นแบ่งความรับผิดชอบระหว่าง State กับ Post ดูเลือนลางลงไปบ้าง
โปรดสังเกตว่าเราจำเป็นต้องระบุตัวกำกับอายุการใช้งาน (lifetime annotation) บนเมธอดนี้ด้วย ดังที่เราได้อธิบายไว้ในบทที่ 10 เพราะเรากำลังรับเรเฟอเรนซ์ของ post เข้ามาเป็นอาร์กิวเมนต์ และส่งคืนเรเฟอเรนซ์ไปยังส่วนหนึ่งของ post นั้นกลับออกไป อายุการใช้งานของเรเฟอเรนซ์ที่คืนกลับจึงผูกพันอยู่กับอายุการใช้งานของอาร์กิวเมนต์ post
และแล้วก็เสร็จเรียบร้อย—ตอนนี้โค้ดทั้งหมดในลิสติ้ง 18-11 สามารถทำงานได้ครบถ้วนแล้ว! เราได้อิมพลีเมนต์แพตเทิร์นสถานะตามกฎเกณฑ์ของเวิร์กโฟลว์โพสต์บล็อก โดยตรรกะที่เกี่ยวข้องกับกฎเกณฑ์ต่าง ๆ จะรวมศูนย์อยู่ในออบเจกต์สถานะ แทนที่จะกระจัดกระจายอยู่ทั่ว struct Post
ทำไมไม่ใช้ Enum?
คุณอาจสงสัยว่าทำไมเราไม่ใช้ enum ที่มีสถานะต่าง ๆ ที่เป็นไปได้ของโพสต์เป็นวาเรียนต์ นั่นก็เป็นหนึ่งในทางออกที่เป็นไปได้อย่างแน่นอน ลองเขียนดูแล้วเปรียบเทียบผลลัพธ์สุดท้ายว่าคุณชอบแบบใดมากกว่า! ข้อเสียประการหนึ่งของการใช้ enum คือ ทุกจุดที่มีการตรวจสอบค่าของ enum จะต้องมีนิพจน์
matchหรือโครงสร้างที่คล้ายกันเพื่อจัดการกับทุกวาเรียนต์ที่เป็นไปได้ ซึ่งอาจทำให้เกิดโค้ดซ้ำซ้อนมากกว่าแนวทางที่ใช้เทรตออบเจกต์นี้
การประเมินแพตเทิร์นสถานะ
เราได้แสดงให้เห็นแล้วว่า Rust สามารถอิมพลีเมนต์แพตเทิร์นสถานะเชิงวัตถุเพื่อห่อหุ้ม (encapsulate) พฤติกรรมต่าง ๆ ที่โพสต์ควรมีในแต่ละสถานะได้ โดยที่เมธอดบน Post ไม่จำเป็นต้องรู้เรื่องพฤติกรรมเหล่านั้นเลย ด้วยวิธีการจัดระเบียบโค้ดเช่นนี้ เราจึงเปิดดูเพียงจุดเดียวก็เข้าใจได้ทันทีว่าโพสต์ที่เผยแพร่แล้วมีพฤติกรรมอย่างไร นั่นคือดูที่การอิมพลีเมนต์เทรต State บน struct Published
หากเราเลือกอิมพลีเมนต์ด้วยวิธีอื่นที่ไม่ใช้แพตเทิร์นสถานะ เราอาจต้องใช้นิพจน์ match ในเมธอดต่าง ๆ บน Post หรือแม้กระทั่งในโค้ด main เพื่อคอยตรวจสอบสถานะของโพสต์แล้วปรับเปลี่ยนพฤติกรรมในแต่ละจุด ซึ่งนั่นจะทำให้เราต้องไล่ดูโค้ดหลายที่มากเพื่อที่จะเข้าใจผลกระทบทั้งหมดของการที่โพสต์อยู่ในสถานะเผยแพร่แล้ว
การใช้แพตเทิร์นสถานะทำให้เมธอดของ Post และจุดที่เราเรียกใช้ Post ไม่จำเป็นต้องมีนิพจน์ match เลย และเมื่อต้องการเพิ่มสถานะใหม่ เราก็เพียงแค่เพิ่ม struct ใหม่ขึ้นมา แล้วอิมพลีเมนต์เมธอดของเทรตบน struct นั้นในที่เดียวจบ
การอิมพลีเมนต์โดยใช้แพตเทิร์นสถานะจึงง่ายต่อการต่อขยายเพื่อเพิ่มฟังก์ชันการทำงาน เพื่อสัมผัสถึงความสะดวกในการบำรุงรักษาโค้ดที่ใช้แพตเทิร์นสถานะ ลองทำตามคำแนะนำเหล่านี้ดู:
- เพิ่มเมธอด
rejectที่เปลี่ยนสถานะของโพสต์จากPendingReviewกลับไปเป็นDraft - กำหนดให้ต้องเรียก
approveสองครั้งก่อนที่สถานะจะเปลี่ยนเป็นPublishedได้ - อนุญาตให้ผู้ใช้เพิ่มข้อความได้เฉพาะเมื่อโพสต์อยู่ในสถานะ
Draftเท่านั้น คำใบ้: ให้ออบเจกต์สถานะเป็นผู้รับผิดชอบว่ามีอะไรเปลี่ยนแปลงเกี่ยวกับเนื้อหาได้บ้าง แต่ไม่ต้องรับผิดชอบการแก้ไขPostโดยตรง
ข้อเสียประการหนึ่งของแพตเทิร์นสถานะคือ เนื่องจากแต่ละสถานะเป็นตัวกำหนดการเปลี่ยนผ่านไปยังสถานะถัดไป สถานะบางตัวจึงเกิดการผูกมัดซึ่งกันและกัน (coupled) หากเราต้องการแทรกสถานะใหม่เข้าไปคั่นระหว่าง PendingReview กับ Published เช่น Scheduled เราจะต้องเข้าไปแก้โค้ดใน PendingReview ให้เปลี่ยนผ่านไปยัง Scheduled แทน ซึ่งคงจะเหนื่อยน้อยลงหาก PendingReview ไม่จำเป็นต้องถูกแก้ไขเมื่อมีการเพิ่มสถานะใหม่ แต่นั่นก็หมายความว่าเราต้องเปลี่ยนไปใช้แบบแผนการออกแบบอื่น
ข้อเสียอีกประการหนึ่งคือเราเกิดโค้ดซ้ำซ้อนขึ้นบางส่วน เพื่อกำจัดความซ้ำซ้อนบางส่วน เราอาจลองสร้างการอิมพลีเมนต์ดีฟอลต์สำหรับเมธอด request_review และ approve บนเทรต State ที่คืน self อย่างไรก็ตาม วิธีนี้ใช้ไม่ได้: เมื่อใช้ State เป็นเทรตออบเจกต์ เทรตไม่รู้ว่า self ที่เป็นรูปธรรมจะเป็นอะไรอย่างแน่ชัด ชนิดที่คืนกลับจึงไม่เป็นที่รู้ตอนคอมไพล์ (นี่เป็นหนึ่งในกฎความเข้ากันได้ของ dyn ที่กล่าวถึงก่อนหน้านี้)
ความซ้ำซ้อนอีกจุดหนึ่งคือ โค้ดการทำงานที่คล้ายคลึงกันมากของเมธอด request_review และ approve บน Post โดยทั้งสองเมธอดต่างเรียกใช้ Option::take กับฟิลด์ state ของ Post และหาก state มีค่าเป็น Some ก็จะส่งต่องานไปยังการอิมพลีเมนต์เมธอดเดียวกันของค่าที่ถูกห่อไว้ แล้วนำผลลัพธ์ที่ได้มาตั้งเป็นค่าใหม่ของฟิลด์ state หากเรามีเมธอดบน Post จำนวนมากที่ใช้รูปแบบนี้ซ้ำ ๆ เราอาจพิจารณานิยามมาโคร (macro) ขึ้นมาเพื่อลดความซ้ำซ้อนในการเขียนโค้ด (ดูหัวข้อ “มาโคร” ในบทที่ 20)
การอิมพลีเมนต์แพตเทิร์นสถานะตามนิยามดั้งเดิมของภาษาเชิงวัตถุอย่างเคร่งครัด ทำให้เรายังไม่ได้ใช้ประโยชน์จากจุดแข็งของ Rust ได้อย่างเต็มที่ มาลองดูการปรับเปลี่ยนบางอย่างที่เราสามารถทำได้กับเครต blog ซึ่งจะช่วยเปลี่ยนสถานะและการเปลี่ยนสถานะที่ไม่ถูกต้อง ให้กลายเป็นข้อผิดพลาดตั้งแต่ตอนคอมไพล์กันดีกว่า
การเข้ารหัสสถานะและพฤติกรรมเป็นชนิดข้อมูล
เราจะแสดงวิธีคิดใหม่กับแพตเทิร์นสถานะเพื่อให้ได้ข้อแลกเปลี่ยนอีกแบบหนึ่ง แทนที่จะห่อหุ้มสถานะและการเปลี่ยนผ่านไว้อย่างมิดชิดจนโค้ดภายนอกไม่รู้เรื่องเลย เราจะเข้ารหัสสถานะต่าง ๆ ลงไปในชนิดข้อมูลที่แตกต่างกัน ด้วยวิธีนี้ ระบบตรวจสอบชนิดข้อมูลของ Rust จะป้องกันความพยายามในการนำโพสต์ฉบับร่างไปใช้ในจุดที่อนุญาตเฉพาะโพสต์ที่เผยแพร่แล้ว โดยแจ้งเตือนเป็นข้อผิดพลาดจากคอมไพเลอร์ทันที
ลองมาดูส่วนแรกของฟังก์ชัน main ในลิสติ้ง 18-11 กัน:
use blog::Post;
fn main() {
let mut post = Post::new();
post.add_text("I ate a salad for lunch today");
assert_eq!("", post.content());
post.request_review();
assert_eq!("", post.content());
post.approve();
assert_eq!("I ate a salad for lunch today", post.content());
}เรายังคงอนุญาตให้สร้างโพสต์ใหม่ในสถานะฉบับร่างด้วย Post::new และอนุญาตให้เพิ่มข้อความลงในเนื้อหาของโพสต์ได้เหมือนเดิม แต่แทนที่จะมีเมธอด content บนโพสต์ฉบับร่างที่คืนค่าสตริงว่าง เราจะทำให้โพสต์ฉบับร่างไม่มีเมธอด content เลย ด้วยวิธีนั้น หากเราพยายามดึงเนื้อหาจากโพสต์ฉบับร่าง เราจะได้รับข้อผิดพลาดจากคอมไพเลอร์ว่าไม่มีเมธอดดังกล่าวอยู่ ผลลัพธ์คือ เราจะไม่มีทางเผลอแสดงเนื้อหาของโพสต์ฉบับร่างในระบบจริง (production) โดยไม่ตั้งใจได้อย่างแน่นอน เพราะโค้ดนั้นจะไม่สามารถคอมไพล์ผ่านได้ตั้งแต่แรก ลิสติ้ง 18-19 แสดงนิยามของ struct Post และ struct DraftPost พร้อมกับเมธอดของแต่ละตัว
pub struct Post {
content: String,
}
pub struct DraftPost {
content: String,
}
impl Post {
pub fn new() -> DraftPost {
DraftPost {
content: String::new(),
}
}
pub fn content(&self) -> &str {
&self.content
}
}
impl DraftPost {
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
}ทั้ง struct Post และ DraftPost ต่างมีฟิลด์ไพรเวต content สำหรับเก็บข้อความของโพสต์บล็อก แต่ทั้งสอง struct จะไม่มีฟิลด์ state อีกต่อไป เพราะเราได้ย้ายการเข้ารหัสสถานะไปไว้ที่ตัวชนิดข้อมูลของ struct แทน โดย struct Post จะเป็นตัวแทนของโพสต์ที่เผยแพร่แล้ว และมีเมธอด content ที่คืนค่า content ออกมา
เรายังคงมีฟังก์ชัน Post::new อยู่ แต่แทนที่จะคืนอินสแตนซ์ของ Post มันกลับคืนอินสแตนซ์ของ DraftPost ออกมาแทน และเนื่องจาก content เป็นแบบไพรเวต อีกทั้งยังไม่มีฟังก์ชันใดที่คืน Post ได้เลย ในตอนนี้จึงเป็นไปไม่ได้ที่จะสร้างอินสแตนซ์ของ Post ขึ้นมาตรง ๆ
struct DraftPost จะมีเมธอด add_text ทำให้เรายังคงเพิ่มข้อความลงใน content ได้เหมือนเดิม แต่สังเกตว่า DraftPost ไม่ได้นิยามเมธอด content เอาไว้! โปรแกรมจึงสามารถรับประกันได้ว่า โพสต์ทั้งหมดจะต้องเริ่มต้นจากการเป็นโพสต์ฉบับร่าง และโพสต์ฉบับร่างจะไม่มีเนื้อหาเปิดให้แสดงผล ความพยายามใด ๆ ที่จะหลบเลี่ยงข้อจำกัดนี้จะถูกปฏิเสธด้วยข้อผิดพลาดจากคอมไพเลอร์ทันที
ถ้าเช่นนั้น เราจะได้โพสต์ที่เผยแพร่แล้วมาได้อย่างไร? เราต้องการบังคับใช้กฎว่า โพสต์ฉบับร่างจะต้องผ่านการตรวจสอบและได้รับการอนุมัติก่อนจึงจะสามารถเผยแพร่ได้ และโพสต์ในสถานะรอตรวจสอบก็ยังไม่ควรแสดงเนื้อหาใด ๆ ออกมา เราจะสร้างข้อจำกัดเหล่านี้ขึ้นมาโดยการเพิ่ม struct อีกตัวชื่อ PendingReviewPost พร้อมกับนิยามเมธอด request_review บน DraftPost ให้คืน PendingReviewPost และนิยามเมธอด approve บน PendingReviewPost ให้คืน Post ดังแสดงในลิสติ้ง 18-20
pub struct Post {
content: String,
}
pub struct DraftPost {
content: String,
}
impl Post {
pub fn new() -> DraftPost {
DraftPost {
content: String::new(),
}
}
pub fn content(&self) -> &str {
&self.content
}
}
impl DraftPost {
// --snip--
pub fn add_text(&mut self, text: &str) {
self.content.push_str(text);
}
pub fn request_review(self) -> PendingReviewPost {
PendingReviewPost {
content: self.content,
}
}
}
pub struct PendingReviewPost {
content: String,
}
impl PendingReviewPost {
pub fn approve(self) -> Post {
Post {
content: self.content,
}
}
}เมธอด request_review และ approve จะรับความเป็นเจ้าของของ self จึงเป็นการบริโภคอินสแตนซ์ของ DraftPost และ PendingReviewPost แล้วแปลงร่างให้กลายเป็น PendingReviewPost และ Post ที่เผยแพร่แล้วตามลำดับ ด้วยวิธีนี้ เราจะไม่มีอินสแตนซ์ของ DraftPost หลงเหลืออยู่อีกหลังจากที่เราเรียก request_review ไปแล้ว เป็นต้น และเนื่องจาก struct PendingReviewPost ไม่ได้นิยามเมธอด content ไว้ การพยายามอ่านเนื้อหาของมันจึงทำให้เกิดข้อผิดพลาดจากคอมไพเลอร์เช่นเดียวกับ DraftPost และเพราะหนทางเดียวที่จะได้อินสแตนซ์ของ Post ที่เผยแพร่แล้ว (ซึ่งมีเมธอด content ให้เรียก) คือการเรียกเมธอด approve บน PendingReviewPost และหนทางเดียวที่จะได้ PendingReviewPost คือการเรียก request_review บน DraftPost เราจึงได้เข้ารหัสเวิร์กโฟลว์ของโพสต์บล็อกทั้งหมดลงในระบบชนิดข้อมูลได้อย่างสมบูรณ์
อย่างไรก็ตาม เรายังต้องปรับแก้โค้ดใน main เล็กน้อย เนื่องจากเมธอด request_review และ approve จะส่งคืนอินสแตนซ์ใหม่กลับมาแทนที่จะเป็นการดัดแปลง struct เดิมที่ถูกเรียกใช้ เราจึงต้องใช้การบังเงาตัวแปร (variable shadowing) ด้วยคำสั่ง let post = เพิ่มเติมเพื่อเก็บอินสแตนซ์ใหม่ที่คืนกลับมา นอกจากนี้ เรายังไม่สามารถใส่แอสเซอร์ชัน (assertion) ตรวจสอบเนื้อหาของโพสต์ฉบับร่างและโพสต์ที่รอการตรวจสอบว่าเป็นสตริงว่างได้อีกต่อไป และไม่จำเป็นต้องใส่ด้วย เพราะเราไม่สามารถแม้แต่จะคอมไพล์โค้ดที่พยายามอ่านเนื้อหาของโพสต์ในสถานะเหล่านั้นได้อยู่แล้ว โค้ดที่อัปเดตใน main แสดงไว้ในลิสติ้ง 18-21
use blog::Post;
fn main() {
let mut post = Post::new();
post.add_text("I ate a salad for lunch today");
let post = post.request_review();
let post = post.approve();
assert_eq!("I ate a salad for lunch today", post.content());
}การที่เราต้องปรับแก้ฟังก์ชัน main เพื่อกำหนดค่าตัวแปร post ใหม่นี้ หมายความว่าการอิมพลีเมนต์นี้ไม่ได้ปฏิบัติตามแพตเทิร์นสถานะเชิงวัตถุแบบเป๊ะ ๆ อีกต่อไป: เนื่องจากการแปลงร่างระหว่างสถานะต่าง ๆ ไม่ได้ถูกห่อหุ้มไว้ภายใน Post อย่างเบ็ดเสร็จอีกแล้ว แต่สิ่งที่เราได้รับกลับมาคือ สถานะที่ไม่ถูกต้องจะไม่มีทางเกิดขึ้นได้อย่างเด็ดขาด ต้องขอบคุณระบบชนิดข้อมูลและการตรวจสอบชนิดข้อมูลในตอนคอมไพล์! สิ่งนี้ช่วยรับประกันว่าบั๊กบางประเภท เช่น การเผลอแสดงเนื้อหาของโพสต์ที่ยังไม่เผยแพร่ จะถูกตรวจพบตั้งแต่เนิ่น ๆ ก่อนที่จะหลุดไปถึงโปรดักชัน
ลองนำโจทย์แบบฝึกหัดที่แนะนำไว้ในตอนต้นของหัวข้อนี้ มาทดลองทำกับเครต blog ในเวอร์ชันหลังลิสติ้ง 18-21 ดู เพื่อสัมผัสว่าคุณรู้สึกอย่างไรกับการออกแบบโค้ดในรูปแบบนี้ และโปรดสังเกตว่าโจทย์บางข้ออาจได้รับการแก้ไขเสร็จสิ้นไปแล้วในตัวการออกแบบนี้เอง
เราได้เห็นแล้วว่า แม้ว่า Rust จะมีความสามารถในการอิมพลีเมนต์แบบแผนการออกแบบเชิงวัตถุได้ แต่แพตเทิร์นอื่น ๆ เช่น การเข้ารหัสสถานะลงในระบบชนิดข้อมูล ก็เป็นทางเลือกที่มีประสิทธิภาพใน Rust เช่นกัน แพตเทิร์นแต่ละแบบย่อมมีข้อแลกเปลี่ยนที่แตกต่างกัน แม้ว่าคุณอาจคุ้นเคยกับแพตเทิร์นเชิงวัตถุเป็นอย่างดี แต่การคิดทบทวนโจทย์ใหม่เพื่อดึงประโยชน์จากฟีเจอร์อันทรงพลังของ Rust ก็สามารถมอบคุณประโยชน์ที่ยอดเยี่ยมได้ เช่น การป้องกันบั๊กตั้งแต่ตอนคอมไพล์ โดยแบบแผนเชิงวัตถุอาจไม่ได้เป็นคำตอบที่ดีที่สุดเสมอไปใน Rust เนื่องจากฟีเจอร์เฉพาะตัวอย่างระบบความเป็นเจ้าของ (ownership) ที่ภาษาเชิงวัตถุทั่วไปไม่มี
สรุป
ไม่ว่าหลังจากอ่านบทนี้จบแล้ว คุณจะมองว่า Rust เป็นภาษาเชิงวัตถุหรือไม่ก็ตาม แต่ตอนนี้คุณได้ทราบแล้วว่า คุณสามารถใช้เทรตออบเจกต์เพื่อดึงฟีเจอร์บางประการของเชิงวัตถุมาใช้ใน Rust ได้ การดิสแพตช์แบบไดนามิก (dynamic dispatch) ช่วยเพิ่มความยืดหยุ่นให้กับโค้ดของคุณโดยแลกกับต้นทุนด้านประสิทธิภาพตอนรันไทม์เพียงเล็กน้อย คุณสามารถนำความยืดหยุ่นนี้ไปใช้อิมพลีเมนต์แพตเทิร์นเชิงวัตถุที่ช่วยให้โค้ดของคุณดูแลรักษาง่ายขึ้น ยิ่งไปกว่านั้น Rust ยังมีฟีเจอร์อื่น ๆ เช่น ระบบความเป็นเจ้าของ (ownership) ซึ่งภาษาเชิงวัตถุทั่วไปไม่มี แม้แบบแผนเชิงวัตถุอาจไม่ได้เป็นหนทางที่ดีที่สุดเสมอไปในการดึงจุดแข็งของ Rust ออกมาใช้ แต่มันก็เป็นทางเลือกหนึ่งที่มีพร้อมให้คุณหยิบมาใช้งานเสมอ
ในบทต่อไป เราจะไปดูเรื่อง “แพตเทิร์น” (patterns) ซึ่งเป็นอีกหนึ่งฟีเจอร์สำคัญของ Rust ที่ช่วยเปิดประตูสู่ความยืดหยุ่นอย่างมากมาย แม้เราจะเคยเห็นผ่านตากันมาบ้างแล้วตลอดทั้งเล่ม แต่เรายังไม่เคยเห็นศักยภาพเต็มรูปแบบของมันเลย ไปลุยกันต่อเลย!
แพตเทิร์นและการจับคู่
แพตเทิร์น (pattern) เป็นไวยากรณ์พิเศษใน Rust สำหรับจับคู่กับโครงสร้างของชนิดข้อมูล ทั้งแบบซับซ้อนและแบบเรียบง่าย การใช้แพตเทิร์นร่วมกับนิพจน์ (expression) match และโครงสร้างคำสั่งอื่น ๆ จะช่วยให้คุณควบคุมลำดับการทำงาน (control flow) ของโปรแกรมได้อย่างยืดหยุ่นและแม่นยำยิ่งขึ้น แพตเทิร์นประกอบไปด้วยองค์ประกอบเหล่านี้ผสมผสานกัน:
- ค่าลิเทอรัล (literals)
- อาร์เรย์ (array), enum, struct หรือทูเพิล (tuple) ที่แยกส่วนโครงสร้างข้อมูล (destructured)
- ตัวแปร (variables)
- ไวลด์การ์ด (wildcards)
- ตัวแทนตำแหน่ง (placeholders)
ตัวอย่างของแพตเทิร์น เช่น x, (a, 3) และ Some(Color::Red) ในบริบทที่สามารถใช้งานแพตเทิร์นได้ ส่วนประกอบเหล่านี้จะทำหน้าที่อธิบายรูปทรงของข้อมูล จากนั้นโปรแกรมจะนำค่าต่าง ๆ มาเปรียบเทียบจับคู่กับแพตเทิร์น เพื่อตัดสินว่าข้อมูลนั้นมีรูปทรงที่ถูกต้องตรงตามเงื่อนไขที่จะรันโค้ดส่วนดังกล่าวต่อไปหรือไม่
ในการใช้งานแพตเทิร์น เราจะนำมันไปเปรียบเทียบกับค่าใดค่าหนึ่ง หากแพตเทิร์นจับคู่กับค่านั้นได้สำเร็จ เราจะสามารถนำชิ้นส่วนต่าง ๆ ของค่านั้นไปใช้งานในโค้ดของเราได้ ย้อนกลับไปดูนิพจน์ match ในบทที่ 6 ที่ใช้แพตเทิร์น เช่น ตัวอย่างเครื่องแยกเหรียญ หากค่าของเหรียญตรงกับรูปทรงของแพตเทิร์น เราก็จะสามารถหยิบชิ้นส่วนที่ตั้งชื่อไว้ไปใช้งานได้ แต่หากไม่ตรง โค้ดส่วนที่ผูกไว้กับแพตเทิร์นนั้นก็จะไม่ถูกเรียกทำงาน
บทนี้จะเป็นคู่มืออ้างอิงครอบคลุมทุกแง่มุมที่เกี่ยวข้องกับแพตเทิร์น โดยเราจะพาไปดูจุดต่าง ๆ ในโค้ดที่สามารถนำแพตเทิร์นไปใช้งานได้, ความแตกต่างระหว่างแพตเทิร์นที่อาจจับคู่ไม่สำเร็จ (refutable pattern) กับแพตเทิร์นที่จับคู่สำเร็จเสมอ (irrefutable pattern) ตลอดจนไวยากรณ์ของแพตเทิร์นแบบต่าง ๆ ที่คุณอาจได้พบเจอ เมื่อศึกษาบทนี้จบ คุณจะรู้วิธีนำแพตเทิร์นไปประยุกต์ใช้เพื่อสื่อสารแนวคิดต่าง ๆ ในโค้ดได้อย่างชัดเจนและกระชับ
ทุกจุดที่ใช้แพตเทิร์นได้
ทุกจุดที่ใช้แพตเทิร์นได้
แพตเทิร์นปรากฏอยู่ในหลายจุดทั่วทั้งภาษา Rust และความจริงแล้วคุณอาจได้ใช้งานมันมาบ่อยครั้งโดยไม่รู้ตัว! หัวข้อนี้จะพาไปสำรวจทุกตำแหน่งในโค้ดที่สามารถนำแพตเทิร์นไปใช้งานได้
อาร์มของ match
ดังที่เราได้พูดคุยกันในบทที่ 6 เราใช้แพตเทิร์นในอาร์ม (arm) ของนิพจน์ match โดยตามรูปแบบโครงสร้างแล้ว นิพจน์ match ถูกนิยามขึ้นจากคีย์เวิร์ด match, ค่าที่ต้องการนำมาเปรียบเทียบจับคู่ และอาร์มของ match อย่างน้อยหนึ่งอาร์มขึ้นไป ซึ่งแต่ละอาร์มจะประกอบด้วยแพตเทิร์นและนิพจน์ที่จะถูกประมวลผล หากค่านั้นจับคู่กับแพตเทิร์นของอาร์มดังกล่าวได้สำเร็จ ดังนี้:
match VALUE {
PATTERN => EXPRESSION,
PATTERN => EXPRESSION,
PATTERN => EXPRESSION,
}ตัวอย่างเช่น นี่คือนิพจน์ match จากลิสติ้ง 6-5 ที่จับคู่กับค่า Option<i32> ในตัวแปร x:
match x {
None => None,
Some(i) => Some(i + 1),
}แพตเทิร์นในนิพจน์ match นี้คือ None และ Some(i) ซึ่งอยู่ทางด้านซ้ายของลูกศรในแต่ละบรรทัด
ข้อกำหนดสำคัญประการหนึ่งของนิพจน์ match คือ มันต้องครอบคลุมครบถ้วนทุกกรณี (exhaustive) ซึ่งหมายความว่า ทุกความเป็นไปได้ของค่าในนิพจน์ match จะต้องถูกนำมาพิจารณาและจัดการทั้งหมด วิธีหนึ่งที่จะช่วยรับประกันว่าคุณได้ครอบคลุมครบทุกกรณีแล้ว คือการมีแพตเทิร์นแบบครอบคลุมทั้งหมด (catch-all pattern) ไว้ในอาร์มสุดท้าย ตัวอย่างเช่น การใช้ชื่อตัวแปรที่สามารถจับคู่กับค่าใด ๆ ก็ได้ ซึ่งไม่มีวันจับคู่ล้มเหลว จึงช่วยเก็บตกทุกกรณีที่เหลืออยู่ได้ทั้งหมด
โดยเฉพาะแพตเทิร์น _ นั้นจะสามารถจับคู่ได้กับทุกค่า แต่จะไม่ผูกค่านั้นเข้ากับตัวแปรใด ๆ จึงมักนิยมนำมาใช้ในอาร์มสุดท้ายของ match ตัวอย่างเช่น แพตเทิร์น _ จะมีประโยชน์อย่างยิ่งเมื่อคุณต้องการเพิกเฉยต่อค่าอื่น ๆ ทั้งหมดที่ไม่ได้ระบุไว้ เราจะอธิบายรายละเอียดของแพตเทิร์น _ เพิ่มเติมในหัวข้อ “การเพิกเฉยต่อค่าในแพตเทิร์น” ในช่วงท้ายของบทนี้
สเตตเมนต์ let
ก่อนจะถึงบทนี้ เราได้พูดถึงการใช้แพตเทิร์นกับ match และ if let เป็นหลัก แต่ความจริงแล้ว เรายังใช้แพตเทิร์นในจุดอื่น ๆ อีกด้วย รวมถึงในสเตตเมนต์ (statement) let ตัวอย่างเช่น ลองพิจารณาการกำหนดค่าตัวแปรแบบเรียบง่ายด้วย let ต่อไปนี้:
#![allow(unused)]
fn main() {
let x = 5;
}ทุกครั้งที่คุณใช้สเตตเมนต์ let เช่นนี้ คุณกำลังใช้งานแพตเทิร์นอยู่ แม้คุณอาจจะไม่ทันสังเกตก็ตาม! โดยตามโครงสร้างที่เป็นทางการแล้ว สเตตเมนต์ let จะมีรูปแบบดังนี้:
let PATTERN = EXPRESSION;
ในสเตตเมนต์อย่าง let x = 5; ที่มีชื่อตัวแปรอยู่ในตำแหน่ง PATTERN นั้น ชื่อตัวแปรก็เป็นเพียงรูปแบบหนึ่งของแพตเทิร์นที่เรียบง่ายมาก โดย Rust จะเปรียบเทียบนิพจน์ทางขวากับแพตเทิร์นทางซ้าย แล้วผูกค่าเข้ากับชื่อตัวแปรทั้งหมดที่พบ ดังนั้นในตัวอย่าง let x = 5; ตัว x จึงเป็นแพตเทิร์นที่มีความหมายว่า “จงผูกค่าที่จับคู่ได้ตรงนี้เข้ากับตัวแปร x” และเพราะชื่อ x เป็นตัวแทนของแพตเทิร์นทั้งหมด มันจึงหมายถึง “ผูกค่าทุกอย่างเข้ากับตัวแปร x ไม่ว่าค่านั้นจะเป็นอะไรก็ตาม”
เพื่อให้เห็นภาพของการจับคู่แพตเทิร์น (pattern matching) ใน let ได้ชัดเจนยิ่งขึ้น ลองพิจารณาลิสติ้ง 19-1 ซึ่งใช้แพตเทิร์นร่วมกับ let เพื่อแยกส่วนโครงสร้างข้อมูล (destructure) ของทูเพิล
fn main() {
let (x, y, z) = (1, 2, 3);
}ในที่นี้ เราได้นำทูเพิลมาจับคู่กับแพตเทิร์น โดย Rust จะเปรียบเทียบค่า (1, 2, 3) เข้ากับแพตเทิร์น (x, y, z) และพบว่าค่านั้นตรงกับแพตเทิร์น กล่าวคือ จำนวนสมาชิกของทั้งสองฝั่งเท่ากันพอดี Rust จึงผูกค่า 1 เข้ากับ x, 2 เข้ากับ y และ 3 เข้ากับ z คุณสามารถมองได้ว่าแพตเทิร์นทูเพิลนี้ คือการนำแพตเทิร์นตัวแปรเดี่ยว ๆ สามตัวมาซ้อนไว้ข้างใน
หากจำนวนสมาชิกในแพตเทิร์นไม่ตรงกับจำนวนสมาชิกในทูเพิล ชนิดข้อมูลโดยรวมจะไม่ตรงกัน และเราจะได้รับข้อผิดพลาดจากคอมไพเลอร์ ตัวอย่างเช่น ในลิสติ้ง 19-2 เราพยายามแยกส่วนทูเพิลที่มีสามสมาชิกออกเป็นสองตัวแปร ซึ่งจะทำงานไม่สำเร็จ
fn main() {
let (x, y) = (1, 2, 3);
}การพยายามคอมไพล์โค้ดนี้จะส่งผลให้เกิดข้อผิดพลาดทางชนิดข้อมูลดังนี้:
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
error[E0308]: mismatched types
--> src/main.rs:2:9
|
2 | let (x, y) = (1, 2, 3);
| ^^^^^^ --------- this expression has type `({integer}, {integer}, {integer})`
| |
| expected a tuple with 3 elements, found one with 2 elements
|
= note: expected tuple `({integer}, {integer}, {integer})`
found tuple `(_, _)`
For more information about this error, try `rustc --explain E0308`.
error: could not compile `patterns` (bin "patterns") due to 1 previous error
ในการแก้ไขข้อผิดพลาดนี้ เราสามารถเลือกที่จะละเว้นหรือเพิกเฉยต่อค่าบางค่าในทูเพิลได้โดยใช้เครื่องหมาย _ หรือ .. ดังที่คุณจะได้เห็นในหัวข้อ “การเพิกเฉยต่อค่าในแพตเทิร์น” แต่หากปัญหาเกิดจากการที่เราใส่ตัวแปรในแพตเทิร์นไว้มากเกินไป ทางแก้ก็คือปรับให้ชนิดข้อมูลตรงกัน โดยการตัดตัวแปรส่วนเกินออก เพื่อให้จำนวนตัวแปรเท่ากับจำนวนสมาชิกในทูเพิลพอดี
เอ็กซ์เพรสชัน if let แบบมีเงื่อนไข
ในบทที่ 6 เราได้อธิบายการใช้งานนิพจน์ if let โดยหลักแล้วเพื่อเป็นวิธีเขียนแบบสั้นที่เทียบเท่ากับ match ที่ต้องการจับคู่เพียงกรณีเดียว นอกจากนี้ if let ยังสามารถมีบล็อก else ควบคู่กัน ซึ่งบรรจุโค้ดที่จะทำงานเมื่อแพตเทิร์นใน if let จับคู่ไม่สำเร็จ
ลิสติ้ง 19-3 แสดงให้เห็นว่าเราสามารถนำนิพจน์ if let, else if และ else if let มาผสมผสานเข้าด้วยกันได้ ซึ่งจะให้ความยืดหยุ่นมากกว่านิพจน์ match ที่กำหนดให้เราส่งค่าเข้าเปรียบเทียบกับแพตเทิร์นได้เพียงค่าเดียว ยิ่งไปกว่านั้น Rust ไม่ได้บังคับว่าเงื่อนไขในสายของ if let, else if และ else if let จะต้องมีความเกี่ยวข้องกันแต่อย่างใด
โค้ดในลิสติ้ง 19-3 จะตัดสินใจเลือกว่าสีพื้นหลังควรเป็นสีอะไร โดยตรวจสอบเงื่อนไขหลายประการต่อเนื่องกัน สำหรับตัวอย่างนี้ เราได้สร้างตัวแปรที่กำหนดค่าคงที่ไว้ล่วงหน้า (hardcode) ซึ่งในโปรแกรมจริงอาจเป็นค่าที่ได้รับมาจากผู้ใช้
fn main() {
let favorite_color: Option<&str> = None;
let is_tuesday = false;
let age: Result<u8, _> = "34".parse();
if let Some(color) = favorite_color {
println!("Using your favorite color, {color}, as the background");
} else if is_tuesday {
println!("Tuesday is green day!");
} else if let Ok(age) = age {
if age > 30 {
println!("Using purple as the background color");
} else {
println!("Using orange as the background color");
}
} else {
println!("Using blue as the background color");
}
}หากผู้ใช้ระบุสีที่ชอบ สีนั้นจะถูกนำไปใช้เป็นสีพื้นหลัง แต่ถ้าไม่ได้ระบุสีที่ชอบไว้และวันนี้เป็นวันอังคาร สีพื้นหลังจะกลายเป็นสีเขียว หรือหากผู้ใช้ระบุอายุเป็นสตริงและเราสามารถแปลง (parse) เป็นตัวเลขได้สำเร็จ สีพื้นหลังก็จะเป็นสีม่วงหรือสีส้มขึ้นอยู่กับค่าของตัวเลขนั้น และหากไม่ตรงกับเงื่อนไขใด ๆ เลย สีพื้นหลังก็จะเป็นสีน้ำเงิน
โครงสร้างเงื่อนไขแบบนี้ช่วยให้เรารองรับความต้องการที่ซับซ้อนได้เป็นอย่างดี จากค่าที่กำหนดไว้ในตัวอย่างนี้ โปรแกรมจะพิมพ์ Using purple as the background color
คุณจะสังเกตเห็นว่า if let สามารถประกาศตัวแปรใหม่ที่บดบัง (shadow) ตัวแปรเดิมที่มีอยู่ได้ในลักษณะเดียวกับอาร์มของ match: เช่นในบรรทัด if let Ok(age) = age จะสร้างตัวแปร age ตัวใหม่ขึ้นมาเพื่อเก็บค่าที่อยู่ภายในวาเรียนต์ Ok ซึ่งจะไปบดบังตัวแปร age ตัวเดิม สิ่งนี้ทำให้เราต้องวางเงื่อนไข if age > 30 ไว้ภายในบล็อกนั้น: เราไม่สามารถรวมเงื่อนไขทั้งสองเข้าด้วยกันเป็น if let Ok(age) = age && age > 30 ได้ เพราะตัวแปร age ตัวใหม่ที่เราต้องการนำไปเปรียบเทียบกับ 30 จะยังไม่มีผลให้เรียกใช้ได้ จนกว่าจะเริ่มขอบเขตการทำงาน (scope) ใหม่หลังวงเล็บปีกกาเปิด
ข้อเสียของการใช้นิพจน์ if let คือคอมไพเลอร์จะไม่ช่วยตรวจสอบความครอบคลุมทุกกรณี (exhaustiveness) เหมือนอย่างที่ทำให้นิพจน์ match หากเราละเว้นบล็อก else สุดท้ายไปจนทำให้ตกหล่นบางกรณี คอมไพเลอร์จะไม่สามารถแจ้งเตือนให้เราทราบถึงบั๊กทางตรรกะที่อาจเกิดขึ้นได้
ลูปแบบมีเงื่อนไข while let
ลูปแบบมีเงื่อนไข while let มีโครงสร้างคล้ายกับ if let โดยอนุญาตให้ลูป while วนทำงานต่อไปได้เรื่อย ๆ ตราบเท่าที่แพตเทิร์นยังคงจับคู่ได้สำเร็จ ในลิสติ้ง 19-4 เราจะแสดงลูป while let ที่คอยรอรับข้อความที่ส่งระหว่างเธรด (threads) แต่ในกรณีนี้จะตรวจสอบค่า Result แทนที่จะเป็น Option
fn main() {
let (tx, rx) = std::sync::mpsc::channel();
std::thread::spawn(move || {
for val in [1, 2, 3] {
tx.send(val).unwrap();
}
});
while let Ok(value) = rx.recv() {
println!("{value}");
}
}ตัวอย่างนี้จะพิมพ์ 1, 2 และ 3 ออกมาตามลำดับ เมธอด recv จะดึงข้อความแรกออกจากฝั่งตัวรับของแชนเนล (channel) และคืนค่า Ok(value) กลับมา เมื่อตอนที่เราพบกับ recv ครั้งแรกในบทที่ 16 เราได้ unwrap ผลลัพธ์โดยตรง หรือไม่ก็วนลูปจัดการกับมันในฐานะอิเทอเรเตอร์ (iterator) ด้วยลูป for แต่ดังที่ลิสติ้ง 19-4 แสดงให้เห็น เราสามารถใช้ while let ได้เช่นกัน เพราะเมธอด recv จะส่งคืนค่า Ok ออกมาทุกครั้งที่มีข้อความมาถึง ตราบใดที่ฝั่งผู้ส่งยังคงอยู่ และจะคืนค่า Err เมื่อฝั่งผู้ส่งตัดการเชื่อมต่อไปแล้ว
ลูป for
ในลูป for ค่าที่ตามหลังคีย์เวิร์ด for โดยตรงก็คือแพตเทิร์น ตัวอย่างเช่น ในคำสั่ง for x in y ตัว x ก็คือแพตเทิร์น ลิสติ้ง 19-5 สาธิตการใช้แพตเทิร์นในลูป for เพื่อแยกส่วนโครงสร้างข้อมูล (destructure) ของทูเพิลออกมาขณะวนลูป
fn main() {
let v = vec!['a', 'b', 'c'];
for (index, value) in v.iter().enumerate() {
println!("{value} is at index {index}");
}
}โค้ดในลิสติ้ง 19-5 จะพิมพ์ผลลัพธ์ต่อไปนี้ออกมา:
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.52s
Running `target/debug/patterns`
a is at index 0
b is at index 1
c is at index 2
เราปรับแต่งอิเทอเรเตอร์ด้วยเมธอด enumerate เพื่อให้ส่งคืนค่าพร้อมกับดัชนี (index) ของค่านั้นออกมาเป็นคู่ทูเพิล โดยค่าแรกที่ได้คือทูเพิล (0, 'a') และเมื่อนำไปจับคู่กับแพตเทิร์น (index, value) ตัวแปร index ก็จะได้ค่า 0 และ value ได้ค่า 'a' จึงพิมพ์บรรทัดแรกของผลลัพธ์ออกมา
พารามิเตอร์ของฟังก์ชัน
พารามิเตอร์ของฟังก์ชันก็สามารถเป็นแพตเทิร์นได้เช่นกัน โค้ดในลิสติ้ง 19-6 ซึ่งประกาศฟังก์ชันชื่อ foo ที่รับพารามิเตอร์หนึ่งตัวชื่อ x ชนิด i32 ตอนนี้น่าจะดูคุ้นตาเป็นอย่างดีแล้ว
fn foo(x: i32) {
// code goes here
}
fn main() {}ส่วน x ตรงนั้นก็คือแพตเทิร์น! เช่นเดียวกับที่เราทำกับ let เราสามารถนำแพตเทิร์นมาจับคู่กับทูเพิลในอาร์กิวเมนต์ของฟังก์ชันได้ ลิสติ้ง 19-7 แสดงการแยกส่วนค่าในทูเพิลขณะส่งผ่านเข้าไปยังฟังก์ชัน
fn print_coordinates(&(x, y): &(i32, i32)) {
println!("Current location: ({x}, {y})");
}
fn main() {
let point = (3, 5);
print_coordinates(&point);
}โค้ดนี้จะพิมพ์ Current location: (3, 5) ออกมา โดยค่า &(3, 5) จะจับคู่เข้ากับแพตเทิร์น &(x, y) ทำให้ x ได้รับค่า 3 และ y ได้รับค่า 5
นอกจากนี้ เรายังสามารถใช้แพตเทิร์นในรายการพารามิเตอร์ของโคลเชอร์ (closure) ได้ในทำนองเดียวกับพารามิเตอร์ของฟังก์ชัน เพราะโคลเชอร์มีลักษณะคล้ายคลึงกับฟังก์ชันดังที่เราได้พูดคุยกันไปในบทที่ 13
มาถึงจุดนี้ คุณได้เห็นวิธีนำแพตเทิร์นไปประยุกต์ใช้ในหลากหลายรูปแบบแล้ว แต่แพตเทิร์นไม่ได้มีพฤติกรรมเหมือนกันหมดในทุกตำแหน่ง ในบางจุด แพตเทิร์นจำเป็นต้องเป็นแบบที่จับคู่สำเร็จเสมอ (irrefutable) ขณะที่ในบางสถานการณ์ ก็สามารถเป็นแบบที่อาจจับคู่ไม่สำเร็จได้ (refutable) เราจะไปเจาะลึกสองแนวคิดนี้กันในหัวข้อถัดไป
ความสามารถในการค้าน: แพตเทิร์นอาจจับคู่ไม่สำเร็จหรือไม่
ความสามารถในการค้าน: แพตเทิร์นอาจจับคู่ไม่สำเร็จหรือไม่
แพตเทิร์น (pattern) แบ่งออกเป็นสองรูปแบบ ได้แก่: แพตเทิร์นที่อาจจับคู่ไม่สำเร็จ (refutable pattern) และแพตเทิร์นที่จับคู่สำเร็จเสมอ (irrefutable pattern) โดยแพตเทิร์นที่จะจับคู่สำเร็จกับทุกค่าที่เป็นไปได้เสมอ จัดเป็น แพตเทิร์นที่จับคู่สำเร็จเสมอ (irrefutable) ตัวอย่างเช่น x ในคำสั่ง let x = 5; เพราะ x สามารถจับคู่ได้กับทุกค่า จึงไม่มีทางที่จะจับคู่ไม่สำเร็จ ส่วนแพตเทิร์นที่มีโอกาสจับคู่ไม่สำเร็จกับบางค่า จัดเป็น แพตเทิร์นที่อาจจับคู่ไม่สำเร็จ (refutable) ตัวอย่างเช่น Some(x) ในนิพจน์ if let Some(x) = a_value เพราะหากค่าในตัวแปร a_value เป็น None แทนที่จะเป็น Some แพตเทิร์น Some(x) ย่อมจับคู่ไม่สำเร็จ
พารามิเตอร์ของฟังก์ชัน, สเตตเมนต์ let และลูป for จะรับได้เฉพาะแพตเทิร์นที่จับคู่สำเร็จเสมอเท่านั้น เพราะโปรแกรมไม่สามารถดำเนินการอะไรต่อได้อย่างสมเหตุสมผลหากค่าที่ได้ไม่ตรงกับแพตเทิร์น ส่วนนิพจน์ if let, while let และสเตตเมนต์ let...else นั้นยอมรับได้ทั้งแพตเทิร์นที่อาจจับคู่ไม่สำเร็จและแพตเทิร์นที่จับคู่สำเร็จเสมอ ทว่าคอมไพเลอร์จะแจ้งเตือนเมื่อใช้แพตเทิร์นที่จับคู่สำเร็จเสมอ เพราะโดยนิยามแล้ว โครงสร้างเหล่านี้มีจุดประสงค์เพื่อรับมือกับกรณีที่อาจไม่ตรงเงื่อนไข ซึ่งหน้าที่หลักของคำสั่งเงื่อนไขคือการเลือกทำงานแตกต่างกันไปตามผลลัพธ์ว่าสำเร็จหรือไม่
โดยทั่วไปแล้ว คุณแทบไม่ต้องกังวลถึงความแตกต่างระหว่างแพตเทิร์นทั้งสองแบบนี้เลย อย่างไรก็ตาม คุณจำเป็นต้องเข้าใจแนวคิดเรื่องความสามารถในการค้าน (refutability) เอาไว้ เพื่อให้สามารถแก้ไขโค้ดได้ทันทีเมื่อพบคำนี้ในข้อความแจ้งข้อผิดพลาด (error message) ซึ่งในกรณีดังกล่าว คุณจะต้องปรับเปลี่ยนตัวแพตเทิร์น หรือไม่ก็เปลี่ยนโครงสร้างคำสั่งที่นำแพตเทิร์นนั้นไปใช้งาน ทั้งนี้ขึ้นอยู่กับพฤติกรรมที่ต้องการให้โค้ดทำงาน
ลองมาดูตัวอย่างว่าเกิดอะไรขึ้นเมื่อเราพยายามนำแพตเทิร์นที่อาจจับคู่ไม่สำเร็จไปใช้ในจุดที่ Rust กำหนดให้ต้องเป็นแพตเทิร์นที่จับคู่สำเร็จเสมอ และในทางกลับกัน ลิสติ้ง 19-8 แสดงสเตตเมนต์ let ที่กำหนดแพตเทิร์นเป็น Some(x) ซึ่งเป็นแพตเทิร์นที่อาจจับคู่ไม่สำเร็จ แน่นอนว่าโค้ดนี้จะไม่ผ่านการคอมไพล์
fn main() {
let some_option_value: Option<i32> = None;
let Some(x) = some_option_value;
}หาก some_option_value มีค่าเป็น None ก็จะไม่สามารถจับคู่กับแพตเทิร์น Some(x) ได้ ซึ่งหมายความว่าแพตเทิร์นนี้มีโอกาสจับคู่ไม่สำเร็จ (refutable) แต่สเตตเมนต์ let ยอมรับได้เฉพาะแพตเทิร์นที่จับคู่สำเร็จเสมอเท่านั้น เพราะตัวโค้ดไม่มีทางรู้เลยว่าจะต้องทำอย่างไรต่อไปหากได้ค่า None มา ตอนคอมไพล์ Rust จึงแจ้งข้อผิดพลาดว่าเราพยายามนำแพตเทิร์นที่อาจจับคู่ไม่สำเร็จไปใช้ในจุดที่ต้องเป็นแพตเทิร์นที่จับคู่สำเร็จเสมอ:
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
error[E0005]: refutable pattern in local binding
--> src/main.rs:3:9
|
3 | let Some(x) = some_option_value;
| ^^^^^^^ pattern `None` not covered
|
= note: `let` bindings require an "irrefutable pattern", like a `struct` or an `enum` with only one variant
= note: for more information, visit https://doc.rust-lang.org/book/ch19-02-refutability.html
= note: the matched value is of type `Option<i32>`
help: you might want to use `let...else` to handle the variant that isn't matched
|
3 | let Some(x) = some_option_value else { todo!() };
| ++++++++++++++++
For more information about this error, try `rustc --explain E0005`.
error: could not compile `patterns` (bin "patterns") due to 1 previous error
เนื่องจากแพตเทิร์น Some(x) ไม่ได้ครอบคลุม (และไม่มีทางครอบคลุมได้ทั้งหมด!) ทุกค่าที่เป็นไปได้ Rust จึงแจ้งข้อผิดพลาดจากการคอมไพล์อย่างถูกต้องสมเหตุสมผล
หากเราต้องการใช้แพตเทิร์นที่อาจจับคู่ไม่สำเร็จในตำแหน่งที่จำเป็นต้องเป็นแพตเทิร์นที่จับคู่สำเร็จเสมอ เราสามารถแก้ไขได้ด้วยการปรับเปลี่ยนโครงสร้างของโค้ด: โดยแทนที่จะใช้ let ปกติ เราสามารถเปลี่ยนมาใช้ let...else แทน ซึ่งหากแพตเทิร์นไม่ตรงกับค่าที่ได้ โค้ดในบล็อกวงเล็บปีกกาจะเข้ามาจัดการต่อให้ ลิสติ้ง 19-9 แสดงวิธีแก้ไขโค้ดจากลิสติ้ง 19-8
fn main() {
let some_option_value: Option<i32> = None;
let Some(x) = some_option_value else {
return;
};
}เท่านี้โค้ดของเราก็มีทางออกเมื่อไม่ตรงเงื่อนไขแล้ว! โค้ดนี้จึงถูกต้องและทำงานได้สมบูรณ์ ทว่าในทางกลับกัน หากเรานำแพตเทิร์นที่จับคู่สำเร็จเสมอมาใช้กับ let...else คอมไพเลอร์ก็จะแจ้งคำเตือน ดังตัวอย่างในลิสติ้ง 19-10 ที่เรากำหนดแพตเทิร์นให้ let...else เป็น x ซึ่งเป็นแพตเทิร์นที่จับคู่สำเร็จเสมอ
fn main() {
let x = 5 else {
return;
};
}Rust จะแจ้งเตือนว่าการใช้ let...else ร่วมกับแพตเทิร์นที่จับคู่สำเร็จเสมอนั้นไม่สมเหตุสมผล เพราะบล็อก else จะไม่มีวันถูกเรียกทำงานเลย:
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
warning: unreachable `else` clause
--> src/main.rs:2:15
|
2 | let x = 5 else {
| --------- ^^^^
| |
| assigning to binding pattern will always succeed
|
= note: this pattern always matches, so the else clause is unreachable
= note: `#[warn(irrefutable_let_patterns)]` on by default
warning: `patterns` (bin "patterns") generated 1 warning
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.39s
Running `target/debug/patterns`
ด้วยเหตุนี้ แต่ละอาร์มของ match จึงต้องใช้แพตเทิร์นที่อาจจับคู่ไม่สำเร็จ ยกเว้นอาร์มสุดท้ายที่ควรจับคู่ค่าที่เหลืออยู่ทั้งหมดด้วยแพตเทิร์นที่จับคู่สำเร็จเสมอ ทั้งนี้ Rust อนุญาตให้เราใช้แพตเทิร์นที่จับคู่สำเร็จเสมอใน match ที่มีเพียงอาร์มเดียวได้ แต่ไวยากรณ์รูปแบบนี้ไม่ได้มีประโยชน์อะไรเป็นพิเศษ และสามารถแทนที่ด้วยคำสั่ง let ธรรมดาที่กระชับกว่าได้
เมื่อเราได้เรียนรู้ตำแหน่งต่าง ๆ ที่สามารถนำแพตเทิร์นไปใช้งาน รวมถึงความแตกต่างระหว่างแพตเทิร์นที่อาจจับคู่ไม่สำเร็จและแพตเทิร์นที่จับคู่สำเร็จเสมอแล้ว ในหัวข้อถัดไป เราจะมาดูไวยากรณ์ทั้งหมดที่ใช้สร้างแพตเทิร์นกัน
วากยสัมพันธ์ของแพตเทิร์น
วากยสัมพันธ์ของแพตเทิร์น
ในหัวข้อนี้ เรารวบรวมไวยากรณ์และรูปแบบทั้งหมดที่ใช้ได้กับแพตเทิร์น (pattern) รวมถึงพูดคุยว่าเหตุใดและเมื่อใดที่คุณควรเลือกใช้งานแต่ละรูปแบบ
การจับคู่ค่าลิเทอรัล
ดังที่คุณได้เห็นในบทที่ 6 เราสามารถนำแพตเทิร์นไปจับคู่กับค่าลิเทอรัล (literal) ได้โดยตรง ดังตัวอย่างโค้ดต่อไปนี้:
fn main() {
let x = 1;
match x {
1 => println!("one"),
2 => println!("two"),
3 => println!("three"),
_ => println!("anything"),
}
}โค้ดนี้จะพิมพ์ one ออกมา เนื่องจากค่าใน x คือ 1 ไวยากรณ์รูปแบบนี้มีประโยชน์อย่างยิ่งเมื่อคุณต้องการให้โค้ดทำงานบางอย่าง เมื่อได้รับค่าที่เจาะจงค่าใดค่าหนึ่งโดยเฉพาะ
การจับคู่ตัวแปรที่มีชื่อ
ตัวแปรที่มีชื่อจัดเป็นแพตเทิร์นที่จับคู่สำเร็จเสมอ (irrefutable pattern) ซึ่งสามารถจับคู่ได้กับทุกค่า และเราได้ใช้งานรูปแบบนี้กันมาหลายครั้งตลอดทั้งเล่ม อย่างไรก็ตาม ความซับซ้อนจะเกิดขึ้นเมื่อคุณนำตัวแปรที่มีชื่อไปใช้ในนิพจน์ match, if let หรือ while let เนื่องจากนิพจน์เหล่านี้จะสร้างสโคปใหม่ขึ้นมาเสมอ ตัวแปรที่ประกาศขึ้นเป็นส่วนหนึ่งของแพตเทิร์นภายในนิพจน์เหล่านี้จึงจะไปบดบัง (shadow) ตัวแปรที่มีชื่อเดียวกันซึ่งอยู่นอกโครงสร้างคำสั่งนั้น เช่นเดียวกับพฤติกรรมปกติของตัวแปรทั่วไป ในลิสติ้ง 19-11 เราประกาศตัวแปรชื่อ x ที่เก็บค่า Some(5) และตัวแปร y ที่เก็บค่า 10 จากนั้นสร้างนิพจน์ match สำหรับค่า x ลองพิจารณาแพตเทิร์นในแต่ละอาร์มของ match และคำสั่ง println! ตอนท้าย แล้วลองคาดเดาดูว่าโค้ดจะพิมพ์อะไรออกมาก่อนที่คุณจะรันโค้ดหรืออ่านคำอธิบายถัดไป
fn main() {
let x = Some(5);
let y = 10;
match x {
Some(50) => println!("Got 50"),
Some(y) => println!("Matched, y = {y}"),
_ => println!("Default case, x = {x:?}"),
}
println!("at the end: x = {x:?}, y = {y}");
}มาดูการทำงานทีละขั้นเมื่อนิพจน์ match ทำงานกัน แพตเทิร์นในอาร์มแรกของ match จะจับคู่ไม่ตรงกับค่า x ที่กำหนดไว้ โค้ดจึงทำงานต่อไปยังอาร์มถัดไป
แพตเทิร์นในอาร์มที่สองของ match ประกาศตัวแปรใหม่ชื่อ y ซึ่งจะจับคู่กับค่าใดก็ตามที่อยู่ภายในค่า Some และเนื่องจากเราอยู่ในสโคปใหม่ภายในนิพจน์ match นี่จึงเป็นตัวแปร y ตัวใหม่ ไม่ใช่ตัวแปร y ที่เราประกาศไว้ตอนต้นด้วยค่า 10 การผูกค่า (binding) y ใหม่นี้จะจับคู่กับค่าใดก็ได้ที่อยู่ภายใน Some ซึ่งก็คือค่าที่มีอยู่ใน x ดังนั้น y ใหม่นี้จึงผูกเข้ากับค่าภายในของ Some ใน x ซึ่งมีค่าเป็น 5 นิพจน์ของอาร์มนั้นจึงทำงานและพิมพ์ Matched, y = 5 ออกมา
หาก x มีค่าเป็น None แทนที่จะเป็น Some(5) แพตเทิร์นในสองอาร์มแรกจะไม่ตรงเงื่อนไข ค่านั้นจึงจะถูกจับคู่ด้วยเครื่องหมายขีดล่าง (underscore) และเนื่องจากเราไม่ได้ประกาศตัวแปร x ขึ้นมาใหม่ในแพตเทิร์นของอาร์มขีดล่าง ตัวแปร x ในบล็อกนั้นจึงยังคงเป็น x ตัวนอกที่ไม่ถูกบดบัง ในกรณีสมมตินี้ match จะพิมพ์ Default case, x = None
เมื่อนิพจน์ match ทำงานเสร็จสิ้น สโคปของมันก็จะสิ้นสุดลง และสโคปของ y ตัวในก็สิ้นสุดลงด้วยเช่นกัน คำสั่ง println! ตัวสุดท้ายจึงให้ผลลัพธ์เป็น at the end: x = Some(5), y = 10
หากเราต้องการสร้างนิพจน์ match ที่เปรียบเทียบค่าของ x กับ y ตัวนอก แทนที่จะเป็นการประกาศตัวแปรใหม่ที่บดบังตัวแปร y เดิม เราจะต้องใช้เงื่อนไขการ์ด match (match guard) เข้ามาช่วย ซึ่งเราจะอธิบายเรื่องการ์ด match ต่อไปในหัวข้อ“การเพิ่มเงื่อนไขด้วยการ์ด match”
การจับคู่หลายแพตเทิร์น
ในนิพจน์ match คุณสามารถจับคู่กับหลายแพตเทิร์นได้ด้วยสัญลักษณ์ | ซึ่งทำหน้าที่เป็นตัวดำเนินการ หรือ (or) ของแพตเทิร์น ตัวอย่างเช่น ในโค้ดต่อไปนี้ เราจับคู่ค่าของ x กับอาร์มต่าง ๆ ของ match โดยอาร์มแรกมีตัวเลือกแบบ หรือ ซึ่งหมายความว่าหากค่าของ x ตรงกับค่าใดค่าหนึ่งในอาร์มนั้น โค้ดของอาร์มดังกล่าวก็จะทำงาน:
fn main() {
let x = 1;
match x {
1 | 2 => println!("one or two"),
3 => println!("three"),
_ => println!("anything"),
}
}โค้ดนี้จะพิมพ์ one or two
การจับคู่ช่วงของค่าด้วย ..=
ไวยากรณ์ ..= ช่วยให้เราจับคู่กับช่วงของค่าแบบรวมจุดสิ้นสุด (inclusive range) ได้ ในโค้ดต่อไปนี้ เมื่อแพตเทิร์นจับคู่ตรงกับค่าใดก็ตามที่อยู่ภายในช่วงที่กำหนด อาร์มนั้นจะทำงาน:
fn main() {
let x = 5;
match x {
1..=5 => println!("one through five"),
_ => println!("something else"),
}
}หาก x มีค่าเป็น 1, 2, 3, 4 หรือ 5 อาร์มแรกจะจับคู่สำเร็จ ไวยากรณ์นี้สะดวกกว่าการใช้ตัวดำเนินการ | เพื่อจับคู่หลาย ๆ ค่ามาก เพราะหากใช้ | เราจะต้องเขียนยาวเป็น 1 | 2 | 3 | 4 | 5 การกำหนดช่วงจึงกระชับกว่ากันมาก โดยเฉพาะอย่างยิ่งหากเราต้องการจับคู่กับตัวเลขจำนวนมาก เช่น ระหว่าง 1 ถึง 1,000!
คอมไพเลอร์จะตรวจสอบตั้งแต่ตอนคอมไพล์ว่าช่วงนั้นไม่ว่างเปล่า และเนื่องจากชนิดข้อมูลเดียวที่ Rust ตรวจสอบได้ว่าช่วงว่างเปล่าหรือไม่คือ char และชนิดข้อมูลตัวเลข การกำหนดช่วงจึงใช้ได้เฉพาะกับค่าตัวเลขหรือค่า char เท่านั้น
ตัวอย่างการใช้ช่วงกับค่าชนิด char:
fn main() {
let x = 'c';
match x {
'a'..='j' => println!("early ASCII letter"),
'k'..='z' => println!("late ASCII letter"),
_ => println!("something else"),
}
}Rust สามารถตรวจสอบได้ว่า 'c' อยู่ในช่วงของแพตเทิร์นแรก จึงพิมพ์ early ASCII letter ออกมา
การแยกโครงสร้างข้อมูลเพื่อแยกชิ้นส่วนค่า
เรายังสามารถใช้แพตเทิร์นเพื่อแยกส่วนประกอบหรือแยกโครงสร้างข้อมูล (destructure) ของ struct, enum และทูเพิล เพื่อนำชิ้นส่วนต่าง ๆ ของค่าเหล่านี้ไปใช้งานได้ ลองมาดูทีละกรณีกัน
struct
ในลิสติ้ง 19-12 แสดง struct Point ที่มีสองฟิลด์ (field) คือ x และ y ซึ่งเราสามารถแยกส่วนประกอบออกมาได้โดยใช้แพตเทิร์นร่วมกับสเตตเมนต์ let
struct Point {
x: i32,
y: i32,
}
fn main() {
let p = Point { x: 0, y: 7 };
let Point { x: a, y: b } = p;
assert_eq!(0, a);
assert_eq!(7, b);
}โค้ดนี้จะสร้างตัวแปร a และ b ที่จับคู่กับค่าของฟิลด์ x และ y ของ struct p ตัวอย่างนี้แสดงให้เห็นว่าชื่อของตัวแปรในแพตเทิร์นไม่จำเป็นต้องตรงกับชื่อฟิลด์ของ struct เสมอไป อย่างไรก็ตาม ในทางปฏิบัตินิยมตั้งชื่อตัวแปรให้ตรงกับชื่อฟิลด์เพื่อให้จดจำได้ง่ายว่าตัวแปรใดมาจากฟิลด์ไหน และเนื่องจากกรณีการใช้งานเช่นนี้พบได้บ่อยมาก ประกอบกับการเขียน let Point { x: x, y: y } = p; ก็มีส่วนซ้ำซ้อนกันอยู่ Rust จึงมีไวยากรณ์แบบย่อ (shorthand) สำหรับแพตเทิร์นที่จับคู่กับฟิลด์ของ struct โดยคุณเพียงแค่ระบุชื่อฟิลด์ของ struct เท่านั้น แล้วตัวแปรที่ถูกสร้างจากแพตเทิร์นก็จะมีชื่อเดียวกับฟิลด์นั้นโดยอัตโนมัติ ลิสติ้ง 19-13 ทำงานเหมือนกับโค้ดในลิสติ้ง 19-12 ทุกประการ เพียงแต่ตัวแปรที่ถูกสร้างในแพตเทิร์น let จะเป็น x และ y แทนที่จะเป็น a และ b
struct Point {
x: i32,
y: i32,
}
fn main() {
let p = Point { x: 0, y: 7 };
let Point { x, y } = p;
assert_eq!(0, x);
assert_eq!(7, y);
}โค้ดนี้จะสร้างตัวแปร x และ y ที่จับคู่กับฟิลด์ x และ y ของตัวแปร p ส่งผลให้ตัวแปร x และ y ได้รับค่ามาจาก struct p
นอกจากนี้ เรายังสามารถแยกโครงสร้างข้อมูลร่วมกับการจับคู่ค่าลิเทอรัลในแพตเทิร์นของ struct ได้ แทนที่จะต้องสร้างตัวแปรให้กับทุก ๆ ฟิลด์ วิธีนี้ช่วยให้เราตรวจสอบค่าที่เจาะจงในบางฟิลด์ พร้อมกับสร้างตัวแปรเพื่อดึงค่าจากฟิลด์อื่น ๆ ออกมาได้พร้อมกัน
ในลิสติ้ง 19-14 เรามีนิพจน์ match ที่แยกค่า Point ออกเป็นสามกรณี ได้แก่: จุดที่อยู่บนแกน x (ซึ่งเป็นจริงเมื่อ y = 0), จุดที่อยู่บนแกน y (x = 0) หรือจุดที่ไม่อยู่บนแกนใดเลย
struct Point {
x: i32,
y: i32,
}
fn main() {
let p = Point { x: 0, y: 7 };
match p {
Point { x, y: 0 } => println!("On the x axis at {x}"),
Point { x: 0, y } => println!("On the y axis at {y}"),
Point { x, y } => {
println!("On neither axis: ({x}, {y})");
}
}
}อาร์มแรกจะจับคู่กับจุดใดก็ตามที่อยู่บนแกน x โดยกำหนดเงื่อนไขว่าฟิลด์ y จะจับคู่สำเร็จหากมีค่าตรงกับลิเทอรัล 0 พร้อมทั้งสร้างตัวแปร x ขึ้นมาเพื่อให้เรานำไปใช้ในโค้ดของอาร์มนั้นได้
ในทำนองเดียวกัน อาร์มที่สองจะจับคู่กับจุดใดก็ตามที่อยู่บนแกน y โดยระบุว่าฟิลด์ x จะจับคู่สำเร็จหากมีค่าเป็น 0 และสร้างตัวแปร y สำหรับค่าของฟิลด์ y ส่วนอาร์มที่สามไม่ได้ระบุค่าลิเทอรัลใด ๆ ไว้ จึงจะจับคู่กับ Point อื่น ๆ ที่เหลือทั้งหมด และสร้างตัวแปรสำหรับทั้งฟิลด์ x และ y
ในตัวอย่างนี้ ค่า p จะจับคู่เข้ากับอาร์มที่สองเนื่องจาก x มีค่าเป็น 0 โค้ดนี้จึงพิมพ์ On the y axis at 7
โปรดจำไว้ว่านิพจน์ match จะหยุดตรวจสอบอาร์มทันทีที่พบแพตเทิร์นแรกที่จับคู่ตรงเงื่อนไข ดังนั้นแม้ว่า Point { x: 0, y: 0 } จะอยู่ทั้งบนแกน x และแกน y แต่โค้ดนี้ก็จะพิมพ์เพียง On the x axis at 0 เท่านั้น
enum
เราเคยแยกโครงสร้างข้อมูลของ enum กันมาแล้วในหนังสือเล่มนี้ (ตัวอย่างเช่น ลิสติ้ง 6-5 ในบทที่ 6) แต่ยังไม่ได้อธิบายอย่างชัดเจนว่าแพตเทิร์นในการแยกโครงสร้างข้อมูลของ enum นั้น สอดคล้องกับวิธีที่ข้อมูลภายในแต่ละตัวแปรของ enum ถูกนิยามไว้อย่างไร ตัวอย่างเช่น ในลิสติ้ง 19-15 เราจะนำ enum Message จากลิสติ้ง 6-2 มาเขียนนิพจน์ match ด้วยแพตเทิร์นที่แยกโครงสร้างข้อมูลค่าภายในของแต่ละกรณีออกมา
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(i32, i32, i32),
}
fn main() {
let msg = Message::ChangeColor(0, 160, 255);
match msg {
Message::Quit => {
println!("The Quit variant has no data to destructure.");
}
Message::Move { x, y } => {
println!("Move in the x direction {x} and in the y direction {y}");
}
Message::Write(text) => {
println!("Text message: {text}");
}
Message::ChangeColor(r, g, b) => {
println!("Change color to red {r}, green {g}, and blue {b}");
}
}
}โค้ดนี้จะพิมพ์ Change color to red 0, green 160, and blue 255 ลองเปลี่ยนค่าของ msg เพื่อดูผลการทำงานจากอาร์มอื่น ๆ
สำหรับวาเรียนต์ (variant) ของ enum ที่ไม่มีข้อมูลแนบมาด้วย เช่น Message::Quit เราจะไม่สามารถแยกโครงสร้างข้อมูลได้อีก ทำได้เพียงจับคู่กับค่าลิเทอรัล Message::Quit ตรง ๆ และไม่มีตัวแปรใดอยู่ในแพตเทิร์นนั้น
สำหรับวาเรียนต์ของ enum ที่มีลักษณะคล้าย struct เช่น Message::Move เราสามารถใช้แพตเทิร์นในลักษณะเดียวกับตอนที่จับคู่ struct ได้ โดยใส่วงเล็บปีกกา {} ต่อท้ายชื่อวาเรียนต์แล้วระบุชื่อฟิลด์พร้อมตัวแปร เพื่อแยกค่าออกมาใช้ในโค้ดของอาร์มนั้น ซึ่งในที่นี้เราใช้ไวยากรณ์แบบย่อเหมือนกับในลิสติ้ง 19-13
สำหรับวาเรียนต์ของ enum ที่มีลักษณะคล้ายทูเพิล เช่น Message::Write ที่เก็บทูเพิลที่มีสมาชิกหนึ่งตัว และ Message::ChangeColor ที่เก็บทูเพิลที่มีสมาชิกสามตัว แพตเทิร์นจะมีลักษณะเดียวกับการจับคู่ทูเพิล โดยจำนวนตัวแปรในแพตเทิร์นจะต้องตรงกับจำนวนสมาชิกภายในวาเรียนต์นั้น ๆ พอดี
struct และ enum ที่ซ้อนกัน
จนถึงจุดนี้ ตัวอย่างทั้งหมดเป็นการจับคู่กับ struct หรือ enum ที่มีความลึกเพียงชั้นเดียว แต่การจับคู่แพตเทิร์นยังสามารถทำงานกับข้อมูลที่มีโครงสร้างซ้อนกัน (nested) ได้อีกด้วย! เช่น เราสามารถปรับโครงสร้างโค้ดในลิสติ้ง 19-15 เพื่อรองรับทั้งระบบสี RGB และ HSV ในข้อความ ChangeColor ดังแสดงในลิสติ้ง 19-16
enum Color {
Rgb(i32, i32, i32),
Hsv(i32, i32, i32),
}
enum Message {
Quit,
Move { x: i32, y: i32 },
Write(String),
ChangeColor(Color),
}
fn main() {
let msg = Message::ChangeColor(Color::Hsv(0, 160, 255));
match msg {
Message::ChangeColor(Color::Rgb(r, g, b)) => {
println!("Change color to red {r}, green {g}, and blue {b}");
}
Message::ChangeColor(Color::Hsv(h, s, v)) => {
println!("Change color to hue {h}, saturation {s}, value {v}");
}
_ => (),
}
}แพตเทิร์นของอาร์มแรกในนิพจน์ match จะจับคู่กับวาเรียนต์ Message::ChangeColor ของ enum ที่มีวาเรียนต์ Color::Rgb ซ้อนอยู่ภายใน จากนั้นแพตเทิร์นจะผูกเข้ากับค่า i32 สามค่าที่อยู่ข้างใน ส่วนแพตเทิร์นของอาร์มที่สองก็จับคู่กับวาเรียนต์ Message::ChangeColor ของ enum เช่นกัน แต่วาเรียนต์ภายในจะจับคู่กับ Color::Hsv แทน เราสามารถระบุเงื่อนไขที่ซับซ้อนเหล่านี้ได้ครบถ้วนภายในนิพจน์ match เดียว แม้ว่าจะมี enum สองชนิดเข้ามาเกี่ยวข้องก็ตาม
struct และทูเพิล
เรายังสามารถผสมผสาน จับคู่ และซ้อนแพตเทิร์นการแยกโครงสร้างข้อมูลในรูปแบบที่ซับซ้อนยิ่งขึ้นได้ ตัวอย่างต่อไปนี้แสดงการแยกโครงสร้างข้อมูลที่ซับซ้อน โดยเราซ้อนทั้ง struct และทูเพิลไว้ภายในทูเพิลอีกชั้นหนึ่ง แล้วดึงค่าพื้นฐาน (primitive) ทั้งหมดออกมา:
fn main() {
struct Point {
x: i32,
y: i32,
}
let ((feet, inches), Point { x, y }) = ((3, 10), Point { x: 3, y: -10 });
}โค้ดนี้ช่วยให้เราแยกชนิดข้อมูลที่ซับซ้อนออกเป็นส่วนประกอบย่อย ๆ เพื่อให้เรานำค่าที่สนใจไปใช้งานแยกกันได้
การแยกโครงสร้างข้อมูลด้วยแพตเทิร์นเป็นวิธีที่สะดวกอย่างยิ่งในการดึงค่าบางส่วน เช่น ค่าจากแต่ละฟิลด์ใน struct ออกมาใช้งานแยกกันอย่างอิสระ
การเพิกเฉยต่อค่าในแพตเทิร์น
คุณได้เห็นแล้วว่าในบางครั้ง การละเว้นหรือไม่สนใจค่าในแพตเทิร์นก็มีประโยชน์ เช่น ในอาร์มสุดท้ายของ match เพื่อให้ได้แพตเทิร์นแบบครอบคลุมทั้งหมดที่ไม่ต้องทำอะไร แต่สามารถรองรับค่าที่เป็นไปได้ทั้งหมดที่เหลืออยู่ มีหลายวิธีในการละเว้นค่าทั้งหมดหรือบางส่วนในแพตเทิร์น: ได้แก่ การใช้แพตเทิร์น _ (ดังที่คุณได้เห็นมาแล้ว), การใช้แพตเทิร์น _ ซ้อนอยู่ภายในแพตเทิร์นอื่น, การใช้ชื่อตัวแปรที่ขึ้นต้นด้วยเครื่องหมายขีดล่าง หรือการใช้ .. เพื่อละเว้นส่วนที่เหลือของค่า ลองมาสำรวจวิธีการและเหตุผลในการใช้แพตเทิร์นแต่ละแบบเหล่านี้กัน
ทั้งค่าด้วย _
เราใช้เครื่องหมายขีดล่าง (underscore) เป็นแพตเทิร์นไวลด์การ์ด (wildcard) ที่จะจับคู่กับค่าใดก็ได้ แต่จะไม่ผูกค่านั้นไว้กับตัวแปร รูปแบบนี้มีประโยชน์อย่างยิ่งในอาร์มสุดท้ายของนิพจน์ match แต่ก็สามารถนำไปใช้ในแพตเทิร์นใด ๆ ก็ได้เช่นกัน รวมถึงในพารามิเตอร์ของฟังก์ชัน ดังแสดงในลิสติ้ง 19-17
fn foo(_: i32, y: i32) {
println!("This code only uses the y parameter: {y}");
}
fn main() {
foo(3, 4);
}โค้ดนี้จะไม่สนใจค่า 3 ที่ส่งเข้ามาเป็นอาร์กิวเมนต์แรกโดยสิ้นเชิง และจะพิมพ์ This code only uses the y parameter: 4 ออกมา
โดยทั่วไป หากคุณไม่จำเป็นต้องใช้พารามิเตอร์ของฟังก์ชันตัวใดตัวหนึ่งแล้ว คุณก็มักจะแก้ไขซิกเนเจอร์เพื่อตัดพารามิเตอร์นั้นออกไปเลย แต่การละเว้นพารามิเตอร์ของฟังก์ชันด้วย _ นั้นมีประโยชน์อย่างมากในกรณีเช่น การอิมพลีเมนต์เทรตที่บังคับโครงสร้างซิกเนเจอร์ของฟังก์ชันไว้ แต่บอดี้ของฟังก์ชันในการอิมพลีเมนต์ของคุณไม่จำเป็นต้องใช้พารามิเตอร์ตัวใดตัวหนึ่ง การใช้ _ จะช่วยป้องกันไม่ให้คอมไพเลอร์แจ้งคำเตือนเกี่ยวกับพารามิเตอร์ที่ไม่ได้ใช้ ซึ่งจะเกิดขึ้นหากคุณตั้งชื่อให้พารามิเตอร์นั้น
การเพิกเฉยต่อบางส่วนของค่าด้วย _ ที่ซ้อนกัน
เรายังสามารถใช้ _ ซ้อนอยู่ภายในแพตเทิร์นอื่นเพื่อละเว้นเพียงบางส่วนของค่าได้ เช่น เมื่อเราต้องการทดสอบเพียงบางส่วนของข้อมูลแต่ไม่ได้นำส่วนที่เหลือไปใช้งานในโค้ด ลิสติ้ง 19-18 แสดงโค้ดสำหรับจัดการค่าการตั้งค่า โดยมีกฎทางธุรกิจว่า ผู้ใช้จะต้องไม่สามารถเขียนทับการตั้งค่าที่ถูกปรับแต่งไว้แล้วได้ แต่สามารถล้างการตั้งค่าเดิม และกำหนดค่าใหม่ให้ได้หากปัจจุบันยังไม่ได้ตั้งค่าไว้
fn main() {
let mut setting_value = Some(5);
let new_setting_value = Some(10);
match (setting_value, new_setting_value) {
(Some(_), Some(_)) => {
println!("Can't overwrite an existing customized value");
}
_ => {
setting_value = new_setting_value;
}
}
println!("setting is {setting_value:?}");
}โค้ดนี้จะพิมพ์ Can't overwrite an existing customized value ตามด้วย setting is Some(5) ในอาร์มแรกของ match เราไม่จำเป็นต้องตรวจสอบหรือนำค่าที่อยู่ภายใน Some มาใช้งาน แต่เราต้องการทดสอบกรณีที่ทั้ง setting_value และ new_setting_value ต่างเป็นวาเรียนต์ Some ซึ่งในกรณีนี้ เราจะพิมพ์ข้อความบอกเหตุผลที่ไม่เปลี่ยนแปลง setting_value และค่านั้นจะไม่ถูกแก้ไข
ในกรณีอื่น ๆ ทั้งหมด (เมื่อ setting_value หรือ new_setting_value ตัวใดตัวหนึ่งเป็น None) ซึ่งแทนด้วยแพตเทิร์น _ ในอาร์มที่สอง เราจะอนุญาตให้ new_setting_value กลายเป็นค่าใหม่ของ setting_value
นอกจากนี้ เรายังสามารถใช้เครื่องหมายขีดล่างในหลายตำแหน่งภายในแพตเทิร์นเดียวกันเพื่อละเว้นค่าที่เจาะจงได้ ลิสติ้ง 19-19 แสดงตัวอย่างการละเว้นค่าลำดับที่สองและสี่ในทูเพิลที่มีสมาชิก 5 ตัว
fn main() {
let numbers = (2, 4, 8, 16, 32);
match numbers {
(first, _, third, _, fifth) => {
println!("Some numbers: {first}, {third}, {fifth}");
}
}
}โค้ดนี้จะพิมพ์ Some numbers: 2, 8, 32 โดยที่ค่า 4 และ 16 จะถูกละเว้นไป
ตัวแปรที่ไม่ได้ใช้โดยขึ้นต้นชื่อด้วย _
หากคุณสร้างตัวแปรขึ้นมาแต่ไม่ได้นำไปใช้งานที่ไหนเลย Rust มักจะแจ้งคำเตือน เพราะตัวแปรที่ไม่ได้ใช้อาจเป็นสัญญาณของบั๊กได้ อย่างไรก็ตาม บางครั้งการสร้างตัวแปรที่ยังไม่ได้ใช้ก็มีประโยชน์ เช่น ตอนที่คุณกำลังสร้างตัวอย่างต้นแบบ (prototype) หรือเพิ่งเริ่มโปรเจกต์ ในสถานการณ์นี้ คุณสามารถบอกให้ Rust ไม่ต้องแจ้งเตือนเกี่ยวกับตัวแปรที่ไม่ได้ใช้ได้ โดยการขึ้นต้นชื่อตัวแปรด้วยเครื่องหมายขีดล่าง ในลิสติ้ง 19-20 เราสร้างตัวแปรที่ไม่ได้ใช้สองตัว แต่เมื่อคอมไพล์โค้ดนี้ เราจะได้รับคำเตือนสำหรับตัวแปรเพียงตัวเดียวเท่านั้น
fn main() {
let _x = 5;
let y = 10;
}ในที่นี้ เราจะได้รับคำเตือนเกี่ยวกับการไม่ใช้งานตัวแปร y แต่จะไม่ได้รับคำเตือนเกี่ยวกับ _x
โปรดสังเกตว่า มีความแตกต่างที่สำคัญระหว่างการใช้ _ เดี่ยว ๆ กับการใช้ชื่อที่ขึ้นต้นด้วยขีดล่าง: โดยไวยากรณ์ _x ยังคงผูกค่านั้นเข้ากับตัวแปรอยู่ ในขณะที่ _ เพียงอย่างเดียวจะไม่ผูกค่าใด ๆ เลย เพื่อให้เห็นว่าความแตกต่างนี้ส่งผลอย่างไร ลิสติ้ง 19-21 แสดงตัวอย่างโค้ดที่จะทำให้เกิดข้อผิดพลาด
fn main() {
let s = Some(String::from("Hello!"));
if let Some(_s) = s {
println!("found a string");
}
println!("{s:?}");
}เราจะพบข้อผิดพลาดเนื่องจากค่าของ s ยังคงถูกย้าย (move) ไปยังตัวแปร _s ซึ่งทำให้เราไม่สามารถนำ s มาใช้งานซ้ำได้อีก แต่ในทางกลับกัน การใช้เครื่องหมายขีดล่างเดี่ยว ๆ จะไม่เคยผูกค่าเลย โค้ดในลิสติ้ง 19-22 จึงสามารถคอมไพล์ผ่านได้โดยไม่มีข้อผิดพลาดใด ๆ เนื่องจาก s ไม่ได้ถูกย้ายไปยัง _
fn main() {
let s = Some(String::from("Hello!"));
if let Some(_) = s {
println!("found a string");
}
println!("{s:?}");
}โค้ดนี้ทำงานได้ตามปกติเพราะเราไม่เคยผูกค่า s เข้ากับสิ่งใด จึงไม่มีการย้ายค่าเกิดขึ้น
ส่วนที่เหลือของค่าด้วย ..
สำหรับค่าที่ประกอบด้วยหลายส่วน เราสามารถใช้ไวยากรณ์ .. เพื่อระบุเฉพาะส่วนที่สนใจและละเว้นส่วนที่เหลือได้ โดยไม่จำเป็นต้องใส่เครื่องหมายขีดล่างทีละตัว แพตเทิร์น .. จะละเว้นทุกชิ้นส่วนของค่าที่เราไม่ได้ระบุไว้อย่างชัดเจนในแพตเทิร์น ในลิสติ้ง 19-23 เรามี struct Point ที่เก็บพิกัดในระบบ 3 มิติ และในนิพจน์ match เราต้องการประมวลผลเฉพาะพิกัด x เท่านั้น โดยไม่สนใจค่าในฟิลด์ y และ z
fn main() {
struct Point {
x: i32,
y: i32,
z: i32,
}
let origin = Point { x: 0, y: 0, z: 0 };
match origin {
Point { x, .. } => println!("x is {x}"),
}
}เราเพียงแค่ระบุฟิลด์ x แล้วตามด้วยแพตเทิร์น .. วิธีนี้รวดเร็วกว่าการต้องเขียน y: _ และ z: _ มาก โดยเฉพาะเมื่อต้องจัดการกับ struct ที่มีฟิลด์จำนวนมากแต่เราสนใจเพียงหนึ่งหรือสองฟิลด์เท่านั้น
ไวยากรณ์ .. จะขยายครอบคลุมจำนวนค่าเท่าที่จำเป็นโดยอัตโนมัติ ลิสติ้ง 19-24 แสดงวิธีนำ .. ไปใช้กับทูเพิล
fn main() {
let numbers = (2, 4, 8, 16, 32);
match numbers {
(first, .., last) => {
println!("Some numbers: {first}, {last}");
}
}
}ในโค้ดนี้ ค่าแรกและค่าสุดท้ายจะถูกจับคู่เข้ากับตัวแปร first และ last ส่วน .. จะจับคู่และละเว้นทุกค่าที่อยู่ตรงกลาง
อย่างไรก็ตาม การใช้ .. จะต้องไม่กำกวม หากคอมไพเลอร์ไม่สามารถแยกแยะได้ชัดเจนว่าค่าใดต้องจับคู่และค่าใดต้องละเว้น Rust จะแจ้งข้อผิดพลาดทันที ลิสติ้ง 19-25 แสดงตัวอย่างการใช้ .. ในลักษณะที่กำกวม ซึ่งจะคอมไพล์ไม่ผ่าน
fn main() {
let numbers = (2, 4, 8, 16, 32);
match numbers {
(.., second, ..) => {
println!("Some numbers: {second}")
},
}
}เมื่อเราคอมไพล์ตัวอย่างนี้ เราจะได้ข้อผิดพลาดดังนี้:
$ cargo run
Compiling patterns v0.1.0 (file:///projects/patterns)
error: `..` can only be used once per tuple pattern
--> src/main.rs:5:22
|
5 | (.., second, ..) => {
| -- ^^ can only be used once per tuple pattern
| |
| previously used here
error: could not compile `patterns` (bin "patterns") due to 1 previous error
Rust ไม่มีทางรู้ได้เลยว่าต้องละเว้นค่าไปกี่ตัวในทูเพิลก่อนที่จะนำค่ามาจับคู่กับ second และหลังจากนั้นจะต้องละเว้นต่อไปอีกกี่ตัว โค้ดนี้อาจหมายถึงการละเว้น 2, ผูก second เข้ากับ 4 แล้วละเว้น 8, 16, 32 หรืออาจหมายถึงการละเว้น 2 กับ 4, ผูก second เข้ากับ 8 แล้วละเว้น 16 กับ 32 เป็นต้น ชื่อตัวแปร second ไม่ได้มีความหมายพิเศษอะไรสำหรับ Rust ดังนั้นเราจึงได้รับข้อผิดพลาดจากคอมไพเลอร์ เนื่องจากการใช้ .. สองตำแหน่งเช่นนี้ทำให้เกิดความกำกวม
การเพิ่มเงื่อนไขด้วยการ์ด match
การ์ด match (match guard) คือเงื่อนไข if เพิ่มเติมที่ระบุไว้หลังแพตเทิร์นในอาร์มของ match ซึ่งเงื่อนไขนี้จะต้องเป็นจริงด้วย อาร์มนั้นจึงจะถูกเลือกทำงาน การ์ด match มีประโยชน์อย่างมากในการแสดงตรรกะที่ซับซ้อนเกินกว่าที่ตัวแพตเทิร์นเพียงอย่างเดียวจะทำได้ อย่างไรก็ตาม โปรดทราบว่าการ์ด match ใช้งานได้เฉพาะในนิพจน์ match เท่านั้น ไม่สามารถใช้ในนิพจน์ if let หรือ while let ได้
เงื่อนไขดังกล่าวยังสามารถเข้าถึงตัวแปรที่ถูกสร้างขึ้นในแพตเทิร์นได้ด้วย ลิสติ้ง 19-26 แสดงนิพจน์ match ที่อาร์มแรกมีแพตเทิร์น Some(x) พร้อมการ์ด match if x % 2 == 0 (ซึ่งจะเป็น true เมื่อตัวเลขเป็นจำนวนคู่)
fn main() {
let num = Some(4);
match num {
Some(x) if x % 2 == 0 => println!("The number {x} is even"),
Some(x) => println!("The number {x} is odd"),
None => (),
}
}ตัวอย่างนี้จะพิมพ์ The number 4 is even ออกมา เมื่อนำ num ไปเปรียบเทียบกับแพตเทิร์นในอาร์มแรก จะพบว่าจับคู่ได้สำเร็จเพราะ Some(4) ตรงกับ Some(x) จากนั้นการ์ด match จะตรวจสอบต่อว่าเศษจากการหาร x ด้วย 2 เท่ากับ 0 หรือไม่ และเนื่องจากเท่ากับ 0 อาร์มแรกจึงถูกเลือกทำงาน
หาก num มีค่าเป็น Some(5) แทน การ์ด match ในอาร์มแรกก็จะได้ผลลัพธ์เป็น false เพราะเศษจากการหาร 5 ด้วย 2 คือ 1 ซึ่งไม่เท่ากับ 0 Rust ก็จะข้ามไปยังอาร์มที่สอง ซึ่งจะจับคู่สำเร็จเนื่องจากอาร์มที่สองไม่มีการ์ด match จึงยอมรับวาเรียนต์ Some ใดก็ได้
เนื่องจากเราไม่สามารถเขียนเงื่อนไข if x % 2 == 0 ลงในแพตเทิร์นตรง ๆ ได้ การ์ด match จึงเข้ามาช่วยให้เราแสดงตรรกะนี้ได้อย่างสะดวก ทว่าข้อแลกเปลี่ยนของความยืดหยุ่นที่เพิ่มขึ้นนี้คือ คอมไพเลอร์จะไม่สามารถตรวจสอบความครอบคลุมทุกกรณี (exhaustiveness) ของแพตเทิร์นได้อย่างสมบูรณ์เมื่อมีการใช้การ์ด match ร่วมด้วย
ในการพูดคุยถึงลิสติ้ง 19-11 เราเคยกล่าวไว้ว่าเราสามารถใช้การ์ด match เพื่อแก้ปัญหาการบดบังตัวแปร (shadowing) ในแพตเทิร์นได้ ย้อนกลับไปในตัวอย่างนั้น เราสร้างตัวแปรใหม่ขึ้นมาภายในแพตเทิร์นของนิพจน์ match แทนที่จะเป็นตัวแปรภายนอก ส่งผลให้เราไม่สามารถตรวจสอบเปรียบเทียบกับค่าของตัวแปรภายนอกได้ ลิสติ้ง 19-27 แสดงวิธีใช้การ์ด match เพื่อแก้ไขปัญหานี้
fn main() {
let x = Some(5);
let y = 10;
match x {
Some(50) => println!("Got 50"),
Some(n) if n == y => println!("Matched, n = {n}"),
_ => println!("Default case, x = {x:?}"),
}
println!("at the end: x = {x:?}, y = {y}");
}โค้ดนี้จะพิมพ์ Default case, x = Some(5) แพตเทิร์นในอาร์มที่สองไม่ได้ประกาศตัวแปร y ขึ้นมาใหม่ที่จะไปบดบัง y ตัวนอก ซึ่งหมายความว่าเราสามารถนำ y ตัวนอกมาใช้ในการ์ด match ได้ โดยแทนที่เราจะกำหนดแพตเทิร์นเป็น Some(y) (ซึ่งจะบดบัง y ตัวนอก) เราเปลี่ยนมากำหนดเป็น Some(n) แทน ซึ่งจะสร้างตัวแปรใหม่ n ที่ไม่ได้ไปบดบังตัวแปรใด ๆ เลย เพราะไม่มีตัวแปรชื่อ n อยู่ภายนอก match
การ์ด match if n == y ไม่ใช่แพตเทิร์น จึงไม่มีการประกาศตัวแปรใหม่ ดังนั้น y ในที่นี้ คือ y ตัวนอกจริง ๆ ไม่ใช่ y ตัวใหม่ที่ไปบดบังมัน เราจึงสามารถตรวจสอบหาค่าที่ตรงกับ y ตัวนอกได้โดยการเปรียบเทียบ n กับ y
นอกจากนี้ คุณยังสามารถใช้ตัวดำเนินการ หรือ | ร่วมกับการ์ด match เพื่อกำหนดหลายแพตเทิร์นได้ โดยเงื่อนไขของการ์ด match จะมีผลกับทุก ๆ แพตเทิร์นที่ระบุ ลิสติ้ง 19-28 แสดงลำดับความสำคัญเมื่อรวมแพตเทิร์นที่ใช้ | เข้ากับการ์ด match สิ่งสำคัญของตัวอย่างนี้คือ การ์ด match if y จะมีผลครอบคลุมทั้ง 4, 5 และ 6 แม้ว่าเมื่อมองดูอาจเหมือนกับว่า if y มีผลเฉพาะกับ 6 เท่านั้นก็ตาม
fn main() {
let x = 4;
let y = false;
match x {
4 | 5 | 6 if y => println!("yes"),
_ => println!("no"),
}
}เงื่อนไขของ match ระบุว่าอาร์มจะจับคู่สำเร็จก็ต่อเมื่อค่าของ x เท่ากับ 4, 5 หรือ 6 และ y มีค่าเป็น true เมื่อโค้ดนี้ทำงาน แพตเทิร์นของอาร์มแรกจับคู่สำเร็จเพราะ x มีค่าเป็น 4 แต่เนื่องจากการ์ด match if y เป็น false อาร์มแรกจึงไม่ถูกเลือก โค้ดจึงดำเนินต่อไปยังอาร์มที่สองซึ่งจับคู่สำเร็จ และโปรแกรมนี้จะพิมพ์ no ออกมา เหตุผลก็คือเงื่อนไข if จะมีผลกับแพตเทิร์นทั้งหมดคือ 4 | 5 | 6 ไม่ใช่แค่ค่าสุดท้ายคือ 6 กล่าวคือ ลำดับความสำคัญของการ์ด match เมื่อเทียบกับแพตเทิร์นจะมีพฤติกรรมดังนี้:
(4 | 5 | 6) if y => ...
ไม่ใช่แบบนี้:
4 | 5 | (6 if y) => ...
เมื่อรันโค้ดแล้ว พฤติกรรมของลำดับความสำคัญนี้จะเห็นได้อย่างชัดเจน: เพราะหากการ์ด match มีผลเฉพาะกับค่าสุดท้ายในรายการที่เชื่อมด้วยตัวดำเนินการ | แล้วล่ะก็ อาร์มแรกก็ย่อมจะจับคู่สำเร็จ และโปรแกรมก็จะพิมพ์ yes ออกมาแทน
การใช้การผูกค่าด้วย @
ตัวดำเนินการ at @ ช่วยให้เราสร้างตัวแปรเพื่อเก็บค่าไปพร้อม ๆ กับการทดสอบค่านั้นกับแพตเทิร์น ในลิสติ้ง 19-29 เราต้องการทดสอบว่าฟิลด์ id ของ Message::Hello อยู่ในช่วง 3..=7 หรือไม่ พร้อมทั้งต้องการผูกค่านั้นเข้ากับตัวแปร id เพื่อให้เราสามารถนำค่านั้นไปใช้งานในโค้ดของอาร์มดังกล่าวได้ด้วย
fn main() {
enum Message {
Hello { id: i32 },
}
let msg = Message::Hello { id: 5 };
match msg {
Message::Hello { id: id @ 3..=7 } => {
println!("Found an id in range: {id}")
}
Message::Hello { id: 10..=12 } => {
println!("Found an id in another range")
}
Message::Hello { id } => println!("Found some other id: {id}"),
}
}ตัวอย่างนี้จะพิมพ์ Found an id in range: 5 ออกมา โดยการระบุ id @ ไว้ข้างหน้าช่วง 3..=7 เราจะดักจับค่าใดก็ตามที่จับคู่ตรงกับช่วงนั้นมาเก็บไว้ในตัวแปรชื่อ id ไปพร้อมกับทดสอบว่าค่านั้นตรงตามเงื่อนไขของช่วงหรือไม่
ในอาร์มที่สอง ซึ่งเราระบุเพียงช่วงในแพตเทิร์น โค้ดในอาร์มนั้นจะไม่มีตัวแปรที่เก็บค่าจริงของฟิลด์ id เลย ค่าของฟิลด์ id อาจเป็น 10, 11 หรือ 12 แต่โค้ดของอาร์มนั้นไม่รู้แน่ชัดว่าเป็นค่าใดกันแน่ จึงไม่สามารถนำค่าจากฟิลด์ id มาใช้งานได้เพราะเราไม่ได้บันทึกค่า id ไว้ในตัวแปรใด
ในอาร์มสุดท้าย ซึ่งเราระบุตัวแปรไว้โดยไม่มีช่วง เราจะมีค่าพร้อมใช้งานในโค้ดของอาร์มผ่านตัวแปรชื่อ id เนื่องจากเราใช้ไวยากรณ์แบบย่อของฟิลด์ struct ทว่าเราไม่ได้ใส่การทดสอบเงื่อนไขใด ๆ กับค่าในฟิลด์ id ในอาร์มนี้เหมือนกับสองอาร์มแรก: ค่าใดก็ตามจึงสามารถจับคู่กับแพตเทิร์นนี้ได้ทั้งหมด
การใช้ @ ช่วยให้เราทดสอบค่าและบันทึกค่านั้นไว้ในตัวแปรได้จบครบภายในแพตเทิร์นเดียว
สรุป
แพตเทิร์นของ Rust มีประโยชน์อย่างยิ่งในการจำแนกความแตกต่างระหว่างข้อมูลชนิดต่าง ๆ เมื่อนำไปใช้ในนิพจน์ match แล้ว Rust จะช่วยรับประกันว่าแพตเทิร์นของคุณครอบคลุมทุกค่าที่เป็นไปได้เสมอ มิฉะนั้นโปรแกรมก็จะไม่ผ่านการคอมไพล์ นอกจากนี้ แพตเทิร์นในสเตตเมนต์ let และพารามิเตอร์ของฟังก์ชันยังช่วยเพิ่มประโยชน์ให้แก่โครงสร้างคำสั่งเหล่านั้น โดยเปิดทางให้เราแยกโครงสร้างข้อมูลออกเป็นชิ้นส่วนย่อย ๆ และกำหนดค่านั้นให้แก่ตัวแปรได้อย่างสะดวก เราจึงสามารถสร้างแพตเทิร์นทั้งแบบเรียบง่ายหรือแบบซับซ้อนให้ตรงกับความต้องการของงานได้อย่างยืดหยุ่น
ในบทถัดไป ซึ่งเป็นบทรองสุดท้ายของหนังสือเล่มนี้ เราจะไปสำรวจแง่มุมและคุณลักษณะขั้นสูงต่าง ๆ ของฟีเจอร์ในภาษา Rust กัน
ฟีเจอร์ขั้นสูง
ถึงตอนนี้ คุณได้เรียนรู้ส่วนที่ใช้งานบ่อยที่สุดของภาษาโปรแกรม Rust ไปแล้ว ก่อนที่เราจะลงมือทำโปรเจกต์ส่งท้ายอีกหนึ่งโปรเจกต์ในบทที่ 21 เราจะมาสำรวจแง่มุมบางประการของภาษาที่คุณอาจได้พบเจอเป็นครั้งคราว แต่อาจไม่ได้หยิบมาใช้งานในชีวิตประจำวันทุกวัน คุณสามารถใช้บทนี้เป็นคู่มืออ้างอิงเมื่อพบเจอสิ่งที่ไม่คุ้นเคย โดยฟีเจอร์ที่เราจะกล่าวถึงในบทนี้มีประโยชน์อย่างยิ่งในสถานการณ์เฉพาะเจาะจง แม้คุณอาจไม่ได้ใช้งานบ่อยนัก แต่เราก็อยากให้คุณมีความเข้าใจและคุ้นเคยกับฟีเจอร์ทั้งหมดที่ Rust มีให้
ในบทนี้ เราจะครอบคลุมหัวข้อต่าง ๆ ดังนี้:
- Unsafe Rust: วิธีเลือกปิดการรับประกันความปลอดภัยบางประการของ Rust และรับหน้าที่ดูแลความปลอดภัยเหล่านั้นด้วยตัวเอง
- เทรต (trait) ขั้นสูง: ชนิดข้อมูลที่เชื่อมโยง (associated type), พารามิเตอร์ชนิดข้อมูลเริ่มต้น (default type parameter), ไวยากรณ์แบบระบุชื่อเต็ม (fully qualified syntax), ซูเปอร์เทรต (supertrait) และรูปแบบนิวไทป์ (newtype pattern) ที่เกี่ยวข้องกับเทรต
- ชนิดข้อมูลขั้นสูง: เจาะลึกเพิ่มเติมเกี่ยวกับรูปแบบนิวไทป์, นามแฝงชนิดข้อมูล (type alias), ชนิดข้อมูล never (never type) และชนิดข้อมูลที่กำหนดขนาดแบบไดนามิก (dynamically sized types)
- ฟังก์ชันและโคลเชอร์ (closure) ขั้นสูง: พอยน์เตอร์ฟังก์ชัน (function pointer) และการคืนค่าโคลเชอร์จากฟังก์ชัน
- มาโคร (macro): วิธีการเขียนโค้ดเพื่อสร้างโค้ดอื่นเพิ่มเติมในขณะคอมไพล์
บทนี้รวบรวมฟีเจอร์อันทรงพลังมากมายของ Rust ที่มีประโยชน์สำหรับทุกคน มาเริ่มลุยกันเลย!
Unsafe Rust
Unsafe Rust
โค้ดทั้งหมดที่เราพูดถึงกันมาจนถึงตอนนี้ ล้วนได้รับการบังคับใช้การรับประกันความปลอดภัยของหน่วยความจำ (memory safety) ของ Rust ในขณะคอมไพล์ อย่างไรก็ตาม Rust มีภาษาที่สองซ่อนอยู่ภายใน ซึ่งไม่ได้บังคับใช้การรับประกันความปลอดภัยของหน่วยความจำเหล่านี้ ภาษาดังกล่าวเรียกว่า unsafe Rust ซึ่งทำงานเหมือนกับ Rust ปกติทุกประการ แต่เปิดโอกาสให้เราใช้พลังพิเศษเพิ่มเติมได้
Unsafe Rust มีอยู่เพราะโดยธรรมชาติแล้ว การวิเคราะห์แบบสแตติก (static analysis) จะมีความระมัดระวังรอบคอบ (conservative) เสมอ เมื่อคอมไพเลอร์พยายามตัดสินว่าโค้ดเป็นไปตามการรับประกันความปลอดภัยหรือไม่ คอมไพเลอร์ยอมที่จะปฏิเสธโปรแกรมที่ถูกต้องบางโปรแกรม ดีกว่ายอมรับโปรแกรมที่มีข้อผิดพลาด แม้ว่าโค้ดนั้น_อาจจะ_ทำงานได้ถูกต้อง แต่หากคอมไพเลอร์ Rust มีข้อมูลไม่เพียงพอที่จะมั่นใจ ก็จะปฏิเสธโค้ดนั้น ในกรณีเหล่านี้ คุณสามารถใช้โค้ด unsafe เพื่อบอกคอมไพเลอร์ว่า “เชื่อใจฉันเถอะ ฉันรู้ว่ากำลังทำอะไรอยู่” แต่ขอเตือนไว้ก่อนว่า คุณใช้ unsafe Rust ด้วยความเสี่ยงของคุณเอง หากคุณใช้โค้ด unsafe อย่างไม่ถูกต้อง ปัญหาความไม่ปลอดภัยของหน่วยความจำย่อมเกิดขึ้นได้ เช่น การดีเรเฟอเรนซ์พอยน์เตอร์ที่เป็น null
อีกเหตุผลหนึ่งที่ Rust มีตัวตนอีกด้านที่เป็น unsafe ก็เพราะฮาร์ดแวร์คอมพิวเตอร์ระดับล่างนั้นไม่ได้ปลอดภัยโดยธรรมชาติ หาก Rust ไม่อนุญาตให้คุณทำงานที่ไม่ปลอดภัย คุณก็จะไม่สามารถทำภารกิจบางอย่างได้ Rust จึงจำเป็นต้องเปิดทางให้คุณเขียนโปรแกรมเชิงระบบระดับต่ำ (low-level systems programming) เช่น การโต้ตอบกับระบบปฏิบัติการโดยตรง หรือแม้กระทั่งการเขียนระบบปฏิบัติการขึ้นมาเอง การรองรับการเขียนโปรแกรมเชิงระบบระดับต่ำถือเป็นเป้าหมายหลักประการหนึ่งของภาษา Rust มาสำรวจกันว่าเราสามารถทำอะไรได้บ้างใน unsafe Rust และมีวิธีใช้งานอย่างไร
การใช้พลังพิเศษของ unsafe
หากต้องการสลับไปใช้ unsafe Rust ให้ใช้คำสงวน unsafe แล้วเริ่มต้นบล็อกใหม่เพื่อบรรจุโค้ด unsafe คุณสามารถดำเนินการ 5 สิ่งใน unsafe Rust ที่ไม่สามารถทำได้ใน safe Rust ซึ่งเราเรียกว่า_พลังพิเศษของ unsafe (unsafe superpowers)_ พลังพิเศษเหล่านั้นได้แก่:
- ดีเรเฟอเรนซ์พอยน์เตอร์ดิบ (raw pointer)
- เรียกใช้ฟังก์ชันหรือเมธอดที่เป็น unsafe
- เข้าถึงหรือแก้ไขตัวแปร static แบบเปลี่ยนแปลงค่าได้ (mutable static variable)
- อิมพลีเมนต์เทรต (trait) ที่เป็น unsafe
- เข้าถึงฟิลด์ต่าง ๆ ของ
union
สิ่งสำคัญที่ต้องทำความเข้าใจคือ unsafe ไม่ได้ปิดการทำงานของตัวตรวจการยืม (borrow checker) หรือปิดระบบตรวจสอบความปลอดภัยอื่น ๆ ของ Rust หากคุณใช้การอ้างอิง (reference) ภายในโค้ด unsafe การอ้างอิงนั้นก็ยังคงได้รับการตรวจสอบตามปกติ คำสงวน unsafe เพียงแค่เปิดโอกาสให้คุณเข้าถึงฟีเจอร์ทั้งห้านี้ ซึ่งคอมไพเลอร์จะไม่ตรวจสอบความปลอดภัยของหน่วยความจำให้อีกต่อไป คุณจึงยังคงได้รับการปกป้องในระดับหนึ่งภายในบล็อก unsafe
นอกจากนี้ unsafe ไม่ได้หมายความว่าโค้ดภายในบล็อกนั้นจะต้องเป็นอันตราย หรือต้องเกิดปัญหาความปลอดภัยของหน่วยความจำอย่างแน่นอน จุดมุ่งหมายคือ ในฐานะโปรแกรมเมอร์ คุณจะต้องเป็นผู้รับประกันเองว่าโค้ดภายในบล็อก unsafe จะเข้าถึงหน่วยความจำได้อย่างถูกต้องและปลอดภัย
มนุษย์ย่อมมีข้อผิดพลาดได้ และข้อผิดพลาดย่อมเกิดขึ้นได้เสมอ แต่การกำหนดให้การดำเนินการ unsafe ทั้ง 5 อย่างนี้ต้องอยู่ภายในบล็อกที่กำกับด้วย unsafe ทำให้คุณมั่นใจได้ว่า ข้อผิดพลาดใด ๆ ที่เกี่ยวข้องกับความปลอดภัยของหน่วยความจำจะต้องอยู่ภายในบล็อก unsafe อย่างแน่นอน จงรักษาบล็อก unsafe ให้มีขนาดเล็กที่สุดเท่าที่จะทำได้ แล้วคุณจะขอบคุณตัวเองในภายหลังเมื่อต้องค้นหาและแก้ไขบั๊กเกี่ยวกับหน่วยความจำ
เพื่อแยกโค้ด unsafe ออกมาให้เป็นสัดส่วนมากที่สุด ทางที่ดีที่สุดคือการห่อหุ้มโค้ดดังกล่าวไว้ภายในแอบสแตรกชันที่ปลอดภัย (safe abstraction) และเตรียม API ที่ปลอดภัยไว้ให้เรียกใช้งาน ซึ่งเราจะพูดถึงในบทนี้เมื่อเราศึกษาฟังก์ชันและเมธอดที่เป็น unsafe บางส่วนของไลบรารีมาตรฐานได้รับการอิมพลีเมนต์เป็นแอบสแตรกชันที่ปลอดภัยครอบโค้ด unsafe ที่ผ่านการตรวจสอบอย่างละเอียดแล้ว การห่อหุ้มโค้ด unsafe ไว้ในแอบสแตรกชันที่ปลอดภัยช่วยป้องกันไม่ให้การใช้งาน unsafe รั่วไหลไปยังทุกจุดที่คุณหรือผู้ใช้งานต้องการเรียกใช้ฟังก์ชันการทำงานที่สร้างขึ้นด้วยโค้ด unsafe เพราะการเรียกใช้งานแอบสแตรกชันที่ปลอดภัยนั้นปลอดภัยอยู่แล้ว
มาดูพลังพิเศษของ unsafe แต่ละอย่างจากทั้ง 5 ข้อตามลำดับกัน รวมถึงดูแอบสแตรกชันบางส่วนที่เตรียมอินเทอร์เฟซที่ปลอดภัยครอบโค้ด unsafe เอาไว้ด้วย
การดีเรเฟอเรนซ์พอยน์เตอร์ดิบ
ในบทที่ 4 ในหัวข้อ“เรเฟอเรนซ์ที่ชี้ไปยังหน่วยความจำที่ถูกคืนแล้ว” เราได้กล่าวถึงการที่คอมไพเลอร์คอยรับประกันว่าการอ้างอิงจะถูกต้องสมบูรณ์เสมอ ส่วน Unsafe Rust มีชนิดข้อมูลใหม่ 2 ชนิดที่เรียกว่า_พอยน์เตอร์ดิบ (raw pointer)_ ซึ่งมีลักษณะคล้ายกับการอ้างอิง เช่นเดียวกับการอ้างอิง พอยน์เตอร์ดิบสามารถเป็นแบบเปลี่ยนแปลงค่าไม่ได้หรือเปลี่ยนแปลงค่าได้ โดยเขียนเป็น *const T และ *mut T ตามลำดับ เครื่องหมายดอกจันไม่ใช่ตัวดำเนินการดีเรเฟอเรนซ์ (dereference operator) แต่เป็นส่วนหนึ่งของชื่อชนิดข้อมูล ในบริบทของพอยน์เตอร์ดิบ คำว่า เปลี่ยนแปลงค่าไม่ได้ (immutable) หมายความว่าเราไม่สามารถกำหนดค่าลงไปยังพอยน์เตอร์ได้โดยตรงหลังจากที่ดีเรเฟอเรนซ์แล้ว
สิ่งที่พอยน์เตอร์ดิบแตกต่างไปจากการอ้างอิงและสมาร์ตพอยน์เตอร์ (smart pointer) คือ:
- ได้รับอนุญาตให้ละเว้นกฎการยืมได้ โดยสามารถมีทั้งพอยน์เตอร์แบบเปลี่ยนแปลงค่าไม่ได้และแบบเปลี่ยนแปลงค่าได้ หรือมีพอยน์เตอร์แบบเปลี่ยนแปลงค่าได้หลายตัวชี้ไปยังตำแหน่งเดียวกัน
- ไม่มีการรับประกันว่าจะชี้ไปยังหน่วยความจำที่ถูกต้องสมบูรณ์
- อนุญาตให้เป็น null ได้
- ไม่มีการทำความสะอาดหน่วยความจำโดยอัตโนมัติ (automatic cleanup)
การเลือกไม่ให้ Rust บังคับใช้การรับประกันเหล่านี้ ทำให้คุณสามารถแลกความปลอดภัยที่รับประกันไว้ กับประสิทธิภาพที่สูงขึ้น หรือความสามารถในการเชื่อมต่อกับภาษาอื่นหรือฮาร์ดแวร์ที่การรับประกันของ Rust ไม่สามารถครอบคลุมได้
ลิสติ้ง 20-1 แสดงวิธีสร้างพอยน์เตอร์ดิบทั้งแบบเปลี่ยนแปลงค่าไม่ได้และแบบเปลี่ยนแปลงค่าได้
fn main() {
let mut num = 5;
let r1 = &raw const num;
let r2 = &raw mut num;
}โปรดสังเกตว่าเราไม่ได้ใส่คำสงวน unsafe ในโค้ดนี้ เพราะเราสามารถสร้างพอยน์เตอร์ดิบในโค้ด safe ได้ เพียงแต่เราไม่สามารถดีเรเฟอเรนซ์พอยน์เตอร์ดิบภายนอกบล็อก unsafe ได้ ดังที่คุณจะได้เห็นในอีกสักครู่
เราสร้างพอยน์เตอร์ดิบขึ้นมาโดยใช้ตัวดำเนินการยืมแบบ raw: &raw const num สร้างพอยน์เตอร์ดิบแบบเปลี่ยนแปลงค่าไม่ได้ชนิด *const i32 และ &raw mut num สร้างพอยน์เตอร์ดิบแบบเปลี่ยนแปลงค่าได้ชนิด *mut i32 เนื่องจากเราสร้างพอยน์เตอร์เหล่านี้ขึ้นมาจากตัวแปรโลคัลโดยตรง เราจึงรู้ว่าพอยน์เตอร์ดิบชุดนี้ชี้ไปยังตำแหน่งที่ถูกต้องแน่นอน แต่เราไม่สามารถสรุปเช่นนั้นกับพอยน์เตอร์ดิบทั่วไปได้เสมอไป
เพื่อสาธิตให้เห็นชัดเจน ต่อไปเราจะสร้างพอยน์เตอร์ดิบที่เราไม่สามารถมั่นใจในความถูกต้องของตำแหน่งปลายทางได้ โดยใช้คำสงวน as เพื่อแปลงชนิดค่า (cast) แทนการใช้ตัวดำเนินการยืมแบบ raw ลิสติ้ง 20-2 แสดงวิธีสร้างพอยน์เตอร์ดิบที่ชี้ไปยังตำแหน่งหน่วยความจำใด ๆ ก็ตาม การพยายามเข้าถึงหน่วยความจำตามใจชอบเช่นนี้ถือเป็นพฤติกรรมที่ไม่พึงประสงค์หรือไม่ถูกกำหนดไว้ (undefined behavior): แอดเดรสดังกล่าวอาจมีข้อมูลอยู่จริงหรือไม่ก็ได้ คอมไพเลอร์อาจปรับแต่งโค้ดจนไม่มีการเข้าถึงหน่วยความจำเลย หรือโปรแกรมอาจหยุดทำงานกะทันหันด้วยข้อผิดพลาด segmentation fault โดยปกติแล้ว ไม่มีเหตุผลอันสมควรที่จะเขียนโค้ดแบบนี้ โดยเฉพาะเมื่อคุณสามารถใช้ตัวดำเนินการยืมแบบ raw แทนได้ แต่วิธีนี้ก็สามารถทำได้ในเชิงเทคนิค
fn main() {
let address = 0x012345usize;
let r = address as *const i32;
}โปรดจำไว้ว่าเราสามารถสร้างพอยน์เตอร์ดิบในโค้ด safe ได้ แต่ไม่สามารถดีเรเฟอเรนซ์พอยน์เตอร์ดิบเพื่ออ่านข้อมูลที่ตำแหน่งปลายทางได้ ในลิสติ้ง 20-3 เราใช้ตัวดำเนินการดีเรเฟอเรนซ์ * กับพอยน์เตอร์ดิบ ซึ่งจำเป็นต้องทำภายในบล็อก unsafe
fn main() {
let mut num = 5;
let r1 = &raw const num;
let r2 = &raw mut num;
unsafe {
println!("r1 is: {}", *r1);
println!("r2 is: {}", *r2);
}
}การสร้างพอยน์เตอร์ไม่ได้ก่อให้เกิดอันตรายใด ๆ จะมีก็เฉพาะตอนที่เราพยายามเข้าถึงค่าที่พอยน์เตอร์ชี้ไปเท่านั้นที่เราอาจต้องเผชิญกับค่าที่ไม่ถูกต้องสมบูรณ์
โปรดสังเกตด้วยว่าในลิสติ้ง 20-1 และ 20-3 เราสร้างพอยน์เตอร์ดิบชนิด *const i32 และ *mut i32 ซึ่งต่างก็ชี้ไปยังตำแหน่งหน่วยความจำเดียวกันที่เก็บค่า num เอาไว้ หากเราเปลี่ยนไปพยายามสร้างการอ้างอิงแบบเปลี่ยนแปลงค่าไม่ได้และการอ้างอิงแบบเปลี่ยนแปลงค่าได้ไปยัง num โค้ดจะไม่สามารถคอมไพล์ผ่านได้ เพราะกฎความเป็นเจ้าของ (ownership) ของ Rust ไม่อนุญาตให้มีการอ้างอิงแบบเปลี่ยนแปลงค่าได้พร้อมกับการอ้างอิงแบบเปลี่ยนแปลงค่าไม่ได้ แต่สำหรับพอยน์เตอร์ดิบ เราสามารถสร้างทั้งพอยน์เตอร์แบบเปลี่ยนแปลงค่าได้และเปลี่ยนแปลงค่าไม่ได้ชี้ไปยังตำแหน่งเดียวกัน พร้อมทั้งแก้ไขข้อมูลผ่านพอยน์เตอร์แบบเปลี่ยนแปลงค่าได้ ซึ่งอาจก่อให้เกิดภาวะแย่งชิงข้อมูล (data race) ได้ จึงต้องใช้ความระมัดระวังอย่างยิ่ง!
เมื่อมีความเสี่ยงมากมายขนาดนี้ ทำไมเราถึงยังต้องใช้พอยน์เตอร์ดิบอยู่อีก? กรณีการใช้งานหลักข้อหนึ่งคือการเชื่อมต่อกับโค้ดภาษา C ดังที่คุณจะได้เห็นในหัวข้อถัดไป อีกกรณีหนึ่งคือการสร้างแอบสแตรกชันที่ปลอดภัยซึ่งตัวตรวจการยืมไม่สามารถเข้าใจได้ เราจะแนะนำฟังก์ชัน unsafe ให้รู้จักกันก่อน แล้วจึงไปดูตัวอย่างการสร้างแอบสแตรกชันที่ปลอดภัยซึ่งอาศัยโค้ด unsafe ในการทำงาน
การเรียกฟังก์ชันหรือเมธอด unsafe
การทำงานประเภทที่ 2 ที่คุณสามารถทำได้ในบล็อก unsafe คือการเรียกใช้ฟังก์ชันที่เป็น unsafe โดยฟังก์ชันและเมธอด unsafe มีหน้าตาเหมือนกับฟังก์ชันและเมธอดปกติทุกประการ เพียงแต่มีคำสงวน unsafe เพิ่มเข้ามาด้านหน้านิยามส่วนที่เหลือ คำสงวน unsafe ในบริบทนี้บ่งชี้ว่าฟังก์ชันดังกล่าวมีข้อกำหนดและเงื่อนไขที่เราต้องดูแลรักษาให้ถูกต้องเมื่อเรียกใช้งาน เนื่องจาก Rust ไม่สามารถตรวจสอบและรับประกันได้ว่าเราปฏิบัติตามข้อกำหนดเหล่านั้นครบถ้วน การเรียกใช้ฟังก์ชัน unsafe ภายในบล็อก unsafe จึงเป็นการยืนยันว่าเราได้อ่านเอกสารประกอบของฟังก์ชันนี้แล้ว และเราขอรับผิดชอบในการปฏิบัติตามข้อตกลง (contract) ของฟังก์ชันด้วยตนเอง
นี่คือตัวอย่างฟังก์ชัน unsafe ชื่อ dangerous ซึ่งไม่ได้ทำอะไรเลยในบอดี้ของมัน:
fn main() {
unsafe fn dangerous() {}
unsafe {
dangerous();
}
}เราจำเป็นต้องเรียกใช้ฟังก์ชัน dangerous ภายในบล็อก unsafe แยกต่างหาก หากเราพยายามเรียก dangerous โดยไม่มีบล็อก unsafe เราจะพบกับข้อผิดพลาด:
$ cargo run
Compiling unsafe-example v0.1.0 (file:///projects/unsafe-example)
error[E0133]: call to unsafe function `dangerous` is unsafe and requires unsafe block
--> src/main.rs:4:5
|
4 | dangerous();
| ^^^^^^^^^^^ call to unsafe function
|
= note: consult the function's documentation for information on how to avoid undefined behavior
For more information about this error, try `rustc --explain E0133`.
error: could not compile `unsafe-example` (bin "unsafe-example") due to 1 previous error
การครอบด้วยบล็อก unsafe เป็นการยืนยันกับ Rust ว่าเราได้ศึกษาเอกสารของฟังก์ชัน เข้าใจวิธีใช้งานอย่างถูกต้อง และตรวจสอบแล้วว่าเราได้ปฏิบัติตามข้อตกลงของฟังก์ชันครบถ้วน
สำหรับการดำเนินการ unsafe ภายในบอดี้ของฟังก์ชัน unsafe คุณยังคงต้องใช้บล็อก unsafe เช่นเดียวกับในฟังก์ชันปกติ และคอมไพเลอร์จะแจ้งเตือนหากคุณลืมใส่ สิ่งนี้ช่วยให้เรารักษาบล็อก unsafe ให้มีขนาดเล็กที่สุดเท่าที่จะทำได้ เนื่องจากการดำเนินการ unsafe อาจไม่จำเป็นต้องครอบคลุมตลอดทั้งบอดี้ของฟังก์ชัน
การสร้างแอบสแตรกชันที่ปลอดภัยครอบโค้ด unsafe
เพียงเพราะฟังก์ชันหนึ่งมีโค้ด unsafe อยู่ข้างใน ไม่ได้หมายความว่าเราจำเป็นต้องทำเครื่องหมายฟังก์ชันนั้นทั้งฟังก์ชันว่าเป็น unsafe ในความเป็นจริง การห่อหุ้มโค้ด unsafe ไว้ในฟังก์ชันที่ปลอดภัยถือเป็นแอบสแตรกชันที่พบได้เป็นปกติ ตัวอย่างเช่น ลองมาศึกษาฟังก์ชัน split_at_mut จากไลบรารีมาตรฐาน ซึ่งต้องอาศัยโค้ด unsafe ในบางจุด เราจะมาดูวิธีอิมพลีเมนต์ฟังก์ชันนี้กัน โดยเมธอดที่ปลอดภัยนี้ถูกนิยามไว้บนสไลซ์แบบเปลี่ยนแปลงค่าได้ (mutable slice) ซึ่งรับสไลซ์เข้ามาหนึ่งตัว แล้วแยกออกเป็นสองตัวตามตำแหน่งดัชนีที่ส่งเข้ามาเป็นอาร์กิวเมนต์ ลิสติ้ง 20-4 แสดงวิธีเรียกใช้งาน split_at_mut
fn main() {
let mut v = vec![1, 2, 3, 4, 5, 6];
let r = &mut v[..];
let (a, b) = r.split_at_mut(3);
assert_eq!(a, &mut [1, 2, 3]);
assert_eq!(b, &mut [4, 5, 6]);
}เราไม่สามารถอิมพลีเมนต์ฟังก์ชันนี้โดยอาศัยเพียง safe Rust ได้ ตัวอย่างความพยายามอาจมีลักษณะดังลิสติ้ง 20-5 ซึ่งจะไม่สามารถคอมไพล์ผ่านได้ เพื่อความเข้าใจง่าย เราจะอิมพลีเมนต์ split_at_mut เป็นฟังก์ชันแทนที่จะเป็นเมธอด และรองรับเฉพาะสไลซ์ของค่า i32 แทนที่จะเป็นชนิดข้อมูลเจเนอริก T
fn split_at_mut(values: &mut [i32], mid: usize) -> (&mut [i32], &mut [i32]) {
let len = values.len();
assert!(mid <= len);
(&mut values[..mid], &mut values[mid..])
}
fn main() {
let mut vector = vec![1, 2, 3, 4, 5, 6];
let (left, right) = split_at_mut(&mut vector, 3);
}ฟังก์ชันนี้เริ่มต้นด้วยการหาความยาวทั้งหมดของสไลซ์ จากนั้นตรวจสอบยืนยัน (assert) ว่าดัชนีที่ส่งเข้ามาเป็นพารามิเตอร์นั้นอยู่ภายในขอบเขตของสไลซ์ โดยตรวจดูว่าค่าน้อยกว่าหรือเท่ากับความยาวหรือไม่ การยืนยันนี้หมายความว่า หากเราส่งดัชนีที่มีค่ามากกว่าความยาวเพื่อใช้ตัดแบ่งสไลซ์ ฟังก์ชันจะเกิดอาการแพนิก (panic) ก่อนที่จะพยายามนำดัชนีนั้นไปใช้งานจริง
จากนั้น เราคืนค่าทูเพิล (tuple) ที่บรรจุสไลซ์แบบเปลี่ยนแปลงค่าได้สองตัว: ตัวหนึ่งเริ่มตั้งแต่จุดเริ่มต้นของสไลซ์เดิมไปจนถึงดัชนี mid และอีกตัวเริ่มตั้งแต่ mid ไปจนถึงจุดสิ้นสุดของสไลซ์
เมื่อเราพยายามคอมไพล์โค้ดในลิสติ้ง 20-5 เราจะได้รับข้อผิดพลาดดังนี้:
$ cargo run
Compiling unsafe-example v0.1.0 (file:///projects/unsafe-example)
error[E0499]: cannot borrow `*values` as mutable more than once at a time
--> src/main.rs:6:31
|
1 | fn split_at_mut(values: &mut [i32], mid: usize) -> (&mut [i32], &mut [i32]) {
| - let's call the lifetime of this reference `'1`
...
6 | (&mut values[..mid], &mut values[mid..])
| --------------------------^^^^^^--------
| | | |
| | | second mutable borrow occurs here
| | first mutable borrow occurs here
| returning this value requires that `*values` is borrowed for `'1`
|
= help: use `.split_at_mut(position)` to obtain two mutable non-overlapping sub-slices
For more information about this error, try `rustc --explain E0499`.
error: could not compile `unsafe-example` (bin "unsafe-example") due to 1 previous error
ตัวตรวจการยืมของ Rust ไม่เข้าใจว่าเรากำลังขอยืมส่วนต่าง ๆ ของสไลซ์ที่ไม่ทับซ้อนกัน มันรู้เพียงว่าเรากำลังขอยืมจากสไลซ์เดียวกันถึงสองครั้ง ในความเป็นจริง การขอยืมส่วนต่าง ๆ ของสไลซ์ย่อมทำได้อย่างปลอดภัยเพราะสไลซ์ทั้งสองไม่มีส่วนใดทับซ้อนกัน แต่ Rust ไม่ฉลาดพอที่จะรับรู้ข้อเท็จจริงนี้ เมื่อเรารู้แน่ชัดว่าโค้ดทำงานได้ถูกต้อง แต่ตัว Rust ไม่รู้ นั่นคือจังหวะเวลาที่เราต้องหยิบโค้ด unsafe เข้ามาช่วย
ลิสติ้ง 20-6 แสดงวิธีนำบล็อก unsafe, พอยน์เตอร์ดิบ และการเรียกใช้ฟังก์ชัน unsafe มาช่วยให้การอิมพลีเมนต์ split_at_mut ทำงานได้สำเร็จ
use std::slice;
fn split_at_mut(values: &mut [i32], mid: usize) -> (&mut [i32], &mut [i32]) {
let len = values.len();
let ptr = values.as_mut_ptr();
assert!(mid <= len);
unsafe {
(
slice::from_raw_parts_mut(ptr, mid),
slice::from_raw_parts_mut(ptr.add(mid), len - mid),
)
}
}
fn main() {
let mut vector = vec![1, 2, 3, 4, 5, 6];
let (left, right) = split_at_mut(&mut vector, 3);
}ย้อนนึกถึงหัวข้อ“ชนิดสไลซ์” ในบทที่ 4 ซึ่งระบุว่าสไลซ์ประกอบด้วยพอยน์เตอร์ที่ชี้ไปยังข้อมูลส่วนหนึ่งและค่าความยาวของสไลซ์ เราใช้เมธอด len เพื่อหาความยาวของสไลซ์ และใช้เมธอด as_mut_ptr เพื่อเข้าถึงพอยน์เตอร์ดิบของสไลซ์ ในกรณีนี้ เนื่องจากเรามีสไลซ์แบบเปลี่ยนแปลงค่าได้ไปยังค่า i32 เมธอด as_mut_ptr จึงคืนค่าพอยน์เตอร์ดิบชนิด *mut i32 ซึ่งเรานำมาเก็บไว้ในตัวแปร ptr
เรายังคงการยืนยันว่าดัชนี mid อยู่ในขอบเขตของสไลซ์ไว้ จากนั้นก็เข้าสู่ส่วนของโค้ด unsafe: ฟังก์ชัน slice::from_raw_parts_mut รับพอยน์เตอร์ดิบและความยาว แล้วสร้างสไลซ์ขึ้นมา เราใช้ฟังก์ชันนี้สร้างสไลซ์ที่เริ่มต้นจาก ptr และมีความยาวเท่ากับ mid รายการ จากนั้น เราเรียกเมธอด add บน ptr โดยส่ง mid เป็นอาร์กิวเมนต์ เพื่อให้ได้พอยน์เตอร์ดิบที่เริ่มต้นที่ตำแหน่ง mid แล้วจึงสร้างสไลซ์โดยใช้พอยน์เตอร์นั้นร่วมกับจำนวนรายการที่เหลืออยู่หลัง mid เป็นความยาว
ฟังก์ชัน slice::from_raw_parts_mut ถือเป็น unsafe เพราะรับพอยน์เตอร์ดิบเข้ามาและต้องไว้วางใจว่าพอยน์เตอร์นี้ชี้ไปยังตำแหน่งที่ถูกต้อง ส่วนเมธอด add บนพอยน์เตอร์ดิบก็เป็น unsafe เช่นกัน เนื่องจากต้องเชื่อใจว่าตำแหน่งที่บวกเยื้องเพิ่มไป (offset) นั้นยังคงเป็นพอยน์เตอร์ที่ถูกต้องสมบูรณ์ ด้วยเหตุนี้ เราจึงต้องครอบการเรียกใช้ slice::from_raw_parts_mut และ add ไว้ด้วยบล็อก unsafe เพื่อให้สามารถเรียกใช้งานได้ เมื่อพิจารณาจากตรรกะของโค้ดและข้อกำหนดที่เราใส่เพิ่มไว้ว่า mid ต้องน้อยกว่าหรือเท่ากับ len เราจึงสามารถบอกได้ว่าพอยน์เตอร์ดิบทั้งหมดที่ใช้ภายในบล็อก unsafe จะเป็นพอยน์เตอร์ที่ถูกต้องและชี้ไปยังข้อมูลภายในสไลซ์อย่างแน่นอน นี่คือตัวอย่างการใช้งาน unsafe ที่เหมาะสมและยอมรับได้
โปรดสังเกตว่าเราไม่จำเป็นต้องทำเครื่องหมายฟังก์ชัน split_at_mut ที่ได้ว่าเป็น unsafe และเราสามารถเรียกใช้ฟังก์ชันนี้จากโค้ดที่เป็น safe Rust ได้ตามปกติ เราได้สร้างแอบสแตรกชันที่ปลอดภัยครอบโค้ด unsafe เอาไว้ ด้วยการอิมพลีเมนต์ฟังก์ชันที่ใช้โค้ด unsafe อย่างปลอดภัย เพราะตัวฟังก์ชันสร้างเฉพาะพอยน์เตอร์ที่ถูกต้องสมบูรณ์จากข้อมูลที่ฟังก์ชันเข้าถึงได้เท่านั้น
ในทางตรงกันข้าม การเรียกใช้ slice::from_raw_parts_mut ในลิสติ้ง 20-7 มีแนวโน้มสูงที่จะทำให้โปรแกรมหยุดทำงานกะทันหัน (crash) เมื่อนำสไลซ์นั้นไปใช้งาน โค้ดนี้หยิบตำแหน่งหน่วยความจำใด ๆ ขึ้นมา แล้วสร้างสไลซ์ที่มีความยาวถึง 10,000 รายการ
fn main() {
use std::slice;
let address = 0x01234usize;
let r = address as *mut i32;
let values: &[i32] = unsafe { slice::from_raw_parts_mut(r, 10000) };
}เราไม่ได้เป็นเจ้าของหน่วยความจำ ณ ตำแหน่งที่ระบุขึ้นมาลอย ๆ นี้ และไม่มีสิ่งใดรับประกันได้เลยว่าสไลซ์ที่โค้ดนี้สร้างขึ้นจะมีค่า i32 ที่ถูกต้องสมบูรณ์อยู่จริง การพยายามนำ values ไปใช้งานเสมือนว่าเป็นสไลซ์ที่สมบูรณ์ จะนำไปสู่พฤติกรรมที่ไม่พึงประสงค์หรือไม่ถูกกำหนดไว้ (undefined behavior)
การใช้ฟังก์ชัน extern เพื่อเรียกโค้ดภายนอก
ในบางครั้งโค้ด Rust ของคุณอาจจำเป็นต้องสื่อสารหรือทำงานร่วมกับโค้ดที่เขียนด้วยภาษาอื่น สำหรับกรณีนี้ Rust มีคำสงวน extern ที่ช่วยอำนวยความสะดวกในการสร้างและใช้งาน Foreign Function Interface (FFI) ซึ่งเป็นกลไกที่เปิดให้ภาษาโปรแกรมหนึ่งสามารถนิยามฟังก์ชัน และอนุญาตให้ภาษาโปรแกรมอื่น (ภาษาภายนอก) สามารถเรียกใช้ฟังก์ชันเหล่านั้นได้
ลิสติ้ง 20-8 สาธิตวิธีเชื่อมต่อกับฟังก์ชัน abs จากไลบรารีมาตรฐานของภาษา C โดยทั่วไปแล้ว ฟังก์ชันที่ประกาศไว้ภายในบล็อก extern จะถือเป็น unsafe เมื่อเรียกใช้จากโค้ด Rust ดังนั้นบล็อก extern จึงต้องกำกับด้วย unsafe เช่นกัน เหตุผลคือภาษาอื่นไม่ได้บังคับใช้กฎและการรับประกันความปลอดภัยของ Rust และ Rust เองก็ไม่สามารถตรวจสอบความปลอดภัยของภาษาเหล่านั้นได้ ความรับผิดชอบจึงตกอยู่กับโปรแกรมเมอร์ที่จะต้องดูแลความปลอดภัยด้วยตนเอง
unsafe extern "C" {
fn abs(input: i32) -> i32;
}
fn main() {
unsafe {
println!("Absolute value of -3 according to C: {}", abs(-3));
}
}ภายในบล็อก unsafe extern "C" เราระบุชื่อและซิกเนเจอร์ของฟังก์ชันภายนอกจากภาษาอื่นที่เราต้องการเรียกใช้ ส่วนคำว่า "C" กำหนดว่าฟังก์ชันภายนอกนั้นใช้ ส่วนต่อประสานไบนารีของแอปพลิเคชัน (application binary interface หรือ ABI) แบบใด: ABI เป็นตัวกำหนดวิธีการเรียกใช้ฟังก์ชันในระดับภาษาแอสเซมบลี ABI แบบ "C" เป็นรูปแบบที่พบได้บ่อยที่สุดและเป็นไปตาม ABI ของภาษาโปรแกรม C คุณสามารถดูข้อมูลเกี่ยวกับ ABI ทั้งหมดที่ Rust รองรับได้ในคู่มืออ้างอิงของ Rust (Rust Reference)
ทุกรายการที่ประกาศภายในบล็อก unsafe extern จะถือเป็น unsafe โดยปริยาย อย่างไรก็ตาม ฟังก์ชัน FFI บางฟังก์ชันก็ปลอดภัยที่จะเรียกใช้งาน ตัวอย่างเช่น ฟังก์ชัน abs จากไลบรารีมาตรฐานของ C ไม่มีประเด็นความเสี่ยงด้านความปลอดภัยของหน่วยความจำใด ๆ และเรารู้ว่าสามารถส่งค่า i32 ใด ๆ ให้ทำงานได้เสมอ ในกรณีเช่นนี้ เราสามารถใช้คำสงวน safe เพื่อระบุเจาะจงว่าฟังก์ชันนี้ปลอดภัยที่จะเรียกใช้งาน แม้ว่าจะอยู่ภายในบล็อก unsafe extern ก็ตาม เมื่อปรับเปลี่ยนเช่นนี้แล้ว การเรียกใช้งานฟังก์ชันดังกล่าวก็ไม่จำเป็นต้องครอบด้วยบล็อก unsafe อีกต่อไป ดังที่แสดงในลิสติ้ง 20-9
unsafe extern "C" {
safe fn abs(input: i32) -> i32;
}
fn main() {
println!("Absolute value of -3 according to C: {}", abs(-3));
}การทำเครื่องหมายฟังก์ชันว่าเป็น safe ไม่ได้ทำให้ฟังก์ชันปลอดภัยขึ้นมาได้ด้วยตัวเองโดยอัตโนมัติ! แต่มันเปรียบเสมือนสัญญาที่คุณให้ไว้กับ Rust ว่าฟังก์ชันนี้ปลอดภัย และยังคงเป็นหน้าที่ของคุณที่จะต้องดูแลให้สัญญานั้นเป็นจริงอยู่เสมอ!
การเรียกฟังก์ชัน Rust จากภาษาอื่น
เรายังสามารถใช้ extern เพื่อสร้างอินเทอร์เฟซที่เปิดให้ภาษาอื่นสามารถเรียกใช้ฟังก์ชันของ Rust ได้ด้วยเช่นกัน โดยแทนที่จะสร้างบล็อก extern ทั้งบล็อก เราจะใส่คำสงวน extern พร้อมระบุ ABI ที่จะใช้ไว้หน้าคำสงวน fn ของฟังก์ชันนั้น ๆ โดยตรง นอกจากนี้เรายังต้องระบุแอตทริบิวต์ #[unsafe(no_mangle)] เพื่อบอกคอมไพเลอร์ Rust ไม่ให้ดัดแปลงชื่อ (mangle) ฟังก์ชันนี้ การดัดแปลงชื่อหรือ mangling คือกระบวนการที่คอมไพเลอร์เปลี่ยนชื่อฟังก์ชันที่เราตั้งไว้ให้เป็นชื่อใหม่ที่บรรจุข้อมูลเพิ่มเติมสำหรับใช้ในขั้นตอนการคอมไพล์ส่วนอื่น ๆ ซึ่งทำให้อ่านเข้าใจได้ยากขึ้นสำหรับมนุษย์ คอมไพเลอร์ของแต่ละภาษาโปรแกรมจะดัดแปลงชื่อแตกต่างกันไป ดังนั้น เพื่อให้ภาษาอื่นสามารถอ้างอิงชื่อฟังก์ชันของ Rust ได้อย่างถูกต้อง เราจึงต้องปิดระบบ name mangling ของคอมไพเลอร์ Rust สิ่งนี้ถือเป็น unsafe เพราะหากไม่มีระบบดัดแปลงชื่อของคอมไพเลอร์ ก็อาจเสี่ยงต่อการเกิดชื่อฟังก์ชันชนกันข้ามไลบรารีได้ เราจึงมีหน้าที่ต้องตรวจสอบให้แน่ใจว่าชื่อที่เราเลือกนั้นปลอดภัยที่จะส่งออก (export) โดยไม่ผ่านการดัดแปลงชื่อ
ในตัวอย่างต่อไปนี้ เราทำให้ฟังก์ชัน call_from_c สามารถเรียกใช้ได้จากโค้ดภาษา C หลังจากคอมไพล์เป็นแชร์ไลบรารี (shared library) และเชื่อมโยง (link) จากฝั่ง C แล้ว:
#[unsafe(no_mangle)]
pub extern "C" fn call_from_c() {
println!("Just called a Rust function from C!");
}
การใช้งาน extern ในลักษณะนี้จำเป็นต้องมี unsafe เฉพาะในแอตทริบิวต์เท่านั้น ไม่ใช่บนบล็อก extern
การเข้าถึงหรือแก้ไขตัวแปร static ที่เปลี่ยนแปลงได้
ในหนังสือเล่มนี้ เรายังไม่ได้พูดถึงตัวแปรแบบโกลบอล (global variable) ซึ่ง Rust ก็รองรับการใช้งานเช่นกัน แต่อาจเกิดปัญหาขัดแย้งกับกฎความเป็นเจ้าของของ Rust ได้ หากมีสองเธรดพยายามเข้าถึงตัวแปรโกลบอลแบบเปลี่ยนแปลงค่าได้ตัวเดียวกัน ก็อาจนำไปสู่ภาวะแย่งชิงข้อมูล (data race) ได้
ในภาษา Rust ตัวแปรโกลบอลจะเรียกว่า ตัวแปร static ลิสติ้ง 20-10 แสดงตัวอย่างการประกาศและใช้งานตัวแปร static ที่เก็บค่าเป็นสตริงสไลซ์
static HELLO_WORLD: &str = "Hello, world!";
fn main() {
println!("value is: {HELLO_WORLD}");
}ตัวแปร static มีความคล้ายคลึงกับค่าคงที่ (constant) ซึ่งเราได้พูดคุยกันไปในหัวข้อ“การประกาศค่าคงที่” ในบทที่ 3 ตามธรรมเนียมปฏิบัตินิยมตั้งชื่อตัวแปร static ด้วยรูปแบบ SCREAMING_SNAKE_CASE ตัวแปร static สามารถจัดเก็บได้เฉพาะการอ้างอิงที่มีไลฟ์ไทม์เป็น 'static เท่านั้น ซึ่งหมายความว่าคอมไพเลอร์ Rust สามารถอนุมานไลฟ์ไทม์ได้เองโดยที่เราไม่จำเป็นต้องระบุไว้อย่างชัดแจ้ง การเข้าถึงตัวแปร static แบบเปลี่ยนแปลงค่าไม่ได้นั้นถือว่าปลอดภัย
จุดแตกต่างอันละเอียดอ่อนระหว่างค่าคงที่กับตัวแปร static แบบเปลี่ยนแปลงค่าไม่ได้ คือ ค่าในตัวแปร static จะมีตำแหน่งแอดเดรสในหน่วยความจำที่แน่นอนตายตัว การเรียกใช้ค่าดังกล่าวจะเข้าถึงข้อมูลตำแหน่งเดิมเสมอ ในทางกลับกัน ค่าคงที่สามารถคัดลอกข้อมูลซ้ำใหม่ได้ทุกครั้งที่มีการหยิบไปใช้งาน จุดแตกต่างอีกประการหนึ่งคือตัวแปร static สามารถกำหนดให้เปลี่ยนแปลงค่าได้ ซึ่งการเข้าถึงและแก้ไขตัวแปร static แบบเปลี่ยนแปลงค่าได้นั้น_เป็น unsafe_ ลิสติ้ง 20-11 แสดงวิธีประกาศ เข้าถึง และแก้ไขตัวแปร static แบบเปลี่ยนแปลงค่าได้ที่มีชื่อว่า COUNTER
static mut COUNTER: u32 = 0;
/// SAFETY: Calling this from more than a single thread at a time is undefined
/// behavior, so you *must* guarantee you only call it from a single thread at
/// a time.
unsafe fn add_to_count(inc: u32) {
unsafe {
COUNTER += inc;
}
}
fn main() {
unsafe {
// SAFETY: This is only called from a single thread in `main`.
add_to_count(3);
println!("COUNTER: {}", *(&raw const COUNTER));
}
}เช่นเดียวกับตัวแปรทั่วไป เรากำหนดให้เปลี่ยนแปลงค่าได้โดยใช้คำสงวน mut โดยโค้ดใดก็ตามที่อ่านหรือเขียนค่าไปยัง COUNTER จะต้องอยู่ภายในบล็อก unsafe โค้ดในลิสติ้ง 20-11 สามารถคอมไพล์ผ่านและพิมพ์ผลลัพธ์ COUNTER: 3 ออกมาได้ตามที่คาดหมายไว้ เนื่องจากโปรแกรมทำงานอยู่บนเธรดเดียว แต่หากมีหลายเธรดเข้าถึง COUNTER พร้อมกัน ก็มีโอกาสสูงมากที่จะเกิด data race ขึ้น จึงถือเป็นพฤติกรรมที่ไม่พึงประสงค์หรือไม่ถูกกำหนดไว้ ดังนั้น เราจึงต้องทำเครื่องหมายทั้งฟังก์ชันว่าเป็น unsafe พร้อมทั้งบันทึกเอกสารกำกับข้อจำกัดด้านความปลอดภัยไว้ เพื่อให้ทุกคนที่เรียกใช้ฟังก์ชันนี้ทราบว่าตนเองสามารถทำอะไรได้อย่างปลอดภัยและมีสิ่งใดที่ห้ามทำบ้าง
เมื่อใดก็ตามที่เราเขียนฟังก์ชัน unsafe ถือเป็นแนวทางปฏิบัติที่ดี (idiomatic) ในการเขียนคอมเมนต์ขึ้นต้นด้วย SAFETY เพื่ออธิบายว่าผู้เรียกใช้ฟังก์ชันจำเป็นต้องทำสิ่งใดบ้างเพื่อให้สามารถเรียกใช้งานฟังก์ชันได้อย่างปลอดภัย ในทำนองเดียวกัน เมื่อใดก็ตามที่เราทำการดำเนินการ unsafe ก็ถือเป็นแนวทางปฏิบัติที่ดีในการเขียนคอมเมนต์ขึ้นต้นด้วย SAFETY เพื่ออธิบายว่ากฎเกณฑ์ด้านความปลอดภัยต่าง ๆ ได้รับการปฏิบัติตามอย่างไร
นอกจากนี้ คอมไพเลอร์จะปฏิเสธความพยายามสร้างการอ้างอิงไปยังตัวแปร static แบบเปลี่ยนแปลงค่าได้เป็นค่าเริ่มต้นผ่าน lint ของคอมไพเลอร์ คุณต้องเลือกระงับการป้องกันของ lint ดังกล่าวอย่างชัดแจ้งด้วยแอตทริบิวต์ #[allow(static_mut_refs)] หรือไม่ก็เข้าถึงตัวแปร static แบบเปลี่ยนแปลงค่าได้ผ่านทางพอยน์เตอร์ดิบที่สร้างขึ้นด้วยตัวดำเนินการยืมแบบ raw ซึ่งรวมถึงกรณีที่การอ้างอิงถูกสร้างขึ้นโดยไม่รู้ตัว เช่น เมื่อนำไปใช้งานใน println! ในลิสติ้งโค้ดนี้ การกำหนดให้การอ้างอิงไปยังตัวแปร static แบบเปลี่ยนแปลงค่าได้ต้องสร้างผ่านพอยน์เตอร์ดิบ ช่วยทำให้ข้อกำหนดด้านความปลอดภัยในการใช้งานตัวแปรเหล่านี้ชัดเจนยิ่งขึ้น
เมื่อข้อมูลที่เปลี่ยนแปลงค่าได้สามารถเข้าถึงได้จากทั่วทั้งโปรแกรม ย่อมเป็นการยากที่จะรับประกันว่าจะไม่เกิด data race ขึ้น นี่จึงเป็นเหตุผลที่ Rust ถือว่าตัวแปร static แบบเปลี่ยนแปลงค่าได้เป็น unsafe เมื่อเป็นไปได้ จึงแนะนำให้เลือกใช้เทคนิคการทำงานพร้อมกัน (concurrency) และสมาร์ตพอยน์เตอร์ที่ปลอดภัยต่อการใช้งานข้ามเธรด (thread-safe smart pointer) ดังที่เราได้พูดคุยกันในบทที่ 16 แทน เพื่อให้คอมไพเลอร์ช่วยตรวจสอบว่าการเข้าถึงข้อมูลจากเธรดต่าง ๆ กระทำได้อย่างปลอดภัย
การอิมพลีเมนต์เทรต unsafe
เราสามารถใช้ unsafe เพื่ออิมพลีเมนต์เทรตที่เป็น unsafe ได้ โดยเทรตจะถือว่าเป็น unsafe ก็ต่อเมื่อมีเมธอดอย่างน้อยหนึ่งตัวที่มีเงื่อนไขคงที่ (invariant) บางประการที่คอมไพเลอร์ไม่สามารถตรวจสอบได้ เราประกาศว่าเทรตใดเป็น unsafe ได้โดยใส่คำสงวน unsafe ไว้หน้าคำว่า trait และทำเครื่องหมายการอิมพลีเมนต์เทรตนั้นว่าเป็น unsafe ด้วยเช่นกัน ดังที่แสดงในลิสติ้ง 20-12
unsafe trait Foo {
// methods go here
}
unsafe impl Foo for i32 {
// method implementations go here
}
fn main() {}การใช้ unsafe impl เป็นการให้คำสัญญาว่าเราจะดูแลรักษาเงื่อนไขคงที่ที่คอมไพเลอร์ไม่สามารถตรวจสอบให้ได้นั้นด้วยตนเอง
ตัวอย่างเช่น ย้อนนึกถึงเทรตบ่งชี้ (marker trait) อย่าง Send และ Sync ที่เราได้พูดคุยกันในหัวข้อ“การทำงานพร้อมกันแบบขยายได้ด้วย Send และ Sync” ในบทที่ 16: คอมไพเลอร์จะอิมพลีเมนต์เทรตเหล่านี้ให้โดยอัตโนมัติหากชนิดข้อมูลของเราประกอบขึ้นมาจากชนิดข้อมูลอื่นที่ต่างก็อิมพลีเมนต์ Send และ Sync ครบทั้งหมด แต่หากเราอิมพลีเมนต์ชนิดข้อมูลที่มีสมาชิกเป็นชนิดข้อมูลที่ไม่ได้อิมพลีเมนต์ Send หรือ Sync (เช่น พอยน์เตอร์ดิบ) แล้วเราต้องการทำเครื่องหมายให้ชนิดข้อมูลนั้นเป็น Send หรือ Sync เราจำเป็นต้องใช้ unsafe เนื่องจาก Rust ไม่สามารถตรวจสอบได้ว่าชนิดข้อมูลของเรารักษาการรับประกันว่าจะสามารถส่งต่อข้ามเธรด หรือเข้าถึงพร้อมกันจากหลายเธรดได้อย่างปลอดภัยหรือไม่ เราจึงต้องดำเนินการตรวจสอบเหล่านั้นด้วยตนเอง และยืนยันความปลอดภัยด้วยคำสงวน unsafe
การเข้าถึงฟิลด์ของ union
การทำงานประการสุดท้ายที่ใช้ได้เฉพาะใน unsafe คือการเข้าถึงฟิลด์ต่าง ๆ ของ union โดย union มีลักษณะคล้ายกับ struct แต่จะมีฟิลด์ที่ประกาศไว้เพียงฟิลด์เดียวเท่านั้นที่ถูกใช้งานในอินสแตนซ์หนึ่ง ๆ ณ ช่วงเวลาใดเวลาหนึ่ง การใช้งาน union มีวัตถุประสงค์หลักเพื่อเชื่อมต่อกับ union ในโค้ดภาษา C การเข้าถึงฟิลด์ของ union ถือเป็น unsafe เนื่องจาก Rust ไม่สามารถรับประกันชนิดข้อมูลของข้อมูลที่กำลังจัดเก็บอยู่ในอินสแตนซ์ของ union นั้นได้ คุณสามารถศึกษาเพิ่มเติมเกี่ยวกับ union ได้ในคู่มืออ้างอิงของ Rust (Rust Reference)
การใช้ Miri เพื่อตรวจสอบโค้ด unsafe
เมื่อเขียนโค้ด unsafe คุณอาจต้องการตรวจสอบให้แน่ใจว่าสิ่งที่คุณเขียนนั้นปลอดภัยและถูกต้องจริง ๆ หรือไม่ หนึ่งในวิธีที่ดีที่สุดคือการใช้ Miri ซึ่งเป็นเครื่องมืออย่างเป็นทางการของ Rust สำหรับตรวจจับพฤติกรรมที่ไม่พึงประสงค์หรือไม่ถูกกำหนดไว้ (undefined behavior) ในขณะที่ตัวตรวจการยืมเป็นเครื่องมือแบบ_สแตติก (static)_ ที่ทำงานในตอนคอมไพล์ Miri จะเป็นเครื่องมือแบบ_ไดนามิก (dynamic)_ ที่ทำงานในตอนรันไทม์ โดยจะตรวจสอบโค้ดของคุณด้วยการรันโปรแกรมจริงหรือรันชุดการทดสอบ แล้วตรวจจับเมื่อมีการละเมิดกฎเกณฑ์การทำงานของ Rust ตามที่มันเข้าใจ
การใช้งาน Miri จำเป็นต้องใช้ Rust รุ่น nightly (ซึ่งเราจะอธิบายเพิ่มเติมในภาคผนวก G: กระบวนการพัฒนา Rust และ “Nightly Rust”) คุณสามารถติดตั้ง Rust เวอร์ชัน nightly และเครื่องมือ Miri ได้โดยพิมพ์คำสั่ง rustup +nightly component add miri การทำเช่นนี้ไม่ได้เปลี่ยนเวอร์ชันของ Rust ที่โปรเจกต์ของคุณใช้งานอยู่ แต่เป็นเพียงการเพิ่มเครื่องมือลงในระบบเพื่อให้คุณสามารถเรียกใช้เมื่อต้องการได้ คุณสามารถรัน Miri บนโปรเจกต์ได้โดยสั่ง cargo +nightly miri run หรือ cargo +nightly miri test
เพื่อแสดงให้เห็นว่าเครื่องมือนี้มีประโยชน์เพียงใด ลองมาดูสิ่งที่จะเกิดขึ้นเมื่อเรารัน Miri กับโค้ดในลิสติ้ง 20-7:
$ cargo +nightly miri run
Compiling unsafe-example v0.1.0 (file:///projects/unsafe-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.17s
Running `file:///home/.rustup/toolchains/nightly/bin/cargo-miri runner target/miri/debug/unsafe-example`
warning: integer-to-pointer cast
--> src/main.rs:5:13
|
5 | let r = address as *mut i32;
| ^^^^^^^^^^^^^^^^^^^ integer-to-pointer cast
|
= help: this program is using integer-to-pointer casts or (equivalently) `ptr::with_exposed_provenance`, which means that Miri might miss pointer bugs in this program
= help: see https://doc.rust-lang.org/nightly/std/ptr/fn.with_exposed_provenance.html for more details on that operation
= help: to ensure that Miri does not miss bugs in your program, use Strict Provenance APIs (https://doc.rust-lang.org/nightly/std/ptr/index.html#strict-provenance, https://crates.io/crates/sptr) instead
= help: you can then set `MIRIFLAGS=-Zmiri-strict-provenance` to ensure you are not relying on `with_exposed_provenance` semantics
= help: alternatively, `MIRIFLAGS=-Zmiri-permissive-provenance` disables this warning
error: Undefined Behavior: constructing invalid value of type &mut [i32]: encountered a dangling reference (0x1234[noalloc] has no provenance)
--> src/main.rs:7:35
|
7 | let values: &[i32] = unsafe { slice::from_raw_parts_mut(r, 10000) };
| ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ Undefined Behavior occurred here
|
= help: this indicates a bug in the program: it performed an invalid operation, and caused Undefined Behavior
= help: see https://doc.rust-lang.org/nightly/reference/behavior-considered-undefined.html for further information
note: some details are omitted, run with `MIRIFLAGS=-Zmiri-backtrace=full` for a verbose backtrace
error: aborting due to 1 previous error; 1 warning emitted
Miri แจ้งเตือนอย่างถูกต้องว่าเรากำลังแปลงเลขจำนวนเต็มไปเป็นพอยน์เตอร์ ซึ่งอาจก่อให้เกิดปัญหาได้ แต่ Miri ยังไม่สามารถฟันธงได้ว่ามีปัญหาจริงหรือไม่ เนื่องจากมันไม่ทราบที่มาที่ไปของพอยน์เตอร์นั้น จากนั้น Miri จะส่งข้อผิดพลาดออกมาตรงจุดที่ลิสติ้ง 20-7 มีพฤติกรรมที่ไม่พึงประสงค์ เนื่องจากเรามีพอยน์เตอร์ค้าง (dangling pointer) ที่ชี้ไปยังตำแหน่งที่ไม่ถูกต้อง ด้วยความช่วยเหลือของ Miri ทำให้ตอนนี้เราทราบถึงความเสี่ยงของการเกิด undefined behavior และสามารถหาวิธีปรับปรุงโค้ดให้ปลอดภัยได้ ในบางกรณี Miri ยังสามารถให้คำแนะนำเกี่ยวกับวิธีแก้ไขข้อผิดพลาดได้อีกด้วย
อย่างไรก็ตาม Miri ไม่ได้ตรวจจับทุกข้อผิดพลาดที่คุณอาจทำพลาดในการเขียนโค้ด unsafe เนื่องจาก Miri เป็นเครื่องมือวิเคราะห์แบบไดนามิก จึงตรวจจับปัญหาได้เฉพาะกับโค้ดส่วนที่ถูกรันจริงเท่านั้น นั่นหมายความว่าคุณจำเป็นต้องใช้งานมันควบคู่ไปกับเทคนิคการทดสอบที่ดีเพื่อเพิ่มความมั่นใจในโค้ด unsafe ที่คุณเขียนขึ้น นอกจากนี้ Miri ยังไม่ได้ครอบคลุมทุกแง่มุมที่โค้ดของคุณอาจไม่ปลอดภัยสมบูรณ์ (unsound)
กล่าวอีกนัยหนึ่งคือ: หาก Miri ตรวจพบปัญหา คุณก็มั่นใจได้เลยว่ามีบั๊กอยู่แน่นอน แต่การที่ Miri ตรวจไม่พบบั๊ก ก็ไม่ได้แปลว่าจะไม่มีปัญหาใด ๆ ซ่อนอยู่ ถึงกระนั้น Miri ก็สามารถตรวจจับข้อผิดพลาดได้เป็นจำนวนมาก ลองนำไปรันกับตัวอย่างโค้ด unsafe อื่น ๆ ในบทนี้ดู แล้วสังเกตผลลัพธ์ที่ได้รับ!
คุณสามารถเรียนรู้เพิ่มเติมเกี่ยวกับ Miri ได้ที่ GitHub repository ของ Miri
การใช้โค้ด unsafe อย่างถูกต้อง
การใช้คำสงวน unsafe เพื่อใช้งานพลังพิเศษอย่างใดอย่างหนึ่งใน 5 ข้อที่เพิ่งกล่าวถึงไปนั้นไม่ใช่เรื่องผิด และไม่ใช่เรื่องที่น่าตำหนิแต่อย่างใด เพียงแต่การเขียนโค้ด unsafe ให้ถูกต้องสมบูรณ์นั้นทำได้ยากกว่า เพราะคอมไพเลอร์ไม่สามารถช่วยดูแลความปลอดภัยของหน่วยความจำให้ได้ เมื่อคุณมีเหตุผลจำเป็นต้องใช้โค้ด unsafe คุณก็สามารถใช้งานได้ และการกำกับด้วย unsafe ไว้อย่างชัดเจนจะช่วยให้ค้นหาต้นตอของปัญหาได้ง่ายยิ่งขึ้นเมื่อเกิดข้อผิดพลาดขึ้น และเมื่อใดก็ตามที่คุณเขียนโค้ด unsafe คุณสามารถนำ Miri มาช่วยเพิ่มความมั่นใจว่าโค้ดที่คุณเขียนนั้นยังคงปฏิบัติตามกฎเกณฑ์ของ Rust ได้
สำหรับการศึกษาเชิงลึกเพิ่มเติมเกี่ยวกับวิธีการทำงานกับ unsafe Rust อย่างมีประสิทธิภาพ สามารถอ่านเพิ่มเติมได้จากคู่มืออย่างเป็นทางการของ Rust สำหรับ unsafe นั่นคือ “The Rustonomicon”
เทรตขั้นสูง
เทรตขั้นสูง
เราได้แนะนำให้รู้จักกับเทรต (trait) เป็นครั้งแรกในหัวข้อ“นิยามพฤติกรรมร่วมด้วยเทรต” ในบทที่ 10 แต่ในตอนนั้นเรายังไม่ได้ลงลึกถึงรายละเอียดขั้นสูง เมื่อตอนนี้คุณมีความเข้าใจเกี่ยวกับ Rust มากขึ้นแล้ว เราจึงพร้อมที่จะมาเจาะลึกในรายละเอียดปลีกย่อยกัน
การนิยามเทรตด้วยชนิดข้อมูลที่เชื่อมโยง
ชนิดข้อมูลที่เชื่อมโยง (associated types) ทำหน้าที่เชื่อมตัวแทนชนิดข้อมูล (type placeholder) เข้ากับเทรต เพื่อให้นิยามเมธอดของเทรตสามารถนำชนิดข้อมูลตัวแทนเหล่านี้ไปใช้ในซิกเนเจอร์ได้ โดยผู้ที่อิมพลีเมนต์เทรตจะเป็นผู้ระบุชนิดข้อมูลที่เป็นรูปธรรม (concrete type) ที่จะนำมาใช้งานแทนตัวแทนชนิดข้อมูลสำหรับการอิมพลีเมนต์นั้น ๆ ด้วยวิธีนี้ เราจึงสามารถนิยามเทรตที่ใช้ชนิดข้อมูลบางอย่างได้ โดยไม่จำเป็นต้องรู้ล่วงหน้าว่าชนิดข้อมูลจริง ๆ คืออะไร จนกระทั่งถึงเวลาที่เทรตนั้นถูกนำไปอิมพลีเมนต์
เราได้เกริ่นไว้ว่าฟีเจอร์ขั้นสูงส่วนใหญ่ในบทนี้มักไม่ค่อยได้ใช้งานบ่อยนัก แต่ชนิดข้อมูลที่เชื่อมโยงจะอยู่ตรงกึ่งกลาง กล่าวคือ มีการใช้งานน้อยกว่าฟีเจอร์ทั่วไปที่อธิบายไว้ในส่วนอื่น ๆ ของหนังสือ แต่ก็ยังพบบ่อยกว่าฟีเจอร์ขั้นสูงตัวอื่น ๆ ที่กล่าวถึงในบทนี้
ตัวอย่างหนึ่งของเทรตที่มีชนิดข้อมูลที่เชื่อมโยงคือเทรต Iterator ในไลบรารีมาตรฐาน ชนิดข้อมูลที่เชื่อมโยงนี้มีชื่อว่า Item ซึ่งทำหน้าที่เป็นตัวแทนของชนิดข้อมูลของค่าที่ชนิดข้อมูลผู้อิมพลีเมนต์เทรต Iterator กำลังวนซ้ำอยู่ นิยามของเทรต Iterator มีลักษณะดังที่แสดงในลิสติ้ง 20-13
pub trait Iterator {
type Item;
fn next(&mut self) -> Option<Self::Item>;
}ชนิดข้อมูล Item เป็นเพียงตัวแทน และนิยามของเมธอด next แสดงให้เห็นว่าจะคืนค่าเป็นชนิด Option<Self::Item> โดยผู้ที่อิมพลีเมนต์เทรต Iterator จะเป็นผู้ระบุชนิดข้อมูลที่เป็นรูปธรรมสำหรับ Item และเมธอด next จะคืนค่า Option ที่บรรจุค่าของชนิดข้อมูลที่เป็นรูปธรรมนั้น
ชนิดข้อมูลที่เชื่อมโยงอาจดูคล้ายกับแนวคิดของเจเนอริก (generics) ตรงที่เปิดให้เรานิยามฟังก์ชันได้โดยไม่ต้องระบุชนิดข้อมูลที่เจาะจงล่วงหน้า เพื่อทำความเข้าใจความแตกต่างระหว่างสองแนวคิดนี้ เราจะมาดูการอิมพลีเมนต์เทรต Iterator บนชนิดข้อมูลที่ชื่อว่า Counter ซึ่งระบุให้ชนิดข้อมูล Item เป็น u32:
struct Counter {
count: u32,
}
impl Counter {
fn new() -> Counter {
Counter { count: 0 }
}
}
impl Iterator for Counter {
type Item = u32;
fn next(&mut self) -> Option<Self::Item> {
// --snip--
if self.count < 5 {
self.count += 1;
Some(self.count)
} else {
None
}
}
}ไวยากรณ์นี้ดูเทียบเคียงได้กับไวยากรณ์ของเจเนอริก แล้วทำไมเราถึงไม่นิยามเทรต Iterator ด้วยเจเนอริกไปเลยล่ะ ดังที่แสดงในลิสติ้ง 20-14?
pub trait Iterator<T> {
fn next(&mut self) -> Option<T>;
}ความแตกต่างคือ เมื่อใช้เจเนอริกดังในลิสติ้ง 20-14 เราจะต้องระบุชนิดข้อมูลในการอิมพลีเมนต์แต่ละครั้ง และเนื่องจากเราสามารถอิมพลีเมนต์ Iterator<String> for Counter หรือชนิดข้อมูลอื่นใดก็ได้ เราจึงอาจมีโค้ดการอิมพลีเมนต์ Iterator ให้กับ Counter ได้หลายแบบ กล่าวคือ เมื่อเทรตมีพารามิเตอร์เจเนอริก เทรตนั้นจะสามารถอิมพลีเมนต์ให้กับชนิดข้อมูลหนึ่ง ๆ ได้หลายครั้ง โดยเปลี่ยนชนิดข้อมูลที่เป็นรูปธรรมของพารามิเตอร์เจเนอริกในแต่ละครั้ง ส่งผลให้เวลาที่เราเรียกใช้เมธอด next บน Counter เราจะต้องระบุชนิดข้อมูลกำกับไว้ด้วยเสมอ เพื่อบอกว่าเราต้องการเรียกใช้การอิมพลีเมนต์ของ Iterator ตัวใด
แต่สำหรับชนิดข้อมูลที่เชื่อมโยง เราไม่จำเป็นต้องระบุชนิดข้อมูลกำกับซ้ำ ๆ เพราะเราสามารถอิมพลีเมนต์เทรตบนชนิดข้อมูลหนึ่งได้เพียงครั้งเดียวเท่านั้น ในลิสติ้ง 20-13 ที่ใช้นิยามแบบชนิดข้อมูลที่เชื่อมโยง เราเลือกได้ว่าชนิดข้อมูลของ Item จะเป็นอะไรเพียงครั้งเดียว เนื่องจากมีบล็อก impl Iterator for Counter ได้เพียงบล็อกเดียวเท่านั้น เราจึงไม่จำเป็นต้องระบุว่าต้องการอิเทอเรเตอร์ (iterator) ของค่า u32 ทุกครั้งที่เรียกใช้ next บน Counter
นอกจากนี้ ชนิดข้อมูลที่เชื่อมโยงยังกลายเป็นส่วนหนึ่งของข้อตกลง (contract) ของเทรตด้วย กล่าวคือ ผู้อิมพลีเมนต์เทรตจะต้องเตรียมชนิดข้อมูลจริงมาแทนที่ตัวแทนของชนิดข้อมูลที่เชื่อมโยงเสมอ โดยชนิดข้อมูลที่เชื่อมโยงมักจะมีชื่อที่สื่อถึงการนำไปใช้งาน และการอธิบายรายละเอียดของชนิดข้อมูลที่เชื่อมโยงไว้ในเอกสาร API ก็ถือเป็นแนวทางปฏิบัติที่ดี
การใช้พารามิเตอร์ชนิดข้อมูลเริ่มต้นและการโอเวอร์โหลดตัวดำเนินการ
เมื่อเราใช้พารามิเตอร์ชนิดข้อมูลเจเนอริก เราสามารถกำหนดชนิดข้อมูลที่เป็นรูปธรรมเริ่มต้น (default concrete type) ให้กับชนิดข้อมูลเจเนอริกนั้นได้ ซึ่งจะช่วยให้ผู้ที่อิมพลีเมนต์เทรตไม่จำเป็นต้องระบุชนิดข้อมูลที่เป็นรูปธรรม หากค่าเริ่มต้นนั้นสามารถใช้งานได้อยู่แล้ว คุณสามารถกำหนดชนิดข้อมูลเริ่มต้นเมื่อประกาศชนิดข้อมูลเจเนอริกด้วยไวยากรณ์ <PlaceholderType=ConcreteType>
ตัวอย่างสถานการณ์ที่เห็นประโยชน์ของเทคนิคนี้ได้อย่างชัดเจนคือ การโอเวอร์โหลดตัวดำเนินการ (operator overloading) ซึ่งคุณสามารถปรับแต่งพฤติกรรมการทำงานของตัวดำเนินการ (เช่น +) ในสถานการณ์เฉพาะเจาะจงได้
Rust ไม่อนุญาตให้คุณสร้างตัวดำเนินการขึ้นมาเอง หรือโอเวอร์โหลดตัวดำเนินการใด ๆ ได้ตามใจชอบ แต่คุณสามารถโอเวอร์โหลดการดำเนินการและเทรตที่เกี่ยวข้องซึ่งระบุไว้ใน std::ops ได้ โดยการอิมพลีเมนต์เทรตที่เชื่อมโยงกับตัวดำเนินการนั้น ๆ ตัวอย่างเช่น ในลิสติ้ง 20-15 เราโอเวอร์โหลดตัวดำเนินการ + เพื่อนำอินสแตนซ์ของ Point สองตัวมาบวกเข้าด้วยกัน ซึ่งทำได้โดยการอิมพลีเมนต์เทรต Add ให้กับ struct Point
use std::ops::Add;
#[derive(Debug, Copy, Clone, PartialEq)]
struct Point {
x: i32,
y: i32,
}
impl Add for Point {
type Output = Point;
fn add(self, other: Point) -> Point {
Point {
x: self.x + other.x,
y: self.y + other.y,
}
}
}
fn main() {
assert_eq!(
Point { x: 1, y: 0 } + Point { x: 2, y: 3 },
Point { x: 3, y: 3 }
);
}เมธอด add นำค่า x ของอินสแตนซ์ Point ทั้งสองตัวมาบวกกัน และนำค่า y ของอินสแตนซ์ Point ทั้งสองตัวมาบวกกัน เพื่อสร้างเป็น Point ตัวใหม่ขึ้นมา เทรต Add มีชนิดข้อมูลที่เชื่อมโยงชื่อ Output ซึ่งทำหน้าที่กำหนดชนิดข้อมูลที่จะถูกส่งกลับคืนมาจากเมธอด add
ชนิดข้อมูลเจเนอริกเริ่มต้นในโค้ดนี้อยู่ภายในเทรต Add โดยมีนิยามดังต่อไปนี้:
#![allow(unused)]
fn main() {
trait Add<Rhs=Self> {
type Output;
fn add(self, rhs: Rhs) -> Self::Output;
}
}โค้ดนี้น่าจะดูคุ้นเคยเป็นส่วนใหญ่: เป็นเทรตที่มีหนึ่งเมธอดและหนึ่งชนิดข้อมูลที่เชื่อมโยง ส่วนใหม่ที่เพิ่มเข้ามาคือ Rhs=Self: ไวยากรณ์นี้เรียกว่า พารามิเตอร์ชนิดข้อมูลเริ่มต้น (default type parameters) โดยพารามิเตอร์ชนิดข้อมูลเจเนอริก Rhs (ย่อมาจาก “right-hand side” หรือด้านขวามือ) เป็นตัวกำหนดชนิดข้อมูลของพารามิเตอร์ rhs ในเมธอด add หากเราไม่ได้ระบุชนิดข้อมูลที่เป็นรูปธรรมให้กับ Rhs เมื่อเราอิมพลีเมนต์เทรต Add ชนิดข้อมูลของ Rhs จะใช้ค่าเริ่มต้นเป็น Self ซึ่งก็คือชนิดข้อมูลที่เรากำลังอิมพลีเมนต์เทรต Add ให้นั่นเอง
ตอนที่เราอิมพลีเมนต์ Add ให้กับ Point เราใช้ค่าเริ่มต้นของ Rhs เพราะเราต้องการนำอินสแตนซ์ของ Point สองตัวมาบวกกัน คราวนี้มาดูตัวอย่างการอิมพลีเมนต์เทรต Add ในกรณีที่เราต้องการปรับแต่งชนิดข้อมูลของ Rhs แทนที่จะใช้ค่าเริ่มต้นกันบ้าง
สมมติว่าเรามี struct สองตัวคือ Millimeters และ Meters ซึ่งเก็บค่าในหน่วยวัดที่แตกต่างกัน การนำชนิดข้อมูลที่มีอยู่แล้วมาห่อหุ้มไว้ในอีก struct หนึ่งแบบบาง ๆ นี้เป็นที่รู้จักกันในชื่อ รูปแบบนิวไทป์ (newtype pattern) ซึ่งเราจะอธิบายอย่างละเอียดในหัวข้อ“การอิมพลีเมนต์เทรตภายนอกด้วยแพตเทิร์นนิวไทป์” เราต้องการนำค่าในหน่วยมิลลิเมตรมาบวกกับค่าในหน่วยเมตร และให้โค้ดการอิมพลีเมนต์ Add ทำการแปลงหน่วยให้ถูกต้อง เราสามารถอิมพลีเมนต์ Add ให้กับ Millimeters โดยกำหนดให้ Meters เป็น Rhs ได้ ดังที่แสดงในลิสติ้ง 20-16
use std::ops::Add;
struct Millimeters(u32);
struct Meters(u32);
impl Add<Meters> for Millimeters {
type Output = Millimeters;
fn add(self, other: Meters) -> Millimeters {
Millimeters(self.0 + (other.0 * 1000))
}
}ในการบวกค่าระหว่าง Millimeters กับ Meters เราระบุเป็น impl Add<Meters> เพื่อกำหนดค่าให้กับพารามิเตอร์ชนิดข้อมูล Rhs แทนที่จะใช้ค่าเริ่มต้นซึ่งเป็น Self
คุณจะได้ใช้งานพารามิเตอร์ชนิดข้อมูลเริ่มต้นใน 2 วัตถุประสงค์หลัก ได้แก่:
- เพื่อต่อขยายชนิดข้อมูลโดยไม่ส่งผลกระทบให้โค้ดเดิมเสียหาย (non-breaking extension)
- เพื่อเปิดโอกาสให้ปรับแต่งได้ในกรณีเฉพาะที่ผู้ใช้ส่วนใหญ่ไม่จำเป็นต้องใช้
เทรต Add ในไลบรารีมาตรฐานเป็นตัวอย่างที่ดีของวัตถุประสงค์ข้อที่สอง: โดยทั่วไปแล้ว คุณมักจะบวกข้อมูลที่มีชนิดเดียวกัน แต่เทรต Add ก็เปิดความสามารถให้ปรับแต่งได้มากกว่านั้น การใช้พารามิเตอร์ชนิดข้อมูลเริ่มต้นในนิยามของเทรต Add ทำให้คุณไม่จำเป็นต้องระบุพารามิเตอร์เสริมในกรณีใช้งานทั่วไป ช่วยลดโค้ดส่วนเกินที่ซ้ำซ้อน (boilerplate) และทำให้เรียกใช้งานเทรตได้สะดวกยิ่งขึ้น
ส่วนวัตถุประสงค์ข้อแรกมีลักษณะคล้ายกันแต่เป็นมุมกลับ: หากคุณต้องการเพิ่มพารามิเตอร์ชนิดข้อมูลให้กับเทรตเดิมที่มีอยู่แล้ว คุณสามารถกำหนดค่าเริ่มต้นให้กับพารามิเตอร์นั้น เพื่อให้สามารถขยายฟังก์ชันการทำงานของเทรตได้โดยไม่ทำให้โค้ดที่อิมพลีเมนต์เทรตเดิมไว้พังทลายลง
การแยกแยะระหว่างเมธอดที่ชื่อเหมือนกัน
ไม่มีสิ่งใดใน Rust ที่ห้ามไม่ให้เทรตหนึ่งมีเมธอดชื่อซ้ำกับเมธอดของเทรตอื่น และ Rust ก็ไม่ได้ห้ามคุณอิมพลีเมนต์ทั้งสองเทรตให้กับชนิดข้อมูลเดียวกัน นอกจากนี้ยังสามารถนิยามเมธอดบนชนิดข้อมูลโดยตรงให้มีชื่อซ้ำกับเมธอดจากเทรตได้อีกด้วย
เมื่อต้องการเรียกใช้เมธอดที่มีชื่อเหมือนกัน คุณจะต้องบอก Rust ให้ชัดเจนว่าคุณต้องการเรียกใช้ตัวไหน ลองพิจารณาโค้ดในลิสติ้ง 20-17 ซึ่งเรานิยามเทรตสองตัวคือ Pilot และ Wizard โดยทั้งคู่ต่างก็มีเมธอดชื่อ fly จากนั้นเราอิมพลีเมนต์ทั้งสองเทรตให้กับชนิดข้อมูล Human ซึ่งมีเมธอดชื่อ fly ที่นิยามไว้บนตัวมันเองโดยตรงอยู่ก่อนแล้ว โดยเมธอด fly แต่ละตัวทำงานแตกต่างกัน
trait Pilot {
fn fly(&self);
}
trait Wizard {
fn fly(&self);
}
struct Human;
impl Pilot for Human {
fn fly(&self) {
println!("This is your captain speaking.");
}
}
impl Wizard for Human {
fn fly(&self) {
println!("Up!");
}
}
impl Human {
fn fly(&self) {
println!("*waving arms furiously*");
}
}
fn main() {}เมื่อเราเรียก fly บนอินสแตนซ์ของ Human คอมไพเลอร์จะเลือกเรียกเมธอดที่อิมพลีเมนต์บนชนิดข้อมูลโดยตรงเป็นค่าเริ่มต้น ดังที่แสดงในลิสติ้ง 20-18
trait Pilot {
fn fly(&self);
}
trait Wizard {
fn fly(&self);
}
struct Human;
impl Pilot for Human {
fn fly(&self) {
println!("This is your captain speaking.");
}
}
impl Wizard for Human {
fn fly(&self) {
println!("Up!");
}
}
impl Human {
fn fly(&self) {
println!("*waving arms furiously*");
}
}
fn main() {
let person = Human;
person.fly();
}การรันโค้ดนี้จะพิมพ์ *waving arms furiously* ออกมา ซึ่งแสดงให้เห็นว่า Rust เรียกใช้เมธอด fly ที่อิมพลีเมนต์ไว้บน Human โดยตรง
หากต้องการเรียกใช้เมธอด fly จากเทรต Pilot หรือเทรต Wizard เราจำเป็นต้องใช้ไวยากรณ์ที่ระบุเจาะจงยิ่งขึ้น เพื่อบ่งบอกว่าเราหมายถึงเมธอด fly ตัวใด ลิสติ้ง 20-19 สาธิตการใช้งานไวยากรณ์นี้
trait Pilot {
fn fly(&self);
}
trait Wizard {
fn fly(&self);
}
struct Human;
impl Pilot for Human {
fn fly(&self) {
println!("This is your captain speaking.");
}
}
impl Wizard for Human {
fn fly(&self) {
println!("Up!");
}
}
impl Human {
fn fly(&self) {
println!("*waving arms furiously*");
}
}
fn main() {
let person = Human;
Pilot::fly(&person);
Wizard::fly(&person);
person.fly();
}การระบุชื่อเทรตนำหน้าชื่อเมธอดทำให้ Rust ทราบชัดเจนว่าเราต้องการเรียกการอิมพลีเมนต์ของ fly ตัวใด นอกจากนี้เรายังสามารถเขียนเป็น Human::fly(&person) ได้ด้วย ซึ่งให้ผลเหมือนกับ person.fly() ในลิสติ้ง 20-19 เพียงแต่วิธีนี้จะเขียนยาวกว่าเล็กน้อยหากเราไม่จำเป็นต้องแยกแยะความกำกวม
เมื่อรันโค้ดนี้จะได้ผลลัพธ์ดังนี้:
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.46s
Running `target/debug/traits-example`
This is your captain speaking.
Up!
*waving arms furiously*
เนื่องจากเมธอด fly รับพารามิเตอร์ self หากเรามีสอง_ชนิดข้อมูล_ที่ต่างก็อิมพลีเมนต์_เทรต_เดียวกัน Rust จะสามารถตัดสินใจได้ว่าควรเรียกใช้การอิมพลีเมนต์ของเทรตตัวใด โดยพิจารณาจากชนิดข้อมูลของ self
อย่างไรก็ตาม สำหรับฟังก์ชันที่เชื่อมโยง (associated functions) ซึ่งไม่ใช่เมธอด จะไม่มีพารามิเตอร์ self เมื่อมีหลายชนิดข้อมูลหรือหลายเทรตที่นิยามฟังก์ชันที่ไม่ใช่เมธอดด้วยชื่อเดียวกัน Rust จะไม่สามารถทราบได้เสมอไปว่าคุณหมายถึงฟังก์ชันของชนิดข้อมูลใด เว้นแต่คุณจะใช้ไวยากรณ์แบบระบุชื่อเต็ม (fully qualified syntax) ตัวอย่างเช่น ในลิสติ้ง 20-20 เราสร้างเทรตสำหรับศูนย์พักพิงสัตว์ที่ต้องการตั้งชื่อลูกสุนัขทุกตัวว่า Spot เราสร้างเทรต Animal ที่มีฟังก์ชันเชื่อมโยงที่ไม่ใช่เมธอดชื่อ baby_name จากนั้นเราอิมพลีเมนต์เทรต Animal ให้กับ struct Dog ซึ่งบน Dog เองก็มีฟังก์ชันเชื่อมโยงที่ไม่ใช่เมธอดชื่อ baby_name นิยามไว้โดยตรงเช่นเดียวกัน
trait Animal {
fn baby_name() -> String;
}
struct Dog;
impl Dog {
fn baby_name() -> String {
String::from("Spot")
}
}
impl Animal for Dog {
fn baby_name() -> String {
String::from("puppy")
}
}
fn main() {
println!("A baby dog is called a {}", Dog::baby_name());
}เราเขียนโค้ดสำหรับตั้งชื่อลูกสุนัขทุกตัวว่า Spot ไว้ในฟังก์ชันเชื่อมโยง baby_name ที่นิยามบน Dog ในขณะเดียวกันชนิดข้อมูล Dog ก็อิมพลีเมนต์เทรต Animal ซึ่งอธิบายลักษณะทั่วไปที่สัตว์ทุกตัวพึงมี โดยลูกสุนัขจะเรียกว่า puppies ซึ่งข้อเท็จจริงนี้ถูกสื่อไว้ในการอิมพลีเมนต์เทรต Animal ให้กับ Dog ผ่านฟังก์ชัน baby_name ที่เชื่อมโยงกับเทรต Animal
ในฟังก์ชัน main เราเรียกใช้ Dog::baby_name ซึ่งจะไปเรียกฟังก์ชันเชื่อมโยงที่นิยามไว้บน Dog โดยตรง โค้ดนี้จะพิมพ์ผลลัพธ์ออกมาดังนี้:
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.54s
Running `target/debug/traits-example`
A baby dog is called a Spot
ผลลัพธ์นี้ไม่ใช่สิ่งที่เราต้องการ เราต้องการเรียกใช้ฟังก์ชัน baby_name ที่เป็นส่วนหนึ่งของเทรต Animal ตามที่อิมพลีเมนต์ไว้ให้ Dog เพื่อให้พิมพ์ข้อความ A baby dog is called a puppy ออกมา เทคนิคการระบุชื่อเทรตนำหน้าอย่างที่เราใช้ในลิสติ้ง 20-19 ไม่สามารถช่วยในกรณีนี้ได้ หากเราเปลี่ยนโค้ดใน main เป็นลิสติ้ง 20-21 เราจะพบกับข้อผิดพลาดในการคอมไพล์
trait Animal {
fn baby_name() -> String;
}
struct Dog;
impl Dog {
fn baby_name() -> String {
String::from("Spot")
}
}
impl Animal for Dog {
fn baby_name() -> String {
String::from("puppy")
}
}
fn main() {
println!("A baby dog is called a {}", Animal::baby_name());
}เนื่องจาก Animal::baby_name ไม่มีพารามิเตอร์ self และอาจมีชนิดข้อมูลอื่น ๆ อีกที่อิมพลีเมนต์เทรต Animal ไว้ Rust จึงไม่สามารถคาดเดาได้ว่าเราต้องการเรียกการอิมพลีเมนต์ Animal::baby_name ของชนิดข้อมูลใด เราจึงได้รับข้อผิดพลาดจากคอมไพเลอร์ดังนี้:
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
error[E0790]: cannot call associated function on trait without specifying the corresponding `impl` type
--> src/main.rs:20:43
|
2 | fn baby_name() -> String;
| ------------------------- `Animal::baby_name` defined here
...
20 | println!("A baby dog is called a {}", Animal::baby_name());
| ^^^^^^^^^^^^^^^^^^^ cannot call associated function of trait
|
help: use the fully-qualified path to the only available implementation
|
20 | println!("A baby dog is called a {}", <Dog as Animal>::baby_name());
| +++++++ +
For more information about this error, try `rustc --explain E0790`.
error: could not compile `traits-example` (bin "traits-example") due to 1 previous error
ในการขจัดความกำกวมและบอกกับ Rust ให้ชัดเจนว่าเราต้องการเรียกใช้การอิมพลีเมนต์ Animal สำหรับ Dog ไม่ใช่การอิมพลีเมนต์ Animal สำหรับชนิดข้อมูลอื่น เราจำเป็นต้องใช้ไวยากรณ์แบบระบุชื่อเต็ม (fully qualified syntax) ลิสติ้ง 20-22 สาธิตวิธีใช้งานไวยากรณ์ดังกล่าว
trait Animal {
fn baby_name() -> String;
}
struct Dog;
impl Dog {
fn baby_name() -> String {
String::from("Spot")
}
}
impl Animal for Dog {
fn baby_name() -> String {
String::from("puppy")
}
}
fn main() {
println!("A baby dog is called a {}", <Dog as Animal>::baby_name());
}เราได้ระบุชนิดข้อมูลกำกับไว้ภายในเครื่องหมายวงเล็บเหลี่ยมมุม <Dog as Animal> ซึ่งเป็นการบอกกับ Rust ว่าเราต้องการเรียกเมธอด baby_name จากเทรต Animal ตามที่อิมพลีเมนต์ไว้ให้กับ Dog โดยมองชนิดข้อมูล Dog เสมือนเป็น Animal สำหรับการเรียกฟังก์ชันนี้ คราวนี้โค้ดจะพิมพ์ผลลัพธ์ตามที่เราต้องการ:
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.48s
Running `target/debug/traits-example`
A baby dog is called a puppy
โดยทั่วไปแล้ว ไวยากรณ์แบบระบุชื่อเต็มจะมีโครงสร้างดังนี้:
<Type as Trait>::function(receiver_if_method, next_arg, ...);สำหรับฟังก์ชันเชื่อมโยงที่ไม่ใช่เมธอด จะไม่มีตัวรับค่า receiver จะมีเพียงรายการอาร์กิวเมนต์อื่น ๆ เท่านั้น คุณสามารถนำไวยากรณ์แบบระบุชื่อเต็มนี้ไปใช้ได้ในทุกที่ที่มีการเรียกฟังก์ชันหรือเมธอด อย่างไรก็ตาม คุณสามารถละเว้นส่วนใดก็ตามของไวยากรณ์นี้ที่ Rust สามารถอนุมานได้เองจากบริบทอื่น ๆ ในโปรแกรม คุณจำเป็นต้องใช้ไวยากรณ์แบบเต็มที่ยาวขึ้นนี้เฉพาะในกรณีที่มีหลายการอิมพลีเมนต์ที่ใช้ชื่อเดียวกัน และตัว Rust ต้องการความช่วยเหลือในการระบุว่าจะเรียกใช้การอิมพลีเมนต์ตัวใดเท่านั้น
การใช้ซูเปอร์เทรต
ในบางครั้งคุณอาจเขียนนิยามเทรตที่ต้องพึ่งพาเทรตอื่น: เพื่อให้ชนิดข้อมูลหนึ่งสามารถอิมพลีเมนต์เทรตแรกได้ คุณต้องการกำหนดให้ชนิดข้อมูลนั้นต้องอิมพลีเมนต์เทรตที่สองด้วยเช่นกัน เหตุผลที่ทำเช่นนี้เพื่อให้โค้ดนิยามเทรตของคุณสามารถดึงรายการที่เชื่อมโยงของเทรตที่สองมาใช้งานได้ โดยเทรตที่เทรตของคุณพึ่งพาอยู่นั้นจะเรียกว่า ซูเปอร์เทรต (supertrait)
ตัวอย่างเช่น สมมติว่าเราต้องการสร้างเทรต OutlinePrint ที่มีเมธอด outline_print ซึ่งจะพิมพ์ค่าที่กำหนดโดยจัดรูปแบบให้อยู่ภายในกรอบเครื่องหมายดอกจัน กล่าวคือ หากมี struct Point ที่อิมพลีเมนต์เทรต Display ของไลบรารีมาตรฐานเพื่อให้ผลลัพธ์เป็น (x, y) เมื่อเราเรียก outline_print บนอินสแตนซ์ Point ที่มีค่า x เป็น 1 และ y เป็น 3 ควรจะพิมพ์ผลลัพธ์ออกมาดังนี้:
**********
* *
* (1, 3) *
* *
**********
ในการอิมพลีเมนต์เมธอด outline_print เราจำเป็นต้องอาศัยฟังก์ชันการทำงานของเทรต Display ดังนั้น เราจึงต้องระบุว่าเทรต OutlinePrint จะใช้งานได้เฉพาะกับชนิดข้อมูลที่อิมพลีเมนต์ Display ร่วมด้วยเท่านั้น เพื่อให้มีฟังก์ชันที่ OutlinePrint ต้องการใช้งาน เราสามารถกำหนดเช่นนั้นได้ในนิยามเทรตด้วยการระบุ OutlinePrint: Display ซึ่งเทคนิคนี้คล้ายกับการเพิ่มข้อกำหนดเทรต (trait bound) ให้กับตัวเทรต ลิสติ้ง 20-23 แสดงการอิมพลีเมนต์เทรต OutlinePrint
use std::fmt;
trait OutlinePrint: fmt::Display {
fn outline_print(&self) {
let output = self.to_string();
let len = output.len();
println!("{}", "*".repeat(len + 4));
println!("*{}*", " ".repeat(len + 2));
println!("* {output} *");
println!("*{}*", " ".repeat(len + 2));
println!("{}", "*".repeat(len + 4));
}
}
fn main() {}เนื่องจากเราระบุว่า OutlinePrint ต้องการเทรต Display เราจึงสามารถเรียกใช้ฟังก์ชัน to_string ที่ได้รับการอิมพลีเมนต์โดยอัตโนมัติสำหรับชนิดข้อมูลใดก็ตามที่อิมพลีเมนต์ Display ได้ หากเราพยายามใช้ to_string โดยไม่ใส่เครื่องหมายโคลอนและระบุเทรต Display ไว้หลังชื่อเทรต เราจะได้รับข้อผิดพลาดแจ้งว่าไม่พบเมธอดชื่อ to_string สำหรับชนิดข้อมูล &Self ในขอบเขตปัจจุบัน
ลองมาดูกันว่าจะเกิดอะไรขึ้นเมื่อเราพยายามอิมพลีเมนต์ OutlinePrint บนชนิดข้อมูลที่ไม่ได้อิมพลีเมนต์ Display เช่น struct Point:
use std::fmt;
trait OutlinePrint: fmt::Display {
fn outline_print(&self) {
let output = self.to_string();
let len = output.len();
println!("{}", "*".repeat(len + 4));
println!("*{}*", " ".repeat(len + 2));
println!("* {output} *");
println!("*{}*", " ".repeat(len + 2));
println!("{}", "*".repeat(len + 4));
}
}
struct Point {
x: i32,
y: i32,
}
impl OutlinePrint for Point {}
fn main() {
let p = Point { x: 1, y: 3 };
p.outline_print();
}เราจะได้รับข้อผิดพลาดที่ระบุว่าจำเป็นต้องมี Display แต่อิมพลีเมนต์ยังไม่ครบถ้วน:
$ cargo run
Compiling traits-example v0.1.0 (file:///projects/traits-example)
error[E0277]: `Point` doesn't implement `std::fmt::Display`
--> src/main.rs:20:23
|
20 | impl OutlinePrint for Point {}
| ^^^^^ unsatisfied trait bound
|
help: the trait `std::fmt::Display` is not implemented for `Point`
--> src/main.rs:15:1
|
15 | struct Point {
| ^^^^^^^^^^^^
note: required by a bound in `OutlinePrint`
--> src/main.rs:3:21
|
3 | trait OutlinePrint: fmt::Display {
| ^^^^^^^^^^^^ required by this bound in `OutlinePrint`
error[E0277]: `Point` doesn't implement `std::fmt::Display`
--> src/main.rs:24:7
|
24 | p.outline_print();
| ^^^^^^^^^^^^^ unsatisfied trait bound
|
help: the trait `std::fmt::Display` is not implemented for `Point`
--> src/main.rs:15:1
|
15 | struct Point {
| ^^^^^^^^^^^^
note: required by a bound in `OutlinePrint::outline_print`
--> src/main.rs:3:21
|
3 | trait OutlinePrint: fmt::Display {
| ^^^^^^^^^^^^ required by this bound in `OutlinePrint::outline_print`
4 | fn outline_print(&self) {
| ------------- required by a bound in this associated function
For more information about this error, try `rustc --explain E0277`.
error: could not compile `traits-example` (bin "traits-example") due to 2 previous errors
เพื่อแก้ไขปัญหานี้ เราจึงอิมพลีเมนต์ Display ให้กับ Point เพื่อให้เป็นไปตามข้อกำหนดที่ OutlinePrint ต้องการ ดังนี้:
trait OutlinePrint: fmt::Display {
fn outline_print(&self) {
let output = self.to_string();
let len = output.len();
println!("{}", "*".repeat(len + 4));
println!("*{}*", " ".repeat(len + 2));
println!("* {output} *");
println!("*{}*", " ".repeat(len + 2));
println!("{}", "*".repeat(len + 4));
}
}
struct Point {
x: i32,
y: i32,
}
impl OutlinePrint for Point {}
use std::fmt;
impl fmt::Display for Point {
fn fmt(&self, f: &mut fmt::Formatter) -> fmt::Result {
write!(f, "({}, {})", self.x, self.y)
}
}
fn main() {
let p = Point { x: 1, y: 3 };
p.outline_print();
}หลังจากนั้น การอิมพลีเมนต์เทรต OutlinePrint ให้กับ Point ก็จะคอมไพล์ผ่านได้อย่างราบรื่น และเราสามารถเรียก outline_print บนอินสแตนซ์ของ Point เพื่อแสดงผลภายในกรอบเครื่องหมายดอกจันได้ตามต้องการ
การอิมพลีเมนต์เทรตภายนอกด้วยแพตเทิร์นนิวไทป์
ในหัวข้อ“การอิมพลีเมนต์เทรตบนชนิดข้อมูล” ในบทที่ 10 เราได้กล่าวถึงกฎเด็กกำพร้า (orphan rule) ซึ่งระบุว่าเราจะได้รับอนุญาตให้อิมพลีเมนต์เทรตบนชนิดข้อมูลได้ ก็ต่อเมื่อเทรตหรือชนิดข้อมูลนั้นอย่างใดอย่างหนึ่ง หรือทั้งสองอย่าง เป็นของเครตเราเองเท่านั้น เราสามารถหลีกเลี่ยงข้อจำกัดนี้ได้โดยใช้รูปแบบนิวไทป์ (newtype pattern) ซึ่งเกี่ยวข้องกับการสร้างชนิดข้อมูลใหม่ด้วยทูเพิล struct (เราได้อธิบายทูเพิล struct ไว้ในหัวข้อ“การสร้างชนิดข้อมูลที่แตกต่างกันด้วยทูเพิล struct” ในบทที่ 5) โดยทูเพิล struct นี้จะมีเพียงฟิลด์เดียว ทำหน้าที่เป็นตัวห่อหุ้มแบบบาง ๆ ครอบชนิดข้อมูลที่เราต้องการอิมพลีเมนต์เทรตให้ และเนื่องจากชนิดข้อมูลตัวห่อหุ้มนี้เป็นของเครตเราเอง เราจึงสามารถอิมพลีเมนต์เทรตให้กับตัวห่อหุ้มนี้ได้ คำว่า นิวไทป์ (newtype) มีที่มาจากภาษาการเขียนโปรแกรม Haskell การใช้รูปแบบนี้ไม่มีต้นทุนด้านประสิทธิภาพในตอนรันไทม์แต่อย่างใด เนื่องจากชนิดข้อมูลตัวห่อหุ้มจะถูกตัดทอนออกไปในขั้นตอนการคอมไพล์
ตัวอย่างเช่น สมมติว่าเราต้องการอิมพลีเมนต์ Display ให้กับ Vec<T> ซึ่งกฎออร์แฟนจะไม่อนุญาตให้เราทำได้โดยตรง เนื่องจากทั้งเทรต Display และชนิดข้อมูล Vec<T> ต่างก็ถูกนิยามไว้นอกเครตของเรา เราจึงสามารถสร้าง struct Wrapper ขึ้นมาเพื่อเก็บอินสแตนซ์ของ Vec<T> จากนั้นเราก็สามารถอิมพลีเมนต์ Display ให้กับ Wrapper และนำค่า Vec<T> ภายในไปใช้งานได้ ดังที่แสดงในลิสติ้ง 20-24
use std::fmt;
struct Wrapper(Vec<String>);
impl fmt::Display for Wrapper {
fn fmt(&self, f: &mut fmt::Formatter) -> fmt::Result {
write!(f, "[{}]", self.0.join(", "))
}
}
fn main() {
let w = Wrapper(vec![String::from("hello"), String::from("world")]);
println!("w = {w}");
}โค้ดการอิมพลีเมนต์ Display จะใช้ self.0 เพื่อเข้าถึง Vec<T> ที่อยู่ภายใน เนื่องจาก Wrapper เป็นทูเพิล struct และ Vec<T> คือสมาชิกที่ดัชนี 0 ของทูเพิล จากนั้น เราจึงสามารถใช้งานฟังก์ชันการทำงานของเทรต Display บน Wrapper ได้
ข้อเสียของการใช้เทคนิคนี้คือ Wrapper เป็นชนิดข้อมูลใหม่ จึงไม่มีเมธอดเดิมของค่าที่มันห่อหุ้มอยู่ หากต้องการให้ทำงานได้เหมือนเดิม เราจะต้องอิมพลีเมนต์เมธอดทั้งหมดของ Vec<T> ให้กับ Wrapper โดยตรง เพื่อให้เมธอดเหล่านั้นส่งต่อการทำงานไปยัง self.0 ซึ่งจะช่วยให้เราปฏิบัติต่อ Wrapper เสมือนเป็น Vec<T> ได้อย่างสมบูรณ์ หรือหากต้องการให้ชนิดข้อมูลใหม่มีครบทุกเมธอดที่ชนิดข้อมูลภายในมี การอิมพลีเมนต์เทรต Deref ให้กับ Wrapper เพื่อคืนชนิดข้อมูลภายในก็เป็นอีกหนึ่งทางออก (เราได้อธิบายการอิมพลีเมนต์เทรต Deref ไว้ในหัวข้อ“ปฏิบัติกับสมาร์ตพอยน์เตอร์เหมือนเรเฟอเรนซ์ทั่วไป” ในบทที่ 15) แต่หากเราไม่ต้องการให้ชนิดข้อมูล Wrapper มีเมธอดทุกตัวเหมือนชนิดข้อมูลภายใน—ตัวอย่างเช่น เพื่อจำกัดพฤติกรรมของชนิดข้อมูล Wrapper ไม่ให้ทำบางอย่างได้—เราก็เพียงแค่อิมพลีเมนต์เฉพาะเมธอดที่เราต้องการใช้งานจริง ๆ ด้วยตนเอง
รูปแบบนิวไทป์นี้ยังมีประโยชน์อย่างมากแม้ในกรณีที่ไม่เกี่ยวข้องกับเทรตเลยก็ตาม ตอนนี้ขอให้เราสลับความสนใจไปสำรวจแนวทางขั้นสูงในการทำงานร่วมกับระบบชนิดข้อมูลของ Rust กันต่อ
ชนิดข้อมูลขั้นสูง
ชนิดข้อมูลขั้นสูง
ระบบชนิดข้อมูลของ Rust ยังมีฟีเจอร์บางประการที่เราเคยกล่าวถึงมาบ้างแล้ว แต่ยังไม่ได้อธิบายในรายละเอียด เราจะเริ่มต้นด้วยการศึกษาเกี่ยวกับรูปแบบนิวไทป์ (newtypes) ในภาพรวม พร้อมทั้งพิจารณาว่าเหตุใดรูปแบบนี้จึงมีประโยชน์ในฐานะชนิดข้อมูล จากนั้นเราจะไปต่อกันที่นามแฝงชนิดข้อมูล (type aliases) ซึ่งเป็นฟีเจอร์ที่คล้ายกับนิวไทป์แต่มีความหมายเชิงความหมาย (semantics) แตกต่างกันเล็กน้อย นอกจากนี้เรายังจะกล่าวถึงชนิดข้อมูล ! (never type) และชนิดข้อมูลที่กำหนดขนาดแบบไดนามิก (dynamically sized types) อีกด้วย
ความปลอดภัยของชนิดข้อมูลและแอบสแตรกชันด้วยแพตเทิร์นนิวไทป์
หัวข้อนี้ตั้งอยู่บนสมมติฐานว่าคุณได้อ่านหัวข้อ“การอิมพลีเมนต์เทรตภายนอกด้วยแพตเทิร์นนิวไทป์” ในตอนต้นมาแล้ว รูปแบบนิวไทป์ (newtype pattern) ยังมีประโยชน์ต่องานอื่น ๆ นอกเหนือจากที่เราได้กล่าวไปแล้ว ซึ่งรวมถึงการบังคับความถูกต้องในระดับสแตติก (statically enforcing) เพื่อป้องกันไม่ให้เกิดความสับสนในการใช้งานค่าต่าง ๆ และการใช้ระบุหน่วยวัดของค่าข้อมูล คุณได้เห็นตัวอย่างการนำนิวไทป์มาใช้ระบุหน่วยวัดในลิสติ้ง 20-16 ไปแล้ว: ย้อนนึกถึง struct Millimeters และ Meters ที่นำค่า u32 มาห่อหุ้มไว้ในนิวไทป์ หากเราเขียนฟังก์ชันที่รับพารามิเตอร์ชนิด Millimeters คอมไพเลอร์จะไม่อนุญาตให้โปรแกรมคอมไพล์ผ่าน หากเผลอเรียกใช้ฟังก์ชันนั้นด้วยค่าชนิด Meters หรือค่า u32 ธรรมดา
นอกจากนี้ เรายังสามารถใช้รูปแบบนิวไทป์เพื่อซ่อนรายละเอียดการอิมพลีเมนต์บางส่วนของชนิดข้อมูลได้ด้วย โดยชนิดข้อมูลใหม่สามารถเปิดเผย API สาธารณะที่แตกต่างไปจาก API ของชนิดข้อมูลภายในซึ่งถูกซ่อนไว้เป็นส่วนตัว
นิวไทป์ยังสามารถช่วยซ่อนการทำงานภายในได้เป็นอย่างดี ตัวอย่างเช่น เราสามารถสร้างชนิดข้อมูล People ขึ้นมาเพื่อห่อหุ้ม HashMap<i32, String> ที่จัดเก็บ ID ของบุคคลคู่กับชื่อของบุคคลนั้น โค้ดที่เรียกใช้ People จะโต้ตอบเฉพาะกับ API สาธารณะที่เราเตรียมไว้ให้เท่านั้น เช่น เมธอดสำหรับเพิ่มชื่อสตริงลงในคอลเลกชัน People โดยโค้ดภายนอกไม่จำเป็นต้องรับรู้เลยว่าภายในเรากำหนด ID ชนิด i32 ให้กับชื่อต่าง ๆ อย่างไร รูปแบบนิวไทป์จึงเป็นวิธีที่เบาและเรียบง่ายในการสร้างการห่อหุ้ม (encapsulation) เพื่อซ่อนรายละเอียดการอิมพลีเมนต์ ดังที่เราได้พูดคุยกันในหัวข้อ“การห่อหุ้มที่ซ่อนรายละเอียดการอิมพลีเมนต์” ในบทที่ 18
ชื่อพ้องของชนิดข้อมูลและชื่อแทนชนิดข้อมูล
Rust เปิดความสามารถให้คุณประกาศ นามแฝงชนิดข้อมูล (type alias) เพื่อตั้งชื่ออื่นให้กับชนิดข้อมูลเดิมที่มีอยู่แล้ว โดยใช้คำสงวน type ตัวอย่างเช่น เราสามารถสร้างนามแฝง Kilometers ให้กับ i32 ได้ดังนี้:
fn main() {
type Kilometers = i32;
let x: i32 = 5;
let y: Kilometers = 5;
println!("x + y = {}", x + y);
}ตอนนี้นามแฝง Kilometers จึงเป็น คำพ้อง (synonym) ของ i32 ซึ่งต่างจากชนิดข้อมูล Millimeters และ Meters ที่เราสร้างขึ้นในลิสติ้ง 20-16 เพราะ Kilometers ไม่ใช่ชนิดข้อมูลใหม่ที่แยกออกมา ค่าที่มีชนิด Kilometers จะได้รับการปฏิบัติตามมาตรฐานเดียวกับค่าที่มีชนิด i32 ทุกประการ:
fn main() {
type Kilometers = i32;
let x: i32 = 5;
let y: Kilometers = 5;
println!("x + y = {}", x + y);
}เนื่องจาก Kilometers และ i32 เป็นชนิดข้อมูลเดียวกัน เราจึงสามารถนำค่าของทั้งสองชนิดมาบวกกันได้ และส่งค่า Kilometers ให้กับฟังก์ชันที่รับพารามิเตอร์ i32 ได้โดยตรง อย่างไรก็ตาม การใช้วิธีนี้จะไม่ได้ประโยชน์ด้านการตรวจสอบชนิดข้อมูลเข้มงวดเหมือนกับรูปแบบนิวไทป์ที่เราพูดถึงก่อนหน้านี้ กล่าวคือ หากเราเผลอนำค่าของ Kilometers กับ i32 มาปะปนกัน คอมไพเลอร์จะไม่แจ้งข้อผิดพลาดใด ๆ ออกมา
กรณีการใช้งานหลักของนามแฝงชนิดข้อมูลคือการลดความซ้ำซ้อน ตัวอย่างเช่น เราอาจมีชนิดข้อมูลที่ยาวและซับซ้อนเช่นนี้:
Box<dyn Fn() + Send + 'static>การเขียนชนิดข้อมูลที่ยาวเหยียดนี้ซ้ำไปซ้ำมาในซิกเนเจอร์ของฟังก์ชันและในคำกำกับชนิดข้อมูล (type annotation) ทั่วทั้งโค้ด อาจเป็นเรื่องน่าเบื่อและนำไปสู่ข้อผิดพลาดได้ง่าย ลองจินตนาการถึงโปรเจกต์ที่เต็มไปด้วยโค้ดแบบในลิสติ้ง 20-25
fn main() {
let f: Box<dyn Fn() + Send + 'static> = Box::new(|| println!("hi"));
fn takes_long_type(f: Box<dyn Fn() + Send + 'static>) {
// --snip--
}
fn returns_long_type() -> Box<dyn Fn() + Send + 'static> {
// --snip--
Box::new(|| ())
}
}นามแฝงชนิดข้อมูลช่วยให้โค้ดนี้จัดการได้ง่ายขึ้นมากด้วยการลดความซ้ำซ้อน ในลิสติ้ง 20-26 เราได้แนะนำนามแฝงชื่อ Thunk สำหรับชนิดข้อมูลที่ยาวนี้ และสามารถแทนที่การใช้งานชนิดข้อมูลนั้นทั้งหมดด้วยนามแฝงที่สั้นกระชับอย่าง Thunk
fn main() {
type Thunk = Box<dyn Fn() + Send + 'static>;
let f: Thunk = Box::new(|| println!("hi"));
fn takes_long_type(f: Thunk) {
// --snip--
}
fn returns_long_type() -> Thunk {
// --snip--
Box::new(|| ())
}
}โค้ดนี้อ่านและเขียนได้ง่ายขึ้นอย่างเห็นได้ชัด! การเลือกชื่อที่มีความหมายสำหรับนามแฝงชนิดข้อมูลยังช่วยสื่อเจตนารมณ์ของคุณได้ชัดเจนขึ้นอีกด้วย (thunk เป็นศัพท์ทางคอมพิวเตอร์ที่หมายถึงโค้ดที่จะถูกประเมินผลในภายหลัง จึงเป็นชื่อที่เหมาะสมอย่างยิ่งสำหรับโคลเชอร์ (closure) ที่ถูกบันทึกเก็บไว้)
นอกจากนี้นามแฝงชนิดข้อมูลยังนิยมนำมาใช้กับชนิด Result<T, E> เพื่อลดความซ้ำซ้อนเช่นกัน ลองพิจารณามอดูล std::io ในไลบรารีมาตรฐาน การทำงานเกี่ยวกับ I/O มักจะคืนค่าเป็น Result<T, E> เพื่อจัดการกับสถานการณ์ที่การทำงานล้มเหลว โดยไลบรารีนี้มี struct std::io::Error ที่เป็นตัวแทนของข้อผิดพลาด I/O ทั้งหมดที่เป็นไปได้ ฟังก์ชันจำนวนมากใน std::io จึงคืนค่าเป็น Result<T, E> โดยที่ E คือ std::io::Error เสมอ เช่นฟังก์ชันเหล่านี้ในเทรต Write:
use std::fmt;
use std::io::Error;
pub trait Write {
fn write(&mut self, buf: &[u8]) -> Result<usize, Error>;
fn flush(&mut self) -> Result<(), Error>;
fn write_all(&mut self, buf: &[u8]) -> Result<(), Error>;
fn write_fmt(&mut self, fmt: fmt::Arguments) -> Result<(), Error>;
}การเขียน Result<..., Error> ซ้ำ ๆ เกิดขึ้นบ่อยครั้ง ด้วยเหตุนี้ std::io จึงได้ประกาศนามแฝงชนิดข้อมูลนี้ไว้:
use std::fmt;
type Result<T> = std::result::Result<T, std::io::Error>;
pub trait Write {
fn write(&mut self, buf: &[u8]) -> Result<usize>;
fn flush(&mut self) -> Result<()>;
fn write_all(&mut self, buf: &[u8]) -> Result<()>;
fn write_fmt(&mut self, fmt: fmt::Arguments) -> Result<()>;
}เนื่องจากการประกาศนี้อยู่ภายในมอดูล std::io เราจึงสามารถเรียกใช้นามแฝงแบบระบุชื่อเต็มได้เป็น std::io::Result<T> ซึ่งก็คือ Result<T, E> ที่เติม E เป็น std::io::Error ไว้แล้วนั่นเอง ส่งผลให้ซิกเนเจอร์ของฟังก์ชันในเทรต Write กลายมาเป็นดังนี้:
use std::fmt;
type Result<T> = std::result::Result<T, std::io::Error>;
pub trait Write {
fn write(&mut self, buf: &[u8]) -> Result<usize>;
fn flush(&mut self) -> Result<()>;
fn write_all(&mut self, buf: &[u8]) -> Result<()>;
fn write_fmt(&mut self, fmt: fmt::Arguments) -> Result<()>;
}นามแฝงชนิดข้อมูลช่วยเราใน 2 ด้าน: ทำให้เขียนโค้ดได้ง่ายขึ้น และ ทำให้อินเทอร์เฟซมีความสอดคล้องกันตลอดทั้งมอดูล std::io และเนื่องจากมันเป็นเพียงนามแฝง จึงทำงานเสมือนเป็น Result<T, E> ตัวเดิมทุกประการ ทำให้เราสามารถเรียกใช้เมธอดใด ๆ ที่มีใน Result<T, E> ได้ตามปกติ รวมถึงไวยากรณ์พิเศษอย่างตัวดำเนินการ ? ด้วย
ชนิดไม่คืนค่าที่ไม่คืนค่าเลย
Rust มีชนิดข้อมูลพิเศษที่มีชื่อว่า ! ซึ่งในเชิงทฤษฎีชนิดข้อมูล (type theory) จะเรียกว่า ชนิดข้อมูลว่าง (empty type) เนื่องจากชนิดข้อมูลนี้ไม่มีค่าใด ๆ เลย แต่เรานิยมเรียกว่า ชนิดไม่คืนค่า (never type) เพราะมันจะถูกนำมาวางแทนตำแหน่งของชนิดข้อมูลคืนค่า เมื่อฟังก์ชันนั้นจะไม่มีวันคืนค่ากลับมาเลย นี่คือตัวอย่าง:
fn bar() -> ! {
// --snip--
panic!();
}โค้ดนี้อ่านความหมายได้ว่า “ฟังก์ชัน bar ไม่คืนค่าใด ๆ เลย” โดยฟังก์ชันที่ไม่เคยคืนค่ากลับมาจะเรียกว่า ฟังก์ชันลู่ออก (diverging functions) เราไม่สามารถสร้างค่าของชนิดข้อมูล ! ขึ้นมาได้ ดังนั้น bar จึงไม่มีทางส่งค่าคืนกลับมาได้อย่างแน่นอน
แต่ชนิดข้อมูลที่ไม่สามารถสร้างค่าได้เลยจะมีประโยชน์อย่างไร? ย้อนนึกถึงโค้ดจากลิสติ้ง 2-5 ซึ่งเป็นส่วนหนึ่งของเกมทายตัวเลข เราได้คัดลอกบางส่วนของโค้ดนั้นมาแสดงอีกครั้งในลิสติ้ง 20-27
use std::cmp::Ordering;
use std::io;
use rand::prelude::*;
fn main() {
println!("Guess the number!");
let secret_number = rand::rng().random_range(1..=100);
println!("The secret number is: {secret_number}");
loop {
println!("Please input your guess.");
let mut guess = String::new();
// --snip--
io::stdin()
.read_line(&mut guess)
.expect("Failed to read line");
let guess: u32 = match guess.trim().parse() {
Ok(num) => num,
Err(_) => continue,
};
println!("You guessed: {guess}");
// --snip--
match guess.cmp(&secret_number) {
Ordering::Less => println!("Too small!"),
Ordering::Greater => println!("Too big!"),
Ordering::Equal => {
println!("You win!");
break;
}
}
}
}ในตอนนั้น เราได้ข้ามรายละเอียดบางจุดของโค้ดนี้ไป ในหัวข้อ“โครงสร้างควบคุมโฟลว์ match” ในบทที่ 6 เราได้พูดคุยกันว่าทุกกิ่งกรณี (arm) ของนิพจน์ match จะต้องคืนค่าเป็นชนิดข้อมูลเดียวกัน ดังนั้น ตัวอย่างเช่น โค้ดต่อไปนี้จะไม่สามารถทำงานได้:
fn main() {
let guess = "3";
let guess = match guess.trim().parse() {
Ok(_) => 5,
Err(_) => "hello",
};
}ชนิดข้อมูลของ guess ในโค้ดนี้จะต้องเป็นทั้งจำนวนเต็ม และ สตริงในเวลาเดียวกัน ซึ่ง Rust กำหนดไว้ว่า guess จะต้องมีเพียงชนิดข้อมูลเดียวเท่านั้น แล้วคำสั่ง continue คืนค่าอะไรกลับมาล่ะ? เหตุใดเราจึงได้รับอนุญาตให้คืนค่า u32 จากกิ่งหนึ่ง และมีอีกกิ่งหนึ่งที่ลงท้ายด้วย continue ในลิสติ้ง 20-27 ได้?
อย่างที่คุณอาจเดาได้ ค่าของ continue คือชนิดข้อมูล ! กล่าวคือ เมื่อ Rust ประเมินชนิดข้อมูลของ guess คอมไพเลอร์จะดูที่กิ่งทั้งสองของ match โดยกิ่งแรกให้ค่าเป็น u32 และกิ่งหลังให้ค่าเป็น ! และเนื่องจาก ! ไม่มีวันมีค่าอยู่จริง Rust จึงตัดสินว่าชนิดข้อมูลของ guess คือ u32
หากจะอธิบายพฤติกรรมนี้อย่างเป็นทางการก็คือ นิพจน์ที่มีชนิดข้อมูล ! สามารถแปลงชนิดข้อมูลแบบบังคับ (coerce) ไปเป็นชนิดข้อมูลอื่นใดก็ได้ เราจึงสามารถลงท้ายกิ่งของ match ด้วย continue ได้อย่างถูกต้อง เพราะ continue ไม่ได้คืนค่า แต่จะส่งการควบคุมกลับไปยังจุดเริ่มต้นของลูปแทน ดังนั้นในกรณี Err เราจึงไม่ต้องกำหนดค่าใด ๆ ให้กับ guess เลย
ชนิดไม่คืนค่ายังมีประโยชน์ร่วมกับมาโคร panic! อีกด้วย ย้อนนึกถึงฟังก์ชัน unwrap ที่เราเรียกใช้บนค่า Option<T> เพื่อดึงค่าออกมาหรือสั่งแพนิกตามนิยามต่อไปนี้:
enum Option<T> {
Some(T),
None,
}
use crate::Option::*;
impl<T> Option<T> {
pub fn unwrap(self) -> T {
match self {
Some(val) => val,
None => panic!("called `Option::unwrap()` on a `None` value"),
}
}
}ในโค้ดนี้ เกิดกระบวนการแบบเดียวกับ match ในลิสติ้ง 20-27: Rust ตรวจพบว่า val มีชนิดข้อมูล T และ panic! มีชนิดข้อมูล ! ดังนั้นผลลัพธ์ของนิพจน์ match โดยรวมจึงเป็น T โค้ดนี้ทำงานได้ถูกต้องเพราะ panic! ไม่ได้สร้างค่าส่งกลับมา แต่เป็นการยุติการทำงานของโปรแกรม ในกรณีที่เป็น None เราจะไม่คืนค่าใด ๆ จาก unwrap โค้ดนี้จึงถูกต้องสมบูรณ์
นิพจน์สุดท้ายที่มีชนิดข้อมูลเป็น ! คือลูปที่ไม่รู้จบ:
fn main() {
print!("forever ");
loop {
print!("and ever ");
}
}ในกรณีนี้ ลูปไม่มีวันสิ้นสุดลง ค่าของนิพจน์จึงเป็น ! อย่างไรก็ตาม สิ่งนี้จะไม่เป็นจริงหากเราใส่คำสั่ง break เข้าไป เพราะลูปจะหยุดทำงานเมื่อทำงานไปถึงจุดที่มี break
ชนิดข้อมูลขนาดไดนามิกและเทรต Sized
Rust จำเป็นต้องทราบรายละเอียดบางอย่างเกี่ยวกับชนิดข้อมูล เช่น ต้องจัดสรรพื้นที่หน่วยความจำเท่าใดสำหรับค่าของชนิดข้อมูลหนึ่ง ๆ จุดนี้อาจทำให้ระบบชนิดข้อมูลของ Rust ดูชวนสับสนอยู่บ้างในตอนแรก นั่นคือแนวคิดเรื่อง ชนิดข้อมูลที่กำหนดขนาดแบบไดนามิก (dynamically sized types) ซึ่งบางครั้งเรียกว่า DSTs หรือ ชนิดข้อมูลที่ไม่มีขนาดแน่นอน (unsized types) ชนิดข้อมูลเหล่านี้ช่วยให้เราสามารถเขียนโค้ดเพื่อจัดการกับค่าข้อมูลที่เราจะทราบขนาดได้ในตอนรันไทม์เท่านั้น
ลองมาเจาะลึกในรายละเอียดของชนิดข้อมูลที่กำหนดขนาดแบบไดนามิกตัวหนึ่งที่ชื่อว่า str ซึ่งเราใช้งานกันมาตลอดทั้งเล่ม ถูกต้องแล้วครับ เราไม่ได้หมายถึง &str แต่หมายถึง str เดี่ยว ๆ ซึ่งจัดเป็น DST ในหลายกรณี เช่น การจัดเก็บข้อความที่ผู้ใช้ป้อนเข้ามา เราไม่สามารถทราบล่วงหน้าได้ว่าสตริงจะมีความยาวเท่าใดจนกว่าจะถึงตอนรันไทม์ นั่นหมายความว่าเราไม่สามารถสร้างตัวแปรชนิด str ขึ้นมาโดยตรง และไม่สามารถรับอาร์กิวเมนต์เป็นชนิด str ได้ ลองพิจารณาโค้ดต่อไปนี้ซึ่งจะไม่สามารถทำงานได้:
fn main() {
let s1: str = "Hello there!";
let s2: str = "How's it going?";
}Rust จำเป็นต้องทราบว่าต้องจัดสรรหน่วยความจำเท่าใดสำหรับค่าใด ๆ ของชนิดข้อมูลนั้น และค่าทุกค่าของชนิดข้อมูลเดียวกันจะต้องใช้พื้นที่หน่วยความจำเท่ากันเสมอ หาก Rust อนุญาตให้เราเขียนโค้ดนี้ได้ ค่า str ทั้งสองตัวนี้ก็จะต้องใช้พื้นที่เท่ากัน แต่ในความเป็นจริงทั้งคู่มีความยาวต่างกัน: s1 ต้องใช้พื้นที่ 12 ไบต์ ส่วน s2 ต้องใช้ 15 ไบต์ นี่คือเหตุผลว่าทำไมเราจึงไม่สามารถสร้างตัวแปรที่เก็บชนิดข้อมูลที่กำหนดขนาดแบบไดนามิกได้โดยตรง
แล้วเรามีวิธีแก้อย่างไร? ในกรณีนี้ คุณคงทราบคำตอบดีอยู่แล้ว: เราเปลี่ยนชนิดข้อมูลของ s1 และ s2 ให้เป็นสตริงสไลซ์ (&str) แทนที่จะเป็น str ย้อนนึกถึงหัวข้อ“สตริงสไลซ์” ในบทที่ 4 ซึ่งระบุว่าโครงสร้างข้อมูลของสไลซ์จะเก็บเพียงตำแหน่งเริ่มต้นและความยาวของสไลซ์เท่านั้น ดังนั้น แม้ว่า &T จะเป็นค่าเดี่ยว ๆ ที่เก็บแอดเดรสหน่วยความจำที่ T วางอยู่ แต่สตริงสไลซ์จะประกอบด้วยค่า สอง ค่า ได้แก่ แอดเดรสของ str และความยาวของมัน ด้วยเหตุนี้ เราจึงสามารถทราบขนาดของค่าสตริงสไลซ์ได้ในตอนคอมไพล์ ซึ่งก็คือมีขนาดเป็น 2 เท่าของความยาวของชนิด usize นั่นหมายความว่าเราทราบขนาดของสตริงสไลซ์เสมอ ไม่ว่าข้อความสตริงที่มันอ้างอิงถึงจะมีความยาวเท่าใดก็ตาม โดยทั่วไปแล้ว นี่คือวิธีการที่ Rust ใช้จัดการกับชนิดข้อมูลที่กำหนดขนาดแบบไดนามิก: มีการแนบข้อมูลเมทาดาทา (metadata) เพิ่มเติมเล็กน้อยเพื่อเก็บขนาดของข้อมูลแบบไดนามิกนั้น กฎเหล็กของชนิดข้อมูลที่กำหนดขนาดแบบไดนามิกคือ เราจะต้องวางค่าของชนิดข้อมูลดังกล่าวไว้เบื้องหลังพอยน์เตอร์เสมอ
เราสามารถใช้งาน str ร่วมกับพอยน์เตอร์ได้ทุกรูปแบบ เช่น Box<str> หรือ Rc<str> อันที่จริง คุณเคยพบเห็นรูปแบบนี้มาก่อนแล้วกับชนิดข้อมูลที่กำหนดขนาดแบบไดนามิกอีกประเภทหนึ่ง นั่นคือ เทรต (traits) ทุกเทรตถือเป็นชนิดข้อมูลที่กำหนดขนาดแบบไดนามิกที่เราสามารถอ้างอิงถึงได้โดยใช้ชื่อของเทรตนั้น ในหัวข้อ“การใช้เทรตออบเจกต์เพื่อนามธรรมพฤติกรรมร่วม” ในบทที่ 18 เราได้อธิบายว่าในการใช้งานเทรตในฐานะเทรตออบเจกต์ (trait object) เราจะต้องวางเทรตไว้เบื้องหลังพอยน์เตอร์เสมอ เช่น &dyn Trait หรือ Box<dyn Trait> (Rc<dyn Trait> ก็ใช้ได้เช่นกัน)
ในการทำงานร่วมกับ DST นั้น Rust ได้เตรียมเทรต Sized ไว้เพื่อใช้ตัดสินว่าขนาดของชนิดข้อมูลหนึ่ง ๆ เป็นที่ทราบแน่ชัดในตอนคอมไพล์หรือไม่ เทรตนี้จะได้รับการอิมพลีเมนต์ให้โดยอัตโนมัติสำหรับทุกชนิดข้อมูลที่ทราบขนาดในตอนคอมไพล์ นอกจากนี้ Rust ยังเพิ่มข้อกำหนดบนเทรต Sized ให้กับฟังก์ชันเจเนอริกทุกฟังก์ชันโดยปริยาย กล่าวคือนิยามฟังก์ชันเจเนอริกที่มีลักษณะดังนี้:
fn generic<T>(t: T) {
// --snip--
}แท้จริงแล้วจะได้รับการปฏิบัติต่อเสมือนว่าเราเขียนไว้เช่นนี้:
fn generic<T: Sized>(t: T) {
// --snip--
}โดยค่าเริ่มต้น ฟังก์ชันเจเนอริกจะทำงานได้เฉพาะกับชนิดข้อมูลที่ทราบขนาดในตอนคอมไพล์เท่านั้น อย่างไรก็ตาม คุณสามารถใช้ไวยากรณ์พิเศษต่อไปนี้เพื่อผ่อนปรนข้อจำกัดดังกล่าวได้:
fn generic<T: ?Sized>(t: &T) {
// --snip--
}ข้อกำหนดเทรตบน ?Sized มีความหมายว่า “T อาจทราบขนาด (Sized) หรือไม่ทราบขนาดก็ได้” และสัญลักษณ์นี้จะเข้าแทนที่ข้อกำหนดเริ่มต้นที่ว่าชนิดข้อมูลเจเนอริกต้องทราบขนาดในตอนคอมไพล์ ไวยากรณ์ ?Trait ที่มีความหมายในลักษณะนี้เปิดให้ใช้งานได้เฉพาะกับเทรต Sized เท่านั้น ไม่สามารถใช้กับเทรตอื่นใดได้
โปรดสังเกตด้วยว่าเราเปลี่ยนชนิดข้อมูลของพารามิเตอร์ t จาก T เป็น &T เนื่องจากชนิดข้อมูลอาจไม่ทราบขนาด (!Sized) เราจึงจำเป็นต้องเรียกใช้งานผ่านพอยน์เตอร์รูปแบบใดรูปแบบหนึ่ง ซึ่งในกรณีนี้เราเลือกใช้การอ้างอิง (reference)
ในหัวข้อถัดไป เราจะมาพูดคุยกันถึงเรื่องฟังก์ชันและโคลเชอร์ขั้นสูงกันต่อ!
ฟังก์ชันและโคลเชอร์ขั้นสูง
ฟังก์ชันและโคลเชอร์ขั้นสูง
หัวข้อนี้จะพาไปสำรวจฟีเจอร์ขั้นสูงที่เกี่ยวข้องกับฟังก์ชันและโคลเชอร์ (closure) ซึ่งรวมถึงพอยน์เตอร์ฟังก์ชัน (function pointers) และการคืนค่าโคลเชอร์จากฟังก์ชัน
พอยน์เตอร์ฟังก์ชัน
เราได้พูดคุยถึงวิธีส่งโคลเชอร์เข้าไปเป็นอาร์กิวเมนต์ของฟังก์ชันกันไปแล้ว คุณยังสามารถส่งฟังก์ชันปกติเข้าไปยังฟังก์ชันอื่นได้ด้วยเช่นกัน! เทคนิคนี้มีประโยชน์อย่างยิ่งเมื่อคุณต้องการส่งฟังก์ชันที่นิยามไว้อยู่แล้วเข้าไป แทนที่จะต้องนิยามโคลเชอร์ใหม่ โดยฟังก์ชันปกติสามารถแปลงชนิดข้อมูลแบบบังคับ (coerce) ไปเป็นชนิด fn (เขียนด้วยตัวอักษร f พิมพ์เล็ก) ซึ่งต้องระวังอย่าสับสนกับเทรตโคลเชอร์ Fn โดยชนิด fn นี้จะเรียกว่า พอยน์เตอร์ฟังก์ชัน (function pointer) การส่งฟังก์ชันผ่านพอยน์เตอร์ฟังก์ชันช่วยให้คุณสามารถนำฟังก์ชันไปใช้เป็นอาร์กิวเมนต์ของฟังก์ชันอื่นได้
ไวยากรณ์สำหรับระบุว่าพารามิเตอร์เป็นพอยน์เตอร์ฟังก์ชันนั้นมีความคล้ายคลึงกับไวยากรณ์ของโคลเชอร์ ดังที่แสดงในลิสติ้ง 20-28 ซึ่งเรานิยามฟังก์ชัน add_one ที่ทำหน้าที่บวก 1 ให้กับพารามิเตอร์ ส่วนฟังก์ชัน do_twice รับพารามิเตอร์สองตัว ได้แก่: พอยน์เตอร์ฟังก์ชันที่ชี้ไปยังฟังก์ชันใด ๆ ที่รับพารามิเตอร์ชนิด i32 และคืนค่าเป็น i32 กับค่า i32 อีกหนึ่งค่า โดยฟังก์ชัน do_twice จะเรียกฟังก์ชัน f สองครั้งพร้อมส่งค่า arg เข้าไป แล้วนำผลลัพธ์จากการเรียกฟังก์ชันทั้งสองมารวมกัน ในฟังก์ชัน main มีการเรียกใช้ do_twice โดยส่งอาร์กิวเมนต์เป็น add_one และ 5
fn add_one(x: i32) -> i32 {
x + 1
}
fn do_twice(f: fn(i32) -> i32, arg: i32) -> i32 {
f(arg) + f(arg)
}
fn main() {
let answer = do_twice(add_one, 5);
println!("The answer is: {answer}");
}โค้ดนี้จะพิมพ์ The answer is: 12 ออกมา เราระบุว่าพารามิเตอร์ f ใน do_twice มีชนิดเป็น fn ที่รับพารามิเตอร์หนึ่งตัวชนิด i32 และคืนค่าเป็น i32 จากนั้นเราจึงสามารถเรียกใช้ f ภายในบอดี้ของ do_twice ได้ ในฟังก์ชัน main เราสามารถส่งชื่อฟังก์ชัน add_one เป็นอาร์กิวเมนต์ตัวแรกให้กับ do_twice ได้โดยตรง
สิ่งที่แตกต่างจากโคลเชอร์คือ fn เป็นชนิดข้อมูล ไม่ใช่เทรต เราจึงสามารถระบุ fn เป็นชนิดของพารามิเตอร์ได้โดยตรง แทนที่จะต้องประกาศพารามิเตอร์เจเนอริกแล้วกำกับด้วยเทรตตระกูล Fn เป็นข้อกำหนดเทรต (trait bound)
พอยน์เตอร์ฟังก์ชันอิมพลีเมนต์เทรตโคลเชอร์ครบทั้งสามตัว (Fn, FnMut และ FnOnce) ซึ่งหมายความว่าคุณสามารถส่งพอยน์เตอร์ฟังก์ชันเป็นอาร์กิวเมนต์ให้กับฟังก์ชันที่คาดหวังโคลเชอร์ได้เสมอ ทางที่ดีที่สุดในการเขียนฟังก์ชันคือการใช้ชนิดข้อมูลเจเนอริกร่วมกับเทรตโคลเชอร์ตัวใดตัวหนึ่ง เพื่อให้ฟังก์ชันของคุณมีความยืดหยุ่นและรองรับได้ทั้งฟังก์ชันปกติและโคลเชอร์
อย่างไรก็ตาม ตัวอย่างสถานการณ์ที่คุณต้องการรับเฉพาะ fn และไม่รับโคลเชอร์ คือการเชื่อมต่อกับโค้ดภายนอกที่ไม่มีแนวคิดเรื่องโคลเชอร์ เช่น ฟังก์ชันของภาษา C สามารถรับฟังก์ชันเป็นอาร์กิวเมนต์ได้ แต่ภาษา C ไม่มีโคลเชอร์
เพื่อเป็นตัวอย่างแสดงจุดที่คุณสามารถเลือกใช้ได้ทั้งโคลเชอร์ที่นิยามแบบอินไลน์หรือฟังก์ชันที่มีชื่อ ลองมาดูการเรียกใช้เมธอด map จากเทรต Iterator ในไลบรารีมาตรฐาน หากต้องการใช้เมธอด map เพื่อแปลงเวกเตอร์ (vector) ของตัวเลขให้กลายเป็นเวกเตอร์ของสตริง เราสามารถเขียนโดยใช้โคลเชอร์ได้ดังในลิสติ้ง 20-29
fn main() {
let list_of_numbers = vec![1, 2, 3];
let list_of_strings: Vec<String> =
list_of_numbers.iter().map(|i| i.to_string()).collect();
}หรือเราจะส่งชื่อฟังก์ชันเข้าไปเป็นอาร์กิวเมนต์ของ map แทนการใช้โคลเชอร์ก็ได้ ลิสติ้ง 20-30 แสดงให้เห็นว่าโค้ดจะมีลักษณะอย่างไร
fn main() {
let list_of_numbers = vec![1, 2, 3];
let list_of_strings: Vec<String> =
list_of_numbers.iter().map(ToString::to_string).collect();
}โปรดสังเกตว่าเราต้องใช้ไวยากรณ์แบบระบุชื่อเต็ม (fully qualified syntax) ตามที่เราได้พูดคุยกันในหัวข้อ“เทรตขั้นสูง” เนื่องจากมีฟังก์ชันชื่อ to_string หลายตัวให้เลือกใช้งาน
ในที่นี้ เรากำลังเรียกใช้ฟังก์ชัน to_string ที่นิยามไว้ในเทรต ToString ซึ่งไลบรารีมาตรฐานได้อิมพลีเมนต์ให้กับทุกชนิดข้อมูลที่อิมพลีเมนต์ Display ไว้แล้ว
ย้อนนึกถึงหัวข้อ“ค่าของ enum” ในบทที่ 6 ซึ่งระบุว่าชื่อของแต่ละวาเรียนต์ (variant) ของ enum ที่เรานิยามไว้ จะทำหน้าที่เป็นฟังก์ชันตัวเริ่มต้น (initializer function) ได้ด้วย เราสามารถนำฟังก์ชันตัวเริ่มต้นเหล่านี้มาใช้เป็นพอยน์เตอร์ฟังก์ชันที่อิมพลีเมนต์เทรตโคลเชอร์ได้ ซึ่งหมายความว่าเราสามารถส่งฟังก์ชันตัวเริ่มต้นเป็นอาร์กิวเมนต์ให้กับเมธอดที่รับโคลเชอร์ได้เช่นกัน ดังที่แสดงในลิสติ้ง 20-31
fn main() {
enum Status {
Value(u32),
Stop,
}
let list_of_statuses: Vec<Status> = (0u32..20).map(Status::Value).collect();
}ในโค้ดนี้ เราสร้างอินสแตนซ์ของ Status::Value ขึ้นมาสำหรับแต่ละค่า u32 ในช่วงตัวเลขที่เรียกใช้ map โดยอาศัยฟังก์ชันตัวเริ่มต้นของ Status::Value โปรแกรมเมอร์บางท่านชอบสไตล์นี้ ในขณะที่บางท่านชอบเขียนด้วยโคลเชอร์มากกว่า โดยทั้งสองรูปแบบคอมไพล์ออกมาเป็นโค้ดผลลัพธ์แบบเดียวกัน ดังนั้นคุณสามารถเลือกใช้สไตล์ที่ช่วยให้อ่านเข้าใจได้ง่ายและชัดเจนที่สุดสำหรับคุณ
การคืนค่าโคลเชอร์
โคลเชอร์ถูกแทนด้วยเทรต ซึ่งหมายความว่าคุณไม่สามารถคืนค่าโคลเชอร์กลับมาโดยตรงได้ ในกรณีส่วนใหญ่ที่คุณต้องการคืนค่าเทรต คุณสามารถระบุชนิดข้อมูลที่เป็นรูปธรรม (concrete type) ที่อิมพลีเมนต์เทรตนั้นเป็นค่าคืนกลับของฟังก์ชันแทนได้ แต่โดยปกติแล้วคุณไม่สามารถทำเช่นนั้นกับโคลเชอร์ได้ เพราะโคลเชอร์ไม่มีชนิดข้อมูลรูปธรรมที่สามารถระบุเพื่อคืนค่าได้ ตัวอย่างเช่น คุณไม่ได้รับอนุญาตให้ใช้พอยน์เตอร์ฟังก์ชัน fn เป็นชนิดข้อมูลคืนกลับ หากโคลเชอร์นั้นมีการจับยึด (capture) ค่าใด ๆ มาจากขอบเขตภายนอก
ในทางปฏิบัติ คุณมักจะใช้ไวยากรณ์ impl Trait ตามที่เราได้เรียนรู้กันไปในบทที่ 10 คุณสามารถคืนค่าฟังก์ชันชนิดใดก็ได้โดยระบุ Fn, FnOnce หรือ FnMut ตัวอย่างเช่น โค้ดในลิสติ้ง 20-32 จะสามารถคอมไพล์ผ่านได้อย่างราบรื่น
#![allow(unused)]
fn main() {
fn returns_closure() -> impl Fn(i32) -> i32 {
|x| x + 1
}
}อย่างไรก็ตาม ดังที่เราได้ตั้งข้อสังเกตไว้ในหัวข้อ“การอนุมานและการระบุชนิดของโคลเชอร์” ในบทที่ 13 ว่าโคลเชอร์แต่ละตัวจะมีชนิดข้อมูลเฉพาะตัวที่ไม่ซ้ำกัน หากคุณจำเป็นต้องทำงานกับฟังก์ชันหลายตัวที่มีซิกเนเจอร์เหมือนกันแต่มีการอิมพลีเมนต์แตกต่างกัน คุณจะต้องใช้เทรตออบเจกต์ (trait object) เข้ามาช่วย ลองพิจารณาสิ่งที่จะเกิดขึ้นหากคุณเขียนโค้ดดังที่แสดงในลิสติ้ง 20-33
fn main() {
let handlers = vec![returns_closure(), returns_initialized_closure(123)];
for handler in handlers {
let output = handler(5);
println!("{output}");
}
}
fn returns_closure() -> impl Fn(i32) -> i32 {
|x| x + 1
}
fn returns_initialized_closure(init: i32) -> impl Fn(i32) -> i32 {
move |x| x + init
}ในที่นี้เรามีฟังก์ชันสองตัวคือ returns_closure และ returns_initialized_closure ซึ่งต่างก็คืนค่าเป็น impl Fn(i32) -> i32 โปรดสังเกตว่าโคลเชอร์ที่ทั้งสองฟังก์ชันคืนกลับมานั้นเป็นคนละตัวกัน แม้ว่าจะอิมพลีเมนต์ชนิดข้อมูลเดียวกันก็ตาม หากเราพยายามคอมไพล์โค้ดนี้ Rust จะแจ้งให้เราทราบว่าไม่สามารถทำงานได้:
$ cargo build
Compiling functions-example v0.1.0 (file:///projects/functions-example)
error[E0308]: mismatched types
--> src/main.rs:2:44
|
2 | let handlers = vec![returns_closure(), returns_initialized_closure(123)];
| ^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^^ expected opaque type, found a different opaque type
...
9 | fn returns_closure() -> impl Fn(i32) -> i32 {
| ------------------- the expected opaque type
...
13 | fn returns_initialized_closure(init: i32) -> impl Fn(i32) -> i32 {
| ------------------- the found opaque type
|
= note: expected opaque type `impl Fn(i32) -> i32`
found opaque type `impl Fn(i32) -> i32`
= note: distinct uses of `impl Trait` result in different opaque types
For more information about this error, try `rustc --explain E0308`.
error: could not compile `functions-example` (bin "functions-example") due to 1 previous error
ข้อความแจ้งข้อผิดพลาดอธิบายว่า ทุกครั้งที่เราคืนค่า impl Trait คอมไพเลอร์ Rust จะสร้าง ชนิดข้อมูลแบบทึบแสง (opaque type) ที่มีเอกลักษณ์เฉพาะตัวขึ้นมา ซึ่งเป็นชนิดข้อมูลที่เราไม่สามารถมองเห็นรายละเอียดภายในที่ Rust สร้างขึ้น และไม่สามารถคาดเดาชนิดข้อมูลที่ Rust สร้างขึ้นเพื่อเขียนระบุด้วยตนเองได้ ดังนั้น แม้ว่าฟังก์ชันเหล่านี้จะคืนค่าโคลเชอร์ที่อิมพลีเมนต์เทรตเดียวกันคือ Fn(i32) -> i32 แต่ชนิดข้อมูลทึบแสงที่ Rust สร้างขึ้นสำหรับแต่ละตัวกลับแตกต่างกัน (ลักษณะนี้คล้ายคลึงกับวิธีที่ Rust สร้างชนิดข้อมูลรูปธรรมที่ต่างกันให้กับบล็อก async คนละบล็อก แม้ว่าจะมีชนิดข้อมูลเอาต์พุตเดียวกัน ดังที่เราเห็นใน“ชนิด Pin และเทรต Unpin” ในบทที่ 17) เราเคยเห็นทางออกสำหรับปัญหานี้มาแล้วหลายครั้ง นั่นคือการนำเทรตออบเจกต์มาใช้งาน ดังที่แสดงในลิสติ้ง 20-34
fn main() {
let handlers = vec![returns_closure(), returns_initialized_closure(123)];
for handler in handlers {
let output = handler(5);
println!("{output}");
}
}
fn returns_closure() -> Box<dyn Fn(i32) -> i32> {
Box::new(|x| x + 1)
}
fn returns_initialized_closure(init: i32) -> Box<dyn Fn(i32) -> i32> {
Box::new(move |x| x + init)
}โค้ดนี้จะสามารถคอมไพล์ผ่านได้อย่างราบรื่น สำหรับข้อมูลเพิ่มเติมเกี่ยวกับเทรตออบเจกต์ สามารถย้อนกลับไปดูหัวข้อ“การใช้เทรตออบเจกต์เพื่อนามธรรมพฤติกรรมร่วม” ในบทที่ 18 ได้
ต่อไป มาสำรวจเรื่องมาโคร (macros) กัน!
มาโคร
มาโคร
เราได้ใช้งานมาโคร (macros) อย่างเช่น println! มาตลอดทั้งเล่มนี้ แต่เรายังไม่ได้เจาะลึกอย่างเต็มที่ว่า แท้จริงแล้วมาโครคืออะไรและมีหลักการทำงานอย่างไร คำว่า มาโคร ในภาษา Rust ครอบคลุมฟีเจอร์ 2 กลุ่มใหญ่ ได้แก่ มาโครแบบประกาศ (declarative macros) ที่สร้างด้วย macro_rules! และ มาโครเชิงกระบวนการ (procedural macros) ซึ่งแบ่งออกเป็น 3 รูปแบบ:
- มาโคร
#[derive]แบบกำหนดเอง (custom derive macros) ซึ่งใช้สร้างโค้ดเพิ่มเติมโดยอัตโนมัติเมื่อระบุแอตทริบิวต์deriveบน struct และ enum - มาโครคล้ายแอตทริบิวต์ (attribute-like macros) ซึ่งเปิดให้เรานิยามแอตทริบิวต์แบบกำหนดเองขึ้นมาใช้งานกับไอเท็มใด ๆ ก็ได้
- มาโครคล้ายฟังก์ชัน (function-like macros) ซึ่งมีหน้าตาคล้ายกับการเรียกใช้ฟังก์ชัน แต่ทำงานโดยตรงกับลำดับของโทเค็น (tokens) ที่ส่งเข้ามาเป็นอาร์กิวเมนต์
เราจะศึกษามาโครแต่ละประเภทไปตามลำดับ แต่ก่อนอื่น มาทำความเข้าใจกันก่อนว่า ทำไมเราถึงยังต้องการมาโครทั้งที่เรามีฟังก์ชันให้ใช้งานอยู่แล้ว
ความแตกต่างระหว่างมาโครกับฟังก์ชัน
โดยเนื้อแท้แล้ว มาโครคือวิธีการเขียนโค้ดเพื่อสร้างโค้ดอื่นขึ้นมา ซึ่งเป็นที่รู้จักกันในชื่อ เมตาโปรแกรมมิ่ง (metaprogramming) ในภาคผนวก C เราได้พูดถึงแอตทริบิวต์ derive ที่ช่วยสร้างโค้ดอิมพลีเมนต์เทรตต่าง ๆ ให้กับคุณโดยอัตโนมัติ นอกจากนี้เรายังได้ใช้มาโครอย่าง println! และ vec! มาตลอดทั้งเล่ม มาโครทั้งหมดเหล่านี้จะทำหน้าที่ คลี่ขยายโค้ด (expand) เพื่อสร้างโค้ดออกมามากกว่าโค้ดที่คุณเขียนด้วยมือจริง ๆ
เมตาโปรแกรมมิ่งมีประโยชน์อย่างมากในการลดปริมาณโค้ดที่คุณต้องเขียนและดูแลรักษา ซึ่งนั่นก็เป็นหน้าที่หนึ่งของฟังก์ชันเช่นกัน อย่างไรก็ตาม มาโครมีพลังพิเศษบางประการที่ฟังก์ชันธรรมดาไม่สามารถทำได้
ซิกเนเจอร์ของฟังก์ชันจำเป็นต้องประกาศจำนวนและชนิดของพารามิเตอร์ไว้อย่างตายตัว ในทางกลับกัน มาโครสามารถรับอาร์กิวเมนต์ที่มีจำนวนไม่แน่นอนได้ (variadic): เราสามารถเรียก println!("hello") ด้วยอาร์กิวเมนต์เดียว หรือเรียก println!("hello {}", name) ด้วยสองอาร์กิวเมนต์ก็ได้ นอกจากนี้ มาโครยังถูกคลี่ขยายก่อนที่คอมไพเลอร์จะตีความหมายของโค้ด ดังนั้น มาโครจึงสามารถสร้างโค้ดเพื่ออิมพลีเมนต์เทรตให้กับชนิดข้อมูลที่กำหนดได้ ซึ่งฟังก์ชันไม่สามารถทำเช่นนั้นได้เนื่องจากฟังก์ชันจะถูกเรียกใช้งานในตอนรันไทม์ ขณะที่การอิมพลีเมนต์เทรตจำเป็นต้องทำตั้งแต่ตอนคอมไพล์
ข้อเสียของการสร้างมาโครแทนฟังก์ชัน คือนิยามของมาโครจะมีความซับซ้อนกว่าฟังก์ชันมาก เพราะคุณกำลังเขียนโค้ด Rust เพื่อสร้างโค้ด Rust อีกทอดหนึ่ง และเนื่องจากความซับซ้อนเชิงอ้อมนี้ จึงทำให้นิยามของมาโครอ่าน ทำความเข้าใจ และดูแลรักษาได้ยากกว่าฟังก์ชันทั่วไป
ความแตกต่างที่สำคัญอีกประการระหว่างมาโครกับฟังก์ชัน คือคุณจะต้องนิยามมาโครหรือนำมาโครเข้ามาสู่ขอบเขต (scope) ก่อน ที่จะเรียกใช้งานในไฟล์นั้น ซึ่งต่างจากฟังก์ชันที่คุณสามารถนิยามไว้ที่ใดก็ได้และเรียกใช้งานจากจุดใดก็ได้ในสโคป
มาโครแบบประกาศสำหรับเมตาโปรแกรมมิ่งทั่วไป
รูปแบบของมาโครที่มีการใช้งานอย่างแพร่หลายที่สุดใน Rust คือ มาโครแบบประกาศ (declarative macros) ซึ่งบางครั้งมักเรียกว่า “มาโครตามตัวอย่าง (macros by example)” หรือ “มาโคร macro_rules!” หรือเรียกสั้น ๆ ว่า “มาโคร” โดยหัวใจสำคัญคือ มาโครแบบประกาศช่วยให้คุณสามารถเขียนโครงสร้างที่มีลักษณะคล้ายกับนิพจน์ match ของ Rust ได้ ดังที่เราได้พูดคุยกันในบทที่ 6 ว่านิพจน์ match เป็นโครงสร้างควบคุมที่รับนิพจน์เข้ามา แล้วนำค่าผลลัพธ์ไปเปรียบเทียบกับรูปแบบ (patterns) ต่าง ๆ จากนั้นจึงรันโค้ดของกิ่งกรณีที่ตรงกับรูปแบบนั้น มาโครก็ทำหน้าที่เปรียบเทียบค่ากับรูปแบบที่เชื่อมโยงกับโค้ดเช่นเดียวกัน: เพียงแต่ในบริบทนี้ ค่าที่ส่งเข้ามาคือซอร์สโค้ดของ Rust ตัวจริงที่ส่งให้กับมาโคร; รูปแบบจะถูกนำมาเปรียบเทียบกับโครงสร้างของซอร์สโค้ดนั้น; และโค้ดที่ผูกไว้กับแต่ละรูปแบบจะถูกนำมาแทนที่โค้ดต้นฉบับเมื่อรูปแบบตรงกัน ซึ่งกระบวนการทั้งหมดนี้เกิดขึ้นในระหว่างการคอมไพล์
ในการนิยามมาโคร คุณจะใช้โครงสร้าง macro_rules! มาศึกษาการใช้งาน macro_rules! ผ่านการดูนิยามของมาโคร vec! กัน ในบทที่ 8 เราได้เรียนรู้วิธีใช้มาโคร vec! เพื่อสร้างเวกเตอร์ใหม่ที่บรรจุค่าต่าง ๆ ตัวอย่างเช่น มาโครต่อไปนี้สร้างเวกเตอร์ใหม่ที่เก็บเลขจำนวนเต็ม 3 ตัว:
#![allow(unused)]
fn main() {
let v: Vec<u32> = vec![1, 2, 3];
}นอกจากนี้เรายังสามารถใช้ vec! สร้างเวกเตอร์ของเลขจำนวนเต็ม 2 ตัว หรือเวกเตอร์ของสตริงสไลซ์ 5 ตัวก็ได้ เราไม่สามารถเขียนฟังก์ชันธรรมดาให้ทำงานยืดหยุ่นเช่นนี้ได้ เพราะเราไม่สามารถทราบจำนวนหรือชนิดของค่าข้อมูลล่วงหน้าได้เลย
ลิสติ้ง 20-35 แสดงนิยามแบบย่อของมาโคร vec! เพื่อให้เข้าใจง่ายขึ้น
#[macro_export]
macro_rules! vec {
( $( $x:expr ),* ) => {
{
let mut temp_vec = Vec::new();
$(
temp_vec.push($x);
)*
temp_vec
}
};
}หมายเหตุ: นิยามจริงของมาโคร
vec!ในไลบรารีมาตรฐานจะมีโค้ดสำหรับจัดสรรหน่วยความจำล่วงหน้าให้เพียงพอกับขนาดข้อมูล โค้ดส่วนนั้นเป็นการเพิ่มประสิทธิภาพ (optimization) ซึ่งเราตัดทอนออกไปในตัวอย่างนี้เพื่อให้โค้ดกระชับและเข้าใจง่าย
แอตทริบิวต์ #[macro_export] บ่งบอกว่ามาโครนี้ควรเปิดให้พร้อมใช้งานได้ทุกเมื่อที่มีการนำเครต (crate) ที่นิยามมาโครนี้เข้ามาสู่ขอบเขตการทำงาน หากไม่มีแอตทริบิวต์นี้ มาโครจะไม่สามารถถูกนำเข้ามาใช้งานในสโคปอื่นได้
จากนั้นเราเริ่มต้นนิยามมาโครด้วยคำสั่ง macro_rules! ตามด้วยชื่อมาโครที่เราต้องการนิยามโดย_ไม่ต้องมี_เครื่องหมายอัศเจรีย์ (ในที่นี้คือชื่อ vec) แล้วตามด้วยวงเล็บปีกกาที่ครอบบอดี้ของนิยามมาโครเอาไว้
โครงสร้างภายในบอดี้ของ vec! มีลักษณะคล้ายกับนิพจน์ match โดยในที่นี้มีหนึ่งกิ่งกรณีที่มีรูปแบบเป็น ( $( $x:expr ),* ) ตามด้วยเครื่องหมาย => และบล็อกโค้ดที่เชื่อมโยงกับรูปแบบนี้ หากโค้ดที่ส่งเข้ามาตรงกับรูปแบบ บล็อกโค้ดที่เกี่ยวข้องก็จะถูกปล่อยออกมาแทนที่ และเนื่องจากในมาโครนี้มีเพียงรูปแบบเดียว จึงมีวิธีจับคู่ที่ถูกต้องเพียงวิธีเดียวเท่านั้น รูปแบบอื่นใดนอกเหนือจากนี้จะทำให้เกิดข้อผิดพลาดในการคอมไพล์ สำหรับมาโครที่ซับซ้อนกว่านี้ก็สามารถมีได้หลายกิ่งกรณี
ไวยากรณ์ของรูปแบบที่ใช้ในนิยามมาโครจะแตกต่างไปจากไวยากรณ์ของแพตเทิร์นที่เราเรียนรู้ในบทที่ 19 เนื่องจากรูปแบบของมาโครจะจับคู่กับโครงสร้างโค้ดของ Rust ไม่ใช่จับคู่กับค่าข้อมูล มาดูกันว่าแต่ละชิ้นส่วนของรูปแบบในลิสติ้ง 20-35 มีความหมายอย่างไร (สำหรับไวยากรณ์รูปแบบของมาโครฉบับสมบูรณ์ สามารถศึกษาได้จาก คู่มืออ้างอิงของ Rust (Rust Reference))
อันดับแรก เราใช้วงเล็บกลมคู่หนึ่งครอบรูปแบบทั้งหมดเอาไว้ เราใช้เครื่องหมายดอลลาร์ ($) เพื่อประกาศตัวแปรในระบบมาโคร ซึ่งจะทำหน้าที่เก็บโค้ด Rust ที่จับคู่ตรงกับรูปแบบ โดยเครื่องหมายดอลลาร์ช่วยระบุชัดเจนว่านี่คือตัวแปรของระบบมาโคร ไม่ใช่ตัวแปร Rust ทั่วไป ถัดมาคือวงเล็บ $() ซึ่งทำหน้าที่จับยึด (capture) ค่าที่ตรงกับรูปแบบภายในวงเล็บเพื่อนำไปใช้ในโค้ดส่วนแทนที่ ภายใน $() มี $x:expr ซึ่งหมายถึงการจับคู่กับนิพจน์ (expression) ใด ๆ ของ Rust และตั้งชื่อให้กับนิพจน์นั้นว่า $x
เครื่องหมายจุลภาคที่ตามหลัง $() บ่งบอกว่าสามารถมีเครื่องหมายจุลภาคคั่นระหว่างแต่ละอินสแตนซ์ของโค้ดที่ตรงกับเงื่อนไขใน $() ได้ ส่วนเครื่องหมาย * ระบุว่ารูปแบบสามารถจับคู่กับสิ่งที่อยู่ข้างหน้าได้ตั้งแต่ 0 ครั้งขึ้นไป
เมื่อเราเรียกใช้มาโครนี้ด้วยคำสั่ง vec![1, 2, 3]; รูปแบบ $x จะจับคู่ 3 ครั้งกับนิพจน์ทั้งสามตัว ได้แก่ 1, 2 และ 3
คราวนี้มาดูรูปแบบในบอดี้ของโค้ดที่เชื่อมโยงกับกิ่งนี้: ส่วน temp_vec.push() ภายใน $()* จะถูกสร้างขึ้นซ้ำตามจำนวนครั้งที่จับคู่กับ $() ในรูปแบบ (ตั้งแต่ 0 ครั้งขึ้นไป ขึ้นอยู่กับจำนวนข้อมูลที่ส่งเข้ามา) โดย $x จะถูกแทนที่ด้วยนิพจน์แต่ละตัวที่จับคู่ได้ เมื่อเราเรียกมาโครนี้ด้วย vec![1, 2, 3]; โค้ดที่ถูกสร้างขึ้นเพื่อแทนที่การเรียกใช้มาโครดังกล่าวก็คือ:
{
let mut temp_vec = Vec::new();
temp_vec.push(1);
temp_vec.push(2);
temp_vec.push(3);
temp_vec
}เราจึงได้มาโครที่สามารถรับอาร์กิวเมนต์จำนวนเท่าใดก็ได้และชนิดข้อมูลใดก็ได้ พร้อมทั้งสร้างโค้ดขึ้นมาสร้างเวกเตอร์ที่บรรจุสมาชิกเหล่านั้นได้อย่างสมบูรณ์
หากต้องการเรียนรู้เพิ่มเติมเกี่ยวกับวิธีการเขียนมาโคร สามารถศึกษาเพิ่มเติมได้จากเอกสารออนไลน์และแหล่งข้อมูลอื่น ๆ เช่น “The Little Book of Rust Macros” ซึ่งริเริ่มโดย Daniel Keep และดูแลต่อโดย Lukas Wirth
มาโครแบบโพรซีเยอร์สำหรับสร้างโค้ดจากแอตทริบิวต์
รูปแบบที่สองของมาโครคือ มาโครเชิงกระบวนการ (procedural macros) ซึ่งมีลักษณะการทำงานคล้ายกับฟังก์ชันมากกว่า โดยมาโครเชิงกระบวนการจะรับโค้ดเข้ามาเป็นอินพุต ทำการประมวลผลโค้ดนั้น แล้วสร้างโค้ดใหม่ออกมาเป็นเอาต์พุต แทนที่จะเป็นการจับคู่กับรูปแบบแล้วแทนที่โค้ดเหมือนอย่างที่มาโครแบบประกาศทำ มาโครเชิงกระบวนการทั้ง 3 ประเภท ได้แก่ derive แบบกำหนดเอง, คล้ายแอตทริบิวต์ และคล้ายฟังก์ชัน ซึ่งทั้งหมดทำงานในลักษณะที่คล้ายคลึงกัน
การสร้างมาโครเชิงกระบวนการจำเป็นต้องแยกนิยามไปไว้ในเครตต่างหากที่มีชนิดเครตเป็นพิเศษ ซึ่งเป็นผลมาจากข้อจำกัดทางเทคนิคที่ซับซ้อนของคอมไพเลอร์ที่หวังว่าจะสามารถยกเลิกข้อจำกัดนี้ได้ในอนาคต ในลิสติ้ง 20-36 เราแสดงวิธีนิยามมาโครเชิงกระบวนการ โดย some_attribute เป็นตัวแทนของแอตทริบิวต์ที่ระบุชนิดของมาโครเจาะจง
use proc_macro::TokenStream;
#[some_attribute]
pub fn some_name(input: TokenStream) -> TokenStream {
}ฟังก์ชันที่นิยามมาโครเชิงกระบวนการจะรับ TokenStream เป็นอินพุต และสร้าง TokenStream เป็นเอาต์พุต ชนิดข้อมูล TokenStream ถูกนิยามไว้ในเครต proc_macro ที่มาพร้อมกับ Rust และทำหน้าที่เป็นตัวแทนของลำดับโทเค็นในภาษา นี่คือหัวใจสำคัญของมาโคร: ซอร์สโค้ดที่ส่งเข้ามาให้มาโครประมวลผลจะรวมกันเป็น TokenStream ขาเข้า และโค้ดที่มาโครสร้างขึ้นมาใหม่ก็คือ TokenStream ขาออก นอกจากนี้ตัวฟังก์ชันยังต้องมีแอตทริบิวต์กำกับไว้เพื่อระบุว่าเรากำลังสร้างมาโครเชิงกระบวนการชนิดใด โดยเราสามารถนิยามมาโครเชิงกระบวนการหลายชนิดไว้ในเครตเดียวกันได้
มาดูรายละเอียดของมาโครเชิงกระบวนการแต่ละประเภทกัน เราจะเริ่มจากมาโคร derive แบบกำหนดเอง จากนั้นจะอธิบายจุดแตกต่างเล็กน้อยของมาโครในรูปแบบอื่น ๆ
มาโคร derive แบบกำหนดเอง
มาลองสร้างเครตชื่อ hello_macro ที่นิยามเทรตชื่อ HelloMacro พร้อมฟังก์ชันเชื่อมโยงหนึ่งฟังก์ชันชื่อ hello_macro กัน แทนที่จะให้ผู้ใช้งานเครตของเราต้องมาเขียนโค้ดอิมพลีเมนต์เทรต HelloMacro ให้กับชนิดข้อมูลของตนทีละตัว เราจะสร้างมาโครเชิงกระบวนการขึ้นมา เพื่อให้ผู้ใช้งานสามารถกำกับชนิดข้อมูลด้วย #[derive(HelloMacro)] แล้วได้รับการอิมพลีเมนต์เริ่มต้นของฟังก์ชัน hello_macro ไปโดยอัตโนมัติ โดยการอิมพลีเมนต์เริ่มต้นนี้จะพิมพ์ข้อความ Hello, Macro! My name is TypeName! ออกมา ซึ่ง TypeName คือชื่อของชนิดข้อมูลที่นำเทรตนี้ไปใช้ กล่าวคือ เราจะเขียนเครตที่เปิดโอกาสให้นักพัฒนาท่านอื่นสามารถเขียนโค้ดได้ตามลิสติ้ง 20-37 เมื่อเรียกใช้เครตของเรา
use hello_macro::HelloMacro;
use hello_macro_derive::HelloMacro;
#[derive(HelloMacro)]
struct Pancakes;
fn main() {
Pancakes::hello_macro();
}เมื่อทำเสร็จสิ้น โค้ดนี้จะพิมพ์ Hello, Macro! My name is Pancakes! ออกมา ขั้นตอนแรกคือการสร้างโปรเจกต์ไลบรารีเครตใหม่ด้วยคำสั่งดังนี้:
$ cargo new hello_macro --lib
ถัดไป ในลิสติ้ง 20-38 เราจะนิยามเทรต HelloMacro และฟังก์ชันเชื่อมโยงของมัน
pub trait HelloMacro {
fn hello_macro();
}ตอนนี้เรามีเทรตและฟังก์ชันพร้อมแล้ว ในจุดนี้ ผู้ใช้เครตของเราสามารถอิมพลีเมนต์เทรตนี้ด้วยตนเองเพื่อให้ได้การทำงานที่ต้องการได้ ดังที่แสดงในลิสติ้ง 20-39
use hello_macro::HelloMacro;
struct Pancakes;
impl HelloMacro for Pancakes {
fn hello_macro() {
println!("Hello, Macro! My name is Pancakes!");
}
}
fn main() {
Pancakes::hello_macro();
}อย่างไรก็ตาม ผู้ใช้จะต้องเขียนบล็อกการอิมพลีเมนต์นี้ซ้ำ ๆ สำหรับทุกชนิดข้อมูลที่ต้องการใช้งานร่วมกับ hello_macro ซึ่งเราต้องการช่วยให้ผู้ใช้ไม่ต้องมาเสียเวลาเขียนโค้ดซ้ำซากนี้
นอกจากนี้ เรายังไม่สามารถกำหนดการอิมพลีเมนต์เริ่มต้นให้กับฟังก์ชัน hello_macro เพื่อให้พิมพ์ชื่อของชนิดข้อมูลที่ถูกอิมพลีเมนต์ออกมาได้โดยตรง เนื่องจาก Rust ไม่มีระบบ reflection (การตรวจสอบโครงสร้างของโปรแกรมในขณะรันไทม์) จึงไม่สามารถค้นหาชื่อของชนิดข้อมูลในตอนรันไทม์ได้ เราจึงจำเป็นต้องใช้มาโครเข้ามาช่วยสร้างโค้ดตั้งแต่ในตอนคอมไพล์
ขั้นตอนถัดไปคือการนิยามมาโครเชิงกระบวนการ ณ เวลาที่เขียนหนังสือเล่มนี้ มาโครเชิงกระบวนการจำเป็นต้องแยกไปอยู่ในเครตของตัวเอง (ซึ่งในอนาคตข้อจำกัดนี้อาจถูกยกเลิกไป) ธรรมเนียมปฏิบัติในการตั้งชื่อเครตสำหรับมาโครคือ: หากเครตหลักชื่อ foo เครตมาโคร derive แบบกำหนดเองจะตั้งชื่อว่า foo_derive เรามาสร้างเครตใหม่ชื่อ hello_macro_derive ไว้ภายในโฟลเดอร์ของโปรเจกต์ hello_macro กัน:
$ cargo new hello_macro_derive --lib
เนื่องจากเครตทั้งสองมีความเกี่ยวข้องกันอย่างใกล้ชิด เราจึงสร้างโฟลเดอร์เครตมาโครไว้ภายในไดเรกทอรีของเครต hello_macro หากเราแก้ไขนิยามของเทรตใน hello_macro เราก็จะต้องแก้ไขโค้ดการอิมพลีเมนต์ของมาโครใน hello_macro_derive ตามไปด้วย โดยทั้งสองเครตจะต้องเผยแพร่แยกกันบน crates.io และนักพัฒนาที่ต้องการใช้งานจะต้องเพิ่มดีเพนเดนซีทั้งสองตัวเข้ามาในโปรเจกต์ หรืออีกทางเลือกหนึ่งคือเราอาจให้เครต hello_macro เรียกใช้ hello_macro_derive เป็นดีเพนเดนซี แล้วส่งออกต่อ (re-export) มาโครออกมาก็ได้ อย่างไรก็ตาม การแยกโครงสร้างแบบที่เราทำนี้ช่วยให้นักพัฒนาสามารถเลือกใช้งานเฉพาะ hello_macro ได้ แม้ว่าจะไม่ต้องการฟังก์ชันการทำงานของ derive ก็ตาม
เราจำเป็นต้องประกาศให้เครต hello_macro_derive มีชนิดเป็นเครตมาโครเชิงกระบวนการ นอกจากนี้เรายังต้องใช้ฟังก์ชันการทำงานจากเครต syn และ quote ดังที่คุณจะได้เห็นในอีกสักครู่ จึงต้องเพิ่มทั้งสองเครตเข้ามาเป็นดีเพนเดนซีด้วย โดยเพิ่มข้อความต่อไปนี้ลงในไฟล์ Cargo.toml ของเครต hello_macro_derive:
[lib]
proc-macro = true
[dependencies]
syn = "3.0"
quote = "1.0"
สำหรับการเริ่มต้นนิยามมาโคร ให้นำโค้ดในลิสติ้ง 20-40 ไปวางไว้ในไฟล์ src/lib.rs ของเครต hello_macro_derive โปรดทราบว่าโค้ดนี้จะยังคอมไพล์ไม่ผ่านจนกว่าเราจะเพิ่มนิยามของฟังก์ชัน impl_hello_macro เข้าไป
use proc_macro::TokenStream;
use quote::quote;
#[proc_macro_derive(HelloMacro)]
pub fn hello_macro_derive(input: TokenStream) -> TokenStream {
// Construct a representation of Rust code as a syntax tree
// that we can manipulate.
let ast = syn::parse(input).unwrap();
// Build the trait implementation.
impl_hello_macro(&ast)
}โปรดสังเกตว่าเราได้แยกโค้ดออกเป็นสองส่วน ได้แก่ ฟังก์ชัน hello_macro_derive ซึ่งทำหน้าที่แยกวิเคราะห์ (parse) TokenStream และฟังก์ชัน impl_hello_macro ซึ่งทำหน้าที่แปลงทรีไวยากรณ์ (syntax tree) การแยกเช่นนี้ช่วยให้การเขียนมาโครเชิงกระบวนการเป็นระบบและสะดวกยิ่งขึ้น โค้ดในฟังก์ชันชั้นนอก (hello_macro_derive ในกรณีนี้) จะมีหน้าตาแทบจะเหมือนกันในเครตมาโครเชิงกระบวนการเกือบทุกตัวที่คุณพบเห็น ส่วนโค้ดที่คุณเขียนในบอดี้ของฟังก์ชันชั้นใน (impl_hello_macro ในกรณีนี้) จะแตกต่างกันไปตามวัตถุประสงค์เฉพาะของมาโครแต่ละตัว
เราได้แนะนำเครตใหม่ 3 ตัว ได้แก่: proc_macro, syn และ quote โดยเครต proc_macro จะมาพร้อมกับคอมไพเลอร์ Rust อยู่แล้ว เราจึงไม่จำเป็นต้องระบุไว้ในดีเพนเดนซีของ Cargo.toml ซึ่ง proc_macro คือ API ของคอมไพเลอร์ที่ช่วยให้เราสามารถอ่านและดัดแปลงโค้ด Rust ได้จากโค้ดของเราเอง
เครต syn ทำหน้าที่แยกวิเคราะห์โค้ด Rust จากข้อความสตริงให้อยู่ในรูปของโครงสร้างข้อมูลที่เราสามารถนำไปประมวลผลต่อได้ ส่วนเครต quote จะทำหน้าที่แปลงโครงสร้างข้อมูลของ syn กลับไปเป็นโค้ด Rust อีกครั้ง เครตทั้งสองนี้ช่วยให้การจัดการกับโค้ด Rust ทำได้ง่ายขึ้นอย่างมหาศาล เนื่องจากการเขียนตัวแยกวิเคราะห์ (parser) สำหรับภาษา Rust ด้วยตนเองตั้งแต่ต้นนั้นเป็นเรื่องที่ซับซ้อนอย่างยิ่ง
ฟังก์ชัน hello_macro_derive จะถูกเรียกใช้งานเมื่อผู้ใช้ระบุแอตทริบิวต์ #[derive(HelloMacro)] บนชนิดข้อมูลใดชนิดข้อมูลหนึ่ง สาเหตุที่ทำเช่นนี้ได้เนื่องจากเรากำกับฟังก์ชัน hello_macro_derive ไว้ด้วย #[proc_macro_derive(HelloMacro)] ซึ่งระบุชื่อ HelloMacro ให้ตรงกับชื่อเทรตของเรา ซึ่งนี่เป็นแนวทางปฏิบัติมาตรฐานที่มาโครเชิงกระบวนการส่วนใหญ่ยึดถือร่วมกัน
ฟังก์ชัน hello_macro_derive จะเริ่มต้นด้วยการแปลง input จาก TokenStream ให้กลายเป็นโครงสร้างข้อมูลที่เราสามารถตีความและประมวลผลได้ ซึ่งนี่คือหน้าที่ของ syn โดยฟังก์ชัน parse ใน syn จะรับ TokenStream แล้วคืนค่ากลับมาเป็น struct DeriveInput ที่เป็นตัวแทนของโค้ด Rust ที่ผ่านการแยกวิเคราะห์แล้ว ลิสติ้ง 20-41 แสดงส่วนสำคัญของ struct DeriveInput ที่ได้จากการแยกวิเคราะห์ข้อความ struct Pancakes;
DeriveInput {
// --snip--
ident: Ident {
ident: "Pancakes",
span: #0 bytes(95..103)
},
data: Struct(
DataStruct {
struct_token: Struct,
fields: Unit,
semi_token: Some(
Semi
)
}
)
}ฟิลด์ต่าง ๆ ของ struct นี้แสดงให้เห็นว่า โค้ด Rust ที่เราแยกวิเคราะห์ออกมาเป็นยูนิต struct (unit struct) ที่มี ident (ย่อมาจาก identifier หมายถึงชื่อของไอเท็ม) เป็น "Pancakes" นอกจากนี้ยังมีฟิลด์อื่น ๆ ใน struct นี้อีกมากมายที่ใช้อธิบายโครงสร้างโค้ดแบบต่าง ๆ ของ Rust คุณสามารถดูรายละเอียดเพิ่มเติมได้ที่ เอกสารของ syn สำหรับ DeriveInput
ต่อไปเราจะนิยามฟังก์ชัน impl_hello_macro ซึ่งเป็นจุดที่เราจะสร้างโค้ด Rust ใหม่เพื่อใส่เพิ่มเติมเข้าไป แต่ก่อนจะไปถึงตรงนั้น โปรดสังเกตว่าผลลัพธ์ของมาโคร derive ก็คือ TokenStream เช่นกัน โดย TokenStream ที่ส่งคืนกลับไปจะถูกผนวกรวมเข้ากับโค้ดที่ผู้ใช้เขียนขึ้น ดังนั้นเมื่อผู้ใช้คอมไพล์เครตของตนเอง โค้ดดังกล่าวจะได้รับการต่อขยายด้วยฟังก์ชันการทำงานเพิ่มเติมที่เราสร้างขึ้นผ่าน TokenStream ใหม่นี้
คุณอาจสังเกตเห็นว่าเรามีการเรียกใช้ unwrap ซึ่งจะทำให้ฟังก์ชัน hello_macro_derive เกิดการแพนิกหากการเรียกใช้ syn::parse ล้มเหลว การให้มาโครเชิงกระบวนการเกิดอาการแพนิกเมื่อพบข้อผิดพลาดเป็นสิ่งจำเป็น เนื่องจากฟังก์ชัน proc_macro_derive ต้องคืนค่าเป็น TokenStream ไม่ใช่ Result เพื่อให้สอดคล้องกับข้อกำหนดของ API มาโคร ในตัวอย่างนี้เราเลือกใช้ unwrap เพื่อให้โค้ดเข้าใจง่าย แต่ในโค้ดที่ใช้งานจริงในโปรดักชัน คุณควรแสดงข้อความข้อผิดพลาดที่ชัดเจนและเฉพาะเจาะจงยิ่งขึ้นด้วย panic! หรือ expect
เมื่อเรามีโค้ดสำหรับแปลงโค้ด Rust จาก TokenStream ไปเป็นอินสแตนซ์ DeriveInput เรียบร้อยแล้ว ตอนนี้เรามาสร้างโค้ดเพื่ออิมพลีเมนต์เทรต HelloMacro ให้กับชนิดข้อมูลดังกล่าวกัน ดังที่แสดงในลิสติ้ง 20-42
use proc_macro::TokenStream;
use quote::quote;
#[proc_macro_derive(HelloMacro)]
pub fn hello_macro_derive(input: TokenStream) -> TokenStream {
// Construct a representation of Rust code as a syntax tree
// that we can manipulate
let ast = syn::parse(input).unwrap();
// Build the trait implementation
impl_hello_macro(&ast)
}
fn impl_hello_macro(ast: &syn::DeriveInput) -> TokenStream {
let name = &ast.ident;
let generated = quote! {
impl HelloMacro for #name {
fn hello_macro() {
println!("Hello, Macro! My name is {}!", stringify!(#name));
}
}
};
generated.into()
}เราดึงอินสแตนซ์ของ struct Ident ที่เก็บชื่อตัวระบุของชนิดข้อมูลออกมาผ่าน ast.ident โดยจากโครงสร้างในลิสติ้ง 20-41 เมื่อเรารันฟังก์ชัน impl_hello_macro กับโค้ดในลิสติ้ง 20-37 ค่าในฟิลด์ ident จะมีค่าเป็น "Pancakes" ดังนั้นตัวแปร name ในลิสติ้ง 20-42 จึงเก็บอินสแตนซ์ของ Ident ซึ่งเมื่อแปลงเป็นข้อความจะได้สตริง "Pancakes" ซึ่งเป็นชื่อของ struct ในลิสติ้ง 20-37 นั่นเอง
มาโคร quote! ช่วยให้เราสามารถเขียนโค้ด Rust ที่ต้องการส่งคืนกลับไปได้โดยตรง แต่คอมไพเลอร์คาดหวังผลลัพธ์ที่มีชนิดเป็น TokenStream เราจึงต้องแปลงผลลัพธ์จาก quote! ไปเป็น TokenStream ด้วยการเรียกใช้เมธอด into ซึ่งจะนำตัวแทนระดับกลาง (intermediate representation) นี้ไปแปลงเป็นค่าชนิด TokenStream ที่คอมไพเลอร์ต้องการ
มาโคร quote! ยังมีกลไกการทำเทมเพลตที่สะดวกมาก: เราสามารถระบุเป็น #name แล้ว quote! จะแทนที่ตำแหน่งนั้นด้วยค่าที่เก็บอยู่ในตัวแปร name ให้โดยอัตโนมัติ นอกจากนี้ยังสามารถเขียนลูปเพื่อทำซ้ำในลักษณะเดียวกับมาโครทั่วไปได้ด้วย สามารถศึกษาบทนำและรายละเอียดทั้งหมดได้จาก เอกสารของเครต quote
เราต้องการให้มาโครเชิงกระบวนการสร้างโค้ดอิมพลีเมนต์เทรต HelloMacro ให้กับชนิดข้อมูลที่ผู้ใช้ระบุแอตทริบิวต์ไว้ ซึ่งเราดึงชื่อชนิดข้อมูลมาใช้ผ่าน #name โดยการอิมพลีเมนต์เทรตนี้มีฟังก์ชันเดียวคือ hello_macro ซึ่งบอดี้ของฟังก์ชันจะบรรจุการทำงานที่เราต้องการไว้ นั่นคือ การพิมพ์ข้อความ Hello, Macro! My name is ตามด้วยชื่อของชนิดข้อมูลนั้น ๆ
ส่วนมาโคร stringify! ที่เรียกใช้ตรงนี้เป็นมาโครที่มีมาให้อยู่แล้วใน Rust ซึ่งทำหน้าที่รับนิพจน์ใด ๆ ของ Rust (เช่น 1 + 2) แล้วแปลงนิพจน์นั้นให้เป็นสตริงลิเทอรัลในตอนคอมไพล์ เช่น "1 + 2" ซึ่งต่างจาก format! หรือ println! ที่จะประเมินผลลัพธ์ของนิพจน์ก่อนแล้วจึงแปลงเป็น String และเนื่องจากมีความเป็นไปได้ที่อินพุต #name อาจเป็นนิพจน์ที่ต้องการพิมพ์ออกมาตรง ๆ เราจึงเลือกใช้ stringify! ซึ่งนอกจากจะตรงกับวัตถุประสงค์แล้ว ยังช่วยประหยัดการจัดสรรหน่วยความจำในตอนรันไทม์ได้อีกหนึ่งครั้งด้วย
ถึงจุดนี้ คำสั่ง cargo build ควรจะคอมไพล์ผ่านได้อย่างเรียบร้อยทั้งในเครต hello_macro และ hello_macro_derive คราวนี้เรามาเชื่อมต่อเครตทั้งสองเข้ากับโค้ดในลิสติ้ง 20-37 เพื่อดูการทำงานจริงของมาโครเชิงกระบวนการกัน! สร้างโปรเจกต์ไบนารีใหม่ในโฟลเดอร์ projects ของคุณด้วยคำสั่ง cargo new pancakes เราจำเป็นต้องเพิ่ม hello_macro และ hello_macro_derive เป็นดีเพนเดนซีในไฟล์ Cargo.toml ของเครต pancakes หากคุณได้เผยแพร่เวอร์ชันของทั้งสองเครตนี้ไปยัง crates.io แล้ว ก็สามารถระบุเป็นดีเพนเดนซีปกติได้ แต่หากยังไม่ได้เผยแพร่ คุณสามารถระบุพาธตรงไปยังเครตผ่านคีย์ path ได้ดังนี้:
[dependencies]
hello_macro = { path = "../hello_macro" }
hello_macro_derive = { path = "../hello_macro/hello_macro_derive" }
ให้นำโค้ดจากลิสติ้ง 20-37 ไปใส่ในไฟล์ src/main.rs แล้วสั่งรันด้วย cargo run: โปรแกรมควรจะพิมพ์ Hello, Macro! My name is Pancakes! ออกมาอย่างถูกต้อง โดยโค้ดการอิมพลีเมนต์เทรต HelloMacro จะถูกสร้างและใส่เข้ามาโดยอัตโนมัติจากมาโครเชิงกระบวนการ โดยที่เครต pancakes ไม่จำเป็นต้องเขียนโค้ดอิมพลีเมนต์เองเลยแม้แต่น้อย เพราะแอตทริบิวต์ #[derive(HelloMacro)] ได้จัดการเพิ่มโค้ดอิมพลีเมนต์เทรตทั้งหมดให้แล้ว
ในหัวข้อถัดไป เราจะมาสำรวจกันว่ามาโครเชิงกระบวนการประเภทอื่น ๆ แตกต่างจากมาโคร derive แบบกำหนดเองอย่างไรบ้าง
มาโครคล้ายแอตทริบิวต์
มาโครคล้ายแอตทริบิวต์ (attribute-like macros) มีความคล้ายคลึงกับมาโคร derive แบบกำหนดเอง แต่แทนที่จะสร้างโค้ดเฉพาะสำหรับแอตทริบิวต์ derive มาโครประเภทนี้จะเปิดให้คุณสร้างแอตทริบิวต์ใหม่ขึ้นมาใช้งานได้เองอย่างอิสระ นอกจากนี้ยังมีความยืดหยุ่นสูงกว่า เนื่องจาก derive ใช้งานได้เฉพาะกับ struct และ enum เท่านั้น ขณะที่แอตทริบิวต์สามารถนำไปกำกับไว้บนไอเท็มอื่น ๆ ได้ด้วย เช่น ฟังก์ชัน นี่คือตัวอย่างการใช้งานมาโครคล้ายแอตทริบิวต์ สมมติว่าคุณมีแอตทริบิวต์ชื่อ route ที่ใช้กำกับฟังก์ชันเมื่อทำงานร่วมกับเว็บเฟรมเวิร์ก:
#[route(GET, "/")]
fn index() {แอตทริบิวต์ #[route] นี้จะได้รับการนิยามโดยตัวเฟรมเวิร์กในฐานะมาโครเชิงกระบวนการ โดยซิกเนเจอร์ของฟังก์ชันที่นิยามมาโครจะมีลักษณะดังนี้:
#[proc_macro_attribute]
pub fn route(attr: TokenStream, item: TokenStream) -> TokenStream {ในที่นี้ เรามีพารามิเตอร์ชนิด TokenStream สองตัว ตัวแรกคือข้อมูลเนื้อหาที่อยู่ภายในแอตทริบิวต์ ซึ่งก็คือส่วน GET, "/" ส่วนตัวที่สองคือบอดี้ของไอเท็มที่แอตทริบิวต์นี้แนบอยู่ด้วย ในกรณีนี้คือ fn index() {} รวมทั้งส่วนที่เหลือของบอดี้ฟังก์ชัน
นอกเหนือจากประเด็นนี้แล้ว มาโครคล้ายแอตทริบิวต์ก็ทำงานเหมือนกับมาโคร derive แบบกำหนดเองทุกประการ: คุณสร้างเครตที่มีชนิดเป็น proc-macro แล้วเขียนฟังก์ชันเพื่อสร้างโค้ดที่คุณต้องการส่งกลับออกมา!
มาโครคล้ายฟังก์ชัน
มาโครคล้ายฟังก์ชัน (function-like macros) ทำหน้าที่นิยามมาโครที่มีรูปแบบการเรียกใช้งานคล้ายกับฟังก์ชัน เช่นเดียวกับมาโคร macro_rules! มาโครประเภทนี้มีความยืดหยุ่นมากกว่าฟังก์ชันปกติ ตัวอย่างเช่น สามารถรับอาร์กิวเมนต์ได้ไม่จำกัดจำนวน อย่างไรก็ตาม มาโคร macro_rules! สามารถนิยามได้เฉพาะผ่านไวยากรณ์คล้าย match ตามที่เราได้พูดคุยกันในหัวข้อ“มาโครแบบประกาศสำหรับเมตาโปรแกรมมิ่งทั่วไป” ในตอนต้นเท่านั้น แต่สำหรับมาโครคล้ายฟังก์ชัน จะรับพารามิเตอร์เป็น TokenStream และในนิยามของมาโครจะสามารถประมวลผล TokenStream นั้นด้วยโค้ด Rust ปกติได้เช่นเดียวกับมาโครเชิงกระบวนการอีกสองประเภท ตัวอย่างหนึ่งของมาโครคล้ายฟังก์ชันคือมาโคร sql! ที่อาจเรียกใช้งานในลักษณะนี้:
let sql = sql!(SELECT * FROM posts WHERE id=1);มาโครนี้จะแยกวิเคราะห์คำสั่ง SQL ที่อยู่ข้างใน และตรวจสอบความถูกต้องทางไวยากรณ์ของคำสั่ง ซึ่งเป็นการประมวลผลที่ซับซ้อนเกินกว่าที่มาโคร macro_rules! จะสามารถทำได้ โดยมาโคร sql! จะถูกนิยามไว้ดังนี้:
#[proc_macro]
pub fn sql(input: TokenStream) -> TokenStream {นิยามนี้มีลักษณะคล้ายกับซิกเนเจอร์ของมาโคร derive แบบกำหนดเอง: ฟังก์ชันจะรับโทเค็นทั้งหมดที่อยู่ภายในวงเล็บเข้ามา แล้วส่งคืนโค้ดที่เราต้องการสร้างกลับออกไป
สรุป
เฮ้อ! ตอนนี้คุณมีฟีเจอร์ขั้นสูงของ Rust เพิ่มเข้ามาในกล่องเครื่องมือของคุณแล้ว แม้ว่าคุณอาจไม่ได้หยิบมาใช้งานในชีวิตประจำวันบ่อยนัก แต่คุณก็จะได้รู้ว่ามีฟีเจอร์เหล่านี้พร้อมให้เลือกใช้ในสถานการณ์ที่เฉพาะเจาะจงอย่างยิ่ง เราได้แนะนำหัวข้อที่ซับซ้อนหลายหัวข้อ เพื่อที่ว่าเมื่อคุณพบเจอสิ่งเหล่านี้ในข้อความแนะนำข้อผิดพลาดของคอมไพเลอร์ หรือในโค้ดของผู้อื่น คุณจะสามารถจดจำแนวคิดและเข้าใจไวยากรณ์เหล่านี้ได้อย่างรวดเร็ว ขอให้ใช้บทนี้เป็นคู่มืออ้างอิงเพื่อนำทางคุณไปสู่ทางออกที่ดีในยามจำเป็น
ในบทต่อไป เราจะนำทุกสิ่งที่เราได้เรียนรู้ร่วมกันมาตลอดทั้งเล่มมาลงมือปฏิบัติจริงในโปรเจกต์ส่งท้ายอีกหนึ่งโปรเจกต์!
โปรเจกต์สุดท้าย: สร้างเว็บเซิร์ฟเวอร์แบบหลายเธรด
เป็นการเดินทางอันยาวนาน แต่ในที่สุดเราก็มาถึงบทสุดท้ายของหนังสือเล่มนี้แล้ว ในบทนี้ เราจะร่วมกันสร้างโปรเจกต์ส่งท้ายอีกหนึ่งโปรเจกต์ เพื่อสาธิตแนวคิดต่าง ๆ ที่เราได้เรียนรู้ในบทท้าย ๆ รวมถึงทบทวนเนื้อหาจากบทก่อนหน้าไปพร้อมกัน
สำหรับโปรเจกต์ส่งท้ายนี้ เราจะสร้างเว็บเซิร์ฟเวอร์ (web server) ที่ตอบกลับว่า “Hello!” และแสดงผลในเว็บเบราว์เซอร์ดังรูปที่ 21-1
นี่คือแผนงานในการสร้างเว็บเซิร์ฟเวอร์ของเรา:
- ทำความเข้าใจ TCP และ HTTP เบื้องต้น
- รอรับการเชื่อมต่อ TCP บนซ็อกเก็ต (socket)
- แยกวิเคราะห์คำขอ (parse HTTP requests) รูปแบบพื้นฐาน
- สร้างการตอบกลับ (HTTP response) ที่ถูกต้องตามมาตรฐาน
- เพิ่มประสิทธิภาพการรองรับงาน (throughput) ของเซิร์ฟเวอร์ด้วยพูลเธรด (thread pool)
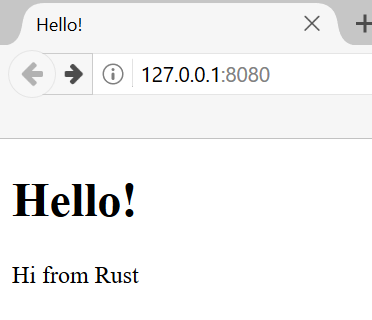
รูปที่ 21-1: โปรเจกต์สุดท้ายที่เราทำร่วมกัน
ก่อนจะเริ่มต้น มีรายละเอียด 2 ข้อที่เราควรทำความเข้าใจร่วมกัน:
ประการแรก วิธีการที่เราจะใช้นี้ไม่ใช่วิธีที่ดีที่สุดในการสร้างเว็บเซิร์ฟเวอร์ด้วย Rust ในทางปฏิบัติจริง เนื่องจากชุมชนนักพัฒนาได้เผยแพร่เครต (crates) พร้อมใช้งานระดับโปรดักชันไว้มากมายบน crates.io ซึ่งมีเว็บเซิร์ฟเวอร์และพูลเธรดที่สมบูรณ์แบบกว่าสิ่งที่เราจะสร้างขึ้นเองมาก ทว่าเป้าหมายของเราในบทนี้คือการเรียนรู้กลไกเบื้องหลัง ไม่ใช่การเลือกทางลัด เนื่องจาก Rust เป็นภาษาโปรแกรมระดับระบบ (systems programming language) เราจึงสามารถเลือกระดับของแอบสแตรกชัน (abstraction) ที่ต้องการทำงานด้วยได้อย่างอิสระ และสามารถลงลึกไปในระดับต่ำ (low-level) กว่าที่ทำได้หรือเหมาะสมในภาษาอื่น ๆ
ประการที่สอง เราจะไม่นำ async และ await มาใช้ในโปรเจกต์นี้ เพราะการสร้างพูลเธรดด้วยตัวเองก็ถือเป็นความท้าทายที่สำคัญมากพออยู่แล้ว โดยไม่ต้องเพิ่มความซับซ้อนของการสร้างรันไทม์แบบ async เข้ามาอีก อย่างไรก็ตาม เราจะชี้ให้เห็นว่า async และ await สามารถนำมาประยุกต์ใช้แก้โจทย์ปัญหาแบบเดียวกับที่เราพบในบทนี้ได้อย่างไร และที่สำคัญ ตามที่เราได้เห็นกันในบทที่ 17 รันไทม์แบบ async ส่วนใหญ่ต่างก็ใช้พูลเธรดในการบริหารจัดการงานเบื้องหลังเช่นกัน
ดังนั้น เราจะลงมือเขียนเว็บเซิร์ฟเวอร์ HTTP ขั้นพื้นฐานและสร้างพูลเธรดขึ้นมาด้วยตัวเอง เพื่อให้คุณได้เข้าใจแนวคิดและเทคนิคสำคัญที่อยู่เบื้องหลังเครตต่าง ๆ ที่คุณจะได้ใช้งานจริงในอนาคต
สร้างเว็บเซิร์ฟเวอร์แบบเธรดเดียว
สร้างเว็บเซิร์ฟเวอร์แบบเธรดเดียว
เราจะเริ่มต้นด้วยการสร้างเว็บเซิร์ฟเวอร์ (web server) แบบเธรดเดียว (single-threaded) ให้ทำงานได้ก่อน ก่อนเริ่มลงมือเขียนโค้ด มาดูภาพรวมสั้น ๆ ของโปรโตคอล (protocols) ที่เกี่ยวข้องกับการสร้างเว็บเซิร์ฟเวอร์กันสักนิด แม้รายละเอียดเชิงลึกของโปรโตคอลเหล่านี้จะอยู่นอกเหนือขอบเขตของหนังสือเล่มนี้ แต่ภาพรวมโดยสังเขปจะช่วยปูพื้นฐานข้อมูลที่จำเป็นทั้งหมดที่คุณต้องใช้
โปรโตคอลหลักสองตัวที่เกี่ยวข้องกับเว็บเซิร์ฟเวอร์คือ Hypertext Transfer Protocol (HTTP) และ Transmission Control Protocol (TCP) ทั้งคู่จัดเป็นโปรโตคอลรูปแบบ คำขอ-การตอบกลับ (request-response) ซึ่งหมายความว่า ไคลเอนต์ (client) จะเป็นฝ่ายเริ่มส่งคำขอ (request) ส่วน เซิร์ฟเวอร์ (server) จะคอยรอรับคำขอดังกล่าวแล้วส่งการตอบกลับ (response) แก่ไคลเอนต์ โดยเนื้อหาของคำขอและการตอบกลับจะถูกกำหนดไว้ตามข้อกำหนดของโปรโตคอล
TCP เป็นโปรโตคอลระดับล่าง (lower-level) ที่อธิบายรายละเอียดการเดินทางของข้อมูลจากคอมพิวเตอร์เครื่องหนึ่งไปยังอีกเครื่องหนึ่ง แต่ไม่ได้ระบุว่าข้อมูลนั้นคืออะไร ส่วน HTTP จะสร้างต่อยอดขึ้นมาจาก TCP โดยกำหนดรูปแบบเนื้อหาของคำขอและการตอบกลับ แม้ในทางเทคนิคเราจะใช้ HTTP ร่วมกับโปรโตคอลอื่นได้ ทว่าในกรณีส่วนใหญ่แล้ว HTTP จะส่งข้อมูลผ่าน TCP และในบทนี้ เราจะทำงานกับข้อมูลไบต์ดิบ (raw bytes) ของคำขอและการตอบกลับทั้งในระดับ TCP และ HTTP
การรอฟังการเชื่อมต่อ TCP
เว็บเซิร์ฟเวอร์ของเราจำเป็นต้องคอยรอรับการเชื่อมต่อ TCP นี่จึงเป็นส่วนแรกที่เราจะลงมือสร้าง ไลบรารีมาตรฐานของ Rust มีมอดูล std::net สำหรับจัดการเรื่องนี้โดยเฉพาะ มาเริ่มสร้างโปรเจกต์ใหม่ตามขั้นตอนปกติกัน:
$ cargo new hello
Created binary (application) `hello` project
$ cd hello
ตอนนี้ให้ป้อนโค้ดในลิสติ้ง 21-1 ใน src/main.rs เพื่อเริ่มต้น โค้ดนี้จะรอฟังสตรีม (stream) TCP ที่เข้ามายังแอดเดรสภายในเครื่อง 127.0.0.1:7878 เมื่อได้รับสตรีมที่เข้ามา มันจะพิมพ์ Connection established!
use std::net::TcpListener;
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
println!("Connection established!");
}
}การใช้ TcpListener ทำให้เราสามารถรอรับการเชื่อมต่อ TCP ที่แอดเดรส 127.0.0.1:7878 ได้ สำหรับแอดเดรสนี้ ส่วนที่อยู่ข้างหน้าเครื่องหมายโคลอนคือ IP address ที่แทนเครื่องคอมพิวเตอร์ของคุณเอง (ซึ่งมีค่าเหมือนกันบนทุกเครื่อง และไม่ได้ระบุถึงเครื่องของผู้เขียนโดยเฉพาะ) ส่วน 7878 คือหมายเลขพอร์ต (port) เราเลือกใช้พอร์ตนี้ด้วยเหตุผลสองประการ: ประการแรก โดยปกติพอร์ตนี้ไม่ได้ใช้รับส่งข้อมูล HTTP เซิร์ฟเวอร์ของเราจึงแทบไม่มีโอกาสชนกับเว็บเซิร์ฟเวอร์อื่นที่คุณอาจรันอยู่บนเครื่อง และประการที่สอง เลข 7878 หากกดแป้นพิมพ์โทรศัพท์ปุ่มตัวเลขจะสะกดได้เป็นคำว่า rust
ฟังก์ชัน bind ในบริบทนี้ทำงานคล้ายกับฟังก์ชัน new โดยจะคืนค่าอินสแตนซ์ใหม่ของ TcpListener ฟังก์ชันนี้ใช้ชื่อว่า bind เพราะในแวดวงระบบเครือข่าย การเชื่อมต่อไปยังพอร์ตเพื่อรอรับการเชื่อมต่อนั้นเรียกว่า “การผูกติดกับพอร์ต (binding to a port)”
ฟังก์ชัน bind จะคืนค่าเป็น Result<T, E> ซึ่งบ่งชี้ว่าการผูกพอร์ตอาจล้มเหลวได้ เช่น ในกรณีที่เรารันโปรแกรมนี้ขึ้นมาพร้อมกันสองอินสแตนซ์ ทำให้มีโปรแกรมสองตัวพยายามรอรับการเชื่อมต่อที่พอร์ตเดียวกัน แต่เนื่องจากเรากำลังเขียนเซิร์ฟเวอร์พื้นฐานเพื่อการเรียนรู้ เราจึงยังไม่ต้องกังวลกับการจัดการข้อผิดพลาดเหล่านี้ และจะเลือกใช้ unwrap เพื่อหยุดการทำงานของโปรแกรมทันทีหากเกิดข้อผิดพลาดขึ้น
เมธอด incoming บน TcpListener จะคืนค่าเป็นอิเทอเรเตอร์ (iterator) ที่ส่งมอบลำดับของสตรีม (stream) ให้แก่เรา (เจาะจงคือสตรีมชนิด TcpStream) โดย สตรีม หนึ่งตัวจะแทนการเชื่อมต่อที่เปิดอยู่ระหว่างไคลเอนต์กับเซิร์ฟเวอร์ คำว่า การเชื่อมต่อ (connection) เป็นชื่อเรียกกระบวนการรับส่งคำขอและการตอบกลับแบบครบวงจร ตั้งแต่ไคลเอนต์เชื่อมต่อไปยังเซิร์ฟเวอร์ เซิร์ฟเวอร์สร้างการตอบกลับ ไปจนถึงเซิร์ฟเวอร์ปิดการเชื่อมต่อลง ดังนั้นเราจึงสามารถอ่านข้อมูลจาก TcpStream เพื่อดูว่าไคลเอนต์ส่งสิ่งใดมา แล้วเขียนข้อมูลการตอบกลับของเราลงในสตรีมเพื่อส่งกลับไปยังไคลเอนต์ โดยสรุปแล้ว ลูป for นี้จะประมวลผลการเชื่อมต่อแต่ละรายการตามลำดับ และสร้างชุดของสตรีมออกมาให้เราจัดการ
ในตอนนี้ การจัดการสตรีมของเรามีเพียงการเรียก unwrap เพื่อหยุดโปรแกรมหากพบข้อผิดพลาดในสตรีม แต่หากไม่มีข้อผิดพลาด โปรแกรมก็จะพิมพ์ข้อความออกมา เราจะเพิ่มฟังก์ชันการทำงานในกรณีที่สำเร็จในลิสติ้งถัดไป สาเหตุที่เราอาจได้รับข้อผิดพลาดจากเมธอด incoming ขณะที่ไคลเอนต์เชื่อมต่อเข้ามาก็คือ ในความเป็นจริงแล้วเราไม่ได้กำลังวนซ้ำการเชื่อมต่อที่สมบูรณ์ แต่เรากำลังวนซ้ำ ความพยายามในการเชื่อมต่อ (connection attempts) ซึ่งการเชื่อมต่ออาจล้มเหลวได้จากหลายสาเหตุ โดยหลายสาเหตุมักขึ้นอยู่กับระบบปฏิบัติการโดยเฉพาะ เช่น ระบบปฏิบัติการหลายระบบมีขีดจำกัดจำนวนการเชื่อมต่อพร้อมกันที่สามารถเปิดค้างไว้ได้ หากมีความพยายามเชื่อมต่อใหม่เข้ามาเกินขีดจำกัดดังกล่าว ก็จะเกิดข้อผิดพลาดขึ้นจนกว่าการเชื่อมต่อที่เปิดอยู่บางส่วนจะปิดลง
มาลองรันโค้ดนี้กัน! เรียกใช้คำสั่ง cargo run ในเทอร์มินัล จากนั้นเปิดแอดเดรส 127.0.0.1:7878 บนเว็บเบราว์เซอร์ เบราว์เซอร์จะแสดงข้อผิดพลาด เช่น “Connection reset” เนื่องจากเซิร์ฟเวอร์ยังไม่ได้ส่งข้อมูลใด ๆ กลับไป แต่เมื่อคุณสลับมาดูที่เทอร์มินัล คุณจะเห็นข้อความปรากฏขึ้นหลายบรรทัดเมื่อเบราว์เซอร์เชื่อมต่อเข้ามายังเซิร์ฟเวอร์!
Running `target/debug/hello`
Connection established!
Connection established!
Connection established!
ในบางครั้งคุณอาจเห็นข้อความพิมพ์ซ้ำหลายครั้งสำหรับการเรียกหน้าเว็บบนเบราว์เซอร์เพียงครั้งเดียว สาเหตุอาจเกิดจากการที่เบราว์เซอร์ส่งคำขอเพื่อดึงหน้าเว็บ ควบคู่ไปกับคำขอทรัพยากรอื่น ๆ เช่น ไอคอน favicon.ico ที่แสดงบนแท็บของเบราว์เซอร์
อีกสาเหตุหนึ่งอาจเป็นเพราะเบราว์เซอร์พยายามเชื่อมต่อกับเซิร์ฟเวอร์ซ้ำหลายครั้งเนื่องจากเซิร์ฟเวอร์ไม่ได้ตอบกลับข้อมูลใด ๆ กลับไป เมื่อตัวแปร stream หลุดออกจากขอบเขต (scope) และถูกทำลายทิ้งที่จุดสิ้นสุดของลูป การเชื่อมต่อจะถูกปิดลงโดยอัตโนมัติผ่านการทำงานของ drop ซึ่งในบางครั้งเบราว์เซอร์จะรับมือกับการเชื่อมต่อที่ถูกปิดกะทันหันด้วยการลองส่งคำขอใหม่อีกครั้ง เนื่องจากประเมินว่าอาจเป็นปัญหาชั่วคราว
นอกจากนี้ เบราว์เซอร์บางตัวยังอาจเปิดการเชื่อมต่อทิ้งไว้หลายรายการโดยไม่ส่งคำขอใด ๆ เพื่อที่ว่าเมื่อถึงเวลาต้อง ส่งคำขอจริง คำขอนั้นจะเกิดขึ้นได้อย่างรวดเร็วทันที เมื่อเกิดเหตุการณ์นี้ขึ้น เซิร์ฟเวอร์ของเราจะมองเห็นการเชื่อมต่อแต่ละรายการเข้ามา ไม่ว่าจะมีข้อมูลคำขอส่งผ่านการเชื่อมต่อนั้นจริงหรือไม่ก็ตาม ตัวอย่างเช่น เบราว์เซอร์ตระกูล Chromium มักใช้วิธีนี้ คุณสามารถปิดการทำงานนี้ได้ด้วยการเปิดโหมดท่องเว็บแบบส่วนตัว (incognito/private mode) หรือเปลี่ยนไปใช้เบราว์เซอร์อื่น
สิ่งที่สำคัญที่สุดคือ ตอนนี้เราได้รับแฮนเดิล (handle) สำหรับการเชื่อมต่อ TCP ได้สำเร็จแล้ว!
อย่าลืมหยุดการทำงานของโปรแกรมโดยกด ctrl-C เมื่อคุณทดสอบโค้ดแต่ละรอบเสร็จสิ้น จากนั้นค่อยเริ่มรันโปรแกรมใหม่อีกครั้งด้วยคำสั่ง cargo run หลังจากแก้ไขโค้ดในแต่ละช่วง เพื่อให้มั่นใจว่าคุณกำลังรันโปรแกรมเวอร์ชันล่าสุดอยู่เสมอ
การอ่านคำขอ
มาเริ่มเขียนฟังก์ชันสำหรับอ่านข้อมูลคำขอที่ส่งมาจากเบราว์เซอร์กัน! เพื่อแยกหน้าที่การทำงาน (separation of concerns) ระหว่างการรับการเชื่อมต่อกับการจัดการสิ่งที่เกิดขึ้นบนการเชื่อมต่อนั้น เราจะสร้างฟังก์ชันใหม่ขึ้นมาสำหรับประมวลผลการเชื่อมต่อโดยเฉพาะ ในฟังก์ชัน handle_connection ใหม่นี้ เราจะอ่านข้อมูลจากสตรีม TCP แล้วพิมพ์ออกมาเพื่อให้เราเห็นข้อมูลที่เบราว์เซอร์ส่งมา ให้แก้ไขโค้ดตามลิสติ้ง 21-2
use std::{
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let http_request: Vec<_> = buf_reader
.lines()
.map(|result| result.unwrap())
.take_while(|line| !line.is_empty())
.collect();
println!("Request: {http_request:#?}");
}เรานำ std::io::BufReader และ std::io::prelude เข้ามาสู่ขอบเขตการทำงานเพื่อให้สามารถเข้าถึงเทรต (traits) และชนิดข้อมูลที่ใช้ในการอ่านและเขียนข้อมูลลงสตรีมได้ และภายในลูป for ของฟังก์ชัน main แทนที่จะพิมพ์ข้อความแจ้งว่าเชื่อมต่อสำเร็จ เราจะเปลี่ยนมาเรียกฟังก์ชัน handle_connection และส่ง stream เข้าไปแทน
ภายในฟังก์ชัน handle_connection เราสร้างอินสแตนซ์ใหม่ของ BufReader ที่ครอบการอ้างอิง (reference) ไปยัง stream เอาไว้ ซึ่ง BufReader จะช่วยเพิ่มความสามารถในการบัฟเฟอร์ข้อมูล (buffering) โดยจัดการการเรียกใช้เมธอดต่าง ๆ จากเทรต std::io::Read ให้เราโดยอัตโนมัติ
เราสร้างตัวแปรชื่อ http_request เพื่อรวบรวมแต่ละบรรทัดของคำขอที่เบราว์เซอร์ส่งมายังเซิร์ฟเวอร์ของเรา และระบุว่าต้องการรวบรวมข้อมูลเหล่านี้ไว้ในเวกเตอร์ (vector) ด้วยการใส่คำกำกับชนิดข้อมูล (type annotation) เป็น Vec<_>
BufReader อิมพลีเมนต์เทรต std::io::BufRead ซึ่งมีเมธอด lines ให้ใช้งาน โดยเมธอด lines จะคืนค่าเป็นอิเทอเรเตอร์ของ Result<String, std::io::Error> จากการตัดแบ่งสตรีมข้อมูลทุกครั้งที่พบไบต์ขึ้นบรรทัดใหม่ (newline byte) และเพื่อให้ได้ข้อความ String แต่ละบรรทัด เราจึงใช้ map ร่วมกับ unwrap บนแต่ละค่า Result ทั้งนี้ ค่า Result อาจเป็นข้อผิดพลาดได้หากข้อมูลที่อ่านเข้ามาไม่ใช่ UTF-8 ที่ถูกต้อง หรือหากเกิดปัญหาในการอ่านข้อมูลจากสตรีม ซึ่งเช่นเคยว่า ในโปรแกรมระดับโปรดักชันจริงควรจัดการข้อผิดพลาดเหล่านี้อย่างรอบคอบและปลอดภัยกว่านี้ แต่ในที่นี้เราเลือกหยุดโปรแกรมทันทีหากเกิดข้อผิดพลาดเพื่อความกระชับและเข้าใจง่าย
เบราว์เซอร์จะส่งสัญญาณบ่งบอกจุดสิ้นสุดของคำขอ HTTP ด้วยการส่งอักขระขึ้นบรรทัดใหม่ 2 ตัวติดต่อกัน ดังนั้นเพื่อให้ได้คำขอครบถ้วนหนึ่งรายการจากสตรีม เราจึงอ่านข้อมูลทีละบรรทัดไปเรื่อย ๆ จนกระทั่งพบบรรทัดที่เป็นสตริงว่าง เมื่อรวบรวมบรรทัดทั้งหมดลงในเวกเตอร์เรียบร้อยแล้ว เราก็สั่งพิมพ์ข้อมูลออกมาด้วยรูปแบบการดีบักแบบสวยงาม เพื่อให้เราสามารถตรวจสอบเนื้อหาคำขอที่เว็บเบราว์เซอร์ส่งมายังเซิร์ฟเวอร์ได้อย่างชัดเจน
มาลองทดสอบโค้ดนี้กัน! รันโปรแกรมและเปิดส่งคำขอบนเว็บเบราว์เซอร์อีกครั้ง สังเกตว่าบนหน้าเบราว์เซอร์จะยังคงแสดงข้อผิดพลาดเหมือนเดิม แต่ข้อความเอาต์พุตของโปรแกรมในเทอร์มินัลจะมีหน้าตาดังต่อไปนี้:
$ cargo run
Compiling hello v0.1.0 (file:///projects/hello)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.42s
Running `target/debug/hello`
Request: [
"GET / HTTP/1.1",
"Host: 127.0.0.1:7878",
"User-Agent: Mozilla/5.0 (Macintosh; Intel Mac OS X 10.15; rv:99.0) Gecko/20100101 Firefox/99.0",
"Accept: text/html,application/xhtml+xml,application/xml;q=0.9,image/avif,image/webp,*/*;q=0.8",
"Accept-Language: en-US,en;q=0.5",
"Accept-Encoding: gzip, deflate, br",
"DNT: 1",
"Connection: keep-alive",
"Upgrade-Insecure-Requests: 1",
"Sec-Fetch-Dest: document",
"Sec-Fetch-Mode: navigate",
"Sec-Fetch-Site: none",
"Sec-Fetch-User: ?1",
"Cache-Control: max-age=0",
]
ข้อความเอาต์พุตของคุณอาจแตกต่างไปจากนี้เล็กน้อยขึ้นอยู่กับเบราว์เซอร์ที่ใช้ แต่เมื่อเราพิมพ์ข้อมูลคำขอออกมา เราจะเข้าใจได้ทันทีว่าทำไมการเรียกหน้าเว็บบนเบราว์เซอร์เพียงครั้งเดียวจึงเกิดการเชื่อมต่อเข้ามาหลายรายการ โดยสังเกตได้จากพาธ (path) ที่ตามหลังคำว่า GET ในบรรทัดแรกของคำขอ หากการเชื่อมต่อที่ซ้ำกันเหล่านั้นล้วนร้องขอ / นั่นแสดงว่าเบราว์เซอร์กำลังพยายามส่งคำขอดึงหน้า / ซ้ำ ๆ เนื่องจากยังไม่ได้รับการตอบกลับจากโปรแกรมของเรานั่นเอง
มาลองแยกชิ้นส่วนของข้อมูลคำขอนี้ เพื่อทำความเข้าใจให้ชัดเจนว่าเบราว์เซอร์กำลังร้องขอสิ่งใดจากโปรแกรมของเรา
การดูคำขอ HTTP อย่างใกล้ชิดยิ่งขึ้น
HTTP เป็นโปรโตคอลแบบข้อความ (text-based protocol) โดยคำขอมีรูปแบบมาตรฐานดังนี้:
Method Request-URI HTTP-Version CRLF
headers CRLF
message-body
บรรทัดแรกเรียกว่า บรรทัดคำขอ (request line) ซึ่งบรรจุข้อมูลเกี่ยวกับสิ่งที่ไคลเอนต์กำลังร้องขอ ส่วนแรกของบรรทัดคำขอจะระบุเมธอด (method) ที่ใช้ เช่น GET หรือ POST เพื่ออธิบายว่าไคลเอนต์ต้องการทำสิ่งใด ไคลเอนต์ของเราส่งคำขอเป็น GET ซึ่งหมายถึงการขอดึงข้อมูล
ส่วนถัดมาของบรรทัดคำขอคือ / ซึ่งระบุ uniform resource identifier (URI) ของทรัพยากรที่ไคลเอนต์กำลังร้องขอ แม้ว่า URI จะมีความหมายคล้ายคลึงกับ uniform resource locator (URL) เกือบทั้งหมดแต่ก็ไม่เหมือนกันเสียทีเดียว อย่างไรก็ตาม ความแตกต่างระหว่าง URI กับ URL ไม่ได้ส่งผลต่อเนื้อหาในบทนี้ แต่เนื่องจากข้อกำหนดมาตรฐานของ HTTP เลือกใช้คำว่า URI คุณจึงสามารถนึกภาพเปรียบเทียบคำว่า URI ตรงนี้เป็น URL ในใจได้เลย
ส่วนสุดท้ายคือเวอร์ชันของ HTTP ที่ไคลเอนต์ใช้ จากนั้นบรรทัดคำขอจะลงท้ายด้วยลำดับ CRLF (คำว่า CRLF ย่อมาจาก carriage return และ line feed ซึ่งเป็นคำที่สืบทอดมาจากยุคของเครื่องพิมพ์ดีด!) ลำดับ CRLF สามารถเขียนแทนได้ด้วย \r\n โดยที่ \r คือ carriage return และ \n คือ line feed ทั้งนี้ ลำดับ CRLF มีหน้าที่คั่นแบ่งบรรทัดคำขอออกจากข้อมูลส่วนที่เหลือของคำขอ และโปรดสังเกตว่าเมื่อพิมพ์ CRLF ออกมาทางหน้าจอ เราจะเห็นเป็นการขึ้นบรรทัดใหม่ ไม่ใช่ตัวอักษร \r\n
เมื่อพิจารณาข้อมูลบรรทัดคำขอที่เราได้รับจากการรันโปรแกรมจนถึงตอนนี้ จะเห็นว่า GET คือเมธอด, / คือ URI ของคำขอ และ HTTP/1.1 คือเวอร์ชัน
ถัดจากบรรทัดคำขอ บรรทัดที่เหลือทั้งหมดตั้งแต่ Host: เป็นต้นไปคือส่วนหัวของคำขอ หรือเฮดเดอร์ (headers) โดยคำขอแบบ GET จะไม่มีส่วนของเนื้อหา หรือบอดี้ (body)
ลองเปิดส่งคำขอจากเบราว์เซอร์ตัวอื่น หรือลองเรียกแอดเดรสอื่นดู เช่น 127.0.0.1:7878/test เพื่อสังเกตดูว่าข้อมูลของคำขอเปลี่ยนแปลงไปอย่างไรบ้าง
เมื่อเราเข้าใจแล้วว่าเบราว์เซอร์ส่งคำขออะไรมา คราวนี้มาเขียนโค้ดเพื่อส่งข้อมูลกลับไปกัน!
การเขียนการตอบกลับ
เราจะลงมือเขียนส่วนการส่งข้อมูลกลับไปเพื่อตอบรับคำขอจากไคลเอนต์ โดยโครงสร้างของการตอบกลับ (response) มีรูปแบบมาตรฐานดังนี้:
HTTP-Version Status-Code Reason-Phrase CRLF
headers CRLF
message-body
บรรทัดแรกเรียกว่า บรรทัดสถานะ (status line) ซึ่งประกอบด้วยเวอร์ชัน HTTP ที่ใช้ตอบกลับ, รหัสสถานะ (status code) แบบตัวเลขที่สรุปผลลัพธ์ของคำขอ และข้อความบอกเหตุผล (reason phrase) ที่อธิบายความหมายของรหัสสถานะนั้นเป็นข้อความ ถัดจากลำดับ CRLF จะเป็นส่วนของเฮดเดอร์ (headers) ตามด้วยลำดับ CRLF อีกชุดหนึ่ง แล้วจึงเป็นส่วนเนื้อหาของการตอบกลับ หรือบอดี้ (message-body)
ตัวอย่างด้านล่างคือข้อความตอบกลับที่ใช้ HTTP เวอร์ชัน 1.1 มีรหัสสถานะ 200 พร้อมข้อความเหตุผล OK โดยไม่มีทั้งเฮดเดอร์และบอดี้:
HTTP/1.1 200 OK\r\n\r\n
รหัสสถานะ 200 คือรหัสมาตรฐานที่บ่งบอกว่าการทำงานสำเร็จ ข้อความนี้จึงถือเป็นการตอบกลับ HTTP ที่สำเร็จในขนาดเล็กที่สุดเท่าที่จะทำได้ มาลองเขียนข้อความนี้ลงในสตรีมเพื่อตอบรับคำขอที่สำเร็จกัน! ในฟังก์ชัน handle_connection ให้ลบคำสั่ง println! ที่ใช้พิมพ์ข้อมูลคำขอออก แล้วแทนที่ด้วยโค้ดในลิสติ้ง 21-3
use std::{
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let http_request: Vec<_> = buf_reader
.lines()
.map(|result| result.unwrap())
.take_while(|line| !line.is_empty())
.collect();
let response = "HTTP/1.1 200 OK\r\n\r\n";
stream.write_all(response.as_bytes()).unwrap();
}บรรทัดแรกที่เพิ่มเข้ามาจะนิยามตัวแปร response ขึ้นมาเก็บข้อความแจ้งความสำเร็จ จากนั้นเราเรียกใช้ as_bytes บนตัวแปร response เพื่อแปลงข้อมูลสตริงให้เป็นชุดของไบต์ เมธอด write_all บน stream จะรับค่าเป็น &[u8] แล้วส่งไบต์เหล่านั้นผ่านการเชื่อมต่อไปยังไคลเอนต์โดยตรง และเนื่องจากการทำงานของ write_all มีโอกาสล้มเหลวได้ เราจึงใช้ unwrap กับผลลัพธ์ที่อาจเป็นข้อผิดพลาดเช่นเดิม ซึ่งในแอปพลิเคชันจริง คุณควรใส่การจัดการข้อผิดพลาดที่เหมาะสม ณ จุดนี้
หลังจากแก้ไขโค้ดเรียบร้อยแล้ว มารันโปรแกรมและส่งคำขอบนเบราว์เซอร์กัน ตอนนี้เราไม่ได้พิมพ์ข้อมูลใด ๆ ออกทางเทอร์มินัลแล้ว เราจึงไม่เห็นเอาต์พุตอื่นนอกจากข้อความของ Cargo และเมื่อคุณเปิดหน้า 127.0.0.1:7878 บนเบราว์เซอร์ คุณจะเห็นเป็นหน้าเว็บว่างเปล่าสีขาวแทนที่จะแสดงข้อผิดพลาด ยินดีด้วย! คุณเพิ่งเขียนโค้ดรับคำขอ HTTP และส่งการตอบกลับด้วยตัวเองเสร็จเรียบร้อยแล้ว!
การคืนค่า HTML ของจริง
คราวนี้มาเพิ่มความสามารถให้เซิร์ฟเวอร์ส่งเนื้อหากลับไปมากกว่าแค่หน้าเว็บว่างเปล่ากัน ให้สร้างไฟล์ใหม่ชื่อ hello.html ไว้ที่รูทของไดเรกทอรีโปรเจกต์ (root directory ไม่ใช่ในโฟลเดอร์ src) คุณจะใส่เนื้อหา HTML ใด ๆ ตามที่ต้องการก็ได้ โดยลิสติ้ง 21-4 แสดงตัวอย่างโค้ด HTML รูปแบบหนึ่ง
<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="utf-8">
<title>Hello!</title>
</head>
<body>
<h1>Hello!</h1>
<p>Hi from Rust</p>
</body>
</html>
นี่คือเอกสาร HTML5 ขนาดกะทัดรัดที่มีหัวข้อและข้อความสั้น ๆ เพื่อให้เซิร์ฟเวอร์ส่งเนื้อหานี้กลับไปเมื่อได้รับคำขอ เราจะแก้ไขฟังก์ชัน handle_connection ดังที่แสดงในลิสติ้ง 21-5 เพื่ออ่านไฟล์ HTML แล้วนำเนื้อหามาต่อท้ายการตอบกลับในฐานะบอดี้ก่อนจะส่งออกไป
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
// --snip--
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let http_request: Vec<_> = buf_reader
.lines()
.map(|result| result.unwrap())
.take_while(|line| !line.is_empty())
.collect();
let status_line = "HTTP/1.1 200 OK";
let contents = fs::read_to_string("hello.html").unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}เราได้เพิ่ม fs เข้าไปในสเตตเมนต์ use เพื่อนำมอดูลจัดการระบบไฟล์ของไลบรารีมาตรฐานเข้ามาใช้งาน โค้ดส่วนที่อ่านเนื้อหาของไฟล์ออกมาเป็นสตริงน่าจะคุ้นตากันดี เพราะเราเคยใช้รูปแบบนี้มาแล้วตอนอ่านไฟล์ในโปรเจกต์ I/O ในลิสติ้ง 12-4
ถัดมา เราใช้ format! เพื่อนำเนื้อหาของไฟล์มาใส่เป็นบอดี้ของการตอบกลับ และเพื่อให้การตอบกลับ HTTP ถูกต้องตามมาตรฐาน เราจึงได้เพิ่มเฮดเดอร์ Content-Length โดยกำหนดค่าเป็นขนาดของเนื้อหาบอดี้ ซึ่งในกรณีนี้ก็คือความยาวของเนื้อหาในไฟล์ hello.html
รันโค้ดนี้ด้วยคำสั่ง cargo run แล้วเปิดหน้า 127.0.0.1:7878 บนเบราว์เซอร์ คุณจะเห็นหน้าเว็บ HTML ของคุณถูกเรนเดอร์ขึ้นมาอย่างสวยงาม!
ในตอนนี้ เรายังไม่ได้นำข้อมูลคำขอในตัวแปร http_request มาพิจารณาเลย แต่เลือกส่งเนื้อหาของไฟล์ HTML กลับไปทันทีโดยไม่มีเงื่อนไขใด ๆ นั่นหมายความว่าหากคุณลองเรียก 127.0.0.1:7878/something-else บนเบราว์เซอร์ คุณก็จะยังได้รับหน้า HTML เดิมนี้กลับมาอยู่ดี ในขณะนี้ เซิร์ฟเวอร์ของเราจึงยังมีข้อจำกัดอย่างมากและยังทำงานได้ไม่เหมือนเว็บเซิร์ฟเวอร์ทั่วไป สิ่งที่เราต้องการคือการปรับแต่งการตอบกลับให้สอดคล้องกับคำขอ โดยส่งไฟล์ HTML กลับไปเฉพาะคำขอที่ถูกต้องและเรียกมายังพาธ / เท่านั้น
การตรวจสอบความถูกต้องของคำขอและการตอบกลับอย่างเลือกสรร
ในปัจจุบัน เว็บเซิร์ฟเวอร์ของเราจะส่งไฟล์ HTML กลับไปเสมอไม่ว่าไคลเอนต์จะร้องขอพาธใดก็ตาม มาเพิ่มฟังก์ชันการทำงานเพื่อตรวจสอบว่าเบราว์เซอร์ร้องขอพาธ / หรือไม่ ก่อนจะส่งไฟล์ HTML กลับไป และหากร้องขอพาธอื่นก็ให้ส่งข้อผิดพลาดกลับไปแทน ด้วยเหตุนี้ เราจึงต้องปรับแก้ฟังก์ชัน handle_connection ดังที่แสดงในลิสติ้ง 21-6 โค้ดใหม่นี้จะตรวจเช็กเนื้อหาของคำขอที่ได้รับเทียบกับรูปแบบคำขอที่เรียกมายัง / พร้อมทั้งเพิ่มบล็อก if และ else เพื่อจัดการแต่ละกรณีให้แตกต่างกัน
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
// --snip--
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
if request_line == "GET / HTTP/1.1" {
let status_line = "HTTP/1.1 200 OK";
let contents = fs::read_to_string("hello.html").unwrap();
let length = contents.len();
let response = format!(
"{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}"
);
stream.write_all(response.as_bytes()).unwrap();
} else {
// some other request
}
}เนื่องจากเราต้องการตรวจสอบเฉพาะบรรทัดแรกของคำขอ HTTP เท่านั้น ดังนั้นแทนที่จะอ่านคำขอทั้งหมดเก็บลงในเวกเตอร์ เราจึงเปลี่ยนมาเรียกเมธอด next เพื่อดึงรายการแรกจากอิเทอเรเตอร์ โดย unwrap ตัวแรกจะจัดการกับค่า Option และหยุดโปรแกรมหากอิเทอเรเตอร์ไม่มีข้อมูลใด ๆ ส่วน unwrap ตัวที่สองจะจัดการกับ Result ซึ่งให้ผลแบบเดียวกับ unwrap ใน map ที่เราเคยใส่ไว้ในลิสติ้ง 21-2
ถัดมา เราตรวจสอบตัวแปร request_line ว่าตรงกับบรรทัดคำขอของคำขอแบบ GET ที่เรียกไปยังพาธ / หรือไม่ หากตรงกัน บล็อก if จะส่งเนื้อหาของไฟล์ HTML ของเรากลับไป
หาก request_line ไม่ตรง กับคำขอ GET ไปยังพาธ / ก็แสดงว่าเราได้รับคำขอแบบอื่นเข้ามา ซึ่งเราจะเพิ่มโค้ดเข้าไปในบล็อก else ในลำดับถัดไปเพื่อจัดการกับคำขออื่น ๆ ทั้งหมดที่เหลือ
ลองรันโค้ดนี้แล้วเรียกไปยัง 127.0.0.1:7878 คุณจะได้รับหน้า HTML จากไฟล์ hello.html แต่ถ้าคุณส่งคำขออื่น เช่น 127.0.0.1:7878/something-else คุณจะพบกับข้อผิดพลาดในการเชื่อมต่อเหมือนที่เคยเห็นตอนรันโค้ดในลิสติ้ง 21-1 และ 21-2
คราวนี้มาเพิ่มโค้ดในลิสติ้ง 21-7 ลงในบล็อก else เพื่อส่งการตอบกลับที่มีรหัสสถานะ 404 ซึ่งบ่งบอกว่าไม่พบเนื้อหาที่ต้องการ (Not Found) และเราจะส่งหน้าเว็บ HTML กลับไปด้วยเพื่อให้เบราว์เซอร์เรนเดอร์ข้อความแจ้งเตือนแก่ผู้ใช้งาน
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
if request_line == "GET / HTTP/1.1" {
let status_line = "HTTP/1.1 200 OK";
let contents = fs::read_to_string("hello.html").unwrap();
let length = contents.len();
let response = format!(
"{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}"
);
stream.write_all(response.as_bytes()).unwrap();
// --snip--
} else {
let status_line = "HTTP/1.1 404 NOT FOUND";
let contents = fs::read_to_string("404.html").unwrap();
let length = contents.len();
let response = format!(
"{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}"
);
stream.write_all(response.as_bytes()).unwrap();
}
}ในกรณีนี้ การตอบกลับของเราจะมีบรรทัดสถานะที่ประกอบด้วยรหัสสถานะ 404 และข้อความบอกเหตุผล NOT FOUND โดยมีบอดี้เป็นการตอบกลับด้วย HTML จากไฟล์ 404.html คุณจะต้องสร้างไฟล์ 404.html วางไว้ข้าง ๆ hello.html สำหรับแสดงหน้าข้อผิดพลาดนี้ ซึ่งคุณสามารถใส่เนื้อหา HTML ใด ๆ ตามที่ต้องการ หรือนำตัวอย่าง HTML ในลิสติ้ง 21-8 ไปใช้ได้เลย
<!DOCTYPE html>
<html lang="en">
<head>
<meta charset="utf-8">
<title>Hello!</title>
</head>
<body>
<h1>Oops!</h1>
<p>Sorry, I don't know what you're asking for.</p>
</body>
</html>
เมื่อแก้ไขโค้ดเรียบร้อย ให้ลองรันเซิร์ฟเวอร์ใหม่อีกครั้ง การเรียก 127.0.0.1:7878 จะได้เนื้อหาของ hello.html ส่วนคำขออื่น ๆ เช่น 127.0.0.1:7878/foo จะได้หน้า HTML แจ้งข้อผิดพลาดจาก 404.html
การรีแฟกเตอร์
ในตอนนี้ บล็อก if และ else มีการทำงานที่ซ้ำซ้อนกันมาก ทั้งคู่อ่านไฟล์และเขียนเนื้อหาของไฟล์ลงในสตรีม โดยจุดที่ต่างกันมีเพียงบรรทัดสถานะกับชื่อไฟล์เท่านั้น มาปรับโค้ดให้กระชับยิ่งขึ้นโดยแยกส่วนที่ต่างกันออกมาไว้ในนิพจน์ if และ else เพื่อกำหนดค่าของบรรทัดสถานะและชื่อไฟล์ให้กับตัวแปร จากนั้นเราจะสามารถนำตัวแปรเหล่านั้นมาใช้งานร่วมกันในโค้ดส่วนที่อ่านไฟล์และเขียนการตอบกลับได้โดยตรง ลิสติ้ง 21-9 แสดงผลลัพธ์ของโค้ดหลังจากปรับแทนที่บล็อก if และ else เดิม
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
// --snip--
fn handle_connection(mut stream: TcpStream) {
// --snip--
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = if request_line == "GET / HTTP/1.1" {
("HTTP/1.1 200 OK", "hello.html")
} else {
("HTTP/1.1 404 NOT FOUND", "404.html")
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}ตอนนี้บล็อก if และ else จะคืนค่าเฉพาะคู่ข้อมูลของบรรทัดสถานะและชื่อไฟล์ออกมาเป็นทูเพิล (tuple) จากนั้นเราใช้การแยกโครงสร้าง (destructuring) เพื่อนำค่าทั้งสองมากำหนดให้กับตัวแปร status_line และ filename ผ่านแพตเทิร์นในสเตตเมนต์ let ดังที่เราได้ศึกษาไปในบทที่ 19
โค้ดส่วนที่เคยซ้ำซ้อนกันถูกย้ายออกมาอยู่นอกบล็อก if และ else โดยเรียกใช้ตัวแปร status_line และ filename แทน การทำเช่นนี้ช่วยให้เห็นความแตกต่างระหว่างทั้งสองกรณีได้ชัดเจนยิ่งขึ้น และทำให้มีจุดแก้ไขโค้ดเพียงจุดเดียวหากเราต้องการปรับเปลี่ยนการอ่านไฟล์หรือการเขียนการตอบกลับในอนาคต โดยที่พฤติกรรมการทำงานของโค้ดในลิสติ้ง 21-9 ยังคงเหมือนกับในลิสติ้ง 21-7 ทุกประการ
ยอดเยี่ยมมาก! ตอนนี้เราได้เว็บเซิร์ฟเวอร์เรียบง่ายด้วยโค้ด Rust เพียงราว ๆ 40 บรรทัด ซึ่งสามารถตอบกลับคำขอที่ต้องการด้วยหน้าเว็บที่มีเนื้อหา และตอบกลับคำขออื่น ๆ ทั้งหมดด้วยรหัส 404
อย่างไรก็ตาม เซิร์ฟเวอร์ของเราในปัจจุบันทำงานอยู่บนเธรดเดียว จึงให้บริการคำขอได้ทีละรายการเท่านั้น ในหัวข้อถัดไป เรามาดูกันว่าข้อจำกัดนี้จะส่งผลเสียอย่างไรเมื่อเกิดคำขอที่ใช้เวลาประมวลผลนาน และเราจะแก้ไขปัญหานี้อย่างไรเพื่อให้เซิร์ฟเวอร์สามารถรองรับคำขอหลายรายการพร้อมกันได้
จากเซิร์ฟเวอร์แบบเธรดเดียวสู่แบบหลายเธรด
จากเว็บเซิร์ฟเวอร์แบบเธรดเดียวสู่เว็บเซิร์ฟเวอร์แบบหลายเธรด
ในตอนนี้ เซิร์ฟเวอร์จะประมวลผลคำขอทีละรายการตามลำดับ หมายความว่าเซิร์ฟเวอร์จะไม่เริ่มประมวลผลการเชื่อมต่อที่สองจนกว่าการเชื่อมต่อแรกจะเสร็จสิ้น หากเซิร์ฟเวอร์ได้รับคำขอเข้ามาเป็นจำนวนมาก การทำงานตามลำดับเช่นนี้ (serial execution) จะยิ่งด้อยประสิทธิภาพลงเรื่อย ๆ ยิ่งถ้าเซิร์ฟเวอร์ได้รับคำขอที่ต้องใช้เวลาประมวลผลนาน คำขออื่น ๆ ที่ตามมาจะต้องรอคอยจนกว่าคำขอที่ใช้เวลานานนั้นจะเสร็จสิ้น แม้ว่าคำขอใหม่เหล่านั้นจะสามารถประมวลผลได้อย่างรวดเร็วก็ตาม เราจำเป็นต้องแก้ไขปัญหานี้ แต่ก่อนอื่น มาจำลองสถานการณ์จริงเพื่อดูปัญหานี้ให้เห็นภาพชัดเจนกันก่อน
การจำลองคำขอที่ช้า
เราจะมาดูกันว่าคำขอที่ประมวลผลช้าจะส่งผลกระทบต่อคำขออื่น ๆ ที่ส่งมายังเซิร์ฟเวอร์เวอร์ชันปัจจุบันของเราอย่างไร ลิสติ้ง 21-10 เพิ่มการจัดการคำขอที่เรียกมายัง /sleep โดยจำลองการตอบกลับที่ล่าช้าด้วยการสั่งให้เซิร์ฟเวอร์หยุดพักการทำงาน (sleep) เป็นเวลา 5 วินาทีก่อนจะส่งข้อมูลตอบกลับ
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
// --snip--
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
handle_connection(stream);
}
}
fn handle_connection(mut stream: TcpStream) {
// --snip--
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
// --snip--
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}เราเปลี่ยนจากการใช้ if มาเป็น match เนื่องจากตอนนี้เรามี 3 กรณีที่ต้องจัดการ และเราจำเป็นต้องจับคู่กับสไลซ์ (slice) ของ request_line อย่างชัดเจน เพื่อจับคู่แพตเทิร์นเข้ากับค่าสตริงลิเทอรัล (string literal) เพราะ match ไม่ได้ทำการอ้างอิงและดีเรเฟอเรนซ์ให้อัตโนมัติเหมือนกับการทำงานของเมธอดตรวจสอบความเท่ากัน
กิ่ง (arm) แรกทำงานเหมือนกับบล็อก if จากลิสติ้ง 21-9 ส่วนกิ่งที่สองจะจับคู่กับคำขอที่เรียกมายัง /sleep โดยเมื่อได้รับคำขอนี้ เซิร์ฟเวอร์จะหยุดพักการทำงานเป็นเวลา 5 วินาทีก่อนจะเรนเดอร์หน้า HTML แจ้งความสำเร็จ และกิ่งที่สามทำงานเหมือนกับบล็อก else จากลิสติ้ง 21-9
คุณจะเห็นได้ว่าเซิร์ฟเวอร์ของเรายังมีความเรียบง่ายและเป็นแบบดิบมาก ในขณะที่ไลบรารีของจริงจะจัดการการตรวจจับคำขอรูปแบบต่าง ๆ ด้วยวิธีที่กระชับและยืดหยุ่นกว่านี้มาก!
เริ่มรันเซิร์ฟเวอร์ด้วยคำสั่ง cargo run จากนั้นเปิดหน้าต่างเบราว์เซอร์ขึ้นมา 2 หน้าต่าง: หน้าต่างหนึ่งเปิด http://127.0.0.1:7878 และอีกหน้าต่างเปิด http://127.0.0.1:7878/sleep หากคุณเข้า URI / ซ้ำ ๆ หลายครั้งเหมือนก่อนหน้านี้ จะเห็นว่าเซิร์ฟเวอร์ตอบกลับอย่างรวดเร็ว แต่หากคุณเข้า /sleep แล้วรีเฟรชหน้า / ทันที คุณจะพบว่าหน้า / ต้องรอจนกว่าคำสั่ง sleep จะทำงานครบ 5 วินาทีเต็มเสียก่อนจึงจะเริ่มโหลดหน้าเว็บได้
มีหลากหลายเทคนิคที่เราสามารถนำมาใช้เพื่อป้องกันไม่ให้คำขอต่าง ๆ ต้องไปติดค้างอยู่เบื้องหลังคำขอที่ทำงานช้า รวมถึงการใช้ async ดังที่เราได้ศึกษาไปในบทที่ 17 แต่แนวทางที่เราจะเลือกสร้างขึ้นมาในบทนี้คือ พูลเธรด (thread pool)
การปรับปรุงทรูพุตด้วยพูลเธรด
พูลเธรด (thread pool) คือกลุ่มของเธรดที่ถูกสร้างขึ้นเตรียมพร้อมไว้ล่วงหน้าเพื่อรอรับงาน เมื่อโปรแกรมได้รับงานใหม่ โปรแกรมจะมอบหมายงานนั้นให้แก่เธรดตัวใดตัวหนึ่งในพูล และเธรดนั้นจะรับหน้าที่ประมวลผลงานดังกล่าว ส่วนเธรดที่เหลือในพูลก็ยังพร้อมรองรับงานอื่น ๆ ที่อาจทยอยเข้ามาในระหว่างที่เธรดแรกกำลังทำงานอยู่ เมื่อเธรดแรกประมวลผลงานของตนเสร็จสิ้น ก็จะกลับคืนสู่พูลในสถานะว่าง เพื่อรอรับงานใหม่ต่อไป การใช้พูลเธรดจึงช่วยให้คุณประมวลผลการเชื่อมต่อหลายรายการพร้อมกันได้ ซึ่งช่วยเพิ่มขีดความสามารถในการรองรับงาน (throughput) ของเซิร์ฟเวอร์ได้อย่างมาก
เราจะจำกัดจำนวนเธรดในพูลไว้ในปริมาณไม่มากนักเพื่อช่วยป้องกันการโจมตีแบบปฏิเสธการให้บริการ (Denial of Service หรือ DoS) เพราะหากเราปล่อยให้โปรแกรมสร้างเธรดใหม่สำหรับทุกคำขอที่ส่งเข้ามา หากมีผู้ไม่ประสงค์ดีส่งคำขอเข้ามา 10 ล้านครั้งพร้อมกัน ก็อาจสร้างความเสียหายร้ายแรงด้วยการผลาญทรัพยากรทั้งหมดของระบบจนหมดสิ้น และทำให้เซิร์ฟเวอร์หยุดทำงานจนไม่สามารถประมวลผลคำขอใด ๆ ได้อีกเลย
ดังนั้น แทนที่จะสร้างเธรดอย่างไร้ขีดจำกัด เราจะมีเธรดตามจำนวนที่กำหนดคงที่รอคอยอยู่ในพูล คำขอใหม่ที่เข้ามาจะถูกส่งตรงไปยังพูลเพื่อประมวลผล โดยพูลจะคอยดูแลคิวของคำขอที่เข้ามา เธรดแต่ละตัวในพูลจะคอยดึงคำขอออกจากคิวนี้ไปจัดการ แล้ววนกลับมาขอดึงคำขอถัดไปจากคิวเรื่อย ๆ ด้วยสถาปัตยกรรมเช่นนี้ เราจึงสามารถประมวลผลคำขอได้พร้อมกันสูงสุดถึง N คำขอ โดยที่ N คือจำนวนเธรด แม้ว่าหากทุกเธรดกำลังติดพันกับคำขอที่ใช้เวลานาน คำขอใหม่ที่เข้ามาก็ยังอาจต้องรออยู่ในคิวเช่นเดิม แต่วิธีนี้ช่วยเพิ่มขีดความสามารถในการรองรับคำขอที่ใช้เวลานานได้มากขึ้นอย่างมีนัยสำคัญก่อนที่จะถึงจุดคอขวด
เทคนิคนี้เป็นเพียงหนึ่งในหลากหลายวิธีสำหรับการเพิ่มทรูพุตของเว็บเซิร์ฟเวอร์ ทางเลือกอื่น ๆ ที่คุณอาจศึกษาเพิ่มเติมได้แก่ โมเดลแบบ fork/join, โมเดลแบบ single-threaded async I/O และโมเดลแบบ multithreaded async I/O หากคุณสนใจในหัวข้อนี้ คุณสามารถค้นคว้าแนวทางอื่น ๆ เพิ่มเติมและทดลองสร้างขึ้นมาได้จริง เพราะด้วยภาษาที่ทำงานในระดับล่างอย่าง Rust ทางเลือกทั้งหมดเหล่านี้ล้วนสามารถทำได้ทั้งสิ้น
ก่อนที่เราจะลงมือสร้างพูลเธรด มาลองพูดคุยกันก่อนว่าการเรียกใช้งานพูลนี้ควรมีหน้าตาอย่างไร เมื่อคุณกำลังออกแบบโค้ด การเขียนอินเทอร์เฟซในมุมของผู้เรียกใช้งาน (client interface) ไว้ล่วงหน้าจะช่วยชี้นำทิศทางการออกแบบได้เป็นอย่างดี โดยให้เขียน API ของโค้ดตามโครงสร้างที่คุณต้องการเรียกใช้จริงก่อน จากนั้นจึงค่อยลงมือสร้างฟังก์ชันการทำงานจริงตามโครงสร้างนั้น แทนที่จะเขียนฟังก์ชันการทำงานจนเสร็จแล้วค่อยมาออกแบบ API สาธารณะในภายหลัง
คล้ายกับที่เราเคยใช้การพัฒนาที่ขับเคลื่อนด้วยการทดสอบ (test-driven development หรือ TDD) ในโปรเจกต์ของบทที่ 12 ในบทนี้เราจะใช้การพัฒนาที่ขับเคลื่อนด้วยคอมไพเลอร์ (compiler-driven development) กล่าวคือ เราจะเขียนโค้ดเรียกใช้ฟังก์ชันตามที่เราต้องการก่อน แล้วอาศัยข้อความแจ้งเตือนข้อผิดพลาดจากคอมไพเลอร์เป็นตัวนำทางว่าเราต้องแก้ไขจุดใดต่อไปเพื่อให้โปรแกรมทำงานได้ อย่างไรก็ดี ก่อนจะไปถึงจุดนั้น เรามาลองสำรวจเทคนิคที่ ไม่แนะนำ ให้ใช้ เพื่อเป็นจุดเริ่มต้นในการเปรียบเทียบกันก่อน
การสร้างเธรดใหม่สำหรับแต่ละคำขอ
ก่อนอื่น มาดูว่าโค้ดของเราจะมีหน้าตาอย่างไรหากสั่งสร้างเธรดใหม่ขึ้นมาสำหรับทุก ๆ การเชื่อมต่อจริง ๆ อย่างที่ได้กล่าวไปแล้วว่านี่ไม่ใช่แผนสุดท้ายที่เราจะใช้ เนื่องจากอาจเกิดปัญหาจากการสร้างเธรดได้ไม่จำกัด แต่นี่เป็นจุดเริ่มต้นที่ดีในการทำความเข้าใจการทำงานของเว็บเซิร์ฟเวอร์แบบหลายเธรด จากนั้นเมื่อเรานำพูลเธรดเข้ามาปรับปรุง จะช่วยให้เห็นความแตกต่างของทั้งสองวิธีได้อย่างชัดเจน
ลิสติ้ง 21-11 แสดงการเปลี่ยนแปลงที่ต้องทำกับ main เพื่อสร้างเธรดใหม่สำหรับจัดการแต่ละสตรีมภายในลูป for
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
for stream in listener.incoming() {
let stream = stream.unwrap();
thread::spawn(|| {
handle_connection(stream);
});
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}ดังที่คุณได้ศึกษาในบทที่ 16 ฟังก์ชัน thread::spawn จะสร้างเธรดใหม่ขึ้นมาและรันโค้ดในโคลเชอร์ (closure) บนเธรดใหม่นั้น หากคุณรันโค้ดนี้แล้วเปิดหน้า /sleep บนเบราว์เซอร์ จากนั้นเปิดหน้า / ในแท็บอื่น ๆ คุณจะพบว่าคำขอที่เรียกไปยัง / ไม่จำเป็นต้องรอให้หน้า /sleep ทำงานเสร็จอีกต่อไป อย่างไรก็ดี ตามที่เราได้เตือนไว้ วิธีนี้จะทำให้ระบบทำงานหนักเกินพิกัดในที่สุด เพราะเซิร์ฟเวอร์จะสร้างเธรดใหม่ขึ้นมาเรื่อย ๆ อย่างไร้ขีดจำกัด
คุณอาจจำได้จากบทที่ 17 ว่าสถานการณ์เช่นนี้คือจุดที่ async และ await โดดเด่นอย่างแท้จริง! ขอให้จำจุดนี้ไว้ในใจขณะที่เรากำลังสร้างพูลเธรด และลองขบคิดดูว่าหากเปลี่ยนมาใช้ async โค้ดของเราจะมีความเหมือนหรือแตกต่างจากเดิมอย่างไรบ้าง
การสร้างเธรดจำนวนจำกัด
เราต้องการให้พูลเธรดมีรูปแบบการเรียกใช้งานที่คล้ายคลึงและคุ้นเคย เพื่อให้การเปลี่ยนจากการสร้างเธรดโดยตรงมาใช้พูลเธรดแทบไม่ต้องแก้ไขโค้ดส่วนที่เรียกใช้ API เดิมเลย ลิสติ้ง 21-12 แสดงอินเทอร์เฟซในอุดมคติของ struct ThreadPool ที่เราต้องการนำมาใช้แทน thread::spawn
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
let pool = ThreadPool::new(4);
for stream in listener.incoming() {
let stream = stream.unwrap();
pool.execute(|| {
handle_connection(stream);
});
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}เราใช้ ThreadPool::new เพื่อสร้างพูลเธรดใหม่ที่มีจำนวนเธรดตามที่กำหนด ซึ่งในที่นี้คือ 4 เธรด จากนั้นในลูป for เมธอด pool.execute จะมีรูปแบบอินเทอร์เฟซคล้ายกับ thread::spawn โดยรับโคลเชอร์ที่พูลควรรันสำหรับแต่ละสตรีม เราจำเป็นต้องสร้างเมธอด pool.execute ให้สามารถรับโคลเชอร์แล้วส่งมอบให้แก่เธรดว่างในพูลเพื่อนำไปรัน แน่นอนว่าโค้ดนี้ยังคอมไพล์ไม่ผ่าน แต่เราจะลองคอมไพล์ดูเพื่อให้ข้อความจากคอมไพเลอร์ช่วยนำทางเราในการแก้ไขต่อไป
การสร้าง ThreadPool ด้วยการพัฒนาแบบขับเคลื่อนด้วยคอมไพเลอร์
ให้แก้ไขโค้ดใน src/main.rs ตามลิสติ้ง 21-12 จากนั้นเราจะใช้ข้อความแจ้งเตือนข้อผิดพลาดจากคำสั่ง cargo check ในการขับเคลื่อนการพัฒนาต่อไป นี่คือข้อผิดพลาดแรกที่ปรากฏขึ้น:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0433]: cannot find type `ThreadPool` in this scope
--> src/main.rs:11:16
|
11 | let pool = ThreadPool::new(4);
| ^^^^^^^^^^ use of undeclared type `ThreadPool`
For more information about this error, try `rustc --explain E0433`.
error: could not compile `hello` (bin "hello") due to 1 previous error
ยอดเยี่ยม! ข้อผิดพลาดนี้บอกให้เรารู้ว่าโปรแกรมยังขาดชนิดข้อมูลหรือมอดูล (module) ThreadPool เราจึงจะสร้างมันขึ้นมาในตอนนี้ และเนื่องจากโครงสร้างการทำงานของ ThreadPool ควรเป็นอิสระจากลักษณะงานเฉพาะของเว็บเซิร์ฟเวอร์ เราจึงจะปรับเปลี่ยนโครงสร้างของเครต (crate) hello จากเดิมที่เป็นเครตไบนารี (binary crate) ให้กลายเป็นเครตไลบรารี (library crate) เพื่อใช้เก็บโค้ดการทำงานของ ThreadPool โดยเฉพาะ ซึ่งการแยกเป็นเครตไลบรารีเช่นนี้จะทำให้เราสามารถนำไลบรารีพูลเธรดนี้ไปประยุกต์ใช้กับงานอื่น ๆ ที่ต้องการใช้พูลเธรดได้ด้วย ไม่จำกัดเพียงแค่งานให้บริการคำขอเว็บเท่านั้น
สร้างไฟล์ src/lib.rs โดยใส่โค้ดต่อไปนี้ ซึ่งเป็นนิยามที่เรียบง่ายที่สุดของ struct ThreadPool ที่เราสามารถเขียนได้ในตอนนี้:
pub struct ThreadPool;จากนั้น แก้ไขไฟล์ main.rs เพื่อนำ ThreadPool จากเครตไลบรารีเข้ามาสู่ขอบเขตการทำงาน โดยเพิ่มโค้ดต่อไปนี้ไว้ที่ส่วนบนสุดของ src/main.rs:
use hello::ThreadPool;
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
let pool = ThreadPool::new(4);
for stream in listener.incoming() {
let stream = stream.unwrap();
pool.execute(|| {
handle_connection(stream);
});
}
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}โค้ดนี้ยังคงทำงานไม่ได้ แต่ให้เราลองตรวจสอบด้วย cargo check อีกครั้งเพื่อดูข้อผิดพลาดถัดไปที่เราต้องลงมือจัดการ:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0599]: no associated function or constant named `new` found for struct `ThreadPool` in the current scope
--> src/main.rs:12:28
|
12 | let pool = ThreadPool::new(4);
| ^^^ associated function or constant not found in `ThreadPool`
For more information about this error, try `rustc --explain E0599`.
error: could not compile `hello` (bin "hello") due to 1 previous error
ข้อผิดพลาดนี้ชี้ให้เห็นว่าในขั้นตอนต่อไป เราต้องสร้างฟังก์ชันที่มีความสัมพันธ์กับชนิดข้อมูล (associated function) ชื่อ new ให้กับ ThreadPool และเรารู้ว่า new ต้องรับพารามิเตอร์หนึ่งตัวที่สามารถรับค่าอาร์กิวเมนต์เป็น 4 ได้ และควรคืนค่าอินสแตนซ์ของ ThreadPool ออกมา มาลองสร้างฟังก์ชัน new ในรูปแบบที่เรียบง่ายที่สุดซึ่งมีคุณสมบัติดังกล่าวกัน:
pub struct ThreadPool;
impl ThreadPool {
pub fn new(size: usize) -> ThreadPool {
ThreadPool
}
}เราเลือกใช้ usize เป็นชนิดข้อมูลสำหรับพารามิเตอร์ size เนื่องจากจำนวนเธรดไม่สามารถเป็นค่าติดลบได้ และเรารู้ว่าจะนำค่า 4 นี้ไปใช้เป็นจำนวนสมาชิกในคอลเลกชันของเธรด ซึ่งตรงกับจุดประสงค์การใช้งานของชนิดข้อมูล usize ดังที่ได้กล่าวถึงในหัวข้อ“ชนิดจำนวนเต็ม” ในบทที่ 3
มาตรวจสอบโค้ดอีกครั้ง:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0599]: no method named `execute` found for struct `ThreadPool` in the current scope
--> src/main.rs:17:14
|
17 | pool.execute(|| {
| -----^^^^^^^ method not found in `ThreadPool`
For more information about this error, try `rustc --explain E0599`.
error: could not compile `hello` (bin "hello") due to 1 previous error
ตอนนี้ข้อผิดพลาดเกิดจากการที่เรายังไม่มีเมธอด execute บน ThreadPool หากย้อนนึกถึงหัวข้อ“การสร้างเธรดจำนวนจำกัด” เราได้ตัดสินใจไว้ว่าพูลเธรดของเราควรมีอินเทอร์เฟซที่คล้ายกับ thread::spawn นอกจากนี้ เราจะสร้างฟังก์ชัน execute ให้รับโคลเชอร์เข้ามา แล้วส่งต่อให้เธรดที่ว่างอยู่ในพูลนำไปรัน
เราจะนิยามเมธอด execute บน ThreadPool ให้รับโคลเชอร์เป็นพารามิเตอร์ ย้อนนึกถึงหัวข้อ“การย้ายค่าที่ถูกจับออกจากโคลเชอร์” ในบทที่ 13 เราสามารถรับโคลเชอร์เป็นพารามิเตอร์ผ่านเทรต 3 ตัวที่แตกต่างกัน ได้แก่ Fn, FnMut และ FnOnce เราจึงต้องตัดสินใจว่าจะใช้โคลเชอร์ชนิดใดในจุดนี้ เรารู้ว่าในท้ายที่สุดการทำงานของเราจะคล้ายคลึงกับการทำงานของ thread::spawn ในไลบรารีมาตรฐาน ดังนั้นเราจึงสามารถเข้าไปดูข้อกำหนด (bounds) บนพารามิเตอร์ในซิกเนเจอร์ของ thread::spawn ได้ ซึ่งเอกสารแสดงให้เห็นดังนี้:
pub fn spawn<F, T>(f: F) -> JoinHandle<T>
where
F: FnOnce() -> T,
F: Send + 'static,
T: Send + 'static,พารามิเตอร์ชนิดข้อมูล (type parameter) F คือสิ่งที่เราให้ความสนใจในที่นี้ ส่วนพารามิเตอร์ชนิดข้อมูล T นั้นเกี่ยวข้องกับค่าที่คืนกลับ ซึ่งเราไม่จำเป็นต้องสนใจ เราจะเห็นว่า spawn กำหนดข้อกำหนดเทรต (trait bound) บน F ไว้เป็น FnOnce ซึ่งเป็นสิ่งที่เราต้องการเช่นเดียวกัน เพราะในท้ายที่สุดเราจะส่งอาร์กิวเมนต์ที่ได้รับใน execute ส่งต่อไปให้ spawn และเรายิ่งมั่นใจได้ว่า FnOnce คือเทรตที่ถูกต้อง เนื่องจากเธรดที่ทำหน้าที่ประมวลผลคำขอจะรันโคลเชอร์ของคำขอนั้นเพียงครั้งเดียวเท่านั้น ซึ่งสอดคล้องกับคำว่า Once ใน FnOnce
นอกจากนี้ พารามิเตอร์ชนิดข้อมูล F ยังมีข้อกำหนดเทรต Send และข้อกำหนดช่วงอายุ (lifetime bound) 'static' กำกับอยู่ด้วย ซึ่งจำเป็นอย่างยิ่งในสถานการณ์ของเรา กล่าวคือ เราต้องมี Send เพื่อถ่ายโอนโคลเชอร์ข้ามจากเธรดหนึ่งไปยังอีกเธรดหนึ่งได้ และต้องมี 'static เนื่องจากเราไม่อาจทราบได้ล่วงหน้าว่าเธรดจะใช้เวลาในการรันนานเท่าใด มาสร้างเมธอด execute บน ThreadPool ที่รับพารามิเตอร์เจเนอริกชนิด F พร้อมข้อกำหนดเหล่านี้กัน:
pub struct ThreadPool;
impl ThreadPool {
// --snip--
pub fn new(size: usize) -> ThreadPool {
ThreadPool
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}เรายังคงใส่วงเล็บ () ไว้หลัง FnOnce เพราะในที่นี้แทนโคลเชอร์ที่ไม่รับพารามิเตอร์ใด ๆ และคืนค่าเป็นชนิดยูนิต () เช่นเดียวกับนิยามฟังก์ชันทั่วไป ชนิดข้อมูลของค่าที่คืนกลับสามารถละเว้นได้ในซิกเนเจอร์ แต่ถึงแม้จะไม่มีพารามิเตอร์ เราก็ยังคงต้องใส่วงเล็บไว้เสมอ
เช่นเคย นี่คือการเขียนเมธอด execute ในรูปแบบที่เรียบง่ายที่สุด โดยยังไม่ทำสิ่งใดเลยเพราะเป้าหมายของเราตอนนี้คือการทำให้โค้ดคอมไพล์ผ่านก่อน มาตรวจสอบโค้ดอีกครั้ง:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.24s
คอมไพล์ผ่านแล้ว! แต่สังเกตว่าหากคุณลองสั่ง cargo run แล้วส่งคำขอผ่านเบราว์เซอร์ คุณจะยังคงเห็นข้อผิดพลาดบนเบราว์เซอร์เหมือนกับที่เราพบในตอนต้นบท เพราะไลบรารีของเรายังไม่ได้สั่งรันโคลเชอร์ที่ส่งเข้ามายัง execute จริง ๆ เลย!
หมายเหตุ: คุณอาจเคยได้ยินคำกล่าวเกี่ยวกับภาษาที่มีคอมไพเลอร์เข้มงวดอย่าง Haskell และ Rust ว่า “ถ้าโค้ดคอมไพล์ผ่าน แสดงว่าโค้ดทำงานได้ถูกต้อง” แต่นั่นไม่ได้เป็นจริงเสมอไป ในตอนนี้โปรเจกต์ของเราคอมไพล์ผ่านได้อย่างราบรื่น แต่มันยังไม่ได้ทำสิ่งใดเลย! หากนี่เป็นการพัฒนาโปรเจกต์จริงที่สมบูรณ์ นี่คือ จังหวะที่เหมาะสมอย่างยิ่งในการเริ่มเขียนแบบทดสอบระดับยูนิต (unit test) เพื่อ ยืนยันว่าโค้ดคอมไพล์ผ่าน และ ทำงานได้ถูกต้องตามที่เราคาดหวังจริง ๆ
ลองขบคิดดู: หากในจุดนี้เราต้องการรันฟิวเจอร์ (future) แทนที่จะเป็นโคลเชอร์ โค้ดจะมีความแตกต่างไปอย่างไรบ้าง?
การตรวจสอบความถูกต้องของจำนวนเธรดใน new
เรายังไม่ได้ทำอะไรกับพารามิเตอร์ของ new และ execute เลย มาเริ่มเขียนเนื้อหาภายในฟังก์ชันเหล่านี้ให้มีพฤติกรรมการทำงานตามที่เราต้องการกัน เริ่มจากฟังก์ชัน new ก่อนหน้านี้เราเลือกชนิดข้อมูลแบบไม่มีเครื่องหมายให้กับพารามิเตอร์ size เพราะพูลที่มีจำนวนเธรดติดลบนั้นเป็นไปไม่ได้ในทางปฏิบัติ อย่างไรก็ดี พูลที่มีจำนวนเธรดเป็นศูนย์ก็ไม่สมเหตุสมผลเช่นกัน แม้ว่าศูนย์จะเป็นค่าที่ถูกต้องตามชนิดข้อมูล usize ก็ตาม ดังนั้นเราจะเพิ่มโค้ดตรวจสอบว่า size มีค่ามากกว่าศูนย์ก่อนจะคืนค่าอินสแตนซ์ของ ThreadPool ออกไป และกำหนดให้โปรแกรมแพนิก (panic) ทันทีหากได้รับค่าเป็นศูนย์ โดยใช้มาโคร assert! ดังแสดงในลิสติ้ง 21-13
pub struct ThreadPool;
impl ThreadPool {
/// Create a new ThreadPool.
///
/// The size is the number of threads in the pool.
///
/// # Panics
///
/// The `new` function will panic if the size is zero.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
ThreadPool
}
// --snip--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}เรายังได้เพิ่มเอกสารประกอบให้กับ ThreadPool ผ่านทางคอมเมนต์เอกสาร (doc comment) สังเกตว่าเราได้ปฏิบัติตามแนวทางที่ดีในการเขียนเอกสารประกอบ โดยเพิ่มหัวข้อย่อยระบุเงื่อนไขที่ฟังก์ชันของเราอาจเกิดการแพนิกได้ ดังที่เราได้เรียนรู้ในบทที่ 14 ลองรันคำสั่ง cargo doc --open แล้วคลิกดูที่ struct ThreadPool เพื่อดูเอกสารที่สร้างขึ้นสำหรับฟังก์ชัน new กันได้เลย!
แทนที่จะใช้มาโคร assert! เช่นนี้ เราอาจเปลี่ยนฟังก์ชัน new ไปเป็น build แล้วคืนค่าเป็น Result เหมือนที่เราเคยทำกับ Config::build ในโปรเจกต์ I/O ในลิสติ้ง 12-9 ได้ แต่ในกรณีนี้เราตัดสินใจว่าการพยายามสร้างพูลเธรดที่ไม่มีเธรดอยู่เลยถือเป็นข้อผิดพลาดที่ไม่สามารถกู้คืนได้ (unrecoverable error) หากคุณต้องการความท้าทายเพิ่มเติม ลองเขียนฟังก์ชันชื่อ build ที่มีซิกเนเจอร์ดังต่อไปนี้เพื่อเปรียบเทียบกับฟังก์ชัน new ดูได้:
pub fn build(size: usize) -> Result<ThreadPool, PoolCreationError> {การสร้างพื้นที่สำหรับจัดเก็บเธรด
เมื่อเรามีวิธีตรวจสอบแล้วว่าจำนวนเธรดที่กำหนดให้จัดเก็บในพูลมีความถูกต้อง เราก็สามารถสร้างเธรดเหล่านั้นขึ้นมาและจัดเก็บไว้ใน struct ThreadPool ก่อนจะคืนค่า struct ออกไปได้ แต่คำถามคือเราจะ “จัดเก็บ” เธรดไว้ได้อย่างไร? มาดูซิกเนเจอร์ของ thread::spawn กันอีกครั้ง:
pub fn spawn<F, T>(f: F) -> JoinHandle<T>
where
F: FnOnce() -> T,
F: Send + 'static,
T: Send + 'static,ฟังก์ชัน spawn จะคืนค่าเป็น JoinHandle<T> โดยที่ T คือชนิดข้อมูลที่โคลเชอร์คืนกลับออกมา มาลองใช้ JoinHandle ดูว่าจะเกิดอะไรขึ้น ในกรณีของเรา โคลเชอร์ที่เราส่งให้พูลเธรดมีหน้าที่จัดการการเชื่อมต่อและไม่ได้คืนค่าใด ๆ กลับมา ดังนั้น T จึงเป็นชนิดยูนิต ()
โค้ดในลิสติ้ง 21-14 จะคอมไพล์ผ่าน แต่ยังไม่ได้สร้างเธรดใด ๆ ขึ้นมาจริง เราได้ปรับนิยามของ ThreadPool ให้เก็บเวกเตอร์ของอินสแตนซ์ thread::JoinHandle<()> และสร้างเวกเตอร์เริ่มต้นที่มีขนาดความจุเท่ากับ size พร้อมทั้งเขียนลูป for สำหรับรันโค้ดสร้างเธรด จากนั้นจึงคืนค่าอินสแตนซ์ของ ThreadPool ที่บรรจุเธรดเหล่านั้นออกมา
use std::thread;
pub struct ThreadPool {
threads: Vec<thread::JoinHandle<()>>,
}
impl ThreadPool {
// --snip--
/// Create a new ThreadPool.
///
/// The size is the number of threads in the pool.
///
/// # Panics
///
/// The `new` function will panic if the size is zero.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let mut threads = Vec::with_capacity(size);
for _ in 0..size {
// create some threads and store them in the vector
}
ThreadPool { threads }
}
// --snip--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}เรานำ std::thread เข้ามาสู่ขอบเขตการทำงานในเครตไลบรารี เนื่องจากเราใช้ thread::JoinHandle เป็นชนิดข้อมูลของสมาชิกในเวกเตอร์ของ ThreadPool
เมื่อได้ค่าขนาดที่ถูกต้อง ThreadPool จะสร้างเวกเตอร์ใหม่ที่สามารถรองรับสมาชิกได้ size ตัว ฟังก์ชัน Vec::with_capacity ทำงานคล้ายกับ Vec::new แต่มีข้อแตกต่างที่สำคัญคือ มีการจัดสรรหน่วยความจำล่วงหน้าสำหรับเวกเตอร์ และเนื่องจากเรารู้จำนวนสมาชิก size ตัวที่แน่นอนที่จะจัดเก็บ การจัดสรรล่วงหน้าเช่นนี้จึงมีประสิทธิภาพสูงกว่าการใช้ Vec::new เล็กน้อย ซึ่งจะต้องคอยขยายขนาดหน่วยความจำทุกครั้งที่มีการแทรกสมาชิกใหม่
เมื่อคุณรันคำสั่ง cargo check อีกครั้ง การตรวจสอบควรผ่านฉลุย
การส่งโค้ดจาก ThreadPool ไปยังเธรด
เราได้ใส่คอมเมนต์ทิ้งไว้ในลูป for ของลิสติ้ง 21-14 เกี่ยวกับการสร้างเธรด ตรงนี้เราจะมาดูกันว่าเราจะสร้างเธรดขึ้นมาจริง ๆ ได้อย่างไร ไลบรารีมาตรฐานมี thread::spawn สำหรับสร้างเธรด ซึ่งฟังก์ชันนี้คาดหวังว่าจะได้รับโค้ดที่เธรดต้องรันทันทีที่ถูกสร้างขึ้น ทว่าในกรณีของเรา เราต้องการสร้างเธรดเตรียมไว้ล่วงหน้าแล้วให้พวกมัน รอรับ โค้ดที่เราจะส่งไปให้ในภายหลัง ซึ่งโครงสร้างเธรดของไลบรารีมาตรฐานไม่ได้มีกลไกนี้มาให้ในตัว เราจึงจำเป็นต้องสร้างกลไกนี้ขึ้นมาเอง
เราจะสร้างโครงสร้างข้อมูลใหม่คั่นกลางระหว่าง ThreadPool กับเธรด เพื่อทำหน้าที่จัดการพฤติกรรมดังกล่าว โดยเราจะตั้งชื่อโครงสร้างข้อมูลนี้ว่า Worker ซึ่งเป็นคำศัพท์มาตรฐานที่ใช้กันทั่วไปในการสร้างระบบพูล โครงสร้าง Worker จะมีหน้าที่รับโค้ดที่ต้องทำงานแล้วนำไปรันบนเธรดของมันเอง
ลองนึกภาพพนักงานในครัวของร้านอาหาร: พนักงาน (worker) จะคอยรอจนกว่าจะมีรายการสั่งอาหารเข้ามาจากลูกค้า จากนั้นจึงรับรายการอาหารนั้นไปปรุงให้เสร็จสิ้น
แทนที่จะจัดเก็บเวกเตอร์ของ JoinHandle<()> ในพูลเธรด เราจะเปลี่ยนมาจัดเก็บอินสแตนซ์ของ struct Worker แทน โดย Worker แต่ละตัวจะเก็บอินสแตนซ์ JoinHandle<()> ไว้หนึ่งตัว จากนั้นเราจะสร้างเมธอดบน Worker ที่รับโคลเชอร์ของโค้ดที่ต้องรัน แล้วส่งต่อไปยังเธรดที่กำลังทำงานอยู่เพื่อเริ่มประมวลผล นอกจากนี้เรายังจะกำหนดค่า id ให้กับ Worker แต่ละตัว เพื่อให้สามารถแยกแยะอินสแตนซ์ของ Worker แต่ละตัวในพูลได้อย่างชัดเจนเวลาพิมพ์ล็อกหรือดีบัก
นี่คือขั้นตอนการทำงานใหม่ที่จะเกิดขึ้นเมื่อเราสร้าง ThreadPool โดยเราจะเขียนโค้ดสำหรับส่งโคลเชอร์ไปยังเธรดหลังจากที่เราตั้งค่าโครงสร้าง Worker เสร็จเรียบร้อย:
- นิยาม struct
Workerที่เก็บidและJoinHandle<()> - ปรับเปลี่ยน
ThreadPoolให้เก็บเวกเตอร์ของอินสแตนซ์Worker - นิยามฟังก์ชัน
Worker::newที่รับค่าหมายเลขidและคืนค่าอินสแตนซ์Workerที่เก็บidและเธรดที่สร้างขึ้นด้วยโคลเชอร์ว่างเปล่า - ใน
ThreadPool::newให้นำตัวนับของลูปforมากำหนดเป็นidสร้างWorkerใหม่ด้วยidนั้น แล้วจัดเก็บWorkerลงในเวกเตอร์
หากคุณพร้อมสำหรับความท้าทาย ลองลงมือแก้ไขโค้ดตามขั้นตอนเหล่านี้ด้วยตัวเองก่อนจะดูเฉลยในลิสติ้ง 21-15
พร้อมหรือยัง? ด้านล่างนี้คือลิสติ้ง 21-15 ซึ่งแสดงตัวอย่างการปรับปรุงโค้ดตามแนวทางข้างต้น
use std::thread;
pub struct ThreadPool {
workers: Vec<Worker>,
}
impl ThreadPool {
// --snip--
/// Create a new ThreadPool.
///
/// The size is the number of threads in the pool.
///
/// # Panics
///
/// The `new` function will panic if the size is zero.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id));
}
ThreadPool { workers }
}
// --snip--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize) -> Worker {
let thread = thread::spawn(|| {});
Worker { id, thread }
}
}เราได้เปลี่ยนชื่อฟิลด์ใน ThreadPool จาก threads เป็น workers เพราะตอนนี้มันเก็บอินสแตนซ์ของ Worker แทนที่จะเป็น JoinHandle<()> โดยตรง เราส่งตัวนับในลูป for ไปเป็นอาร์กิวเมนต์ของ Worker::new และจัดเก็บแต่ละ Worker ที่สร้างขึ้นใหม่ลงในเวกเตอร์ workers
โค้ดส่วนอื่นภายนอก (เช่น เซิร์ฟเวอร์ใน src/main.rs) ไม่จำเป็นต้องรับรู้รายละเอียดเชิงลึกว่าภายใน ThreadPool มีการใช้ struct Worker อย่างไร เราจึงกำหนดให้ struct Worker และฟังก์ชัน new ของมันเป็นแบบส่วนตัว (private) ฟังก์ชัน Worker::new จะนำ id ที่ส่งเข้ามาไปจัดเก็บคู่กับอินสแตนซ์ JoinHandle<()> ที่ได้จากการสร้างเธรดใหม่ด้วยโคลเชอร์ว่างเปล่า
หมายเหตุ: หากระบบปฏิบัติการไม่สามารถสร้างเธรดได้เนื่องจากทรัพยากรระบบไม่ เพียงพอ ฟังก์ชัน
thread::spawnจะเกิดการแพนิก ซึ่งส่งผลให้เซิร์ฟเวอร์ ทั้งหมดแพนิกและหยุดทำงานไปด้วย แม้ว่าเธรดก่อนหน้านั้นบางตัวจะสร้างสำเร็จแล้ว ก็ตาม สำหรับการเรียนรู้นี้ พฤติกรรมดังกล่าวถือว่าเพียงพอแล้ว แต่ในการสร้าง พูลเธรดระดับโปรดักชันจริง คุณควรใช้std::thread::Builderร่วมกับเมธอดspawnที่คืนค่าเป็นResultแทน
โค้ดชุดนี้จะคอมไพล์ผ่านและจัดเก็บอินสแตนซ์ Worker ตามจำนวนที่เราระบุเป็นอาร์กิวเมนต์ใน ThreadPool::new ได้เรียบร้อย แต่เรา ยังไม่ได้ นำโคลเชอร์ที่ส่งเข้ามาใน execute ไปประมวลผลจริง ในหัวข้อถัดไปเรามาดูวิธีทำสิ่งนั้นกัน
การส่งคำขอไปยังเธรดผ่านแชนเนล
ปัญหาถัดไปที่เราต้องจัดการคือ โคลเชอร์ที่ส่งให้กับ thread::spawn ยังไม่ได้ทำสิ่งใดเลย ในปัจจุบัน เราได้รับโคลเชอร์ที่ต้องการรันเข้ามาทางเมธอด execute แต่เราจำเป็นต้องส่งโคลเชอร์ให้ thread::spawn ไปตั้งแต่ตอนสร้าง Worker แต่ละตัวระหว่างการเริ่มต้น ThreadPool
สิ่งที่เราต้องการคือ ให้ struct Worker ที่เพิ่งสร้างขึ้นไปคอยดึงโค้ดที่ต้องรันมาจากคิวที่เก็บอยู่ใน ThreadPool แล้วส่งโค้ดดังกล่าวไปยังเธรดของตัวเองเพื่อเริ่มทำงาน
แชนเนล (channel) ที่เราได้เรียนรู้ในบทที่ 16 ซึ่งเป็นวิธีที่สะดวกและง่ายดายในการสื่อสารระหว่างเธรด จึงตอบโจทย์การใช้งานนี้ได้อย่างลงตัว เราจะใช้แชนเนลทำหน้าที่เป็นคิวของงาน (job) โดยเมธอด execute จะส่งงานจาก ThreadPool ไปยังอินสแตนซ์ของ Worker ซึ่งจะส่งต่องานนั้นไปยังเธรดของตัวเองอีกทอดหนึ่ง นี่คือแผนการทำงานของเรา:
ThreadPoolจะสร้างแชนเนลขึ้นมาและเก็บฝั่งส่ง (sender) เอาไว้Workerแต่ละตัวจะถือครองฝั่งรับ (receiver) เอาไว้- เราจะสร้าง struct
Jobขึ้นมาใหม่เพื่อบรรจุโคลเชอร์ที่เราต้องการส่งผ่านแชนเนล - เมธอด
executeจะส่งงานที่ต้องการรันผ่านทางฝั่งส่ง - ภายในเธรดของตัวเอง
Workerจะวนลูปคอยรับข้อมูลจากฝั่งรับ แล้วสั่งรันโคลเชอร์ของงานใด ๆ ก็ตามที่ได้รับเข้ามา
มาเริ่มด้วยการสร้างแชนเนลใน ThreadPool::new และเก็บฝั่งส่งไว้ในอินสแตนซ์ของ ThreadPool ดังแสดงในลิสติ้ง 21-16 ในตอนนี้ struct Job ยังไม่ได้เก็บข้อมูลใด ๆ แต่จะกลายมาเป็นชนิดข้อมูลของสมาชิกที่เราส่งผ่านแชนเนลต่อไป
use std::{sync::mpsc, thread};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
struct Job;
impl ThreadPool {
// --snip--
/// Create a new ThreadPool.
///
/// The size is the number of threads in the pool.
///
/// # Panics
///
/// The `new` function will panic if the size is zero.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id));
}
ThreadPool { workers, sender }
}
// --snip--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize) -> Worker {
let thread = thread::spawn(|| {});
Worker { id, thread }
}
}ใน ThreadPool::new เราสร้างแชนเนลใหม่ขึ้นมาและให้พูลเก็บฝั่งส่งไว้ โค้ดชุดนี้จะคอมไพล์ผ่านอย่างราบรื่น
คราวนี้มาลองส่งฝั่งรับของแชนเนลเข้าไปให้ Worker แต่ละตัวตอนที่พูลเธรดสร้างแชนเนลกัน เรารู้ว่าต้องการใช้ฝั่งรับภายในเธรดที่สร้างขึ้นใน Worker เราจึงจะอ้างถึงพารามิเตอร์ receiver ในโคลเชอร์ โค้ดในลิสติ้ง 21-17 จะยังคอมไพล์ไม่ผ่าน
use std::{sync::mpsc, thread};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
struct Job;
impl ThreadPool {
// --snip--
/// Create a new ThreadPool.
///
/// The size is the number of threads in the pool.
///
/// # Panics
///
/// The `new` function will panic if the size is zero.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, receiver));
}
ThreadPool { workers, sender }
}
// --snip--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}
// --snip--
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: mpsc::Receiver<Job>) -> Worker {
let thread = thread::spawn(|| {
receiver;
});
Worker { id, thread }
}
}เราได้ทำการแก้ไขเพิ่มเติมเล็กน้อยแบบตรงไปตรงมา โดยส่งฝั่งรับเข้าไปใน Worker::new แล้วเรียกใช้มันภายในโคลเชอร์
เมื่อเราลองตรวจสอบโค้ดนี้ด้วย cargo check ก็จะพบกับข้อผิดพลาดต่อไปนี้:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0382]: use of moved value: `receiver`
--> src/lib.rs:26:42
|
21 | let (sender, receiver) = mpsc::channel();
| -------- move occurs because `receiver` has type `std::sync::mpsc::Receiver<Job>`, which does not implement the `Copy` trait
...
25 | for id in 0..size {
| ----------------- inside of this loop
26 | workers.push(Worker::new(id, receiver));
| ^^^^^^^^ value moved here, in previous iteration of loop
|
note: consider changing this parameter type in method `new` to borrow instead if owning the value isn't necessary
--> src/lib.rs:47:33
|
47 | fn new(id: usize, receiver: mpsc::Receiver<Job>) -> Worker {
| --- in this method ^^^^^^^^^^^^^^^^^^^ this parameter takes ownership of the value
For more information about this error, try `rustc --explain E0382`.
error: could not compile `hello` (lib) due to 1 previous error
โค้ดกำลังพยายามส่ง receiver ให้กับอินสแตนซ์ Worker หลายตัว ซึ่งไม่สามารถทำได้ ดังที่คุณจำได้จากบทที่ 16 ว่า แชนเนลที่ Rust มีให้นั้นเป็นแบบ ผู้ผลิตหลายราย ผู้บริโภครายเดียว (multiple producer, single consumer หรือ mpsc) นั่นหมายความว่าเราไม่สามารถโคลนฝั่งรับ (consumer) ของแชนเนลเพื่อแก้ปัญหานี้ได้ และเราก็ไม่ได้ต้องการส่งข้อความซ้ำไปยังผู้รับหลายคนด้วย สิ่งที่เราต้องการคือคิวข้อความชุดเดียวที่แชร์ให้อินสแตนซ์ของ Worker หลายตัวเข้ามาดึงไป โดยแต่ละข้อความจะถูกประมวลผลเพียงครั้งเดียวเท่านั้น
นอกจากนี้ การดึงงานออกจากคิวของแชนเนลจำเป็นต้องเปลี่ยนแปลงค่า (mutate) ของ receiver เธรดต่าง ๆ จึงต้องการกลไกที่ปลอดภัยในการร่วมกันใช้งานและเปลี่ยนแปลงค่า receiver มิเช่นนั้นเราอาจพบกับสภาวะการแย่งชิงข้อมูล (race condition) ดังที่ได้อธิบายไว้ในบทที่ 16
ย้อนนึกถึงสมาร์ตพอยน์เตอร์ (smart pointer) ที่ปลอดภัยสำหรับการทำงานข้ามเธรดที่เราได้ศึกษาในบทที่ 16: หากต้องการแชร์สิทธิ์ความเป็นเจ้าของข้ามหลายเธรดและยินยอมให้เธรดเหล่านั้นแก้ไขค่าได้ เราจำเป็นต้องใช้ Arc<Mutex<T>> โดยชนิดข้อมูล Arc จะช่วยให้อินสแตนซ์ของ Worker หลายตัวสามารถร่วมเป็นเจ้าของฝั่งรับได้ และมิวเท็กซ์ Mutex จะช่วยรับประกันว่าจะมี Worker เพียงตัวเดียวเท่านั้นที่ได้รับสิทธิ์ดึงงานจากฝั่งรับในแต่ละขณะ ลิสติ้ง 21-18 แสดงการปรับปรุงโค้ดที่จำเป็น
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
// --snip--
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
struct Job;
impl ThreadPool {
// --snip--
/// Create a new ThreadPool.
///
/// The size is the number of threads in the pool.
///
/// # Panics
///
/// The `new` function will panic if the size is zero.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
// --snip--
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
}
}
// --snip--
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
// --snip--
let thread = thread::spawn(|| {
receiver;
});
Worker { id, thread }
}
}ใน ThreadPool::new เราห่อหุ้มฝั่งรับไว้ภายใน Arc และ Mutex และสำหรับ Worker แต่ละตัวที่สร้างขึ้นใหม่ เราจะโคลน Arc เพื่อเพิ่มจำนวนการอ้างอิง (reference count) ทำให้อินสแตนซ์ของ Worker สามารถแชร์สิทธิ์ความเป็นเจ้าของฝั่งรับร่วมกันได้
หลังจากการปรับปรุงนี้ โค้ดก็คอมไพล์ผ่านฉลุย! เราเข้าใกล้เป้าหมายแล้ว!
การอิมพลีเมนต์เมธอด execute
ในที่สุดก็ถึงเวลาสร้างเมธอด execute บน ThreadPool แล้ว โดยเราจะเปลี่ยน Job จากเดิมที่เป็น struct ให้กลายเป็นนามแฝงชนิดข้อมูล (type alias) สำหรับเทรตออบเจกต์ (trait object) ที่บรรจุชนิดของโคลเชอร์ที่ส่งเข้ามายัง execute ดังที่ได้ศึกษาในหัวข้อ“ชื่อพ้องของชนิดข้อมูลและชื่อแทนชนิดข้อมูล” ในบทที่ 20 ซึ่งนามแฝงชนิดข้อมูลจะช่วยย่อชนิดข้อมูลที่ยาวให้สั้นกระชับและสะดวกต่อการเรียกใช้ ลองดูโค้ดในลิสติ้ง 21-19
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
// --snip--
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
// --snip--
/// Create a new ThreadPool.
///
/// The size is the number of threads in the pool.
///
/// # Panics
///
/// The `new` function will panic if the size is zero.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
// --snip--
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(|| {
receiver;
});
Worker { id, thread }
}
}หลังจากสร้างอินสแตนซ์ Job ใหม่โดยนำโคลเชอร์ที่ได้รับใน execute มาบรรจุไว้ เราก็ส่งงานนั้นผ่านทางฝั่งส่งของแชนเนล เราใช้ unwrap กับผลลัพธ์ของ send เผื่อกรณีที่การส่งล้มเหลว ซึ่งอาจเกิดขึ้นได้เช่น เมื่อเราสั่งหยุดการทำงานของเธรดทั้งหมด ทำให้ฝั่งรับปิดตัวลงและไม่รับข้อความใหม่อีกต่อไป แต่ในตอนนี้เรายังไม่มีคำสั่งหยุดเธรด เธรดของเราจึงจะรันอยู่ตลอดตราบเท่าที่พูลยังคงอยู่ สาเหตุที่เราใช้ unwrap ก็เพราะเรารู้ดีว่าข้อผิดพลาดนี้จะไม่เกิดขึ้นในตอนนี้ แม้ว่าคอมไพเลอร์จะไม่อาจล่วงรู้ได้ก็ตาม
แต่เรายังทำไม่เสร็จสมบูรณ์! เพราะใน Worker โคลเชอร์ที่ส่งให้ thread::spawn ยังเพียงแค่ อ้างถึง ฝั่งรับของแชนเนลเท่านั้น แต่สิ่งที่เราต้องการจริง ๆ คือให้โคลเชอร์วนลูปทำงานไปเรื่อย ๆ โดยคอยดึงงานจากฝั่งรับของแชนเนลและนำมาสั่งรันเมื่อได้รับงาน มาปรับแก้โค้ดใน Worker::new ตามที่แสดงในลิสติ้ง 21-20 กัน
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Create a new ThreadPool.
///
/// The size is the number of threads in the pool.
///
/// # Panics
///
/// The `new` function will panic if the size is zero.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
// --snip--
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let job = receiver.lock().unwrap().recv().unwrap();
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}ในจุดนี้ เราเรียกเมธอด lock บน receiver ก่อนเพื่อครอบครองล็อกของมิวเท็กซ์ จากนั้นจึงเรียก unwrap เพื่อให้เกิดการแพนิกหากพบข้อผิดพลาด การขอครอบครองล็อกอาจล้มเหลวได้หากมิวเท็กซ์ตกอยู่ในสถานะ ถูกวางยาพิษ (poisoned) ซึ่งเกิดขึ้นเมื่อเธรดอื่นเกิดการแพนิกในขณะที่ยังถือครองล็อกอยู่แทนที่จะปล่อยล็อกคืน ในสถานการณ์เช่นนี้ การเรียก unwrap เพื่อให้เธรดนี้หยุดทำงานด้วยการแพนิกตามไปด้วยถือเป็นแนวทางที่เหมาะสม หรือคุณอาจเลือกเปลี่ยน unwrap นี้เป็น expect พร้อมข้อความแจ้งเตือนข้อผิดพลาดที่สื่อความหมายชัดเจนตามต้องการก็ได้
เมื่อครอบครองล็อกของมิวเท็กซ์ได้แล้ว เราจะเรียกใช้ recv เพื่อรับ Job มาจากแชนเนล คำสั่ง unwrap ตัวสุดท้ายก็ทำหน้าที่จัดการข้อผิดพลาด ณ จุดนี้เช่นกัน ซึ่งอาจเกิดขึ้นได้หากเธรดที่เป็นฝั่งส่งปิดตัวลง คล้ายคลึงกับกรณีที่เมธอด send จะคืนค่า Err หากฝั่งรับปิดตัวลง
การเรียกใช้ recv จะทำการหยุดรอ (block) ดังนั้นหากยังไม่มีงานส่งเข้ามา เธรดปัจจุบันจะหยุดรอจนกว่าจะมีงานใหม่พร้อมให้ประมวลผล และ Mutex<T> จะเป็นตัวรับประกันว่าจะมีเธรด Worker เพียงตัวเดียวเท่านั้นที่พยายามขอดึงงานในแต่ละขณะ
ในตอนนี้ พูลเธรดของเราพร้อมทำงานจริงแล้ว! ให้ลองสั่ง cargo run แล้วส่งคำขอเข้ามาทดสอบสักสองสามครั้ง:
$ cargo run
Compiling hello v0.1.0 (file:///projects/hello)
warning: field `workers` is never read
--> src/lib.rs:7:5
|
6 | pub struct ThreadPool {
| ---------- field in this struct
7 | workers: Vec<Worker>,
| ^^^^^^^
|
= note: `#[warn(dead_code)]` on by default
warning: fields `id` and `thread` are never read
--> src/lib.rs:48:5
|
47 | struct Worker {
| ------ fields in this struct
48 | id: usize,
| ^^
49 | thread: thread::JoinHandle<()>,
| ^^^^^^
warning: `hello` (lib) generated 2 warnings
Finished `dev` profile [unoptimized + debuginfo] target(s) in 4.91s
Running `target/debug/hello`
Worker 0 got a job; executing.
Worker 2 got a job; executing.
Worker 1 got a job; executing.
Worker 3 got a job; executing.
Worker 0 got a job; executing.
Worker 2 got a job; executing.
Worker 1 got a job; executing.
Worker 3 got a job; executing.
Worker 0 got a job; executing.
Worker 2 got a job; executing.
สำเร็จ! ตอนนี้เราได้พูลเธรดที่ประมวลผลการเชื่อมต่อแบบอะซิงโครนัส (asynchronous) เป็นที่เรียบร้อยแล้ว และจะไม่มีการสร้างเธรดเกิน 4 ตัวอย่างแน่นอน ระบบของเราจึงไม่ทำงานหนักจนเกินพิกัดเมื่อเซิร์ฟเวอร์ได้รับคำขอเข้ามาเป็นจำนวนมาก หากเราส่งคำขอไปยัง /sleep เซิร์ฟเวอร์ก็ยังคงสามารถให้บริการคำขออื่น ๆ ได้อย่างต่อเนื่องโดยให้เธรดตัวอื่นที่ว่างอยู่รับไปประมวลผลแทน
หมายเหตุ: หากคุณเปิดหน้า /sleep บนหน้าต่างเบราว์เซอร์หลายหน้าต่างพร้อมกัน หน้าเว็บอาจทยอยโหลดเสร็จทีละหน้าต่างโดยห่างกันช่วงละ 5 วินาที เนื่องจากเบราว์เซอร์ บางตัวจะประมวลผลคำขอที่ซ้ำกันตามลำดับทีละคำขอเพื่อการจัดการแคช (cache) ข้อจำกัดนี้จึงเกิดจากพฤติกรรมของเบราว์เซอร์ ไม่ใช่ข้อผิดพลาดของเว็บเซิร์ฟเวอร์เรา
นี่คือช่วงเวลาที่ดีในการหยุดพักและลองพิจารณาดูว่า โค้ดในลิสติ้ง 21-18, 21-19 และ 21-20 จะแตกต่างไปอย่างไรหากเราเปลี่ยนมาใช้ฟิวเจอร์ (futures) แทนโคลเชอร์สำหรับงานที่ต้องทำ ชนิดข้อมูลใดบ้างที่ต้องเปลี่ยน? ซิกเนเจอร์ของเมธอดจะแตกต่างไปหรือไม่? และโค้ดส่วนใดบ้างที่จะยังคงเดิมทุกประการ?
หลังจากได้เรียนรู้เกี่ยวกับลูป while let ในบทที่ 17 และบทที่ 19 คุณอาจสงสัยว่าทำไมเราจึงไม่เขียนโค้ดสำหรับเธรดของ Worker ดังที่แสดงในลิสติ้ง 21-21
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Create a new ThreadPool.
///
/// The size is the number of threads in the pool.
///
/// # Panics
///
/// The `new` function will panic if the size is zero.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
// --snip--
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
while let Ok(job) = receiver.lock().unwrap().recv() {
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}โค้ดนี้สามารถคอมไพล์และรันได้จริง แต่ไม่ได้ให้ผลลัพธ์พฤติกรรมการทำงานของเธรดตามที่เราต้องการ กล่าวคือ คำขอที่ช้าจะยังคงทำให้คำขออื่น ๆ ต้องรอคอยอยู่เช่นเดิม เหตุผลเบื้องหลังค่อนข้างละเอียดอ่อน: struct Mutex ไม่มีเมธอด unlock แบบสาธารณะให้เรียกใช้ เนื่องจากสิทธิ์ในการครอบครองล็อกจะผูกอยู่กับช่วงอายุของ MutexGuard<T> ภายใน LockResult<MutexGuard<T>> ที่เมธอด lock คืนค่ากลับมา ในขั้นตอนคอมไพล์ ตัวตรวจการยืม (borrow checker) จึงสามารถบังคับใช้กฎที่ว่า ข้อมูลที่ได้รับการปกป้องโดย Mutex จะไม่สามารถเข้าถึงได้เลยเว้นแต่จะถือครองล็อกอยู่ ทว่าการทำงานในรูปแบบนี้อาจส่งผลให้การถือครองล็อกยาวนานเกินกว่าที่ตั้งใจไว้ หากเราไม่ได้ตระหนักถึงช่วงอายุของ MutexGuard<T> อย่างรอบคอบ
โค้ดในลิสติ้ง 21-20 ที่ใช้คำสั่ง let job = receiver.lock().unwrap().recv().unwrap(); ทำงานได้อย่างถูกต้องเพราะการใช้ let จะทำให้ค่าชั่วคราวใด ๆ ที่เกิดขึ้นในนิพจน์ (expression) ทางฝั่งขวาของเครื่องหมายเท่ากับถูกทำลายทิ้งทันทีเมื่อสเตตเมนต์ let สิ้นสุดลง ทว่าในทางตรงกันข้าม while let (รวมถึง if let และ match) จะไม่ทำลายค่าชั่วคราวทิ้งจนกว่าจะถึงจุดสิ้นสุดของบล็อกโค้ดนั้น ๆ ส่งผลให้ในลิสติ้ง 21-21 การครอบครองล็อกยังคงค้างอยู่ตลอดระยะเวลาที่คำสั่ง job() กำลังทำงาน ซึ่งหมายความว่าอินสแตนซ์ของ Worker ตัวอื่น ๆ จะไม่สามารถเข้ามาขอดึงงานไปทำได้เลยจนกว่างานปัจจุบันจะเสร็จสิ้น
การปิดระบบอย่างนุ่มนวลและการทำความสะอาด
การปิดระบบอย่างนุ่มนวลและการทำความสะอาด
โค้ดในลิสติ้ง 21-20 สามารถตอบสนองต่อคำขอ (requests) แบบอะซิงโครนัสผ่านการใช้พูลเธรด (thread pool) ได้ตามที่เราตั้งใจไว้แล้ว ทว่าเรายังได้รับคำเตือน (warnings) เกี่ยวกับฟิลด์ workers, id และ thread ที่เราไม่ได้เรียกใช้งานโดยตรง ซึ่งคอยเตือนสติเราว่าเรายังไม่ได้เขียนโค้ดสำหรับเก็บกวาดทำความสะอาดทรัพยากรเลยแม้แต่น้อย ยิ่งไปกว่านั้น เมื่อเราหยุดการทำงานของเธรดหลักด้วยวิธีที่ค่อนข้างหยาบอย่างการกด ctrl-C เธรดอื่น ๆ ทั้งหมดก็จะถูกสั่งหยุดทำงานอย่างกะทันหันในทันที แม้ว่าพวกมันกำลังอยู่ระหว่างการประมวลผลคำขอค้างอยู่ก็ตาม
ในลำดับถัดไป เราจะอิมพลีเมนต์เทรต Drop เพื่อเรียกใช้ join กับแต่ละเธรดในพูล เพื่อเปิดโอกาสให้พวกมันประมวลผลคำขอที่ค้างอยู่ให้เสร็จสิ้นก่อนที่จะปิดตัวลง จากนั้นเราจะสร้างกลไกส่งสัญญาณบอกเธรดต่าง ๆ ว่าพวกมันควรหยุดรับคำขอใหม่และเริ่มปิดตัวลง และเพื่อทดสอบการทำงานของโค้ดนี้ในสถานการณ์จริง เราจะปรับแก้เซิร์ฟเวอร์ของเราให้รับคำขอเพียง 2 ครั้งก่อนจะปิดการทำงานของพูลเธรดลงอย่างนุ่มนวล (graceful shutdown)
ข้อสังเกตประการหนึ่งขณะที่เรากำลังดำเนินการคือ สิ่งเหล่านี้ไม่มีผลกระทบต่อส่วนของโค้ดที่จัดการการรันโคลเชอร์เลย ดังนั้นทุกสิ่งที่เรากำลังจะทำตรงนี้จะยังคงเหมือนเดิมทุกประการหากเรานำพูลเธรดไปประยุกต์ใช้กับรันไทม์แบบ async
การอิมพลีเมนต์เทรต Drop บน ThreadPool
มาเริ่มต้นด้วยการอิมพลีเมนต์เทรต Drop ให้กับพูลเธรดของเรา เมื่อพูลถูกทำลายทิ้ง (drop) เธรดทั้งหมดควรทำการ join เพื่อให้มั่นใจว่าพวกมันประมวลผลงานจนเสร็จสมบูรณ์ ลิสติ้ง 21-22 แสดงความพยายามแรกในการอิมพลีเมนต์ Drop ซึ่งโค้ดนี้จะยังคอมไพล์ไม่ผ่าน
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Create a new ThreadPool.
///
/// The size is the number of threads in the pool.
///
/// # Panics
///
/// The `new` function will panic if the size is zero.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
for worker in &mut self.workers {
println!("Shutting down worker {}", worker.id);
worker.thread.join().unwrap();
}
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let job = receiver.lock().unwrap().recv().unwrap();
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}เริ่มแรก เราวนลูปผ่านแต่ละ workers ของพูลเธรด โดยเราใช้ &mut เนื่องจาก self เป็นการอ้างอิงแบบปรับเปลี่ยนค่าได้ (mutable reference) และเราจำเป็นต้องแก้ไขค่าของ worker ด้วย สำหรับ worker แต่ละตัว เราสั่งพิมพ์ข้อความแจ้งว่าอินสแตนซ์ของ Worker ตัวนั้นกำลังปิดตัวลง จากนั้นจึงเรียกใช้ join กับเธรดของอินสแตนซ์ Worker นั้น หากการเรียก join ล้มเหลว เราจะใช้ unwrap เพื่อให้ Rust แพนิกและเข้าสู่กระบวนการปิดระบบแบบฉับพลัน
นี่คือข้อผิดพลาดที่เราได้รับเมื่อคอมไพล์โค้ดนี้:
$ cargo check
Checking hello v0.1.0 (file:///projects/hello)
error[E0507]: cannot move out of `worker.thread` which is behind a mutable reference
--> src/lib.rs:52:13
|
52 | worker.thread.join().unwrap();
| ^^^^^^^^^^^^^ ------ `worker.thread` moved due to this method call
| |
| move occurs because `worker.thread` has type `JoinHandle<()>`, which does not implement the `Copy` trait
|
note: `JoinHandle::<T>::join` takes ownership of the receiver `self`, which moves `worker.thread`
--> /rustc/88d9e12ae178fab0fb5cc050a94da85685d449ea/library/std/src/thread/join_handle.rs:149:16
For more information about this error, try `rustc --explain E0507`.
error: could not compile `hello` (lib) due to 1 previous error
ข้อความแจ้งเตือนข้อผิดพลาดระบุว่าเราไม่สามารถเรียก join ได้ เนื่องจากเราถือเพียงการยืมแบบปรับเปลี่ยนค่าได้ (mutable borrow) ของ worker แต่ละตัวเท่านั้น ในขณะที่ join จำเป็นต้องรับสิทธิ์ความเป็นเจ้าของ (ownership) ในอาร์กิวเมนต์ของมัน เพื่อแก้ปัญหานี้ เราต้องย้ายเธรดออกจากอินสแตนซ์ Worker ที่เป็นเจ้าของฟิลด์ thread นั้น เพื่อให้ join สามารถดึงข้อมูลเธรดไปใช้งานจนหมดได้ แนวทางหนึ่งคือการใช้วิธีเดียวกับที่เราเคยทำในลิสติ้ง 18-15 หาก Worker จัดเก็บข้อมูลเป็น Option<thread::JoinHandle<()>> เราจะสามารถเรียกเมธอด take บน Option เพื่อย้ายค่าออกจากตัวแปรแบบ Some และทิ้งค่า None ไว้แทนที่ได้ กล่าวคือ Worker ที่ยังทำงานอยู่จะมีค่าเป็น Some อยู่ใน thread และเมื่อเราต้องการเก็บกวาดทำความสะอาด Worker เราจะแทนที่ค่านั้นด้วย None เพื่อให้ Worker ไม่มีเธรดหลงเหลือให้รันอีกต่อไป
อย่างไรก็ตาม จังหวะ เพียงครั้งเดียว ที่เหตุการณ์นี้จะเกิดขึ้นก็คือตอนทำลาย (drop) Worker เท่านั้น แต่เรากลับต้องแลกมาด้วยการคอยจัดการกับ Option<thread::JoinHandle<()>> ในทุก ๆ จุดที่เราเข้าถึง worker.thread แม้ว่าตามสำนวนนิยมของ Rust จะมีการใช้ Option อยู่บ่อยครั้ง แต่หากคุณพบว่าตนเองต้องนำ Option มาห่อหุ้มสิ่งที่คุณรู้อยู่แก่ใจว่ามันมีค่าอยู่เสมอเพียงเพื่อเป็นทางแก้ขัดเช่นนี้ การมองหาแนวทางอื่นเพื่อช่วยให้โค้ดของคุณสะอาดและลดโอกาสเกิดข้อผิดพลาดได้ดีกว่าย่อมเป็นทางเลือกที่เหมาะสมกว่า
ในกรณีนี้ เรามีทางเลือกที่ดีกว่า นั่นคือการใช้เมธอด Vec::drain ซึ่งรับพารามิเตอร์เป็นช่วง (range) เพื่อระบุว่าจะดึงสมาชิกตัวใดออกจากเวกเตอร์บ้าง และจะคืนค่ากลับมาเป็นอิเทอเรเตอร์ของสมาชิกเหล่านั้น โดยการส่งไวยากรณ์ช่วง .. จะเป็นการดึง ทุกค่า ออกจากเวกเตอร์
ดังนั้น เราจึงต้องอัปเดตการอิมพลีเมนต์ drop ของ ThreadPool ดังนี้:
#![allow(unused)]
fn main() {
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: mpsc::Sender<Job>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Create a new ThreadPool.
///
/// The size is the number of threads in the pool.
///
/// # Panics
///
/// The `new` function will panic if the size is zero.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool { workers, sender }
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
for worker in self.workers.drain(..) {
println!("Shutting down worker {}", worker.id);
worker.thread.join().unwrap();
}
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let job = receiver.lock().unwrap().recv().unwrap();
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}
}วิธีนี้ช่วยแก้ข้อผิดพลาดของคอมไพเลอร์ได้โดยไม่ต้องแก้ไขโค้ดส่วนอื่น ๆ เลย สังเกตว่า เนื่องจากการทำลายค่า (drop) อาจถูกเรียกขึ้นมาขณะที่โปรแกรมกำลังแพนิกได้ การใช้ unwrap ในจุดนี้จึงอาจเกิดการแพนิกซ้ำซ้อน (double panic) ซึ่งจะส่งผลให้โปรแกรมแครชในทันทีและทำให้กระบวนการเก็บกวาดทรัพยากรที่กำลังดำเนินอยู่ต้องหยุดชะงักลง พฤติกรรมนี้ถือว่ายอมรับได้ในโปรแกรมตัวอย่างสำหรับการเรียนรู้ แต่ไม่แนะนำให้ใช้ในโค้ดระดับโปรดักชันจริง
การส่งสัญญาณให้เธรดหยุดรอฟังงาน
หลังจากการปรับปรุงทั้งหมดที่เราได้ทำไป โค้ดของเราสามารถคอมไพล์ผ่านได้โดยไม่มีคำเตือนใด ๆ หลงเหลือ ทว่าข่าวร้ายคือโค้ดยังไม่ทำงานตามที่เราต้องการอย่างแท้จริง สาเหตุสำคัญอยู่ที่ตรรกะภายในโคลเชอร์ที่รันอยู่บนเธรดของแต่ละ Worker: ในตอนนี้ แม้เราจะสั่งเรียก join แต่นั่นจะไม่ทำให้เธรดปิดการทำงานลงได้ เพราะเธรดเหล่านั้นยังคงวนลูป loop คอยหางาน (job) ไปเรื่อย ๆ อย่างไม่มีที่สิ้นสุด หากเราพยายามทำลาย ThreadPool ทิ้งด้วยการอิมพลีเมนต์ drop ในปัจจุบัน เธรดหลักจะหยุดรอค้าง (block) อยู่ตลอดไปเพื่อรอให้เธรดแรกทำงานเสร็จ
ในการแก้ไขปัญหานี้ เราต้องปรับเปลี่ยนการทำงานของ drop ใน ThreadPool ควบคู่ไปกับการปรับลูปการทำงานของ Worker
ประการแรก เราจะปรับแก้การทำงานของ drop ใน ThreadPool ให้ทำลาย (drop) sender ทิ้งอย่างชัดเจนก่อนที่จะเริ่มรอให้เธรดทำงานเสร็จ ลิสติ้ง 21-23 แสดงการปรับปรุง ThreadPool เพื่อสั่งทำลาย sender อย่างชัดเจน ซึ่งในจุดนี้ต่างจากกรณีของเธรดตรงที่เรา จำเป็น ต้องใช้ Option เพื่อให้สามารถย้ายสิทธิ์ของ sender ออกมาจาก ThreadPool ด้วย Option::take ได้
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: Option<mpsc::Sender<Job>>,
}
// --snip--
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Create a new ThreadPool.
///
/// The size is the number of threads in the pool.
///
/// # Panics
///
/// The `new` function will panic if the size is zero.
pub fn new(size: usize) -> ThreadPool {
// --snip--
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool {
workers,
sender: Some(sender),
}
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.as_ref().unwrap().send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
drop(self.sender.take());
for worker in self.workers.drain(..) {
println!("Shutting down worker {}", worker.id);
worker.thread.join().unwrap();
}
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let job = receiver.lock().unwrap().recv().unwrap();
println!("Worker {id} got a job; executing.");
job();
}
});
Worker { id, thread }
}
}การทำลาย sender ทิ้งจะส่งผลให้แชนเนลปิดตัวลง ซึ่งเป็นการส่งสัญญาณบ่งบอกว่าจะไม่มีข้อความใหม่ส่งเข้ามาอีกต่อไป เมื่อเป็นเช่นนั้น การเรียก recv ทั้งหมดที่อินสแตนซ์ Worker ทำอยู่ในลูปอนันต์จะคืนค่าเป็นข้อผิดพลาดกลับมา ในลิสติ้ง 21-24 เราจะปรับลูปการทำงานของ Worker ให้หยุดการทำงานและออกจากลูปอย่างนุ่มนวลเมื่อพบกรณีดังกล่าว ซึ่งหมายความว่าเธรดจะสามารถปิดตัวลงได้อย่างสมบูรณ์เมื่อ drop ของ ThreadPool เรียกใช้ join กับพวกมัน
use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: Option<mpsc::Sender<Job>>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Create a new ThreadPool.
///
/// The size is the number of threads in the pool.
///
/// # Panics
///
/// The `new` function will panic if the size is zero.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool {
workers,
sender: Some(sender),
}
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.as_ref().unwrap().send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
drop(self.sender.take());
for worker in self.workers.drain(..) {
println!("Shutting down worker {}", worker.id);
worker.thread.join().unwrap();
}
}
}
struct Worker {
id: usize,
thread: thread::JoinHandle<()>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let message = receiver.lock().unwrap().recv();
match message {
Ok(job) => {
println!("Worker {id} got a job; executing.");
job();
}
Err(_) => {
println!("Worker {id} disconnected; shutting down.");
break;
}
}
}
});
Worker { id, thread }
}
}เพื่อดูการทำงานของโค้ดนี้ในสถานการณ์จริง มาปรับฟังก์ชัน main ให้รับคำขอเพียง 2 ครั้งก่อนจะปิดเซิร์ฟเวอร์ลงอย่างนุ่มนวล ดังแสดงในลิสติ้ง 21-25
use hello::ThreadPool;
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
let pool = ThreadPool::new(4);
for stream in listener.incoming().take(2) {
let stream = stream.unwrap();
pool.execute(|| {
handle_connection(stream);
});
}
println!("Shutting down.");
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}แน่นอนว่าในเว็บเซิร์ฟเวอร์ที่ใช้งานจริง คุณคงไม่ต้องการให้เซิร์ฟเวอร์ปิดตัวลงหลังจากให้บริการเพียง 2 คำขอ แต่โค้ดนี้เขียนขึ้นเพื่อสาธิตให้เห็นว่า กลไกการปิดระบบอย่างนุ่มนวลและการเก็บกวาดทรัพยากรทำงานได้อย่างถูกต้องแม่นยำ
เมธอด take ถูกนิยามไว้ในเทรต Iterator โดยทำหน้าที่จำกัดการวนซ้ำให้เหลือไม่เกิน 2 รายการแรก และเมื่อฟังก์ชัน main สิ้นสุดลง ตัวแปร ThreadPool ก็จะหลุดออกจากขอบเขต (scope) ทำให้โค้ดใน drop เริ่มทำงาน
เริ่มรันเซิร์ฟเวอร์ด้วยคำสั่ง cargo run แล้วลองส่งคำขอเข้ามา 3 ครั้ง โดยคำขอที่สามควรได้รับข้อผิดพลาดกลับไป และในหน้าต่างเทอร์มินัลของคุณ คุณจะเห็นข้อความเอาต์พุตคล้ายกับต่อไปนี้:
$ cargo run
Compiling hello v0.1.0 (file:///projects/hello)
Finished `dev` profile [unoptimized + debuginfo] target(s) in 0.41s
Running `target/debug/hello`
Worker 0 got a job; executing.
Shutting down.
Shutting down worker 0
Worker 3 got a job; executing.
Worker 1 disconnected; shutting down.
Worker 2 disconnected; shutting down.
Worker 3 disconnected; shutting down.
Worker 0 disconnected; shutting down.
Shutting down worker 1
Shutting down worker 2
Shutting down worker 3
คุณอาจเห็นลำดับหมายเลข ID ของ Worker และข้อความเอาต์พุตที่พิมพ์ออกมาแตกต่างไปจากนี้เล็กน้อย แต่เราสามารถเข้าใจการทำงานของโค้ดได้จากข้อความเหล่านี้ กล่าวคือ: อินสแตนซ์ Worker หมายเลข 0 และ 3 เป็นผู้ได้รับ 2 คำขอแรก จากนั้นเซิร์ฟเวอร์หยุดรับการเชื่อมต่อใหม่หลังจากการเชื่อมต่อที่สองเสร็จสิ้น และการทำงานของ Drop บน ThreadPool ได้เริ่มทำงานขึ้นก่อนที่ Worker 3 จะเริ่มประมวลผลงานของมันเสียอีก การทำลาย sender ทิ้งจะตัดการเชื่อมต่อของอินสแตนซ์ Worker ทั้งหมดและส่งสัญญาณบอกให้พวกมันปิดตัวลง โดย Worker แต่ละตัวจะพิมพ์ข้อความเมื่อถูกตัดการเชื่อมต่อ จากนั้นพูลเธรดจึงสั่งเรียก join เพื่อรอให้เธรดของ Worker แต่ละตัวทำงานเสร็จสิ้นลงอย่างสมบูรณ์
สังเกตแง่มุมที่น่าสนใจอย่างหนึ่งในรอบการทำงานนี้: ThreadPool ได้ทำลาย sender ทิ้งไปแล้ว และก่อนที่ Worker ตัวใดจะได้รับข้อผิดพลาด เราได้พยายาม join กับ Worker 0 ในขณะที่ Worker 0 ยังไม่ได้รับข้อผิดพลาดจากการเรียก recv เธรดหลักจึงหยุดรอ (block) จนกว่า Worker 0 จะทำงานเสร็จ ในระหว่างนั้น Worker 3 ได้รับงานไปทำ แล้วหลังจากนั้นเธรดทั้งหมดจึงได้รับข้อผิดพลาดจากแชนเนลที่ปิดลง และเมื่อ Worker 0 ทำงานเสร็จสิ้น เธรดหลักก็รอให้ Worker ที่เหลือทำงานจนเสร็จ ซึ่ง ณ จุดนั้นพวกมันทั้งหมดต่างออกจากลูปและปิดตัวลงเป็นที่เรียบร้อยแล้ว
ขอแสดงความยินดีด้วย! ตอนนี้เราได้สร้างโปรเจกต์ส่งท้ายนี้จนเสร็จสมบูรณ์แล้ว เรามีเว็บเซิร์ฟเวอร์ขั้นพื้นฐานที่นำพูลเธรดมาใช้ในการตอบสนองต่อคำขอแบบอะซิงโครนัสได้อย่างมีประสิทธิภาพ และเรายังสามารถสั่งปิดเซิร์ฟเวอร์ลงอย่างนุ่มนวลพร้อมทั้งเก็บกวาดทำความสะอาดเธรดทั้งหมดในพูลได้อย่างปลอดภัย
นี่คือโค้ดฉบับสมบูรณ์สำหรับใช้อ้างอิง:
use hello::ThreadPool;
use std::{
fs,
io::{BufReader, prelude::*},
net::{TcpListener, TcpStream},
thread,
time::Duration,
};
fn main() {
let listener = TcpListener::bind("127.0.0.1:7878").unwrap();
let pool = ThreadPool::new(4);
for stream in listener.incoming().take(2) {
let stream = stream.unwrap();
pool.execute(|| {
handle_connection(stream);
});
}
println!("Shutting down.");
}
fn handle_connection(mut stream: TcpStream) {
let buf_reader = BufReader::new(&stream);
let request_line = buf_reader.lines().next().unwrap().unwrap();
let (status_line, filename) = match &request_line[..] {
"GET / HTTP/1.1" => ("HTTP/1.1 200 OK", "hello.html"),
"GET /sleep HTTP/1.1" => {
thread::sleep(Duration::from_secs(5));
("HTTP/1.1 200 OK", "hello.html")
}
_ => ("HTTP/1.1 404 NOT FOUND", "404.html"),
};
let contents = fs::read_to_string(filename).unwrap();
let length = contents.len();
let response =
format!("{status_line}\r\nContent-Length: {length}\r\n\r\n{contents}");
stream.write_all(response.as_bytes()).unwrap();
}use std::{
sync::{Arc, Mutex, mpsc},
thread,
};
pub struct ThreadPool {
workers: Vec<Worker>,
sender: Option<mpsc::Sender<Job>>,
}
type Job = Box<dyn FnOnce() + Send + 'static>;
impl ThreadPool {
/// Create a new ThreadPool.
///
/// The size is the number of threads in the pool.
///
/// # Panics
///
/// The `new` function will panic if the size is zero.
pub fn new(size: usize) -> ThreadPool {
assert!(size > 0);
let (sender, receiver) = mpsc::channel();
let receiver = Arc::new(Mutex::new(receiver));
let mut workers = Vec::with_capacity(size);
for id in 0..size {
workers.push(Worker::new(id, Arc::clone(&receiver)));
}
ThreadPool {
workers,
sender: Some(sender),
}
}
pub fn execute<F>(&self, f: F)
where
F: FnOnce() + Send + 'static,
{
let job = Box::new(f);
self.sender.as_ref().unwrap().send(job).unwrap();
}
}
impl Drop for ThreadPool {
fn drop(&mut self) {
drop(self.sender.take());
for worker in &mut self.workers {
println!("Shutting down worker {}", worker.id);
if let Some(thread) = worker.thread.take() {
thread.join().unwrap();
}
}
}
}
struct Worker {
id: usize,
thread: Option<thread::JoinHandle<()>>,
}
impl Worker {
fn new(id: usize, receiver: Arc<Mutex<mpsc::Receiver<Job>>>) -> Worker {
let thread = thread::spawn(move || {
loop {
let message = receiver.lock().unwrap().recv();
match message {
Ok(job) => {
println!("Worker {id} got a job; executing.");
job();
}
Err(_) => {
println!("Worker {id} disconnected; shutting down.");
break;
}
}
}
});
Worker {
id,
thread: Some(thread),
}
}
}เรายังสามารถต่อยอดสิ่งต่าง ๆ ได้อีกมากจากจุดนี้! หากคุณต้องการพัฒนาและปรับปรุงโปรเจกต์นี้ต่อไป นี่คือไอเดียบางส่วนที่คุณสามารถลองทำได้:
- เพิ่มเอกสารประกอบ (documentation) ให้กับ
ThreadPoolและเมธอดสาธารณะต่าง ๆ ของมัน - เพิ่มแบบทดสอบอัตโนมัติ (tests) เพื่อตรวจสอบความถูกต้องในการทำงานของไลบรารี
- ปรับเปลี่ยนจากการเรียกใช้
unwrapไปเป็นการจัดการข้อผิดพลาดที่มีความแข็งแกร่งและปลอดภัยยิ่งขึ้น - นำ
ThreadPoolไปประยุกต์ใช้งานประมวลผลอื่น ๆ นอกเหนือจากการให้บริการคำขอของเว็บ - ค้นหาเครตสำหรับพูลเธรดบน crates.io แล้วลองสร้างเว็บเซิร์ฟเวอร์ที่คล้ายกันโดยใช้เครตดังกล่าว จากนั้นลองเปรียบเทียบรูปแบบของ API และความแข็งแกร่งในการทำงานกับพูลเธรดที่เราลงมือเขียนขึ้นเอง
สรุป
ยอดเยี่ยมมาก! คุณเดินทางมาถึงบทสุดท้ายของหนังสือเล่มนี้แล้ว! เราขอขอบคุณเป็นอย่างยิ่งที่คุณได้ร่วมเดินทางสำรวจโลกของภาษา Rust ไปพร้อมกับเรา ในตอนนี้คุณมีความรู้และเครื่องมือที่พร้อมสำหรับการสร้างสรรค์โปรเจกต์ Rust ของคุณเอง รวมถึงพร้อมที่จะเข้าไปมีส่วนร่วมและช่วยเหลือโปรเจกต์ของผู้อื่นในชุมชนแล้ว และโปรดจำไว้เสมอว่า มีชุมชนชาว Rustaceans ที่เป็นมิตรและพร้อมต้อนรับ คอยให้ความช่วยเหลือคุณในทุก ๆ ความท้าทายที่คุณจะได้พบเจอบนเส้นทางการเขียนโปรแกรมด้วยภาษา Rust!
ภาคผนวก
เนื้อหาในหัวข้อต่อไปนี้รวบรวมข้อมูลอ้างอิงที่เป็นประโยชน์สำหรับการเดินทางในโลกของภาษา Rust ของคุณ
A - คำสงวน
ภาคผนวก A: คำสงวน
รายการต่อไปนี้รวบรวมคำสงวน (keywords) ที่ถูกสงวนไว้สำหรับการใช้งานในปัจจุบันหรือในอนาคตของภาษา Rust ด้วยเหตุนี้ คำเหล่านี้จึงไม่สามารถนำมาตั้งเป็นตัวระบุหรือชื่อเรียก (identifiers) ได้ (ยกเว้นเมื่อใช้งานในรูปแบบ raw identifier ดังที่เราจะกล่าวถึงในหัวข้อ“ชื่อเรียกแบบ raw”) โดยคำว่า ตัวระบุ (identifiers) หมายถึงชื่อของฟังก์ชัน ตัวแปร พารามิเตอร์ ฟิลด์ของ struct มอดูล เครต (crate) ค่าคงที่ มาโคร (macro) ค่าสแตติก แอตทริบิวต์ (attribute) ชนิดข้อมูล เทรต (trait) หรือช่วงอายุ (lifetime)
คำสงวนที่ใช้อยู่ในปัจจุบัน
ต่อไปนี้คือรายการคำสงวนที่ใช้อยู่ในปัจจุบัน พร้อมคำอธิบายการทำงานของแต่ละคำ
as: ทำการแคสต์ชนิดข้อมูลพื้นฐาน, ช่วยแยกความกำกวมของเทรตเฉพาะที่มีไอเท็มนั้นอยู่ หรือใช้เปลี่ยนชื่อไอเท็มในสเตตเมนต์useasync: คืนค่าเป็นFutureแทนที่จะทำการบล็อกเธรด (thread) ปัจจุบันawait: พักการทำงานชั่วคราวไว้จนกว่าผลลัพธ์ของFutureจะพร้อมใช้งานbreak: ออกจากลูปการทำงานทันทีconst: นิยามค่าคงที่ หรือ raw pointer ที่เป็นค่าคงที่continue: ข้ามไปยังรอบถัดไปของลูปการทำงานcrate: ในพาธของมอดูล ใช้อ้างอิงถึงรูทของเครต (crate root)dyn: ส่งต่อการทำงานแบบไดนามิก (dynamic dispatch) ไปยังเทรตออบเจกต์ (trait object)else: ทางเลือกสำรองในโครงสร้างควบคุมทิศทางการทำงานแบบifและif letenum: นิยามประเภทข้อมูลแจงนับ (enumeration)extern: เชื่อมโยงฟังก์ชันหรือตัวแปรภายนอกfalse: ค่าลิเทอรัลเท็จของชนิดข้อมูลบูลีน (boolean)fn: นิยามฟังก์ชัน หรือชนิดข้อมูลพอยน์เตอร์ของฟังก์ชันfor: วนลูปประมวลผลสมาชิกจากอิเทอเรเตอร์ (iterator), อิมพลีเมนต์เทรต หรือระบุช่วงอายุแบบ higher-rankedif: แตกกิ่งการทำงานตามผลลัพธ์ของนิพจน์เงื่อนไขimpl: อิมพลีเมนต์ฟังก์ชันการทำงานเฉพาะตัว (inherent) หรือของเทรตin: ส่วนหนึ่งของไวยากรณ์ลูปforlet: ผูกค่าตัวแปรloop: วนลูปซ้ำแบบไม่มีเงื่อนไขmatch: จับคู่ค่ากับแพตเทิร์นmod: นิยามมอดูลmove: กำหนดให้โคลเชอร์ (closure) รับสิทธิ์ความเป็นเจ้าของในตัวแปรทั้งหมดที่แคปเจอร์มาmut: ระบุความสามารถในการเปลี่ยนแปลงค่า (mutability) ในการอ้างอิง, raw pointer หรือการผูกค่าแพตเทิร์นpub: กำหนดระดับการเข้าถึงเป็นแบบสาธารณะ (public) ในฟิลด์ของ struct, บล็อกimplหรือมอดูลref: ผูกค่าด้วยการอ้างอิง (reference)return: คืนค่าออกจากฟังก์ชันSelf: นามแฝงชนิดข้อมูลสำหรับชนิดข้อมูลที่เรากำลังนิยามหรืออิมพลีเมนต์อยู่self: ตัวรับของเมธอด (method subject) หรือมอดูลปัจจุบันstatic: ตัวแปรส่วนกลาง (global variable) หรือช่วงอายุที่คงอยู่ตลอดอายุการทำงานของโปรแกรมstruct: นิยามโครงสร้างข้อมูล (struct)super: มอดูลแม่ของมอดูลปัจจุบันtrait: นิยามเทรต (trait)true: ค่าลิเทอรัลจริงของชนิดข้อมูลบูลีนtype: นิยามนามแฝงชนิดข้อมูล (type alias) หรือชนิดข้อมูลร่วม (associated type)union: นิยาม union; ถือเป็นคำสงวนเฉพาะเมื่อใช้ในการประกาศ union เท่านั้นunsafe: ระบุโค้ด ฟังก์ชัน เทรต หรือการอิมพลีเมนต์ที่อาจไม่ปลอดภัย (unsafe)use: นำสัญลักษณ์ (symbols) เข้ามาสู่ขอบเขตการทำงาน (scope)where: ระบุข้อกำหนดเงื่อนไข (clauses) ที่ใช้จำกัดชนิดข้อมูลwhile: วนลูปตามเงื่อนไขโดยอิงจากผลลัพธ์ของนิพจน์
คำสงวนที่สงวนไว้สำหรับใช้ในอนาคต
คำสงวนต่อไปนี้ยังไม่มีฟังก์ชันการทำงานใด ๆ ในปัจจุบัน แต่ถูกสงวนไว้โดยภาษา Rust เผื่อสำหรับการใช้งานในอนาคต:
abstractbecomeboxdofinalgenmacrooverrideprivtrytypeofunsizedvirtualyield
ชื่อเรียกแบบ raw
ชื่อเรียกแบบ raw (raw identifiers) คือไวยากรณ์พิเศษที่ช่วยให้คุณสามารถนำคำสงวนมาใช้ในตำแหน่งที่ปกติแล้วไม่อนุญาตให้ใช้ได้ โดยใช้งานด้วยการใส่คำนำหน้า r# กำกับไว้หน้าคำสงวน
ตัวอย่างเช่น match เป็นคำสงวน หากคุณพยายามคอมไพล์ฟังก์ชันต่อไปนี้ที่ใช้ match เป็นชื่อของมัน:
ชื่อไฟล์: src/main.rs
fn match(needle: &str, haystack: &str) -> bool {
haystack.contains(needle)
}คุณจะได้รับข้อผิดพลาดนี้:
error: expected identifier, found keyword `match`
--> src/main.rs:4:4
|
4 | fn match(needle: &str, haystack: &str) -> bool {
| ^^^^^ expected identifier, found keyword
ข้อผิดพลาดนี้แสดงให้เห็นว่าคุณไม่สามารถใช้คำสงวน match เป็นชื่อเรียกของฟังก์ชันได้ หากต้องการใช้ match เป็นชื่อฟังก์ชัน คุณต้องใช้ชื่อเรียกแบบ raw ดังนี้:
ชื่อไฟล์: src/main.rs
fn r#match(needle: &str, haystack: &str) -> bool {
haystack.contains(needle)
}
fn main() {
assert!(r#match("foo", "foobar"));
}โค้ดชุดนี้จะคอมไพล์ผ่านได้โดยไม่มีข้อผิดพลาดใด ๆ สังเกตการใส่คำนำหน้า r# ที่ชื่อฟังก์ชัน ทั้งในจุดที่นิยามฟังก์ชันและจุดที่เรียกใช้ฟังก์ชันใน main
ชื่อเรียกแบบ raw ช่วยให้คุณสามารถเลือกใช้คำใดก็ได้เป็นตัวระบุ แม้ว่าคำนั้นจะตรงกับคำสงวนก็ตาม วิธีนี้ช่วยให้เรามีอิสระในการตั้งชื่อตัวระบุมากขึ้น และยังช่วยให้สามารถทำงานร่วมกับโปรแกรมที่เขียนด้วยภาษาอื่นที่คำเหล่านี้ไม่ได้เป็นคำสงวนได้เป็นอย่างดี นอกจากนี้ ชื่อเรียกแบบ raw ยังช่วยให้คุณสามารถเรียกใช้ไลบรารีที่เขียนขึ้นด้วยฉบับ (edition) ของ Rust ที่แตกต่างจากฉบับที่เครตของคุณใช้อยู่ได้ ตัวอย่างเช่น คำว่า try ไม่ได้เป็นคำสงวนในฉบับ 2015 แต่ถูกกำหนดเป็นคำสงวนในฉบับ 2018, 2021 และ 2024 หากคุณต้องพึ่งพาไลบรารีที่เขียนด้วยฉบับ 2015 ซึ่งมีฟังก์ชันชื่อ try คุณจะต้องใช้ไวยากรณ์ชื่อเรียกแบบ raw ในรูปแบบ r#try เพื่อเรียกใช้งานฟังก์ชันดังกล่าวจากโค้ดของคุณในฉบับที่ใหม่กว่า สามารถดูรายละเอียดเพิ่มเติมเกี่ยวกับฉบับต่าง ๆ ของ Rust ได้ในภาคผนวก E
B - ตัวดำเนินการและสัญลักษณ์
ภาคผนวก B: ตัวดำเนินการและสัญลักษณ์
ภาคผนวกนี้รวบรวมอภิธานศัพท์ไวยากรณ์ (syntax) ของภาษา Rust ซึ่งครอบคลุมทั้งตัวดำเนินการ (operators) และสัญลักษณ์ (symbols) อื่น ๆ ที่ปรากฏแบบเดี่ยว ๆ หรือใช้ในบริบทของพาธ (paths), เจเนอริก (generics), ข้อกำหนดเทรต (trait bounds), มาโคร (macros), แอตทริบิวต์ (attributes), คอมเมนต์ (comments), ทูเพิล (tuples) และวงเล็บรูปแบบต่าง ๆ
ตัวดำเนินการ
ตารางที่ B-1 รวบรวมตัวดำเนินการต่าง ๆ ใน Rust พร้อมตัวอย่างการใช้งานในบริบท คำอธิบายโดยสังเขป และระบุว่าตัวดำเนินการนั้นสามารถโอเวอร์โหลด (overload) ได้หรือไม่ หากสามารถโอเวอร์โหลดได้ จะระบุเทรตที่เกี่ยวข้องซึ่งใช้ในการโอเวอร์โหลดตัวดำเนินการดังกล่าวไว้ด้วย
ตารางที่ B-1: ตัวดำเนินการ
| ตัวดำเนินการ | ตัวอย่าง | คำอธิบาย | โอเวอร์โหลดได้หรือไม่ |
|---|---|---|---|
! | ident!(...), ident!{...}, ident![...] | การขยายมาโคร | |
! | !expr | การกลับบิตหรือนิเสธเชิงตรรกะ | Not |
!= | expr != expr | การเปรียบเทียบความไม่เท่ากัน | PartialEq |
% | expr % expr | เศษจากการหารทางคณิตศาสตร์ | Rem |
%= | var %= expr | เศษจากการหารทางคณิตศาสตร์พร้อมกำหนดค่า | RemAssign |
& | &expr, &mut expr | การยืมค่า | |
& | &type, &mut type, &'a type, &'a mut type | ชนิดพอยน์เตอร์อ้างอิงที่ถูกยืม | |
& | expr & expr | AND ระดับบิต | BitAnd |
&= | var &= expr | AND ระดับบิตพร้อมกำหนดค่า | BitAndAssign |
&& | expr && expr | AND เชิงตรรกะแบบลัดวงจร | |
* | expr * expr | การคูณทางคณิตศาสตร์ | Mul |
*= | var *= expr | การคูณทางคณิตศาสตร์พร้อมกำหนดค่า | MulAssign |
* | *expr | การดีเรเฟอเรนซ์ (dereference) | Deref |
* | *const type, *mut type | พอยน์เตอร์ดิบ | |
+ | trait + trait, 'a + trait | ข้อกำหนดชนิดข้อมูลแบบผสม | |
+ | expr + expr | การบวกทางคณิตศาสตร์ | Add |
+= | var += expr | การบวกทางคณิตศาสตร์พร้อมกำหนดค่า | AddAssign |
, | expr, expr | ตัวคั่นอาร์กิวเมนต์และสมาชิก | |
- | - expr | การกลับค่าเป็นลบทางคณิตศาสตร์ | Neg |
- | expr - expr | การลบทางคณิตศาสตร์ | Sub |
-= | var -= expr | การลบทางคณิตศาสตร์พร้อมกำหนดค่า | SubAssign |
-> | fn(...) -> type, |…| -> type | ชนิดข้อมูลของค่าที่คืนกลับสำหรับฟังก์ชันและโคลเชอร์ (closure) | |
. | expr.ident | การเข้าถึงฟิลด์ | |
. | expr.ident(expr, ...) | การเรียกใช้เมธอด | |
. | expr.0, expr.1 และอื่นๆ | การเข้าถึงสมาชิกทูเพิลด้วยดัชนี | |
.. | .., expr.., ..expr, expr..expr | เรนจ์ลิเทอรัลแบบไม่รวมขอบขวา | PartialOrd |
..= | ..=expr, expr..=expr | เรนจ์ลิเทอรัลแบบรวมขอบขวา | PartialOrd |
.. | ..expr | ไวยากรณ์อัปเดตสมาชิกของ struct | |
.. | variant(x, ..), struct_type { x, .. } | การผูกค่าแพตเทิร์นแบบ “และสมาชิกที่เหลือ” | |
... | expr...expr | (เลิกใช้แล้ว ให้ใช้ ..= แทน) ในแพตเทิร์น: แพตเทิร์นเรนจ์แบบรวมขอบเขต | |
/ | expr / expr | การหารทางคณิตศาสตร์ | Div |
/= | var /= expr | การหารทางคณิตศาสตร์พร้อมกำหนดค่า | DivAssign |
: | pat: type, ident: type | ข้อกำหนดชนิดข้อมูล | |
: | ident: expr | การกำหนดค่าเริ่มต้นของฟิลด์ใน struct | |
: | 'a: loop {...} | ป้ายกำกับของลูป | |
; | expr; | ตัวปิดท้ายสเตตเมนต์และไอเท็ม | |
; | [...; len] | ส่วนหนึ่งของไวยากรณ์อาร์เรย์ขนาดคงที่ | |
<< | expr << expr | การเลื่อนบิตไปทางซ้าย | Shl |
<<= | var <<= expr | การเลื่อนบิตไปทางซ้ายพร้อมกำหนดค่า | ShlAssign |
< | expr < expr | การเปรียบเทียบน้อยกว่า | PartialOrd |
<= | expr <= expr | การเปรียบเทียบน้อยกว่าหรือเท่ากับ | PartialOrd |
= | var = expr, ident = type | การกำหนดค่า / ความเทียบเท่า | |
== | expr == expr | การเปรียบเทียบความเท่ากัน | PartialEq |
=> | pat => expr | ส่วนหนึ่งของไวยากรณ์กิ่งของ match | |
> | expr > expr | การเปรียบเทียบมากกว่า | PartialOrd |
>= | expr >= expr | การเปรียบเทียบมากกว่าหรือเท่ากับ | PartialOrd |
>> | expr >> expr | การเลื่อนบิตไปทางขวา | Shr |
>>= | var >>= expr | การเลื่อนบิตไปทางขวาพร้อมกำหนดค่า | ShrAssign |
@ | ident @ pat | การผูกค่าแพตเทิร์นเข้ากับตัวแปร | |
^ | expr ^ expr | XOR ระดับบิต | BitXor |
^= | var ^= expr | XOR ระดับบิตพร้อมกำหนดค่า | BitXorAssign |
| | pat | pat | ทางเลือกของแพตเทิร์น | |
| | expr | expr | OR ระดับบิต | BitOr |
|= | var |= expr | OR ระดับบิตพร้อมกำหนดค่า | BitOrAssign |
|| | expr || expr | OR เชิงตรรกะแบบลัดวงจร | |
? | expr? | การส่งต่อข้อผิดพลาด |
สัญลักษณ์ที่ไม่ใช่ตัวดำเนินการ
ตารางต่อไปนี้รวบรวมสัญลักษณ์ทั้งหมดที่ไม่ได้ทำหน้าที่เป็นตัวดำเนินการ กล่าวคือ สัญลักษณ์เหล่านี้ไม่ได้มีพฤติกรรมเสมือนการเรียกฟังก์ชันหรือเมธอด
ตารางที่ B-2 แสดงสัญลักษณ์ที่ปรากฏเดี่ยวๆ และใช้ได้ในหลากหลายตำแหน่ง
ตารางที่ B-2: ไวยากรณ์แบบเดี่ยว
| สัญลักษณ์ | คำอธิบาย |
|---|---|
'ident | ช่วงอายุที่มีชื่อหรือป้ายกำกับของลูป |
ตัวเลขที่ตามด้วย u8, i32, f64, usize และอื่นๆ ทันที | ลิเทอรัลตัวเลขที่มีชนิดข้อมูลระบุกำกับไว้ |
"..." | สตริงลิเทอรัล |
r"...", r#"..."#, r##"..."## และอื่นๆ | สตริงลิเทอรัลแบบ raw โดยไม่มีการแปลง escape characters |
b"..." | ไบต์สตริงลิเทอรัล; สร้างอาร์เรย์ของไบต์แทนสตริง |
br"...", br#"..."#, br##"..."## และอื่นๆ | ไบต์สตริงลิเทอรัลแบบ raw; การผสมผสานของสตริงลิเทอรัลแบบ raw และไบต์สตริงลิเทอรัล |
'...' | อักขระลิเทอรัล |
b'...' | ไบต์ลิเทอรัล ASCII |
|…| expr | โคลเชอร์ |
! | ชนิด bottom type ที่ว่างเปล่าเสมอสำหรับฟังก์ชันที่ไม่คืนค่ากลับ |
_ | การผูกค่าแพตเทิร์นแบบ “ไม่สนใจค่า”; ยังใช้คั่นตัวเลขจำนวนเต็มเพื่อให้อ่านง่ายขึ้น |
ตารางที่ B-3 แสดงสัญลักษณ์ที่ปรากฏในบริบทของพาธที่ลากผ่านลำดับชั้นของมอดูลไปยังไอเท็ม
ตารางที่ B-3: ไวยากรณ์ที่เกี่ยวกับพาธ
| สัญลักษณ์ | คำอธิบาย |
|---|---|
ident::ident | พาธของเนมสเปซ |
::path | พาธที่สัมพัทธ์กับรูทของเครต (พาธแบบสัมบูรณ์อย่างชัดเจน) |
self::path | พาธที่สัมพัทธ์กับมอดูลปัจจุบัน (พาธแบบสัมพัทธ์อย่างชัดเจน) |
super::path | พาธที่สัมพัทธ์กับมอดูลแม่ของมอดูลปัจจุบัน |
type::ident, <type as trait>::ident | ค่าคงที่ ฟังก์ชัน และชนิดข้อมูลร่วม (associated items) |
<type>::... | ไอเท็มร่วมของชนิดข้อมูลที่ไม่สามารถระบุชื่อได้โดยตรง (ตัวอย่างเช่น <&T>::..., <[T]>::... และอื่นๆ) |
trait::method(...) | การแยกความกำกวมของการเรียกเมธอดโดยระบุชื่อเทรตที่นิยามเมธอดนั้น |
type::method(...) | การแยกความกำกวมของการเรียกเมธอดโดยระบุชื่อชนิดข้อมูลที่นิยามเมธอดนั้น |
<type as trait>::method(...) | การแยกความกำกวมของการเรียกเมธอดโดยระบุทั้งชื่อเทรตและชนิดข้อมูล |
ตารางที่ B-4 แสดงสัญลักษณ์ที่ปรากฏในบริบทของการใช้พารามิเตอร์ชนิดข้อมูลเจเนอริก
ตารางที่ B-4: เจเนอริก
| สัญลักษณ์ | คำอธิบาย |
|---|---|
path<...> | ระบุพารามิเตอร์ให้กับชนิดเจเนอริกในชนิดข้อมูล (ตัวอย่างเช่น Vec<u8>) |
path::<...>, method::<...> | ระบุพารามิเตอร์ให้กับชนิดเจเนอริก ฟังก์ชัน หรือเมธอดในนิพจน์; มักเรียกกันว่า เทอร์โบฟิช (turbofish) (ตัวอย่างเช่น "42".parse::<i32>()) |
fn ident<...> ... | นิยามฟังก์ชันเจเนอริก |
struct ident<...> ... | นิยาม struct เจเนอริก |
enum ident<...> ... | นิยาม enum เจเนอริก |
impl<...> ... | นิยามการอิมพลีเมนต์เจเนอริก |
for<...> type | ข้อกำหนดช่วงอายุแบบ higher-ranked (higher-ranked lifetime bounds) |
type<ident=type> | ชนิดเจเนอริกที่กำหนดค่าเฉพาะให้กับชนิดข้อมูลร่วมหนึ่งตัวหรือมากกว่า (ตัวอย่างเช่น Iterator<Item=T>) |
ตารางที่ B-5 แสดงสัญลักษณ์ที่ปรากฏในบริบทของการจำกัดพารามิเตอร์ชนิดข้อมูลเจเนอริกด้วยข้อกำหนดเทรต
ตารางที่ B-5: ข้อจำกัดจากข้อกำหนดเทรต
| สัญลักษณ์ | คำอธิบาย |
|---|---|
T: U | พารามิเตอร์เจเนอริก T ถูกจำกัดให้ใช้กับชนิดข้อมูลที่อิมพลีเมนต์เทรต U |
T: 'a | ชนิดเจเนอริก T ต้องมีช่วงอายุยืนยาวกว่าช่วงอายุ 'a (หมายความว่าชนิดข้อมูลนั้นต้องไม่มีการอ้างอิงที่มีช่วงอายุสั้นกว่า 'a ปะปนอยู่ แม้โดยอ้อม) |
T: 'static | ชนิดเจเนอริก T ต้องไม่มีการอ้างอิงที่ถูกยืมอื่นใดนอกจากที่เป็น 'static |
'b: 'a | ช่วงอายุเจเนอริก 'b ต้องยืนยาวกว่าช่วงอายุ 'a |
T: ?Sized | ยินยอมให้พารามิเตอร์ชนิดข้อมูลเจเนอริกเป็นชนิดข้อมูลขนาดไม่คงที่ขณะคอมไพล์ได้ |
'a + trait, trait + trait | ข้อกำหนดชนิดข้อมูลแบบผสม |
ตารางที่ B-6 แสดงสัญลักษณ์ที่ปรากฏในบริบทของการเรียกหรือนิยามมาโคร และการระบุแอตทริบิวต์บนไอเท็ม
ตารางที่ B-6: มาโครและแอตทริบิวต์
| สัญลักษณ์ | คำอธิบาย |
|---|---|
#[meta] | แอตทริบิวต์ภายนอก |
#![meta] | แอตทริบิวต์ภายใน |
$ident | การแทนที่ตัวแปรของมาโคร |
$ident:kind | ตัวแปรระดับเมตาของมาโคร |
$(...)... | การทำซ้ำของมาโคร |
ident!(...), ident!{...}, ident![...] | การเรียกใช้มาโคร |
ตารางที่ B-7 แสดงสัญลักษณ์ที่ใช้สร้างคอมเมนต์
ตารางที่ B-7: คอมเมนต์
| สัญลักษณ์ | คำอธิบาย |
|---|---|
// | คอมเมนต์บรรทัดเดียว |
//! | คอมเมนต์เอกสารบรรทัดเดียวแบบภายใน |
/// | คอมเมนต์เอกสารบรรทัดเดียวแบบภายนอก |
/*...*/ | คอมเมนต์แบบบล็อก |
/*!...*/ | คอมเมนต์เอกสารแบบบล็อกภายใน |
/**...*/ | คอมเมนต์เอกสารแบบบล็อกภายนอก |
ตารางที่ B-8 แสดงบริบทที่มีการใช้วงเล็บ
ตารางที่ B-8: วงเล็บ
| สัญลักษณ์ | คำอธิบาย |
|---|---|
() | ทูเพิลว่างเปล่า (ยูนิต หรือ unit) ทั้งในรูปของลิเทอรัลและชนิดข้อมูล |
(expr) | นิพจน์ที่อยู่ในวงเล็บ |
(expr,) | นิพจน์ทูเพิลที่มีสมาชิกตัวเดียว |
(type,) | ชนิดข้อมูลทูเพิลที่มีสมาชิกตัวเดียว |
(expr, ...) | นิพจน์ทูเพิล |
(type, ...) | ชนิดข้อมูลทูเพิล |
expr(expr, ...) | นิพจน์การเรียกใช้ฟังก์ชัน; ใช้กำหนดค่าเริ่มต้นให้ struct แบบทูเพิลและวาเรียนต์แบบทูเพิลของ enum ด้วย |
ตารางที่ B-9 แสดงบริบทที่มีการใช้วงเล็บปีกกา
ตารางที่ B-9: วงเล็บปีกกา
| บริบท | คำอธิบาย |
|---|---|
{...} | นิพจน์บล็อก |
Type {...} | ลิเทอรัล struct |
ตารางที่ B-10 แสดงบริบทที่มีการใช้วงเล็บเหลี่ยม
ตารางที่ B-10: วงเล็บเหลี่ยม
| บริบท | คำอธิบาย |
|---|---|
[...] | ลิเทอรัลอาร์เรย์ |
[expr; len] | ลิเทอรัลอาร์เรย์ที่บรรจุ expr ซ้ำกันจำนวน len ตัว |
[type; len] | ชนิดข้อมูลอาร์เรย์ที่บรรจุสมาชิกชนิด type จำนวน len อินสแตนซ์ |
expr[expr] | การเข้าถึงสมาชิกคอลเลกชันด้วยดัชนี; โอเวอร์โหลดได้ (Index, IndexMut) |
expr[..], expr[a..], expr[..b], expr[a..b] | การเข้าถึงสมาชิกคอลเลกชันในลักษณะการตัดสไลซ์ โดยใช้ Range, RangeFrom, RangeTo หรือ RangeFull เป็น “ดัชนี” |
C - เทรตที่ derive ได้
ภาคผนวก C: เทรตที่ derive ได้
ในหลายส่วนของหนังสือเล่มนี้ เราได้กล่าวถึงแอตทริบิวต์ derive ซึ่งคุณสามารถนำไปใช้งานกับนิยามของ struct หรือ enum ได้ โดยแอตทริบิวต์ derive จะสร้างโค้ดสำหรับอิมพลีเมนต์เทรต (traits) ตามพฤติกรรมเริ่มต้นของเทรตนั้น ๆ ให้กับชนิดข้อมูลที่คุณกำกับด้วยไวยากรณ์ derive โดยอัตโนมัติ
ในภาคผนวกนี้ เรารวบรวมข้อมูลอ้างอิงของเทรตทั้งหมดในไลบรารีมาตรฐานที่คุณสามารถใช้งานร่วมกับ derive ได้ โดยในแต่ละหัวข้อย่อยจะครอบคลุมเนื้อหาดังนี้:
- การ derive เทรตนี้จะเปิดใช้งานตัวดำเนินการและเมธอดใดบ้าง
- โค้ดที่
deriveสร้างขึ้นมาทำหน้าที่อะไรบ้าง - การอิมพลีเมนต์เทรตนี้บ่งบอกถึงคุณสมบัติใดของชนิดข้อมูล
- เงื่อนไขที่อนุญาตหรือไม่อนุญาตให้อิมพลีเมนต์เทรตนั้น
- ตัวอย่างการทำงานที่จำเป็นต้องอาศัยเทรตนั้น
หากคุณต้องการให้มีพฤติกรรมการทำงานที่แตกต่างไปจากที่แอตทริบิวต์ derive จัดเตรียมไว้ โปรดศึกษาเอกสารของไลบรารีมาตรฐาน สำหรับแต่ละเทรต เพื่อดูรายละเอียดวิธีการเขียนโค้ดอิมพลีเมนต์ด้วยตนเอง
เทรตที่ระบุไว้ในบทนี้คือเทรตทั้งหมดในไลบรารีมาตรฐานที่รองรับการอิมพลีเมนต์บนชนิดข้อมูลของคุณผ่าน derive ส่วนเทรตอื่น ๆ ที่นิยามไว้ในไลบรารีมาตรฐานจะไม่มีพฤติกรรมเริ่มต้นที่เหมาะสมในตัวเอง จึงขึ้นอยู่กับคุณที่จะต้องอิมพลีเมนต์เทรตเหล่านั้นให้สอดคล้องกับวัตถุประสงค์การใช้งานของคุณเอง
ตัวอย่างหนึ่งของเทรตที่ไม่สามารถ derive ได้คือ Display ซึ่งมีหน้าที่จัดการการจัดรูปแบบข้อความสำหรับแสดงผลแก่ผู้ใช้งานปลายทาง คุณควรพิจารณาเสมอว่ารูปแบบการแสดงผลที่เหมาะสมสำหรับผู้ใช้ควรเป็นอย่างไร ผู้ใช้ควรเห็นข้อมูลส่วนใดบ้าง? ข้อมูลส่วนใดที่เกี่ยวข้องและเป็นประโยชน์ต่อพวกเขามากที่สุด? ซึ่งคอมไพเลอร์ของ Rust ย่อมไม่อาจล่วงรู้บริบทเหล่านี้ได้ จึงไม่สามารถกำหนดพฤติกรรมเริ่มต้นที่เหมาะสมให้คุณได้โดยอัตโนมัติ
อนึ่ง รายการเทรตที่ derive ได้ในภาคผนวกนี้ไม่ได้จำกัดอยู่เพียงเท่านี้ เนื่องจากไลบรารีภายนอกต่าง ๆ สามารถสร้าง derive สำหรับเทรตของตนเองขึ้นมาได้ ทำให้รายการเทรตที่คุณสามารถใช้ร่วมกับ derive นั้นเปิดกว้างอย่างไร้ขีดจำกัด การสร้าง derive ขึ้นมาเองเกี่ยวข้องกับการเขียนมาโครเชิงกระบวนการ (procedural macros) ซึ่งเราได้อธิบายไว้ในหัวข้อ“มาโคร derive แบบกำหนดเอง” ในบทที่ 20
Debug สำหรับเอาต์พุตของโปรแกรมเมอร์
เทรต Debug ช่วยเปิดใช้งานการจัดรูปแบบสำหรับการดีบัก (debug formatting) ในสตริงจัดรูปแบบ ซึ่งคุณสามารถระบุได้โดยใส่ :? ไว้ภายในตัวแทนค่า {}
เทรต Debug ช่วยให้คุณพิมพ์ค่าของอินสแตนซ์ออกมาเพื่อการตรวจสอบและดีบัก เพื่อให้คุณและนักพัฒนาคนอื่น ๆ สามารถตรวจสอบค่าของอินสแตนซ์ ณ จุดต่าง ๆ ระหว่างที่โปรแกรมกำลังทำงานได้
ตัวอย่างเช่น การใช้งานมาโคร assert_eq! จำเป็นต้องอาศัยเทรต Debug เนื่องจากมาโครนี้จะพิมพ์ค่าของอินสแตนซ์ที่ส่งเข้ามาหากการตรวจสอบความเท่ากันล้มเหลว เพื่อให้นักพัฒนาสามารถมองเห็นได้อย่างชัดเจนว่าทำไมค่าทั้งสองจึงไม่เท่ากัน
PartialEq และ Eq สำหรับการเปรียบเทียบความเท่ากัน
เทรต PartialEq ช่วยให้คุณสามารถเปรียบเทียบอินสแตนซ์ของชนิดข้อมูลเพื่อตรวจสอบความเท่ากัน และเปิดใช้งานตัวดำเนินการ == และ !=
การ derive PartialEq จะสร้างเมธอด eq ขึ้นมา โดยเมื่อ derive บน struct อินสแตนซ์สองตัวจะเท่ากันก็ต่อเมื่อฟิลด์ ทั้งหมด มีค่าเท่ากัน และจะไม่เท่ากันหากมีฟิลด์ ใดฟิลด์หนึ่ง ไม่เท่ากัน ส่วนเมื่อ derive บน enum แต่ละวาเรียนต์จะเท่ากับตัวมันเอง และไม่เท่ากับวาเรียนต์อื่น ๆ
การใช้งานมาโคร assert_eq! จำเป็นต้องอาศัยเทรต PartialEq เพื่อให้สามารถเปรียบเทียบความเท่ากันของอินสแตนซ์ทั้งสองได้
เทรต Eq ไม่มีเมธอดใด ๆ ในตัว หน้าที่ของมันคือการบ่งชี้ว่า ทุก ๆ ค่าของชนิดข้อมูลนั้นจะเท่ากับตัวมันเองเสมอ (reflexive property) โดยเทรต Eq สามารถใช้ได้เฉพาะกับชนิดข้อมูลที่อิมพลีเมนต์ PartialEq อยู่แล้วเท่านั้น ทว่าไม่ใช่ทุกชนิดข้อมูลที่อิมพลีเมนต์ PartialEq จะสามารถอิมพลีเมนต์ Eq ได้ ตัวอย่างเช่น ชนิดข้อมูลตัวเลขทศนิยม (floating-point numbers): ข้อกำหนดของตัวเลขทศนิยมระบุว่าค่า Not-a-Number (NaN) สองค่าจะไม่เท่ากัน
ตัวอย่างการใช้งานที่จำเป็นต้องมี Eq คือการนำชนิดข้อมูลไปใช้เป็นคีย์ใน HashMap<K, V> เพื่อให้ HashMap สามารถตรวจสอบได้ว่าคีย์สองตัวเป็นคีย์เดียวกันจริงหรือไม่
PartialOrd และ Ord สำหรับการเปรียบเทียบการเรียงลำดับ
เทรต PartialOrd ช่วยให้คุณสามารถเปรียบเทียบอินสแตนซ์ของชนิดข้อมูลเพื่อการจัดเรียงลำดับ ชนิดข้อมูลที่อิมพลีเมนต์ PartialOrd จะสามารถใช้ตัวดำเนินการ <, >, <= และ >= ได้ โดยคุณสามารถนำเทรต PartialOrd ไปใช้ได้เฉพาะกับชนิดข้อมูลที่อิมพลีเมนต์ PartialEq อยู่แล้วเท่านั้น
การ derive PartialOrd จะสร้างเมธอด partial_cmp ซึ่งคืนค่าเป็น Option<Ordering> โดยจะมีค่าเป็น None หากค่าที่นำมาเปรียบเทียบไม่สามารถจัดเรียงลำดับกันได้ ตัวอย่างของค่าที่ไม่สามารถเปรียบเทียบเพื่อเรียงลำดับได้แม้ค่าอื่น ๆ ส่วนใหญ่ของชนิดนั้นจะเปรียบเทียบได้ ก็คือค่า NaN ของเลขทศนิยม การเรียกใช้ partial_cmp ระหว่างตัวเลขทศนิยมใด ๆ กับค่า NaN จะได้ผลลัพธ์เป็น None เสมอ
เมื่อ derive บน struct เทรต PartialOrd จะเปรียบเทียบอินสแตนซ์สองตัวโดยเทียบค่าของแต่ละฟิลด์ตามลำดับที่ฟิลด์นั้นปรากฏในนิยามของ struct ส่วนเมื่อ derive บน enum วาเรียนต์ที่ประกาศไว้ก่อนหน้าในนิยามของ enum จะถือว่ามีค่าน้อยกว่าวาเรียนต์ที่ประกาศไว้ทีหลัง
ตัวอย่างการใช้งานที่ต้องอาศัยเทรต PartialOrd เช่น เมธอด gen_range จากเครต rand ซึ่งทำหน้าที่สุ่มค่าตัวเลขในช่วงที่กำหนดผ่านนิพจน์เรนจ์
เทรต Ord บ่งบอกว่า สำหรับสองค่าใด ๆ ของชนิดข้อมูลนั้น จะสามารถเปรียบเทียบเพื่อหาลำดับที่แน่นอนได้เสมอ โดยเทรต Ord จะอิมพลีเมนต์เมธอด cmp ซึ่งคืนค่าเป็น Ordering โดยตรง (ไม่ใช่ Option<Ordering>) เพราะสามารถเปรียบเทียบลำดับได้แน่นอนเสมอ คุณสามารถนำเทรต Ord ไปใช้ได้เฉพาะกับชนิดข้อมูลที่อิมพลีเมนต์ทั้ง PartialOrd และ Eq แล้วเท่านั้น (และ Eq ก็ต้องใช้ PartialEq ด้วย) เมื่อ derive บน struct และ enum เมธอด cmp จะทำงานในลักษณะเดียวกับ partial_cmp ของ PartialOrd
ตัวอย่างการใช้งานที่จำเป็นต้องอาศัย Ord เช่น การจัดเก็บข้อมูลใน BTreeSet<T> ซึ่งเป็นโครงสร้างข้อมูลที่จัดเก็บสมาชิกตามลำดับการเรียงของค่า
Clone และ Copy สำหรับการทำสำเนาค่า
เทรต Clone ช่วยให้คุณสามารถทำสำเนาแบบลึก (deep copy) ของค่าหนึ่งได้อย่างชัดเจน ซึ่งกระบวนการทำสำเนานี้อาจเกี่ยวข้องกับการรันโค้ดใด ๆ และการคัดลอกข้อมูลบนฮีป (heap) ดูรายละเอียดเพิ่มเติมเกี่ยวกับ Clone ได้ในหัวข้อ“ตัวแปรและข้อมูลที่ปฏิสัมพันธ์กันด้วยการโคลน” ในบทที่ 4
การ derive Clone จะสร้างเมธอด clone ขึ้นมา ซึ่งเมื่ออิมพลีเมนต์สำหรับชนิดข้อมูลโดยรวม ก็จะทำการเรียก clone กับแต่ละส่วนประกอบของชนิดข้อมูลนั้นด้วย นั่นหมายความว่าฟิลด์หรือค่าทั้งหมดในชนิดข้อมูลนั้นจะต้องอิมพลีเมนต์ Clone ด้วยเช่นกันจึงจะสามารถ derive Clone ได้
ตัวอย่างกรณีที่จำเป็นต้องใช้ Clone เช่น การเรียกเมธอด to_vec บนสไลซ์ (slice) เนื่องจากสไลซ์ไม่ได้เป็นเจ้าของอินสแตนซ์ที่มันบรรจุอยู่ แต่เวกเตอร์ที่ได้จาก to_vec จำเป็นต้องเป็นเจ้าของอินสแตนซ์เหล่านั้น เมธอด to_vec จึงต้องเรียก clone บนแต่ละสมาชิก ดังนั้นชนิดข้อมูลที่จัดเก็บอยู่ในสไลซ์จึงต้องอิมพลีเมนต์ Clone
เทรต Copy ช่วยให้คุณสามารถทำสำเนาค่าได้ด้วยการคัดลอกเฉพาะข้อมูลบิตที่อยู่บนสแตก (stack) เท่านั้น โดยไม่ต้องรันโค้ดเพิ่มเติมใด ๆ ดูรายละเอียดเพิ่มเติมเกี่ยวกับ Copy ได้ในหัวข้อ“ข้อมูลบนสแตกเท่านั้น: การคัดลอกค่า” ในบทที่ 4
เทรต Copy ไม่ได้นิยามเมธอดใด ๆ ไว้ เพื่อป้องกันไม่ให้นักพัฒนาไปโอเวอร์โหลดเมธอดเหล่านั้นจนละเมิดข้อตกลงที่ว่าต้องไม่มีการรันโค้ดซับซ้อนใด ๆ เกิดขึ้น ด้วยเหตุนี้ นักพัฒนาทุกคนจึงสามารถมั่นใจได้ว่าการคัดลอกค่าของชนิดข้อมูลที่เป็น Copy จะรวดเร็วอย่างยิ่งเสมอ
คุณสามารถ derive Copy บนชนิดข้อมูลใด ๆ ที่ทุกส่วนประกอบอิมพลีเมนต์ Copy อยู่แล้ว โดยชนิดข้อมูลที่อิมพลีเมนต์ Copy จะต้องอิมพลีเมนต์ Clone ด้วยเสมอ เพราะชนิดข้อมูลที่อิมพลีเมนต์ Copy จะมีการอิมพลีเมนต์ Clone แบบพื้นฐานที่ทำหน้าที่เช่นเดียวกับ Copy
เทรต Copy แทบไม่ค่อยมีข้อกำหนดบังคับใช้ ชนิดข้อมูลที่อิมพลีเมนต์ Copy จะได้รับประโยชน์จากการปรับปรุงประสิทธิภาพ ทำให้คุณไม่จำเป็นต้องคอยเรียก clone ช่วยให้โค้ดกระชับขึ้น
ทุกสิ่งที่คุณทำได้ด้วย Copy คุณก็สามารถทำได้ด้วย Clone เช่นกัน เพียงแต่โค้ดอาจทำงานช้ากว่า หรือต้องคอยเรียก clone ในบางจุด
Hash สำหรับการแมปค่าหนึ่งไปยังค่าที่มีขนาดคงที่
เทรต Hash ช่วยให้คุณนำอินสแตนซ์ของชนิดข้อมูลที่มีขนาดใด ๆ มาแปลง (map) ให้เป็นค่าที่มีขนาดคงที่ผ่านฟังก์ชันแฮช (hash function) การ derive Hash จะสร้างเมธอด hash ขึ้นมา ซึ่งจะนำผลลัพธ์จากการเรียก hash บนแต่ละส่วนประกอบของชนิดข้อมูลมารวมเข้าด้วยกัน นั่นหมายความว่าฟิลด์หรือค่าทั้งหมดในชนิดข้อมูลต้องอิมพลีเมนต์ Hash ด้วยจึงจะสามารถ derive Hash ได้
ตัวอย่างกรณีที่ต้องใช้ Hash คือการนำไปใช้เป็นคีย์ใน HashMap<K, V> เพื่อให้สามารถจัดเก็บและค้นหาข้อมูลได้อย่างมีประสิทธิภาพ
Default สำหรับค่าเริ่มต้น
เทรต Default ช่วยให้คุณสร้างค่าเริ่มต้นสำหรับชนิดข้อมูลได้ การ derive Default จะสร้างฟังก์ชัน default ขึ้นมา ซึ่งจะเรียกฟังก์ชัน default บนแต่ละส่วนประกอบของชนิดข้อมูล นั่นหมายความว่าฟิลด์หรือค่าทั้งหมดในชนิดข้อมูลต้องอิมพลีเมนต์ Default ด้วยจึงจะสามารถ derive Default ได้
ฟังก์ชัน Default::default มักนิยมนำมาใช้ร่วมกับไวยากรณ์อัปเดต struct ดังที่ได้กล่าวถึงในหัวข้อ“การสร้างอินสแตนซ์ด้วยไวยากรณ์อัปเดต struct” ในบทที่ 5 คุณสามารถกำหนดค่าเฉพาะให้กับฟิลด์เพียงไม่กี่ฟิลด์ แล้วใช้ค่าเริ่มต้นสำหรับฟิลด์ที่เหลือด้วยคำสั่ง ..Default::default()
ตัวอย่างกรณีที่จำเป็นต้องใช้เทรต Default เช่น การเรียกเมธอด unwrap_or_default บนอินสแตนซ์ของ Option<T> หาก Option<T> มีค่าเป็น None เมธอด unwrap_or_default จะคืนค่าผลลัพธ์ของ Default::default สำหรับชนิดข้อมูล T ที่บรรจุอยู่ใน Option<T> ออกมา
D - เครื่องมือพัฒนาที่มีประโยชน์
ภาคผนวก D: เครื่องมือพัฒนาที่มีประโยชน์
ในภาคผนวกนี้ เราจะพูดถึงเครื่องมือพัฒนาที่เป็นประโยชน์ซึ่งโปรเจกต์ Rust มีมาให้พร้อมใช้งาน เราจะได้เรียนรู้เกี่ยวกับการจัดรูปแบบโค้ดอัตโนมัติ (automatic formatting), วิธีแก้ไขคำเตือนของคอมไพเลอร์อย่างรวดเร็ว, เครื่องมือตรวจสอบคุณภาพโค้ด (linter) และการเชื่อมต่อทำงานร่วมกับโปรแกรม IDE
การจัดรูปแบบอัตโนมัติด้วย rustfmt
เครื่องมือ rustfmt จะจัดรูปแบบโค้ดของคุณใหม่ตามมาตรฐานรูปแบบโค้ดที่เป็นสากลของชุมชนนักพัฒนา Rust โปรเจกต์ที่ต้องทำงานร่วมกันหลายคนมักนำ rustfmt มาใช้เพื่อป้องกันการถกเถียงเรื่องรูปแบบการเขียนโค้ด โดยให้ทุกคนจัดรูปแบบโค้ดด้วยเครื่องมือตัวนี้เหมือนกันทั้งหมด
ชุดติดตั้งของ Rust จะรวม rustfmt มาให้เป็นค่าเริ่มต้นอยู่แล้ว ดังนั้นคุณจึงควรมีโปรแกรม rustfmt และ cargo-fmt อยู่ในระบบของคุณเรียบร้อยแล้ว โดยคำสั่งทั้งสองนี้มีความสัมพันธ์กันคล้ายกับ rustc และ cargo กล่าวคือ rustfmt จะให้การควบคุมที่ละเอียดยิบย่อยกว่า ส่วน cargo-fmt จะเข้าใจแบบแผนโครงสร้างของโปรเจกต์ที่จัดการด้วย Cargo หากต้องการจัดรูปแบบโค้ดของโปรเจกต์ Cargo ใด ๆ ให้พิมพ์คำสั่งต่อไปนี้:
$ cargo fmt
การรันคำสั่งนี้จะจัดรูปแบบโค้ด Rust ทั้งหมดในเครตปัจจุบันใหม่ โดยจะเปลี่ยนเฉพาะรูปแบบการจัดวางโค้ดเท่านั้น ไม่ได้เปลี่ยนแปลงความหมายหรือพฤติกรรมการทำงานของโค้ด สามารถดูข้อมูลเพิ่มเติมเกี่ยวกับ rustfmt ได้ในเอกสารประกอบอย่างเป็นทางการ
แก้ไขโค้ดของคุณด้วย rustfix
เครื่องมือ rustfix รวมมาพร้อมกับการติดตั้ง Rust และสามารถแก้ไขคำเตือนของคอมไพเลอร์ (compiler warnings) ได้โดยอัตโนมัติ เมื่อมีแนวทางแก้ไขปัญหาที่ชัดเจนซึ่งตรงกับสิ่งที่คุณต้องการ คุณน่าจะเคยเห็นคำเตือนของคอมไพเลอร์กันมาบ้างแล้ว ตัวอย่างเช่น พิจารณาโค้ดต่อไปนี้:
ชื่อไฟล์: src/main.rs
fn main() {
let mut x = 42;
println!("{x}");
}ในที่นี้ เราประกาศตัวแปร x ให้เปลี่ยนแปลงค่าได้ (mutable) ทว่าในความเป็นจริงเราไม่เคยแก้ไขค่าของมันเลย Rust จึงแจ้งเตือนเราเกี่ยวกับเรื่องนี้:
$ cargo build
Compiling myprogram v0.1.0 (file:///projects/myprogram)
warning: variable does not need to be mutable
--> src/main.rs:2:9
|
2 | let mut x = 0;
| ----^
| |
| help: remove this `mut`
|
= note: `#[warn(unused_mut)]` on by default
คำเตือนแนะนำให้เราลบคีย์เวิร์ด mut ออก เราสามารถนำคำแนะนำดังกล่าวมาปรับใช้กับโค้ดได้โดยอัตโนมัติผ่านเครื่องมือ rustfix ด้วยการรันคำสั่ง cargo fix:
$ cargo fix
Checking myprogram v0.1.0 (file:///projects/myprogram)
Fixing src/main.rs (1 fix)
Finished dev [unoptimized + debuginfo] target(s) in 0.59s
เมื่อเราเปิดดูไฟล์ src/main.rs อีกครั้ง จะพบว่า cargo fix ได้แก้ไขโค้ดให้เราเรียบร้อยแล้ว:
ชื่อไฟล์: src/main.rs
fn main() {
let x = 42;
println!("{x}");
}ตอนนี้ตัวแปร x กลายเป็นแบบเปลี่ยนแปลงค่าไม่ได้ (immutable) และข้อความแจ้งเตือนก็หายไปแล้ว
นอกจากนี้ คุณยังสามารถใช้คำสั่ง cargo fix ในการแปลงย้ายโค้ดของคุณข้ามระหว่างฉบับ (editions) ต่าง ๆ ของ Rust ได้อีกด้วย โดยสามารถอ่านรายละเอียดเรื่องฉบับของ Rust ได้ในภาคผนวก E
ลินต์เพิ่มเติมด้วย Clippy
เครื่องมือ Clippy เป็นชุดเครื่องมือตรวจสอบโค้ด (linter) ที่ช่วยวิเคราะห์โค้ดของคุณ เพื่อให้คุณสามารถตรวจจับข้อผิดพลาดที่พบบ่อยและปรับปรุงโค้ด Rust ของคุณให้มีคุณภาพดียิ่งขึ้น โดย Clippy ถูกรวมมาพร้อมกับชุดติดตั้งมาตรฐานของ Rust แล้ว
หากต้องการรันการตรวจสอบของ Clippy บนโปรเจกต์ Cargo ใด ๆ ให้พิมพ์คำสั่งต่อไปนี้:
$ cargo clippy
ตัวอย่างเช่น สมมติว่าคุณเขียนโปรแกรมที่ใช้ค่าประมาณของค่าคงตัวทางคณิตศาสตร์อย่างค่าพาย (pi) ดังเช่นในโค้ดนี้:
fn main() {
let x = 3.1415;
let r = 8.0;
println!("the area of the circle is {}", x * r * r);
}เมื่อรันคำสั่ง cargo clippy บนโปรเจกต์นี้ จะได้ผลลัพธ์เป็นข้อความเตือนดังนี้:
error: approximate value of `f{32, 64}::consts::PI` found
--> src/main.rs:2:13
|
2 | let x = 3.1415;
| ^^^^^^
|
= note: `#[deny(clippy::approx_constant)]` on by default
= help: consider using the constant directly
= help: for further information visit https://rust-lang.github.io/rust-clippy/master/index.html#approx_constant
ข้อความนี้ชี้แจงให้คุณทราบว่า ภาษา Rust มีการนิยามค่าคงตัว PI ที่มีความแม่นยำสูงกว่าเตรียมไว้ให้อยู่แล้ว และโปรแกรมของคุณจะมีความถูกต้องแม่นยำยิ่งขึ้นหากเปลี่ยนมาใช้ค่าคงตัวดังกล่าวแทน จากนั้นคุณก็สามารถแก้ไขโค้ดเพื่อเรียกใช้ค่าคงตัว PI ได้โดยตรง
โค้ดต่อไปนี้จะไม่ทำให้เกิดข้อผิดพลาดหรือคำเตือนใด ๆ จาก Clippy อีก:
fn main() {
let x = std::f64::consts::PI;
let r = 8.0;
println!("the area of the circle is {}", x * r * r);
}สามารถดูข้อมูลเพิ่มเติมเกี่ยวกับ Clippy ได้ในเอกสารประกอบอย่างเป็นทางการ
การผสานรวมกับ IDE ด้วย rust-analyzer
สำหรับการทำงานร่วมกับโปรแกรม IDE ทางชุมชน Rust แนะนำให้ใช้ rust-analyzer ซึ่งเป็นชุดเครื่องมือที่ทำงานประสานกับคอมไพเลอร์และสื่อสารผ่าน Language Server Protocol อันเป็นข้อกำหนดมาตรฐานสำหรับการติดต่อสื่อสารระหว่างโปรแกรม IDE กับภาษาโปรแกรมต่าง ๆ โดยมีโปรแกรมแก้ไขโค้ดหลากหลายตัวที่รองรับการใช้งาน rust-analyzer เช่น ปลั๊กอิน Rust analyzer สำหรับ Visual Studio Code
สามารถเข้าไปดูคำแนะนำในการติดตั้งได้ที่หน้าแรก ของโปรเจกต์ rust-analyzer จากนั้นให้ติดตั้งส่วนขยาย language server ลงใน IDE ที่คุณใช้งาน ซึ่งจะช่วยให้ IDE ของคุณมีความสามารถขั้นสูงต่าง ๆ เพิ่มขึ้นมา เช่น การเติมเต็มโค้ดอัตโนมัติ (autocompletion), การกระโดดไปยังจุดนิยามโค้ด (jump to definition) และการแสดงข้อความแจ้งเตือนข้อผิดพลาดแทรกในบรรทัดโค้ด (inline errors)
E - ฉบับของ Rust
ภาคผนวก E: ฉบับของ Rust
ในบทที่ 1 คุณได้เห็นแล้วว่าคำสั่ง cargo new ได้เพิ่มข้อมูลเมทาดาทาเกี่ยวกับฉบับ (edition) ลงในไฟล์ Cargo.toml ของคุณ ภาคผนวกนี้จะอธิบายว่าสิ่งนั้นมีความหมายอย่างไร!
ภาษา Rust และคอมไพเลอร์มีรอบการเผยแพร่เวอร์ชันใหม่ทุก 6 สัปดาห์ ซึ่งหมายความว่าผู้ใช้งานจะได้รับฟีเจอร์ใหม่ ๆ เข้ามาอย่างต่อเนื่อง ภาษาโปรแกรมอื่น ๆ อาจเลือกปล่อยการเปลี่ยนแปลงครั้งใหญ่แบบนาน ๆ ครั้ง ทว่า Rust เลือกที่จะปล่อยการอัปเดตย่อย ๆ บ่อยกว่า เมื่อเวลาผ่านไป การเปลี่ยนแปลงเล็ก ๆ น้อย ๆ เหล่านี้จะสะสมรวมกันจนเกิดความก้าวหน้าอย่างมีนัยสำคัญ แต่หากมองเปรียบเทียบในแต่ละรอบการเผยแพร่ การจะมองย้อนกลับไปแล้วอุทานว่า “ว้าว ระหว่าง Rust 1.10 กับ Rust 1.31 ภาษา Rust เปลี่ยนไปเยอะมาก!” ก็อาจเป็นเรื่องที่สังเกตเห็นได้ยาก
ทุก ๆ ประมาณ 3 ปี ทีมพัฒนา Rust จะเปิดตัว ฉบับ (edition) ใหม่ของ Rust โดยแต่ละฉบับจะรวบรวมฟีเจอร์ทั้งหมดที่ถูกเพิ่มเข้ามาแล้วให้อยู่ในรูปของแพ็กเกจที่เข้าใจได้ชัดเจน พร้อมด้วยเอกสารประกอบและชุดเครื่องมือที่ได้รับการอัปเดตอย่างสมบูรณ์ ซึ่งฉบับใหม่นี้จะถูกปล่อยออกมาเป็นส่วนหนึ่งของรอบการเผยแพร่ทุก 6 สัปดาห์ตามปกติ
แต่ละฉบับมีจุดประสงค์ที่ตอบโจทย์กลุ่มบุคคลที่แตกต่างกัน:
- สำหรับผู้ใช้งาน Rust ในปัจจุบัน ฉบับใหม่จะรวบรวมการเปลี่ยนแปลงย่อย ๆ มารวมเป็นแพ็กเกจที่เข้าใจและนำไปปรับใช้ได้ง่าย
- สำหรับผู้ที่ยังไม่ได้ใช้งาน ฉบับใหม่คือสัญญาณบ่งบอกว่ามีความก้าวหน้าครั้งสำคัญเกิดขึ้นในภาษา ซึ่งอาจเป็นแรงจูงใจให้หันมาทดลองใช้งาน Rust อีกครั้ง
- สำหรับทีมงานผู้พัฒนาภาษา Rust เอง ฉบับใหม่คือเป้าหมายร่วมและจุดรวมพลังขับเคลื่อนโปรเจกต์ในภาพรวม
ณ ขณะที่เขียนหนังสือเล่มนี้ มีฉบับของ Rust ให้เลือกใช้งานได้ 4 ฉบับ ได้แก่ Rust 2015, Rust 2018, Rust 2021 และ Rust 2024 โดยหนังสือเล่มนี้เขียนขึ้นโดยใช้สำนวนและแบบแผนของ Rust ฉบับ 2024
คีย์ edition ในไฟล์ Cargo.toml จะระบุว่าคอมไพเลอร์ควรประมวลผลโค้ดของคุณตามข้อกำหนดของฉบับใด หากไม่มีการระบุคีย์นี้ Rust จะเลือกใช้ฉบับ 2015 โดยอัตโนมัติเพื่อรักษาความเข้ากันได้ย้อนหลัง (backward compatibility)
แต่ละโปรเจกต์สามารถเลือกเปลี่ยนไปใช้ฉบับอื่นนอกเหนือจากฉบับ 2015 ที่เป็นค่าเริ่มต้นได้ โดยในแต่ละฉบับอาจมีการเปลี่ยนแปลงที่ไม่เข้ากันกับโค้ดเดิม เช่น การเพิ่มคำสงวน (keyword) ใหม่ซึ่งอาจชนกับชื่อตัวระบุ (identifier) ที่เคยตั้งไว้ในโค้ดเดิม ทว่าหากคุณไม่ได้เลือกเปลี่ยนไปใช้ฉบับใหม่ดังกล่าว โค้ดของคุณจะยังคงคอมไพล์ผ่านได้ตามปกติอย่างต่อเนื่อง แม้คุณจะอัปเกรดเวอร์ชันของคอมไพเลอร์ Rust ไปเป็นเวอร์ชันล่าสุดแล้วก็ตาม
คอมไพเลอร์ของ Rust ทุกเวอร์ชันจะรองรับฉบับใดก็ตามที่เปิดตัวมาก่อนการเผยแพร่ของคอมไพเลอร์เวอร์ชันนั้น และสามารถลิงก์เครต (crates) ที่เขียนด้วยฉบับต่าง ๆ เข้าด้วยกันได้อย่างราบรื่น การเปลี่ยนแปลงของฉบับจะมีผลเฉพาะขั้นตอนที่คอมไพเลอร์แยกวิเคราะห์ไวยากรณ์ (parse) โค้ดในเบื้องต้นเท่านั้น ดังนั้น หากโปรเจกต์ของคุณใช้ Rust 2015 แต่ดีเพนเดนซี (dependency) ตัวหนึ่งใช้ Rust 2018 โปรเจกต์ของคุณก็ยังคงคอมไพล์ผ่านและสามารถเรียกใช้งานดีเพนเดนซีนั้นได้โดยไม่มีปัญหา ในทำนองเดียวกัน หากโปรเจกต์ของคุณใช้ Rust 2018 แต่ดีเพนเดนซีใช้ Rust 2015 ก็ทำงานร่วมกันได้อย่างสมบูรณ์แบบเช่นกัน
เพื่อความเข้าใจที่ชัดเจน: ฟีเจอร์ส่วนใหญ่จะเปิดให้ใช้งานได้ในทุกฉบับ นักพัฒนาที่ใช้ Rust ฉบับใดก็ตามจะยังคงได้รับประโยชน์จากการปรับปรุงประสิทธิภาพต่าง ๆ เมื่อมีการปล่อยเวอร์ชันเสถียรใหม่ออกมา อย่างไรก็ตาม ในบางกรณี โดยเฉพาะเมื่อมีการเพิ่มคำสงวนใหม่เข้ามา ฟีเจอร์ใหม่บางอย่างอาจเปิดให้ใช้งานได้เฉพาะในฉบับใหม่เท่านั้น คุณจึงต้องสลับไปใช้ฉบับที่ใหม่กว่าหากต้องการใช้ประโยชน์จากฟีเจอร์เหล่านั้น
สามารถศึกษาข้อมูลและรายละเอียดเพิ่มเติมได้ในคู่มือ The Rust Edition Guide ซึ่งเป็นหนังสือฉบับสมบูรณ์ที่แจกแจงข้อแตกต่างระหว่างฉบับต่าง ๆ และอธิบายวิธีการอัปเกรดโค้ดของคุณไปสู่ฉบับใหม่โดยอัตโนมัติผ่านคำสั่ง cargo fix
F - คำแปลของหนังสือเล่มนี้
ภาคผนวก F: คำแปลของหนังสือเล่มนี้
แหล่งข้อมูลหนังสือในภาษาอื่น ๆ นอกเหนือจากภาษาอังกฤษ ซึ่งส่วนใหญ่ยังอยู่ในระหว่างการจัดทำคำแปล สามารถดูที่ ป้ายกำกับ Translations เพื่อร่วมเป็นส่วนหนึ่งในการแปล หรือแจ้งให้เราทราบเกี่ยวกับโครงการแปลภาษาใหม่ ๆ!
- Português (BR)
- Português (PT)
- 简体中文: KaiserY/trpl-zh-cn, gnu4cn/rust-lang-Zh_CN
- 正體中文
- Українська
- Español, alternate, Español por RustLangES
- Русский
- 한국어
- 日本語
- Français
- Polski
- Cebuano
- Tagalog
- Esperanto
- ελληνική
- Svenska
- Farsi, Persian (FA)
- Deutsch
- हिंदी
- ไทย
- Danske
- O’zbek
- Tiếng Việt
- Italiano
- বাংলা
G - Rust ถูกสร้างขึ้นมาอย่างไร และ "Nightly Rust"
ภาคผนวก G - Rust ถูกสร้างขึ้นมาอย่างไร และ “Nightly Rust”
ภาคผนวกนี้จะอธิบายถึงกระบวนการพัฒนา Rust และสิ่งนั้นส่งผลต่อคุณในฐานะนักพัฒนา Rust อย่างไร
ความเสถียรโดยไม่หยุดนิ่ง
ในฐานะภาษาการโปรแกรม Rust ให้ความสำคัญกับความเสถียรของโค้ดของคุณ_อย่างยิ่งยวด_ เราต้องการให้ Rust เป็นรากฐานอันมั่นคงดั่งหินผาที่คุณสามารถนำไปต่อยอดได้ และหากทุกสิ่งเปลี่ยนแปลงอยู่ตลอดเวลา สิ่งนั้นย่อมเป็นไปไม่ได้ ในขณะเดียวกัน หากเราไม่สามารถทดลองกับฟีเจอร์ใหม่ๆ ได้เลย เราอาจตรวจไม่พบข้อบกพร่องสำคัญจนกระทั่งปล่อยเวอร์ชันใหม่ออกไปแล้ว ซึ่งถึงตอนนั้นเราก็ไม่สามารถแก้ไขอะไรได้อีก
ทางออกของปัญหานี้คือสิ่งที่เราเรียกว่า “ความเสถียรโดยไม่หยุดนิ่ง” (stability without stagnation) และหลักการชี้นำของเราคือ: คุณไม่ควรต้องหวาดกลัวการอัปเกรดไปยัง Rust เวอร์ชันเสถียรรุ่นใหม่เลย การอัปเกรดแต่ละครั้งควรราบรื่นและสร้างภาระน้อยที่สุด แต่ในขณะเดียวกันก็ต้องนำพาฟีเจอร์ใหม่ ลดข้อผิดพลาดลง และช่วยให้คอมไพล์ได้เร็วขึ้นด้วย
ชู ชู! ช่องทางการเผยแพร่และการนั่งรถไฟ
การพัฒนา Rust ดำเนินไปตาม_ตารางเวลารถไฟ_ (train schedule) กล่าวคือ การพัฒนาทั้งหมดจะเกิดขึ้นบนแบรนช์ main ของรีพอซิทอรี Rust การปล่อยเวอร์ชันจะเป็นไปตามโมเดลขบวนรถไฟปล่อยซอฟต์แวร์ (software release train model) ซึ่งคล้ายกับที่ Cisco IOS และโครงการซอฟต์แวร์อื่นๆ เคยนำมาใช้ โดยมี_ช่องทางการเผยแพร่_ (release channel) อยู่สามช่องทางสำหรับ Rust:
- Nightly
- Beta
- Stable
นักพัฒนา Rust ส่วนใหญ่จะใช้ช่องทางการเผยแพร่แบบเสถียร (stable) เป็นหลัก แต่ผู้ที่ต้องการทดลองฟีเจอร์ใหม่เชิงทดลองก็สามารถเลือกใช้ nightly หรือ beta ได้
นี่คือตัวอย่างการทำงานของกระบวนการพัฒนาและการปล่อยเวอร์ชัน: สมมติว่าทีมงาน Rust กำลังพัฒนาเพื่อเตรียมปล่อยเวอร์ชัน Rust 1.5 (การปล่อยเวอร์ชันดังกล่าวเกิดขึ้นจริงในเดือนธันวาคม 2015 แต่เราขอยกมาเป็นตัวอย่างเพื่อให้เห็นภาพหมายเลขเวอร์ชันที่สมจริง) เมื่อมีฟีเจอร์ใหม่เพิ่มเข้ามาใน Rust และมีคอมมิตใหม่รวมเข้าสู่แบรนช์ main ในแต่ละคืน ก็จะมีการสร้าง Rust เวอร์ชัน nightly ใหม่ขึ้นมา ทุกๆ วันจึงถือเป็นวันปล่อยเวอร์ชัน และเวอร์ชันเหล่านี้จะถูกสร้างขึ้นผ่านโครงสร้างพื้นฐานการเผยแพร่ของเราโดยอัตโนมัติ ดังนั้นเมื่อเวลาผ่านไป ช่องทางการปล่อยเวอร์ชันของเราจึงมีลักษณะดังนี้ คืนละหนึ่งจุด:
nightly: * - - * - - *
เมื่อครบทุกๆ หกสัปดาห์ ก็จะถึงเวลาเตรียมการปล่อยเวอร์ชันใหม่! แบรนช์ beta ของรีพอซิทอรี Rust จะแตกกิ่งออกมาจากแบรนช์ main ที่ nightly ใช้งานอยู่ ตอนนี้จึงมีช่องทางการปล่อยเวอร์ชันอยู่สองส่วน:
nightly: * - - * - - *
|
beta: *
ผู้ใช้ Rust ส่วนใหญ่ไม่ได้นำรุ่น beta ไปใช้งานจริง แต่จะใช้ทดสอบร่วมกับระบบ CI ของตน เพื่อช่วยให้ทีม Rust ค้นพบข้อผิดพลาดถดถอย (regression) ที่อาจเกิดขึ้น ในระหว่างนั้น การปล่อยเวอร์ชัน nightly ก็ยังคงเกิดขึ้นทุกคืนต่อไป:
nightly: * - - * - - * - - * - - *
|
beta: *
สมมติว่าพบข้อผิดพลาดถดถอย นับเป็นโชคดีที่เรามีเวลาทดสอบรุ่น beta ก่อนที่ข้อผิดพลาดนั้นจะหลุดรอดเข้าไปในเวอร์ชันเสถียร! การแก้ไขจะถูกนำไปใช้กับแบรนช์ main เพื่อให้ nightly ได้รับการแก้ไข จากนั้นจึงแบ็กพอร์ต (backport) การแก้ไขนั้นกลับมายังแบรนช์ beta แล้วจึงสร้างรุ่น beta ใหม่ออกมา:
nightly: * - - * - - * - - * - - * - - *
|
beta: * - - - - - - - - *
หกสัปดาห์หลังจากสร้าง beta รุ่นแรกขึ้นมา ก็ถึงเวลาสำหรับการปล่อยเวอร์ชันเสถียร! แบรนช์ stable จะถูกสร้างขึ้นมาจากแบรนช์ beta:
nightly: * - - * - - * - - * - - * - - * - * - *
|
beta: * - - - - - - - - *
|
stable: *
ไชโย! Rust 1.5 เสร็จสมบูรณ์แล้ว! อย่างไรก็ดี เรายังลืมไปอีกสิ่งหนึ่ง: เนื่องจากเวลาผ่านไปหกสัปดาห์แล้ว เราจึงจำเป็นต้องมี beta ตัวใหม่สำหรับ Rust เวอร์ชัน_ถัดไป_ นั่นคือ 1.6 ด้วย ดังนั้นหลังจาก stable แตกกิ่งออกมาจาก beta แล้ว beta เวอร์ชันถัดไปก็จะแตกกิ่งออกมาจาก nightly ใหม่อีกครั้ง:
nightly: * - - * - - * - - * - - * - - * - * - *
| |
beta: * - - - - - - - - * *
|
stable: *
เราเรียกสิ่งนี้ว่า “โมเดลรถไฟ” (train model) เพราะทุกๆ หกสัปดาห์ ตัวเวอร์ชันจะ “เคลื่อนออกจากสถานี” ทว่ายังคงต้องเดินทางผ่านช่องทาง beta ก่อนที่จะมาถึงจุดหมายในฐานะการปล่อยเวอร์ชันเสถียร
Rust ปล่อยเวอร์ชันใหม่ออกมาทุกหกสัปดาห์อย่างสม่ำเสมอ หากคุณทราบวันปล่อยเวอร์ชันของ Rust รอบหนึ่ง คุณก็จะทราบวันปล่อยเวอร์ชันรอบถัดไปได้ทันที: นั่นคืออีกหกสัปดาห์ถัดมา ข้อดีของการกำหนดตารางปล่อยเวอร์ชันทุกหกสัปดาห์เช่นนี้คือ รถไฟขบวนถัดไปกำลังจะมาถึงในอีกไม่ช้า หากมีฟีเจอร์ใดที่พัฒนาไม่ทันรอบนี้ ก็ไม่ต้องกังวล: เพราะรอบถัดไปจะตามมาในเวลาอันสั้น! สิ่งนี้ช่วยลดแรงกดดันที่จะรีบยัดเยียดฟีเจอร์ที่ยังไม่ผ่านการขัดเกลาเข้ามาในช่วงใกล้ถึงกำหนดเส้นตาย
ด้วยกระบวนการนี้ คุณจึงสามารถทดลองใช้บิลด์ถัดไปของ Rust ได้เสมอ และพิสูจน์ด้วยตนเองว่าการอัปเกรดเป็นเรื่องง่าย: หากรุ่น beta ทำงานไม่ตรงตามที่คาดไว้ คุณสามารถรายงานให้ทีมงานทราบ เพื่อแก้ไขปัญหาก่อนที่เวอร์ชันเสถียรรอบถัดไปจะปล่อยออกมา! ความเสียหายหรือการพังของโค้ดในรุ่น beta นั้นเกิดขึ้นค่อนข้างน้อย แต่ rustc ก็ยังคงเป็นซอฟต์แวร์ชิ้นหนึ่ง และย่อมมีบั๊กเกิดขึ้นได้เสมอ
ช่วงเวลาบำรุงรักษา
โปรเจกต์ Rust จะสนับสนุนเฉพาะเวอร์ชันเสถียรล่าสุดเท่านั้น เมื่อมีการปล่อยเวอร์ชันเสถียรรุ่นใหม่ออกมา เวอร์ชันเก่าก็จะสิ้นสุดอายุการใช้งาน (end of life หรือ EOL) ทันที ซึ่งหมายความว่าแต่ละเวอร์ชันจะได้รับการสนับสนุนเป็นระยะเวลาหกสัปดาห์
ฟีเจอร์ที่ยังไม่เสถียร
ยังมีเงื่อนไขสำคัญอีกประการหนึ่งในโมเดลการปล่อยเวอร์ชันนี้: นั่นคือฟีเจอร์ที่ยังไม่เสถียร (unstable features) Rust ใช้เทคนิคที่เรียกว่า “แฟล็กฟีเจอร์” (feature flags) ในการกำหนดว่าฟีเจอร์ใดจะเปิดใช้งานในการปล่อยเวอร์ชันแต่ละครั้ง หากฟีเจอร์ใหม่อยู่ระหว่างการพัฒนาอย่างต่อเนื่อง ฟีเจอร์นั้นจะถูกผสานเข้าสู่แบรนช์ main จึงปรากฏอยู่ใน nightly แต่อยู่เบื้องหลัง_แฟล็กฟีเจอร์_ หากคุณในฐานะผู้ใช้งานต้องการทดลองใช้ฟีเจอร์ที่อยู่ระหว่างพัฒนานี้ คุณก็สามารถทำได้ แต่จะต้องใช้ Rust รุ่น nightly และระบุแอตทริบิวต์กำกับในซอร์สโค้ดด้วยแฟล็กที่เหมาะสมเพื่อเปิดใช้งาน
หากคุณใช้งาน Rust รุ่น beta หรือรุ่นเสถียร คุณจะไม่สามารถใช้งานแฟล็กฟีเจอร์ใดๆ ได้เลย นี่คือกุญแจสำคัญที่เปิดโอกาสให้เราได้นำฟีเจอร์ใหม่ๆ ไปทดลองใช้งานจริงในทางปฏิบัติ ก่อนที่เราจะประกาศให้ฟีเจอร์เหล่านั้นเสถียรอย่างถาวร ผู้ที่ต้องการทดลองเทคโนโลยีล้ำสมัยก็สามารถเลือกใช้งานได้ ส่วนผู้ที่ต้องการความมั่นคงปลอดภัยอันแข็งแกร่งดั่งหินผาก็สามารถใช้เวอร์ชันเสถียรและมั่นใจได้ว่าโค้ดจะไม่พัง นี่คือความเสถียรโดยไม่หยุดนิ่ง
หนังสือเล่มนี้จะครอบคลุมเฉพาะฟีเจอร์ที่เสถียรแล้วเท่านั้น เนื่องจากฟีเจอร์ที่อยู่ระหว่างการพัฒนายังคงเปลี่ยนแปลงได้เสมอ และย่อมมีความแตกต่างระหว่างช่วงเวลาที่เขียนหนังสือเล่มนี้กับช่วงเวลาที่ฟีเจอร์เหล่านั้นเปิดให้ใช้งานในบิลด์เสถียรจริง คุณสามารถค้นหาเอกสารประกอบสำหรับฟีเจอร์เฉพาะของ nightly ได้จากช่องทางออนไลน์
Rustup และบทบาทของ nightly Rust
Rustup ช่วยให้การสลับเปลี่ยนช่องทางการปล่อยเวอร์ชันต่างๆ ของ Rust เป็นเรื่องง่าย ทั้งในระดับส่วนกลางของทั้งระบบหรือแบบเจาะจงเฉพาะโปรเจกต์ โดยค่าเริ่มต้น คุณจะมี Rust เวอร์ชันเสถียรติดตั้งอยู่แล้ว ตัวอย่างเช่น หากต้องการติดตั้ง nightly:
$ rustup toolchain install nightly
คุณยังสามารถดู_ทูลเชน_ (toolchain) ทั้งหมด (การปล่อยเวอร์ชันของ Rust และคอมโพเนนต์ที่เกี่ยวข้อง) ที่คุณติดตั้งไว้ได้ด้วย rustup นี่คือตัวอย่างบนคอมพิวเตอร์ Windows ของหนึ่งในผู้เขียนหนังสือเล่มนี้:
> rustup toolchain list
stable-x86_64-pc-windows-msvc (default)
beta-x86_64-pc-windows-msvc
nightly-x86_64-pc-windows-msvc
ดังที่คุณเห็น ทูลเชนเสถียรจะเป็นค่าเริ่มต้น ผู้ใช้ Rust ส่วนใหญ่ใช้เวอร์ชันเสถียรเกือบตลอดเวลา คุณอาจต้องการใช้เวอร์ชันเสถียรเป็นหลัก แต่ใช้ nightly กับโปรเจกต์ใดโปรเจกต์หนึ่งโดยเฉพาะ เนื่องจากคุณสนใจฟีเจอร์ล้ำสมัย เมื่อต้องการทำเช่นนั้น คุณสามารถใช้คำสั่ง rustup override ในไดเรกทอรีของโปรเจกต์นั้น เพื่อตั้งให้ทูลเชน nightly เป็นทูลเชนที่ rustup ควรใช้เมื่อคุณอยู่ในไดเรกทอรีดังกล่าว:
$ cd ~/projects/needs-nightly
$ rustup override set nightly
ตอนนี้ ทุกครั้งที่คุณเรียก rustc หรือ cargo ภายใน ~/projects/needs-nightly rustup จะทำให้แน่ใจว่าคุณกำลังใช้งาน nightly Rust แทนที่จะเป็นค่าเริ่มต้นอย่าง Rust เวอร์ชันเสถียรของคุณ สิ่งนี้มีประโยชน์มากเมื่อคุณมีโปรเจกต์ Rust จำนวนมาก!
กระบวนการ RFC และทีมงานต่างๆ
แล้วคุณจะเรียนรู้เกี่ยวกับฟีเจอร์ใหม่เหล่านี้ได้อย่างไร? โมเดลการพัฒนาของ Rust ดำเนินตาม_กระบวนการ Request For Comments (RFC)_ หากคุณอยากเห็นการปรับปรุงหรือเพิ่มฟีเจอร์ใน Rust คุณสามารถเขียนเอกสารข้อเสนอที่เรียกว่า RFC ขึ้นมาได้
ใครๆ ก็สามารถเขียน RFC เพื่อร่วมพัฒนา Rust ได้ และข้อเสนอเหล่านี้จะได้รับการตรวจสอบและพิจารณาหารือโดยทีมงานของ Rust ซึ่งประกอบด้วยทีมย่อยเฉพาะทางหลายทีม คุณสามารถดูรายชื่อทีมทั้งหมดได้บนเว็บไซต์ของ Rust ซึ่งครอบคลุมทีมงานสำหรับแต่ละภาคส่วนของโปรเจกต์: ไม่ว่าจะเป็นการออกแบบภาษา การพัฒนาคอมไพเลอร์ โครงสร้างพื้นฐาน เอกสารประกอบ และอื่นๆ ทีมงานที่เกี่ยวข้องจะอ่านข้อเสนอและความคิดเห็นต่างๆ พร้อมร่วมแสดงความคิดเห็นเพิ่มเติม จนกระทั่งเกิดฉันทามติว่าจะยอมรับหรือปฏิเสธฟีเจอร์ดังกล่าว
หากฟีเจอร์นั้นได้รับการยอมรับ ก็จะมีการเปิดประเด็นปัญหา (issue) บนที่เก็บโค้ดของ Rust และเปิดให้มีผู้นำไปพัฒนาต่อไป ซึ่งผู้ที่ลงมือพัฒนาอาจไม่ใช่ผู้ที่เสนอแนวคิดตั้งแต่แรกก็ได้! เมื่อโค้ดพัฒนาเสร็จสมบูรณ์ ก็จะถูกผสานเข้าสู่แบรนช์ main ภายใต้เกตฟีเจอร์ (feature gate) ดังที่เราได้อธิบายไว้ในส่วน“ฟีเจอร์ที่ยังไม่เสถียร”
เมื่อเวลาผ่านไประยะหนึ่ง และนักพัฒนา Rust ที่ใช้งานรุ่น nightly ได้มีโอกาสทดลองใช้งานฟีเจอร์ใหม่แล้ว สมาชิกในทีมจะนำฟีเจอร์นั้นมาหารือกันอีกครั้ง เพื่อประเมินผลการทำงานบน nightly และตัดสินใจว่ามันควรเข้าไปอยู่ใน Rust เวอร์ชันเสถียรหรือไม่ หากมีมติให้ดำเนินการต่อ เกตฟีเจอร์ก็จะถูกปลดออก และถือว่าฟีเจอร์นั้นเข้าสู่สถานะเสถียรแล้ว! พร้อมออกเดินทางไปกับขบวนรถไฟสู่การปล่อย Rust เวอร์ชันเสถียรรอบถัดไป